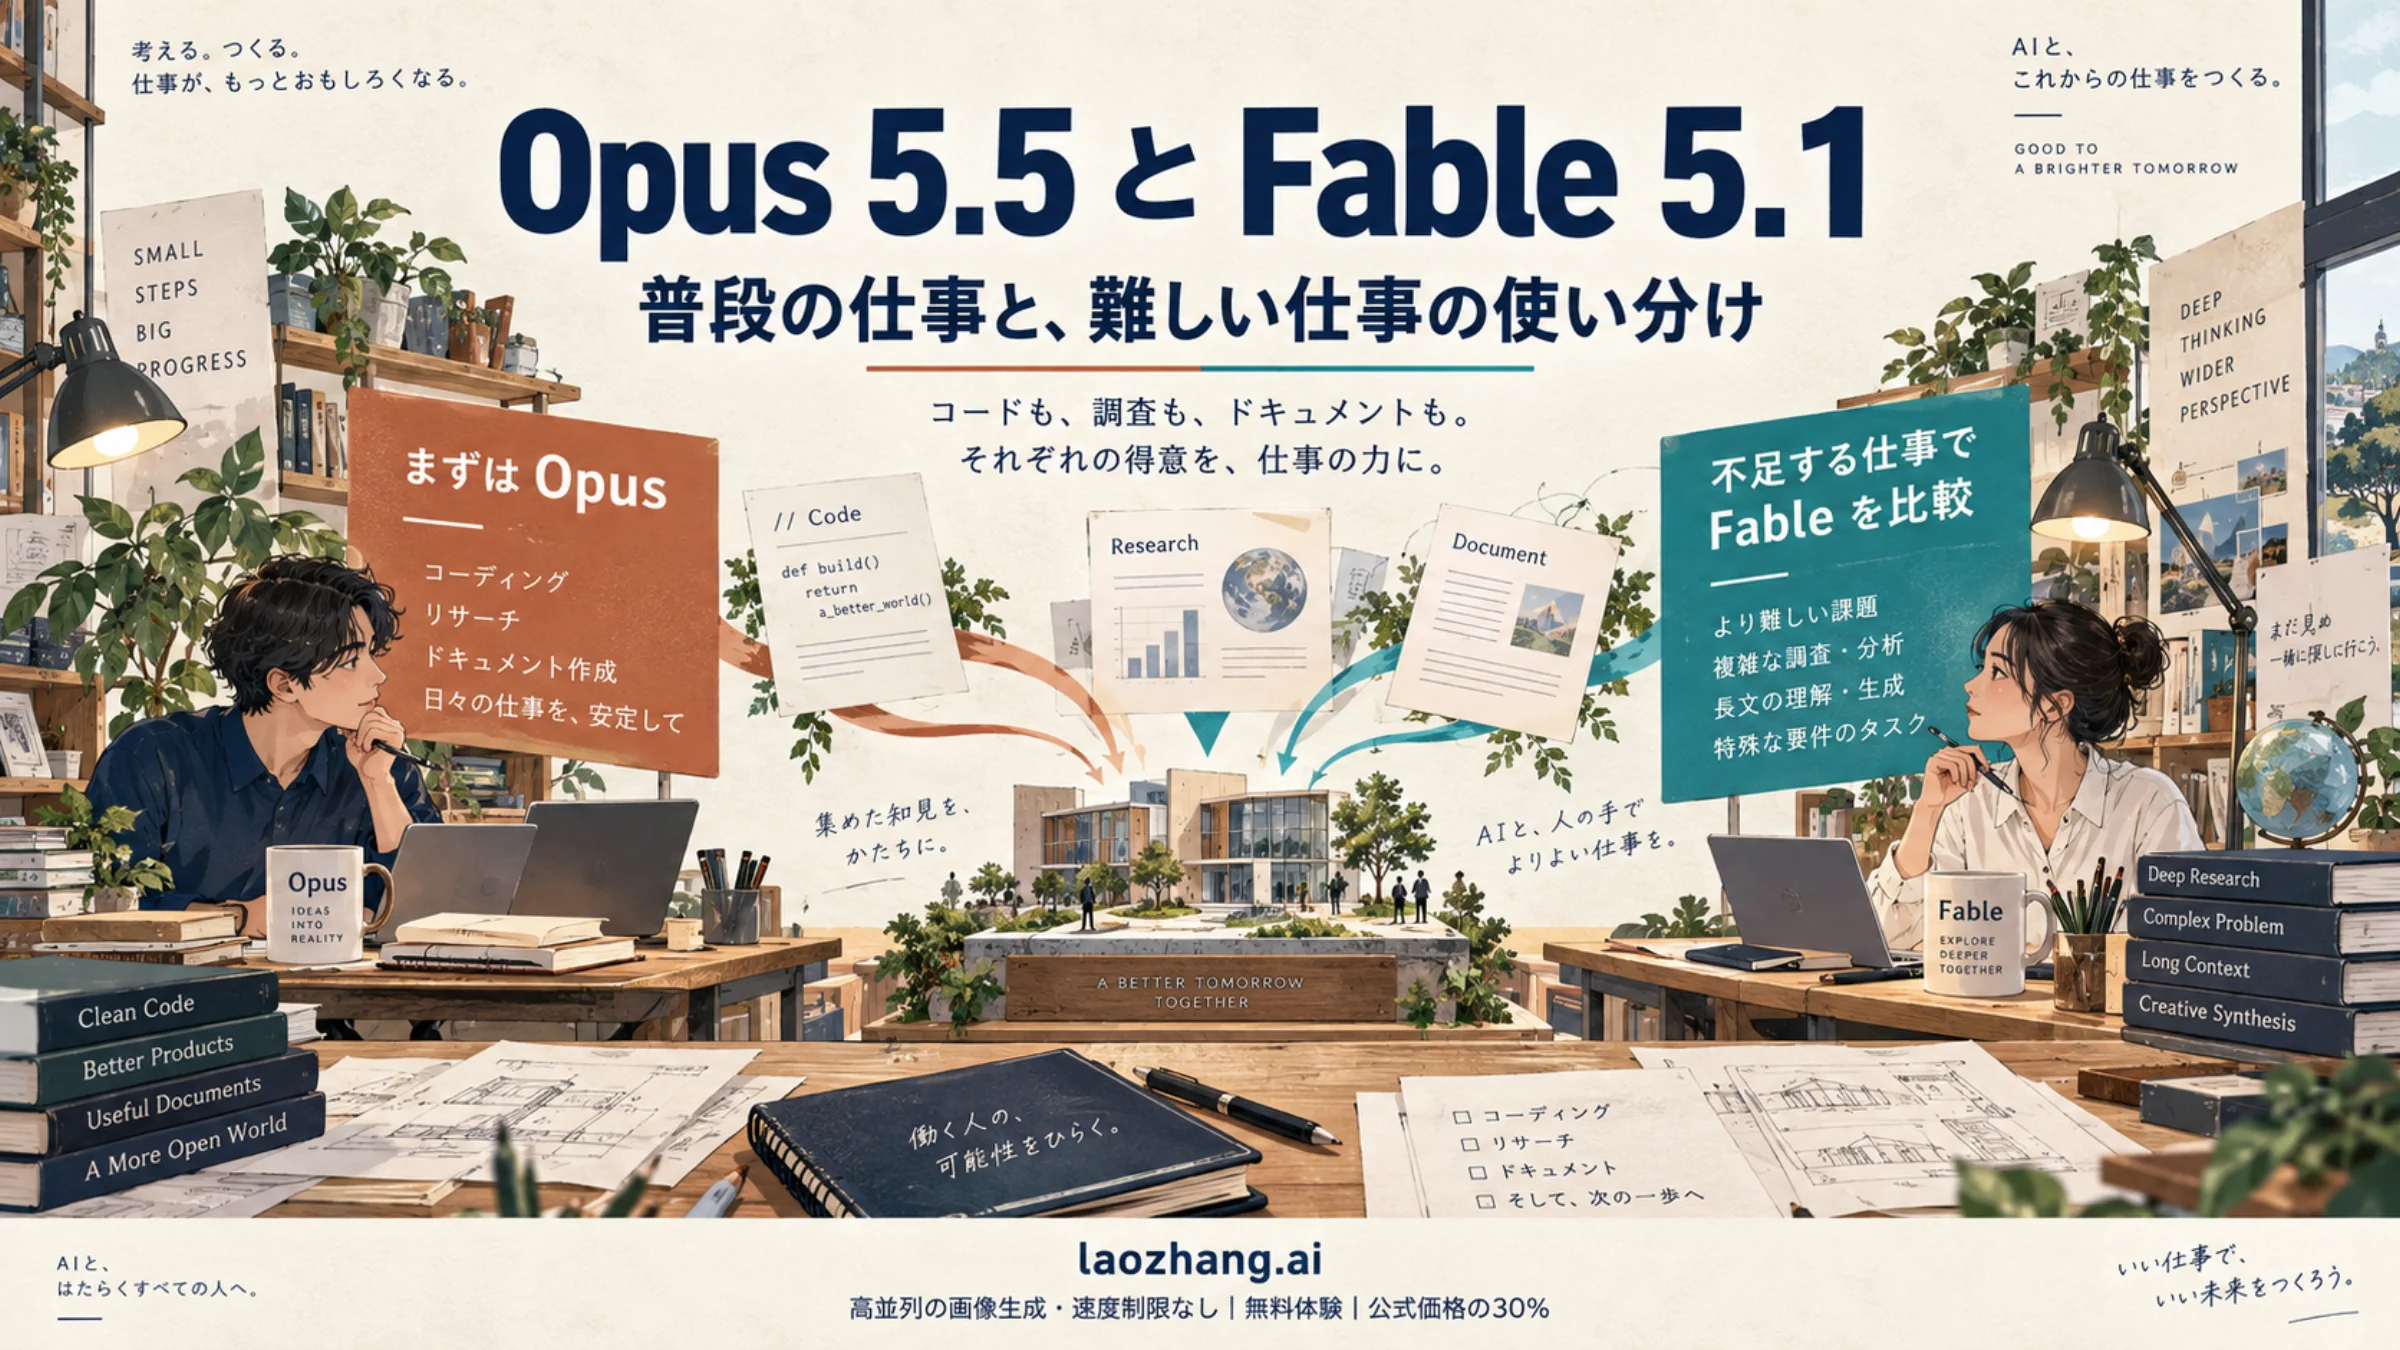
普段のコーディング、調査、資料作成に使うなら、まずはClaude Opus 5.5を選ぶのが妥当です。Fable 5.1は、Opusの思考にかける労力を増やしても、必要な品質に届かない仕事で比較する候補として残します。Anthropicのモデル選択ガイドも、能力を重視する場合はOpus 5.5から始め、xhighやmaxでも難しい推論・長期の自律作業が不十分ならFable 5.1へ進む、という順序を示しています。
ただし、「Opusのほうが安いから、今の仕事を全部置き換える」とまでは言えません。選ぶ単位はモデル名ではなく、必要な成果を出すまでの時間と費用です。この記事では、2026年9月23日時点の公式資料を基に、その判断に効く違いを整理します。掲載する評価結果はAnthropicの公表値で、当サイトが両モデルを実測したものではありません。
普段はOpus 5.5、Fable 5.1は失敗の残る仕事で試す
使い分けの出発点は、次のように考えると迷いにくくなります。表の用途は本記事の提案であり、各用途での勝率を測定した結果ではありません。
| 今の仕事・困りごと | 最初の選択 | Fable 5.1を試す条件 |
|---|---|---|
| バグ修正、機能追加、コードレビュー | Opus 5.5の既定設定 | effortを上げても、再現テストや受入条件を満たせない |
| 調査結果の整理、文書・表・資料の作成 | Opus 5.5 | 根拠の取り違えや条件の見落としが残り、人の手戻りが大きい |
| 複数工程にまたがる開発や調査 | Opus 5.5で代表的な仕事を評価 | 途中の判断や検証を含めて、Fableのほうが安定して完了する |
| 既にFable 5.1で安定している業務 | 現行運用を保ち、Opus 5.5を別セッションで比較 | 切替後の品質低下が費用削減に見合わないならFableを維持 |
「数時間かかるからFable」と時間だけで決める必要はありません。AnthropicはOpus 5.5についても長い開発作業を想定しています。公開されたHAProxyのCからRustへの移植実験では、両モデルの成果物がほぼすべての回帰テストを通過し、所要時間はOpusが9.5時間、Fableが12時間、費用はOpusが51%低かったとしています。これは同社内の一つの実験であり、あらゆる移植作業に通用する削減率ではありません。Opus 5.5発表
Fableを残す意味は、「高いモデルだから最後は必ず勝つ」ことではありません。自分の難しい仕事で、Opusとは違う結果を出せるかを確かめる比較対象があることです。既存のFable運用を置き換えるなら、うまくいった簡単な依頼だけでなく、以前に人の修正が必要だった依頼も試すと判断しやすくなります。
同じなのは文脈の長さ。既定のeffortと応答速度は違う
通常のAPI仕様では、両モデルとも100万トークンのコンテキストと最大128Kトークンの出力に対応します。長い資料やコードを扱いたいという理由だけでは、Fableを選ぶ決め手になりません。
| 項目 | Opus 5.5 | Fable 5.1 |
|---|---|---|
| APIモデルID | claude-opus-5-5 | claude-fable-5-1 |
| コンテキスト | 100万トークン | 100万トークン |
| 通常の最大出力 | 128Kトークン | 128Kトークン |
| 既定のeffort | medium | high |
| 公式の相対的な遅延区分 | Moderate | Slower |
出典:Opus 5.5の仕様、Fable 5.1の仕様。遅延区分は同一依頼での待ち時間を保証するものではありません。OpusのBatchにはベータ指定による300K出力の例外があり、上表は通常の上限です。
effortは、モデルが推論にどれだけ労力をかけるかを調整する設定です。同じhighという名前でも、別モデルが同じ計算量・費用で動くと考えるべきではありません。まずは各モデルの既定値で、自分の仕事をどこまで任せられるかを見ます。Opusで不足があればeffortを上げ、追加の時間や費用に見合う改善があるかを確かめます。公式のeffort選択方針
品質を比較するときは、モデルIDとeffortを必ず一緒に記録してください。「FableからOpusに替えたら速くなった」という結果でも、既定値の違いを含む比較なのか、狙った品質に合わせて調整した比較なのかで意味が変わります。
公開ベンチマークではOpusが上。それでも万能とは言えない
Anthropicの発表では、以下の開発系評価でOpus 5.5がFable 5.1を上回っています。
| Anthropic公表の評価 | Opus 5.5 | Fable 5.1 |
|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 55.8% |
| CursorBench 4.0 | 57.8% | 51.8% |
発表ページの評価表と注記に基づきます。OpusはTerminal-Benchでxhigh、CursorBenchでmaxの設定です。Terminal-BenchのOpusの標準誤差は±2.6ポイント。評価は本番の安全対策を有効にし、対象分野の制約が働いた場合は別モデルへ切り替える構成を含みます。
この結果は「まずOpusを試す」根拠になります。一方で、すべての依頼に対する勝率ではありません。Anthropic自身も、実際に使ったときの両モデルの差は、ベンチマークの数字が示すほど大きくないと説明しています。
自分の業務に置き換えるなら、コードではテストの合否、不要な変更、人が修正した箇所を見ます。調査や資料なら、根拠と結論の対応、抜けた条件、修正にかかった時間を見ます。説明が長い、考えている時間が長い、といった見た目を品質の代わりにしないことが大切です。
API単価は60%安い。ただしキャッシュ読み出しは20%差
通常のClaude APIでは、Opus 5.5の未キャッシュ入力・出力・キャッシュ書き込みは、Fable 5.1より60%安くなっています。キャッシュ読み出しだけは20%差です。いずれも100万トークン当たりの米ドル建て料金です。
| 課金対象 | Opus 5.5 | Fable 5.1 |
|---|---|---|
| 未キャッシュ入力 | $4 | $10 |
| 出力 | $20 | $50 |
| 5分キャッシュ書き込み | $5 | $12.50 |
| 1時間キャッシュ書き込み | $8 | $20 |
| キャッシュ読み出し | $0.20 | $0.25 |
出典:Claude API料金表。2026年9月23日時点の通常料金で、Fastモード、Batch割引、地域指定による加算、ツール料金、税金、他社プラットフォーム独自の料金は含みません。
Fableのキャッシュ読み出しは基本入力単価の2.5%、Opusは5%です。ただし、比率が小さいFableのほうが安いわけではありません。元の入力単価が異なるため、実額ではOpusの$0.20に対してFableは$0.25です。旧Fable 5の読み出し単価とも区別してください。キャッシュ課金の説明
キャッシュが多い仕事でも、出力の費用を忘れない
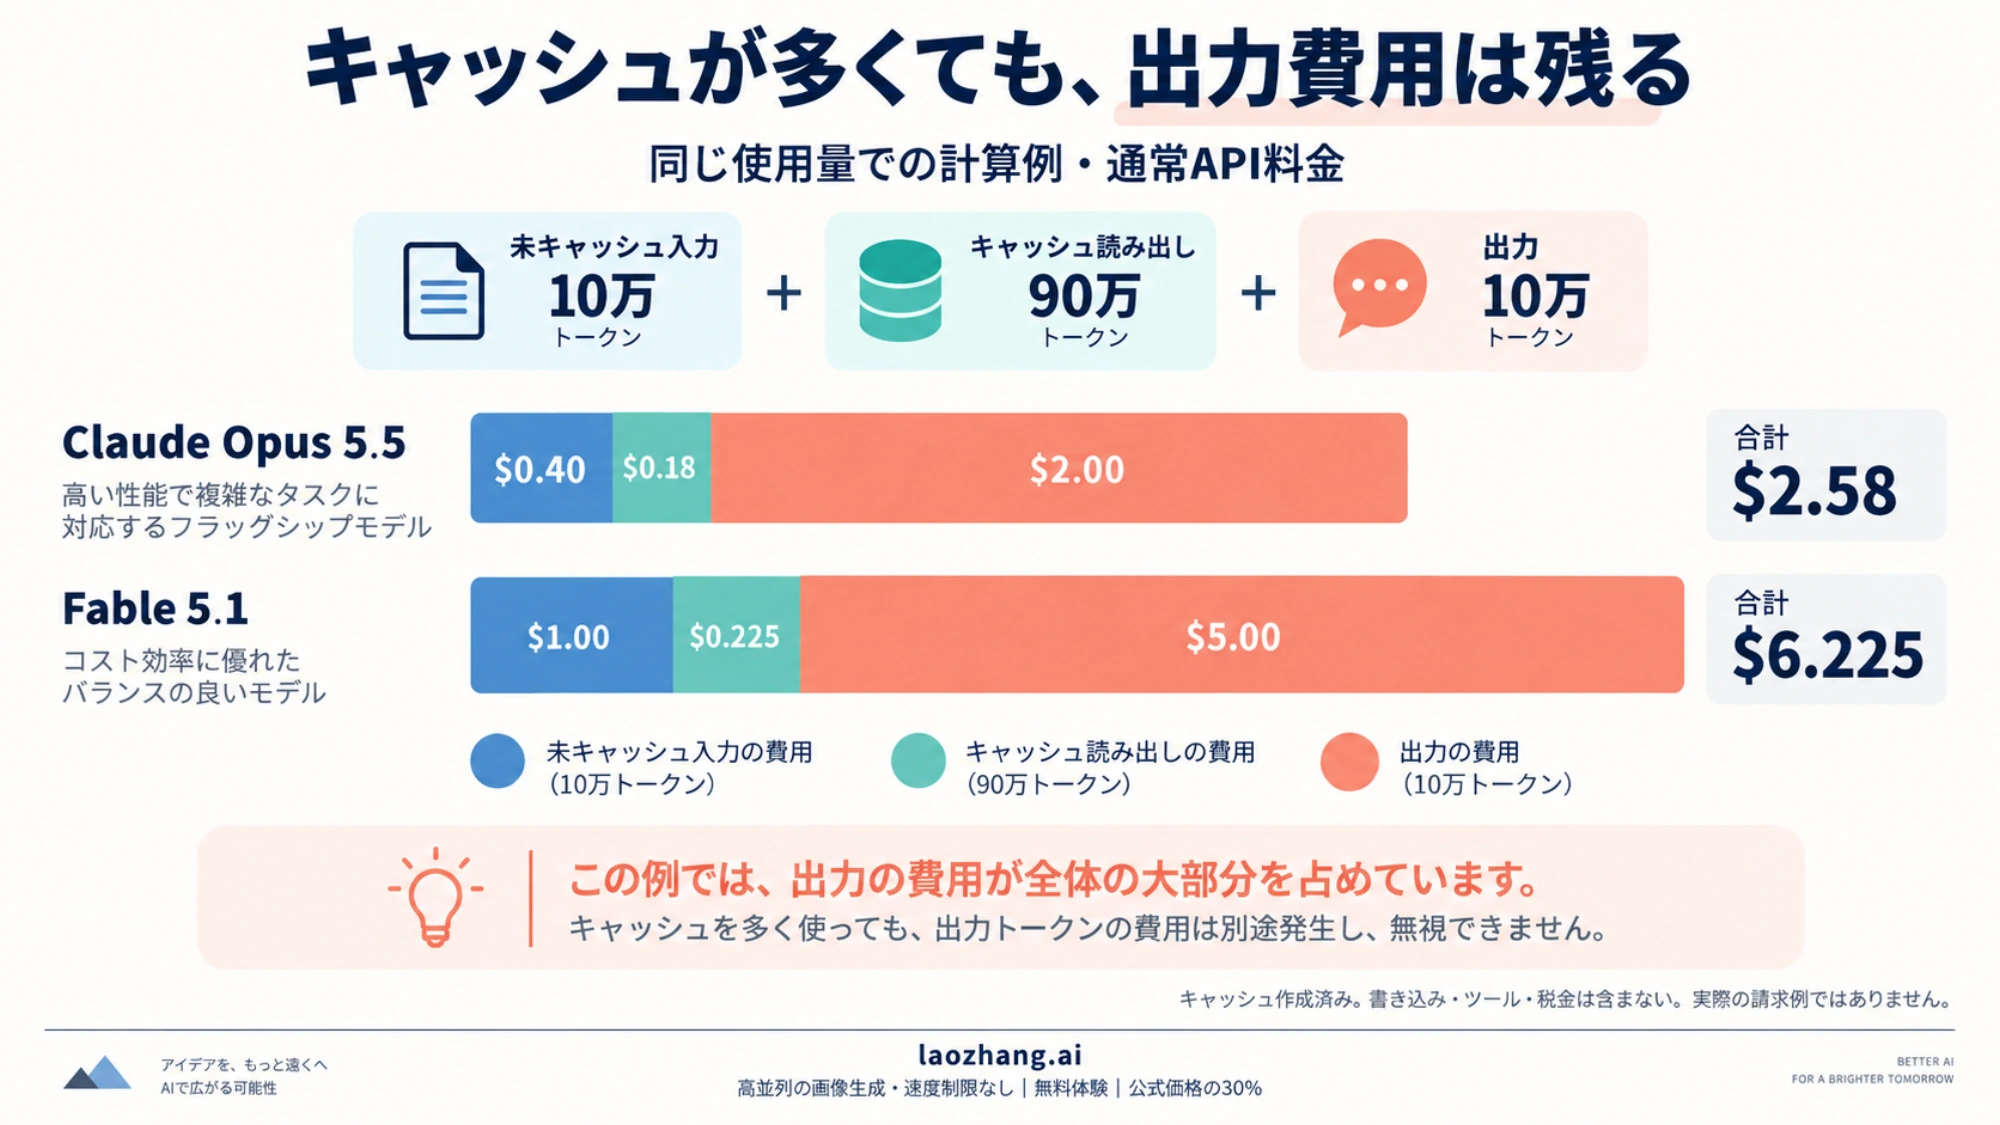
次は同じトークン量を処理したと仮定した計算例です。実際の請求額や、1回の依頼で必ず消費する量ではありません。複数回のAPI呼び出しを合計した使用量として考えてください。
| 合計使用量の例 | Opus 5.5 | Fable 5.1 | Opusの削減率 |
|---|---|---|---|
| 未キャッシュ入力100万+出力10万 | $6.00 | $15.00 | 60% |
| 未キャッシュ入力10万+キャッシュ読み出し90万+出力10万 | $2.58 | $6.225 | 約58.6% |
| キャッシュ読み出し100万だけ | $0.20 | $0.25 | 20% |
2行目は、既にキャッシュが作成されており、その書き込み費用を計算の外に置いた例です。Opusは0.1 × 4 + 0.9 × 0.20 + 0.1 × 20 = 2.58、Fableは0.1 × 10 + 0.9 × 0.25 + 0.1 × 50 = 6.225となります。削減率は1 − 2.58 ÷ 6.225です。3行目は読み出し部分だけの比較で、回答を生成する仕事全体の費用ではありません。
つまり、入力の9割をキャッシュから読んでも、出力が多ければ全体の価格差は大きくなります。逆に、既存の長い文脈を繰り返し読み、出力がごく少ない仕事では、読み出し単価の差が効きやすくなります。自分の請求を見直すときは、キャッシュのヒット率だけでなく、入力・書き込み・読み出し・出力を分けて比べてください。
実際のモデル変更では、出力の長さ、再試行、ツール使用、人の手戻りも変わります。単価が60%安いことと、一つの仕事を終える総費用が60%下がることは別です。また、このAPI価格差からClaudeの月額プランの利用枠が60%増えるとは計算できません。プランの制限やリセットが目的なら、Opus 5.5の料金・利用制限の整理を参照してください。
Claude Codeではモデルを明示して比較する
Claude CodeでOpus 5.5を使うには、バージョン2.1.280以降が必要です。AnthropicのモデルIDを使う環境では、更新したうえで次のように起動できます。Claude Codeのモデル設定
bashclaude update
claude --model claude-opus-5-5
Fable 5.1と比べるときは、別の新しいセッションで起動します。
bashclaude --model claude-fable-5-1
起動済みのセッションでは/modelから選択できます。ただし、opusやfableという別名が指す版は接続先によって異なります。利用中のプランや接続先で対象モデルが提供されていることを確認し、比較では完全なモデルIDを使うと版の取り違えを避けやすくなります。Bedrockの推論プロファイルやFoundryのデプロイなどを使う環境では、その接続先の指定方法に従ってください。モデル名と接続先の対応
比較用の入力には、同じソースコードや資料、同じ完了条件を渡します。既に一方のモデルが修正したコードを、もう一方の開始地点に使わないようにしてください。結果を見てから都合のよい条件を追加するより、先に「このテストを通す」「この根拠を示す」と決めておくほうが、切替の判断に使えます。
自作APIでは、思考の引継ぎが片方向になる
Claude APIで会話履歴を自分で組み立てる場合は、切替方向に注意が必要です。Fable 5.1はOpus 5.5が生成したthinkingブロックを読めますが、Opus 5.5はFable 5.1のthinkingブロックを読めません。読めないブロックはエラーを出さずに除外されます。これは会話の通常のテキストまで全部消えるという意味ではありません。Preserved thinkingの仕様
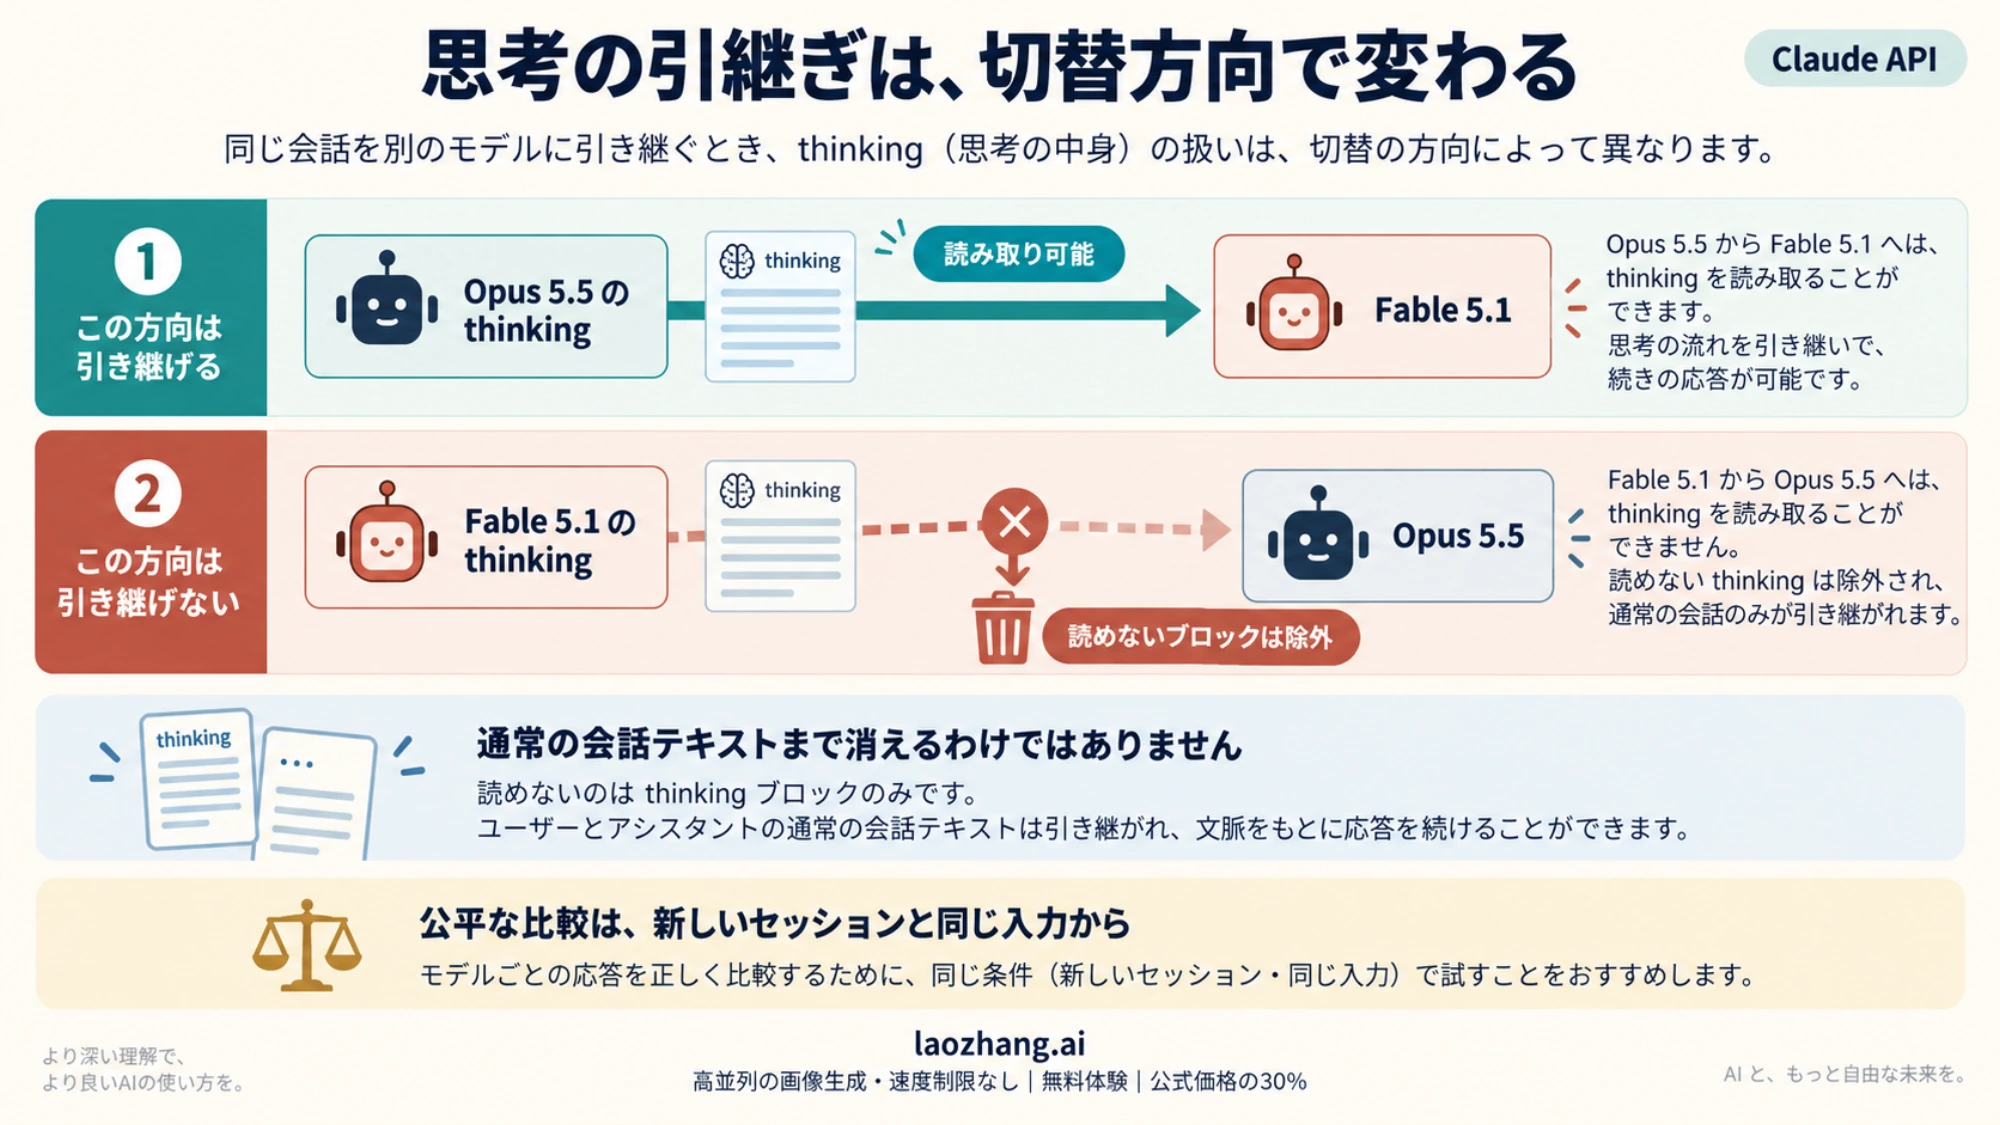
そのため、Opusで始めて難所をFableに引き継ぐ構成と、Fableから安価なOpusへ戻す構成は、同じ条件ではありません。モデル間の品質比較は、新しいセッションに同じ必要情報を渡して行うと、この非対称性を混ぜずに済みます。運用中に切り替える場合は、確定した要件、成果物、未解決の問題を通常のテキストとして残す設計も検討してください。
また、thinkingブロックより前のsystem、tools、messagesを変更すると、思考の引継ぎが無効になる場合があります。これは自作の履歴処理で確認すべき点です。Claude Codeやclaude.aiなどにリクエストの構築を任せている一般の利用者が、署名付きブロックを手作業で編集する必要はありません。対象となる実装の説明
Fable中心のAPI運用を変更する場合は、Fable 5.1の移行・キャッシュ・effortの確認項目も併せて確認してください。
切替は「同じ品質で、手戻り込みで得か」で決める
新しく使い始めるなら、Opus 5.5の既定設定で代表的な仕事を任せます。品質が足りなければeffortを上げ、それでも残る失敗をFable 5.1で試します。Fableでしか解消しない失敗が見つかれば、その種類の仕事にFableを残す理由になります。
既にFableで成果が出ているなら、同じ開始地点と完了条件でOpusを試し、合格した仕事から切り替えるのが現実的です。比べるのは一度の返答の印象ではなく、成果物が使える状態になるまでの費用、待ち時間、修正の手間です。それが同程度なら安いOpusを選び、Fableが明確に手戻りを減らすなら、その仕事では追加費用を払う価値があります。