Geminiコンテキストキャッシュの使い方:損益分岐と実測ヒット率
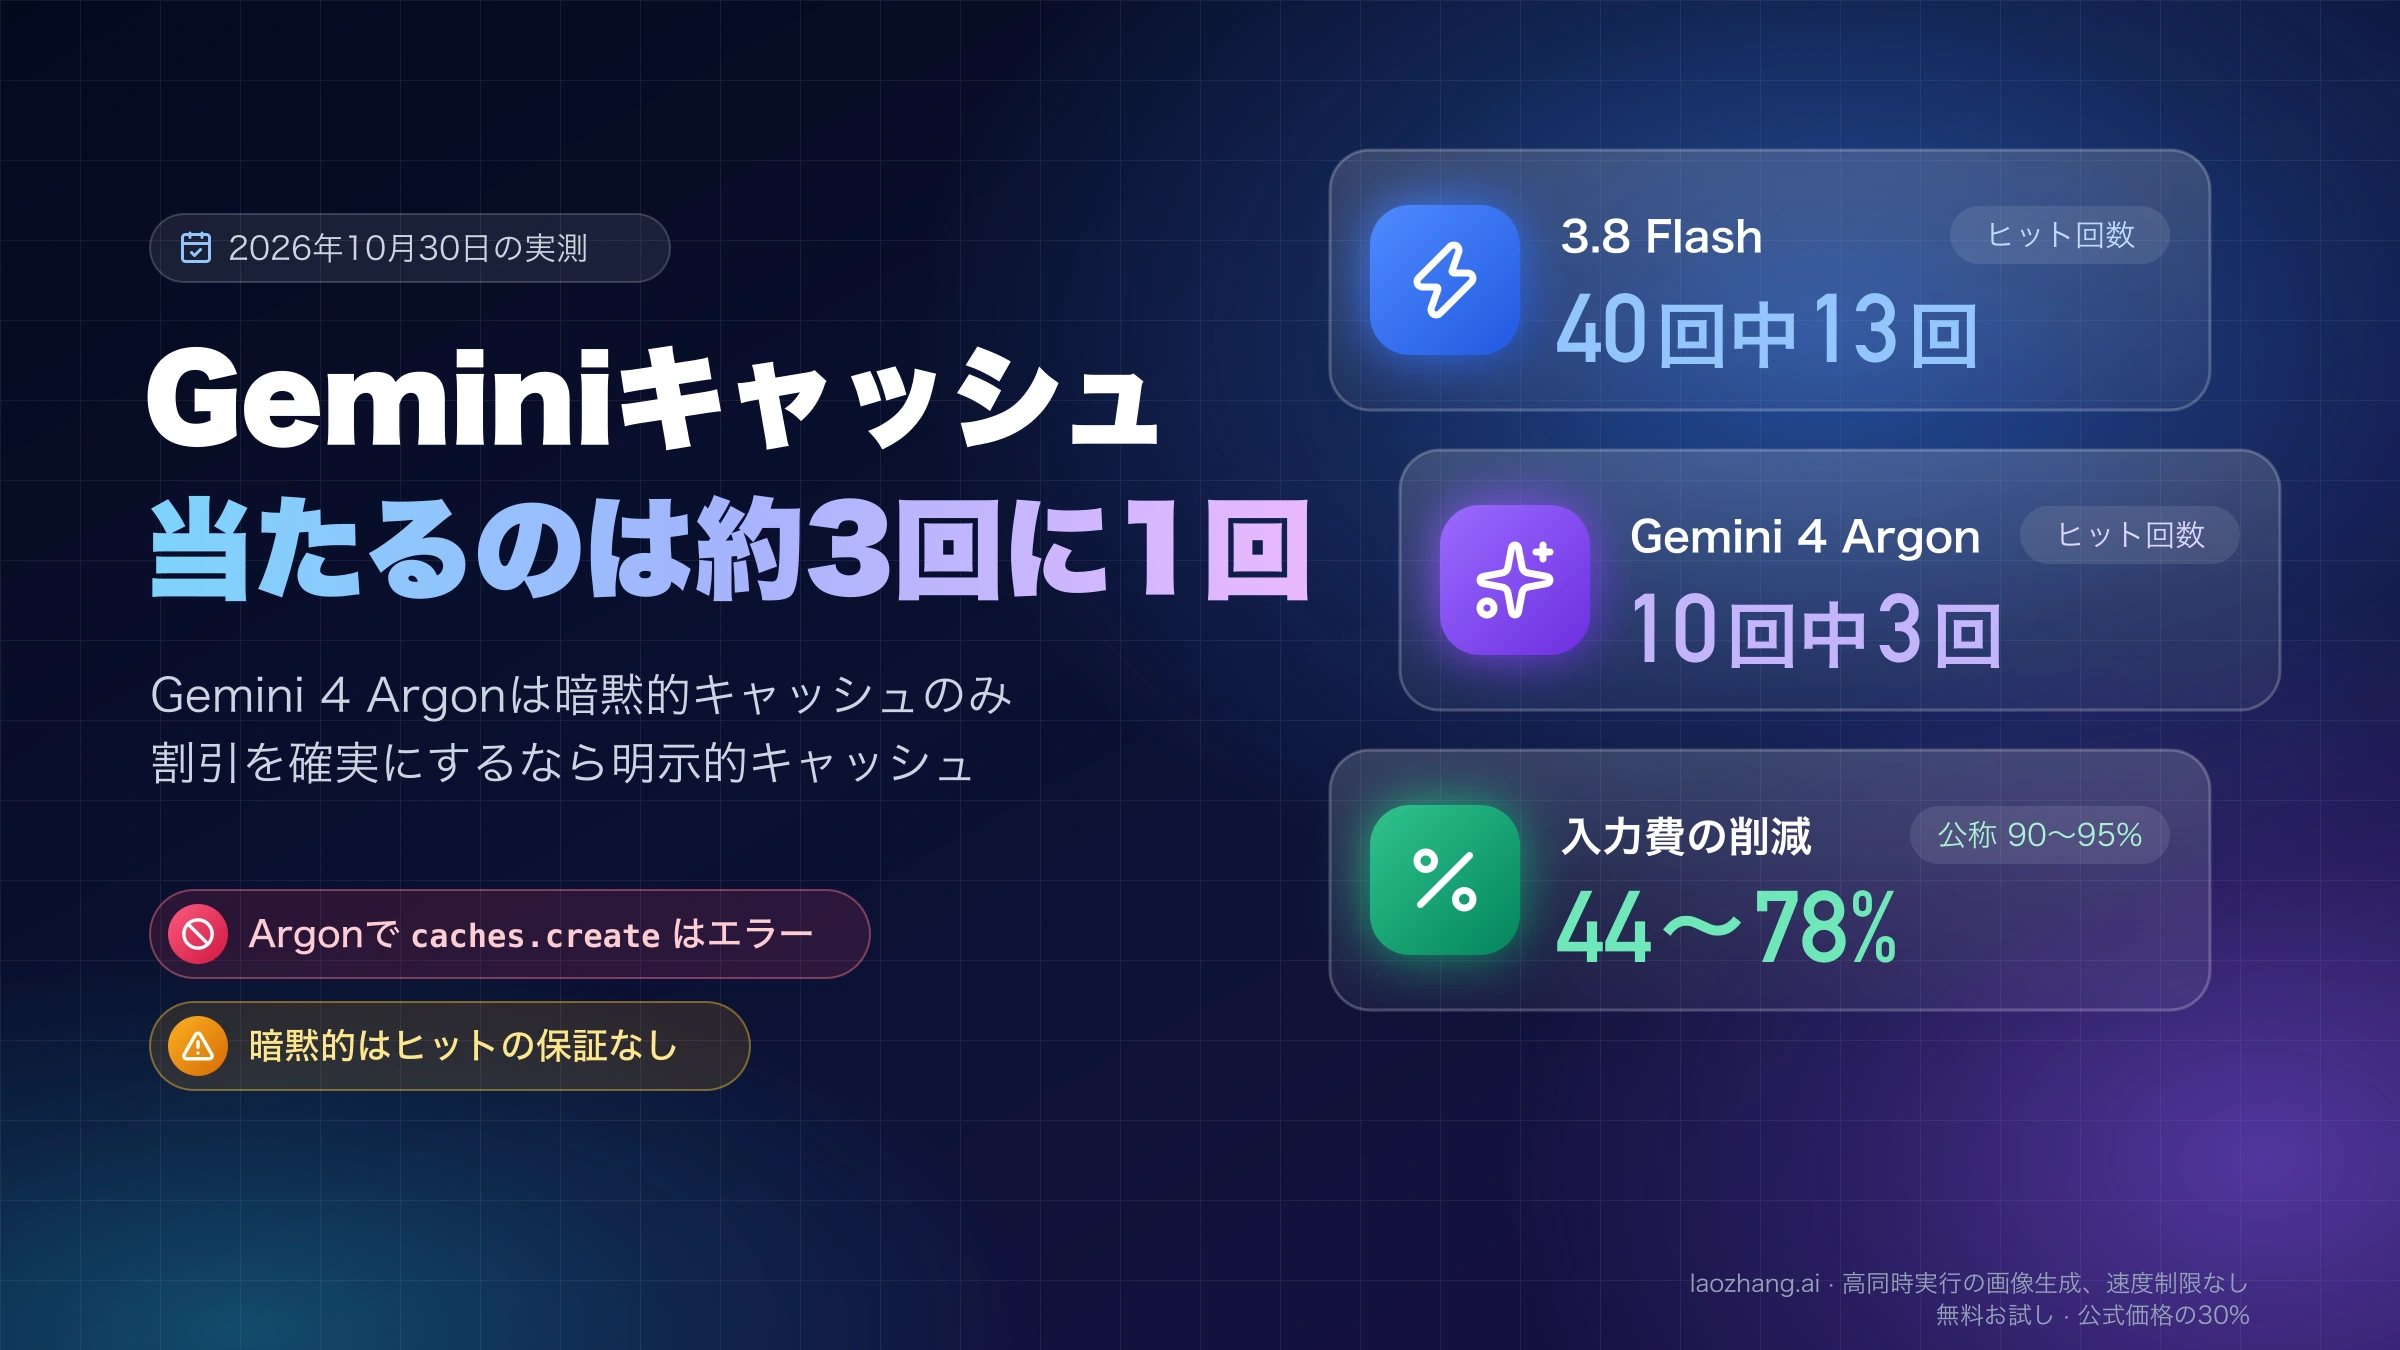
Gemini 4 Argonは暗黙的キャッシュのみで、明示的は3.8 Flashなどが対象です。2026年10月30日の実測では約3回に1回ヒットし、削減は44〜78%でした。
目次
Geminiのコンテキストキャッシュには、何もしなくても働く暗黙的キャッシュと、キャッシュを自分で作って指定する明示的キャッシュの2種類があります。2026年10月30日時点で、Gemini 4 Argon(gemini-4-argon)が使えるのは暗黙的キャッシュだけです。Argonへ移行するなら、caches.createとcached_contentを呼ぶコードは外してください。残すとエラーになります。3.8 Flash、3.6 Flash、3.1 Pro Preview、3.5 Flash-Lite、2.5系では両方を使えますが、明示的キャッシュを作れるのはgenerateContent APIだけで、GoogleがおすすめしているInteractions APIでは作れません。
暗黙的キャッシュはストレージ料金がかからない代わりに、ヒットの保証がありません。ヒットさせるには、長いシステム指示や資料をプロンプトの先頭に固定し、毎回変わる質問や日時は最後に置きます。当たったかどうかは、レスポンスのusageMetadataにcachedContentTokenCountが出ているかで確かめます。2026年10月30日にLaoZhang経由で同じ前置きのリクエストを繰り返したところ、5,605トークン以上のプロンプトで3.8 Flashのヒットは40回中13回(OpenAI互換経由の3回を含み、34回はまったく同じリクエスト、6回は最後の質問だけを変更)、Argonは10回中3回でした。当たった回でもキャッシュされたのはプロンプトの49〜82%で、入力費の削減は公称の90〜95%ではなく44〜78%にとどまりました。
割引を確実に受けたいなら、Argon以外のモデルで明示的キャッシュを使います。ただし1時間ごとのストレージ料金がかかり、作成時の入力も通常単価で課金されるので、1時間だけ置くキャッシュなら、3.8 Flashと3.6 Flashは1時間に2回以上、3.1 Pro Previewは4回以上、3.5 Flash-Liteは5回以上質問して、ようやくキャッシュなしより安くなります。
暗黙的キャッシュと明示的キャッシュ:モデル別・API別の対応表
自分のモデルで使えるキャッシュは、モデルの世代と、呼び出しに使うAPIの2つで決まります。2026年10月30日時点のGoogleのドキュメントでは、暗黙的キャッシュはGemini 2.5以降の全モデルで既定で有効、明示的キャッシュはGemini 3系と2.5系だけが対象で、Gemini 4 Argon以降は対象外です。Googleの日本語ドキュメントでは、この機能を「コンテキストのキャッシュ保存」と呼んでいます。
| モデル | 暗黙的キャッシュ | 明示的キャッシュ | 暗黙的の最小トークン数(ai.google.dev) | キャッシュ読み取りの単価 |
|---|---|---|---|---|
| Gemini 4 Argon | あり(既定で有効) | なし(呼ぶとエラー) | 4,096 | 入力の5%(95%引き) |
| Gemini 3.8 Flash | あり | あり | 4,096 | 入力の10%(90%引き) |
| Gemini 3.6 Flash | あり | あり | 4,096 | 入力の10% |
| Gemini 3.1 Pro Preview | あり | あり | 4,096 | 入力の10% |
| Gemini 3.5 Flash-Lite / 3.1 Flash-Lite | あり | あり | 表に記載なし | 入力の10% |
| Gemini 2.5 Flash / 2.5 Pro | あり | あり | 2,048 | 入力の10% |
API側の条件も見落とせません。Gemini APIのコンテキストキャッシュ(generateContent版)が明示的キャッシュの作成・管理を説明している一方、Interactions API版のキャッシュのページは暗黙的キャッシュだけに対応すると書いています。Interactions APIでも、previous_interaction_idで会話をつなぐ方式とつながない方式のどちらでも暗黙的キャッシュは働きますが、対応モデルで明示的キャッシュを使いたいならgenerateContentに切り替える必要があります。明示的キャッシュはまだベータで、エンドポイントとSDKのメソッドはv1betaにあります。
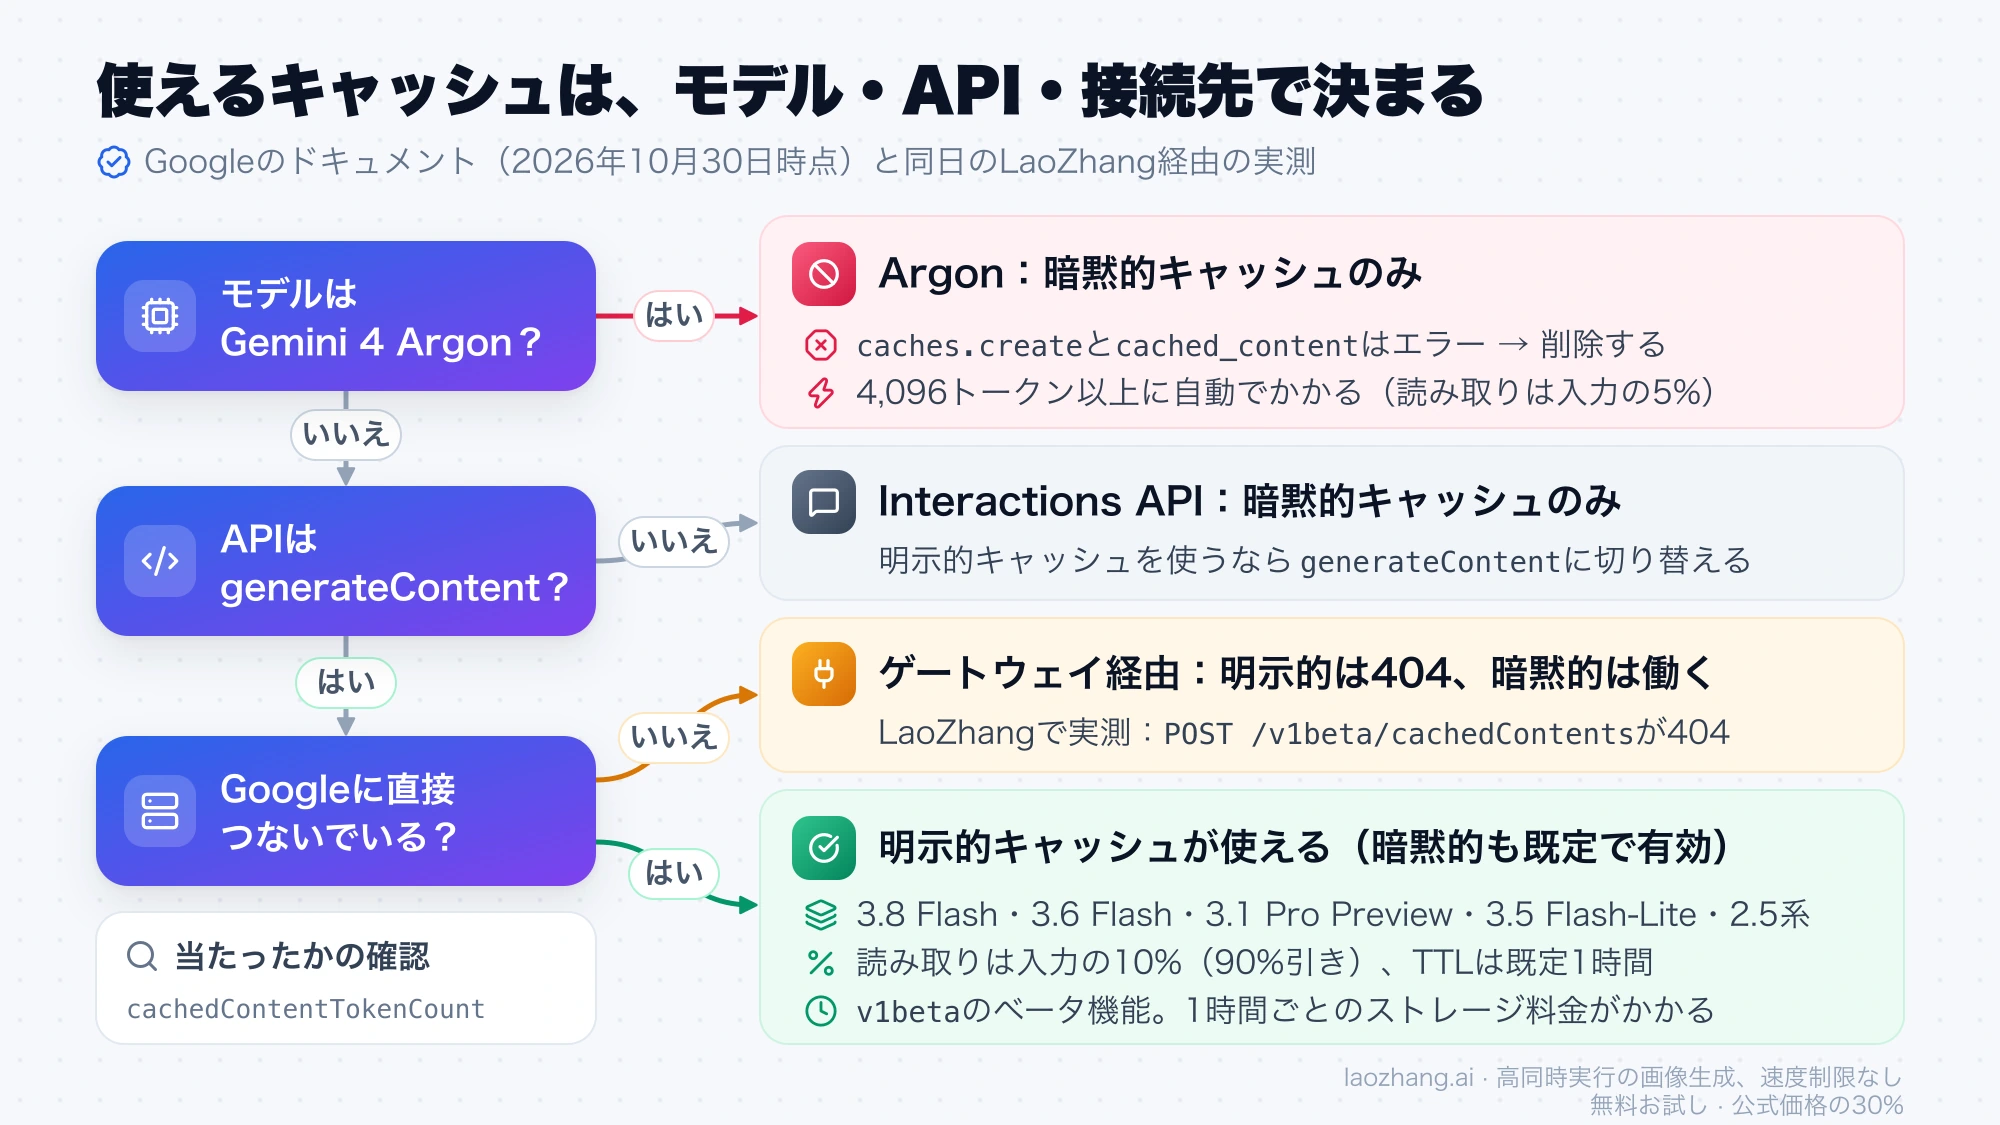
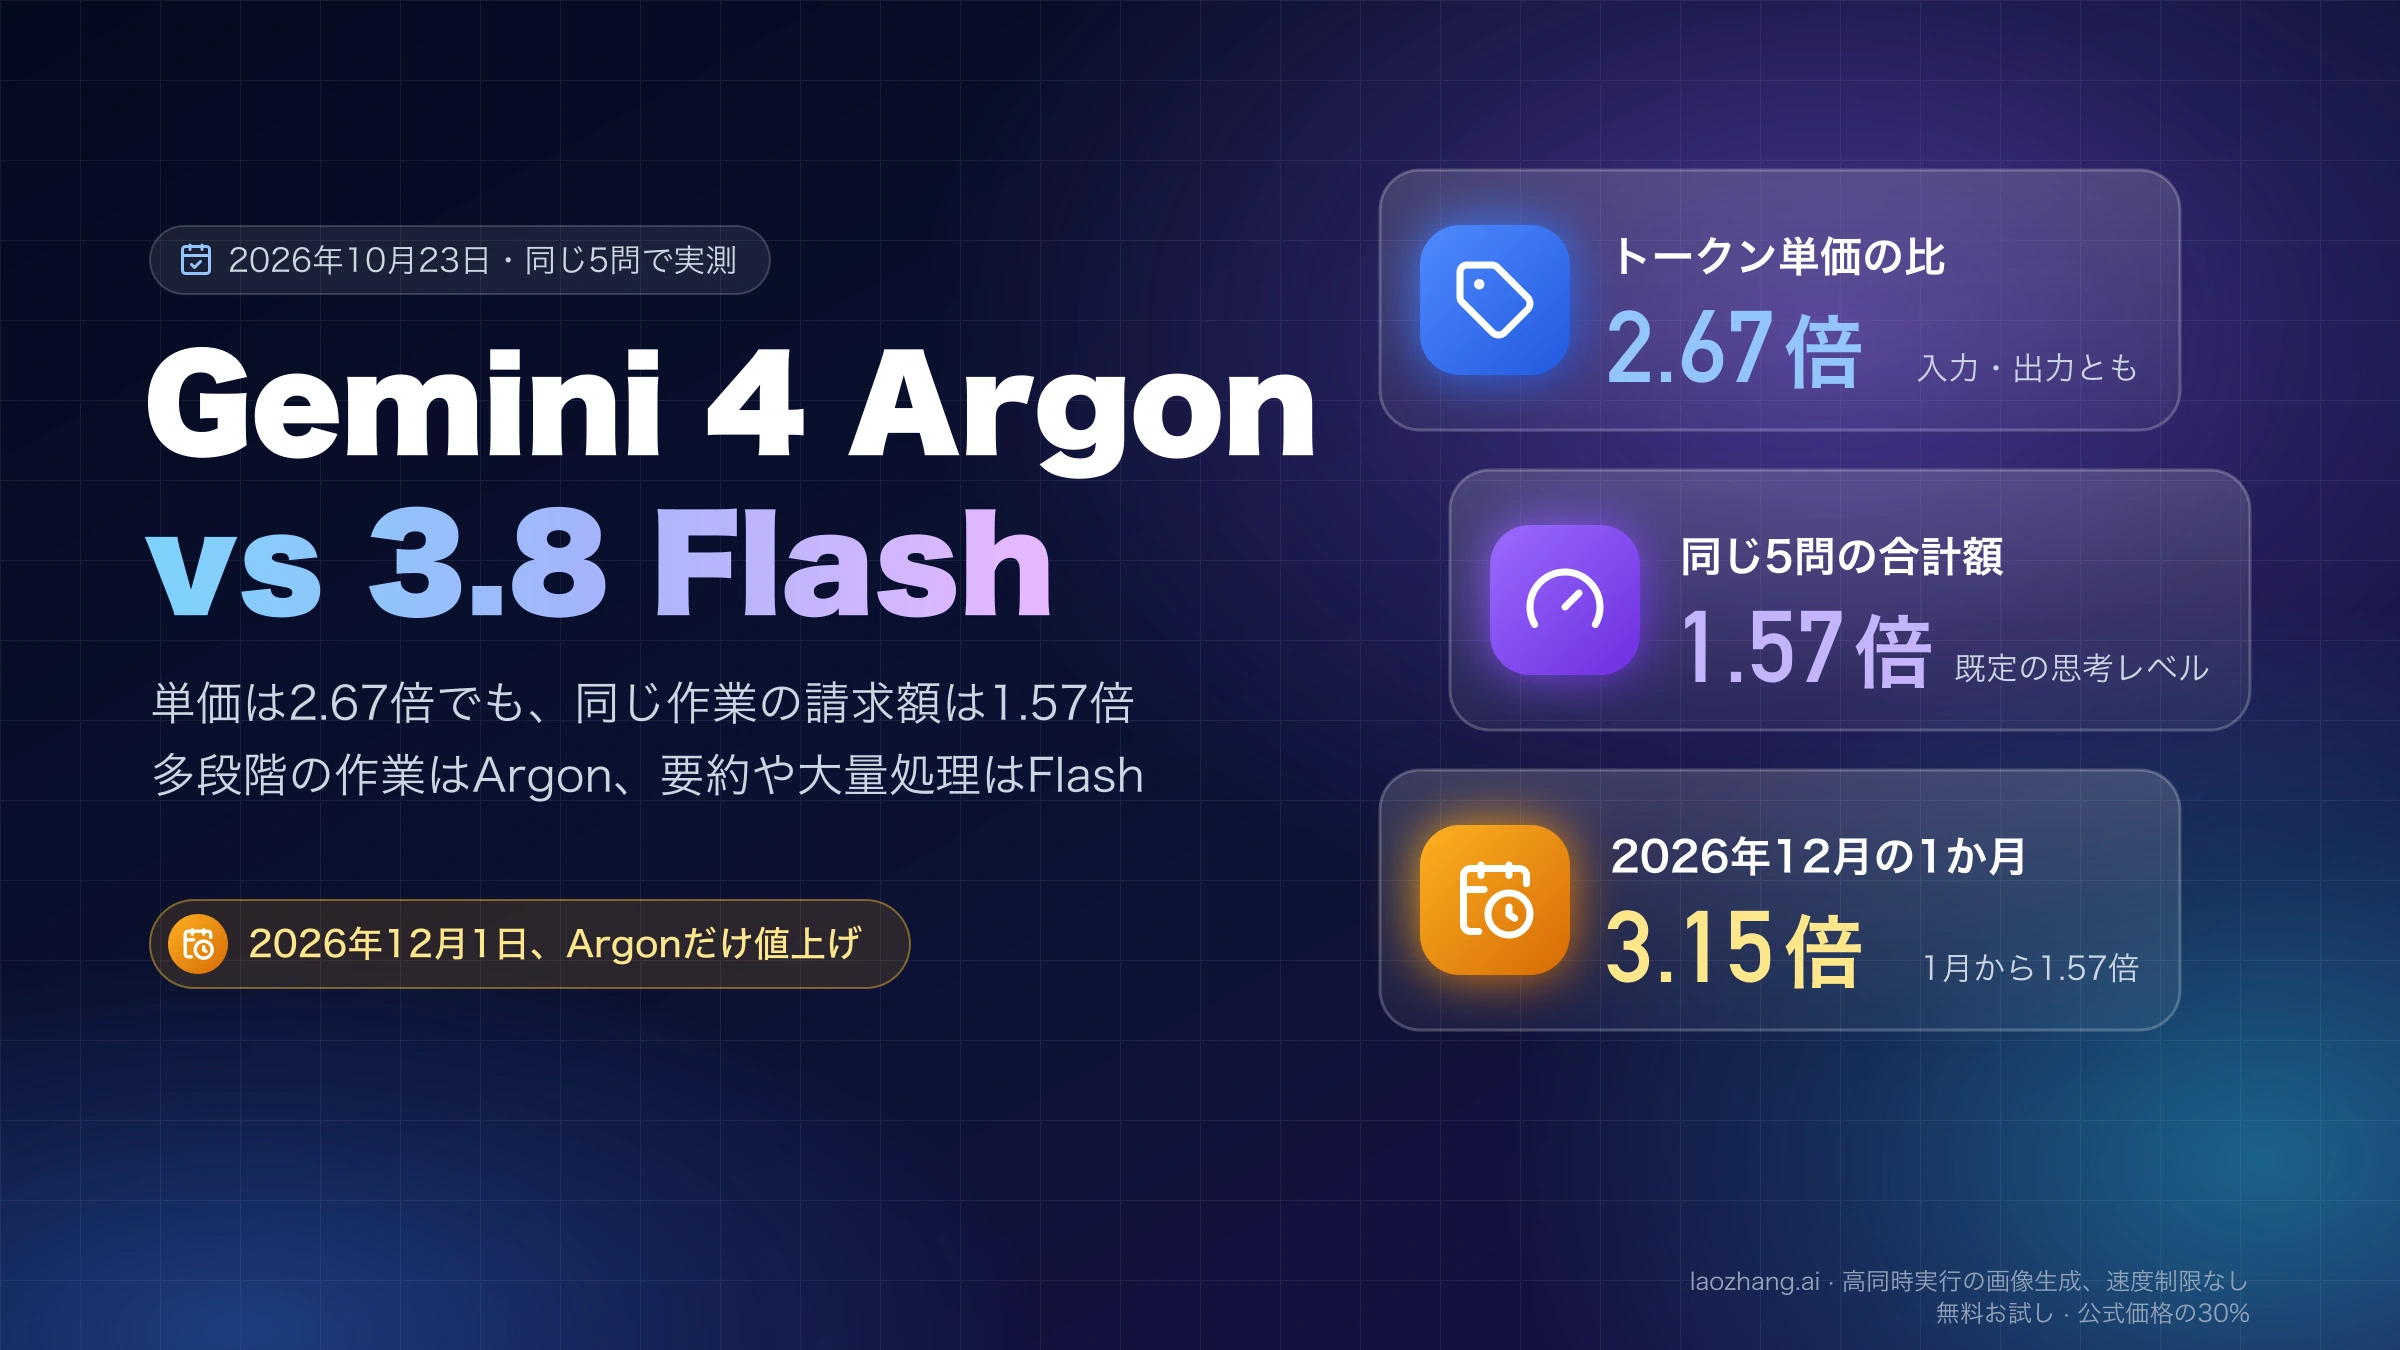
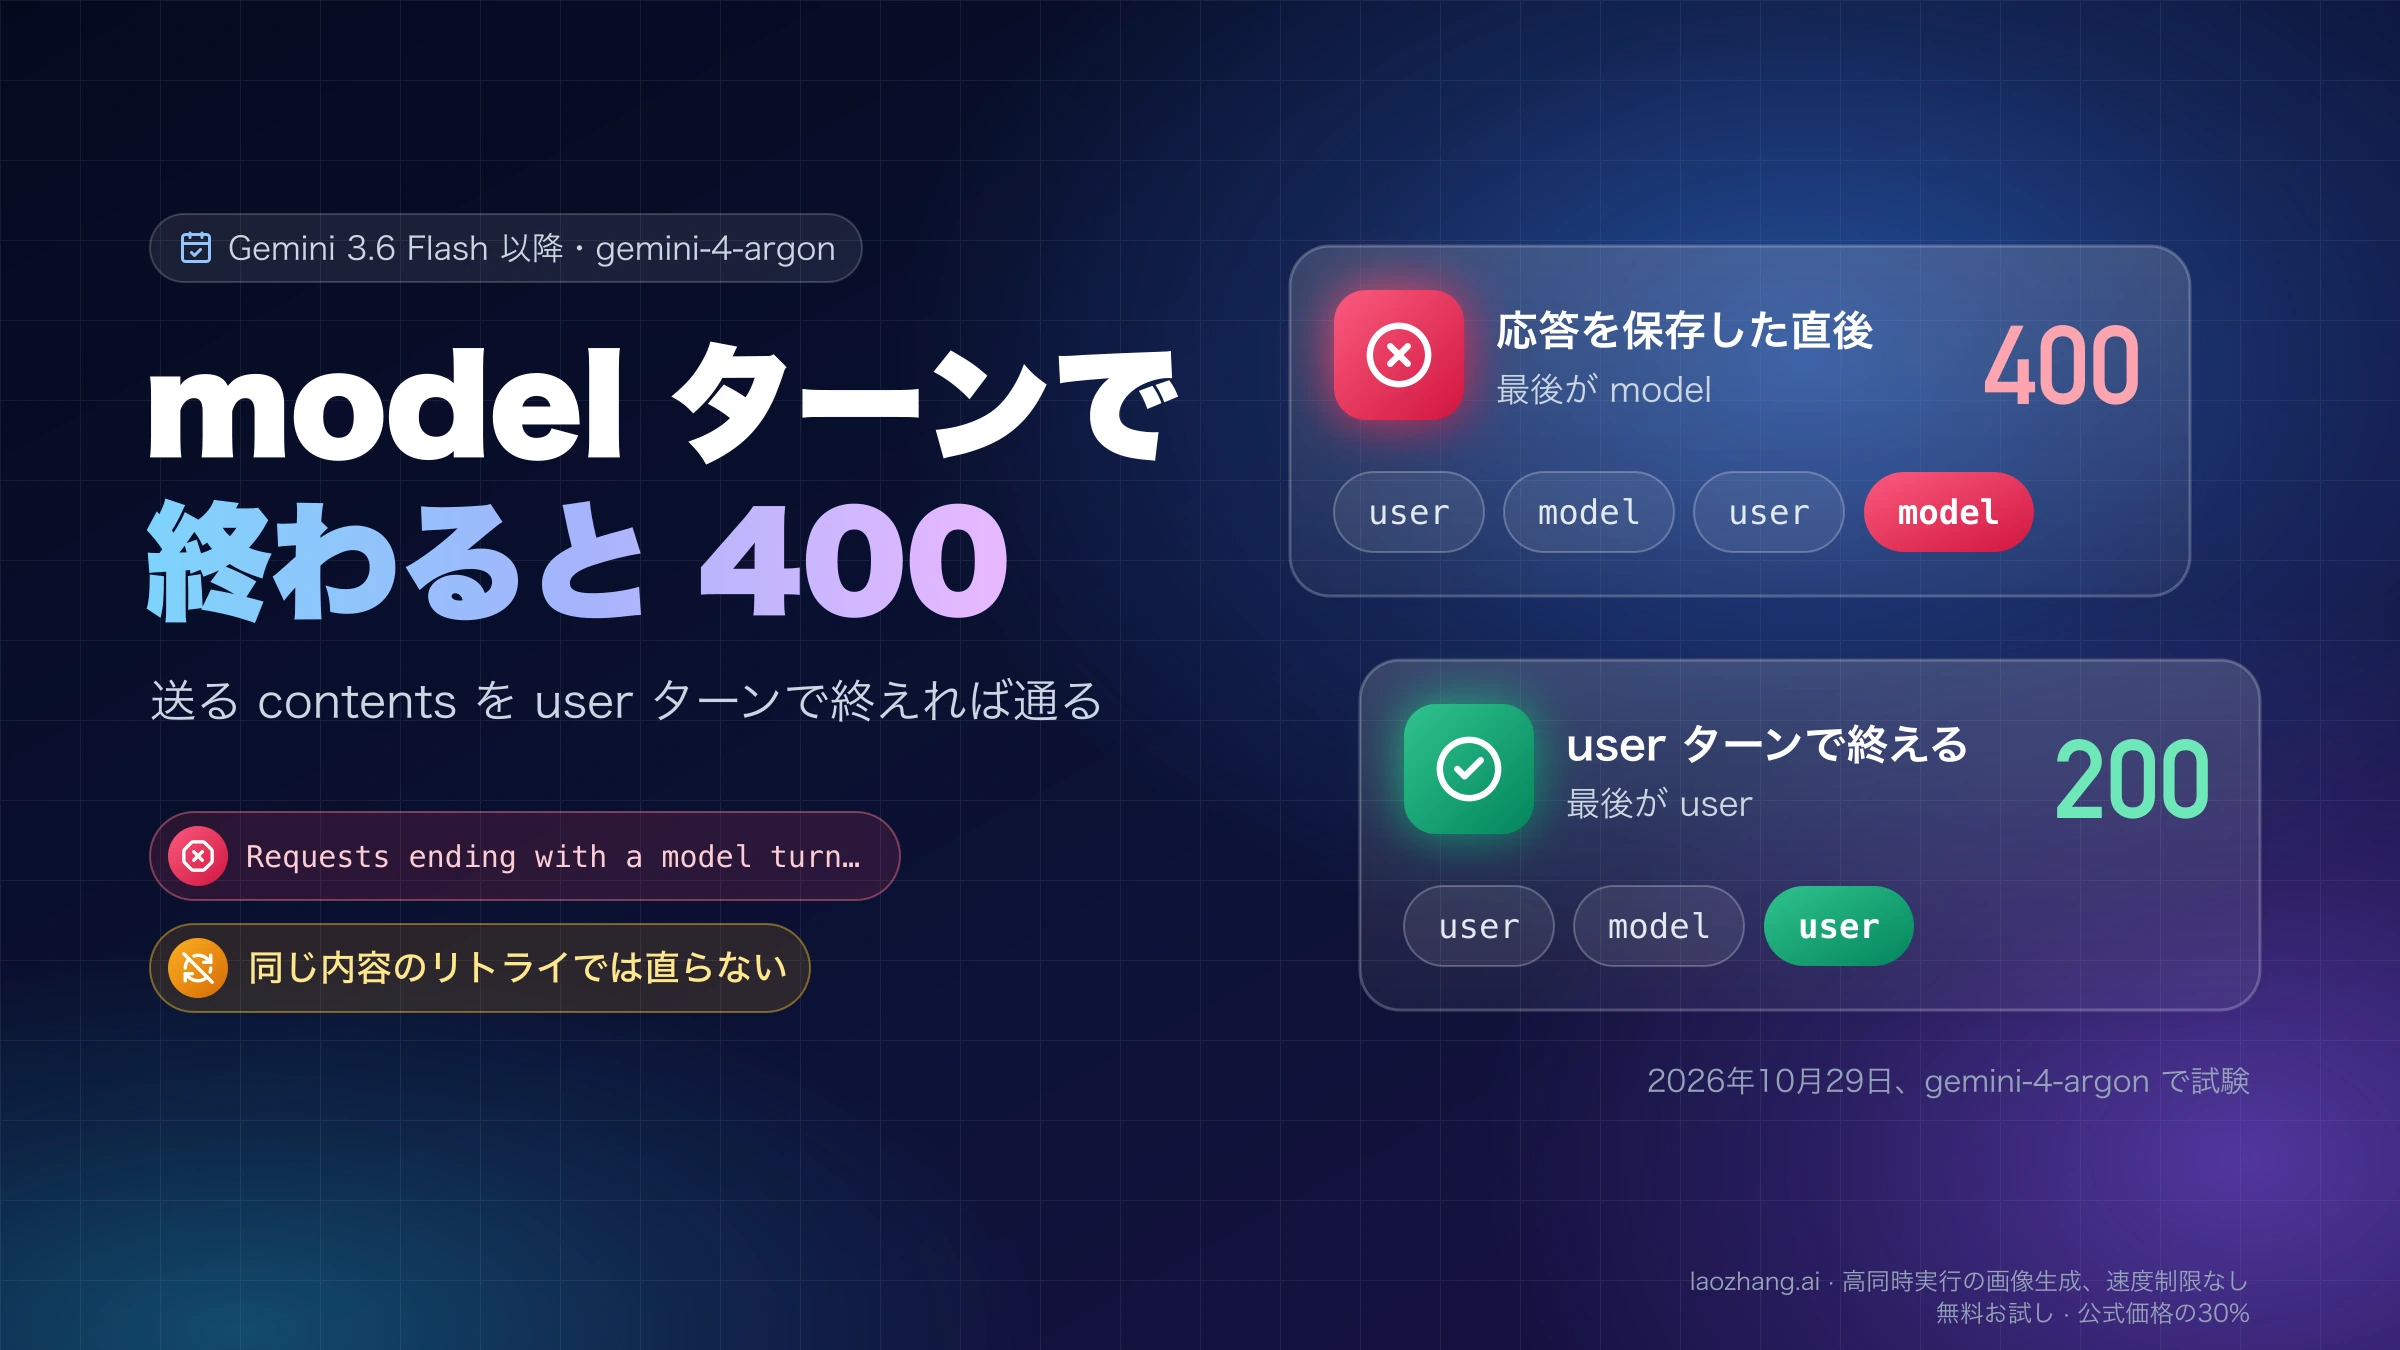
Argonへの移行では、Googleの移行ガイド「What's new in Gemini 4 Argon」が、cachedContentsやcaches.createの呼び出しはエラーを返すので、キャッシュを作る処理とcached_contentを渡す処理を削除するよう案内しています。同じガイドによると、Argonでは4,096トークン以上のプロンプトに暗黙的キャッシュが自動でかかるので、代わりに書き足すコードはありません。Argonへの移行ではもう一つ、会話の末尾がモデルのターンで終わるリクエストが400になる点にも注意が必要です。詳しくは「Gemini 400「Requests ending with a model turn」の原因と直し方」で扱っています。そもそもArgonと3.8 Flashのどちらを使うか迷っている場合は、「Gemini 4 Argonと3.8 Flashの違い:実測コストと使い分け」を参考にしてください。
Argonのマルチターンとエージェントループには、もう一つ規則があります。ドキュメントによると、新しいリクエストが前回より2,050トークン以上増えたときに限って前回のリクエスト全体がキャッシュされ、増分がそれより小さいと、前回の最後の2,050トークンは通常の入力単価で処理し直されます。モデルの出力、思考、関数の結果も増分に数えられ、ほとんどのエージェントのターンはこの基準を超えるとされています。この規則は単発のリクエストしか試していないため確かめられておらず、ドキュメントの記載によるものです。
料金は安くなる?キャッシュ単価と明示的キャッシュの損益分岐
キャッシュから読んだ入力トークンの単価は、Gemini 4 Argonで通常入力の5%(95%引き)、それ以外のモデルで10%(90%引き)です。ただし明示的キャッシュには1時間ごとのストレージ料金がかかるため、安くなるかどうかは同じキャッシュを1時間に何回読むかで決まります。次の表は、Gemini APIの料金ページにある有料ティアの標準単価(2026年10月30日時点、100万トークンあたり)です。
| モデル | 入力 | キャッシュ読み取り | ストレージ(1時間) | ストレージ代の損益分岐 |
|---|---|---|---|---|
| Gemini 4 Argon(2026年11月30日まで) | $2.00 | $0.10 | 明示的キャッシュなし | — |
| Gemini 4 Argon(2026年12月1日から) | $4.00 | $0.20 | 明示的キャッシュなし | — |
| Gemini 3.8 Flash / 3.6 Flash(2026年12月31日まで) | $0.75 | $0.075 | $0.50 | 1時間に0.74回 |
| Gemini 3.8 Flash / 3.6 Flash(2027年1月1日から) | $1.50 | $0.15 | $1.00 | 1時間に0.74回 |
| Gemini 3.1 Pro Preview(20万トークン以下) | $2.00 | $0.20 | $4.50 | 1時間に2.50回 |
| Gemini 3.5 Flash-Lite | $0.30 | $0.03 | $1.00 | 1時間に3.70回 |
| Gemini 3.1 Flash-Lite(テキスト) | $0.25 | $0.025 | $1.00 | 1時間に4.44回 |
表の右端は「1時間のストレージ料金 ÷(入力単価 − キャッシュ読み取り単価)」で、キャッシュを何時間も置き続けるときに、ストレージ代を取り戻すのに必要な1時間あたりの読み取り回数です。3.8 Flashなら$0.50 ÷($0.75 − $0.075)= 0.74で、3つの単価がそろって2倍になる2027年1月1日以降も比率は変わりません。ただし、Google Cloudのドキュメントによるとキャッシュを作るときに送る入力トークンは通常の入力単価で課金されるため、1時間だけ置くキャッシュでは作成費も回収しなければなりません。その場合に必要な質問回数は「(ストレージ料金 + 入力単価)÷(入力単価 − キャッシュ読み取り単価)」で、3.8 Flashと3.6 Flashは1.85回、3.1 Pro Previewは3.61回、3.5 Flash-Liteは4.81回です。1時間に2回以上、4回以上、5回以上という目安は、この数字を切り上げたものです。
100,000トークンの資料を3.8 Flashで1時間使う場合を、2026年の単価で入力側だけ計算すると差がはっきりします。1時間に1回しか質問しないなら、キャッシュなしは$0.075ですが、明示的キャッシュは作成$0.075、読み取り$0.0075、ストレージ$0.05の合計$0.1325で、かえって高くつきます。10回質問すると、キャッシュなしの$0.75に対し、明示的キャッシュは$0.075 + 10 × $0.0075 + $0.05 = $0.20です。暗黙的キャッシュは、2回目以降がすべて当たれば$0.075 + 9 × $0.0075 = $0.1425ですが、10回中2回しか当たらなければ$0.615で、ほとんど安くなりません。実測に近い3回に1回のヒット率で期待値を出すと、1時間に2回の質問では暗黙的キャッシュが約$0.1275、明示的キャッシュが$0.14ですが、3回になると約$0.18と$0.1475で逆転し、明示的キャッシュのほうが安くなります。どの計算も資料全体がキャッシュに入る前提で、実際には後述の実測のように一部しかキャッシュされないことがあります。
Argonには明示的キャッシュがないので、ヒットのたびに表の入力単価とキャッシュ読み取り単価の差額が浮くだけで、損益分岐を考える必要はありません。Batchモードのキャッシュ読み取りは、Argonで$0.05(12月1日から$0.10)です。無料枠では、3.8 Flashのコンテキストキャッシュは無料で、3.5 Flash-Liteは利用できず、Argonにはそもそも無料枠がありません。無料枠のモデルと上限は「Gemini API無料枠の利用上限 2026:無料モデルと超えたらどうなるか」に、Flash系の単価と2027年の値上げは「Gemini API料金確認:3.8 Flashは2027年に2倍、無料枠超過は前払い」にまとめています。
明示的キャッシュの作り方:作成・利用・TTL変更・削除
明示的キャッシュは、generateContent APIでcaches.createを呼んでキャッシュを作り、その名前をcached_contentに渡して使います。対象はGemini 3.8 Flashなど明示的キャッシュに対応したモデルだけで、Gemini 4 Argonで同じコードを実行するとエラーになります。キャッシュする内容は、そのモデルの最小トークン数(3.8 Flashなら4,096)以上にしてください。
次の例は、Python SDK(google-genai)で社内マニュアルをキャッシュし、質問し、期限を延ばし、最後に削除する流れです。APIキーは環境変数GEMINI_API_KEYから読みます。
import os
from google import genai
from google.genai import types

client = genai.Client(api_key=os.environ["GEMINI_API_KEY"])
MODEL = "gemini-3.8-flash"  # gemini-4-argon では使えない

with open("manual.md", encoding="utf-8") as f:
    manual = f.read()  # 4,096トークン以上の資料

# 1. キャッシュを作る(ttl を省略すると1時間)
cache = client.caches.create(
    model=MODEL,
    config=types.CreateCachedContentConfig(
        display_name="support-manual",
        system_instruction="あなたは社内マニュアルに基づいて回答するサポート担当です。",
        contents=[manual],
        ttl="3600s",
    ),
)
print(cache.name, cache.usage_metadata)

# 2. キャッシュを指定して質問する
response = client.models.generate_content(
    model=MODEL,
    contents="返品の受付期限は何日ですか?",
    config=types.GenerateContentConfig(cached_content=cache.name),
)
print(response.usage_metadata.cached_content_token_count)
print(response.text)

# 3. 期限を延ばす(変更できるのは ttl か expire_time だけ)
client.caches.update(
    name=cache.name,
    config=types.UpdateCachedContentConfig(ttl="7200s"),
)

# 4. 一覧を見る(中身は取り出せず、メタデータのみ)
for c in client.caches.list():
    print(c.name, c.display_name, c.expire_time)

# 5. 使い終わったら削除してストレージ料金を止める
client.caches.delete(name=cache.name)TTLを秒数ではなく時刻で指定するときは、expire_timeにタイムゾーン付きの日時を渡します。datetime.datetime.now(datetime.timezone.utc) + datetime.timedelta(minutes=10)は使えますが、タイムゾーンの付かないdatetime.utcnow()は使えません。キャッシュの一覧や個別取得で返るのは名前、モデル、表示名、使用量、作成・更新・失効の時刻だけで、キャッシュした本文は読み出せません。OpenAIのライブラリからGeminiを呼んでいる場合は、extra_bodyのcached_contentにキャッシュ名を渡します。
キャッシュしたトークンは、モデルから見るとプロンプトの先頭部分と同じ扱いです。キャッシュ専用のレート制限はなく、generateContentの通常の制限がそのまま適用され、トークン数の上限にはキャッシュ分も含まれます。上限の確認場所と引き上げ方は「Gemini APIのレート制限:確認場所、Tier別の支出上限、上げ方」を見てください。
ヒットしたかの確認:cachedContentTokenCountとcached_tokens
キャッシュに当たったかどうかは、レスポンスの使用量フィールドで確認します。generateContentではusageMetadata.cachedContentTokenCount(Python SDKではusage_metadata.cached_content_token_count)にキャッシュから読んだトークン数が入り、外れたときはこのキー自体がありません。値が0で返るわけではないので、キーがあるかどうかで判定します。
2026年10月30日にLaoZhang経由で3.8 Flashを呼んだとき、ヒットした回のusageMetadataは次のとおりでした(抜粋)。
{
  "promptTokenCount": 11645,
  "cachedContentTokenCount": 8165,
  "candidatesTokenCount": 56,
  "totalTokenCount": 11701,
  "cacheTokensDetails": [{ "modality": "TEXT", "tokenCount": 8165 }]
}promptTokenCountはキャッシュ分を含むプロンプト全体の数なので、通常単価で課金されるのは11,645 − 8,165 = 3,480トークンです。同じ本文で外れた回はcachedContentTokenCountとcacheTokensDetailsがなく、promptTokenCountだけが返りました。OpenAI互換の/v1/chat/completionsでは、ヒット時に"prompt_tokens_details": {"cached_tokens": 8161}、ミス時に"prompt_tokens_details": {}が返り、prompt_tokensはキャッシュ分を含む合計でした。Interactions APIでは、ヒットしたトークン数がusage.total_cached_tokensに入ります。
ログに残すなら、ヒットの有無と、その回の入力費をまとめて記録しておくと後で判断しやすくなります。
usage = response.usage_metadata
cached = usage.cached_content_token_count or 0  # ミス時は None
uncached = usage.prompt_token_count - cached
# 3.8 Flash の2026年単価(100万トークンあたり 入力 $0.75、キャッシュ読み取り $0.075)
input_cost = (uncached * 0.75 + cached * 0.075) / 1_000_000
print(f"hit={cached > 0} cached={cached} uncached={uncached} input=${input_cost:.6f}")
最小トークン数は4,096か6,144か:Googleのページの食い違いと実測の境目
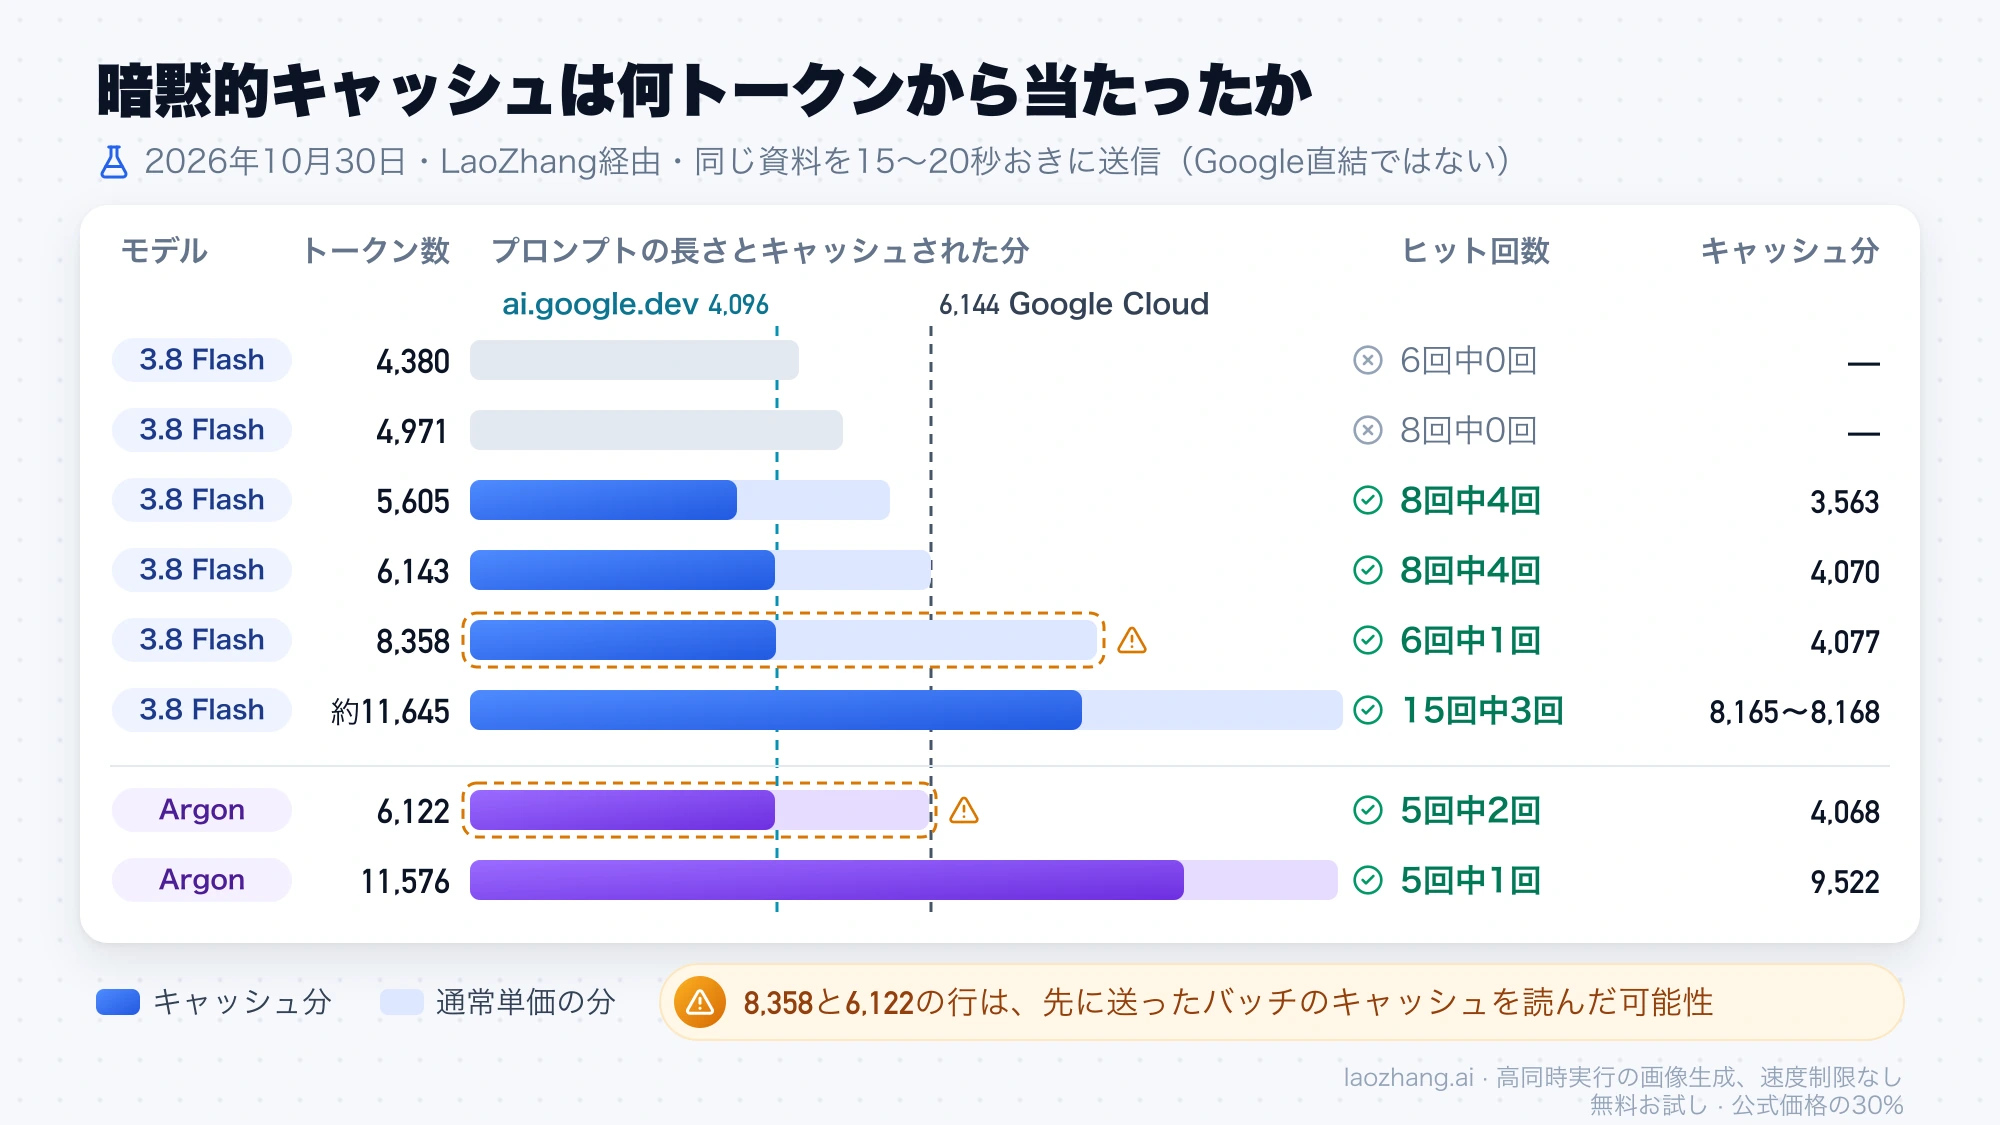
暗黙的キャッシュが働く最小トークン数は、2026年10月30日時点でGoogleのページによって4,096と6,144に分かれています。同じ日にLaoZhang経由で長さを変えて試したところ、3.8 Flashは約5,000トークン以下では一度も当たらず、5,605トークンから当たりました。
食い違いは4か所あります。ai.google.devのキャッシュのページは、Argon、3.8 Flash、3.6 Flash、3.1 Pro Previewをすべて4,096トークン、2.5 Flashと2.5 Proを2,048トークンとしています。一方、Google Cloudのコンテキストキャッシュ保存の概要は、3.8 Flash、3.7 Flash、3.1 Pro Preview、3.0 Flash Previewの暗黙的キャッシュを6,144トークンとし、それ以外のGemini 3系と4系を4,096トークンとしています。さらにGoogle CloudのArgonの開発者ガイドは6,144トークンと書き、同じGoogle CloudのArgonのモデルページは4,096トークンと書いています。どのページを正しいと見るかで、3.8 Flashの境目は2,000トークン以上ずれます。
実測の条件は次のとおりです。2026年10月30日の15時15分から15時51分(UTC)に、LaoZhangのGeminiネイティブのgenerateContentエンドポイントへ、1つのアカウントから、英語の同じ資料をシステム指示に入れたリクエストを、本文を変えずに15〜20秒おきに送りました。約11,645トークンの回だけは、資料を最初のユーザーターンに置いたものと、最後の質問だけを変えたものも含みます。資料の前に付けた識別子はスクリプトを1回実行するごとに変わる仕組みだったため、同じ実行の中のバッチどうしは先頭の文章が共通していました。Googleに直接つないだ測定ではなく、資料は1種類だけです。すべての応答でmodelVersionは指定したモデル名と一致していました。
| モデル | プロンプトのトークン数 | ヒット回数 | ヒット時のキャッシュ分 |
|---|---|---|---|
| Gemini 3.8 Flash | 4,380 | 6回中0回 | — |
| Gemini 3.8 Flash | 4,971 | 8回中0回 | — |
| Gemini 3.8 Flash | 5,605 | 8回中4回 | 3,563 |
| Gemini 3.8 Flash | 6,143 | 8回中4回 | 4,070 |
| Gemini 3.8 Flash | 8,358 | 6回中1回 | 4,077 |
| Gemini 3.8 Flash | 約11,645 | 15回中3回 | 8,165〜8,168 |
| Gemini 4 Argon | 6,122 | 5回中2回 | 4,068 |
| Gemini 4 Argon | 11,576 | 5回中1回 | 9,522 |
3.8 Flashは、ai.google.devの4,096を超える4,380と4,971トークンでも14回すべて外れ、Google Cloudの6,144に届かない5,605トークンで当たりました。この境目は、先に送ったバッチのキャッシュが混ざりようのない条件で得た結果です。一方、3.8 Flashの8,358トークンとArgonの6,122トークンの行は、同じ実行の中で先に送ったリクエストと先頭が共通していたため、そちらが作ったキャッシュを読んだ可能性があります。特にArgonの6,122トークンのヒットは、直前の11,576トークンのリクエストが書いたキャッシュかもしれず、6,122トークンのプロンプトだけでキャッシュが作られる証拠にはなりません。また、長くすれば当たるわけでもなく、6,144トークンを超えるリクエストでも大半は外れました。暗黙的キャッシュのヒットは、どの長さでも保証されません。約11,645トークンの回では、長い資料をシステム指示に入れた場合は6回中2回、最初のユーザーターンに入れた場合は6回中1回のヒットで、置き場所による差ははっきりしませんでした。
暗黙的キャッシュが当たらないときのチェックリスト
暗黙的キャッシュが当たらない、または当たっても思ったほど安くならない原因は、ひとつではありません。下の項目を上から確かめ、当てはまるものを直してください。
- 毎回同じになる部分が約5,000トークン以下なら、3.8 Flashではヒットをほぼ期待できません。プロンプト全体が4,096トークンを超えていても、4,380と4,971トークンでは14回すべて外れ、5,605トークンから当たり始めました。複数のリクエストで共有できる指示や資料があるなら、先頭にまとめて共通部分を長くします。ただし、それより長くしても当たったり外れたりは続きます。
- システム指示の冒頭に現在時刻、リクエストID、ユーザー名、検索結果のような毎回変わる内容があるなら、それを末尾へ移します。キャッシュは先頭から一致する部分(プレフィックス)にしか効かないので、冒頭が変わるとその後ろは毎回別物になります。Redditのn8nのスレッドでも、AIエージェントのノードがプロンプトの先頭に動的な指示を差し込んでいるためにヒットしないのではないか、という報告がありました。
- 同じプレフィックスのリクエストが何十分も空いて届いているなら、まとめて送るようにします。Googleは似たプレフィックスのリクエストを短時間に送るよう勧めていて、暗黙的キャッシュがどのくらい残るかは後の「キャッシュの保持時間」の節にまとめました。
- 1〜2回のリクエストで「効いていない」と判断しているなら、数十回分のヒット率で見直します。暗黙的キャッシュにはヒットの保証がなく、実測では6,143トークンのリクエストが外れ、外れ、当たり、外れ、外れ、当たり、当たり、当たりと交互になり、1回目だけ外れてあとはずっと当たる、とはなりませんでした。割引を確実にしたいなら、Argon以外のモデルで明示的キャッシュに切り替えます。
- 料金表どおり90〜95%の削減で見積もっているなら、44〜78%で見積もり直します。実測のヒットでキャッシュされたのはプロンプトの49〜82%で、残りの2,042〜4,281トークンは毎回通常料金でした。末尾の短い質問だけでなく、その手前の約2,000トークン以上もキャッシュの外です。
- ゲートウェイや複数のプロジェクトを経由しているなら、ヒット率が低いのはその影響かもしれません。Google Cloudのドキュメントでは暗黙的キャッシュのデータはプロジェクト単位で管理されるので、ゲートウェイが上流で複数のプロジェクトやキーにリクエストを振り分けていると、同じプレフィックスでも別のキャッシュに当たる可能性があります。今回の測定でも、この影響とGoogle側の「保証なし」の挙動は切り分けられていません。
実測のヒットを料金表の単価で計算し直すと、削減幅は次のようになりました。3.8 Flashで11,645トークン中8,165がキャッシュされた回は、入力費が$0.008734から$0.003222へ63%減り、6,143トークンの回は60%、5,605トークンの回は57%、8,358トークン中4,077がキャッシュされた回は$0.006269から$0.003517へ44%減でした。Argonは11,576トークン中9,522がキャッシュされた回が$0.023152から$0.005060へ78%減、6,122トークンの回が63%減です。約60回のテスト全体の費用は、Googleの定価で計算して約$0.44でした。なお、今回の規模(5,000〜12,000トークン)ではヒットとミスで応答時間に一貫した差は見えなかったため、応答速度については結論を出していません。
キャッシュの保持時間:明示的は既定1時間、暗黙的は最長24時間
明示的キャッシュのTTLは、指定しなければ1時間です。暗黙的キャッシュは期限を指定できず、Google Cloudのドキュメントでは作成から最長24時間で、多くはそれより早く消えるとされています。
明示的キャッシュのTTLについて、ai.google.devは上限も下限もないと書き、Google Cloudは最短1分で上限なしとしています。長く置くほどストレージ料金が積み上がるので、使う時間帯だけ置いてcaches.deleteで消すのが基本です。暗黙的キャッシュについては、Google CloudのArgonの開発者ガイドが、連続するリクエストが15〜20分のキャッシュTTL内に収まれば95%の割引を受けられると書いています。24時間はあくまで上限なので、夜に作ったプレフィックスが翌朝まで残っている前提で設計すると外れます。
durable caching(永続キャッシュ):Google Cloudだけの仕組み
durable cachingは、Google Cloud側の暗黙的キャッシュにある2段目の保存層です。メモリから追い出されたプレフィックスを捨てずに永続ストレージへ移し、間隔が空いた再利用でもヒットしやすくします。
Vertex AI(現在のGoogle Cloudのドキュメントでの名称はGemini Enterprise Agent Platform)のドキュメントによると、暗黙的キャッシュはメモリ上の層とdurableな層の2段構成で、どちらも既定で有効です。2026年10月30日時点で、durable cachingの対象はGemini 4 Argon、4 Argon Cyber Permissive、3.8 Flash、3.8 Flash Cyberです。明示的キャッシュと違ってストレージ料金はかかりません。この仕組みはGoogle CloudのAgent Platformのドキュメントにだけ書かれていて、ai.google.devのGemini APIには記載がありません。AI StudioのAPIキーで呼んでいる場合に同じ層があるとは考えないでください。
データの扱いも決まっています。Google Cloudのゼロデータ保持のページによると、durable cachingが保存するのはプロンプトから計算したキャッシュデータ(キーと値の表現)で、Googleの既定の暗号化がかかり、プロジェクト単位で管理され、学習には使われません。リージョンやマルチリージョンのエンドポイントでは選んだロケーションにとどまり、グローバルエンドポイントではどのリージョンにも置かれます。CMEK(顧客管理の暗号鍵)には対応していないので、要件がある場合はプロジェクト単位でdurable cachingだけを切るか、暗黙的キャッシュ全体を切ります。プロジェクトのキャッシュ設定をAPIで確認すると、有効なときは"retentionType": "DURABLE"が返ります。組織全体で止めたい場合は、Google Cloudのアカウントチームへの依頼が必要です。明示的キャッシュを作ると、指定した範囲を超えて暗黙的キャッシュも働くことがあるため、データを残したくない場合は暗黙的キャッシュを無効にし、明示的キャッシュも使わないようにします。AI StudioのAPIとVertex AIのどちらで運用するかは「Gemini API と Vertex AI API の選び方:速く始めるか、クラウド運用で固めるか」で比べています。
ゲートウェイやOpenAI互換APIで使えるか:暗黙的は可、明示的は404
2026年10月30日にLaoZhang経由で試した範囲では、暗黙的キャッシュはGeminiネイティブとOpenAI互換の両方で働き、明示的キャッシュは使えませんでした。
OpenAI互換の/v1/chat/completionsで3.8 Flashを呼んだ3回のうち1回が当たり、prompt_tokens_details.cached_tokensに8,161が入りました。このヒットは、同じ実行の中で先に送った6,143トークンのリクエストと先頭が共通していたため、そちらのキャッシュを読んだ可能性があります。明示的キャッシュは、POST /v1beta/cachedContents(3.8 FlashとArgon)もGET /v1beta/cachedContentsもHTTP 404で、{"error":{"message":"Invalid URL (POST /v1beta/cachedContents)","type":"invalid_request_error"}}が返りました。これはゲートウェイ自身のエラー形式で、リクエストはGoogleまで届いていません。明示的キャッシュを使うなら、GoogleのAPIキーかGoogle Cloudのプロジェクトから直接呼ぶ必要があります。
料金の面では、LaoZhangのモデル一覧が2026年10月30日時点でgemini-3.8-flashにキャッシュ読み取り単価(100万トークンあたり$0.075)を載せている一方、gemini-4-argonにはキャッシュ読み取りの単価を載せていません。Argonのヒットがゲートウェイの請求で割り引かれるかどうかは、今回のデータからは判断できませんでした。Google側のArgonの12月1日の値上げについても、LaoZhangはまだ告知していません。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
Geminiコンテキストキャッシュのよくある質問
Claudeのプロンプトキャッシュとは何が違いますか?
Claudeのプロンプトキャッシュは、書き込みに割増、読み取りに割引がかかる料金体系で、ストレージを時間で課金するGeminiの明示的キャッシュとも、指定なしで働く暗黙的キャッシュとも計算の仕方が違います。Claude側の倍率と損益分岐は「Claudeプロンプトキャッシュの使い方:5分/1時間の損益分岐と実測値」にまとめています。
動画やPDFもキャッシュできますか?
明示的キャッシュでは、動画やPDFをcontentsに入れてキャッシュできます。Gemini APIのgenerateContent版のドキュメントには、Files APIでアップロードした動画とシステム指示をまとめてキャッシュする例と、PDFの例が載っています。Google Cloudのドキュメントでは、キャッシュできるテキストやファイルの大きさの上限は10MBです。
参考資料5
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月30日。
参考資料5
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月30日。
- 1.Gemini APIのコンテキストキャッシュ(generateContent版)ai.google.dev/gemini-api/docs/generate-content/caching
- 2.Interactions API版のキャッシュのページai.google.dev/gemini-api/docs/caching
- 3.Gemini APIの料金ページai.google.dev/gemini-api/docs/pricing
- 4.Google Cloudのコンテキストキャッシュ保存の概要docs.cloud.google.com/gemini-enterprise-agent-platform/models/context-cache/context-cache-overview
- 5.Google Cloudのゼロデータ保持のページdocs.cloud.google.com/gemini-enterprise-agent-platform/resources/zero-data-retention