Sonnet 5.5とGPT-6 Astra比較:費用と使い分け
AAの指数v5.0ではどの推論の強さでもGPT-6 AstraがSonnet 5.5より上です。Sonnetが1課題あたり安いのはhigh以下で、それ以上はAstraが安価です。
目次
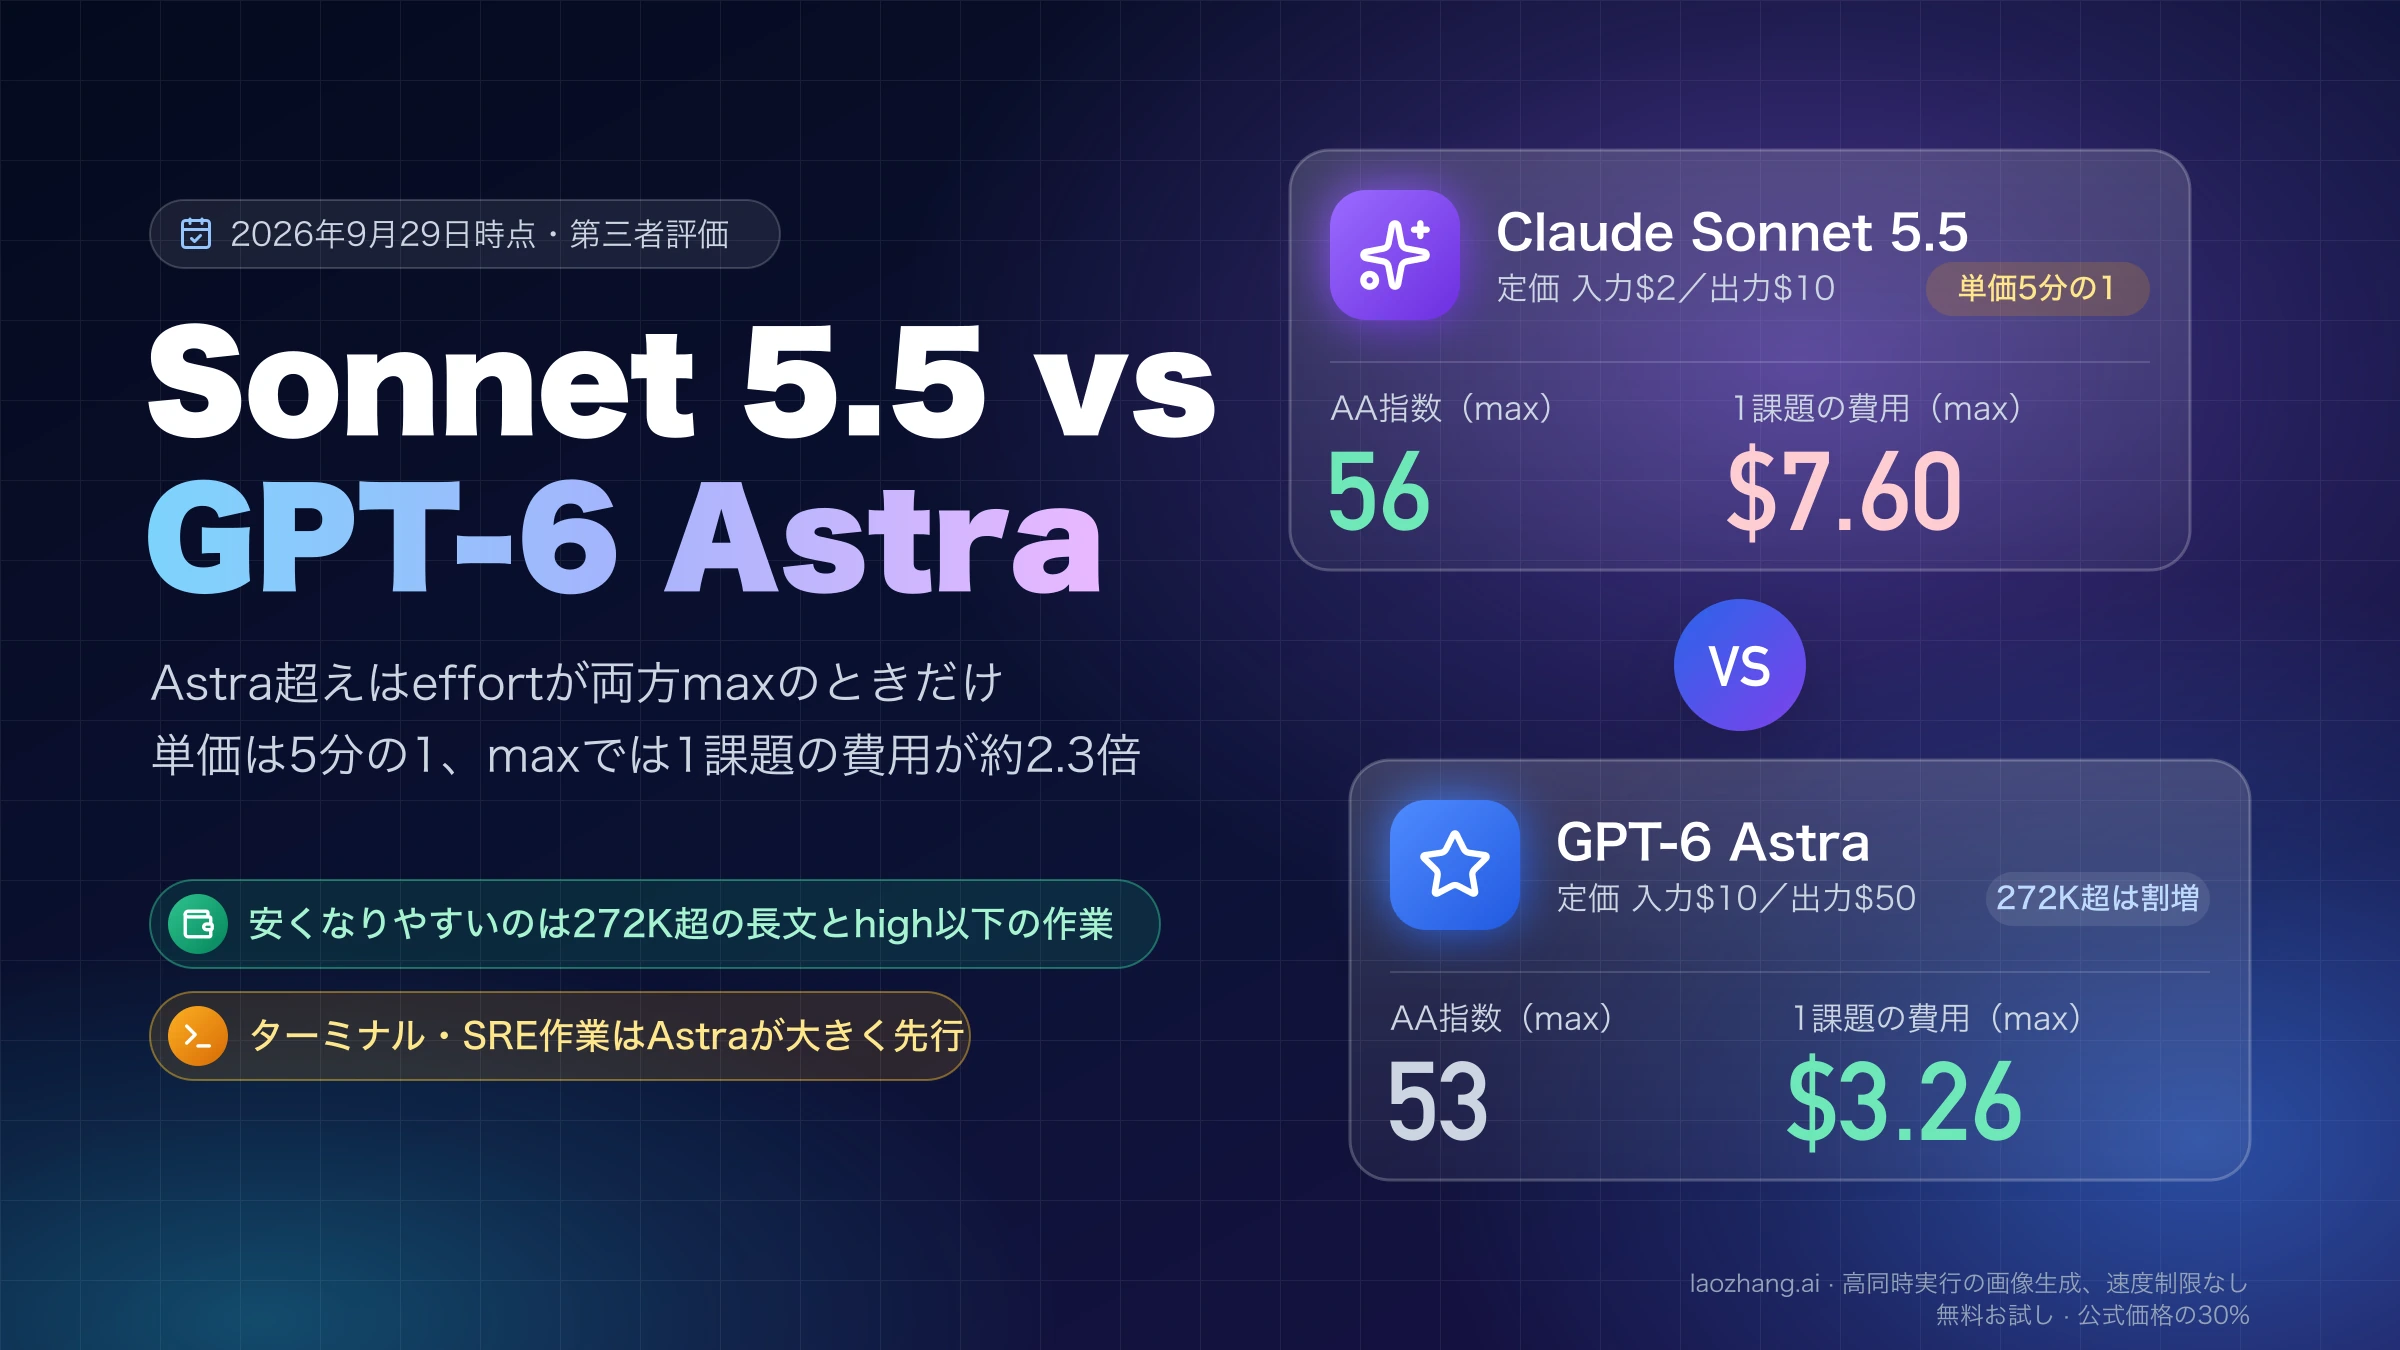
2026年9月28日に公開されたClaude Sonnet 5.5について、「OpenAIの最上位モデルGPT-6 Astraを上回った」「しかも単価は5分の1」という話が広がっています。前者は旧版の指数での話で、2026年10月28日時点の指数では成り立たなくなりました。後者は定価の比としては正しいものの、成り立つ条件があります。
- 「上回った」の根拠は、Artificial Analysis(以下AA)の旧総合指数v4.3.2で、推論の強さ(effort)を両方とも
maxにしたときの56対53でした。AAは2026年10月27〜28日に指数を9種類の評価からなるv5.0へ切り替え、v5.0ではlowからmaxまですべての段階でAstraが上です(max同士で57対54)。総合指数で見る限り、Sonnet 5.5がAstraより賢いとは言えません。 - 「5分の1」は100万トークンあたりの定価の比です。入力は$2対$10、出力は$10対$50です。AA(v5.0)の評価課題1件あたりの費用では、Sonnet 5.5が安いのは
highまでで、Astraの費用はSonnetの約2.0〜3.5倍です。xhighとmaxではAstraのほうが安く(maxで$6.24対$10.02、Sonnetが約1.6倍高い)、点数も上です。
そのため、Astraの代わりにSonnet 5.5を使って費用を下げられるのは、high以下の設定で自分の作業の合格ラインを越えられる場合か、1回の入力が272Kトークンを超える長い依頼が中心の場合です。Sonnet 5.5が勝つのはhigh以下での費用と出力速度(AAの計測で毎秒109〜140トークン、Astraは48〜71トークン)です。ターミナル操作やSRE(システム運用)のようなエージェント作業ではAstraが大きく先行する評価もあります。AAの数字は2026年10月28日時点、それ以外は特記がない限り2026年9月29日時点のもので、比較の根拠にするベンチマークはAAとVals AIによる第三者の評価です。
「Astra超え」は旧指数の話:v5.0では全effortでAstraが上
AAの総合指数(Intelligence Index v5.0)は9種類の評価をまとめた指数で、2026年10月27〜28日に10種類の評価からなるv4.3.2から切り替わりました。各モデルをeffortの5段階すべてで測っており、新旧の点数はそのまま比べられません。
| effort | Sonnet 5.5 指数 | Sonnet 5.5 1課題の費用 | GPT-6 Astra 指数 | GPT-6 Astra 1課題の費用 |
|---|---|---|---|---|
low | 25 | $0.51 | 43 | $1.42 |
medium | 30 | $0.78 | 51 | $2.73 |
high | 41 | $1.64 | 55 | $3.24 |
xhigh | 50 | $4.09 | 55 | $3.66 |
max | 54 | $10.02 | 57 | $6.24 |
出典はAAのSonnet 5.5とGPT-6 Astraの比較ページです(2026年10月28日時点)。「1課題の費用」はAAが全評価を定価で1回実行した費用を評価課題1件あたりに割ったもので、読者自身の作業にかかる費用とは別物です。
この表から読み取れるのは次の3点です。
- 同じeffort同士では、すべての段階でAstraが上です。差は
lowで18点、mediumで21点、highで14点、xhighで5点、maxで3点です。旧指数v4.3.2(2026年9月29日時点)ではmax同士だけSonnet 5.5が56対53で上でしたが、v5.0ではその逆転もなくなりました。旧指数の時点でAAは、Sonnet 5.5がmaxで評価課題1件あたり約19.3万の出力トークンを使い、「これまで測定した中で最多」「GPT-6 Astra(max)の約7倍」だったとSonnet 5.5解説記事に書いていました。 - 費用の向きは
highとxhighの間で入れ替わります。highまではSonnet 5.5のほうが1課題あたり安く、Astraの費用はSonnetの約2.8倍(low)、3.5倍(medium)、2.0倍(high)です。xhighでは$3.66対$4.09、maxでは$6.24対$10.02とAstraのほうが安く、点数も上です。近いスコアで比べても、Astraのlow(43点、$1.42)はSonnet 5.5のhigh(41点、$1.64)より点数が高く、安く済みます。 - Sonnet 5.5がはっきり安いのは
lowとmediumですが、その段階の指数は25〜30点で、Astraの最も低いlow(43点)にも届きません。
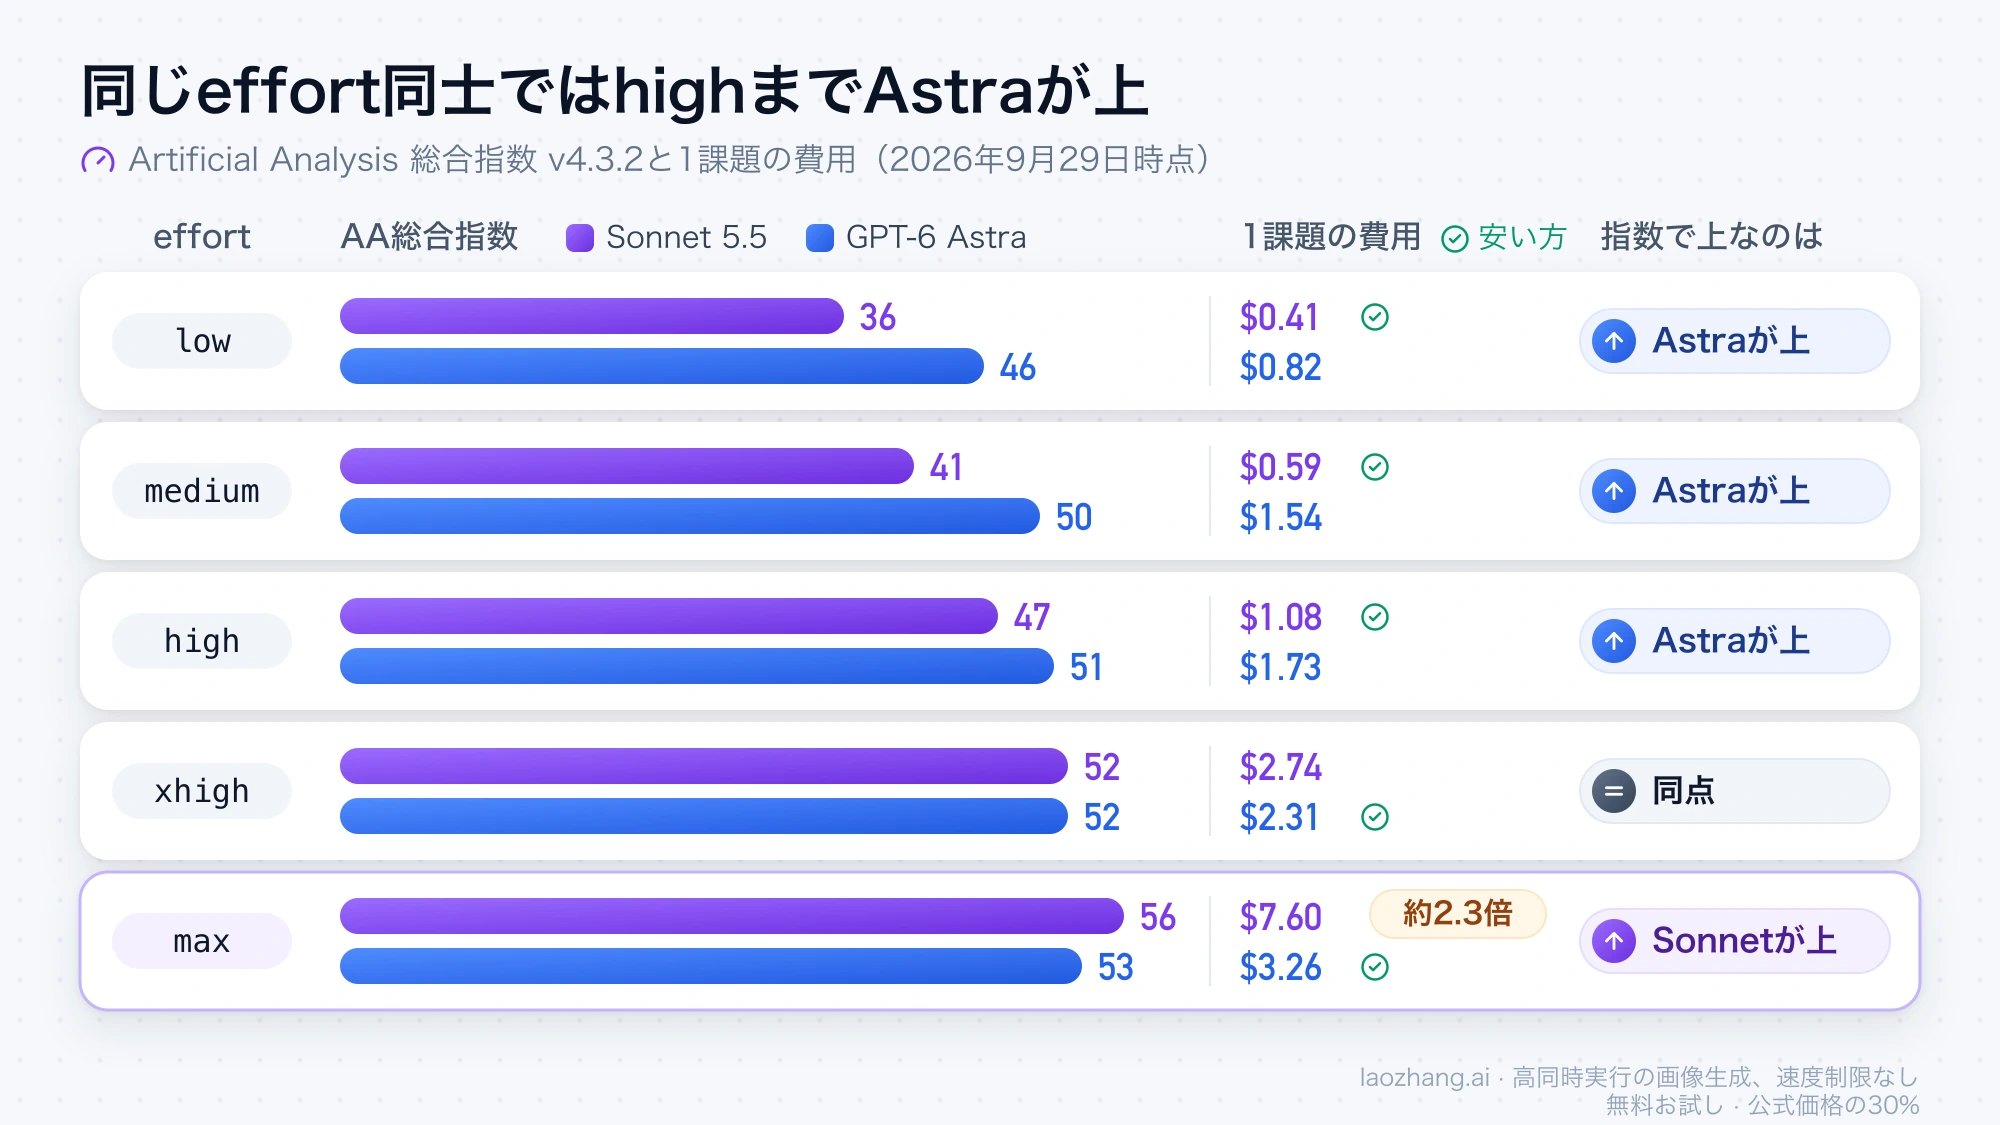
図はArtificial Analysisの旧指数v4.3.2(2026年9月29日時点)の数値です。2026年10月28日時点のv5.0の数値は上の表と本文のとおりで、すべての段階でAstraが上です。
既定の設定にも注意が必要です。Sonnet 5.5のAPIでの既定はhigh(AA指数v5.0で41点)ですが、ClaudeのアプリとClaude Codeではmedium(同30点)で動きます。Astraの既定のeffortはOpenAIの公開ドキュメントに記載がありません。なおAstraはnoneを受け付けず、指定すると400エラーになります。「設定を変えずに比べた」という体験談を読むときは、Sonnet側がどの段階で動いていたかを先に確かめてください。
前提がもう二つあります。effortの段階名は各社が独自に決めたもので、AnthropicのhighとOpenAIのhighが同じ計算量を意味するわけではありません。同じ名前同士の比較はあくまで目安です。また、旧指数v4.3.2の時点でAAはSonnet 5.5をリリース前の環境で評価しており、構造化出力を使うリクエストで回答が劣化する不具合があったこと(公開版では修正済み)と、再評価を予定していることを注記していました。v5.0への切り替えで点数はすべて入れ替わっており、今後も動く可能性があります。
Vals AIでは19項目中13項目でSonnet 5.5が上
Vals AIの比較ページは、両モデルともmaxで共通の19ベンチマークを比べています。Sonnet 5.5が13項目、Astraが6項目で上回りますが、±1標準誤差の範囲が重なる項目が9つあり、Vals自身が「ペアごとの統計的有意差の検定ではない」と断っています。
差の大きい項目と総合指数は次のとおりです(2026年9月29日時点)。
| ベンチマーク | Sonnet 5.5 | GPT-6 Astra | 差 |
|---|---|---|---|
| Terminal-Bench Science | 38.57% | 65.71% | Astraが27.14ポイント上 |
| SRE Bench | 30.15% | 56.87% | Astraが26.72ポイント上 |
| IOI(競技プログラミング) | 83.06% | 100.00% | Astraが16.94ポイント上 |
| CyberBench v1.1 | 59.58% | 41.07% | Sonnet 5.5が18.51ポイント上 |
| Tax Agent Bench | 73.39% | 63.34% | Sonnet 5.5が10.06ポイント上 |
| Legal Research Bench | 48.08% | 39.42% | Sonnet 5.5が8.65ポイント上 |
| Vals Index(総合) | 69.22% | 66.61% | Sonnet 5.5が2.61ポイント上 |
この表には読み方の注意が三つあります。
- CyberBenchの差はフォールバック込みの数字です。 ValsはSonnet 5.5を、拒否したリクエストをSonnet 5で再試行するサーバー側フォールバック付きで評価しました。フォールバックに頼った課題を失敗扱いにすると、CyberBenchは41.97%、SRE Benchは19.08%、Vals Indexは68.89%まで下がります。セキュリティ分野でのSonnet 5.5単体の優位は、Astraの41.07%とほぼ並ぶ水準まで縮みます。
- 費用が近くても所要時間は大きく違います。 Vals Index全体の実行費用は$20.80対$19.09とほぼ同じですが、所要時間は1時間10分対25分11秒でした。Terminal-Bench 4.0では費用が$19.33対$8.21、時間は2時間6分対42分です。
- 分野ごとの平均では向きが分かれます。 法務・金融・医療・教育の平均はSonnet 5.5、科学とコーディングの平均はAstraが上です。
両社の発表値を横に並べられない理由
Anthropicの発表ページはSonnet 5.5をSonnet 5、Opus 5.5、GPT-6 Solと比べていて、GPT-6 Astraは表にありません。OpenAIのAstraの発表ページにも、Sonnet 5.5やOpus 5.5の列はありません。それぞれ自社の測定環境で出した数字です。
分かりやすい例がTerminal-Bench 4.0です。Anthropicの発表ではSonnet 5.5が70.6%、OpenAIの発表ではAstra(max)が57.9%ですが、この二つを「70.6%対57.9%」と並べると、別々の環境で測った値を比べることになります。第三者の測定では結果の向きすら一致しません。
| 測定 | Sonnet 5.5 | GPT-6 Astra |
|---|---|---|
| AA | 63.6%(max) | 59.6%(xhigh) |
| Vals AI | 53.03%(max) | 57.07%(max) |
AAではSonnet 5.5、ValsではAstraが上なので、Terminal-Bench 4.0でどちらが勝つとは言えません。FrontierCodeやOSWorldも、測定環境やバージョン(OSWorldは2.1と2.0)が両社で異なります。
Anthropicが発表でうたう「30%以上高速」「ほとんどの作業で費用が最大30%安い」も、先代のSonnet 5と比べた数字で、Astraとの比較ではありません。しかもAAの旧指数v4.3.2(2026年9月29日時点)の測定では、maxでのSonnet 5.5の1課題あたり費用はSonnet 5(max)より約50%高くなっており(Sonnet 5はv5.0では採点されていません)、この「最大30%安い」はeffortや作業の内容次第で成り立たないこともあります。
トークン単価の差を自分の依頼の形で計算する
2026年10月28日時点のAPI定価(100万トークンあたり、米ドル)は次のとおりです。
| 項目 | Claude Sonnet 5.5 | GPT-6 Astra(入力272K以下) | GPT-6 Astra(入力272K超) |
|---|---|---|---|
| 入力 | $2 | $10 | $20 |
| キャッシュ読み出し | $0.10 | $1 | $2 |
| キャッシュ書き込み | $2.50(5分)/$4(1時間) | $12.50(30分)/$25(12時間) | $25(30分)/$50(12時間) |
| 出力 | $10 | $50 | $75 |
| Batch | 入力$1/出力$5 | 標準の半額(Flexも同じ) | 標準の半額 |
出典はAnthropicの料金ページとOpenAIの料金ページです。Sonnet 5.5のキャッシュ読み出しは2026年10月7日に$0.20から$0.10に下がりました。Sonnet 5.5には100万トークンの範囲内で長文の割増がなく、90万トークンの依頼も9,000トークンの依頼と同じ単価です。Astraは1回の入力が272Kトークンを超えると、その依頼全体が右列の単価になります。ほかに、AstraのFastモードは標準の2倍(遅延の保証なし)、データ所在地を指定する地域処理は10%増、Sonnet 5.5は米国内のみで推論させる指定が1.1倍で、Sonnet 5.5にFastモードはありません。Astraの12時間キャッシュ書き込みは2026年10月20日に追加された区分で、Responses APIでのみ使えます。
1回の依頼の費用は「入力トークン数÷100万×入力単価+出力トークン数÷100万×出力単価」で出せます。キャッシュを使わず、両モデルの課金トークン数が同じだと仮定すると、次のようになります。
| 依頼の形 | Sonnet 5.5 | GPT-6 Astra | 差 |
|---|---|---|---|
| 入力10万+出力2万トークン | 0.1×$2+0.02×$10=$0.40 | 0.1×$10+0.02×$50=$2.00 | 5倍 |
| 入力30万+出力2万トークン | 0.3×$2+0.02×$10=$0.80 | 0.3×$20+0.02×$75=$7.50 | 約9.4倍 |
これはあくまで仮定の上の計算で、実際の請求額ではありません。実際には、トークナイザーが違うため同じ文章でもトークン数が変わり、推論に使ったトークンは出力として課金され、やり直しの分も加わります。
この計算から、次のような目安が導けます。272K以下の依頼では入力・キャッシュ書き込み・出力が5倍、キャッシュ読み出しは10倍の差なので、Sonnet 5.5が同じ作業に使う課金トークンがAstraの5倍未満なら安くなります。キャッシュ読み出しが多い依頼ほど、逆転する倍率は5倍より上がります。272K超では入力10倍・出力7.5倍の差になるため、Sonnet 5.5が有利な範囲は広がります。AAの旧指数v4.3.2のmaxで1課題あたりの費用が逆転したのも、出力トークンが約7倍と、この5倍の線を越えていたためです。
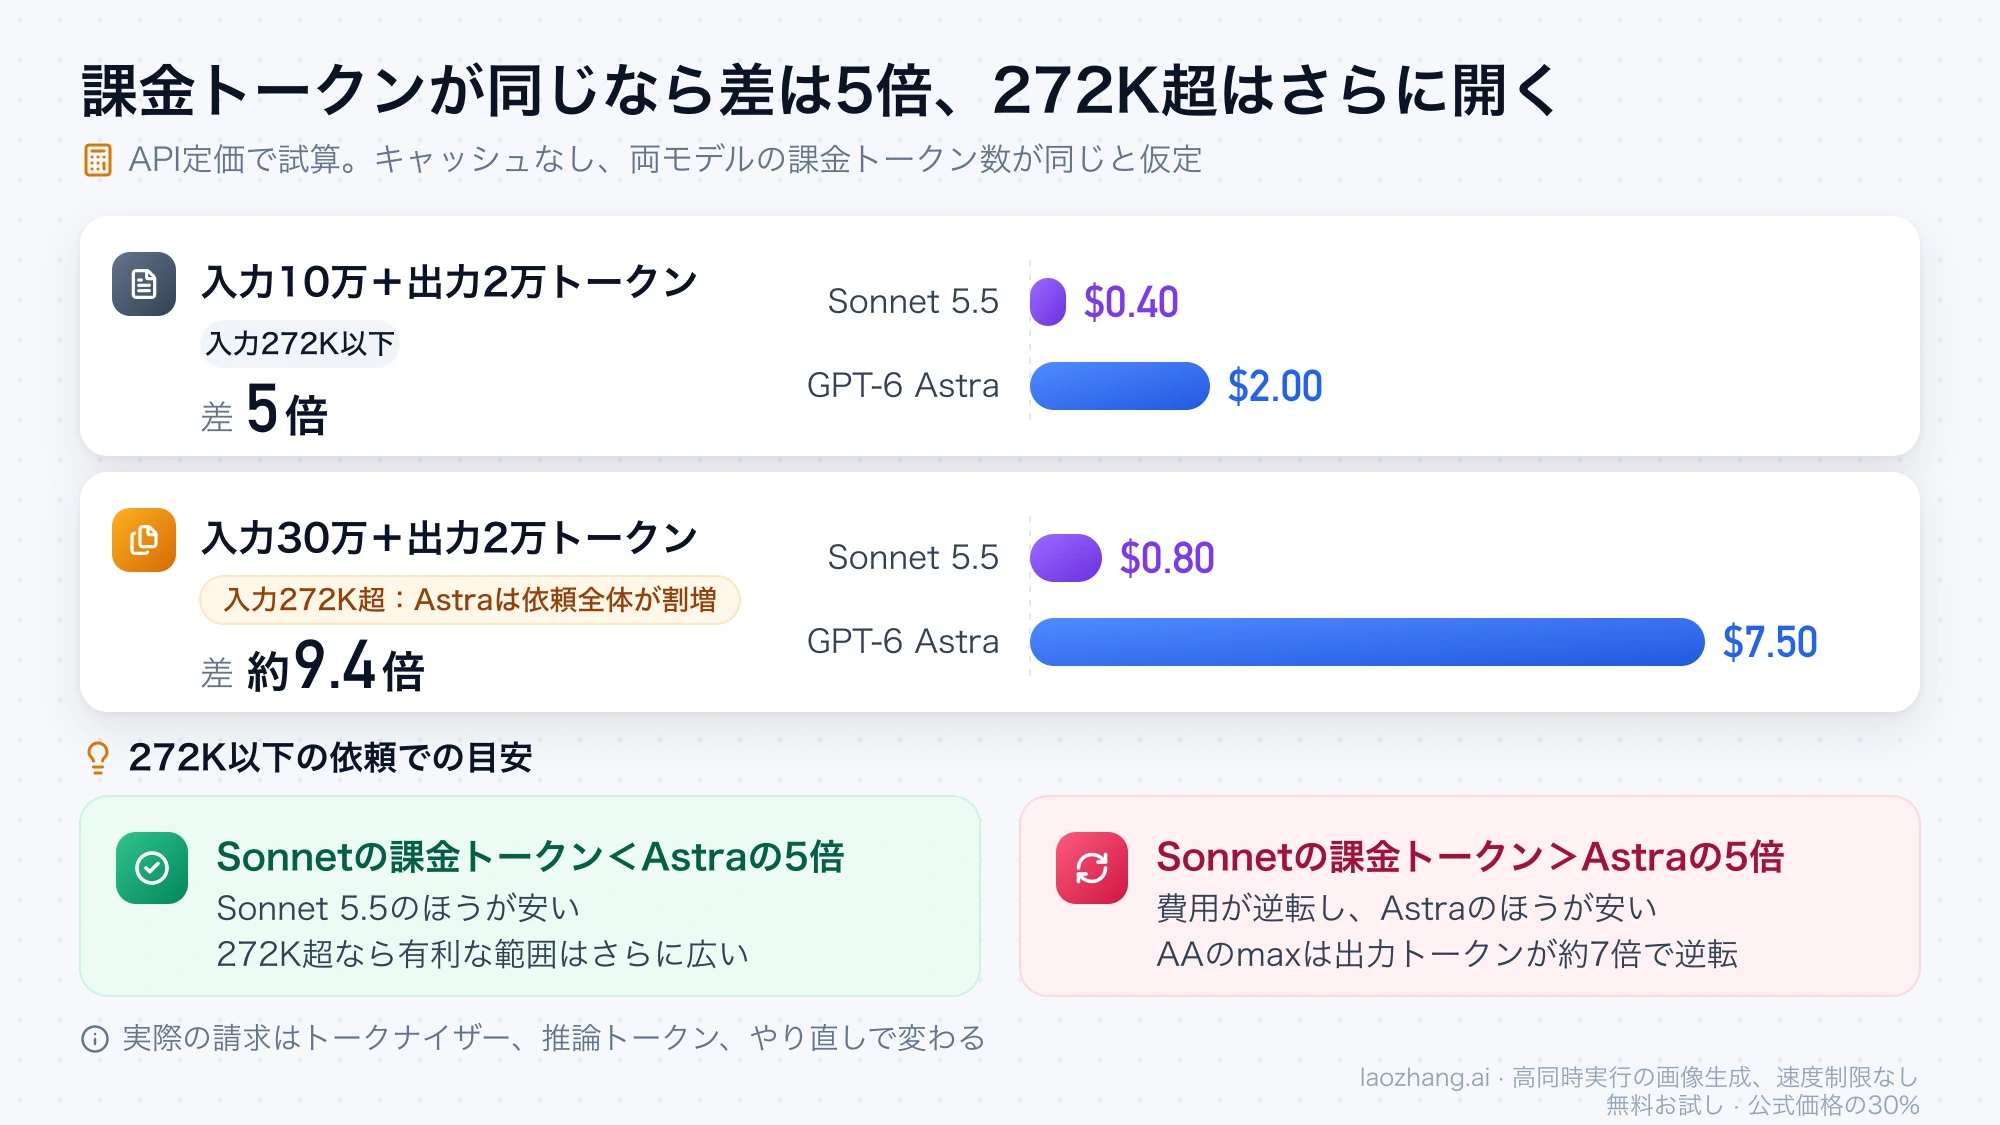
図中の「AAのmaxは出力トークンが約7倍」はArtificial Analysisの旧指数v4.3.2(2026年9月29日時点)の計測です。2026年10月28日時点のv5.0では、xhighとmaxでSonnet 5.5の1課題あたり費用がAstraを上回ります。
Batchの割引は両社とも半額なので、Batch同士でも比は変わりません。Astraの細かい料金計算は「GPT-6 Astra API料金:10種類の単価と長文・Batch・Fastの計算方法」に、Sonnet帯のキャッシュの課金は「Claude Sonnet 5の値上げは撤回。現在のAPI料金と予算の見直し方」に詳しい説明があります。Sonnet 5.5の入力・出力の料金はSonnet 5と同じなので、キャッシュ読み取りを$0.10(Sonnet 5は$0.20)に置き換えれば後者の計算が使えます。
同じ単価で比べる相手はGPT-6 Sol
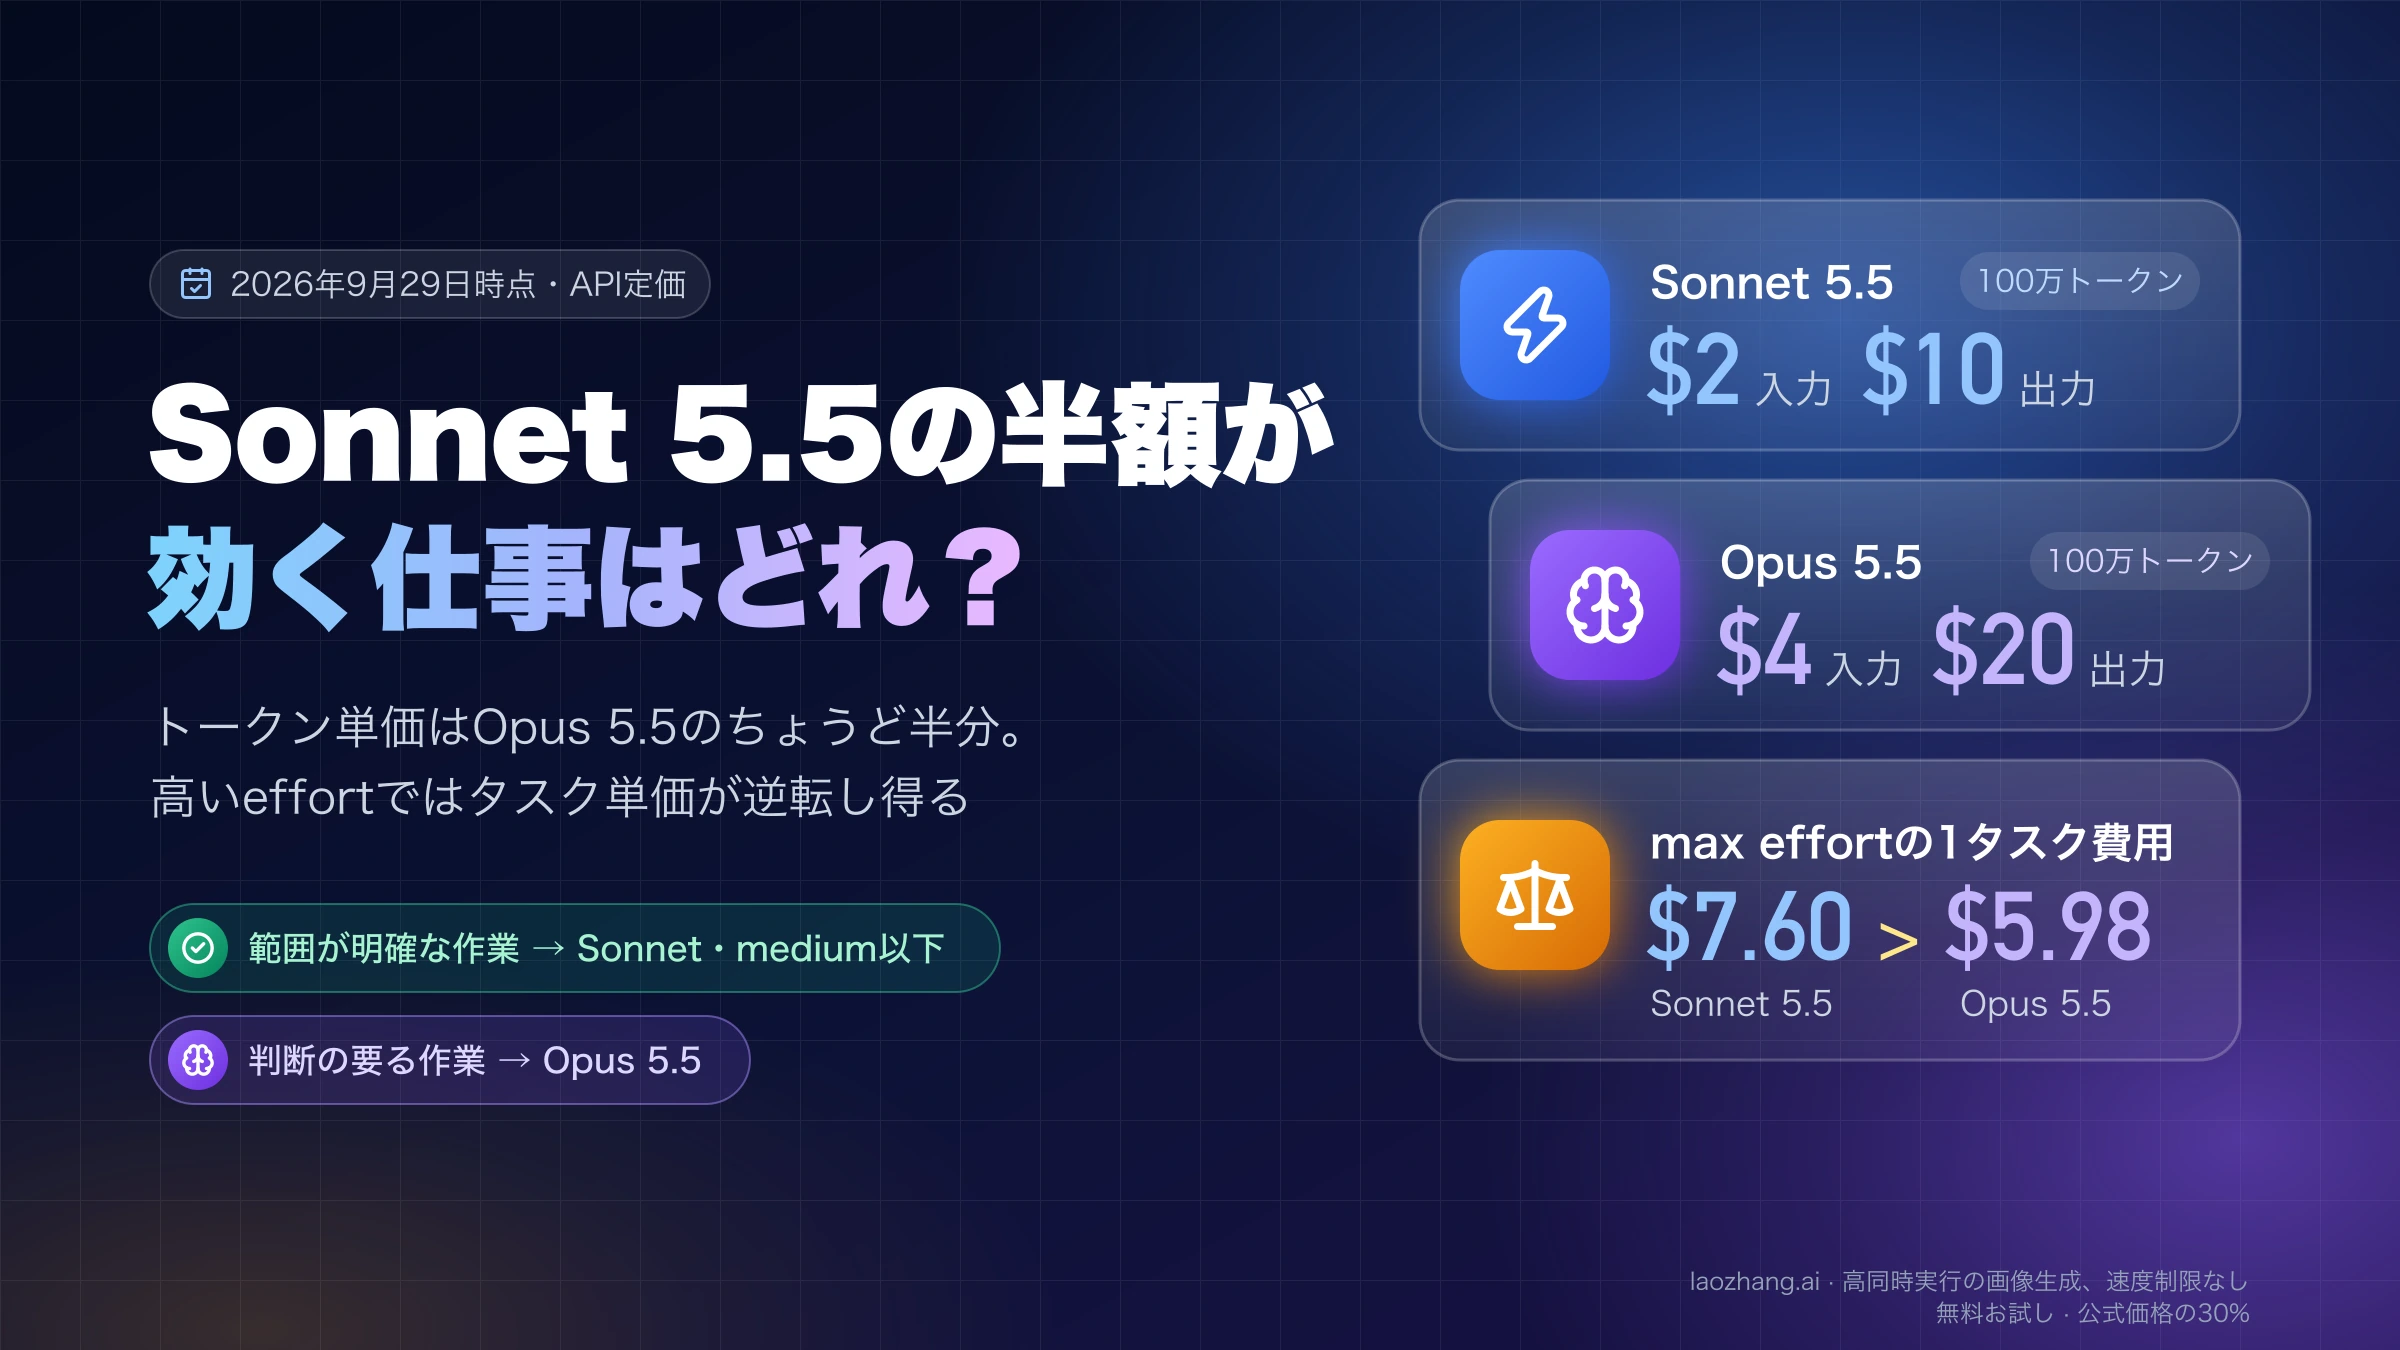
「同じお金を払うならどちらが良いか」を知りたいなら、比べる相手はAstraではなくGPT-6 Solです。GPT-6 Solの定価は入力$2、キャッシュ読み出し$0.20、キャッシュ書き込み$2.50、出力$10(入力272K以下)で、キャッシュ読み出し以外はSonnet 5.5と同じです(Sonnet 5.5のキャッシュ読み出しは2026年10月7日から$0.10)。Anthropicの発表でもSonnet 5.5の比較相手はGPT-6 Solでした。
違いは272Kを超えたときに出ます。GPT-6 Solはそこで入力$4・出力$15などに上がり、Sonnet 5.5は変わりません。旧指数v4.3.2の時点でAAは、Sonnet 5.5のhighがGPT-6 Solとほぼ同じ1課題あたり費用で、指数はわずかに下と評していました(GPT-6 Solはv5.0では採点されていません)。GPT-6 Sol・Luna・Astraの選び分けは「GPT-6 Sol・Luna・AstraとTerraの違い:API料金と用途から選ぶ」、Claudeの上位モデルとの比較は「Opus 5.5とGPT-6 Sol比較:料金2倍はどこに効くか」が参考になります。
一方、「Astraでないとこなせない作業を、Sonnet 5.5で安く済ませられるか」を知りたいなら、比べる相手はAstraのままです。とにかく最高のスコアが欲しい場合、AAの指数v5.0(2026年10月28日時点)で最も高いのはOpus 5.5(max)の58点で、Opus 5.5(xhigh)とAstra(max)の57点、GPT-6.1 Sol(max)とAstra(high・xhigh)の55点が続き、Sonnet 5.5(max)の54点はその下です。Claudeの中でさらに上を検討するなら、2026年11月9日に公開されたFable 5.2を扱う「Claude Fable 5.2とOpus 5.5の違い:同じ正解数で費用1.86倍」も見てください。
作業別:Sonnet 5.5を試すか、Astraを続けるか
ここまでの評価を作業の種類ごとに整理すると、次のようになります。いずれも第三者の評価からの見立てなので、最終判断は後述の試験で行ってください。
| 作業の種類 | 先に試す構成 | 根拠 |
|---|---|---|
| 入力が272Kトークンを超える長文の読解・要約・レビュー | Sonnet 5.5(high以下から) | 同じトークン数ならAstraの長文単価との差は7.5〜10倍になり、Sonnet側のトークン増を吸収しやすい |
| 短い応答を大量にさばくチャットや分類 | Sonnet 5.5のlow/medium | AA v5.0の1課題費用は$0.51/$0.78で、lowでの最初の回答トークンまでの時間は1.29秒(Astraは2.71秒)、出力速度は毎秒109トークン(Astraは48)。ただしこの段階の指数はAstraのlowより大きく低い |
Astraをlow〜mediumで使っている汎用作業 | Astraを継続し、Sonnet 5.5のhighと比べる | AA v5.0ではAstraのlow(43点、$1.42)がSonnet 5.5のhigh(41点、$1.64)より点数が高く安い |
| ターミナル操作、科学計算の手順、SRE・障害対応のエージェント | Astraを継続 | ValsでTerminal-Bench Science(27.14ポイント差)とSRE Bench(26.72ポイント差)がAstraの大差 |
| 法務・税務・金融の調査や文書作業 | Sonnet 5.5のxhigh/maxを試す | ValsでLegal Research、Tax Agent、Finance AgentがSonnet 5.5の上。ただしAA v5.0ではxhigh以上の1課題費用がAstraより高いため、費用は必ず実測する |
| セキュリティ調査 | Astraを継続するか、Sonnet 5の扱いまで確認 | CyberBenchの優位はフォールバック込み。Claudeのアプリでは、サイバー関連と判定されると会話がSonnet 5に切り替わることがある |
| 長時間の最高難度エージェント作業 | Astraのxhigh/maxを基準に置く | Valsでは同じmaxで所要時間がおよそ3分の1。AAのmaxでは1課題費用もAstraが安い |
サブスクリプションで使っている場合は、API定価の比較はそのまま当てはまりません。ChatGPTでは、Astraを使う「GPT-6 Pro」がChatで使えるのはPro($100/$200)、Business、Enterpriseのプランで、PlusはChatGPT WorkとCodexでのみAstraを使えます。FreeとGoにAstraはありません。Codexでの利用量は5時間あたりのローカルメッセージ数の目安(Plusで5〜45など)として公開されていて、固定の上限ではありません。Claude側では、Sonnet 5.5はウェブ・モバイル・デスクトップのアプリやClaude Codeで選べますが、どの有料プランに含まれるかは公開情報に記載がありません。
乗り換える前に確認すること
AstraからSonnet 5.5へ移る場合
同じ会社の新旧モデルを入れ替えるのとは違い、APIそのものが変わります。
- APIの形。 OpenAIのResponses API(またはChat Completions)から、AnthropicのMessages APIへの書き換えになります。Astraでツール呼び出しを使うにはResponses APIが必要なので、既存のコードはResponses前提で書かれていることが多いはずです。ツール定義の書式、キャッシュの仕組み(Anthropicは5分/1時間の書き込みを明示的に指定、Astraは
prompt_cache_options.ttlで"30m")、トークナイザーも異なります。 - effortの指定。 Sonnet 5.5では
output_config.effort、AstraではResponses APIのreasoning.effort(Chat Completionsではreasoning_effort)で指定します。段階名は同じでも中身はそろっていないので、AstraでmediumだったからSonnet 5.5もmedium、とはなりません。 - サンプリングパラメータ。 Astraは
noneを持たないため、常にtemperatureやtop_pを外して使う前提です。これらを使っていないプロンプトは移しやすく、Sonnet 5.5でも既定以外のtemperature・top_p・top_kは400エラーになります。 - OpenAI固有の機能。 Responses APIの組み込みツールや
pro推論モードに頼っている処理は、Claude側に同じ役割の仕組みがあるかを個別に確かめる必要があります。 - 提供経路。 両モデルともAmazon Bedrockで使えます(Astraはus-west-2)。アカウントや請求の手間は減らせますが、APIの形の違いはなくなりません。
Astraをこれから使い始める場合の手順は「GPT-6 Astra APIの始め方:利用権限の確認から最初の応答まで」にあります。Claudeへの接続経路を選び直す場合は「Claude を安定して使うにはどう選ぶべきか: Anthropic 直結、対応クラウド、それとも laozhang.ai の互換ゲートウェイ?」も参考になります。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
Sonnet 5向けのコードをSonnet 5.5に流用する場合
AnthropicのSonnet 5.5の変更点には、Sonnet 5で動いていたコードが失敗する変更が五つ挙がっています。
thinking: {"type": "disabled"}と、budget_tokensによる手動の思考予算は400エラーになります。事前の思考を止めたいときはthinking: {"type": "between_tools"}を使いますが、使えるのはlow・medium・highだけで、xhighとmaxでは400エラーです。tool_choiceでanyやtoolを指定する強制ツール呼び出しは400エラーになります。autoのままstrict: trueを付けるか、構造化出力に移します。- 思考ブロックは生成したモデルと会話、アカウントに結び付きます。2026年8月31日以降に作られたアカウントでは、過去の履歴を編集してから思考ブロックを送り返すと、既定で400エラーになります。会話は追記だけで進めてください。
- Claude APIとGoogle Cloudでは、コンピューター操作ツール
computer_20251124が受け付けられず、computer_toolset_20260801への移行が必要です(Amazon Bedrockでは旧ツールも使えます)。 - advisorツールで、Opus 4.8、Opus 4.7、Sonnet 5をadvisorに指定すると400エラーになります。
エラーにはならないものの挙動が変わる点もあります。ツール呼び出しの合間に出るテキストがthinkingブロックで返るようになり、既定のdisplay: "omitted"ではその中身が空になります。ツール呼び出しの間の進捗を画面に流しているアプリは、何のエラーも出ないまま表示が止まるので、displayを変えるかbetween_toolsを使ってください。ほかに、アシスタント応答の先頭を埋めておくプリフィルは400エラー、キャッシュできるプロンプトの最小長は512トークンです。
合格した1件あたりの費用で決める
最終的な判断は、自分の作業で「合格した1件あたりの費用」を比べるのが確実です。合格した1件あたりの費用とは、試験全体で実際に課金された金額を、受け入れ基準を満たした件数で割った値です。1件ごとの単価が安くても、やり直しや人の手直しが増えれば意味がないので、この値で比べます。
- 実際の作業から20〜50件を選び、それぞれに合否の基準を決めます(テストが通る、レビューで修正なしなど)。
- 両モデルに同じ入力と同じツールを渡し、effortの組み合わせを明示して実行します。まずSonnet 5.5の
highに対してAstraのmediumとhigh、次にそれぞれ1段階上げます。 - 課金されたトークン数(入力、キャッシュ読み出し、キャッシュ書き込み、推論を含む出力)、やり直しの回数、所要時間、人が手直しした時間を記録します。
- 合格した1件あたりの費用=課金額の合計÷合格件数、を計算します。たとえば30件で合計$12、合格が24件なら$0.50です。
- Sonnet 5.5が同じ合格基準を満たし、そのうえでこの値が下がる場合にだけ切り替えます。作業の種類によって結果が分かれたら、種類ごとに振り分けます。
effortの指定は、それぞれ次のように書きます。
# Claude(Messages API)
anthropic_client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=128000,
    output_config={"effort": "high"},
    messages=[{"role": "user", "content": task}],
)

# OpenAI(Responses API)
openai_client.responses.create(
    model="gpt-6-astra",
    reasoning={"effort": "medium"},
    input=task,
)
Sonnet 5.5では、思考に使ったトークンもmax_tokensに含まれます。Anthropicはエージェント型のコーディングでは上限の128,000に設定することを勧めているので、高いeffortで試すときはmax_tokensを小さくしすぎないでください。
よくある質問
Sonnet 5.5はGPT-6 Astraより賢いのですか?
AAの総合指数v5.0(2026年10月28日時点)で見る限り、そうとは言えません。lowからmaxまですべての段階でAstraが上で、max同士でも57対54です。旧指数v4.3.2ではmax同士だけSonnet 5.5が56対53で上でした。一方、Vals AIの19項目の比較(両方max、2026年9月29日時点)ではSonnet 5.5が13項目で上ですが、ターミナル操作や科学計算のエージェント作業ではAstraが大きく先行しています。
Sonnet 5.5ならAstraの5分の1の費用で済みますか?
課金トークン数が同じなら、272K以下の依頼で5分の1です。ただしSonnet 5.5は高いeffortでトークンを多く使い、AAの指数v5.0での1課題あたり費用は、highまではSonnet 5.5が安いものの、xhighとmaxではAstraより高くなります(maxで$10.02対$6.24)。Sonnet 5.5が同じ作業に使うトークンがAstraの5倍未満に収まるかどうかが分かれ目です。
同じ値段のモデル同士で比べるなら何と比べればいいですか?
GPT-6 Solです。入力272K以下の定価はSonnet 5.5と同じ入力$2・出力$10で、Anthropic自身も発表でSonnet 5.5をGPT-6 Solと比べています。
ChatGPTでAstraを使っている場合も同じ判断になりますか?
なりません。ChatGPTやCodexの利用枠はプランごとに決まっていて、API定価から割り出すことはできません。サブスクリプション同士なら、普段の作業をどちらのアプリで進めるか(Claude CodeかCodexか)と、各プランで使える範囲で考えるのが現実的です。
参考資料6
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年11月10日。
参考資料6
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年11月10日。
- 1.AAのSonnet 5.5とGPT-6 Astraの比較ページartificialanalysis.ai/models/releases/comparisons/claude-sonnet-5-5-vs-gpt-6-astra
- 2.Sonnet 5.5解説記事artificialanalysis.ai/articles/claude-sonnet-5-5
- 3.Vals AIの比較ページvals.ai/comparisons/anthropic_claude-sonnet-5-5-vs-openai_gpt-6-astra
- 4.Anthropicの料金ページplatform.claude.com/docs/en/about-claude/pricing
- 5.OpenAIの料金ページdevelopers.openai.com/api/docs/pricing
- 6.Sonnet 5.5の変更点platform.claude.com/docs/en/models/sonnet-5-5/whats-new-sonnet-5-5