GPT-6 AstraとClaude Fable 5.2比較:effort対応と1タスクの費用
Fable 5.2は単価がGPT-6 Astraより20%安い一方、同じhighでは出力が2.5倍でした。点数をそろえればFableが安く、軽い仕事はAstraが最安です。
目次
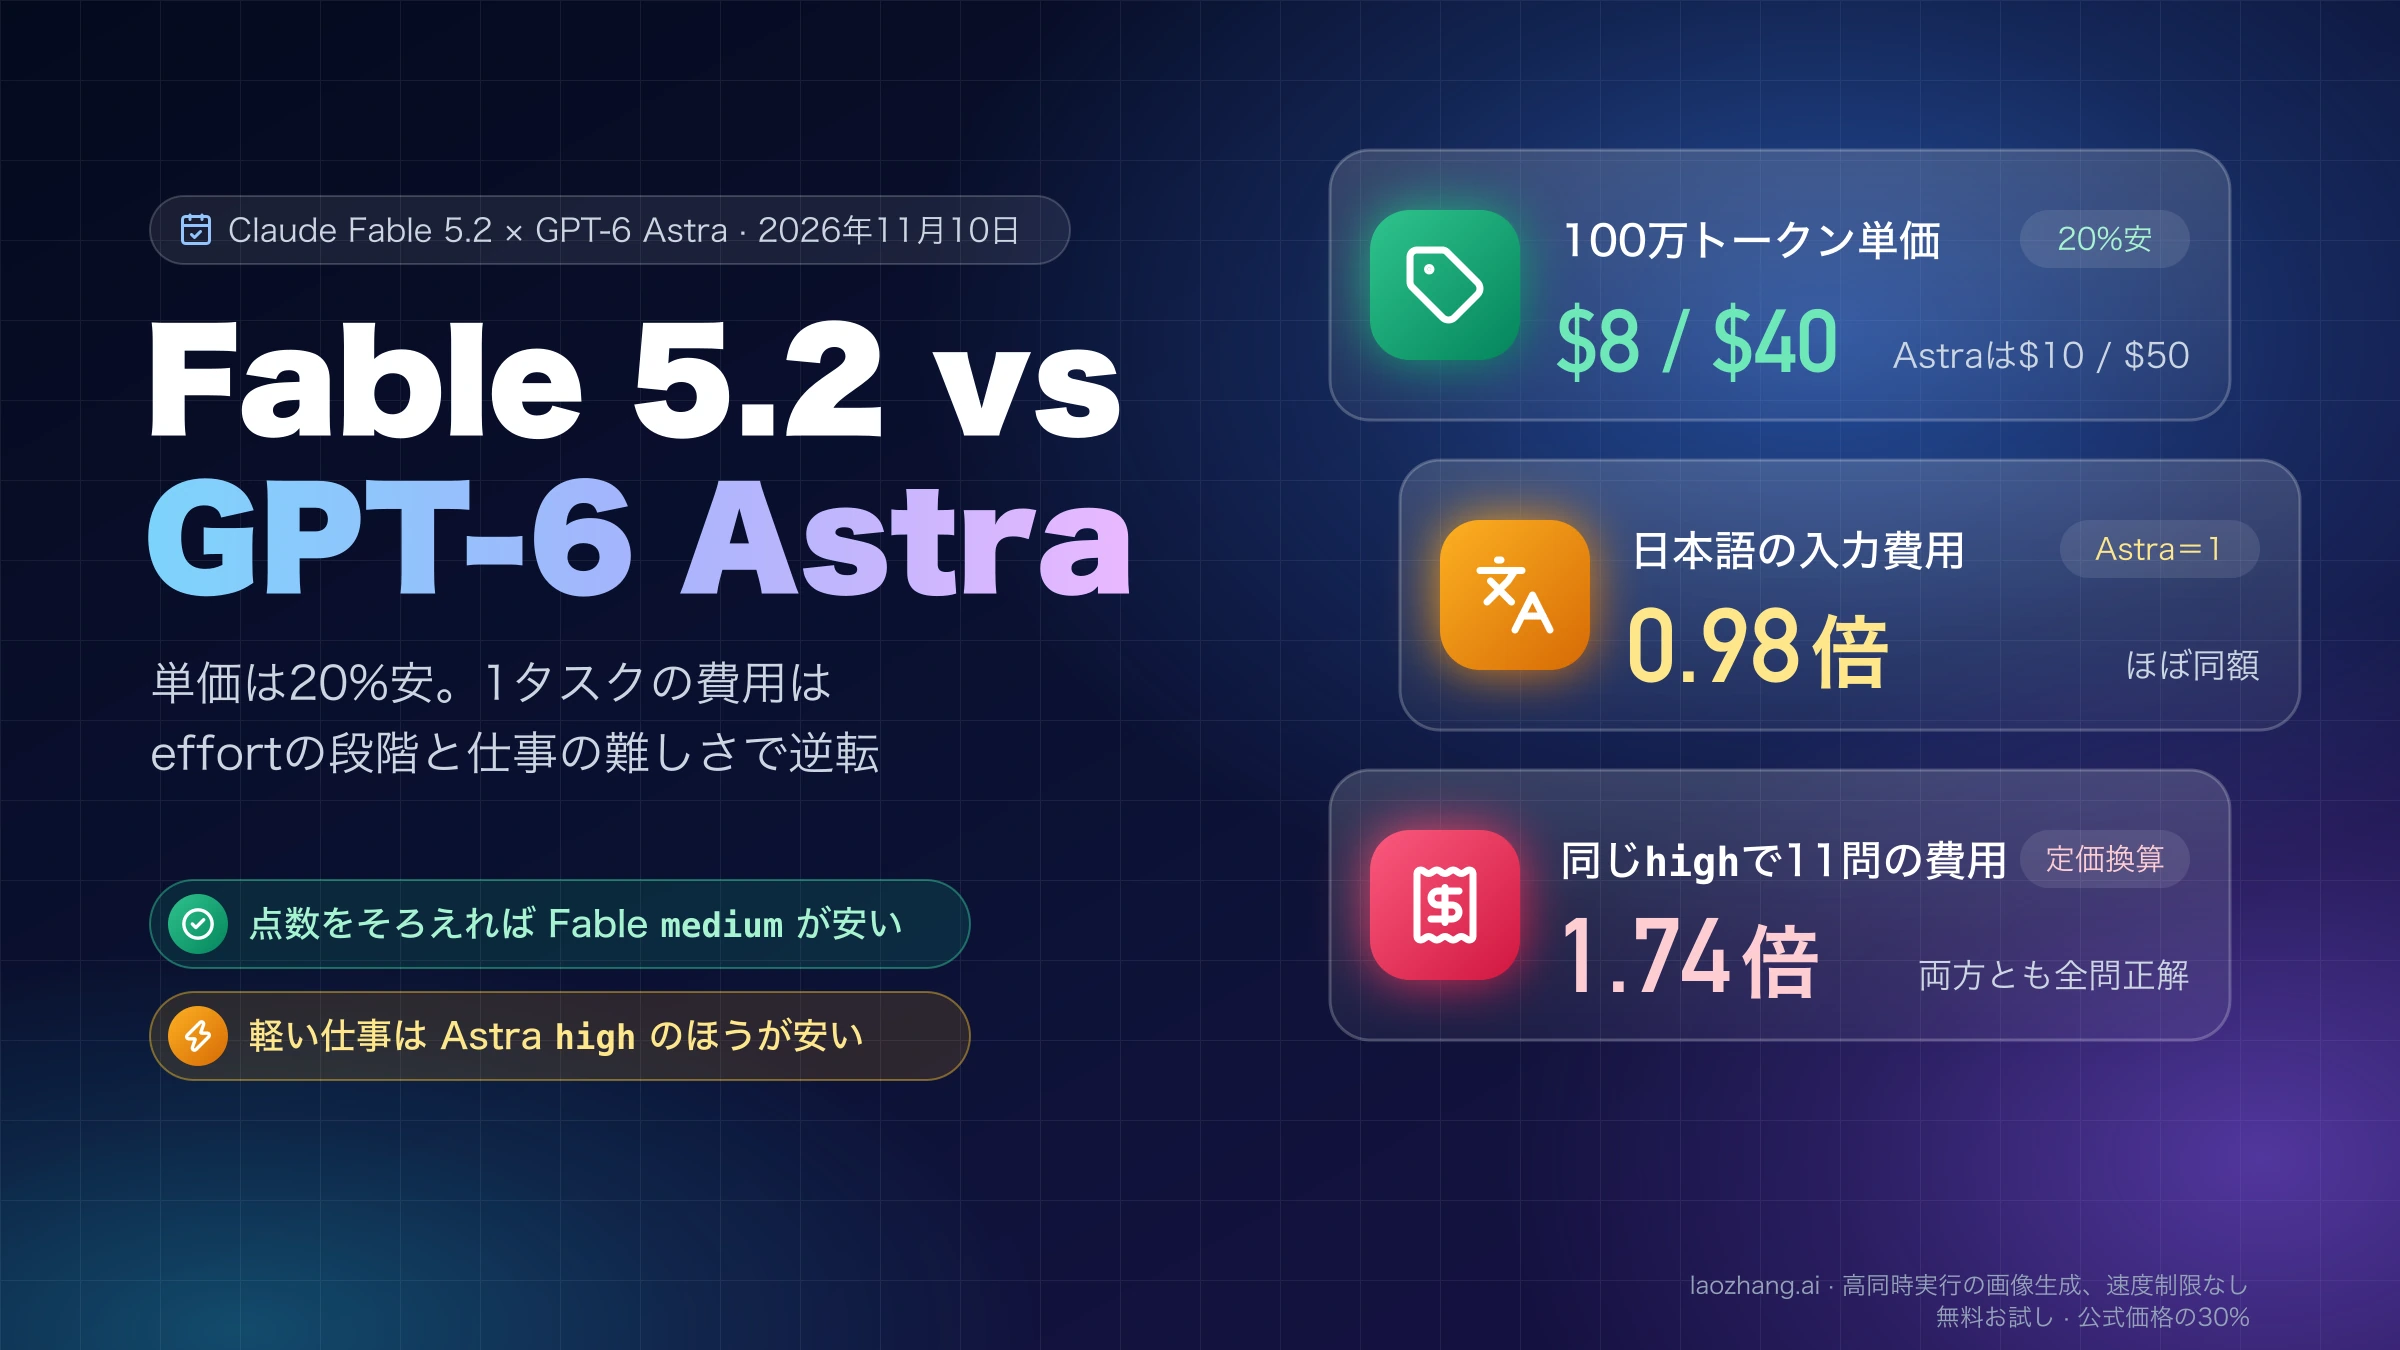
難しい仕事でGPT-6 Astraを推論の強さ(effort)high〜maxで使っているなら、2026年11月9日に出たClaude Fable 5.2(claude-fable-5-2)をmediumで試す価値があります。Artificial Analysisの総合指数v5.0.1(2026年11月10日時点)では、Fable 5.2のmediumは56点でAstra maxの57点に1点差まで迫り、指数タスク1件の費用は$3.80対$6.24、時間は8.3分対22.6分です。一方、仕様がはっきりした小さな課題では話が逆になります。2026年11月10日に同じ11問を両方のhighで解かせたところ、どちらも全問正解で、Fable 5.2は出力トークンを2.49倍使い、定価換算の費用は1.74倍でした。
普段のモデルは、仕事の難しさで決めます。Astra highで足りている定型的なコーディングや短い調査はgpt-6-astraのまま、Astra maxで回している難しい仕事は点数がほぼ同じで安いclaude-fable-5-2のmediumに、Astra maxでも届かない難問や長い自律作業はFable 5.2のhighに回します。Astra low(43点、$1.42)より安い選択肢はFable 5.2にはありません。
ただし、品質を比べる前に決まる条件があります。Fable 5.2はサイバーセキュリティと研究系の生物学の多くの依頼を安全分類器で止め、30日間のデータ保持が前提で、ツール呼び出しの強制(tool_choiceのany/tool)は400エラーになります。これに当たる仕事はAstraに残します。
Fable 5.2は本当に20%安いのか:単価は下がったが1タスクの費用は別
11月9日から、Fable 5.2の100万トークンあたりの単価は入力$8、出力$40で、GPT-6 Astraの$10/$50より20%安くなりました。9月のFable 5.1はAstraと同じ$10/$50だったので、「料金は同額」という比較は5.1までの話です。ただし20%は単価の差で、1つの仕事を終えるまでの費用ではありません。
「Astra 6」と検索されるのはGPT-6 Astra(gpt-6-astra、2026年9月3日公開)のことで、その名前の別モデルはありません。2026年11月10日時点のOpenAIの料金表にあるのはgpt-6-astra、gpt-6.1-sol、gpt-6.1-terra、gpt-6-lunaで、GPT-6.2はまだありません。Anthropic側では、Fable 5.1はレガシー扱いになりましたが引き続き使え、Mythos 5.2は同じモデルを認証済みの組織だけに安全対策を緩めて提供する版です。
| 100万トークンあたり | Claude Fable 5.2 | GPT-6 Astra |
|---|---|---|
| 入力 | $8 | $10 |
| 出力 | $40 | $50 |
| キャッシュ読み取り | $0.20 | $1.00 |
| キャッシュ書き込み | 5分は$10、1時間は$16(cache_control指定時のみ) | 30分は$12.50、12時間は$25(既定で課金) |
| 長い入力 | 100万トークンまで同じ単価 | 入力272K超はリクエスト全体が入力$20/出力$75 |
| Batch | 入力$4/出力$20 | 半額(Flexも半額) |
Fable 5.2の単価はClaude APIの料金表、Astraの通常の単価はOpenAI APIの料金表で、どちらも2026年11月10日時点です。Astraの272K超の単価とBatch・Flexは2026年10月26日時点の同じ料金表の値です。
単価の20%がそのまま費用の20%にならない理由は3つあります。同じ文章でもFableのほうがトークン数を多く数えること、同じ名前の段階でもFableのほうが長く考えて出力が増えること、キャッシュの課金の仕組みが違うことです。順に下の節で数字を出します。Astraの長文やBatchを含めた単価の全体は「GPT-6 Astra API料金:10種類の単価と長文・Batch・Fastの計算方法」にまとめています。
両社のeffortはどう対応するか:同じ名前ではなく同じ点数で比べる
両社とも推論の強さ(effort)をlowからmaxまでの5段階で指定できますが、同じ名前の段階が同じ作業量を意味するわけではありません。Artificial Analysisの総合指数v5.0.1(2026年11月10日時点)で同じ名前どうしを並べると、Fable 5.2は4〜11点高い代わりに、費用は1.39〜4.25倍かかります。比べるなら、点数が近い段階どうしです。
| 推論の強さ | Claude Fable 5.2 | GPT-6 Astra |
|---|---|---|
low | 54点/$3.10/6.5分 | 43点/$1.42/3.8分 |
medium | 56点/$3.80/8.3分 | 52点/$2.73/6.9分 |
high | 62点/$9.08/17.7分 | 55点/$3.24/9.9分 |
xhigh | 62点/$14.83/26.3分 | 55点/$3.66/11.6分 |
max | 65点/$26.54/44.1分 | 57点/$6.24/22.6分 |
値はArtificial AnalysisのGPT-6 AstraとFable 5.2の比較ページの総合指数、指数タスク1件あたりの費用、1件あたりの時間です。費用はFable 5.2を$8/$40、Astraを$10/$50の定価で計算したもので、あなたの請求額ではありません。公開の翌日の数値で、Artificial Analysisは予告なく数値を改訂することがあります。
点数をそろえて読むと、Fable 5.2のmediumはAstra maxより1点低いだけで、費用は39%安く、時間は約3分の1です。Fable lowの54点はAstra highとxhighの55点に1点届きませんが、費用はそれぞれ4%と15%安く、時間も短く済みます。ただしAstra medium(52点)と比べると、Fable lowは2点高い代わりに14%高くなります。52点より下にはAstraのlowしかなく、Fable 5.2で最も安い段階でも$3.10かかります。逆に57点より上はFable 5.2だけの領域で、highの62点はAstra maxの1.46倍の費用で時間は0.78倍、maxの65点は4.25倍の費用です。
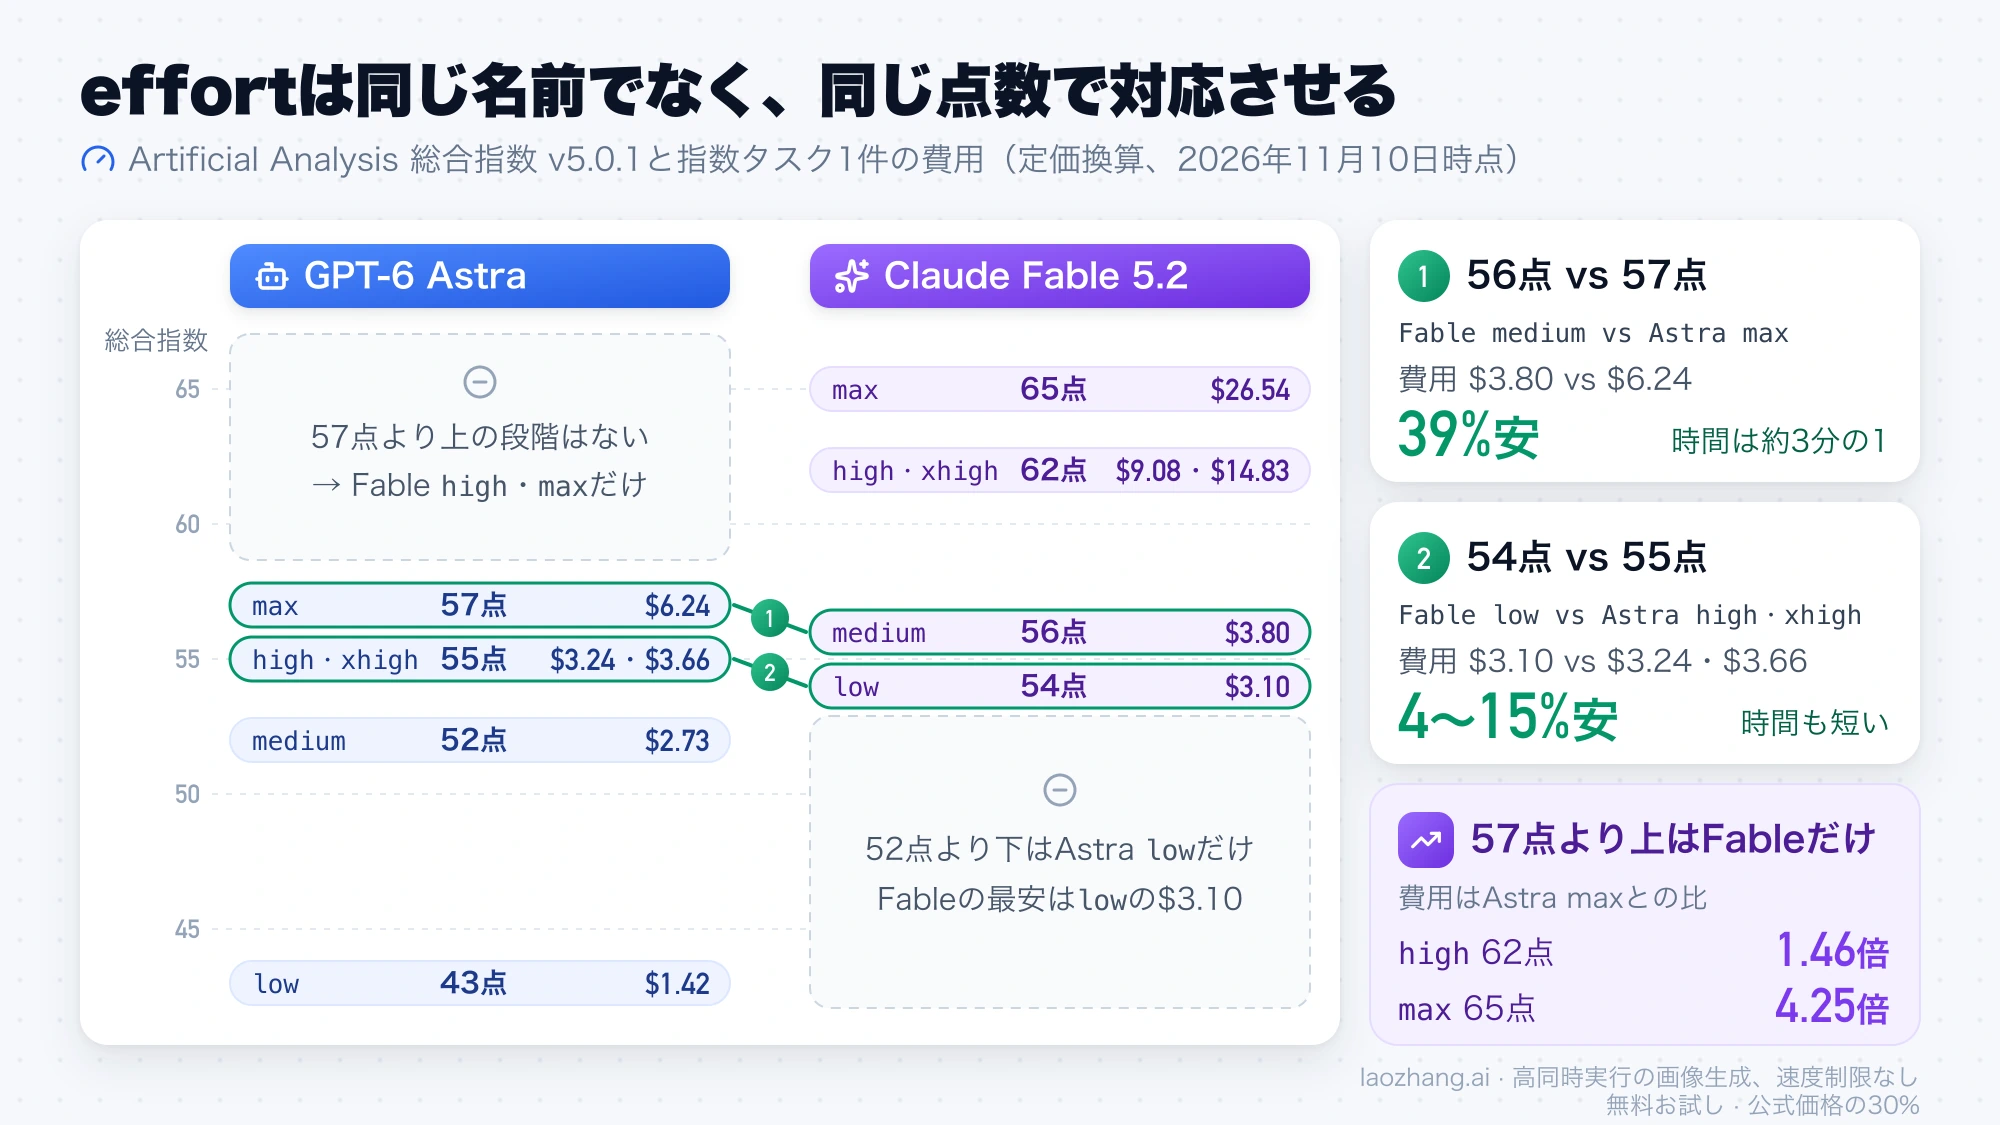
公開当日から、XではFable 5.2とGPT-6 Astraを「両方xhighで」比べた投稿が出ています。同じ表でxhighどうしを見ると、Fable 5.2は62点対55点で7点上ですが、費用は4.05倍、時間は2倍以上です。しかもFable 5.2のxhighは指数の上ではhighと同じ62点で、費用だけが1.63倍になっています。同じ名前どうしの比較は「それぞれを強く回したときの差」を見るには使えますが、どちらが得かの判断には向きません。
既定の段階も揃っていません。Fable 5.2はAPIの既定がhighで、Claude CodeとClaudeアプリではmediumです。Anthropicのeffortの説明は、highから始め、自分の評価で品質が保てるならmediumやlowに下げ、maxはxhighより遅く高いわりに改善が小さいことが多いとしています。GPT-6 AstraはAPIの既定値を公開文書に記載しておらず、Codexでは設定ファイルのmodel_reasoning_effortの値で動きます。「Claude CodeでFableを使ったら」という感想は、多くの場合mediumでの話です。
同じ11問を両方のhighで解かせた結果(2026年11月10日)
2026年11月10日、同じ11問をGPT-6 AstraはCodex CLI、Fable 5.2はClaude Codeで、それぞれhighのまま2回ずつ解かせました。採点した44件はすべて合格で、差が出たのは使ったトークンと費用です。Fable 5.2の出力トークンはAstraの2.49倍、定価換算の費用は1.74倍で、所要時間はほぼ同じでした。
課題は、隠しテストで採点する小さなコーディング4問、6,723語の記事の5項目要約、数式の評価器、CSVの1行パーサー、コードを使わない数え上げ、semverの範囲判定、長い文書に埋もれた3つのメモからの計算、存在しない関数を2つ混ぜた標準ライブラリの質問です。AstraはCodex CLI 0.166.0、Fable 5.2はClaude Code 2.1.317で、どちらもサブスクリプションのアカウントで動かしました。採点用のテストは、どちらかのモデルが答える前に用意したものです。
| 1回あたりの平均 | Fable 5.2(high、Claude Code) | GPT-6 Astra(high、Codex CLI) | Fable÷Astra |
|---|---|---|---|
| 合格 | 22件中22件 | 22件中22件 | — |
| 出力トークン | 24,052 | 9,645 | 2.49倍 |
| うち思考・推論トークン | 8,426 | 1,044 | 8.1倍 |
| 所要時間 | 221.8秒 | 236.0秒 | 0.94倍 |
| 出力の費用 | $0.96 | $0.48 | 2.00倍 |
| コンテキストの費用 | $1.19 | $0.75 | 1.58倍 |
| 合計(定価換算) | $2.15 | $1.24 | 1.74倍 |
費用は使ったトークン数に2026年11月10日時点の定価を掛けた換算額で、Fable 5.2は入力$8、キャッシュ読み取り$0.20、5分のキャッシュ書き込み$10、出力$40、Astraは入力$10、キャッシュ入力$1、出力$50で計算しています。Codexはキャッシュ書き込みを0と報告したため、Astraの書き込み分(APIでは既定で100万トークンあたり$12.50)は入っていません。
同じhighでも、Fable 5.2は思考トークンをAstraの約8倍使いました。出力単価が20%安くても、出力トークンが2.49倍なら出力の費用は約2倍(2.49×0.8)になります。それでも所要時間がほぼ同じだったのは、Fable 5.2のほうがトークンを速く書き出すからです。
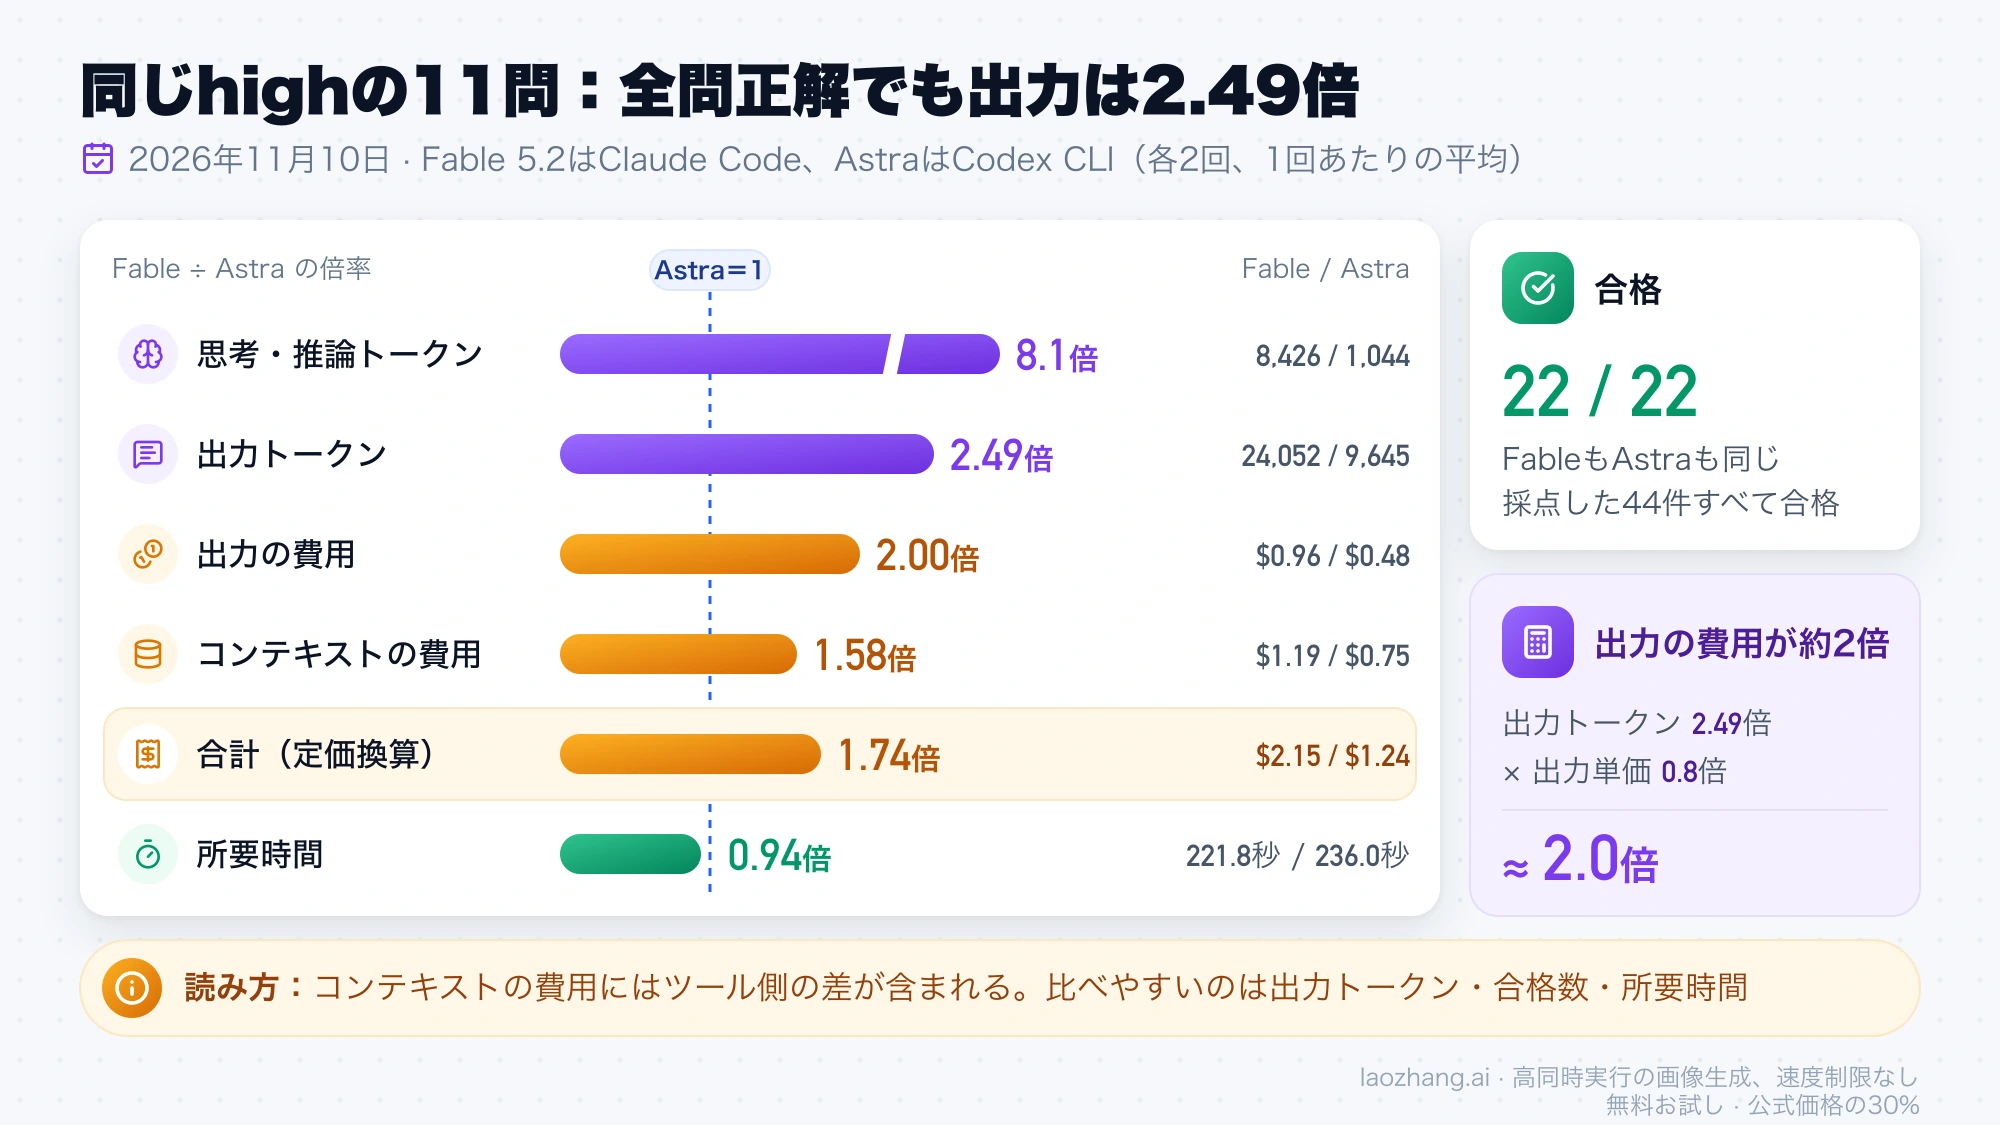
この結果には限界もあります。エージェントが別々なので、コンテキストの費用にはツール側の差が含まれます(Codexは1回の呼び出しで約16Kトークン、Claude Codeは1セッションで約85〜125Kトークンを自前の文脈に使っていました)。比べやすいのは出力トークン、合格数、所要時間のほうです。課題は小さく仕様が明確で、両方が全問解けるため、難しい仕事や長い自律作業での差は分かりません。各モデル2回だけ、段階はhighだけで、Fable 5.2のmediumとlowは試していません。APIを直接呼んだ請求額でもありません。
Artificial Analysisの数字と矛盾するように見えますが、見ている場所が違います。Astra highですでに合格する簡単な仕事では、Fable 5.2が長く考えても得るものがなく、その分だけ高くつきます。Fable 5.2が得になるのは、段階をmediumやlowに下げても品質が保てる場合か、Astra maxでも届かない仕事の場合です。次に試すべきは、自分の課題でのFable 5.2のmediumとlowです。
同じプロンプトなら費用は同じか:日本語の入力はほぼ同額
同じ文章でも、Fable 5.2とGPT-6 Astraでは数えられるトークン数が違うため、単価だけでは費用を比べられません。日本語の文章はFable側で約1.23倍のトークンになり、単価の差と相殺されて、キャッシュなしの入力費用はAstraの約0.98倍とほぼ同額です。英語や韓国語では逆にFableのほうが高くなります。
| 文章の言語 | Fableのトークン数(Astra=1) | キャッシュなしの入力費用(Astra=1) |
|---|---|---|
| 日本語 | 1.23 | 0.98 |
| 英語 | 1.45 | 1.16 |
| 中国語 | 1.50 | 1.20 |
| ロシア語 | 1.56 | 1.25 |
| スペイン語 | 1.88 | 1.50 |
| 韓国語 | 1.90 | 1.52 |
入力費用の比は「トークン数の比×$8÷$10」、つまりトークン数の比の0.8倍です。トークン数は2026年10月26日に同じ文章を両方のAPIに送り、各APIの使用量欄から取った値で、言語ごとに1つの文章(246〜799文字)で測ったため、内容によって比は変わります。計測したのはFable 5.1ですが、AnthropicはFable 5.2も現行の他モデルと同じトークナイザー(Opus 4.7で導入されたもの)を使うと説明しているので、同じ比を当てています。Fable 5.1では単価が同じだったため、入力費用はそのまま1.23〜1.90倍でした。計測の詳細は「GPT-6 AstraとClaude Fable 5.1を比較:料金とトークン実測で選ぶ」にあります。
エージェントのように同じ文脈を何度も読み直す使い方では、キャッシュの差が大きく効きます。キャッシュ読み取りはAstraが100万トークンあたり$1.00、Fable 5.2が$0.20なので、日本語の文章ならAstraのトークン換算で1.23×$0.20=約$0.25、Astraの約4分の1です。一方、最初の書き込みはAstraが既定で自動的に行い30分保持で$12.50、Fable 5.2はリクエストにcache_controlを指定したときだけ行い、5分保持なら日本語換算で1.23×$10=$12.30とほぼ同額です。Fable 5.2で指定を忘れると、毎回キャッシュなしの入力として課金されます。Claude側の設定は「Claudeプロンプトキャッシュの使い方:5分/1時間の損益分岐と実測値」を参照してください。
長い入力では差が開きます。Astraは入力が272Kトークン(Astraの数え方)を超えると、リクエスト全体が入力$20の単価になります。キャッシュなしの日本語の資料がAstraで300Kトークンなら、Astraの入力費用は0.3×$20=$6.00、Fable 5.2では同じ文章が約369Kトークンになり0.369×$8=約$2.95で、約半分です。272K以下ならこの差はなく、上の表の0.98倍に戻ります。
GPT-6 Astraのほうが強い点は残っているか:GDP.pdfとCritPt
残っています。Artificial Analysisの個別評価(2026年11月10日時点)では、GDP.pdfでGPT-6 Astraはどの段階でも30.4〜32.2%と、Fable 5.2の21.4〜26.8%を上回っています。難問の部分集合で測るCritPt v2では、Astraのmedium〜max(70.5〜72.0%)がFable 5.2のlow(60.0%)とmedium(61.5%)を上回ります。
CritPt v2でFable 5.2がAstraを上回るのはhigh(73.0%)、xhigh(73.5%)、max(76.5%)からです。費用を抑えるためにFable 5.2をmediumまで下げると、この種の問題ではAstraより低くなる点に注意が必要です。端末操作のTerminal-Bench 4.0では、Astra xhighの59.6%がFable 5.2のhighとmaxに並び、Fable 5.2が上なのはxhighの61.6%だけです。
差が大きいのはFable 5.2が上の項目です。知識と誤答を測るAA-Omniscience v1.1は63〜67対40〜45、HLE-Diamondはmaxどうしで80.2%対63.8%、FrontierCode 2.0はFable 5.2 highの49.1%に対しAstra maxが42.4%でした。
Anthropicの発表にもGPT-6 Astraとの比較表がありますが、これは当事者の一方が公表した数字です。FrontierCode 2.0で49.1%対42.8%、FrontierSWE v2で69.9%対65.5%、Terminal-Bench-Science 0.1で74.6%対68.1%、Remote Labor Indexで41.3%対20.8%と、載っているすべての項目でFable 5.2が上回っていますが、項目を選んだのもAnthropicです。AnthropicはFrontierCode 2.0で、Fable 5.2のhigh(45.3%)が「ほぼ同じ費用で」Astraの最高点を上回るとも書いています。OpenAIはFable 5.2との比較表を出していません。
どちらが速いか:トークンの生成はFable、1件の時間は段階しだい
トークンを書き出す速さはFable 5.2が上です。Artificial Analysisの計測(2026年11月10日時点)では、Fable 5.2は毎秒87〜103トークン、GPT-6 Astraは毎秒38〜44トークンでした。ただし1件の仕事にかかる時間は、どれだけ考えるかで決まります。
同じ名前の段階では、Fable 5.2のほうが長く考えるため、1件の時間はかえって長くなります。Artificial Analysisの指数タスクではhighで17.7分対9.9分、maxで44.1分対22.6分です。点数をそろえると逆転し、Fable 5.2のmediumは8.3分でAstra maxの22.6分より大幅に短く済みます。2026年11月10日の11問のテストでは、出力が2.5倍でも所要時間はほぼ同じ(Fable 5.2が6%短い)でした。
さらに速さが必要なら、どちらにも割増料金の高速モードがあります。Fable 5.2のspeed: "fast"は出力速度が最大2.5倍で、単価は入力$16/出力$80です。AstraはFastが2倍、Ultrafastが6倍の単価で、UltrafastはResponses APIだけです。Anthropicの「Fable 5.1より最大30%速い」という説明は5.1との比較で、Astraとの比較ではありません。
品質を比べる前に確かめること:どちらかが使えなくなる条件
次の条件に当たる仕事は、性能の比較より先に使えるモデルが決まります。どれも互いに独立した確認項目なので、1つずつ確かめてください。Fable 5.2側の条件はFable 5.2のモデル概要と移行ガイド、Astra側はOpenAIのモデルページとプロンプトキャッシュのガイド(2026年10月26日時点)によります。
- サイバーセキュリティや研究系の生物学を扱う仕事では、Fable 5.2の安全分類器が多くの依頼を止めます。APIでは拒否がHTTP 200と
stop_reason: "refusal"で返り、エラーにはなりません。この分野の能力が要る組織向けには、認証制のMythos 5.2があります。 - データを保持しない契約(ZDR)の組織では、Fable 5.2はAnthropicが個別に認めない限り使えません。30日間の保持がない組織やワークスペースからのリクエストは400
invalid_request_errorになります。 - 既存のコードが
tool_choiceでanyや特定のツールを強制していると、Fable 5.2では400エラーになります。autoとnoneは使えます。 temperature、top_p、top_kを送っている場合は、Fable 5.2では外す必要があります。思考は常に有効で、オフにはできません。- Fable 5.2のレート制限はFable 5.1と別枠です。5.1で上限を引き上げていても、5.2の枠は別に確かめる必要があります。
- Chat Completionsで関数呼び出しを使っている場合、GPT-6 Astraではツールを呼べないため、Responses APIへの移行が先に必要です。
- Astraに272Kトークンを超える入力を送る場合は、リクエスト全体が割増の単価になります。
- Astraはキャッシュ書き込みを既定で行い課金します。不要なら
prompt_cache_options.mode: "explicit"で止められます。データレジデンシーのエンドポイントは10%増しです。 - 外部のゲートウェイ経由で使う場合は、新しいモデルがまだ一覧にないことがあります。2026年11月10日時点で、laozhang.aiのモデル一覧(
GET /v1/models)にはgpt-6-astraとclaude-fable-5-1はありましたが、claude-fable-5-2はありませんでした。使う前にモデル一覧を確認してください。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
Claude CodeとCodexのプランで使う場合
サブスクリプションでは、Fable 5.2は有料プランのみで、Proと標準のTeamシートでは原則として使用量クレジットでの従量課金です(2026年11月10日時点)。GPT-6 AstraはFreeとGoでは使えず、PlusではWorkとCodexで5時間ごとに約5〜45メッセージの目安です(2026年10月26日時点)。
ClaudeのプランごとのFableの扱いによると、Max、Ultra、プレミアムシートではFableは込みですが、週の上限のうちFableに使えるのは最大50%です。Proと標準のTeamシートは、Fable 5.2の公開記念の特典により、2026年11月16日午後11時59分(米国太平洋時間)まで週の上限の50%までFableが込みになります。Fableは既定のモデルにはならないので、Claude Codeでは/model fableで選びます。
ChatGPT側は2026年10月26日時点で、FreeとGoにはGPT-6 Lunaが割り当てられ、PlusとBusinessの標準プランではWorkとCodexでAstraを使えます。Proには5時間の上限がなく、EnterpriseとEduは管理者が有効にする必要があります。Codexではcodex -m gpt-6-astraで指定し、推論の強さはmodel_reasoning_effortで決まります。通常のチャット画面でどのプランがAstraを選べるかは、OpenAIの公開文書に記載がありません。
自分の仕事で確かめる方法と費用の計算式
最終的な判断は、自分の代表的な仕事を両方で解かせ、合格した成果1件あたりの費用で決めます。点数の対応表も11問のテストも、あなたの仕事そのものではないからです。比べる組み合わせは、同じ名前の段階ではなく、点数が近い組にします。
まず代表的な仕事を10〜20件選び、以前に人の手直しが必要だった依頼も含めて、合否の基準を先に決めます。次に、いま使っているAstraの段階と並べて、Fable 5.2をmediumとhighで、新しいセッションに同じ入力を渡して実行します。そのうえでAPIの使用量欄から、入力、キャッシュ読み取り、キャッシュ書き込み、出力(思考・推論を含む)のトークン数を記録し、下の式で費用を出して合格件数で割ります。
費用は100万トークンあたりの単価で、Fable 5.2が「入力×$8+キャッシュ読み取り×$0.20+5分の書き込み×$10+出力×$40」、GPT-6 Astraが「入力×$10+キャッシュ入力×$1+書き込み×$12.50+出力×$50」です。Astraは入力が272Kを超えたリクエストだけ入力$20、出力$75に置き換えます。たとえば11月10日のテストの1回分なら、Fable 5.2は$2.15÷11問≒$0.20、Astraは$1.24÷11問≒$0.11が合格1件あたりの費用です。合格率に差が出る仕事では、失敗1件の手直しにかかる手間も足して比べます。
| 状況 | 普段のモデルと段階 | もう一方へ回す条件 |
|---|---|---|
定型的なコーディングや短い調査で、Astra highの合格率に不満がない | gpt-6-astraのhigh(mediumで足りるならそちら) | Astraで落ちる種類の仕事が見つかったら、その仕事だけFable 5.2 mediumで試す |
Astra maxで回している難しい仕事 | claude-fable-5-2のmedium | 合格率が落ちる種類の仕事はhighに上げるか、Astra maxに戻す |
Astra maxでも失敗が残る難問や、長時間の自律作業 | claude-fable-5-2のhigh | mediumで合格率が保てれば下げる。CritPtのような難問では下げすぎない |
| 件数が多く、とにかく安く回したい | gpt-6-astraのlowかmedium | 点数52より上が必要になったらFable 5.2 lowと比べる |
| 日本語の長い資料をキャッシュして何度も読む | claude-fable-5-2(cache_controlを指定) | 出力が長く思考も多い仕事では、出力の費用を先に確かめる |
| セキュリティ・研究系の生物学、ZDR契約、ツール呼び出しの強制 | gpt-6-astra | Fable 5.2の条件が外れるまでは回さない |
Fable 5.1を使い続けている場合の比較は「GPT-6 AstraとClaude Fable 5.1を比較:料金とトークン実測で選ぶ」が9月時点の条件で扱っています。もっと安いモデルを探しているなら、OpenAI側は「GPT-6.1 Sol・6 Sol・Astra比較:移行の判断」、Claude側は「Claude Fable 5.1とOpus 5.5を比較:普段はどっちを使うべき?」(5.1時点)、中価格帯のClaudeとAstraの組み合わせは「Sonnet 5.5とGPT-6 Astra比較:費用と使い分け」が参考になります。
参考資料9
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年11月10日。
参考資料9
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年11月10日。
- 1.Claude APIの料金表platform.claude.com/docs/en/about-claude/pricing
- 2.OpenAI APIの料金表developers.openai.com/api/docs/pricing
- 3.Artificial AnalysisのGPT-6 AstraとFable 5.2の比較ページartificialanalysis.ai/models/releases/comparisons/gpt-6-astra-vs-claude-fable-5-2
- 4.effortの説明platform.claude.com/docs/en/build-with-claude/effort
- 5.Anthropicの発表anthropic.com/claude-fable-and-mythos-5-2
- 6.Fable 5.2のモデル概要platform.claude.com/docs/en/models/fable-5-2/overview
- 7.移行ガイドplatform.claude.com/docs/en/models/fable-5-2/migration-guide
- 8.プランごとのFableの扱いsupport.claude.com/en/articles/15424964
- 9.Fable 5.2の公開記念の特典support.claude.com/en/articles/17506494