Sonnet 5.5とOpus 5.5の使い分け:半額が効く仕事
Sonnet 5.5の単価はOpus 5.5の半額でも、maxではタスク単価が並びます。範囲が明確な作業はSonnetをmedium以下、判断の要る作業はOpusで。
目次
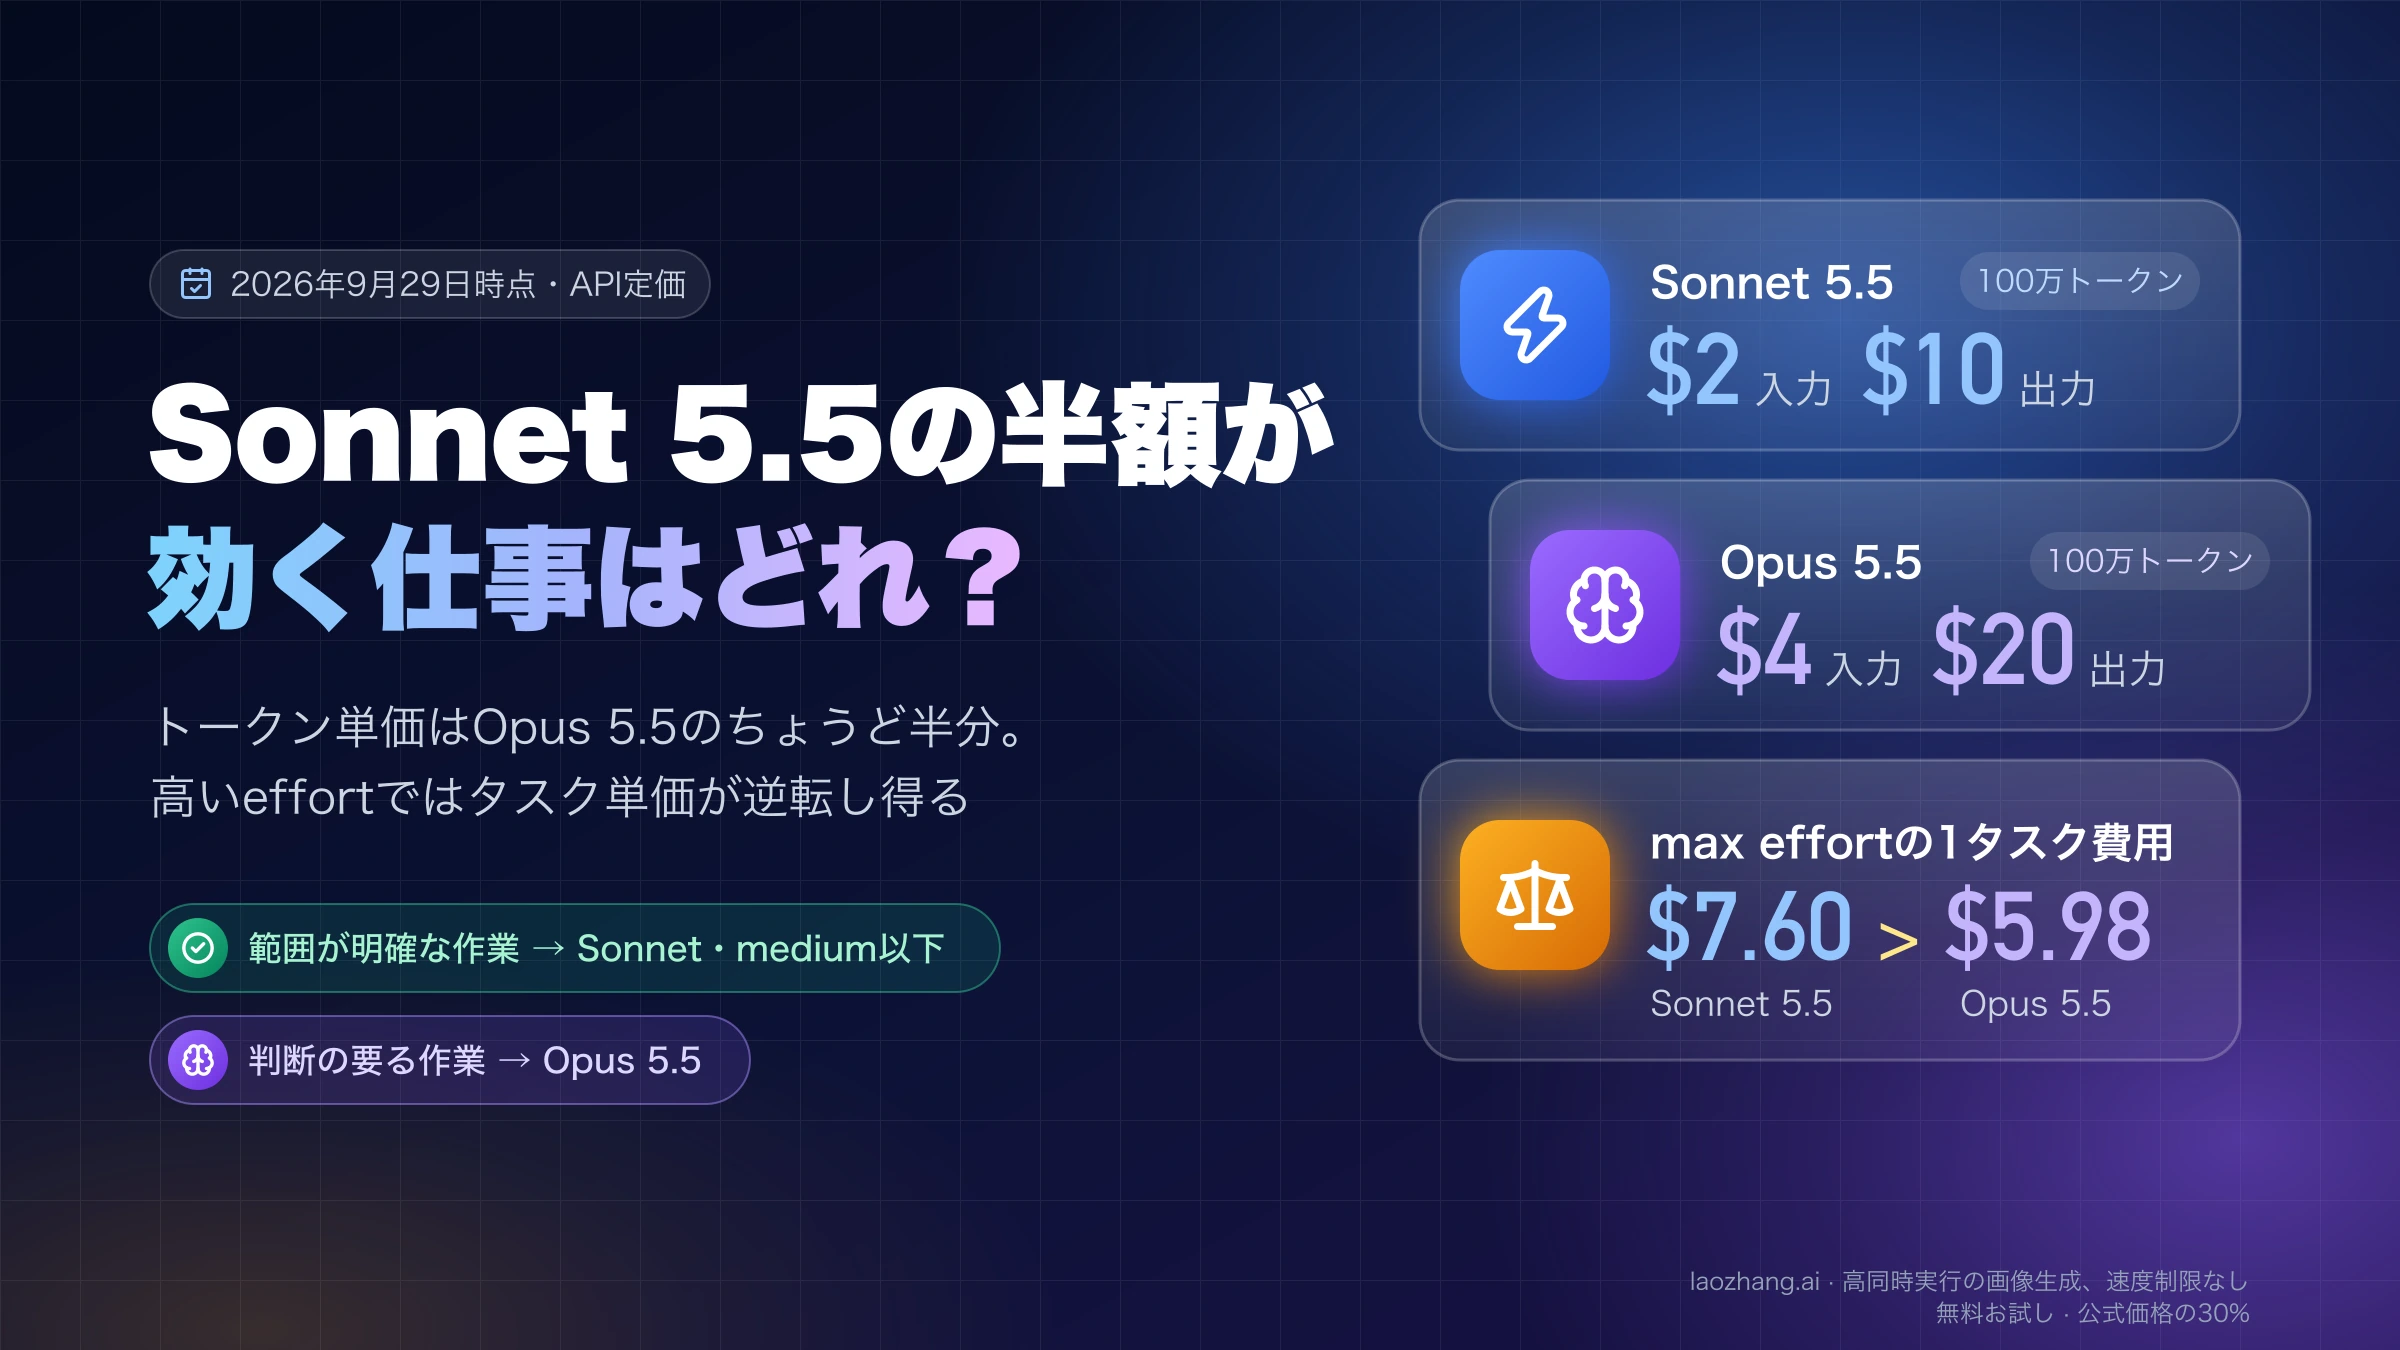
Claude Sonnet 5.5は2026年9月28日に公開されました。API定価は100万トークンあたり入力$2・出力$10で、6日前に出たOpus 5.5(入力$4・出力$20)のちょうど半分です。AnthropicはSonnet 5.5の発表で、Opus 5.5を慎重な判断を要する複雑な作業向け、Sonnet 5.5を範囲が明確な日常のタスクやバグ修正、文書・スライド・表計算の作成に強いモデルと位置づけ、Opus 5.5を補う「より速く安い」選択肢だと説明しています。
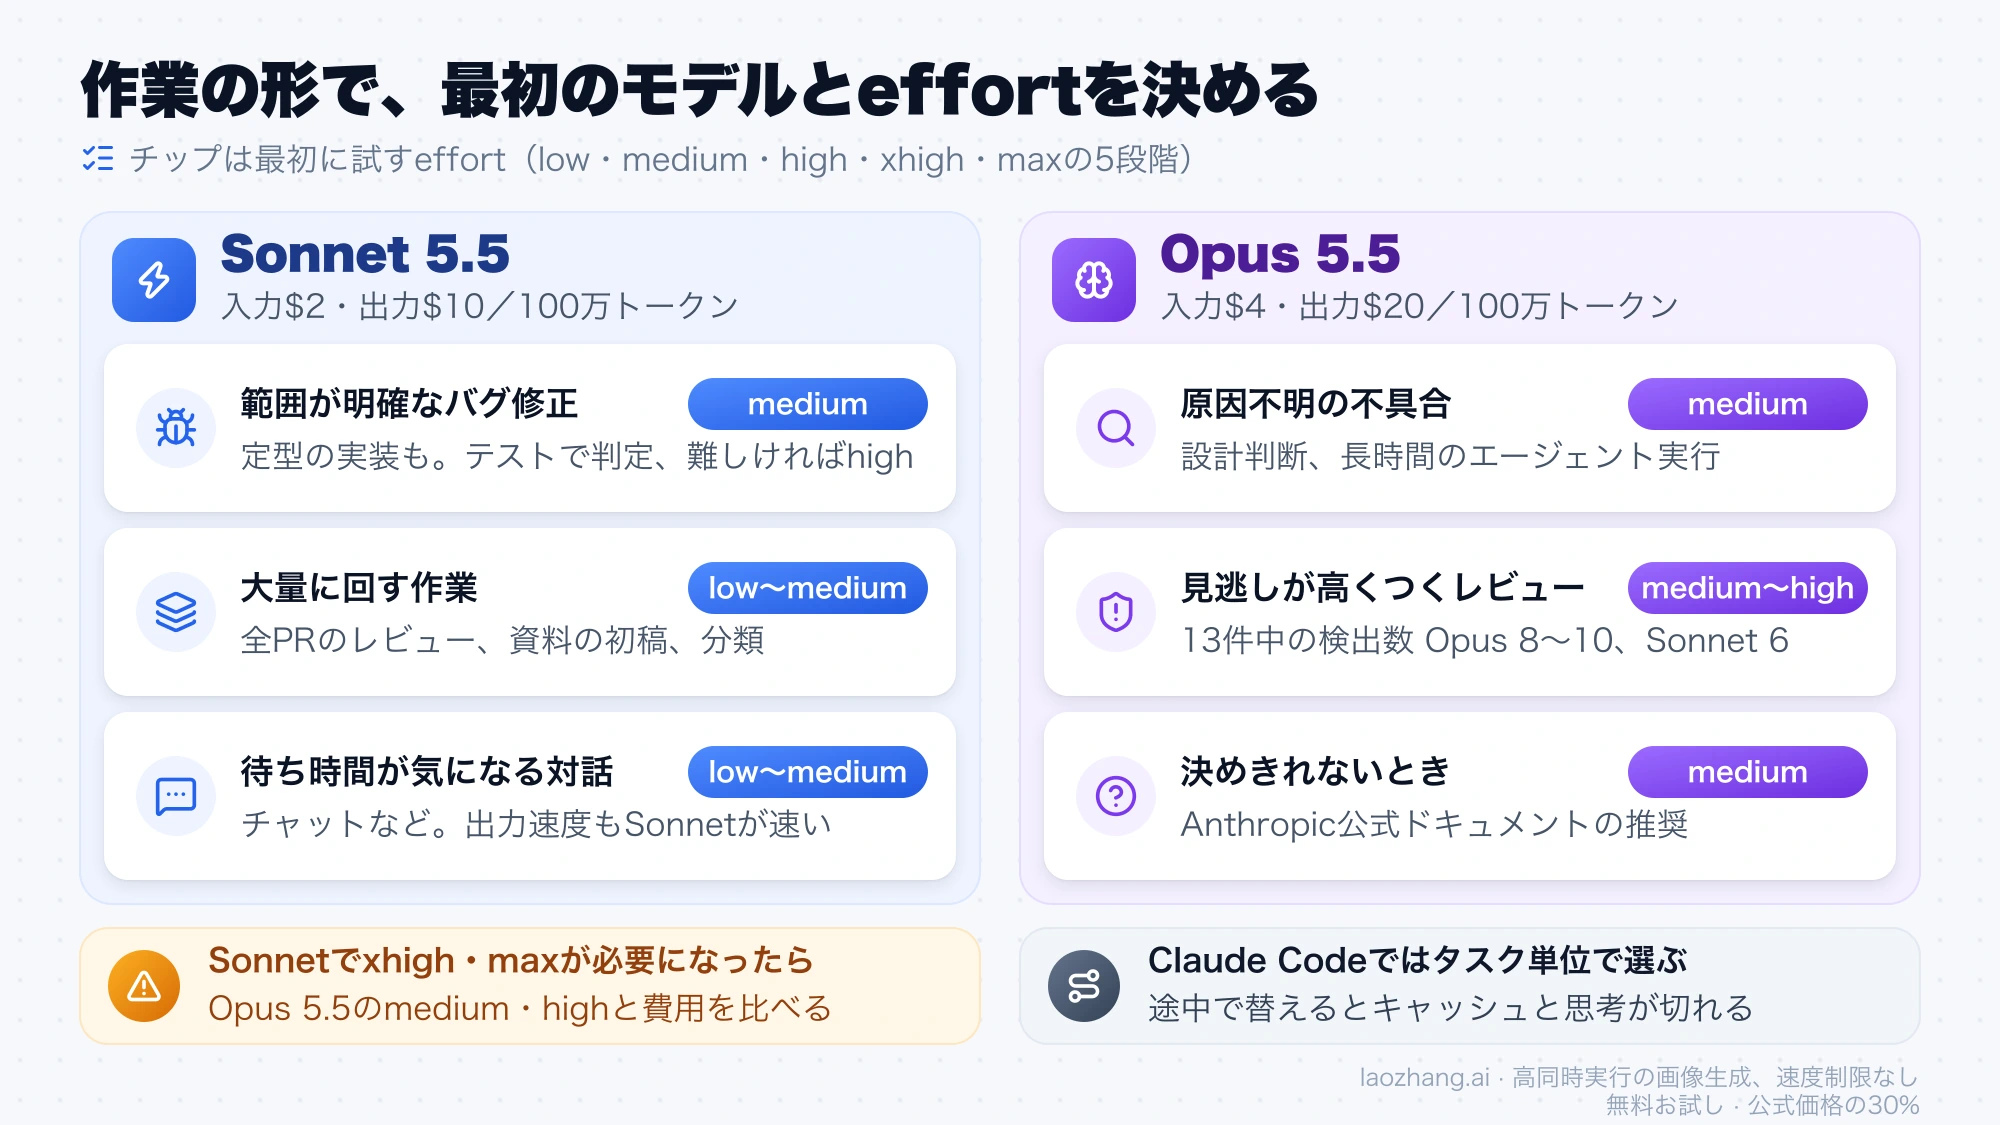
使い分けの答えを先に書くと、範囲がはっきりしていて結果をテストなどで確かめられる作業、大量に回す作業、待ち時間を短くしたい対話はSonnet 5.5をmedium以下のeffortで使います。原因や終わりが見えない作業、長時間のエージェント実行、見逃しが高くつくレビューはOpus 5.5を既定のmediumから使います。どちらか決めきれないときは、Anthropicのモデル一覧の推奨どおりOpus 5.5から始めます。
ただし「半額」はトークン単価の話です。1つの作業に使うトークン数やターン数が増えれば、タスク単価の差は縮み、逆転もします。第三者機関Artificial Analysisの総合指数v5.0(9種類の評価。2026年10月27〜28日に旧版v4.3.2から切り替え)では、max effortでの1タスクあたりの費用がSonnet 5.5の$10.02に対してOpus 5.5が$10.04とほぼ同じで、点数はSonnetが4点低くなっています(54点と58点)。xhigh以上が必要な作業では、Opus 5.5を1段低いeffortで動かしたほうが安く、点数も高くなります。Anthropic自身も、Sonnet 5.5がOpus 5.5より安く済むのはlowやmediumといった低めのeffortのときで、高い設定では同程度の性能を「同程度のコスト」で出す、と書いています。
作業の形でモデルとeffortの初期値を決める
effortは、モデルがどれだけ考え、ツールを呼び、自分の作業を見直すかを決める設定で、low・medium・high・xhigh・maxの5段階があります。Claudeのプラン名にもMaxがありますが、ここでのmaxはeffortの最上段のことです。
| 作業の形 | 最初に試すモデル | effortの目安 | 根拠 |
|---|---|---|---|
| 範囲が明確なバグ修正、定型の実装やリファクタ(テストで合否がわかる) | Sonnet 5.5 | medium、難しければhigh | Anthropicは、仕様が明確なエージェント型コーディングはmedium、難しい・長い作業はhighから始めるよう案内 |
| 全プルリクエストのレビュー、資料の初稿、分類など大量に回す作業 | Sonnet 5.5 | low〜medium | 低いeffortほどSonnetのタスク単価の優位が出やすい(Anthropic) |
| チャットなど待ち時間が気になる対話 | Sonnet 5.5 | low〜medium | 同上の案内。出力速度もSonnetが速い |
| 原因不明の不具合、設計判断、長時間のエージェント実行 | Opus 5.5 | medium(既定)、足りなければhigh | 持続的な判断を要する複雑で終わりの見えない作業はOpusが明確に強い(Anthropic) |
| 見逃しが高くつく変更のレビュー | Opus 5.5 | medium〜high | CodeRabbitの難しい13件で、Opus 5.5は8〜10件、Sonnet 5.5は6件を検出 |
| どちらとも言えない | Opus 5.5 | medium | Anthropicの公式ドキュメントの推奨 |
この表を使うときの目安が2つあります。1つは、Sonnet 5.5でxhighやmaxが必要になった作業は、Opus 5.5をmediumかhighで回した場合と費用を比べてから決めることです。高いeffortのSonnetは、安さの根拠が薄れます。Artificial Analysisの指数v5.0では、Opus 5.5のhigh(52点、$3.46)がSonnet 5.5のxhigh(50点、$4.09)を点数・費用・処理時間のすべてで上回ります。もう1つは、Opus 5.5のhighでも足りない作業は、Sonnetとの比較ではなく上位モデルへの切り替えを検討する段階だということです。その判断の材料はClaude Fable 5.2とOpus 5.5の違い:同じ正解数で費用1.86倍にあります。
両方を行き来する価値が大きいのは、作業の形が混ざっていて量も多いAPI利用です。Claude Codeで1人が使う場合は、会話の途中で頻繁に切り替えるより、タスクごとにどちらで始めるかを決めるほうが扱いやすくなります。理由は、後半で説明するキャッシュと思考ブロックの扱いです。
料金表では半額、タスク単価では逆転もある理由
API定価(米ドル、100万トークンあたり、2026年10月28日時点、Anthropicの料金ページ)は次のとおりです。
| 項目 | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| 入力 | $2 | $4 |
| 出力 | $10 | $20 |
| キャッシュ書き込み(5分) | $2.50 | $5 |
| キャッシュ書き込み(1時間) | $4 | $8 |
| キャッシュ読み取り | $0.10 | $0.20 |
| バッチ処理(入力/出力) | $1/$5 | $2/$10 |
どちらも100万トークンのコンテキストを持ち、長い入力でも割増料金はありません。Sonnet 5.5の入力・出力・キャッシュ書き込みの料金はSonnet 5と同じで(キャッシュ読み取りはSonnet 5が$0.20のまま)、Sonnet 5の料金の経緯はClaude Sonnet 5の値上げは撤回。現在のAPI料金と予算の見直し方が参考になります。Opus 5.5側の請求とサブスクリプションの上限についてはClaude Opus 5.5の料金と上限リセット権:API単価、使える枠、確認手順が詳しいです。
キャッシュ読み取りは2026年10月7日にSonnet 5.5が$0.20から$0.10に下がり、Opus 5.5と同じく入力単価の5%(Fable 5.1は2.5%、ほかの多くのモデルは10%)になりました(Claude Sonnet 5.5のキャッシュ読み取り料金は$0.10:削減率の求め方)。これでSonnet 5.5は、表のすべての項目でOpus 5.5のちょうど半額です。
Sonnet 5.5は何倍のトークンまで安いままか
1ターンの費用は、次の式で出せます。
1ターンの費用(米ドル)=(キャッシュ読み取り × キャッシュ読み取り単価 + 新規入力 × 入力単価 + 出力 × 出力単価)÷ 1,000,000同じトークン数で両モデルの費用を計算し、Sonnet 5.5が同じ作業にその何倍までトークン(またはターン)を使ってもOpus 5.5より安いままかを出したのが下の表です。トークンの構成は説明用の仮定で、実際の請求を測ったものではありません。
| 1ターンの想定 | Opus 5.5 | Sonnet 5.5 | Sonnetが安いままの上限 |
|---|---|---|---|
| ツールを回すエージェント:キャッシュ読み取り100k、新規入力5k、出力6k | $0.160 | $0.080 | 2.0倍 |
| キャッシュなし:入力5k、出力6k | $0.140 | $0.070 | 2.0倍 |
| 長い文脈をキャッシュから読み直す:キャッシュ読み取り500k、新規入力2k、出力3k | $0.168 | $0.084 | 2.0倍 |
キャッシュ読み取りを含むすべての単価がちょうど半額なので、トークンの内訳によらず上限は次の1行にまとまります。
Sonnet 5.5が安いままでいられる倍率 = Opus 5.5の費用 ÷ Sonnet 5.5の費用 = 2Sonnet 5.5が同じ作業にOpus 5.5の2倍を超えるトークン(またはターン)を使うと、Opus 5.5より高くなります。キャッシュ読み取りが両モデル$0.20で同額だった2026年10月6日までは、大きなリポジトリや長い資料を毎ターン読み直す作業ほど上限が下がり、3行目の想定では約1.25倍でした。値下げ後はこの差がなくなっています。
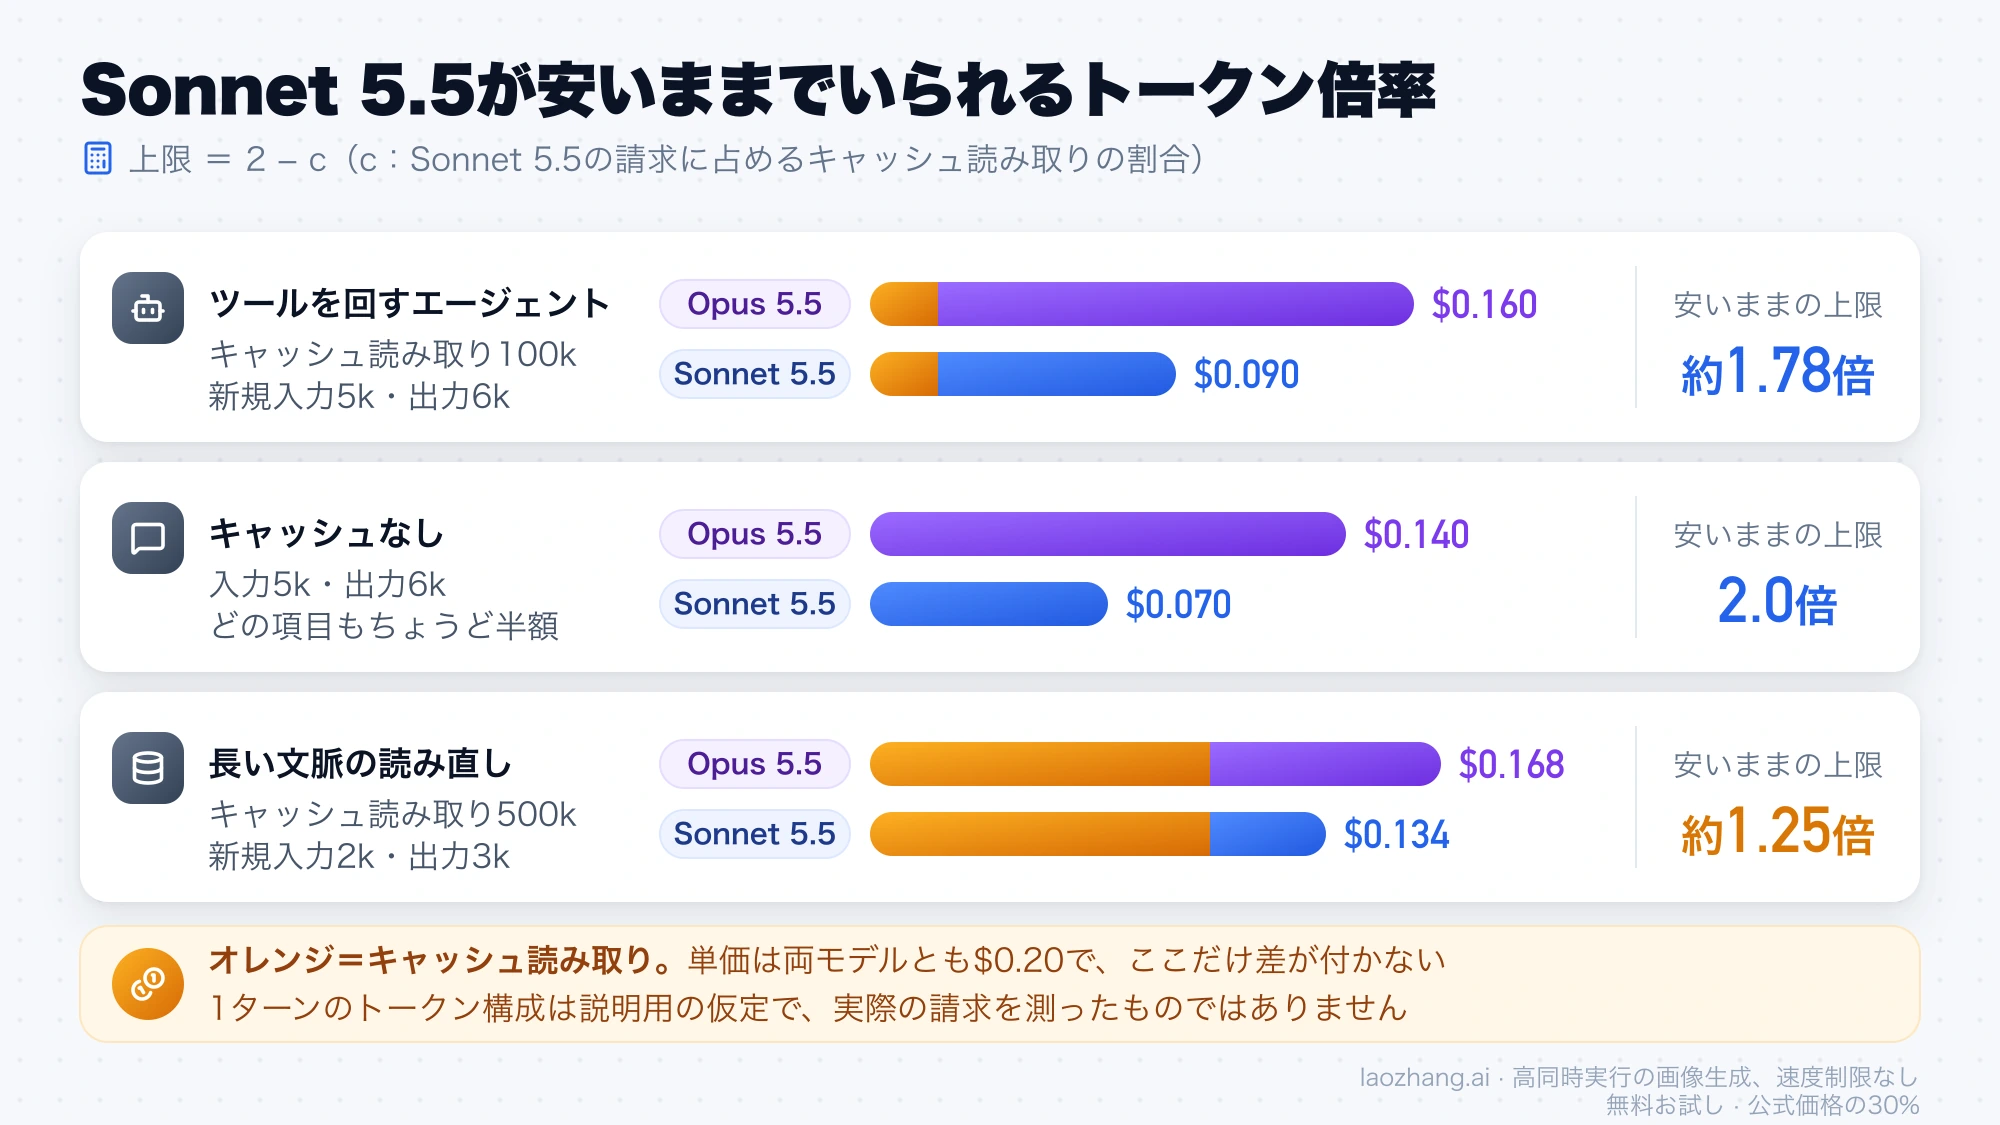
図は2026年10月7日の値下げ前のキャッシュ読み取り料金(両モデル$0.20)で計算したものです。2026年10月28日時点の料金では、Sonnet 5.5の費用はどの想定でも$0.080、$0.070、$0.084で、上限は一律2倍です。
Artificial Analysisの指数v5.0(2026年10月28日時点)では、5段階すべてのeffortについて点数、指数のタスク1件あたりの費用(全評価を定価で1回実行した費用をタスク当たりに割ったもの)、タスク1件あたりの処理時間が公開されています。
| effort | Sonnet 5.5 | Opus 5.5 | Sonnet÷Opusのタスク単価 |
|---|---|---|---|
| low | 25点/$0.51/121秒 | 35点/$0.98/147秒 | 0.52 |
| medium | 30点/$0.78/178秒 | 48点/$2.45/337秒 | 0.32 |
| high | 41点/$1.64/332秒 | 52点/$3.46/464秒 | 0.47 |
| xhigh | 50点/$4.09/691秒 | 57点/$6.05/779秒 | 0.68 |
| max | 54点/$10.02/1,326秒 | 58点/$10.04/1,133秒 | 1.00 |
同じeffort同士なら、Sonnet 5.5のタスク単価はhigh以下でOpus 5.5の約3〜5割、xhighで約7割、maxではほぼ同じです。点数を合わせて見ると、Opus 5.5のhigh(52点、$3.46、464秒)はSonnet 5.5のxhigh(50点、$4.09、691秒)を点数・費用・時間のすべてで上回り、Opus 5.5のxhigh(57点、$6.05)もSonnet 5.5のmax(54点、$10.02)より高得点で安く済みます。出力速度はmaxで毎秒140トークンと98トークンでSonnetのほうが速いものの、maxのSonnetは考える量が多く、1タスクの時間はOpusより長くかかります。
effortをまたいだ組み合わせでは、Sonnet 5.5のhigh(41点、$1.64)はOpus 5.5のlow(35点、$0.98)より6点高く、費用は約1.7倍です。Opus 5.5のmedium(48点、$2.45)はSonnet 5.5のhighより7点高く、費用は約1.5倍で、処理時間はほぼ同じ(337秒と332秒)です。Sonnet 5.5のmedium(30点、$0.78)とOpus 5.5のlow(35点、$0.98)では、Opusのlowが5点高く、費用は約1.26倍です。
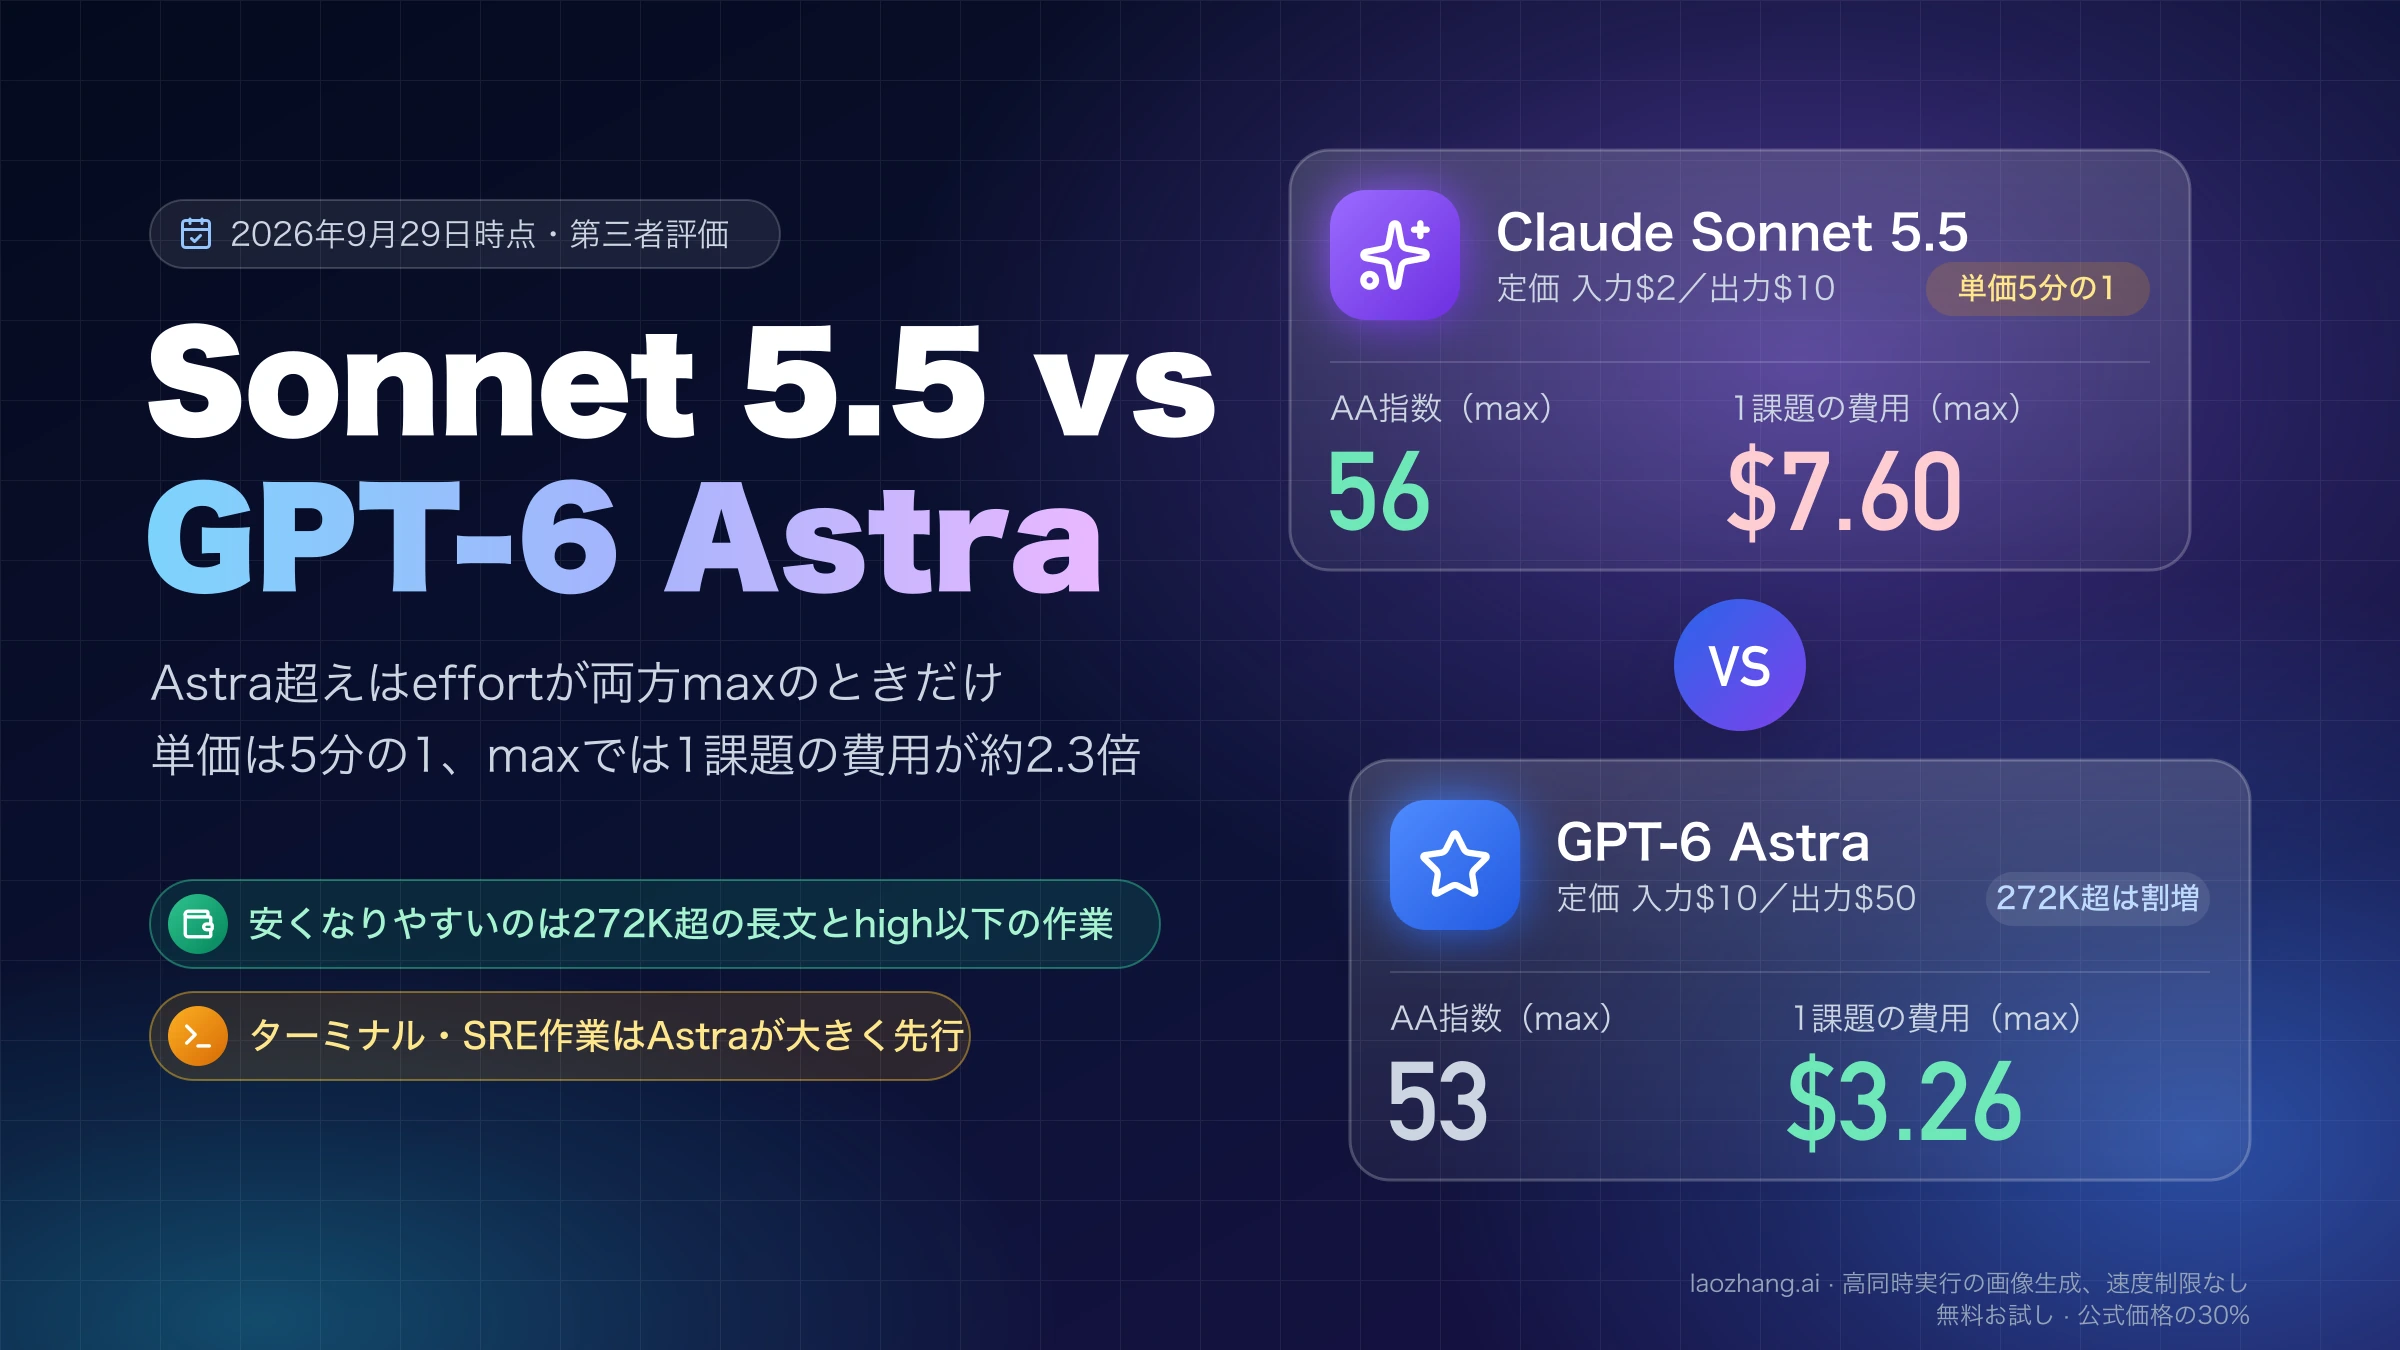
旧指数v4.3.2(2026年9月29日時点、max effortのみ)ではSonnet 5.5が1タスク$7.60、Opus 5.5が$5.98でしたが、Sonnetのキャッシュ読み取り値下げ前の料金で、評価の構成も違うため、v5.0の数字とは比べられません。Anthropicが公表している「低いeffortならSonnetのほうがタスクあたり安い」という結論は、元のグラフが画像で数値の表はありませんが、上の表の傾向と合っています。ただしAAの数字は評価用タスクでの費用で、あなたの請求額ではありません。自分の用途でどちらが安いかは、最後の節の方法で小さく測るのが確実です。
APIでは既定のeffortがそろっていない
APIでeffortを指定しないと、Sonnet 5.5はhigh、Opus 5.5はmediumで動きます。モデルIDだけを差し替えて比べると、多く考える設定のSonnetと、控えめな設定のOpusを比べることになり、Sonnetの半額の効果が見かけより小さく出ます。比較するときは両方に同じeffortを明示します。
Claude CodeとClaudeアプリでは、Sonnet 5.5の既定はmediumです。Claude Codeのドキュメントでは、Opus 5.5とSonnet 5.5はどちらも既定がmediumで、ほかの多くのモデルの既定はhighとされています。どちらのモデルでも、以前のモデルのeffort設定をそのまま持ち込まないよう求められています。Sonnet 5.5はSonnet 5から各effortでの考える量が調整し直されており、Opus 5.5は同じeffortでもOpus 5より1ターンに多く考える傾向があるためです。
ベンチマークで見る性能差:どこが近く、どこで開くか
以下の数値は、Anthropicの公表値と第三者(Artificial Analysis、CodeRabbit)の計測で、条件はそれぞれに添えます。まずAnthropicがSonnet 5.5の発表で示した比較です。
| 評価 | Sonnet 5.5 | Opus 5.5 | 条件など |
|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 66.4% | Opusはxhighの値(同モデルの最高値) |
| FrontierCode 1.1 (Main) | 46.2%(max)/52.1%(xhigh) | 54.4% | Sonnetはmaxのほうが低い。Claude Codeのコードレビュー用スキルを多用し、タイムアウトや範囲外の編集が増えたため |
| CursorBench 4.0 | 55.5% | 57.8% | Sonnetの最高値はOpusの約2ポイント下 |
| GDPval-AA v2.1 | 1844 | 1846 | 実務タスクの評価 |
| AA-Briefcase v1.1 | 1811 | 1822 | 長時間の知的作業。AAが10月28日に公開したv5.0のmax同士ではSonnet 1812、Opus 1800と順位が逆 |
| Humanity's Last Exam(ツールあり) | 64.5% | 67.7% | |
| OSWorld 2.1 (partial) | 80.1% | 81.8% | コンピューター操作 |
| Chartography(ツールなし) | 61.6% | 64.4% | グラフの読み取り |
多くはmax effortでの値です。GDPval-AAとAA-BriefcaseはArtificial Analysisが公開前の環境で実行したもので、その後修正された構造化出力の不具合があったと注記されています。GDPval-AAとHumanity's Last ExamはArtificial Analysisの旧指数v4.3.2に含まれていた評価で、2026年10月28日時点の指数v5.0には入っていません。Opus 5.5の既定(medium)での値はFrontierCodeが54.6%、CursorBenchが52.5%と別に公表されていますが、表のSonnet 5.5の55.5%は既定のeffortの値ではありません。55.5%と52.5%を並べて「SonnetがOpusを上回る」とは読めません。
「コーディングでSonnetはOpusに勝つのか」への答えは、評価によって分かれます。Terminal-Bench 4.0ではSonnet 5.5が上回り、ほかの項目は1〜3ポイントほど下です。Anthropic自身も、複数の評価でmax effortのSonnet 5.5はOpus 5.5に近い性能を出すとしつつ、複雑で終わりのない、持続的な判断を要する作業ではOpus 5.5が明確に強いと書いています。
その差がはっきり出たのが、CodeRabbitのコードレビューの計測です。オープンソースの実際のプルリクエストから選んだ難しい13件で、既知の問題を指摘できた件数と、指摘の的中率は次のとおりでした。
| 構成 | 検出できた件数 | 指摘の的中率 |
|---|---|---|
| Opus 5.5(Max) | 10/13(76.9%) | 52.0% |
| Opus 5.5(Standard) | 8/13(61.5%) | 66.7% |
| Sonnet 5.5(思考あり) | 6/13(46.2%) | 41.2% |
| Sonnet 5.5(思考なし) | 5/13(38.5%) | 38.5% |
| Sonnet 5 | 4/13(30.8%) | 40.0% |
Opus 5.5の数値は同じ13件を使った9月の計測からの引用です。Sonnet 5.5のレビュー1件あたりのClaude呼び出し費用は定価換算で$0.46〜0.47で、Sonnet 5の$1.16より大きく下がりました。CodeRabbit自身も、13件は傾向を見るには足りるが結論を出すには足りないと書いています。同じくCodeRabbitがClaude Codeで同じ長い指示を並走させた試行では、Sonnet 5.5が29分27秒、Opus 5.5が44分50秒で終わり、仕上がりはほぼ同じで、忠実さはOpus 5.5がわずかに上でした。これは1回だけの試行です。
まとめると、Sonnet 5.5は多くの作業でOpus 5.5の近くまで届き、速く終わります。差が開くのは、難しいレビューのように見逃し1件が重い作業です。
Claude Codeでモデルとeffortを切り替える
モデルの切り替えは3通りあります(Claude Codeのモデル設定のヘルプ)。
- セッション中に
/modelを実行し、メニューから選ぶ(すぐ反映) claude --model claude-sonnet-5-5のように、起動時にそのセッションだけ指定する- シェルの設定ファイルに
export ANTHROPIC_MODEL="claude-sonnet-5-5"を書き、以後の既定にする
いま動いているモデルは/statusで確認できます。
effortの変え方はClaude Codeのドキュメントに次のように書かれています。
/effort:引数なしでスライダーを開く。/effort mediumのように段階名を付けると直接設定、/effort autoで保存した値を消す/modelのメニュー:モデルを選ぶときに左右キーでeffortを調整するclaude --effort high:そのセッションだけ指定する- 環境変数
CLAUDE_CODE_EFFORT_LEVEL:段階名かautoを指定する
/effortのスライダーや/modelのメニューでEnterを押すと、その値がモデルごとの既定として保存されます。sキーならそのセッションだけに適用されます(v2.1.257以降)。maxは設定ファイルには書けず、/effortで選んだ場合はそのセッションだけに適用されます。また、ユーザー設定の最上位にある古い形式のeffortLevelはOpus 5.5以降のモデルには効かず、Opus 5.5とSonnet 5.5は、/effortか/modelで選ぶまでそれぞれの既定値(medium)で始まります。
クラウド経由で使う場合は、sonnetやopusという別名に注意が必要です。Anthropic APIではsonnetがSonnet 5.5、opusがOpus 5.5を指しますが、Amazon BedrockやGoogle CloudではsonnetがSonnet 4.5、Claude Platform on AWSではSonnet 4.6、Microsoft FoundryではopusがOpus 4.6を指します。別名のままだと、Sonnet 5.5を使っているつもりで旧モデルが動くことがあるので、claude-sonnet-5-5(またはそのクラウドでのモデルID)を明示し、/statusで確かめます。
途中で切り替えると、キャッシュも前の思考も引き継がれない
Claude Codeでは、プロンプトキャッシュがモデルごとに分かれています。セッションの途中で/modelを使ってモデルを変えると、次のリクエストは会話全体をキャッシュなしで読み直します。キャッシュが有効な間は、Claude Codeが切り替えてよいか確認を求めます。会話が長いほど、この読み直しの費用は大きくなります。一方、Opus 5.5やSonnet 5.5のままeffortだけを変える場合は、APIキーかClaudeのサブスクリプションで使っていればキャッシュは保たれ、確認なしで反映されます。BedrockとGoogle Cloud経由はこの扱いの対象外です(Claude Codeのプロンプトキャッシュの説明)。
推論の中身も引き継がれません。APIのドキュメントによると、Sonnet 5.5はOpus 5やOpus 5.5の思考ブロックを読めず、Sonnet 5.5の思考ブロックを読めるモデルはほかにありません。読めないブロックは、リクエストは成功したまま、モデルに渡る前に捨てられます(その分の課金はありません)。会話の途中でOpus 5.5からSonnet 5.5へ、またはその逆へ切り替えると、切り替え後のターンはそれまでの推論なしで進みます。Claude Codeの/modelにも同じ規則が当てはまると考えられますが、Claude Codeのドキュメントにこの点の明記はありません。
そのため、1つの作業の中ではeffortで調整し、モデルはタスクの区切りで切り替えるのが安全です。たとえば調査と設計をOpus 5.5で終えたら、その結論をファイルやタスクの説明にまとめ、新しいセッションでclaude --model claude-sonnet-5-5から実装を始めます。
計画はOpus、実装はSonnetという分担は、別名opusplanでも指定できます。プランモードの間はopus、実行に移るとsonnetを使う設定です。ただしsonnetの解決規則は上と同じなので、BedrockやGoogle Cloudでは実装側がSonnet 4.5になります。5.5世代の2モデルでopusplanを使ったときの費用の計測は公開されていません。
プランとアプリでの扱い
Claudeの料金ページ(米国版、2026年9月29日時点)の表では、無料プランで使えるのはSonnetとHaikuで、Opusは使えません。表にバージョンの記載はありませんが、現行のSonnetはSonnet 5.5です。Opusを使えるのはPro(月$20、年払いなら月$17相当)とMax(月$100から)で、Claude CodeもProから含まれます。Claude Codeを軸にしたプラン選びはClaude ProとMaxを比較 2026年版:料金、Claude Code制限、Maxの損益分岐点を参照してください。
Claudeアプリでは、安全上の分類器が反応すると別のモデルに自動で切り替わることがあります(Sonnet 5.5のヘルプ)。
- Sonnet 5.5:エクスプロイトの作成、バイナリを対象にした脆弱性スキャン、侵入テストといった攻撃寄りのサイバーセキュリティの依頼や、一部の先端LLM開発の依頼(特定のアクセラレーター向けカーネル開発など)はSonnet 5に切り替わります。生物学の危険な依頼と、内部の推論を書き出させる依頼は切り替えではなく拒否されます
- Opus 5.5:サイバーセキュリティではOpus 4.8、生物学の両用途の依頼と先端LLM開発ではOpus 5に切り替わります
切り替わった会話はその後も切り替え先のモデルのままなので、モデル選択メニューから戻します。ソースコードの脆弱性を調べるような通常のセキュアコーディングは、どちらのモデルでもそのまま使えます。分類器はメモリー、コネクタの内容、検索結果、ファイルも読むため、自分で入力していない内容がきっかけになることもあります。
APIでモデルIDを差し替える前に確認すること
Sonnet 5.5とOpus 5.5はAPIの挙動が同じではありません。Sonnet 5やOpus 5から移るとき、また2つのモデルを切り替えて使うときに引っかかる点を並べます(AnthropicのSonnet 5.5の変更点とOpus 5.5の変更点、2026年9月29日時点)。
| 項目 | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| モデルID | claude-sonnet-5-5(Bedrockはanthropic.claude-sonnet-5-5) | claude-opus-5-5(Bedrockはanthropic.claude-opus-5-5) |
| API既定のeffort | high | medium |
| 事前の思考を止める | thinking: {"type": "between_tools"}(low〜highのみ。xhigh・maxでは400エラー) | 止められない。effortを下げて調整する |
thinkingのdisabledとbudget_tokens指定 | 400エラー | 400エラー |
temperature・top_p・top_kの既定外の値 | 400エラー | 400エラー |
強制ツール呼び出し(tool_choiceのany・tool) | 400エラー。autoとstrict tool use、または構造化出力に置き換え | 同左 |
computer_20251124 | Claude APIとGoogle Cloudでは400エラー。computer_toolset_20260801へ(Bedrockは旧ツールも可) | 同左 |
| ツール呼び出しの合間のテキスト | thinkingブロックで返る。既定のdisplay: "omitted"では空になり、UIが無言になる | 同左 |
| fast mode | なし | あり($8/$40、Claude API・Google Cloud・Microsoft Foundry) |
| 読める思考ブロック | Sonnet 5、Opus 4.8、Haiku 4.5以前。Opus 5・Opus 5.5のものは読めない | Opus 5以前のOpus・Sonnet・Haiku。Sonnet 5.5のものは読めない |
| advisorツール(ベータ) | 実行役としてOpus 5.5を助言役に指定できる。Opus 4.8・Opus 4.7・Sonnet 5の助言役は400エラー | ― |
特に見落としやすいのは3点です。1つ目は、Sonnet 5で思考をオフにしていたコードはdisabledがエラーになるのでbetween_toolsに変えること。ただしbetween_toolsではeffortをhigh以下にし、会話の途中でメッセージ単位のeffortを変えることもできません。2つ目は、ツール呼び出しの合間の進捗メッセージをユーザーに見せているアプリが、エラーも出さずに黙ってしまうことです。adaptive thinkingを使うならthinking.displayに"summarized"を指定し、between_toolsならそのままテキストが返ります。3つ目は、2026年8月31日以降に作成したアカウントでは、思考ブロックより前の履歴(system、tools、過去のメッセージ)を編集してから送り直すと400エラーになることです。会話は追記のみにし、指示やツールの変更は会話途中のsystemメッセージで行います。
リクエスト側は、比較のためにeffortを必ず明示します。
import anthropic

client = anthropic.Anthropic()

resp = client.messages.create(
    model="claude-sonnet-5-5",           # Opus 5.5なら "claude-opus-5-5"
    max_tokens=16000,                    # 思考と本文を合わせた上限。高いeffortほど余裕を持たせる
    output_config={"effort": "medium"},  # 省略時はSonnet 5.5がhigh、Opus 5.5がmedium
    messages=[{"role": "user", "content": "このテストが落ちる原因を調べて修正案を出してください。"}],
)
print(resp.usage)
APIを直接使う場合、トップレベルのeffortを会話の途中で変えるとプロンプトキャッシュが無効になります(Anthropicのeffortの説明)。1つの会話の中でeffortを変えたい場合は、両モデルが対応しているメッセージ単位のeffort(ベータ)を使うとキャッシュを保てます。
自分の作業で「合格1件あたりのコスト」を測る
トークン単価でもベンチマークでもなく、自分の作業で合格した成果1件にいくらかかったかで比べます。Anthropicのコストと性能の最適化ガイドが勧める手順を、この2モデルの比較に当てはめると次のようになります。
- 実際の作業ログから20〜50件ほどを選び、テストが通る、件数が合うなど機械的に合否を判定できるチェックを用意します。普段の作業だけでなく、難しいほうから1割を必ず含めます。安いモデルが落とす難しい作業の再試行と後始末が、請求を左右するためです。
- Sonnet 5.5とOpus 5.5を、それぞれ2〜3段階のeffortで実行します。条件ごとに別のセッションで回し、途中でeffortを変えません。
- 各レスポンスの
usageから費用を計算し、合計費用を合格件数で割ります。
PRICES = {  # 米ドル/100万トークン(2026年10月28日時点の定価)
    "claude-sonnet-5-5": {"in": 2.00, "cw5m": 2.50, "cw1h": 4.00, "cr": 0.10, "out": 10.00},
    "claude-opus-5-5":   {"in": 4.00, "cw5m": 5.00, "cw1h": 8.00, "cr": 0.20, "out": 20.00},
}

def request_cost(model: str, usage: dict) -> float:
    """usageはレスポンスのusageを辞書にしたもの(Python SDKならresp.usage.model_dump())"""
    p = PRICES[model]
    cc = usage.get("cache_creation") or {}
    return (
        usage["input_tokens"] * p["in"]
        + (cc.get("ephemeral_5m_input_tokens") or 0) * p["cw5m"]
        + (cc.get("ephemeral_1h_input_tokens") or 0) * p["cw1h"]
        + (usage.get("cache_read_input_tokens") or 0) * p["cr"]
        + usage["output_tokens"] * p["out"]
    ) / 1_000_000

def cost_per_pass(runs: list[dict]) -> float:
    """runs: [{"model": ..., "usages": [usage, ...], "passed": True/False}, ...]"""
    total = sum(request_cost(r["model"], u) for r in runs for u in r["usages"])
    passed = sum(1 for r in runs if r["passed"])
    return total / passed if passed else float("inf")
不合格だった作業の費用も合計に含めるのがポイントです。Sonnetが安く見えても、落とした作業のやり直しで結局Opusより高くなることがあります。
合否を自動で判定できる作業なら、最初は低いeffortで回し、落ちたものだけ高いeffortでやり直す方法も比べる価値があります。AnthropicがOpus 5.5で試した例(SWE-bench Proの一部)では、lowで回して失敗分をhighでやり直すと約97%が合格し、1件あたり約$0.17でした。すべてhighで回すと95.3%で約$0.29です。これはOpus 5.5だけでの計測なので、Sonnet 5.5をlowやmediumで回して失敗分だけOpus 5.5に回す組み合わせは、自分の作業で同じように測って確かめる必要があります。モデルをまたぐと思考ブロックは引き継がれないので、やり直しは最初から実行する形になります。
よくある質問
OpusとSonnetはどちらがいいですか?
作業の形で決まります。範囲が明確でテストなどで結果を確かめられる作業、大量に回す作業、速さが大事な対話はSonnet 5.5をmedium以下で使います。原因や終わりが見えない作業、長時間のエージェント実行、見逃しが高くつくレビューはOpus 5.5が向いています。迷う場合、Anthropicの公式ドキュメントはOpus 5.5から始めるよう勧めています。
SonnetとOpusの料金はどのくらい違いますか?
APIの単価は、入力・出力・キャッシュ書き込み・キャッシュ読み取りのすべてでSonnet 5.5がOpus 5.5のちょうど半分です(入力$2対$4、出力$10対$20、キャッシュ読み取りは2026年10月7日から$0.10対$0.20)。ただしタスク単価は使うトークン数とeffortで変わり、Artificial Analysisの指数v5.0(2026年10月28日時点)では、medium同士でSonnet 5.5が$0.78、Opus 5.5が$2.45なのに対し、max同士では$10.02と$10.04でほぼ同じです。Sonnet 5.5が安いままでいられるのは、同じ作業に使うトークン数がOpus 5.5の2倍までです。
無料プランでSonnet 5.5やOpus 5.5は使えますか?
Claudeの料金ページでは、無料プランはSonnetを使えてOpusは使えません。表にバージョンの記載はありませんが、現行のSonnetはSonnet 5.5です。Opus 5.5とClaude CodeはPro以上のプランで使えます。
Opusで計画し、Sonnetで実装する分担は得ですか?
作業の区切りで分けるなら現実的です。Claude Codeでは、Opus 5.5で調査と設計を終えて結論をファイルに残し、新しいセッションでSonnet 5.5に実装させる形が扱いやすく、プランモードと実行でモデルを分ける別名opusplanもあります(クラウド経由では実装側がSonnet 5.5にならない点に注意)。APIでは、Sonnet 5.5を実行役、Opus 5.5を助言役にするadvisorツール(ベータ)も使えます。ただし、どちらの組み合わせも5.5世代での費用や精度は公表されていません。Anthropicのコストガイドは、助言役のモデル(ここではOpus 5.5)を単独でlowのeffortで回した場合を比較の基準にするよう勧めています。
他社モデルも含めて比べたい場合はOpus 5.5とGPT-6 Sol比較:料金2倍はどこに効くかも参考になります。
参考資料11
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年11月10日。
参考資料11
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年11月10日。
- 1.Sonnet 5.5の発表anthropic.com/claude-sonnet-5-5
- 2.モデル一覧platform.claude.com/docs/en/about-claude/models/overview
- 3.Anthropicの料金ページplatform.claude.com/docs/en/about-claude/pricing
- 4.Claude Codeのモデル設定のヘルプsupport.claude.com/en/articles/11940350-claude-code-model-configuration
- 5.Claude Codeのドキュメントcode.claude.com/docs/en/model-config
- 6.Claude Codeのプロンプトキャッシュの説明code.claude.com/docs/en/prompt-caching
- 7.Claudeの料金ページclaude.com/pricing
- 8.Sonnet 5.5のヘルプsupport.claude.com/en/articles/17161993-why-claude-switched-models-in-your-conversation-with-sonnet-5-5
- 9.Sonnet 5.5の変更点platform.claude.com/docs/en/models/sonnet-5-5/whats-new-sonnet-5-5
- 10.Opus 5.5の変更点platform.claude.com/docs/en/models/opus-5-5/whats-new-opus-5-5
- 11.コストと性能の最適化ガイドplatform.claude.com/docs/en/about-claude/models/optimizing-for-cost-and-intelligence