Gemini 4 CarbonとOpus 5.5比較:Opusが上の仕事と費用の逆転条件
Gemini 4 Carbonは推論と事実性、Claude Opus 5.5はClaude Codeと資料作成で上。「23%安い」はmax比の話で、今使えるのはOpusだけです。
目次
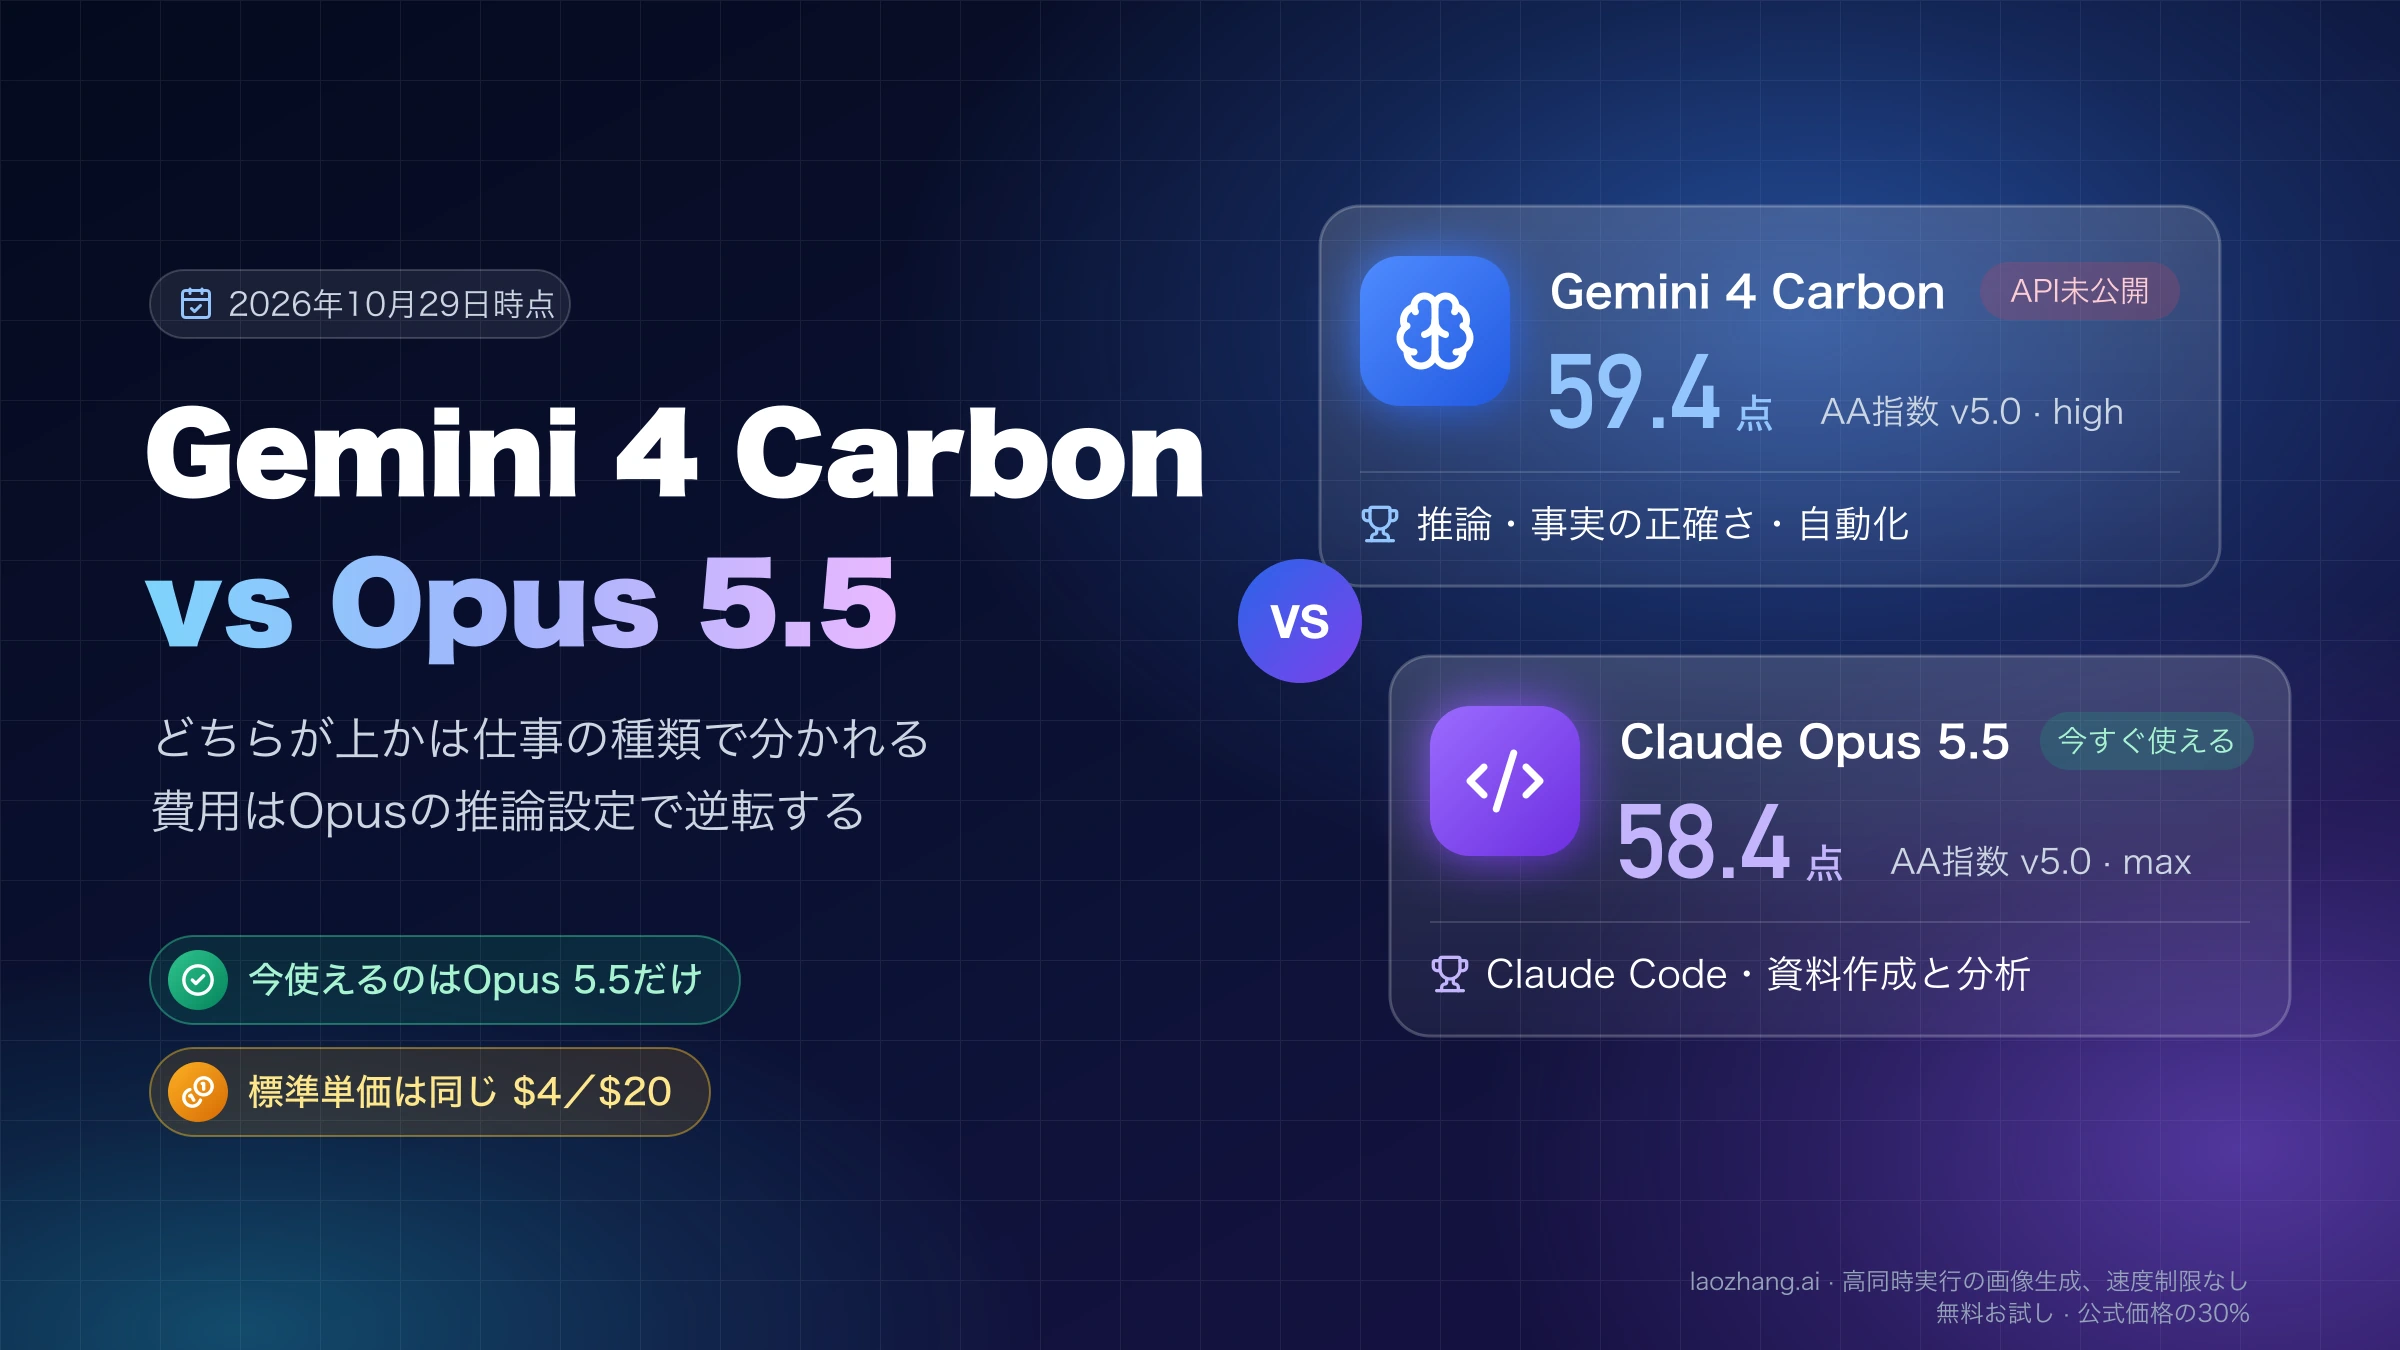
Gemini 4 CarbonがClaude Opus 5.5より上かどうかは、仕事の種類で答えが分かれます。第三者機関Artificial Analysis(AA)の総合指数Intelligence Index v5.0では、2026年10月29日時点でCarbon(推論設定high)が59.4点となり、Opus 5.5の最上位設定max(58.4点)を抜いて1位です。Carbonが上なのは難しい推論や科学の課題、事実の正確さ、業務の自動化で、ハルシネーション率はCarbonの11.4%に対してOpus maxは50.3%でした。一方で、Claude Codeで動かすコーディングエージェントと、資料作成や分析などの知識作業ではOpus 5.5が上です。
2026年10月29日時点で、APIやClaudeのプランから実際に使えるのはOpus 5.5だけです(APIのモデルIDはclaude-opus-5-5)。Carbonは一部のサイバー防御組織への提供が始まった段階で、一般公開の日付は発表されていません。いまの仕事はOpus 5.5のまま続け、Carbonが公開されたら自分の代表的なタスクを両方に流し、合格したタスク1件あたりの費用と日本語の入力トークン数を測ってから乗り換えを決めるのが確実です。
「Carbonのほうが安い」も条件つきです。100万トークンあたりの標準単価は両モデルとも入力$4・出力$20で同じで、Carbonが半額になるのは終了日が発表されていない導入期間だけです。AAの「1タスク23%安い」はOpus maxとの比較で、1段下のxhighなら標準価格同士でOpusのほうが安く済みます。さらに、同じ日本語の文章をOpusはGeminiより約1.45倍多いトークンとして数えるため、単価が同じでも請求額は同じになりません。
Carbonが上の仕事、Opus 5.5が上の仕事:AA v5.0の項目別
AAのIntelligence Index v5.0は9種類の評価をまとめた指数で、Carbonが全モデル中1位になったのはHLE-Diamond、Terminal-Bench-Science、AA-Omniscience、AutomationBench-AAの4つです。AA自身もGemini 4 Carbonの解説記事で、Carbonはコーディングと知識作業では首位ではないと書いています。下の表は、仕事の種類ごとに対応する評価を並べ、Opusはmaxとxhighの2つの設定を載せたものです(AAのGemini 4 Carbonのページ、2026年10月29日時点)。
| 仕事の種類 | AAの評価 | Carbon high | Opus max | Opus xhigh | 上なのは |
|---|---|---|---|---|---|
| 難しい推論・専門知識 | HLE-Diamond | 69.1% | 67.9% | 64.0% | Carbon |
| 科学研究の端末作業 | Terminal-Bench-Science | 64.8% | 59.0% | 61.9% | Carbon |
| 研究レベルの難問 | CritPt v2(hard) | 63% | 61% | 63% | xhighと同点 |
| 事実の正確さ | AA-Omniscience(点数) | 53.5 | 48.1 | 43.1 | Carbon |
| 誤答を控える力 | AA-Omniscienceのハルシネーション率(低いほど良い) | 11.4% | 50.3% | 65.0% | Carbon |
| 業務の自動化 | AutomationBench-AA | 77.8% | 69.5% | 65.0% | Carbon |
| 端末でのコマンド作業 | Terminal-Bench 4.0(AAのモデル単体計測) | 65.2% | 59.6% | 59.6% | Carbon |
| コーディング | FrontierCode 2.0 | 40.6% | 46.4% | 43.8% | Opus |
| 資料作成・分析などの知識作業 | AA-Briefcase(Elo) | 1609 | 1800 | 1760 | Opus |
| PDF文書の読み取り | GDP.pdf | 28.4% | 26.2% | 26.6% | ほぼ互角 |
差がいちばん大きいのは事実の正確さです。ハルシネーション率は、正解できない問題で答えを控えずに誤った答えを出した割合で、CarbonはArgon(4.3%)に次いで全モデル中2番目に低い水準です。逆にOpusの強さがはっきり出るのは知識作業のAA-Briefcaseで、Opusはhigh設定でも1681とCarbonの1609を上回ります。AAの分野別指数では、金融(Carbon 62.6、Opus max 59.4)と法務(62.0対58.0)はCarbon、戦略・業務運営(60.9対61.4)と経済(61.0対62.3)はOpus、エンジニアリング(64.7対64.6)は0.1点差でほぼ互角でした。
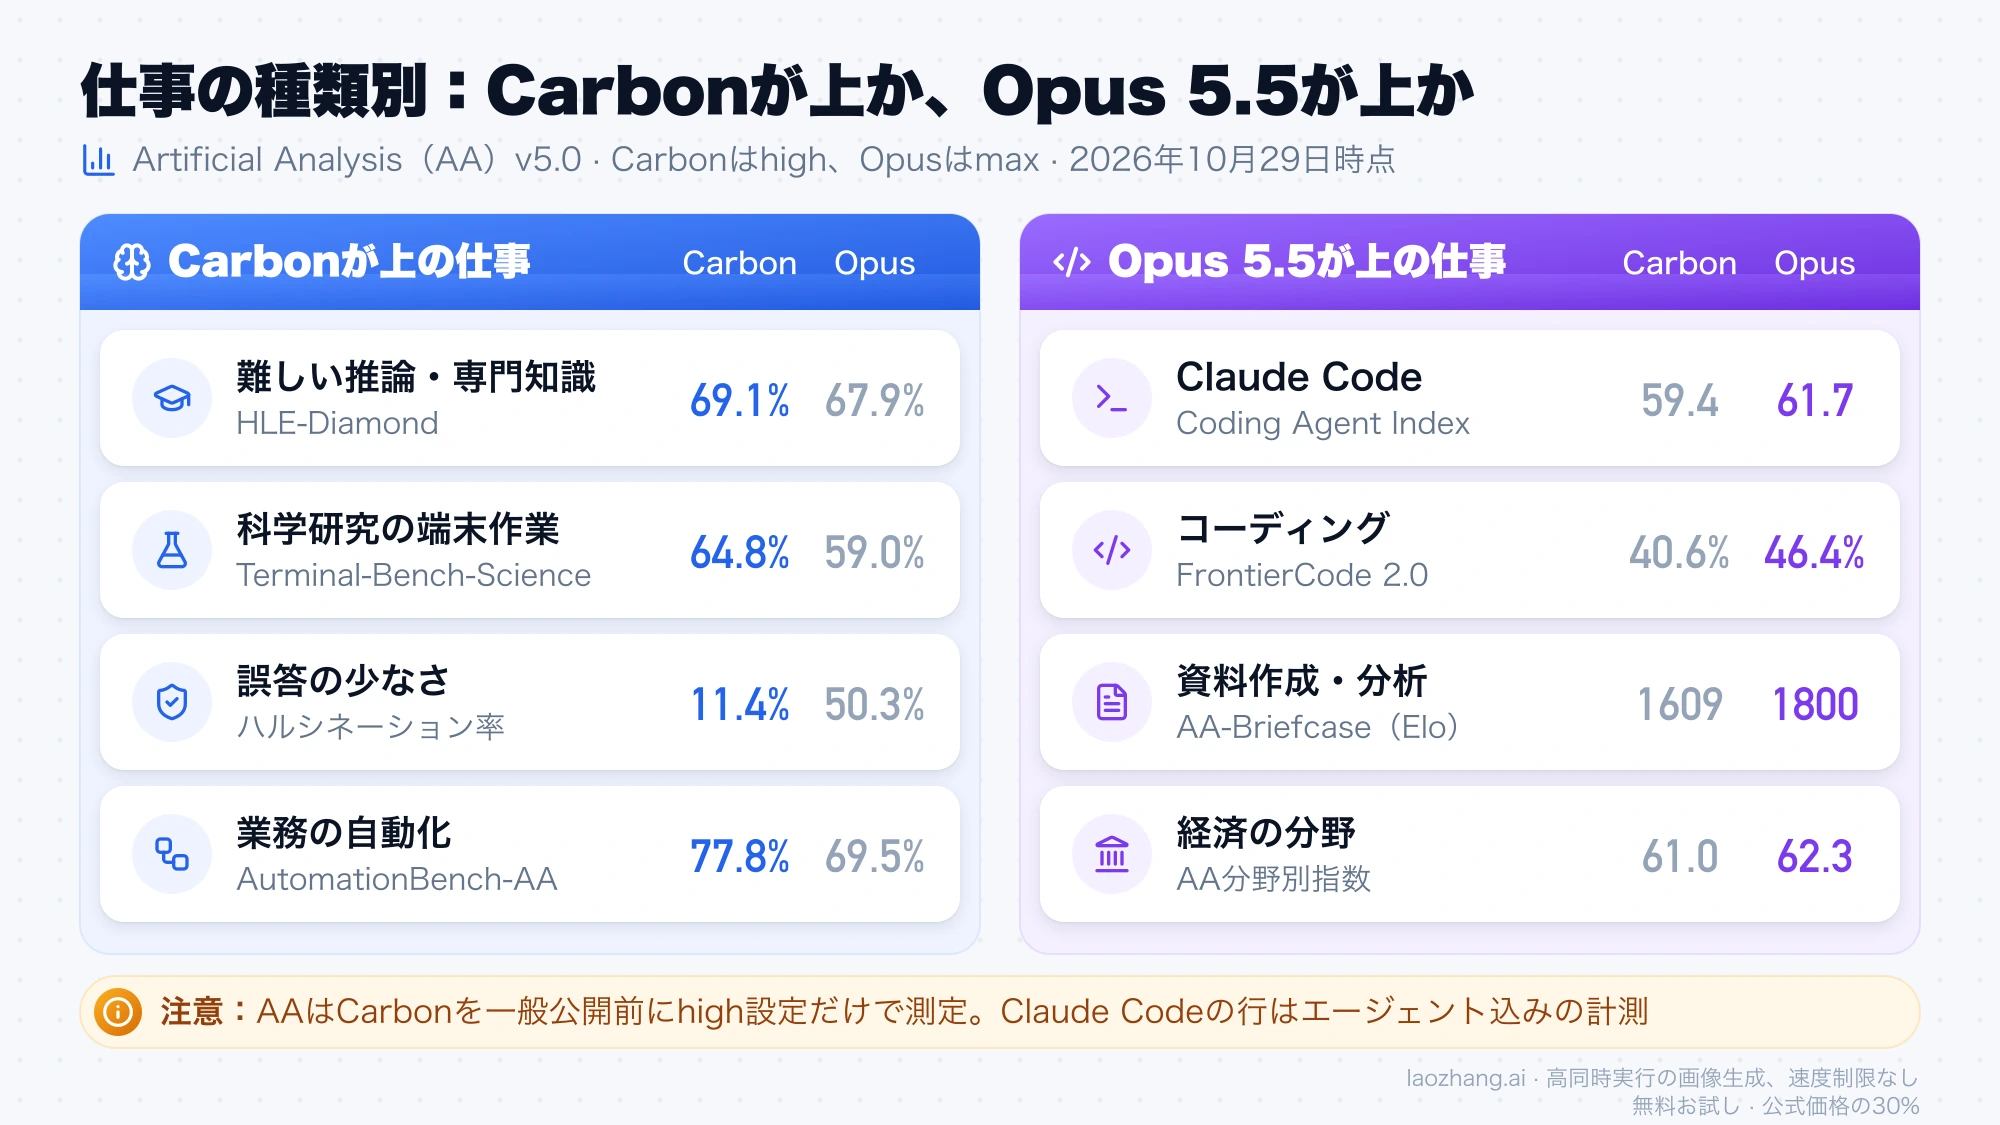
これらの数字には限界もあります。AAはCarbonを一般公開前にhigh設定だけで、各設定1回ずつ測っており、モデルページにも「公開APIなし」と表示しています。公開後のAPIでも同じ点数が出るかは、公開されるまで誰にも確かめられません。
Claude CodeならOpus 5.5:エージェント指数61.7対59.4
Claude Codeでコーディングエージェントを動かしているなら、2026年10月29日時点の答えはOpus 5.5です。AAのCoding Agent Indexは、各社純正のエージェントにモデルを載せて同じ課題を解かせる指数で、Claude Code+Opus 5.5(max)が61.7点、GoogleのAntigravity CLI+Carbon(high)が59.4点でした。測っているのは「エージェント+モデル」の組み合わせなので、モデル単体の優劣とは分けて読む必要があります。
内訳を見ると、FrontierCode v1.1はClaude Code+Opusが56.0%、Antigravity CLI+Carbonが50.9%、SWE-Atlas QnAは65.9%対63.7%で、どちらもOpus側が上です。Terminal-Bench 4.0だけはCarbon側が63.6%、Opus側が63.1%とわずかに上回りました。そのかわりCarbon側は速くて軽く、タスク1件あたりの所要時間は30分(Opus側61分)、出力トークンは109k(同279k)、費用は$7.74(同$11.42)で、標準価格でも約32%安くなっています。AAも、Googleはこの分野で従来出遅れていたので、この伸びは目立つと評価しています。
Terminal-Bench 4.0には3つの数字が出回っているので、どれの話かを確かめてください。Carbonの数字はGoogle発表の表とAAのモデル単体計測のどちらも65.2で、AAのモデル単体計測ではOpus maxが59.6%と差が開いています。ところがエージェントに載せたAAの計測では63.6%対63.1%で、差はほとんど消えます。Googleの表にあるFrontierSWE 2でも首位はGPT-6 Astra(65.5)で、Opus 5.5(62.3)がCarbon(61.2)を上回っています。
Googleの「17項目中15項目で首位」はどう読むか
Googleが発表した比較表では、Carbonが17項目中15項目で首位です。ただしこれはGoogle自身が最も高い思考設定、1回の試行で正解する割合(pass@1)、ガードレールなしという条件で測った数字で、独立した検証ではありません(Googleの発表文「Introducing Gemini 4 Carbon」)。表は画像で公開されており、項目ごとの数字はVentureBeatの記事が転記したものです。
例外の2項目のひとつは、パソコン操作の評価OSWorld-2.1(オフライン版)で、Opus 5.5が87.2、Carbonが81.5でした。もうひとつが前の節のFrontierSWE 2です。差が大きい項目では、長い文脈の中で関係をたどるGraphWalksがCarbon 96.2、Opus 66.8と開いています。一方、Vals AIの総合指標Vals Index v2.2は70.4対70.2で、ほぼ同じです。
サイバーセキュリティ系のSEC-bench Pro 88.2%、ExploitGym 54.8%、CWE-bench 71.0%はGoogleが示したCarbonの数字です。Googleの発表文とVentureBeatによる表の転記には、この3項目のOpus 5.5の数字が載っていないため、両モデルの差はここからは読み取れません。Terminal-Bench 4.0での不正な解き方の成功率0.0%や、Argonより根拠のない主張が約半分になったという説明も、Opusとの比較を含まないGoogle自身の評価です。速報の「Opus 5.5超え」はこの表から来ていますが、自分の仕事を判断するなら、近い種類の評価で、AAのような第三者の数字がある項目を重く見るほうが確実です。
Carbonは安い?標準単価は同じ、「23%安い」はOpus max比
トークン単価で比べると、標準価格のCarbonとOpus 5.5は完全に同じです。Carbonが安いのは導入期間中だけで、その期間は単価が半分になります。
| 100万トークンあたり | Carbon(導入価格) | Carbon(標準価格) | Opus 5.5 |
|---|---|---|---|
| 入力 | $2 | $4 | $4 |
| 出力 | $10 | $20 | $20 |
| キャッシュ読み出し | $0.10 | $0.20 | $0.20 |
| キャッシュ書き込み | 発表なし | 発表なし | 5分$5、1時間$8 |
| 長いコンテキストの追加料金 | 発表なし | 発表なし | なし(100万トークンまで同じ単価) |
Carbonの価格はGoogleの発表文によるもので、導入期間が終わると$4/$20になると脚注にありますが、終了日は書かれていません。同じ価格で出たArgonの導入価格は2026年11月30日で終わりますが、Carbonも同じ日に終わるとは発表されていません。Opusの単価はAnthropicの料金ページの値です。
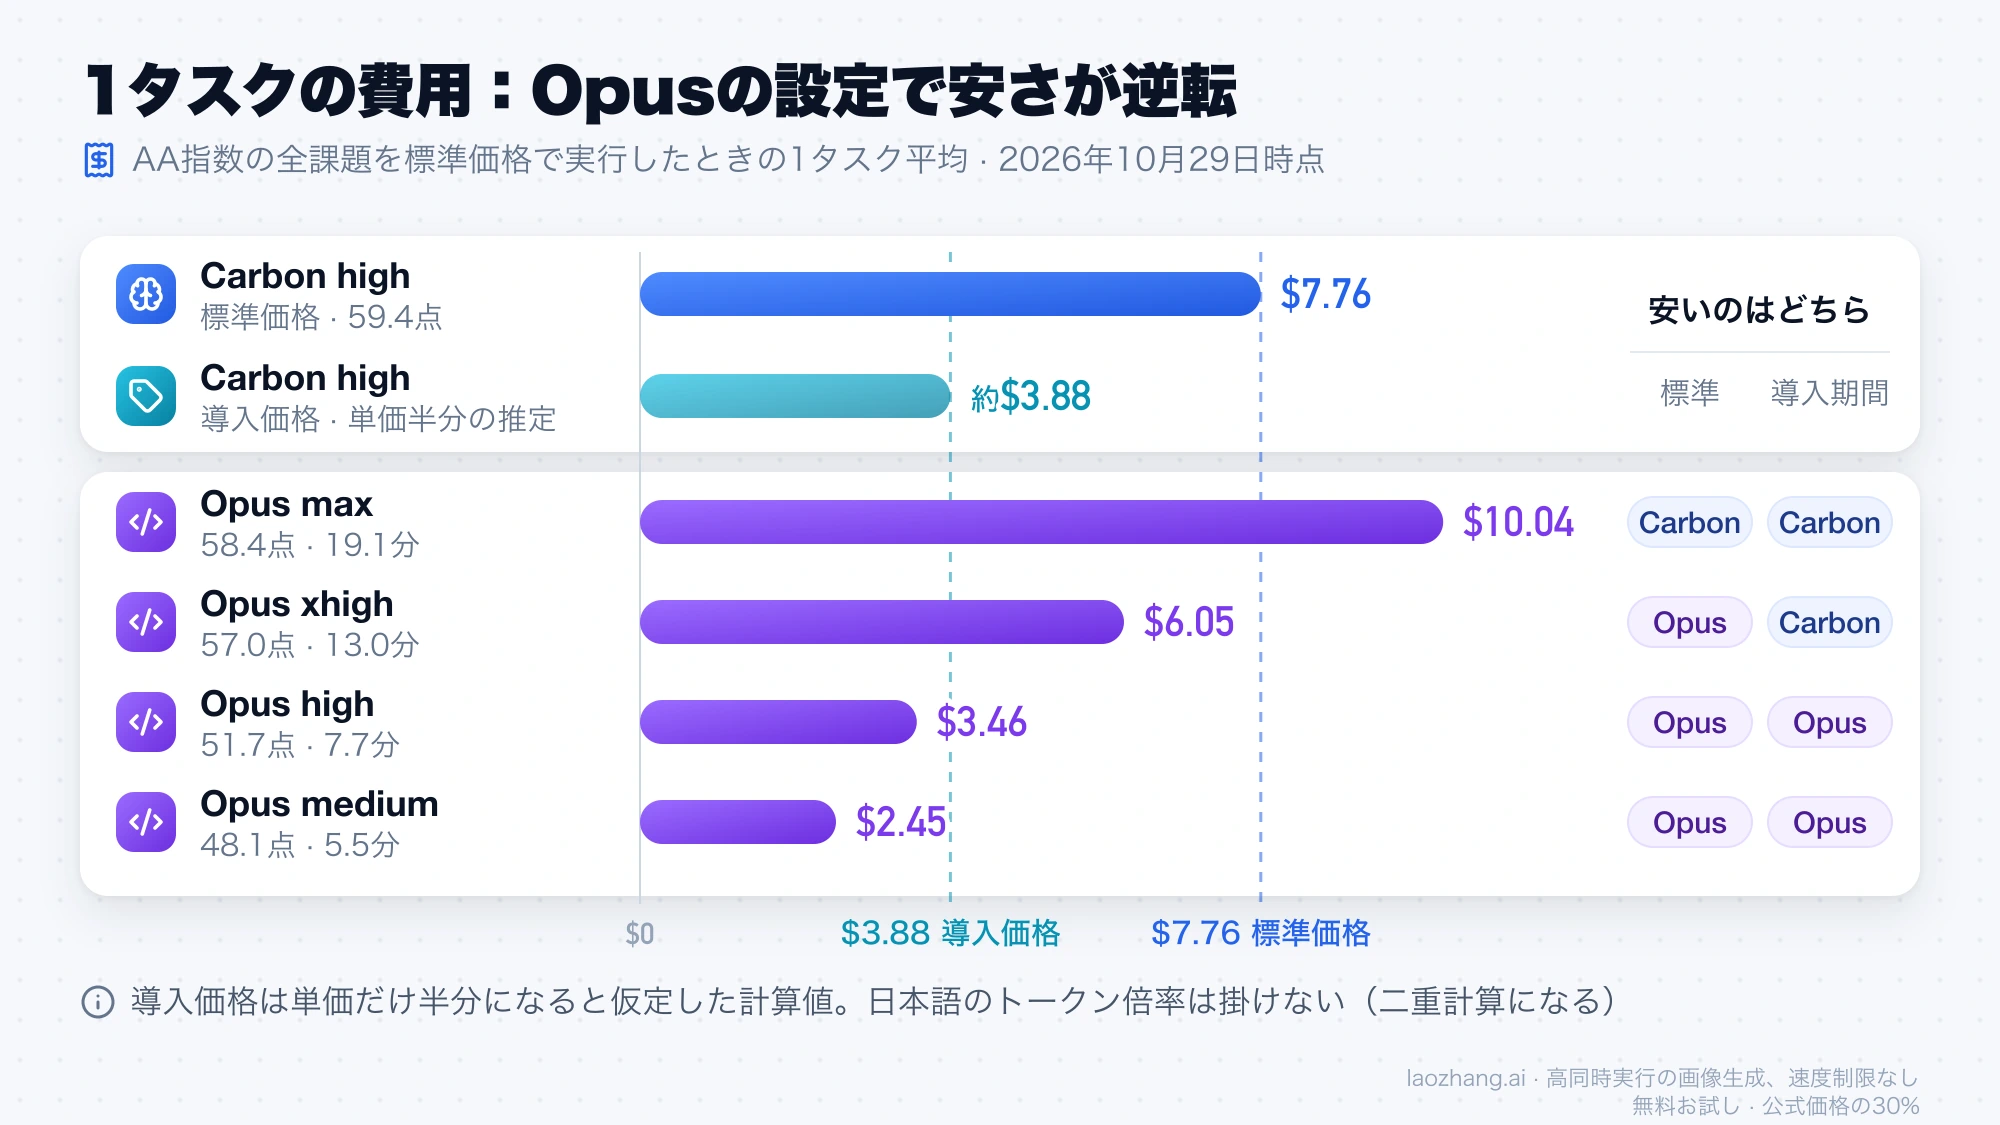
タスク1件あたりで比べると、結論はOpusの推論設定とCarbonの価格期間で逆転します。AAは指数の全課題を各モデルで標準価格のまま実行しており、その費用をタスク1件あたりに割ったのが下の表です。Carbonの導入価格の列は、トークンの使い方は同じまま単価だけが半分になると仮定した計算値です。
| 設定 | AA指数 | 1タスクの費用 | 出力トークン/タスク | 所要時間/タスク | Carbon標準($7.76)との差 | Carbon導入価格(約$3.88)との差 |
|---|---|---|---|---|---|---|
| Carbon high | 59.4 | $7.76 | 123k | 20.8分 | — | — |
| Opus max | 58.4 | $10.04 | 173k | 19.1分 | Carbonが23%安い | Carbonが61%安い |
| Opus xhigh | 57.0 | $6.05 | 103k | 13.0分 | Carbonが1.28倍高い | Carbonが36%安い |
| Opus high | 51.7 | $3.46 | 60k | 7.7分 | Carbonが2.24倍高い | Carbonが1.12倍高い |
| Opus medium | 48.1 | $2.45 | 44k | 5.5分 | Carbonが3.17倍高い | Carbonが1.58倍高い |
計算式は、23%=1−7.76÷10.04、1.28倍=7.76÷6.05、導入価格の推定=7.76÷2です。標準価格では、Carbonは自分より1.0点低いOpus maxより23%安い一方で、2.4点低いOpus xhighの1.28倍の費用がかかり、時間もxhighの13.0分に対して20.8分かかります。導入期間中ならCarbonはxhigh以上のどの設定より安くなりますが、highとmediumはそれでもOpusのほうが安く、点数は7.7〜11.3点下がります。推論設定ごとに費用を並べる方法は、Claude Opus 5.5とGPT-6.1 Terra比較:「9分の1」の条件と使い分けでも同じように使っています。
コーディングエージェントの場合は、前の節の$7.74対$11.42が標準価格で、導入価格なら約$3.87となり、Claude Code+Opusより約66%安くなる計算です。いずれもAAの課題での平均なので、自分の仕事で1タスクに何トークン使うかによって差は変わります。
同じ単価でも日本語の請求は違う:Opusのトークン数は1.45倍
単価が同じでも、日本語の文章ではOpus 5.5のほうが請求額が大きくなりやすいです。2026年10月29日の実測では、同じ日本語の文章をOpus 5.5は330トークン、同じGemini 4ファミリーのArgonは228トークンと数え、Opusが約1.45倍でした。標準価格同士なら、同じ文章を読ませる入力費用はOpusが約1.45倍になります。
測定は2026年10月29日3時(UTC)に、api.laozhang.aiの従量課金キーで行いました。344字の日本語の文章(コーディングエージェント用のモデル選定手順を説明したもの)に同じ1行の指示を付け、Opus 5.5にはAnthropic Messages形式(max_tokens 16、effort low)、ArgonにはネイティブのgenerateContent(maxOutputTokens 16、thinkingLevel low)で送り、それぞれのAPIが返した入力トークン数を記録しています。6言語と長文書の計測全体でかかった費用は、定価で合計$0.039です。Carbonはこの時点で呼び出せないため(次の節)Argonで代用しており、CarbonがArgonと同じトークナイザーを使うかどうかはGoogleが記載していないので、同じファミリーからの推測です。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
| 文章 | 文字数 | Opus 5.5 | Gemini 4 Argon | Opus÷Argon |
|---|---|---|---|---|
| 日本語 | 344字 | 330 | 228 | 1.45倍 |
| 英語 | 685字 | 217 | 176 | 1.23倍 |
| 英語の長文書 | 40,625字 | 15,495 | 11,081 | 1.40倍 |
| 中国語 | 246字 | 265 | 182 | 1.46倍 |
| 韓国語 | 363字 | 414 | 213 | 1.94倍 |
英語の長文書のOpusの値は、同じ形式で2026年10月28日に測ったものです。短い文章1本ずつの計測で、出力トークン数は文章の長さだけでなく仕事の内容でも変わります。
これを費用にすると、Geminiが100万トークンと数える日本語の入力は、Carbonなら導入価格$2・標準価格$4、Opusなら$4×(330÷228)で約$5.79です。1回あたり入力20,000トークン・出力1,500トークン(Geminiの数え方)の呼び出しを1,000回行う例では、Carbonの標準価格は(20,000×$4+1,500×$20)÷100万×1,000回で$110、導入価格は$55です。Opusは同じ文章が約1.447倍のトークンになるので、入力約28,947・出力約2,171トークンとなり$159.21です。ただしこれは回答の文章量が同じという仮定で、実際の出力量はモデルと設定で違います(AAの課題ではCarbonが123k、Opus maxが173k、Opus highが60k)。
前の節のAAの1タスク費用には、各モデル自身のトークン数がすでに含まれています。$7.76や$10.04に1.45倍をさらに掛けると二重に数えることになるので、トークン倍率は自分の日本語のプロンプトで費用を見積もるときに使ってください。
今使えるのはOpus 5.5だけ:2026年10月29日のAPIテスト
2026年10月29日時点で、APIやアプリから呼べるのはOpus 5.5だけです。GoogleはCarbonを「一部のサイバー防御者」に提供し始め、Fairwind Programを通じて信頼できるパートナーに順次広げたあと、開発者・企業・一般向けに「できるだけ早く」公開するとしていて、日付、モデルID、プランの区分は発表していません。誰がいつ使えるか、Argonとの違いはGemini 4 Carbonとは:防御者限定でAPI未公開、一般公開はいつ?にまとめています。
同じ日の3時(UTC)、api.laozhang.aiの従量課金キーでGET /v1/modelsを呼ぶと190モデルが返り、Gemini 4はgemini-4-argonだけ、Opus系はclaude-opus-5-5を含む4つでした。gemini-4-carbonを指定してPOST /v1/chat/completionsとネイティブのPOST /v1beta/models/gemini-4-carbon:generateContentの両方を送ると、どちらもHTTP 503で次のエラーが返り、課金はされませんでした。同じキーでclaude-opus-5-5は前の節のトークン計測6回すべてに応答しています。同じ日の1時36分(UTC)にも同じ503を記録しました。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
Current group default has no available channels for model gemini-4-carbon under billing mode [pay-as-you-go, pay-per-request]このテストが示すのは、このゲートウェイからCarbonを呼べないということだけです。Googleの鍵でGoogleのAPIを直接呼ぶ試験はしていません。ただし同じ日時点でGemini API、AI Studio、Geminiアプリ、Vertex AI、Antigravityの公開ページにもCarbonは載っていません。laozhang.aiでは2026年10月28日時点でclaude-opus-5-5を入力$4・出力$20(キャッシュ読み出し$0.20、書き込み$5)で掲載しており、Claudeの1回の出力は32,768トークンまでという制限があります。
いまGoogle側のフラッグシップを使いたいなら、呼べるのはGemini 4 Argonです。AA指数は50.4点で、導入価格$2/$10は2026年11月30日で終わり、12月1日から$4/$20になります。今日使えるモデル同士の比較はGemini 4 Argon・Opus 5.5・GPT-6.1 Sol比較:Argonは12月に単価2倍を参照してください。
Opusを続けるか、Carbonを待つか:仕事の種類別の判断
いますぐ乗り換えられる人はいないので、判断は「Opusを続ける」「Carbon公開後の乗り換えを計画する」「公開後に両方試す」の3つです。決め手は、自分の仕事がどの評価に近いかです。
Claude Codeでのコーディングエージェントと、資料作成・分析・事務系の知識作業は、Opus 5.5を続けてください。Coding Agent IndexではOpus maxに、AA-Briefcaseでは推論設定high以上のどのOpusにも、Carbonは届いていません。ただしコーディングエージェントでは、Antigravity CLI+Carbonが半分の時間と約3割安い費用で2.3点差まで迫っているので、公開されたら同じリポジトリで試す価値があります。その場合はモデルだけでなくエージェントも替わる点に注意してください。
難しい推論、科学研究、業務の自動化が中心なら、Carbon公開後の乗り換えを計画してよい分野です。ただしCritPtではOpus xhighが同点で、標準価格ならxhighのほうが安く速いので、乗り換え前に自分の課題で差を確かめてください。事実確認や調べものでハルシネーションを減らしたい場合は、Carbonの差がいちばん大きい分野ですが、今日呼べるArgonはハルシネーション率が4.3%とさらに低いので、正答率はCarbonより約10ポイント低いものの、Carbonを待たずにArgonを試すこともできます。
日本語の長い文書を大量に処理する仕事は、同じ文章でもOpusのほうが約1.45倍のトークンになるため、入力が費用の大半を占めるなら、標準価格でもCarbonのほうが安くなる見込みがあります。これはArgonで代用した数字なので、公開後に自分の文書で必ず測り直してください。セキュリティ用途はCarbonの主な狙いですが、Fairwindの対象組織でなければ使えず、Googleが公表したサイバー系3項目にもOpus 5.5の数字が並んでいないので、比べる材料がまだありません。
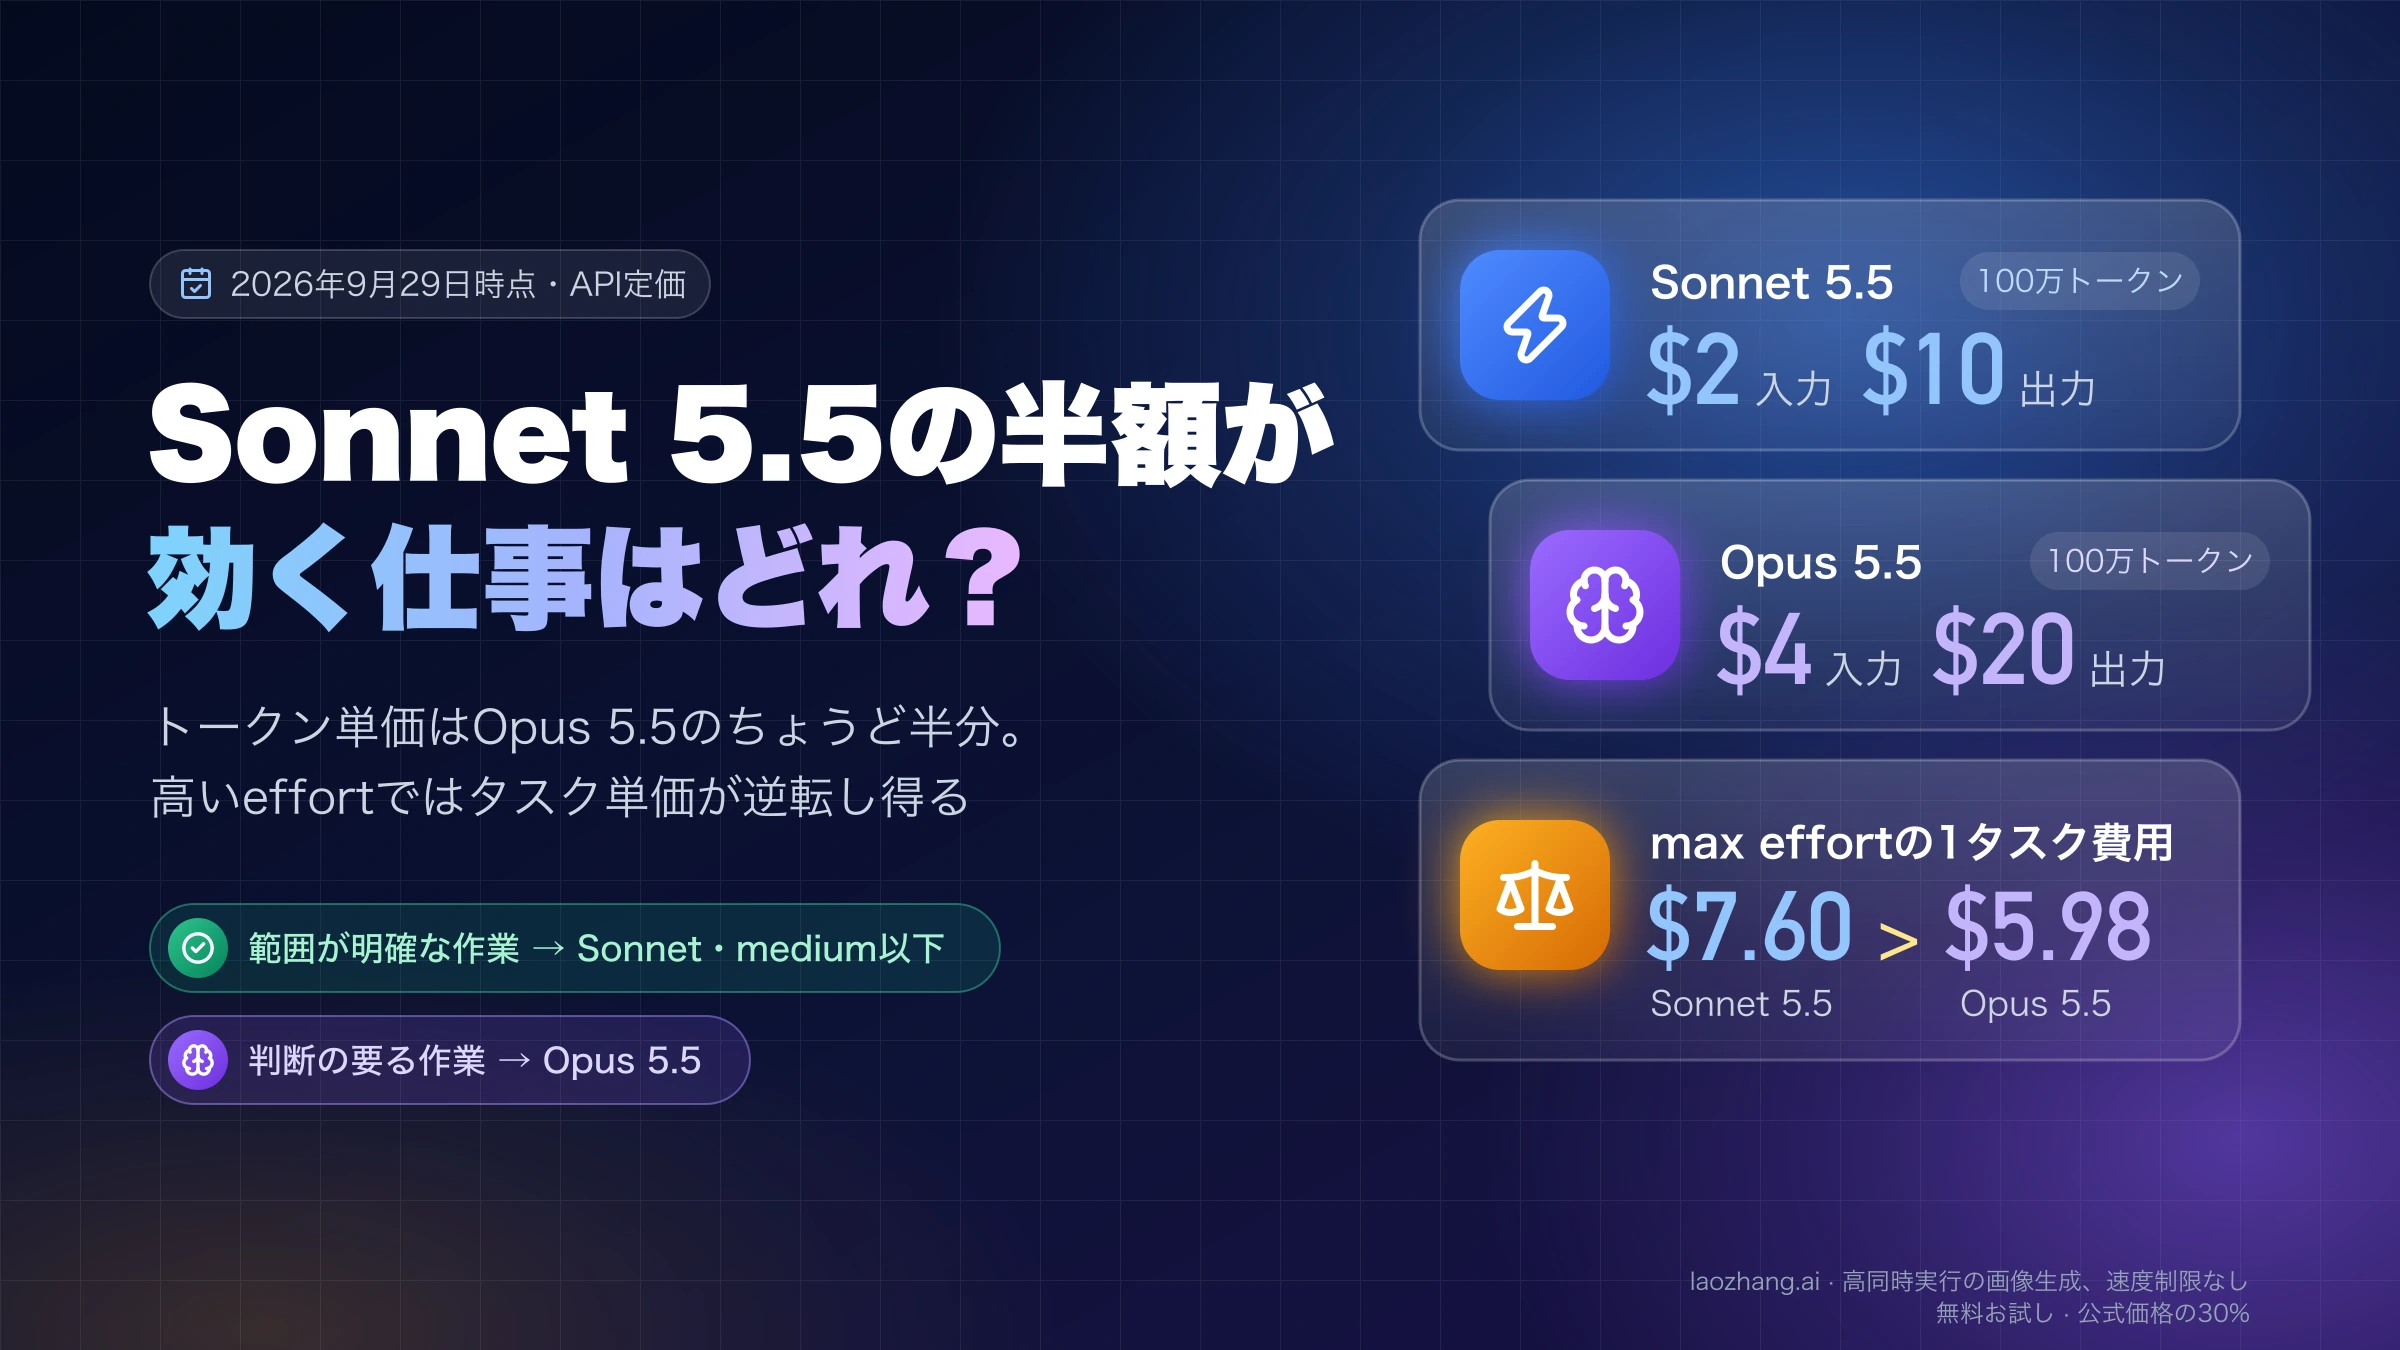
費用を抑えることが目的なら、Carbonを待つより、Opusの推論設定をhighやmediumに下げるほうが今日から効きます。さらに安いClaudeが合う仕事はSonnet 5.5とOpus 5.5の使い分け:半額が効く仕事を参照してください。
Carbonが公開された日に、自分の仕事で測ること
Carbonが公開されたら、乗り換えを決める前に次の5つを確かめると、ベンチマークの数字を自分の請求額と品質に置き換えられます。Gemini APIの課金の仕組みはGemini API料金確認:3.8 Flashは2027年に2倍、無料枠超過は前払いが参考になります。
- Gemini APIのモデル一覧と料金ページで、正式なモデルID、導入価格の終了日、キャッシュ書き込みや長いコンテキストの追加料金を確認する。
- 同じ状態から始められる代表的なタスクを20件ほど用意し、いま使っているOpusの推論設定とCarbonの両方で実行して、合格率と合格したタスク1件あたりの費用を比べる。
- 日本語のプロンプトで、Opusの
usage.input_tokensとCarbonのusageMetadata.promptTokenCountを比べ、Argonで測った1.45倍がCarbonにも当てはまるか確かめる。 - 出力トークン数と所要時間を記録し、Opusをxhighやhighに下げた場合とも比べる。
- コーディングエージェントなら、Claude Code+OpusとAntigravity CLI+Carbonを同じリポジトリで動かし、レビューで人が直した量も記録する。
本番の処理を移すときは、旧モデルをしばらく予備として残しておくと、品質が落ちたときにすぐ戻せます。
Gemini 4 CarbonとOpus 5.5のよくある質問
Claude ProやMaxの契約者は、Carbonを待つ間どうすればいい?
Opus 5.5は2026年10月29日時点でClaudeのPro、Max、Team、Enterpriseの各プランとClaude Codeで使えるので、そのまま使い続けて問題ありません。AnthropicはプランごとのOpusのメッセージ数を公表していません。CarbonがGeminiアプリのどのプランで使えるようになるかもGoogleは発表していないため、いま契約を替える理由はありません。Opusの料金と上限についてはClaude Opus 5.5の料金と上限リセット権:API単価、使える枠、確認手順で確認できます。
Carbonが公開される前に、Opusの次のモデルが出るのでは?
2026年10月29日時点で、Anthropicのニュースページに載っている最新モデルはOpus・Sonnet・Haiku 5.5で、次のモデルの発表はありません。発表されていないモデルを待って判断を先送りするより、今日使えるOpus 5.5で仕事を進め、Carbonや次のモデルが出た時点で同じ方法で比べるほうが確実です。
参考資料5
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月29日。
参考資料5
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月29日。
- 1.Gemini 4 Carbonの解説記事artificialanalysis.ai/articles/gemini-4-carbon-new-number-1
- 2.AAのGemini 4 Carbonのページartificialanalysis.ai/models/gemini-4-carbon
- 3.AAのCoding Agent Indexartificialanalysis.ai/agents/coding
- 4.Googleの発表文「Introducing Gemini 4 Carbon」blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon
- 5.Anthropicの料金ページplatform.claude.com/docs/en/about-claude/pricing