Claude Haiku 5.5とGPT-6 Luna比較:単価は同じ、費用差は2.2〜8.6倍
Claude Haiku 5.5とGPT-6 Lunaは単価が同じでも、同じeffortの第三者評価ではHaikuの1課題費用が2.2〜8.6倍。100K超の入力はLunaが割安。
目次
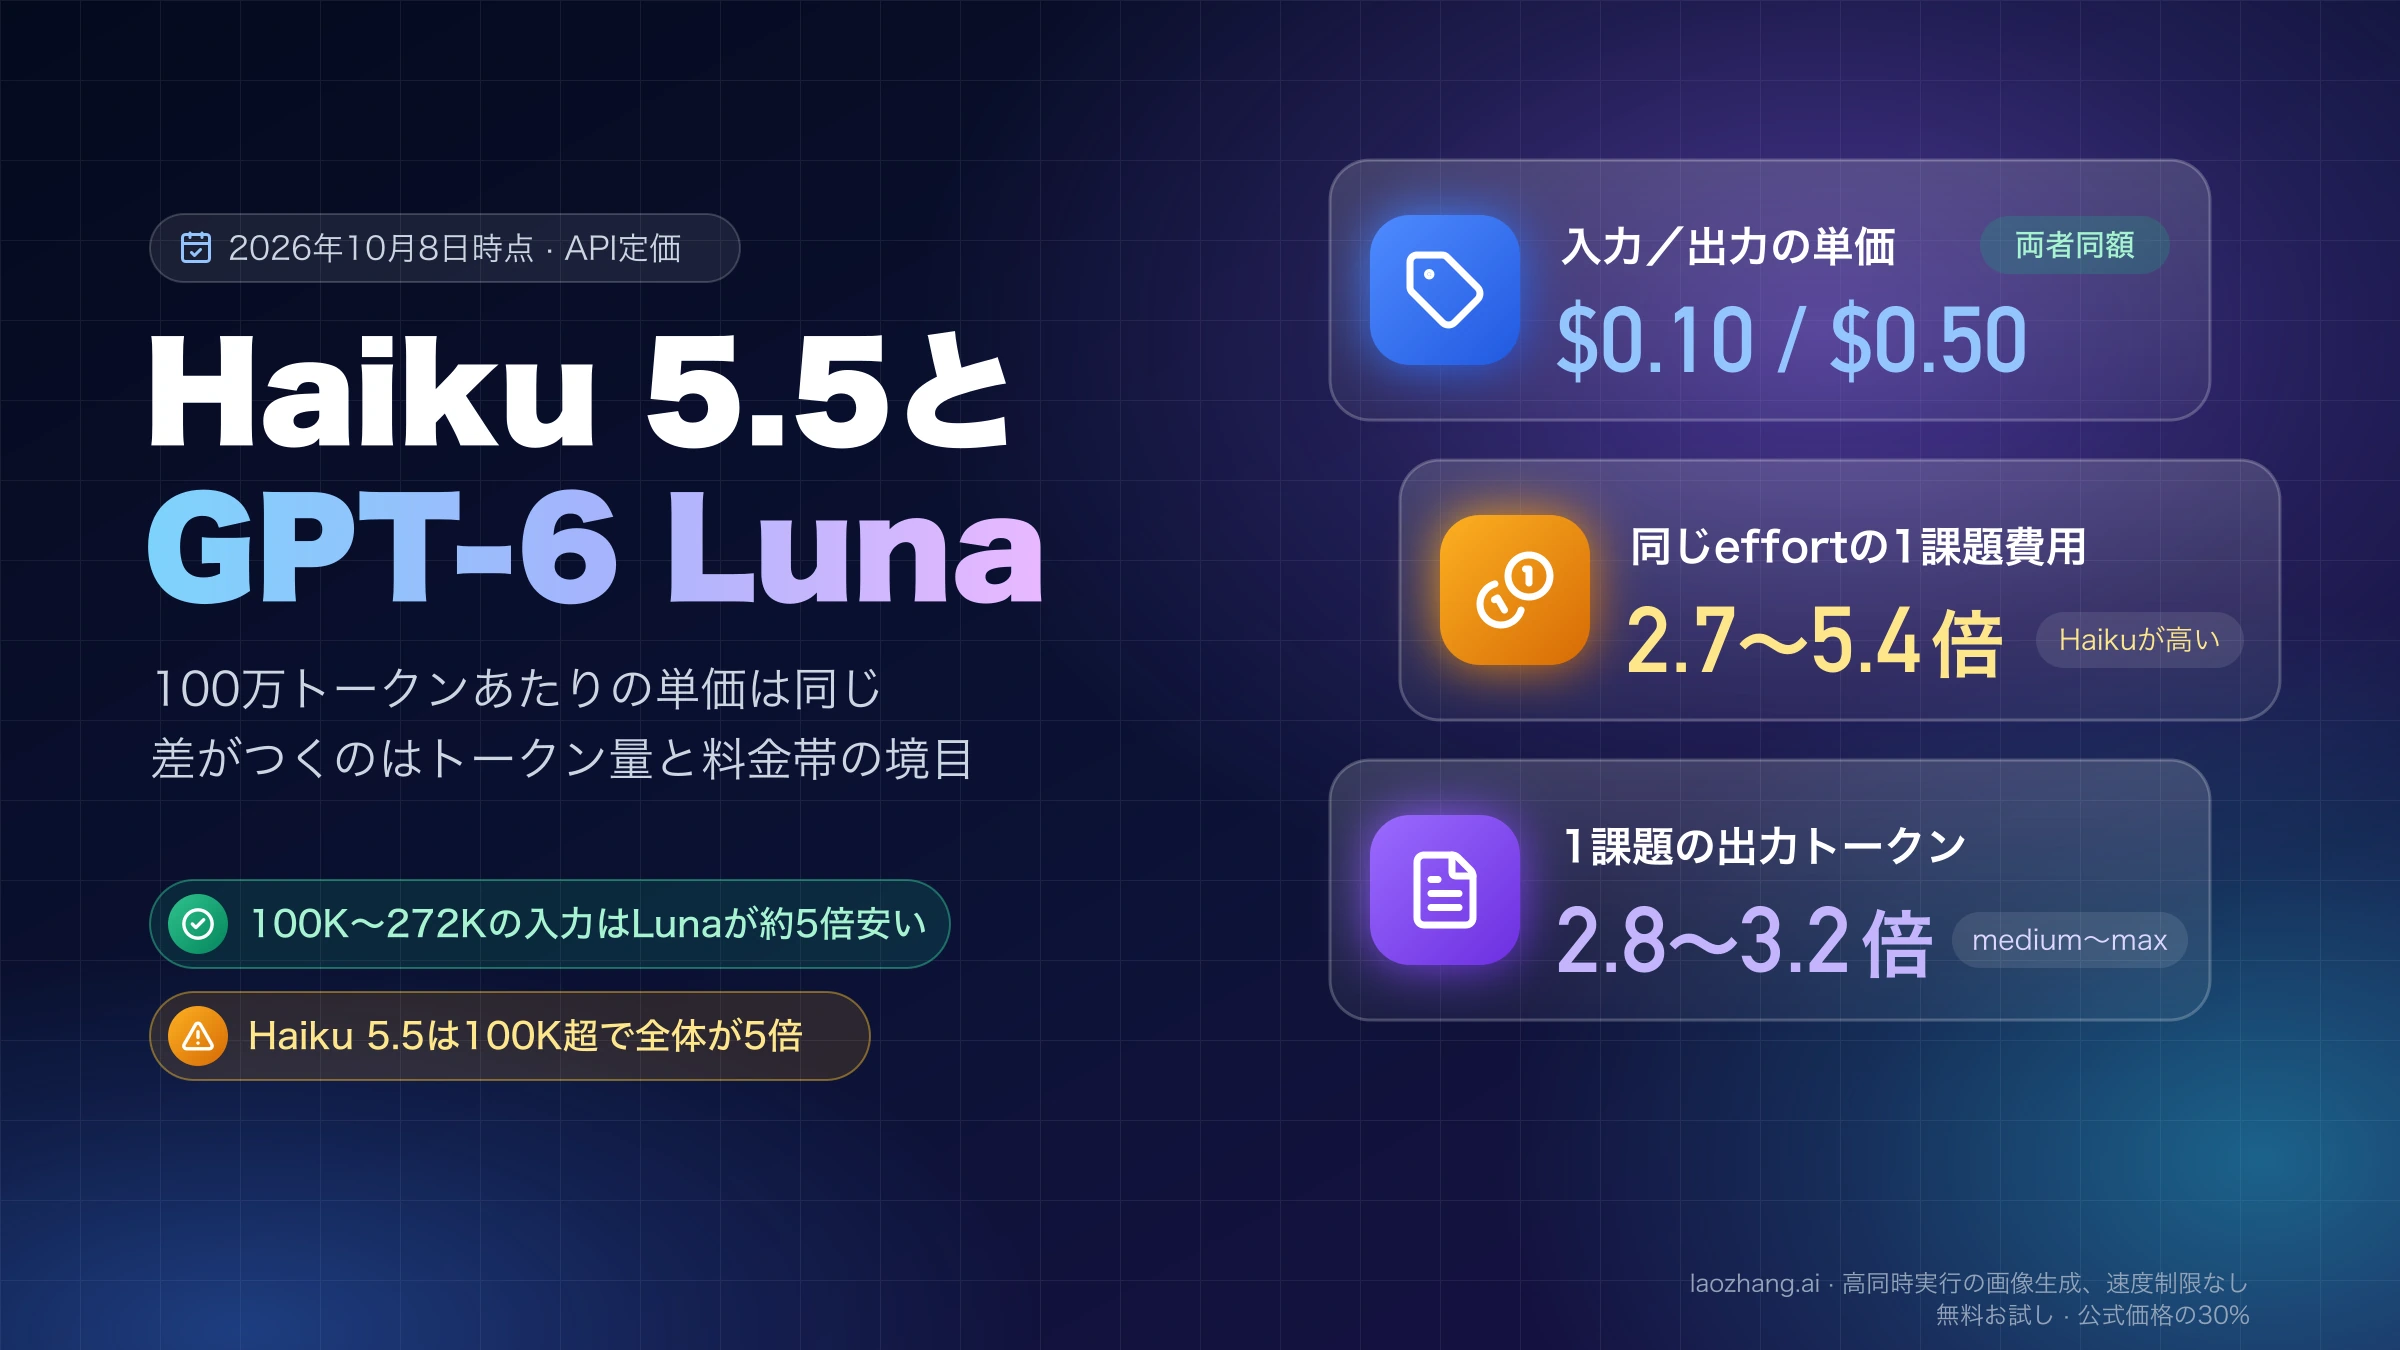
Claude Haiku 5.5(2026年10月7日公開)とGPT-6 Luna(APIは9月22日公開)は、APIの定価がそろっています。100万トークンあたり入力$0.10、キャッシュ読み出し$0.01、出力$0.50で、この単価が適用されるのはHaiku 5.5ならプロンプトが100Kトークン以下、GPT-6 Lunaなら入力が272Kトークン以下の依頼です(2026年10月8日時点のAnthropicの料金ページとOpenAIのAPI料金ページ)。請求額に差がつくのは単価ではなく、1回の依頼で使うトークンの量と、高い料金帯に切り替わる位置です。
- 推論の深さ(effort)をそろえて同じ課題を解かせたArtificial AnalysisのHaiku 5.5とGPT-6 Lunaの比較ページでは、1課題あたりの費用はHaiku 5.5がGPT-6 Lunaの2.2〜8.6倍です(総合指数v5.0、2026年10月28日時点。AAは同月27〜28日に9種類の評価からなるこの版へ切り替えました)。単価が同じなので、差は出力(思考を含む)トークンの多さから来ています。
- 同じ評価の総合スコアをそろえて比べると費用はほぼ互角で、既定のmedium付近ではHaiku 5.5のmedium(25点)がGPT-6 Lunaのxhigh(23点)より約12%安く済みます。GPT-6 Lunaの最高点28を超える30〜36点は、Haiku 5.5のhigh以上でしか出ていません。
- プロンプトが100Kトークンを超えると、Haiku 5.5はリクエスト全体の単価が5倍になります。100K〜272Kの依頼ではGPT-6 Lunaのほうが約5倍安くなります。
先に試す順番の目安は次のとおりです。大量の短い分類や抽出、100Kを超える長い入力、最初の応答までの速さを重視する用途はGPT-6 Lunaから。ブラウザやPCの操作、Claude Codeのサブエージェントのように、ベンダー公表のスコア差が大きい用途はHaiku 5.5から。どちらも日本から公式APIを利用できます。
Haiku 5.5とGPT-6 Lunaの料金:単価と高い料金帯に切り替わる位置
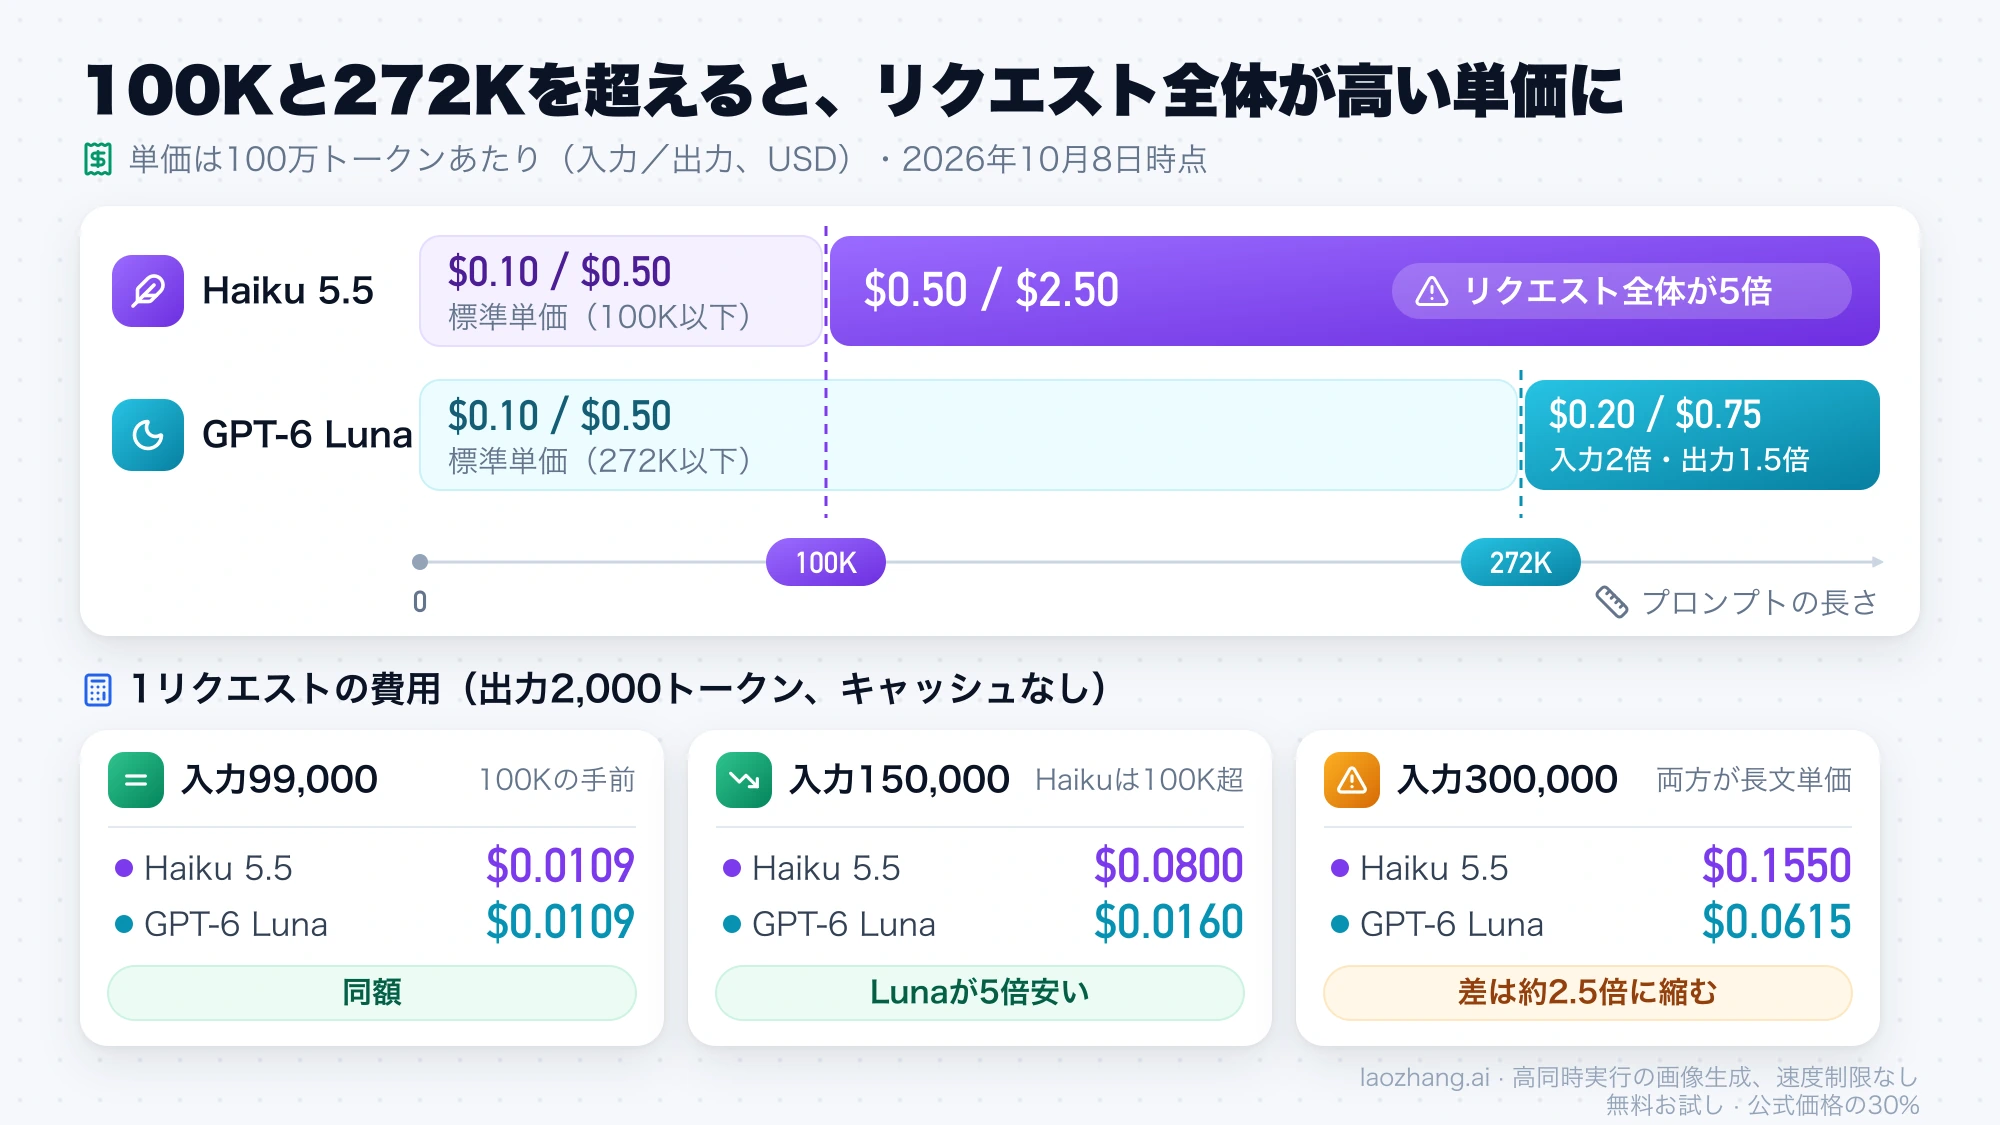
短い依頼の単価は、入力・キャッシュ読み出し・出力のすべてで同じです。違うのは高い料金帯に入る位置と、入ったときの上がり幅です。
| 項目(100万トークンあたり、USD) | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| 標準の単価が適用される範囲 | プロンプト100,000トークン以下 | 入力272,000トークン以下 |
| 入力 | $0.10 | $0.10 |
| キャッシュ読み出し | $0.01 | $0.01 |
| キャッシュ書き込み | $0.125(5分)、$0.20(1時間) | $0.125 |
| 出力(思考・推論トークンを含む) | $0.50 | $0.50 |
| 範囲を超えた依頼の入力/キャッシュ読み出し/出力 | $0.50/$0.05/$2.50 | $0.20/$0.02/$0.75 |
| 範囲を超えたときの上がり幅 | すべての項目が5倍 | 入力とキャッシュが2倍、出力が1.5倍 |
| バッチ処理 | Batch APIで入出力とも50%引き | BatchとFlexで50%引き |
| 優先処理 | Priority Tier非対応 | Fast mode(旧Priority)は2倍の単価 |
どちらも、範囲を超えると超えた分だけでなくリクエスト全体が高い単価になります。OpenAIは「272Kを超える入力のプロンプトはリクエスト全体に長文の料金をかける」と明記しています。Anthropicは料金表の各行に「100,000トークンを超えるプロンプト」と書き、出力とキャッシュの列も同じ行で5倍にしているので、出力も含めて全体が上がると読むのが自然です。
単価が同じでも、同じ文章が同じトークン数になるとは限りません。Haiku 5.5は新しいトークナイザーを使っており、Anthropicによると同じ文章がHaiku 4.5より約30%多いトークンになります。OpenAIのトークナイザーとの比率は公開されていないので、日本語の多い入力では両方のAPIで実際のトークン数を数えてから見積もってください。
「同じ料金」「12倍」「75%安い」はそれぞれ何を測った数字か
Haiku 5.5の公開直後から、食い違って見える3つの数字が出回っています。どれも間違いではありませんが、測っているものが違います。
| よく見る主張 | 実際に比べているもの | 自分の請求への効き方 |
|---|---|---|
| 「Lunaと同じ料金」 | 100万トークンあたりの定価(Haikuは100K以下、Lunaは272K以下) | トークン数が同じなら1リクエストの費用も同じ。ただし同じ課題で出るトークン数は同じにならない |
| 「同じ作業で12倍かかった」 | 1つの依頼を両方に解かせた体験談として出回っている数字。Artificial Analysisの旧指数v4.3.2ではHaiku 5.5のmaxとGPT-6 Lunaのmediumを並べたときだけ約12倍 | effortをそろえると2.2〜8.6倍(v5.0)。12倍はeffortの違いを含んだ比較 |
| 「75%安くなった」 | Anthropicが示したHaiku 4.5との平均比較 | GPT-6 Lunaとの比較ではない。Haiku 4.5から移るときの目安 |
12倍の計算は、旧指数v4.3.2(2026年10月8日時点)でHaiku 5.5(max)の1課題$0.2128をGPT-6 Luna(medium)の$0.0175で割った値(約12.2倍)でした。2026年10月28日時点のv5.0では、同じ組み合わせが$0.4110÷$0.0422で約9.7倍です。effortを同じにした組み合わせでは、最大でもlow同士の約8.6倍です。
75%はAnthropicのHaiku 5.5発表にある数字で、100Kトークン以下の依頼では90%、100K超では50%安く、トークナイザーの変更で1課題のトークンが少し増える分も織り込んだ平均です。Anthropicによると、従来のHaikuに来ていた依頼の約90%は100K以下でした。
1課題あたりの費用:同じeffortならHaiku 5.5が2.2〜8.6倍
Artificial Analysis(AA)の総合指数(Intelligence Index v5.0、9種類の評価)を、effortごとに両モデルで回した結果です(2026年10月28日時点)。AAは2026年10月27〜28日に10種類の評価からなるv4.3.2からこの版へ切り替えており、新旧の点数はそのまま比べられません。費用は、AAが全評価を定価で1回実行した費用を1課題あたりに割ったものです。
| effort | Haiku 5.5のスコア | GPT-6 Lunaのスコア | Haiku 5.5の1課題費用 | GPT-6 Lunaの1課題費用 | 費用の比(Haiku÷Luna) | 1課題の所要時間(Haiku/Luna) |
|---|---|---|---|---|---|---|
| max | 36 | 28 | $0.4110 | $0.1520 | 2.7倍 | 593秒/597秒 |
| xhigh | 34 | 23 | $0.2484 | $0.1041 | 2.4倍 | 441秒/357秒 |
| high | 30 | 21 | $0.1586 | $0.0729 | 2.2倍 | 298秒/269秒 |
| medium(両方の既定値) | 25 | 18 | $0.0918 | $0.0422 | 2.2倍 | 193秒/非公開 |
| low | 19 | 10 | $0.0438 | $0.0051 | 8.6倍 | 98秒/28秒 |
| none(推論なし、Lunaのみ) | — | 9 | — | $0.07 | — | —/86秒 |
単価が同じなので、費用の差はほぼトークン量の差です。旧指数v4.3.2(2026年10月8日時点)の計測では、medium〜maxでHaiku 5.5の出力がGPT-6 Lunaの2.8〜3.2倍、lowでは8.3倍ありました。同じ時点でAAは、Haiku 5.5(max)が指数一式で出力したトークンを約4.4億とし、比較対象の中央値(約1億)を大きく上回る「very verbose」に分類していました。v5.0でもmedium〜maxの出力は2.7〜3.1倍です。
maxで指数一式を回した総額はAAのmax同士の比較ページでHaiku 5.5が$339、GPT-6 Lunaが$136です(2026年10月28日時点)。総額の比(約2.5倍)が1課題の比(約2.7倍)と一致しないのは、両モデルで集計された課題数が違うためです。旧指数v4.3.2の時点では、Haiku 5.5の総額$330のうち約$199(約6割)が思考トークンの出力代でした。
AAはHaiku 5.5をすべて100K以下の単価で計算しています。100Kを超えるプロンプトの課題が含まれていれば、Haiku 5.5の実際の費用は表より高くなります。
スコアをそろえると費用はほぼ互角、30点以上はHaiku 5.5だけ
同じeffortで比べると、Haiku 5.5は費用が高いぶんスコアも7〜11点高くなります。そこで「同じスコアを出すのにいくらかかるか」で並べ直すと、差はほとんどなくなります。
| 狙うスコア帯 | Haiku 5.5の設定と1課題費用 | GPT-6 Lunaの設定と1課題費用 | 費用の比 | 1課題の所要時間(Haiku/Luna) |
|---|---|---|---|---|
| 18〜19 | low(19)$0.0438 | medium(18)$0.0422 | Haikuが約1.04倍 | 98秒/非公開 |
| 23〜25 | medium(25)$0.0918 | xhigh(23)$0.1041 | Haikuが約12%安い | 193秒/357秒 |
| 28〜30 | high(30)$0.1586 | max(28)$0.1520 | Haikuが約1.04倍 | 298秒/597秒 |
| 34〜36 | xhigh(34)$0.25、max(36)$0.4110 | 届かない | — | 441秒、593秒/— |
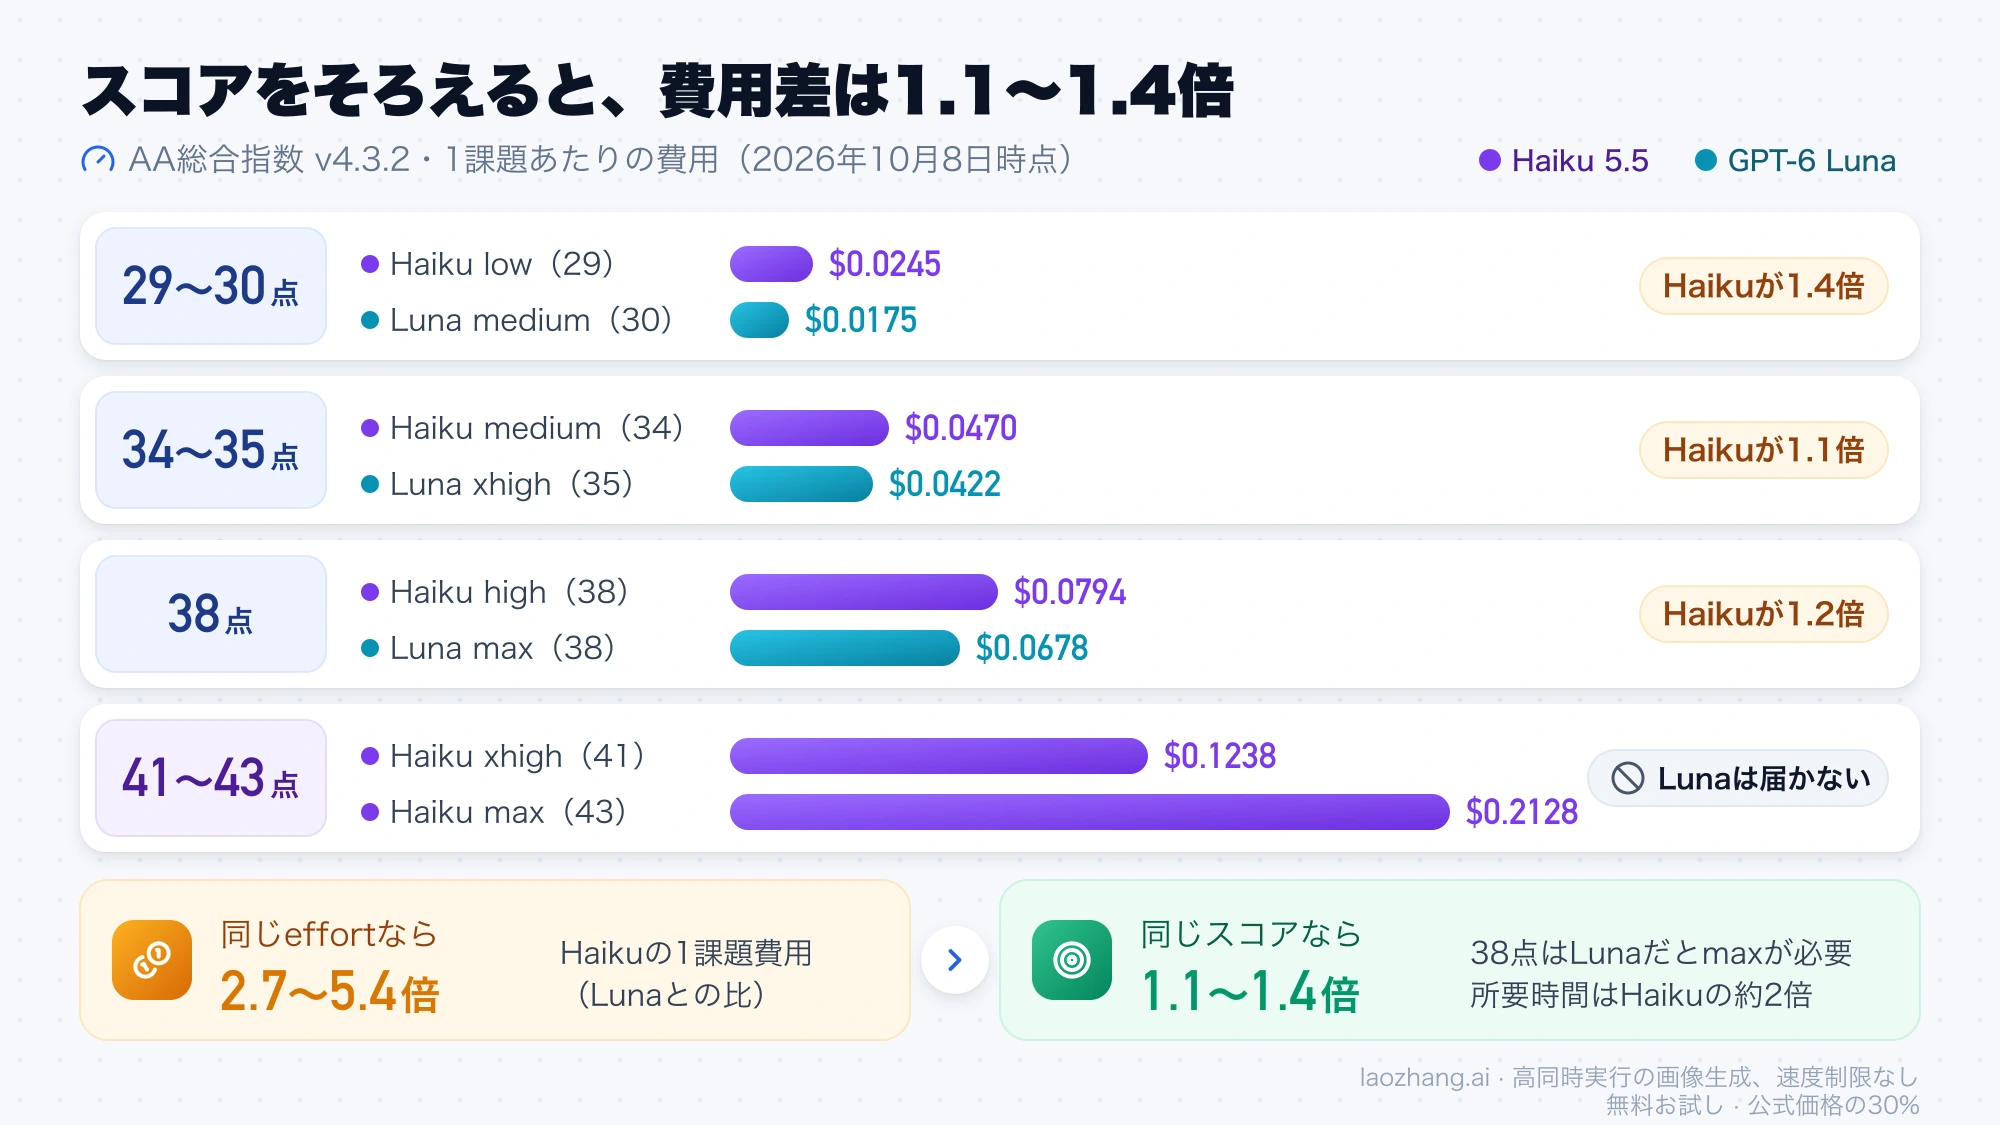
図はArtificial Analysisの旧指数v4.3.2(2026年10月8日時点)の数値です。2026年10月28日時点のv5.0の数値は上の表のとおりで、既定のmedium付近ではHaiku 5.5のほうが安くなっています。
既定のmedium付近では、Haiku 5.5のmedium(25点)がGPT-6 Lunaのxhigh(23点)より点数が高く、費用は約12%安く、所要時間も約半分です。28〜30点の帯ではGPT-6 Lunaのmaxが約4%安いものの点数は2点低く、所要時間はHaiku 5.5(high)の約2倍かかります。18〜19点の帯ではGPT-6 Lunaのmediumが約4%安くなります。冗長でもスコアの高いモデルが得になるのは、次のような場合です。
- 必要な品質がGPT-6 Lunaのxhigh〜maxでやっと届く水準の場合。Haiku 5.5のmediumかhighなら、費用は同じかそれより安く、時間は約半分になります。
- 必要な品質がGPT-6 Lunaの上限(28点)を超える場合。Haiku 5.5のhigh以上(30〜36点)しか選択肢がありません(この帯ならSonnet 5.5も比べる価値があります)。
反対に、GPT-6 Lunaのlowやmediumで課題を十分こなせるなら、Haiku 5.5に替えても同じeffortで2.2〜8.6倍払うだけです。
総合指数は9種類の評価の合成なので、項目によっては順位が逆になります。AAの内訳では、Terminal-Bench 4.0はmax同士でHaiku 5.5が32.8%、GPT-6 Lunaが12.6%と大差ですが、AutomationBench-AAはGPT-6 Lunaが53.2%、Haiku 5.5が35.4%と逆転します。長文読解のAA-LCRは83.3%と82.7%でほぼ同じでしたが、この評価は旧指数v4.3.2に含まれていたもので、v5.0の指数からは外れています。自分の用途に近い項目を確認してください。
自分のデータで比べるときは、次の式で「使える結果1件あたり」の費用にそろえます。
使える結果1件あたりの費用 = 1課題の費用 ÷ 合格率例えばmedium同士なら、Haiku 5.5の$0.0918はGPT-6 Lunaの$0.0422の約2.18倍なので、GPT-6 Lunaの合格率がHaiku 5.5の約46%(1÷2.18)を下回らない限り、GPT-6 Lunaのほうが安くつきます。Haiku 5.5が90%合格する課題なら、GPT-6 Lunaは約41%以上合格すれば安い計算です。不合格の結果を人が直す手間が大きい業務では、その手間も費用に足して比べてください。
自分の依頼で見積もる:計算式と5つの例
1リクエストの費用は、各トークン数に単価をかけて足すだけです。
費用 = 入力 × 入力単価
     + キャッシュ読み出し × 読み出し単価
     + キャッシュ書き込み × 書き込み単価
     + 出力(思考・推論を含む)× 出力単価
(単価は100万トークンあたりなので、トークン数 ÷ 1,000,000をかける)
プロンプトの長さで、まずどちらの料金帯かを決めます。以下はキャッシュなしの例です。
| 例 | 条件 | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| A:短い依頼 | 入力10,000・出力1,000 | $0.0015 | $0.0015 |
| B:100Kの手前 | 入力99,000・出力2,000 | $0.0109 | $0.0109 |
| C:100K超 | 入力150,000・出力2,000 | $0.0800 | $0.0160 |
| D:272K超 | 入力300,000・出力2,000 | $0.1550 | $0.0615 |
| E:大量の分類 | 100万回 ×(入力2,000・出力300) | $350(バッチなら$175) | $350(Batch/Flexなら$175) |
計算の中身は次のとおりです。
- A:10,000 × $0.10 + 1,000 × $0.50を100万で割ると$0.0010 + $0.0005 = $0.0015。両者同額です。
- C:Haiku 5.5は100K超の単価になり、150,000 × $0.50 + 2,000 × $2.50で$0.0750 + $0.0050 = $0.0800。GPT-6 Lunaは272K以下なので150,000 × $0.10 + 2,000 × $0.50で$0.0150 + $0.0010 = $0.0160。差は5倍です。
- D:GPT-6 Lunaも長文の単価になり、300,000 × $0.20 + 2,000 × $0.75 = $0.0600 + $0.0015 = $0.0615。Haiku 5.5は300,000 × $0.50 + 2,000 × $2.50 = $0.1500 + $0.0050 = $0.1550で、差は約2.5倍に縮みます。
- E:1回あたり2,000 × $0.10 + 300 × $0.50 = $0.0002 + $0.00015 = $0.00035、100万回で$350です。
Eのような大量処理では、出力に思考トークンが乗るかどうかが効きます。仮に1回あたり思考が1,000トークン増えると、1回$0.0005、100万回で$500が上乗せされ、合計$850になります。両モデルとも既定のeffortはmediumで、何も指定しなければ思考が走ります。GPT-6 Lunaはnoneで推論を止められ、Haiku 5.5はeffortがhigh以下ならthinking: {"type": "disabled"}で思考を切れます。分類のように答えが短い用途では、まず思考を止めた設定で精度を測るのが近道です。
100K超とキャッシュ:Haiku 5.5の予算は高いほうの単価で組む
Haiku 5.5で見落としやすいのは、キャッシュから読んだトークンも100Kの判定に数えられることです。Anthropicの料金ページは、プロンプトの長さにはリクエストの入力トークンがすべて数えられ、キャッシュ読み出しとキャッシュ書き込みも含まれると明記しています。料金はリクエストごとに決まり、100Kを超えたリクエストはプロンプトの一部がキャッシュヒットでも高い単価になります。それ以前のリクエストの料金は変わりません。
影響の大きさを、150,000トークンのプロンプトのうち140,000トークンがキャッシュ読み出し、10,000トークンが新しい入力、出力が2,000トークンという例で計算します。
| ケース | 計算 | 1リクエストの費用 |
|---|---|---|
| Haiku 5.5(キャッシュも100Kに数える) | 140,000 × $0.05 + 10,000 × $0.50 + 2,000 × $2.50 | $0.0170 |
| GPT-6 Luna(272K以下) | 140,000 × $0.01 + 10,000 × $0.10 + 2,000 × $0.50 | $0.0034 |
キャッシュ読み出しが大半でも、Haiku 5.5はLunaの5倍になります。予算は$0.0170のほうで組み、usageのcache_read_input_tokens、cache_creation_input_tokens、input_tokensの合計で100Kを超えていないかを確かめてください。
エージェント用途では、システムプロンプト、会話履歴、ツール定義、ツールの返り値がすべてプロンプトに積み上がります。ツール利用時はシステムプロンプトだけで286〜406トークン増え、ブラウザ操作のように画面やページ内容を返す処理では、セッションの途中で100Kを超えることがあります。Haiku 5.5で長いループを回すなら、履歴の要約や切り詰めで100K未満に保つか、その部分だけGPT-6 Lunaに回すかを決めておくと、請求が急に5倍になる事態を避けられます。
用途別にどちらを先に試すか:分類・長文・ブラウザ操作・サブエージェント
| 用途 | 先に試す | 根拠 | 切り替えを考える条件 |
|---|---|---|---|
| 大量の分類・ルーティング・抽出(短い入力) | GPT-6 Luna(noneかlow) | 単価が同じで出力が最も少ない。AA v5.0のlowで1課題$0.0051、Haiku 5.5のlow($0.0438)の約9分の1 | 合格率で割ってもHaiku 5.5のlowが安くなるとき |
| 100Kを超える長い入力(RAG、長文要約、ログ解析) | GPT-6 Luna | 100K〜272Kではリクエスト単価が約5倍安い。旧指数のAA-LCRはほぼ同点 | Haiku 5.5を使うなら入力を100K未満に分割できるとき |
| ブラウザ操作・PC操作 | Haiku 5.5 | Anthropic公表のOSWorld 2.1(オフラインのサブセット)で72.4%対48.9%。ブラウザ操作用のbrowser_toolset_20260801がある | 自分の画面と手順で合格率に差が出ないとき |
| コーディングのサブエージェント(Opus 5.5やSonnet 5.5と併用) | Haiku 5.5 | Anthropic公表のTerminal-Bench 4.0で39.2%対16.4%、AAのmax同士でも32.8%対12.6% | 普段の環境がCodexなどOpenAI側にそろっているとき |
| 対話の最初の応答を速く返したい用途(サポート窓口など) | GPT-6 Luna(lowかnone) | AAの初回トークンまでの時間(2026年10月8日時点)はGPT-6 Lunaのlowで3.2秒、推論なしで0.9秒、Haiku 5.5のlowで12.0秒 | 長い回答を一気に出す用途。生成速度はHaiku 5.5のほうが速い(2026年10月28日時点のlowで毎秒185トークン対119トークン) |
| GPT-6 Lunaの上限(AA総合28)を超える品質が必要 | Haiku 5.5のhigh以上 | AA v5.0で30〜36点。1課題$0.16〜$0.41 | この費用帯ならSonnet 5.5との比較も必要 |
Anthropicの表のスコアは、セルごとのeffortが明記されていないベンダー計測です。OSWorldの数字もオフラインのサブセットでの値なので、そのまま本番の成功率とは読めません。
小規模な第三者テストもあります。kingy.aiのHaiku 5.5とGPT-6 Lunaの比較テストは、40の課題を各2回、Claude MaxとChatGPT Proのサブスクリプション経由のコマンドラインクライアントで解かせ、入力はすべて2万トークン未満でした。全チェック合格はHaiku 5.5が80件中60件(75.0%)、GPT-6 Lunaが51件(63.75%)。差が出たのは計算(10件中8件対4件)や編集(8件対5件)で、JSON抽出とコード修正は両者とも10件すべて合格でした。完了までの時間の中央値はHaiku 5.5が6.83秒、GPT-6 Lunaが2.92秒です。課題数が少なく、クライアントも別物なので、自分の課題で傾向を確かめるための手がかりとして使うのが妥当です。
GPT-6 LunaとHaiku 5.5を切り替えるときに壊れる設定
APIのコードを使い回すと、次の点で400エラーや費用の変化が起きます。Haiku 5.5側の詳細はAnthropicのHaiku 5.5移行ガイド、GPT-6 Luna側はOpenAIの最新モデル利用ガイドにあります。
| 項目 | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| モデルID | claude-haiku-5-5(日付なしの固定ID) | gpt-6-luna |
| effortの段階と既定値 | low・medium・high・xhigh・maxの5段階、既定はmedium | none・low・medium・high・xhigh・max、既定はmedium |
| 思考を止める方法 | thinking: {"type": "disabled"}(highまで。xhigh・maxでは400) | reasoning.effortをnoneに |
| 旧式の思考予算 | budget_tokensを送ると400。{"type": "adaptive"}とeffortに置き換える | — |
| サンプリング引数 | 省略が基本。temperatureは1、top_pは0.99以外を送ると400、top_kは値に関係なく400 | effortがnone以外ならtemperature・top_p・top_logprobsを外す |
| アシスタントのプリフィル | 思考オフでも400。最後はユーザーのターンで終える | — |
| ツールと推論の組み合わせ | — | Chat Completionsで関数呼び出しが使えるのはnoneのときだけ。推論とツールを併用するならResponses API |
| コンテキストと出力上限 | コンテキスト1M、出力128K | コンテキスト1,050,000、入力最大922,000、出力128K |
| 安全側の停止 | stop_reason: "refusal"が返ることがあり、サーバー側の代替はない | — |
ほかに見落としやすい点が3つあります。
- Haiku 5.5では思考トークンも
max_tokensに数えられます。Haiku 4.5時代の小さなmax_tokensのままだと、思考だけで上限に達して本文が出ないまま止まることがあります。 - トークン数は
claude-haiku-5-5を指定して数え直します。Haiku 4.5で測った値を流用すると、コストと100Kの判定の両方がずれます。 - PC操作はClaude APIとGoogle Cloudでは
computer_toolset_20260801だけが使え、従来のcomputer_20250124を宣言すると400になります。
Claude Code・Claude.ai・ChatGPTでHaiku 5.5とGPT-6 Lunaは使えるか
APIを使わない場合の入口は次のとおりです(2026年10月8日時点)。
- Claude.ai:AnthropicのHaikuページによると、Free・Pro・Max・Team・EnterpriseのどのプランでもHaiku 5.5を選べます(Web、iOS、Android)。
- Claude Code:v2.1.293以降が必要です。Claude Codeのモデル設定ドキュメントによると、エイリアス
haikuがHaiku 5.5を指すのはAnthropic APIで使う場合だけで、Amazon Bedrock、Google Cloud、Microsoft Foundry、Claude Platform on AWSでは今もHaiku 4.5を指します。版を固定したいときはフルのモデル名を指定します。 - ChatGPT:OpenAIの「GPT-6 for everyone」の発表によると、10月8日からFreeとGoのChatタブのGPT-6がGPT-6 Lunaで動きます(順次展開、Plus以上はGPT-6 Sol)。会話向けに調整されたモデルで、APIの
gpt-6-lunaと同一とは書かれていません。WorkとCodexで使うモデルはこの変更では変わりません。
APIの提供国には、AnthropicとOpenAIのどちらも日本を含めています。OpenAI互換のエンドポイントでGPT-6 Lunaを使う方法としては、laozhang.aiのモデル一覧にgpt-6-lunaが公式と同じ単価(272Kまでとそれ以上の2段階)で載っています。Claudeのモデルは容量の都合で一時停止していましたが、2026年10月18日に再掲載され、同じ一覧にclaude-haiku-5-5も公式と同じ単価(入力$0.1・出力$0.5、入力10万トークン超は長文脈料金)で載っています。この経路では1回の出力が32,768トークンまでに制限されます。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
OpenAIのGPT-6系の中でLunaとほかのモデルをどう分けるかは「GPT-6 Sol・Luna・AstraとTerraの違い:API料金と用途から選ぶ」、上位モデル同士の費用差は「Opus 5.5とGPT-6 Sol・6.1 Sol比較:費用差」で扱っています。
Haiku 5.5とGPT-6 Lunaのよくある質問
Claude Haiku 5.5とGPT-6 Lunaはどちらが賢いですか?
AAの総合指数v5.0(2026年10月28日時点)では、どのeffortでもHaiku 5.5が上です(maxで36対28、mediumで25対18)。Anthropicの公表値でも、知識業務のGDPval-AA v2.1(AAの旧指数v4.3.2に含まれていた評価)で1620対1437、Terminal-Bench 4.0で39.2%対16.4%とHaiku 5.5が上回ります。ただしAAのAutomationBench-AAのようにGPT-6 Lunaが上の項目もあります。また、Haiku 5.5の高いスコアは出力トークンの多さと引き換えで、同じeffortでは1課題の費用が2.2〜8.6倍です。自分の課題に近い評価で確かめるのが確実です。
Claude Haiku 4.5からHaiku 5.5に移ると本当に75%安くなりますか?
Anthropicの見積もりでは、100K以下の依頼で90%、100K超で50%安く、平均で約75%です。単価はHaiku 4.5の入力$1・出力$5から、入力$0.10・出力$0.50に下がりました。一方で、同じ文章が約30%多いトークンになり、既定でmediumの思考が走るため、実際の削減幅は依頼の長さとeffortの設定で変わります。移行前にclaude-haiku-5-5でトークン数を数え直し、出力の増え方も確認してください。
参考資料11
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月28日。
参考資料11
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月28日。
- 1.Anthropicの料金ページplatform.claude.com/docs/en/about-claude/pricing
- 2.OpenAIのAPI料金ページdevelopers.openai.com/api/docs/pricing
- 3.Artificial AnalysisのHaiku 5.5とGPT-6 Lunaの比較ページartificialanalysis.ai/models/releases/comparisons/claude-haiku-5-5-vs-gpt-6-luna
- 4.AnthropicのHaiku 5.5発表anthropic.com/claude-haiku-5-5
- 5.AAのmax同士の比較ページartificialanalysis.ai/models/comparisons/claude-haiku-5-5-vs-gpt-6-luna
- 6.kingy.aiのHaiku 5.5とGPT-6 Lunaの比較テストkingy.ai/blog/claude-haiku-5-5-vs-gpt-6-luna-benchmark
- 7.AnthropicのHaiku 5.5移行ガイドplatform.claude.com/docs/en/models/haiku-5-5/migration-guide
- 8.OpenAIの最新モデル利用ガイドdevelopers.openai.com/api/docs/guides/latest-model
- 9.AnthropicのHaikuページanthropic.com/claude/haiku
- 10.Claude Codeのモデル設定ドキュメントcode.claude.com/docs/en/model-config
- 11.OpenAIの「GPT-6 for everyone」の発表openai.com/index/gpt-6-for-everyone