Claude Fable 5.2とOpus 5.5の違い:同じ正解数で費用1.86倍
Fable 5.2の単価はOpus 5.5の2倍。普段はOpusの既定effortで十分で、xhighでも解けない仕事だけFableをmediumかhighで試します。
目次
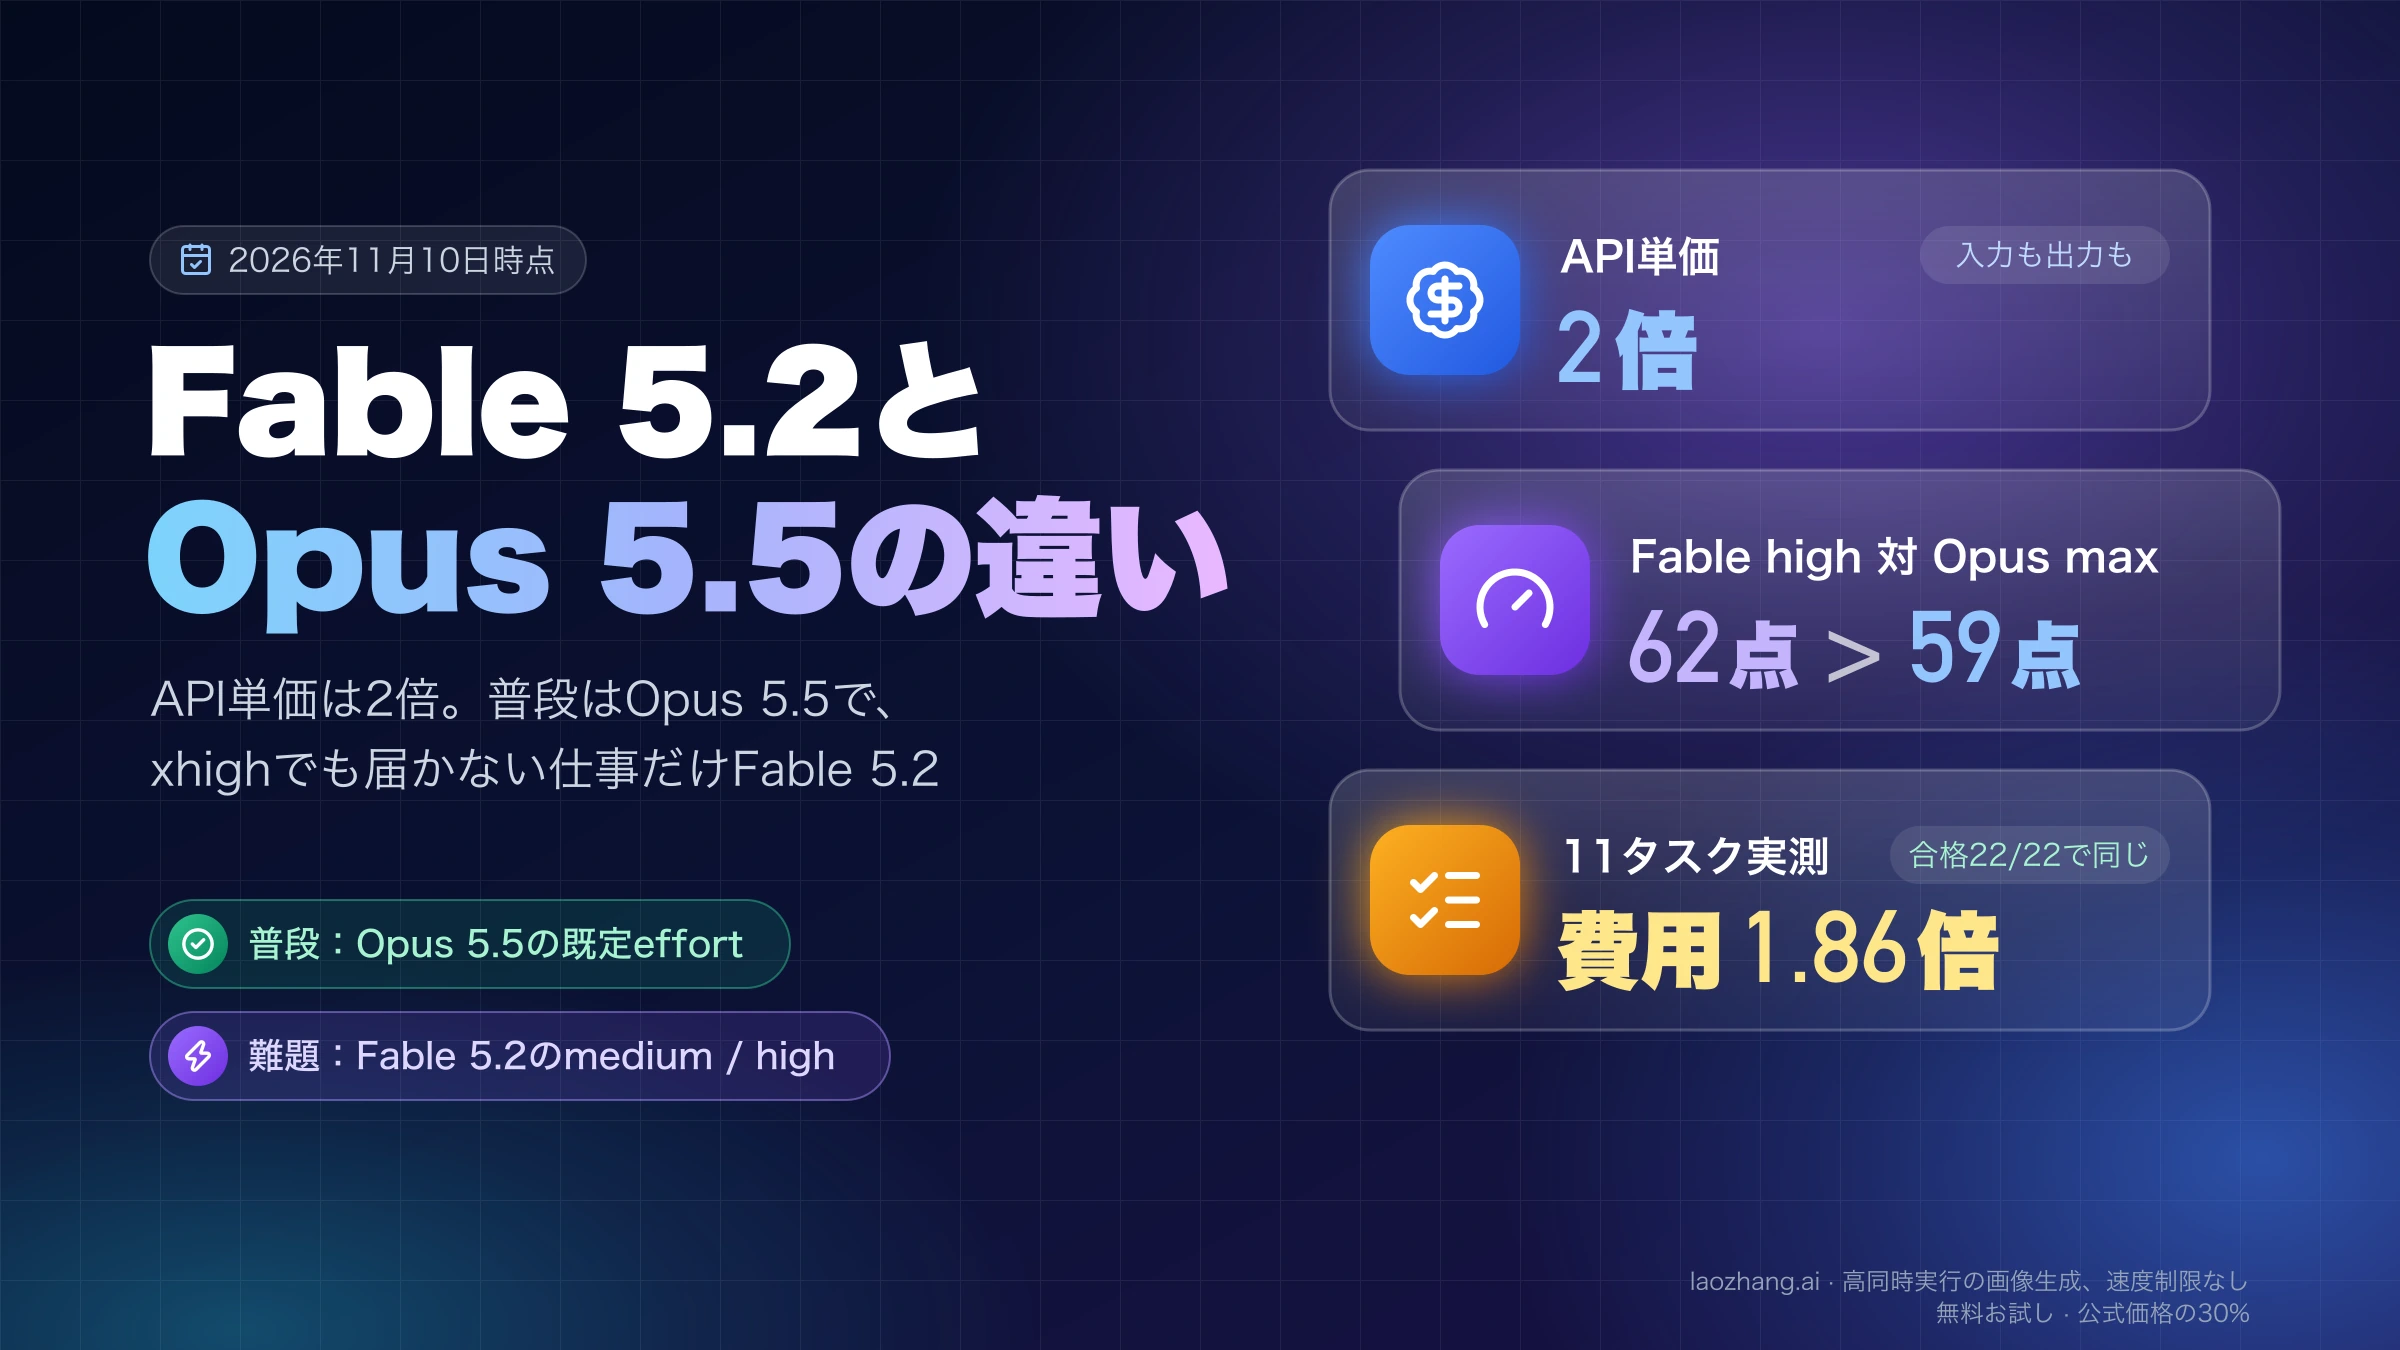
2026年11月9日に公開されたClaude Fable 5.2は、Opus 5.5の上に位置するモデルで、API単価は入力も出力もOpus 5.5のちょうど2倍です。普段のコーディング、調査、資料作成は、これまでどおりOpus 5.5の既定effortから始めてください。Fable 5.2に替えるのは、Opus 5.5をxhighやmaxにしても品質が届かない仕事、何時間も続くエージェント作業、結論まで詰める多段の調査です。Anthropicのモデル選択ガイドもこの順序を勧めています。
切り替えるときは、モデルと一緒に推論の強さ(effort)も選び直します。Artificial Analysisの総合指数v5.0.1(2026年11月10日時点)では、Fable 5.2のhighが62点でOpus 5.5のmaxの59点を上回り、1タスクの費用も約1割少なく済みます。一方、仕様と合格条件がはっきりした仕事では差が出ません。2026年11月10日に同じ11タスクを両モデルのhighでClaude Codeに解かせたところ、44件すべてが合格し、Fable 5.2はトークンを定価で換算した費用が1.86倍、所要時間が1.27倍でした。
プランによって条件が変わります。MaxとUltraでは週の利用上限の50%までFableを使え、Proでは公開記念として太平洋時間11月16日23時59分(日本時間11月17日16時59分)まで同じ扱いですが、その後は従量課金のクレジット(usage credits)で払います。APIではeffortを省略するとFable 5.2がhighで動くので、明示してから切り替えてください。
Fable 5.2とOpus 5.5の使い分け:Opusのxhighで足りるかが境目
Fable 5.2を使うかどうかの境目は、Opus 5.5のeffortをxhighやmaxまで上げても解けない仕事かどうかです。Anthropicは発表で、Opus 5.5を「最も強力な日常用モデル」と呼び、ほとんどのコーディングと知識作業はOpus 5.5から始め、仕事の範囲と難しさに応じてFableへ上げるよう勧めています。Fableの用途として挙げているのは、何時間も続くエージェント作業、多段の調査、分析を文書・表・スライドの完成形まで仕上げる仕事です(Claude Fable 5.2とMythos 5.2の発表)。
| 仕事の種類 | 先に試す設定 | Fable 5.2を検討する条件 |
|---|---|---|
| 仕様とテストが決まったバグ修正、機能追加、レビュー | Opus 5.5のmedium、足りなければhigh、xhigh | Opusのxhighでも同じテストに落ち続ける |
| 数時間続くエージェント作業、資料や表まで仕上げる分析 | Opus 5.5のxhighとFable 5.2のmediumを並べて試す | Fableのmediumで同等以上なら、Fableのほうが安く速く終わりうる |
| Web調査をまとめた調査レポート | Opus 5.5の既定 | 自分の評価でFableが上回るときだけ(下記のDeepResearch Bench IIでは逆) |
| 専門知識を問う推論、図表の読み取り | Fable 5.2のlowかmediumも最初から候補 | Anthropicの計測では、Opusの最高点にFableの低い段階が10分の1未満の費用で並ぶ |
| サイバーセキュリティ、生物学の研究 | Opus 5.5 | Fableでは分類器に止められ、別の旧モデルが答える |
最後の行は、Fable 5.2固有の安全対策によるものです。侵入テスト、エクスプロイトの作成、バイナリの脆弱性調査、研究目的の生物学の大半は分類器がブロックし、その場合はサイバーならOpus 4.8、生物学ならOpus 5が代わりに回答します。Fable 5.1よりブロックは約55%減ったとAnthropicは説明していますが、この分野でFableを選ぶと、Opus 5.5より古いモデルの答えを受け取る可能性があります。なお、Opus 5.5にも安全対策はあり、AnthropicのコストガイドではDeepResearch Bench IIの生物学の4タスクで止められています。
Fable 5.2 highとOpus 5.5 xhighはどちらが得か:同じ点数で比べる
同じ段階名どうしではなく、同じ点数どうしで比べると答えが出ます。Artificial Analysisの総合指数v5.0.1(2026年11月10日時点)では、Fable 5.2のhighは62点でOpus 5.5のxhighの57点より5点高く、費用は1タスク$9.08対$6.05で1.5倍、時間は17.7分対16.3分でほぼ同じです。Opusのxhighと同じくらいの点数で足りるなら、Fable 5.2のmediumが56点を$3.80、8.3分で出すので、費用は37%少なく、時間は約半分になります。
| effort | Fable 5.2 | Opus 5.5 | 同じ段階での費用比 |
|---|---|---|---|
max | 65点・$26.54・44.1分 | 59点・$10.04・25.1分 | 2.64倍 |
xhigh | 62点・$14.83・26.3分 | 57点・$6.05・16.3分 | 2.45倍 |
high | 62点・$9.08・17.7分 | 52点・$3.46・9.5分 | 2.62倍 |
medium | 56点・$3.80・8.3分 | 48点・$2.45・7.1分 | 1.55倍 |
low | 54点・$3.10・6.5分 | 35点・$0.98・3.0分 | 3.16倍 |
数値は左から総合指数、1タスクあたりの費用、1タスクあたりの時間です。出典はArtificial AnalysisのOpus 5.5とFable 5.2の比較ページで、費用はAPIの定価で計算されています。公開翌日の数値で、同サイトは予告なく数値を改めることがあります。
点数が近い組み合わせを拾うと、Fable 5.2のhighはOpus 5.5のmaxより点が高く、費用も時間も少なく済みます。Fableのlow(54点、$3.10)もOpusのhigh(52点、$3.46)をわずかに上回ります。逆に、Opusのmedium(48点、$2.45)やlow(35点、$0.98)で足りる仕事では、Fableの最安のlowでも$3.10かかるので、安さでOpusに勝てる段階はありません。同じ段階名で比べるとFableは1.55〜3.16倍の費用で5〜19点上という関係になり、「Fableは高い」という印象はこの比べ方から来ています。
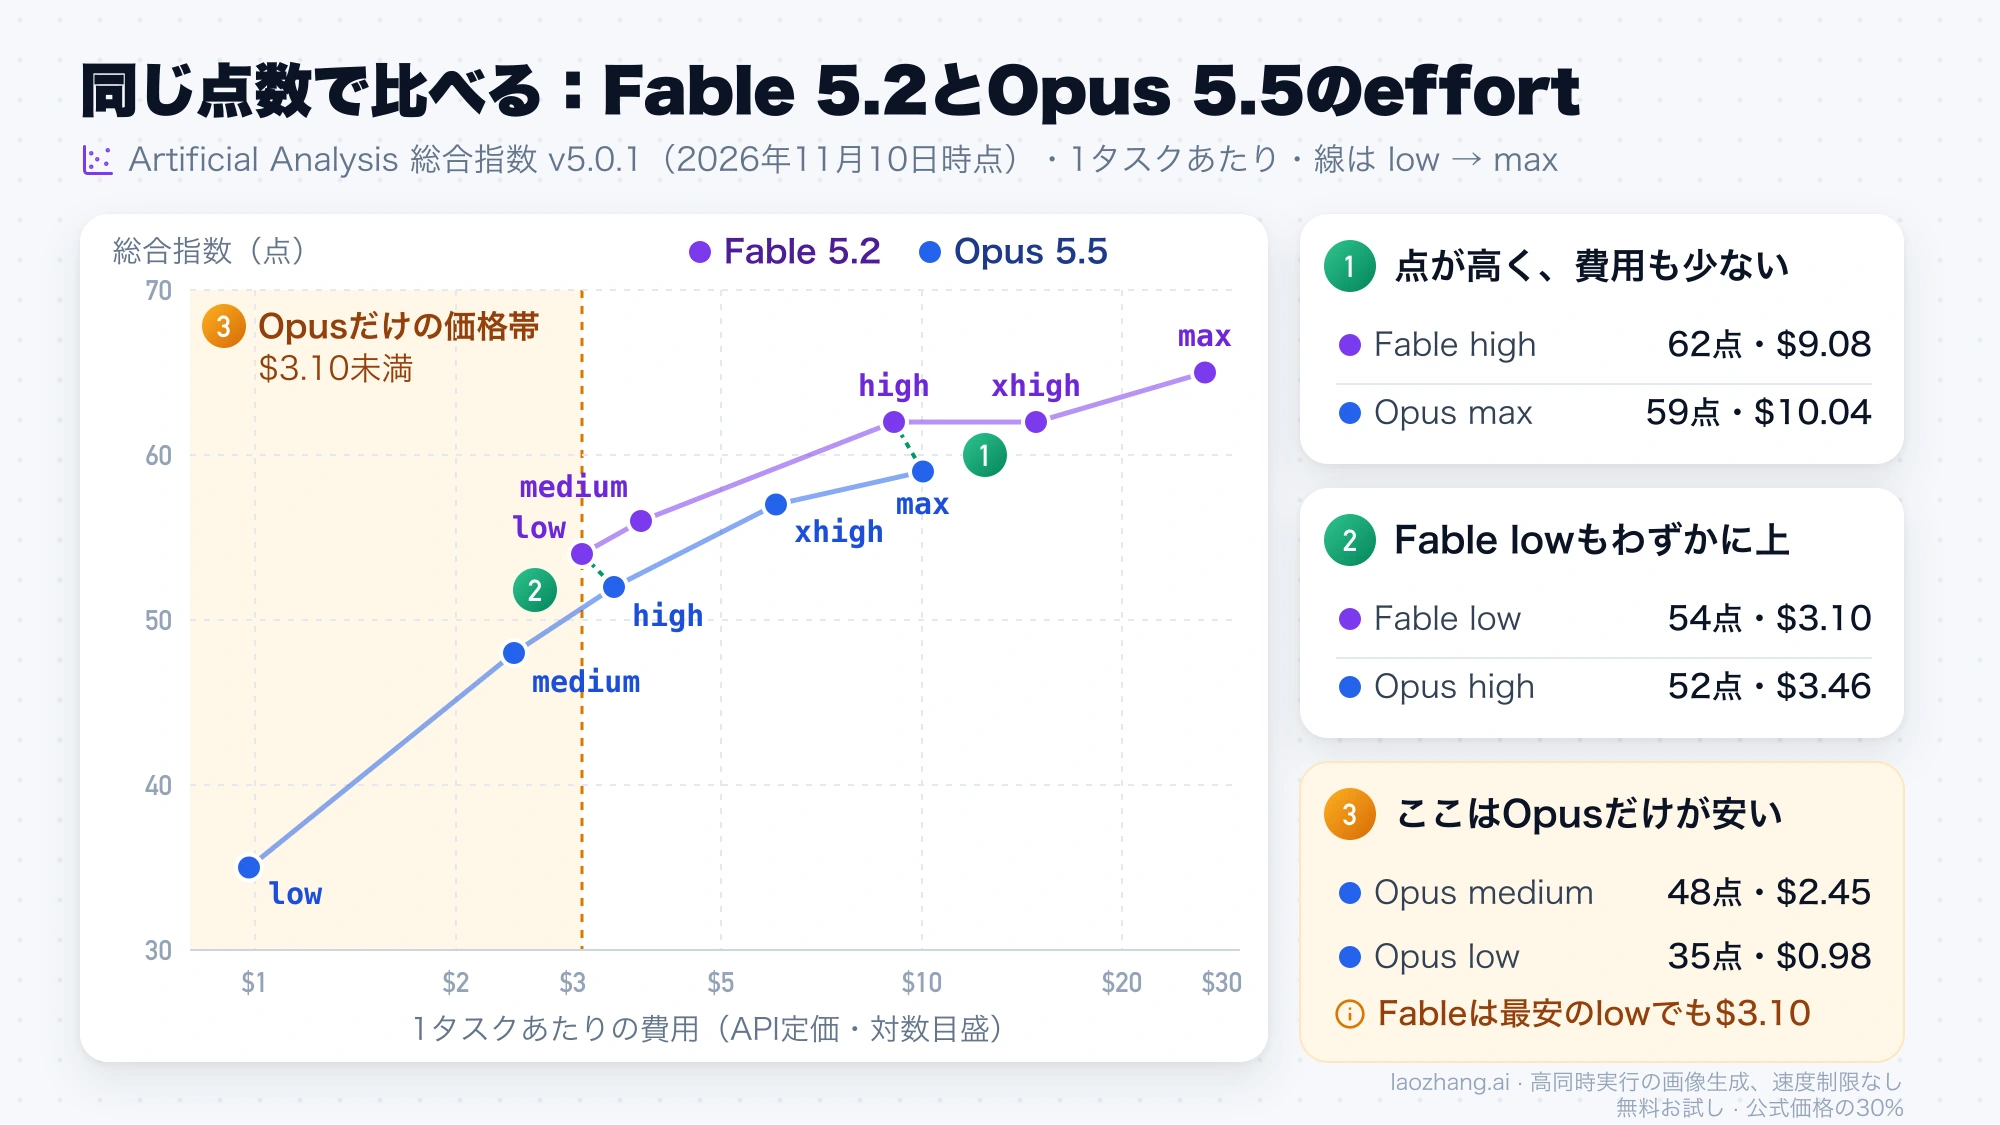
Fable 5.2自身の段階選びでは、xhighはhighと同じ62点で費用が約1.6倍です。Anthropicのeffortの指針も、Fable 5.2はhighから始め、能力の伸びの大半はhighまでに出ており、xhighは効果を測れた仕事だけ、maxはxhighより遅く高いわりに伸びが小さいことが多い、としています。Anthropicの発表にある計測も同じ向きで、FrontierCode 2.0ではFableのhighがOpusのmaxとほぼ同点(45.3%対45.5%)を約半分の費用で、Humanity's Last ExamではFableのlowがOpusの最高点に10分の1未満の費用で並んでいます。
普通のコーディングでは逆:Opus 5.5のxhighが約半額で並ぶ
Opus 5.5がほぼ解けてしまう種類の仕事では、向きが逆になります。Anthropic自身のコストと性能の最適化ガイドによると、SWE-bench Proの一部(463問)で、Fable 5.2のhighは96.3%を解いて1問あたり$1.39、Opus 5.5のxhighは96.5%を$0.75で解きました。同じ正答率をOpusは約半分の費用で出しています。Opusのhighも95.5%を$0.30で解き、Fableのlow(94.6%、$0.39)より高い正答率を安く出しており、既定のmediumなら93.1%で$0.22です。ガイドはこの問題群について、Opus 5.5でもほぼ解き切ってしまうと注記しています。
調査でも同じことが起きています。同ガイドのDeepResearch Bench II(44タスク、Messages APIの既定effort)では、Fable 5.2はOpus 5.5の2.9倍の費用で、点数は1.9ポイント低い結果でした。社内のエージェント型コーディング評価では、mediumどうしでFable 5.2が88.9%(1回のみの実行)とOpus 5.5の86.6%を2.3ポイント上回ったものの、1回の試行あたりの費用は$1.34対$0.84で約1.6倍でした。
前の節の結果と食い違うのは、仕事の難しさが違うからです。Opusがすでに解ける問題では、Fableの余力は点数に表れず、2倍の単価と多めの思考だけが費用に乗ります。Opusが解けない問題では、Fableの低い段階がOpusの高い段階より安く同じ結果を出すことがあります。ガイドが「1トークンではなく、完了したタスク1件あたりの費用で比べ、Opus 5.5の既定と、effortを下げた上位モデルの両方を試す」よう求めているのはこのためです。
同じ11タスクの実測:合格数は同じ、Fableは費用も時間も上
仕様が明確な小さなタスクでは、Fable 5.2とOpus 5.5の合格数は変わらず、Fableのほうが費用も時間もかかりました。2026年11月10日、同じ11タスクをClaude Code(アプリ同梱の2.1.317、macOS)のサブエージェントに与え、Fable 5.2とOpus 5.5で各2回、すべてのリクエストのeffortをhighにして実行しました。応答したモデルは記録上claude-fable-5-2とclaude-opus-5-5です。タスクは、料金の文章題1問、隠しテストで採点する小さなPython関数3問、6,723語の記事の5項目要約、数式評価器、CSVの1行パーサー、コードを使わない数え上げ、semverの範囲判定、長文に埋もれた3つのメモからの計算、架空の関数2つを混ぜた標準ライブラリの質問です。
| 項目(1回あたりの平均) | Fable 5.2(high) | Opus 5.5(high) | Fable÷Opus |
|---|---|---|---|
| 合格(2回の合計) | 22/22 | 22/22 | 同じ |
| APIの往復回数 | 8回 | 15回 | 0.53倍 |
| 出力トークン(うち思考) | 24,052(8,426) | 17,826(4,684) | 1.35倍(思考1.80倍) |
| 所要時間 | 221.8秒 | 174.9秒 | 1.27倍 |
| 出力の費用 | $0.96 | $0.36 | 2.70倍 |
| コンテキストの費用 | $1.19 | $0.80 | 1.49倍 |
| 合計 | $2.15 | $1.16 | 1.86倍 |
費用は、使ったトークンをAPIの定価(Fableは出力100万トークンあたり$40、Opusは$20、キャッシュ読み出しはどちらも$0.20)で換算した値で、実際の請求額ではありません。実行はサブスクリプションの範囲で行っています。比較したのはどちらもhighで、各モデルの既定の段階ではありません。
Fableは同じ答えを出すのに思考を1.80倍使ったため出力トークン全体が1.35倍になり、出力トークンの単価も2倍なので、出力の費用は1.35×2で2.70倍になりました。それでも合計が2倍を下回ったのは、Fableが1回の応答で複数のツール呼び出しをまとめ、APIの往復が約半分で済んだからです。各回とも85,000〜125,000トークンほどのセッション文脈を毎回キャッシュから読み直しており、その読み出し単価は両モデルで同じです。文脈が軽い環境なら合計の比率は出力の2.70倍に近づき、重い環境なら差が縮まります。
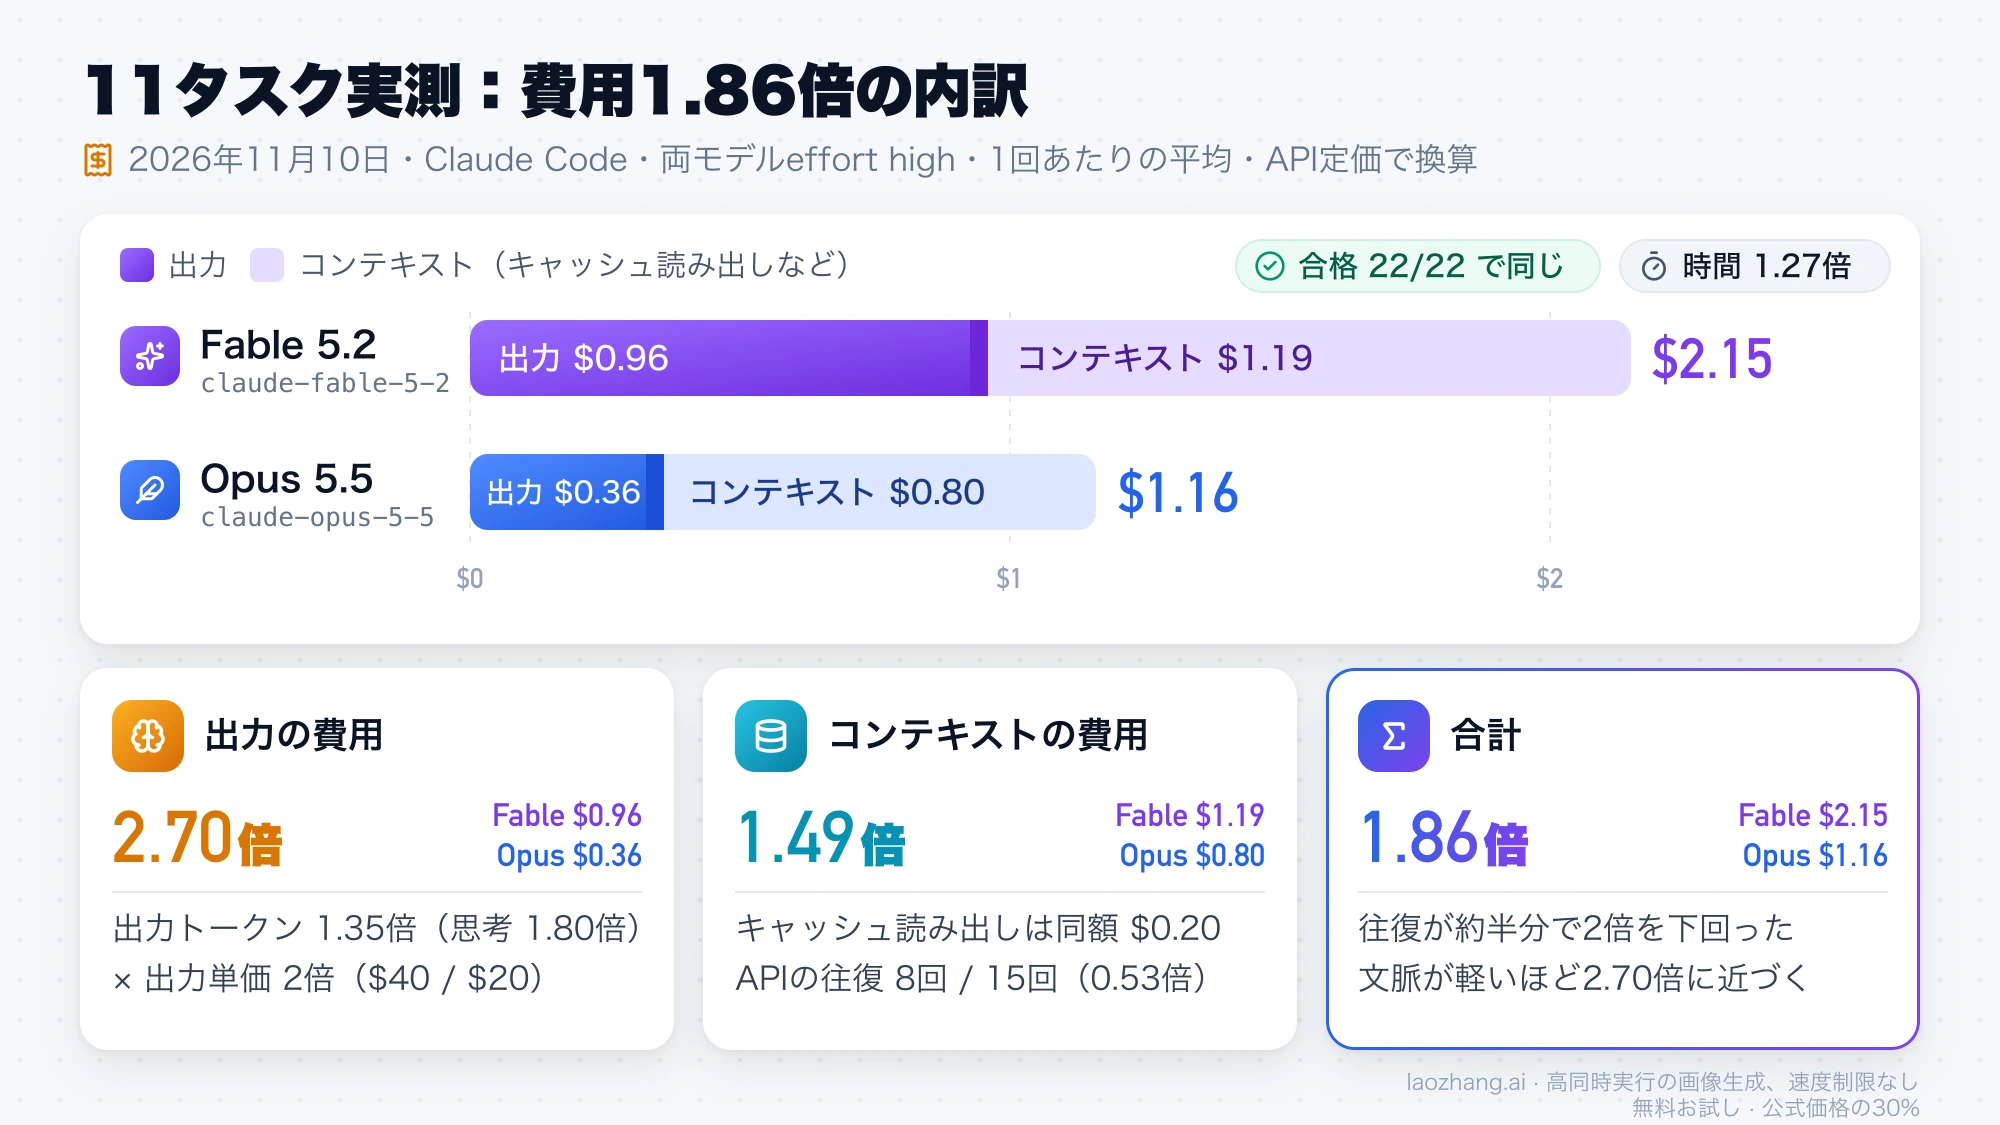
分かるのは、Opus 5.5で足りている種類の仕事をFable 5.2に替えると、同じ結果のために費用が2倍近く、時間が3割ほど余分にかかるということです。各モデル2回、1アカウント、1日、4本を同時に走らせた結果で、ほかのeffort、高速モード、APIの直接呼び出し、数時間かかる作業、ブロック時の代替回答は試していません。長く曖昧な仕事での差は、前の2節のArtificial AnalysisとAnthropicの数字で判断してください。
Fable 5.2とOpus 5.5の料金:単価は2倍、キャッシュ読み出しは同じ$0.20
Claude APIの定価では、Fable 5.2の入力、出力、キャッシュ書き込みはOpus 5.5の2倍で、キャッシュ読み出しだけが同額です。いずれも2026年11月10日時点、100万トークンあたりの米ドル建てです(Claude APIの料金表)。
| 課金対象 | Fable 5.2 | Opus 5.5 |
|---|---|---|
| 入力 / 出力 | $8 / $40 | $4 / $20 |
| 5分キャッシュ書き込み | $10 | $5 |
| 1時間キャッシュ書き込み | $16 | $8 |
| キャッシュ読み出し | $0.20 | $0.20 |
| Batch API(入力 / 出力) | $4 / $20 | $2 / $10 |
| 高速モード(入力 / 出力) | $16 / $80 | $8 / $40 |
Opus 5.5のBatch料金は、料金表にある50%割引を定価に当てはめた値です。両モデルはOpus 4.7から使われているトークナイザーを共有しているので、同じ文章は同じトークン数になり、単価の差がトークン数で広がることはありません。長い文脈を何度も読み直す仕事ほど、同額のキャッシュ読み出しが占める割合が増え、総額の差は2倍より小さくなります。キャッシュの損益分岐はClaudeプロンプトキャッシュの使い方:5分/1時間の損益分岐と実測値で扱っています。
旧版のFable 5.1は$10 / $50だったので、Fable 5.2は20%安くなりました。また、Opus 5.5の高速モードはFable 5.2の通常料金と同じ単価です。Opus 5.5のサブスクリプション上の扱いや上限リセットについては、Claude Opus 5.5の料金と上限リセット権:API単価、使える枠、確認手順を参照してください。
Fable 5.2とOpus 5.5の性能差:大半はFableが上、並ぶ評価もある
Anthropicの発表表では、Fable 5.2はほとんどの評価でOpus 5.5を上回っています。差が大きいのは、Remote Labor Indexの41.3%(Fableはhigh)対21.3%、Terminal-Bench-Science 0.1の74.6%対58.7%、AutomationBenchの51.4%対42.5%、Humanity's Last Exam(ツールあり)の74.2%対67.7%です。一方、OSWorld 2.1(オフライン集合の一部)は89.3%対87.2%と小差で、AA-Briefcase v1.1のEloはOpus 5.5が1800、Fable 5.2が1785とOpusが上でした。Remote Labor IndexのFableを除いて各モデルの最高の段階で測った、安全対策を有効にしたベンダー計測で、第三者による再現ではありません(Claude Fable 5.2とMythos 5.2の発表)。
Artificial Analysisの個別評価でも、Opus 5.5が並ぶか勝つ項目があります。GDP.pdfではOpusのhigh〜maxが26.2〜28.8%、Fableのhigh〜maxが21.4〜24.2%で、Terminal-Bench 4.0はOpusのmaxとxhighが59.6%で、Fableのhighとmaxと同じでした。Fableの差が大きいのは、AA-Omniscience v1.1(64〜67対40〜48)と、HLE-Diamondのmaxどうし(80.2%対67.9%)です。
AI開発そのものを加速させる分野も例外です。Anthropicは学習段階で、アクセラレータ向けのカーネル最適化のような研究能力の伸びを意図的に抑えたと説明しており、この分野ではFable 5.2はOpus 5.5と同程度の性能です。
Fable 5.2のほうが速い?「最大30%高速」はFable 5.1との比較
同じ段階で比べると、速いのはOpus 5.5です。Anthropicの「出力が最大30%速い」はFable 5.2をFable 5.1と比べた数字で、Opus 5.5との比較ではありません。Artificial Analysisの1タスクあたりの時間は、highどうしでFableがOpusの約1.9倍、mediumどうしで約1.2倍で、出力速度もFableが毎秒87〜103トークン、Opusが103〜115トークンです。2026年11月10日のClaude Codeでの実行でも、Fableのほうが時間がかかりました。
Fableが速くなるのは、低い段階のFableで高い段階のOpusを置き換えられる場合です。Opusのxhighに近い点数をFableのmediumで出せれば、1タスクの時間はほぼ半分になります。待ち時間そのものを縮めたいなら、両モデルとも高速モード(speed: "fast"、出力が最大2.5倍速)があり、Claude CodeとClaude APIで使えます(高速モードの説明)。
Fable 5.2はプランの枠をどれだけ使う?Max・Ultraは週の50%まで
Opus 5.5は有料プランの通常の利用上限に含まれますが、Fable 5.2はプランによって扱いが分かれます。Max、Ultra、Teamのプレミアムシート、旧来の席数制Enterpriseのプレミアムシートでは、週の利用上限の50%までをFableモデルに使え、超えたら従量課金のクレジットで続けるか別のモデルに替えます。Fableは他のClaudeモデルより速く上限を減らすとされていますが、どれだけ速いかは公表されていません。Proと、Teamの標準シートでは、Fableは最初のリクエストから従量課金のクレジットで払います。無料プランではFableモデルを使えません(Claudeヘルプ:プランごとのFableモデルの扱い)。Opus 5.5を使える入口はClaude Opus 5.5の使い方:6つの入口と無料条件、モデルの確かめ方にまとめています。
公開記念の特典は11月9日から始まっています。ProとTeamの標準シートは、太平洋時間2026年11月16日23時59分までの1週間、Fableモデルが週の上限の50%まで追加料金なしで使え、同じ期限で失効するFableの上限リセットが1回付きます。Max、Ultra、プレミアムシートには、契約期間に応じてFableの上限リセットが1〜3回付き、期限は太平洋時間2027年3月8日23時59分(日本時間3月9日16時59分)です。リセットの対象は、太平洋時間11月9日10時(日本時間11月10日3時)より前に有料の請求が始まっていたアカウントだけです(Claudeヘルプ:Fable 5.2の公開記念特典)。Fableの上限リセットは、Fableに使った週の利用分を戻し、5時間の枠を満タンにします。上限リセットの仕組み全般は前述のOpus 5.5の料金記事で説明しています。
どのプランでも既定のモデルはFableに変わらないので、使うときはモデル選択から選びます。Enterpriseでは管理者が有効にするまでFable 5.2は使えず、公開から7日後に、既にFableモデルを許可しているロールへ自動で追加されます(管理者が事前に止めた場合を除く)。
Claude CodeでFable 5.2に切り替える手順とeffortの設定
Claude Codeでは、Fable 5.2もOpus 5.5も既定のeffortはmediumです。APIと違って既定の段階は同じなので、モデルだけ替えると、FableのmediumとOpusのmediumを比べることになります。
claude updateでClaude Codeを更新します。Anthropicの資料ではFable 5.2にはv2.1.321以降が必要です。- セッション内で
/model fableを実行するか、claude --model fableで起動します。Claude apps gatewayのセッションではfableがFable 5を指すので、/model claude-fable-5-2と完全なモデル名で選びます。 /effortで段階を選びます。スライダーでEnterを押すか/effort highのように入力すると、そのモデルの既定として次回以降も使われ、sを押すと今のセッションだけに適用されます。- ProやTeamの標準シートで
/modelのFable行に「Requires usage credits」と出ていれば、従量課金のクレジットで払う状態です。対話セッションでは同意を求められます。
-pを付けた非対話モードやAgent SDKのアプリでは、確認なしで従量課金のクレジットに請求されるので、スクリプトやCIでFableを指定するときは注意してください(Claude Codeのモデル設定)。Fable 5.2は、委任を促す環境ではサブエージェントに仕事を渡しやすく、Anthropicはサブエージェントがセッション費用の大きな部分を占めることがあると説明しています。11月10日の実行では、モデルごとに段階を指定しなかったにもかかわらず、両モデルのサブエージェントの全リクエストがeffort highで送られていました。設定した段階が効かない、戻ってしまう場合は、Claude Code の effort とは:既定値・おすすめ・設定が効かない原因で原因を確かめられます。
APIでOpus 5.5からFable 5.2に替える前の確認リスト
Messages APIの形、常に有効な適応型思考(adaptive thinking)、ツール選択の強制が400エラーになる点は両モデルで同じなので、モデルIDをclaude-opus-5-5からclaude-fable-5-2に替えるだけでリクエストは通ります。ただし、AnthropicのFable 5.2への移行ガイドによると、次の点で結果や費用が変わったり、エラーになったりします。
effortを明示します。省略するとFable 5.2はhigh、Opus 5.5はmediumで動くので、リクエストは成功しても費用と待ち時間だけが変わります。- ゼロデータ保持(ZDR)の組織では、30日保持を有効にするか、Anthropicから許可を得ない限り、Fable 5.2へのリクエストはすべて400になります。
system、tools、過去のメッセージをリクエストの間で書き換えるコードは、Fable 5.2ではアカウントの作成時期にかかわらずThe block is bound to a different conversationの400になります。Opus 5.5でこの検査が既定で働くのは2026年8月31日以降に作られたアカウントだけなので、古いアカウントでは今まで問題が見えていなかった可能性があります。- FableからOpusに会話を戻すルーターやフォールバックでは、Opus 5.5がFable 5.2の思考ブロックを読めないため、テキストとツール呼び出しは残りますが推論の引き継ぎは失われます。OpusからFableへの方向は引き継がれます。
- Fable 5.2の安全分類器による拒否はHTTP 200と
stop_reason: "refusal"で返るので、Opus 5.5で見たことのない拒否の種類も処理できるようにします。fallbacksを指定する場合、Fable 5.2で認められる移り先はOpus 4.8とOpus 5だけです。 - レート制限はOpus 5.5とは別枠で、どのティアでもトークン上限が低めです。
- 顧客管理の暗号鍵(CMEK)を使う組織では、Fable 5.2で構造化出力が使えないので、
strict: trueとoutput_config.formatを外して自前で検証します。 - advisorツールでFable 5.2を実行側にする場合、助言役に指定できるのはFable 5.2かMythos 5.2だけです。
- 旧来の
computer_20251124ツールはAmazon Bedrock以外で400になるので、computer_toolset_20260801に移します。 - 第三者のゲートウェイ経由で使う場合は、先にモデル一覧を確認します。2026年11月10日時点で、laozhang.aiの
GET /v1/modelsにはclaude-opus-5-5とclaude-fable-5-1があり、claude-fable-5-2はまだありませんでした。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
自分の仕事で確かめる:Opusが落としたタスクでFableを比べる
Fable 5.2を入れる価値があるかは、Opus 5.5が落とすタスクで比べると最短で分かります。Anthropicのコストガイドも、典型的な仕事ではなく難しい上位1割で比べ、1トークンではなく完了したタスク1件あたりの費用で判断するよう勧めています。全部の仕事で両モデルを走らせると、Opusで足りている大半のタスクに倍近い費用を払うだけになります。
まず、最近の仕事からOpus 5.5の既定effortで失敗したものや人が大きく直したものを10件ほど集め、合格条件を先に書いておきます。次に、同じタスクをOpus 5.5のxhighで新しいセッションからやり直し、合格数と費用を記録します。ここで解ければ、その種類の仕事はOpusの段階を上げるだけで済みます。それでも落ちるタスクだけを、Fable 5.2のmediumとhighでそれぞれ新しいセッションから実行します。セッションの途中で段階を変えるとキャッシュが無効になり、比較がゆがむからです。最後に「合格1件あたりの費用+人が直す時間」で比べ、Fableで新たに解けたタスクの価値が追加費用を上回る種類の仕事だけをFableに回します。
普段の設定としては、Claude CodeならOpus 5.5のmediumを既定にし、足りない仕事でhigh、xhighへ上げ、それでも落ちる種類の仕事だけFable 5.2のmediumかhighに切り替える形が、費用と品質の釣り合いを取りやすくなります。APIでは両モデルともeffortを明示し、モデルIDと段階を必ずセットで記録してください。
Claude Fable 5.2とOpus 5.5のよくある質問
Claude Mythos 5.2とFable 5.2は別のモデルですか?
同じ基盤モデルです。Mythos 5.2はサイバーセキュリティと生物学の安全対策が少ない版で、Anthropicの検証プログラムを通った組織だけが使えます。一般の利用者が選べるのはFable 5.2で、2026年11月10日時点ではこれが最新のFableです。Fable 5.1はレガシー扱いになりました。
まだFable 5.1を使っている場合はどうすればいいですか?
APIではFable 5.2のほうが単価で20%安く、AnthropicのSWE-bench Proの一部でも5.1を上回る正答率でした(ただしhighどうしでは1問あたりの費用は5.2のほうが高めです)。調査用途は別で、AnthropicのDeepResearch Bench IIでは、Fable 5.2は各段階でFable 5.1より20〜61%安い一方、点数は4.7〜7.0ポイント低くなりました。調査レポート中心なら、自分の評価で5.1と比べてから移ってください。
Claude CodeのProとMaxでは、ユーザー設定に保存したclaude-fable-5-1はv2.1.321以降を初めて起動したときにfableの別名へ移り、その後はFable 5.2の既定effortで始まります。前世代どうしの比較はClaude Fable 5.1とOpus 5.5を比較:普段はどっちを使うべき?にあります。
Opus 5.5ではなくSonnet 5.5で足りる仕事はありますか?
あります。Sonnet 5.5のトークン単価はOpus 5.5の半分で、AnthropicのSWE-bench Proの一部では、Opus 5.5のlowがSonnet 5.5の既定とほぼ同じ正答率で、1問あたり約7%高いだけでした。Opusから一段下げる判断はSonnet 5.5とOpus 5.5の使い分け:半額が効く仕事で扱っています。
参考資料11
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年11月10日。
参考資料11
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年11月10日。
- 1.モデル選択ガイドplatform.claude.com/docs/en/about-claude/models/choosing-a-model
- 2.Claude Fable 5.2とMythos 5.2の発表anthropic.com/claude-fable-and-mythos-5-2
- 3.Artificial AnalysisのOpus 5.5とFable 5.2の比較ページartificialanalysis.ai/models/releases/comparisons/claude-opus-5-5-vs-claude-fable-5-2
- 4.effortの指針platform.claude.com/docs/en/build-with-claude/effort
- 5.コストと性能の最適化ガイドplatform.claude.com/docs/en/about-claude/models/optimizing-for-cost-and-intelligence
- 6.Claude APIの料金表platform.claude.com/docs/en/about-claude/pricing
- 7.高速モードの説明platform.claude.com/docs/en/build-with-claude/fast-mode
- 8.Claudeヘルプ:プランごとのFableモデルの扱いsupport.claude.com/en/articles/15424964
- 9.Claudeヘルプ:Fable 5.2の公開記念特典support.claude.com/en/articles/17506494
- 10.Claude Codeのモデル設定code.claude.com/docs/en/model-config
- 11.Fable 5.2への移行ガイドplatform.claude.com/docs/en/models/fable-5-2/migration-guide