Claude Opus 5.5とGPT-6 Astra比較:同じ課題の実測費用と使い分け
Claude Opus 5.5の単価はGPT-6 Astraの4割。同じ小さな課題の実測では費用0.5〜0.7倍でしたが、長いエージェント作業では同じスコアで差が縮むか逆転します。
目次
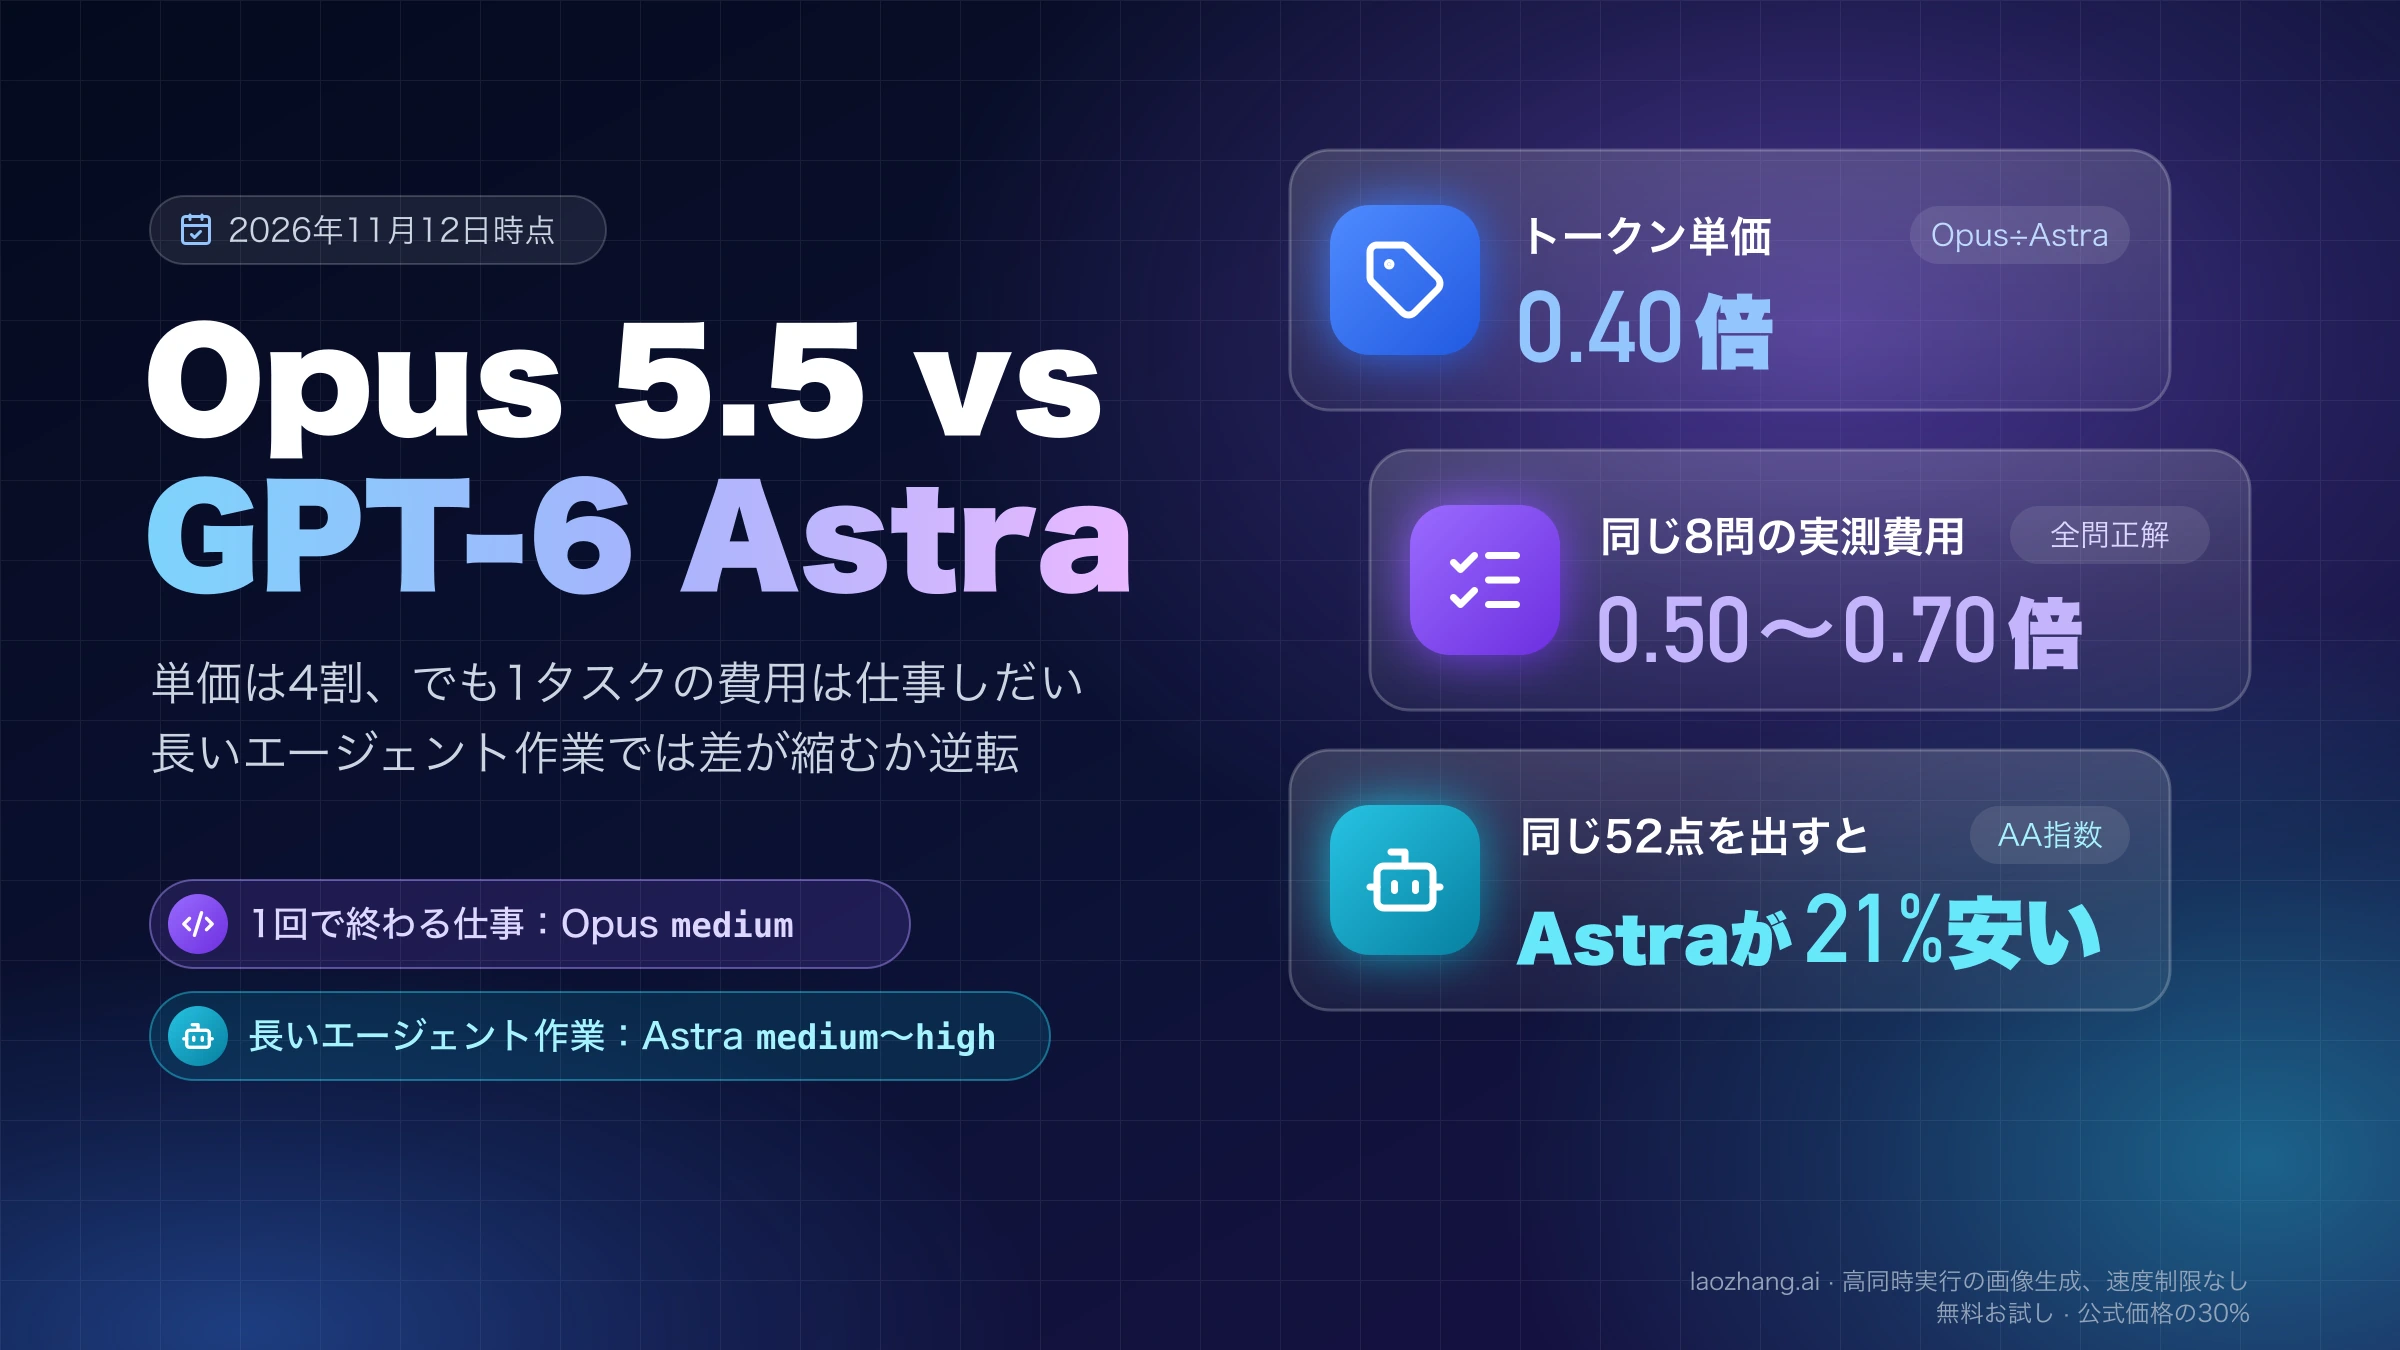
Claude Opus 5.5とGPT-6 Astraのどちらを普段使いにするかは、1回のリクエストで終わる仕事が中心か、長時間のエージェント作業が中心かで決まります。関数の実装、要約、長いログの集計のように短く仕様がはっきりした仕事なら、Opus 5.5のmediumを基準にしてください。2026年11月11日に同じゲートウェイから同じ8問を両モデルに解かせたところ、どちらも全問正解で、Opus mediumの費用はAstra(effort指定なし)の0.70倍でした。何十分も動き続けるエージェント作業が中心なら、GPT-6 Astraのmedium〜highが基準です。第三者機関Artificial Analysis(AA)の指数v5.0.1では、同じ52点を出すのにOpusはhigh、Astraはmediumが必要で、費用はAstraのほうが21%安くなっています。
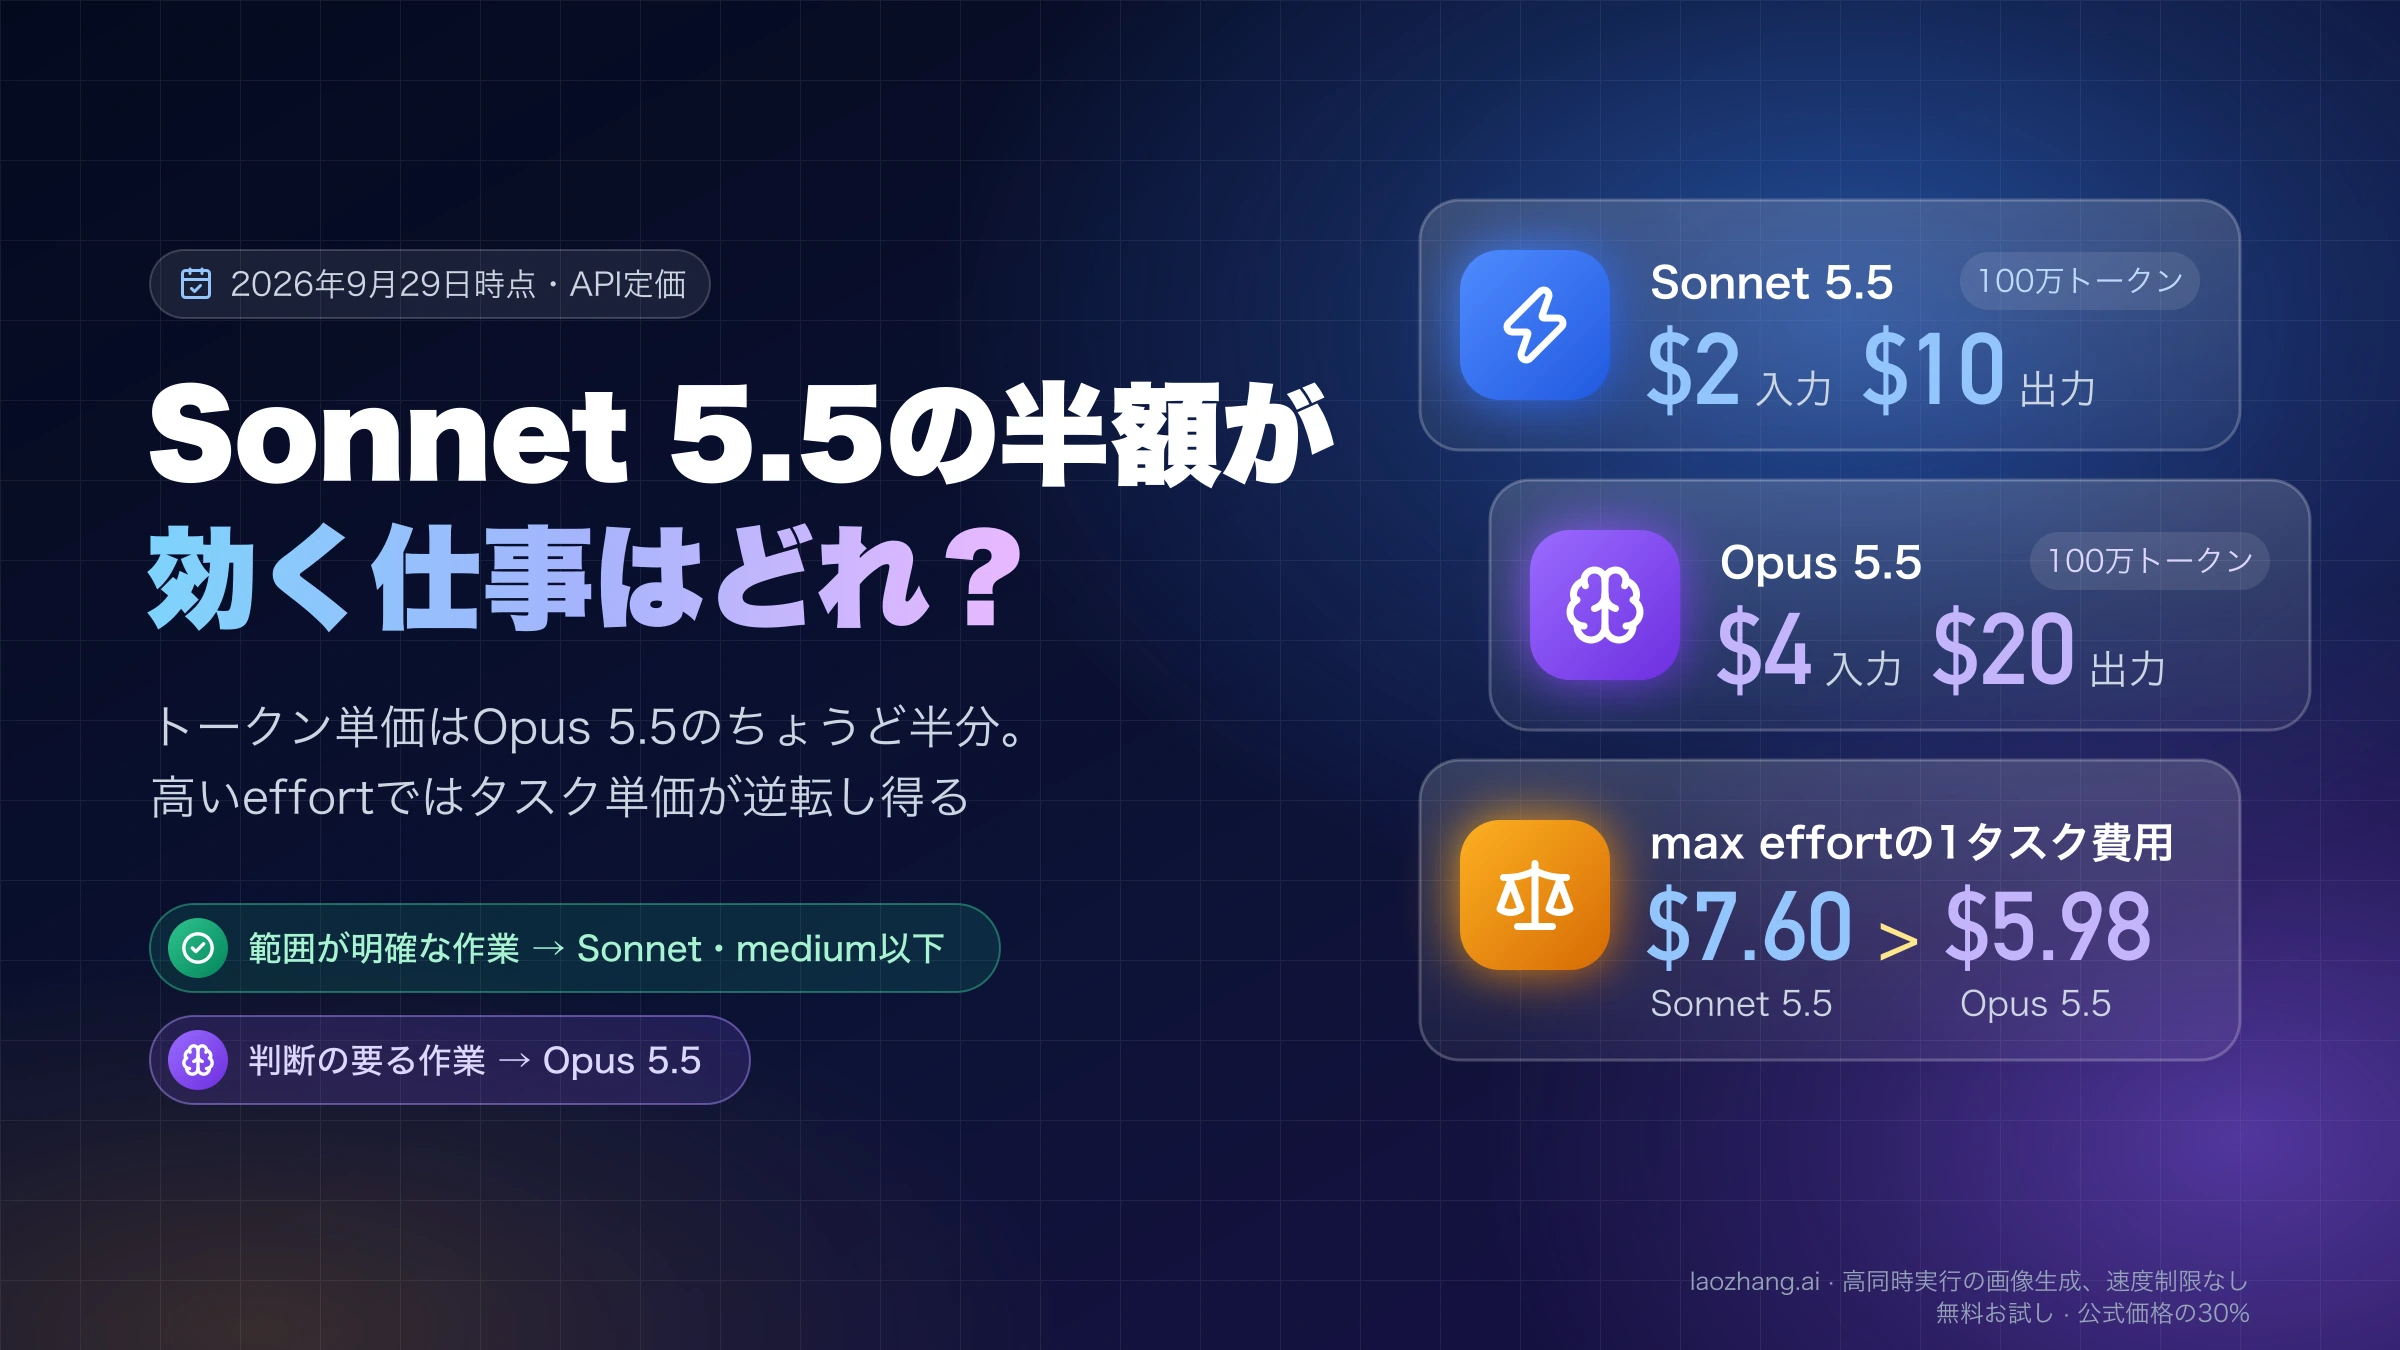
単価だけならOpus 5.5はAstraの4割です(100万トークンあたり入力$4/出力$20に対し、Astraは$10/$50)。それでも1つの仕事の費用が4割にならないのは、Opusが同じ文章をより多くのトークンとして数え、出力も多く書くからです。もう一方へ切り替える基準も単価ではなく仕事で決まります。Astraを普段使いにしていてhighの55点でも足りない仕事は、Opusのxhigh(57点)に切り替えると、費用は同じ57点のAstra maxとほぼ同じで、時間は35%短くなります。逆にOpusを普段使いにしていて研究寄りの課題や厳密な計算が多いなら、AAの評価でAstraがすべての段階で上回っている項目があるため、Astraを試す価値があります。
料金は2026年11月12日時点の各社APIの定価(USD)、AAの数値は同日時点のv5.0.1です。GPT-6 Astra(検索では「Astra 6」「GPT Astra」とも書かれます)は2026年9月3日に公開されたOpenAIの最上位モデルで、GPT-6.2というモデルは出ていません。Opus 5.5は9月22日の公開で、11月9日からはClaude Fable 5.2がAnthropicの最上位になりましたが、Anthropicは普段のコーディングや知識作業をOpus 5.5から始めるよう勧めています。Fable 5.2とAstraの比較はGPT-6 AstraとClaude Fable 5.2比較:effort対応と1タスクの費用で扱っています。
Opus 5.5は1つの仕事でも安いか:同じ8問で費用0.5〜0.7倍
小さく仕様がはっきりした課題では、Opus 5.5は1つの仕事の単位でも安くなりました。ただし単価から計算できる0.4倍ではなく、0.5〜0.7倍です。2026年11月11日、laozhang.aiのゲートウェイを経由して、各社のAPI形式のまま同じ8問を両モデルに送りました。システムプロンプトとツールはなしで、ストリーミングで受け取っています。設定はOpusがmedium(APIの既定値を明示して送信)とhigh、Astraがeffortを指定しない場合とhighの4つです。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
課題は、文章題1問、関数の実装3問(区間の結合、時間を表す文字列の解析、頻出語の集計)、6,723語の英文記事をちょうど5項目に要約する課題、evalを使わない式の評価器(隠しテスト25件)、csvモジュールを使わないCSV行の解析(同16件)、桁和の数え上げです。後半の3問は2回ずつ聞いたので設定ごとに11件、合計44件を採点し、44件すべてが合格でした。
| 設定 | 合格 | 入力トークン | 出力トークン | 費用(定価で計算) | 所要時間 |
|---|---|---|---|---|---|
Opus 5.5 medium | 11/11 | 17,202 | 11,056 | $0.2899 | 126.1秒 |
Opus 5.5 high | 11/11 | 17,202 | 11,968 | $0.3082 | 147.2秒 |
| GPT-6 Astra(effort指定なし) | 11/11 | 11,407 | 5,471(うち推論1,964) | $0.4129 | 91.8秒 |
GPT-6 Astra high | 11/11 | 11,407 | 9,455(うち推論6,042) | $0.6121 | 141.7秒 |
費用は、APIが返したトークン数に定価を掛けて計算しています。同じプロンプトなのにOpusの入力トークンは1.51倍、出力はmediumと指定なしの組で2.02倍あり、単価の差をかなり打ち消しています。それでもOpus mediumとAstra(指定なし)の組で0.70倍、high同士では0.50倍でした。Astraの費用には長文要約の課題で請求されたキャッシュ書き込み(設定ごとに$0.0253の上乗せ)が入っていますが、これを除いてもOpusは0.75倍と0.53倍で安いままです。11件を1件ずつ見ても、AstraのほうがOpusより安かったのはCSV行の解析の1回目だけでした。
全問が合格だったので、この結果は賢さの順位を示すものではありません。分かるのは、両方が解ける仕事でのトークン、費用、時間です。1つのゲートウェイで1日、1つの組み合わせにつき1〜2回の実行で、所要時間にはゲートウェイの時間も含まれます。Opusは思考のトークンを出力と分けて報告しないため、表の出力トークンには思考分も入っています。ツールを繰り返し呼ぶエージェント作業は含まれておらず、その種類の仕事は後述のAAの計測が近く、そこでは結果が逆向きになります。
長いログを1回読ませると:Opusは初回の費用が0.57〜0.64倍
長い文書やログを1回だけ読ませる仕事でも、初回の呼び出しはOpusのほうが安くなりました。使ったのは146KB・1,500行の合成アプリケーションログ(ERROR行326件)で、5種類のエラーコードの件数、E503のエラーが出た利用者の数、リトライ回数が最大のリクエストという7つの値を正確に数える課題です。正解はスクリプトで先に作って確かめてあります。Opus 5.5は2026年11月11日に4回(mediumとhighを2回ずつ)、Astraは11月4日と11日に計5回(指定なし3回、high2回)実行し、すべての回で7つとも正解でした。
Opusは入力78,537トークン、出力7,699〜8,255トークンで、1回$0.47〜0.48、55.7〜59.0秒でした。Astra(指定なし)は入力55,843トークン、出力2,423〜3,793トークンで、キャッシュなしなら$0.75、キャッシュ書き込みが請求された回は$0.82、時間は26.3〜46.4秒です。新しい長いプロンプトを初めて送る場面では、OpusはAstra(指定なし)の57〜64%の費用で済んだことになります。Astra highはキャッシュなしで$0.90、71.7〜77.5秒でした。キャッシュ書き込みが請求されたのは11月11日の1回だけで、11月4日の回にはなく、その差がゲートウェイ側によるものかOpenAI側によるものかは区別できていません。
答えが変わるのは、同じ長いプロンプトを続けて読ませる場合です。Astraは1,024トークン以上のプロンプトを既定でキャッシュするため、11月4日の2回目はキャッシュから読まれて$0.21(highは$0.34)になり、Opusのキャッシュなしの$0.47を下回りました。Claude APIはリクエストにcache_controlを付けない限りキャッシュしないので、このテストのOpusはキャッシュを使っていません。定価で計算すると、78,537トークンのキャッシュ読み取りは78,537×$0.20÷100万≒$0.016で、出力8,000トークン前後(約$0.16)を足しても約$0.18です。同じ文書に何度も質問する仕事では、Opusにもcache_controlを付けてから比べてください。
日本語の入力は何トークンになるか:OpusはAstraの1.23倍
同じプロンプトでも、請求されるトークン数はモデルによって違います。同じ文章に同じ1行の指示を付けて送り、指示だけのときのトークン数を引いて比べると、日本語ではOpus 5.5がGPT-6 Astraの1.23倍で、6言語のなかで差がいちばん小さくなりました。入力単価は$4と$10なので、日本語の入力費用はAstraの約0.49倍です。韓国語やスペイン語では1.9倍近くになり、入力費用の差は24〜25%まで縮みます。
| 言語 | Opus 5.5 | GPT-6 Astra | トークン数の比 | 入力費用の比(Opus÷Astra) |
|---|---|---|---|---|
| 日本語 | 312 | 254 | 1.23倍 | 0.49倍 |
| 英語 | 199 | 137 | 1.45倍 | 0.58倍 |
| 中国語 | 247 | 165 | 1.50倍 | 0.60倍 |
| ロシア語 | 302 | 193 | 1.56倍 | 0.63倍 |
| スペイン語 | 304 | 162 | 1.88倍 | 0.75倍 |
| 韓国語 | 396 | 208 | 1.90倍 | 0.76倍 |
計測はOpusが2026年11月11日、Astraが11月4日で、1言語あたり250〜800字程度の短い文章を使っています。長い文章でも傾向は同じで、6,723語の英文記事では1.52倍でした。ここで分かるのは入力側の差だけで、出力のトークン数は課題によって変わります。日本語のプロンプトが中心なら、「6割安い」に最も近い条件にいることになりますが、それでも入力で約5割安い程度です。
長いエージェント作業ではeffortをどう対応させるか:同じスコアで比べる
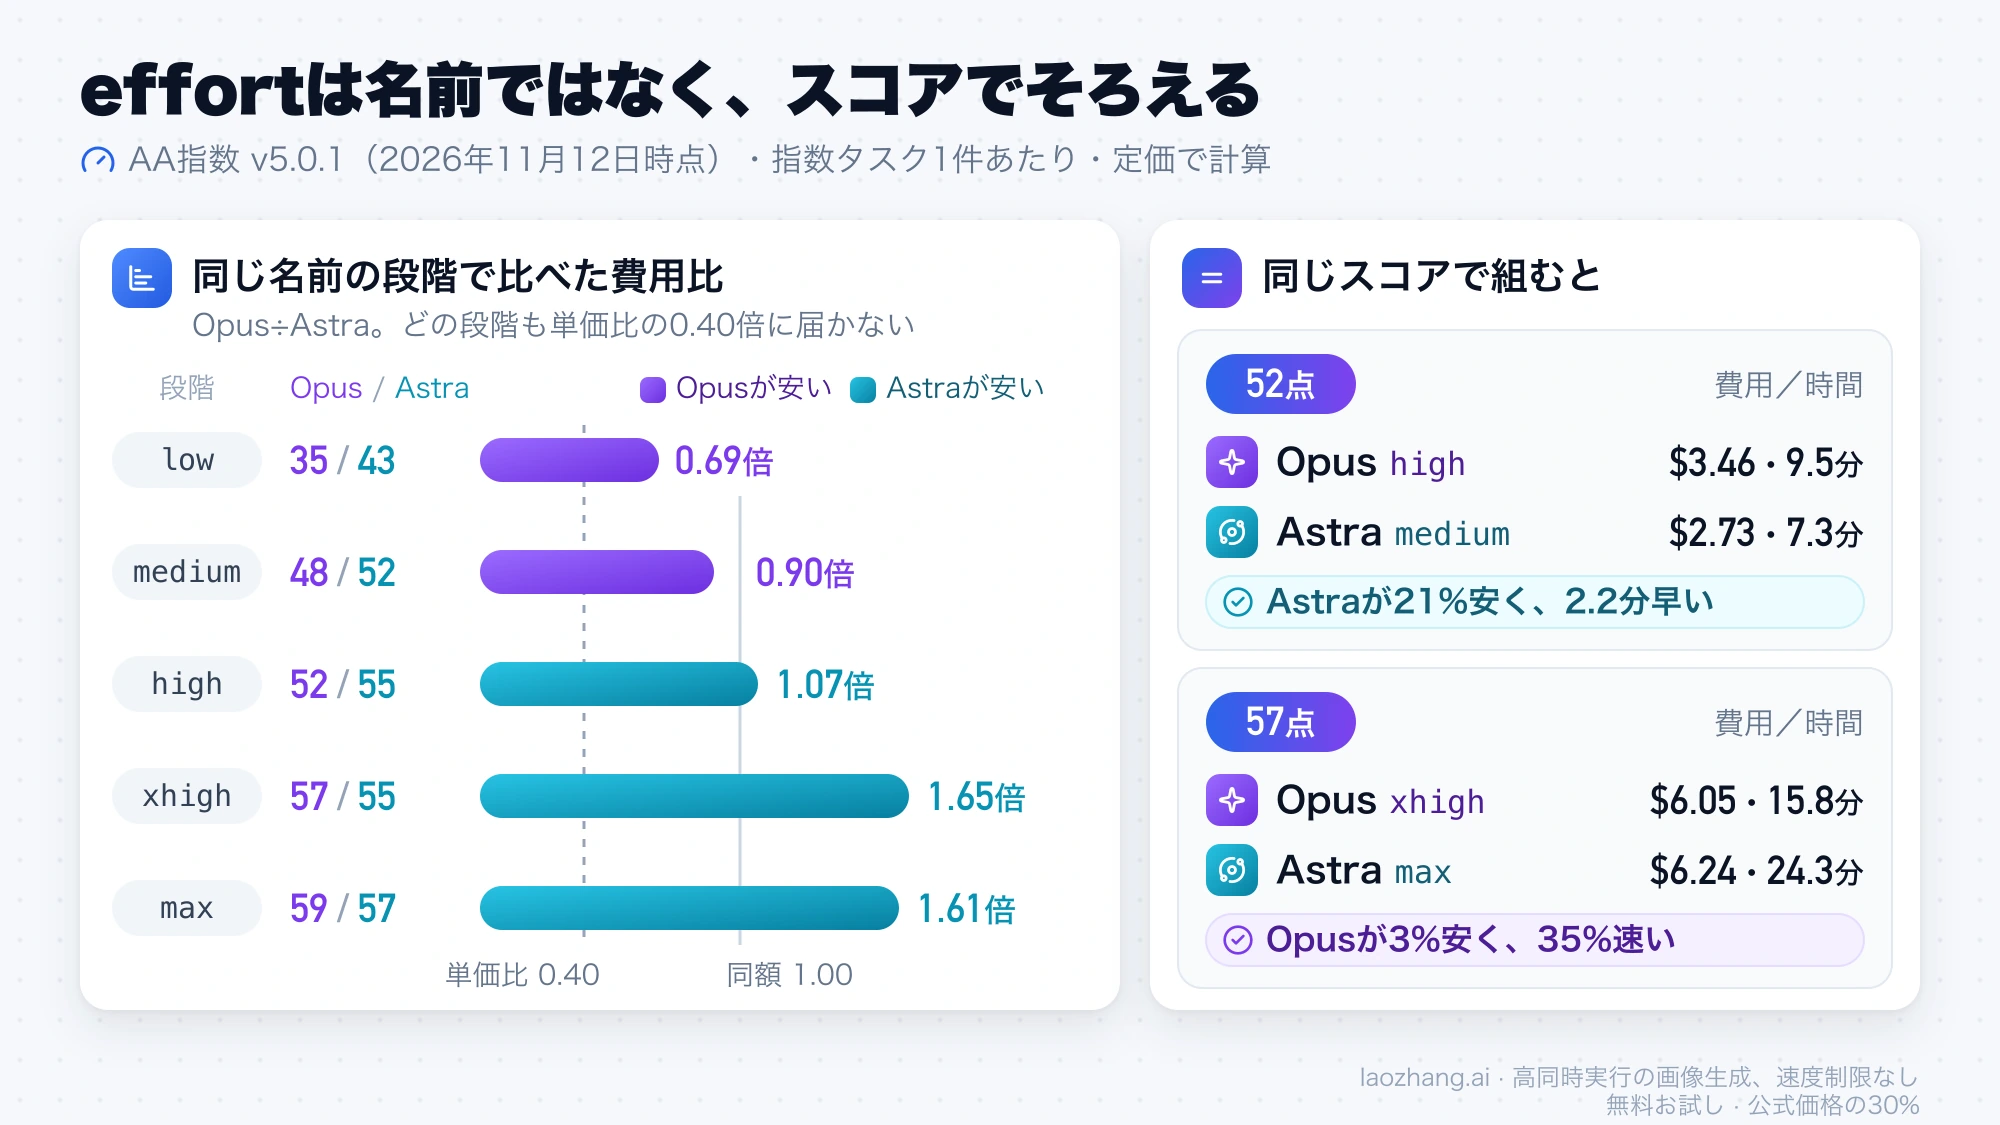
推論の強さ(effort)は両社ともlow・medium・high・xhigh・maxの5段階ですが、同じ名前でも作業量は同じではありません。比べるなら、同じ名前の段階どうしではなく、同じスコアを出す段階どうしです。AAの指数v5.0.1(2026年11月12日時点)は、端末操作やコーディングなどのエージェント型の課題を含む9種類の評価を同じ環境で両モデルに実行し、段階ごとのスコア、指数タスク1件あたりの費用と時間を公開しています。
| effort | Opus 5.5(スコア/費用/時間) | GPT-6 Astra(スコア/費用/時間) | 費用の比(Opus÷Astra) |
|---|---|---|---|
low | 35点/$0.98/3.0分 | 43点/$1.42/4.0分 | 0.69倍 |
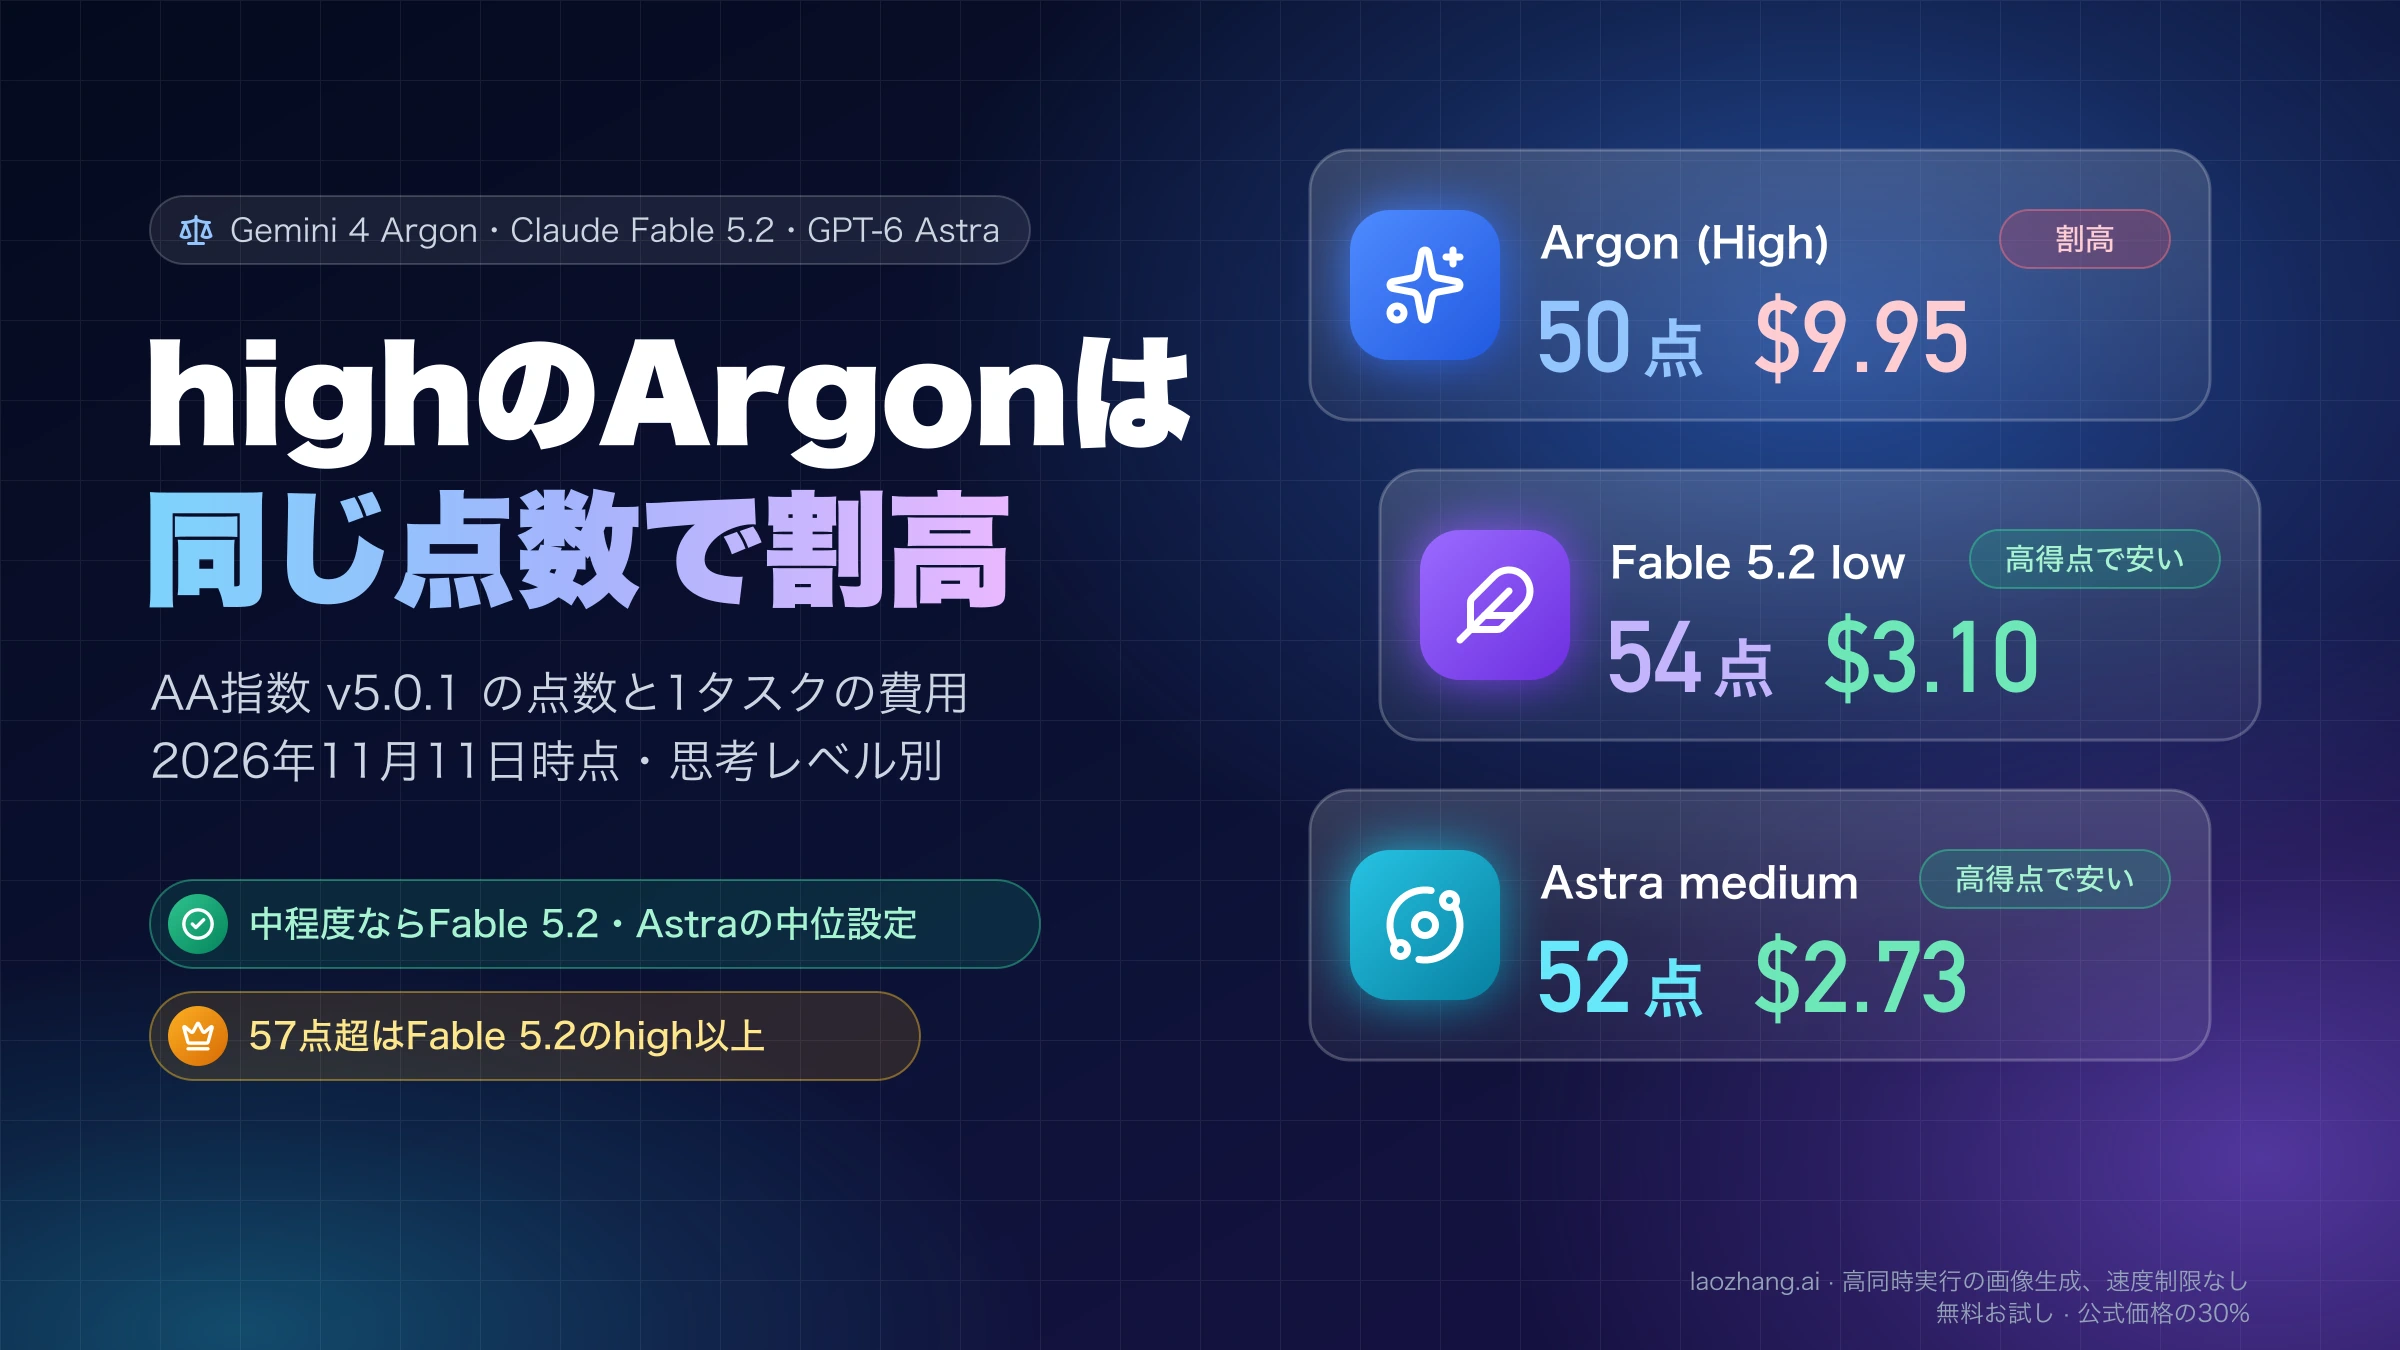
medium | 48点/$2.45/7.1分 | 52点/$2.73/7.3分 | 0.90倍 |
high | 52点/$3.46/9.5分 | 55点/$3.24/9.5分 | 1.07倍 |
xhigh | 57点/$6.05/15.8分 | 55点/$3.66/11.1分 | 1.65倍 |
max | 59点/$10.04/25.0分 | 57点/$6.24/24.3分 | 1.61倍 |
出典はArtificial AnalysisのClaude Opus 5.5とGPT-6 Astraの比較ページで、両モデルとも定価で計算されています。Opusのmaxの行には「Max, Default Fallback」と表示されています。費用はAAの評価用の数字で、あなたの請求額ではありません。
同じ名前の段階で比べると、low〜highではAstraが8点、4点、3点上で、xhighとmaxではOpusが2点上です。費用の比は0.69〜1.65倍で、単価表の0.40倍にはどの段階でも届きません。両モデルが同じトークン数を使えば0.40倍になるはずなので、この差を0.40で割ると、AAの課題でOpusはAstraの約1.7〜4.1倍のトークンを使っている計算になります。入力・出力・キャッシュの比率が両者で近いと仮定し、単価で重み付けした量で見た推定値です。
スコアをそろえると対応は次のとおりです。52点ならOpus highとAstra mediumが並び、Astraが21%安く、2.2分早く終わります。57点ならOpus xhighとAstra maxが並び、Opusが3%安く35%速く終わります。Astra highはOpus highより3点高く、費用は6%低くなっています。59点に届くのはOpus maxだけで、43点より下の安い設定はOpus lowしかありません。
既定値の違いにも注意してください。Opus 5.5の既定はClaude APIでもClaude Codeでもmediumですが、OpenAIはAstraの既定のeffortを公開資料に書いていません。2026年11月11日のテストで「effort指定なし」としたのはそのためです。AAの表では、Opus mediumの48点に相当するAstraの段階はなく、Astra low(43点)とmedium(52点)の間に入ります。
コーディングにはどちらか:highまではAstra寄り、xhigh以上はOpus
短く仕様がはっきりしたコーディングは、11月11日のテストのとおり両方とも正解し、Opusのほうが安く済みました。差が出るのは長い自律的なコーディングで、AA v5.0.1(2026年11月12日時点)のコーディング系の評価では、highまでは項目によってAstraが上、xhigh以上ではOpusが上という分かれ方をしています。
コードの課題を集めたFrontierCode-AA 2.0では、mediumでOpus 33.1%対Astra 36.6%、highで35.9%対40.1%とAstraが上で、xhighでは43.8%対41.4%とOpusが逆転します。端末操作の課題であるTerminal-Bench 4.0は、mediumで52.5%対49.5%、highで56.6%対54.0%とOpusが上、xhighでは両方59.6%で並び、lowではAstraが41.9%対31.3%で上です。分野別の「Engineering」のスコアは、low〜highでAstra 50・57・60点、Opus 43・54・58点、xhighではOpus 63点対Astra 60点です。
実務に当てはめると、長いコーディング作業のためにOpusをhighへ上げるより、Astraのhighのほうが安い費用でFrontierCodeとEngineeringのスコアが上です(Terminal-Bench 4.0だけはOpus highが上)。一方で、難しい課題のためにxhigh以上まで上げるならOpusが上で、費用も57点の段階ではAstraとほぼ同じです。日々の小さな修正や関数単位の実装が多いなら、Opus mediumの安さがそのまま効きます。
ベンチマークは誰が測ったか:Anthropicの発表とAAで向きが違う
出回っているベンチマークの数字は、Anthropicが2026年9月22日のOpus 5.5の発表で示した表と、AAが同じ環境で両モデルを測った表の2種類です。OpenAIはOpus 5.5と比べた表を出していません。同じ名前の評価でも版や設定が違うため、最高設定どうしで並べても差の向きと大きさは項目ごとに変わり、Terminal-Bench 4.0ではOpusの優位がAAで縮み、AutomationBenchでは向きが入れ替わります。はっきり食い違うのは既定に近い段階のOpusの評価と費用で、Anthropicの主張とAAの数字が逆を示しています。
| 評価 | Anthropicの発表(Opus/Astra) | AA v5.0.1のmax(Opus/Astra) |
|---|---|---|
| Terminal-Bench 4.0 | 66.4%/57.9% | 59.6%/59.1% |
| FrontierCode | 54.4%/53.3%(v1.1 Main) | 46.4%/42.4%(AA 2.0) |
| AutomationBench | 40.0%/41.4% | 69.5%/68.5% |
| Terminal-Bench-Science 0.1 | 58.7%/64.6% | 59.0%/63.3% |
Anthropicの発表ページの表は原則としてOpusをmaxで測ったもので、Terminal-Bench 4.0だけはOpus xhighとAstra highという、それぞれの最高値を並べています。AstraのTerminal-Benchの値はOpenAIが報告した数字、AutomationBenchはZapierが実施したものです。標準誤差はTerminal-BenchのOpusで±2.6ポイント、Terminal-Bench-Scienceで±3.5〜5ポイントと注記されています。
費用についての主張も食い違います。Anthropicは発表で、既定のeffortのOpusがFrontierCodeではAstraを約20%のタスク費用で上回り、Terminal-Bench 4.0では約40%の費用で並ぶと書いています。AA v5.0.1では、Opus mediumの費用はAstra mediumの90%でスコアは4点低く、FrontierCode-AA 2.0ではOpus mediumの33.1%がAstra maxの42.4%を下回ります。評価の版、実行環境、安全対策の違いで一部は説明がつきそうですが、どちらの資料も差の理由を書いていません。Anthropic自身も、ベンチマークの差は実際の違いを見る目安として信頼しにくくなったと述べています。
AAの評価項目別に見ると、Astraが全段階で上回るのはGDP.pdfとCritPt v2で、Terminal-Bench-Scienceもxhighを除いてAstraが上です。Opusが全段階で上回るのは、知識作業の成果物を評価するAA-Briefcaseです。研究寄りの課題や厳密な計算が多い仕事ならAstra、資料や成果物の作成が多い仕事ならOpusを先に試すのが、この数字に沿った選び方です。
「Opusのほうが高くついた」報告はどんな仕事か
RedditやX、技術ブログには、同じ依頼を両方に出したらOpusのほうが高くついたという報告がいくつもあります。いずれも自由度の高い制作をエージェントツールで動かしたもので、effortやプロンプトの条件は書かれていないか、公開されている抜粋からは読み取れません。
MindStudioは9月24日の記事で、出力の品質ではOpusが勝ったものの、時間と費用ではAstraが速く安く、Astraは32分・$11.33で終えたと書いています。Moe Luekerは9月25日、ゲーム制作で2回ともOpusのほうが良い出来だったが、費用は$15.25対$7.09だったと報告しました。XのユーザーEnvolDevは11月9日ごろ、Opusが$60.89・2時間19分、Astraが$16.89・34分で、出来はOpusのほうがはるかに良いと投稿しています。Nate HerkはLinkedInで12の用途を試し、Astraは時間が45%短く、推定のAPI費用で約38%安かったと書いています。逆向きの例もあり、r/ClaudeCodeでは「Astraが堂々巡りした問題に約5,000ドルを使ったが、Opusは100ドル未満で解いた」というコメントが上位に付いています。
共通しているのは、終わりの基準がゆるい課題ではOpusが作業を続けて仕上げを重ね、その分だけ時間と費用が膨らむという点です。1つの仕事が長く、自由度が高いほど、11月11日の小さな課題の結果よりもAAの長い課題の結果に近くなります。Redditには「トークンが無制限ならどちらを使うか」という問いも出ていますが、費用を考えないなら、AAで最高の59点を出したのはOpus maxです(1件25分)。
速いのはどちらか:毎秒の出力はOpus、短い課題の完了はAstra
速さは測り方で答えが変わります。AA v5.0.1では出力速度がOpusは毎秒103〜116トークン、Astraは36〜41トークンと約3倍の差がありますが、指数タスク1件の時間はmediumで7.1分と7.3分、highではどちらも9.5分です。Opusは多く書く分、毎秒の速さが完了までの時間に結びつきません。OpenRouterの比較ページ(11月4日ごろの抜粋)では、毎秒69.0トークン対33.0トークンでした。
短い課題では逆にAstraのほうが早く終わりました。11月11日の8問は、Astra(指定なし)が91.8秒、Opus mediumが126.1秒で、high同士では141.7秒と147.2秒です。最初の文字が表示されるまでの中央値はOpusが6.0〜6.5秒、Astraが5.0秒(指定なし)と7.4秒(high)でした。長いログの課題ではAstra(指定なし)が26〜46秒、Opusが56〜59秒、Astra highが72〜78秒です。対話的に使っていて待ち時間が気になるなら、effortを指定しないAstraがいちばん早く返ってくる組み合わせでした。
普段使う設定と、もう一方に切り替える基準
普段使う設定は仕事の長さで分け、もう一方への切り替えは必要なスコアと入力の条件で決めます。ここまでの数字を仕事の種類ごとにまとめると次のようになります。
| 主な仕事 | 普段使う設定 | もう一方に切り替える基準 |
|---|---|---|
| 1回で終わる実装・修正・要約・変換 | Opus 5.5 medium | 研究寄りの課題や厳密な計算が多い、または返答の早さを優先するならAstra(effort指定なし)を試す |
| 長いログや文書を1回だけ読ませる | Opus 5.5 medium | 同じ文書に何度も質問するなら、Opusにcache_controlを付けたうえでAstraと比べる |
| 長時間のエージェント作業(自律的なコーディングなど) | GPT-6 Astra medium〜high | highで足りない難しい仕事はOpus xhigh、さらに上が要るならOpus max |
| 資料や成果物の作成が中心の知識作業 | Opus 5.5 | 長い作業で費用が膨らむなら、Astraの同スコアの段階と比べる |
| 1回の入力が272Kトークンを超える | Opus 5.5 | Astraに移すのは入力を272K以下に分けられる場合だけ |
もっと安いモデルで足りるかを見たい場合は、Sonnet 5.5とGPT-6 Astra比較:費用と使い分け、OpenAIの中で一段安いモデルとの比較はGPT-6.1 Sol・6 Sol・Astra比較:移行の判断、OpusとOpenAIの中価格帯の比較はOpus 5.5とGPT-6 Sol・6.1 Sol比較:費用差にあります。Opusの上のFable 5.2へ上げるかどうかはClaude Fable 5.2とOpus 5.5の違い:同じ正解数で費用1.86倍で判断できます。
品質より先に確かめる、どちらかが使えなくなる条件
品質を比べる前に、次の条件に当てはまるとどちらかが候補から外れたり、費用の前提が変わったりします。2026年11月12日時点の各社の料金表と資料に基づきます。
- 1回の入力が272Kトークンを超えるリクエストがあるなら、Astraはそのリクエスト全体が入力$20/出力$75で請求されます。Opus 5.5は100万トークンのコンテキスト全体が同じ単価です。
- Chat Completions APIで関数呼び出しを使っているなら、Astraではそのまま動きません。Astraの関数呼び出しはResponses APIでだけ使えます。
- Astraは1,024トークン以上のプロンプトを既定でキャッシュし、30分のキャッシュ書き込みを入力単価の1.25倍で請求します。繰り返さないプロンプトばかりなら、
prompt_cache_options.mode: "explicit"で既定の書き込みを止められます。 - Astraをデータレジデンシー用のエンドポイントで使うと、料金が10%上乗せされます。
- Opus 5.5には、サイバーセキュリティの課題をOpus 4.8に、生物学や最先端のLLMに関わる一部の課題をOpus 5に回す安全対策があります(Anthropicの発表)。セキュリティ診断が中心の仕事では、Opus 5.5そのものの性能で比べたことになりません。
Astraの長文・Batch・Fastを含めた料金の仕組みは、GPT-6 Astra API料金:10種類の単価と長文・Batch・Fastの計算方法で確認できます。
ClaudeとChatGPTのどのプランで使えるか
サブスクリプションで使う場合、APIの料金比較はそのまま当てはまりません。Claudeでは2026年11月6日時点で、FreeプランではOpusもClaude Codeも使えず、Pro(月$20、年払いなら月$17)、Max($100)、Ultra($200)、Team、EnterpriseでOpus 5.5が使えます。ChatGPTでは2026年10月26日時点で、FreeとGoはGPT-6 LunaでAstraは使えず、Plusと標準のBusinessではWorkとCodexで5時間あたりおよそ5〜45件のAstraのローカルメッセージ、Proは5時間の上限なし、EnterpriseとEduは管理者が有効にすると使えます。
通常のチャット画面でどのプランがAstraを選べるかは、OpenAIの公開資料に記載がありません。どちらのサブスクリプションにもAPIの利用料は含まれません。Opusを使える入口と条件はClaude Opus 5.5の使い方:6つの入口と無料条件、モデルの確かめ方にまとめています。
自分の仕事で見積もり直す:単価表と計算の手順
自分の請求額を見積もるときは、単価をそのまま比べるのではなく、いま使っている側の実際のトークン数に倍率を掛けて計算します。単価は次のとおりです(100万トークンあたり、2026年11月12日時点の定価)。
| 項目 | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|
| 入力 | $4 | $10(272K以下) |
| 出力 | $20 | $50(272K以下) |
| キャッシュ読み取り | $0.20 | $1.00 |
| キャッシュ書き込み | 5分$5、1時間$8 | 30分$12.50、12時間$25 |
| 入力272Kトークン超 | 段階なし | リクエスト全体が入力$20/出力$75 |
| Batch | $2/$10 | Standardの半額(Flexも同じ) |
| 高速モード | fast mode $8/$40 | Fastは2倍、Ultrafastは6倍 |
出典はClaude APIの料金表とOpenAI APIの料金表です。
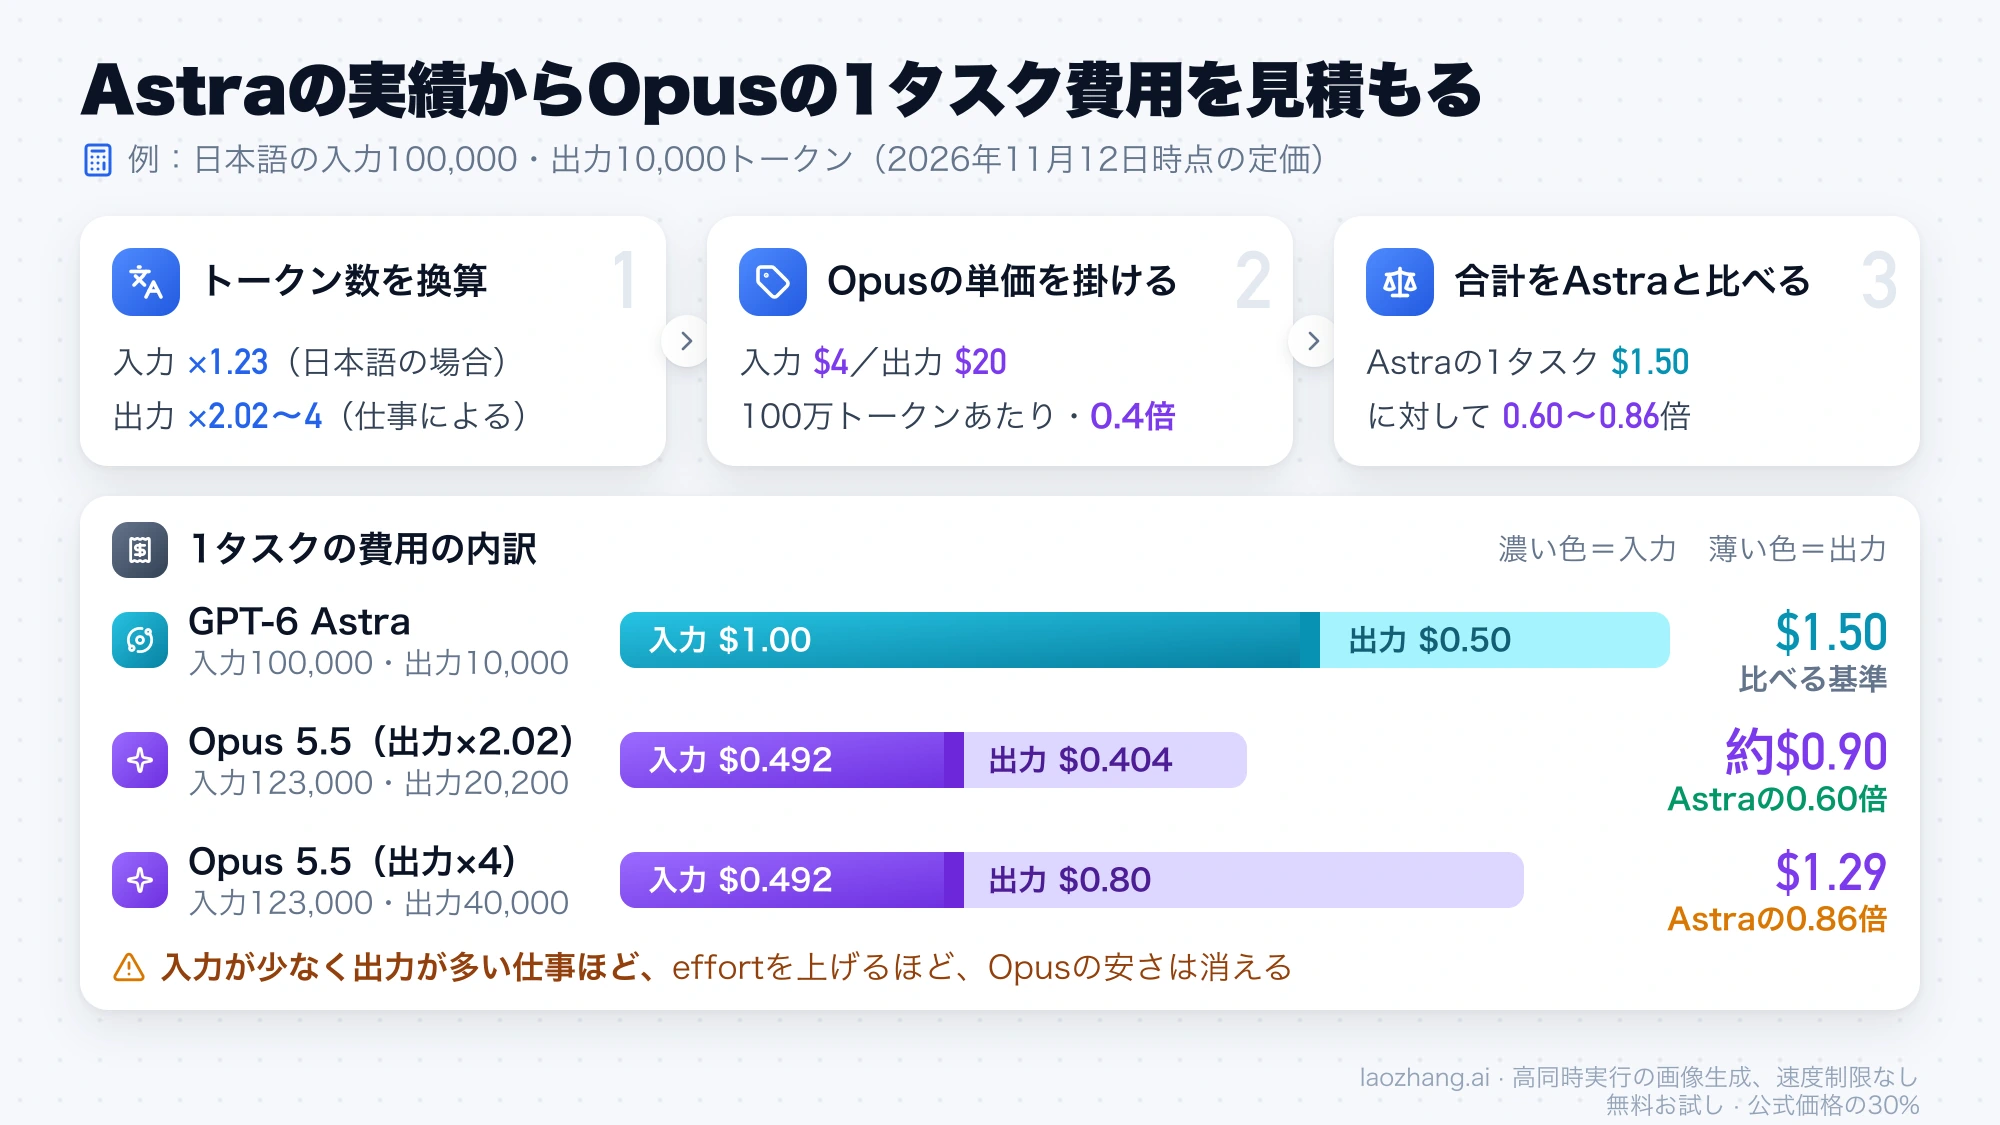
たとえばAstraで1回あたり日本語の入力100,000トークン、出力10,000トークンの仕事なら、Astraの費用は0.1×$10+0.01×$50=$1.50です。Opusに移すと入力は1.23倍の123,000トークンで$0.492、出力が小さな課題と同じ2.02倍なら20,200トークンで$0.404、合計約$0.90(Astraの0.60倍)になります。出力が4倍の40,000トークンになると出力だけで$0.80、合計$1.29(0.86倍)です。入力が少なく出力の多い仕事ほど、またeffortを上げるほど、Opusの安さは消えていきます。
倍率は仕事によって違うので、最後は自分の代表的な仕事で両方を動かして確かめます。
- いま扱っている仕事から代表例を5〜10件選び、テストが通る、値が一致するといった合否の基準を先に決めます。
- 両モデルに同じ入力を送ります。短い仕事はOpus
mediumとAstra(effort指定なし)、長いエージェント作業はスコアの近い組(OpushighとAstramedium、OpusxhighとAstramax)も含めます。 - 同じ長いプロンプトを繰り返す仕事なら、Opusには
cache_controlを付け、両方ともキャッシュが効く条件にそろえます。 - APIの使用量(usage)から入力・出力・キャッシュのトークン数を取り、合格1件あたりの費用=総費用÷合格件数で比べます。
合格件数が同じなら安いほうを普段使いにし、片方だけが落とす仕事があれば、その種類の仕事だけをもう一方に回すのが無駄のない分け方です。
参考資料4
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年11月12日。
参考資料4
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年11月12日。