Gemini 4 Argon・Fable 5.2・GPT-6 Astra比較:highのArgonは割高
AA指数で同じ点数なら、Argon (High)はFable 5.2やGPT-6 Astraの中位設定より割高。57点超はFable 5.2のhigh以上が候補です。
目次
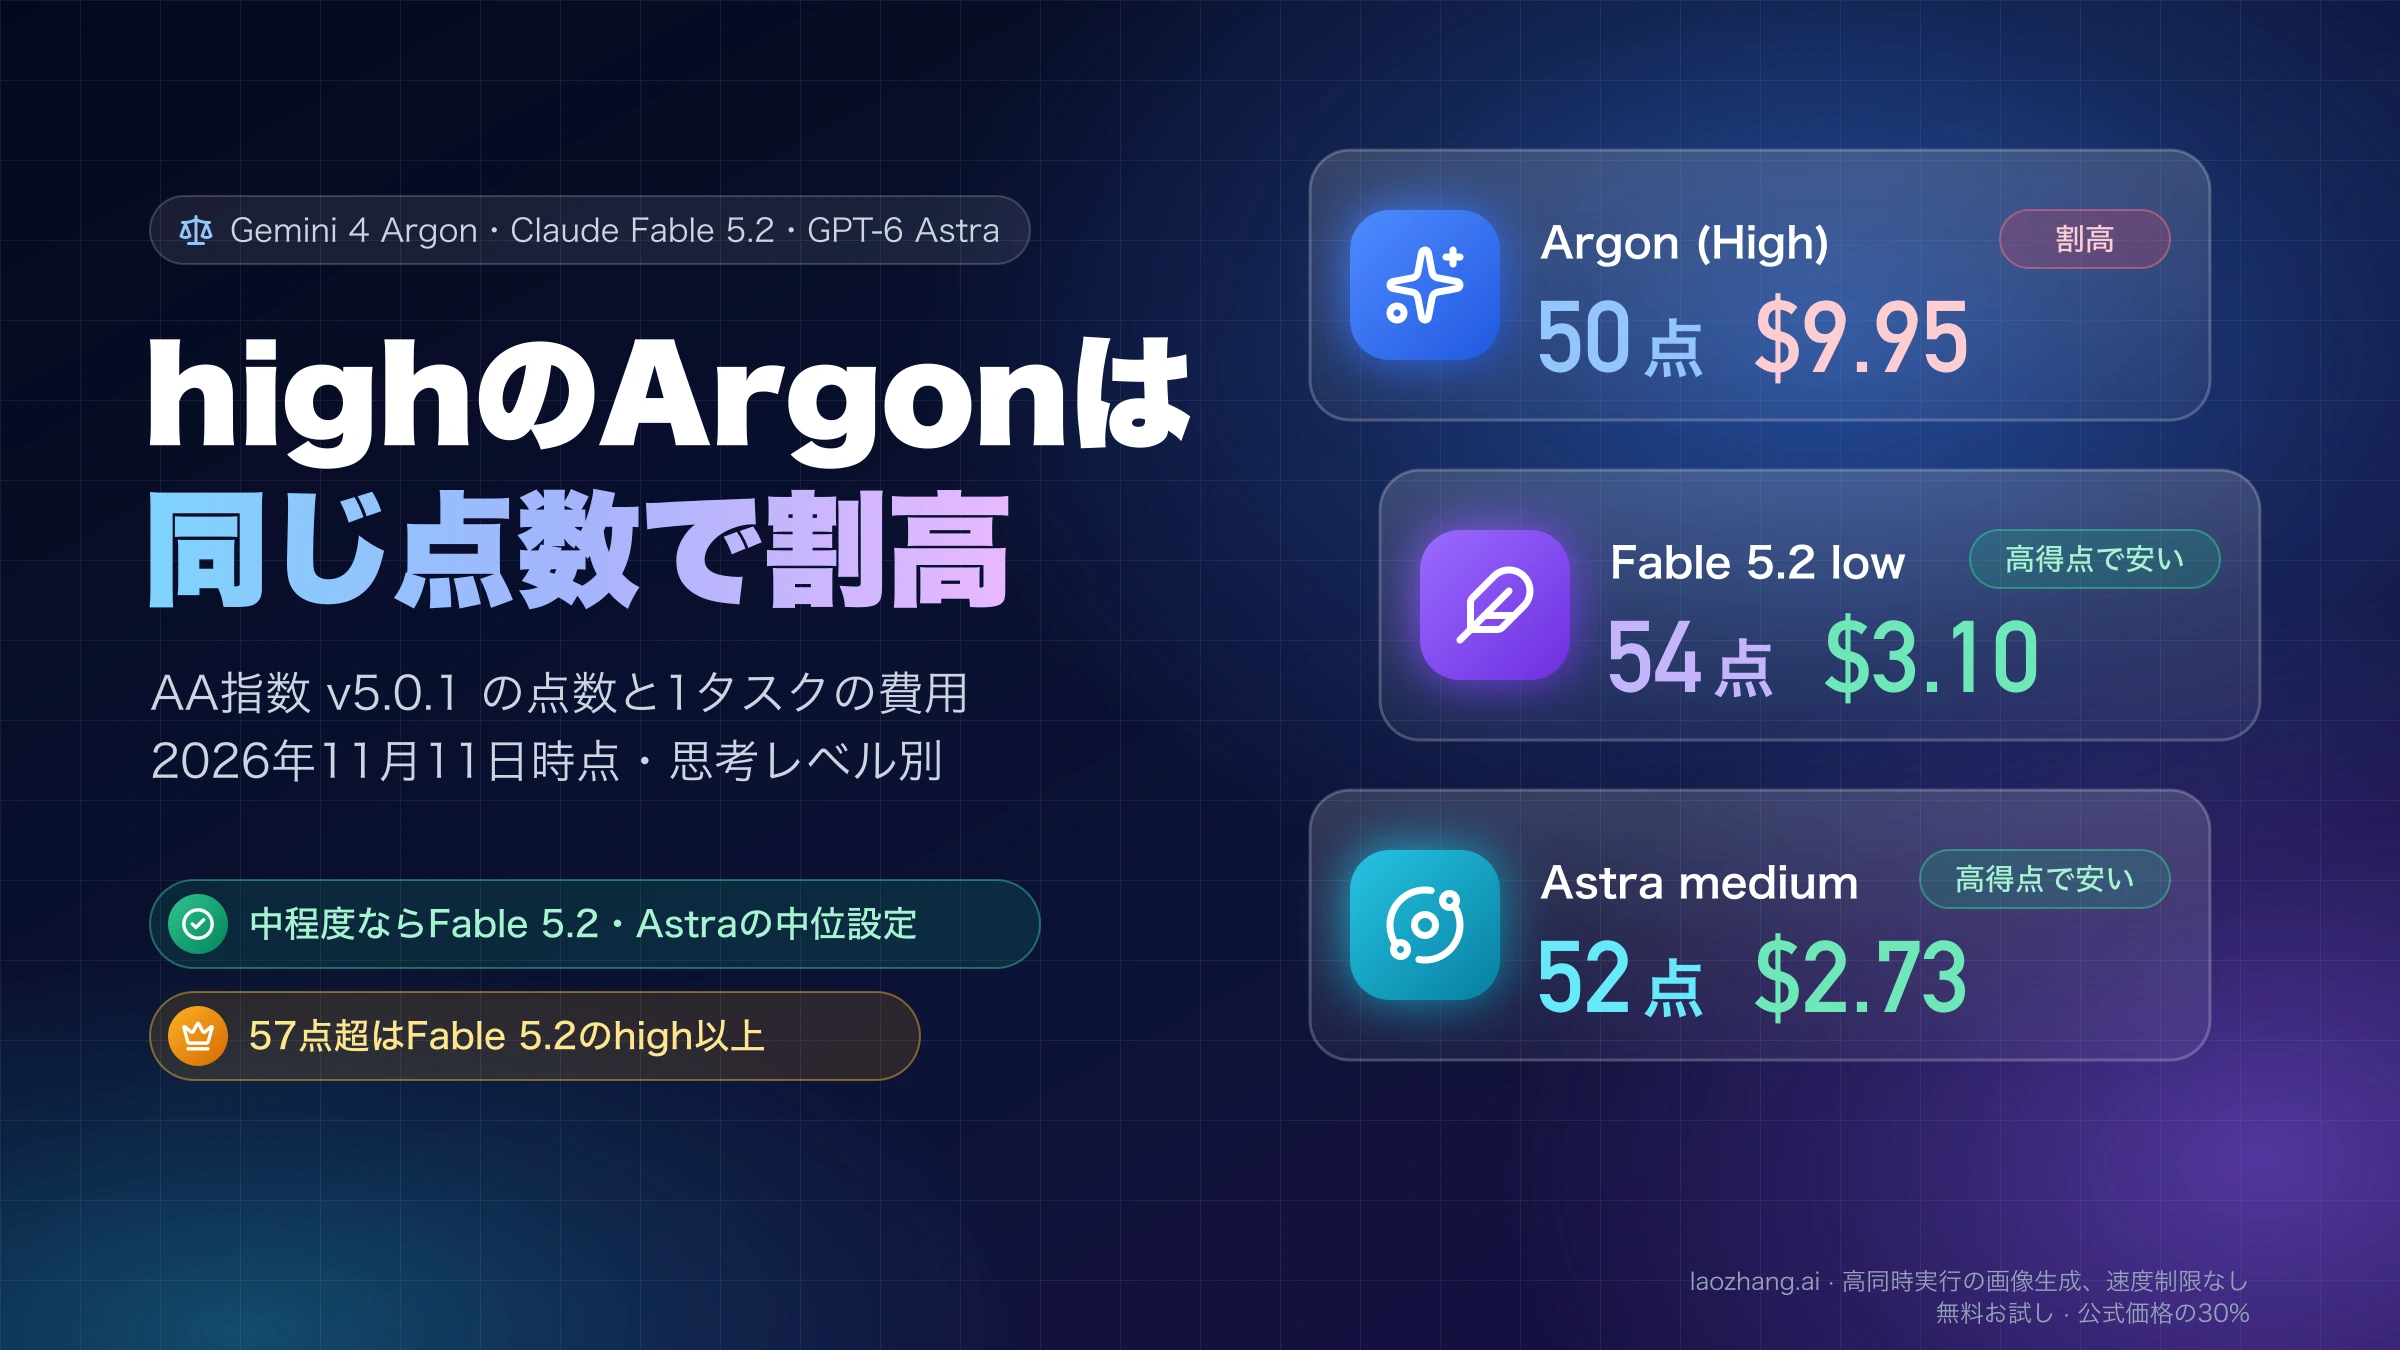
2026年11月11日時点で、Gemini 4 Argon・Claude Fable 5.2・GPT-6 Astraから普段使いのモデルを選ぶなら、仕様がはっきりした小さめの仕事はGemini 4 Argonを思考レベルを指定しない既定設定のまま使うのがいちばん安く済みます。同じ日に同じ8課題(採点対象11件)を3モデルに解かせたテストでは、試した7つの設定がすべて全問合格し、定価で換算した費用は既定のArgonが$0.096、Fable 5.2のlowとAstraの既定設定がその約4.3〜4.4倍でした。12月1日にArgonの単価が2倍になっても、約2.1〜2.2倍の差は残ります。
Argonの思考レベルをhighに上げないと足りない難しい仕事では、答えが変わります。第三者機関Artificial Analysis(AA)の総合指数v5.0.1(11月11日時点)では、Argon (High)の50点より高い点数を、Astraのmedium〜xhighとFable 5.2のlow・mediumがより安い1タスク費用で出しています。同じ8課題でもhighのArgonは12月の単価で$0.777となり、7つの設定の中で最も高くなります。中程度の難しさならFable 5.2のlow・mediumかAstraのmedium・highを、AA指数で57点を超える水準が要る仕事ならFable 5.2のhigh以上を普段のモデルにしてください。
例外が3つあります。長いログから件数を正確に数える課題では、既定設定のArgonが思考トークンを使わないまま22秒で間違え、highにすると正解しましたが329秒かかりました。動画や音声を入力するなら、3つのうちArgonしか使えません。Fable 5.2は高リスクのサイバーセキュリティ作業や研究系バイオの依頼を安全分類器で止めます。
どれを普段使いにするか:仕事の難しさと入力の種類で決める
3つのどれを選ぶかは、モデル名よりも「どの思考レベルで合格させるか」で決まります。3社とも、答える前に考える量を段階で指定できますが、呼び名と段階の数が違います。Argonはthinking level(low・medium・highの3段階、APIの既定はmedium)、Fable 5.2はeffort(low・medium・high・xhigh・maxの5段階、APIの既定はhigh)、Astraはreasoning effort(同じくlow〜maxの5段階、APIの既定値はOpenAIのドキュメントに記載がありません)です。以下ではまとめて「思考レベル」と呼びますが、同じhighという名前でも3社で作業量が同じという意味ではありません。
| 仕事の種類 | まず試すモデルと思考レベル | ほかのモデルへ回す条件 |
|---|---|---|
| 仕様が明確な小さめの仕事(関数の実装、要約、計算問題)を大量に回す | Argonの既定設定 | 長い入力から数値を正確に拾う仕事はFable 5.2かAstraへ |
Argonならhighが必要になる中程度の難しさ | Fable 5.2のlow・medium、またはAstraのmedium・high | 動画・音声の入力があればArgon(high)に残す |
| AA指数で57点を超える水準が要る推論やコーディング | Fable 5.2のhigh(足りなければxhigh・max) | Fable 5.2の安全分類器で止まる、または30日のデータ保持が契約上できない場合はAstraのmax |
| 長いログや表から件数・集計値を正確に出す | Fable 5.2かAstraの既定設定 | Argonを使うならhighでストリーミングにし、数分待つ前提で |
| 動画や音声を入力する | Argon(3つの中で唯一対応) | 入力がテキストと画像だけになったら上の行に戻って選び直す |
1行目と4行目は2026年11月11日に実行した同一課題のテストから、2行目と3行目はAA指数の段階別データから導いています。AAにはArgonの既定設定の成績がないため、1行目は小さく仕様の明確な課題での実測が根拠で、難しい仕事での合否は自分の課題で確かめる必要があります。どれも下の節で数字と条件を示します。Fable 5.1をまだ使っている場合はClaude Fable 5.2と5.1の違い:2割値下げでもhigh以上は割高を、Claudeのまま費用を下げたい場合はClaude Fable 5.2とOpus 5.5の違い:同じ正解数で費用1.86倍を先に確認すると、候補を絞りやすくなります。
料金比較:100万トークン単価はArgonが最安、12月1日に2倍
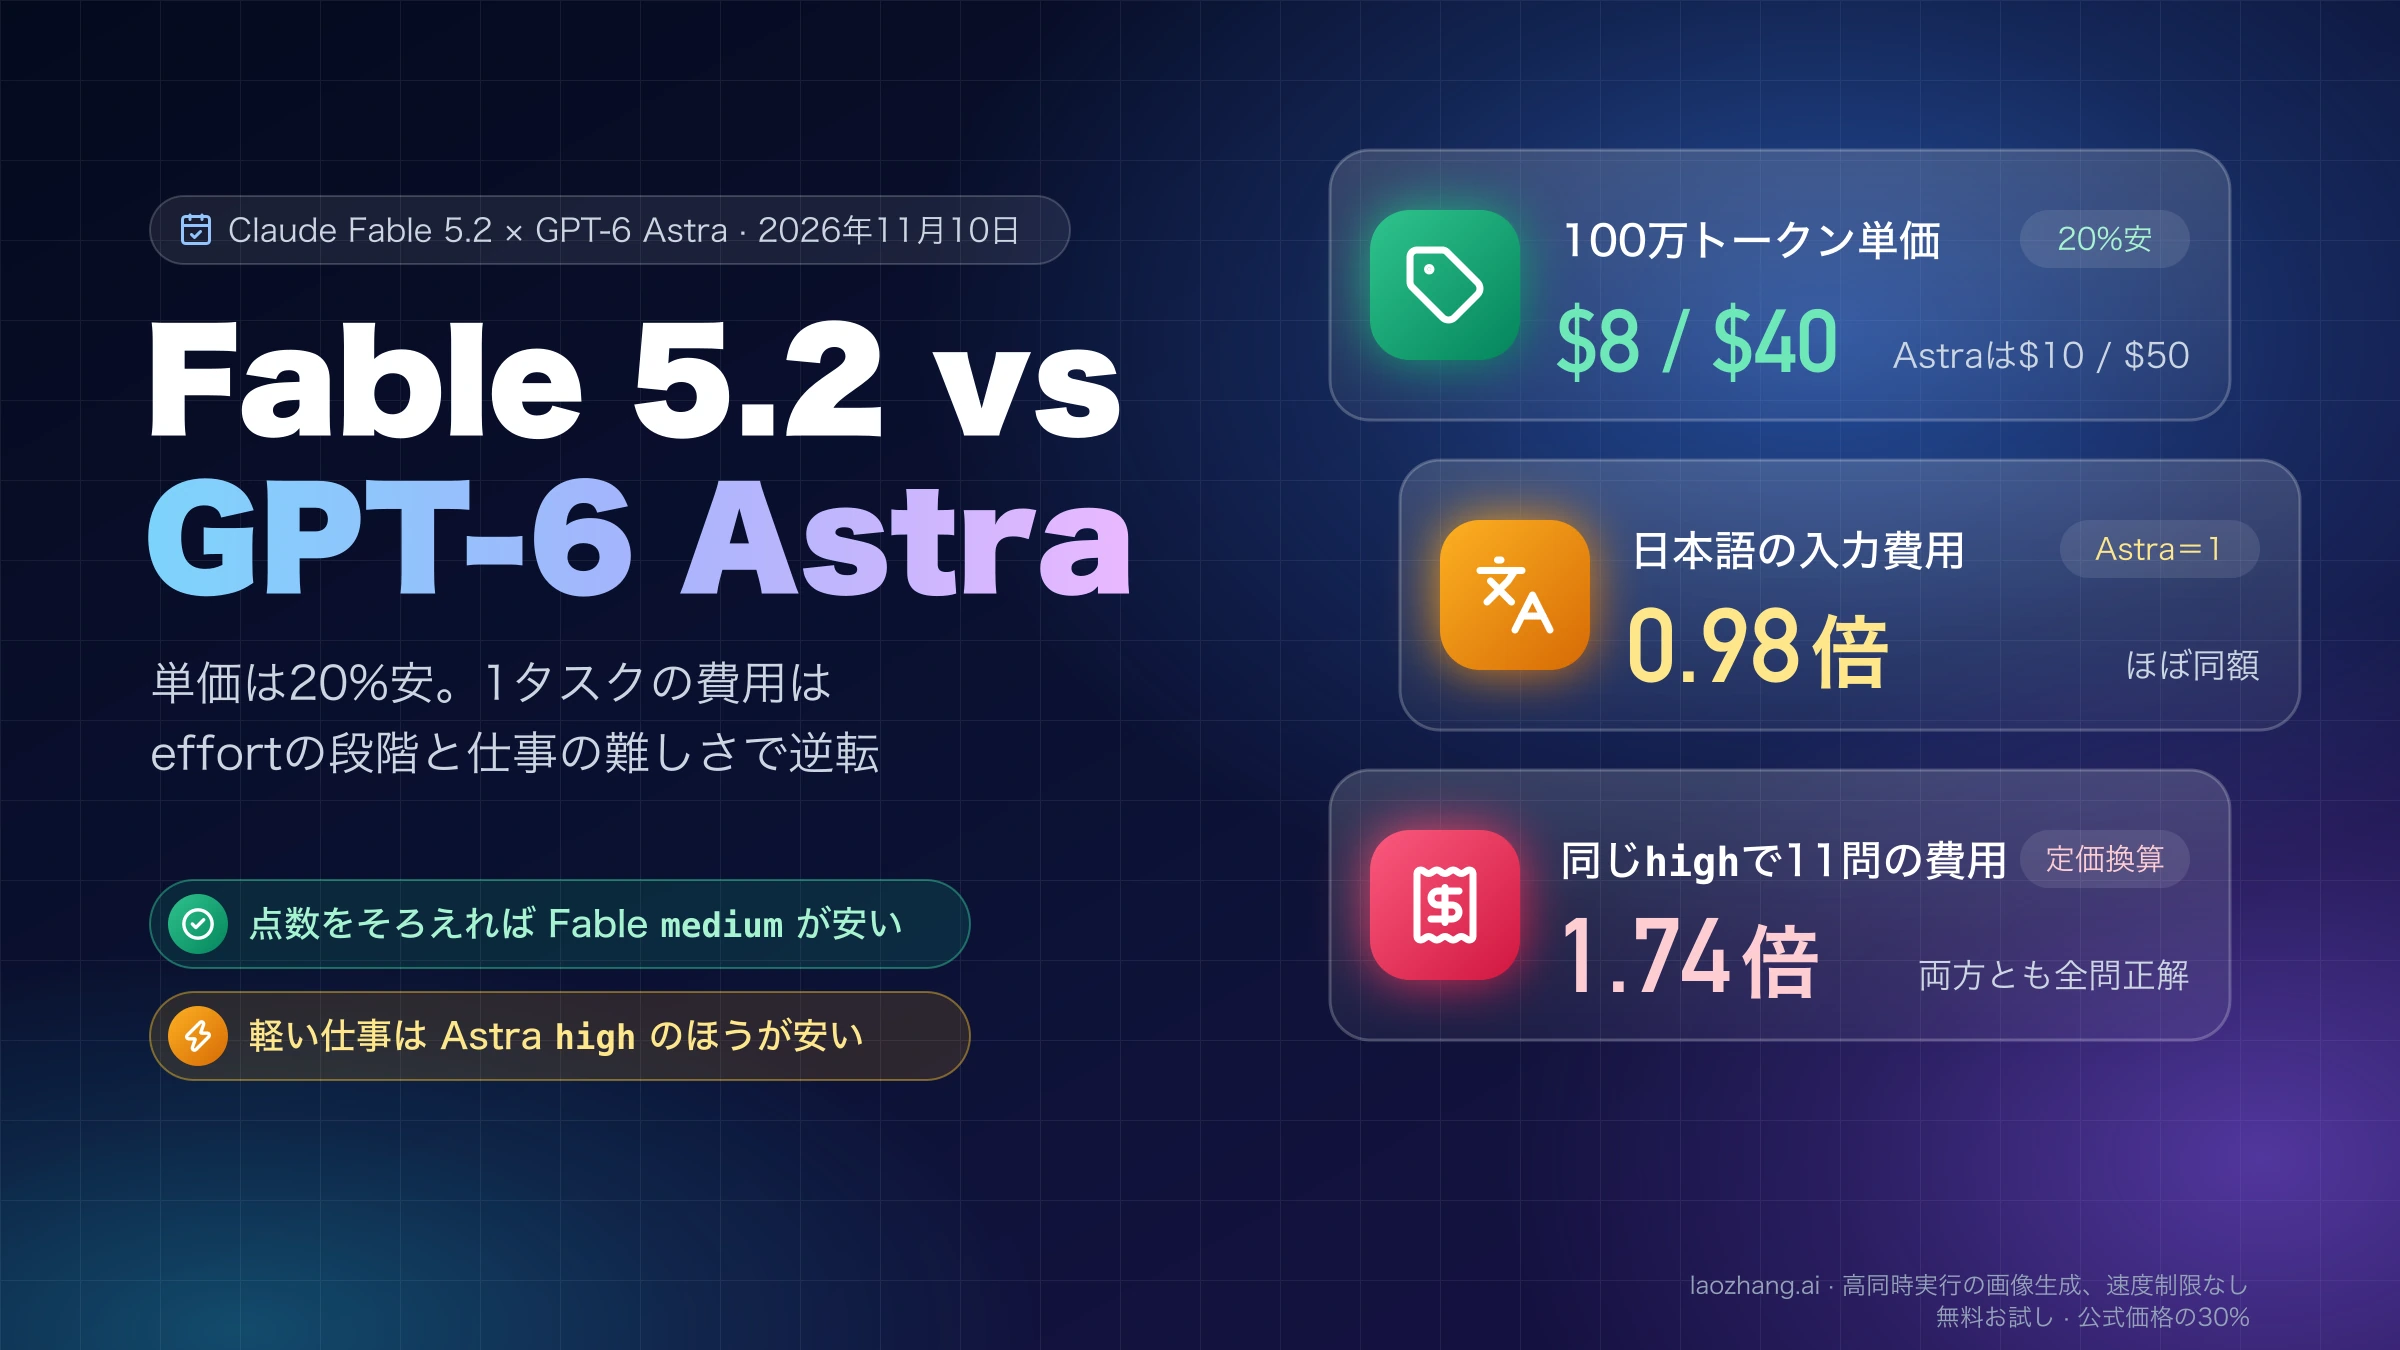
100万トークンあたりの定価では、2026年11月30日までのArgonはFable 5.2の4分の1、Astraの5分の1です。12月1日からArgonは入力$4・出力$20に上がり、Fable 5.2の2分の1、Astraの5分の2になります。Fable 5.2とAstraの単価は変わりません。
| 項目 | Gemini 4 Argon | Claude Fable 5.2 | GPT-6 Astra |
|---|---|---|---|
| APIモデルID | gemini-4-argon | claude-fable-5-2 | gpt-6-astra |
| 入力 | $2.00(12月1日から$4.00) | $8 | $10(入力272Kトークン超は$20) |
| 出力(思考トークンを含む) | $10.00(12月1日から$20.00) | $40 | $50(入力272Kトークン超は$75) |
| キャッシュ読み取り | $0.10(12月1日から$0.20) | $0.20 | $1.00 |
| キャッシュ書き込み | 暗黙的キャッシュのみ | 5分$10、1時間$16(指定したときだけ) | 30分$12.50、12時間$25(既定で書き込み) |
| コンテキスト | 1,048,576トークン(入出力で共有) | 100万トークン | 1,050,000トークン(入力は最大922,000) |
| 最大出力 | 65,536トークン(long decodeで最大1,048,576) | 128Kトークン | 128Kトークン |
| 入力の種類 | テキスト、画像、動画、音声、PDF | テキスト、画像 | テキスト、画像 |
単価は米ドル、APIを直接使うときの標準料金で、Argonは有料枠の価格です(Gemini APIの料金ページ、Claude APIの料金ページ、OpenAI APIの料金ページ、2026年11月11日時点)。Fable 5.2のBatchは入力$4・出力$20、AstraのBatchは標準の半額です。Fable 5.2の単価は100万トークンのコンテキスト全体で一律です。
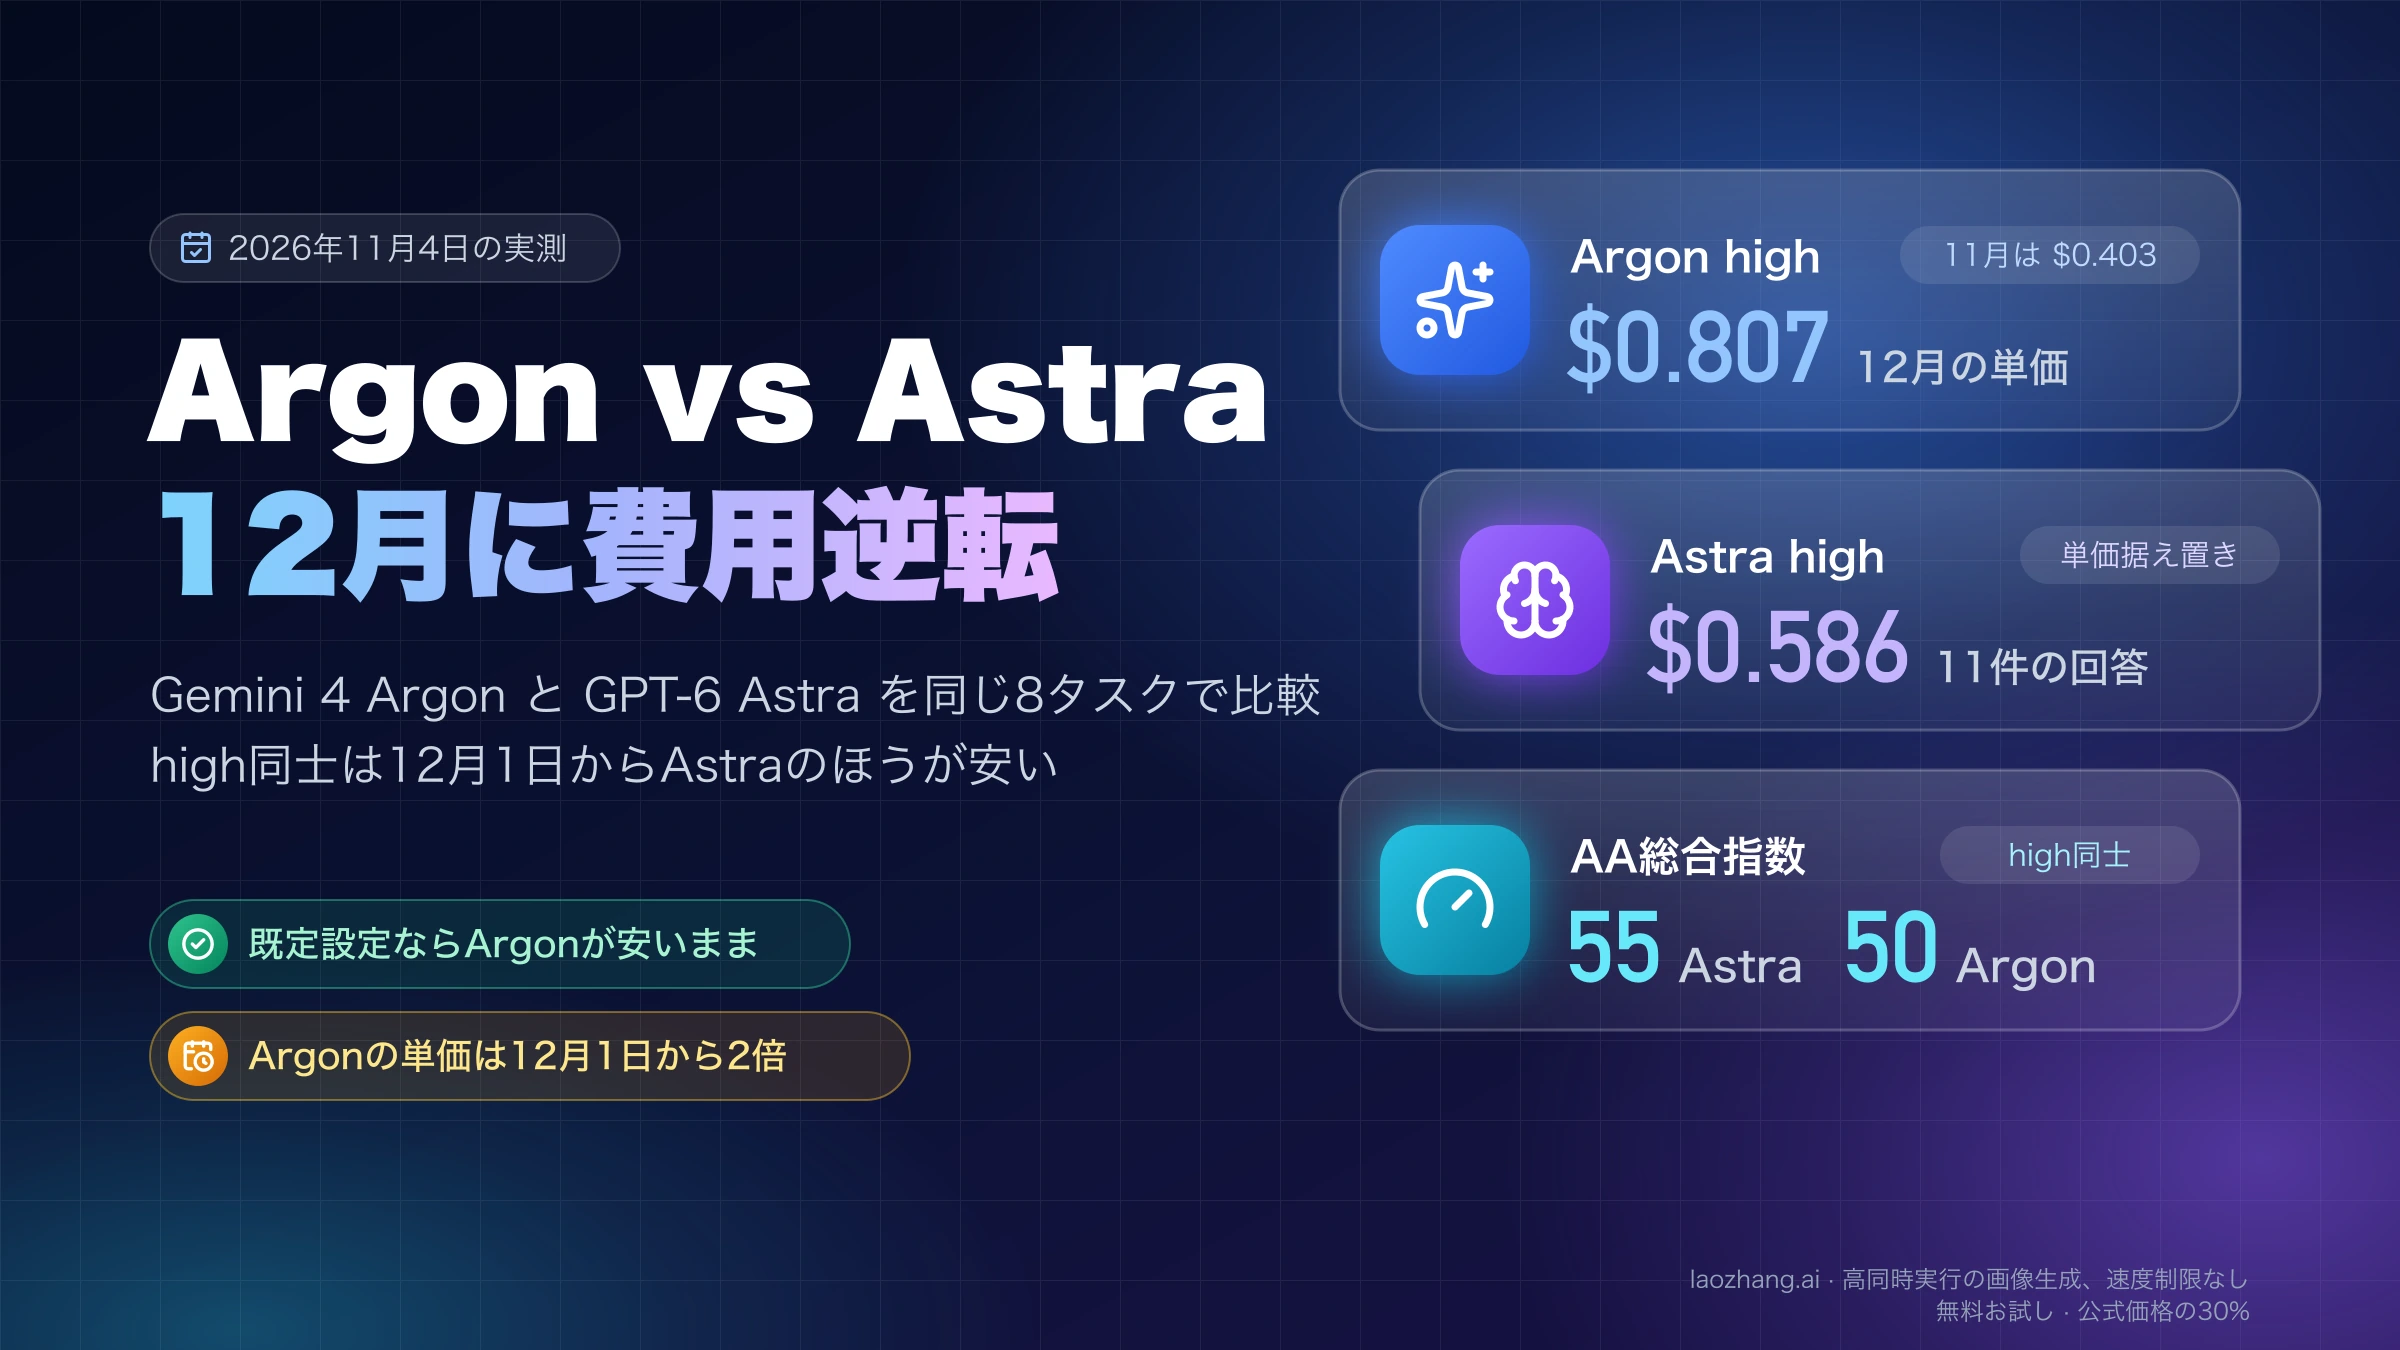
12月1日に変わるのはArgonの単価だけで、入力・出力・キャッシュ読み取りのすべてが2倍になります。ただし、トークン単価の比がそのまま1件あたりの費用の比になるわけではありません。3社は同じ文章を違うトークン数で数え、思考レベルを上げたときに書く出力の量もモデルごとに大きく違うからです。12月以降のArgonとAstraをhigh同士で比べた費用の逆転は、Gemini 4 ArgonとGPT-6 Astra比較:12月からhigh設定はAstraが安いで詳しく扱っています。
Artificial Analysisの指数で比べる:同じ点数ならArgon (High)は割高
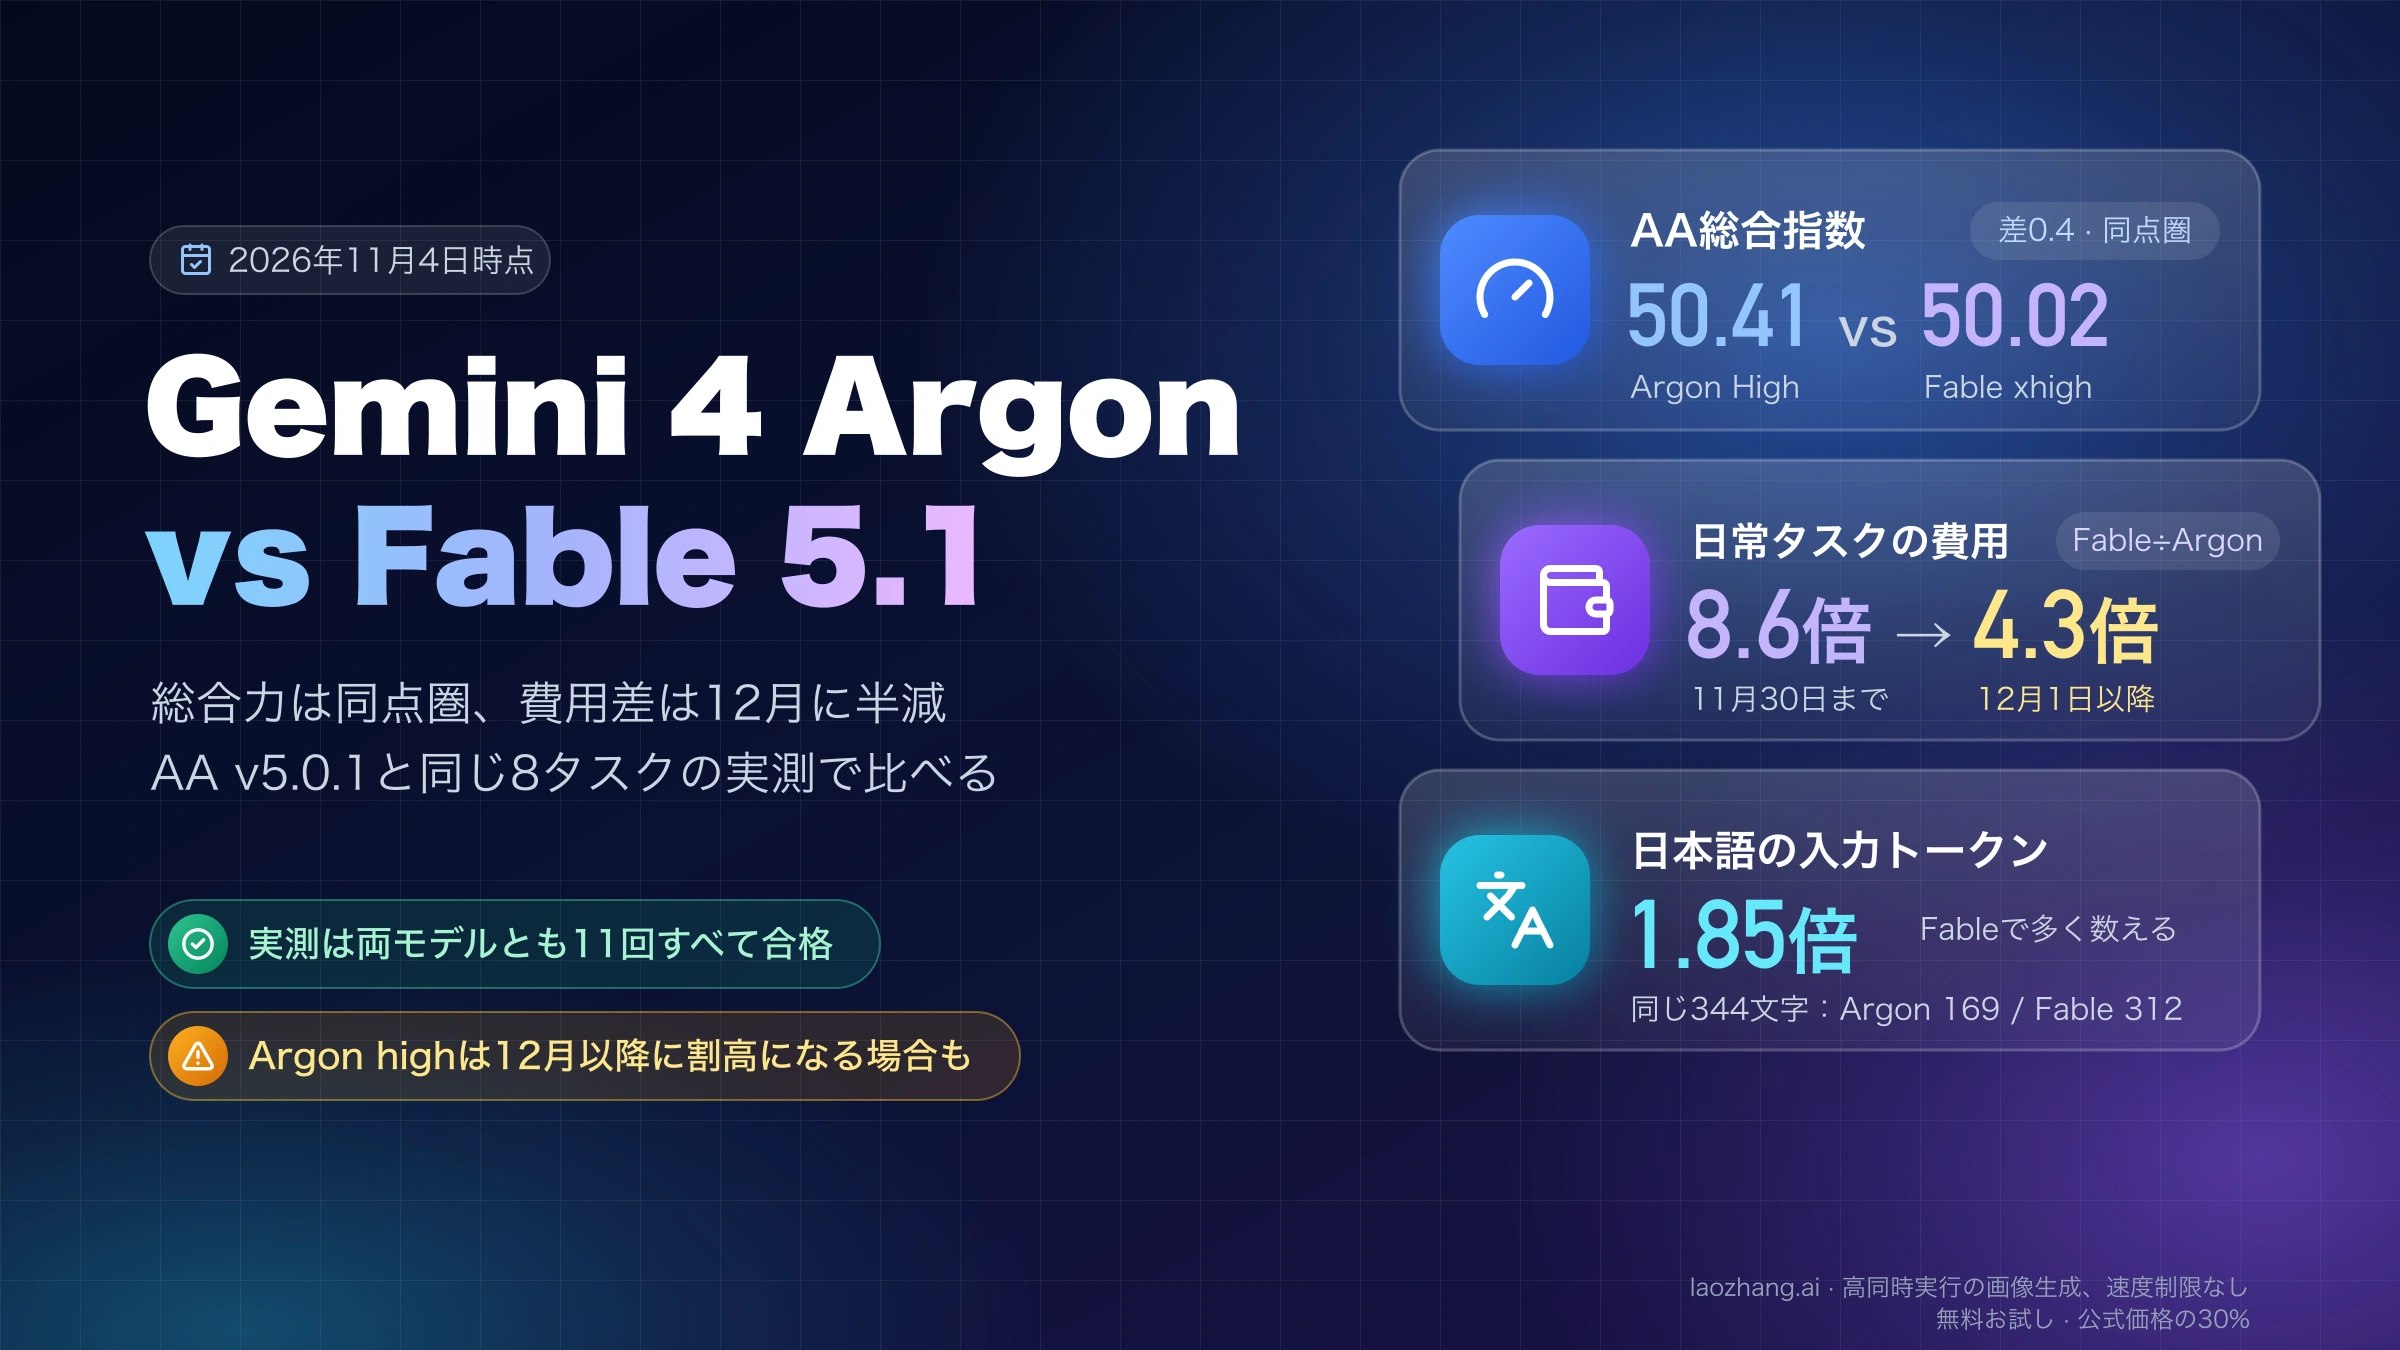
AAの総合指数v5.0.1(2026年11月11日時点)では、Argon (High)の50点より高い点数をより安い1タスク費用で出す設定が、11月30日までの単価で比べてもFable 5.2とAstraに5つ、12月からの単価では7つあります。AAが公表しているArgonの行はhighだけで、APIの既定であるmediumやlowの成績はありません。
| モデルと思考レベル | AA指数 | 1タスクの費用 | 1タスクの時間 |
|---|---|---|---|
Fable 5.2 max | 65 | $26.54 | 44.4分 |
Fable 5.2 xhigh | 62 | $14.83 | 26.1分 |
Fable 5.2 high | 62 | $9.08 | 17.5分 |
Fable 5.2 medium | 56 | $3.80 | 7.9分 |
Fable 5.2 low | 54 | $3.10 | 6.4分 |
Astra max | 57 | $6.24 | 23.0分 |
Astra xhigh | 55 | $3.66 | 11.4分 |
Astra high | 55 | $3.24 | 9.8分 |
Astra medium | 52 | $2.73 | 7.1分 |
Astra low | 43 | $1.42 | 3.8分 |
| Argon (High) | 50 | $9.95 | 28.6分 |
出典はAAのGemini 4 ArgonとClaude Fable 5.2の比較ページ、AAのGPT-6 AstraとClaude Fable 5.2の段階別比較ページ、AAのGemini 4 Argonのモデルページで、いずれも指数v5.0.1、2026年11月11日時点の値です。1タスクの費用は、指数を構成する9種類の評価の1タスクあたりにかかった費用を定価で計算した値で、ArgonはすでにAA側で12月からの単価(入力$4・出力$20)で計算されています。同じページのArgon (High)の費用は、2026年11月4日時点では$7.68で、11月11日時点で$9.95に変わりました(指数のバージョンはどちらもv5.0.1、ページに変更の説明はありません)。11月30日までの単価に合わせて半分にすると約$4.98で、これはAAの数字ではなく単価の比で割り戻した値です。
この$4.98と比べても、Argon (High)より点数が高く1タスクが安い設定は、Astra medium(52点・$2.73)、Fable 5.2 low(54点・$3.10)、Astra high(55点・$3.24)、Astra xhigh(55点・$3.66)、Fable 5.2 medium(56点・$3.80)の5つです。12月1日以降の$9.95で比べると、Astra max(57点・$6.24)とFable 5.2 high(62点・$9.08)もArgon (High)より安くなります。全部の行より安いのはAstra low(43点・$1.42)だけで、こちらは点数がArgon (High)を下回ります。つまり、Argonをhighにしないと足りない難しさの仕事なら、同じ費用でより高い点数の設定がFable 5.2とAstraにあります。逆に、この表はAPI既定のmediumで動くArgonについて何も示していません。
Fable 5.2とAstraの間では、Fable 5.2 medium(56点)がAstra max(57点)より1点低いだけで費用は39%安く、時間は約3分の1です。Fable 5.2 low(54点)もAstraのhigh・xhigh(55点)より1点低く、4〜15%安く済みます。57点を超える行はFable 5.2にしかなく、maxの$26.54はAstra maxの4.25倍です。よく引用される「Fable 5.2は65点、Astraは57点」は、どちらも最高のmax設定での点数です。Fable 5.2とAstraの思考レベルの対応や、両社のコーディングCLIでの実測はGPT-6 AstraとClaude Fable 5.2比較:effort対応と1タスクの費用にまとめています。
同じ8課題の実測:既定のArgonは$0.096、Fable・Astraは4.3倍以上
2026年11月11日に同じ8課題を3モデル・7設定に送ったところ、採点対象の11件はどの設定でも全問合格し、違いは費用と時間だけに出ました。最も安いのは既定設定のArgon($0.096)、最も高いのはFable 5.2の既定設定($0.744)で、差は7.7倍です。
課題は、文章題1問、隠しテストで採点するPythonの小さな関数3問、6,723語の英語記事を5項目に要約する課題、式の評価器(隠しテスト25件)、CSVの1行を分解するパーサー(隠しテスト16件)、コードを使わない数え上げ問題で、最後の3問は2回ずつ出して計11件です。呼び出しはこの節と次のログ課題のどちらもlaozhang.aiのAPIゲートウェイを経由し、1つのキーで各社のネイティブ形式(ArgonはGemini APIのgenerateContentでストリーミングなし、ログ課題のhighだけストリーミング、Fable 5.2はMessages APIでストリーミング、AstraはChat Completionsでストリーミング)を使いました。システムプロンプトとツールは使っていません。要求したモデル名を返した応答だけを数え、そうでない応答は再実行しています。「既定」は思考レベルの項目を送らない設定で、Argonはmedium、Fable 5.2はhighが各社ドキュメント上の既定です。同じ日にこのゲートウェイのGET /v1/modelsが返した208モデルにgemini-4-carbonはなく、Gemini 4 Carbonはテストに入っていません。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
| 設定 | 合格 | 入力トークン | 出力トークン(うち思考) | 費用(11月30日まで) | 費用(12月1日から) | 所要時間 |
|---|---|---|---|---|---|---|
| Argon 既定 | 11/11 | 12,712 | 7,085(1,806) | $0.096 | $0.193 | 148秒 |
Argon high | 11/11 | 12,712 | 36,291(30,842) | $0.388 | $0.777 | 463秒 |
Fable 5.2 low | 11/11 | 17,202 | 7,063(内訳なし) | $0.420 | $0.420 | 97秒 |
Fable 5.2 medium | 11/11 | 17,202 | 9,317(内訳なし) | $0.510 | $0.510 | 122秒 |
| Fable 5.2 既定 | 11/11 | 17,202 | 15,151(内訳なし) | $0.744 | $0.744 | 173秒 |
| Astra 既定 | 11/11 | 11,407 | 5,471(1,964) | $0.413 | $0.413 | 92秒 |
Astra high | 11/11 | 11,407 | 9,455(6,042) | $0.612 | $0.612 | 142秒 |
既定のArgonを1とすると、11月30日までの費用はhighのArgonが4.0倍、Astra既定が4.3倍、Fable 5.2 lowが4.4倍、Fable 5.2 mediumが5.3倍、Astra highが6.4倍、Fable 5.2既定が7.7倍です。12月1日からはArgon同士の比(4.0倍)を除いて約半分になり、Astra既定2.1倍、Fable 5.2 low 2.2倍、Fable 5.2 medium 2.7倍、Astra high 3.2倍、Fable 5.2既定3.9倍です。Fable 5.2 lowとAstra既定の費用は2%以内でほぼ同じで、同じモデル内ではFable 5.2既定がlowの1.77倍、Astra highが既定の1.48倍でした。
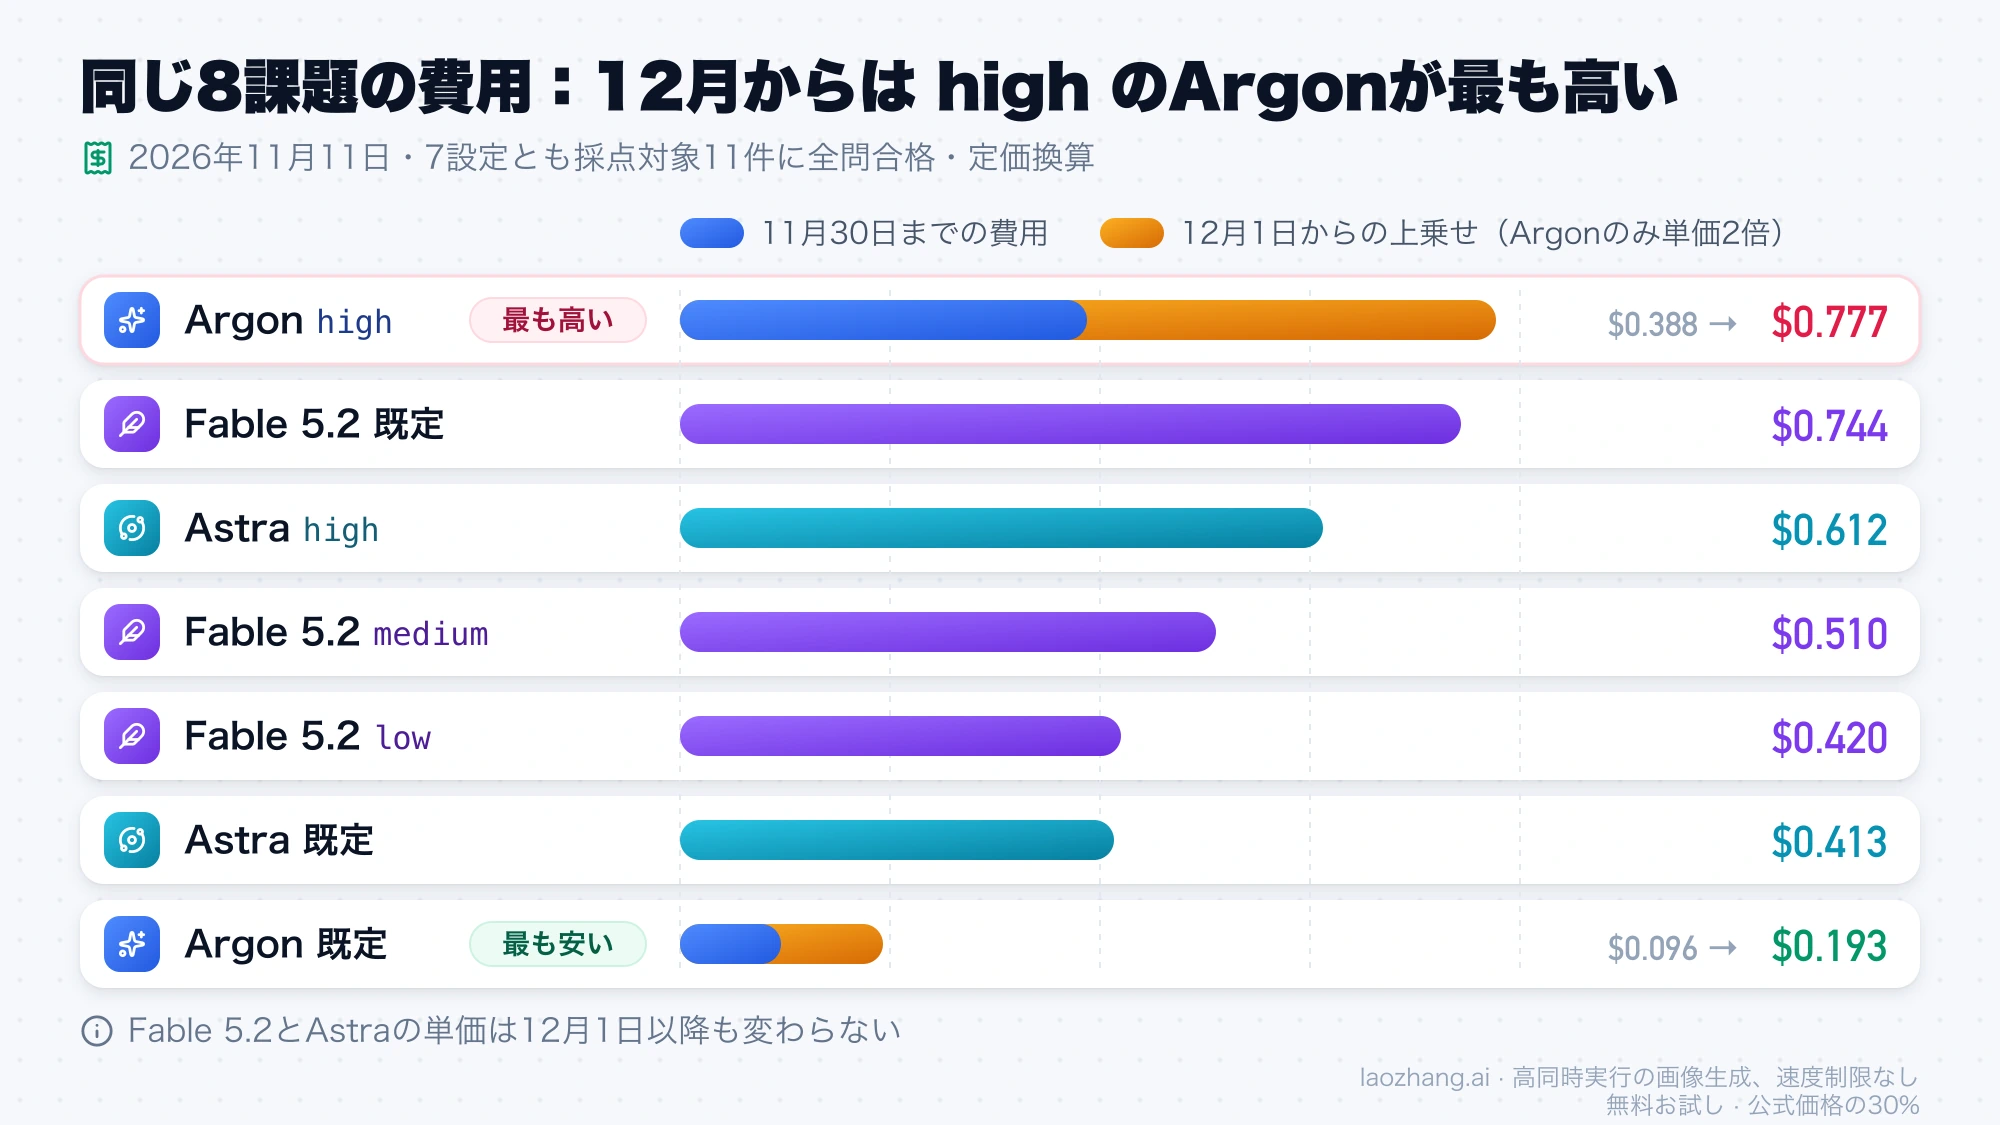
この表から言えるのは、小さく仕様の明確な課題なら3モデルとも合格し、同じ結果を出すのに使ったトークンと費用がこれだけ違う、ということです。どのモデルが賢いかの順位ではありません。費用は返ってきたトークン数に各社の定価を掛けた値で、請求額ではありません。Astraの費用には、キャッシュ設定なしで既定で発生したキャッシュ書き込み(記事の要約で10,104トークン)が含まれます。Fable 5.2は思考トークンを出力トークンの中に含めて返すため内訳がありません。ゲートウェイ1つ、1日、各設定1〜2回の結果です。Argonはストリーミングなしで呼び、再実行分も順に送ったため、所要時間はおおまかな目安として見てください。
単価が最安のArgonがhighで安くならない理由
思考に使ったトークンは出力として課金されるため、思考レベルを上げたときに出力がどれだけ増えるかで、単価の安さが打ち消されます。上の8課題でhighのArgonが書いた出力は36,291トークン(うち思考30,842)で、同じ11件に全問合格した既定設定の7,085トークンの5.1倍でした。今の単価ではその$0.388がAstra既定($0.413)やFable 5.2 low($0.420)をわずかに下回りますが、12月1日からは$0.777となり、Fable 5.2既定($0.744)を含むほかの6設定すべてより高くなります。
次の節のログ課題でも同じことが起きています。highのArgonの出力は44,980トークン(うち思考44,895)で、同じ課題に正解したAstra既定の2,423トークンの約18.6倍、Fable 5.2既定の9,792トークンの約4.6倍でした。出力単価はAstraの5分の1でも、出力の費用だけで見るとArgonは44,980×$10÷100万=約$0.45、Astraは2,423×$50÷100万=約$0.12で、Argonが約3.7倍かかっています。キャッシュなしの合計では入力の安さでArgon(約$0.61)がまだAstra($0.82)を下回りますが、12月の単価では約$1.22となり、正解した3つの設定のどれよりも高くなります。
AAの計測でも同じ傾向が出ています。指数1タスクあたりの出力はArgon (High)が116Kトークン(うち思考68.3K)で、Astra maxの52K(同35.8K)の2倍以上です。出力速度はArgonが毎秒68トークン、Astraが38〜43トークン、Fable 5.2が91〜103トークンで、Argon (High)の1タスク28.6分はAstra high(9.8分)やFable 5.2 high(17.5分)より長くかかります(AA指数v5.0.1、2026年11月11日時点)。Fable 5.2のmaxも1タスクで274Kトークン(うち思考193K)を出力しており、高い思考レベルで費用が膨らむのはArgonだけの問題ではありません。トークン単価から1件の費用を予想するより、合格1件あたりに出力したトークン数を見るほうが確実です。
長いログを正確に数える仕事:既定のArgonだけ不正解
長い入力から件数を正確に数える課題では、2026年11月11日のテストでFable 5.2とAstraは既定設定で正解し、Argonは既定設定で間違えました。課題は146KBのログ(1,500行、うちERROR行326行、同じエラーコードを持つWARN行を紛らわしい行として混在)から7つの値を答えるもので、正解は呼び出しの前にスクリプトで生成しておきました。
| 設定 | 7つの値 | 所要時間 | 出力トークン(うち思考) | 費用(定価換算) |
|---|---|---|---|---|
| Fable 5.2 既定 | すべて正解 | 74秒 | 9,792(内訳なし) | $1.02 |
Fable 5.2 medium | すべて正解 | 64秒 | 8,156(内訳なし) | $0.95 |
| Astra 既定 | すべて正解 | 26秒 | 2,423(2,374) | $0.82 |
| Argon 既定 | 不正解 | 22秒 | 85(0) | $0.16 |
Argon high(ストリーミング) | すべて正解 | 329秒 | 44,980(44,895) | $0.46 |
既定のArgonは思考トークンを1つも使わずに答え、5種類のERRORの件数はすべて実際より18〜38%少なく(たとえばE503は94件に対して58件)、正しかったのはリトライ回数が最大のリクエストIDだけでした。2026年11月4日に同じプロンプトで試したときも、既定のArgonは2回とも思考トークン0で不正解でした。同じ日にhighをストリーミングなしで呼ぶと、思考の途中で出力が32,768トークンに達したところで止まって答えが返らず、定価換算で$0.49分のトークンだけを使いました。ストリーミングにしたhighは2回とも正解し、271〜402秒かかっています。
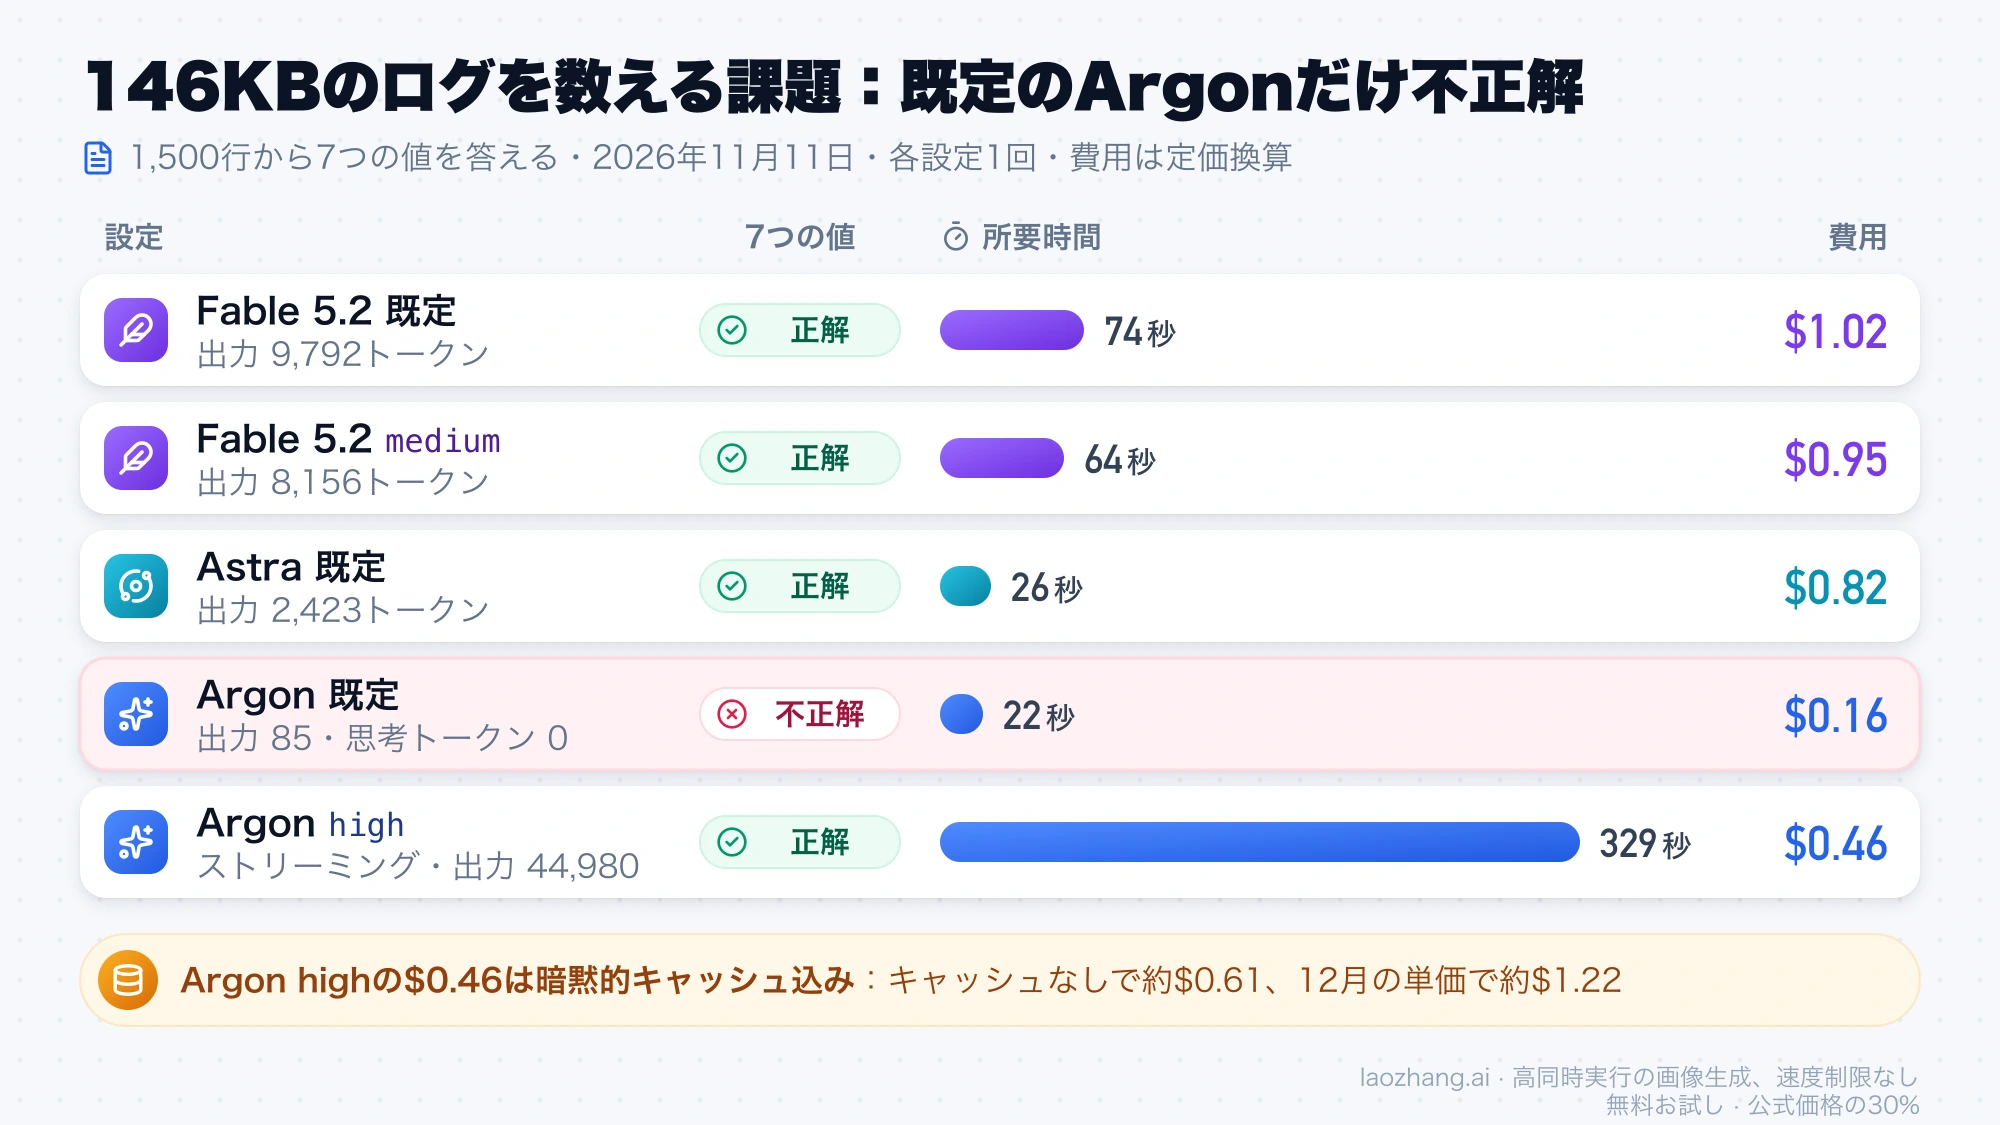
費用の数字には条件が付きます。11月11日のhighのArgonが$0.46で済んだのは、数分前の既定設定の呼び出しが残したGoogleの暗黙的キャッシュから77,258トークンを読んだためで、キャッシュなしなら約$0.61、12月の単価では約$1.22です。Astraの$0.82には、プロンプト全体を既定でキャッシュに書き込んだ分(100万トークンあたり$12.50)が入っており、30分以内に同じ入力を送れば$1の読み取り単価で済みます。課題の種類は1つ、この日は各設定1回なので一般的な品質の順位ではありませんが、Argonで長い入力の正確な集計をするならhighとストリーミングを使い、5分前後待つ前提が必要です。待てない処理はFable 5.2かAstraに回すと、26〜74秒で答えが返っています。
同じ日本語でもトークン数が違う:入力費用はArgonがAstraの約0.13倍
同じ文章でも3社のトークナイザーが数えるトークン数は違うため、100万トークン単価の比だけでは入力費用を比べられません。短い日本語の文章1つで測ると、Astraを1としてFable 5.2が1.23、Argonが0.67でした。これに単価の比を掛けた入力費用は、Fable 5.2がAstraの約0.98倍、Argonが11月30日まで約0.13倍、12月1日から約0.27倍です。
| 言語 | Fable 5.2のトークン数 | Argonのトークン数 | Fable 5.2の入力費用 | Argonの入力費用(11月30日まで) | Argonの入力費用(12月1日から) |
|---|---|---|---|---|---|
| 日本語 | 1.23 | 0.67 | 0.98 | 0.13 | 0.27 |
| 英語 | 1.45 | 1.00 | 1.16 | 0.20 | 0.40 |
| 中国語 | 1.50 | 0.84 | 1.20 | 0.17 | 0.34 |
| 韓国語 | 1.90 | 0.84 | 1.52 | 0.17 | 0.34 |
| ロシア語 | 1.56 | 0.91 | 1.25 | 0.18 | 0.36 |
| スペイン語 | 1.88 | 0.95 | 1.50 | 0.19 | 0.38 |
どの値もAstraを1とした比で、キャッシュのない入力の場合です。入力費用の比は「トークン数の比×入力単価の比」で、日本語のFable 5.2なら1.23×($8÷$10)=0.98、11月30日までのArgonなら0.67×($2÷$10)=0.13になります。Fable側の値は2026年10月26日にFable 5.1で測ったもので、AnthropicはFable 5.2も同じトークナイザーだと説明しています。11月11日のテストでも、英語記事のプロンプトをFable 5.2が数えたトークン数(15,335)は10月26日のFable 5.1と同じでした。Argonの値は11月4日の測定です。
文章1つ(246〜799文字)で測った比なので、内容が変われば値も動きます。11月11日の課題では、6,723語の英語記事がArgon 11,110・Fable 5.2 15,335・Astra 10,106トークン、146KBのログがArgon 79,312・Fable 5.2 78,537・Astra 55,843トークンで、ログではArgonがAstraの1.42倍を数えました。IDや記号の多い入力では日本語の文章ほどArgonが有利になりません。Astraには、入力が272Kトークンを超えるとリクエスト全体が入力$20・出力$75で課金される境目もあります。その計算方法はGPT-6 Astra API料金:10種類の単価と長文・Batch・Fastの計算方法を参照してください。
コーディングならどれか:Fable 5.2が上位、Argon (High)は端末操作で近い
難しいコーディングでは、第三者の評価でもベンダーの公表値でもFable 5.2が上、Astraが次で、Argon (High)はコード生成の評価で差をつけられています。ただし3つを同じ条件で並べたベンダーの表はなく、出どころごとに比べている相手と設定が違います。
第三者のAA(指数v5.0.1、2026年11月11日時点)では、コード生成のFrontierCode-AA 2.0がArgon (High) 25.7%、Fable 5.2 max 48.8%、Astra max 42.4%です。低い設定のFable 5.2 low(38.4%)やAstra medium(36.6%)もArgon (High)を上回ります。一方、端末操作のTerminal-Bench 4.0はArgon (High) 57.1%、Fable 5.2 max 59.6%、Astra max 59.1%と差が小さく、Fable 5.2 medium(55.1%)やAstra high(54.0%)よりはArgon (High)のほうが上です。
ベンダーの公表値は、それぞれ別の相手と比べています。Anthropicが2026年11月9日に出したClaude Fable 5.2の発表ページの表は、ArgonではなくGemini 4 Carbonと比べており、FrontierSWE v2はFable 5.2 69.9%、Astra 65.5%、Carbon 61.2%です。Googleが9月30日のArgon発表時に出した表ではArgonとAstraが並び、FrontierSWE v2はAstraが65.5対55.0、Terminal-Bench 4.0もAstraが上で、DeepSWE v1.1はArgonが77.9対74.1で上でした。FrontierSWE v2を2つの表からつなぐとFable 5.2 69.9、Astra 65.5、Argon 55.0ですが、2社が別々に実行した数字なのでおおまかな目安です。OpenAIはFable 5.2やArgonと比べた表を公表していません。
コーディング以外では、AAの項目別でArgon (High)が3つの中で首位なのは業務自動化のAutomationBench-AA(77.5%、Fable 5.2 max 76.4%、Astra max 68.5%)だけで、PDF文書を読む課題のGDP.pdfではAstra max(31.0%)が首位です。小さな実装は上の8課題のテストで3つともどの設定でも隠しテストに合格しているので、日々の小さな修正は費用で選び、テストを通せない難しい課題が出てきたらFable 5.2を試す、という順番が数字と合います。
Gemini 4 Carbonを使うべきか:11月10日から同じ単価で一般提供
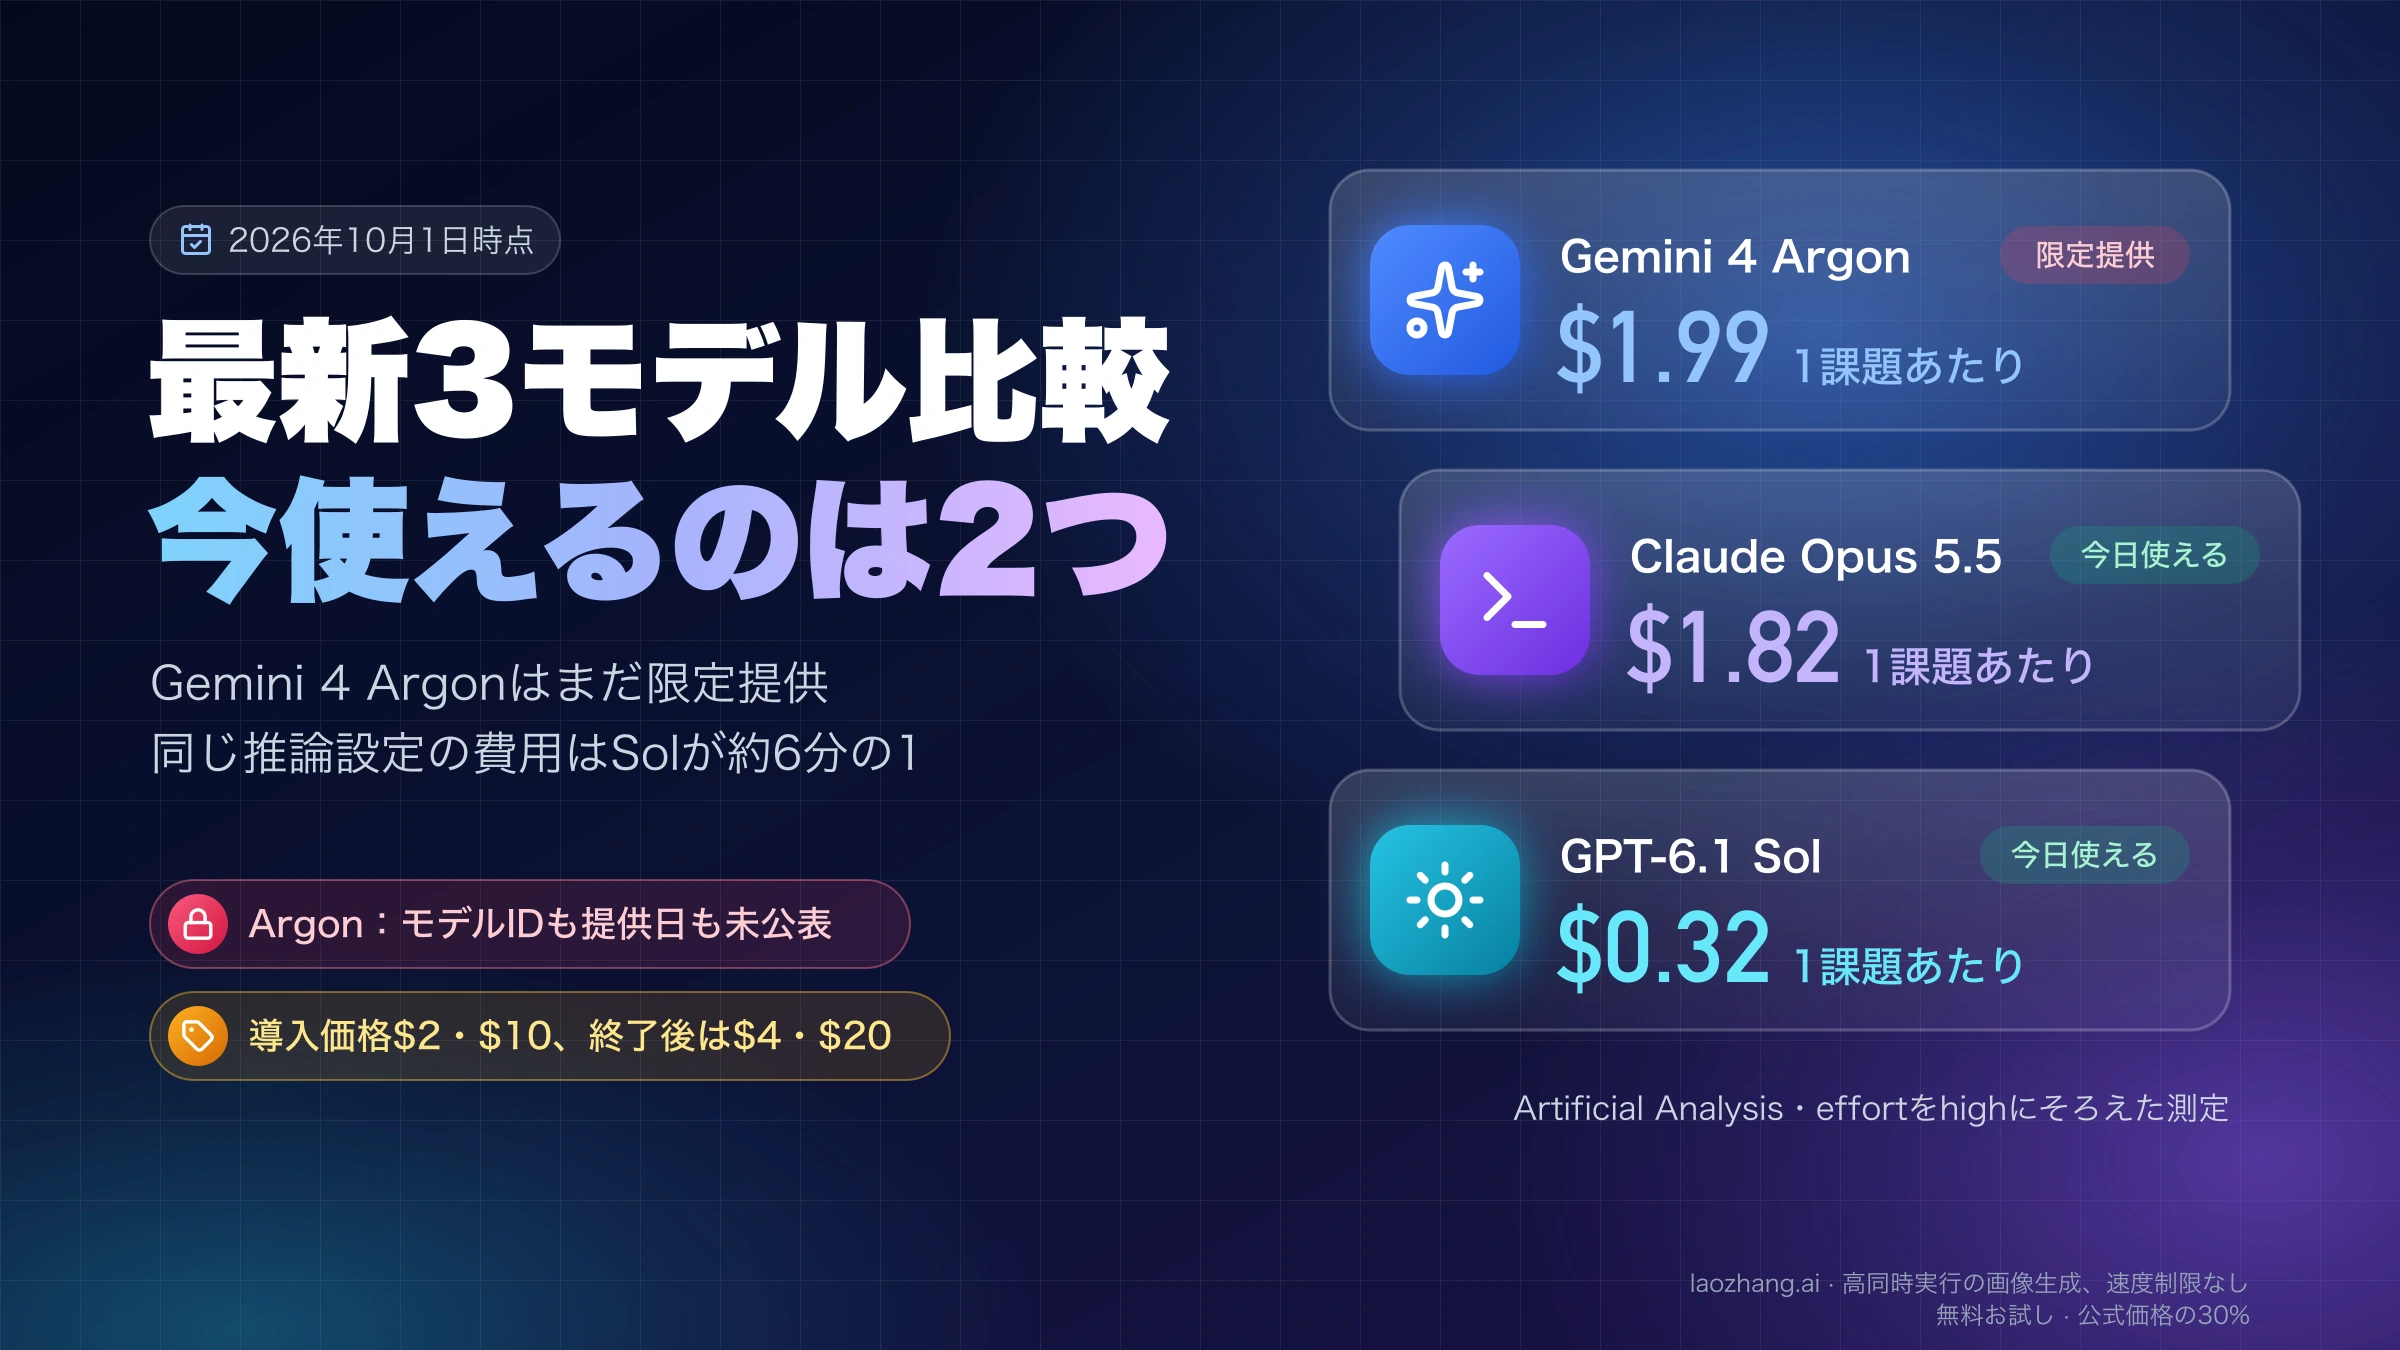
GoogleのGemini 4 Carbon(gemini-4-carbon)は、2026年11月10日から有料のGemini APIとGoogle AI Studioで一般提供されています(Gemini APIの変更履歴)。単価はArgonと同じで、11月30日までは入力$2・出力$10、12月1日から$4・$20、無料枠はありません。コンテキスト100万トークンと思考レベルlow・medium・high(既定はmedium)もArgonと共通です。それ以前は対象を限った提供だったため、「Carbonは限られた組織しか使えない」という説明は11月10日以降は当てはまりません。
GoogleはGemini 4 Carbonの新機能ガイドで、2つの違いを1ターンに使う思考トークンの量だと説明しています。Carbonはより多く考えて自分の答えを検証するぶん、トークン数と待ち時間がArgonより増え、複雑な原因調査、設計、証明、セキュリティ監査に向きます。Argonは高度なソフトウェア開発や知的作業の大半に向き、対話的なコーディングや日々の機能追加で速く、トークンの消費が少ないとしています。
AAの指数v5.0.1(2026年11月11日時点)では、Carbon (High)は60点・1タスク$7.76・24.9分で、Argon (High)の50点・$9.95・28.6分より点数が高く、費用も時間も少なく済んでいます(どちらも12月からの単価で計算)。Argonをhighで使っている仕事なら、Google内で乗り換える候補としてCarbonも比べる価値があります。各モデルの最高点で比べると、CarbonはFable 5.2(maxの65点)に次ぎ、Astra(maxの57点)を上回ります。段階別ではFable 5.2のhighとxhigh(どちらも62点)もCarbonより上です。ただし、Carbonは上の同一課題テストに含まれていないため、既定設定のmediumでの実際の費用は自分の課題で確かめる必要があります。
品質を比べる前に確認する:3モデルが使えなくなる条件
次の条件に当てはまると、性能や費用を比べる前に候補から外れるモデルがあります。内容は2026年11月10〜11日時点の各社ドキュメントに基づきます。
- 動画や音声を入力する仕事では、3つのうちArgonしか使えません。Fable 5.2とAstraの入力はテキストと画像です。
- Argonを
highで使うときはストリーミングにします。2026年11月4日のテストでは、ストリーミングなしで呼んだhighのArgonが出力32,768トークンで止まり、答えが返りませんでした。 - ArgonにはAPIの無料枠がなく、すべてのトークンが課金されます。明示的なコンテキストキャッシュにも対応しておらず、使えるのは暗黙的キャッシュだけです。
- Fable 5.2は、高リスクのサイバーセキュリティ作業と研究系バイオの多くを安全分類器でブロックします。認証を受けた組織向けには、安全対策を緩めた同じモデルのMythos 5.2があります。
- Fable 5.2は30日間のデータ保持が前提で、承認を受けない限りデータを保持しない契約(ゼロデータ保持)では使えません。
- Fable 5.2でツール呼び出しを強制する指定は400エラーになり、
temperature・top_p・top_kは送らずに呼ぶ必要があります。思考をオフにすることもできません。 - Astraの関数呼び出しはResponses APIでしか使えず、Chat Completionsのままでは動きません。費用面では、入力が272Kトークンを超えるとリクエスト全体が入力$20・出力$75で課金され、キャッシュ書き込みも既定で発生して課金されます。
提供国・地域では、3社とも日本を対象に含め、ロシアと中国本土を含めていません(Anthropicの対応国リストは2026年11月11日時点、GoogleとOpenAIのリストは11月4日時点)。
自分の仕事で確かめる:合格1件あたりの費用を計算する
最終的には、自分の仕事で「合格した1件あたりの費用」を比べるのがいちばん確実です。1件の費用は「(入力トークン数×入力単価+出力トークン数×出力単価)÷100万」で、キャッシュから読んだ入力はキャッシュ読み取りの単価に、Astraのキャッシュ書き込みは書き込み単価に置き換えます。たとえばログ課題のhighのArgonをキャッシュなしで計算すると、79,312×$2+44,980×$10を100万で割って$0.1586+$0.4498=約$0.61、8課題のFable 5.2既定設定は17,202×$8+15,151×$40で$0.1376+$0.6060=約$0.744です。
- 普段の仕事から10〜20件を選びます。うまくいった簡単な依頼だけでなく、以前に人の修正が必要だった依頼も入れます。
- 同じ入力を、少なくともArgonの既定設定と
high(ストリーミング)、Fable 5.2のlowとmedium、Astraの既定設定とhighで送ります。 - 自動テストや正解表で合否を判定し、各レスポンスの使用量の欄から入力と出力のトークン数を記録します。3社でトークンの数え方が違うので、1社の数から他社の分を推測しないでください。
- 設定ごとの費用の合計を合格件数で割り、合格1件あたりの費用を出します。
- 12月1日以降の判断用に、Argonの単価だけを2倍にして計算し直します。Fable 5.2とAstraの単価はそのままです。
合格件数が同じなら、合格1件あたりの費用がいちばん低い設定が普段のモデルになります。合格件数に差が出た場合は、落ちた依頼を人が直す手間も費用として加えると、Argon highやFable 5.2 highへ上げる価値があるかが見えてきます。
サブスクリプションで使う場合:Gemini・Claude・ChatGPTのプラン
APIではなく月額プランで使う場合は、条件がプランごとに違います。Argonは、GeminiアプリとAIモードではGoogle AI ProとUltra、AntigravityではPro・Ultra・Enterpriseの有料プランで使え、無料のGeminiアプリでは使えません(2026年10月27日時点)。どこで使えるか、無料になる経路があるかはGemini 4 Argonは無料で使える?どこで使えるかと0円になる条件で詳しく扱っています。
Fable 5.2はClaudeのすべての有料プランで使え、Freeでは使えません。Max、Ultra、プレミアム席では週の上限の50%まで含まれ、Proと標準のTeam席は利用クレジットでの支払いになります(2026年11月16日午後11時59分(PT)までの公開週を除く)。Claude Codeでは/model fableで切り替えます。Astraは、ChatGPTのFreeとGoではGPT-6 Lunaになり、Plusと標準のBusinessではWorkとCodexで5時間あたりおよそ5〜45回のメッセージ、Proは5時間の上限がありません(2026年11月10日時点)。プランの使用量は頻繁に変わるため、契約前に各社のプランページで確認してください。
参考資料10
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年11月11日。
参考資料10
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年11月11日。
- 1.Gemini APIの料金ページaistudio.google.com/docs/pricing
- 2.Claude APIの料金ページplatform.claude.com/docs/en/about-claude/pricing
- 3.OpenAI APIの料金ページdevelopers.openai.com/api/docs/pricing
- 4.AAのGemini 4 ArgonとClaude Fable 5.2の比較ページartificialanalysis.ai/models/comparisons/gemini-4-argon-vs-claude-fable-5-2
- 5.AAのGPT-6 AstraとClaude Fable 5.2の段階別比較ページartificialanalysis.ai/models/releases/comparisons/gpt-6-astra-vs-claude-fable-5-2
- 6.AAのGemini 4 Argonのモデルページartificialanalysis.ai/models/gemini-4-argon
- 7.Claude Fable 5.2の発表ページanthropic.com/claude-fable-and-mythos-5-2
- 8.Gemini APIの変更履歴aistudio.google.com/docs/changelog
- 9.Gemini 4 Carbonの新機能ガイドaistudio.google.com/docs/whats-new-gemini-4-carbon
- 10.対応国リストanthropic.com/supported-countries