Claude Fable 5.2と5.1の違い:2割値下げでもhigh以上は割高
Fable 5.2は単価2割安。1タスクの費用はlow・mediumで3割減、high以上では増えます。Claude Codeはmedium、APIはmediumも試します。
目次
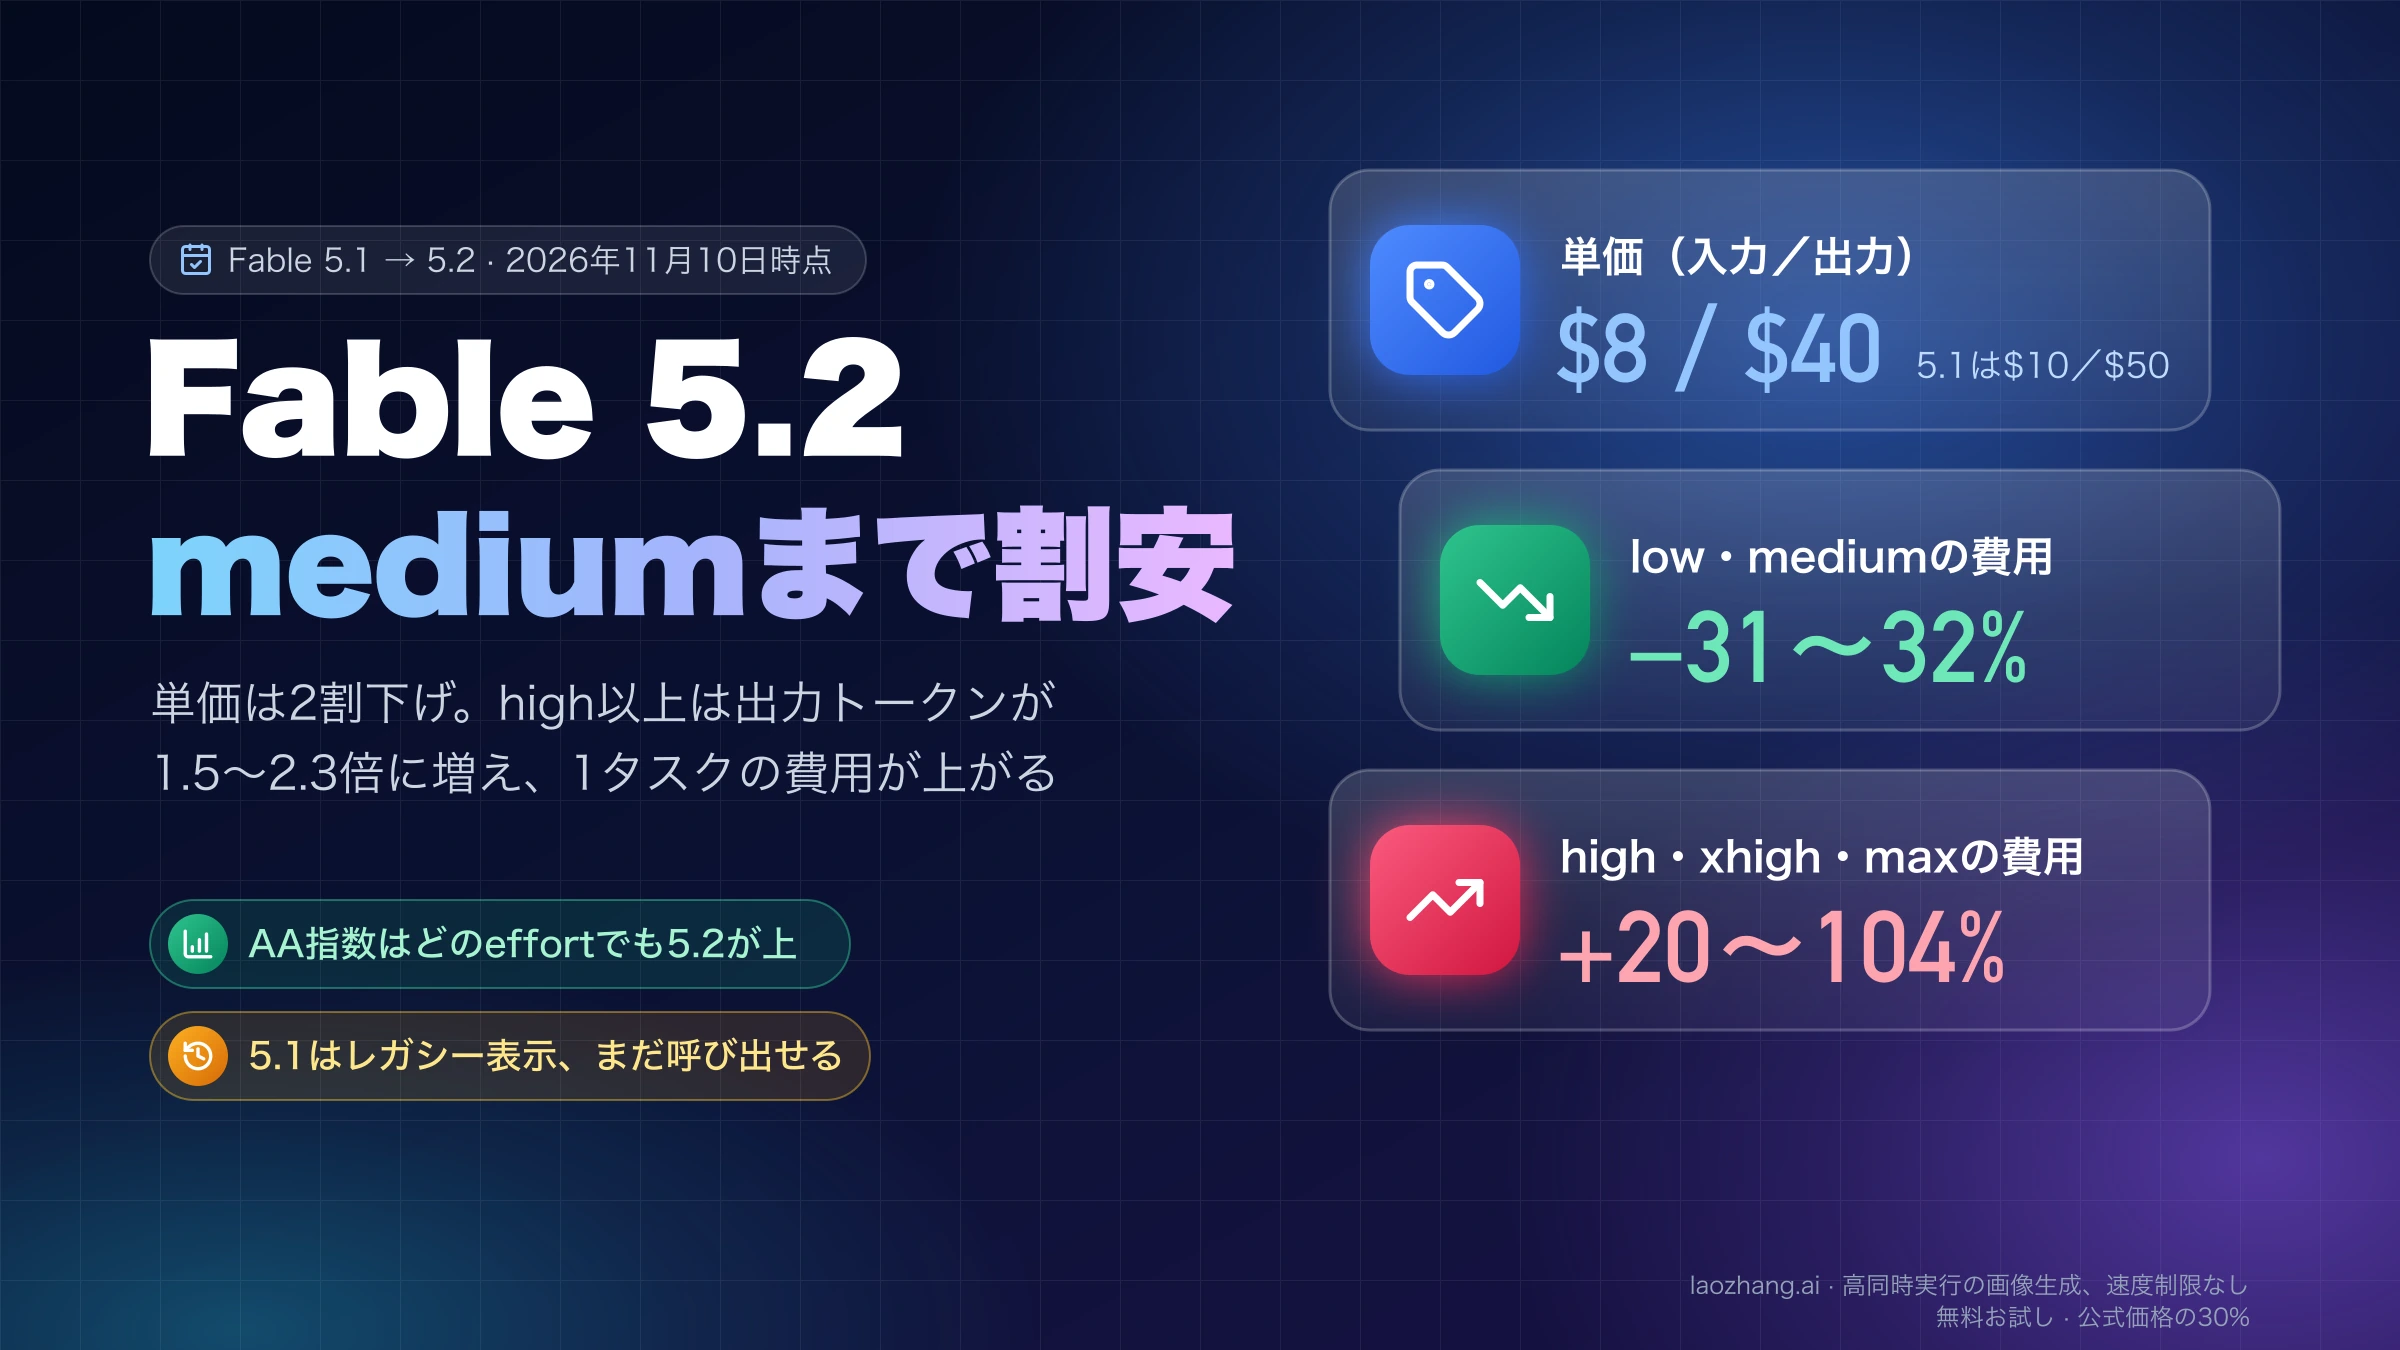
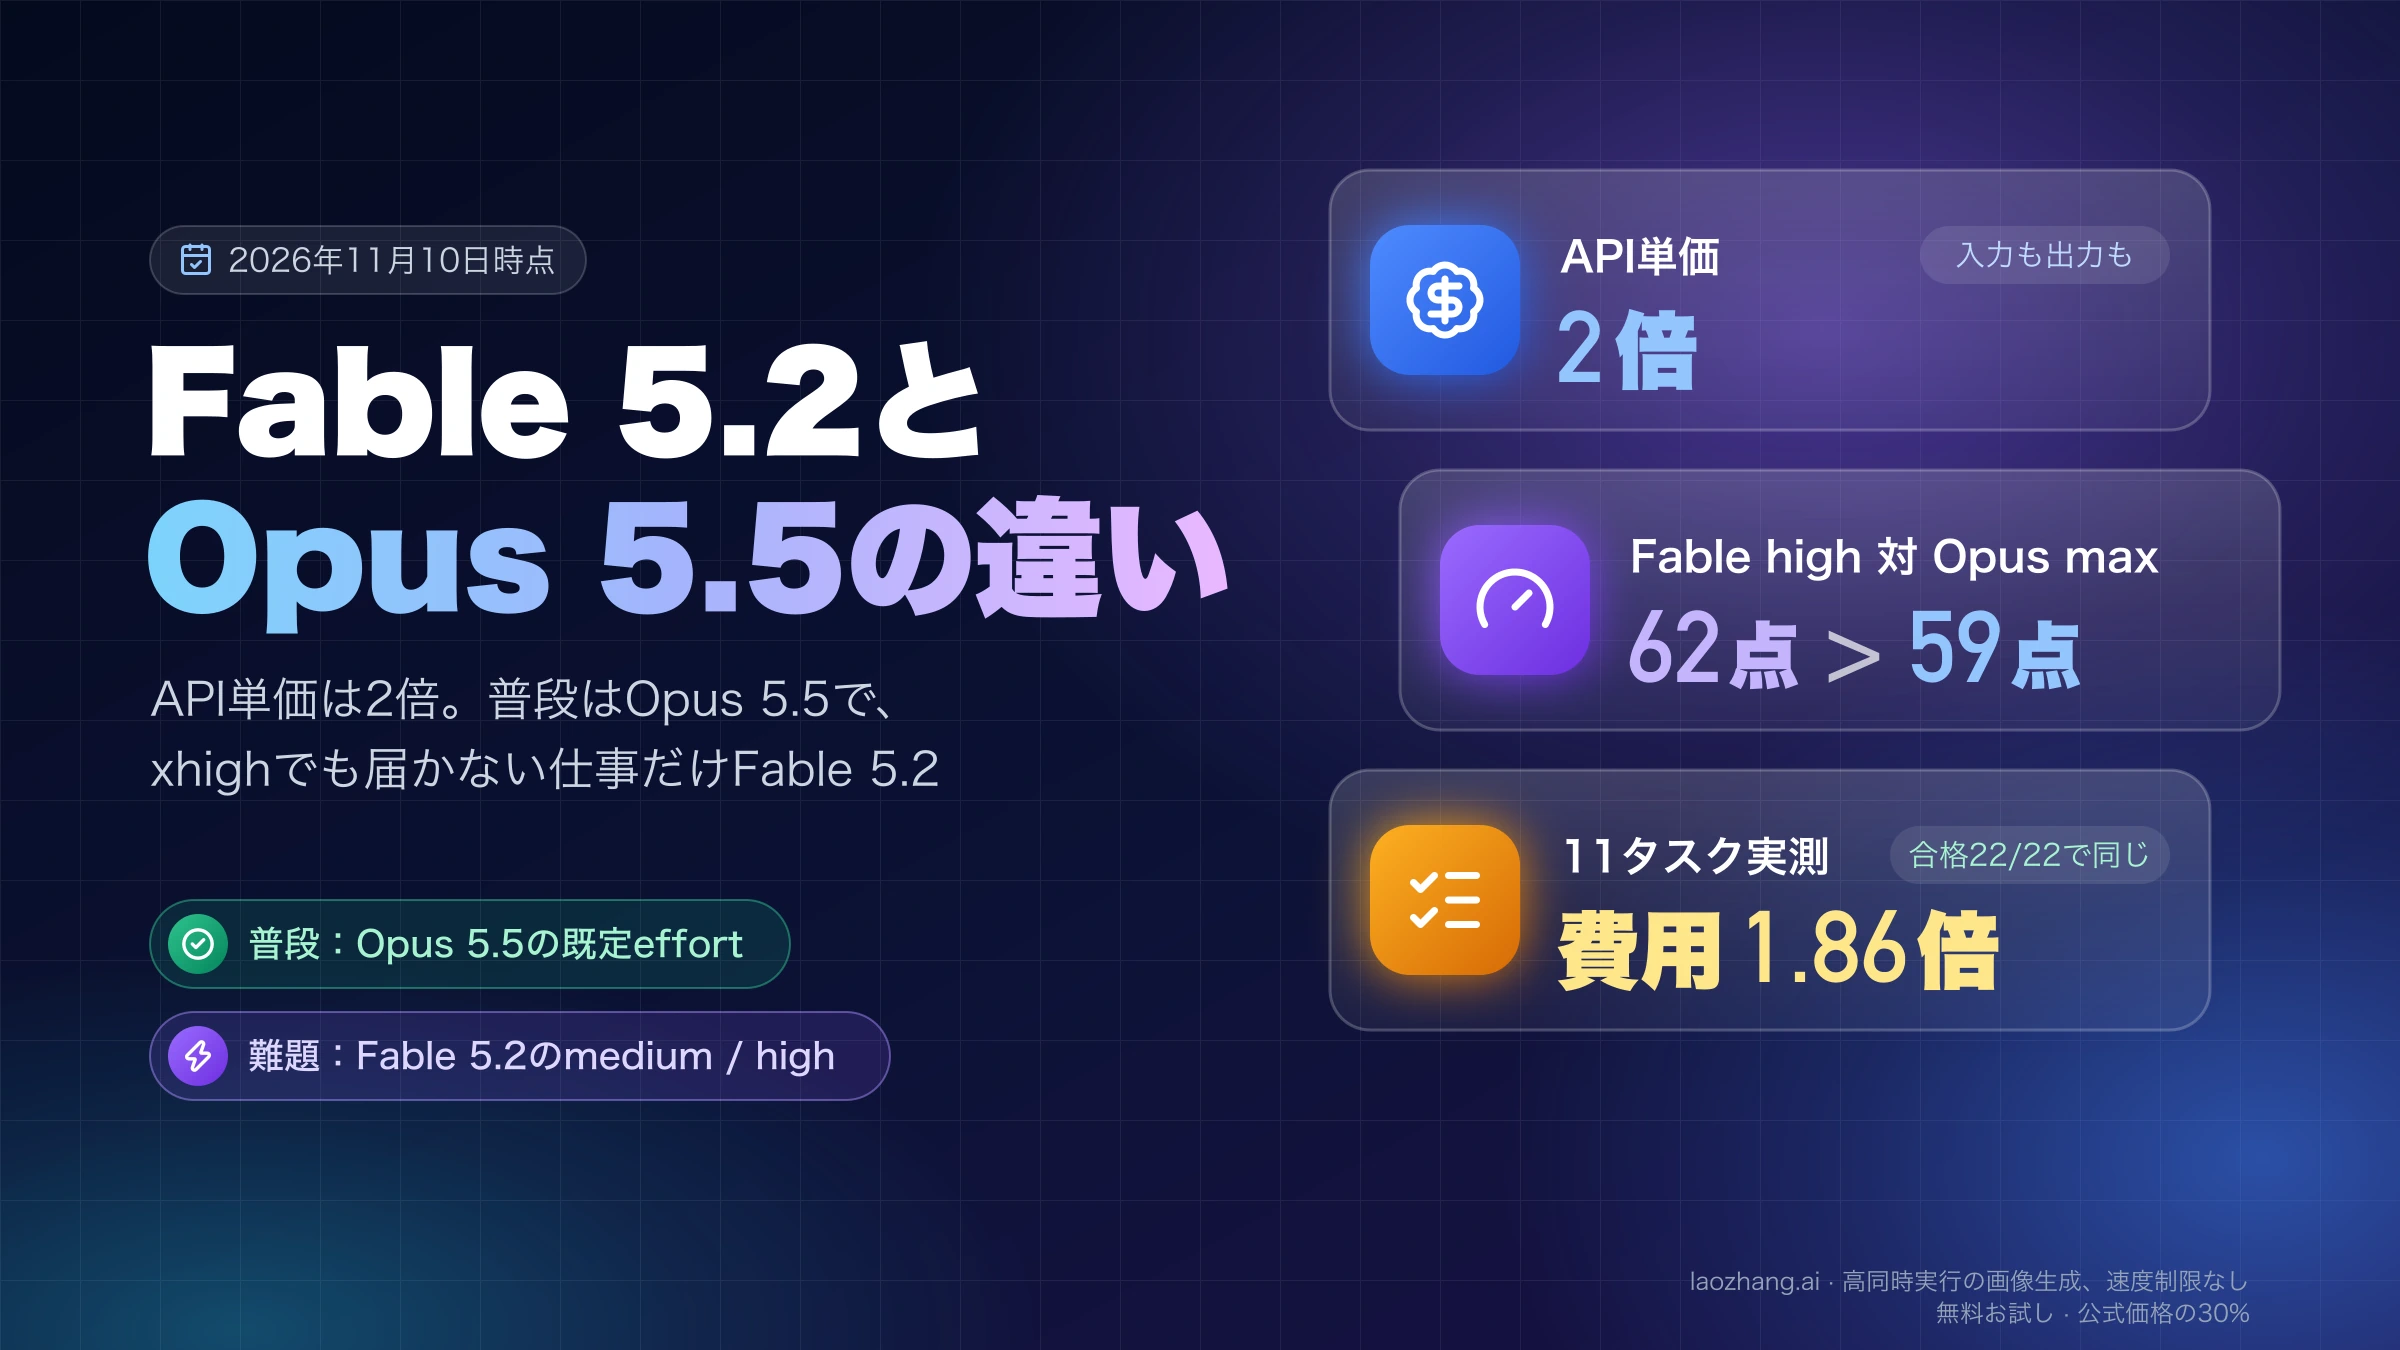
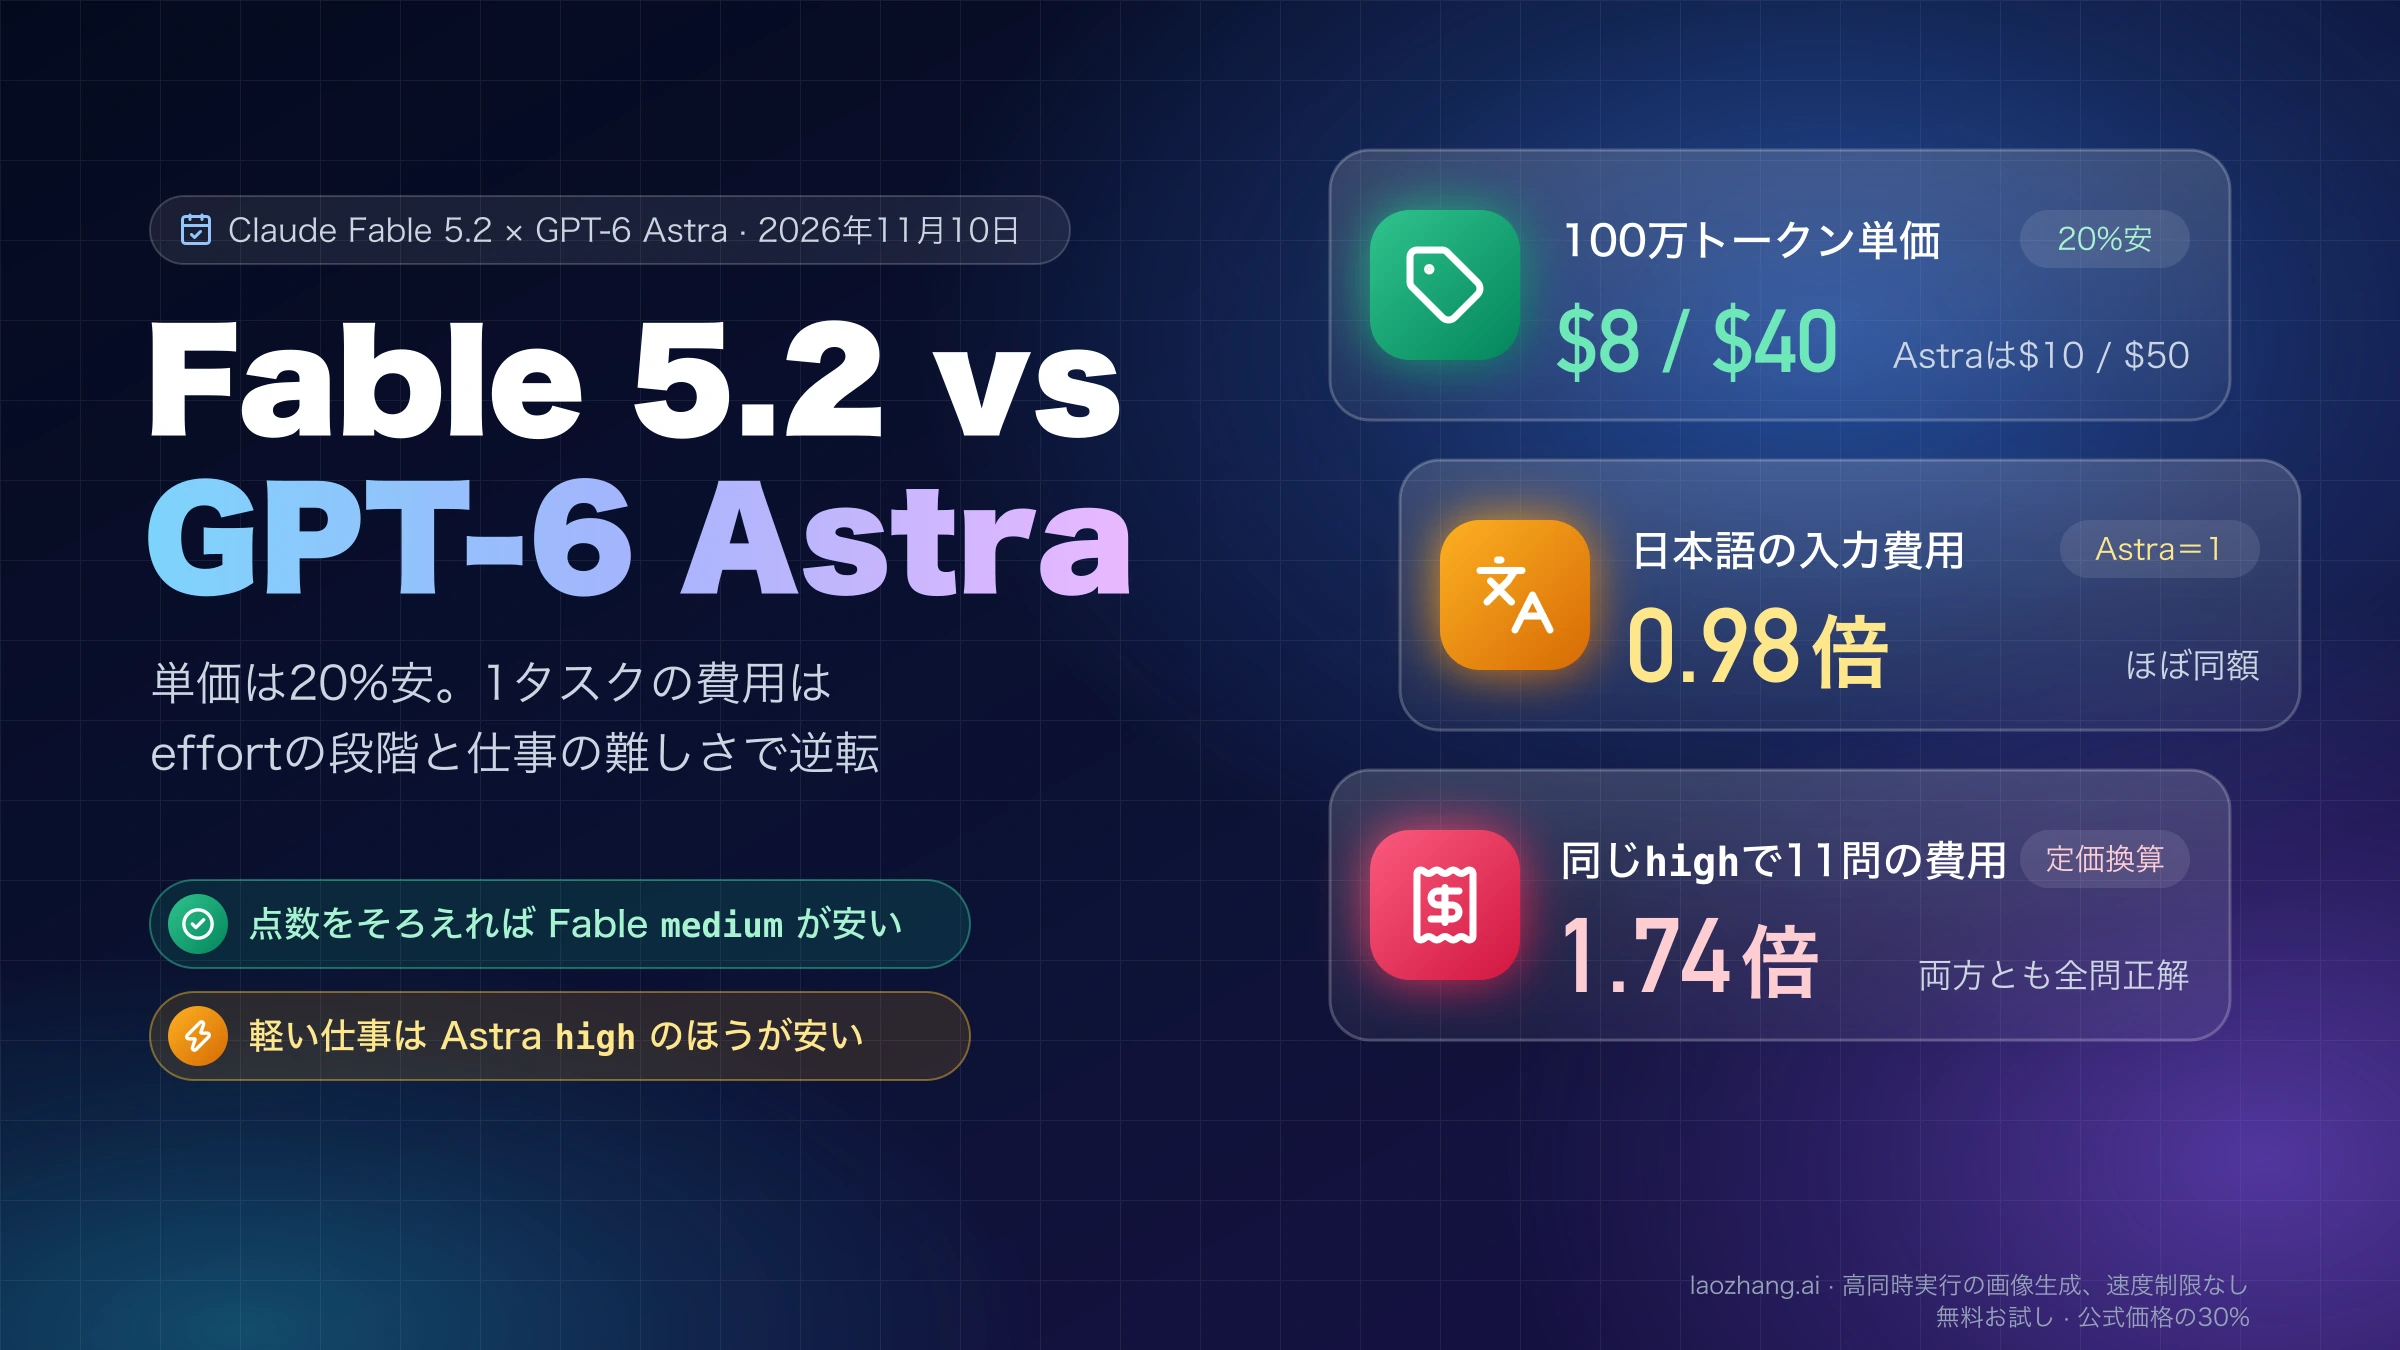
2026年11月9日に公開されたClaude Fable 5.2は、Fable 5.1から切り替える価値のある更新です。100万トークンあたりの単価はすべて2割下がり(入力$10→$8、出力$50→$40)、第三者機関Artificial Analysis(AA)の総合指数v5.0.1(2026年11月10日時点)では、5.2のどのeffortも5.1のどのeffortより高い点を取っています。ただし1タスクあたりの費用は、effortによって逆向きに動きます。同じeffortで比べると、lowとmediumでは5.2が31〜32%安いのに対し、high・xhigh・maxでは出力トークンが1.5〜2.3倍に増えるため、値下げ後でも20%・37%・104%高くなります。
切り替え方と選ぶeffortは入口で決まります。Claude Codeでは/model fableで5.2になり、既定のeffortはmediumです。5.1の既定highと比べるとAAの指数は47→56、1タスクの費用は約半分になるので、そのまま使って構いません。APIではモデルIDをclaude-fable-5-1からclaude-fable-5-2に替えます。APIの既定は5.1も5.2もhighなので、IDだけ替えると点は上がる一方で費用は増えます。費用を抑えたいなら、mediumも同じテストで比べてください。Claudeアプリではモデル選択で「Fable 5.2」を選び、表示されるMediumのままで十分です。2026年11月10日にアプリで同じ6問を両バージョンに解かせたところ、12件すべて合格し、合計時間は76.4秒と76.3秒でほぼ同じでした。
例外は、messagesを自前で組み立てているAPIのコードです。2026年8月31日より前に作成したアカウントでは、5.1で通っていたリクエストが5.2で400エラーになることがあり、computer_20251124やadvisorツールを使う構成も書き換えが必要です。本番を切り替える前に、下のチェックリストを通してください。5.1は「レガシー」表示になりましたが、廃止されたわけではなく引き続き呼び出せます。
Fable 5.1 vs 5.2の比較表:変わった点と変わらない点
変わったのは料金、Claude Codeでの既定effort、APIの細部(レート制限の枠、思考ブロックの扱い、computer use、advisor)、そしてfast modeへの対応です。コンテキスト長、最大出力、APIの既定effort、トークナイザー、思考の仕組みといった使い方の土台は変わっていません。AnthropicもFable 5.2の移行ガイドで「移行はほぼそのまま置き換えるだけ(mostly drop-in)」としています。
| 項目 | Fable 5.1 | Fable 5.2 |
|---|---|---|
| モデルID | claude-fable-5-1 | claude-fable-5-2(Amazon Bedrockはanthropic.claude-fable-5-2) |
| 公開日と位置づけ | 2026年9月1日公開、現在は「レガシー」 | 2026年11月9日公開、現行版 |
| 入力/出力 | $10/$50 | $8/$40 |
| キャッシュ書き込み(5分/1時間) | $12.50/$20 | $10/$16 |
| キャッシュ読み取り | $0.25 | $0.20 |
| Batch API(入力/出力) | $5/$25 | $4/$20 |
| Claude Codeの既定effort | high | medium |
| APIのレート制限 | Fable 5と共通の枠 | 5.2だけの別枠 |
| fast mode | fast modeの対応一覧に記載なし | speed: "fast"で出力最大2.5倍、$16/$80 |
料金は100万トークンあたりの米ドル定価で、Fable 5.2の新機能ページとFable 5.1のモデルページによります(2026年11月10日時点)。5.1のBatch料金は定価の半額として計算した値です。キャッシュ読み取りはどちらも基本入力単価の0.025倍で、比率は変わっていません。キャッシュの損益分岐の考え方は「Claudeプロンプトキャッシュの使い方:5分/1時間の損益分岐と実測値」で扱っています。
変わらない点は、100万トークンのコンテキスト、1リクエスト最大128Kトークンの出力、テキストと画像の入力、常に有効なadaptive thinking(思考を無効にする指定やbudget_tokensは400エラー)、APIの既定effort highと5段階のeffort(low、medium、high、xhigh、max)、信頼できる知識の期限(2026年6月)です。アシスタントのプリフィルができないこと、tool_choiceでanyやtoolを指定してツールを強制すると400になること、30日間のデータ保持が必要なこと、Priority Tierに対応しないことも同じです。トークナイザーもOpus 4.7から使われているものと同じなので、同じ文章は同じトークン数で数えられます。次の節のトークン数の差は、そのままモデルが考えて書いた量の差です。
Fable 5.1は2026年11月10日時点で「レガシー」と表示され、モデルページには「引き続き利用できるが、Fable 5.2への移行を検討すべき」と書かれています。Anthropicのモデル廃止予定の一覧では、提供終了は5.1が早くても2027年9月1日、5.2が早くても2027年11月9日です。したがって、APIのコード修正が済むまで5.1に残すことはできます。
安全対策の面では、Anthropicによると5.2は5.1と同じ強さのまま、claude.ai、Claude Code、Coworkでの初期テストで不要なブロックが約55%減りました。同じモデルで安全対策を緩めたClaude Mythos 5.2もありますが、Anthropicの認証プログラムを通った組織だけが使えます。
5.2は本当に安い?同じeffortで比べた1タスクの費用は−32%〜+104%
「2割安」が自分の設定でも成り立つのは、lowとmediumで使っている場合だけです。単価がすべて2割下がったので、5.2の使うトークンが5.1の1.25倍(1÷0.8)を超えなければ5.2のほうが安くなります。AAの計測では、high以上で5.2の出力トークンがこの線を超えています。
| effort | 指数 5.1→5.2 | 1タスクの費用 5.1→5.2 | 出力トークン(5.2÷5.1) | 1タスクの時間 5.1→5.2 |
|---|---|---|---|---|
low | 39→54 | $4.47→$3.10(−31%) | 0.95倍 | 7.4→6.5分 |
medium | 43→56 | $5.56→$3.80(−32%) | 0.89倍 | 9.7→8.3分 |
high | 47→62 | $7.54→$9.08(+20%) | 1.48倍 | 13.2→17.7分 |
xhigh | 50→62 | $10.85→$14.83(+37%) | 1.67倍 | 19.2→26.3分 |
max | 49→65 | $12.99→$26.54(+104%) | 2.32倍 | 22.7→44.1分 |
指数、費用、トークン数、時間はAAのFable 5.2とFable 5.1の比較ページと、effortごとの比較ページの値です(Intelligence Index v5.0.1、2026年11月10日時点)。増減率と倍率は、2026年11月10日にこれらの値から計算し直したものです。指数はAA独自の環境で10種類の評価を平均した点数で、1タスクの費用はAAの評価タスクを上の定価で実行した場合の値です。あなたの請求額そのものではありませんが、同じ条件で2つのバージョンを比べた方向は読み取れます。AAは公開翌日の値を予告なく修正することがあります。
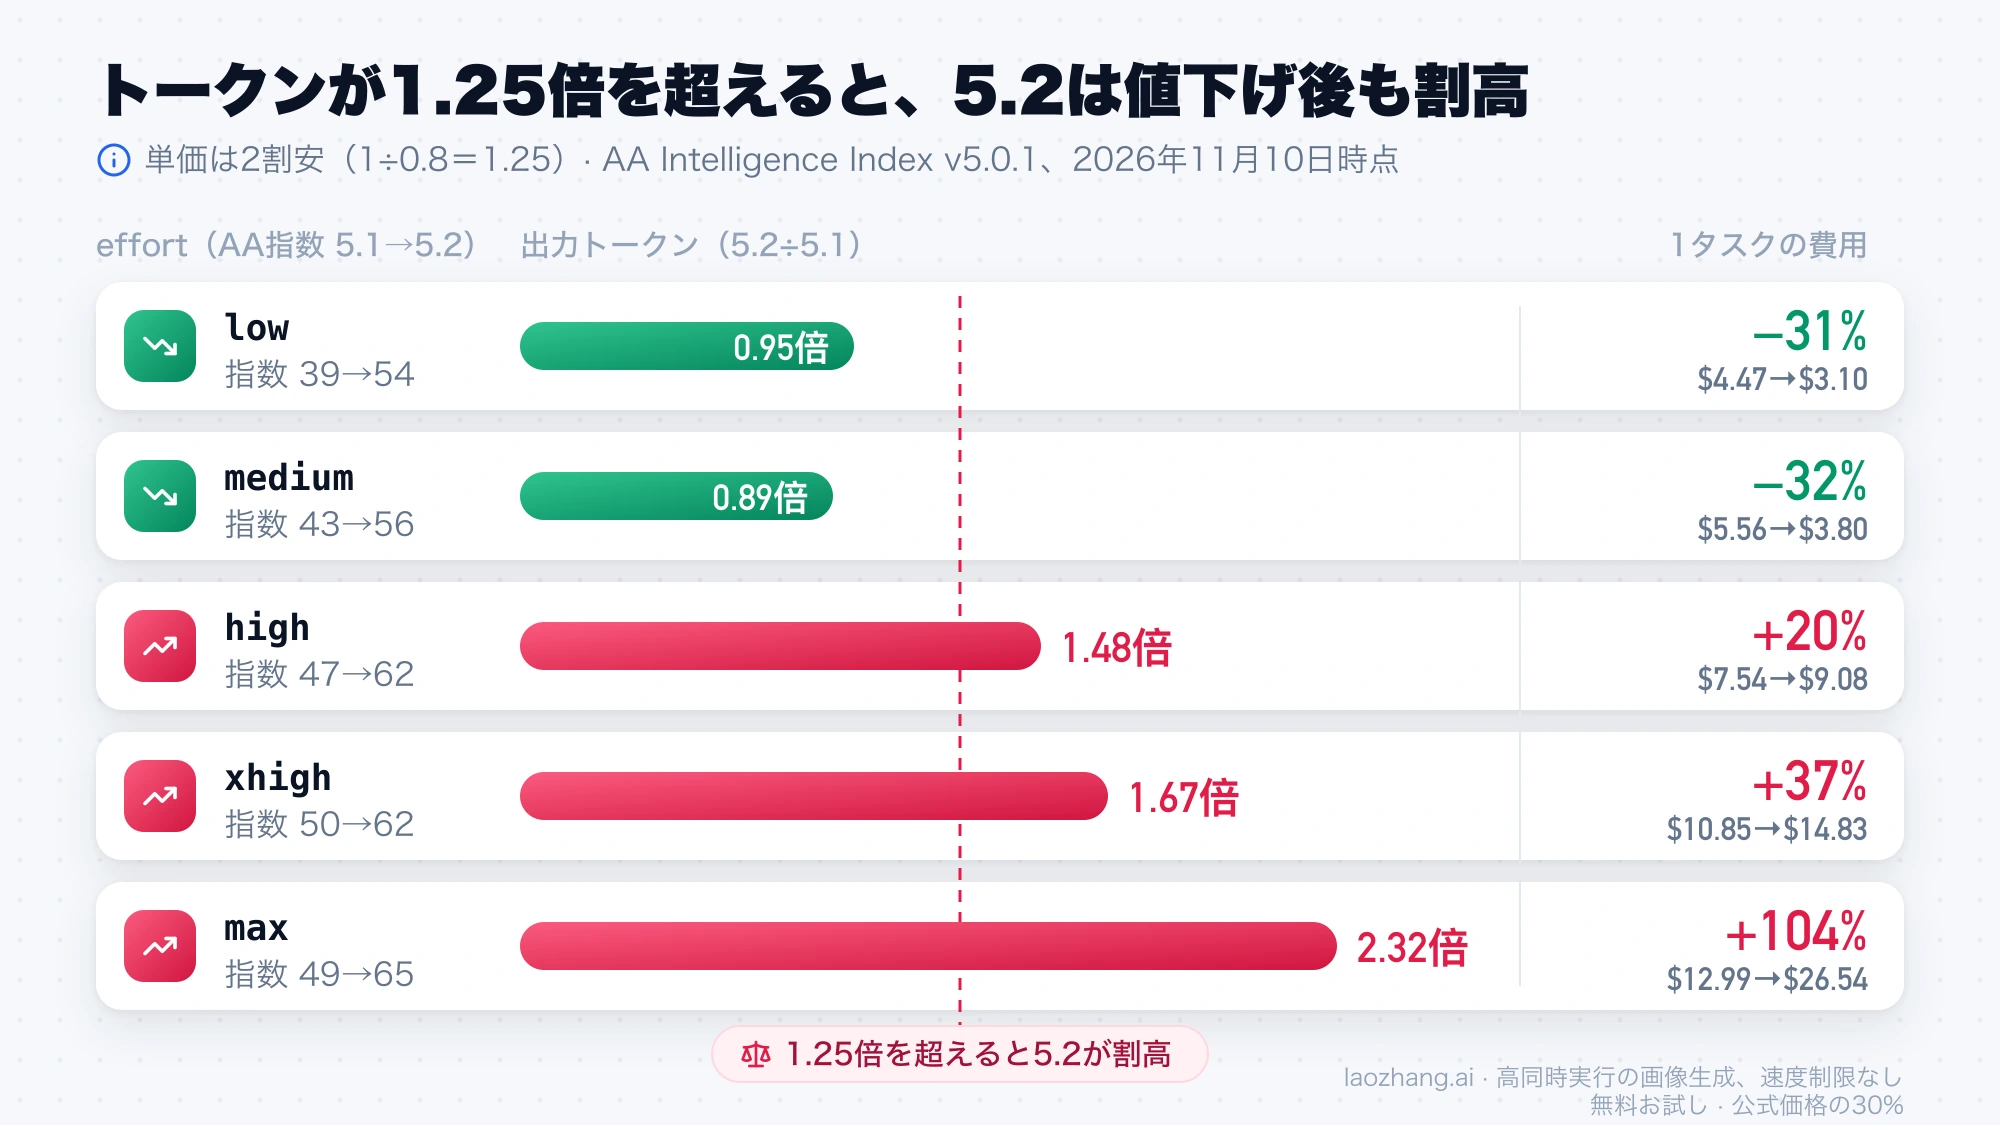
maxは費用が大きく増えるわりに、点はほとんど伸びません。5.1ではmax(49)が自分のxhigh(50)を下回り、5.2でもmaxはhighより3点高いだけで、費用は約2.9倍($26.54÷$9.08)、時間は約2.5倍かかります。maxでは1タスクあたりの推論トークンが5.1の71.4kに対して5.2は193kまで増えていました。AAが測ったコーディング評価FrontierCode 2.0では、5.2の最高点はhighの49.1%で、maxは48.8%です。Anthropic自身もeffortの解説で、能力の向上の大半はhighで得られ、maxは上限を測るときや時間とトークンを気にしない稀な作業向けだとしています。
5.1でxhighやmaxを使っていた人は、切り替えと同時にeffortを下げると費用が大きく下がります。5.1の最高点であるxhigh(50点、$10.85、19.2分)に対して、5.2のlowは54点、$3.10(−71%)、6.5分です。品質を落としたくないなら5.2のhighでも62点、$9.08(−16%)で、5.1のxhighより安く済みます。逆に、5.1と同じxhighやmaxをそのまま5.2で使うと、点は上がりますが費用も時間も増えます。
切り替え後のeffort:Claude Codeはmedium、APIはhighとmediumを比較
どのeffortを選ぶべきかは、入口ごとに既定値が違うため、APIとClaude Codeとアプリで答えが分かれます。Claude Codeは既定がhighからmediumに下がるので、何もしなくても費用は下がり、点も上がります。APIは両方ともhighなので、モデルIDだけ替えると点は上がりますが費用も増えます。
| 入口 | 5.1の既定 | 5.2の既定 | 既定同士のAA指数 | 1タスクの費用(AA) | 切り替え後の目安 |
|---|---|---|---|---|---|
| Claude Code | high | medium | 47→56 | $7.54→$3.80(−50%) | mediumのまま。足りない作業だけhigh |
| Claude API | high | high | 47→62 | $7.54→$9.08(+20%) | highで品質を確かめ、mediumも比べる |
| Claudeアプリ | Medium | Medium | 43→56 | $5.56→$3.80(−32%) | Fable 5.2を選び、Mediumのまま |
既定値はClaude Codeのモデル設定の文書とAnthropicのeffortの解説によります。アプリの既定は、2026年11月10日にUltraプランのアカウントで両バージョンを選んだとき、どちらも「Medium」と表示されたことに基づきます。指数と費用は前の節と同じAAの値(v5.0.1、2026年11月10日時点)です。
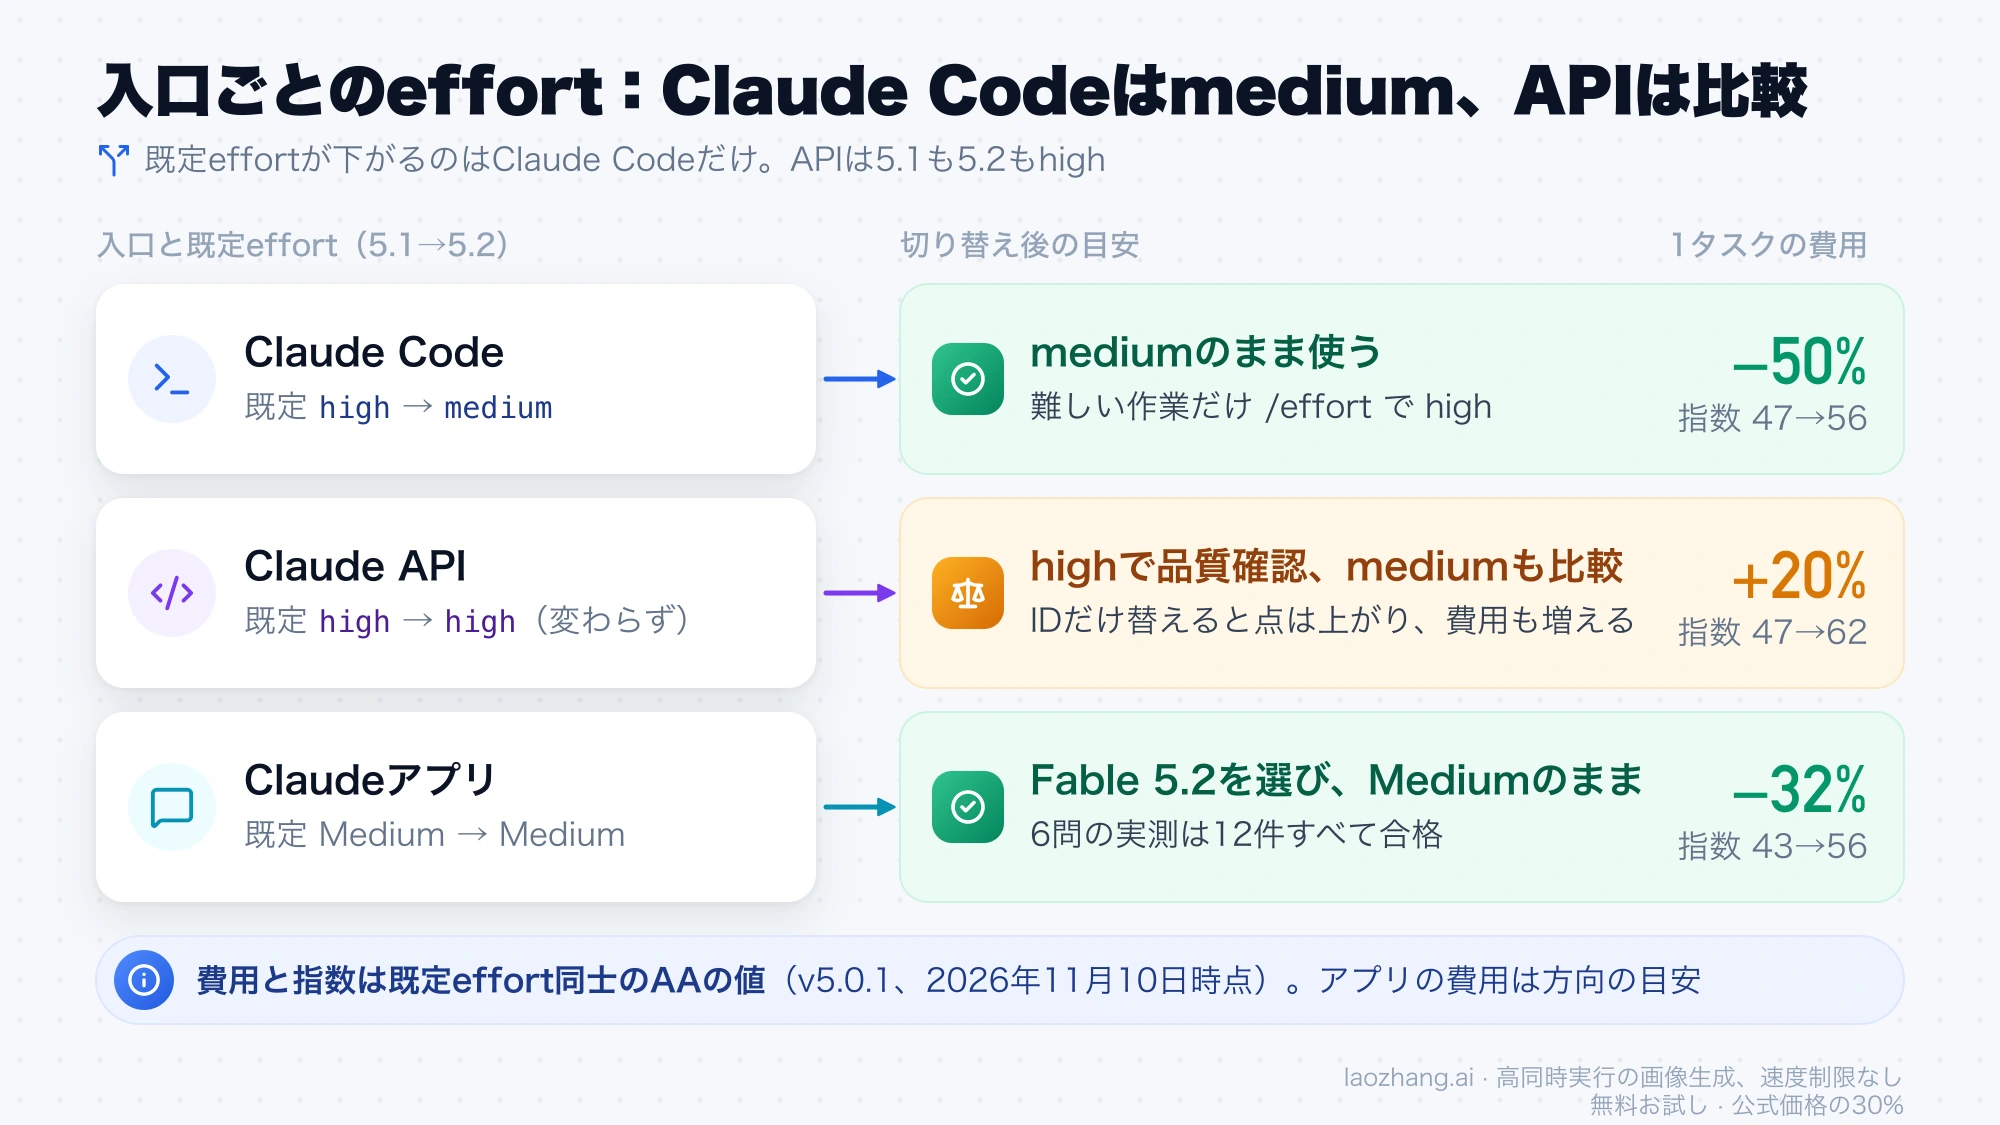
APIでは、Anthropicは5.2を既定のhighから始め、自分の評価で品質が保てるならmediumやlowに下げ、計測して向上が確かめられた最難関の長い作業だけxhighに上げるよう勧めています。表のClaude Codeの行が示すとおり、5.2のmediumは5.1のhighより点が高く、費用は安く済みます。そのため、5.1のhighの品質で満足していたなら、mediumは最初に試す価値のある候補です。
Claude Codeでは、既定のmediumがAAの値で5.1の既定より高く安いので、まずはそのまま使い、難しい調査や設計の作業だけ/effortでhighに上げるのが無理のない使い方です。xhighとmaxでは、5.2が自分の作業を見直すためにサブエージェントを起動する様子がAnthropicのテストで見られ、サブエージェントはセッション費用の大きな部分を占めることがあります。effortの設定方法と、設定した値が戻ってしまう理由は「Claude Code の effort とは:既定値・おすすめ・設定が効かない原因」にまとめています。
アプリはトークン単位の請求ではなくプランの使用上限で動くので、表の費用はあくまで方向の目安です。アプリでMediumを使う限り、AAの値では5.2のほうが出力トークンが少なく(0.89倍)、指数も高くなっています。
Claude Codeに保存したclaude-fable-5-1は自動でfableに移る
ProとMaxのプランでは、ユーザー設定に保存したclaude-fable-5-1は、Claude Code v2.1.321以降を初めて起動したときにfableエイリアスへ移り、Fable 5.2で動くようになります。ターミナルでは起動時のモデル表示に一度だけ(auto-updated)と出ることがあります。TeamとEnterpriseでは組織の設定を待つので、移るのが後の起動になることも、移らないこともあり、(auto-updated)の表示も出ません。Consoleのアカウント、他社のプロバイダー経由、プロジェクト・ローカル・管理者の設定に書いたモデルはclaude-fable-5-1のまま残ります(Claude Codeのモデル設定の文書、2026年11月10日時点)。
移ったあとのセッションは、5.2用のeffortを設定していなければ5.2の既定mediumで始まります。5.1のときにユーザー設定ファイルの最上位のeffortLevelでhighなどを指定していても、5.2には効きません。この古い書き方はOpus 5.5とそれ以降に出たモデルには適用されないためで、5.2でhighを使い続けたいなら、/effortか/modelの選択画面で5.2に対して選び直します。
いま動いているモデルは/modelで確かめられます。5.2を明示するなら/model fableかclaude --model fableを使い、5.1に残るなら/model claude-fable-5-1かclaude --model claude-fable-5-1のようにIDで指定します。Claude apps gatewayのセッションではfableがFable 5を指すので、5.2は/model claude-fable-5-2で選びます。5.2にはClaude Code v2.1.321以降が必要なので、古い場合はclaude updateで更新してください。
速くなった?公式の「最大30%」とAAの出力速度
出力を生成する速さは上がっていますが、1タスクが早く終わるかどうかはeffortで決まります。AnthropicはFable 5.2の発表で、出力の生成が5.1より「最大30%速い」としています。これは速さの上限を示した数字で、平均ではなく、値下げ幅(20%)とも別の話です。
AAの計測(2026年11月10日時点)では、同じeffortでの出力速度の向上はlowからmaxまで+7%、+4%、+10%、+23%、+18%で、30%には届いていません。それでもlowとmediumでは1タスクの時間が12%と14%縮みました。一方、high・xhigh・maxでは書く量が1.5〜2.3倍に増えるため、1タスクの時間は34%、37%、94%延びています。Anthropicのモデル一覧も、5.2の相対的な待ち時間を「Moderate」としています(5.1は2026年9月24日時点で「Slower」でした)。
APIで待ち時間を最優先するなら、5.2にはfast mode(speed: "fast"、出力最大2.5倍、100万トークンあたり$16/$80)があります。短い質問では差がほとんど出ないことは、次の節の実測で確かめました。
2026年11月10日、Claudeアプリで同じ6問を比べた結果
2026年11月10日の午前(日本時間で9時20分〜9時50分ごろ)、Claudeアプリ(claude.ai)でFable 5.1とFable 5.2に同じ6問を1回ずつ送り、どちらも既定のMediumで比べました。使ったのはUltraプランの1アカウントで、問題ごとに新しいシークレットチャットを開き、送信してから回答の表示が終わるまでの時間を計りました。コードを書く3問は、回答より前に用意した隠しテストで採点しています。
| 問題 | 5.1の時間 | 5.2の時間 | 結果(両バージョン) |
|---|---|---|---|
| 料金計算の文章題 | 6.0秒 | 4.5秒 | どちらも正解 |
| 桁の和の個数を数える(コードなし) | 11.4秒 | 6.0秒 | どちらも正解 |
| 実在しない関数2つを含む標準ライブラリの質問 | 2.6秒 | 1.6秒 | どちらも「存在しない」と回答 |
| CSVの1行を分割するプログラム | 6.2秒 | 3.8秒 | 隠しテスト16/16 |
| 数式を計算するプログラム | 10.0秒 | 25.4秒 | 隠しテスト25/25 |
| semverの範囲を判定するプログラム | 40.2秒 | 35.0秒 | 隠しテスト36/36 |
| 合計 | 76.4秒 | 76.3秒 | 12件すべて合格 |
5.2は6問中5問で13〜47%早く終わり、数式のプログラムだけ2.5倍の時間がかかりました。その問題では5.2が31%長いプログラム(3,344文字、5.1は2,558文字)を書いており、semverの問題でもコードは48%長くなっています。文章で答える問題では、5.2の回答は同じか短めでした。正答率では2つのバージョンに差がつきませんでした。
言えるのは、短く条件のはっきりした質問なら、アプリでFable 5.2のMediumに切り替えても正しさは落ちず、待ち時間もほぼ変わらない、という点です。1問1回、1アカウント、1回の午前の計測で、時間には通信やサービスの混み具合も含まれるため、1問ごとの差を速度の差とは読めません。アプリではトークン数が見えないので費用や使用上限の消費についても分からず、長いエージェント作業、API、Claude Codeについてはこの結果から何も言えません。その部分は前の節のAAの値を目安にしてください。アプリのモデル選択では、Fable 5.2はメインの一覧にあり、Fable 5.1は追加のモデル一覧(英語表示では「More models」)に入っています。
API切り替え前のチェックリスト:壊れうる4点と挙動の変化
Claude Code、claude.ai、Claude Agent SDK、Claude Managed Agentsにリクエストの組み立てを任せている場合、Anthropicは変更が要らないとしています。確かめる必要があるのは、Messages APIでmessagesを自前で組み立てているコードです。以下はAnthropicの移行ガイドと新機能ページに書かれている内容で、上から順に当てはまるものを確認します。
- モデルIDを
claude-fable-5-2に替え(Amazon Bedrockではanthropic.claude-fable-5-2)、本番のトラフィックを移す前にレート制限を確かめます。5.2の枠は、5.1とFable 5が共有する枠とは別です。 system、tools、前のメッセージを途中で書き換えるコードは、prefix checkで止まります。書き換えたあとに、それより後のターンで5.2が出した思考ブロック(thinking block)を送り返すと400エラーになり、同じリクエストを再送しても解消しません。5.1でこの検査が既定で有効だったのは2026年8月31日以降に作成したアカウントだけなので、それより古いアカウントでは5.1で通っていたコードが5.2で失敗します。- 切り替え前に、ベータヘッダー
thinking-binding-controls-2026-08-01とthinking.block_binding.prefix_mismatch_behavior: "drop_block"を付けたセッションを流し、input_transformationsに出るprefix_binding_mismatchをすべて直します。5.1でこの検査に引っかかったことがないアカウントでも行います。本番で"drop_block"を使うのは修正までの応急処置にとどめます。捨てた分だけ考え直すので、出力トークンが増えることがあります。 - ルーターの切り替え、クライアント側のリトライ、拒否時のフォールバックで会話が5.2から5.1に戻る構成では、5.1は5.2の思考ブロックを読めず、APIがそのブロックを捨てます。リクエストは成功し、捨てた分は課金されませんが、それまでの推論なしで続けるため、戻った直後のターンは費用と待ち時間が増えることがあります。5.1から5.2へ進む向きでは推論が引き継がれます。保存した会話を別のアカウントから再生した場合も、5.2の思考ブロックは捨てられます。
- computer useで
computer_20251124を使っているなら、Amazon Bedrock以外では400invalid_request_errorになります。computer_toolset_20260801のツールセットに替え、エージェントのループもそれに合わせて直します。5.1はどちらも受け付けていました。 - ベータのadvisorツールで5.2を実行役にするなら、advisorの
modelをclaude-fable-5-2かclaude-mythos-5-2にします。5.1をadvisorにすると400です。advisorの変更はtoolsの書き換えにあたるので、新しい会話から適用します。 - 「考えずに直接答えて」のようなプロンプトの1行で思考を抑え、小さい
max_tokensに収めていたリクエストは見直します。5.2はmedium以上ではこの指示があっても考えるため、テキストを出す前にstop_reason: "max_tokens"で止まることがあります。max_tokensを上げるか、effortを下げます。 - 自分の評価セットでeffortごとの比較をやり直し、費用と待ち時間の基準値を取り直します。前の節のとおり、同じeffortでも費用の向きが変わるためです。
- ゲートウェイやクラウド経由で呼んでいるなら、モデル一覧に
claude-fable-5-2があるかを確かめます。ゲートウェイやクラウドはAnthropicより遅れて新モデルを追加することがあり、たとえばlaozhang.aiのゲートウェイがclaude-fable-5-2を追加したのはAnthropicの公開翌日の2026年11月10日で、同じ日の朝の時点ではモデル一覧(GET https://api.laozhang.ai/v1/models)にありませんでした(料金はAnthropicの定価と同じ100万トークンあたり$8/$40、従量課金)。モデルIDを替える前に、使っている経路の一覧で確かめてください。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
2と3でいう400エラーは、次のような文面です。
messages.5.content.0: Invalid `signature` in `thinking` block. The block is bound to a different conversation. Remove the block, or set `thinking.block_binding.prefix_mismatch_behavior` to "drop_block". That setting requires the `thinking-binding-controls-2026-08-01` value in the `anthropic-beta` header.コードの書き換え自体は、Claude Codeで/claude-api migrate this project to claude-fable-5-2と頼むこともできます。コードを変えなくても現れる挙動の違いもあります。Anthropicによると、長い多段階の作業で5.2は残りの作業を列挙してターンを終えることがあり(lowとmediumで多い)、ツール呼び出しが続く間はユーザー向けのテキストが少なくなりがちで、文体のルールにはかなり忠実に従います。5.1向けに書いたシステムプロンプトは、この点を踏まえて読み直す価値があります。
プランの使用上限:Fable 5.2と5.1は同じルール
サブスクリプションでの扱いは、Fable 5.2、5.1、5で共通です。Anthropicのヘルプ記事「プランでのFableモデルの扱い」によると、Fableは有料プランだけで使え(Freeは対象外)、Max、Ultra、Teamのプレミアムシートでは週の使用上限の50%までをFableに使えます。ProとTeamの標準シートでは、最初のリクエストから使用クレジットで動きます。ただしFable 5.2の公開記念の特典として、2026年11月9日から11月16日午後11時59分(太平洋時間、日本時間では11月17日16時59分)までは、ProとTeamの標準シートでもすべてのFableモデルが週の上限の50%まで含まれ、同じ期限のFable上限リセットが1回付きます。Max、Ultra、プレミアムシートには契約期間に応じて1〜3回のリセットがあり、期限は2027年3月8日です。Anthropicは上限をトークン数や回数で公表しておらず、5.2が5.1より上限を速く減らすか遅く減らすかも示していません。
Anthropic公表のベンチマーク:FrontierCode 2.0は32.4%→49.1%
Anthropicの発表の比較表(それぞれ使える最高のeffort、安全対策を有効にした状態)では、大きく伸びたのはコーディングと長い自律作業です。FrontierCode 2.0は32.4%から49.1%、FrontierSWE v2は56.3%から69.9%、実際の業務を再現するRemote Labor Indexは17.9%から41.3%、RoboDojo Simは27.6%から64.9%に上がりました。一方、OSWorld 2.1(83.5%→89.3%)やAA-Briefcase v1.1(61.5%→66.1%)のように差が小さい評価もあります。どれもAnthropic自身の公表値で、第三者による再現ではありません。
Claude Fable 5.2と5.1のよくある質問
Fable 5.2ではなくOpus 5.5で足りますか?
Anthropicは2026年11月10日時点でも、コーディングや知識作業の多くはOpus 5.5から始め、effortを上げたOpusでも自分の評価の基準に届かないときにFable 5.2へ進むよう勧めています(Fable 5.2の新機能ページ)。5.2に移るなら「Claude Fable 5.2とOpus 5.5の違い:同じ正解数で費用1.86倍」が、5.1に残るなら「Claude Fable 5.1とOpus 5.5を比較:普段はどっちを使うべき?」が、Opusとの選び方を扱っています。
9月に話題になった「Fable 5.2」と同じモデルですか?
違います。2026年9月18〜20日ごろ、「Fable 5.1が5.2に切り替わった」という噂の投稿が出回り、10月初めには噂の名前が「Fable 5.5」に変わりましたが、どちらもAnthropicが公開したモデルではありません。正式なFable 5.2は2026年11月9日に公開されたものが最初で、APIのモデルIDはclaude-fable-5-2です。
参考資料10
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年11月10日。
参考資料10
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年11月10日。
- 1.Fable 5.2の移行ガイドplatform.claude.com/docs/en/models/fable-5-2/migration-guide
- 2.Fable 5.2の新機能ページplatform.claude.com/docs/en/models/fable-5-2/whats-new-fable-5-2
- 3.Fable 5.1のモデルページplatform.claude.com/docs/en/models/fable-5-1/overview
- 4.Anthropicのモデル廃止予定の一覧platform.claude.com/docs/en/about-claude/model-deprecations
- 5.AAのFable 5.2とFable 5.1の比較ページartificialanalysis.ai/models/comparisons/claude-fable-5-2-vs-claude-fable-5-1
- 6.effortの解説platform.claude.com/docs/en/build-with-claude/effort
- 7.Claude Codeのモデル設定の文書code.claude.com/docs/en/model-config
- 8.Fable 5.2の発表anthropic.com/claude-fable-and-mythos-5-2
- 9.プランでのFableモデルの扱いsupport.claude.com/en/articles/15424964
- 10.Fable 5.2の公開記念の特典support.claude.com/en/articles/17506494