GPT-6.2 Sol・6.1 Sol・Opus 5.5の違い:同じ12問の実測と使い分け
GPT-6.2 Solは6.1 Solと同単価でAA指数が2〜7点上。Codexの長い作業だけは6.1 Sol maxが上、Opus 5.5はさらに上で費用は約14倍。
目次
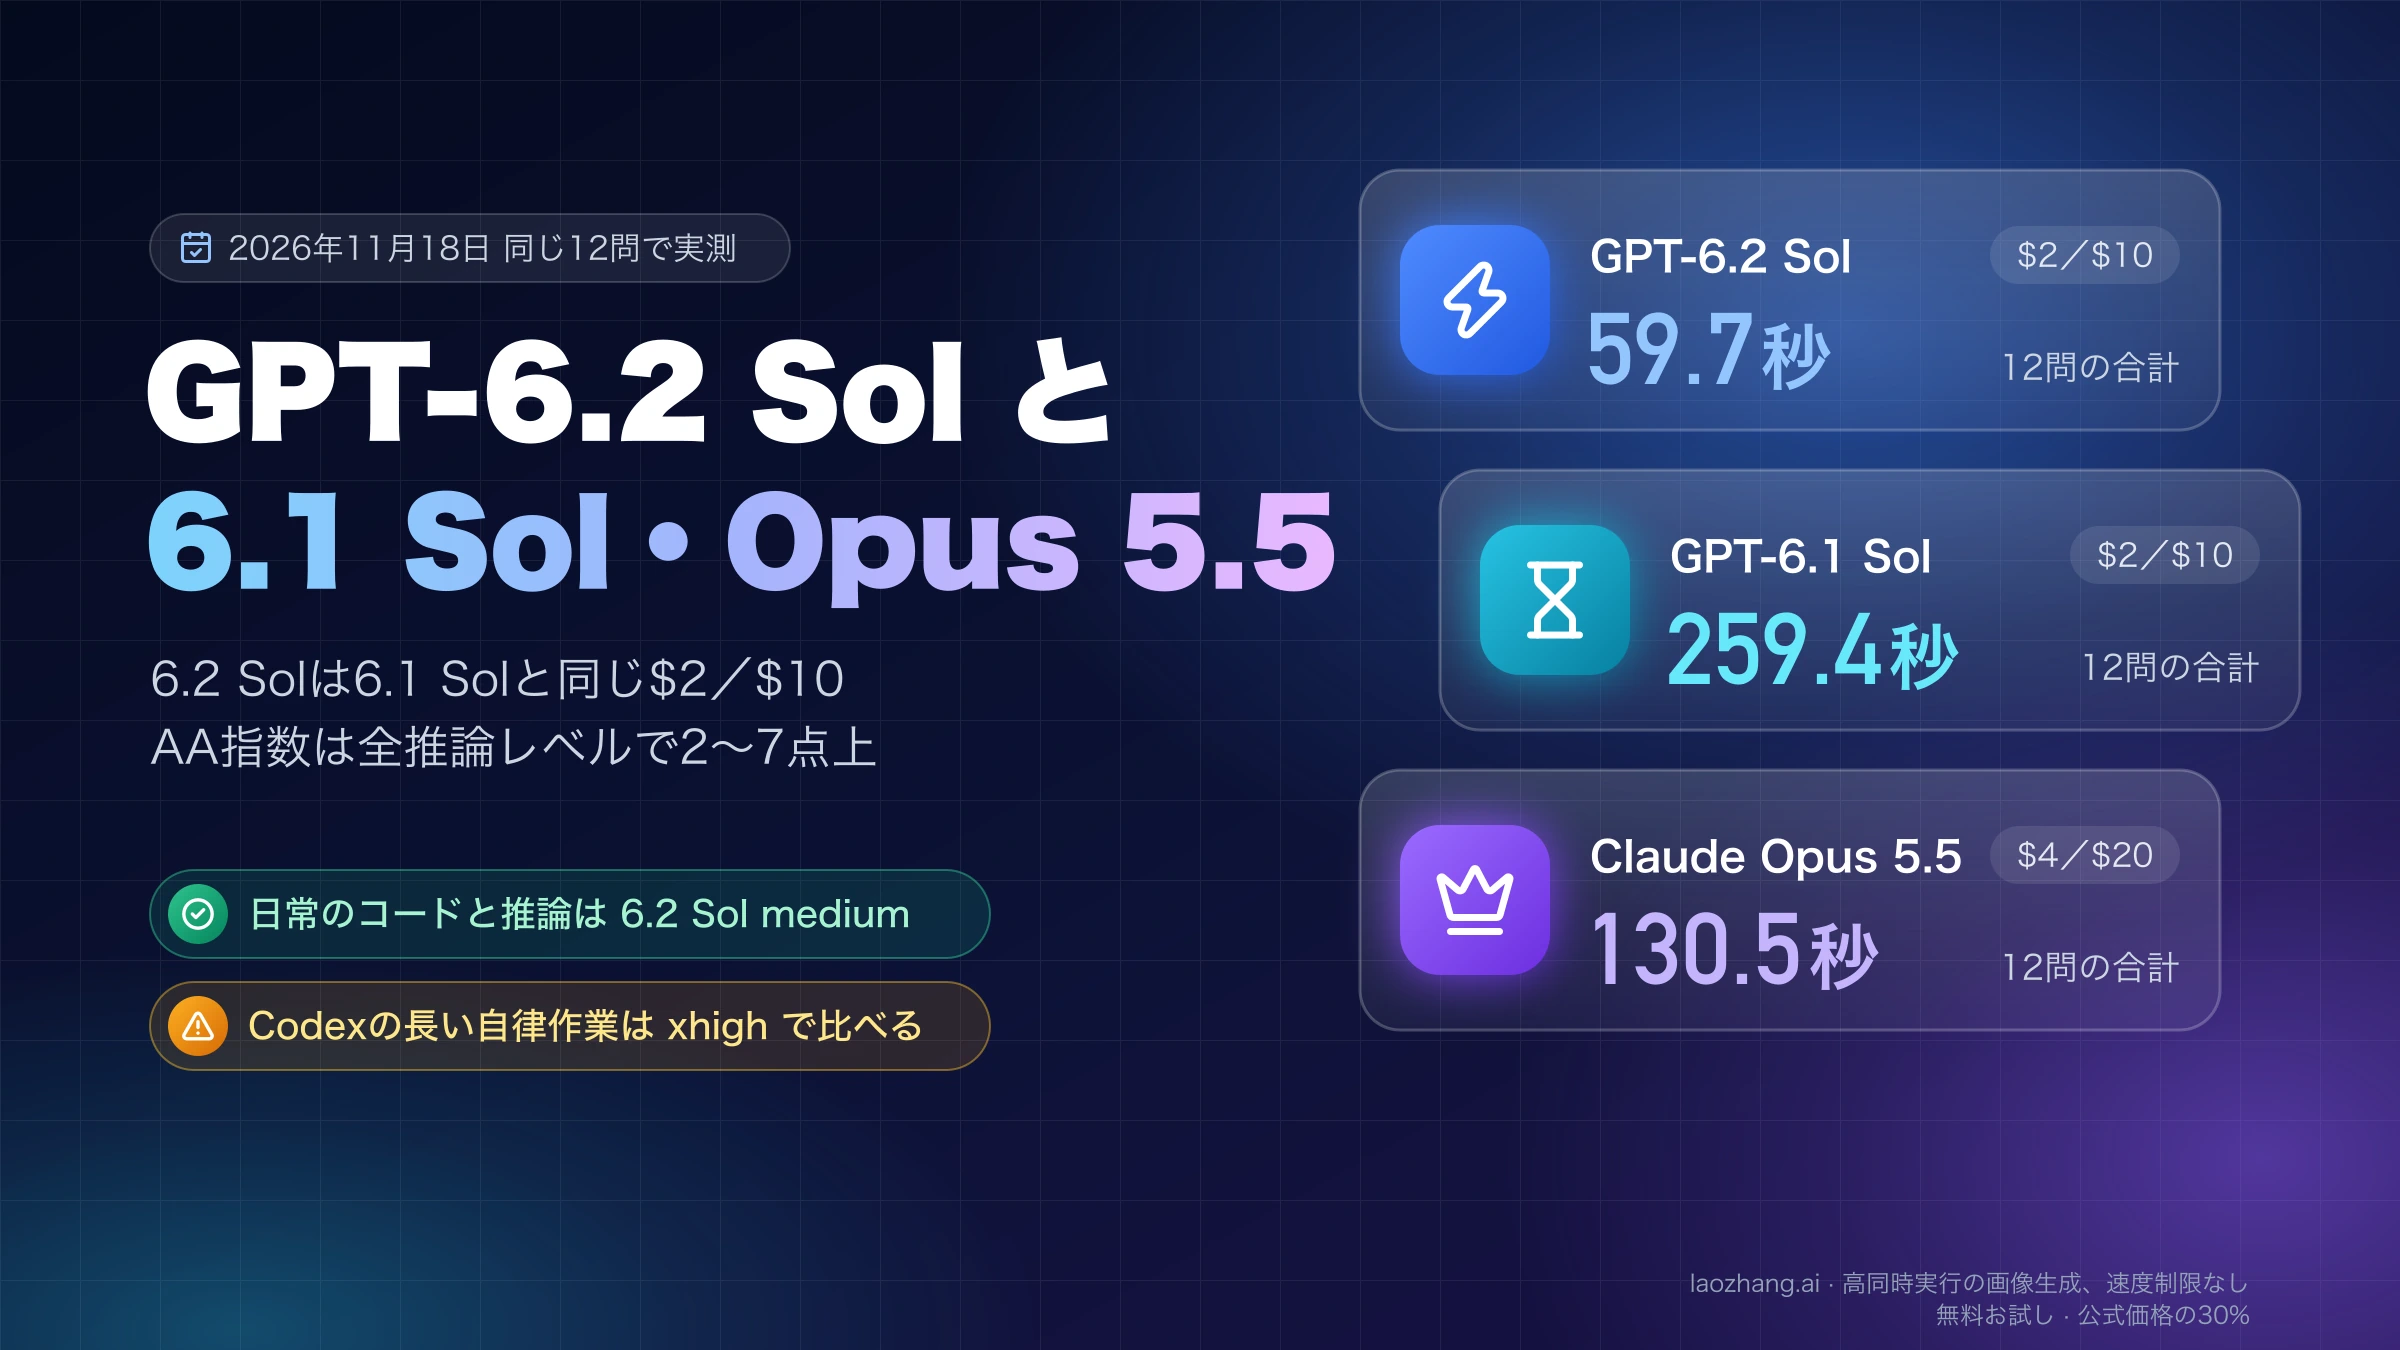
GPT-6.1 SolをAPIやCodexで使っているなら、モデル名をgpt-6.2-solに替え、推論レベル(effort)は既定のmediumから始めて構いません。2026年11月17日に公開されたGPT-6.2 Solは、100万トークンあたり入力$2・出力$10という単価が6.1 Solと同じで、第三者評価機関Artificial Analysis(AA)の総合指数では5段階すべての推論レベルで6.1 Solを2〜7点上回ります。2026年11月18日に同じ12問を解かせたテストでも両者とも全問正解で、6.2 Solの所要時間は6.1 Solの約4分の1でした。
例外は、Codexに数十分かけて自律的にコードを書かせる作業です。AAのコーディングエージェント指数では、Codexと組んだ6.1 Sol maxが52.2点なのに対し、6.2 Solは最高でもxhighの49.8点にとどまります(1タスクの費用は$1.51に対して$0.90)。この種の作業では6.2 Solをmaxではなくxhighで使い、自分のリポジトリで6.1 Solと結果を比べてから切り替えてください。
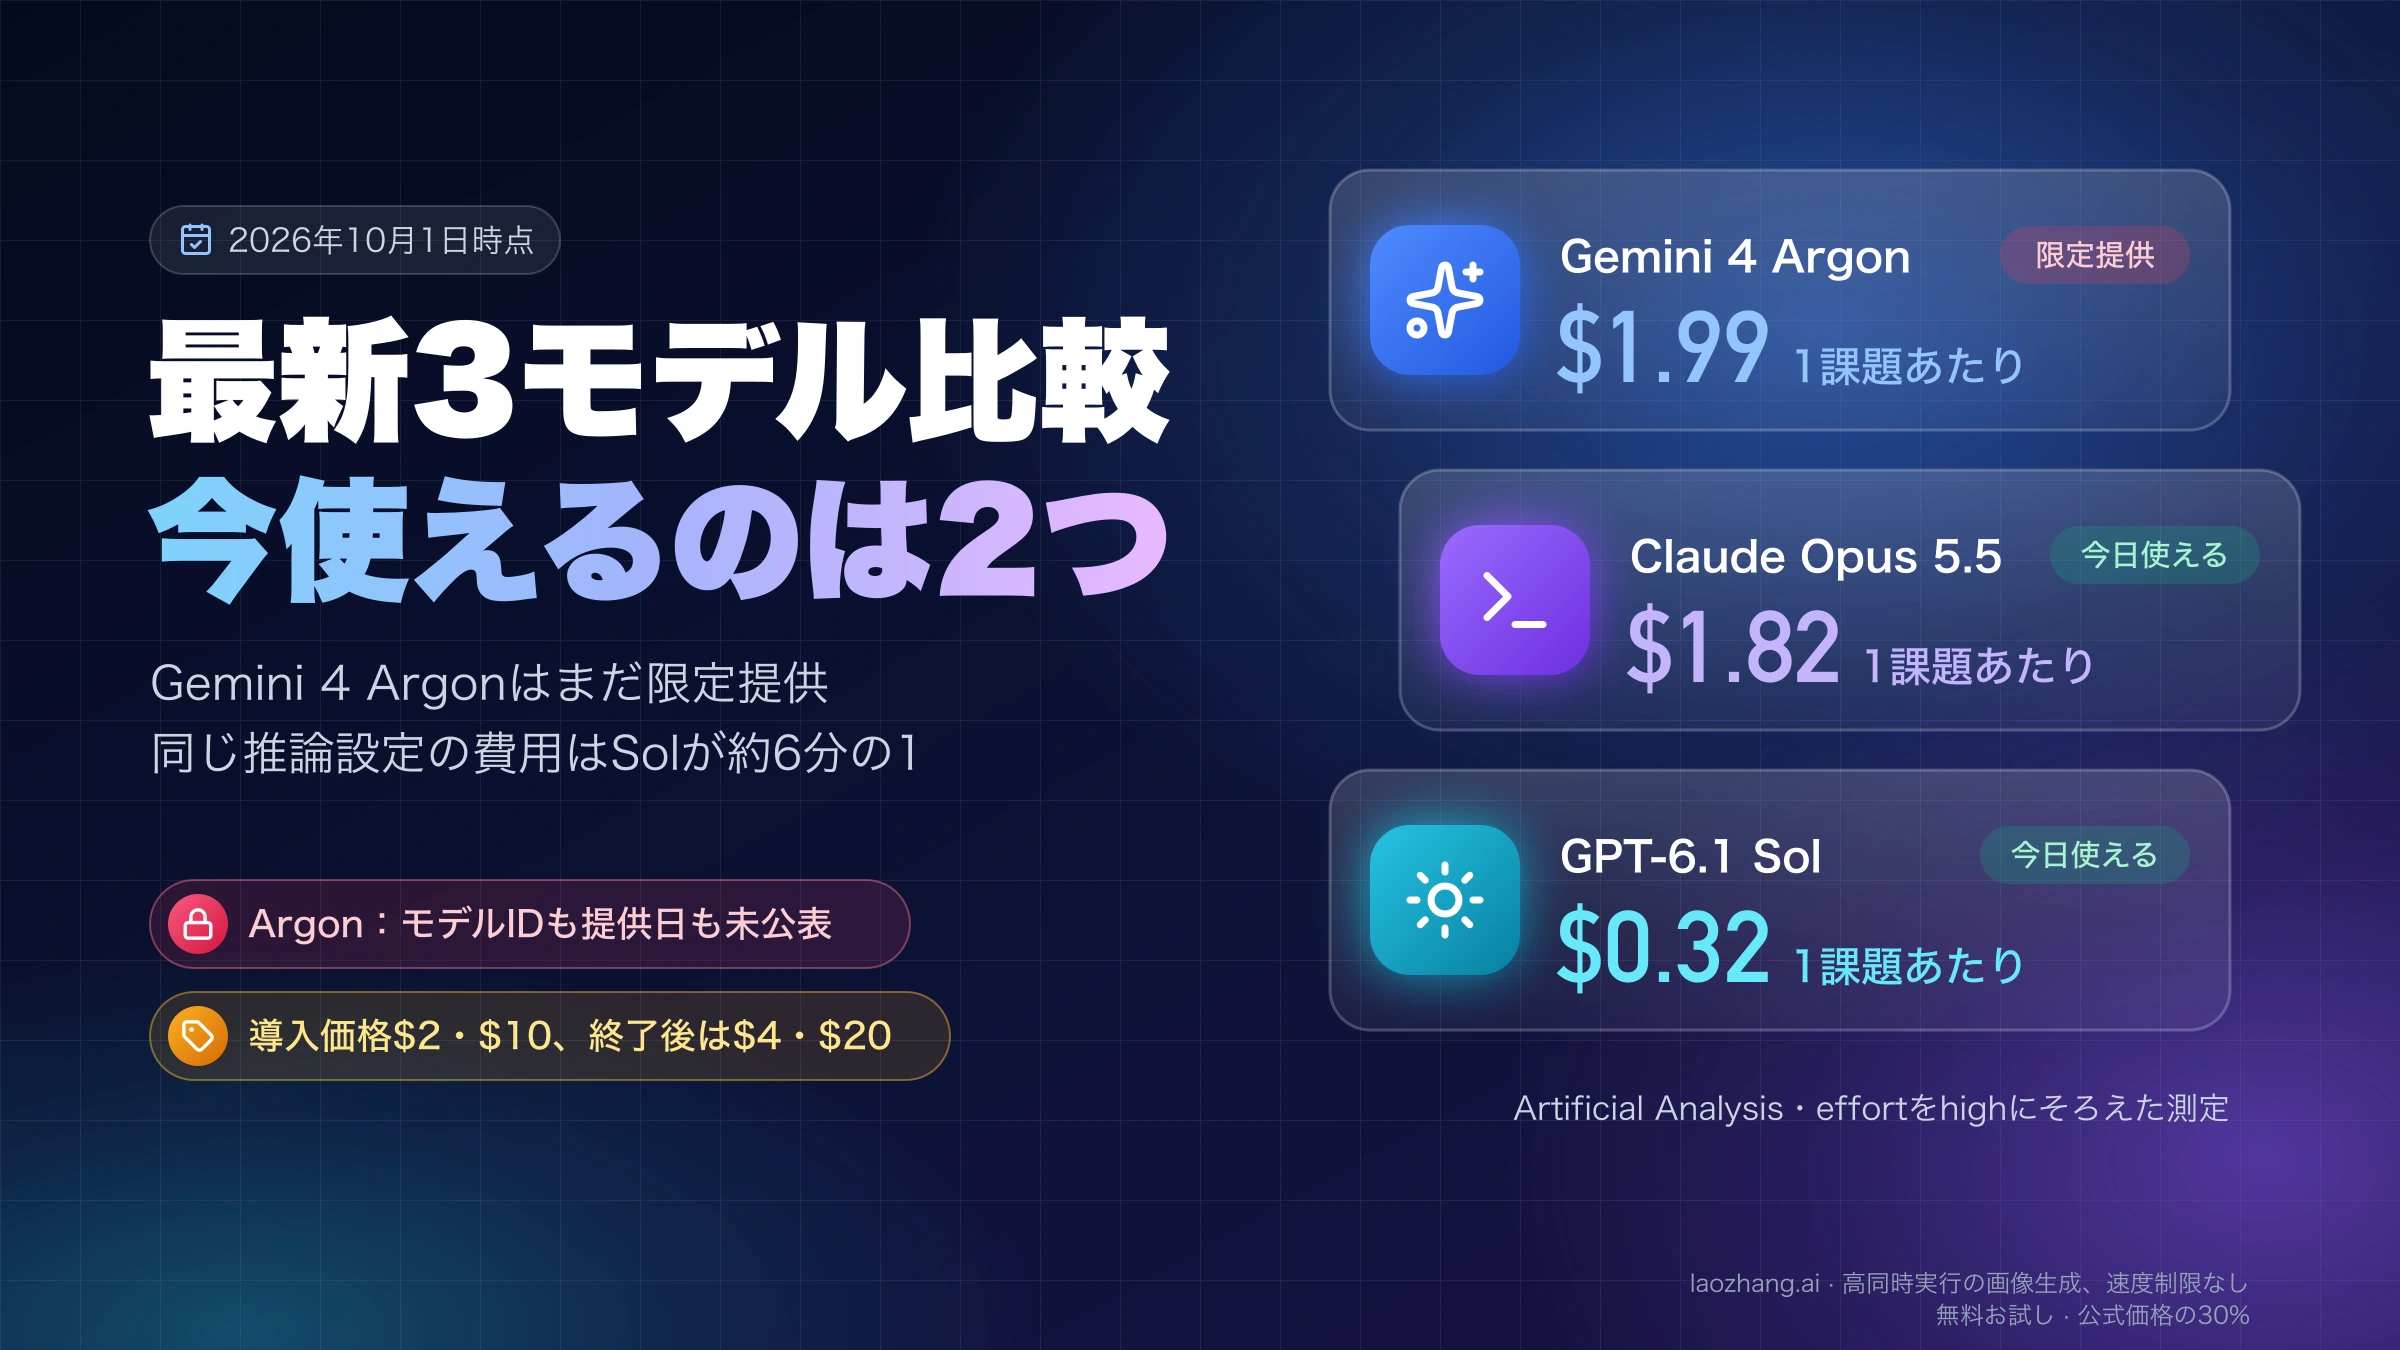
Claude Opus 5.5に任せている作業のうち、日常のコード修正、データ処理、単発の推論は6.2 Solに回せます。AA総合指数では6.2 Sol medium(53点、1タスク$0.41)がOpus 5.5 high(52点、$3.46)を上回るからです。Opus 5.5を残すのは、Claude Codeで長時間走らせるコーディング(同じエージェント指数で58.2点)と、Opus max(59点)の最高点そのものが必要な仕事で、エージェント指数で比べると1タスクの費用は6.2 Sol xhighの約14倍です。AAの数値は、6.2 SolとOpus 5.5が2026年11月18日時点、6.1 Solが11月4日時点(maxは11日)のものです。
3モデルの料金と仕様:6.2 Solと6.1 SolはStandardで同額
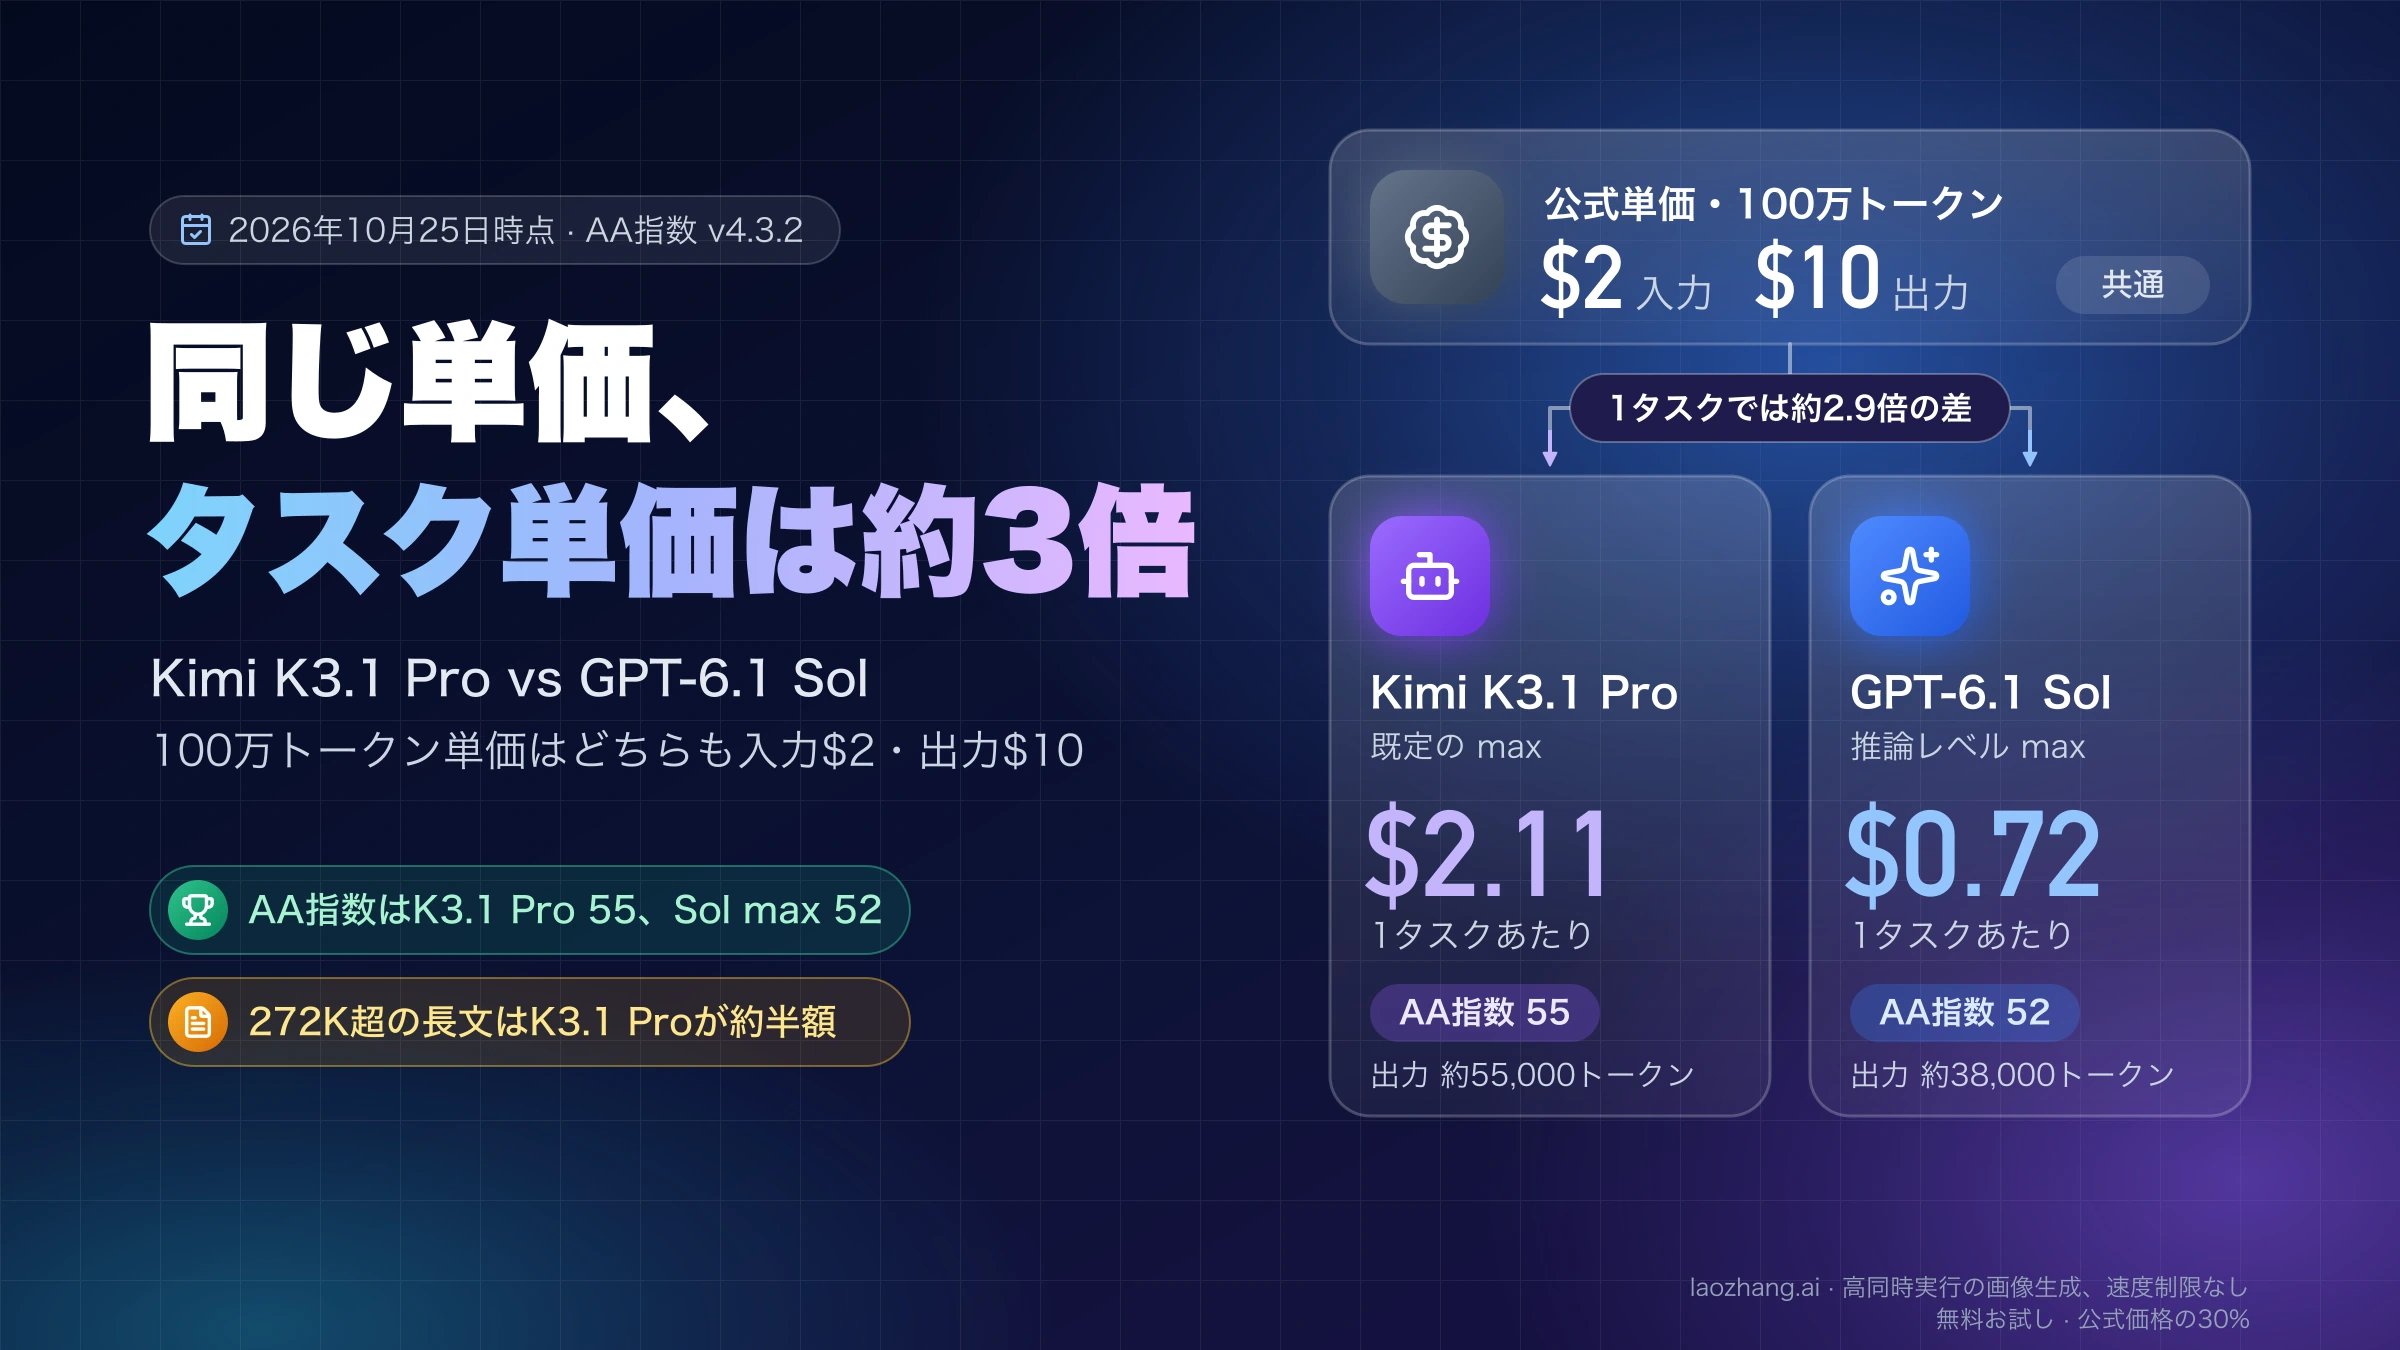
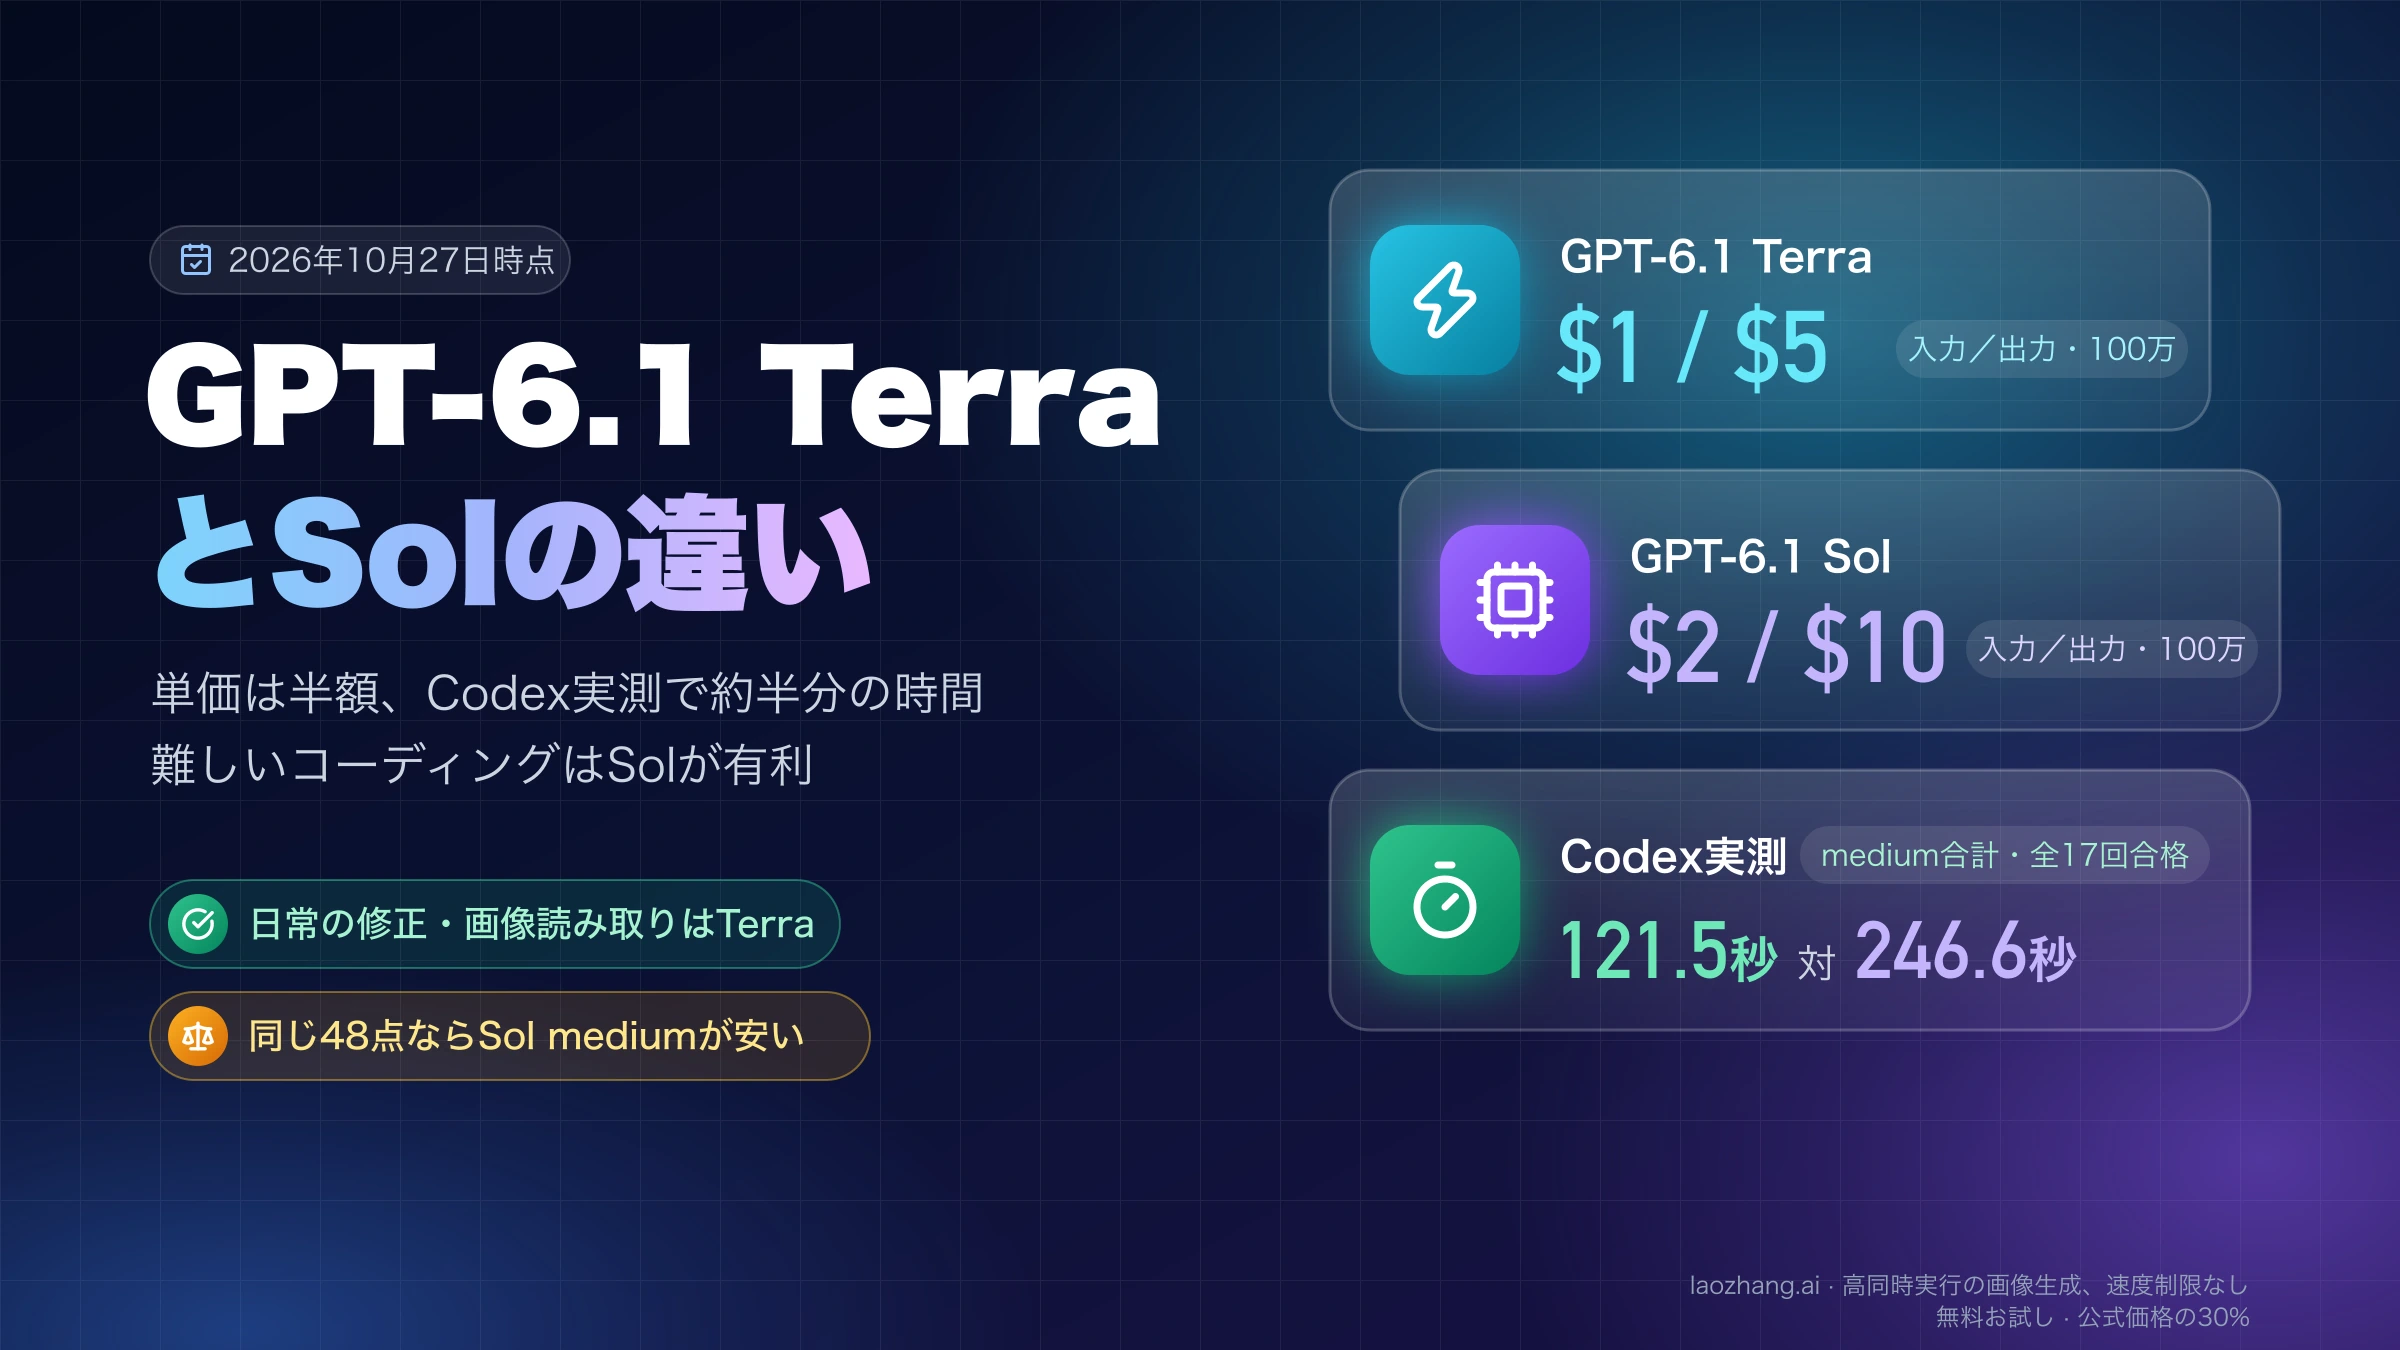
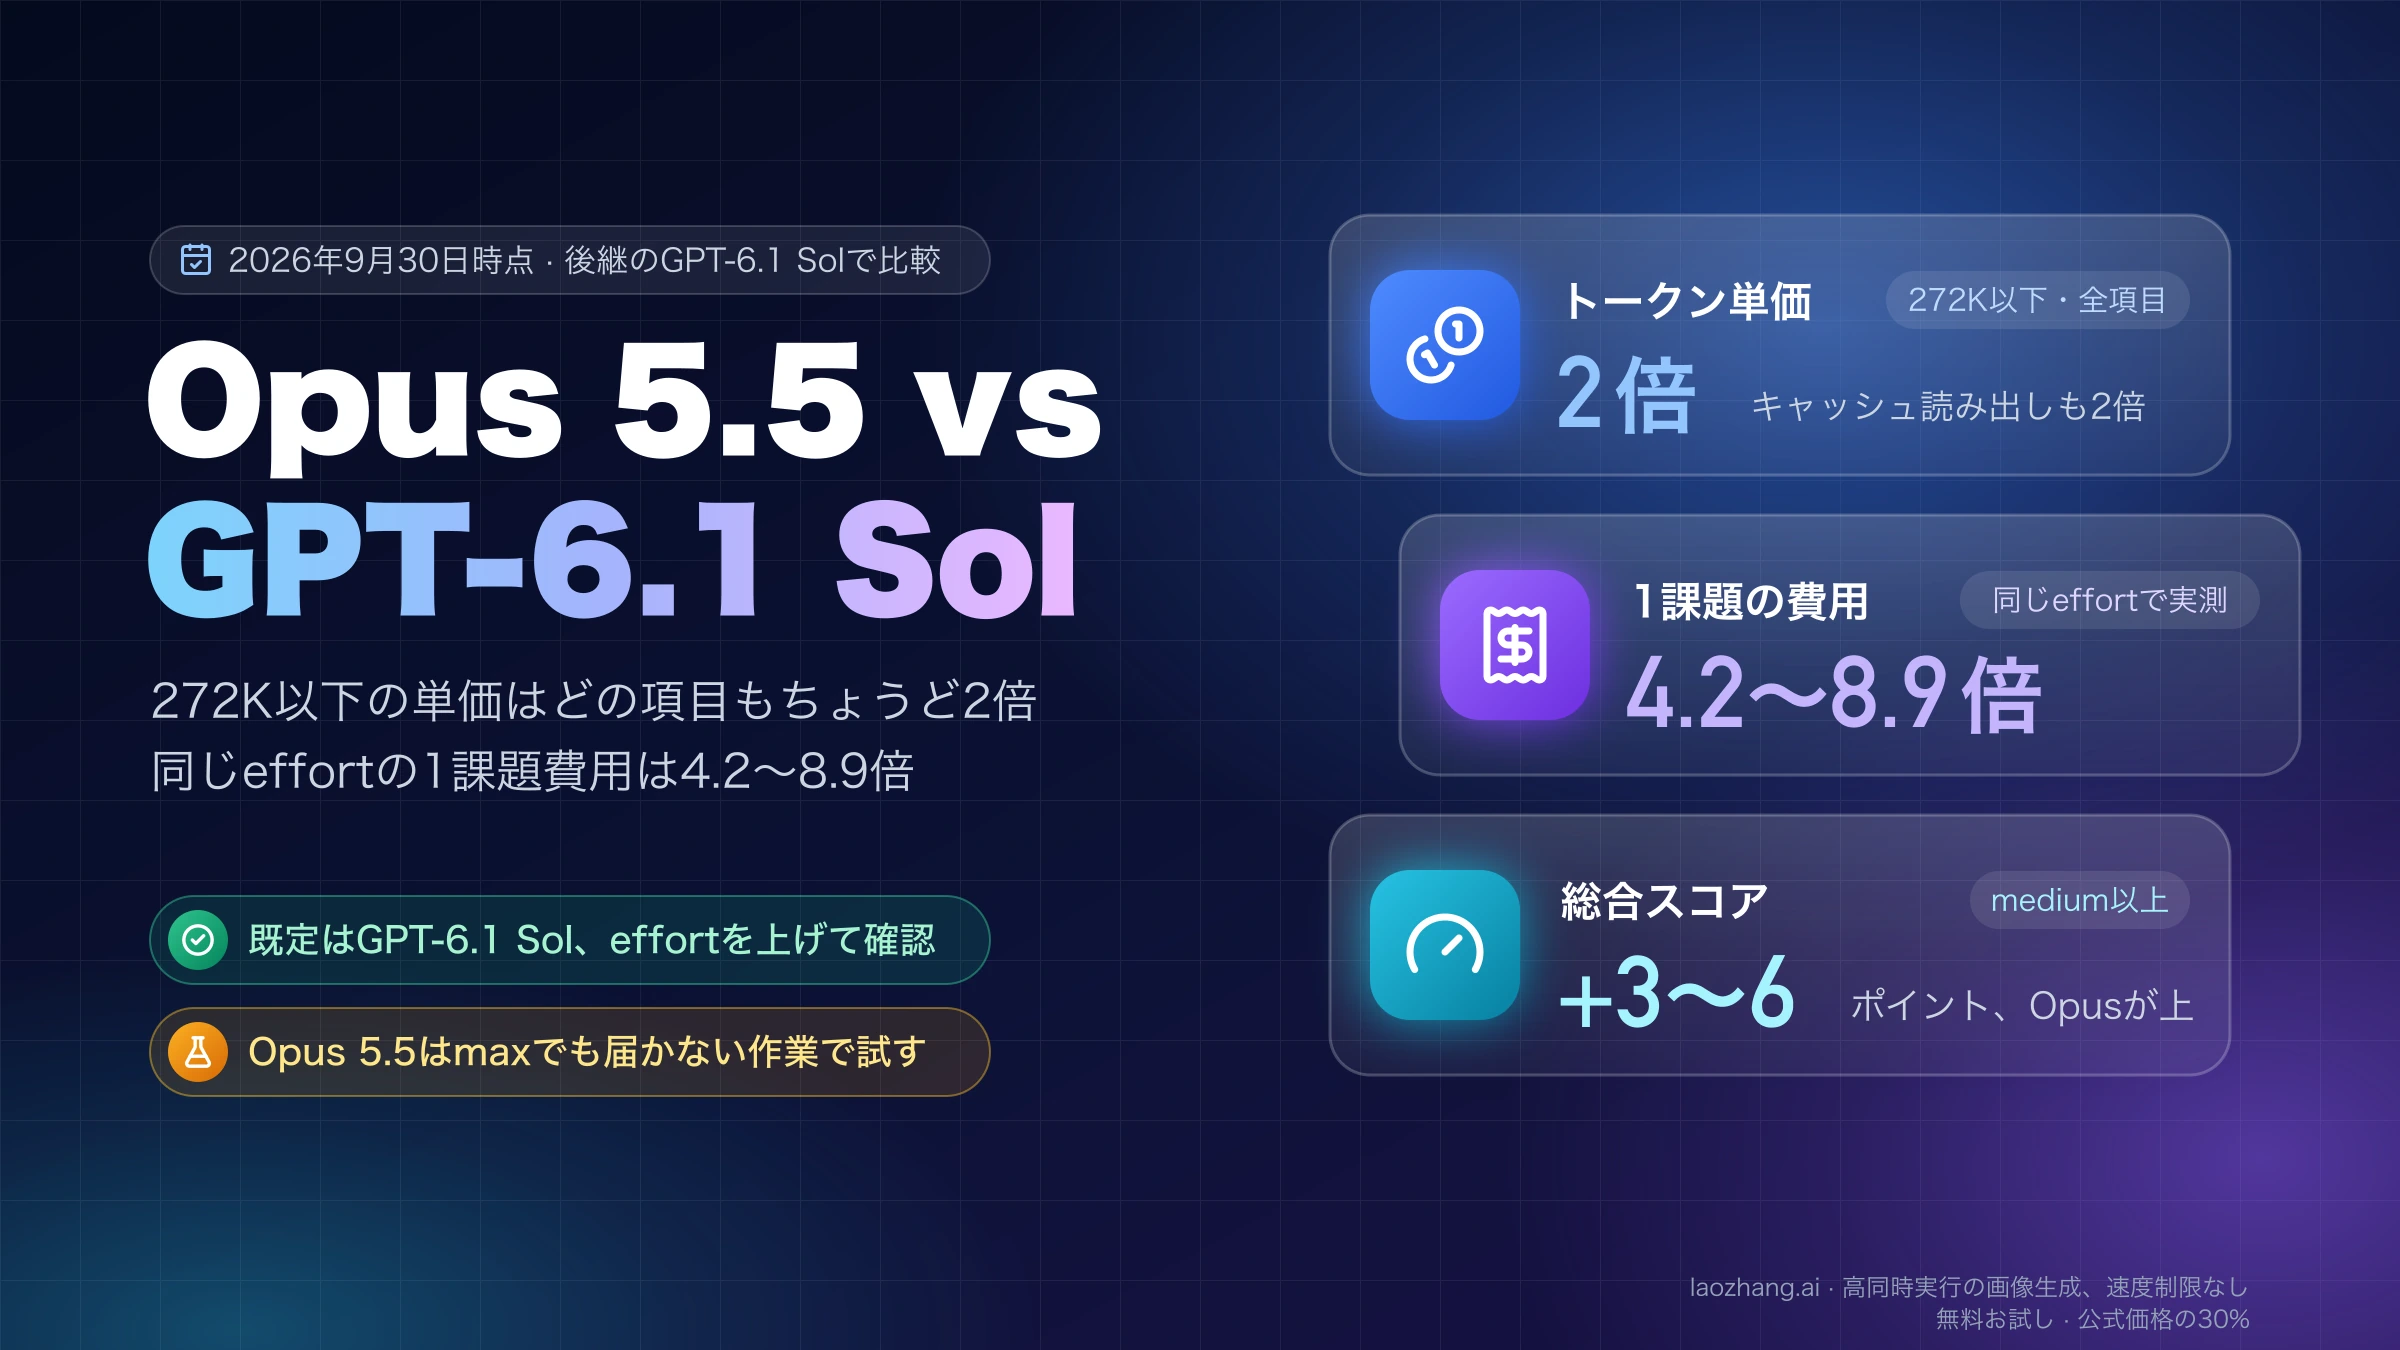
GPT-6.2 SolとGPT-6.1 Solは、OpenAIのAPI料金表のStandard区分で入力$2.00・キャッシュ入力$0.10・出力$10.00と同じ単価が並んでいます。違いは最速のUltrafast区分の倍率と、完了を待てる処理への割引だけです。Claude Opus 5.5はAnthropicの料金ページで入力$4・出力$20で、トークン単価はどちらのSolと比べてもちょうど2倍です。
| 項目 | GPT-6.2 Sol | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|---|
| モデルID | gpt-6.2-sol | gpt-6.1-sol | claude-opus-5-5 |
| 公開日 | 2026年11月17日 | 2026年9月29日 | 2026年9月22日 |
| 入力/出力(100万トークンあたり) | $2/$10 | $2/$10 | $4/$20 |
| キャッシュ入力 | $0.10 | $0.10 | $0.20 |
| Ultrafast | Standardの3倍(2027年3月1日から6倍) | Standardの6倍 | 対象外 |
| 完了を待つ処理の割引 | 2時間で30%引き、8時間で40%引き | なし | 対象外 |
| 推論レベル | low〜max(noneは不可) | low〜max(noneは不可) | low〜max |
6.2 Solのコンテキストは1,050,000トークン、最大出力は128,000トークン、知識のカットオフは2026年6月1日です(GPT-6.2 Solのモデルページ)。入力が272Kトークンを超えるリクエストは全体が入力2倍・出力1.5倍($4/$15)になります。Opus 5.5は1Mトークンまで同じ単価なので、30万トークン級の文書を毎回渡す使い方では単価の差が2倍より縮まります。BatchはどちらのSolも半額($1/$5)、Opus 5.5も半額($2/$10)です。
推論レベル別のAA指数:6.2 Solは6.1 Solより2〜7点高い
AAの総合指数v5.0.1では、同じ推論レベル同士で比べるとGPT-6.2 Solは6.1 Solをすべての段階で上回ります。差が大きいのはlowとmedium(+6点、+7点)で、maxでは+2点まで縮みます。費用はlowとmediumで6.2 Solが1割強高く、high以上では6.2 Solのほうが安くなります。
| 推論レベル | GPT-6.2 Sol | GPT-6.1 Sol | Claude Opus 5.5 | 6.2 Solの1タスク時間 |
|---|---|---|---|---|
low | 41点・$0.18 | 35点・$0.16 | 35点・$0.98 | 1.4分 |
medium | 53点・$0.41 | 46点・$0.36 | 48点・$2.45 | 3.1分 |
high | 55点・$0.56 | 50点・$0.59 | 52点・$3.46 | 4.2分 |
xhigh | 56点・$0.65 | 52点・$0.76 | 57点・$6.05 | 5.1分 |
max | 57点・$1.01 | 55点・$1.27 | 59点・$10.04 | 7.9分 |
金額はAAの指数タスク1件あたりの費用です。GPT-6.2 SolとOpus 5.5はAAのOpus 5.5対GPT-6.2 Sol比較ページの2026年11月18日時点の値、6.1 Solは2026年11月4日時点(maxは11日に再確認)の値です。AAは18日時点で6.1 Solを「deprecated」と表示していますが、これはAAの掲載状態で、OpenAIが提供を終了したという意味ではありません。
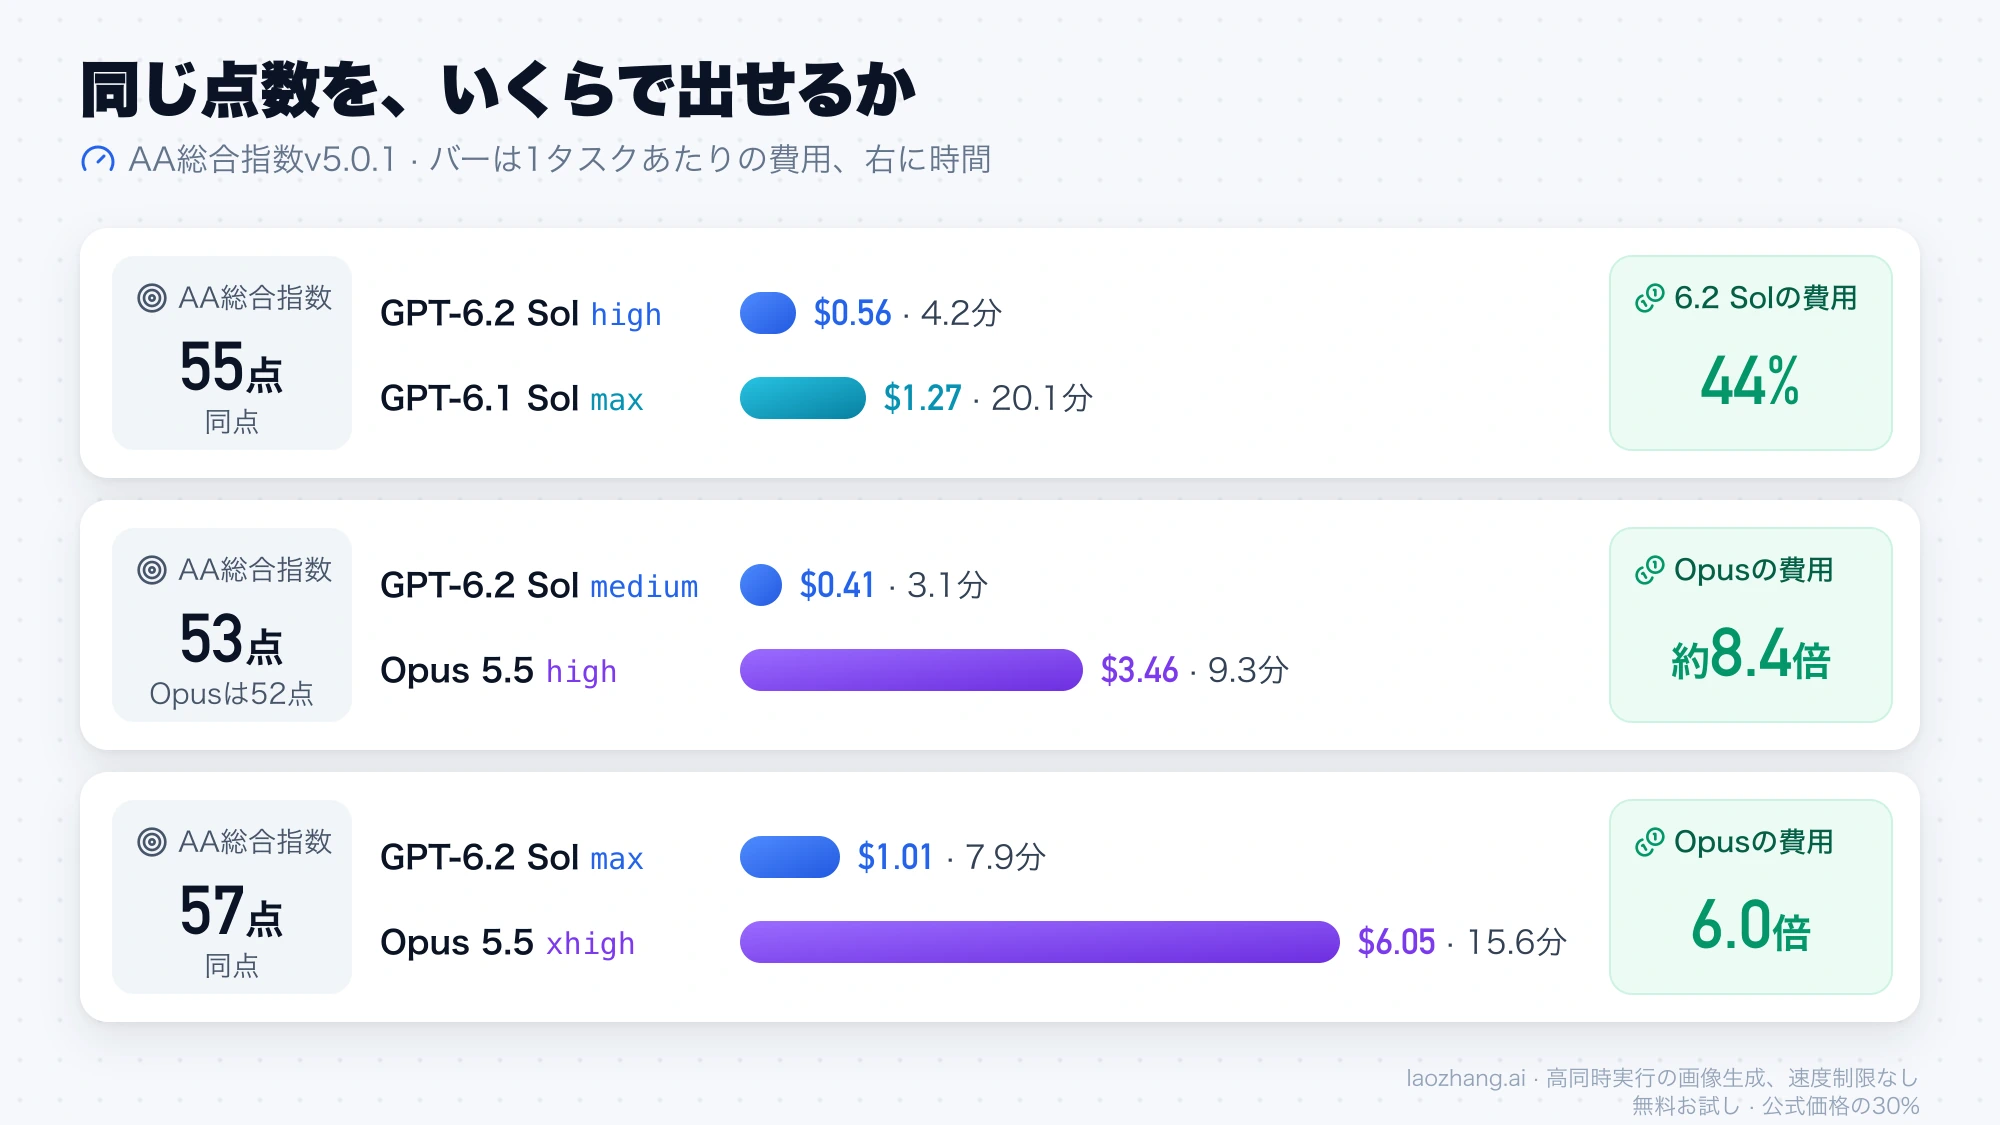
点数をそろえて比べると差がはっきりします。6.2 Sol high(55点、$0.56)は6.1 Sol max(55点、$1.27)と同点で、費用は44%です。AAの計測では6.1 Sol maxが1タスク20.1分かかったのに対し、6.2 Sol highは4.2分でした。6.1 Solでxhighやmaxを使っていた人は、6.2 Solでは1〜2段階下げても同じ点数を得られます。
6.2 Solはコードで6.1より悪い?Codex作業で2.4点下
Codexでの自律的なコーディングに限れば、「6.2 Solは6.1 Solより弱い」という声には根拠があります。Redditのr/codexには「6.2 Sol is worse than 6.1」という題の投稿が立ち(2026年11月18日時点で305票、150件のコメント)、広まっている「52から49に下がった」という数字は、AAのコーディングエージェント指数が出所です。この指数はCodex CLI(0.166.0)やClaude Codeにモデルを組み合わせ、FrontierCode 2.0、SWE-Atlas QnA、Terminal-Bench v4で測ったものです。
| 構成 | 指数 | 1タスクの費用 | 1タスクの時間 |
|---|---|---|---|
Codex+GPT-6.1 Sol max | 52.2 | $1.51 | 21.9分 |
Codex+GPT-6.2 Sol xhigh | 49.8 | $0.90 | 12.6分 |
Codex+GPT-6.2 Sol max | 48.6 | $1.22 | 17.5分 |
Codex+GPT-6.2 Sol high | 47.5 | $0.76 | 10.6分 |
Claude Code+Claude Opus 5.5 max | 58.2 | $12.61 | 65.3分 |
6.2 Solの最高値はxhighの49.8で、6.1 Sol maxより2.4点低い代わりに、費用は40%少なく、時間は12.6分対21.9分と4割ほど短くなります。また6.2 Solはmaxにしてもxhighより点が下がり、費用だけが増えています。Codexで6.2 Solを使うならxhighが上限の目安です。なお、この表に6.1 Solの行はmaxしかないため、同じ推論レベル同士の比較はできません。
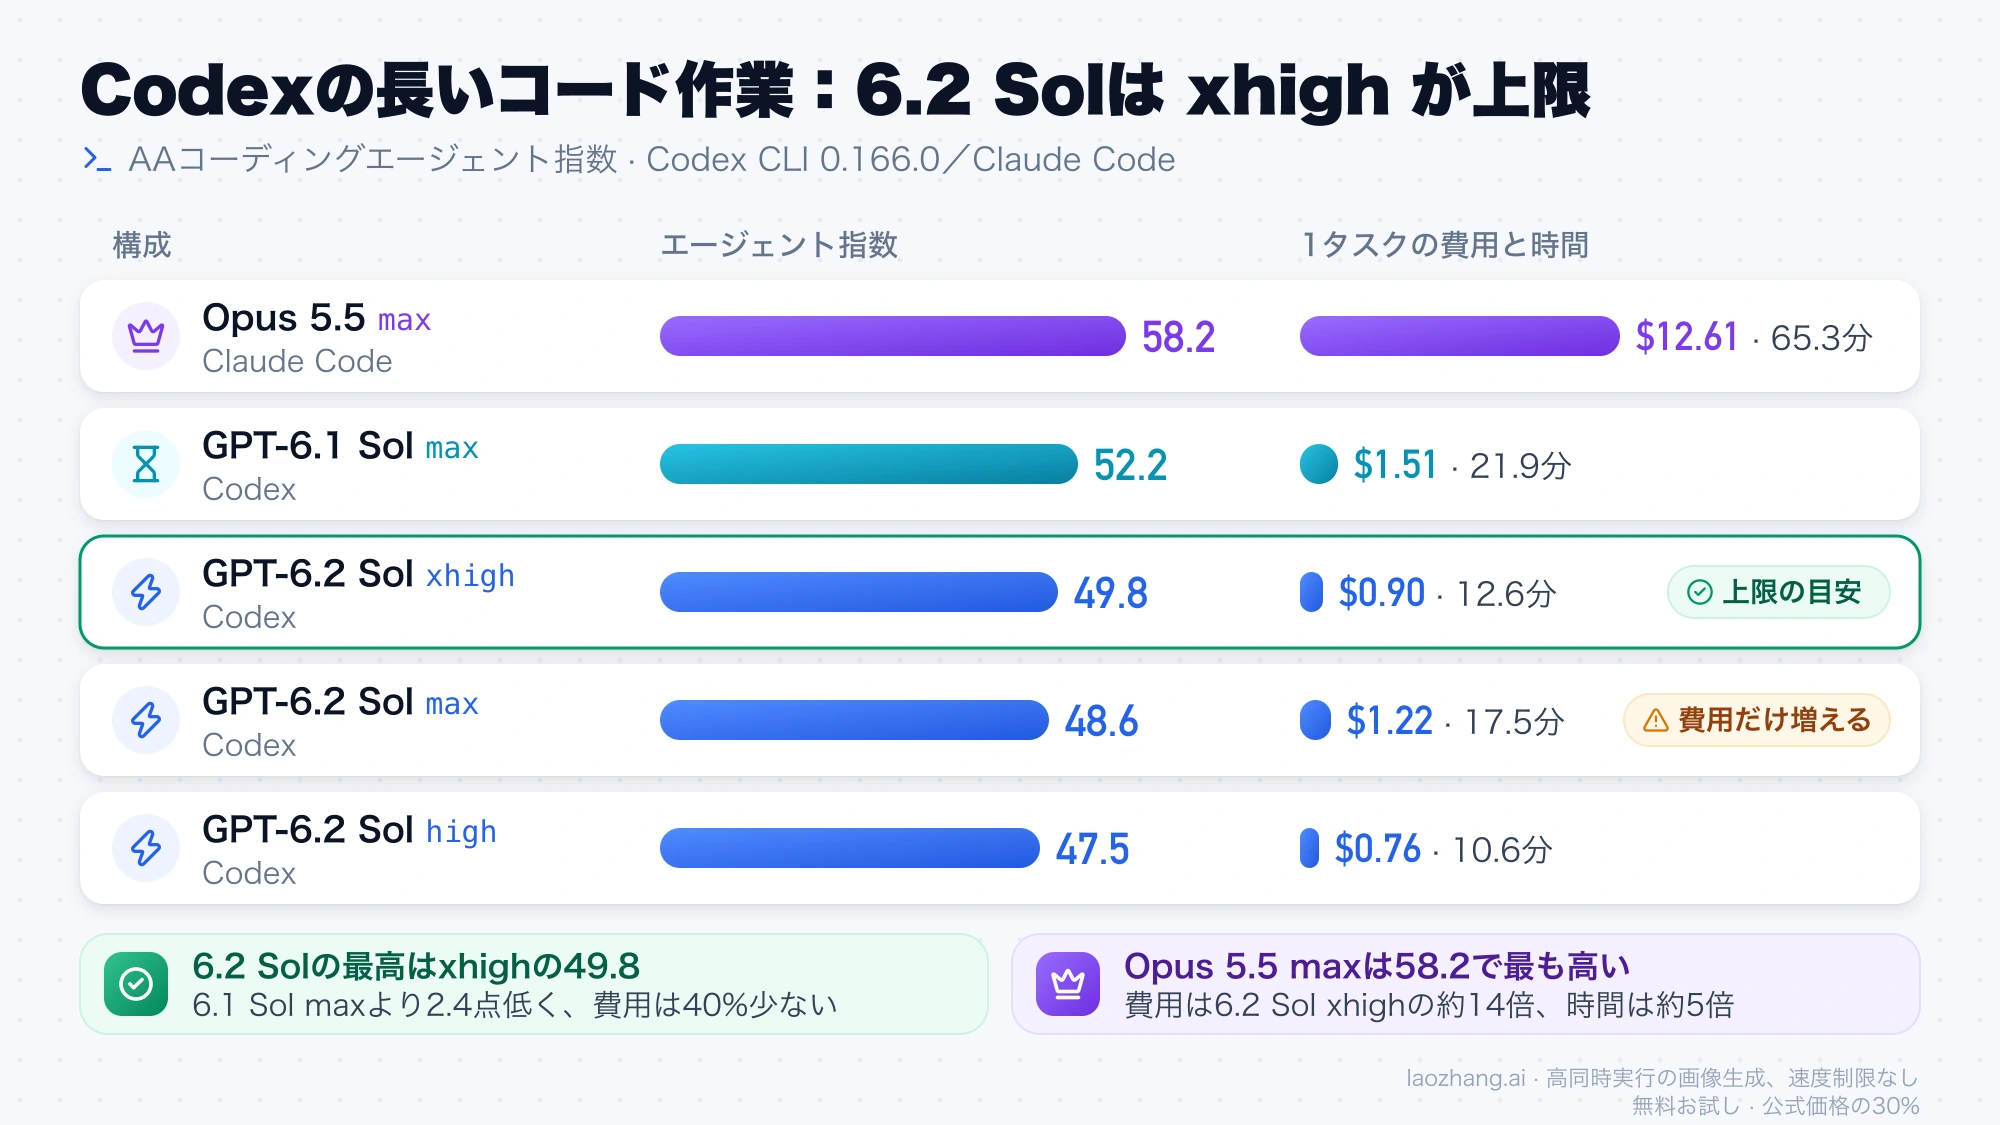
総合指数では全段階で上なのに、エージェント指数では下がるという結果は、作業の形で答えが変わることを示しています。短い指示に答える仕事では6.2 Solが速く安く、数十分の自律作業で正解率を最優先するなら6.1 Sol maxかOpus 5.5に分があります。後者はOpus 5.5が58.2点で最も高い一方、1タスク$12.61・65.3分と、6.2 Sol xhighの約14倍の費用と約5倍の時間がかかります。
6.2 Sol low・mediumはOpus 5.5 mediumに勝てるか
AA総合指数で見ると、GPT-6.2 Sol mediumはOpus 5.5 mediumに勝ちますが、lowでは勝てません。6.2 Sol lowは41点でOpus 5.5 mediumの48点に7点届かず、同じlow同士(41点対35点)なら上回ります。6.2 Sol medium(53点)はOpus 5.5のmedium(48点)だけでなくhigh(52点)も上回り、1タスクの費用は$0.41対$3.46で約8分の1、時間は3.1分対9.3分です。
上の段階では差が逆転します。Opus 5.5 xhighの57点は6.2 Solの最高値(maxの57点)と同点で、このときの費用は$6.05対$1.01で6.0倍、時間は15.6分対7.9分です。Opus 5.5 maxの59点には6.2 Solのどの段階も届きません。内訳では、Terminal-Bench 4.0は6.2 Sol maxが60.1%でOpus maxの59.6%とほぼ並び、FrontierCode-AA 2.0(44.4%対46.4%)とHLE-Diamond(64.0%対67.9%)はOpusが上です。
「6.2 SolはOpus 5.5より10倍安い」という声は、何を比べるかで当たり外れが変わります。トークン単価の差は2倍で、AA総合指数の同点比較では6.0倍、6.2 Sol mediumとOpus highなら約8.4倍、コーディングエージェント指数では約14倍です。X上では、同じ3D制作のプロンプトに6.2 Solが$2.07・30分47秒、Opus 5.5が$31.85・2時間45分かかったという投稿もあります(1件のユーザー報告)。前世代のGPT-6 Sol・6.1 SolとOpus 5.5の費用差はOpus 5.5とGPT-6 Sol・6.1 Sol比較:費用差を参照してください。
同じ12問で3モデルを実測:全問正解、速さと費用に差
2026年11月18日に、隠しテストつきのコーディング課題と答えが一つに決まる問題の計12問(区間のマージ、式の評価、CSV行の解析、semverの範囲判定など)を3モデルに解かせたところ、6つの構成すべてが12問とも正解でした。差が出たのは速さと費用で、6.2 Solの既定(medium)は所要時間の合計が59.7秒と、同じ日に同じ問題を解いた6.1 Solの259.4秒の約4分の1でした。
| 構成 | 正解 | 出力トークン | 所要時間の合計 | 費用(請求ベース) | 費用(全入力をキャッシュなしで換算) |
|---|---|---|---|---|---|
GPT-6.2 Sol 既定(medium) | 12/12 | 4,220 | 59.7秒 | $0.0721 | $0.0862 |
GPT-6.2 Sol high | 12/12 | 6,765 | 76.6秒 | $0.1217 | $0.1116 |
GPT-6.1 Sol 既定(medium) | 12/12 | 6,167 | 259.4秒 | $0.1158 | $0.1056 |
GPT-6.1 Sol high | 12/12 | 10,380 | 363.1秒 | $0.1579 | $0.1477 |
Claude Opus 5.5 medium | 12/12 | 11,833 | 130.5秒 | $0.3699 | $0.3699 |
Claude Opus 5.5 high | 12/12 | 13,674 | 159.3秒 | $0.4067 | $0.4067 |
既定同士で比べると、6.2 Solは6.1 Solに対して出力トークンが0.68倍、時間が0.23倍、費用はキャッシュなし換算で0.82倍です(請求ベースでは0.62倍)。請求額にはキャッシュの読み書きが混ざり、6.2 Solでは同じ長文をhighで送った直後の1問がキャッシュを読んだため、キャッシュなしの換算のほうが公平な比較になります。Opus 5.5 mediumは6.2 Solの既定に対して出力が2.80倍、時間が2.19倍、費用はキャッシュなし換算で4.29倍(請求ベース5.13倍)でした。6.1 Solの応答が遅い理由と速くする設定はGPT-6.1 Solが遅いのは解消した?10月26日の実測と速くする設定を参照してください。
146KB・1,500行のログから7つの数値を正確に数える長文の課題でも、3モデルとも全問正解でした。所要時間と費用は6.2 Sol既定が13.6秒・$0.158(11月18日)、6.1 Sol既定が45.7秒・$0.165(11月16日)、Opus 5.5 mediumが57.6秒・$0.468(11月11日)です。同じログをOpus 5.5は78,537トークン、Solは55,843トークンと数え、Opusは入力トークン数が1.41倍になるため、単価の2倍に上乗せされて費用差が広がります。
このテストの限界も数字と一緒に読んでください。各構成は1回ずつしか実行しておらず、全員が正解できる易しめの問題なので、測れているのは速さ・トークン数・費用で、能力の差ではありません。Opus 5.5の12問のうち8問は2026年11月11日に実行した結果(ストリーミング)を、残り4問は18日の結果を使っています。時間はAPIゲートウェイ経由の実測で、各社のサーバー側の遅延そのものではありません。テストはlaozhang.aiのOpenAI互換エンドポイント(/v1/chat/completions)経由で行い、3モデルを同じAPIキーで呼んでいます。費用は返ってきたトークン数に公式単価を掛けた推計で、6.2 Solに入力8・出力5トークンを送った実際の請求額$0.000066も公式単価どおりでした。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
作業別の使い分け:6.2 Solに移す作業、残す作業
迷ったら、短い指示で完結する作業は6.2 Solへ移し、数十分かけて自律的に進めるコーディングだけを自分の環境で比べてから決めるのが安全です。6.2 Solは6.1 Solと同じ単価で総合指数が高く速いので、移して損をする場面は限られます。Opus 5.5から移すかどうかは、その作業で失敗したときの手戻りと、6〜14倍の費用差のどちらが重いかで決まります。
| 作業 | 選ぶモデルと推論レベル | 理由 |
|---|---|---|
| 日常のコード修正、API経由のデータ処理、要約・分類 | GPT-6.2 Sol medium | 6.1 Solより7点高く、Opus 5.5 highも上回る |
6.1 Solのxhigh・maxで回していた難問 | GPT-6.2 Sol high | 6.1 Sol maxと同点で、費用は44% |
| 応答の速さを優先する大量処理 | GPT-6.2 Sol low | 1タスク1.4分・$0.18で、6.1 Sol lowより6点高い |
| Codexでの数十分の自律コーディング | GPT-6.2 Sol xhighと6.1 Sol maxを比べて決める | 6.2は2.4点低いが、費用と時間は約4割少ない |
| Claude Codeでの長時間作業、失敗のコストが大きい仕事 | Claude Opus 5.5 max | エージェント指数58.2、総合指数59で最も高い |
APIでは6.1 Solも引き続き指定できるので、Codex作業を6.1 Solに残す選択はAPI利用なら確実に取れます。一方、ChatGPTやCodexのモデル選択で6.1 Solを選び続けられるかは、2026年11月18日時点でOpenAIの発表に記載がありません。Opus 5.5を使える場所と無料で試す方法はClaude Opus 5.5の使い方:無料で使う方法と外部サービスの無料枠を参照してください。
6.1 Solから6.2 Solへ切り替えるときに変えるリクエスト
推論レベルの選択肢は6.1 Solと同じなので、モデル名を替えるだけでも動きます。ただしOpenAIのGPT-6.2移行ガイドによると、Responses APIでの指示文の扱いと会話履歴の扱いが変わっており、そのままだとキャッシュが効かなかったり、トークンが増えたりします。変える箇所は次のとおりで、互いに独立しているので該当するものだけ対応すれば足ります。
modelをgpt-6.2-solにします。ゲートウェイ経由では応答のmodel欄にgpt-6.2-sol-2026-11-17のような日付つきの名前が返ることがありますが、OpenAIのドキュメントには日付つきのスナップショットIDが載っていないため、固定指定用の名前として扱わないでください。- 毎回同じ指示文は、トップレベルの
instructionsではなくinputの最初のdeveloperメッセージに置きます。GPT-6.2からはinstructionsがinputの後ろに付くため、プロンプトキャッシュの対象から外れます。2026年11月18日に約9,000トークンのinstructionsを3回続けて送った確認では、キャッシュされたトークンは3回とも0で、OpenAIに直接送っても同じでした。 - 会話の途中で過去の履歴を書き換えたり、途中でモデルを替えたりしないでください。6.2からはこうした変更(6.1 Solへのダウングレードも含む)があると推論アイテムが破棄され、回答の質が落ちたり、同じ作業をやり直してトークンが増えたりします。設定を変えるときも履歴の先頭部分はそのまま保ちます。
reasoning.effortのnoneは400エラーになり、「Unsupported value: 'none' is not supported with the 'gpt-6.2-sol' model.」と返ります。6.1 Solと同じくlow〜maxから選び、古いモデルでnoneやminimalを使っていた場合はlowにします。- ツール呼び出しはResponses APIで行います。Chat Completionsでは
temperature、top_p、logprobs、top_logprobsを送らないでください。2026年11月18日のlaozhang.ai経由の確認では、Chat Completionsのreasoning_effortにmaxを指定すると失敗したため、maxはResponses APIのreasoning.effortで指定します。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
GPT-6.2 Solへの移行でよくある質問
GPT-6.1 Solはもう使えなくなりますか?
2026年11月18日時点では、OpenAIのAPI料金表にgpt-6.1-solがStandard $2/$10で載っており、変更履歴にも提供終了の日付はありません。APIでは引き続き指定できます。ChatGPTやCodexでは6.2 Solが6.1 Solに替わって既定になったと海外の技術メディアが伝えていますが、モデル一覧から6.1 Solが消えるかどうかはOpenAIが公表していません。GPT-6 Solから6.1 Solへの移行で何が変わったかはGPT-6.1 Sol:GPT-6 Solとの違いと移行の注意点を参照してください。
GPT-6.2 AstraとGPT-6.2 Solはどう違いますか?
同じ日に公開されたGPT-6.2 Astraは、OpenAIが「最も要求の厳しい仕事向け」と位置づける上位モデルで、2026年11月18日時点のAPI単価は入力$8・出力$40とSolの4倍、AAのコーディングエージェント指数ではCodexと組んだmaxが53.5点・1タスク$5.12です。
参考資料6
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年11月18日。
参考資料6
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年11月18日。
- 1.API料金表developers.openai.com/api/docs/pricing
- 2.Anthropicの料金ページplatform.claude.com/docs/en/about-claude/pricing
- 3.GPT-6.2 Solのモデルページdevelopers.openai.com/api/docs/models/gpt-6.2-sol
- 4.AAのOpus 5.5対GPT-6.2 Sol比較ページartificialanalysis.ai/models/releases/comparisons/claude-opus-5-5-vs-gpt-6-2-sol
- 5.コーディングエージェント指数artificialanalysis.ai/agents/coding
- 6.GPT-6.2移行ガイドdevelopers.openai.com/api/docs/guides/latest-model