Gemini 4 CarbonとGPT-6.1 Sol比較:コーディング費用はCarbonが7倍
同じコーディング問題7問は両モデル全問正解で、費用はCarbonがSolの7倍、時間は3.4倍。ベンチマークはCarbonが上で、12月1日からCarbonの単価は2倍です。
目次
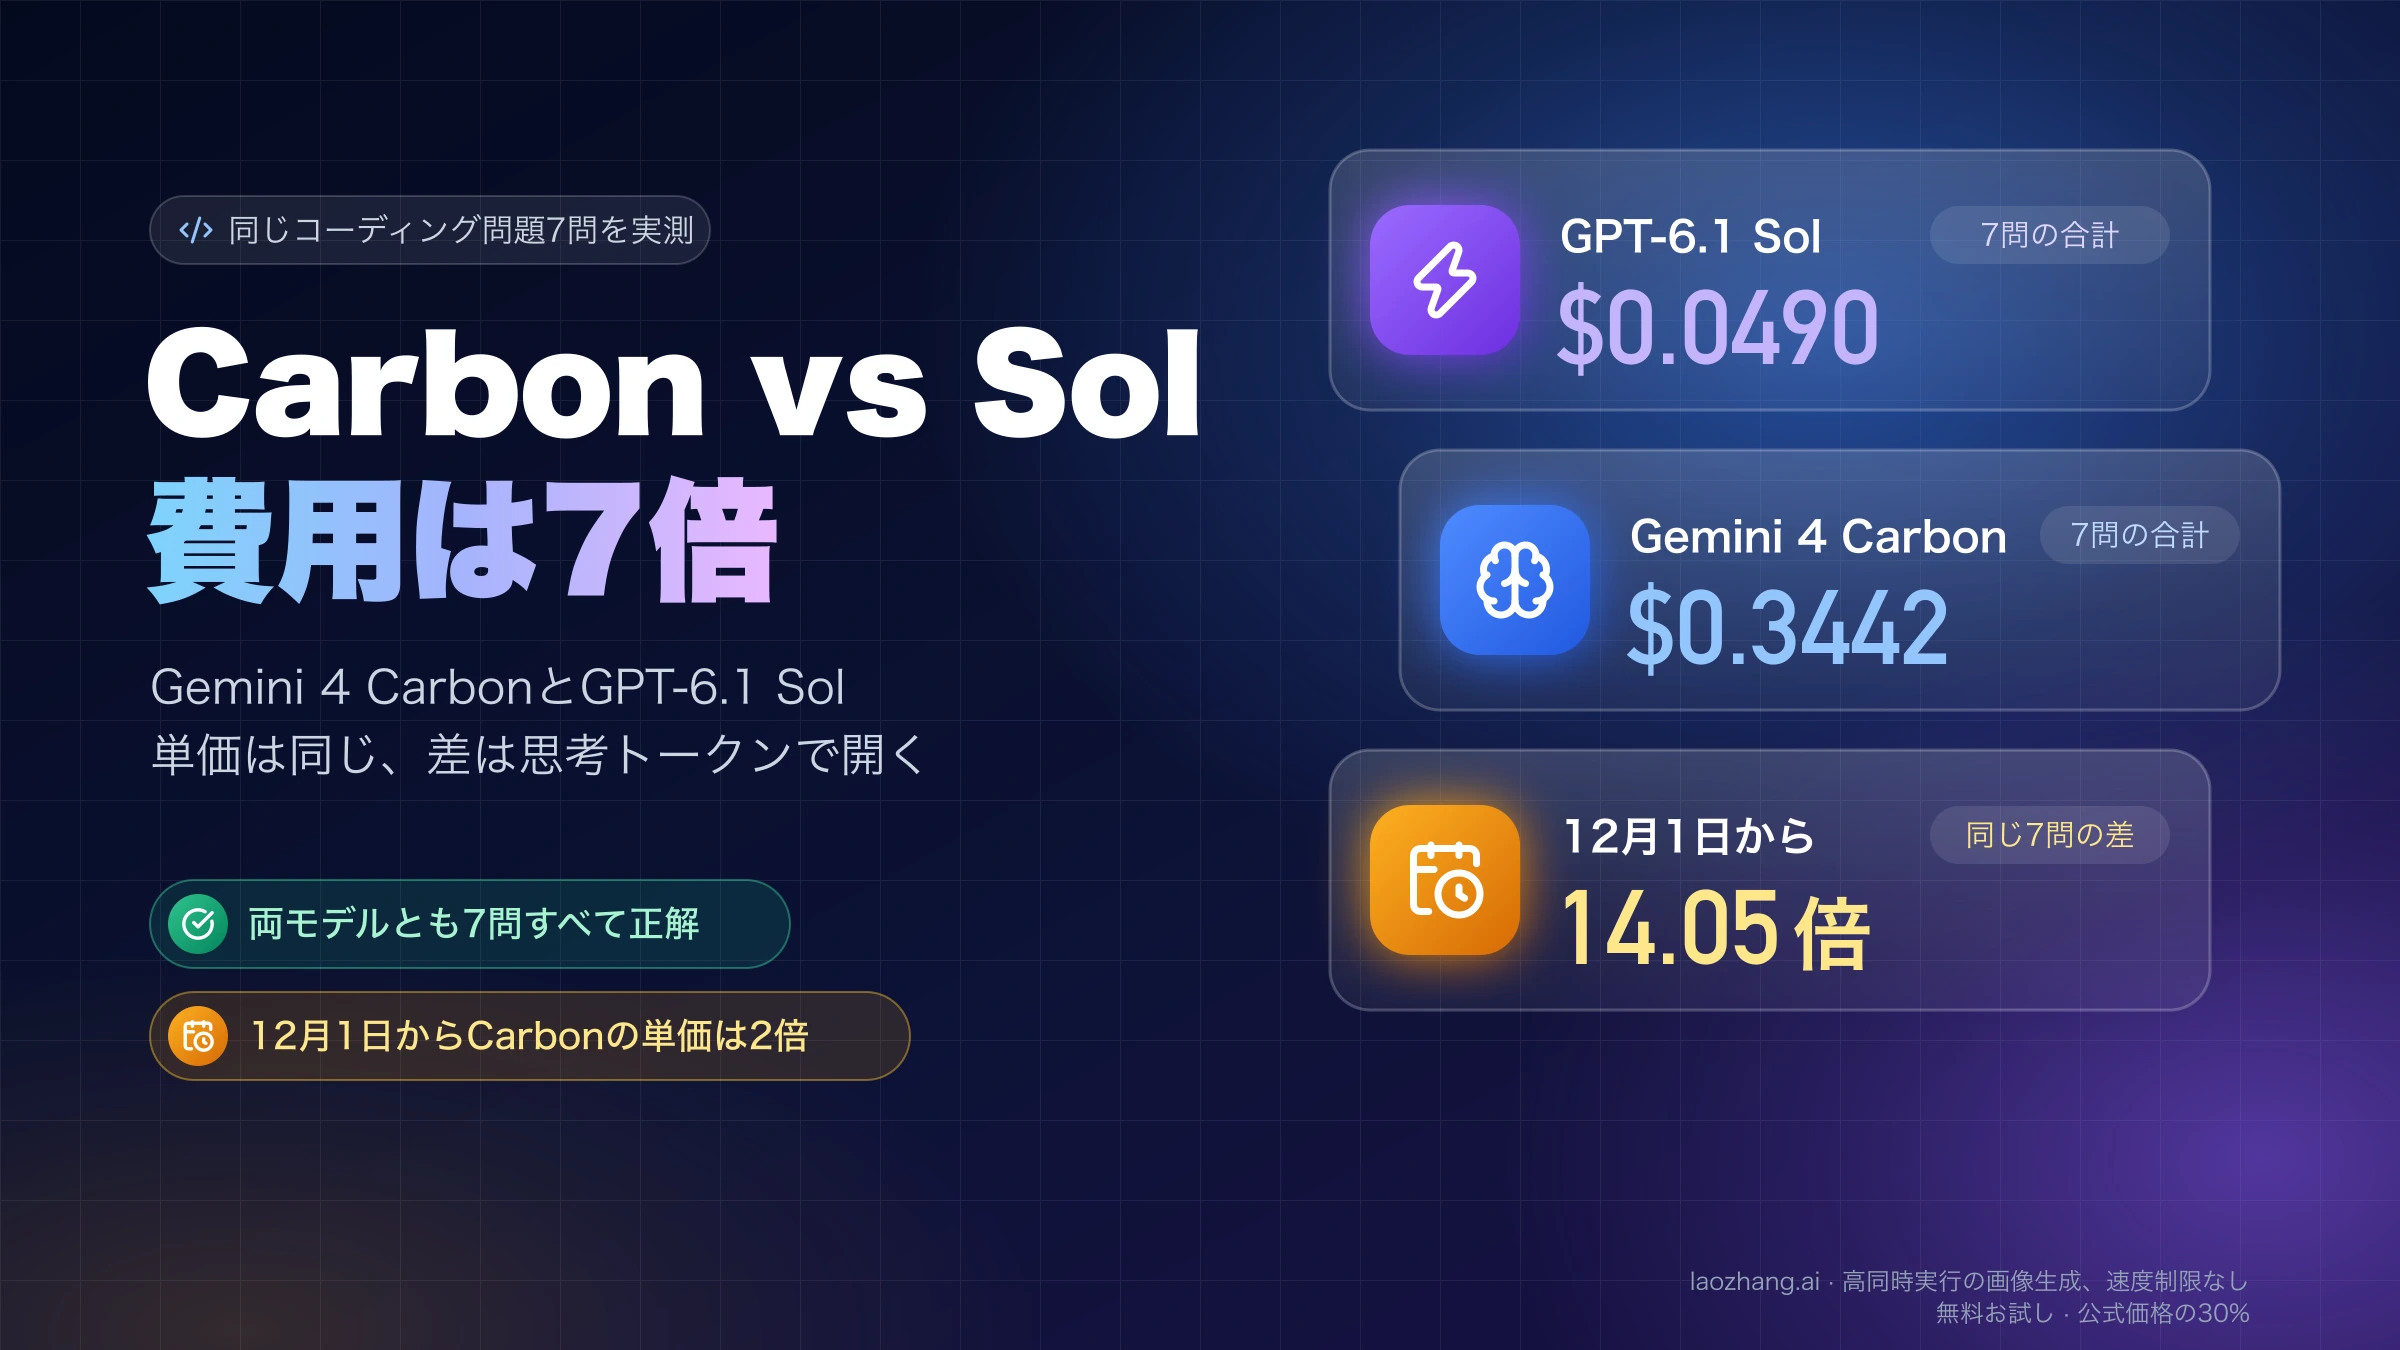
コーディングにGemini 4 CarbonとGPT-6.1 Solのどちらを先に試すか迷っているなら、まずGPT-6.1 Solを既定の推論レベル(medium)で使うのが、費用と待ち時間の両面で有利です。テストつきで仕様が明確なコーディング問題7問を、LaoZhangのゲートウェイ経由で両モデルに既定設定のまま解かせたところ、どちらも7問すべてテストを通過し、Gemini 4 Carbonの費用はSolの7.02倍、待ち時間は3.43倍でした(Solは2026年10月28日、Carbonは11月11日と16日に計測、各1回)。トークン単価が同じなのに費用が開くのは、Carbonが問題によって2万トークンを超える思考トークンを出すためです。
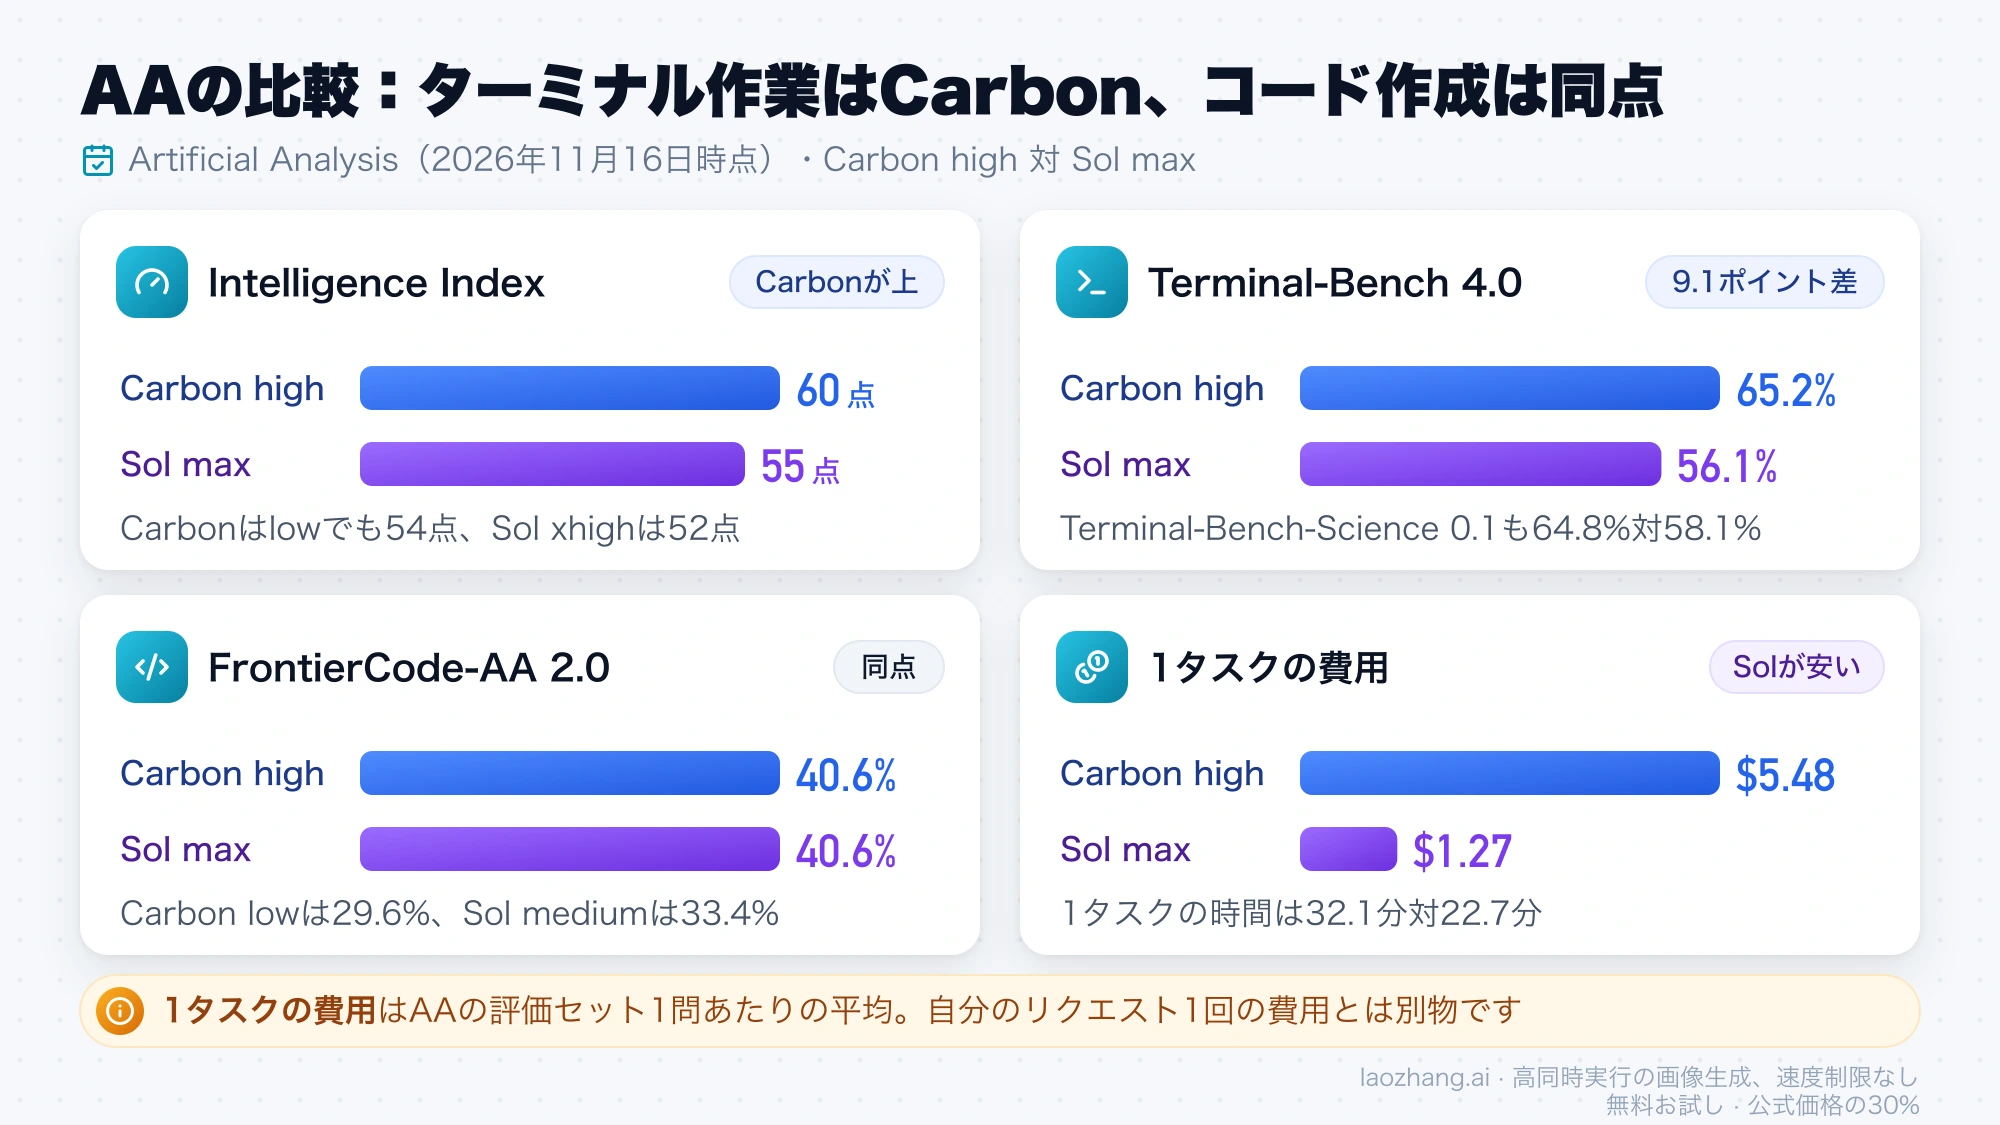
Carbonに切り替える価値があるのは、ターミナル操作の多いエージェント作業です。Artificial Analysis(AA)のIntelligence Index v5.0.1(2026年11月16日時点)ではCarbon highが60点、Sol maxが55点で、Terminal-Bench 4.0は65.2%対56.1%とCarbonが上回る一方、コードを書く課題のFrontierCode-AA 2.0はどちらも40.6%で並びます。
この判断は日付で変わります。2026年11月30日までは両モデルとも入力$2・出力$10(100万トークンあたり)ですが、12月1日からCarbonは入力$4・出力$20になり、同じ7問の費用差は約14倍に広がります。逆に、入力が272Kトークンを超えるとSolだけリクエスト全体が割増になるので、リポジトリ全体を一度に読ませる使い方ではその分を差し引いて比べてください。
同じ7問の実測:両方全問正解、Carbonの費用は7倍
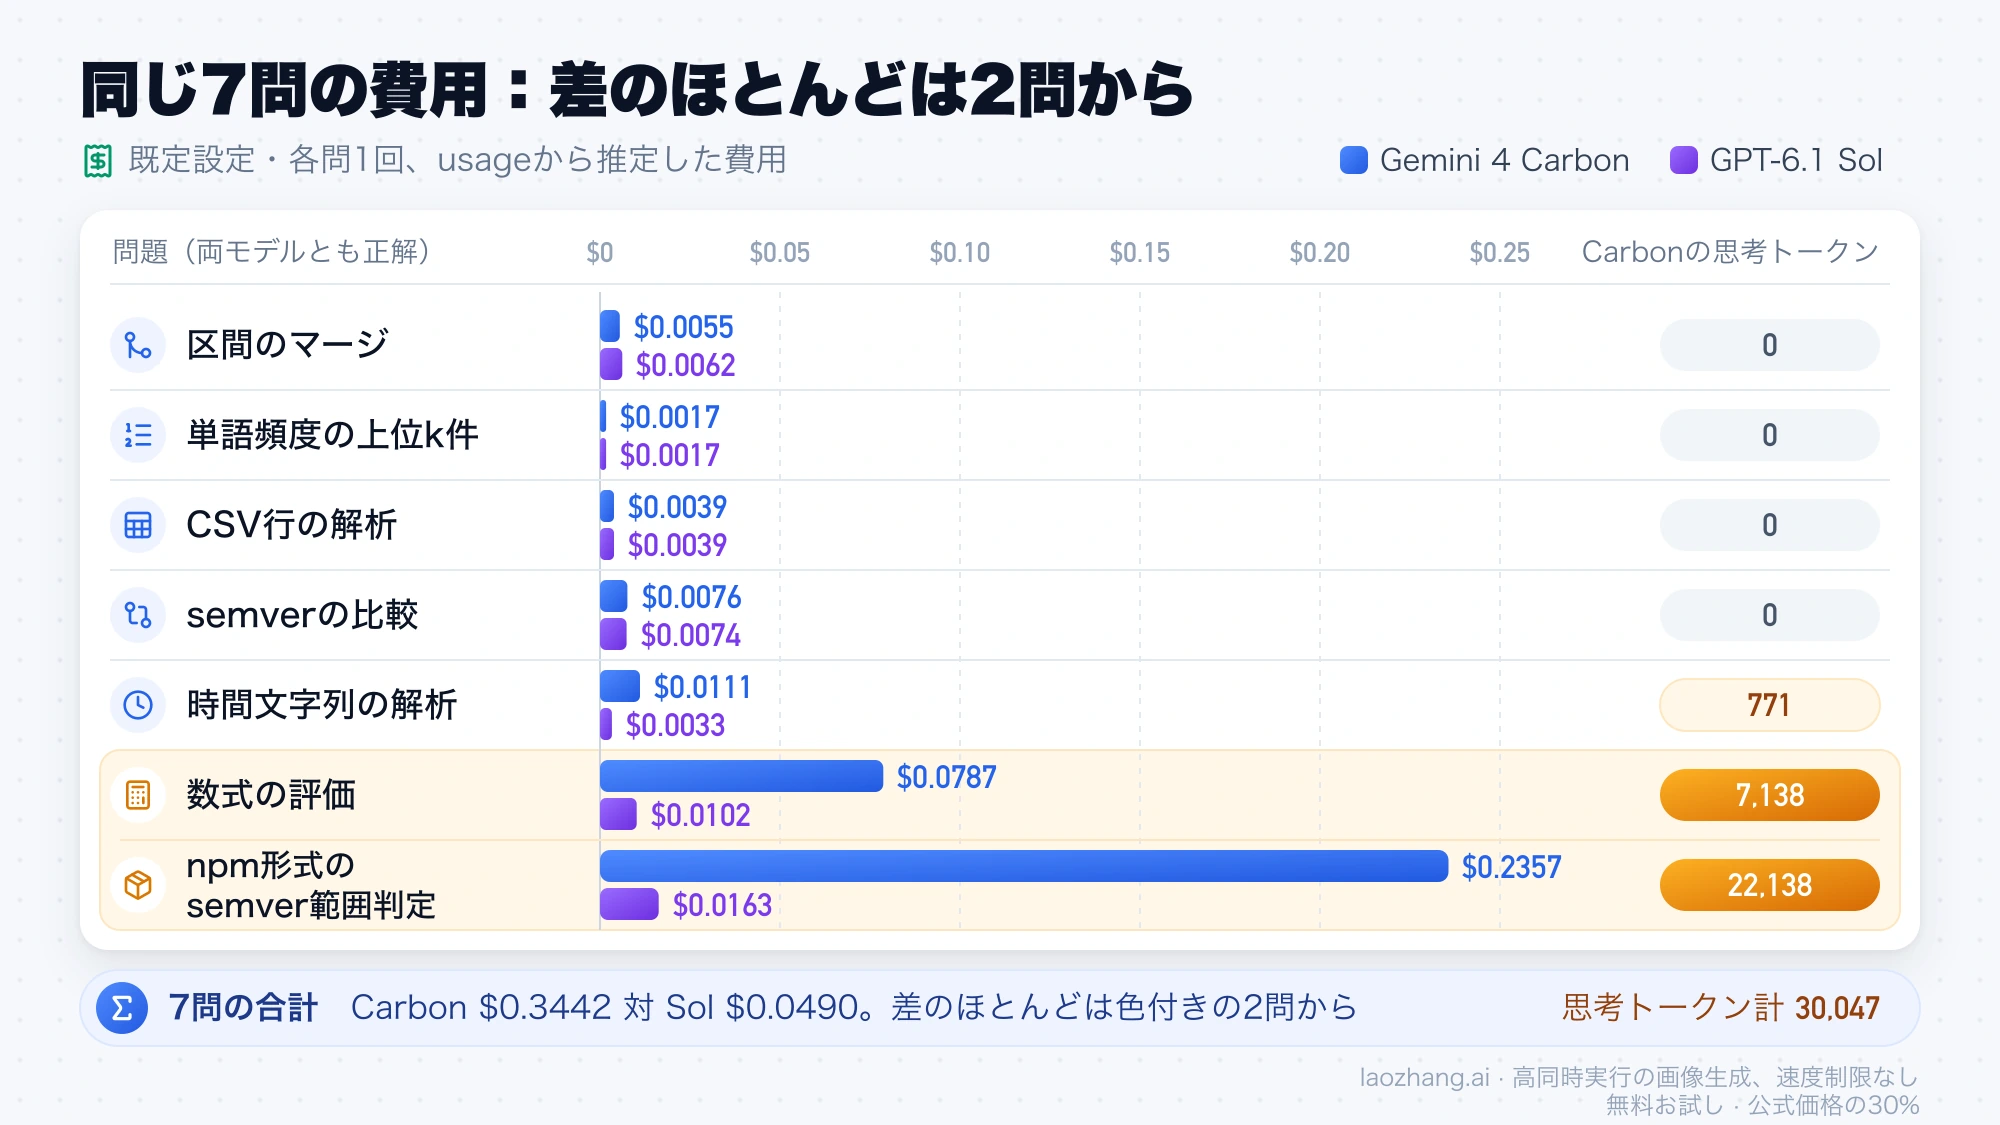
同じ7問はどちらのモデルも既定設定で全問のテストを通過したので、この比較で差が出たのは正誤ではなく、費用、出力量、待ち時間です。問題は区間のマージ、時間文字列の解析、単語頻度の上位k件、数式の評価、CSV行の解析、semverの比較、npm形式のsemver範囲判定で、どれも隠しテストで採点しました。GPT-6.1 Solは2026年10月28日、Gemini 4 Carbonは11月11日と11月16日に、LaoZhangのゲートウェイ経由で1問1回ずつ解かせています。
呼び出し方は両モデルとも、システムプロンプトもツールもない単発のリクエストです。SolはPOST /v1/chat/completionsでreasoning_effortを送らず(公式の既定はmedium)、CarbonはGemini形式のgenerateContentでgenerationConfigを送らずに(公式の既定はmedium)呼んでいます。費用は返ってきたusageに公式の標準単価(11月時点で両モデル同じ)を掛けた推定で、請求額そのものではありません。
| 問題 | Carbon既定の費用 | Carbonの思考トークン | Sol既定の費用 |
|---|---|---|---|
| 区間のマージ | $0.0055 | 0 | $0.0062 |
| 単語頻度の上位k件 | $0.0017 | 0 | $0.0017 |
| CSV行の解析 | $0.0039 | 0 | $0.0039 |
| semverの比較 | $0.0076 | 0 | $0.0074 |
| 時間文字列の解析 | $0.0111 | 771 | $0.0033 |
| 数式の評価 | $0.0787 | 7,138 | $0.0102 |
| npm形式のsemver範囲判定 | $0.2357 | 22,138 | $0.0163 |
| 7問の合計 | $0.3442 | 30,047 | $0.0490 |
7問の合計では、出力トークンがCarbon 34,088(うち思考30,047)対Sol 4,613で7.39倍、呼び出し時間の合計が459.1秒対133.9秒、費用が$0.3442対$0.0490でした。差のほとんどは2問から来ています。npm形式の範囲判定ではCarbonの出力が23,481トークン(うち思考22,138)で284.0秒かかり(Solは出力1,547トークン・45.0秒)、数式の評価でも7,138トークン考えました。残り5問のうち4問は費用の差が15%未満で、思考トークンは0です。Carbonの既定設定は易しい問題ならSolとほぼ同じ費用で済み、少し込み入った問題で思考量が一気に増えるので、合計の倍率は問題の構成しだいで動きます。
Solをhighにしても7問は全問正解で、費用は$0.0859、時間は237.9秒でした。既定のCarbonはこれと比べても費用4.01倍、時間1.93倍です。
コーディング以外の4問(文章題、桁の和の数え上げ、6,723語の長文の5点要約、Python 3.13標準ライブラリの質問)を加えた11問では、Solの既定が11問正解・$0.0897・182.1秒、Carbonの既定が10問正解・$0.4421・574.8秒でした。Carbonが落としたのは標準ライブラリの質問です。存在しない2つの関数のうち、functools.memoize_methodには「存在しない」と答えましたが、statistics.winsorized_meanには“It returns the arithmetic mean of a data set after replacing…”で始まる機能の説明を返しました(2026年11月16日、思考トークン0、5.2秒)。Solは既定とhighのどちらでも、2つとも「存在しない」と答えています。
この1問は1回だけの結果なので、Carbonが存在しないAPIを作り話しやすいとまでは言えません。AAの事実問答AA-Omniscience v1.1では、むしろCarbon highが54、Sol maxが42とCarbonが上です。言えるのは、思考トークン0のまま即答した回答では、存在しない関数の説明が返ってくることもあった、というところまでです。
測定の限界もはっきりさせておきます。SolとCarbonは測った日が違い、各問1回のサンプルです。問題は小さく仕様が明確で、どちらもほぼ全問通るため、この結果が示すのはどちらが賢いかではなく、同じ答えにたどり着くまでの費用と時間です。能力の差はAAの数字で見るのが適しています。
X上でも2026年11月中旬に、同じプロンプトを両モデルに投げた単発の比較が2件投稿されています。ユーザーnotjaziiは最高の推論レベルどうしでSolが30分・約$1.4、Carbonが40分・約$2.9、ユーザーEnvolDevはCarbonが$8.83・2時間39分、Solが$3.11・54分と報告しました。どちらも1回きりの個人の報告で、課題もテストつきのコーディング問題ではなく3D生成系ですが、Carbonの方が時間も費用もかかったという向きは同じです。
ベンチマーク:Carbonはターミナル操作で上、コード作成は互角
Artificial AnalysisのIntelligence Index v5.0.1(2026年11月16日時点)では、Gemini 4 Carbonは最も低いlowでも54点で、GPT-6.1 Solのxhigh(52点)を上回ります。ただ、コードに直接関わる項目に絞ると、差が大きいのはターミナル操作を伴う課題で、コードを書く課題ではほぼ互角です。
| モデルと思考レベル | Intelligence Index | Terminal-Bench 4.0 | FrontierCode-AA 2.0 | 1タスクの費用 | 1タスクの時間 |
|---|---|---|---|---|---|
| Carbon high | 60 | 65.2% | 40.6% | $5.48 | 32.1分 |
| Carbon medium(既定) | 58 | 60.6% | 39.5% | $4.68 | 28.0分 |
| Carbon low | 54 | 62.6% | 29.6% | $5.22 | 25.9分 |
| Sol max | 55 | 56.1% | 40.6% | $1.27 | 22.7分 |
| Sol xhigh | 52 | 54.0% | 38.5% | $0.76 | 9.8分 |
| Sol high | 50 | 51.5% | 36.7% | $0.59 | 7.6分 |
| Sol medium(既定) | 46 | 48.0% | 33.4% | $0.36 | 4.4分 |
| Sol low | 35 | 30.8% | 20.2% | $0.16 | 1.9分 |
数値はArtificial AnalysisのGemini 4 CarbonとGPT-6.1 Solの比較ページの2026年11月16日時点のものです。Terminal-Bench 4.0はCarbon highとSol maxで9.1ポイント差、科学計算の課題を端末で解くTerminal-Bench-Science 0.1も64.8%対58.1%で、シェルを操作しながら進める課題ではCarbonがはっきり上です。AAが工学系の能力をまとめたEngineeringのスコアも65対59です。一方、FrontierCode-AA 2.0はCarbon highとSol maxが同点で、Carbon lowは29.6%とSol mediumの33.4%を下回ります。
表の「1タスクの費用」はAAの評価セット1問あたりの平均で、自分のリクエスト1回の費用とは別物です。それでも比率は参考になり、Carbon mediumの$4.68はSol maxの$1.27の約3.7倍です。AAは両モデルとも11月の同じ単価で計算しています。また、AAのCarbonの1タスク費用は2026年11月11日時点では$7.76・$6.59・$7.19(high・medium・low)と表示されていて、その後に再計算されました。別のページでこの古い数字を見かけたら、日付を確かめてください。
「料金はほぼ同じ」は11月まで:12月1日からCarbonは2倍
トークン単価が同じなのは2026年11月30日までです。GoogleのGemini APIの料金ページは、Gemini 4 Carbonの有料ティアの単価が12月1日から入力・出力・キャッシュのすべてで2倍になると明記しています。OpenAIのGPT-6.1 Solのモデルページでは、11月のCarbonと同じ単価のまま、入力が272Kトークンを超えるリクエストだけが割増です。
| 100万トークンあたり | Carbon(11月30日まで) | Carbon(12月1日から) | Sol(入力272K以下) | Sol(入力272K超) |
|---|---|---|---|---|
| 入力 | $2.00 | $4.00 | $2.00 | $4.00 |
| キャッシュ入力 | $0.10 | $0.20 | $0.10 | $0.20 |
| 出力(思考トークンを含む) | $10.00 | $20.00 | $10.00 | $15.00 |
Solの272K超の単価は、超えたリクエストの全体にかかります。Carbonには長文の割増がありません。Batchはどちらも半額で、SolにはさらにFlex(半額)とFast(2倍)の区分があります。
同じ問題の12月1日以降の費用は、実測したCarbonの費用を2倍にすれば出せます。Solの単価は変わらないので、差はそのまま2倍に広がります。
| 同じ問題のセット | Sol既定 | Carbon既定(11月の単価) | Carbon既定(12月1日からの単価) | 12月1日以降の倍率 |
|---|---|---|---|---|
| コーディング7問 | $0.0490 | $0.3442 | $0.6884 | 14.05倍 |
| 11問全体 | $0.0897 | $0.4421 | $0.8842 | 9.86倍 |
| 長いログの集計 | $0.1654 | $0.4281 | 約$0.856 | 5.18倍 |
AAの1タスク費用も、キャッシュの割合が変わらないと仮定して単純に2倍にすると、Carbon high・medium・lowで約$10.96・$9.36・$10.44になります。11月中に試してCarbonの方が良いと判断した場合でも、12月以降の予算はこの単価で組み直す必要があります。
CodexとAntigravityの中では:Carbonが55.5点、費用は4.7倍
コーディングエージェントに組み込んだ状態で比べるなら、Artificial AnalysisのCoding Agent Index v2.1(2026年11月16日時点)が参考になります。Antigravity CLIで動かしたGemini 4 Carbon(high)が55.5点、Codexで動かしたGPT-6.1 Sol(max)が52.2点でCarbonが上ですが、1タスクあたりの費用は$7.13対$1.51で約4.7倍、時間は33.6分対21.9分、平均ステップ数は186対43でした。
この指標が比べているのは「モデル+そのモデルの会社のエージェント」という2つの製品で、同じエージェントの中でモデルだけを入れ替えた結果ではありません。FrontierCode-AA 2.0、Terminal-Bench 4.1、SWE-Atlas-QnA-AAの3つを各問3回解かせて平均したもので、内訳を見るとFrontierCodeで通った試行はSolが183/396、Carbonが166/396、Terminal-BenchではCarbonが129/198、Solが107/198です。この指標では、コードを書く課題はSol+Codex、ターミナルでの作業はCarbon+Antigravity CLIが強いという分かれ方です。Solはmaxの1段階しか測られておらず、Carbonの$7.13は11月の単価での数字です。
使える条件も違います。GeminiアプリやAntigravityでCarbonを使うにはGoogle AI Ultraの契約が必要で、利用枠は公表されていません(提供状況はGemini 4 Carbonとは:いつから使える?11月10日にAPIで一般提供)。SolはCodexとChatGPT Workでは既定のコンテキストが500Kで、サブスクリプションの利用枠の中では長文の割増がかかりません。自前のエージェントからAPI経由でSolにツールを呼ばせる場合は、Chat CompletionsではなくResponses APIを使う必要があります。
長いログ1問の実測:Carbonは費用2.6倍、highは回答なし
長いログを読ませた1問では、既定設定のGPT-6.1 Solの方が安く速く、Gemini 4 Carbonのhighは答えを返しませんでした。数え上げの問題1問だけの結果なので、長い入力全般にそのまま当てはめることはできません。使ったのは146KB・1,500行のアプリケーションログで、5種類のエラーコードそれぞれの件数、E503が出た異なるユーザーの数、再試行が最も多いリクエストIDの計7つの数を答えさせる問題です。Carbonは2026年11月11日、Solは11月16日に、どちらもLaoZhangのゲートウェイ経由で各設定1回ずつ解かせました。
| モデルと設定 | 結果 | 時間 | 出力トークン(うち思考) | 費用 |
|---|---|---|---|---|
| Sol既定 | 7つとも正解 | 45.7秒 | 2,576(2,527) | $0.1654 |
| Sol high | 7つとも正解 | 87.7秒 | 5,866(5,817) | $0.1983 |
| Carbon既定 | 7つとも正解 | 213.9秒 | 26,952(26,867) | $0.4281 |
| Carbon high | 2回とも出力上限で停止、回答なし | 507.6秒(2回目) | 思考だけで65,533(2回目) | $0.4863と$0.8140 |
既定同士では、Carbonの費用はSolの2.59倍、時間は4.68倍です。トークンの数え方の違いも費用に効いていて、同じログをCarbonは79,312、Solは55,843の入力トークンと数えました(1.42倍)。単価が同じでも、同じ文章を読ませればCarbonの入力費用は多めにかかります。なおSolの費用は、usageで入力のほぼ全量(55,840トークン)がキャッシュ書き込みとして記録されたため書き込み単価$2.50で計算したもので、通常入力の$2.00で計算すると既定は$0.1375です。
Carbonのhighは、1回目(ストリーミングなし)が思考トークン32,765で、2回目(ストリーミング、maxOutputTokensを65,536に指定)が思考トークン65,533で出力上限に達し、どちらも答えを返さないまま課金されました。2回目は、指定した出力上限65,536トークンのほぼすべてを思考に使い切って終わったことになります。
272Kトークンという線については、このテストからは何も言えません。ログはSolの数え方で55,843トークンと、しきい値よりはるかに小さいからです。料金表から言えるのは、272Kを超える入力の場合、11月30日まではCarbonの単価がSolの割増後の単価より入力で半額、出力で3分の2になり、12月1日以降は入力が同額、出力はSolの$15に対してCarbonが$20になる、ということです。
推論レベルの選び方:Solは段階で使い分け、Carbonはmedium
推論レベルは、GPT-6.1 Solは仕事の難しさに合わせて上げ下げし、Gemini 4 Carbonは既定のmediumのまま使うのが、ここまでの数字から引ける線です。ただし目盛りが違います。Carbonのthinking levelはlow・medium・highの3段階、Solのreasoning effortはlow・medium・high・xhigh・maxの5段階で、既定はどちらもmediumですが、同じ「high」が同じ強さを意味するわけではありません。
Solはレベルによる差が大きく、AAの1タスク費用はlowの$0.16からmaxの$1.27まで約8倍、点数は35点から55点まで動きます。7問の実測はmediumで全問通り、Carbonと共通の5問(区間のマージ、時間文字列、単語頻度、数式、CSV)ではhighにすると費用が$0.0252から$0.0387、時間が72.1秒から109.5秒に増えました。上げた分だけ費用と時間が増えるので、mediumで落ちる問題があればhigh、ターミナル作業の多いエージェントならxhighやmaxと、必要な分だけ上げていく使い方が合います。lowはAAのFrontierCodeが20.2%まで下がるので、コードを書かせる用途には向きません。
Carbonはレベルを下げてもあまり安くならず、上げると急に高くなります。AAの1タスク費用はlow $5.22、medium $4.68、high $5.48で、lowが最も安いわけではなく、FrontierCodeは29.6%に落ちます。同じ5問をhighにすると、費用は$0.1009から$0.6121、時間は169.7秒から614.5秒、出力は9,903から61,031トークン(うち思考58,816)に増え、正答数は5問とも変わりませんでした。この5問でSol highと比べると、Carbon highは費用15.82倍、時間5.61倍です。長いログではhighが出力上限で止まったこともあり、Carbonのhighは、mediumでは解けなかったときに出力上限を大きめに取って試すのが無難です。
応答の出だしも違います。AAの計測では、最初のトークンが返るまでSol mediumは4.81秒、Carbon mediumは20.89秒、Carbon highは73.49秒、Sol maxは166.70秒です。エディタで対話しながらコードを直す使い方では、この差がそのまま待ち時間になります。
Gemini 4 CarbonとGPT-6.1 Solのよくある質問
Gemini 4 Carbonは無料で試せますか?
2026年11月16日時点で、Gemini APIのGemini 4 CarbonにはFree tierがなく、有料ティアでの利用になります。費用を抑えて試すなら、急ぎでない呼び出しをBatchに回すと単価が半額です。APIのほかにどこで使えるかはGemini 4 Carbonとは:いつから使える?11月10日にAPIで一般提供にまとめています。
両方を同じ条件で試すにはどうすればいいですか?
公式の経路なら、Gemini 4 CarbonはGemini APIの有料ティアでgemini-4-carbonを、GPT-6.1 SolはOpenAI APIでgpt-6.1-solを指定します。キーと請求を1つにまとめたい場合は、LaoZhangのAPIキー1本で両方を呼べます(2026年11月16日時点のモデル一覧にgemini-4-carbonとgpt-6.1-solの両方があり、上の実測もこの経路です)。どちらの経路でも、自分のテストを用意して、正解したタスクあたりの費用と時間を数えると、同じ単価のモデルでどれだけ差が出るかが自分の仕事で分かります。
GPT-6.1 Solが遅いときはCarbonに替えるべきですか?
待ち時間を減らす目的なら、Gemini 4 Carbonへの切り替えは解決になりにくいです。同じ7問でも長いログでも、既定同士ではCarbonの方が長くかかりました。Solの遅さの原因と速くする設定はGPT-6.1 Solが遅いのは解消した?10月26日の実測と速くする設定で扱っています。
GPT-6.1 Solより安くしたいなら、TerraやArgonは候補になりますか?
GPT-6.1 Solの費用を下げたいなら、同じOpenAIのGPT-6.1 Terraに下げる選択肢があり、違いはGPT-6.1 TerraとSolの違い:単価は半額、Codex実測で2倍速にまとまっています。GoogleのGemini 4 ArgonをSolと比べる場合はGemini 4 Argon・Opus 5.5・GPT-6.1 Sol比較:high同士はOpusが安いが参考になります。
参考資料4
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年11月16日。
参考資料4
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年11月16日。
- 1.Artificial AnalysisのGemini 4 CarbonとGPT-6.1 Solの比較ページartificialanalysis.ai/models/releases/comparisons/gemini-4-carbon-vs-gpt-6-1-sol
- 2.Gemini APIの料金ページaistudio.google.com/docs/pricing
- 3.OpenAIのGPT-6.1 Solのモデルページdevelopers.openai.com/api/docs/models/gpt-6.1-sol
- 4.Artificial AnalysisのCoding Agent Indexartificialanalysis.ai/agents/coding-agents