Claude Fable 5.2とGemini 4 Carbon比較:12月に費用が逆転する条件
同じコーディング7問は両モデルとも全問正解。既定設定のCarbonは費用がFable 5.2の0.61倍で時間は3.3倍、12月1日の値上げ後は費用も1.22倍に逆転します。
目次
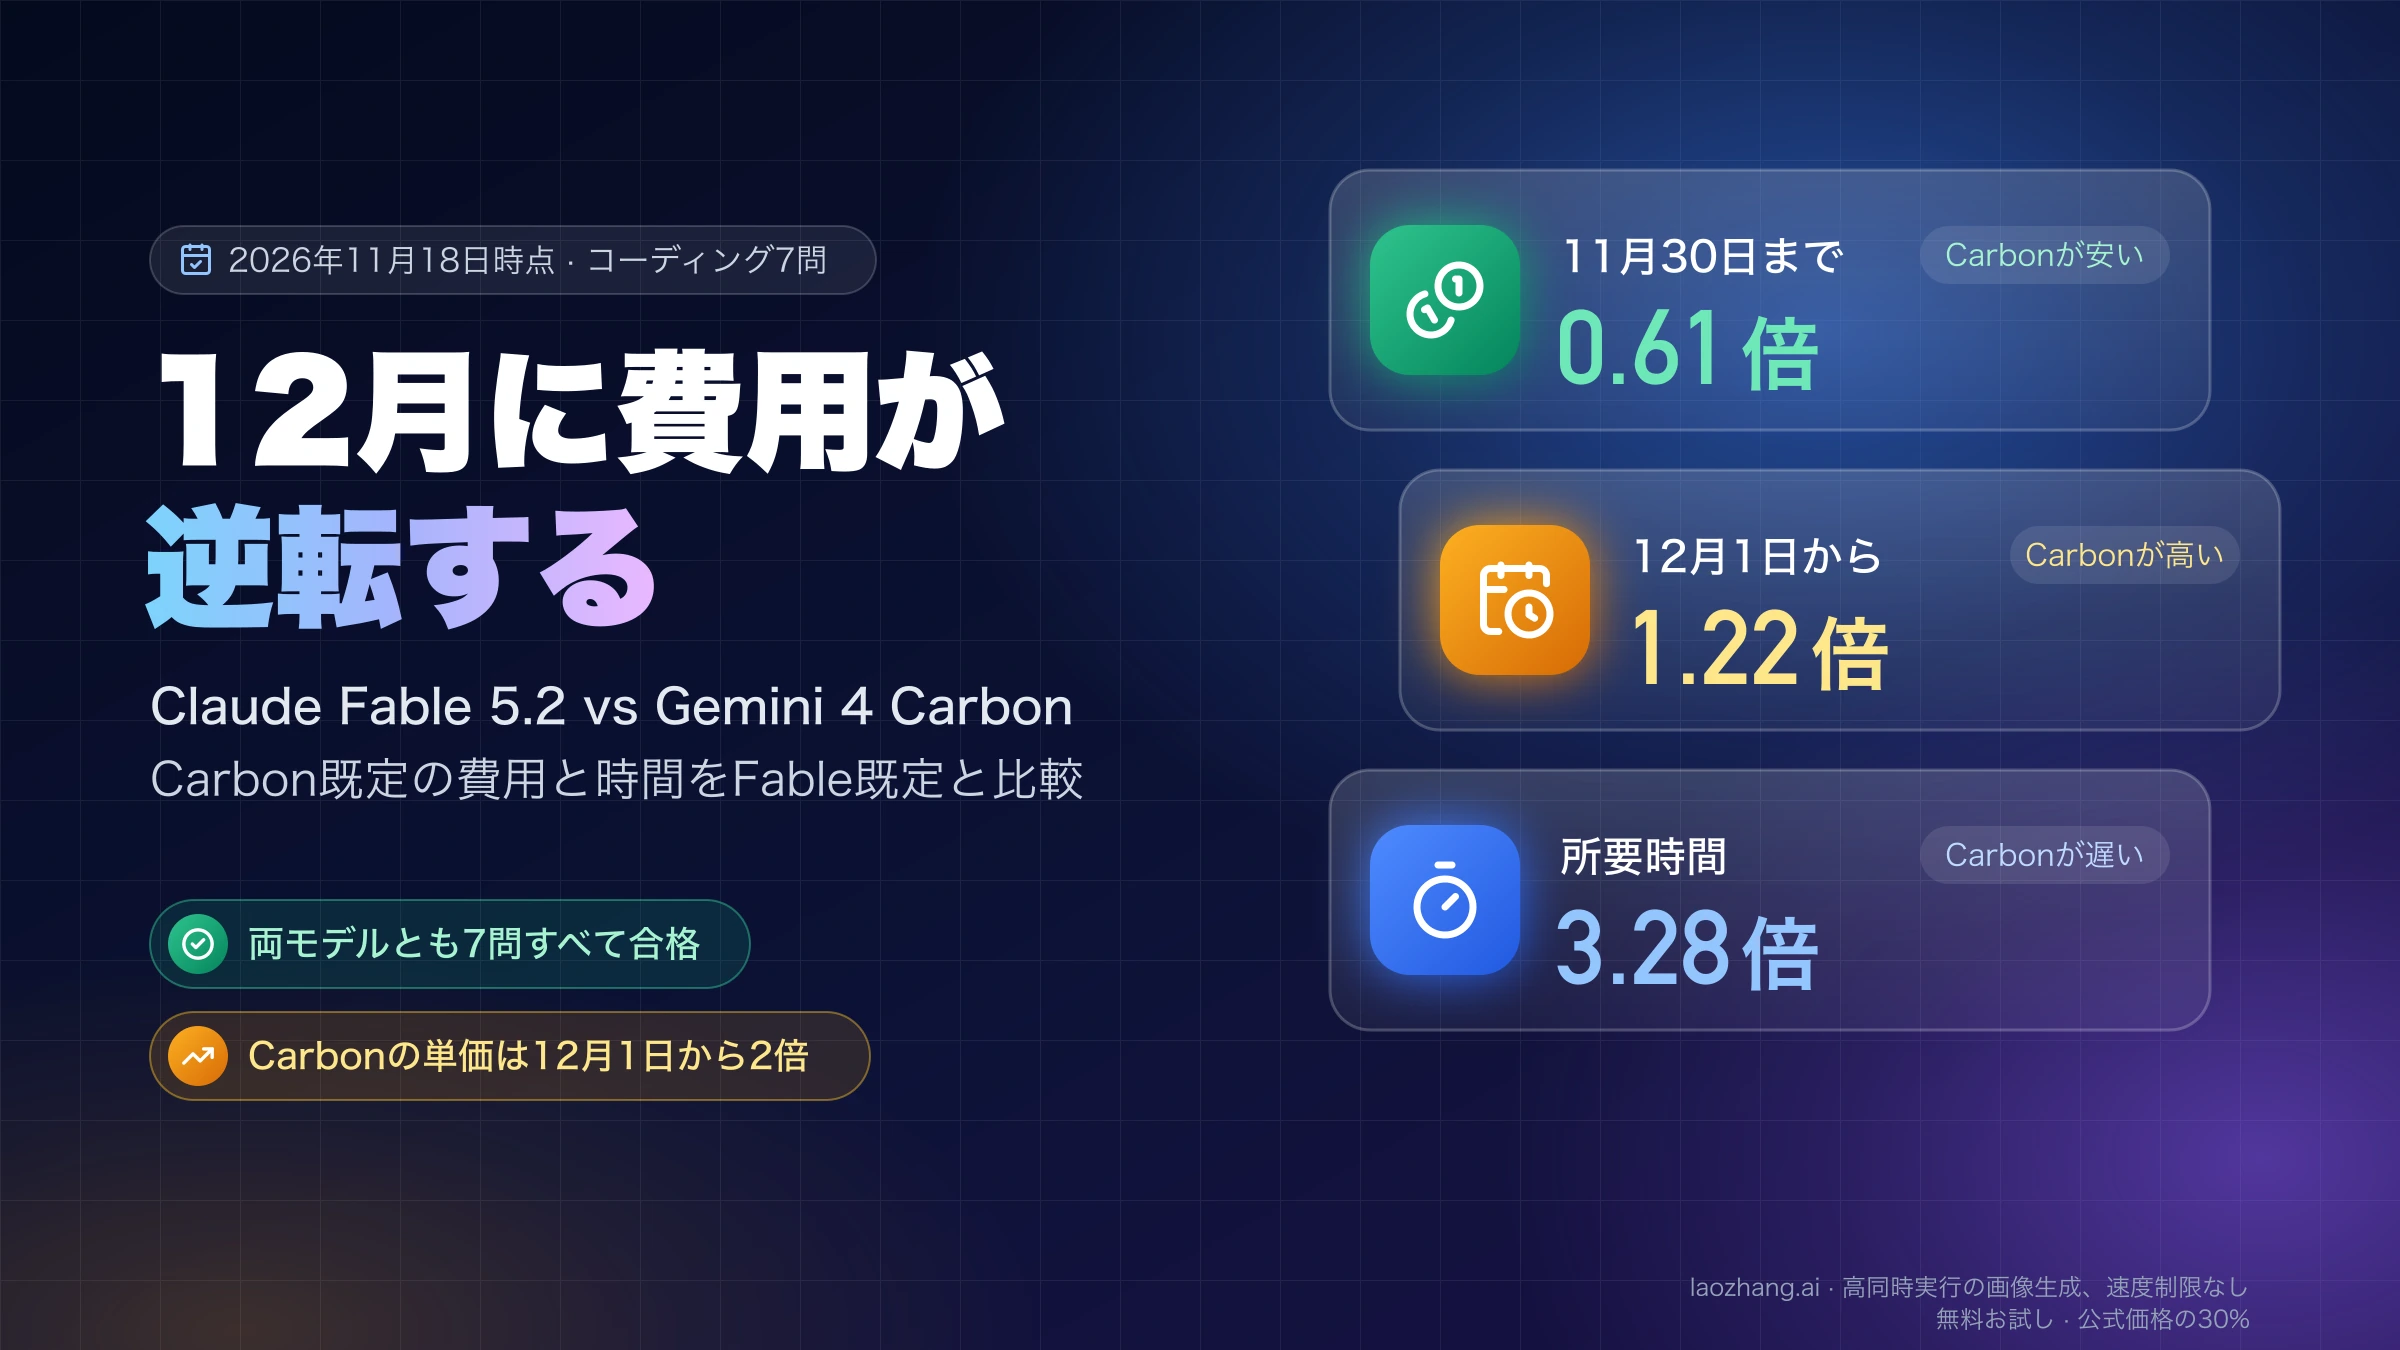
Claude Fable 5.2とGemini 4 Carbonのどちらが1タスクを安く終えられるかは、設定と日付で答えが入れ替わります。2026年11月11〜18日に隠しテスト付きのコーディング問題7問を同じプロンプトで解かせたところ、APIの既定設定(Fableはeffort high、Carbonは思考レベルmedium)ではどちらも7問すべて合格し、Carbonの費用はFableの0.61倍でした。ところが、Carbonの単価が2倍になる12月1日以降の価格で計算し直すと1.22倍に逆転し、所要時間は今の時点でもFableの3.28倍かかっています。
切り替えを決めるなら、難しいコーディング、待ち時間が気になる作業、事実の正確さが要る作業はclaude-fable-5-2をeffort mediumで使うのが費用と速さの両面で有利です。同じ7問でFable mediumの費用は12月以降のCarbon既定の約半分、時間は5分の1でした。gemini-4-carbonを既定のmediumのまま使って得をするのは、思考がほとんど要らない軽い呼び出しを大量に流す場合、長いログのように入力が費用の大半を占める場合、動画や音声を読ませる場合、そしてターミナル操作や業務自動化のように評価でCarbonが上回る作業です。
例外として、Carbonの思考レベルhighは146KBのログを読ませたテストで思考トークンを使い切り、2回とも回答を返しませんでした。また、Fable 5.2のAPIは30日間のデータ保持が前提で、CarbonはGemini APIの無料枠では使えません。これらに当てはまる場合は、費用より先に「使えるかどうか」で答えが決まります。料金とテスト結果は2026年11月18日時点のものです。
料金と仕様:Carbonの単価は11月が4分の1、12月から2分の1
100万トークンあたりの単価は、Gemini 4 Carbonが入力$2/出力$10で、Claude Fable 5.2の入力$8/出力$40のちょうど4分の1です。ただしこれは2026年11月30日までの価格で、12月1日からCarbonは2倍になり、差は2分の1に縮みます(Gemini APIの料金ページ、Anthropicの料金ページ、いずれも2026年11月18日時点)。Fable 5.2には導入価格や期間限定の割引はなく、11月9日の公開時から同じ単価です。
| 項目 | Claude Fable 5.2 | Gemini 4 Carbon |
|---|---|---|
| モデルID | claude-fable-5-2 | gemini-4-carbon |
| 提供開始 | 2026年11月9日 | 2026年11月10日(一般提供) |
| 入力/出力の単価 | $8/$40 | 11月30日まで$2/$10、12月1日から$4/$20 |
| キャッシュ読み取り | $0.20 | 11月30日まで$0.10、12月1日から$0.20 |
| キャッシュ書き込み | $10(5分)、$16(1時間) | 料金なし(暗黙のキャッシュのみ) |
| Batch API | $4/$20 | 通常の半額 |
| コンテキスト | 100万トークン | 1,048,576トークン(入力・思考・出力の合計) |
| 最大出力 | 128Kトークン | 通常の同期応答で65,536、long decodeで最大1,048,576 |
| 入力の種類 | テキスト、画像、PDF | テキスト、画像、動画、音声、PDF |
| 推論の設定 | effort:low、medium、high、xhigh、max | 思考レベル:low、medium、high |
| 既定の設定 | Claude APIはhigh、Claude Codeとアプリはmedium | medium |
| 知識のカットオフ | 2026年6月 | 2026年3月 |
仕様はAnthropicのClaude Fable 5.2の発表とモデル概要、GoogleのGemini 4 Carbonの新機能ページとモデルページによるものです。Carbonの出力単価には思考トークンも含まれ、Googleの料金ページは思考トークンを含めて処理したすべてのトークンを課金すると明記しています。Fable 5.2も適応型の思考を常に使います(オフにはできません)が、応答に思考トークンの内訳は出ないため、両モデルは出力トークンの合計で比べます。
「既定」という言葉には注意が必要です。Claude APIでeffortを省くとFable 5.2はhighで動きますが、Claude Codeとアプリの既定はmediumです。Claude Codeから使う場合は、次の節のFable mediumの行が実際の条件に近くなります。
同じコーディング7問:Carbon既定は今0.61倍、12月から1.22倍
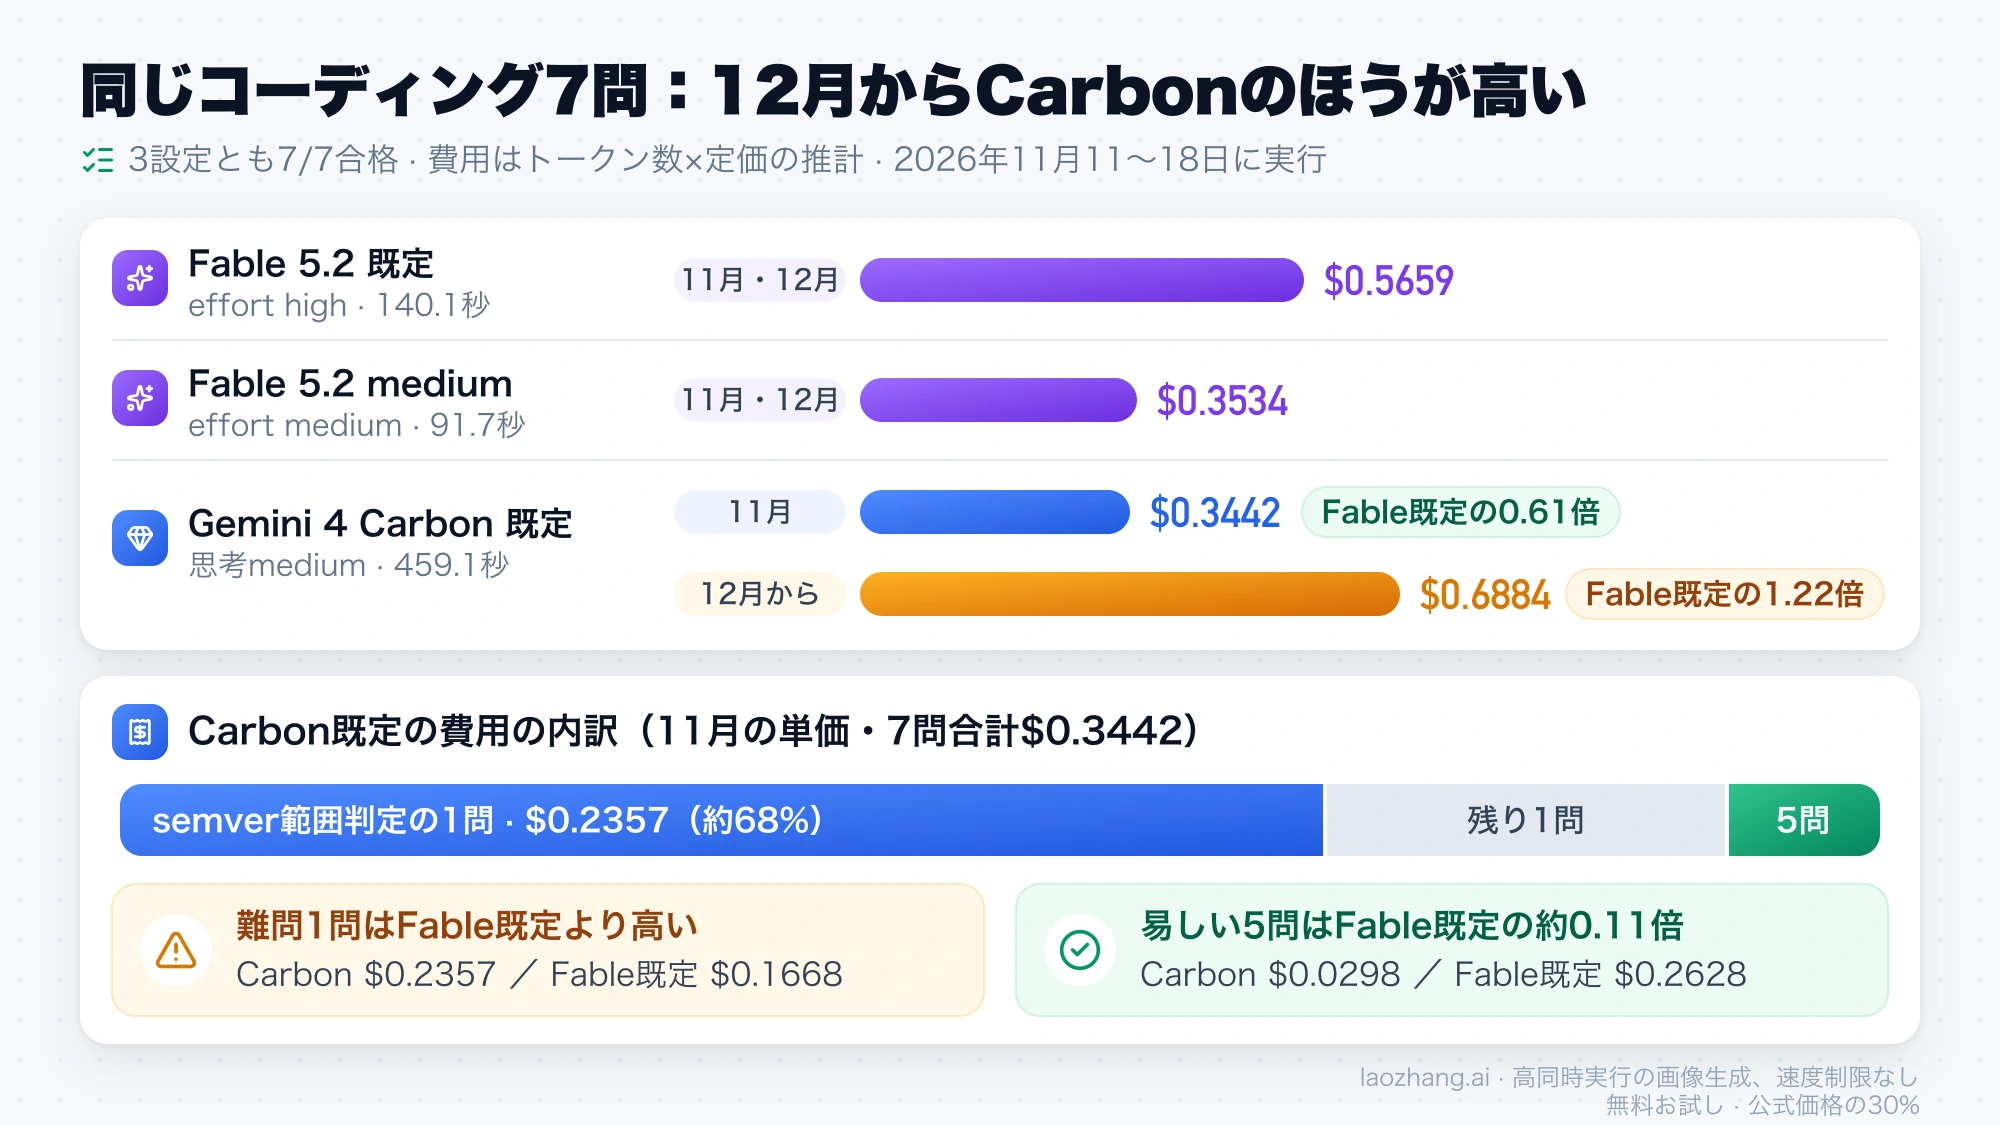
隠しテスト付きのコーディング問題7問では、3つの設定すべてが7問とも合格し、合計費用はCarbon既定が$0.3442、Fable既定が$0.5659、Fable mediumが$0.3534でした。Carbonの費用を12月1日からの単価で計算し直すと$0.6884で、Fable既定の1.22倍、Fable mediumの1.95倍になります。所要時間はCarbonが459.1秒で、Fable既定(140.1秒)の3.28倍、Fable medium(91.7秒)の5.01倍でした。
テストはすべてlaozhang.aiのAPIゲートウェイを経由し、各社のネイティブAPI形式(AnthropicのMessages API、GoogleのgenerateContent)で呼び出したものです。ゲートウェイにはclaude-fable-5-2が2026年11月10日から、gemini-4-carbonが11月11日から登録されており、集計したすべての応答が要求どおりのモデル名を返しています。Fable既定はeffortを指定しない呼び出し(APIの既定でhigh)、Fable mediumはoutput_config.effortにmediumを指定した呼び出し、Carbon既定は思考レベルを指定しない呼び出し(既定でmedium)です。7問のうち5問は2026年11月11日に両モデルで実行し、semver関連の2問はCarbonを11月16日、Fableを11月18日に実行しました。費用は応答に含まれるトークン数に定価を掛けた推計で、請求額ではありません。Carbonの12月の値は同じトークン数に12月からの単価を掛けたもの、つまり11月の値のちょうど2倍です。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
| 設定 | 合格 | 出力トークン | 所要時間 | 費用(11月の単価) | 費用(12月1日からの単価) |
|---|---|---|---|---|---|
| Fable 5.2(既定、effort high) | 7/7 | 13,720 | 140.1秒 | $0.5659 | $0.5659 |
| Fable 5.2(medium) | 7/7 | 8,406 | 91.7秒 | $0.3534 | $0.3534 |
| Gemini 4 Carbon(既定、思考medium) | 7/7 | 34,088 | 459.1秒 | $0.3442 | $0.6884 |
7問は、区間の結合、時間表記の解析、頻出語の集計、式の評価(隠しテスト25件)、CSV行の解析(16件)、semverの大小比較(30件)、npm形式のsemver範囲判定(36件)です。Carbonの費用は難しい1問に集中しました。npm形式の範囲判定ではCarbonが23,481出力トークン(うち思考22,138)、284.0秒、$0.2357を使い、Fable既定の4,036トークン、37.0秒、$0.1668を11月の単価でも上回っています。この1問だけでCarbonの7問合計の約68%です。反対に、区間の結合、時間表記、頻出語、CSV行、semver比較の易しい5問では、Carbonの合計は$0.0298でFable既定($0.2628)の約0.11倍、12月の単価でも約0.23倍でした。5問のうち4問でCarbonの思考トークンは0です。
Carbonの思考量は、同じ問題でも呼び出しごとに大きく変わります。semverの大小比較を同じゲートウェイ経由で2回解かせると、11月16日の1回目は思考0トークン、5.4秒、$0.0076、11月18日の2回目は思考1,414トークン、38.9秒、$0.0216で、どちらも合格でした。費用が3倍近く振れるため、Carbonで予算を組むときは1回の計測値をそのまま掛け算せず、余裕を見ておく必要があります。どのセルも1回(この問題だけ2回)の実行なので、上の倍率は傾向を示すもので、毎回この比率になるわけではありません。
混合11問:既定同士なら12月以降もCarbonが安い
計算問題やコード、要約を混ぜた11回答のセットでは、既定設定同士で比べるかぎり、12月1日以降もCarbonのほうが安く済みました。2026年11月11日に同じゲートウェイ経由で実行し、全設定が11問すべて正解しています。Carbon既定の費用は$0.2937、12月の単価で$0.5874で、Fable既定($0.7436)の0.79倍です。ただし相手をFable mediumやlowにすると、12月以降はCarbonのほうが高くなります。
内容は、料金の文章題、小さなPython関数3つ、6,723語の英文記事の5項目要約、式の評価、CSV行の解析、数え上げ問題で、最後の3問は2回ずつ解かせました。
| 設定 | 出力トークン | 所要時間 | 費用(11月の単価) | 費用(12月1日からの単価) | Carbon÷Fable(11月/12月) |
|---|---|---|---|---|---|
| Fable 5.2(既定、effort high) | 15,151 | 173.2秒 | $0.7436 | $0.7436 | 0.39倍/0.79倍 |
| Fable 5.2(medium) | 9,317 | 122.3秒 | $0.5103 | $0.5103 | 0.58倍/1.15倍 |
| Fable 5.2(low) | 7,063 | 96.8秒 | $0.4201 | $0.4201 | 0.70倍/1.40倍 |
| Gemini 4 Carbon(既定、思考medium) | 26,826(うち思考21,348) | 405.4秒 | $0.2937 | $0.5874 | 比較の基準 |
7問のセットと結論が違うのは、このセットにsemver範囲判定のような、Carbonが2万トークン以上考え込む問題が含まれていないためです。Carbonは出力26,826トークンのうち約8割を思考に使っていますが、単価の安さがそれを上回りました。Claude Codeの既定であるmediumと比べると、12月以降はこのセットでもCarbonが1.15倍になります。時間はどの組み合わせでもCarbonが長く、Fable既定の2.34倍、mediumの3.31倍、lowの4.19倍でした。
146KBのログ:Carbonのhighは思考を使い切って回答なし
1,500行・146KBのアプリケーションログから7種類のイベント数を数えさせる長い入力のテスト(2026年11月11日、同じゲートウェイ経由)では、Fable既定、Fable medium、Carbon既定の3つがすべて正しい数を答えました。費用はCarbon既定が$0.4281(12月の単価で$0.8562)、Fable mediumが$0.9545、Fable既定が$1.02で、入力が費用の大半を占めるこの作業では12月以降もCarbonが安いままです。一方、時間はCarbonが213.9秒、Fable mediumが63.5秒、Fable既定が73.7秒でした。
Fable既定の$1.02の内訳は、入力78,537トークン×$8で約$0.63、出力9,792トークン×$40で約$0.39です。Carbonは入力79,312トークンで約$0.16、出力26,952トークン(うち思考26,867)で約$0.27でした。入力単価の差がそのまま効くため、ログのような長い入力ではCarbonの単価の安さが活きます。
問題はCarbonの思考レベルをhighに上げたときです。非ストリーミングの呼び出しでは思考トークンが32,765に達した時点で上限(MAX_TOKENS)に当たり、回答なしで終わりました(276.9秒、$0.4863)。ストリーミングでmaxOutputTokensを65,536に広げても思考に65,533トークンを使い切り、やはり回答はありませんでした(507.6秒、$0.8140)。回答がなくても課金されるため、2回の失敗で$1.30、12月の単価なら$2.60です。それぞれ1回ずつの結果で、highが常に失敗するという意味ではありませんが、長い入力でhighを使うなら、応答の終了理由がMAX_TOKENSになっていないかを必ず確認してください。
同じ点数の設定同士:11月にCarbonが安いのはhighだけ
第三者機関Artificial Analysis(AA)のIntelligence Index v5.0.1で点数の近い設定同士を比べると、タスク1件の費用と時間はほとんどの組み合わせでFable 5.2のほうが低くなります。Carbonが安いのはCarbon high(60点、$5.48)とFable high(62点、$9.08)の組み合わせだけで、その場合もFableが2点高く、時間は14.8分対33.2分です。数値は2026年11月18日時点のAAによるFable 5.2とCarbonの比較ページによるもので、AAはCarbonの費用を11月30日までの単価で計算しています。
| モデルと設定 | 指数の点数 | 費用/タスク | 時間/タスク | 最初の回答トークンまで | 出力速度 |
|---|---|---|---|---|---|
| Fable 5.2 max | 65 | $26.54 | 40.7分 | 214.95秒 | 112トークン/秒 |
| Fable 5.2 xhigh | 62 | $14.83 | 23.8分 | 54.32秒 | 113トークン/秒 |
| Fable 5.2 high | 62 | $9.08 | 14.8分 | 23.90秒 | 110トークン/秒 |
| Fable 5.2 medium | 56 | $3.80 | 6.4分 | 9.87秒 | 113トークン/秒 |
| Fable 5.2 low | 54 | $3.10 | 5.3分 | 7.17秒 | 112トークン/秒 |
| Gemini 4 Carbon high | 60 | $5.48 | 33.2分 | 73.37秒 | 62トークン/秒 |
| Gemini 4 Carbon medium | 58 | $4.68 | 29.3分 | 27.41秒 | 59トークン/秒 |
| Gemini 4 Carbon low | 54 | $5.22 | 29.6分 | 8.65秒 | 49トークン/秒 |
AAの指数は、後の節で触れるTerminal-Bench 4.0やFrontierCode-AAを含む9種類の評価の総合点で、費用と時間は指数のタスク1件あたりの値です。同じ54点ならFable lowは$3.10・5.3分、Carbon lowは$5.22・29.6分です。Carbon medium(58点)とFable medium(56点)では、Carbonが2点上回るかわりに費用は$4.68対$3.80、時間は約4.6倍かかります。Carbonはlowにしても安くならず、mediumより費用が高くなっています。
12月1日以降の値はAAがまだ公開していないため、幅で見積もるしかありません。現在の計測のトークン量のまま単価だけ2倍にすると、Carbonはhighで約$10.96、mediumで約$9.36、lowで約$10.44です。一方、AAは11月11日の時点でCarbonを12月以降の単価で計算しており、そのときの値はhighが$7.76、mediumが$6.59、lowが$7.19でした。2回の計測でトークン量が変わっているため、12月のCarbon highは約$7.76〜$10.96の幅で読むのが妥当で、この幅がFable highの値をはさむため、high同士はどちらが安いか決まりません。mediumとlowは、どちらの読み方でもFableのほうが安いままです。AAの数値は再計測で動くので、日付の違う数字を並べるときは価格の基準を確かめてください。
コーディングはどちらが上か:小問題は互角、アプリ構築はFable
仕様のはっきりした小さなコーディング問題では、両モデルの正解率に差は出ませんでした。上の7問と11問はどの設定でも全問合格です。差が出るのは課題が大きく難しくなったときで、第三者とAnthropic自身の評価はどちらもFable 5.2を上に置いています。ただし、ターミナル操作を伴うエージェント作業ではCarbonが上回る評価もあります。
AAの評価(2026年11月18日時点、各モデルの最も良い設定)では、FrontierCode-AA 2.0がFable 49.1%対Carbon 40.6%、エンジニアリング分野の小計が73対65でFableが上です。Anthropicが発表時に出した表でも、FrontierSWE v2はFable 69.9%対Carbon 61.2%でした。これはAnthropicが自社の環境で測った数字で、FrontierCodeのようにFableはxhigh、Carbonはmediumと設定がそろっていない項目もあります。
アプリを丸ごと作らせる別の層の比較では、差がもっと大きく出ています。MindStudioのFable 5.2とCarbonの比較記事(2026年11月12日)は、エミュレーターやDocker代替など6つのアプリを1つのプロンプトから作らせるKing Bench 4で、Claude Codeで動かしたFableが70%、Open CodeでVertex経由・高い推論設定で動かしたCarbonが53.3%だったと報告しています。6本の合計は定価でCarbonが約$203、Fableが約$222と大差なく、1本あたりの時間は、Carbonが6本中5本をたいてい34〜44分で仕上げたのに対し、Fableは60〜95分でした。同じ記事は、Carbonの最終報告が6本すべてで、動いていない機能を少なくとも1つ「動作する」と書いていたことも指摘しています。
完了報告をそのまま信じられるかどうかは、知識の正確さとも関係します。存在しないPythonの標準ライブラリ関数2つについて同じゲートウェイ経由で尋ねると、11月16日のCarbon(思考0トークン)はstatistics.winsorized_meanを実在するかのように説明し、11月18日のCarbonは2つとも存在しないと答えました。Fable 5.2は11月18日の既定・mediumとも、存在しないと正しく答えています。2回の結果は誤答率を示すものではありませんが、より大きな測定であるAAのAA-Omniscience(知識と誤答の評価)でもFableが67対54で上です。Carbonでエージェントを動かすなら、完了報告ではなくテストの実行結果で確かめる運用が安全です。
Carbonが強い仕事:ターミナル操作、業務自動化、動画入力
Gemini 4 Carbonが上回るのは、ターミナル操作と業務自動化の評価、PDF資料を読んで答えるAAのGDP.pdfという評価、そして動画や音声をそのまま入力できる点です。AAの評価(2026年11月18日時点、各モデルの最も良い設定)では、Terminal-Bench 4.0がCarbon high 65.2%対Fable xhigh 61.6%、AutomationBench-AAが77.8%対76.4%、GDP.pdfがCarbon medium 29.6%対24.2%でした。Anthropic自身の発表表でも、AutomationBenchだけはCarbon(53.9%)がFable(51.4%)を上回っています。
ただし差は1.4〜5.4ポイントと小さく、Fableが上回る項目のほうが多数です。AAではAA-Briefcase v1.1(Elo 1785対1611)、HLE-Diamond(80.2%対69.1%)、CritPt v2 hard(76.5%対69.0%)、Terminal-Bench-Science(73.3%対64.8%)でFableがはっきり上でした。ターミナル操作や業務自動化をCarbon highに任せる場合も、前の節で見たとおり12月以降はFable highと同程度かそれ以上の費用になりうるため、費用面の優位が確実なのは11月中だけです。
モデルの仕様で差がはっきりしているのは入力の種類です。テキスト、画像、PDFはどちらも受け取れますが、動画と音声を直接入力できるのはCarbonだけです。会議の録音や画面録画を読ませる作業は、比較するまでもなくCarbonの領域です。長い出力も、Carbonはバックグラウンド実行のlong decodeで最大1,048,576トークンまで出せるのに対し、Fableの上限は128Kトークンです。Google自身は、Carbonを複雑な原因調査のデバッグ、設計、マルチモーダルな情報の統合、科学的な証明、セキュリティ監査に使うよう勧めています。
速さの差:Carbonは1タスクにFableの2〜5倍の時間
Carbonは1タスクを終えるまでに、比べるFableの設定によって約2〜5倍の時間がかかります。上のテストでは、コーディング7問で3〜5倍、混合11問で2.34〜4.19倍、ログで2.90〜3.37倍でした(いずれもゲートウェイ経由の実時間で、ネットワークの往復を含みます)。
AAの計測でも同じ傾向で、タスク1件あたりCarbon mediumは29.3分かかり、Fable high(14.8分)の約2倍、Fable medium(6.4分)の約4.6倍です。Fableの出力速度は毎秒110〜113トークン、Carbonは49〜62トークンで、Carbonは出力トークン自体も多いため、時間の差が広がります。最初の回答トークンまでの時間は、lowならCarbon 8.65秒とFable 7.17秒で大差ありませんが、mediumではCarbon 27.41秒に対しFable 9.87秒です。人が待ちながら何度もやり取りする作業ではFable、夜間のバッチ処理のように待ち時間が問題にならない作業ならCarbonの遅さは気にならない、という分け方が現実的です。
日本語の入力はFableで1.60倍のトークンになる
同じ日本語の文章を送ると、課金される入力トークンはFable 5.2が346、Carbonが216で、Fableが1.60倍でした(1行の指示を含むリクエスト全体。Fableは2026年11月18日、Carbonは11月11日に同じゲートウェイ経由で計測)。単価の差に掛け合わせると、日本語の入力にかかる費用はFableがCarbonの約6.4倍(11月、4倍×1.60)、12月以降は約3.2倍(2倍×1.60)になります。
この倍率は言語と入力の種類で変わります。同じ内容の文章で、英語は1.27倍、中国語とロシア語は1.51倍、スペイン語は1.68倍、韓国語は1.94倍でした。6,723語の英文記事では15,335対11,110トークン(1.38倍)、146KBのログでは78,537対79,312トークン(0.99倍)で、記号や数字の多いログではほぼ同じです。日本語の文章を大量に読ませる用途では、単価表から想像するよりFableの入力費用が膨らむと考えてください。各言語とも短い文章1つでの計測で、出力トークンは言語よりも作業の内容で決まります。
作業タイプ別の選び方:モデルとeffort・思考レベル
迷ったらFable 5.2をeffort mediumで始め、Carbonは安さと遅さを受け入れられる作業に絞るのが、上の結果から見た現実的な選び方です。Fable mediumはコーディング7問で既定(high)の約0.62倍の費用、約0.65倍の時間で同じく全問合格しており、Claude APIではeffortを明示しないとhighになる点に注意してください。
| 作業のタイプ | 11月30日まで | 12月1日から | 判断の根拠 |
|---|---|---|---|
| 思考の要らない軽い呼び出しを大量に流す | Carbon既定(medium) | Carbon既定のまま | 易しい5問で12月の単価でもFable既定の約0.23倍。待てない用途ならFable low |
| 難しいコーディング、仕様の多い実装 | Fable medium、足りなければhigh | Fable medium、足りなければhigh | 難問1問でCarbonは11月の単価でも高く、アプリ構築の評価もFableが上 |
| ログや大きなファイルなど長い入力 | Carbon既定(highは避ける) | 費用優先ならCarbon既定、速さ優先ならFable medium | 入力単価の差が効く。Carbon highは回答なしで終わった |
| ターミナル操作・業務自動化のエージェント | Carbon highも候補 | Fable highと費用・時間を比べて選ぶ | Terminal-Bench 4.0とAutomationBench-AAはCarbonが上、差は小さい |
| 動画・音声を入力する | Carbon | Carbon | Fableは動画・音声の入力に対応していない |
| 知識の正確さ、事実確認が要る作業 | Fable medium以上 | Fable medium以上 | AA-OmniscienceでFableが上 |
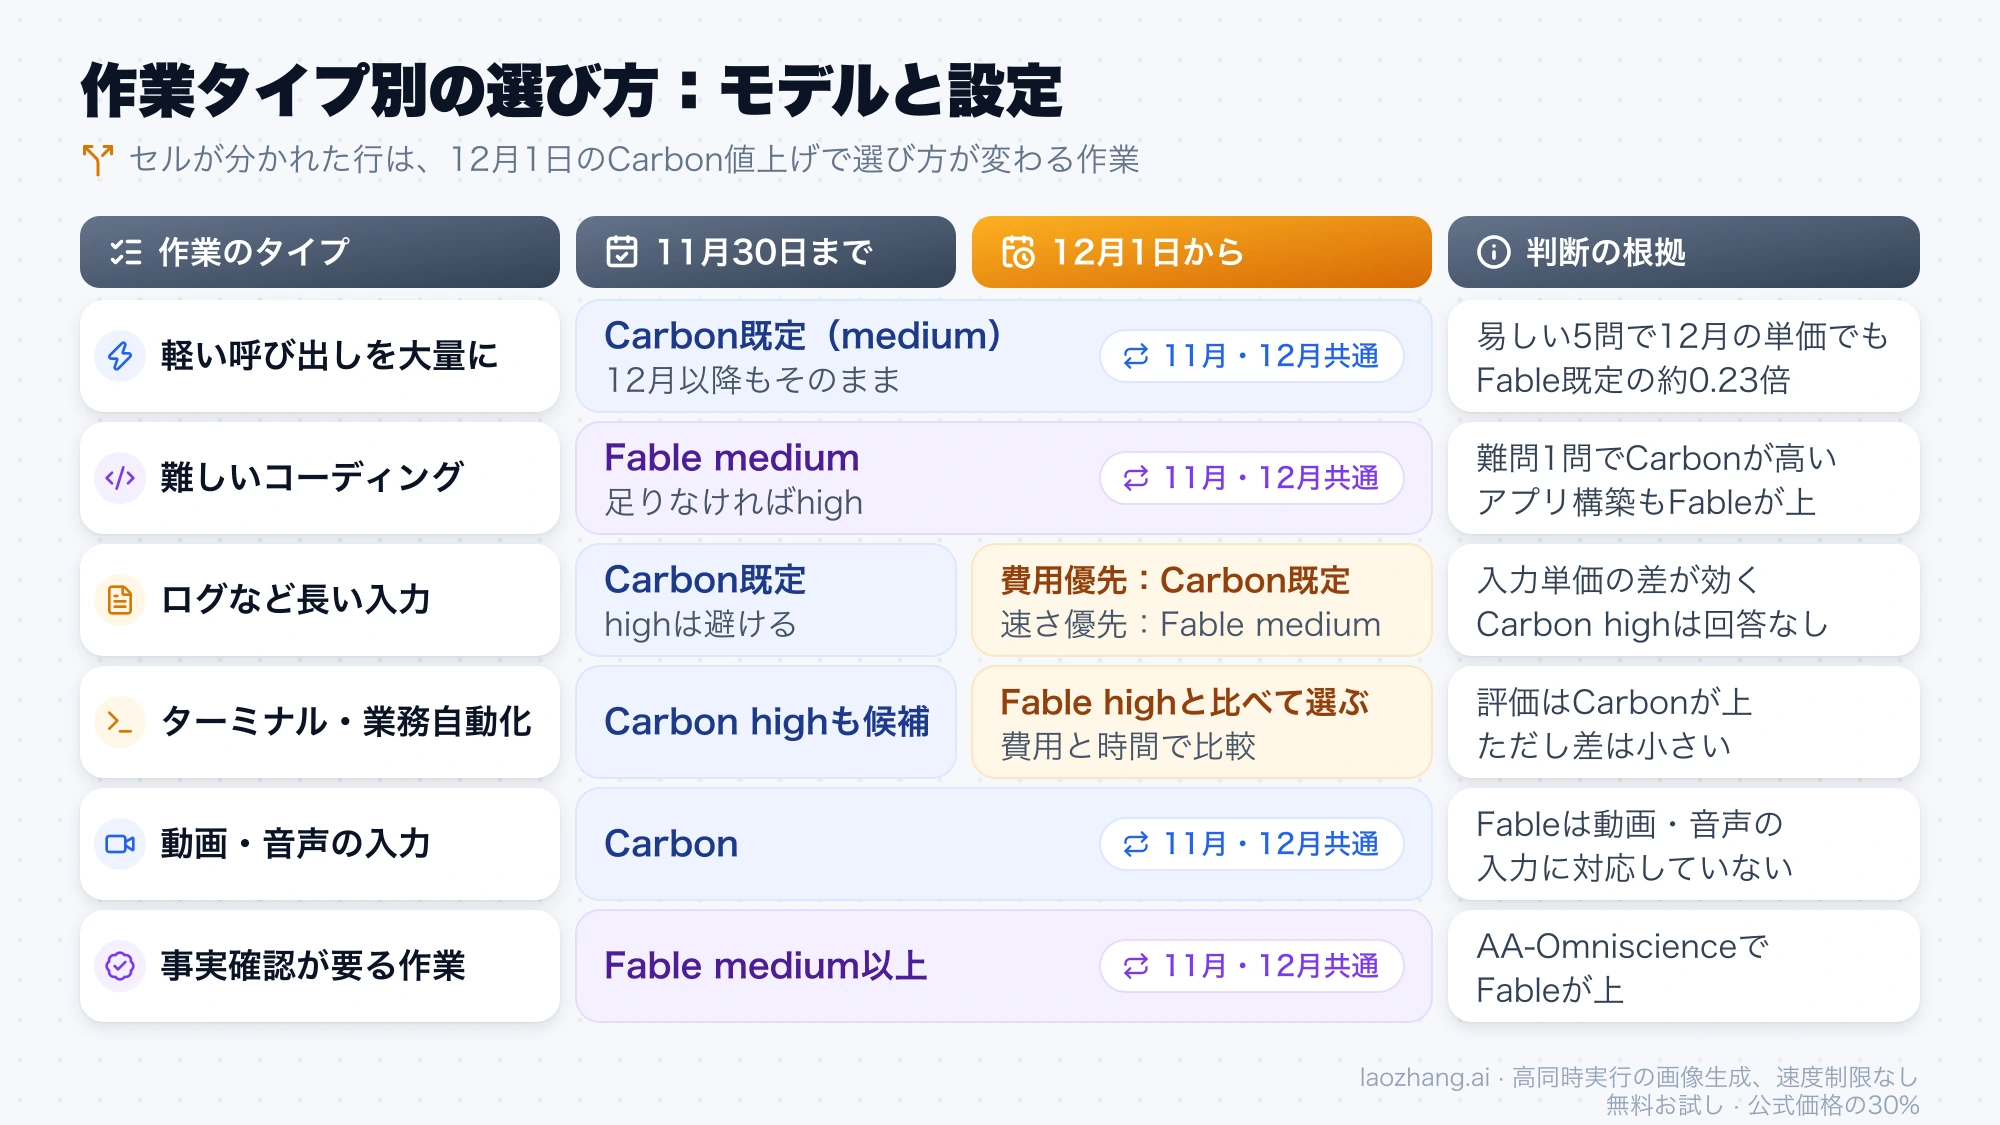
effortと思考レベルは、上げれば良くなるとは限りません。Fableのxhighとmaxは指数の点数が62と65に上がるかわりに、AAのタスク1件あたりの費用は$14.83と$26.54まで増えるため、最高点そのものが必要な作業に限るのが妥当です。Carbonはlowにしても費用が下がらず、highは長い入力で思考を使い切ることがあったので、まずは既定のmediumで自分のタスクを測るのが近道です。Batch APIはどちらも通常の半額なので、バッチに回しても両モデルの比率は変わりません。
切り替えを止める条件:データ保持、プラン、地域、安全フィルター
費用より先に確認したいのは、そもそもその環境で使えるかどうかです。Fable 5.2のClaude APIは30日間のデータ保持が前提で、ゼロデータ保持(ZDR)の組織が呼び出すと、個別に許可を受けていない限り400エラーになります。安全分類器は、侵入テスト、エクスプロイトの作成、バイナリの脆弱性調査といった高リスクのサイバーセキュリティ作業と、研究目的の生物学の多くを拒否し、代わりにOpus 4.8(サイバー)またはOpus 5(生物学)が応答します。tool_choiceでanyやtoolを強制すると400が返り、レート制限もOpus 5.5より低い別枠です。
Claudeのサブスクリプションでは、Fable 5.2は無料プラン以外のすべての有料プランで使えます。MaxとUltra、プレミアムシートは週の利用上限の50%までFableを含み、Proと標準のTeamシートは最初のリクエストから利用クレジットで支払います。ProとTeamでFableが含まれていた公開記念の週は、2026年11月16日(太平洋時間)で終わっています。
Gemini 4 Carbonは、Gemini APIの有料枠でしか使えません。Google AI StudioではAI Ultraプランが必要で、無料プランとAI Proプランでは選べず、Geminiアプリ、AI Mode、Google AntigravityでもGoogle AI Ultraの契約者から順次提供されています。Ultraでの利用上限は公開されていません。Gemini APIはロシア、ベラルーシ、中国本土、香港では提供されていない点も、海外拠点を含むチームでは確認が必要です。セキュリティ用途では、Googleが防御側の組織向けに許可制の「Gemini 4 Carbon for cyber」を別に用意しています。
Fable 5.2とGemini 4 Carbonのよくある質問
Gemini 4 Carbonはいつから使えますか?
Gemini 4 Carbonは2026年11月10日にGemini APIで一般提供が始まり、モデルIDはgemini-4-carbonです。それ以降、2026年11月18日時点までにCarbonの新しい版はGoogleの変更履歴に出ていません。提供範囲と性能の概要は「Gemini 4 Carbonとは:いつから使える?11月10日にAPIで一般提供」で確認できます。
Gemini 4 CarbonとArgonの違いは何ですか?
Googleは、CarbonはArgonより1ターンあたりの思考トークンが多く、そのぶん費用と待ち時間が増えると説明しており、大半のソフトウェア開発と知的作業にはArgonを勧めています(2026年11月時点の公式ドキュメント)。性能と費用の具体的な差は「Gemini 4 Carbon vs Argon:性能と料金、同じ正解数で費用約3倍」にあります。
Fable 5.2より性能が上のモデルはありますか?
Anthropicのモデルでは、Fable 5.2と同じモデルの安全対策を緩めたClaude Mythos 5.2がありますが、審査を受けた組織だけが対象です。費用を下げたい場合のOpus 5.5との比較は「Claude Fable 5.2とOpus 5.5の違い:同じ正解数で費用1.86倍」、OpenAIのモデルとの比較は「GPT-6.2 Astra・GPT-6 AstraとClaude Fable 5.2比較:同定価で費用差」と「Gemini 4 Argon・Fable 5.2・GPT-6 Astra比較:highのArgonは割高」で扱っています。
Gemini 4 CarbonはOpus 5.5やGPT-6.1 Solと比べてどうですか?
同じコーディング問題での比較は「Gemini 4 CarbonとOpus 5.5比較:Opusが上の仕事と費用の逆転条件」と「Gemini 4 CarbonとGPT-6.1 Sol比較:コーディング費用はCarbonが7倍」にあります。どちらもAAの2026年11月11日時点の数値(Carbonは12月以降の単価で計算)を使っているため、11月18日時点のAAの数値とは価格の基準が違います。
Fable 5.2をAPIで使うには何が必要ですか?
Fable 5.2はClaude APIのモデルIDclaude-fable-5-2で呼び出し、専用のAPIキーは要りません。呼び出しが通らないときの原因と設定は「Claude Fable 5.2 APIの使い方:専用キー不要、通らない時の原因」で確認できます。
参考資料6
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年11月18日。
参考資料6
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年11月18日。
- 1.Gemini APIの料金ページaistudio.google.com/docs/pricing
- 2.Anthropicの料金ページanthropic.com/pricing
- 3.Claude Fable 5.2の発表anthropic.com/claude-fable-and-mythos-5-2
- 4.Gemini 4 Carbonの新機能ページaistudio.google.com/docs/whats-new-gemini-4-carbon
- 5.AAによるFable 5.2とCarbonの比較ページartificialanalysis.ai/models/releases/comparisons/claude-fable-5-2-vs-gemini-4-carbon
- 6.MindStudioのFable 5.2とCarbonの比較記事mindstudio.ai/blog/gemini-4-carbon-vs-claude-fable-5-2