Gemini 3.8 FlashとClaude Fable 5.1を比較:先に試すモデルの決め方
大量処理や費用を優先するならGeminiを先に、高価な失敗を減らせるか確かめたいならFableを挑戦候補にします。単価表ではなく、採用できた成果一件あたりの費用で判断します。
目次
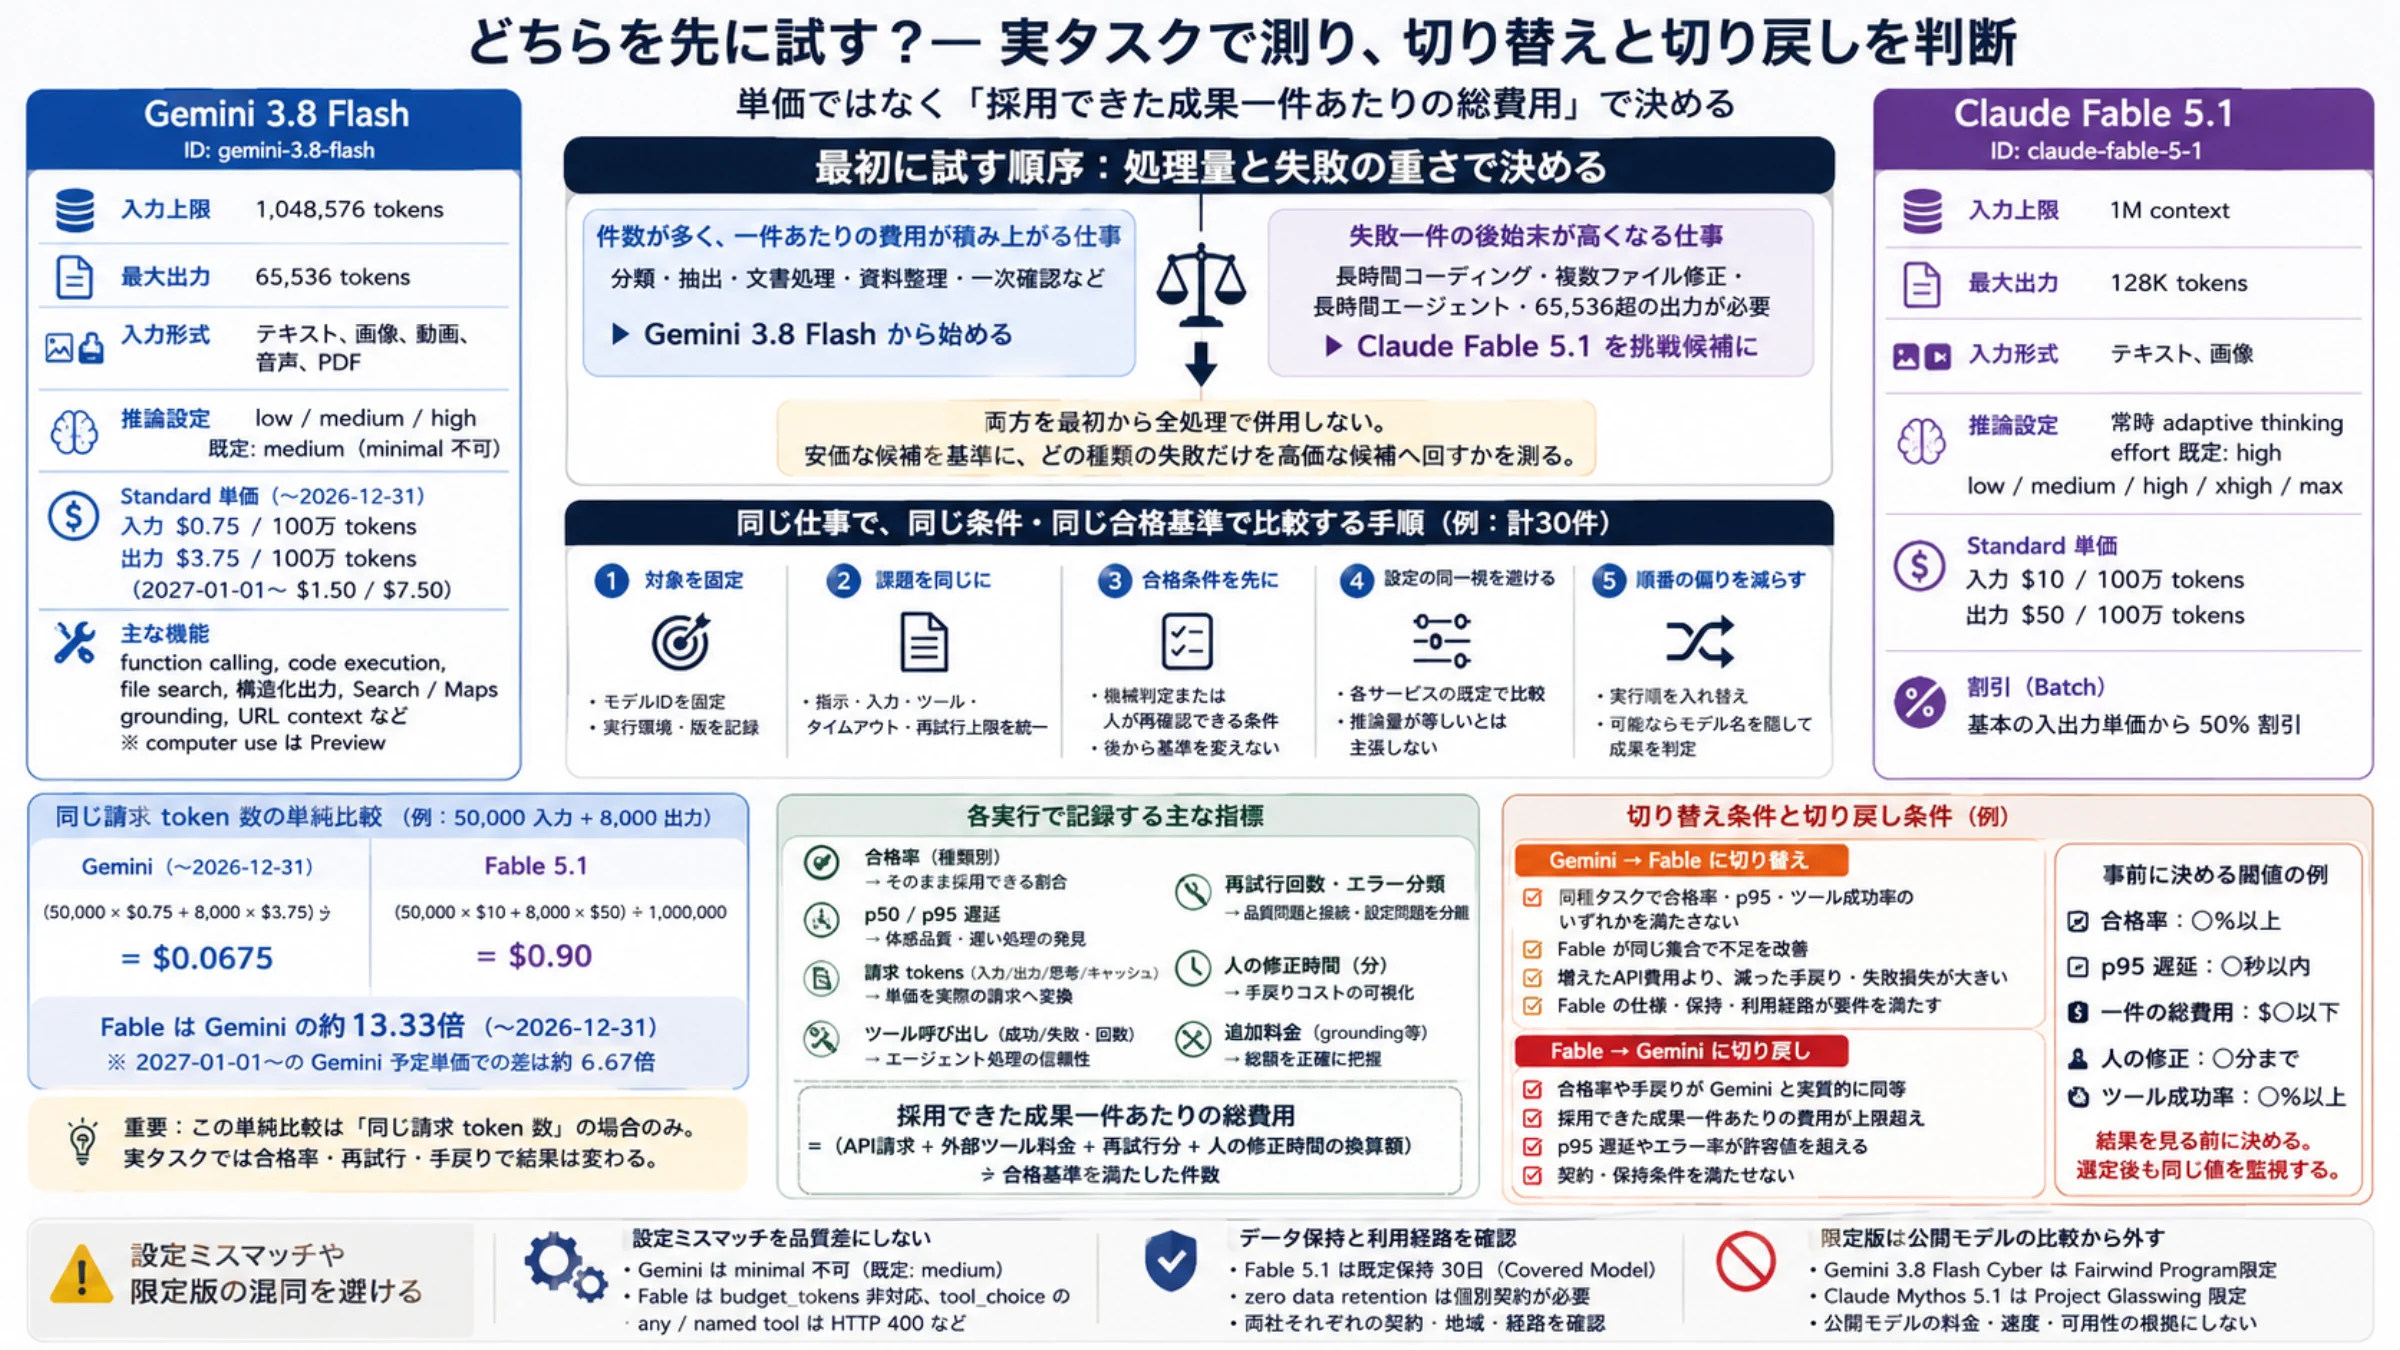
2026年9月4日時点で、Gemini 3.8 Flash と Claude Fable 5.1 のどちらを先に試すべきか。単価と処理量が主な制約なら、まず Gemini 3.8 Flash を評価するのが合理的です。公式の入出力単価が大幅に低く、モデル仕様ではテキスト以外に動画、音声、PDF も直接入力できます。
一方、長時間続くコーディングや複雑なエージェント処理で、一度の失敗が大きな手戻りにつながるなら、Claude Fable 5.1 を高価格帯の挑戦候補にします。ただし、Anthropic のモデル概要も大半の処理は Opus 5 から始め、評価で足りない場合に Fable へ上げるよう案内しています。Fable は、名前だけで常時選ぶモデルではありません。
公開仕様だけでは、品質、速度、長時間処理の安定性の勝者は決まりません。決められるのは、最初に試す順序と、同じ仕事で何を測るかです。最終判断には「安い一回」ではなく、修正せず採用できた成果一件あたりの費用を使います。
最初に試す順序は、処理量と失敗の重さで決める
Gemini 3.8 Flash から始めやすいのは、分類、抽出、文書処理、調査用の資料整理、コードの一次確認など、件数が多く、一件ごとの費用が積み上がる仕事です。動画や音声、PDF をモデルへ直接渡す必要がある場合も、入力形式の違いだけで Gemini が先になります。
Fable 5.1 を早い段階で試す意味があるのは、複数ファイルにまたがる修正、長時間のツール実行、途中の判断を保ったまま進めるエージェント処理など、誤りの後始末が API 料金より高くなる仕事です。また、一回の応答で 65,536 tokens を超える出力が本当に必要なら、Gemini の公称上限を超えるため、最大出力が 128K の Fableだけが候補に残ります。
この二つを最初から全処理で併用する必要はありません。まず安価な候補を基準にし、どの種類の失敗だけを高価な候補へ回すかを測るほうが、請求と運用を説明しやすくなります。逆に、すでに Fable を使っている場合は、高頻度で失敗リスクの低い処理を Gemini へ戻せるかを同じ方法で確かめます。
100万トークン級でも、交換条件は同じではない
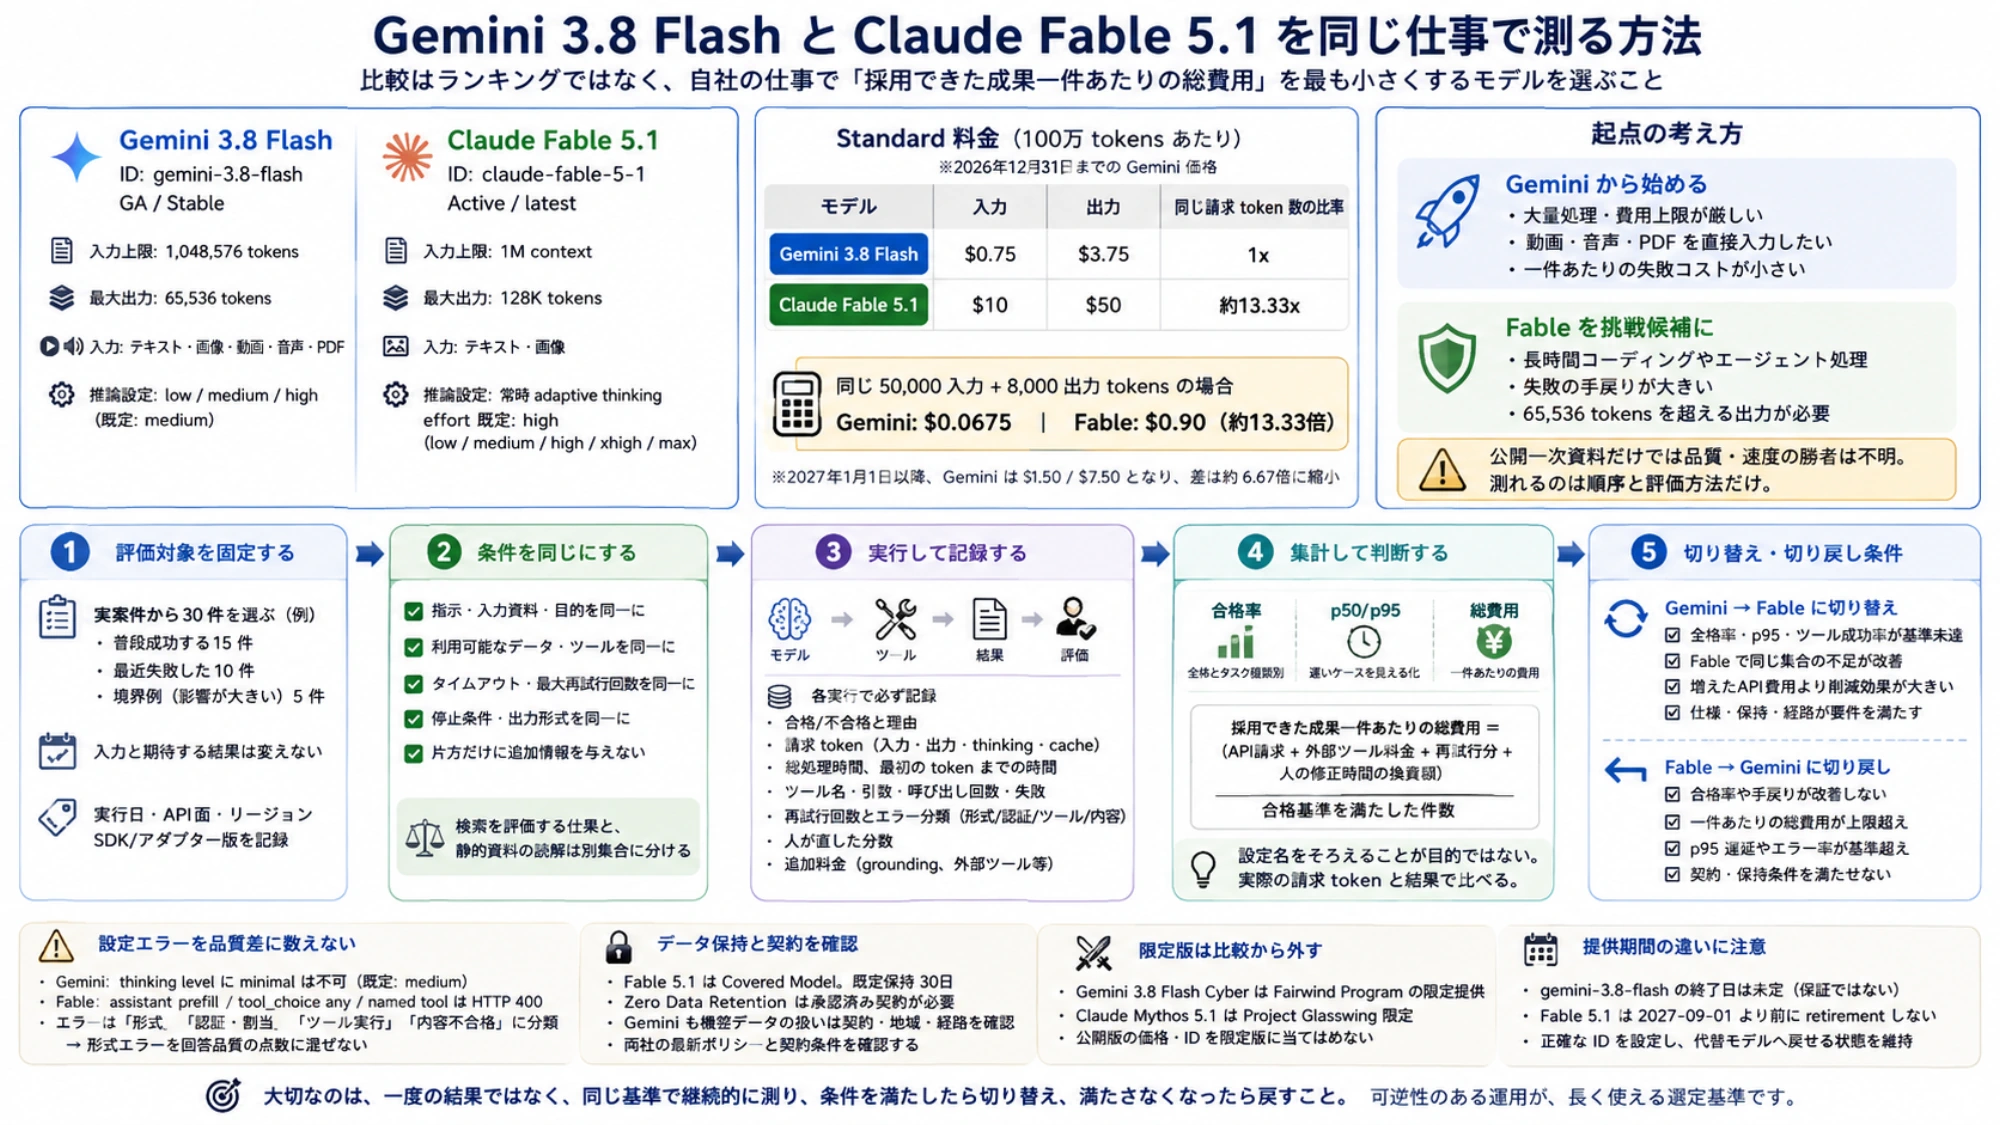
Google のモデル仕様では、Gemini 3.8 Flash は GA/Stable で、API ID は gemini-3.8-flash です。入力上限は 1,048,576 tokens、最大出力は 65,536 tokens。テキスト、画像、動画、音声、PDF を受け取り、出力はテキストです。
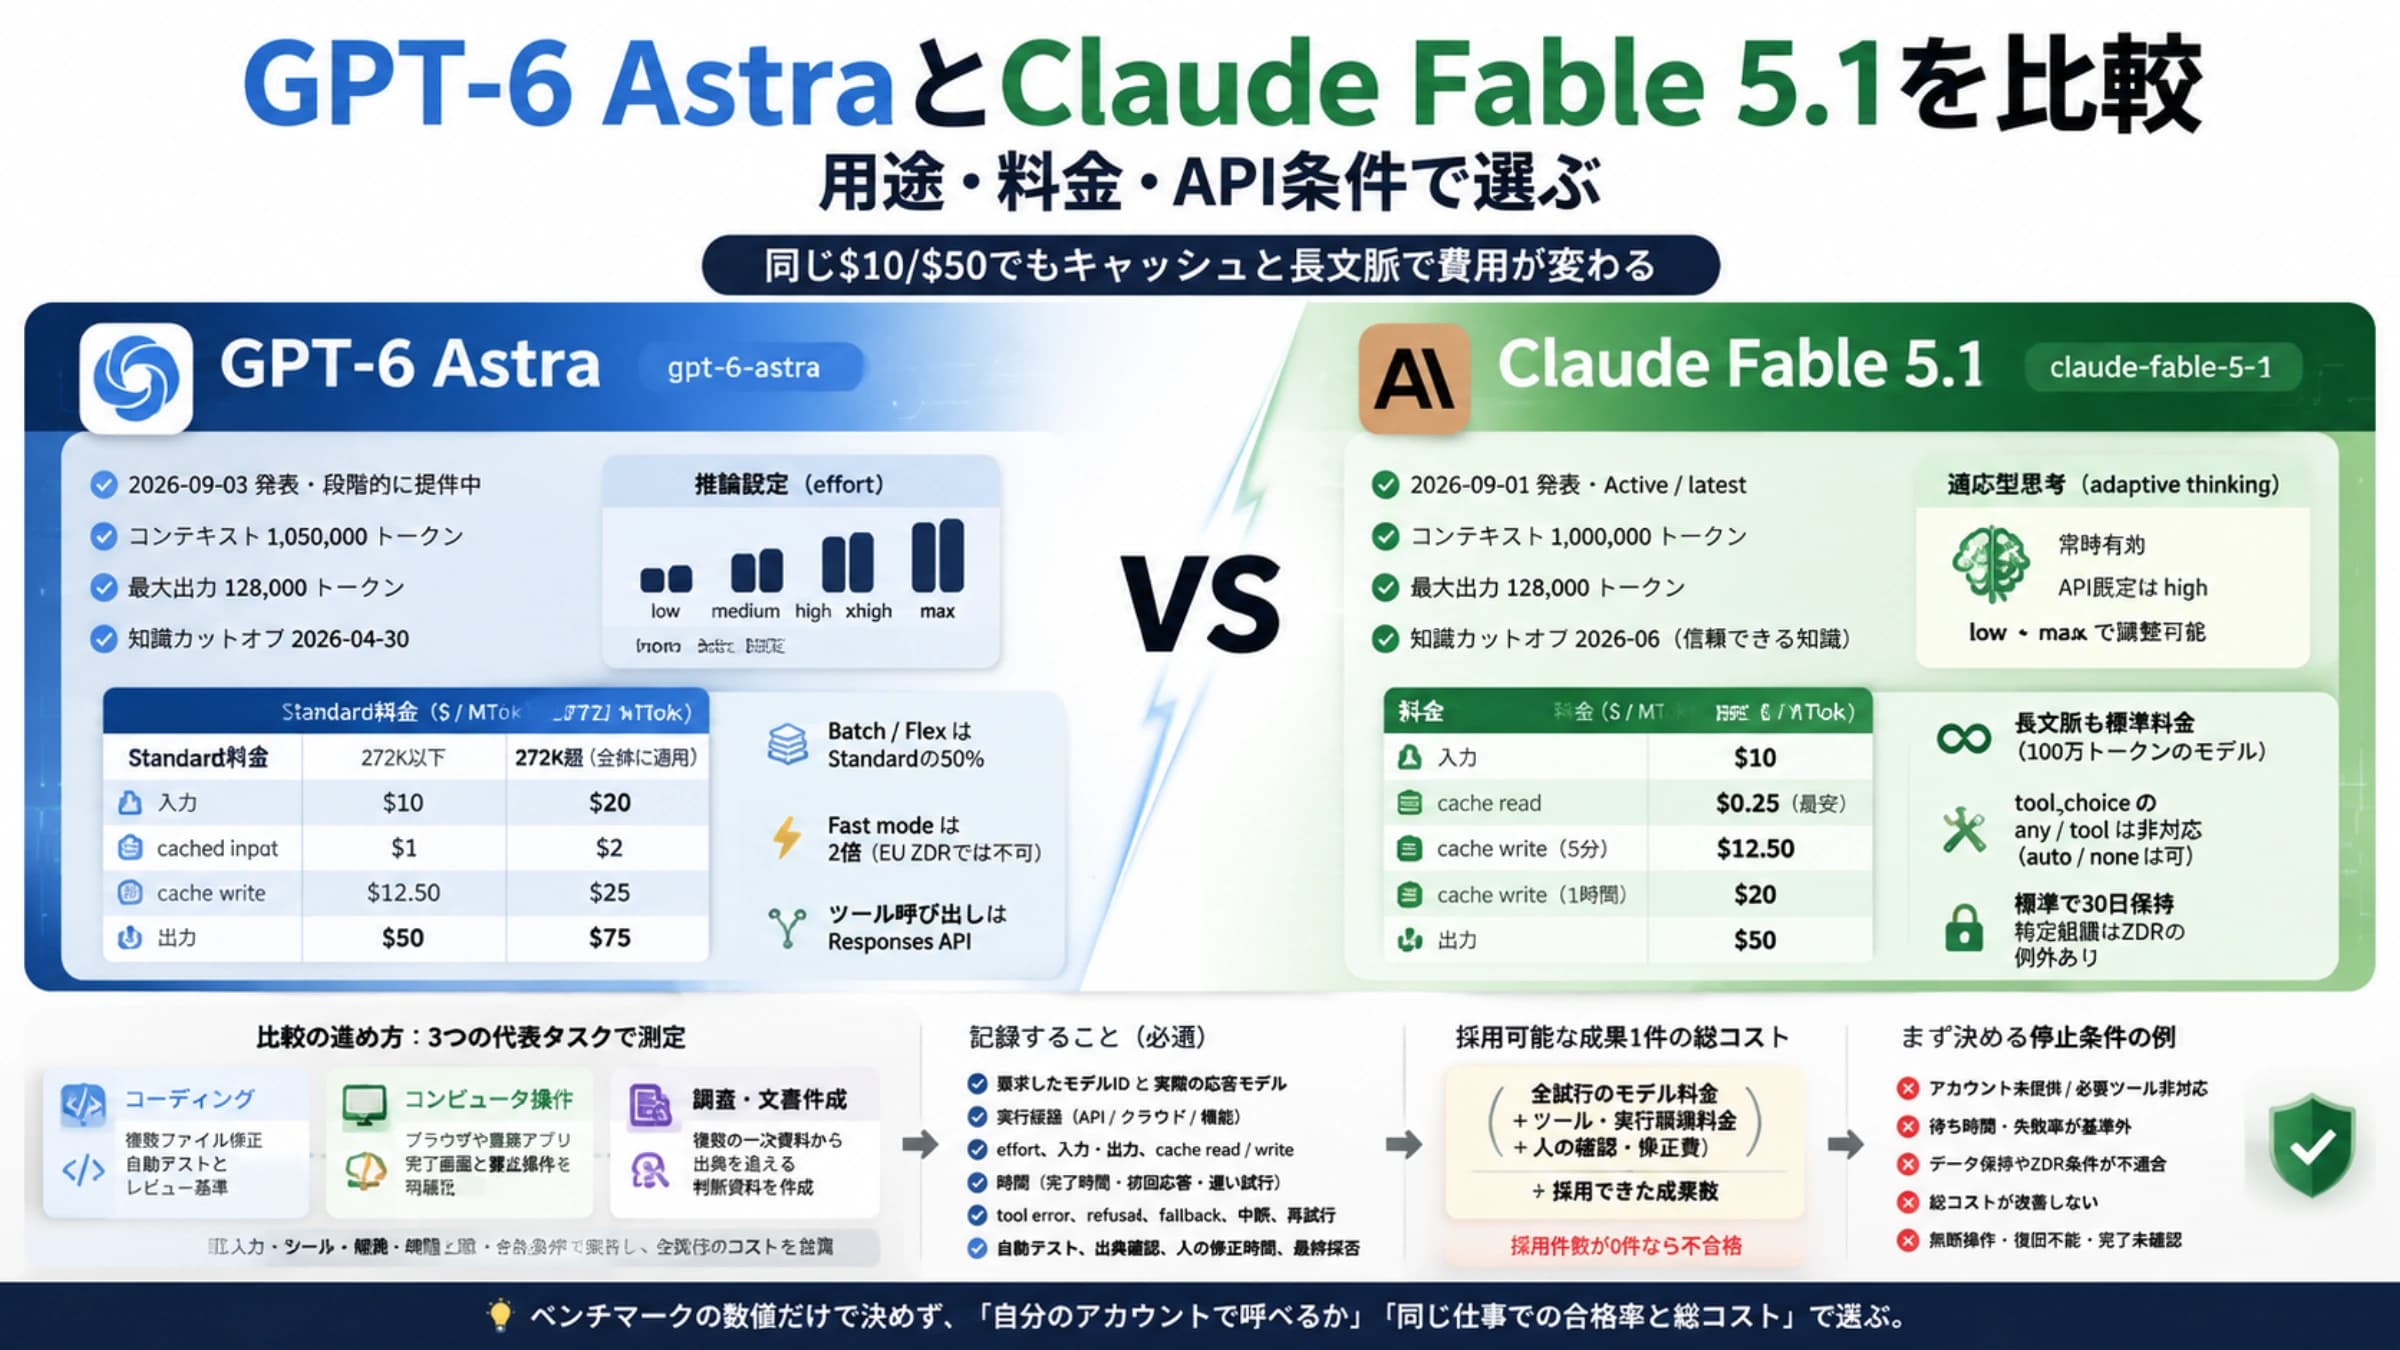
Anthropic のモデル概要では、Claude Fable 5.1 は Active/latest で、API ID は claude-fable-5-1。コンテキストは 1M、最大出力は 128K で、入力はテキストと画像、出力はテキストです。
| 判断に効く項目 | Gemini 3.8 Flash | Claude Fable 5.1 |
|---|---|---|
| 公開状態 | GA/Stable | Active/latest |
| API ID | gemini-3.8-flash | claude-fable-5-1 |
| 入力上限 | 1,048,576 tokens | 1M context |
| 最大出力 | 65,536 tokens | 128K |
| 入力形式 | テキスト、画像、動画、音声、PDF | テキスト、画像 |
| 推論設定 | low、medium、high。既定は medium | 常時 adaptive thinking。effort の既定は high |
| Standard 入力単価 | $0.75/100万 tokens(2026年末まで) | $10/100万 tokens |
| Standard 出力単価 | $3.75/100万 tokens(2026年末まで) | $50/100万 tokens |
| 非同期処理 | Batch/Flex は Standard token 単価の半額 | Batch は基本の入出力単価から50%割引 |
Gemini の thinking level は minimal を受け付けません。function calling、code execution、file search、キャッシュ、構造化出力、Search/Maps grounding、URL context に対応しますが、computer use は Preview です。画像や音声の入力に対応することと、それらを生成できることは別であり、画像生成、音声生成、Live API には対応しません。
Fable は low、medium、high、xhigh、max の effort を選べます。ただし adaptive thinking は常時有効で、Gemini の thinking level と同じ目盛りではありません。「両方を high にした」だけでは、推論量を揃えた比較にはなりません。
入力上限が近くても、扱えるメディア、最大出力、推論制御、周辺機能が違います。コンテキスト長だけを見て同等品と判断すると、実装時に必要な変換や分割を見落とします。
13.33倍の単価差を、そのまま仕事の費用差にしない
Gemini Developer API の料金は、2026年12月31日まで Standard 入力 $0.75、出力 $3.75/100万 tokens です。2027年1月1日からは $1.50/$7.50 になります。出力料金には thinking tokens が含まれ、grounding やキャッシュ保存などには別の費用があります。
Claude API の料金は、Fable 5.1 の Standard 入力 $10、出力 $50/100万 tokens。5分のキャッシュ書き込みは $12.50、1時間は $20、キャッシュ読み出しは $0.25/100万 tokens です。いずれも USD の公開単価であり、税、個別契約、提携クラウド、追加機能の料金は含みません。
同じ 50,000 入力 tokens と 8,000 出力 tokens を一回使う、単純な基準値なら次の計算になります。
Gemini = (50,000 × $0.75 + 8,000 × $3.75) ÷ 1,000,000
       = $0.0675

Fable  = (50,000 × $10 + 8,000 × $50) ÷ 1,000,000
       = $0.90
この条件では Fable が Gemini の約13.33倍です。2027年の Gemini 予定単価で同じ計算をすると $0.135 となり、差は約6.67倍です。ここまでは誰でも再計算できる「同じ請求対象 token 数」の比較です。
実際には、両社の tokenizer、推論の仕組み、キャッシュ区分、ツール呼び出し回数、再試行、回答量が異なります。Fable が一回で終えた仕事を Gemini が三回必要とするかもしれませんし、逆もあり得ます。したがって、選定に使う式は次の形に変えます。
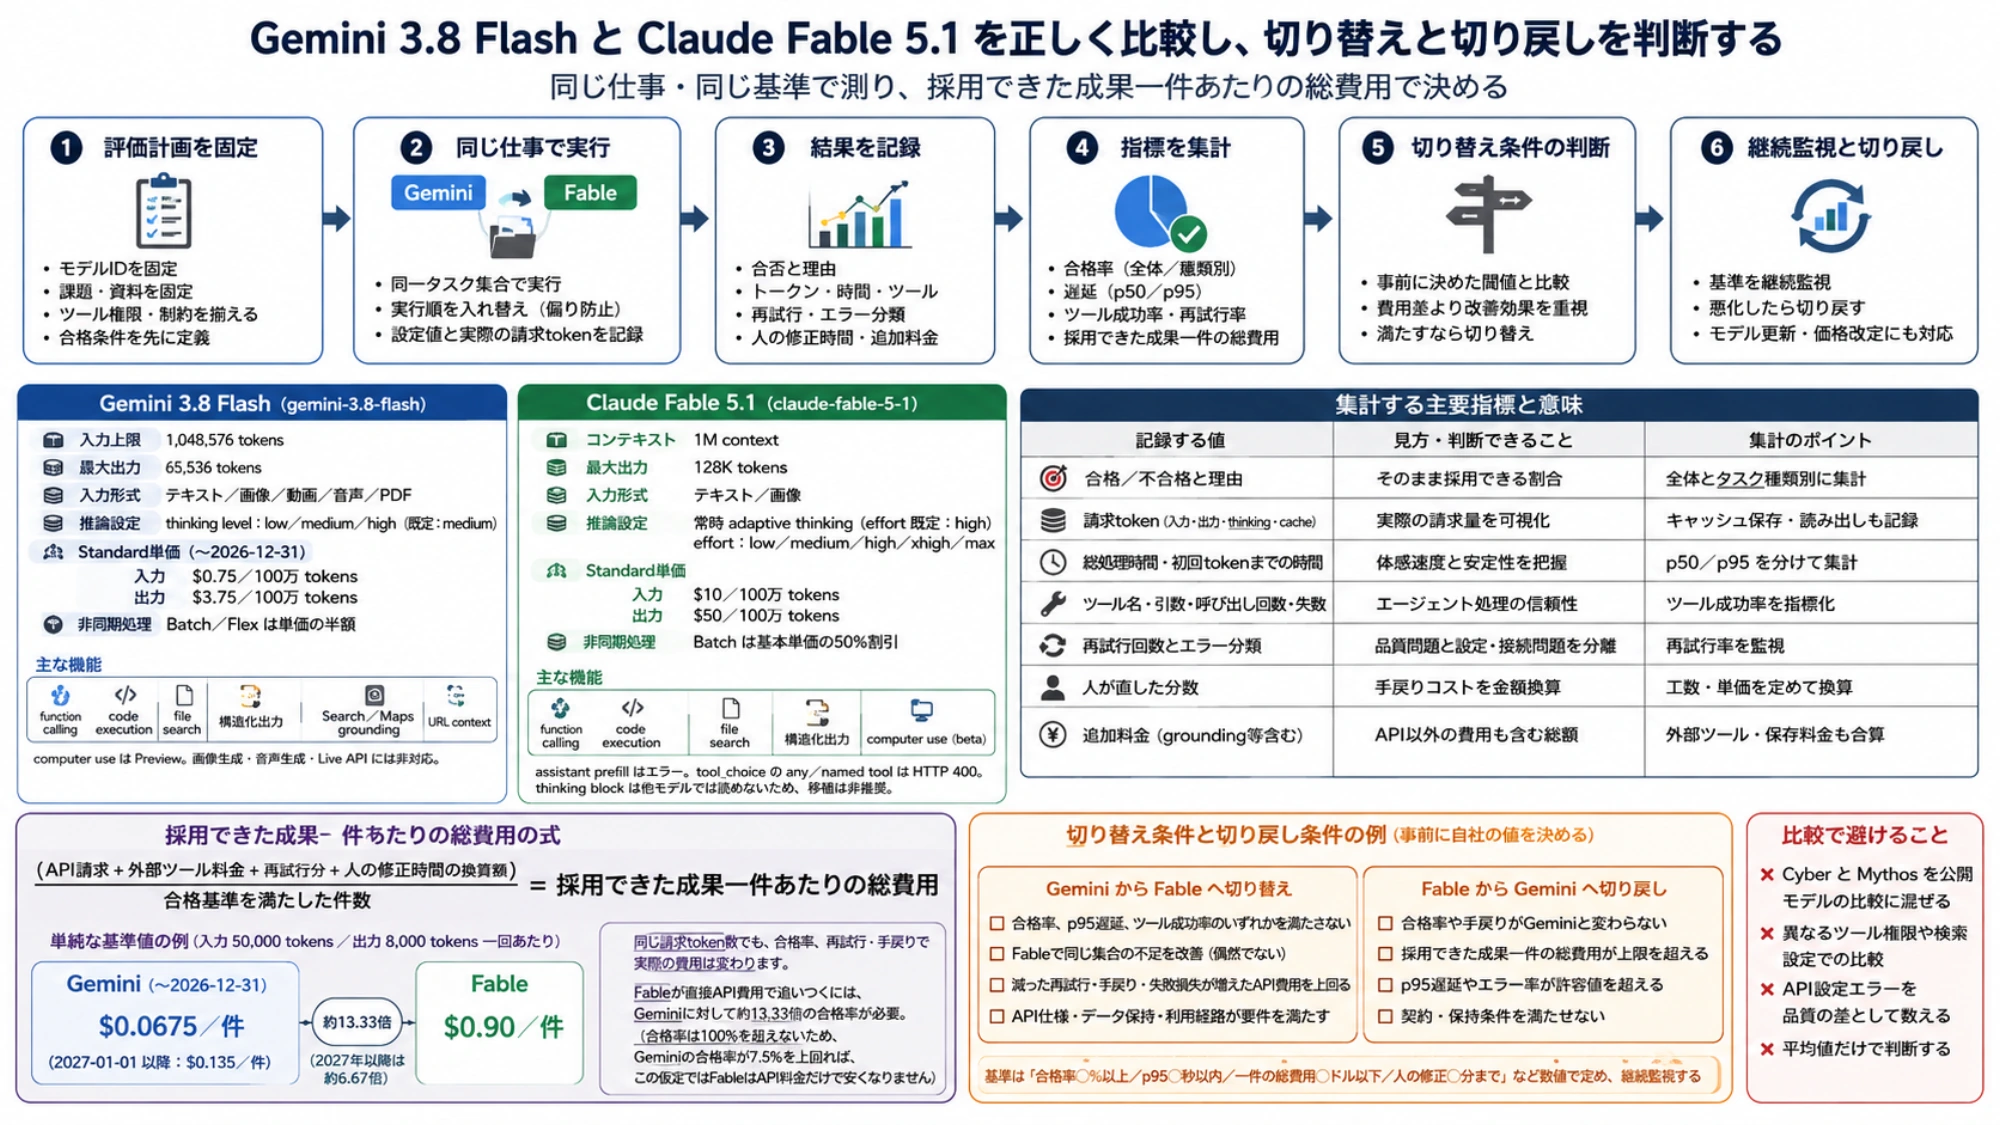
採用できた成果一件あたりの総費用
=(API請求 + 外部ツール料金 + 再試行分 + 人の修正時間の換算額)
 ÷ 合格基準を満たした件数
API 請求だけを比べる場合でも、分母を成功件数にします。同じ token 数を使うという仮定のままなら、Fable が直接 API 費用で追いつくには、Gemini に対して約13.33倍の合格率が必要です。合格率は100%を超えないため、Gemini の合格率が7.5%を上回れば、この仮定では Fable は API 料金だけで安くなりません。Fable の価格を正当化する中心は、token の安さではなく、失敗損失や人の修正をどれだけ減らせるかです。
この計算はモデルの優劣を示しません。費用差を埋めるために必要な改善幅を、評価前に見えるようにするものです。
比較するのは設定名ではなく、同じ仕事と合格条件
再現できる比較には、華やかな一問より、実際に費用を払う処理を使います。小さく始める例として、普段どおり成功する15件、最近失敗した10件、失敗時の影響が大きい境界例5件の計30件を固定します。件数そのものより、入力と期待結果を後から変えないことが重要です。
- 対象を固定する。 Gemini は
gemini-3.8-flash、Claude はclaude-fable-5-1を使い、自動更新 alias は避けます。実行日、API 面、リージョン、SDK とアダプターの版も残します。 - 課題を同じにする。 指示、入力資料、ツールの目的、利用可能なデータ、タイムアウト、最大再試行回数、停止条件を揃えます。プロバイダー固有の形式変換は記録し、片方だけに追加情報を渡しません。
- 合格条件を先に書く。 テスト通過、必要項目の充足、引用の正しさ、許されない変更がないことなど、対象業務で機械判定または人が再確認できる条件にします。出力を見てから採点基準を変えません。
- 既定設定を同一設定と呼ばない。 最初の比較では Gemini の既定
mediumと Fable の既定highを使えますが、これは各サービスの既定同士の比較です。推論量が等しいとは主張せず、設定値と実際の請求 token を記録します。 - 順番の偏りを減らす。 実行順を入れ替え、可能ならモデル名を隠して成果を判定します。外部検索を評価しない仕事では同じ資料を与え、検索能力を評価する仕事は別の集合に分けます。
調査タスクで片方だけに Search grounding を許せば、モデル本体だけでなく検索経路も比べることになります。それが製品要件なら有効ですが、静的な資料読解の評価と混ぜてはいけません。Google のモデルカードも知識の基準時点を2026年3月としつつ、一部領域は2025年1月の場合があると限定しています。新しい事実が必要な仕事では、記憶の新しさを期待せず、同じ根拠を与えるか取得経路を評価対象として明示します。
各実行で残す最小限の記録は次のとおりです。
| 記録する値 | 判断できること |
|---|---|
| 合格/不合格と理由 | そのまま採用できる割合 |
| 入力、出力、thinking、cache の請求 token | 単価を実際の請求へ変換 |
| 総処理時間、可能なら最初の token までの時間 | 平均値に隠れる遅い処理の発見 |
| ツール名、引数、呼び出し回数、失敗 | エージェント処理の信頼性 |
| 再試行回数と API エラー分類 | 品質問題と接続・設定問題の分離 |
| 人が直した分数 | 安い API が高い手戻りを生むか |
| 追加料金 | grounding、外部ツール、保存などを含む総額 |
平均値だけでなく p50 と p95 を分けます。少数の非常に遅い処理が利用体験を壊す場合、平均時間では切り戻し判断が遅れます。合格率も全体だけでなく、「大量抽出」「コード変更」「長時間エージェント」のような、実際に振り分けられる仕事の種類ごとに集計します。
切り替え条件と切り戻し条件を、投入前に決める
費用重視の新規処理なら、Gemini を初期候補にして、Fable は全件の代替ではなく、失敗しやすい種類の挑戦候補にします。Gemini から Fable へ切り替えるのは、次の条件がそろったときです。
- 同じ種類のタスクで Gemini が事前の合格率、p95 遅延、ツール成功率のいずれかを満たさない。
- Fable が同じ評価集合で不足を改善し、改善が偶然の一例ではない。
- 増えた API 費用より、減った再試行、人の修正、失敗時の事業損失のほうが大きい。
- Fable の API 仕様、データ保持、利用経路がシステム要件を満たす。
Fable を使い始めた後も、切り戻し条件を消してはいけません。合格率や手戻りが Gemini と実質的に変わらない、採用可能な成果一件あたりの費用が上限を超える、p95 遅延やエラー率が許容値を超える、または契約・保持条件を満たせない場合は、対象の仕事を Gemini に戻します。
逆に、最初から Fable を評価するのは、長い出力上限が必須、あるいは失敗一件の損害が非常に大きく、価格より先に成功率を確認すべき場合です。それでも Gemini を比較対象から外さず、低リスク・高頻度の処理で同じ合格基準を満たせるかを試します。
閾値に普遍的な正解はありません。重要なのは、結果を見る前に「合格率は何%以上」「p95 は何秒以内」「一件の総費用はいくら以下」「人の修正は何分まで」と自社の値を決めることです。選定後も同じ値を監視すれば、モデル更新や価格改定が起きたときに感覚ではなく記録から戻せます。
API設定の失敗を、モデル品質の差に数えない
両モデルを共通アダプターから呼ぶと、片方で通った設定がもう片方ではエラーになることがあります。それを不合格回答として数えると、比較しているのは知能ではなくアダプターの未対応です。
Gemini 3.8 Flash へ minimal を渡すとエラーになります。既定値は medium です。Gemini 側の導入や 3.7 からの移行を進める場合は、日本語のGemini 3.8 Flash導入ガイドでモデル ID と移行条件を確認できます。
Fable 5.1 は常時 thinking のため、手動の budget_tokens を使いません。公式移行ガイドでは、assistant prefill はエラーとなり、tool_choice の any と named tool は HTTP 400 を返します。また、以前のモデルは Fable 5.1 の thinking block を読めず、過去の履歴を変更すると thinking block が無効になる場合があります。
そのため、モデルを途中で切り替えるシステムでは、ユーザー入力、通常の assistant 出力、ツール結果を移植可能な履歴として保持し、プロバイダー固有の thinking block と設定を分けます。エラーは「形式」「認証・割当」「ツール実行」「内容不合格」に分類し、形式エラーを回答品質の点数へ混ぜません。Fable と Opus の料金や移行差を詳しく詰める場合は、日本語のClaude Fable 5.1移行・料金ガイドが次の確認先になります。
データの扱いも選定条件です。Anthropic のAPI保持方針では、Fable 5.1 は Covered Model で、既定の保持期間は30日です。zero data retention は明示的に承認された契約が必要です。Google 側について同じ資料から対称な結論を作らず、機密データを扱う場合は両社それぞれの契約、利用地域、実際の API 経路を確認します。
CyberとMythosは公開モデルの比較から外す
Gemini 3.8 Flash Cyber は、通常の gemini-3.8-flash と同じ公開 API モデルではありません。Google の発表では Fairwind Program を通じた限定提供です。公開版の価格や ID を Cyber に当てはめることはできません。
Claude Mythos 5.1 も Project Glasswing 限定で、通常の Claude Fable 5.1 ではありません。限定版の名前を含む比較結果を、公開モデルの速度、料金、利用可否の根拠にしないでください。
提供期間にも非対称な表現があります。Google の廃止予定一覧には gemini-3.8-flash の終了日はまだありませんが、永続提供の保証ではありません。Anthropic のモデル廃止方針では、Fable 5.1 の retirement は2027年9月1日より前には行わないとされています。正確な ID を設定し、代替モデルへ戻せる状態を維持することが、どちらを選ぶ場合にも必要です。
迷ったときの実務的な答え
大量処理、動画・音声・PDF の入力、厳しい単価上限が中心なら、Gemini 3.8 Flash を先に試します。現在の等 token 単価差は大きく、Fable を全件の既定にするには、失敗や手戻りを減らす明確な根拠が必要です。
長時間のコーディングやエージェント処理で失敗の損害が大きい、または 65,536 tokens を超える出力が必要なら、Claude Fable 5.1 を挑戦候補として早めに評価します。ただし、Anthropic の位置づけどおり、通常処理で Opus 5 を飛ばしてまで Fable が必要かも別途確認します。
どちらを選んでも、同じタスク、同じツール権限、同じ停止条件、同じ合格基準を使います。そして、合格率、p95 遅延、再試行、人の修正、採用できた成果一件あたりの総費用が事前の基準を満たしたときだけ切り替えます。満たさなくなったら戻す。この可逆性が、公開直後の順位表より長く使える選定基準です。