Claude API最新モデル比較:Haiku・Sonnet・Opus 5.5の違いと選び方
Claude Haiku・Sonnet・Opusの違いは使う場所で変わり、アプリはSonnet 5.5、APIはOpus 5.5から。Fable 5.1はOpusで足りない時に。
目次

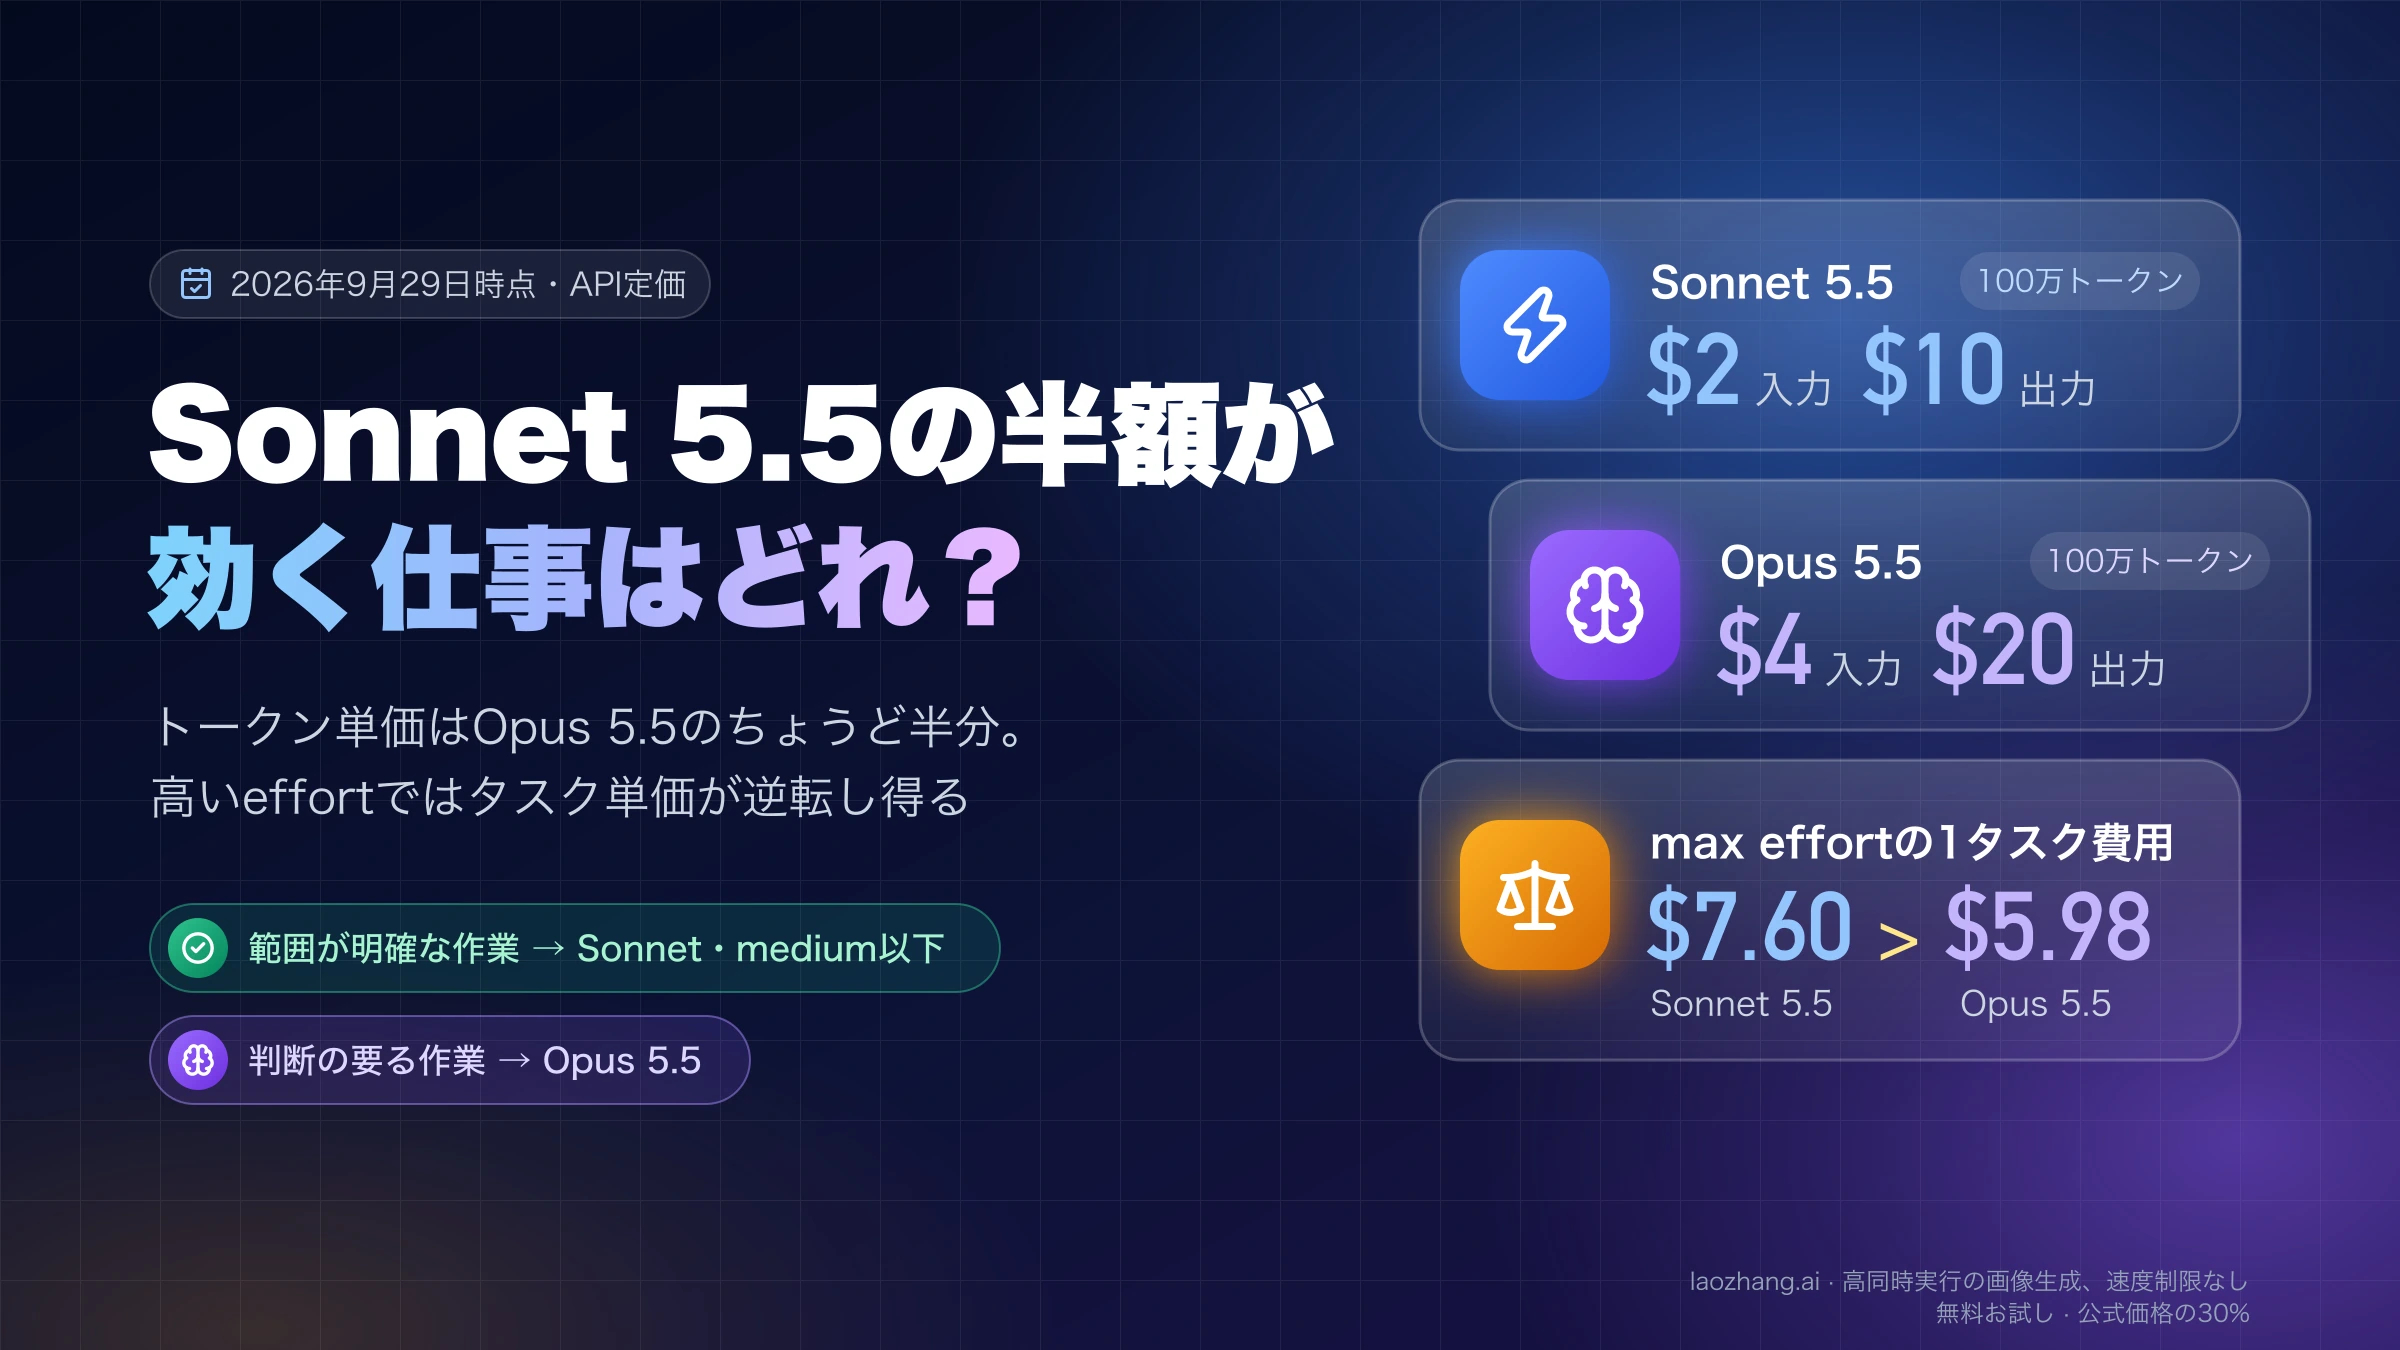
2026年10月26日時点で、Claudeの現行モデルはHaiku 5.5、Sonnet 5.5、Opus 5.5、Fable 5.1の4つです。最初に使うモデルは使う場所で変わり、claude.aiやデスクトップ・モバイルのClaudeアプリならSonnet 5.5、APIから呼ぶならOpus 5.5(claude-opus-5-5)から始めるのが、Anthropic自身の勧める順序です。アプリでは上位モデルほどプランの利用上限を早く消費し、APIではOpusのeffort(推論の深さ)を下げて費用を調整できるためです。大量の分類・抽出・振り分けはHaiku 5.5で試し、Fable 5.1はOpusのeffortを上げても品質が足りない仕事に限って使います。2026年11月9日にはFable 5.2(入力$8 / 出力$40)が公開され、この役割はFable 5.1からFable 5.2に替わりました。Opus 5.5との比較は「Claude Fable 5.2とOpus 5.5の違い:同じ正解数で費用1.86倍」で扱っています。
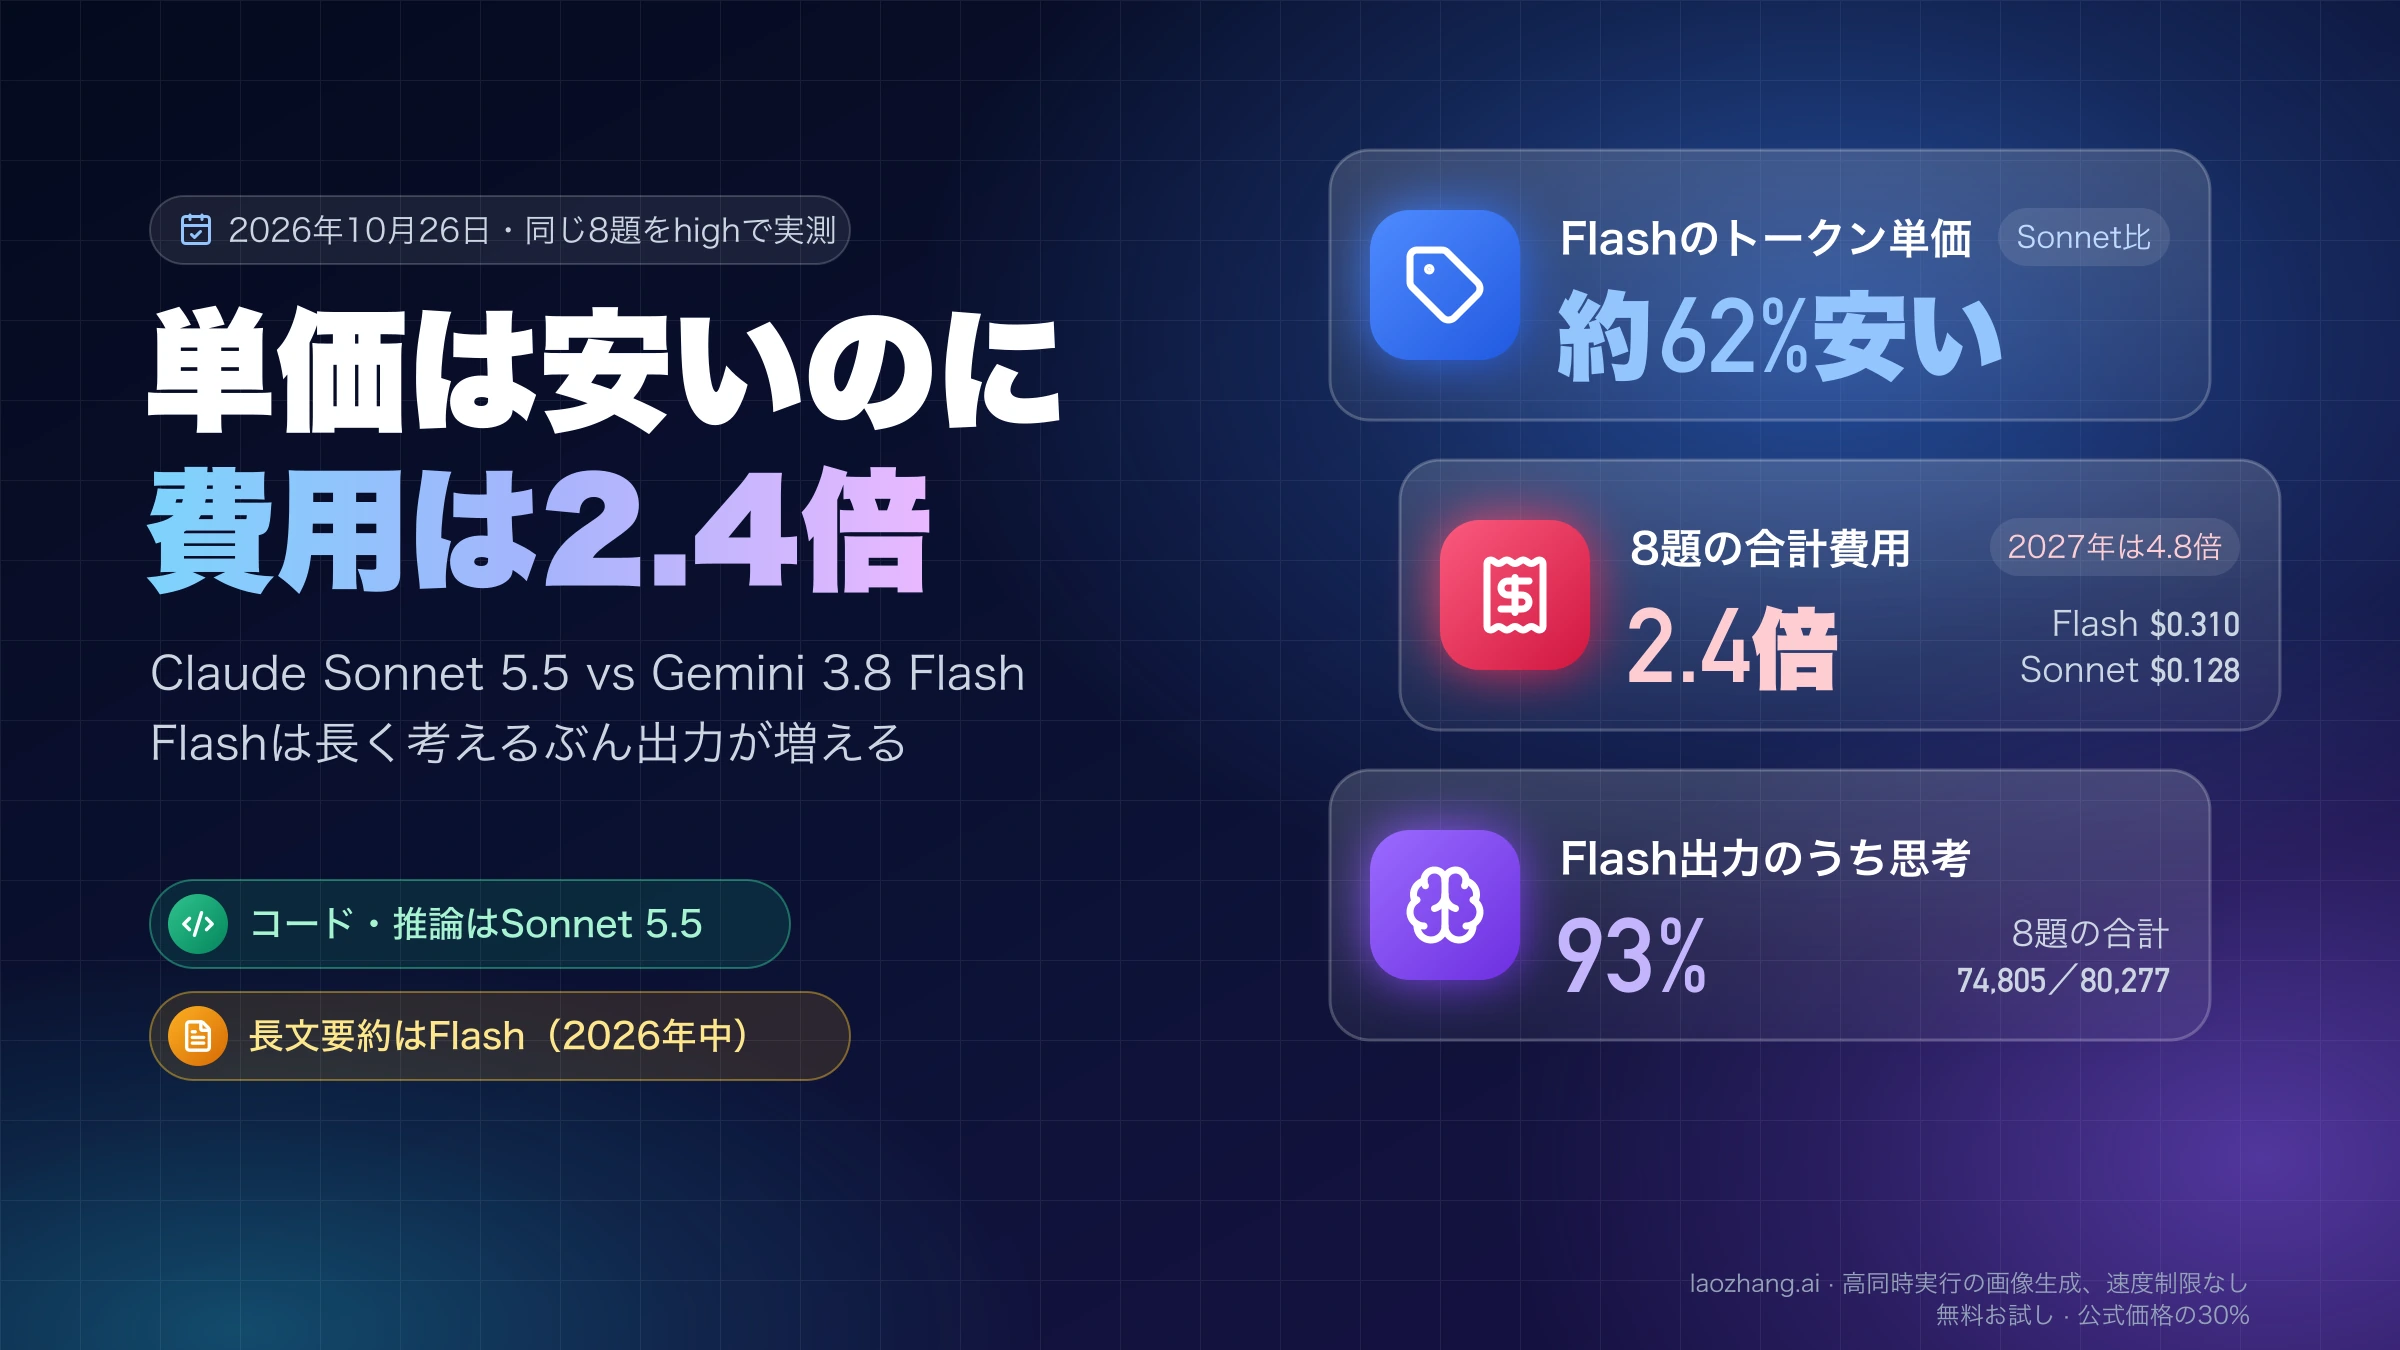
1段上げるか下げるかは、100万トークンあたりの単価ではなく、同じ品質を出すまでの費用で決めます。第三者機関Artificial Analysis(AA)の総合指数では、Sonnet 5.5(既定のhigh)からOpus 5.5(既定のmedium)へ上げると4点上がり、1タスクあたりの費用は1.52倍です。Haiku 5.5からSonnet 5.5へ上げると13点上がって17.6倍になり、Fable 5.1はどの点数帯でも最安の選択肢になりません。小さく仕様が明確な9題を2026年10月26日に3モデルへ送った実測では、3モデルとも全問合格し、合計費用はHaiku $0.0087、Sonnet $0.0866、Opus $0.2695でした。
旧名で探している場合、Haiku 4.5・Sonnet 5・Opus 5・Fable 5は現在レガシー扱いで、APIからは引き続き呼べます。後継はそれぞれHaiku 5.5・Sonnet 5.5・Opus 5.5・Fable 5.1で、価格の変化は後半の「旧モデル名」の節に1表でまとめています。
Claude Haiku・Sonnet・Opus・Fableの違いを1表で比較
4モデルはどれも100万トークンのコンテキスト、同期APIで最大128Kトークンの出力、テキストと画像の入力に対応し、知識の信頼できる範囲も2026年6月までで共通です(AnthropicのModels overview)。違いが出るのは、Anthropicの位置づけ、速度、既定のeffort、価格、Claudeアプリで使えるプランです。読み方はハイク、ソネット、オーパス、フェイブルで、Haikuが最も軽く、Fableが最も重いモデルです。
| 項目 | Haiku 5.5 | Sonnet 5.5 | Opus 5.5 | Fable 5.2 | Fable 5.1 |
|---|---|---|---|---|---|
| APIのモデルID | claude-haiku-5-5 | claude-sonnet-5-5 | claude-opus-5-5 | claude-fable-5-2 | claude-fable-5-1 |
| Anthropicの位置づけ | 分類・抽出・振り分けなど、大量で応答速度が重要な処理 | 速度と知能の最良の組み合わせ | 長時間のエージェント型コーディングと知的作業 | — | 高度な推論と長時間のエージェント作業 |
| 相対速度のラベル | Fastest | Fast | Moderate | — | Slower |
| APIの既定effort | medium | high | medium | high(適応型思考は常時オン) | high |
| API価格(入力 / キャッシュ読み取り / 出力) | $0.10 / $0.01 / $0.50(10万トークン超は$0.50 / $0.05 / $2.50) | $2 / $0.10 / $10 | $4 / $0.20 / $20 | $8 / $0.20 / $40 | $10 / $0.25 / $50 |
| Claudeアプリで使えるプラン | Freeから | Freeから | ProとMax | 有料プラン | 有料プラン |
| アプリの利用上限の消費 | 最も軽い | 中程度 | 重い | — | 最も重い |
| 提供終了(早くても) | 2027年10月7日 | 2027年9月28日 | 2027年9月22日 | — | 2027年9月1日 |
API価格は100万トークンあたりの米ドルで、2026年10月26日時点のAnthropicのPricingの通常料金です。Batch APIは入出力とも50%引き、inference_geoで米国内処理を指定するとすべての区分が1.1倍になります。プランと利用上限の欄は、AnthropicのClaude Academyのモデル選択チュートリアルによります。モデルごとの消費倍率は公開されていません。
「Fastest」「Slower」はAnthropicが現行モデル同士を比べた相対ラベルで、秒数の実測ではありません。実際の待ち時間はプロンプトの長さ、出力の長さ、effortで変わり、後述の9題の実測では「Haikuが最速」にはなりませんでした。
アプリはSonnet、APIはOpusから:出発点が違う理由
Anthropicは、Claudeアプリ向けとAPI向けで別々の出発点を案内しており、どちらも現行の案内です。Claude Academyのチュートリアルは、Sonnet 5.5を「どれを選ぶか迷ったらここから」という万能の既定モデルとしています。一方、APIのModels overviewは「迷ったら、大半の処理はOpus 5.5から」です。食い違いではなく、それぞれの場所で何を消費するかが違います。
Claudeアプリで消費するのは、プランの利用上限です。Academyによると、Freeで使えるのはHaikuとSonnetで、ProとMaxではOpusとFableが加わり、上限にも余裕が出ます。Opusは上限を多く使うため、本当に必要な仕事に取っておくよう勧められており、Opusを使う場面は「Sonnetで試してうまくいかなかった問題」、Fableを使う場面は「Opusで試してうまくいかなかった問題」と説明されています。プランごとの上限は「Claude ProとMaxを比較:料金、Claude Code制限、Maxの損益分岐点」で扱っています。
APIは使った分だけの従量課金で、モデルの中でもeffortを下げれば費用と待ち時間が減ります。Anthropicのモデル選択ガイド(Choosing the right model)は2つの始め方を示しています。品質を優先するならOpus 5.5で実装し、その後effortを下げるか下位モデルへ移す方法、費用と速度を優先するならHaiku 5.5で始め、足りない能力が見つかったときだけ上げる方法です。後者は試作、応答時間の要件が厳しい処理、大量で単純な処理に向くとされています。Sonnet 5.5は、日常のコーディング、エージェント、企業向けの処理で速度と能力を両立させる中間の選択肢です。
SonnetとOpus、どちらが良い?AA指数51点以上ならOpusが安い
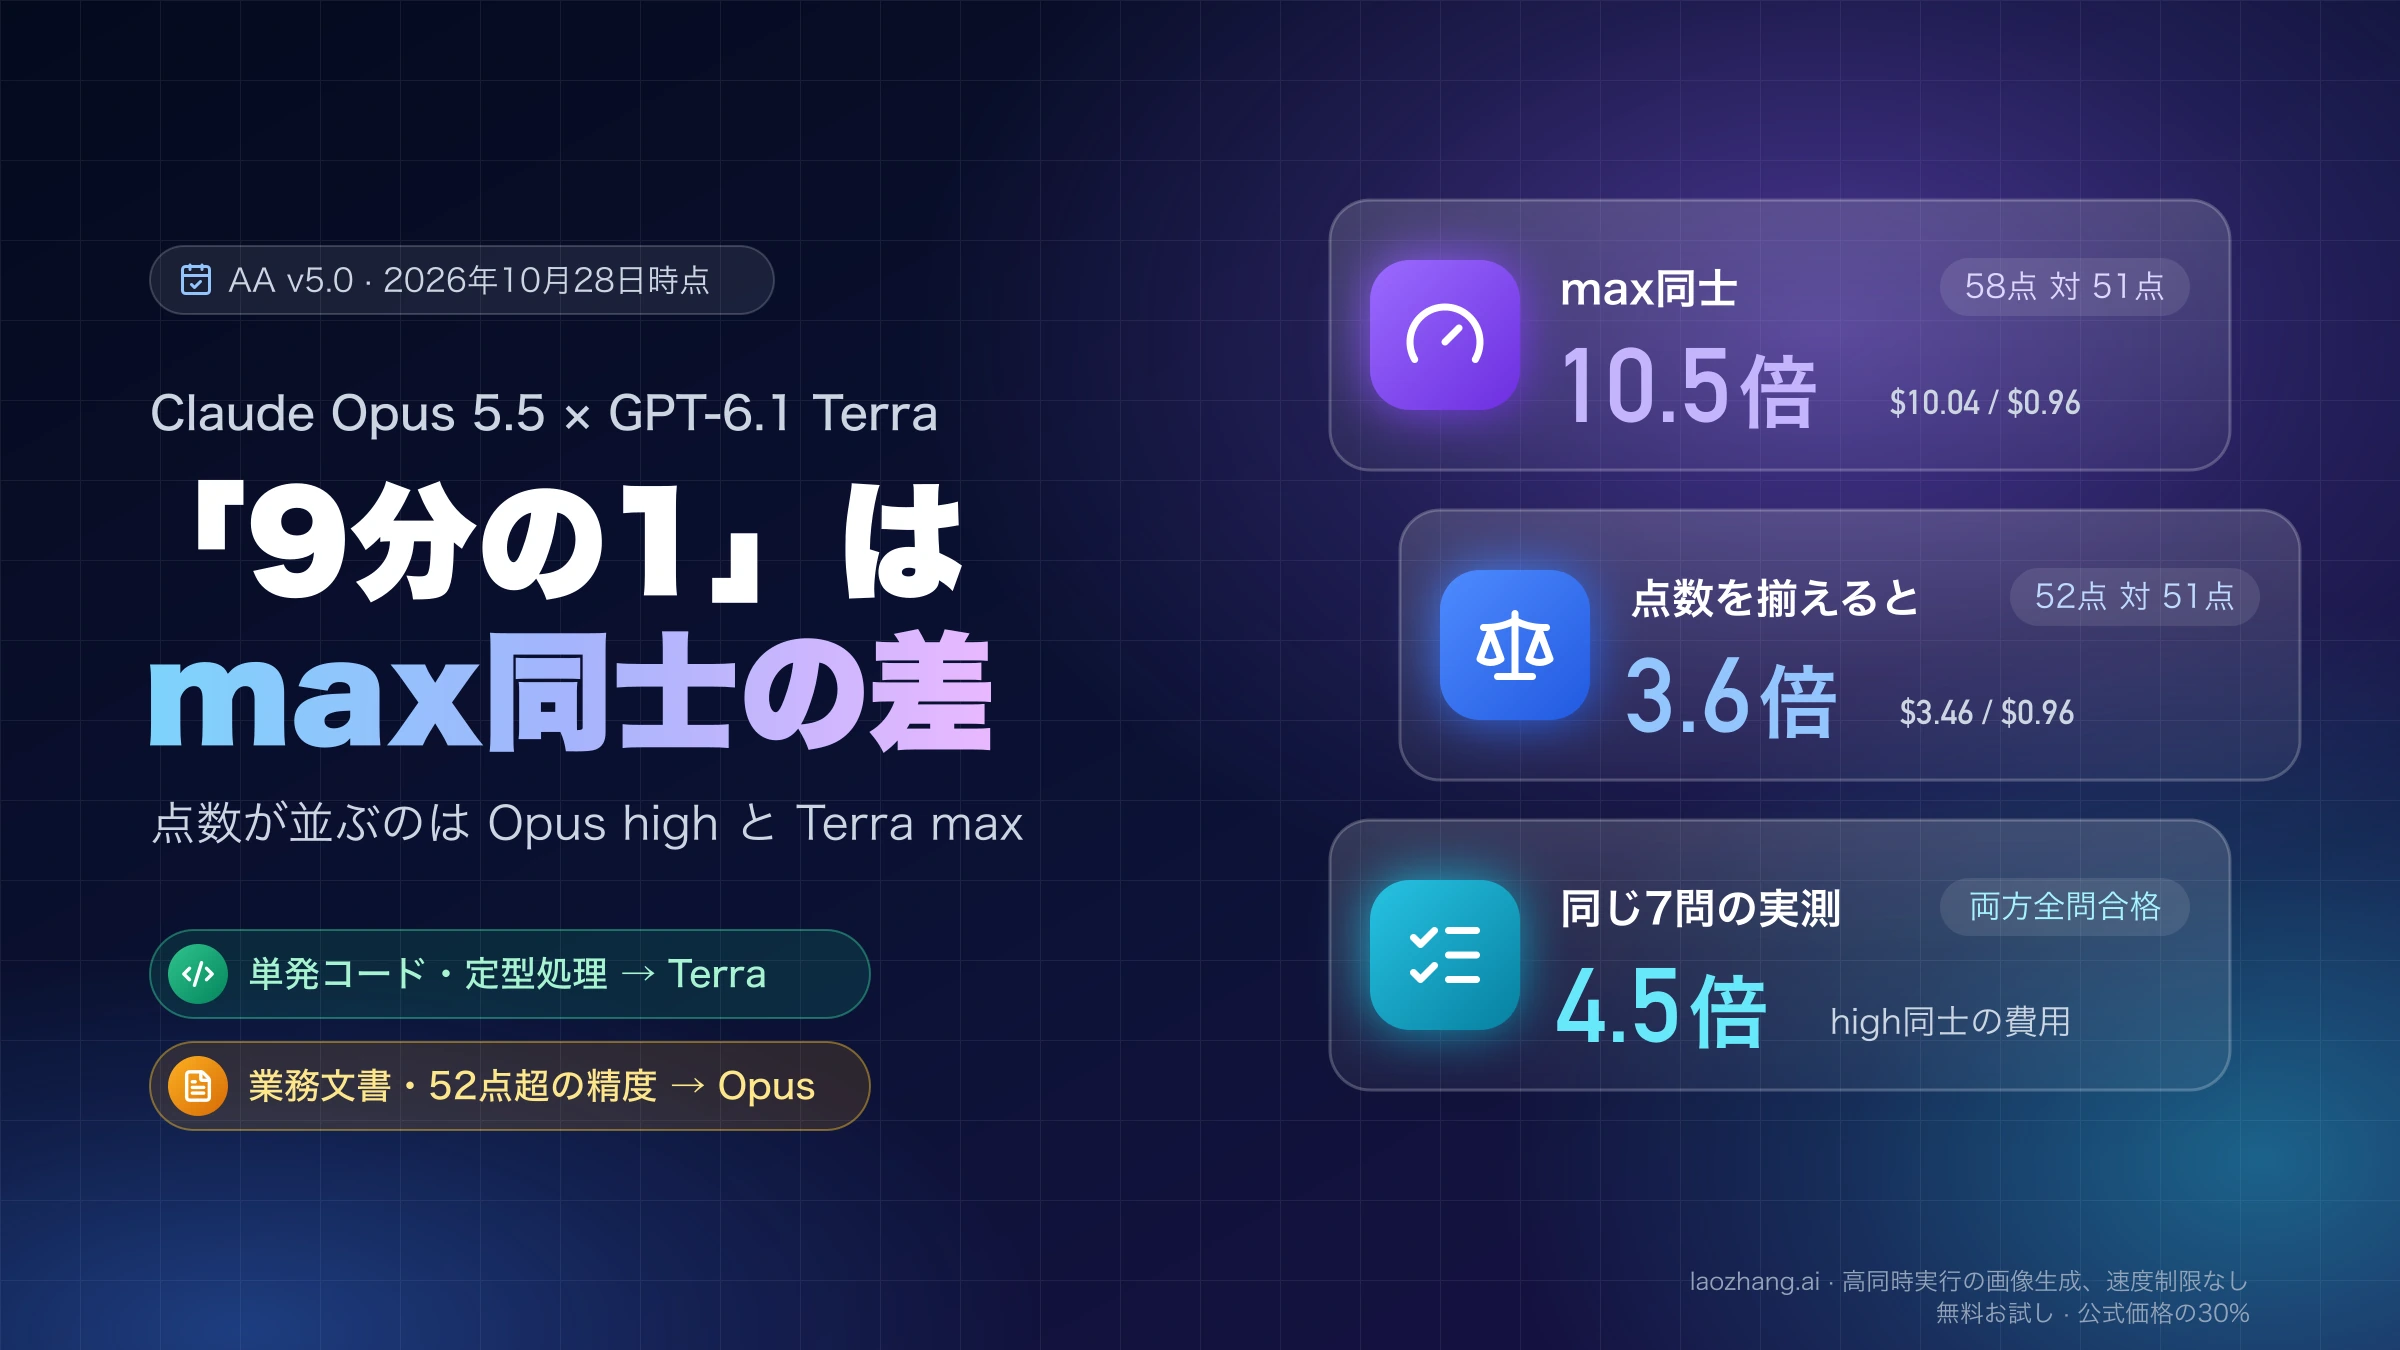
必要な品質がAA指数で47点前後ならSonnet 5.5、51点以上が要るならOpus 5.5のほうが安く済みます。Sonnet 5.5をxhighに上げると52点に届きますが1タスク$2.01かかり、Opus 5.5は既定のmediumで51点・$1.34、highで54点・$1.82です。上限もSonnet 5.5はmaxで56点、Opus 5.5は58点です(AAのSonnet 5.5とOpus 5.5の比較ページ、2026年10月26日時点)。
次の表は、AAが公開している4モデル×5段階のeffort、計20の構成から、各点数に届く最も安い構成を2026年10月26日に再計算したものです。費用と時間はAAの課題1件あたりの値です。
| 必要な点数(AA指数) | 最も安い構成 | 1タスクあたりの費用 | 1タスクあたりの時間 |
|---|---|---|---|
| 34以上 | Haiku 5.5 medium | $0.05 | 119秒 |
| 41以上 | Haiku 5.5 xhigh | $0.12 | 291秒 |
| 47以上 | Sonnet 5.5 high | $0.88 | 217秒 |
| 51以上 | Opus 5.5 medium | $1.34 | 198秒 |
| 54以上 | Opus 5.5 high | $1.82 | 282秒 |
| 56以上 | Opus 5.5 xhigh | $3.46 | 494秒 |
| 58 | Opus 5.5 max | $5.98 | 791秒 |
AA指数は10種類の評価の平均で、AAの課題構成での点数です。自分の仕事での合格率とは一致しないので、判断のしかたとしては次のように使います。Sonnet 5.5の既定設定で合格するならSonnetのままで構いません。小さな課題では両方とも合格し、そのときの費用はOpusのほうが約3倍高くなるからです(9題の実測では3.11倍)。Sonnetのeffortを上げないと合格しない仕事が出てきたら、Sonnetのxhighと比べる前にOpus 5.5のmediumを試します。AAの数字では、ほぼ同じ点数(51点対52点)を、少ない費用($1.34対$2.01)と短い時間(198秒対434秒)で出せます。
Fable 5.1はいつ使う?Opusのeffortを上げても足りないとき
Fable 5.1は、Opus 5.5をxhighやmaxにしても評価が足りない、難しい推論や長時間のエージェント作業に限って試すモデルです。Anthropicのモデル選択ガイドもこの順序を示しています。単価は$10 / $50でOpus 5.5の2.5倍で、AAではOpus 5.5のmediumとFable 5.1のhigh(どちらも既定)が同じ51点ですが、Fableは費用が2.92倍、時間が2.09倍かかります。
「Claudeで一番賢いモデルはどれか」は、何で測るかで答えが変わります。AAの総合指数で最も高いのはOpus 5.5のmax(58点)で、Fable 5.1はmaxでも53点です(AAのOpus 5.5とFable 5.1の比較ページ)。一方、AnthropicはFable 5.1を「最も能力の高いモデル」(most capable model)と呼んでいます。平均点ではOpusが上でも、Fableが向くとされる長い仕事で差が出るかは、自分の難しい課題で比べるしかありません。
同じ能力を持つMythos 5.1は、Anthropicの認証プログラムを通った組織だけが使えるモデルで、通常のAPIアカウントからは選べません。Fableの割増が見合う具体的な場面は「Claude Fable 5.1とOpus 5.5を比較:普段はどっちを使うべき?」で扱っています。
Haikuに下げるといくら減る?2026年10月26日に9題で実測
小さく仕様が明確な仕事では、Haiku 5.5でも同じ合格率のまま、費用はSonnet 5.5の約10分の1、Opus 5.5の約31分の1でした。2026年10月26日に、Haiku 5.5、Sonnet 5.5、Opus 5.5へ同じ9題を1回ずつ送り、回答を読む前に決めておいた判定で採点した結果です。課題は文章題、隠しテスト付きのPython関数5本、6,723語の記事を25語以内の箇条書き5つに要約する課題、組み合わせの数え上げ(正解55,252)、5つのバグを仕込んだ請求処理コードの修正(隠しテスト36件)などです。
送信経路はLaoZhang APIのAnthropic Messages形式のエンドポイントで、effortもthinkingも指定せず、各モデルのAPI既定値(Haiku medium、Sonnet high、Opus medium)で実行しました。費用は返ってきたトークン数にAnthropicの定価を掛けて計算しています。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
| モデル(既定effort) | 合格 | 9題の合計費用 | 合計時間 | 出力トークン |
|---|---|---|---|---|
| Haiku 5.5(medium) | 9/9 | $0.0087 | 74.9秒 | 13,843 |
| Sonnet 5.5(high) | 9/9 | $0.0866 | 50.6秒 | 5,061 |
| Opus 5.5(medium) | 9/9 | $0.2695 | 103.5秒 | 9,875 |
入力トークンはどのモデルも18,003でした。出力単価ではSonnetがHaikuの20倍、OpusがHaikuの40倍なのに、実際の費用差が約10倍と約31倍に縮んだのは、HaikuがSonnetの2.74倍の出力トークン(思考の分を含む)を書いたためです。速度も単価表の印象どおりではなく、9題中8題でSonnet 5.5が最初に回答を終え、Haikuが最速だったのは1題だけで、Opusは全題で最も遅くなりました。AAの計測ではHaiku 5.5の出力速度は毎秒173〜234トークンとSonnet 5.5(105〜134トークン)より速いのですが、書く量が多ければ終わるのは遅くなります。
この結果は、各題1回、1つの送信経路、1日、既定設定だけの測定です。3モデルの品質差が出ない小さな課題なので、同じ合格率での費用と時間を比べたものであり、HaikuがOpusと同等という意味にはなりません。品質の目安としては、既定設定のAA指数でHaiku 5.5が34点、Opus 5.5が51点という差のほうを使います。Fable 5.1は費用の上限を理由に実行しておらず、Anthropicのエンドポイントへの直接送信、effortの変更、プロンプトキャッシュ、Claudeアプリでの挙動も試していません。
Anthropic自身も、Haiku 5.5の発表で、複雑なエージェント型コーディングにはSonnet 5.5とOpus 5.5のほうが適しており、Haiku 5.5は要約、文脈の圧縮、サブエージェントのように範囲の決まった仕事に向くとしています。Haikuをxhighに上げると、AA指数でSonnet 5.5のmediumと同じ41点を4分の1の費用($0.12対$0.48)で出せますが、時間は2.4倍(291秒対121秒)かかります。Sonnetの仕事のどれをHaikuに移せるかは「Claude Haiku 5.5とSonnet 5.5の違い:単価差20倍をタスク費用で比較」で詳しく比べています。
単価表を月額の概算へ:4つのリクエスト例で計算
1リクエストの費用は、区分ごとのトークン数×100万トークンあたりの単価を足し、1,000,000で割れば求められます。月額は、これに月間のリクエスト数を掛けた値です。次の表は、4つの典型的なリクエストを2026年10月26日時点の定価(通常の経路、Batchなし)で計算したもので、どのモデルでも同じトークン数になると仮定しています。
| リクエスト | Haiku 5.5 | Sonnet 5.5 | Opus 5.5 | Fable 5.1 |
|---|---|---|---|---|
| A:入力1万、出力1,000、キャッシュなし | $0.0015 | $0.030 | $0.060 | $0.150 |
| B:エージェントの1ターン(キャッシュ読み取り9万、新規入力5,000、出力2,000) | $0.0024 | $0.039 | $0.078 | $0.1725 |
| C:Bのキャッシュ読み取りを15万にした場合 | $0.015 | $0.045 | $0.090 | $0.1875 |
| D:分類100万回(各回入力2,000、出力300) | $350 | $7,000 | $14,000 | $35,000 |
たとえばSonnet 5.5のBは、9万×$0.10+5,000×$2+2,000×$10を100万で割って$0.039です。BとCではキャッシュへの最初の書き込み費用を除いています。実際の仕事では、前節の実測のように出力トークン数がモデルごとに違うため、本番では候補ごとの請求トークンを記録し、合格した出力1件あたりの費用で計算し直します。
注意したいのはHaiku 5.5の価格帯の切り替わりです。BからCへ移ると、ほかの3モデルの費用は9〜15%しか増えないのに、Haikuだけは$0.0024から$0.015へ6.25倍になります。プロンプトの長さはキャッシュの読み取りと書き込みも含めて数えられ、10万トークンを超えたリクエストは全体が高い価格帯で請求されるからです(Pricingの長文コンテキスト料金)。Haiku 5.5は前のターンの思考ブロックも入力として持ち越すため、長いエージェントループでは早めにこの境界を超えます。なお、Sonnet 5.5のキャッシュ読み取りは2026年10月7日に$0.20から$0.10へ下がっており、計算方法は「Claude Sonnet 5.5のキャッシュ読み取り料金は$0.10:削減率の求め方」にまとめています。

図は2026年8月時点のラインナップ(Sonnet 5の導入価格の注記を含む)で作成したものです。本文の価格と内容は2026年10月26日時点のものです。
モデルを替える前にeffortを調整する:切り替えるサイン
品質が足りないとき、最初に動かすのはモデルではなくeffortです。4モデルともlow、medium、high、xhigh、maxの5段階に対応し、既定値を指定するのは省略するのと同じです。Anthropicのモデル選択ガイドも「effortの調整は、モデルを替えるよりよい手段であることが多い」と書いています。Claudeアプリでも、モデル選択メニューのeffortは既定のままでほとんどの仕事に合い、下げると早く答えて上限の消費も減り、最も高い設定は最も難しい問題に取っておくよう案内されています。
モデルを替えるより安く済むことが多いのは、隣のモデルへの段差が大きいからです。AAの数字では、Opus 5.5をmediumからhighに上げると3点上がって費用は1.36倍($1.34→$1.82)ですが、Fable 5.1に替えても既定設定では同じ51点のまま2.92倍かかります。Haiku 5.5もmediumからxhighに上げれば7点上がって$0.12で、Sonnet 5.5の既定($0.88)よりずっと安く済みます。ただし例外もあり、Sonnet 5.5をhighからxhighに上げると費用は2.3倍($0.88→$2.01)になり、より安いOpus 5.5のmediumとほぼ同じ点数になります。effortを上げた費用が隣のモデルの既定設定を超えるところが、モデルを替える目安です。
上げるサインは、同じ入力と合格条件で、effortを1〜2段上げても合格しない入力が残ることです。アプリでは、Sonnetで試してうまくいかなかったらOpus、OpusでうまくいかなかったらFableという順に進みます。下げるサインは、下位モデルでも同じ合格率が出て、費用か待ち時間が下がることです。Academyは、同じ依頼(例:添付したレポートを5つの箇条書きに要約し、別の出典で確かめたい主張を1つ挙げる)をHaikuとSonnetで実行し、回答の長さではなく、どこで答えが違うかを比べる方法を勧めています。

図は2026年8月時点のラインナップ(Sonnet 5を基準とした当時の案内)で作成したものです。本文は2026年10月26日時点の内容で、現在のAPIの出発点はOpus 5.5、アプリの出発点はSonnet 5.5です。
Model IDを替える前に、400エラーと挙動差を確認する
モデルIDを書き換えるだけでは動かない設定があり、旧モデルや別の階層から移るときに400エラーになります。2026年10月時点のAnthropicの各モデルの変更点(What's new)に記載されている主なものは次のとおりです。
| 設定 | 対象 | 結果と対処 |
|---|---|---|
強制ツール呼び出し(tool_choiceのany・tool) | Opus 5.5、Sonnet 5.5 | 400 tool_choice: type "tool" and "any" are not supported for this model.。autoと厳格なツール使用(strict tool use)に替える |
thinking: {"type":"disabled"} | Opus 5.5、Sonnet 5.5 | Opus 5.5は思考が常時オンで400。Sonnet 5.5は{"type":"between_tools"}を使う(low・medium・highのみ) |
手動のbudget_tokens | 4モデルすべて | 400。effortで調整する |
既定以外のtemperature・top_p・top_k、assistantのprefill | Haiku 4.5からHaiku 5.5へ移る場合 | エラーになるので外す。Haiku 5.5はhigh以下なら思考をオフにできる |
computer_20251124ツール | Opus 5.5 | 受け付けられない。移行前にOpus 5.5のWhat's newで確認する |
会話の途中でモデルを上げ下げする場合は、思考ブロックの引き継ぎにも差があります。Claude APIとGoogle Cloudでは、Opus 5.5はHaiku 5.5とSonnet 5.5の思考ブロックを読めるので、途中でOpusへ上げても安いモデルの推論が引き継がれます。逆にHaiku 5.5はOpus 5.5の、Sonnet 5.5はOpus 5・Opus 5.5・Fableの思考ブロックを読めず、読めないブロックはエラーにも課金にもならずに黙って捨てられます。下げる方向では、前のモデルの推論が失われると考えてください。
モデルIDは4.6世代以降も日付なしの固定スナップショットで、将来の版へ自動で切り替わる別名ではありません(Model IDs and versioning)。Amazon Bedrockではanthropic.claude-opus-5-5のような接頭辞付きのIDを使い、提供終了日もクラウド事業者ごとに決まるため、Anthropic APIの日付はModel deprecationsで、クラウド側の日付は各事業者の資料で確認します。
旧モデル名のHaiku 4.5・Sonnet 5・Opus 5・Fable 5は今どれに当たる?
Haiku 4.5、Sonnet 5、Opus 5、Fable 5の4つは、2026年10月26日時点でAnthropicのモデル一覧のレガシー欄にあり、APIから引き続き使えます。後継は同じ階層の5.5(Fableは5.1)で、価格は次のように変わりました。
| 旧モデル | 旧モデルの価格(入力 / 出力) | 後継 | 後継の価格(入力 / 出力) | 変わった点 |
|---|---|---|---|---|
| Haiku 4.5 | $1 / $5 | Haiku 5.5 | $0.10 / $0.50(10万トークン以下) | 単価は10分の1。10万トークン超は$0.50 / $2.50で2分の1 |
| Sonnet 5 | $2 / $10 | Sonnet 5.5 | $2 / $10 | キャッシュ読み取りが$0.20から$0.10へ |
| Opus 5 | $5 / $25 | Opus 5.5 | $4 / $20 | 入力・出力とも2割安い |
| Fable 5 | $10 / $50 | Fable 5.1 | $10 / $50 | キャッシュ読み取りが$1から$0.25へ |
Sonnet 5の$2 / $10は、発売時には2026年8月31日までの導入価格とされ、9月1日から$3 / $15に上がる予定でした。その値上げは実施されないことになり、$2 / $10がそのまま標準価格になっています(Pricingの脚注)。旧モデルから移るときは、前の節の400エラーの表、とくにHaiku 4.5からのtemperatureなどの扱いを先に確認してください。
1つの会社でも、処理ごとに選択を分ける
同じ会社でも、問い合わせの分類と、長い障害報告から修正案を作る処理では、間違えたときの損失が違います。分類のように大量で範囲の決まった処理は、Haiku 5.5とSonnet 5.5を同じ入力で比べます。前の表のDのように100万回で$350と$7,000の差が出るので、重要なカテゴリの見落としが増えないならHaikuに寄せる価値があります。修正案の作成はOpus 5.5のmediumを基準にし、合格しなかった難しい報告だけをFable 5.1でも評価します。
Claude Codeでも同じ考え方を使えます。Claude Codeのコストに関するドキュメントは、単純なサブエージェントの作業には設定でmodel: haikuを指定するよう勧めています。セッションの途中で/modelでモデルを切り替えると会話がキャッシュなしで読み直されるので、切り替えはセッションの区切りで行うほうが安く済みます。
切り替える前に、次の項目を確認しておくと比較がぶれません。代表的な入力の件数は20〜50件程度が小規模な比較を始める目安で、統計的な十分さを保証する数字ではありません。
- アプリかAPIか、APIならAnthropic直接かクラウド事業者経由かを記録した
- 代表的な入力と合格条件を、回答を読む前に決めた
- 候補を既定のeffortで比べ、足りない場合はまずeffortを1段上げた
- 1件あたりの単価ではなく、合格した出力1件あたりの費用と待ち時間で比べた
- Haiku 5.5では、10万トークンを超えるリクエストの割合を確かめた
- 400エラーになる設定(強制ツール呼び出し、thinkingの無効化、
budget_tokens)を外した
Claude Haiku・Sonnet・Opusのよくある質問
Claude Codeでhaikuと指定すると、どのHaikuが使われますか?
2026年10月15日時点のClaude Codeのドキュメントでは、Anthropic APIで使う場合、haikuはHaiku 5.5(v2.1.293以降)、opusはOpus 5.5を指します。Amazon Bedrock、Google Cloud、Microsoft Foundryではhaikuが以前のバージョンに解決されるため、Haiku 5.5を使いたいときはclaude-haiku-5-5とIDで固定します。Claude Codeの既定effortは、Opus 5.5、Sonnet 5.5、Haiku 5.5のいずれもmediumで、APIの既定(Sonnet 5.5はhigh)とは異なります。
Claudeアプリで選んだモデルと違うモデルが答えることはありますか?
あります。AnthropicのClaude Academyによると、生物学やセキュリティに関する一部の話題では、Claudeが選択したものとは別のモデルに切り替えることがあり、その場合は切り替えたことを表示します。2026年10月26日時点のAcademyの説明には、対象となる話題の一覧はありません。
参考資料9
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年11月10日。
参考資料9
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年11月10日。
- 1.AnthropicのModels overviewplatform.claude.com/docs/en/about-claude/models/overview
- 2.AnthropicのPricingplatform.claude.com/docs/en/about-claude/pricing
- 3.Claude Academyのモデル選択チュートリアルacademy.claude.com/tutorials/choosing-the-right-claude-model
- 4.モデル選択ガイド(Choosing the right model)platform.claude.com/docs/en/about-claude/models/choosing-a-model
- 5.AAのSonnet 5.5とOpus 5.5の比較ページartificialanalysis.ai/models/releases/comparisons/claude-sonnet-5-5-vs-claude-opus-5-5
- 6.AAのOpus 5.5とFable 5.1の比較ページartificialanalysis.ai/models/releases/comparisons/claude-opus-5-5-vs-claude-fable-5-1
- 7.Opus 5.5のWhat's newplatform.claude.com/docs/en/models/opus-5-5/whats-new-opus-5-5
- 8.Model IDs and versioningplatform.claude.com/docs/en/about-claude/models/model-ids-and-versions
- 9.Model deprecationsplatform.claude.com/docs/en/about-claude/model-deprecations