Claude Haiku 5.5とSonnet 5.5の違い:単価差20倍をタスク費用で比較
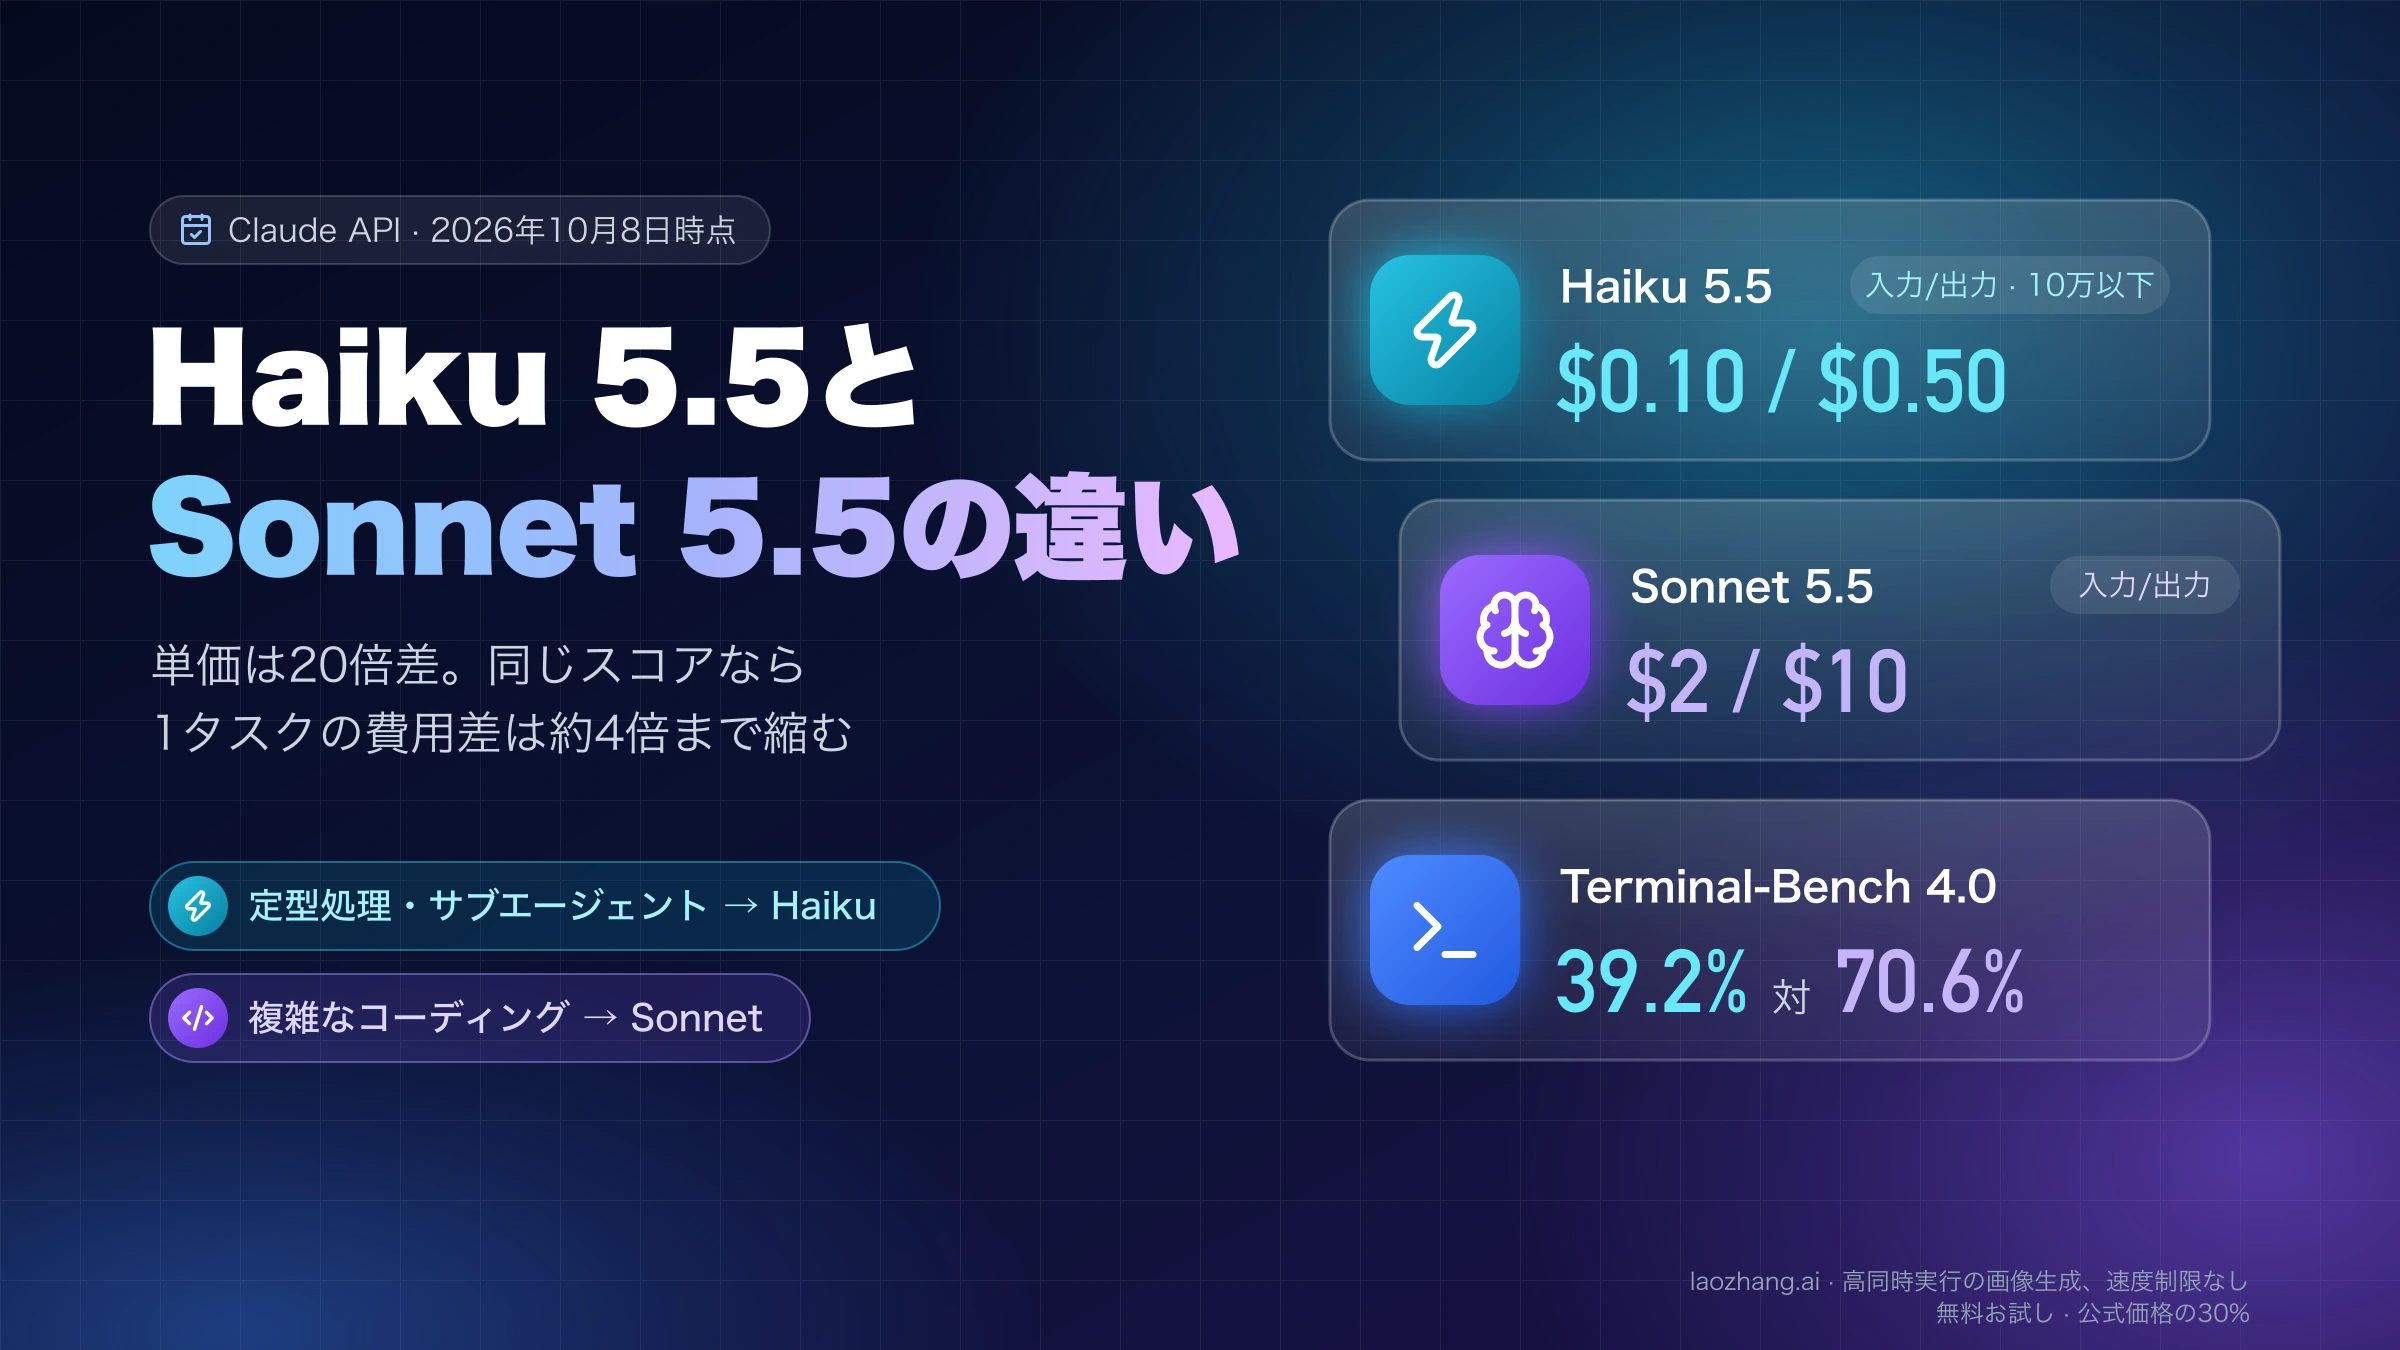
Claude Haiku 5.5の単価はSonnet 5.5の20分の1、同じスコアなら1タスク費用は約4倍差。定型処理はHaiku、複雑なコーディングはSonnetが基本です。
目次
Claude Haiku 5.5とClaude Sonnet 5.5は、仕事の種類で使い分けるのが基本です。分類・抽出・ルーティング・要約や、Claude Codeのサブエージェントのように範囲がはっきりした大量の仕事はHaiku 5.5へ移し、複雑なエージェント型コーディング、複数のツールをまたぐ業務の自動化、事実の正確さが問われる調べものはSonnet 5.5に残します。結果をテストやスキーマ検証で自動判定できる仕事なら、「まずHaikuで処理し、失敗した分だけSonnetでやり直す」構成も選べます。
2026年10月8日時点のClaude APIでは、プロンプトが10万トークン以下ならHaiku 5.5は入力$0.10・出力$0.50(100万トークンあたり)、Sonnet 5.5は入力$2・出力$10で、単価はちょうど20倍の差です。ただし、HaikuでSonnetに近い品質を出そうとeffortを上げると、トークン消費が増えます。Artificial Analysisの測定では、総合スコアが同じ41になる設定どうし(HaikuのxhighとSonnetのmedium)で比べると1タスクの費用差は約4倍まで縮み、所要時間はHaikuのほうが約2.3倍長くなります。単価だけを見て「費用が20分の1になる」と見積もると外れます。
Haiku 5.5のコンテキストを20万トークン、最大出力を6.4万トークン、思考方式を「拡張思考(extended thinking)」とする説明を見かけたら、それはHaiku 4.5の仕様です。Haiku 5.5はSonnet 5.5と同じく、コンテキスト100万トークン、最大出力12.8万トークン、適応型思考(adaptive thinking)を備えています。
以下のベンチマークと1タスク費用は、Anthropicの公表値とArtificial Analysisの独立測定によるもので、測定条件はそれぞれの表に添えます。
HaikuとSonnetの違いは何ですか:仕様は同じ、差は料金と性能
Haiku 5.5とSonnet 5.5は、コンテキスト長、最大出力、扱える入力、知識の期限が同じです。違うのは料金、性能、思考をオフにする方法、そしてeffortの既定値です。Anthropicのモデル一覧ドキュメントとSonnet 5.5の概要ドキュメントの記載を、2026年10月8日時点でまとめると次のとおりです。
| 項目 | Claude Haiku 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| リリース日 | 2026年10月7日 | 2026年9月28日 |
| モデルID(Claude API) | claude-haiku-5-5 | claude-sonnet-5-5 |
| コンテキスト | 100万トークン | 100万トークン |
| 最大出力 | 12.8万トークン(Batch APIはベータで30万) | 12.8万トークン(Batch APIはベータで30万) |
| 入力と出力 | テキストと画像 → テキスト | テキストと画像 → テキスト |
| 思考 | 適応型。effortがhigh以下ならdisabledでオフにできる | 適応型。最も軽い設定はbetween_tools(high以下) |
| effortの既定値(Claude API) | medium | high |
| effortの既定値(Claude Code) | medium | medium |
| 単価(入力/出力、100万トークンあたり) | $0.10 / $0.50(10万トークン以下) | $2 / $10 |
| Anthropicの位置づけ | 分類・抽出・ルーティングなど大量で低遅延の仕事向け。遅延の目安は「Fastest」 | 速度と知能のバランスが最良。遅延の目安は「Fast」 |
| 知識の信頼できる期限 | 2026年6月 | 2026年6月 |
| 提供終了 | 早くても2027年10月7日 | 早くても2027年9月28日 |
effortは、モデルがどれだけ考えるか、つまり品質・速度・費用の配分を決めるパラメーターで、low・medium・high・xhigh・maxの5段階があります。APIでモデルIDだけをclaude-sonnet-5-5からclaude-haiku-5-5に差し替えると、effortの既定値もhighからmediumに下がります。比較するときは、どの環境のどのeffortの話かをそろえる必要があります。
トークン数の数え方も確認しておきます。Haiku 5.5はClaude 4.7以降と同じ新しいトークナイザーを使い、同じ文章でもHaiku 4.5より約30%多くトークンを数えます。Sonnet 5.5も同じ世代のモデルなので、同じプロンプトは両モデルでほぼ同じトークン数になると考えられます。そのため、単価の比較はそのまま費用の比較として使えます。
使い分け:Haiku 5.5に移す仕事、Sonnet 5.5に残す仕事
範囲が狭く結果を確かめやすい大量の仕事はHaiku 5.5、長い手順を自律的にこなす仕事や、間違いが高くつく仕事はSonnet 5.5です。AnthropicもHaiku 5.5の発表記事で、Terminal-Bench 4.0で測るような複雑なエージェント型コーディングにはSonnet 5.5とOpus 5.5のほうが適しており、Haiku 5.5はコンパクション(会話の圧縮)、要約、サブエージェントのような範囲の狭い仕事に向くと説明しています。
| 仕事 | 選ぶモデル | 根拠と条件 |
|---|---|---|
| 分類・抽出・ルーティング・大量の定型処理 | Haiku 5.5(low〜medium) | Anthropicが想定する用途。10万トークン以下なら1件の費用はSonnetの20分の1 |
| 要約、コンパクション、長い文書の読み取り | Haiku 5.5 | Artificial Analysisの長文読解評価(AA-LCR)でSonnetとほぼ同点 |
| Claude Codeのサブエージェント(コード探索、調査、テスト実行の下請け) | Haiku 5.5 | Anthropicのモデル選択ガイドがサブエージェント用途に挙げている |
| 長いエージェント型コーディング、ターミナル作業 | Sonnet 5.5 | Terminal-Bench 4.0でHaiku 39.2%、Sonnet 70.6%(Anthropic公表) |
| 複数の業務ツールをまたぐ自動化 | Sonnet 5.5 | AutomationBench-AAで、同じeffortでもSonnetが約2倍のスコア |
| 事実の正確さが重要な調べもの、社内ナレッジへの回答 | Sonnet 5.5 | ハルシネーションを減点するAA-OmniscienceでHaikuは大きく下回る |
| テストやスキーマ検証で合否を自動判定できる仕事 | まずHaiku、失敗したらSonnet | Haikuの合格率が約10%を超えれば、Sonnet単独より合計費用が安い |
| ユーザーが応答を待つチャット | 両方を計測して決める | Haikuは出力は速いが、思考ありの設定では最初の1文字が出るまで時間がかかる |
Haikuで始めた仕事をSonnetに上げる合図は、主に3つです。effortをhighまで上げても品質が足りないとき、xhighやmaxが必要になったとき、そして長いエージェント作業で途中終了や確認なしの完了報告が続くときです。Claude APIのeffortドキュメントも、Haikuでxhighやmaxを使うのは自分の評価で品質向上を確認できた場合に限り、その場合は性能・費用・速度をSonnet 5.5と比べるよう勧めています。後述のとおり、HaikuのxhighはSonnetのmediumと同じスコアで費用は4分の1ですが、時間は2倍以上かかります。
費用を抑えたいのにどちらか決めきれない場合は、Anthropicのモデル選択ガイドが多くの用途で最適になりうるとする順序が使えます。Haiku 5.5で実装を始め、自分のタスクでテストして、足りない部分だけ上位モデルに上げる方法です。同じガイドは「モデルを変えるより、effortを調整するほうが効くことが多い」とも書いています。Sonnet 5.5でも足りない仕事は、Claude Fable 5.1とOpus 5.5の比較を参考にOpus 5.5以上を検討してください。
性能差はどれくらいか:Terminal-Bench 4.0は39.2%対70.6%
Anthropicの表でも、Artificial Analysisの独立測定でも、総合的な性能はSonnet 5.5が上です。ただし差の大きさは仕事の種類で大きく変わり、長文の読み取りではほぼ並び、業務の自動化や知識の正確さでは大差がつきます。
Anthropicが発表したベンチマーク
Haiku 5.5の発表記事には、参考としてSonnet 5.5の値が並んでいます。すべての項目でSonnetが上です。
| 評価 | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|
| Terminal-Bench 4.0 | 39.2% | 70.6% |
| OSWorld 2.1(オフライン部分集合、部分点あり) | 72.4% | 83.9% |
| GDPval-AA v2.1 | 1620 | 1840 |
| AA-Briefcase v1.1 | 1578 | 1824 |
| Humanity's Last Exam(ツールなし / あり) | 45.9% / 57.4% | 56.9% / 64.5% |
| FrontierCode 1.1 (Main) | 46.4% | 52.1%(Sonnetはxhigh) |
| Chartography(ツールなし) | 46.4% | 61.6% |
FrontierCode以外の項目では、各列のeffort設定は明記されていません。なお、Haiku 4.5のTerminal-Bench 4.0は0.0%で、Haiku 5.5は前の世代から大きく伸びたものの、エージェント型コーディングではまだSonnetの約半分です。
Artificial Analysisの5段階effort測定
同じeffortどうし、同じスコアどうしで比べられるデータは、Artificial AnalysisのHaiku 5.5とSonnet 5.5の比較ページにあります。両モデルをそれぞれ5段階のeffortで、同じ総合指数(Intelligence Index v4.3.2)にかけた結果です。
| effort | Sonnet指数 | 1タスク費用 | 1タスク時間 | Haiku指数 | 1タスク費用 | 1タスク時間 |
|---|---|---|---|---|---|---|
max | 56 | $5.46 | 921秒 | 43 | $0.21 | 423秒 |
xhigh | 52 | $2.01 | 431秒 | 41 | $0.12 | 291秒 |
high | 47 | $0.88 | 217秒 | 38 | $0.08 | 194秒 |
medium | 41 | $0.48 | 126秒 | 34 | $0.05 | 134秒 |
low | 36 | $0.35 | 90秒 | 29 | $0.02 | 62秒 |
2026年10月8日時点の値です。Sonnet側の測定には「with fallback」という表記が付いていますが、その意味はページ上で説明されていません。費用はSonnetのキャッシュ読み出し$0.10、Haikuの10万トークン以下の単価で計算されているため、長いプロンプトを使う仕事ではHaikuの費用が実際より低く出る可能性があります。Artificial Analysisは定期的に測り直すので、数字は変わることがあります。
この表から読み取れることは4つです。
- 同じeffortでは、Sonnetの指数が常に7〜13ポイント高くなっています。Haikuの
max(43)でも、Sonnetのmedium(41)をわずかに上回る程度です。 - 出力の速さはHaikuが上で、毎秒137〜243トークン(Sonnetは101〜136トークン)です。Anthropicの「Fastest」はこの意味です。
- ところが、最初のトークンが出るまでの時間は、Sonnetの
lowが1.05秒、mediumが2.05秒なのに対し、Haikuはlowで11.99秒、mediumで12.63秒でした。Haikuは答え始める前に考えるため、応答の書き出しは遅くなります。 mediumどうしでは、1タスクの所要時間はHaiku 134秒、Sonnet 126秒で、Haikuのほうがわずかに長くかかっています。
仕事によって差が変わる項目
総合指数は10種類の評価の平均なので、個別の差が隠れます。同じ比較ページのサブスコアを、Claude Codeの既定値であるmediumと最上位のmaxで抜き出すと次のようになります。
| 評価(Artificial Analysis測定) | Sonnet max | Haiku max | Sonnet medium | Haiku medium |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 63.6% | 32.8% | 29.8% | 15.2% |
| AutomationBench-AA(業務の自動化) | 71.8% | 35.4% | 54.9% | 28.6% |
| AA-Omniscience(知識の信頼性、ハルシネーションを減点) | 32 | 11 | 20 | 4 |
| AA-LCR v1.1(長文読解) | 82.7% | 82.7% | 76.3% | 77.3% |
| SciCode | 61.0% | 55.0% | 52.9% | 49.0% |
長文読解ではHaikuがSonnetと並び、mediumではわずかに上回っています。科学計算コードのSciCodeも差は数ポイントです。一方、業務の自動化はほぼ半分、知識の信頼性はmaxで約3分の1、mediumで5分の1にとどまり、Haikuに任せるなら結果を確かめる仕組みが欠かせません。
Haiku 5.5とSonnet 5.5の料金:10万トークン超はHaikuが5倍
Haiku 5.5の単価は、プロンプトが10万トークンを超えるとすべての項目が5倍になります。Sonnet 5.5は100万トークンまで同じ単価です。Claude APIの料金ページの2026年10月8日時点の値は次のとおりです(100万トークンあたり、USD)。
| 項目 | Haiku 5.5(10万トークン以下) | Haiku 5.5(10万トークン超) | Sonnet 5.5 |
|---|---|---|---|
| 入力 | $0.10 | $0.50 | $2 |
| 出力 | $0.50 | $2.50 | $10 |
| キャッシュ書き込み(5分) | $0.125 | $0.625 | $2.50 |
| キャッシュ書き込み(1時間) | $0.20 | $1 | $4 |
| キャッシュ読み出し | $0.01 | $0.05 | $0.10 |
| Batch API(入力 / 出力) | $0.05 / $0.25 | $0.25 / $1.25 | $1 / $5 |
倍率は項目によって違います。10万トークン以下では、入力・出力・キャッシュ書き込みが20倍差、キャッシュ読み出しは10倍差です。10万トークンを超えると、入力と出力は4倍差、キャッシュ読み出しは2倍差まで縮みます。
10万トークンの境界には注意点があります。料金表は「10万トークンを超えるプロンプト」と書くだけで、キャッシュ済みの部分やツール定義をこの10万に数えるかは明記していません。各行に入力・出力・キャッシュの単価がまとめて書かれていることから、境界を超えたリクエストは出力を含めて高い単価になると読めます。予算は、キャッシュ読み出し・キャッシュ書き込み・キャッシュなし入力の合計で10万を判定して見積もるのが安全です。
Sonnet 5.5のキャッシュ読み出しは、Haiku 5.5の発表と同じ2026年10月7日に$0.20から$0.10へ値下げされました。Anthropicは、多くのエージェント作業でSonnet 5.5の費用が約20%下がると説明しています。$0.20と書かれた料金表は値下げ前の情報です。
発表記事にある「約75%安い」「90%安い」は、Haiku 4.5と比べた数字です。平均で約75%、10万トークン以下のリクエストで90%、超える場合で50%安いとされ、新しいトークナイザーでトークン数が少し増える分も織り込まれています。Sonnet 5.5との比較ではありません。
1タスクあたりの費用:単価差20倍が4倍まで縮む条件
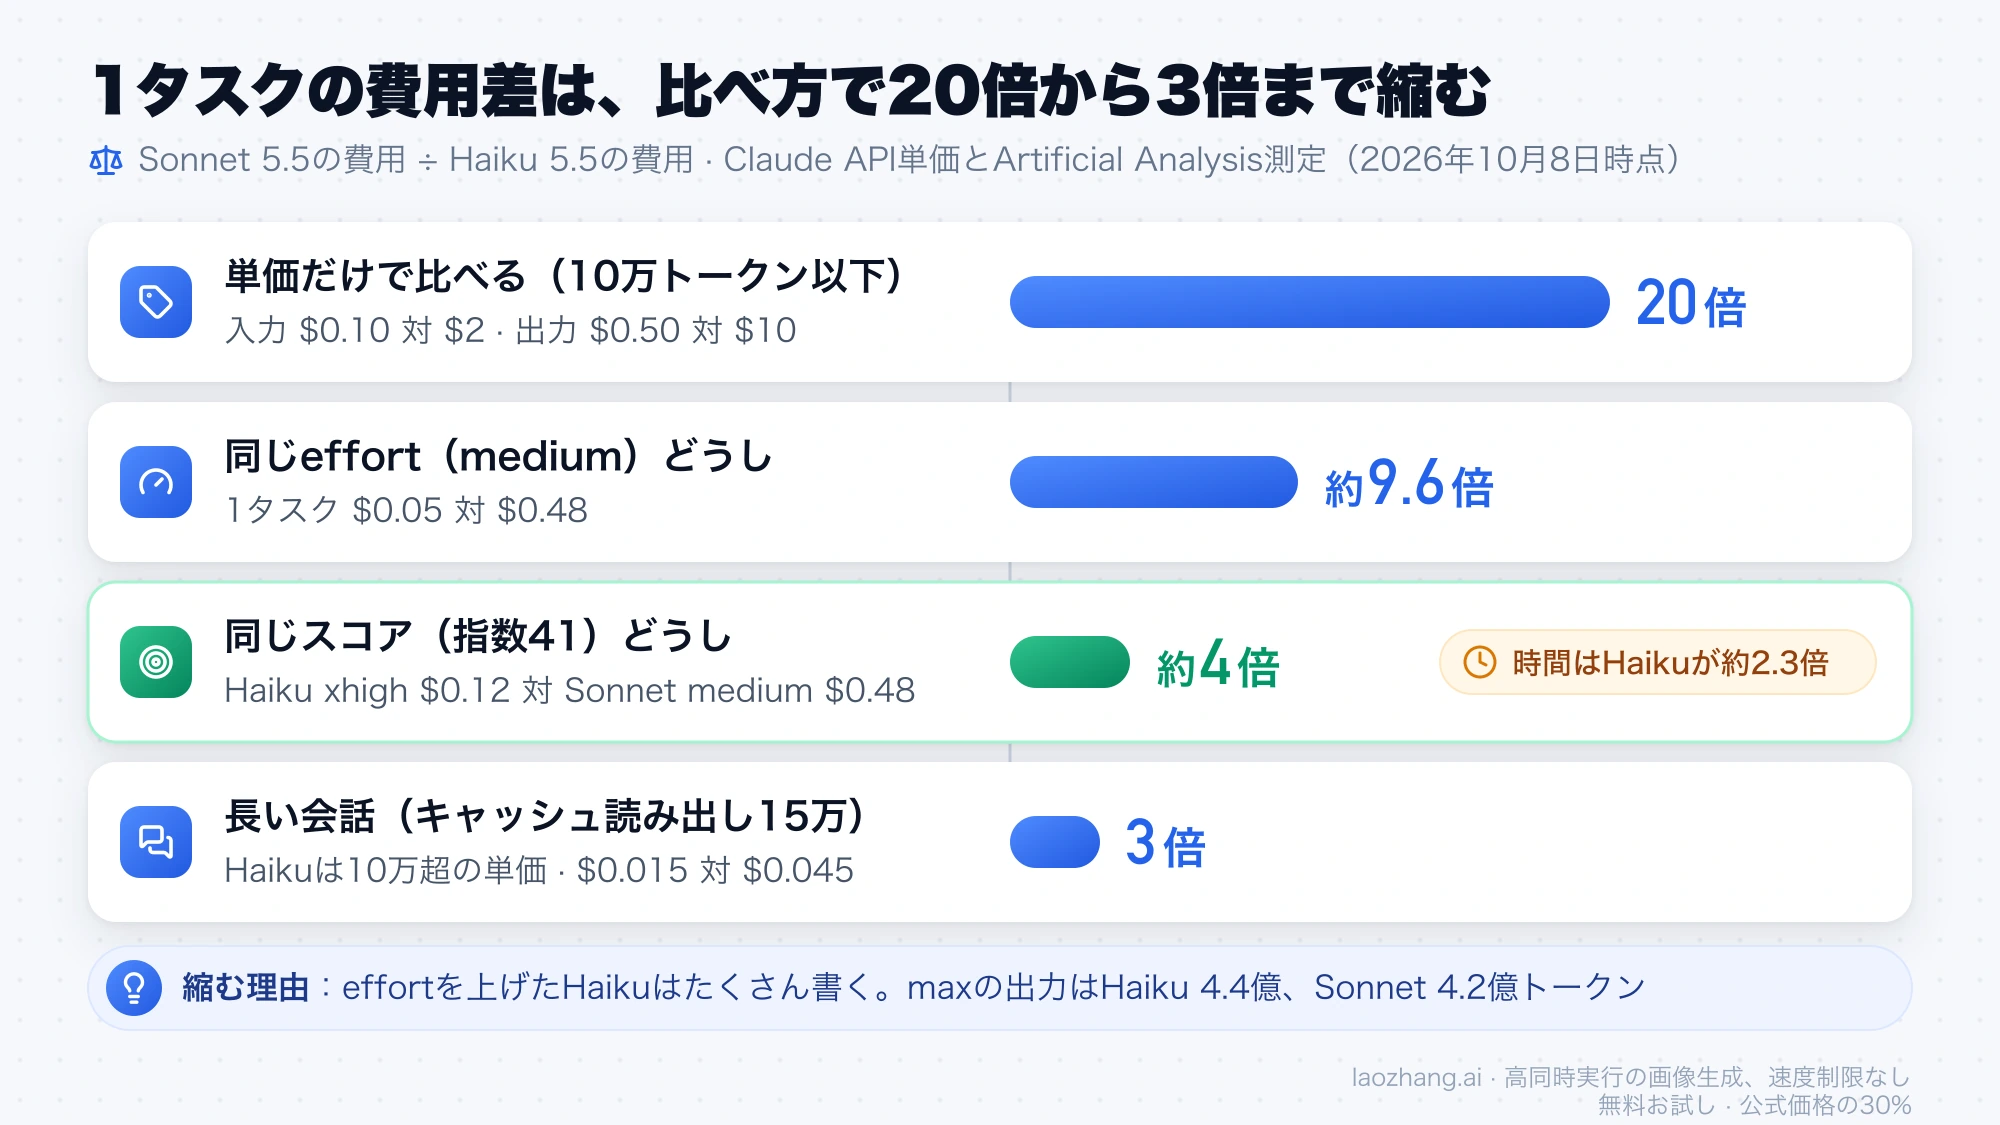
単価が20倍違っても、1タスクの費用差が20倍になるとは限りません。プロンプトが10万トークンを超えるとき、キャッシュ読み出しが大半を占めるとき、そしてHaikuのeffortを上げてSonnetと同じ品質をねらうとき、差は小さくなります。
リクエスト単位の計算例
計算式は次のとおりです。出力トークンには思考のトークンも含まれます。
費用(USD)= Σ(トークン数 × 100万トークンあたりの単価)÷ 1,000,000上の料金表の単価で計算した例です。キャッシュの記載がない行はキャッシュなしとし、両モデルで同じトークン数になると仮定しています。
| 例 | Haiku 5.5 | Sonnet 5.5 | 差 |
|---|---|---|---|
| 入力1万+出力1,000 | $0.0015 | $0.030 | 20倍 |
| 入力9.9万+出力2,000 | $0.0109 | $0.218 | 20倍 |
| 入力15万+出力2,000(Haikuは10万超の単価) | $0.080 | $0.32 | 4倍 |
| 分類100万件(1件あたり入力2,000+出力300) | $350 | $7,000 | 20倍 |
| エージェントの1ターン:キャッシュ読み出し9万+新規入力5,000+出力2,000 | $0.0024 | $0.039 | 約16倍 |
| 同じ1ターンでキャッシュ読み出しが15万(Haikuは10万超の単価) | $0.015 | $0.045 | 3倍 |
エージェントの例では、最初のターンのキャッシュ書き込み費用を除いています。9万トークンのキャッシュ読み出しを含むターンは、Sonnetの値下げ前は$0.048だったので、今回の値下げで18.75%安くなった計算です。最後の行は、キャッシュ分も10万に数える安全側の前提です。Claude Codeの長いセッションのように会話が10万トークンを超えると、Haikuの価格面の利点は約3倍まで縮みます。
同じ品質で比べたときの1タスク費用
前述のArtificial Analysisの表を費用で見ると、比べ方によって倍率が大きく変わります。
- 同じeffortでは、
mediumでSonnetがHaikuの約9.6倍($0.48 ÷ $0.05)、lowで約17.5倍($0.35 ÷ $0.02)です。 - 同じ指数41どうし(Haikuの
xhighとSonnetのmedium)では、Haikuが$0.12、Sonnetが$0.48で約4倍差です。所要時間はHaikuが291秒、Sonnetが126秒で、Haikuのほうが約2.3倍長くかかります。 - Haikuの
max(指数43、$0.21、423秒)は、Sonnetのmedium(指数41、$0.48、126秒)よりスコアが高く、費用は半分以下ですが、時間は約3.4倍です。
倍率が縮むのは、Haikuがeffortを上げるとたくさん書くからです。maxで指数のテストを一通り回したとき、Haikuは4.4億トークン、Sonnetは4.2億トークンを出力しました(Artificial Analysisの各モデルページ)。maxのHaikuは、Sonnetと同じくらいの量のトークンを使うということです。
まずHaiku、失敗したらSonnet:合格率が約10%を超えれば安くなる
合否を自動で判定できる仕事では、全件をまずHaikuで処理し、不合格の分だけSonnetでやり直す構成がとれます。1タスクの期待費用は次の式で計算できます。
期待費用 = Haikuの1タスク費用 + (1 − p) × Sonnetの1タスク費用
p = Haikuで合格する割合
Artificial Analysisのmediumの1タスク費用(Haiku $0.05、Sonnet $0.48)を入れると、期待費用は「0.05 + (1 − p) × 0.48」ドルです。Sonnet単独($0.48)より安くなるのは、pが0.05 ÷ 0.48、つまり約10.4%を超えるときです。
| Haikuの合格率p | 1,000件の費用 | Sonnet単独との差 |
|---|---|---|
| 50% | $290 | $190安い |
| 70% | $194 | $286安い |
| 90% | $98 | $382安い |
| Sonnetのみ | $480 | — |
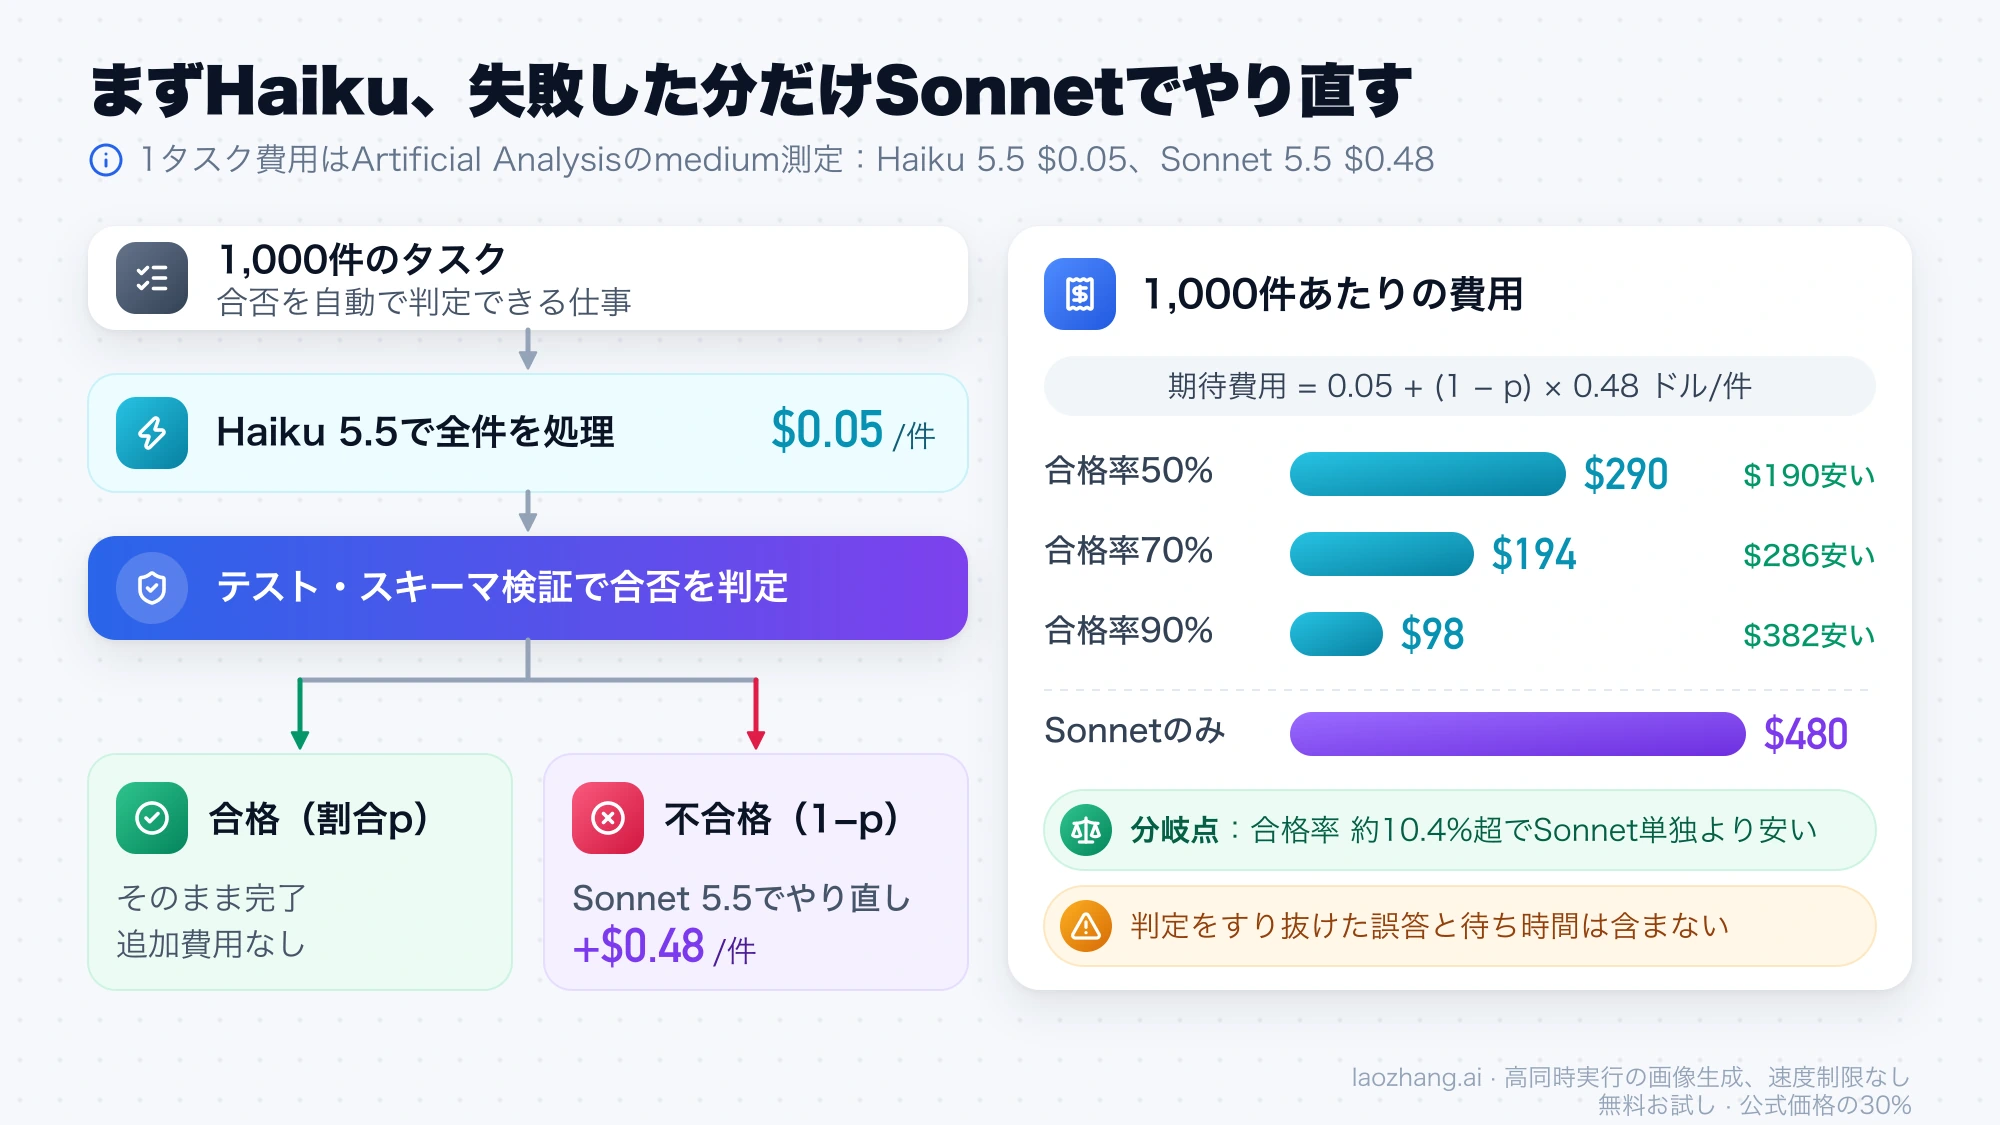
この計算は、次の前提と除外項目のうえに成り立っています。
- 失敗をテスト、型チェック、JSONスキーマ、バリデーターなどで自動的に、追加費用なしで検出できること。
- やり直したSonnetが成功すること。
- 判定をすり抜けた誤答のコストは含めていません。実際にはこれがいちばん高くつくので、合否判定がない仕事にはこの構成を使わないでください。
- 待ち時間は含めていません。やり直したタスクでは、Haikuの処理時間が上乗せされます。
手元の仕事に当てはめるときは、Haiku・Sonnetそれぞれの1タスク費用と合格率pを、自分のタスクで数十件ほど測って式に入れ直してください。
同じリクエストを両方のモデルに送る実装では、パラメーターの違いにも注意が必要です。tool_choiceでツール呼び出しを強制するとSonnet 5.5はエラーを返し、思考をオフにする設定もHaikuはdisabled、Sonnetはbetween_toolsと異なります。Haiku用の設定のままSonnetに転送しないよう、モデルごとにリクエストを組み立ててください。
Sonnet 5.5からHaiku 5.5へ切り替えるときに確認すること
APIでモデルを切り替えるときは、モデルIDの差し替えだけでは済まない項目があります。Haiku 5.5の変更点ドキュメントとAnthropicのHaiku 5.5向けプロンプトガイドをもとに、確認順に並べます。
- モデルID:
claude-sonnet-5-5をclaude-haiku-5-5に変えます。Amazon Bedrockではanthropic.claude-haiku-5-5、Google Cloud、Microsoft Foundry、Claude Platform on AWSではclaude-haiku-5-5です。 - effortを明示する:APIの既定値はSonnetの
highからHaikuのmediumに下がります。Sonnetで使っていた値を持ち込まず、low・medium・highのうち2〜3段階を自分の評価データで比べてください。 - 思考をオフにする設定:Sonnetの
thinking: {"type": "between_tools"}は、Haikuではthinking: {"type": "disabled"}に置き換えます。使えるのはeffortがhigh以下のときだけで、xhighとmaxでは400エラーになります。 max_tokensの余裕:思考のトークンもmax_tokensに数えられます。小さすぎると、思考ブロックだけで回答本文が出ないまま止まります。- 応答ブロックの取り出し方:応答が思考ブロックから始まることがあるので、先頭のブロックを回答とみなさず、
typeで選びます。 - 拒否の処理:Haiku 5.5の安全分類器は
stop_reason: "refusal"を返すことがあり、サーバー側のフォールバックはありません。クライアントで処理してください。同じリクエストをHaikuに再送しても、通常はまた拒否されます。 - JSON出力とツール呼び出し:思考オフとstructured outputs(JSON形式の出力)を組み合わせると、Haikuが必要なツール呼び出しを飛ばすことがあります。適応型思考に戻す、ツールが必要なリクエストから
output_config.formatを外す、tool_choiceで強制する、のいずれかで対処します。 - 長いエージェントプロンプトでの途中終了:
lowでは作業途中でユーザーに返すことがあります。Anthropicのテストでは、lowからmediumに上げると途中終了がほぼ半減し、出力トークンは2倍以上に増えました。プロンプトガイドには、最後まで作業を続けさせるためのシステムプロンプト例もあります。 - 確認なしの完了報告:
lowとmediumでは、コード変更をテストやビルドで確かめないまま「完了」と報告することがあります。実際のチェックを走らせてから報告するよう、システムプロンプトで指示します。 - 検索ツールと日付:検索ツールを渡すときは、今日の日付をシステムプロンプトかツールの説明に入れます。Anthropicのテストでは、これで最近の検索結果に基づいて答えるようになりました。
- computer use:Claude APIとGoogle Cloudでは
computer_toolset_20260801が必要です。 - セキュリティ用途:Haiku 5.5のサイバーセキュリティ系セーフガードは、防御目的の作業についてはSonnet 5.5より広く通しますが、ペネトレーションテストはブロックします。正当なセキュリティ業務が止まる場合は、AnthropicのCyber Verification Programに申請できます。
effortを会話の途中でターンごとに変えたい場合、リクエスト全体のeffortを変えると会話部分のプロンプトキャッシュが無効になります。メッセージ単位の変更(ベータヘッダーmid-conversation-output-config-2026-07-01、Claude APIとGoogle Cloud)ならキャッシュが残りますが、適応型思考が前提で、disabledのときは400エラーになります。
Haiku 4.5から移る場合は、さらに3つの書き方がエラーになります。思考予算のbudget_tokens、既定以外のtemperature・top_p・top_k(400エラー)、アシスタントメッセージのプリフィル(応答の書き出し指定)です。
Claude CodeでHaiku 5.5を使う:/modelとサブエージェントの設定
Claude CodeでHaiku 5.5を使うには、v2.1.293以降が必要です(Sonnet 5.5はv2.1.284以降)。古い場合はclaude updateで更新します。Claude Codeのモデル設定ドキュメントにある指定方法は次のとおりです。
# セッション中に切り替える
/model claude-haiku-5-5

# Haiku 5.5で起動する
claude --model claude-haiku-5-5

# メインのモデルはそのまま、サブエージェントの既定だけをHaikuにする
export CLAUDE_CODE_SUBAGENT_MODEL=haiku
Claude Codeでは、Sonnet 5.5もHaiku 5.5もeffortの既定値はmediumです(APIではSonnetがhigh)。また、Claude CodeではHaiku 5.5とSonnet 5.5の思考をオフにできません。
エイリアスの解決先はプロバイダーによって違います。Anthropic APIではhaikuがHaiku 5.5、sonnetがSonnet 5.5を指しますが、Claude Platform on AWSではsonnetがSonnet 4.6、haikuがHaiku 4.5、Amazon Bedrock、Google CloudのAgent Platform、Microsoft FoundryではsonnetがSonnet 4.5、haikuがHaiku 4.5です。これらの環境では、フルのモデルIDを指定するか、ANTHROPIC_DEFAULT_HAIKU_MODELで固定してください。この環境変数はバックグラウンド処理に使うモデルも決めます。
メインをSonnet 5.5のままにしてサブエージェントだけHaikuにするなら、CLAUDE_CODE_SUBAGENT_MODEL=haikuが手軽です。これはモデルが指定されていないサブエージェント、エージェントチームのメンバー、ワークフローのエージェントの既定値になります。呼び出し時の指定やサブエージェント定義のmodelフィールド(inheritを含む)があればそちらが優先されます。メイン会話のモデルを継承するサブエージェントは、/modelで切り替えたモデルで動きます。
長いセッションの費用にも気を付けてください。Haiku 5.5はAnthropic APIのどのプランでも100万トークンのコンテキストで動きますが、従量課金で使う場合、プロンプトが10万トークンを超えたリクエストは高い単価になります。コードベースを読み込んだセッションはすぐに10万を超えるため、メインのセッションをHaikuにしても、前述のとおり価格差は3〜4倍程度まで縮みます。Haikuの単価の安さを生かしやすいのは、短い指示で完結するサブエージェントの側です。
ドキュメントによると、Haikuのセッションはプランモードでは通常Sonnetに切り替わります(許可リストでSonnetがすべて除外されている場合を除く)。計画を立てる段階だけは、Haikuを選んでいてもSonnetが使われると考えてください。
サブスクリプションで使うか、APIの従量課金で使うかの選び方と、Max・Teamに付く月次のAPIクレジットについてはClaude APIとClaude Codeの違いと使い分けで扱っています。
ClaudeアプリでHaiku 5.5を選ぶと使用量は節約できるか
Claude.aiでは、Free・Pro・Max・Team・EnterpriseのどのプランでもHaiku 5.5を選べます。ウェブ、iOS、Androidのいずれでも使えるとAnthropicのClaude Haiku製品ページに記載されています。Sonnet 5.5も全プランで使えます。
使用量については、Claudeヘルプセンターの使用量と長さの制限の解説に、会話の長さと複雑さ、使う機能、選んだモデル、effortで消費が変わると書かれています。ただし、モデルごとの消費の比率や送れるメッセージ数は公開されていません。Haikuのほうが枠の減りは遅いと考えられますが、「何倍使える」とは言えません。Claude.ai、Claude Code、Claudeデスクトップの利用は同じ上限に数えられます。
アプリで枠を長持ちさせたい場合は、短い質問や下書き、要約をHaikuに切り替えるのに加えて、ヘルプセンターが挙げるようにeffortを下げ、不要なツールや接続アプリをオフにします。プランごとの上限の仕組みはClaudeの使用制限プラン別一覧にまとめています。
Claude Haiku 5.5とSonnet 5.5のよくある質問
Claude Haiku 5.5でコーディングは足りますか?
範囲の決まった変更、コード検索、テスト実行の下請けなら足りることが多く、Claude Codeのサブエージェントには向いています。一方、長い手順のエージェント型コーディングはSonnet 5.5が明確に上です。Anthropic公表のTerminal-Bench 4.0はHaiku 39.2%、Sonnet 70.6%で、Artificial Analysisの同じ評価でも、同じeffortのHaikuはSonnetのおよそ半分のスコアでした。Haikuに任せる場合は、変更をテストで確かめてから完了と報告するよう指示しておくと失敗を減らせます。
Claude Haiku 5.5の「90%安い」はSonnet 5.5と比べた数字ですか?
違います。Haiku 4.5との比較で、10万トークン以下のリクエストで90%、平均で約75%安いという意味です。Sonnet 5.5との単価差は、10万トークン以下で20倍、超える場合で4倍です。
Claude Haiku 5.5は最速なのに、応答が遅く感じるのはなぜですか?
「Fastest」は出力の速さを指し、書き出しまでの時間ではありません。Haiku 5.5は答える前に考えるため、Artificial Analysisの測定では最初のトークンまでlowで約12秒かかり、Sonnet 5.5のlow(約1秒)より遅くなりました。APIでは、effortをhigh以下にしてthinking: {"type": "disabled"}を送れば思考をオフにできます。思考をオフにしたときの待ち時間は測定されていないので、自分の環境で確かめてください。
Sonnet 5.5でも足りないときはOpus 5.5とFable 5.1のどちらですか?
次の候補はOpus 5.5です。Anthropicのモデル選択ガイドは、Opus 5.5のxhighやmaxでも難しい推論や長時間の自律作業が足りない場合に、Fable 5.1へ進む順序を示しています。詳しくはClaude Fable 5.1とOpus 5.5の比較、Opusの料金はClaude Opus 5.5の料金と上限リセット権を参照してください。
参考資料12
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月8日。
参考資料12
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月8日。
- 1.Anthropicのモデル一覧ドキュメントplatform.claude.com/docs/en/about-claude/models/overview
- 2.Sonnet 5.5の概要ドキュメントplatform.claude.com/docs/en/models/sonnet-5-5/overview
- 3.Haiku 5.5の発表記事anthropic.com/claude-haiku-5-5
- 4.Claude APIのeffortドキュメントplatform.claude.com/docs/en/build-with-claude/effort
- 5.Anthropicのモデル選択ガイドplatform.claude.com/docs/en/about-claude/models/choosing-a-model
- 6.Artificial AnalysisのHaiku 5.5とSonnet 5.5の比較ページartificialanalysis.ai/models/releases/comparisons/claude-haiku-5-5-vs-claude-sonnet-5-5
- 7.Claude APIの料金ページplatform.claude.com/docs/en/about-claude/pricing
- 8.Haiku 5.5の変更点ドキュメントplatform.claude.com/docs/en/models/haiku-5-5/whats-new-haiku-5-5
- 9.AnthropicのHaiku 5.5向けプロンプトガイドplatform.claude.com/docs/en/build-with-claude/prompt-engineering/prompting-claude-haiku-5-5
- 10.Claude Codeのモデル設定ドキュメントcode.claude.com/docs/en/model-config
- 11.AnthropicのClaude Haiku製品ページanthropic.com/claude/haiku
- 12.Claudeヘルプセンターの使用量と長さの制限の解説support.claude.com/en/articles/11647753-understanding-usage-and-length-limits