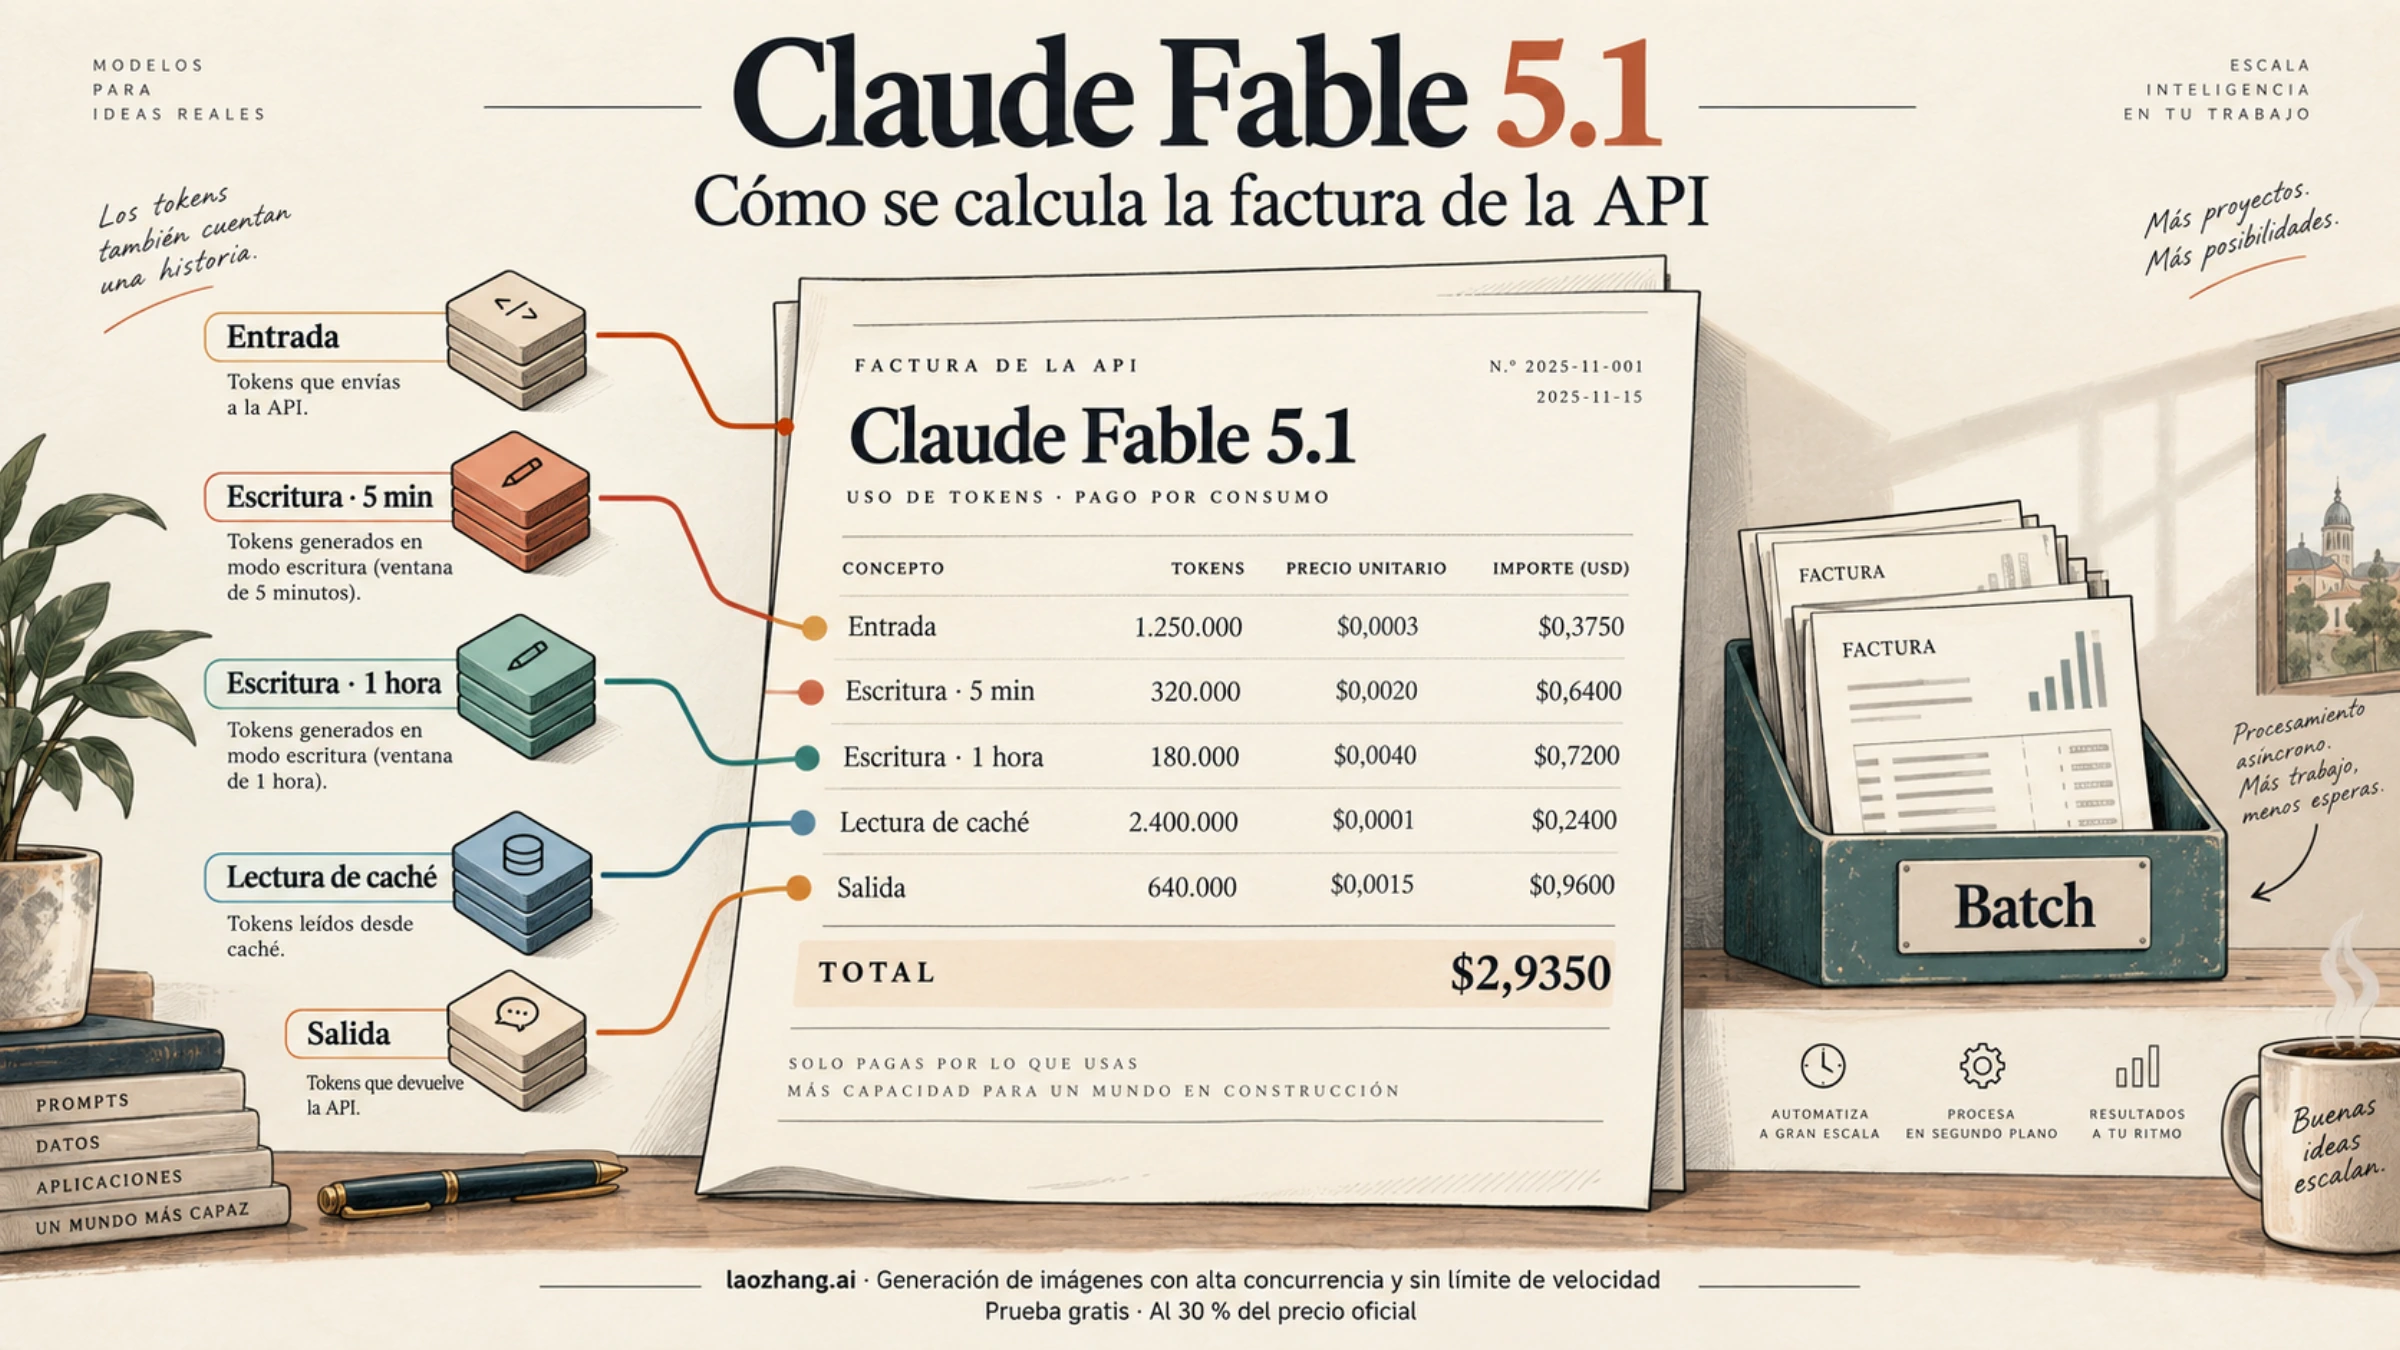
Claude Fable 5.1 cuesta 10 USD por millón de tokens de entrada sin caché y 50 USD por millón de tokens de salida en la API directa de Anthropic. Para presupuestar una aplicación, hay que añadir tres partidas con precios distintos: las escrituras de caché de cinco minutos, las de una hora y las lecturas. Si el trabajo admite procesamiento asíncrono, Message Batches reduce un 50 % esas tarifas de tokens. Son los precios oficiales consultados el 19 de septiembre de 2026 para inferencia global estándar, sin impuestos ni acuerdos privados. Tarifas de Anthropic.
El dato más útil para comprobar la factura es usage. La longitud de la respuesta visible no basta: parte de la entrada puede haberse reutilizado y la salida facturada puede incluir razonamiento. Esta guía separa las partidas y muestra un cálculo que puedes repetir con el consumo de tu aplicación.
Tarifas por millón de tokens
El identificador del modelo es claude-fable-5-1. Los importes de esta tabla corresponden a la API directa; una suscripción a la aplicación de Claude y las tarifas de un intermediario tienen otro alcance. Ficha oficial de Fable 5.1.
| Partida facturada | API estándar, USD/millón | Batch, USD/millón |
|---|---|---|
| Entrada sin caché | 10 | 5 |
| Escritura de caché de 5 minutos | 12,50 | 6,25 |
| Escritura de caché de 1 hora | 20 | 10 |
| Lectura de caché | 0,25 | 0,125 |
| Salida | 50 | 25 |
La columna Batch ya incluye el descuento del 50 %: no vuelvas a dividirla por dos. Anthropic permite combinar los multiplicadores de caché con el descuento de Batch. Esto reduce el precio de los tokens que realmente se hayan leído de caché; no garantiza que una petición vaya a obtener un acierto. Precios de Batch y caché.
La rebaja del 75 % frente a Fable 5 afecta solo a la lectura de caché, que pasa de 1 a 0,25 USD por millón de tokens. No es una rebaja del 75 % de toda la factura. Cuanto más pesen las respuestas largas, las entradas nuevas o las escrituras, menos representará esa mejora en el total. El contexto de hasta un millón de tokens mantiene las mismas tarifas por token, aunque introducir más contenido sigue aumentando el consumo. Precios y contexto de Fable 5.1.
De usage al coste: cinco partidas que no se solapan
En la respuesta de la API, usage.input_tokens recoge únicamente la entrada sin caché. No incluye los tokens leídos ni los escritos en ella. Para reconstruir todo el consumo de entrada hay que sumar esas tres categorías; para calcular el precio, hay que mantenerlas separadas. Cómo medir el uso de caché.
| Variable del cálculo | Campo de consumo | Qué debes contar |
|---|---|---|
| U | usage.input_tokens | Entrada sin caché |
| W5 | usage.cache_creation.ephemeral_5m_input_tokens | Escrituras con duración de 5 minutos |
| W60 | usage.cache_creation.ephemeral_1h_input_tokens | Escrituras con duración de 1 hora |
| R | usage.cache_read_input_tokens | Lecturas de caché |
| O | usage.output_tokens | Salida facturada |
usage.cache_creation_input_tokens es el total de las escrituras: equivale a W5 + W60. Sirve para comprobar la suma, pero no es una sexta partida que debas volver a cobrar. Si solo guardas ese total y mezclas ambas duraciones, perderás el desglose necesario para calcular el coste exacto.
Con cantidades expresadas en tokens, la fórmula estándar es:
textCoste en USD = (10 × U + 12,50 × W5 + 20 × W60 + 0,25 × R + 50 × O) / 1.000.000
Para un trabajo procesado íntegramente mediante Batch, puedes multiplicar ese resultado por 0,5. Si mezclas solicitudes normales y Batch, calcula cada grupo por separado.
Ejemplo completo: un trabajo de 3,25 USD
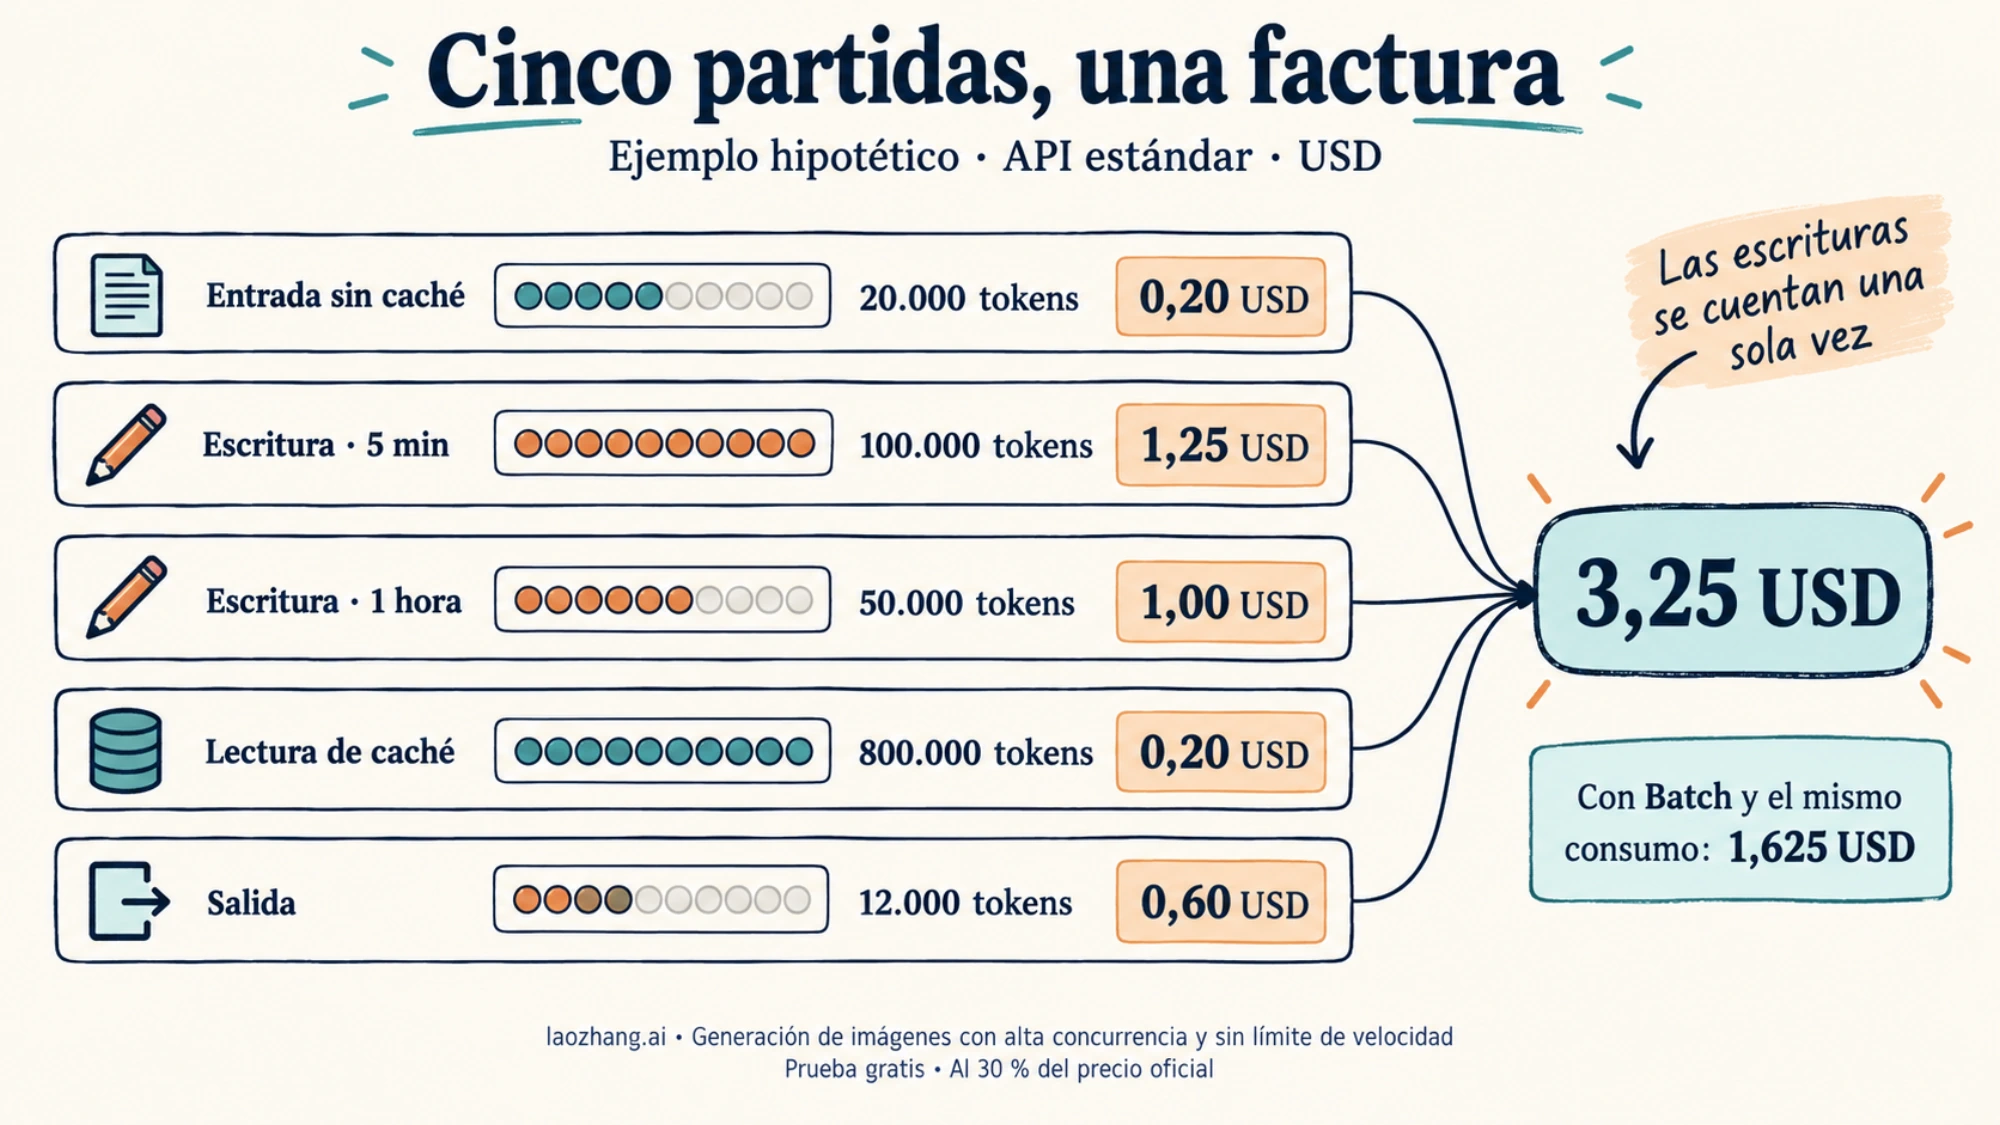
Supongamos que, al sumar el consumo de las respuestas de un trabajo, obtienes los siguientes valores. Son cifras hipotéticas para explicar el cálculo, no una factura medida ni una previsión del ahorro de cualquier aplicación.
| Partida | Tokens acumulados | Cálculo en USD | Coste |
|---|---|---|---|
| Entrada sin caché | 20.000 | 20.000 × 10 / 1.000.000 | 0,20 USD |
| Escrituras de 5 minutos | 100.000 | 100.000 × 12,50 / 1.000.000 | 1,25 USD |
| Escrituras de 1 hora | 50.000 | 50.000 × 20 / 1.000.000 | 1,00 USD |
| Lecturas de caché | 800.000 | 800.000 × 0,25 / 1.000.000 | 0,20 USD |
| Salida | 12.000 | 12.000 × 50 / 1.000.000 | 0,60 USD |
| Total | 3,25 USD |
La entrada total es de 970.000 tokens: 20.000 nuevos, 150.000 de escritura y 800.000 de lectura. Aplicar 10 USD por millón a toda esa entrada daría una cifra equivocada porque ignoraría la caché. Sumar además los 150.000 de cache_creation_input_tokens duplicaría las escrituras.
Con exactamente el mismo reparto de tokens, Batch costaría 1,625 USD. Ese «mismo reparto» es la condición: si cambia el número de aciertos de caché, debes recalcularlo a partir del uso real.
Cuándo compensa escribir en caché
La caché resulta útil cuando varias peticiones comparten un prefijo idéntico: por ejemplo, instrucciones, herramientas y documentación que permanecen estables mientras cambia la consulta final. La escritura inicial cuesta más que enviar esos tokens una vez sin caché; el ahorro aparece al reutilizarlos.
Fable 5.1 exige un mínimo de 512 tokens para almacenar contenido en caché. Por debajo de ese umbral, la petición se procesa sin caché y sin que eso produzca un error. La duración predeterminada es de cinco minutos; puedes solicitar una hora con ttl: "1h". La opción de nivel superior cache_control: {"type":"ephemeral"} activa la caché automática. Requisitos y configuración.
Para comparar duraciones, toma un prefijo de 10.000 tokens que se escribe una sola vez y se reutiliza antes de caducar:
| Usos totales del mismo prefijo | Sin caché | Caché de 5 minutos | Caché de 1 hora |
|---|---|---|---|
| 1 uso: escritura, sin reutilización | 0,10 USD | 0,125 USD | 0,20 USD |
| 2 usos: escritura y 1 lectura | 0,20 USD | 0,1275 USD | 0,2025 USD |
| 3 usos: escritura y 2 lecturas | 0,30 USD | 0,13 USD | 0,205 USD |
Este cálculo aísla el prefijo: no incluye el texto nuevo ni la salida, que suponemos iguales en las tres opciones. Con cinco minutos, el prefijo ya sale más barato en la primera reutilización. Con una hora, necesita dos lecturas posteriores a la escritura para superar el coste de enviarlo siempre sin caché.
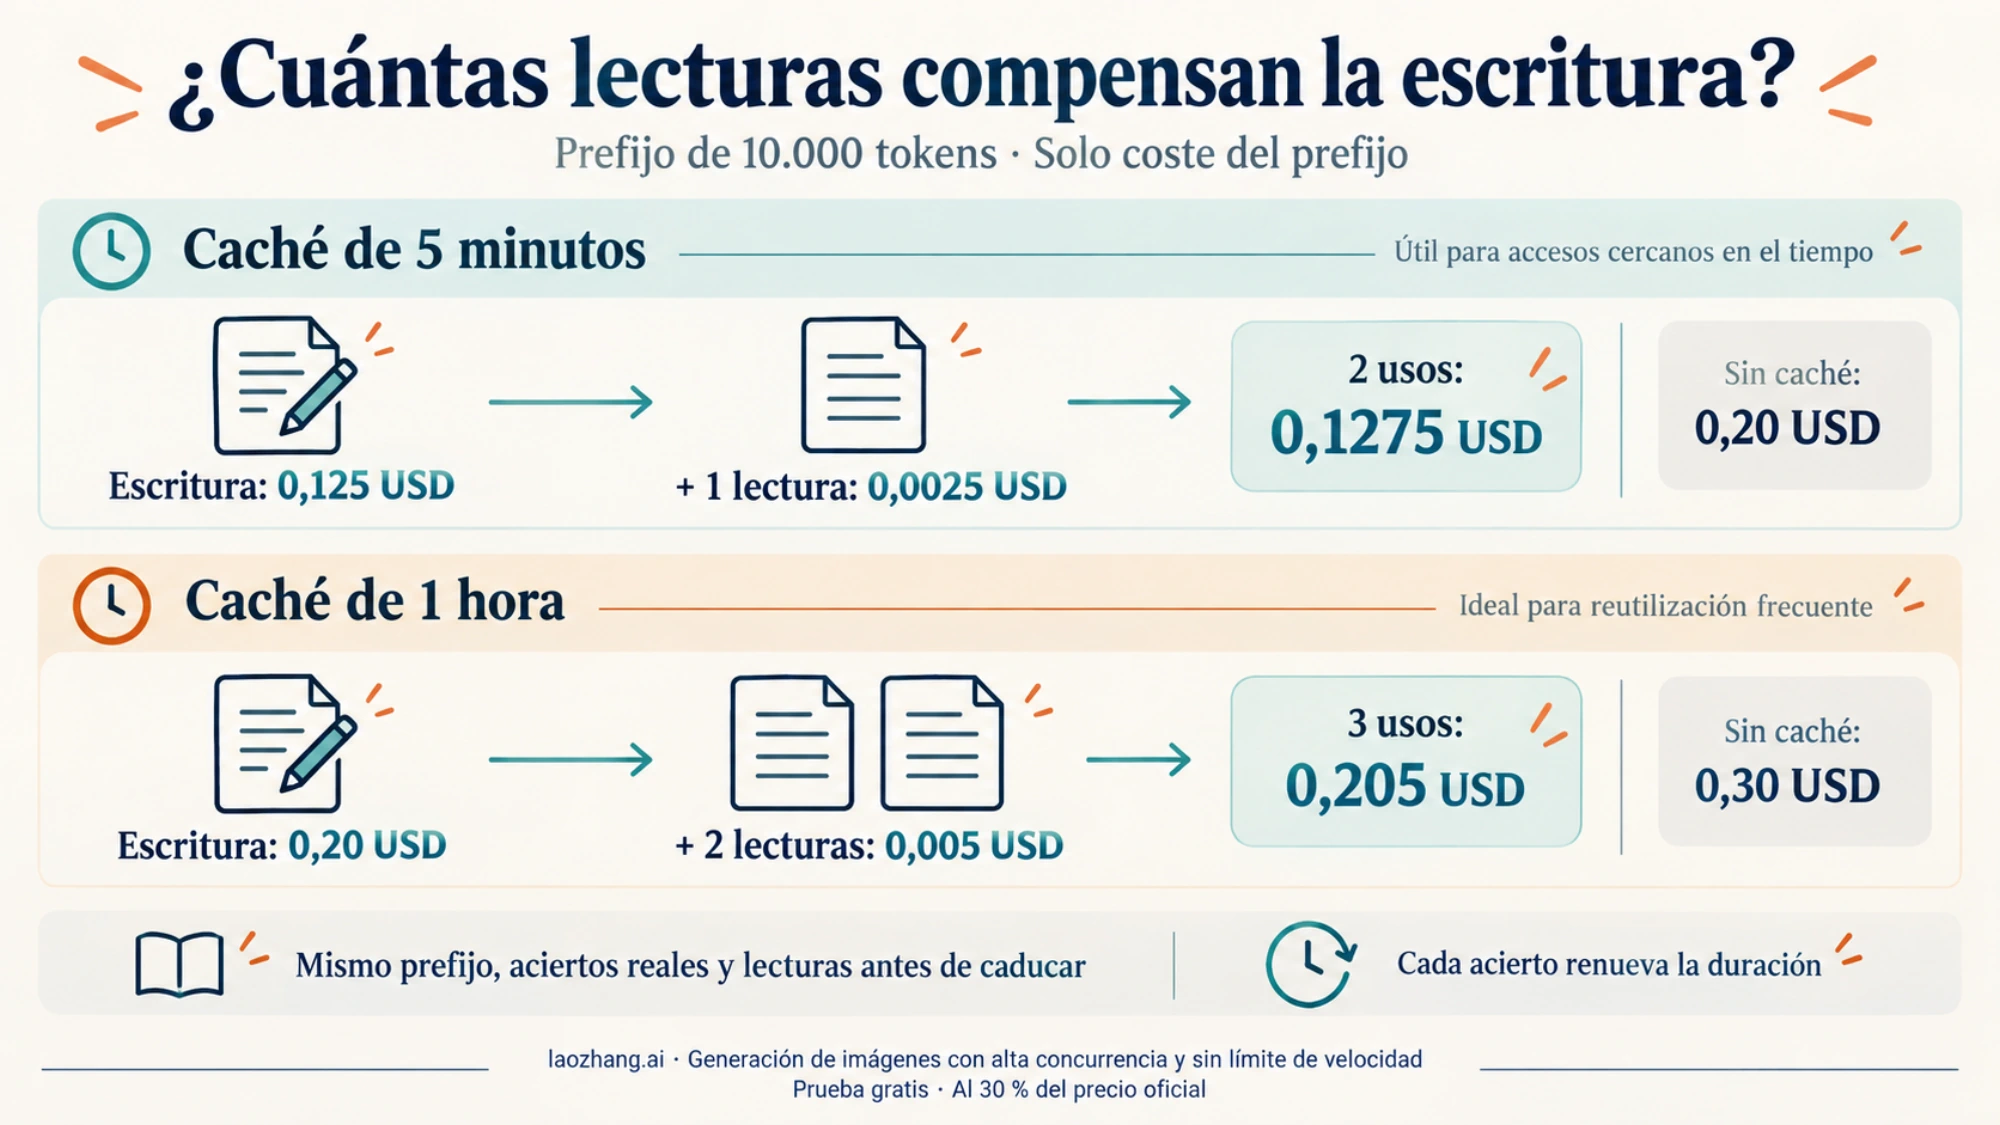
La elección no depende solo del número de peticiones. Una lectura válida renueva la duración de la caché sin cobrar otra escritura, aunque sí cobra los tokens leídos. El tiempo se cuenta desde el inicio de la petición que escribe o lee, no desde que acaba la respuesta. Una secuencia de solicitudes cercanas puede seguir reutilizando una caché de cinco minutos; los intervalos más largos pueden justificar una hora. Duración y renovación de la caché.
Comprueba los aciertos en cache_read_input_tokens. Cambiar el contenido anterior al punto de caché —como instrucciones, herramientas o mensajes— puede invalidar el prefijo correspondiente. También puede afectarle un cambio en el parámetro effort de nivel superior. Si esperabas una lectura y aparece una nueva escritura, revisa los cambios de contenido y el intervalo entre peticiones antes de atribuirlo al precio.
Batch: adecuado para trabajos que pueden esperar
Traducir un catálogo durante la noche o clasificar documentos pendientes son ejemplos de trabajos que pueden tolerar una respuesta diferida. Message Batches procesa peticiones de forma asíncrona y no ofrece respuestas en streaming. La mayoría de los lotes termina en una hora, pero pueden tardar hasta 24 horas y las peticiones aún pendientes pueden caducar. Un lote admite hasta 100.000 peticiones o 256 MB, lo que se alcance antes. Funcionamiento y límites de Message Batches.
La cautela principal para el presupuesto es la caché. Las peticiones del lote pueden ejecutarse en paralelo y en momentos distintos; no debes dar por hecho que la primera escribirá el prefijo a tiempo para todas las siguientes. La documentación advierte de que los aciertos de caché no están garantizados. Una duración de una hora puede ayudar, pero sus escrituras son más caras.
Para valorar un catálogo real, procesa una muestra representativa, suma sus cinco categorías de consumo y calcula el coste por ficha aceptada. Si las lecturas son escasas, estima el resto del trabajo con ese reparto observado. No presupuestes un único prefijo escrito una vez si tus resultados muestran varias escrituras.
Al recoger los resultados, utiliza custom_id para asociar cada respuesta con su petición: el orden no está garantizado. Los resultados se conservan durante 29 días desde la creación del lote. Las peticiones que terminan como errored, canceled o expired no se facturan conforme a las condiciones de Batch. Sin embargo, una petición succeeded que devuelve una traducción que rechazas sí ha consumido tokens; repetirla con éxito añade consumo. Resultados y facturación de los lotes.
Otros costes que conviene incorporar al presupuesto
Las cinco partidas permiten calcular los tokens, pero hay condiciones que pueden cambiar el total:
- Inferencia en Estados Unidos. En la API directa,
inference_geo: "us"aplica un multiplicador de 1,1 a todas las categorías de tokens. El ejemplo de 3,25 USD pasaría a 3,575 USD; con Batch y el mismo consumo, a 1,7875 USD. Este multiplicador no debe trasladarse automáticamente a las tarifas regionales de Bedrock o Google Cloud. Precios por residencia de datos. - Herramientas. Sus definiciones, los resultados y el historial de conversación añaden tokens de entrada. Algunas herramientas del servidor también tienen una tarifa propia: la búsqueda web cuesta 10 USD por 1.000 búsquedas, además de los tokens. El descuento de Batch sobre tokens no autoriza a dividir por dos cualquier cargo de herramientas. Tarifas de herramientas.
- Razonamiento. Los tokens de razonamiento forman parte de la salida facturada. Utiliza el consumo de salida indicado por la API y evita sumar otra vez un desglose de razonamiento ya incluido. Contar las palabras de la respuesta final subestimaría esa partida. Facturación del razonamiento.
Los precios de esta guía están en USD. Para elaborar un presupuesto en euros, aplica por separado el cambio y las condiciones de pago que realmente vayas a utilizar; no hay una equivalencia fija por millón de tokens.
Qué guardar para comprobar cada trabajo
Registra el identificador del modelo, las cinco categorías de consumo, si la petición usa Batch y la ubicación de inferencia seleccionada. Conserva también los cargos de herramientas y los reintentos. Suma primero los costes de todas las peticiones del trabajo y, después, divide por las tareas que hayas aceptado: así una respuesta fallida desde el punto de vista del negocio no desaparece del presupuesto.
Antes de enviar una petición puedes estimar su entrada mediante el recuento de tokens; después, contrástalo con usage. No conviertas caracteres en tokens con un factor fijo, especialmente si mezclas idiomas, código y documentos. La factura depende tanto de lo que envías como de lo que el modelo produce.
Si aún estás decidiendo si migrar a este modelo, la guía de migración a Claude Fable 5.1 aborda esa elección. Para calcular el coste de una aplicación ya definida, empieza por una muestra con su contexto, duración de caché y longitud de respuesta habituales: esos datos te darán un presupuesto mucho más útil que el precio de entrada por sí solo.