Gemini context caching en la API: caché de contexto y ahorro real
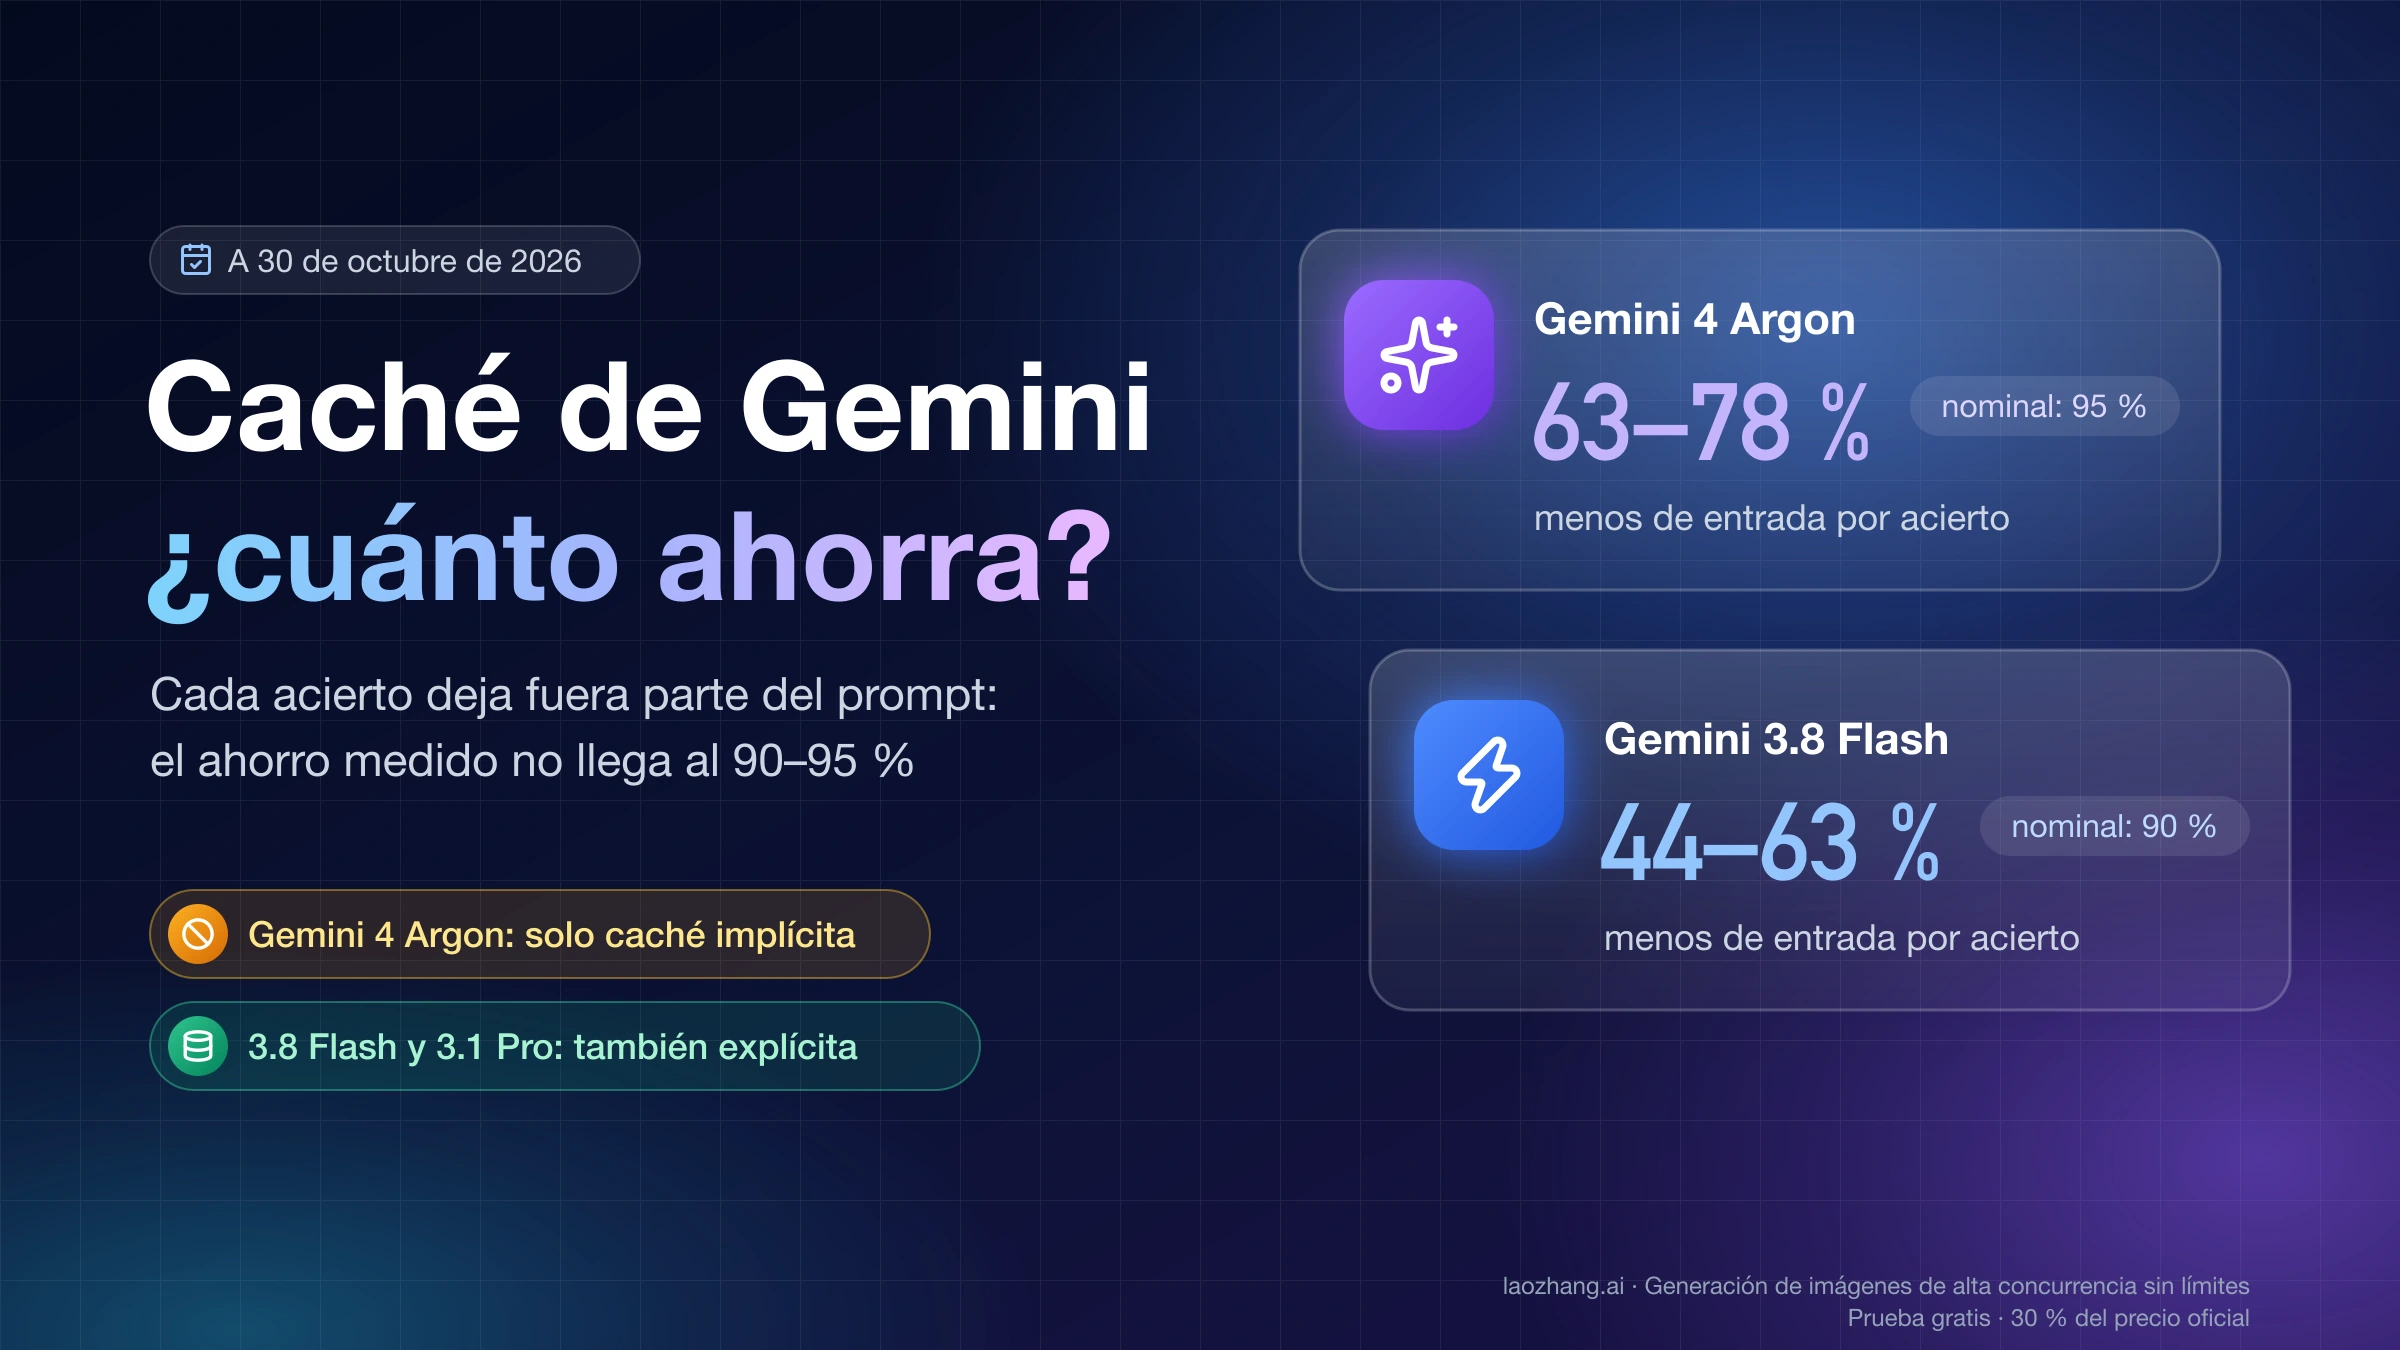
Gemini 4 Argon solo tiene caché implícita; 3.8 Flash y 3.1 Pro, también explícita. En pruebas reales un acierto abarató la entrada un 44–78 %, no un 90–95 %.
En esta página
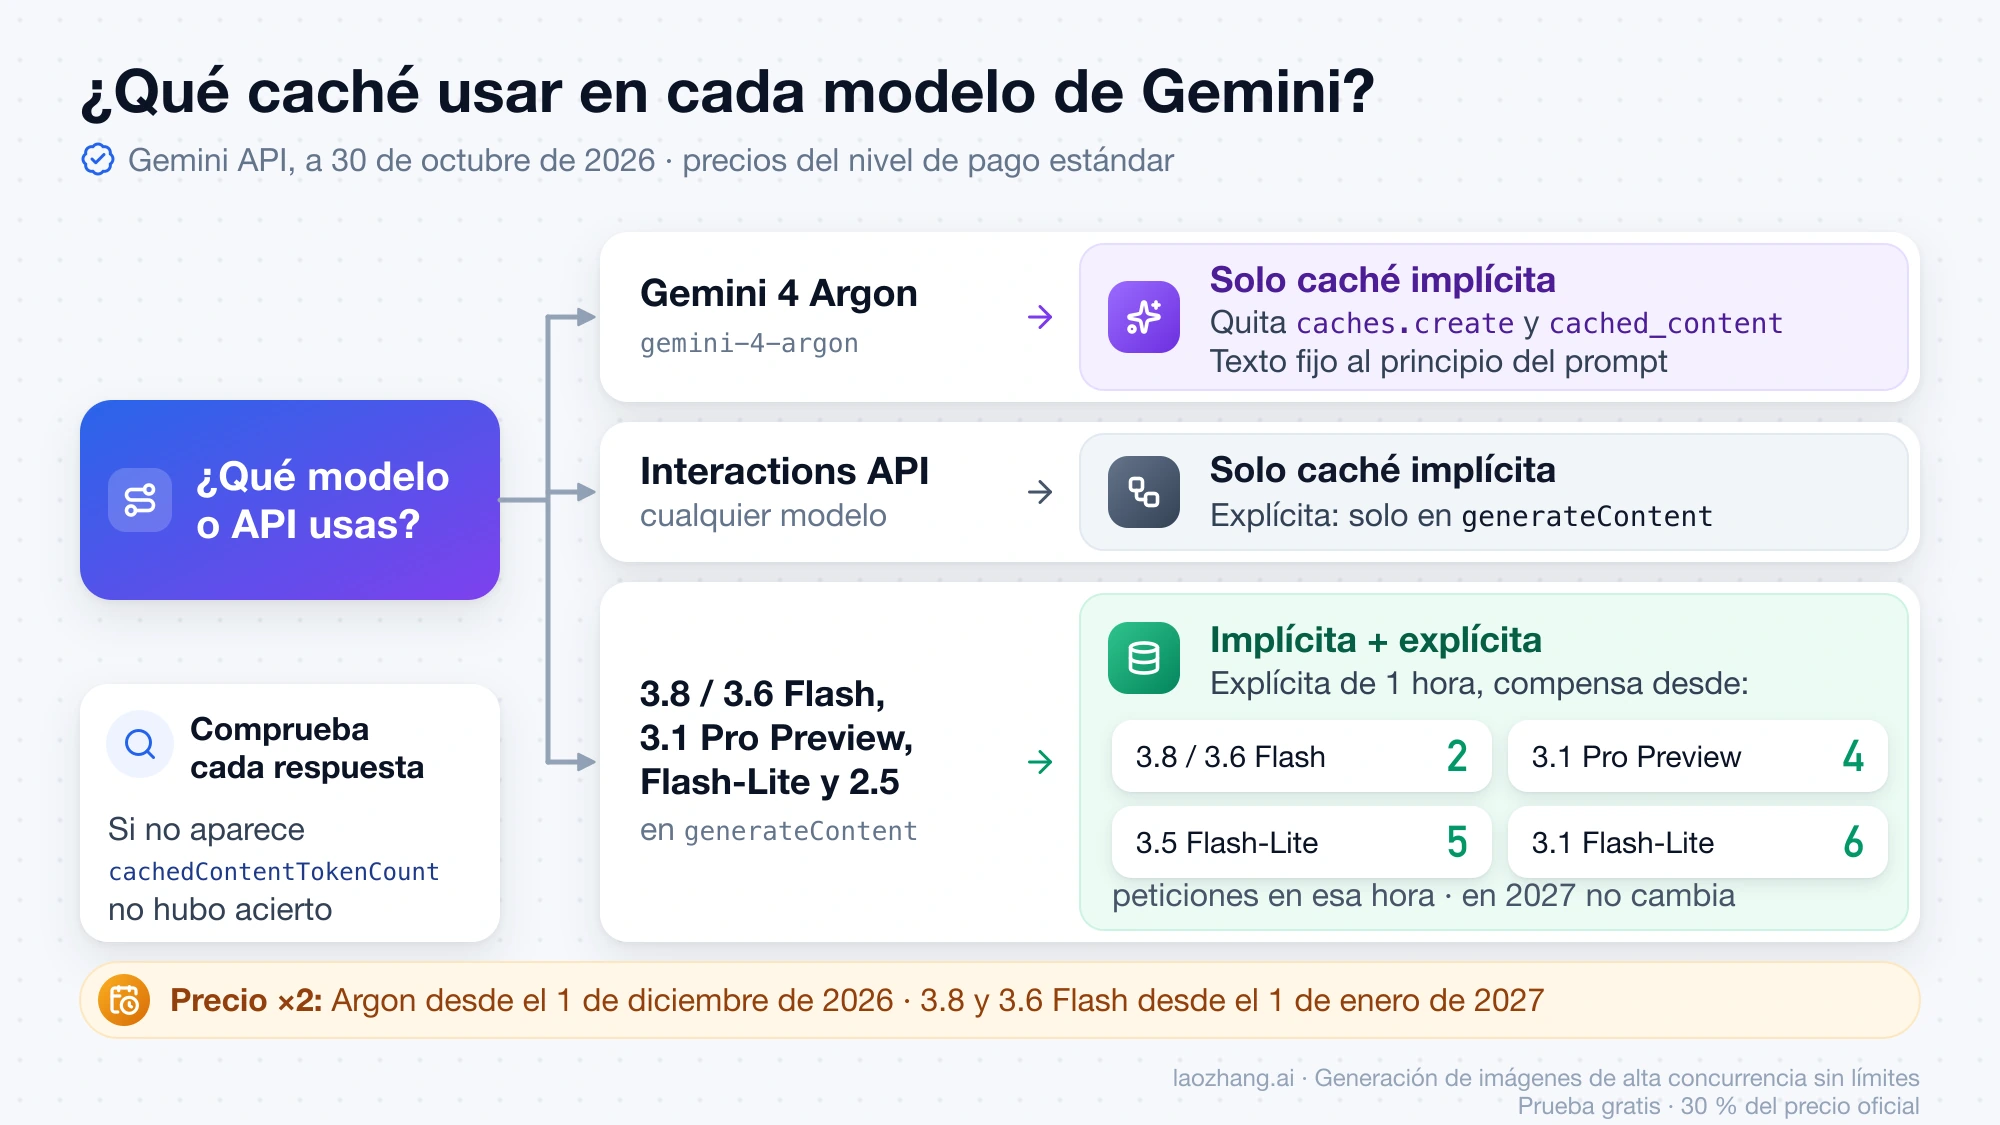
La caché de contexto de Gemini (context caching) cobra a menor precio la parte del prompt que el modelo ya procesó en una petición anterior, y en la API hay dos tipos. La implícita viene activada en Gemini 2.5 y posteriores, no se configura y no garantiza ningún ahorro; la explícita la creas tú con caches.create en la API generateContent, garantiza el descuento y cobra almacenamiento por hora. A 30 de octubre de 2026, Gemini 4 Argon solo tiene la implícita, mientras que 3.8 Flash, 3.6 Flash, 3.1 Pro Preview, 3.5 Flash-Lite y la familia 2.5 admiten las dos; en la Interactions API solo existe la implícita, sea cual sea el modelo.
Si migras a gemini-4-argon, quita las llamadas a caches.create y el parámetro cached_content, porque en Argon devuelven error, y coloca el texto fijo (prompt de sistema, documento o repositorio) al principio de cada petición. En 3.8 o 3.6 Flash, una caché explícita que creas y mantienes durante una hora sale más barata que no usar caché a partir de 2 peticiones en esa hora, porque la creación se paga a precio normal; si la mantienes muchas horas, basta con 0,74 reutilizaciones por hora para cubrir el almacenamiento. En los dos casos comprueba la respuesta: el campo cachedContentTokenCount de usageMetadata dice cuántos tokens salieron de la caché, y si no aparece, no hubo acierto.
No cuentes con el «hasta un 90 %». En unas 60 peticiones enviadas a través de LaoZhang el 30 de octubre de 2026, la caché implícita de 3.8 Flash no acertó ni una vez por debajo de unos 5.000 tokens, por encima acertó de forma intermitente y cada acierto dejó fuera una parte del prompt. Por eso, en 3.8 Flash un acierto abarató la entrada entre un 44 % y un 63 %, frente al 90 % nominal, y en Gemini 4 Argon entre un 63 % y un 78 %, frente al 95 %.
Qué caché tiene cada modelo de Gemini: implícita, explícita o las dos
Gemini 4 Argon no tiene caché explícita: Google la marca como no compatible «para Gemini 4 Argon y posteriores» y, en su lugar, aplica la implícita con un descuento mayor que en los demás modelos. Los modelos Gemini 3 y 2.5 conservan ambas, pero la explícita solo se crea a través de generateContent, porque la Interactions API, la que Google recomienda ahora, se limita a la implícita. Así queda cada modelo según la guía de caché de contexto para generateContent, la versión para la Interactions API y la página de precios de la Gemini API, a 30 de octubre de 2026:
| Modelo o API | Caché implícita | Caché explícita | Precio de un token en caché |
|---|---|---|---|
Gemini 4 Argon (gemini-4-argon) | Sí, por defecto | No; caches.create y cached_content devuelven error | 5 % de la entrada (−95 %) |
| Gemini 3.8 Flash y 3.6 Flash | Sí, por defecto | Sí, en generateContent | 10 % de la entrada (−90 %) |
| Gemini 3.1 Pro Preview | Sí, por defecto | Sí, en generateContent | 10 % de la entrada (−90 %) |
| Gemini 3.5 Flash-Lite y 3.1 Flash-Lite | Sí, por defecto | Sí, en generateContent | 10 % de la entrada (−90 %) |
| Gemini 2.5 Pro, Flash y Flash-Lite | Sí, por defecto | Sí, en generateContent | 10 % de la entrada (−90 %) |
| Cualquier modelo en la Interactions API | Sí, con y sin previous_interaction_id | No existe en esta API | Según el modelo |
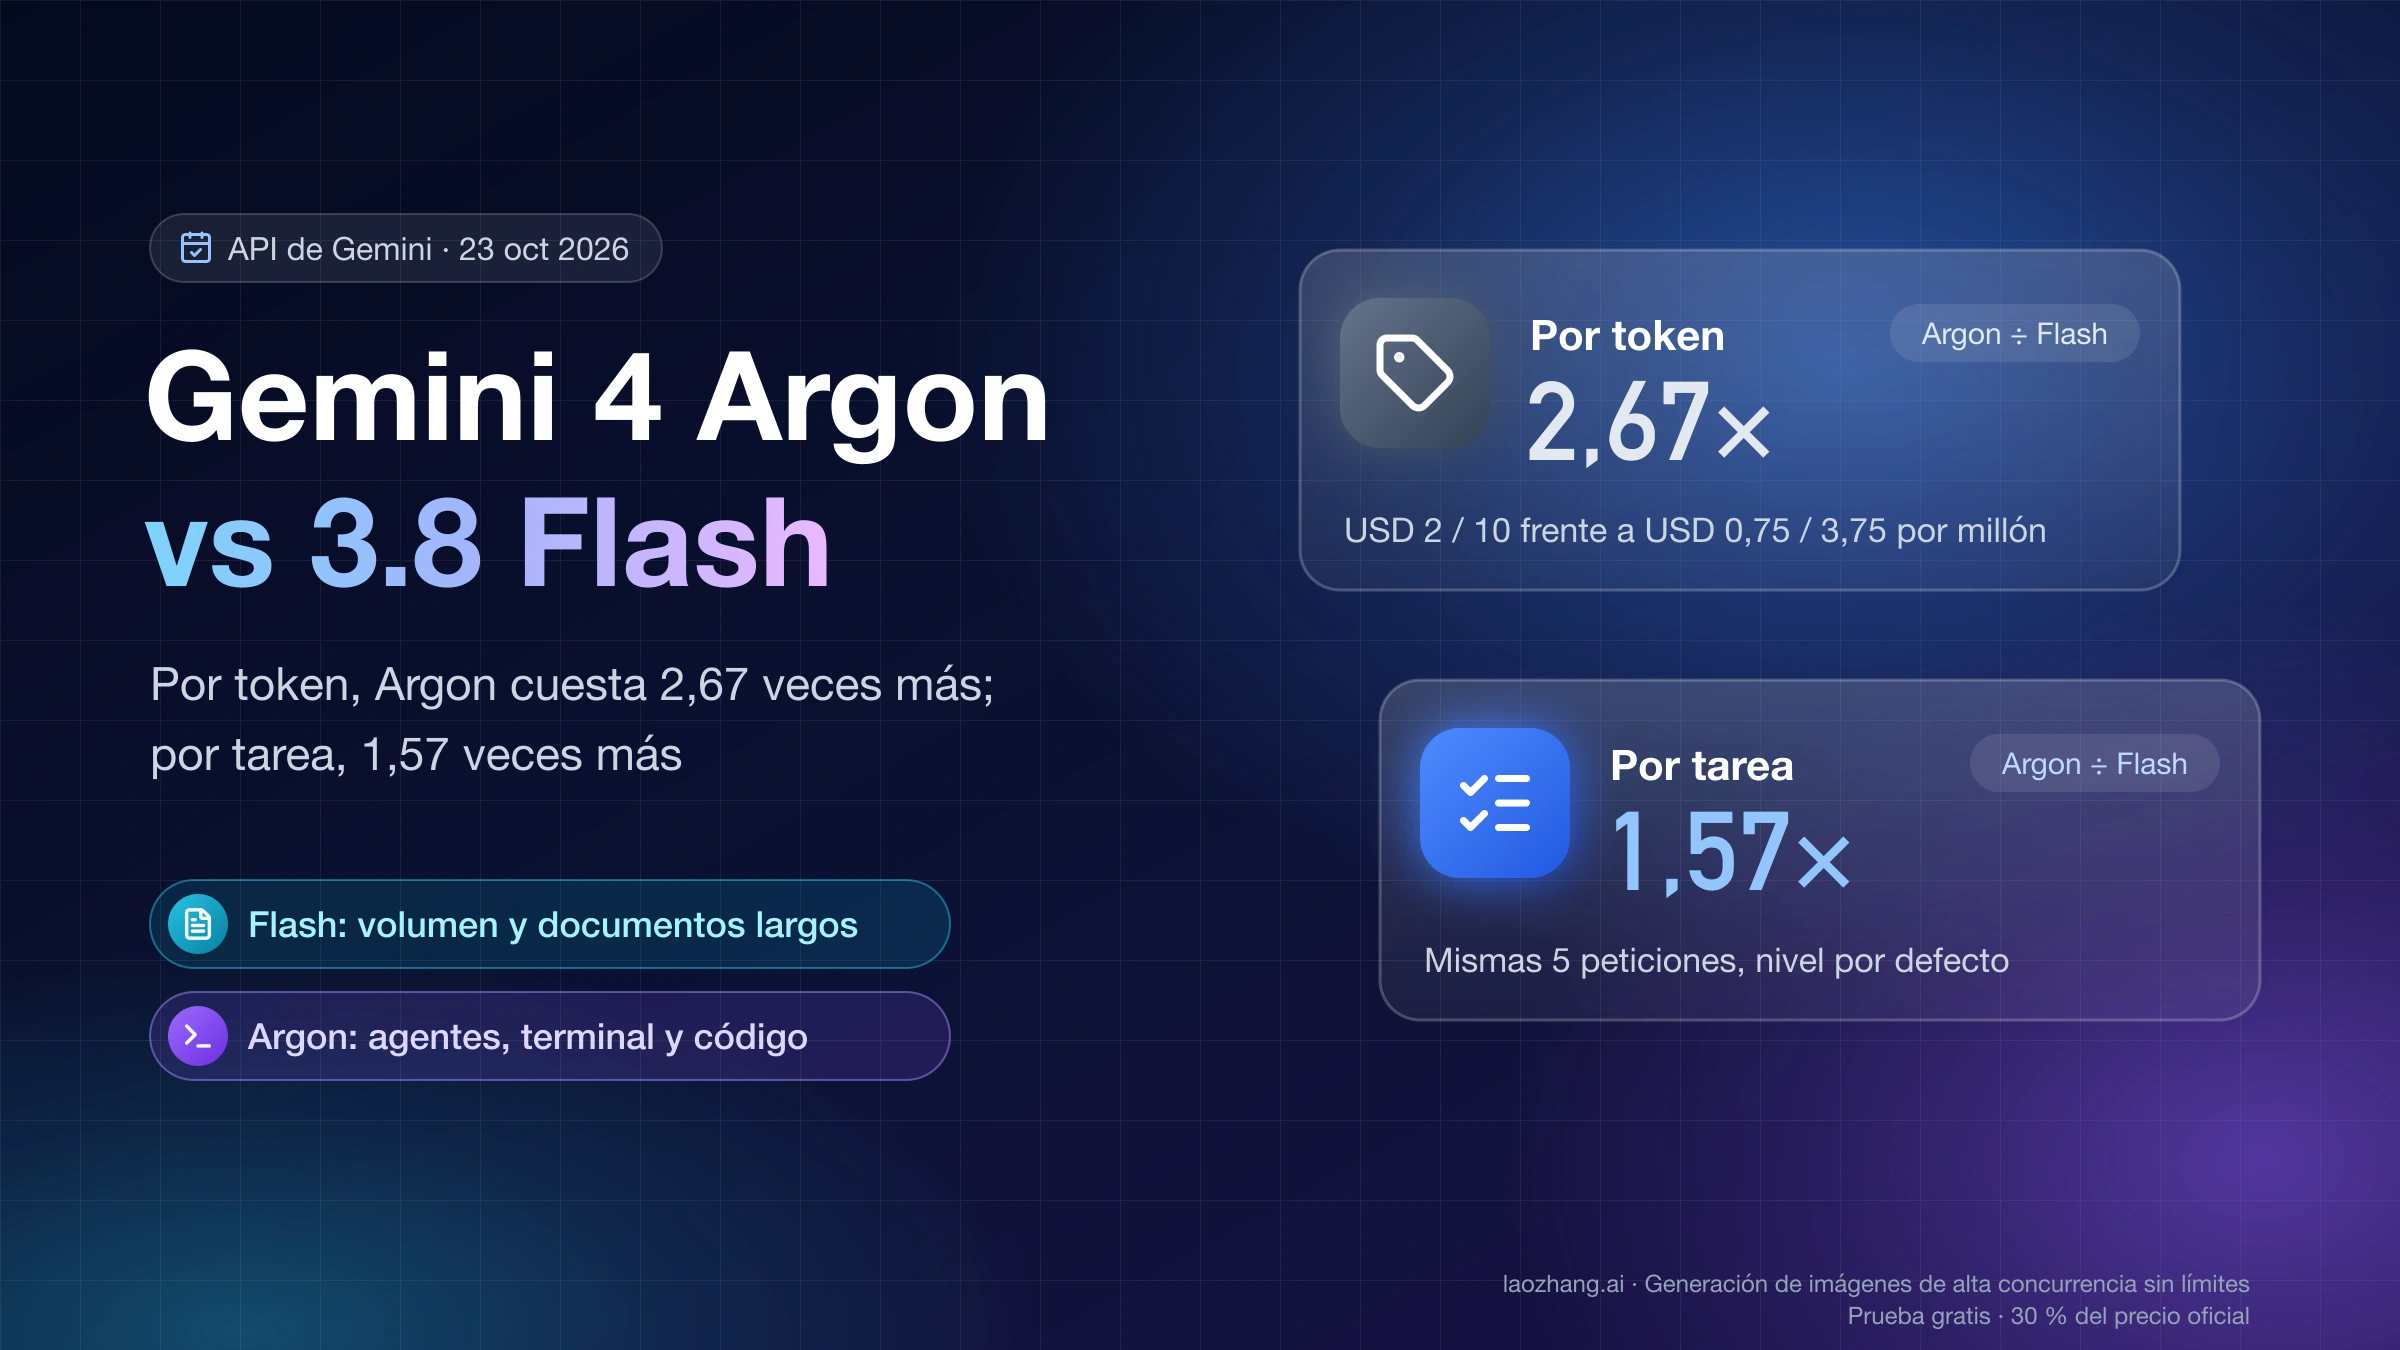
La caché explícita sigue en beta y sus métodos viven bajo v1beta. Si tu código usa la Interactions API y quieres una caché explícita en 3.8 Flash, tienes que hacer esas llamadas con generateContent; si en cambio pasas a Argon, la guía de novedades de Gemini 4 Argon pide eliminar todo lo que crea o envía cached_content. No es la única rotura de esa migración: las peticiones que terminan con un turno del modelo también fallan, como se explica en Gemini «Requests ending with a model turn»: error 400 y solución. Si aún no has decidido entre los dos modelos, la comparación de coste por tarea está en Gemini 4 Argon vs 3.8 Flash: coste real por tarea y cuál usar.
Precio de la caché de Gemini y cuándo compensa la explícita
Un token leído de la caché cuesta el 10 % de la entrada normal en 3.8 Flash, 3.6 Flash, 3.1 Pro Preview y los Flash-Lite, y el 5 % en Gemini 4 Argon, según la página de precios de la Gemini API a 30 de octubre de 2026. La caché explícita suma un cargo de almacenamiento por millón de tokens y hora, así que solo compensa si la reutilizas lo bastante a menudo; la implícita no cobra almacenamiento, pero tampoco garantiza que acierte. Las dos fechas que cambian estas cuentas son el 1 de diciembre de 2026, cuando Argon duplica su precio, y el 1 de enero de 2027, cuando lo hacen 3.8 y 3.6 Flash.
| Modelo (nivel de pago estándar, USD por millón de tokens) | Entrada | Entrada en caché | Almacenamiento por hora | Caché explícita de una hora: peticiones para ganar a no usar caché | Caché explícita mantenida muchas horas: usos por hora que cubren el almacenamiento |
|---|---|---|---|---|---|
| Gemini 4 Argon, hasta el 30 de noviembre de 2026 | 2,00 | 0,10 | Sin caché explícita | No aplica | No aplica |
| Gemini 4 Argon, desde el 1 de diciembre de 2026 | 4,00 | 0,20 | Sin caché explícita | No aplica | No aplica |
| 3.8 Flash y 3.6 Flash, hasta el 31 de diciembre de 2026 | 0,75 | 0,075 | 0,50 | 2 o más (1,85) | 0,74 |
| 3.8 Flash y 3.6 Flash, desde el 1 de enero de 2027 | 1,50 | 0,15 | 1,00 | 2 o más (1,85) | 0,74 |
| 3.1 Pro Preview (prompts de hasta 200.000 tokens) | 2,00 | 0,20 | 4,50 | 4 o más (3,61) | 2,5 |
| 3.5 Flash-Lite | 0,30 | 0,03 | 1,00 | 5 o más (4,81) | 3,7 |
| 3.1 Flash-Lite (texto) | 0,25 | 0,025 | 1,00 | 6 o más (5,56) | 4,44 |
Las dos últimas columnas responden a dos situaciones distintas. Crear la caché se cobra una sola vez como entrada normal, según la documentación de caché de contexto de Google Cloud, así que una caché que creas para una sola hora tiene que recuperar esa creación y una hora de almacenamiento: las peticiones necesarias son (entrada + almacenamiento) ÷ (entrada − entrada en caché), que en 3.8 Flash da (0,75 + 0,50) ÷ 0,675. Si la caché vive muchas horas, la creación se reparte y solo cuenta el almacenamiento: almacenamiento ÷ (entrada − entrada en caché), es decir, 0,50 ÷ 0,675 en 3.8 Flash. En 2027 se duplican los tres precios de Flash y ninguno de los dos resultados cambia. En 3.1 Pro Preview el almacenamiento es caro y en los Flash-Lite cada uso ahorra muy poco, por eso necesitan más peticiones.
Con un documento de 100.000 tokens en 3.8 Flash y precios de 2026, una sola consulta en una hora cuesta USD 0,075 sin caché y USD 0,1325 con caché explícita (0,075 de creación + 0,0075 de lectura + 0,05 de almacenamiento), así que pierdes dinero. Con 10 consultas en esa hora, sin caché pagas USD 0,75 y con caché explícita USD 0,20. La implícita, en el mejor caso de que aciertan todas las peticiones tras la primera, se queda en USD 0,1425; si solo aciertan 2 de las 9 siguientes, sube a USD 0,615. Con la tasa de aciertos de las pruebas, más o menos una de cada tres, la explícita ya sale más barata que la implícita desde 3 consultas por hora (unos USD 0,1475 frente a 0,18). Las cuentas solo incluyen la entrada; la salida y la pregunta de cada consulta se pagan igual en los tres casos.
En Argon no hay nada que decidir: cada millón de tokens que sale de la caché ahorra USD 1,90 hasta el 30 de noviembre y USD 3,80 desde el 1 de diciembre. Lo que sí conviene corregir es la expectativa de cuánto baja la factura en un acierto. En la prueba del 30 de octubre de 2026, un prompt de 11.645 tokens en 3.8 Flash con 8.165 tokens en caché costó USD 0,003222 de entrada en lugar de USD 0,008734 (3.480 × 0,75 + 8.165 × 0,075, por millón), un 63 % menos, pero otro de 8.358 tokens con solo 4.077 en caché bajó de USD 0,006269 a USD 0,003517, un 44 % menos; en Argon, 11.576 tokens con 9.522 en caché pasaron de USD 0,023152 a USD 0,005060, un 78 % menos. El resto de precios por modelo, el nivel gratuito y la subida de 2027 están en Clave de API de Gemini gratis y precio: qué sube en 2027.
Cómo crear, usar y borrar una caché explícita con generateContent
En los modelos que la admiten, una caché explícita se crea una vez con el contenido fijo, se pasa por su nombre en cada generate_content y se borra cuando deja de usarse. El ejemplo usa el SDK google-genai de Python y lee la clave de la variable de entorno GEMINI_API_KEY; necesitas una clave de Google AI Studio o un proyecto de Google Cloud, porque a través de una pasarela estos endpoints pueden no existir.
import os
from google import genai
from google.genai import types

client = genai.Client(api_key=os.environ["GEMINI_API_KEY"])
MODEL = "gemini-3.8-flash"

with open("manual.txt", encoding="utf-8") as f:
    manual = f.read()

# 1. Crear la caché: estos tokens se cobran una vez como entrada normal
cache = client.caches.create(
    model=MODEL,
    config=types.CreateCachedContentConfig(
        display_name="manual-soporte",
        system_instruction="Respondes preguntas sobre el manual adjunto.",
        contents=[types.Content(role="user", parts=[types.Part(text=manual)])],
        ttl="3600s",
    ),
)
print(cache.name)

# 2. Usarla: en cada petición solo envías la pregunta
response = client.models.generate_content(
    model=MODEL,
    contents="¿Cómo se restablece el equipo a valores de fábrica?",
    config=types.GenerateContentConfig(cached_content=cache.name),
)
print(response.usage_metadata.cached_content_token_count)
print(response.text)

# 3. Cambiar la duración: solo se pueden modificar ttl o expire_time
client.caches.update(
    name=cache.name,
    config=types.UpdateCachedContentConfig(ttl="7200s"),
)

# 4. Borrarla en cuanto deje de usarse: el almacenamiento se cobra por hora
client.caches.delete(name=cache.name)
El modelo trata los tokens en caché como un prefijo del prompt, así que la pregunta de cada llamada se añade detrás. Con client.caches.list() y client.caches.get(name=...) ves los metadatos (nombre, modelo, fechas de creación y caducidad, tokens), pero no puedes recuperar el texto guardado. El contenido también tiene un mínimo de tokens que depende del modelo, y el máximo es el contexto del propio modelo. Si llamas a Gemini con la biblioteca de OpenAI, la guía de Google indica que la caché se pasa con la propiedad cached_content dentro de extra_body. El código sigue el ejemplo oficial de generateContent: la pasarela de las pruebas del 30 de octubre de 2026 no ofrece los endpoints de caché explícita, así que esta parte no se midió.
Cómo saber si hubo acierto: cachedContentTokenCount y cached_tokens
Cada respuesta dice cuántos tokens de entrada salieron de la caché, pero el campo cambia según la API que uses, y en un fallo no vale 0: directamente no aparece. En generateContent es cachedContentTokenCount dentro de usageMetadata (en el SDK de Python, cached_content_token_count); en la Interactions API, usage.total_cached_tokens; y en el endpoint compatible con OpenAI, prompt_tokens_details.cached_tokens. En generateContent y en el endpoint compatible con OpenAI, el total de tokens del prompt incluye la parte en caché; esa parte se cobra al precio de entrada en caché y el resto, al precio normal.
Así se vio un acierto real de 3.8 Flash el 30 de octubre de 2026, por la ruta nativa de Gemini a través de LaoZhang (respuesta recortada):
"usageMetadata": {
  "promptTokenCount": 11645,
  "cachedContentTokenCount": 8165,
  "candidatesTokenCount": 56,
  "totalTokenCount": 11701
}
En las peticiones sin acierto, usageMetadata traía promptTokenCount y nada más relacionado con la caché, y en el endpoint compatible con OpenAI un fallo devolvía "prompt_tokens_details": {} mientras que el acierto mostraba "cached_tokens": 8161 con prompt_tokens en 11.644. Por eso, si tu código lee el campo sin comprobar que existe, un fallo puede romperlo o contarse mal. En Python basta con esto:
usage = response.usage_metadata
cached = usage.cached_content_token_count or 0  # None cuando no hay acierto
print(f"{cached} de {usage.prompt_token_count} tokens salieron de la caché")
¿Mínimo de 4.096 o de 6.144 tokens? Las cifras de Google y las pruebas
Las páginas de Google no dan el mismo mínimo de tokens para la caché implícita, y en las pruebas del 30 de octubre de 2026 el umbral real de 3.8 Flash quedó por encima del que publica la Gemini API. La documentación de ai.google.dev fija 4.096 tokens para Argon, 3.8 Flash, 3.6 Flash y 3.1 Pro Preview, y 2.048 para 2.5 Flash y 2.5 Pro. La tabla de límites de Google Cloud pone 6.144 para la caché implícita de 3.8 Flash y 3.1 Pro Preview. Para Argon, la propia Cloud se contradice: la guía de Gemini 4 Argon en Agent Platform habla de prefijos de 6.144 tokens o más, y la ficha del modelo, de 4.096.
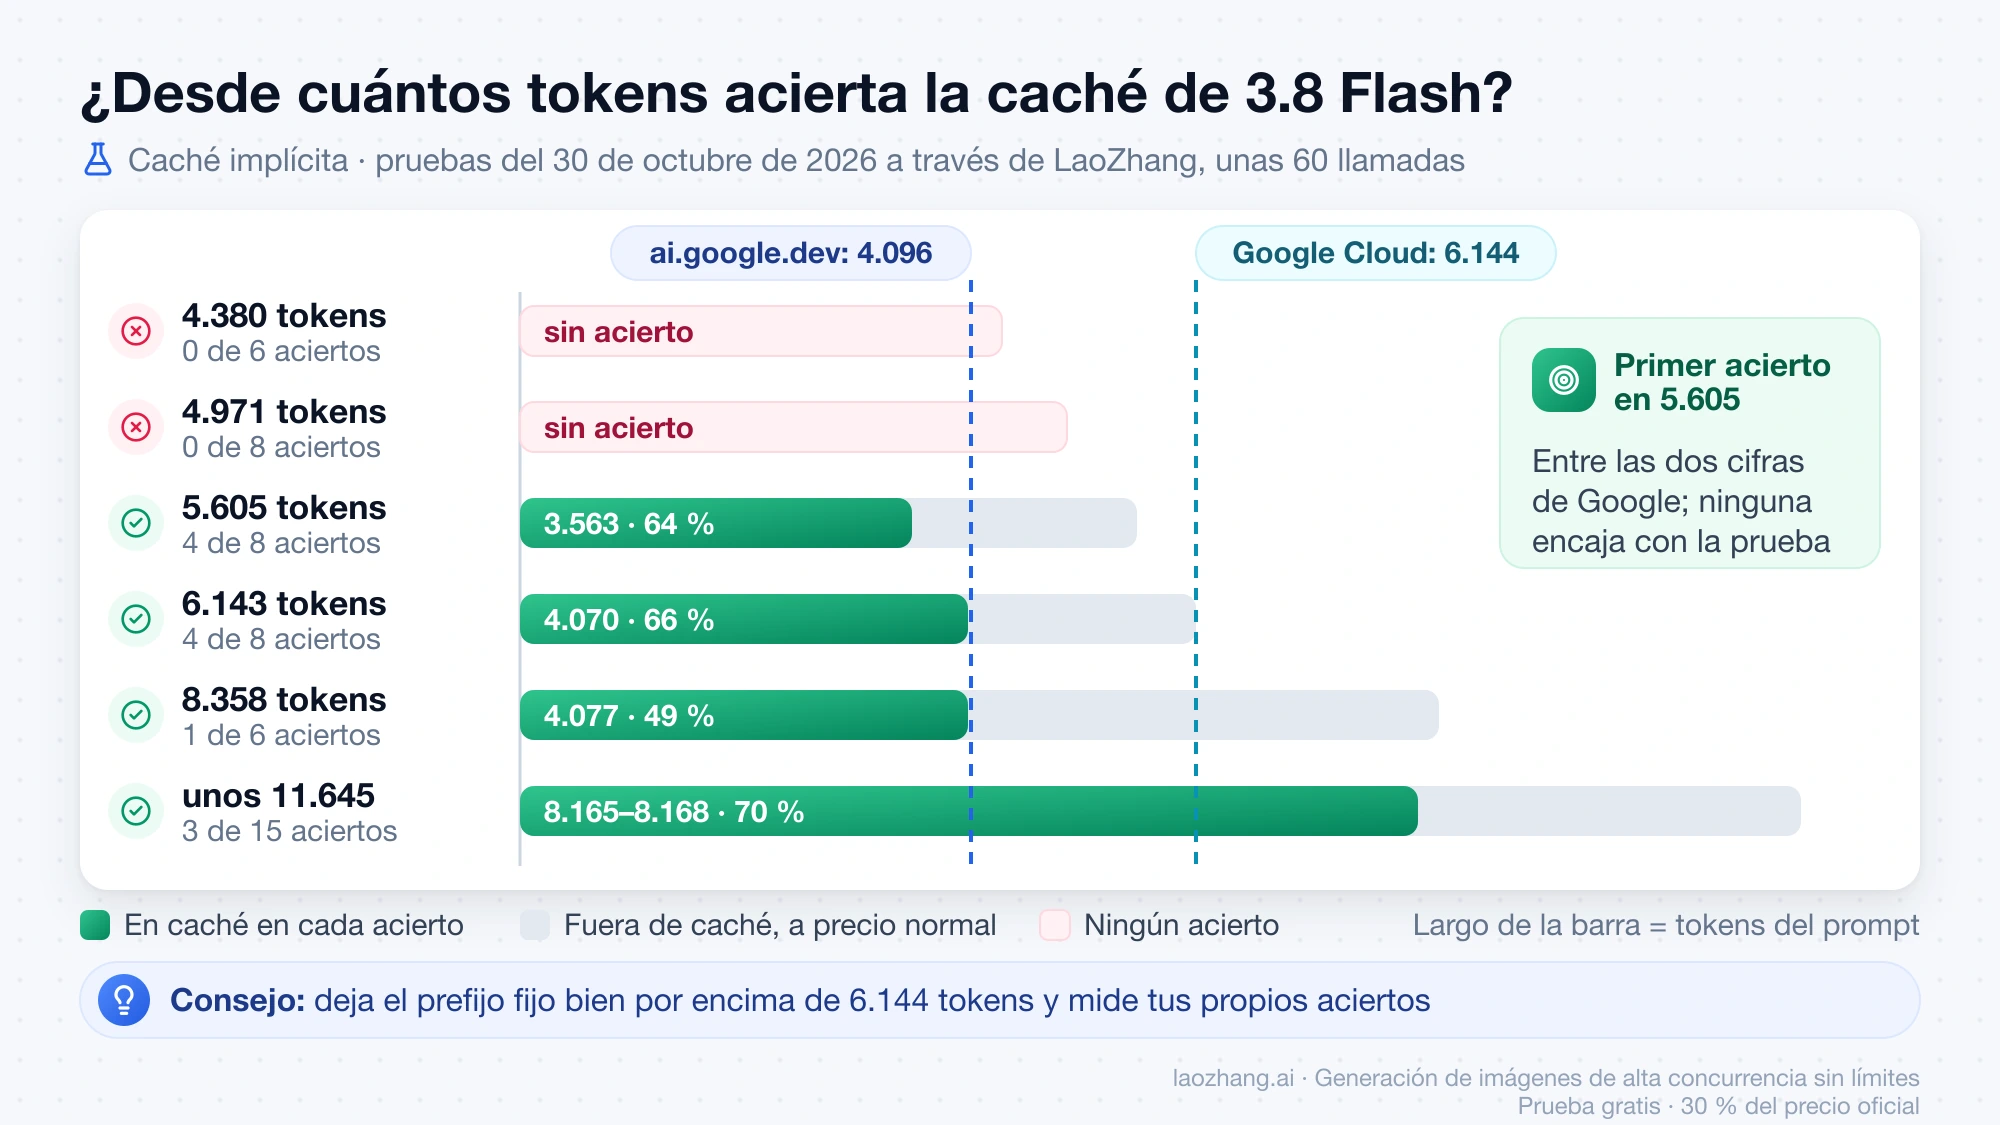
Las pruebas se hicieron entre las 15:15 y las 15:51 UTC del 30 de octubre de 2026, a través de LaoZhang y no directamente contra Google, con una sola cuenta y un mismo texto de prefijo: el texto largo iba en systemInstruction (un lote lo llevaba en el mensaje del usuario) y las peticiones se repetían cada 15–20 segundos, casi todas idénticas byte a byte. Todas las respuestas válidas indicaron el modelo pedido en modelVersion. Los lotes lanzados en una misma ejecución compartían el principio del texto, así que tres de ellos (3.8 Flash con 8.358 tokens, la ruta compatible con OpenAI y Argon con 6.122) pudieron aprovechar una caché que había escrito un lote anterior; los de 4.971, 5.605 y 6.143 tokens en 3.8 Flash, el de unos 11.645 con el texto en systemInstruction y el de 11.576 en Argon, fueron los primeros de su ejecución y no tenían nada previo que reutilizar. Son unas 60 llamadas, con un coste aproximado de USD 0,44 a precios de lista, así que sirven para ver el patrón, no para fijar una tasa de aciertos:
| Modelo | Tokens del prompt | Llamadas | Con acierto | Tokens en caché por acierto | Parte del prompt en caché |
|---|---|---|---|---|---|
| 3.8 Flash | 4.380 | 6 | 0 | — | — |
| 3.8 Flash | 4.971 | 8 | 0 | — | — |
| 3.8 Flash | 5.605 | 8 | 4 | 3.563 | 64 % |
| 3.8 Flash | 6.143 | 8 | 4 | 4.070 | 66 % |
| 3.8 Flash | 8.358 | 6 | 1 | 4.077 | 49 % |
| 3.8 Flash | unos 11.645 | 15 | 3 | 8.165–8.168 | 70 % |
| 4 Argon | 6.122 | 5 | 2 | 4.068 | 66 % |
| 4 Argon | 11.576 | 5 | 1 | 9.522 | 82 % |
Ninguna de las dos cifras de Google describe bien lo que pasó. Con 4.380 y 4.971 tokens, por encima de los 4.096 de ai.google.dev, 3.8 Flash no acertó en 14 llamadas; los aciertos empezaron en 5.605, por debajo de los 6.144 de Cloud. Argon también acertó con una petición de 6.122 tokens, pero su texto coincidía con el principio del lote de 11.576 tokens enviado antes, así que ese acierto no prueba que un prompt de ese tamaño cree una caché por sí solo, y el mínimo real de Argon queda sin medir. Si diseñas el prompt para aprovechar la caché implícita, deja el prefijo fijo bien por encima de 6.144 tokens y mide tus propios aciertos con el campo de la sección anterior.
Por qué la caché implícita de Gemini acierta poco y qué cambiar
La caché implícita falla por causas que se pueden revisar una a una, y algunas no dependen de ti. Google la describe como un mecanismo «sin garantía de ahorro», y sus dos consejos oficiales son poner el contenido grande y común al principio y enviar las peticiones con el mismo prefijo en poco tiempo. Antes de culpar al modelo, repasa esta lista:
- El prompt no llega al mínimo. Por debajo de unos 5.000 tokens, 3.8 Flash no acertó nunca en las pruebas, aunque la documentación diga 4.096.
- Hay algo variable al principio. Una fecha, el nombre del usuario, un ID de petición o una instrucción que inserta tu framework delante del texto fijo crean un prefijo distinto en cada llamada. En el foro r/n8n de Reddit, un usuario sin aciertos sospechaba precisamente que el nodo de agente de n8n añadía instrucciones dinámicas al inicio. Lo variable va al final.
- Solo se cachea una parte del prompt. En cada acierto medido quedaron fuera de la caché entre 2.042 y 4.281 tokens, siempre más que la pregunta final; esa parte se cobró a precio normal y es la razón de que el ahorro no llegue al 90 o 95 % nominal.
- Los aciertos son intermitentes. Con peticiones idénticas cada 15–20 segundos, el lote de 6.143 tokens siguió la secuencia fallo, fallo, acierto, fallo, fallo, acierto, acierto, acierto; sumando las dos rutas, 3.8 Flash acertó 13 de 40 veces con prompts de 5.605 tokens o más (34 de esas llamadas eran repeticiones idénticas y 6 cambiaban la pregunta final). Si necesitas un descuento seguro y tu modelo no es Argon, usa la caché explícita.
- Pasa demasiado tiempo entre peticiones. El prefijo no se conserva indefinidamente, y Google no publica cuánto dura en la Gemini API (más detalles en la sección sobre el TTL).
- En agentes de varios turnos con Argon, el turno nuevo añade poco. Google documenta que Argon solo cachea la petición anterior completa si la nueva añade al menos 2.050 tokens, contando salida, razonamiento y resultados de funciones; con menos, reprocesa los últimos 2.050 tokens a precio normal. Esta regla no se probó en las pruebas, que eran de un solo turno.
- Pasas por una pasarela. En Google Cloud la caché está ligada a cada proyecto, y una pasarela puede repartir las peticiones entre varios proyectos o claves, lo que reduciría los aciertos frente a una clave directa. Es una hipótesis, porque no se puede separar del comportamiento «sin garantía» del propio Google.
- Lees el campo equivocado. En la Interactions API el dato está en
usage.total_cached_tokens, no enusageMetadata.
Las cifras de un tercero confirman que la tasa de aciertos depende mucho del modelo y de la carga. En el banco de pruebas del Intelligence Index v5.0 de Artificial Analysis, publicado el 27–28 de octubre de 2026, solo el 34 % de los 10.160 millones de tokens de entrada de 3.8 Flash salió de la caché, frente al 92 % de los 7.550 millones de Argon. Es un único entorno de pruebas, no una tasa general.
Cuánto dura la caché de Gemini: TTL de la explícita y de la implícita
La caché explícita dura lo que tú le digas: si no fijas ttl, una hora. La guía de la Gemini API dice que no hay mínimo ni máximo, y en Google Cloud el mínimo es de 1 minuto y tampoco hay máximo. Después de crearla solo puedes cambiar ttl o expire_time, y si usas expire_time la hora tiene que llevar zona horaria (en Python, datetime.now(timezone.utc), no datetime.utcnow()). Como el almacenamiento se cobra por el tiempo de vida, un TTL largo en una caché que ya no usas es dinero perdido; bórrala o deja que caduque.
La implícita no se configura y su duración no figura en la documentación de la Gemini API. Google Cloud dice que un prefijo en caché caduca como mucho 24 horas después de crearse y que la mayoría se expulsa antes, y la guía de Argon en Agent Platform habla de un TTL de 15–20 minutos para peticiones seguidas. En la práctica, cuanto más juntas lleguen las peticiones con el mismo prefijo, más probable es el acierto.
Durable caching: solo en Gemini Enterprise Agent Platform
Durable caching es una segunda capa de la caché implícita que Google documenta solo para Gemini Enterprise Agent Platform, el nuevo nombre de Vertex AI en Google Cloud. Cuando un prefijo sale de la caché en memoria, en lugar de descartarse pasa a un almacenamiento duradero, y así sube la probabilidad de acierto cuando reutilizas el contenido con más tiempo de separación. A 30 de octubre de 2026 está disponible en Gemini 4 Argon, 4 Argon Cyber Permissive, 3.8 Flash y 3.8 Flash Cyber, viene activada por defecto y no cobra almacenamiento. La documentación de la Gemini API de AI Studio no la menciona, así que con una clave de AI Studio no cuentes con ella.
Según la página de retención de datos de Agent Platform, la capa duradera guarda datos derivados del prompt (representaciones clave-valor), dentro de tu proyecto y de la región elegida si usas un endpoint regional, se borra como mucho a las 24 horas y no se usa para entrenar. No admite claves de cifrado gestionadas por el cliente (CMEK). Puedes desactivar solo la capa duradera o toda la caché implícita del proyecto; cuando está activa, la configuración de caché del proyecto devuelve "retentionType": "DURABLE". Si dudas entre usar la clave de AI Studio o un proyecto de Cloud, las diferencias de coste y migración están en Gemini API o Vertex AI: cómo elegir, comparar costes y migrar.
Caché de Gemini a través de una pasarela o del endpoint compatible con OpenAI
A través de LaoZhang, el 30 de octubre de 2026 la caché implícita funcionó tanto en la ruta nativa de Gemini como en el endpoint compatible con OpenAI, pero la explícita no estaba disponible. Las peticiones POST /v1beta/cachedContents (para 3.8 Flash y Argon) y GET /v1beta/cachedContents devolvieron HTTP 404 con "Invalid URL (POST /v1beta/cachedContents)", un error de la propia pasarela que no llegó a Google. Si necesitas caché explícita, hazlo con una clave de Google o un proyecto de Agent Platform.
En /v1/chat/completions con gemini-3.8-flash, una de tres peticiones acertó, con 8.161 tokens en prompt_tokens_details.cached_tokens; el principio de esas peticiones coincidía con el de un lote anterior de 6.143 tokens por la ruta nativa, así que el acierto pudo venir de esa caché. Para estimar costes por esta ruta, ten en cuenta que la tabla de precios de LaoZhang a 30 de octubre de 2026 da un precio de lectura de caché de USD 0,075 por millón para gemini-3.8-flash y ninguno para gemini-4-argon, de modo que no consta si allí un acierto en Argon se cobra rebajado; la misma documentación tampoco había anunciado aún el cambio de precio de Argon del 1 de diciembre.
Preguntas frecuentes sobre la caché de contexto de Gemini
¿En qué se diferencia la caché de Gemini de la de Claude?
En Claude marcas tú hasta dónde llega el prefijo con cache_control y la escritura en caché se paga aparte, mientras que la implícita de Gemini no se marca ni cobra escritura. El funcionamiento y los precios de Claude están en Claude prompt caching: cómo activarlo, precio y cuándo sale caro.
¿La caché de contexto tiene límites de peticiones propios?
No. Según la guía de caché de la Gemini API, se aplican los límites normales de generateContent y los tokens en caché cuentan dentro de los límites de tokens. Los niveles y el error 429 se explican en Límites de la API de Gemini: niveles, topes de gasto y error 429.
¿Cuánto cuesta la entrada en caché en Batch con Gemini 4 Argon?
En el modo Batch, un millón de tokens en caché de Argon cuesta USD 0,05 hasta el 30 de noviembre de 2026 y USD 0,10 desde el 1 de diciembre, la mitad que en el modo estándar, según la página de precios de la Gemini API.
¿La caché explícita guarda más datos de los que le pido?
Puede hacerlo en Google Cloud: la documentación de Agent Platform advierte que una caché explícita puede provocar caché implícita adicional más allá del contenido indicado. Si no quieres ninguna retención, Google indica desactivar la caché implícita del proyecto y no crear cachés explícitas.
¿Se puede usar la caché en el nivel gratuito de la Gemini API?
En 3.8 Flash sí, y la página de precios la marca como gratuita; en 3.5 Flash-Lite no está disponible en el nivel gratuito, y Gemini 4 Argon no tiene nivel gratuito. Qué modelos y límites incluye el plan sin coste está en Gemini API free tier 2026: modelos gratis, límites y API key.
Fuentes7
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 30 oct 2026.
Fuentes7
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 30 oct 2026.
- 1.guía de caché de contexto para generateContentai.google.dev/gemini-api/docs/generate-content/caching
- 2.versión para la Interactions APIai.google.dev/gemini-api/docs/caching
- 3.página de precios de la Gemini APIai.google.dev/gemini-api/docs/pricing
- 4.guía de novedades de Gemini 4 Argonai.google.dev/gemini-api/docs/generate-content/latest-model
- 5.documentación de caché de contexto de Google Clouddocs.cloud.google.com/gemini-enterprise-agent-platform/models/context-cache/context-cache-overview
- 6.guía de Gemini 4 Argon en Agent Platformdocs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-argon
- 7.página de retención de datos de Agent Platformdocs.cloud.google.com/gemini-enterprise-agent-platform/resources/zero-data-retention