Claude prompt caching: cómo activarlo, precio y cuándo sale caro
Claude cachea el prefijo hasta el bloque con cache_control. En Opus y Sonnet 5.5 (mínimo 512 tokens), leerlo cuesta 0,05× la entrada; escribirlo, 1,25× o 2×.
En esta página
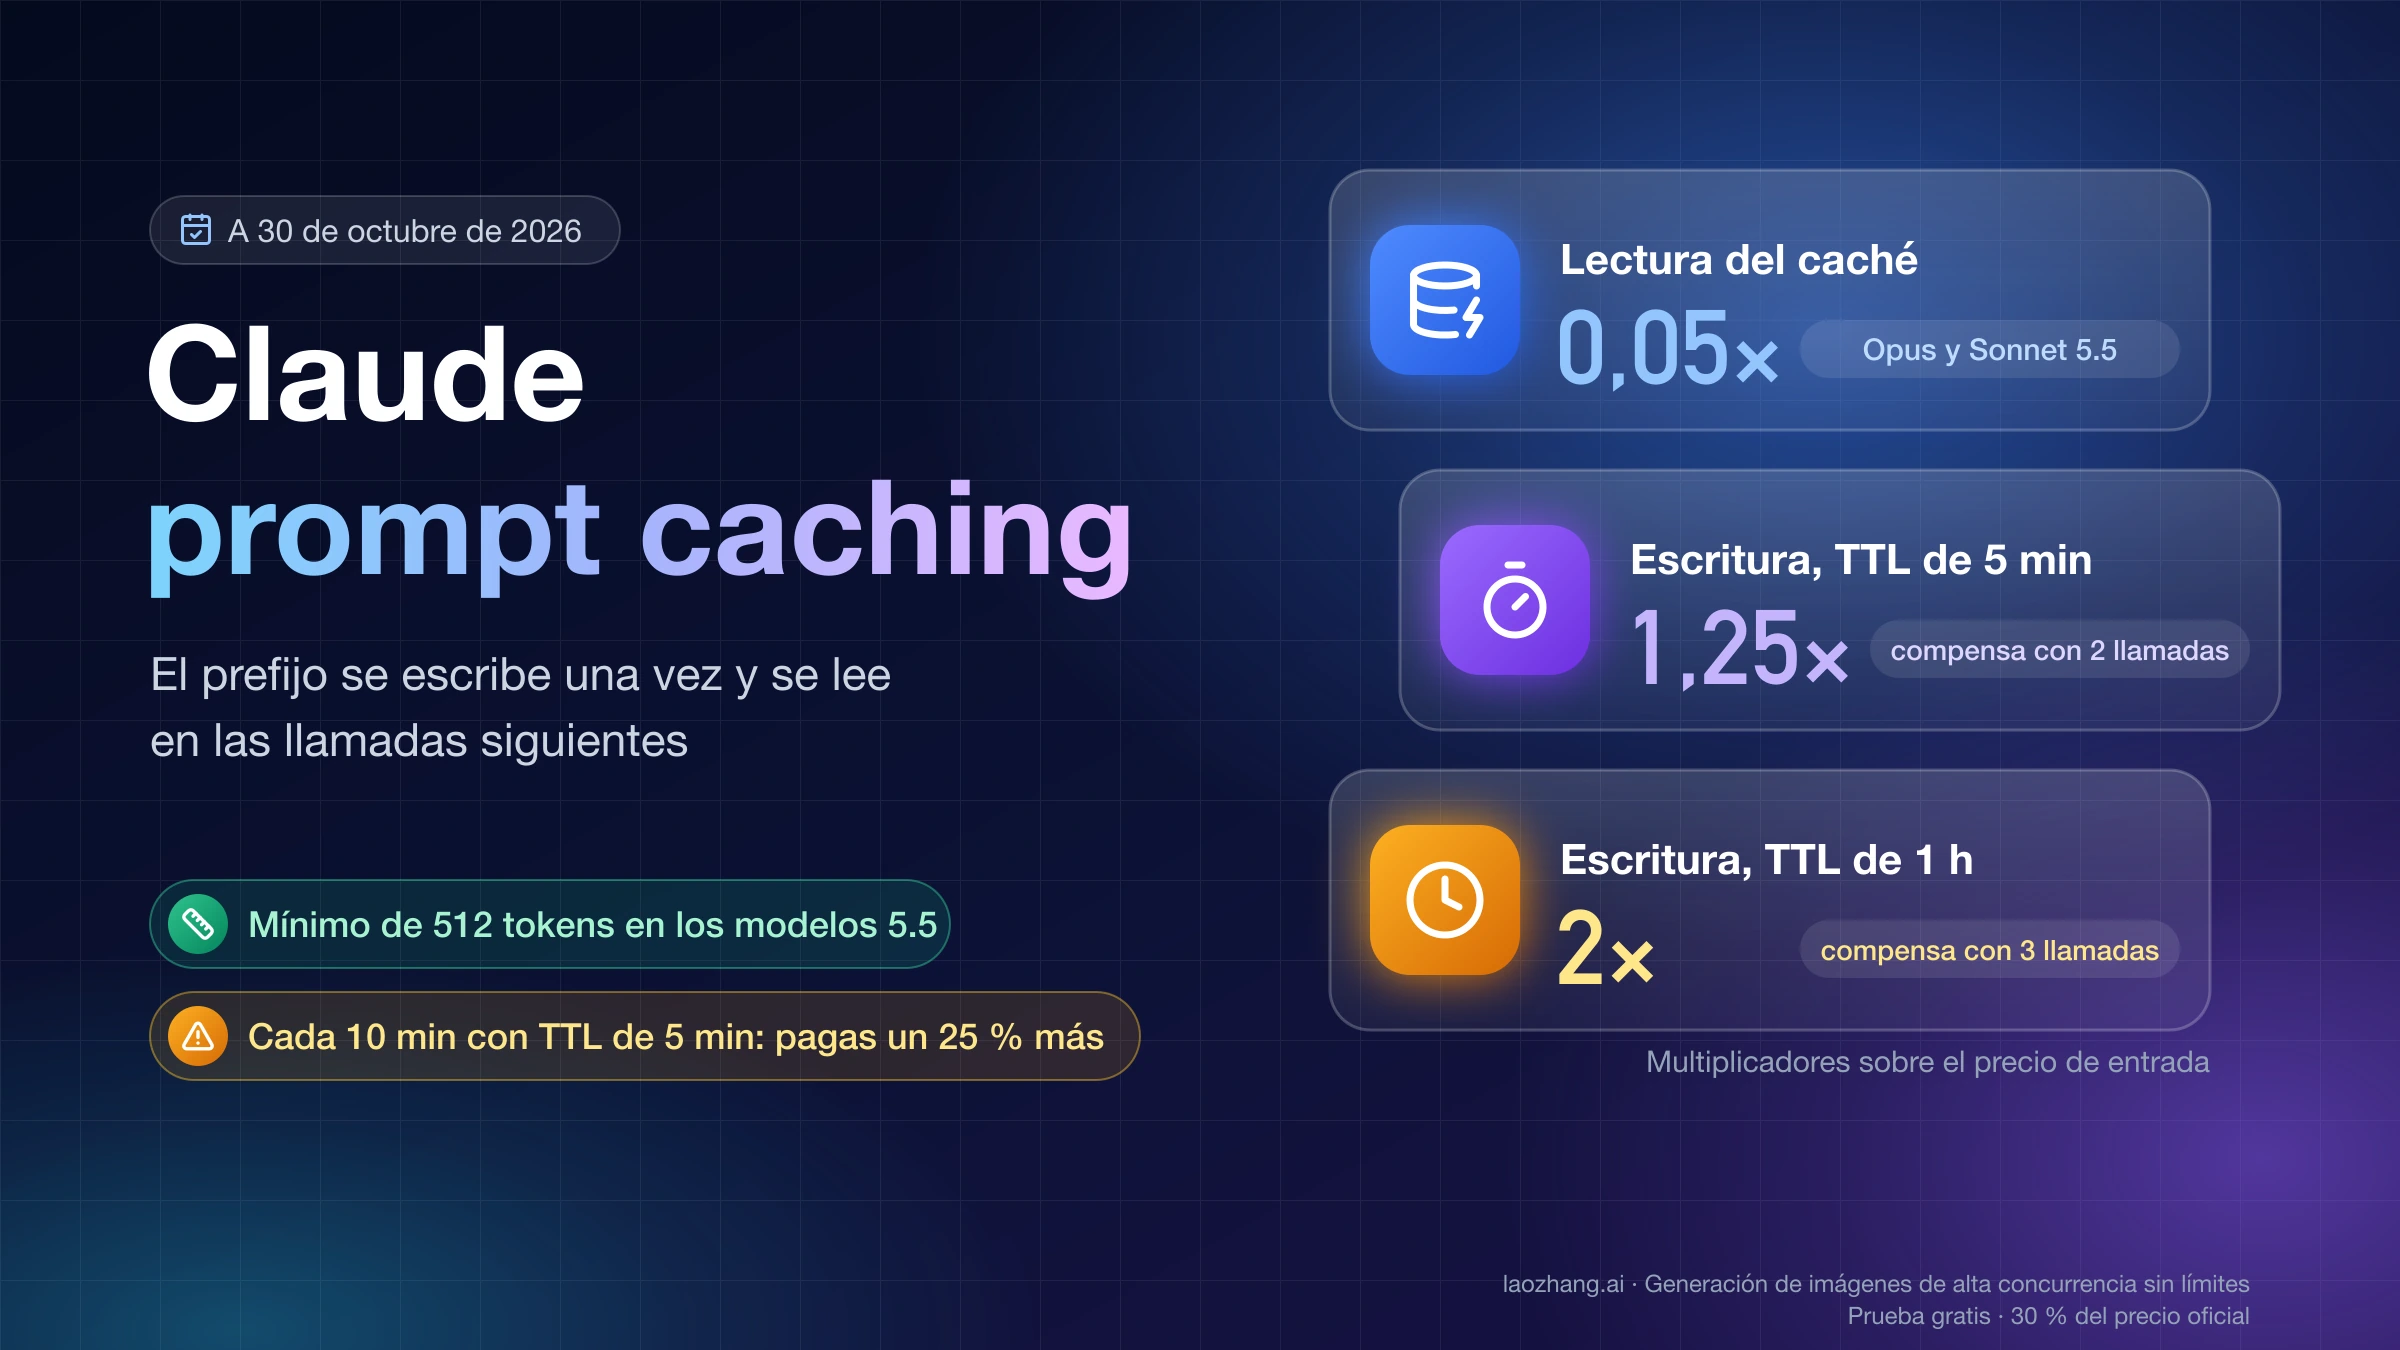
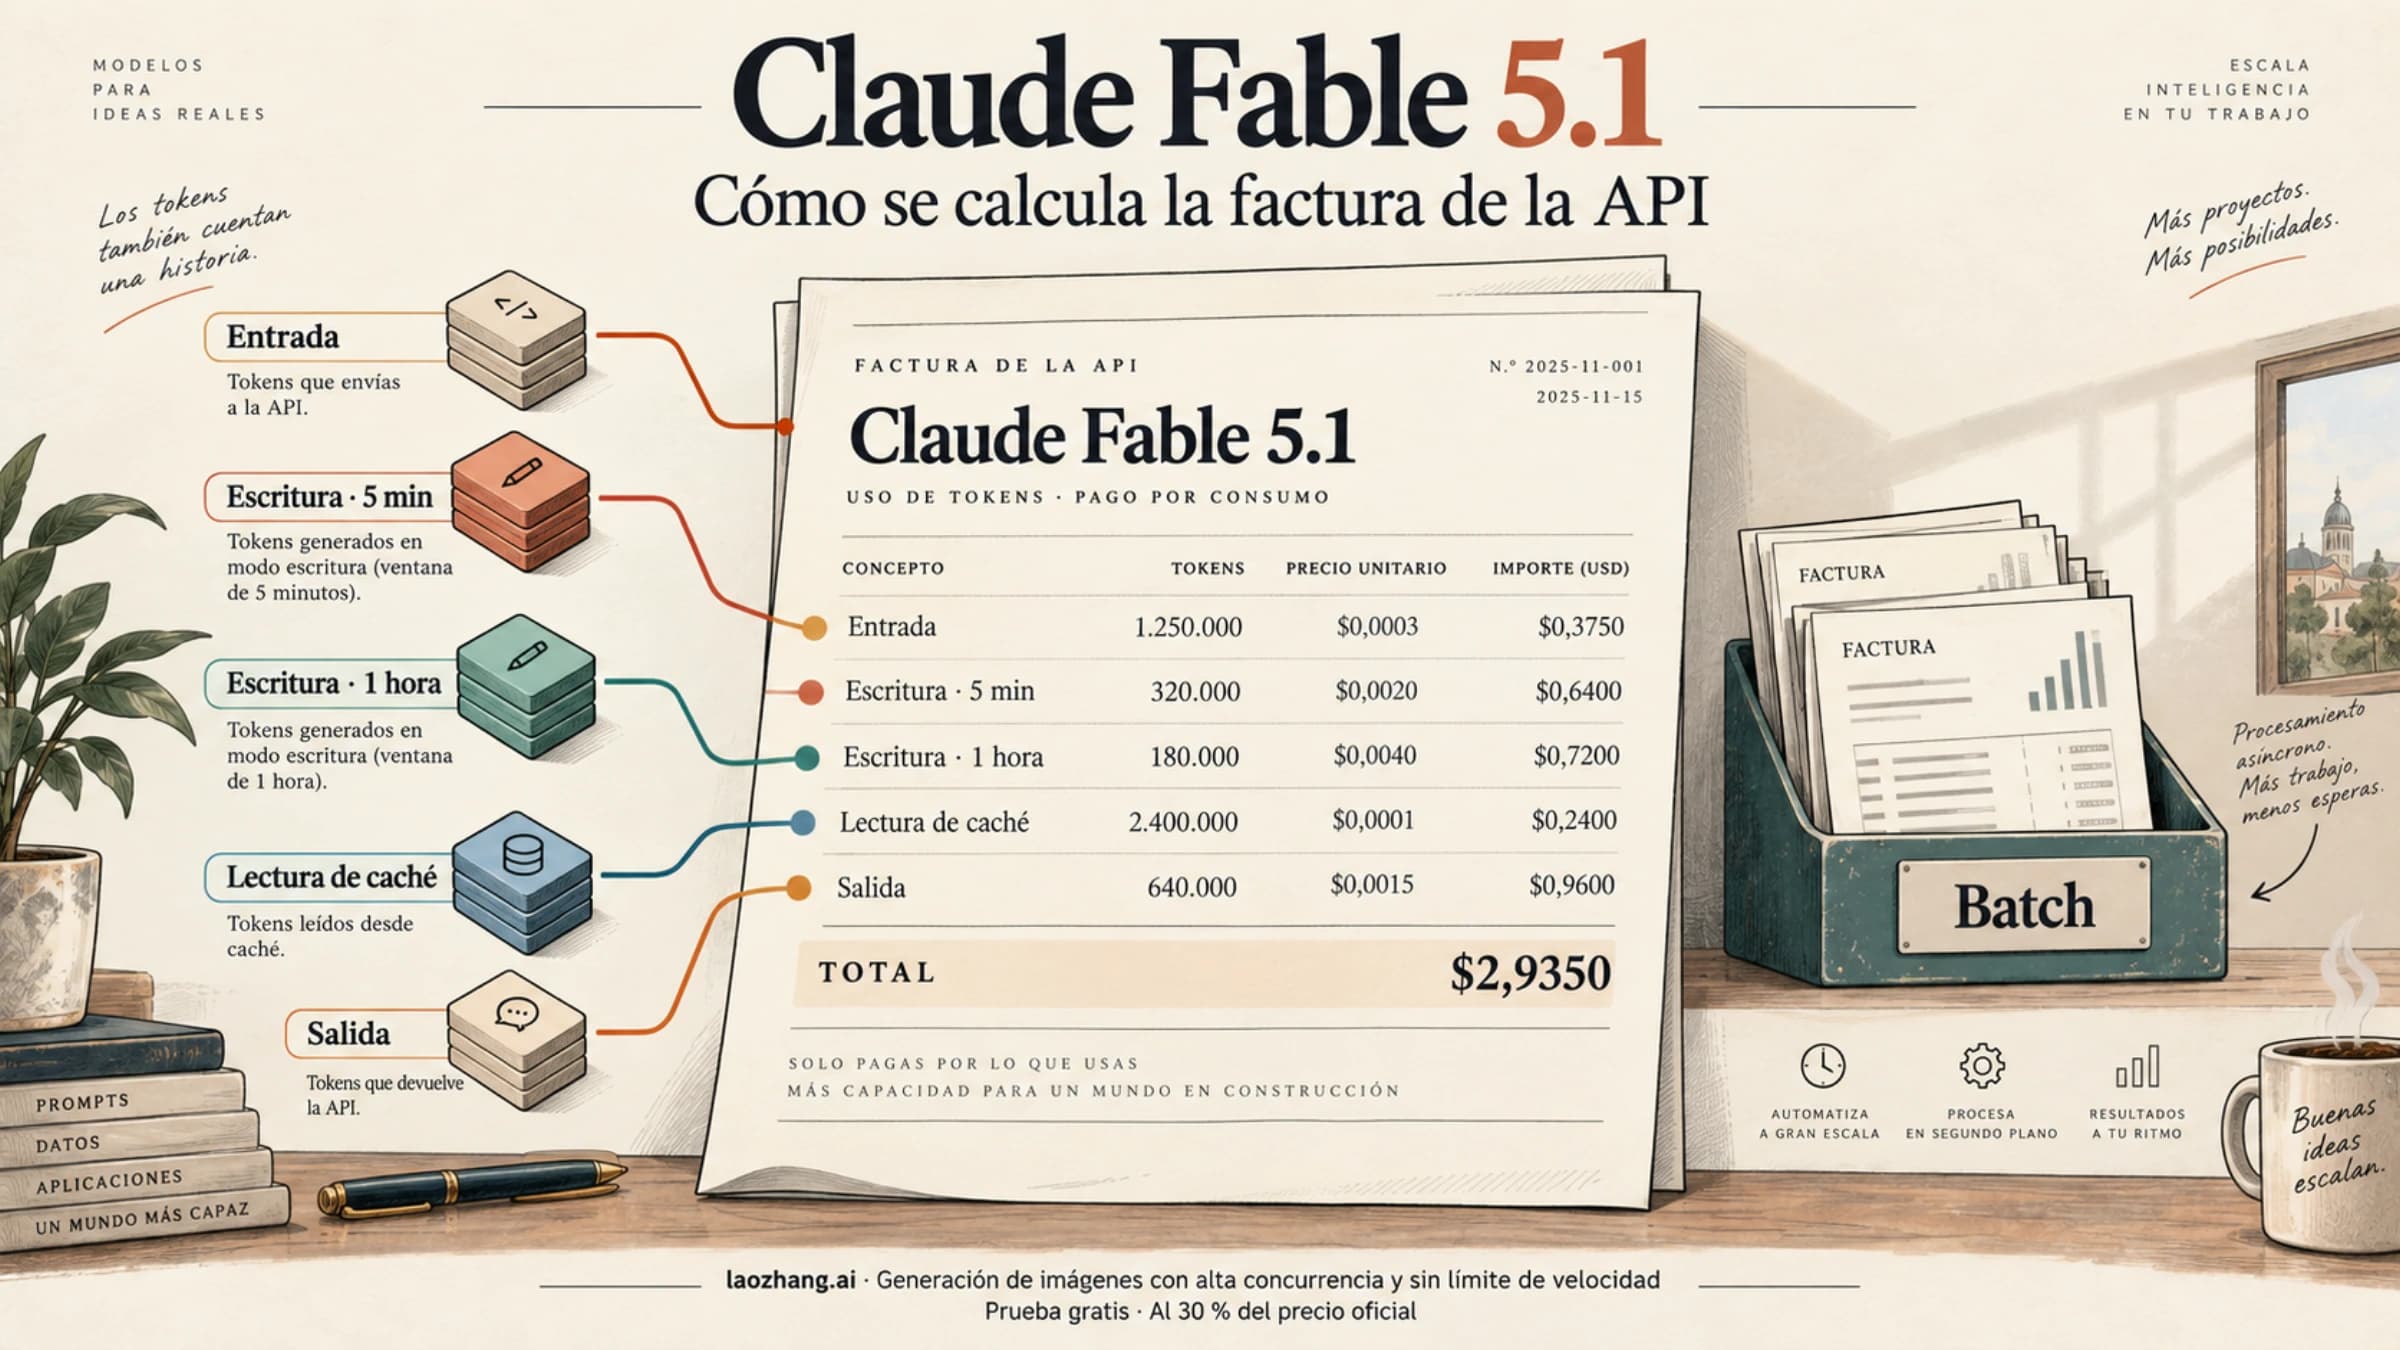
Claude prompt caching guarda el prefijo de tu petición —primero las herramientas, después el system y después los mensajes, hasta el bloque que marques con cache_control— y, si la siguiente petición empieza exactamente igual, lo lee del caché en lugar de procesarlo otra vez. A 30 de octubre de 2026, según la documentación de prompt caching de Anthropic, esa lectura cuesta 0,05× el precio de entrada en Claude Opus 5.5 y Sonnet 5.5, 0,025× en Fable 5.1 y 0,1× en Haiku 5.5, mientras que escribir el caché cuesta 1,25× con un TTL de 5 minutos o 2× con uno de 1 hora. En la API no se activa solo: hay que pedirlo.
Para activarlo hoy, añade "cache_control": {"type": "ephemeral"} en el nivel superior del cuerpo de la petición (caché automático, lo más sencillo para conversaciones de varios turnos) o en el último bloque que no cambia entre llamadas. Después mira cache_read_input_tokens en el usage de la segunda respuesta: si es mayor que 0, hubo acierto. En una prueba del 30 de octubre de 2026 con Sonnet 5.5 a través de LaoZhang, un prompt de sistema de 7.882 tokens se escribió en la primera llamada y se leyó completo en las dos siguientes.
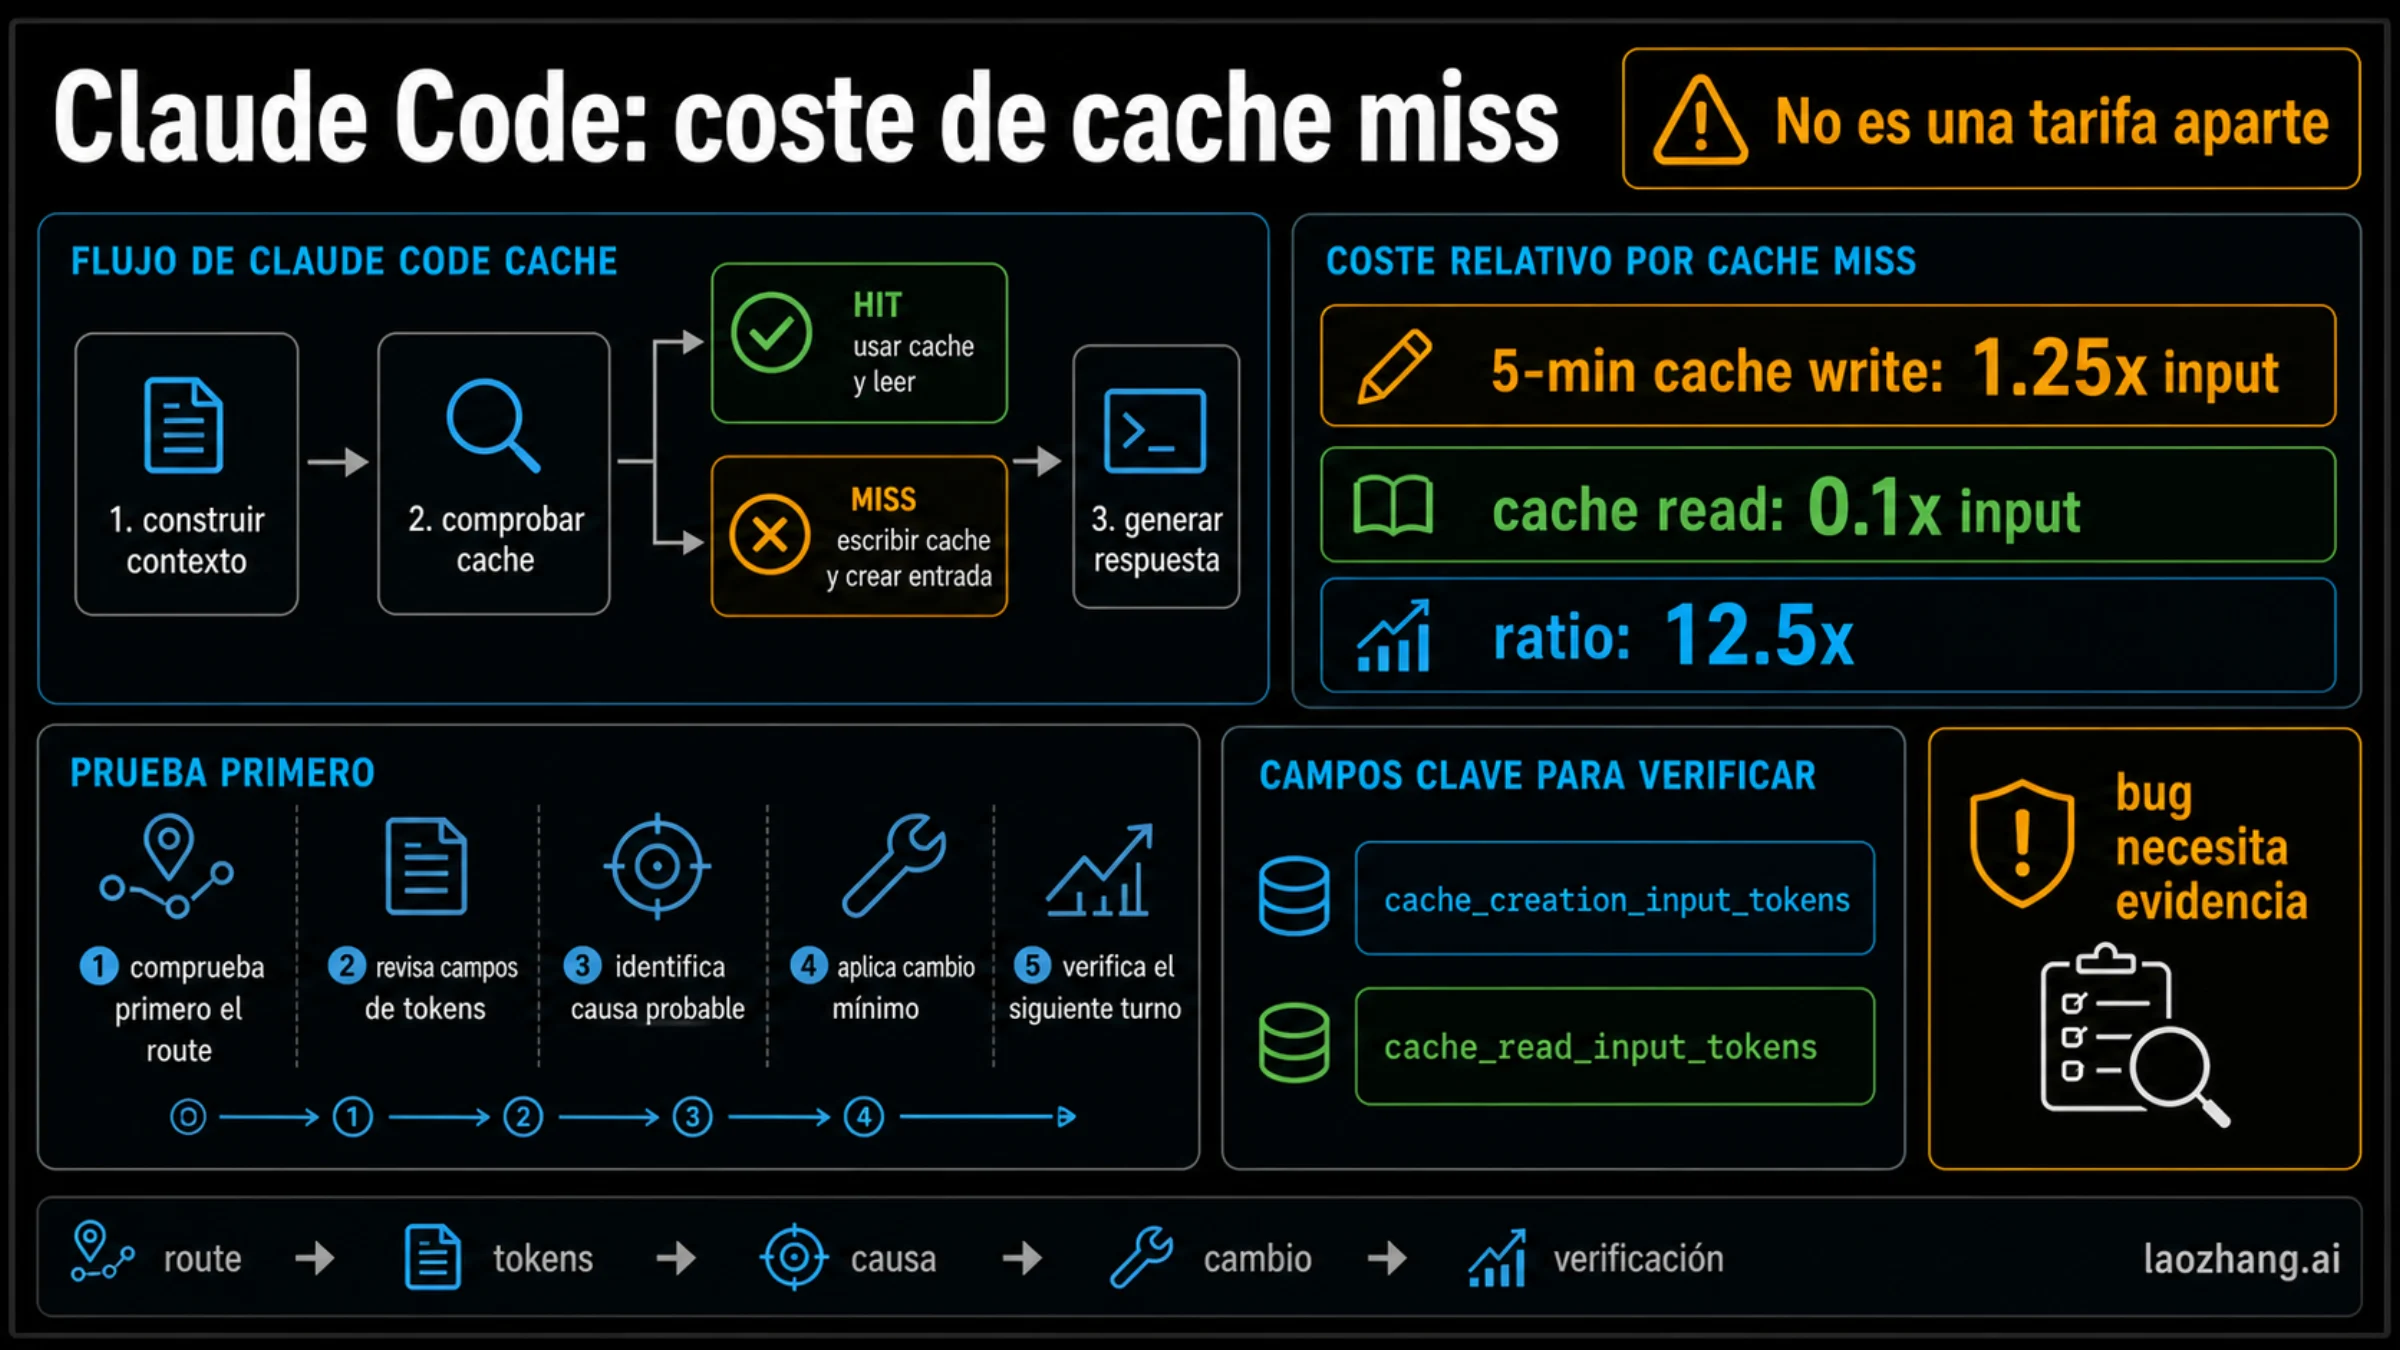
Hay tres situaciones en las que no ganas nada o pagas más. En los modelos 5.5, Opus 5 y Fable 5.1, un prefijo de menos de 512 tokens no se cachea y la API no avisa (en Sonnet 5 el umbral es de 1.024); una petición que no se repite dentro del TTL paga la escritura y nunca la amortiza; y si llamas cada 10 minutos con el caché de 5, reescribes cada vez y gastas un 25 % más que sin caché. Si lo que usas es Claude Code, no tienes que tocar nada: cachea por su cuenta.
Qué guarda el caché de Claude: el prefijo exacto hasta el bloque marcado
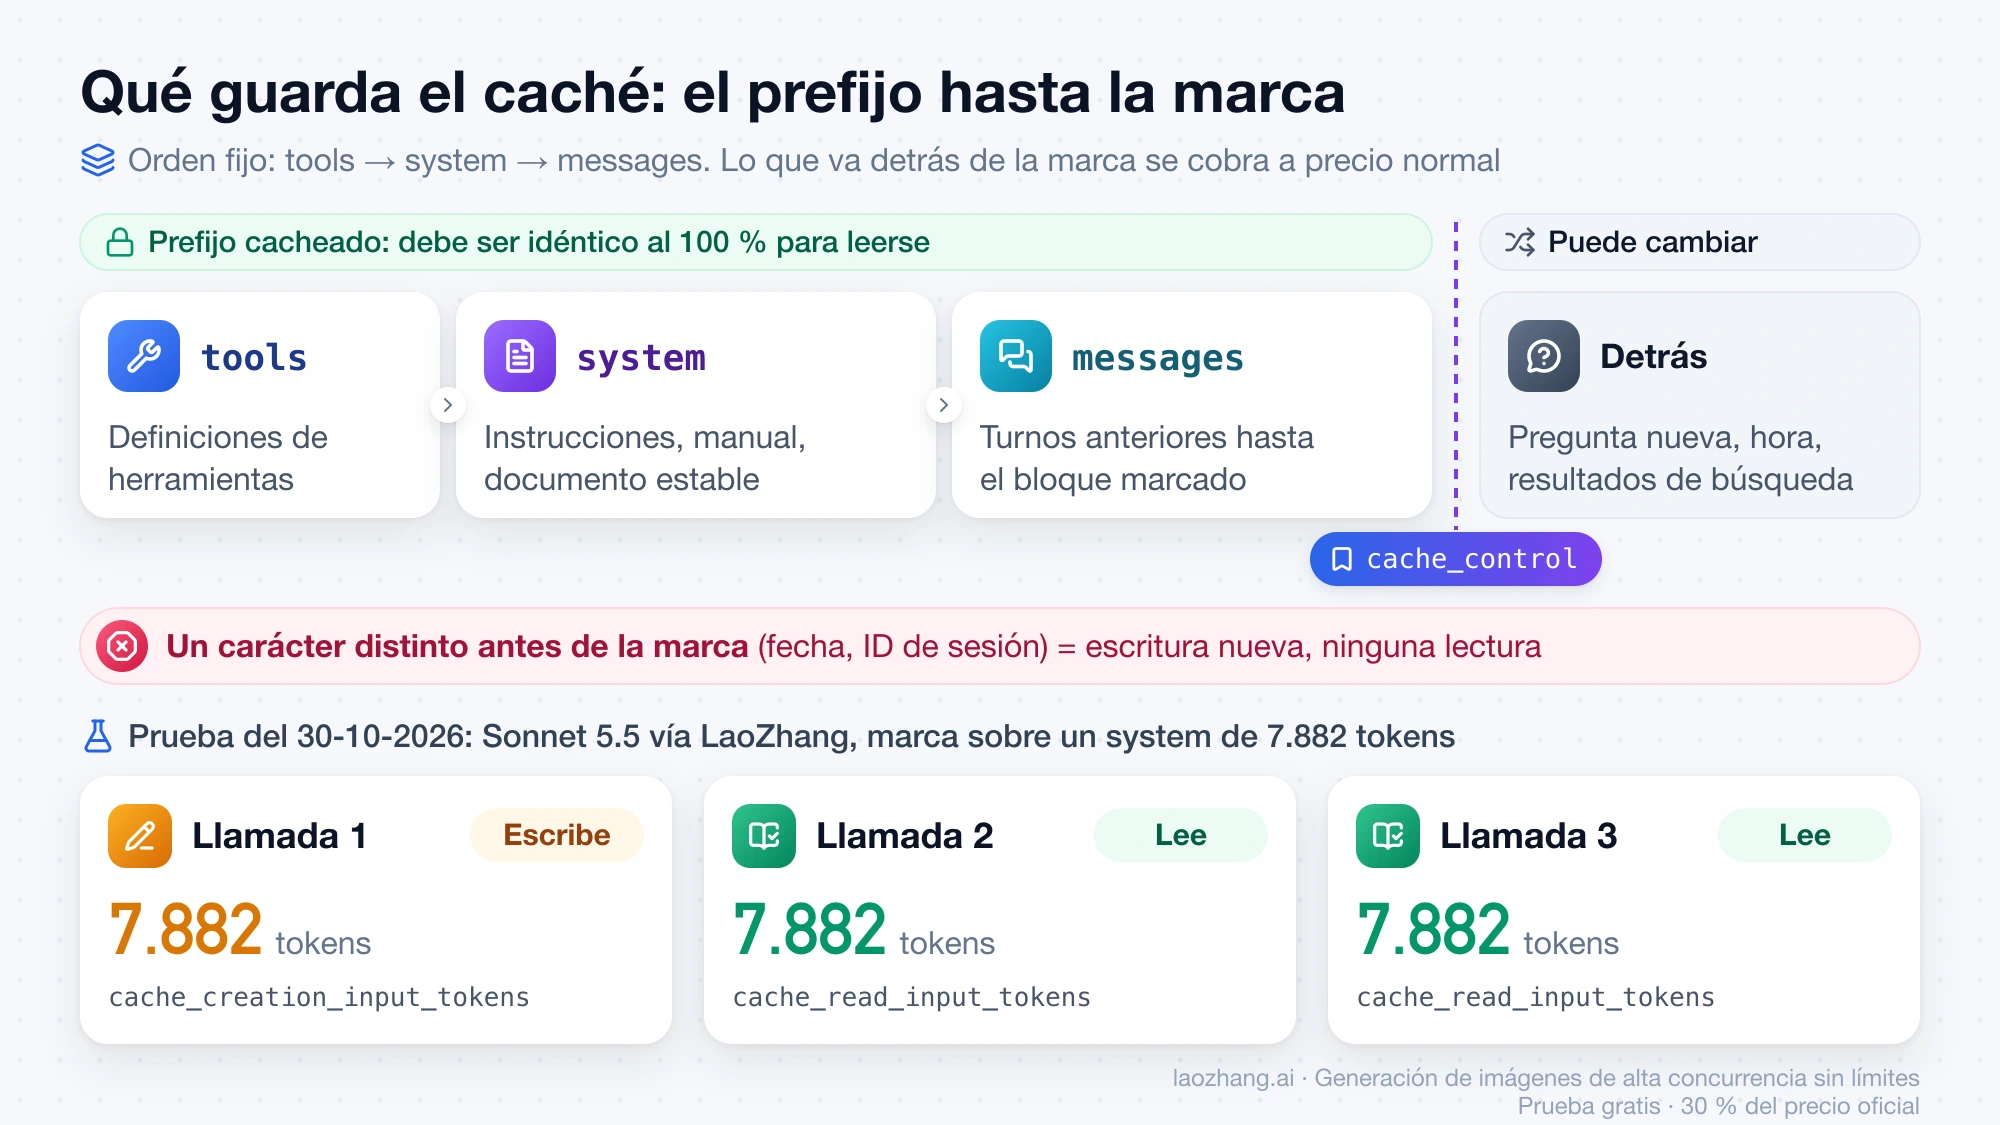
La clave del caché es el prefijo completo en el orden tools → system → messages, hasta el bloque que lleva cache_control incluido. Para leerlo, cada segmento debe ser idéntico al 100 %, texto e imágenes incluidos, así que un solo carácter distinto en ese tramo —una fecha en el system, un ID de sesión, una herramienta con la descripción retocada— produce un prefijo nuevo y una escritura en lugar de una lectura. Lo que va detrás del bloque marcado puede cambiar en cada llamada sin romper nada: es la parte que se cobra a precio normal.
Por eso el orden de tu petición importa más que su tamaño. El contenido estable (instrucciones, definiciones de herramientas, el documento o el código que consultas) va delante; lo que cambia en cada llamada (la pregunta del usuario, la hora, los resultados de búsqueda) va detrás del último punto de corte. Si metes la hora actual al principio del system, ningún caché sobrevive a la llamada siguiente.
Se pueden cachear las definiciones de herramientas, los bloques del system, el texto de los turnos de usuario y de asistente, las imágenes y documentos de los turnos de usuario y los bloques tool_use y tool_result. Los bloques de thinking no se marcan directamente: se cachean junto con el resto de un turno de asistente anterior y, cuando se leen, cuentan como tokens de entrada. Los subbloques de citas tampoco; para eso se cachea el documento.
La entrada vive 5 minutos por defecto y cada lectura la renueva sin coste. El reloj empieza al inicio de la petición que escribe o lee, no al final de su respuesta: si una respuesta en streaming tarda 4 minutos, al caché de 5 le queda alrededor de 1 minuto. Los cachés nunca se comparten entre organizaciones; en la API de Claude, Claude Platform on AWS y Microsoft Foundry además están aislados por workspace, mientras que en Amazon Bedrock y Google Cloud se comparten a nivel de organización. Leer del caché no cambia la respuesta del modelo.
Cómo activar el prompt caching: cache_control automático o por bloque
Hay dos maneras y usan el mismo campo, cache_control. El caché automático pone un único cache_control en el nivel superior y deja que la API coloque el punto de corte en el último bloque cacheable; los puntos de corte explícitos (breakpoints) lo colocan dentro de bloques concretos. Anthropic recomienda empezar por el automático en conversaciones de varios turnos y pasar a los explícitos cuando quieras decidir tú qué se cachea. Ambos tienen el mismo precio, el mismo mínimo de tokens y el mismo orden de prefijo.
Caché automático: un campo en el nivel superior
Con el caché automático, el punto de corte avanza solo a medida que crece la conversación: cada petición lee lo que ya estaba guardado y escribe la cola nueva. Así se ve una petición a la API de Claude:
curl https://api.anthropic.com/v1/messages \
  -H "content-type: application/json" \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -d '{
    "model": "claude-sonnet-5-5",
    "max_tokens": 1024,
    "cache_control": {"type": "ephemeral"},
    "system": "Eres el asistente de soporte de una tienda online. (Aquí van tus instrucciones, políticas y catálogo: más de 512 tokens en total.)",
    "messages": [
      {"role": "user", "content": "¿Cuánto tarda un envío a Canarias?"},
      {"role": "assistant", "content": "Entre 3 y 5 días laborables."},
      {"role": "user", "content": "¿Y si pago el envío urgente?"}
    ]
  }'
En la prueba del 30 de octubre de 2026 (Sonnet 5.5, a través de LaoZhang, tres turnos de la misma conversación), el primer turno escribió 7.906 tokens; el segundo leyó esos 7.906 y escribió 65 nuevos; el tercero leyó 7.971 y escribió 74. Es exactamente el avance que describe la documentación.
El caché automático ocupa uno de los cuatro huecos de punto de corte y tiene algunos casos límite. Si el último bloque ya lleva un cache_control explícito con el mismo TTL, no hace nada; si lo lleva con otro TTL, o si ya hay cuatro puntos de corte explícitos, la API devuelve un error 400. No está disponible en la integración antigua de Amazon Bedrock (Opus 4.6 y anteriores), que también responde 400 al cache_control de nivel superior.
Puntos de corte explícitos: hasta cuatro, en bloques estables
Con puntos de corte explícitos marcas tú el último bloque estable, y la escritura se produce solo en esa marca. Es la opción cuando la parte fija y la variable no siguen el orden natural de la conversación: un manual largo seguido de preguntas distintas, un juego de herramientas que no cambia o varias capas que se renuevan a ritmos diferentes. Puedes poner hasta cuatro, y marcar un bloque no cuesta nada por sí mismo.
import anthropic

client = anthropic.Anthropic()  # lee ANTHROPIC_API_KEY del entorno

manual = open("manual.md", encoding="utf-8").read()  # contenido fijo, más de 512 tokens

response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=1024,
    system=[
        {"type": "text", "text": "Responde solo con datos del manual adjunto."},
        {
            "type": "text",
            "text": manual,
            "cache_control": {"type": "ephemeral"},  # TTL de 1 hora: {"type": "ephemeral", "ttl": "1h"}
        },
    ],
    messages=[{"role": "user", "content": "¿Qué garantía tiene el modelo X200?"}],
)
print(response.usage)
Con un punto de corte así sobre un system de 7.882 tokens, la prueba del 30 de octubre de 2026 en Sonnet 5.5 dio una escritura de 7.882 en la primera llamada y lecturas de 7.882 en la segunda y la tercera, cada una con una pregunta distinta. Para encontrar entradas anteriores, la lectura mira hacia atrás hasta 20 posiciones, pero solo encuentra lo que otras peticiones ya escribieron en sus propios puntos de corte: si el bloque marcado cambia en cada llamada, el contenido estable que va antes de él nunca llega a escribirse por separado y no hay nada que leer. El error más común es justo ese: poner la marca en un bloque que contiene una marca de tiempo o el mensaje del usuario, lo que según Anthropic provoca una escritura nueva en cada petición y ninguna lectura. La solución es mover la marca al último bloque que se mantiene idéntico. El caché automático tiene el mismo problema si el último bloque de tu petición cambia siempre (por ejemplo, un contexto con la hora añadido al final); en ese caso usa una marca explícita.
Precio del caché por modelo: la lectura va de 0,025× a 0,1×
El caché cambia solo el precio de los tokens de entrada que caen en el prefijo, y la lectura ya no cuesta un 10 % uniforme: ese 0,1× queda para Haiku 5.5 y los modelos anteriores. En Opus 5.5 y Sonnet 5.5, entre escribir con TTL de 5 minutos y leer hay una distancia de 25 veces, no las 12,5 que salen con la cifra antigua. Precios por millón de tokens según la tabla de precios de prompt caching de Anthropic, a 30 de octubre de 2026:
| Modelo | Entrada sin caché | Escritura 5 min | Escritura 1 h | Lectura (multiplicador) | Mínimo cacheable |
|---|---|---|---|---|---|
| Claude Fable 5.1 | 10 $ | 12,50 $ | 20 $ | 0,25 $ (0,025×) | 512 tokens |
| Claude Opus 5.5 | 4 $ | 5 $ | 8 $ | 0,20 $ (0,05×) | 512 tokens |
| Claude Sonnet 5.5 | 2 $ | 2,50 $ | 4 $ | 0,10 $ (0,05×) | 512 tokens |
| Claude Haiku 5.5, prompt de hasta 100.000 tokens | 0,10 $ | 0,125 $ | 0,20 $ | 0,01 $ (0,1×) | 512 tokens |
| Claude Haiku 5.5, prompt de más de 100.000 tokens | 0,50 $ | 0,625 $ | 1 $ | 0,05 $ (0,1×) | 512 tokens |
| Claude Sonnet 4.6 | 3 $ | 3,75 $ | 6 $ | 0,30 $ (0,1×) | 1.024 tokens |
| Claude Haiku 4.5 | 1 $ | 1,25 $ | 2 $ | 0,10 $ (0,1×) | 4.096 tokens |
El mínimo de 512 tokens vale para Fable 5.1, Opus 5.5, Sonnet 5.5, Haiku 5.5 y Opus 5 (también para Fable 5 y Mythos 5 y 5.1), no para toda la familia 5.x: Sonnet 5 sigue en 1.024 tokens, igual que Sonnet 4.6, Sonnet 4.5 y Opus 4.8; Opus 4.7 pide 2.048, y Opus 4.6, Opus 4.5 y Haiku 4.5, 4.096. Bedrock publica sus propios mínimos. En Haiku 5.5, las lecturas y escrituras de caché cuentan para la longitud del prompt, de modo que un prefijo cacheado de 90.000 tokens más 20.000 nuevos pasa toda la petición a la tarifa de más de 100.000. Los multiplicadores se acumulan con el descuento de Batch, la tarifa de contexto largo y la residencia de datos.
La cuenta del ahorro es directa. Con el prefijo medido de 7.882 tokens en Sonnet 5.5 y 10 llamadas dentro del TTL, sin caché pagas 10 × 7.882 × 2 $/M = 0,1576 $ de entrada; con caché de 5 minutos, 7.882 × 2,50 $/M + 9 × 7.882 × 0,10 $/M = 0,0268 $ (un 83,0 % menos), y con caché de 1 hora, 7.882 × 4 $/M + 9 × 7.882 × 0,10 $/M = 0,0386 $ (un 75,5 % menos). Con un prefijo de 80.000 tokens y 20 llamadas dentro del TTL, la misma fórmula da esto para la parte de entrada (la salida no cambia con el caché):
| Modelo | Sin caché | Caché de 5 min | Caché de 1 h |
|---|---|---|---|
| Fable 5.1 | 16,00 $ | 1,38 $ (−91,4 %) | 1,98 $ (−87,6 %) |
| Opus 5.5 | 6,40 $ | 0,704 $ (−89,0 %) | 0,944 $ (−85,2 %) |
| Sonnet 5.5 | 3,20 $ | 0,352 $ (−89,0 %) | 0,472 $ (−85,2 %) |
| Haiku 5.5 | 0,16 $ | 0,025 $ (−84,2 %) | 0,031 $ (−80,5 %) |
Las tarifas completas de cada modelo, salida incluida, están en Precio de la API de Claude Fable 5.1 y cuánto baja tu factura y en Claude Opus 5.5: precio de la API y restablecimiento de límites. Si todavía dudas de modelo, Claude Haiku 5.5 vs Sonnet 5.5: cuál elegir y coste por tarea compara el coste por tarea.
¿TTL de 5 minutos o de 1 hora? Cuándo compensa y cuándo sale más caro
Elige por el intervalo entre llamadas que reutilizan el mismo prefijo. Si vuelves a él más a menudo que cada 5 minutos, quédate con el TTL de 5: cada lectura lo renueva gratis y escribir cuesta menos. Si las llamadas llegan separadas entre 5 y 60 minutos —un usuario que piensa antes de responder, un trabajo programado cada cuarto de hora—, usa el de 1 hora. Si el prefijo se usa una sola vez, no lo caches: pagarás 1,25× o 2× sobre esa parte sin leerla nunca. Para la latencia, los dos TTL se comportan igual.
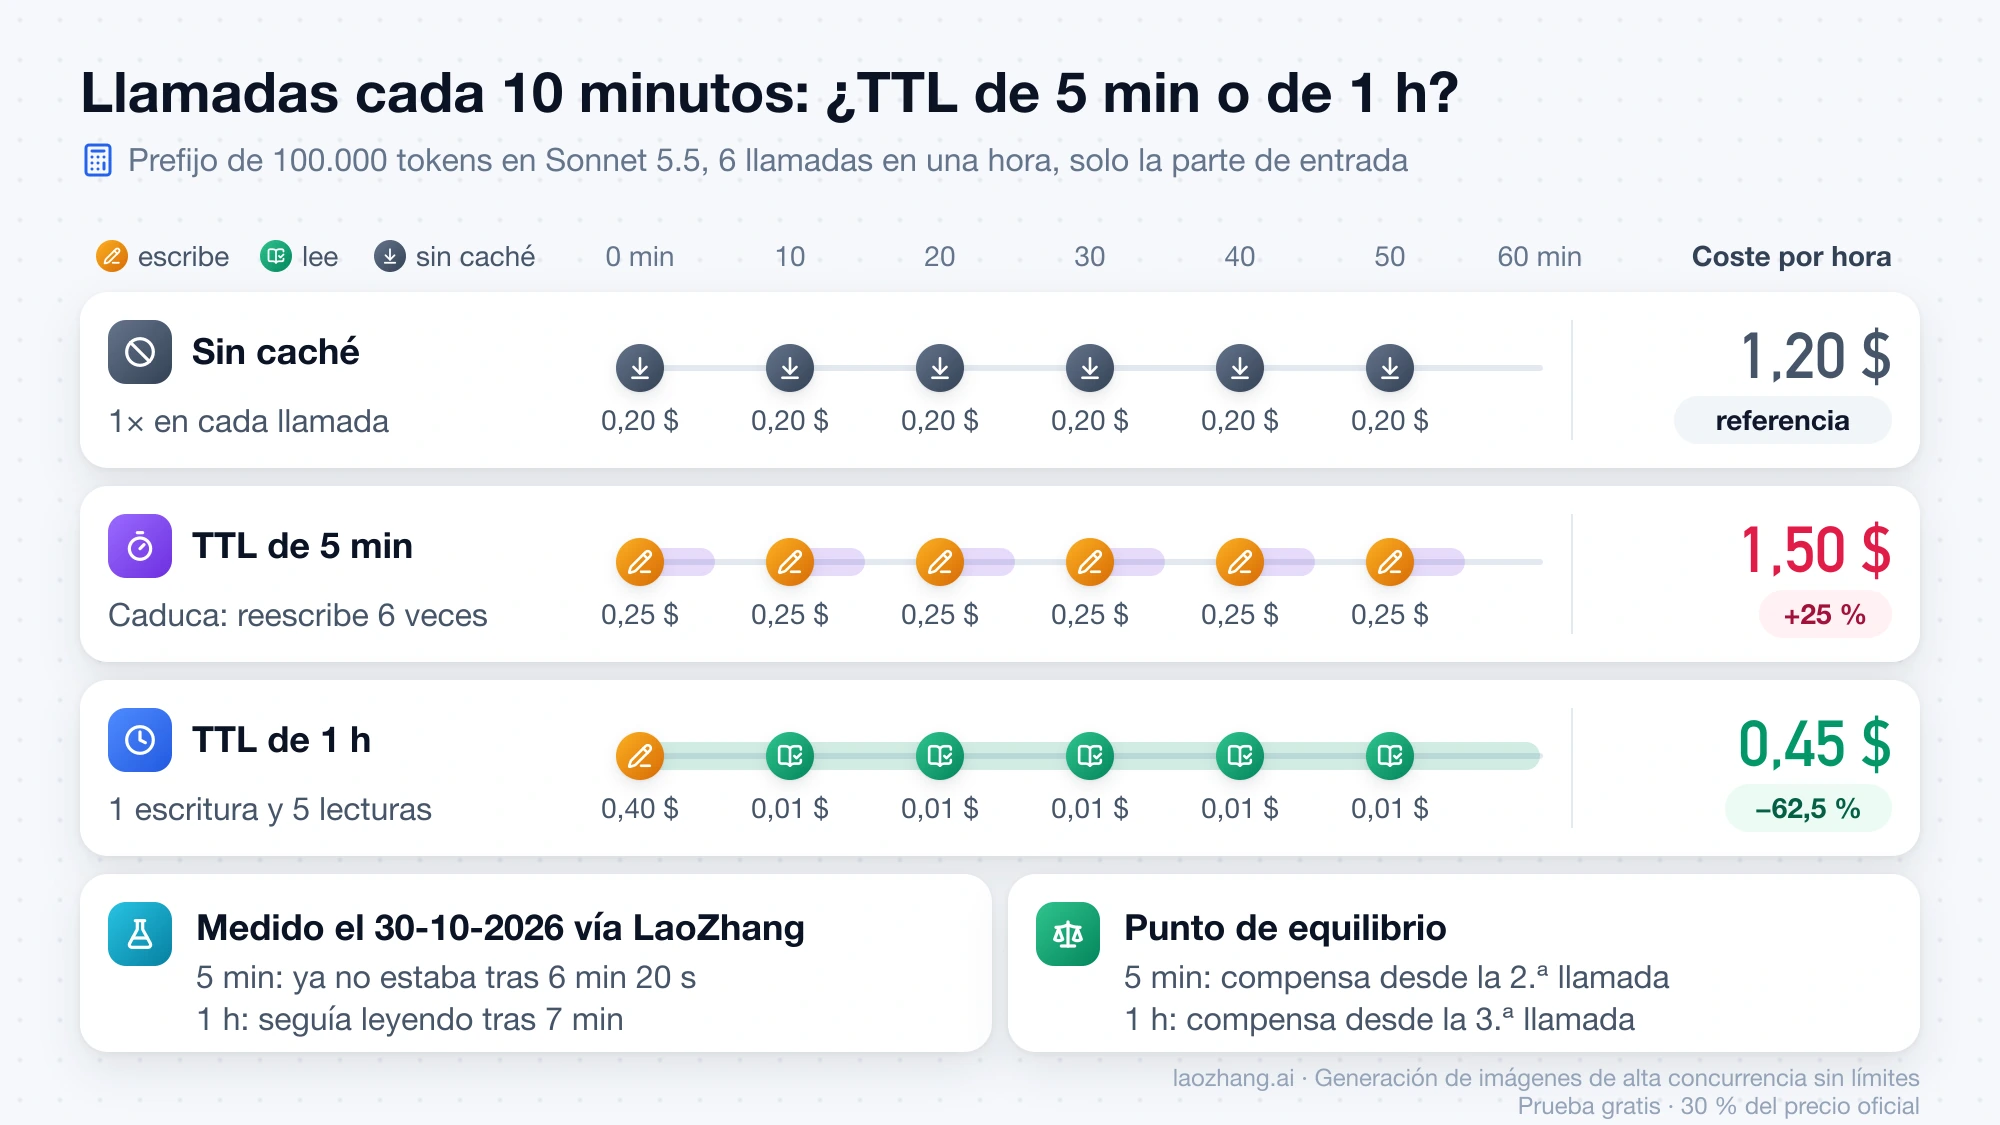
El punto de equilibrio sale de los multiplicadores. Con el caché de 5 minutos, dos llamadas cuestan 1,25 + 0,05 = 1,30 veces la entrada en Opus y Sonnet 5.5 (1,35 en Haiku 5.5, 1,275 en Fable 5.1), menos que las 2 veces de no cachear, así que compensa desde la segunda llamada en todos los modelos. Con el de 1 hora, dos llamadas cuestan 2,05 en Opus y Sonnet 5.5, más que 2; con tres, 2,10 frente a 3. Compensa desde la tercera.
El caso caro es el caché que caduca entre llamadas. Con un prefijo de 100.000 tokens en Sonnet 5.5 y una llamada cada 10 minutos (6 por hora), sin caché pagas 6 × 0,20 $ = 1,20 $ por hora; con el TTL de 5 minutos reescribes las seis veces y pagas 6 × 0,25 $ = 1,50 $, un 25 % más; con el de 1 hora pagas una escritura de 0,40 $ y cinco lecturas de 0,01 $, 0,45 $ en total, un 62,5 % menos. La prueba del 30 de octubre de 2026 confirmó los dos relojes a través de LaoZhang: el caché de 5 minutos ya no estaba tras 6 min 20 s sin uso y la llamada volvió a escribir 7.882 tokens, mientras que el de 1 hora seguía leyendo 7.882 tras 7 minutos de inactividad. El límite superior de la hora no se midió.
Si mezclas los dos TTL en una misma petición, las entradas de 1 hora tienen que ir antes que las de 5 minutos. Los dos métodos también se combinan: según Anthropic, puedes marcar el system con un punto de corte explícito (por ejemplo con "ttl": "1h") y dejar que el caché automático de 5 minutos siga a la conversación; el automático ocupa entonces uno de los cuatro huecos.
Cómo saber si hubo acierto de caché: los campos de usage
La respuesta lo dice en usage: cache_creation_input_tokens son los tokens escritos ahora, cache_read_input_tokens los leídos del caché e input_tokens solo los que van después del último punto de corte. La entrada total es la suma de los tres. Si cache_read_input_tokens es mayor que 0, hubo acierto; si solo hay escritura, el prefijo era nuevo o había caducado; si los dos campos están en 0, no se cacheó nada. En streaming, los campos llegan en el evento message_start.
| Campo | Qué indica | Valor medido el 30-10-2026 (Sonnet 5.5, vía LaoZhang) |
|---|---|---|
cache_creation_input_tokens | Tokens escritos en caché en esta petición, a 1,25× o 2× | 7.882 en la primera llamada; 0 en las repeticiones |
cache_read_input_tokens | Tokens leídos del caché (lo que llaman «cache read») | 0 en la primera; 7.882 en la segunda y la tercera |
input_tokens | Tokens después del último punto de corte, a precio normal | 28, 16 y 17 (solo la pregunta) |
cache_creation.ephemeral_5m_input_tokens / ephemeral_1h_input_tokens | Desglose de la escritura por TTL; Anthropic lo devuelve con el TTL de 1 h | No apareció en la respuesta de /v1/messages con "ttl": "1h" |
prompt_tokens_details.cached_creation_tokens (formato OpenAI) | Escritura, en el endpoint compatible con OpenAI | 7.882 en la primera llamada |
prompt_tokens_details.cached_tokens (formato OpenAI) | Lectura, en el endpoint compatible con OpenAI | 7.882 en la segunda |
prompt_tokens (formato OpenAI) | Total de entrada, cacheados incluidos | 7.893 en ambas llamadas |
El coste de cada petición sale de esos mismos números: cache_creation_input_tokens por el precio de escritura, más cache_read_input_tokens por el de lectura, más input_tokens por el de entrada, más la salida. Si en tu panel no ves la bajada esperada, suma estos campos durante una hora antes de buscar otra causa.
Cuando el fallo no tiene explicación, la API de Claude ofrece diagnóstico de caché: añade "diagnostics": {"previous_message_id": null} en el primer turno y el id de la respuesta anterior en los siguientes, y la respuesta indicará en qué parte divergió el prefijo (modelo, system, herramientas o mensajes); diagnostics: null significa que no hubo divergencia. Según la documentación de diagnóstico de caché de Anthropic, funciona en Fable 5.1, Opus 5.5, Sonnet 5.5 y Haiku 5.5, ya sin cabecera beta, y solo en la API de Claude. A través de LaoZhang, el 30 de octubre de 2026 la petición con diagnostics devolvió HTTP 200 sin ese campo, y el turno con el system modificado mostró una escritura nueva de 7.890 tokens sin explicación.
Por qué Claude no lee el caché: síntomas, causas y arreglo
Casi todos los fallos se reconocen por lo que muestra usage, y cada causa tiene un arreglo distinto. Busca tu síntoma en la tabla; los casos marcados con fecha se reprodujeron el 30 de octubre de 2026 en Sonnet 5.5 a través de LaoZhang, y el resto procede de la documentación de Anthropic.
| Lo que ves en usage | Causa probable | Qué hacer |
|---|---|---|
| Escritura y lectura en 0, HTTP 200 sin error | Prefijo por debajo del mínimo (512 tokens en los modelos 5.5, Opus 5 y Fable 5.1; 1.024 en Sonnet 5). El 30-10-2026, prefijos de 180 y 377 tokens quedaron en 0; los de 567 y 1.094 se cachearon | Acumula más contenido estable antes de la marca o no caches esa petición |
| Escritura completa en cada llamada, ninguna lectura | Algo cambia antes de la marca: hora, ID de petición, mensaje del usuario dentro del bloque marcado | Mueve el contenido variable detrás del último punto de corte |
| Escritura completa tras tocar las herramientas | Cambiar una definición de herramienta invalida herramientas, system y mensajes; Swift y Go pueden desordenar las claves JSON de tool_use | Fija las herramientas y serializa las claves en orden estable |
| Escritura del system tras activar búsqueda web, citas o modo rápido | Esos interruptores invalidan system y mensajes; cambiar tool_choice o añadir o quitar imágenes invalida los mensajes | Decide esos ajustes al principio de la sesión y no los alternes |
Escritura tras cambiar parámetros de thinking o effort | Invalidan siempre los mensajes; herramientas y system, según el modelo. El 30-10-2026, pasar effort de low a medium mantuvo el caché del system en Sonnet 5.5 | Mantén constantes esos parámetros dentro de una conversación |
| Escritura completa al cambiar de modelo | Cada modelo tiene su propio caché. El 30-10-2026, Opus 5.5 escribió de nuevo los 7.882 tokens que Sonnet 5.5 ya tenía cacheados | No alternes modelos sobre el mismo prefijo, o cuenta con una escritura por modelo |
| Escritura tras una pausa | Caducó el TTL. El 30-10-2026, el de 5 minutos ya no estaba tras 6 min 20 s | Pasa a "ttl": "1h" o precalienta antes de la siguiente ráfaga |
| Varias escrituras del mismo prefijo al lanzar peticiones a la vez | Peticiones paralelas en frío: el caché solo existe cuando empieza la primera respuesta. El 30-10-2026, tres peticiones simultáneas escribieron tres veces | Envía una primero y lanza las demás cuando empiece su respuesta |
| Acierto en un servicio, fallo en otro con el mismo prompt | Workspaces distintos: en la API de Claude el caché se aísla por workspace | Usa el mismo workspace para el tráfico que comparte prefijo |
El caso paralelo tiene un coste concreto: tres escrituras del prefijo de 7.882 tokens en Sonnet 5.5 cuestan 3 × 7.882 × 2,50 $/M = 0,0591 $, frente a 0,0213 $ si una escribe y las otras dos leen. Si lanzas lotes de agentes en paralelo con el mismo contexto, esa diferencia se multiplica por cada lote.
Prompt caching a través de una pasarela o del endpoint compatible con OpenAI
Una pasarela puede reenviar cache_control tal cual, rechazarlo o eliminarlo sin avisar, y en este último caso pagas todo el prompt sin caché. La única forma de saberlo es mirar los campos de usage de dos peticiones iguales. Lo que sigue se observó el 30 de octubre de 2026 a través de LaoZhang (POST https://api.laozhang.ai/v1/messages, cabeceras Authorization: Bearer $LAOZHANG_API_KEY y anthropic-version: 2023-06-01), con una sola cuenta, un prefijo de 7.882 tokens y en un solo día; describe esa pasarela, no el comportamiento de la API de Anthropic, que no se probó directamente.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
LaoZhang documenta caché de 5 minutos y de 1 hora para los modelos Claude, y sus precios de entrada, salida y lectura de caché para Opus 5.5, Sonnet 5.5, Haiku 5.5 y Fable 5.1 son los mismos de la tabla de Anthropic. Las 51 llamadas de la prueba costaron 0,471 $, frente a 0,469 $ al recalcular cada usage con los precios de lista, es decir, se cobraron las tarifas oficiales de escritura y lectura.
La diferencia más relevante: a través de esta pasarela, el system se cacheó aunque la petición no llevaba cache_control en ningún sitio (escritura de 7.882 y luego lectura de 7.882). Eso tiene precio. La primera petición se cobró 7.882 × 2,50 $/M + 11 × 2 $/M + 6 × 10 $/M ≈ 0,0198 $, a tarifa de escritura de 5 minutos, frente a los 0,0158 $ que habría costado sin caché, alrededor de un 25 % más; la repetición se cobró 0,00087 $. Del mismo modo, un punto de corte puesto en un bloque con marca de tiempo, que según Anthropic nunca lee, aquí siguió leyendo los 7.882 tokens del system. Todo apunta a que la pasarela marca el system por su cuenta; si haces muchas llamadas únicas con un system largo, tenlo en cuenta.
En el endpoint compatible con OpenAI (/v1/chat/completions), sin enviar ningún campo de caché, la primera llamada devolvió prompt_tokens_details.cached_creation_tokens: 7882 y la segunda prompt_tokens_details.cached_tokens: 7882, además de los campos de Anthropic cache_creation_input_tokens y cache_read_input_tokens. En este formato, prompt_tokens (7.893) ya incluye los tokens cacheados, así que no los sumes dos veces al calcular el coste.
Precalentar el caché de Claude: max_tokens 0 y la alternativa de 1 token
Precalentar sirve para que la primera petición real de un usuario ya encuentre el prefijo escrito. En la API de Claude se hace enviando el prefijo con max_tokens: 0: la API escribe el caché en el punto de corte y devuelve content vacío, stop_reason: "max_tokens" y cero tokens de salida cobrados. La marca debe ir en el bloque que compartirá con la petición siguiente, no en el mensaje de relleno, y con los mismos ajustes de thinking y effort. No se acepta con stream: true, thinking.type: "enabled", salidas estructuradas, tool_choice de tipo tool o any, ni dentro de Message Batches. Anthropic lo prefiere al viejo truco de max_tokens: 1.
A través de LaoZhang, el 30 de octubre de 2026, max_tokens: 0 no se comportó así: devolvió una respuesta normal (stop_reason: "end_turn", 46 tokens de salida) además de escribir los 7.882 tokens, como si el 0 se tratara como «sin límite». Con max_tokens: 1 el precalentamiento funcionó como se espera: 1 token de salida, escritura de 7.882 y lectura de 7.882 en la llamada siguiente. Si pasas por una pasarela, usa max_tokens: 1 hasta comprobar que respeta el 0.
Preguntas frecuentes sobre Claude prompt caching
¿Claude Code cachea automáticamente? ¿Con qué TTL?
Sí. Claude Code gestiona el caché solo. Según la documentación de Claude Code a 30 de octubre de 2026, con una suscripción de Claude y dentro del uso del plan la conversación principal usa 1 hora; con clave API, créditos de uso o un proveedor cloud, 5 minutos. Las causas de un turno caro y cómo cambiar el TTL están en Claude Code cache miss y coste de tokens.
¿Los aciertos de caché cuentan para los límites de velocidad?
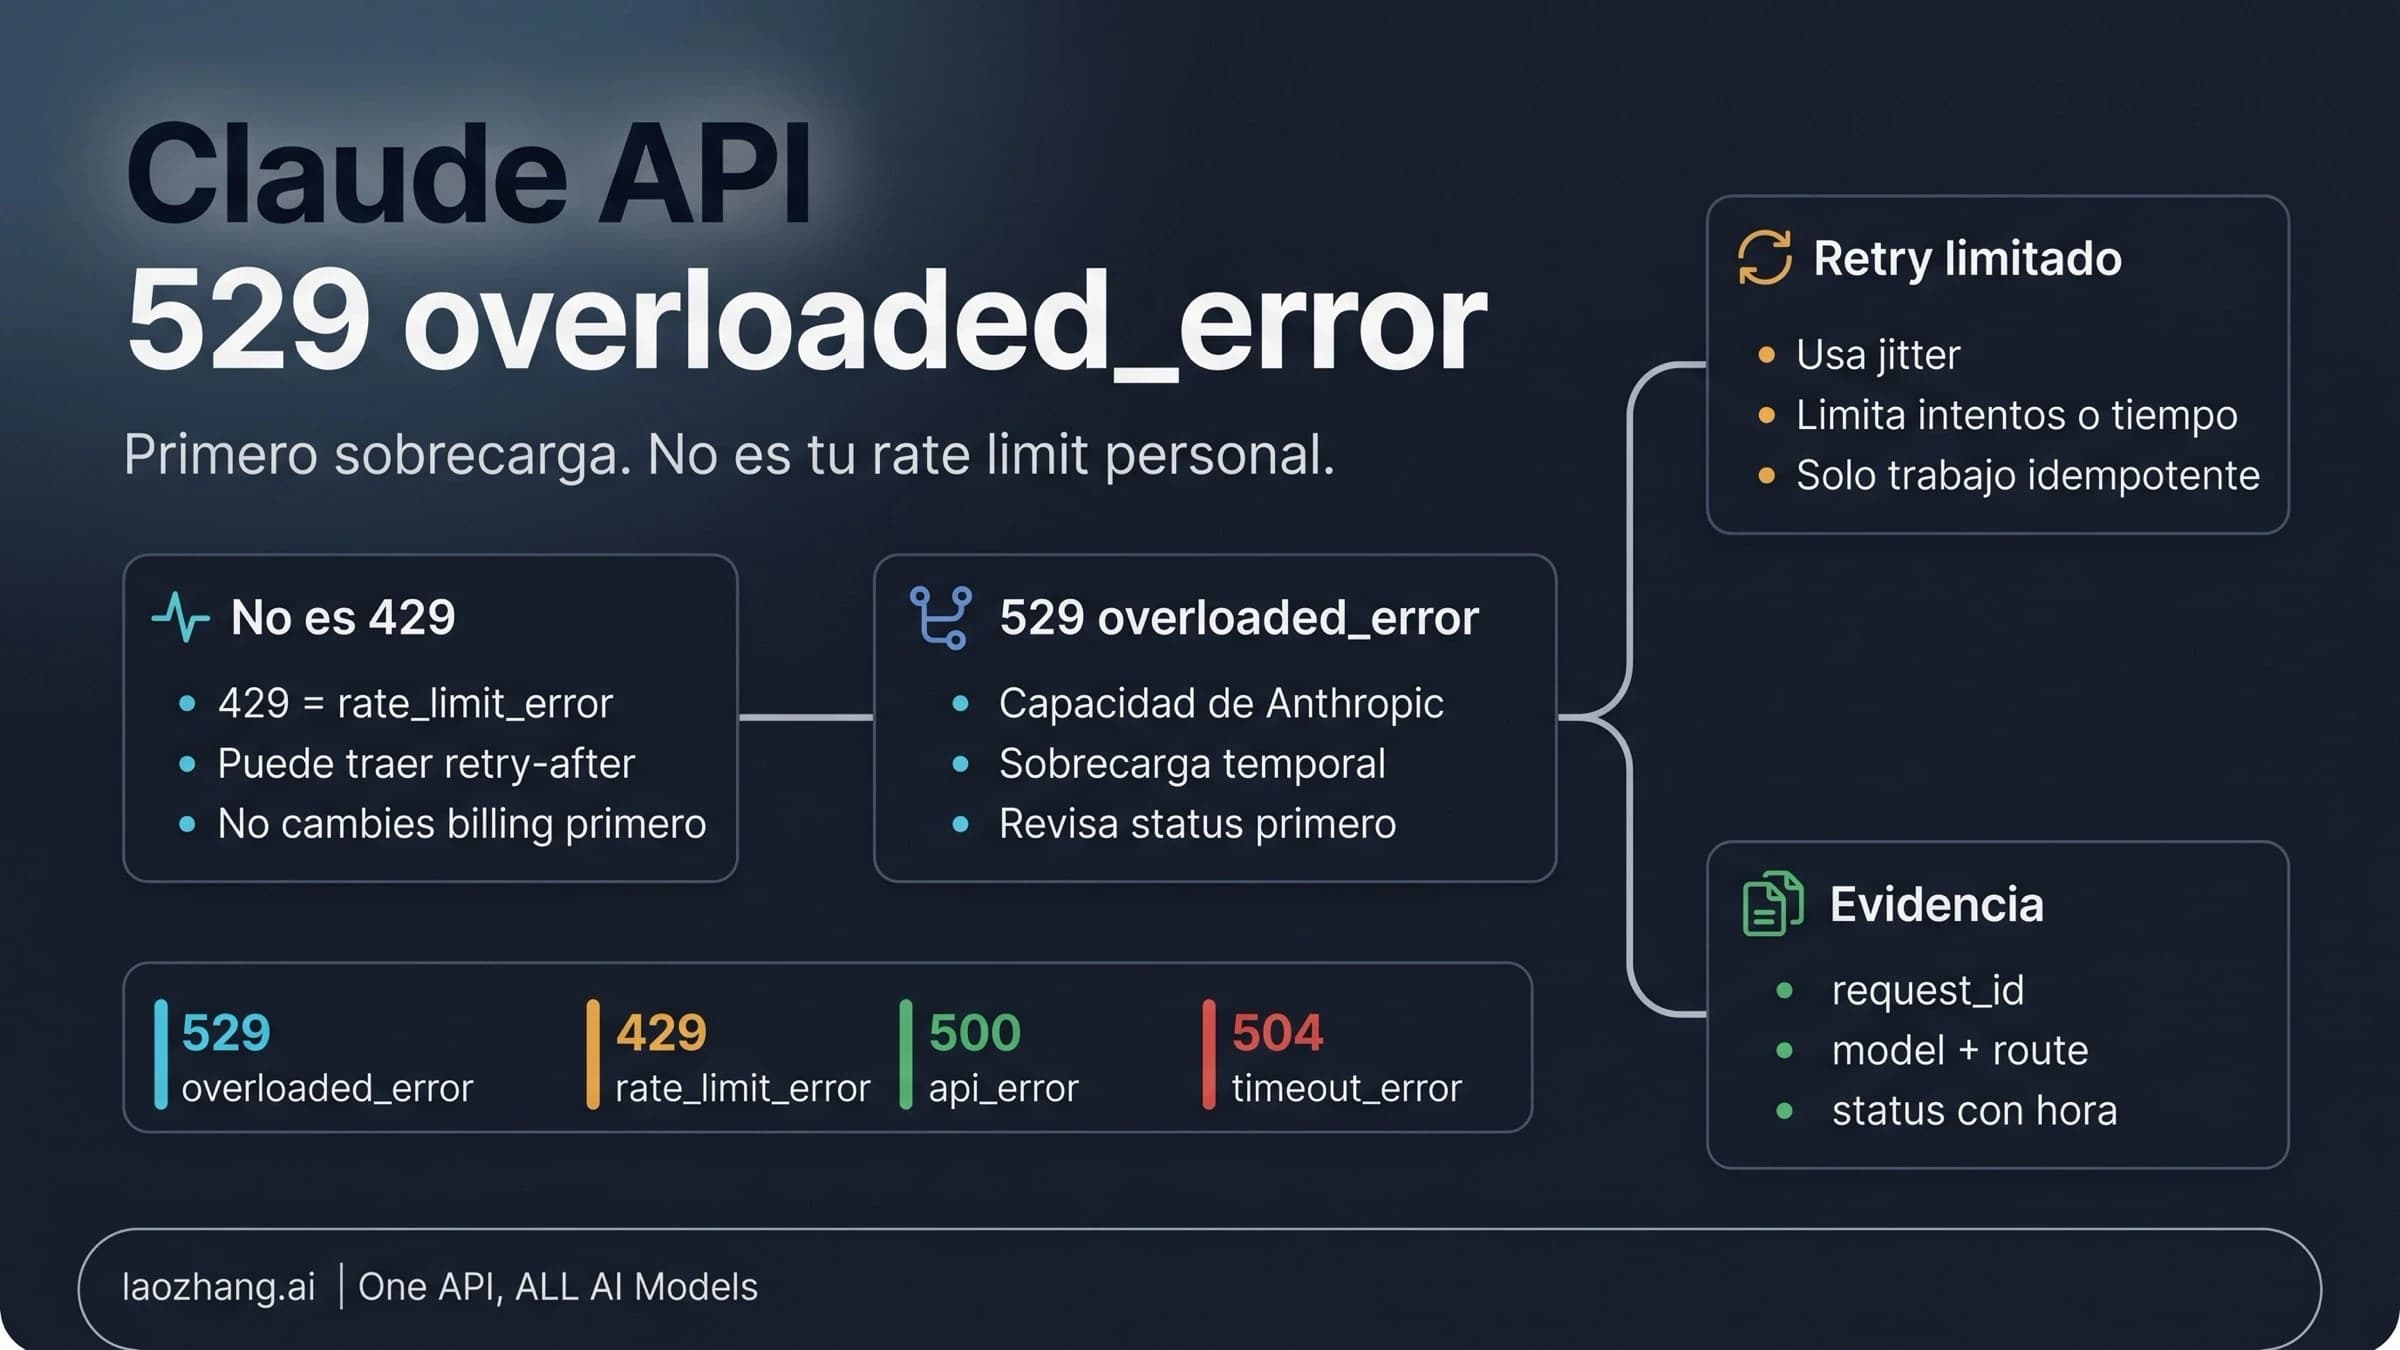
No. La documentación de prompt caching de Anthropic indica que los aciertos de caché no se descuentan de tu límite de velocidad, a 30 de octubre de 2026. Si recibes un 429, revisa a qué límite pertenece en Claude API Rate Limit Reached: encuentra el límite correcto antes de reintentar.
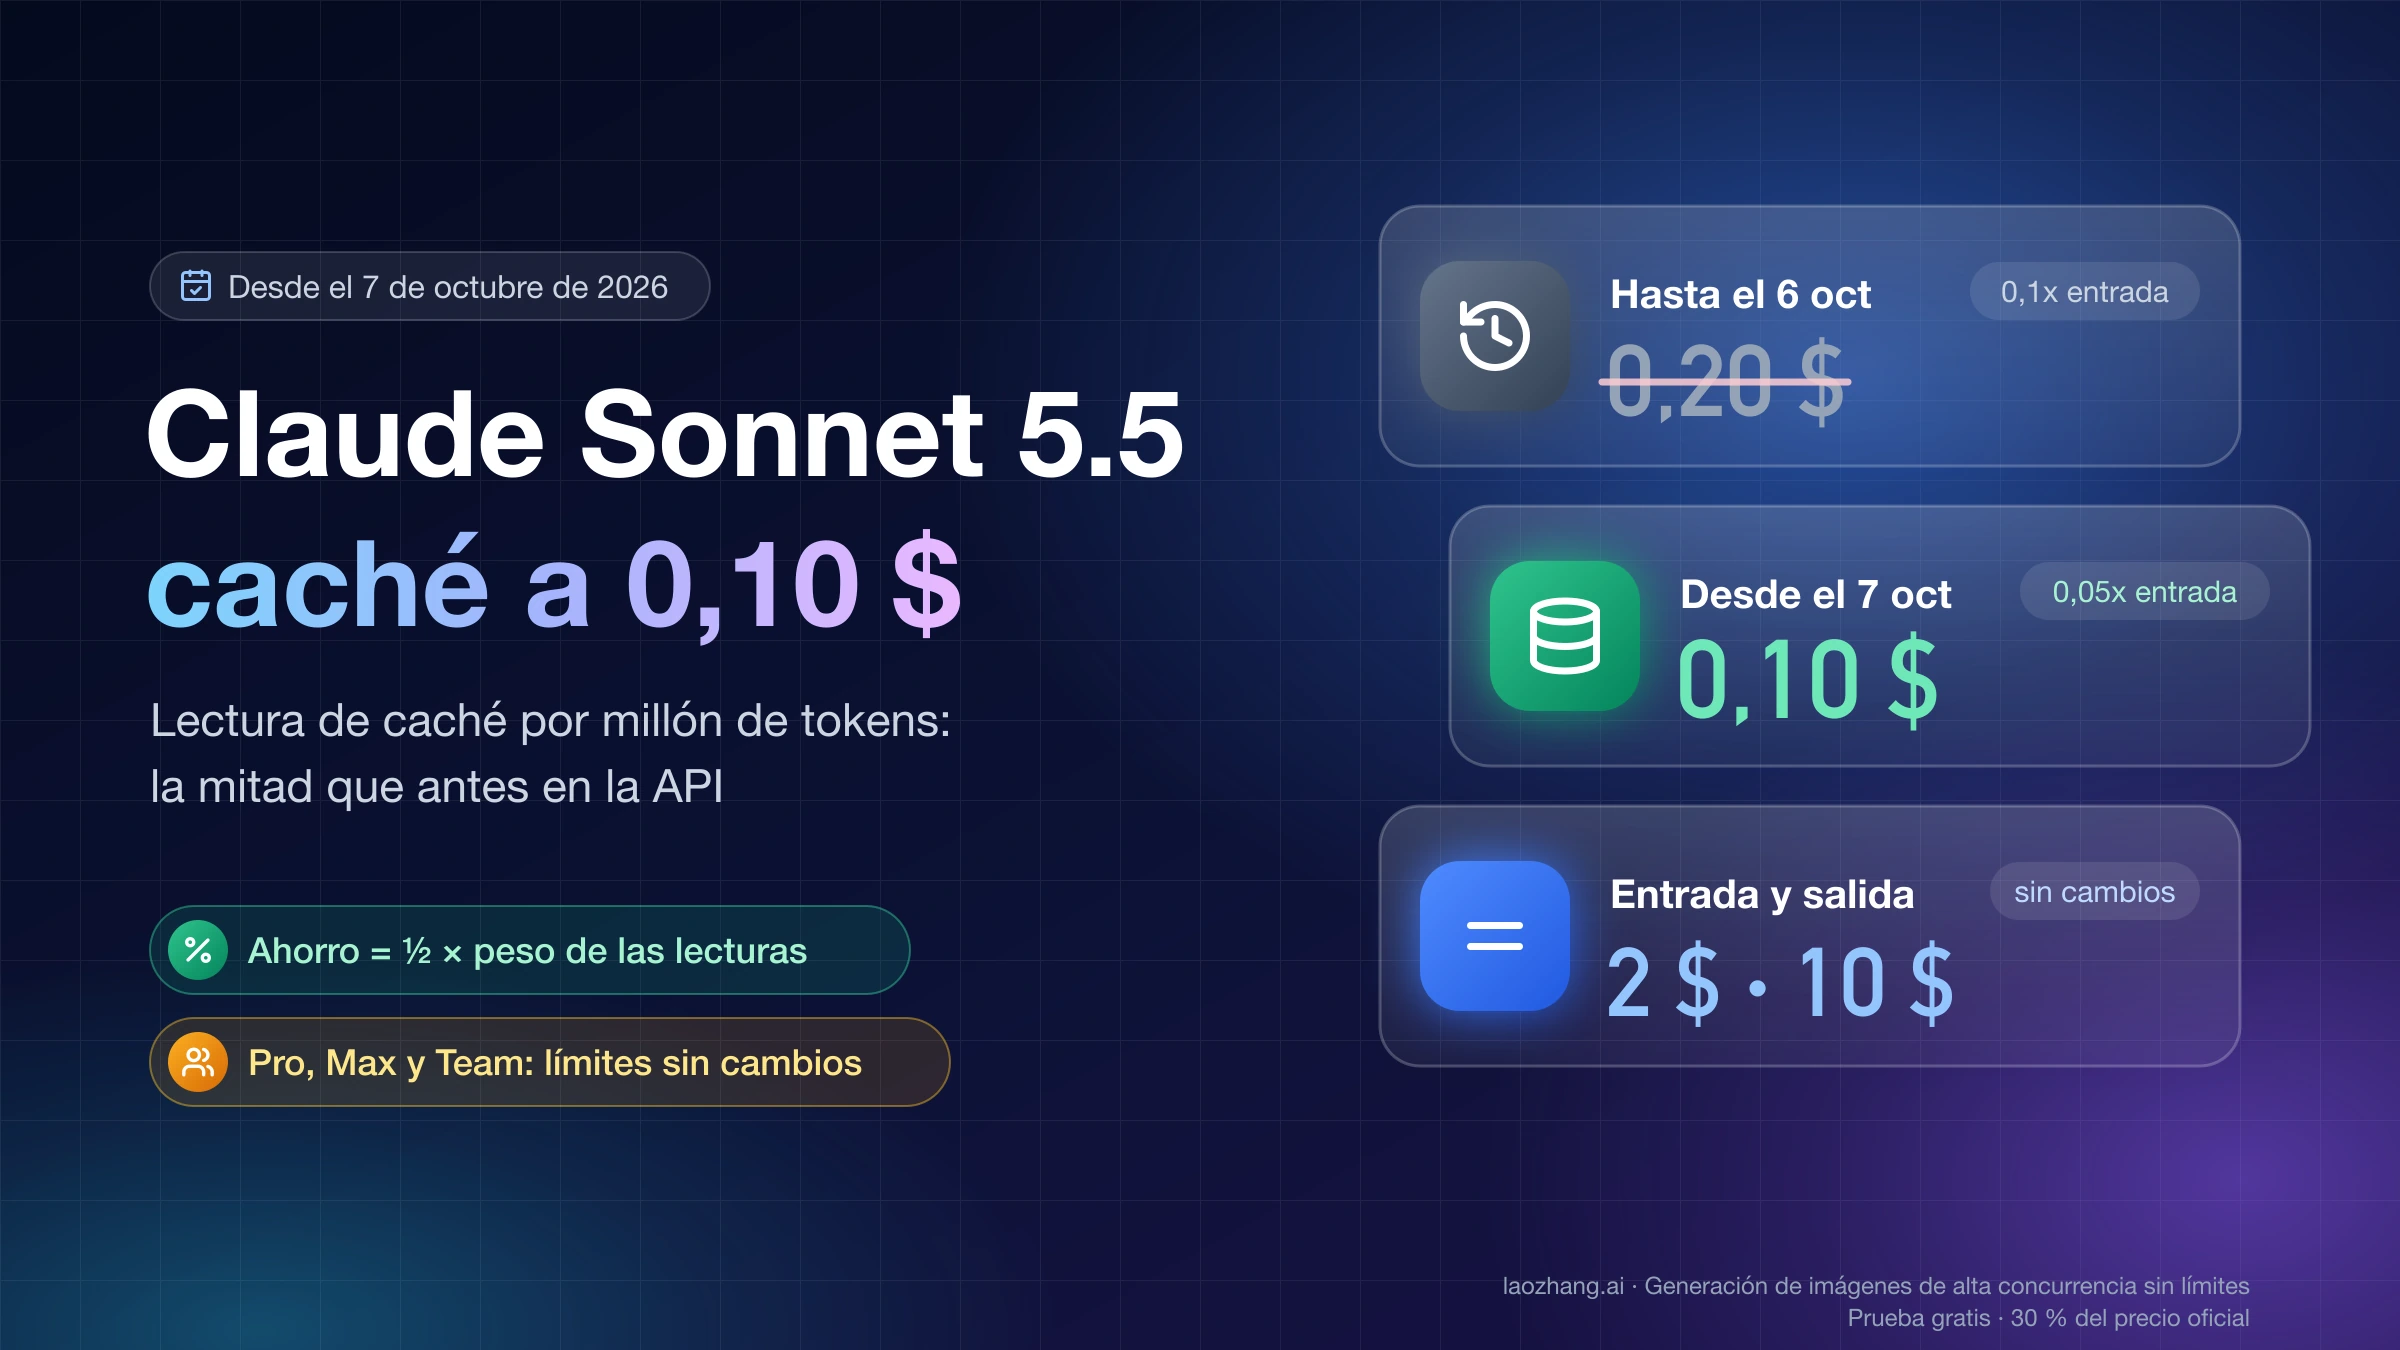
¿Cuánto ahorro con la bajada de la lectura de caché de Sonnet 5.5?
La lectura de Sonnet 5.5 pasó de 0,20 $ a 0,10 $ por millón de tokens el 7 de octubre de 2026, así que ahorras la mitad de lo que antes pagabas en lecturas. El cálculo sobre una factura real está en Claude Sonnet 5.5: precio de caché a 0,10 $ y cuánto ahorras.
Fuentes2
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 30 oct 2026.
Fuentes2
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 30 oct 2026.