Gemini 4 Argon API: acceso, finish_reason y respuestas cortadas
Argon exige el nivel de pago. Con CONTINUATION reenvía la misma petición con el token; con MAX_TOKENS sube max_output_tokens; sin token no hay continuación.
En esta página
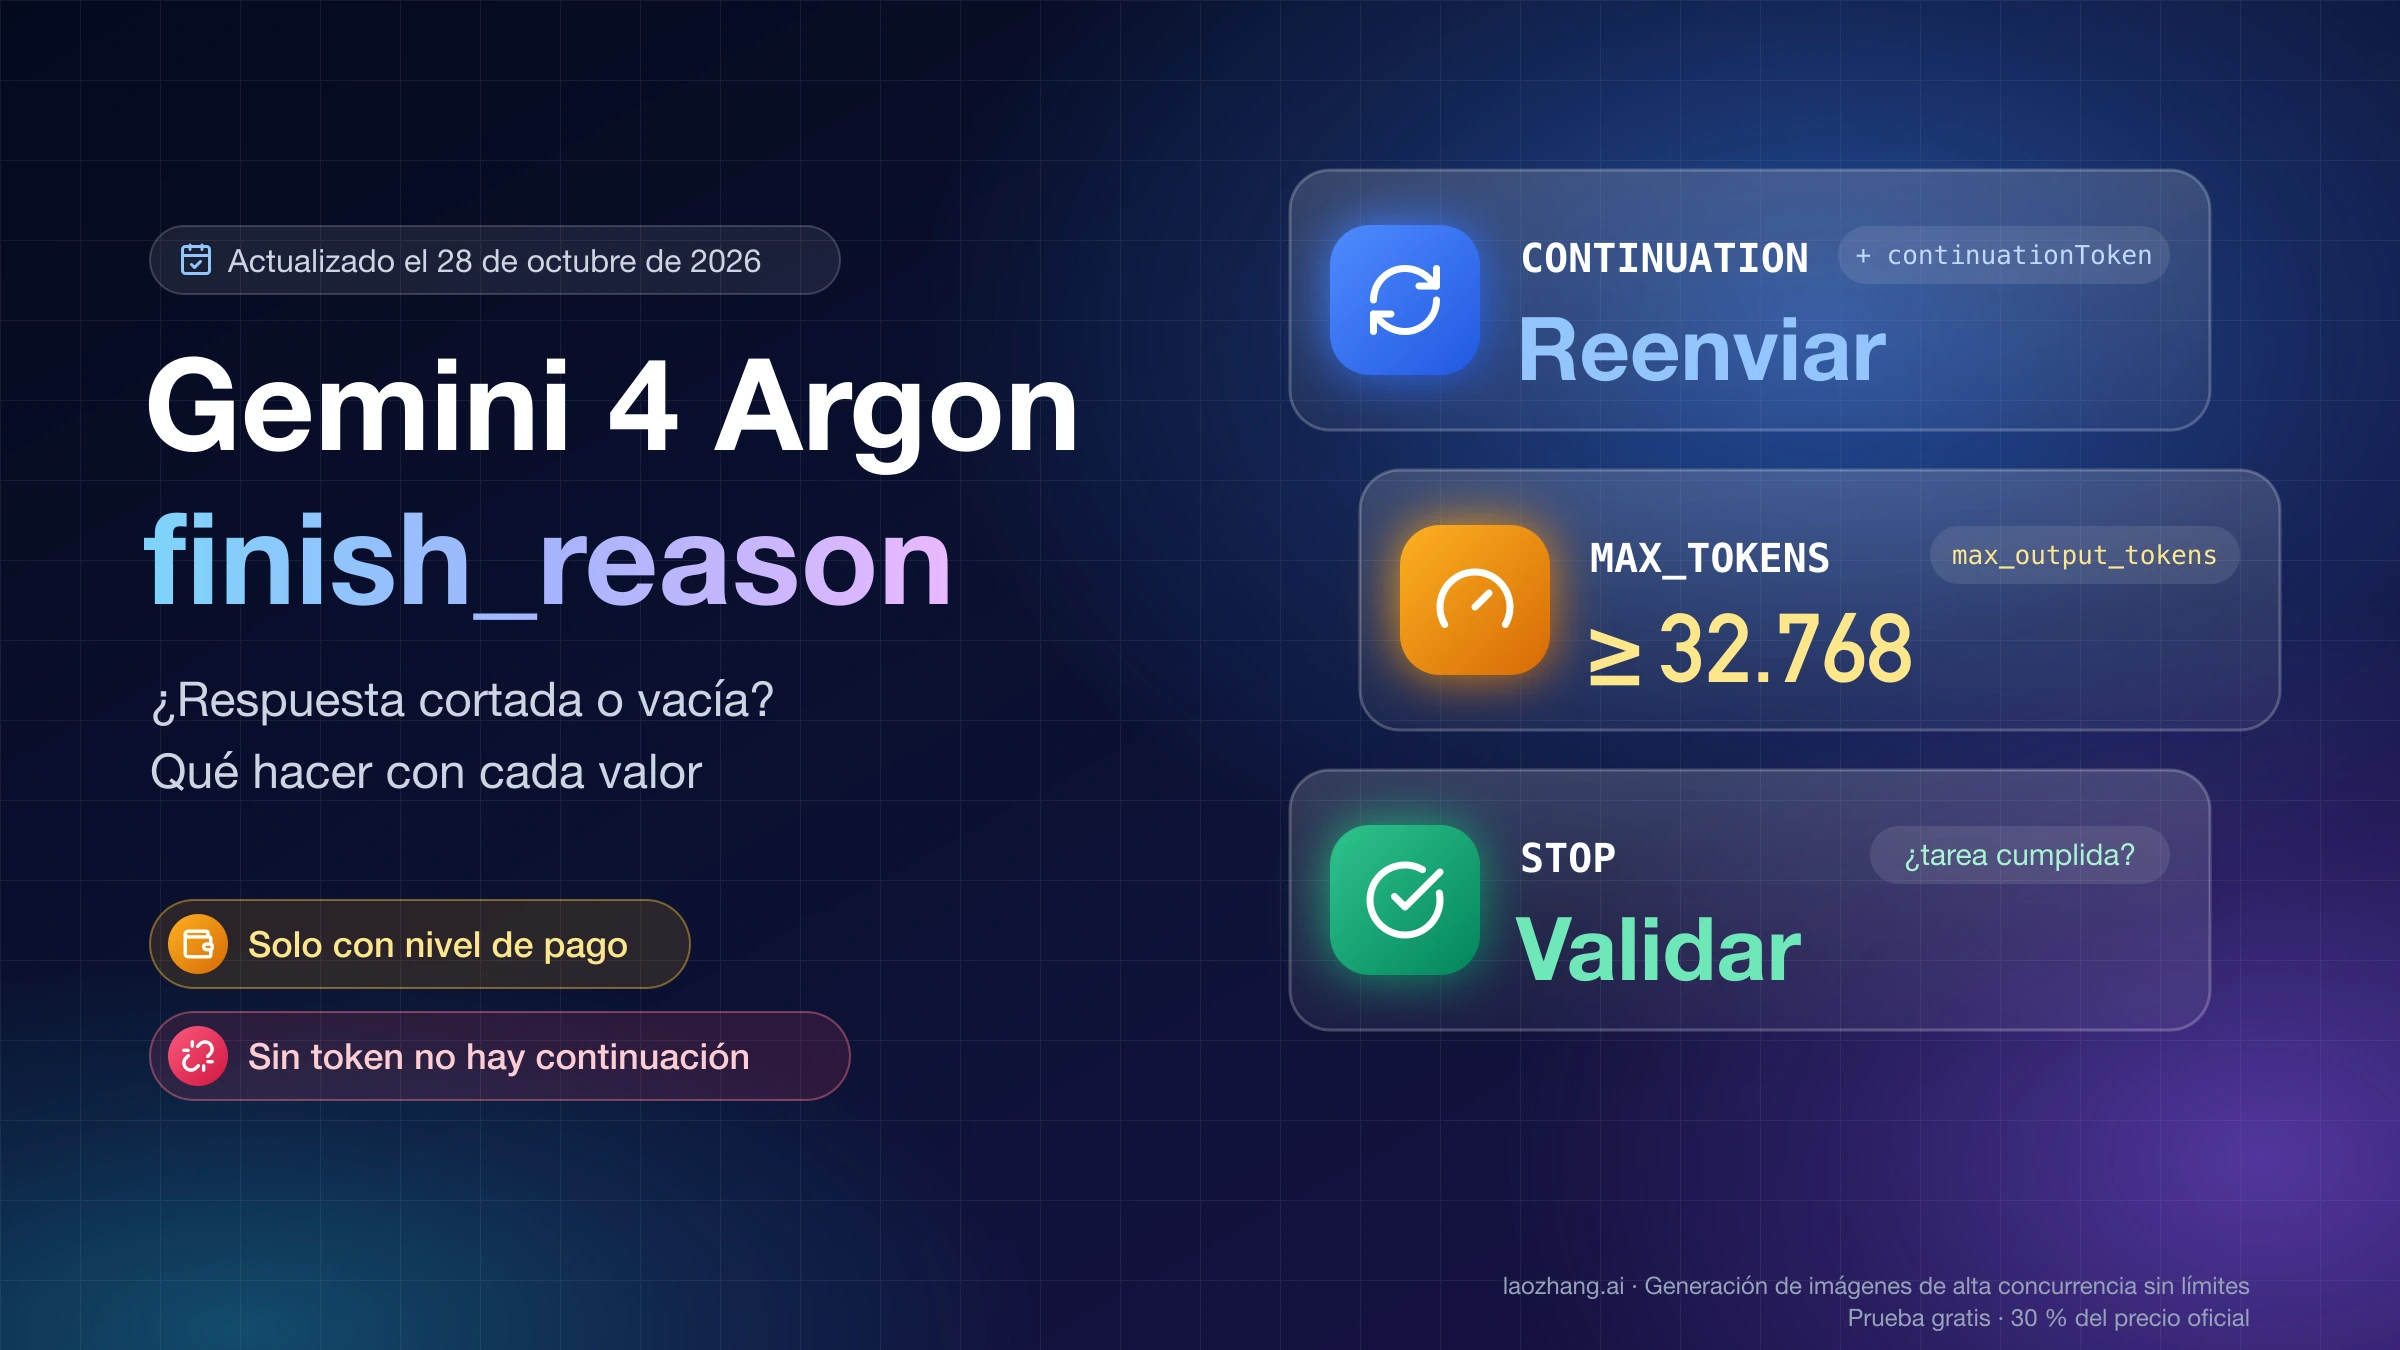
Si una respuesta de gemini-4-argon llega cortada o vacía, el finish_reason te dice qué hacer a continuación. CONTINUATION significa que el modelo llegó al tope de una sola petición (64K tokens en streaming, 32K en REST sin streaming) y todavía le queda presupuesto: reenvía exactamente la misma petición con el continuationToken que acaba de devolver, o actualiza google-genai a la 2.30.1 o posterior (@google/genai 2.29.1 en JavaScript), que lo hace por ti. MAX_TOKENS significa que se agotó tu max_output_tokens, en el que también cuenta el razonamiento: súbelo a 32.768 como mínimo, y por encima de 65.536 si esperas respuestas largas.
La excepción que no se arregla reintentando es la ruta. El endpoint de Gemini compatible con OpenAI no puede continuar, y si CONTINUATION te llega sin token o el stream termina sin ningún finish_reason, algo entre tu código y Google ha perdido la información necesaria. En esos casos cambia a generateContent nativo llamando a la API de Gemini directamente, o a la API Interactions en segundo plano. Todo esto exige además una clave de un proyecto de pago: Argon no está disponible en el nivel gratuito.
Lo que se ejecutó el 28 de octubre de 2026 fue una serie de peticiones de pago a través de una pasarela de API de terceros, por su ruta nativa de Gemini y por su ruta compatible con OpenAI, y una prueba del SDK de Python (versiones 2.33.0 y 2.29.0) contra un servidor simulado local. No se usó una clave directa de Google, en la ruta probada no apareció un CONTINUATION real y no se completó ninguna generación larga (long decode): lo que se dice aquí de la API directa de Google sale de su documentación oficial.
Cómo acceder a la API de Gemini 4 Argon: nivel de pago, ID y versión del SDK
Para llamar a Argon necesitas un proyecto con facturación activa, el ID gemini-4-argon y, si quieres respuestas largas, un SDK que sepa continuar. El modelo es estable y está disponible de forma general desde el 13 de octubre de 2026, según el registro de cambios de la API de Gemini. La puesta en marcha tiene este orden:
- Activa la facturación en el proyecto de Google AI Studio. Una clave del nivel gratuito no puede llamar a Argon; el nivel 1 se consigue vinculando una cuenta de facturación con un prepago de al menos 5 $, y si el saldo prepagado llega a 0 las claves dejan de funcionar con un HTTP 402 (facturación de la API de Gemini).
- Crea la clave de API en ese proyecto y guárdala como
GEMINI_API_KEY, que es la variable que leen los SDK. - Usa el ID de modelo
gemini-4-argontal cual, tanto en la URL de REST como en el SDK. - Instala un SDK que continúe solo: Python
google-genai2.30.1 o superior (la última en PyPI el 28 de octubre era la 2.33.0), JavaScript@google/genai2.29.1, Go 1.74.0, Java 1.77.0, .NET 1.26.0 o Kotlin 1.6.0. - Ajusta la configuración: un
max_output_tokensacorde a la tarea,thinking_levelenlow,medium(el valor por defecto) ohigh, sintemperature,top_pnitop_k, y un tiempo de espera del cliente de 20 minutos.
El quinto paso es el que más respuestas cortadas evita. En Argon, max_output_tokens es un límite duro para el razonamiento y la respuesta juntos, y este modelo gasta en pensar más que los Gemini 3.x, por eso la guía de novedades de Gemini 4 Argon pide subirlo a 32.768 como mínimo. Para tareas largas de código o de agentes, la documentación de long decode recomienda empezar en 65.536, y para matemáticas o demostraciones difíciles, probar desde 262.144. Bajarlo no hace que el modelo piense de forma más concisa: solo corta antes la respuesta. Si quieres gastar menos, baja thinking_level. El valor minimal no existe en Argon y devuelve un error, igual que enviar a la vez thinking_level y thinking_budget.
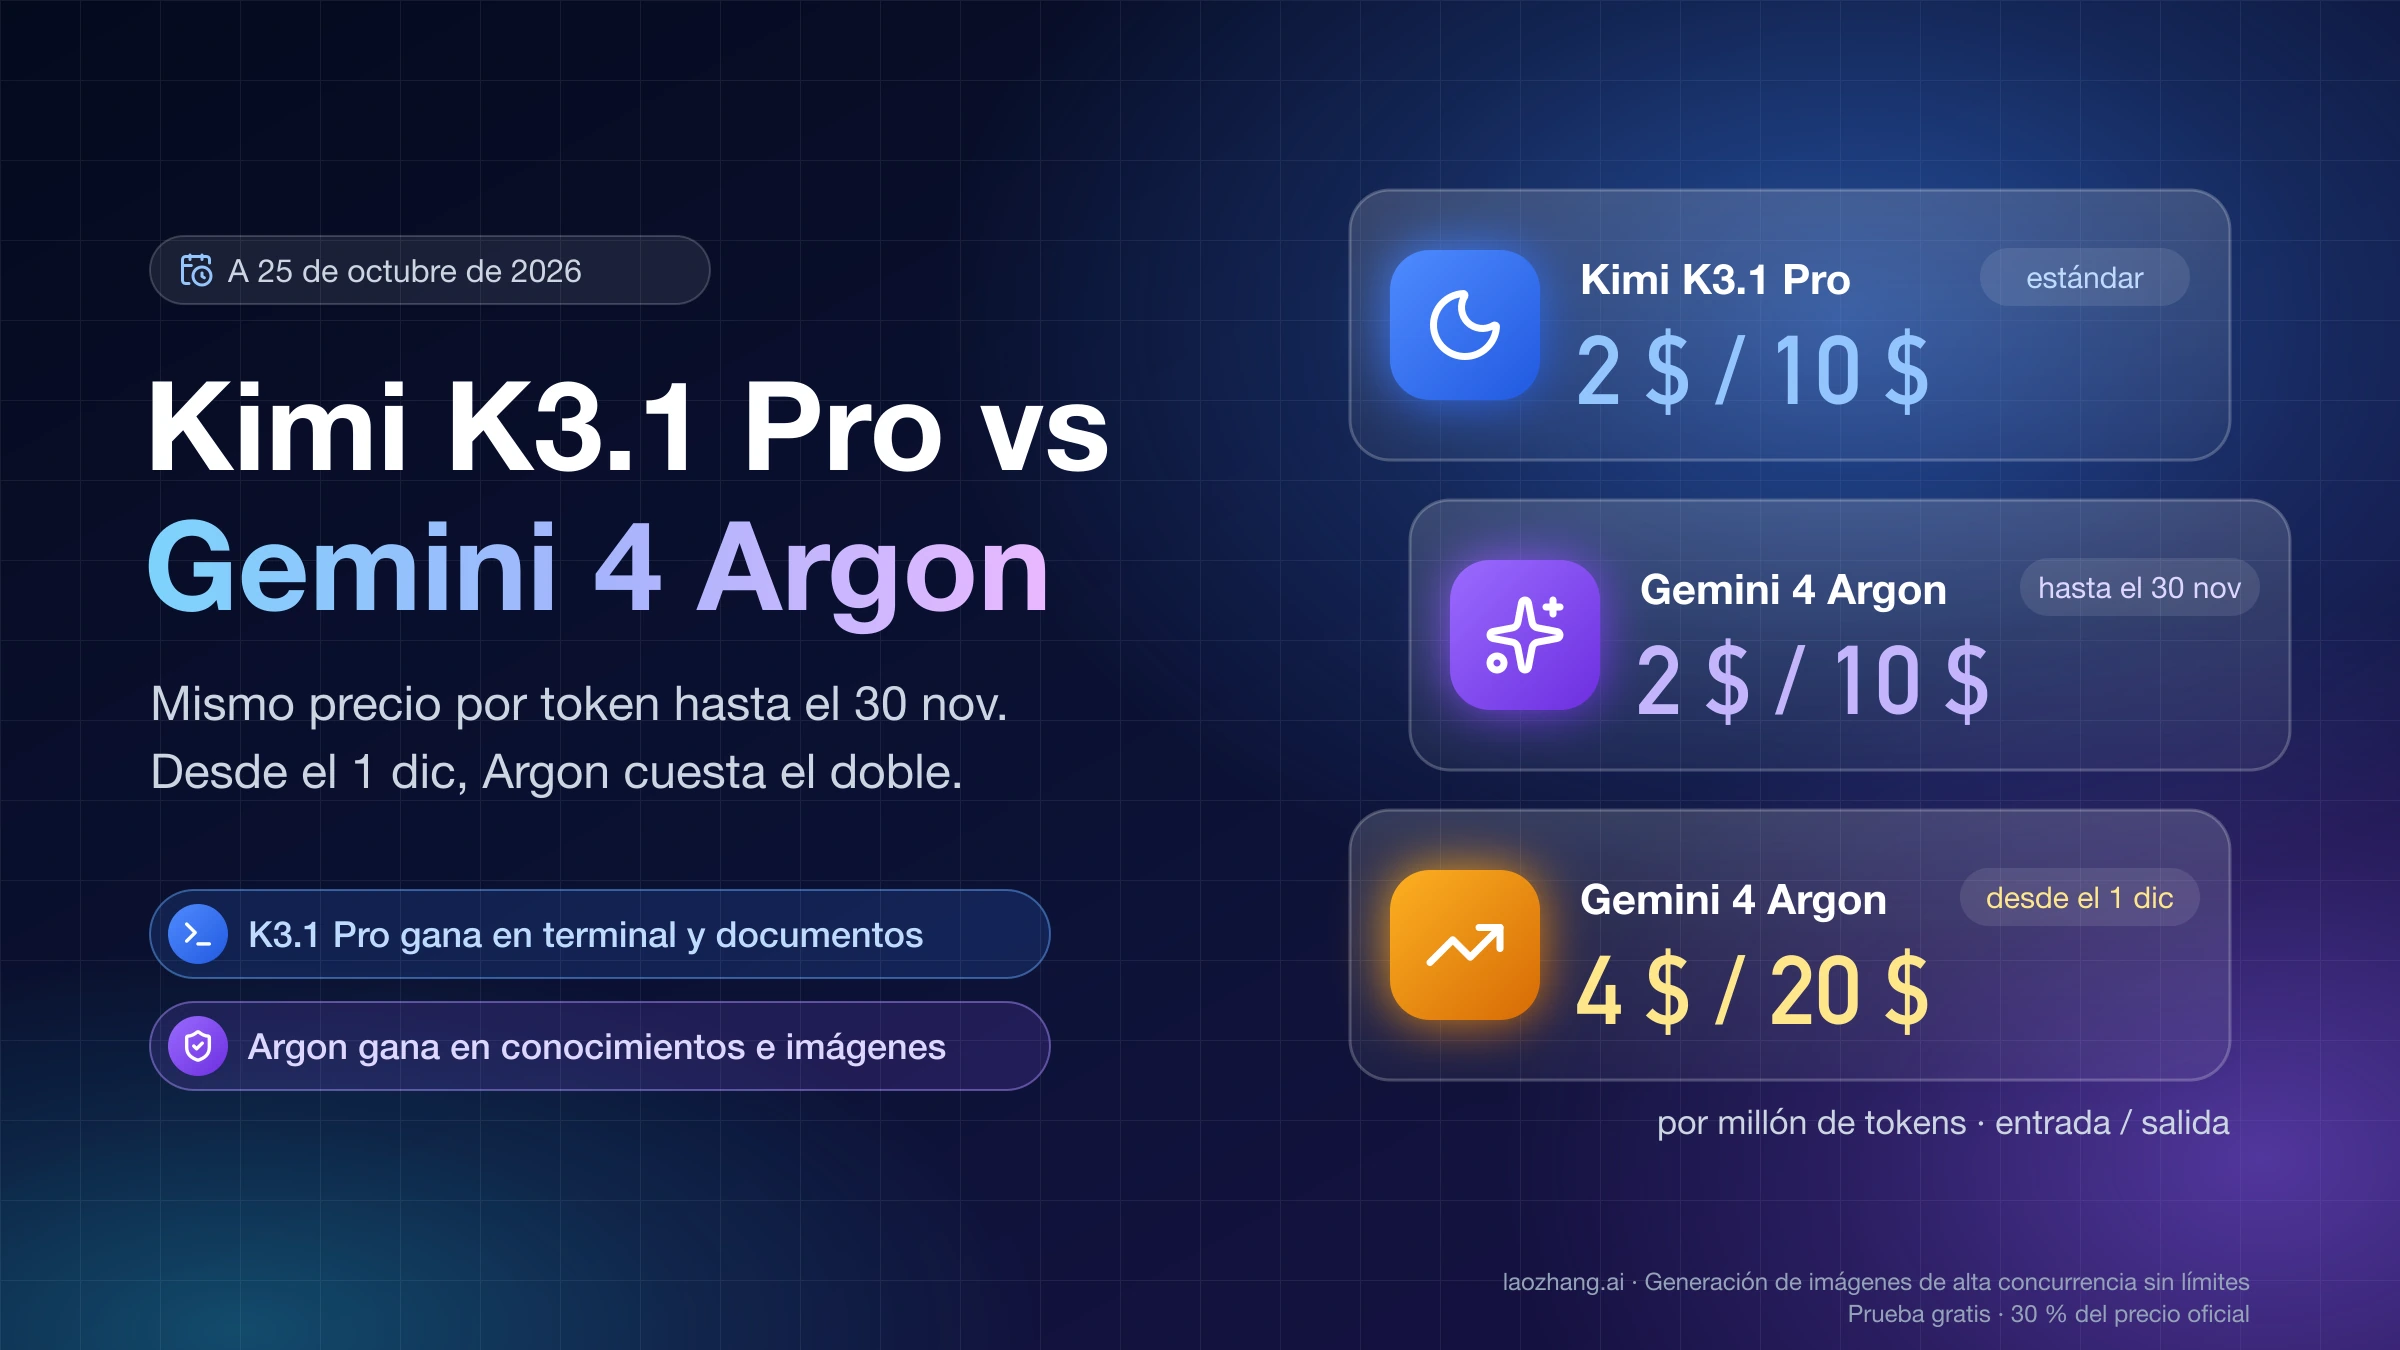
En cuanto al precio, según la página de precios de la API de Gemini, hasta el 30 de noviembre de 2026 Argon cuesta 2 $ por millón de tokens de entrada y 10 $ por millón de salida, razonamiento incluido, y a partir del 1 de diciembre de 2026 pasa a 4 $ y 20 $. Una suscripción Google AI Pro o Ultra te da Argon en la app de Gemini, pero no habilita por sí sola las llamadas a la API de un proyecto: son cuentas separadas. España figura en la lista de regiones disponibles de la API. Los topes por minuto y el error 429 dependen de tu nivel y se explican en Límites de la API de Gemini: niveles, topes de gasto y error 429.
Qué significa cada finish_reason de Argon y qué debe hacer tu código
STOP es el único valor que permite dar la respuesta por terminada; CONTINUATION pide otra petición, MAX_TOKENS pide más presupuesto y el resto apunta a contenido, herramientas o cuenta, casos en los que repetir la misma petición no sirve. La lista sale de la referencia de generateContent, sin los motivos exclusivos de imagen, que no aplican porque Argon solo genera texto. En REST el campo se llama finishReason y en el SDK de Python finish_reason.
| finish_reason | Qué ha pasado | Qué hace tu código |
|---|---|---|
STOP | El modelo terminó por sí mismo o encontró una secuencia de parada | Dar la respuesta por terminada y validar el contenido |
CONTINUATION con continuationToken | Llegó al tope de una petición (64K o 32K) y aún le queda presupuesto | Reenviar la petición idéntica con el token; el texto vacío en este salto es normal |
CONTINUATION sin token | Algo intermedio eliminó el campo del token | No reintentar igual: llamar directamente a la API de Gemini o usar Interactions en segundo plano |
MAX_TOKENS | Se gastó todo max_output_tokens, razonamiento incluido | Subir max_output_tokens; si vino token, reenviarlo con un valor mayor que lo ya usado |
MAX_TOKENS con texto vacío | Todo el presupuesto se fue en razonamiento | Subir max_output_tokens o bajar thinking_level |
SAFETY, PROHIBITED_CONTENT, BLOCKLIST, SPII, RECITATION, LANGUAGE | La entrada o la salida activó un filtro de contenido | Cambiar el prompt o los datos de entrada |
MALFORMED_FUNCTION_CALL, UNEXPECTED_TOOL_CALL, TOO_MANY_TOOL_CALLS | Fallo en las llamadas a herramientas; UNEXPECTED_TOOL_CALL es una llamada sin herramientas habilitadas | Revisar las declaraciones de herramientas y reintentar |
MISSING_THOUGHT_SIGNATURE | Falta al menos una firma de razonamiento (thought signature) en el historial | Devolver las firmas del turno anterior sin tocarlas |
ESCALATION, PUP_LIMITED_DISABLED | Filtrado por una regla de escalado, o cuenta limitada o desactivada por infringir la política de uso prohibido | No es un fallo del código; reintentar no lo resuelve |
MALFORMED_RESPONSE, OTHER | Respuesta mal formada u otro motivo sin categoría concreta | Registrar finishMessage y reintentar una vez |
| Ninguno al acabar el stream | La conexión se cortó antes del último fragmento | Tratar la respuesta como incompleta |
MAX_TOKENS tiene un matiz. Según Google, en Argon ese motivo sigue trayendo un continuationToken, así que puedes continuar enviando la misma petición con el token y un max_output_tokens mayor que los tokens ya consumidos; si no es mayor, la API responde con un 400 «Continuation token has already used output tokens…». La alternativa es empezar de cero sin token, pagando las dos ejecuciones. Y si el token no viene, como ocurrió en la pasarela probada, solo queda empezar de cero.
STOP tampoco garantiza que la tarea esté hecha. En la prueba del 28 de octubre se pidió a Argon que imprimiera todos los enteros del 1 al 7.000 con un presupuesto de 33.000 tokens, y el modelo contestó en 142 tokens que eso superaba su límite de salida, sugirió usar seq 1 7000 y terminó con STOP. Ese valor solo dice que el modelo dejó de escribir por decisión propia, así que si la respuesta tiene que cumplir algo concreto (un número de filas, un JSON completo), compruébalo aparte.
Por qué no ves CONTINUATION: el SDK continúa solo desde la 2.30.1
Con google-genai 2.30.1 o posterior, el SDK recibe el CONTINUATION, hace él mismo la siguiente petición y a tu código solo le llega el resultado final, normalmente con STOP. Por eso puedes leer sobre ese valor en la documentación y no verlo nunca en tus registros. Con una versión anterior pasa lo contrario: el SDK te entrega el CONTINUATION con el texto que haya, que puede estar vacío, sin lanzar ninguna excepción. La continuación automática está activada por defecto con y sin streaming, y se desactiva con automatic_continuation=False en Python o automaticContinuation: false en JavaScript.
El 28 de octubre de 2026 se comprobó con un servidor local que imita :generateContent de Google, cuyas respuestas se escribieron a mano siguiendo la forma documentada. El primer salto (hop, como llama Google a cada petición de la cadena) devolvía CONTINUATION con token, sin texto y con 32.768 tokens de razonamiento; el segundo, STOP. El servidor real puede diferir en detalles, pero el comportamiento del SDK queda claro:
| Escenario simulado | google-genai 2.33.0 | google-genai 2.29.0 |
|---|---|---|
Salto 1 con CONTINUATION y token, salto 2 con STOP | 2 peticiones; la segunda lleva el token, el mismo maxOutputTokens (262.144) y el mismo contenido; tu código ve STOP y el texto final | 1 petición; tu código ve CONTINUATION con texto vacío y el token, sin error |
Lo mismo con automatic_continuation=False | 1 petición; ves CONTINUATION y el token | El parámetro no existe |
CONTINUATION sin token, como si algo intermedio lo hubiera quitado | 1 petición; texto vacío y CONTINUATION, sin excepción | Igual |
MAX_TOKENS con token | 1 petición; el SDK no continúa y te devuelve el texto parcial y el token | Igual |
El tercer escenario es el más traicionero. Si una pasarela o un proxy propio descarta el campo continuationToken, incluso el SDK más reciente te devuelve una respuesta vacía con aspecto de normal, así que tu código debe comprobar el finish_reason aunque uses continuación automática. El cuarto confirma que el SDK solo continúa con CONTINUATION: un MAX_TOKENS siempre vuelve a tus manos.
El código fuente de la 2.33.0 (google/genai/_extra_utils.py) añade dos detalles. En streaming, el SDK borra el CONTINUATION intermedio de los fragmentos que te entrega cuando va a seguir, y abandona tras 3 reconexiones seguidas sin recibir un punto de control nuevo. Además, los tiempos de espera y reintentos que configures se aplican a cada salto, no a la ejecución entera.
Escribir tu propio bucle de continuación sin SDK automático
Si llamas a REST directamente o desactivas la continuación automática, el bucle consiste en reenviar la misma petición con el último continuationToken mientras el finish_reason sea CONTINUATION. Este es el ejemplo en Python de la documentación de long decode de Google, abreviado:
from google import genai
from google.genai import types

client = genai.Client(http_options=types.HttpOptions(timeout=1_200_000))  # 20 min
PROMPT = "Write a complete, rigorous proof of the prime number theorem."

parts, token = [], None
while True:
    response = client.models.generate_content(
        model="gemini-4-argon",
        contents=PROMPT,                      # el contenido original en cada salto
        config=types.GenerateContentConfig(
            max_output_tokens=262_144,        # el mismo total en cada salto
            thinking_config=types.ThinkingConfig(thinking_level="high"),
            automatic_continuation=False,     # el bucle lo llevas tú
            continuation_token=token,
        ),
    )
    candidate = response.candidates[0]
    if candidate.content and candidate.content.parts:
        parts.extend(candidate.content.parts)
    token = candidate.continuation_token
    if candidate.finish_reason != types.FinishReason.CONTINUATION or not token:
        break

print("".join(p.text for p in parts if p.text and not p.thought))
print("Finish reason:", candidate.finish_reason)
Las reglas que hacen que funcione son pocas. En cada salto envía el mismo contents, system_instruction, tools y generation_config, con el mismo max_output_tokens, porque ese valor es el total de todos los saltos y no el de cada uno. No añadas el texto parcial a contents: el token ya lleva el estado del modelo, incluido su razonamiento, y por la misma razón solo hace falta enviar el último. Cuando termines, une las partes de todos los saltos en un único turno del modelo para el historial. En REST el campo va en la raíz del cuerpo como "continuationToken".
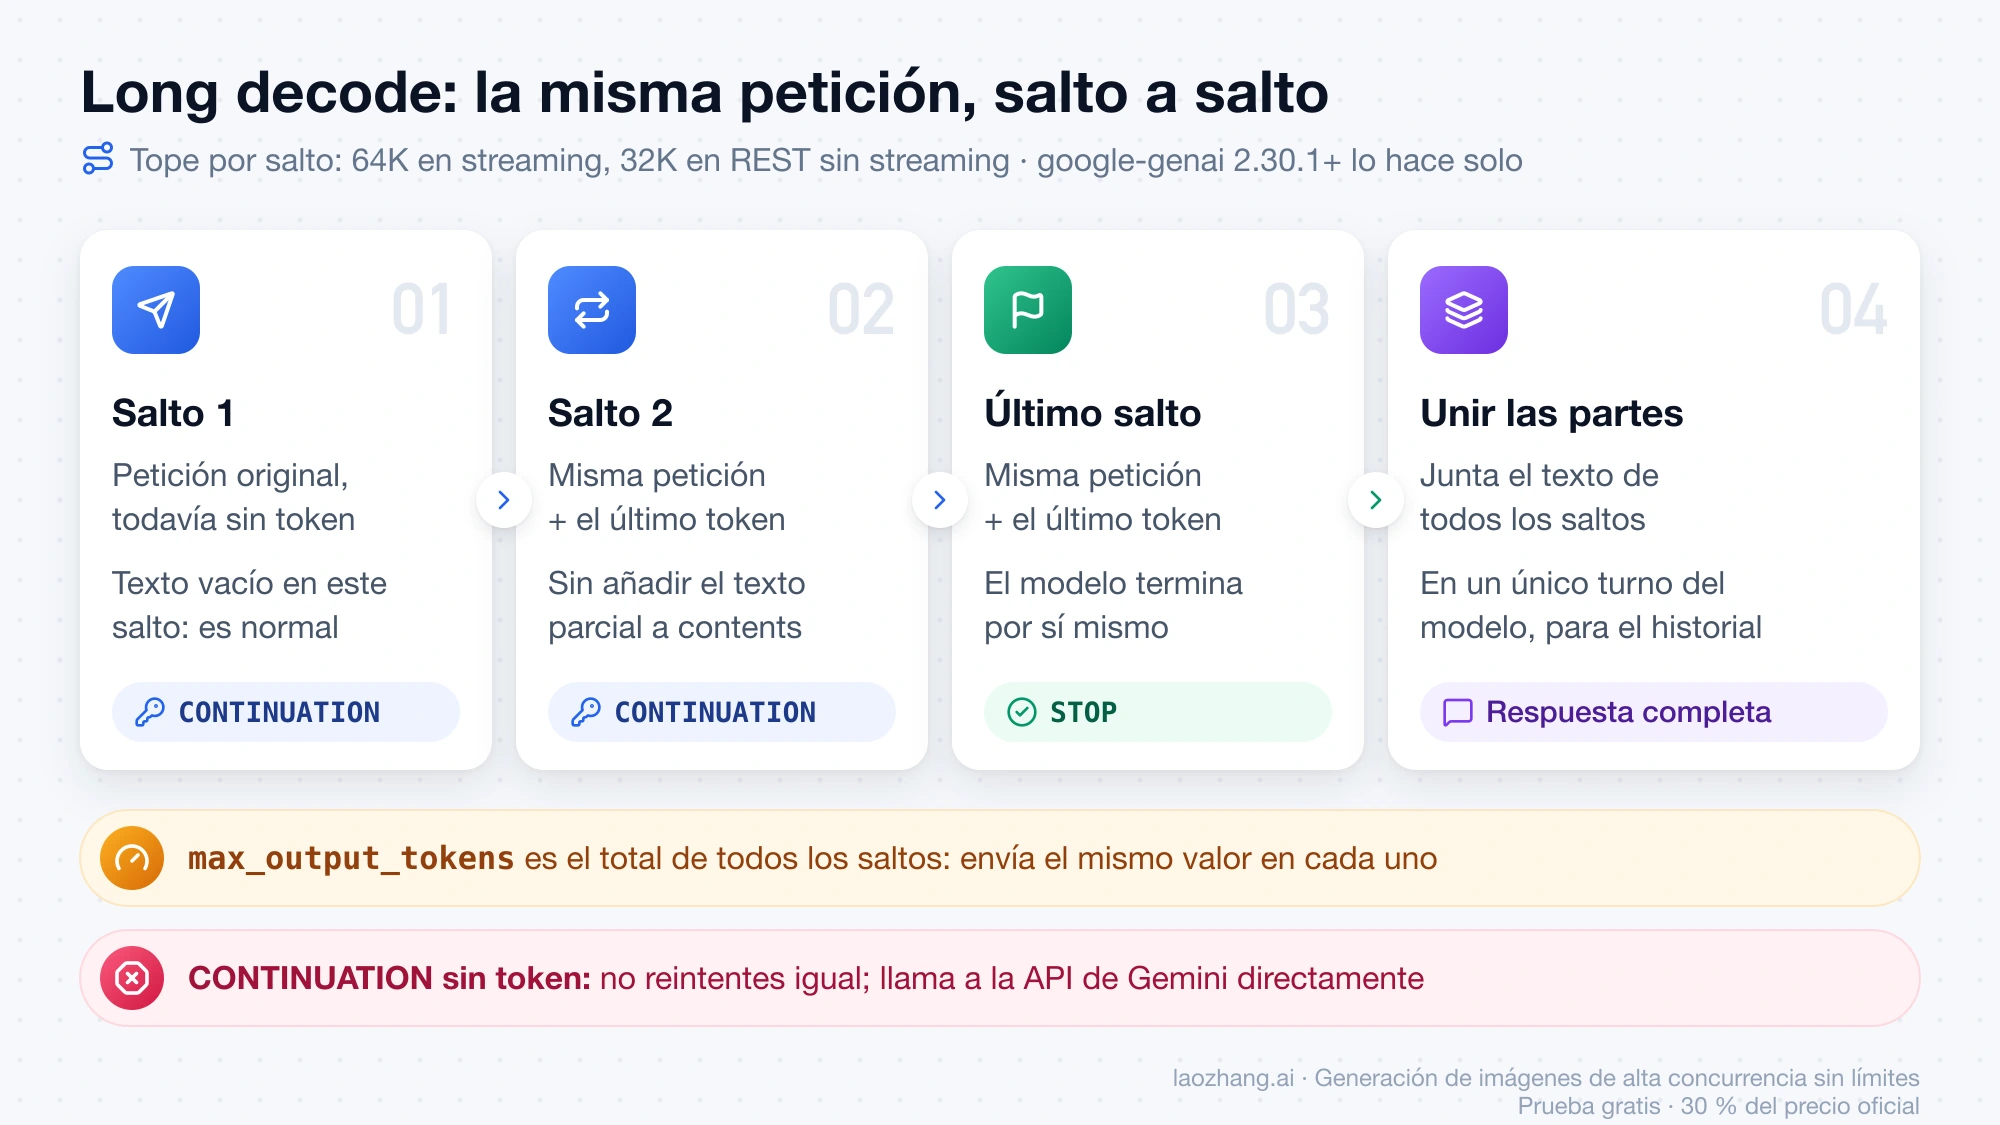
En un bucle con streaming hay una regla más. Pasados los primeros 32.768 tokens, el stream envía un token de punto de control cada 5.000 tokens; guarda los fragmentos nuevos como pendientes y solo dalos por buenos cuando llegue uno con token. Si la conexión se cae, descarta los pendientes y reanuda desde el último token, y si se cae antes del primer punto de control, reenvía la petición original.
Para decidir qué hacer con cada respuesta sirve un clasificador sin dependencias. El 28 de octubre de 2026 se ejecutó sobre siete respuestas guardadas de la pasarela y cuatro casos simulados, y las once quedaron clasificadas como se esperaba, tanto en la versión original como en esta, abreviada y con los mensajes en español:
def next_action(resp: dict) -> str:
    cands = resp.get("candidates") or []
    if not cands:
        return "sin candidato: guardar el cuerpo y reintentar una vez"
    c = cands[0]
    reason = c.get("finishReason") or None    # "" cuenta como ausente
    token = c.get("continuationToken")
    text = "".join(p.get("text", "") for p in (c.get("content") or {}).get("parts") or []
                   if not p.get("thought"))
    if reason is None:
        return "corte de transporte: incompleta; reanudar desde el último punto de control o reenviar"
    if reason == "STOP":
        return "terminada (validar el contenido)"
    if reason == "CONTINUATION":
        return "continuar con el token" if token else "token perdido: llamar a Google directamente"
    if reason == "MAX_TOKENS":
        vacio = " (texto vacío: todo fue razonamiento)" if not text else ""
        return "subir maxOutputTokens" + vacio + (" y reenviar con el token" if token else "; sin token se empieza de cero")
    if reason in ("SAFETY", "PROHIBITED_CONTENT", "BLOCKLIST", "SPII", "RECITATION", "LANGUAGE"):
        return "filtro de contenido: cambiar la entrada"
    if reason in ("MALFORMED_FUNCTION_CALL", "UNEXPECTED_TOOL_CALL", "TOO_MANY_TOOL_CALLS",
                  "MISSING_THOUGHT_SIGNATURE", "MALFORMED_RESPONSE"):
        return "herramientas o formato: corregir declaraciones o firmas y reintentar"
    return f"otro ({reason}): registrar finishMessage y reintentar una vez"


def next_action_openai(resp: dict, max_tokens: int) -> str:
    choice = (resp.get("choices") or [{}])[0]
    used = (resp.get("usage") or {}).get("completion_tokens", 0)
    if choice.get("finish_reason") == "length" or used >= max_tokens:
        return "cortada: este endpoint no continúa; subir max_tokens"
    return "terminada" if choice.get("finish_reason") in ("stop", "tool_calls") else "revisar"
La segunda función existe porque en formato OpenAI el finish_reason no basta, como muestra la sección siguiente. El clasificador también marca como terminada la respuesta en la que el modelo se negó a contar hasta 7.000: lo que no puede hacer ningún finish_reason es comprobar el contenido por ti.
Si prefieres que sea el servidor quien encadene los saltos, la API Interactions con long decode lo hace con background: true, store: true y un max_output_tokens mayor que 65.536, y la ejecución puede durar hasta 24 horas. Ahí no hay finish_reason, sino un status: completed, requires_action, incomplete (se gastó todo max_output_tokens y el texto puede venir vacío), failed o cancelled. Con background: false, cualquier valor por encima de 65.536 devuelve un 400.
Pasarelas y endpoint compatible con OpenAI: lo que devolvieron
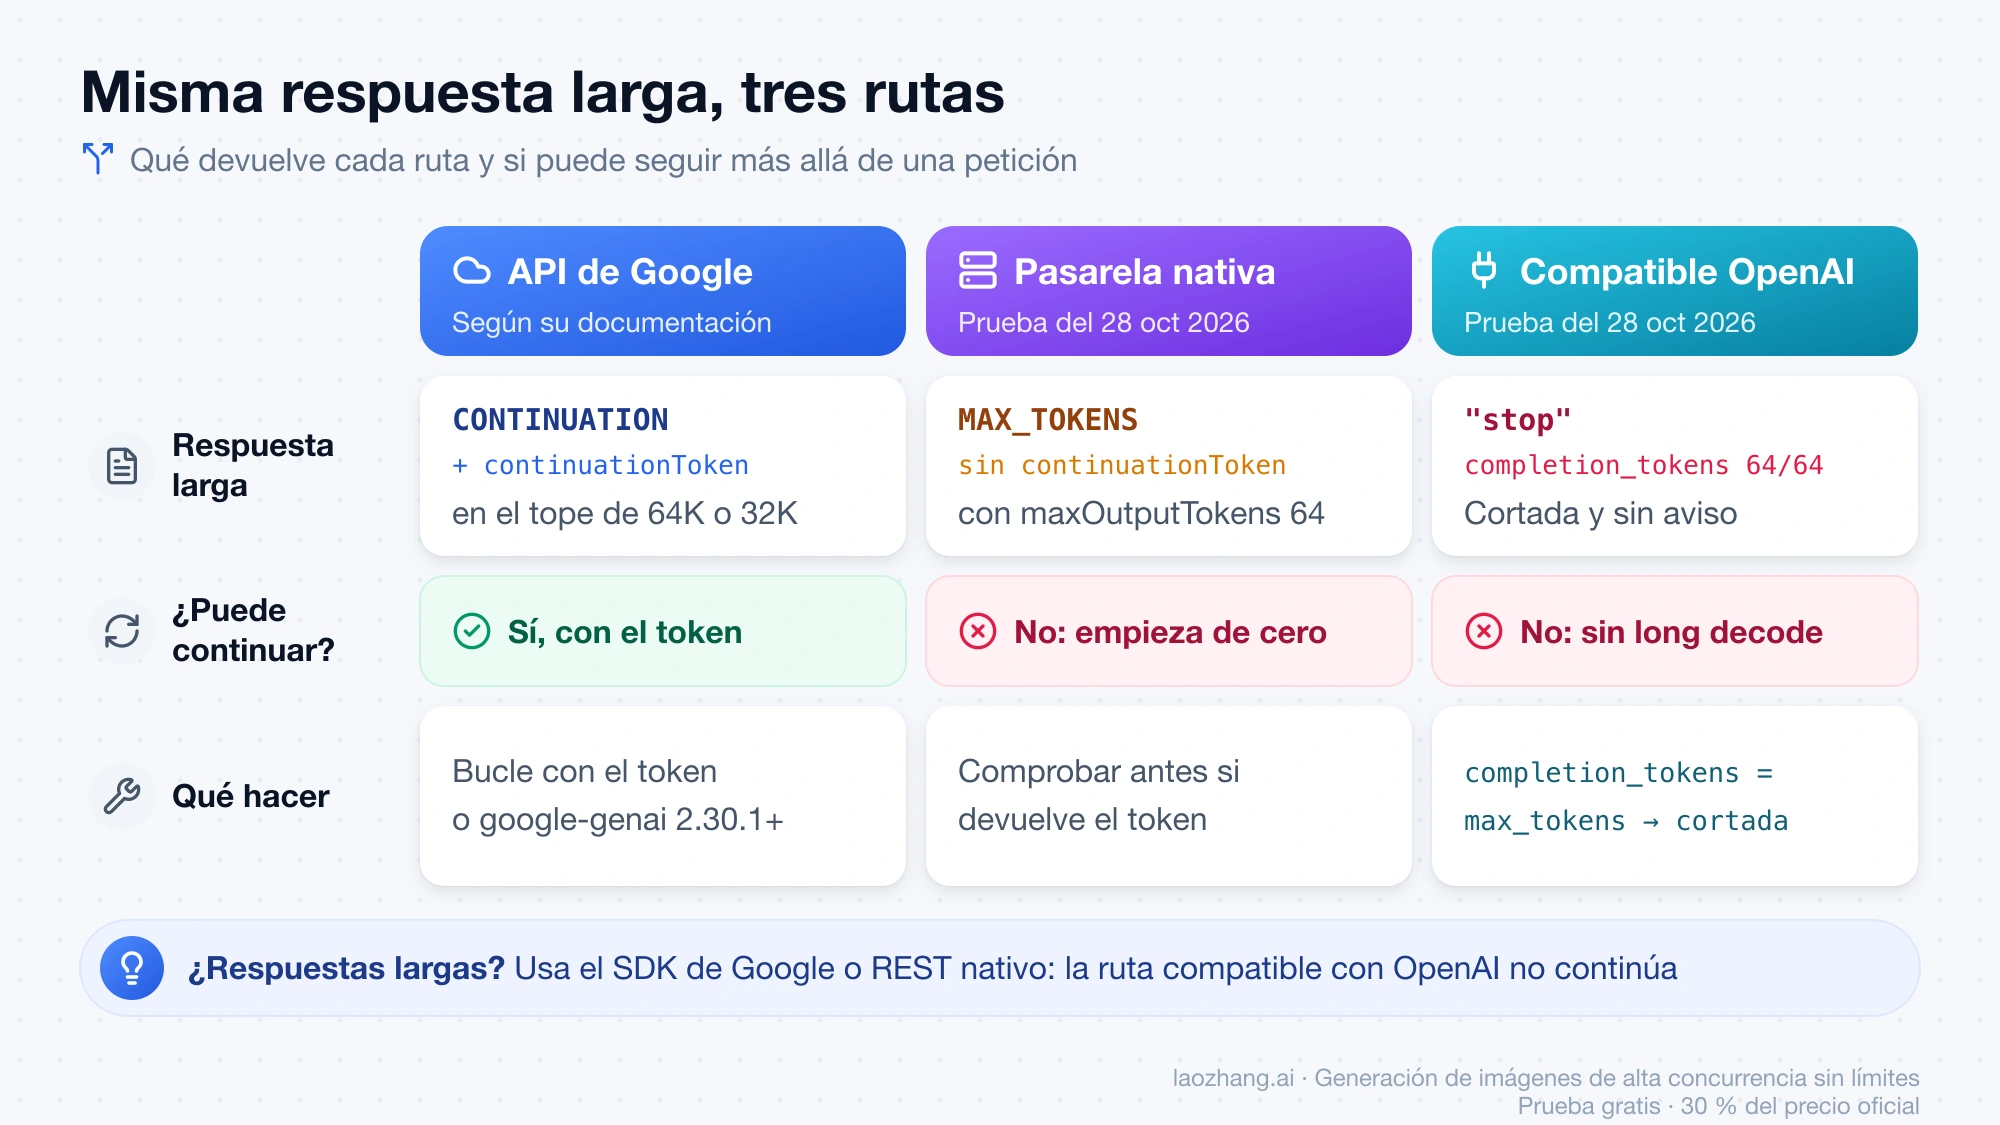
Por una pasarela de API, el 28 de octubre de 2026 MAX_TOKENS llegó sin continuationToken y la ruta compatible con OpenAI devolvió "stop" en una respuesta cortada en seco. La pasarela probada fue laozhang.ai, que acepta tanto generateContent nativo como /v1/chat/completions y lista gemini-4-argon a 2 $ y 10 $ por millón de tokens, sin precio rebajado para la entrada en caché. Los resultados valen para esa pasarela, esa clave y ese día:
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
| Petición | Qué devolvió | Qué implica |
|---|---|---|
Nativa, maxOutputTokens 64, thinkingLevel low, respuesta larga | MAX_TOKENS, 291 caracteres, sin continuationToken | Sin token no hay continuación: reenviar la petición generó otra respuesta desde cero |
Nativa, maxOutputTokens 200, thinkingLevel high, problema difícil | MAX_TOKENS con 0 caracteres de texto (197 tokens de razonamiento y 3 de respuesta) | Con poco presupuesto, high se lo come entero pensando |
Nativa sin streaming, maxOutputTokens 40.000 | STOP y «OK», sin error | No reprodujo el 400 que Google documenta por encima de 32.768 en REST sin streaming |
Nativa, thinkingLevel minimal | HTTP 500 con un mensaje genérico de error del servicio de origen y el código «402» | La pasarela ocultó el error real, que es el rechazo de minimal |
Compatible con OpenAI, max_tokens 64, respuesta larga | completion_tokens 64 de 64 y finish_reason "stop" | El valor no avisó del corte |
La última fila es la que más código rompe. Algunas plataformas de API afirman que en Chat Completions una respuesta cortada en el límite termina con "length", y la documentación del endpoint compatible con OpenAI de Google no dice cómo traduce los motivos de parada. Lo seguro, sea cual sea tu proveedor, es comparar completion_tokens con max_tokens: si son iguales, la respuesta está cortada aunque diga "stop".
Además, ninguna ruta compatible con OpenAI puede continuar. La documentación de long decode lo dice de la propia Google: en https://generativelanguage.googleapis.com/v1beta/openai/ no hay long decode y la salida se detiene en el tope de una petición. Ahí reasoning_effort equivale a thinking_level (low, medium, high), pero si necesitas más que un salto tienes que pasar al SDK de Google o a REST nativo. Si quieres seguir con el SDK de OpenAI para respuestas cortas, Cambiar la base_url de OpenAI: qué ajuste gana y qué ruta poner explica qué ruta poner. Con cualquier pasarela, antes de depender de ella para salidas largas, comprueba con una petición pequeña si devuelve continuationToken: sin ese campo, solo te queda la longitud de una petición.
Las pruebas costaron, en el peor caso, 0,59 $ de un tope de 1 $, calculado a precio de lista.
El stream terminó sin finish_reason: la respuesta está incompleta
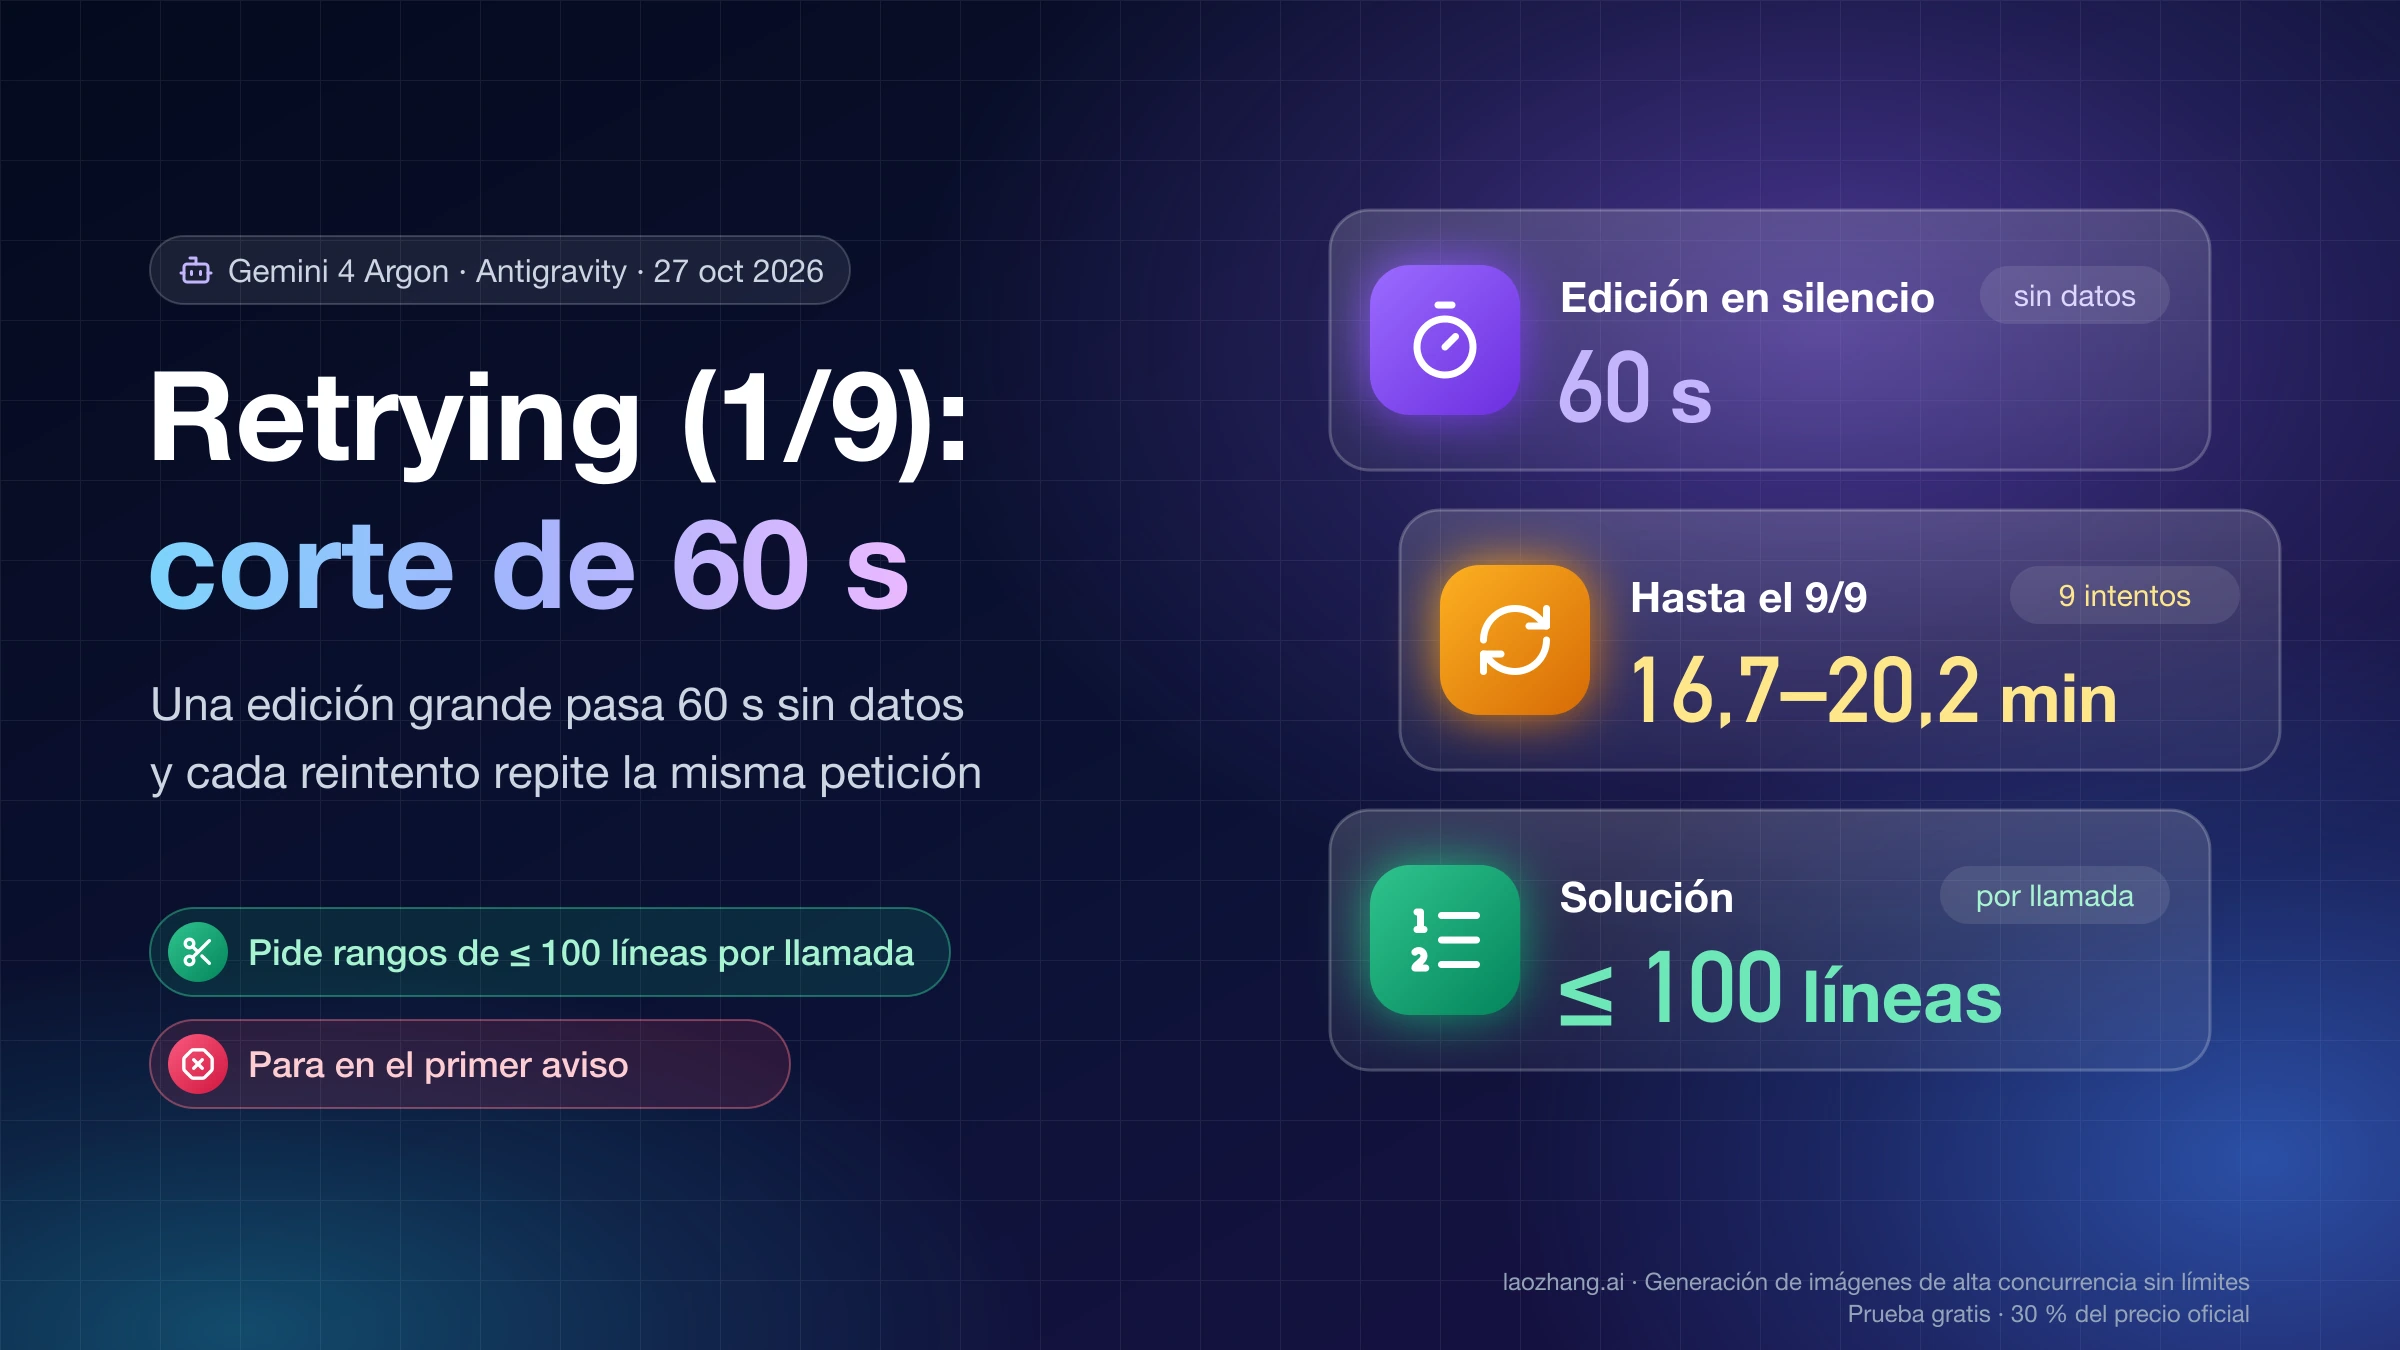
Un stream que se cierra sin finishReason no ha terminado bien: trata la respuesta como incompleta aunque traiga mucho texto. El 28 de octubre de 2026 se pidió por streamGenerateContent?alt=sse una tabla CSV de 2.500 filas en tres idiomas con maxOutputTokens 33.000. Llegaron 993 eventos y 74.760 caracteres, hasta la fila 1.065, y el stream se cerró a los 302,5 segundos sin finishReason, sin el recuento final de tokens y sin ningún token de punto de control; los fragmentos intermedios marcaban candidatesTokenCount 0. La misma petición sin streaming se cortó a los 300,9 segundos sin cuerpo. La ruta pasaba por un proxy HTTP local y por la pasarela, y no se pudo determinar cuál de los dos cortó a los 300 segundos.
Con la API directa de Google, un corte así tiene arreglo si ya habías recibido un punto de control: reanudas desde el último token. Si se corta antes de los primeros 32.768 tokens no hay punto de control y toca reenviar la petición original. Google cierra las conexiones sin streaming a los 10 minutos y los streams a los 20, así que un tiempo de espera de 3 o 5 minutos en el cliente corta las peticiones antes de tiempo; ajústalo a 20 minutos, por ejemplo con genai.Client(http_options=types.HttpOptions(timeout=1_200_000)) en Python.
Por qué prompt_token_count sale tan alto después de varios saltos
Con varios saltos, prompt_token_count suma la entrada de cada petición, así que no mide el tamaño de tu prompt: para eso está initial_prompt_token_count. Cada salto reenvía el prompt más todo lo generado hasta ese momento, y el SDK suma todos los campos de uso de todos los saltos. El ejemplo de la documentación de Google es un prompt de 1.000 tokens que produce 200.000 tokens de razonamiento y respuesta en cuatro saltos de 64K: el primero envía 1.000 tokens de entrada, el segundo 66.536 (prompt más el primer salto), el tercero 132.072 y el cuarto 197.608, en total 397.216. El contexto real ronda los 201.000 tokens, pero prompt_token_count marca unos 397.000 y total_token_count unos 597.000; con un bucle REST sin streaming, de saltos de 32K, son siete saltos y 695.128 tokens de entrada. En la prueba simulada del 28 de octubre ocurrió lo mismo a pequeña escala: con un prompt de 120 tokens y dos saltos, el SDK 2.33.0 informó de 33.008 tokens de entrada (120 + 32.888) y de un initial_prompt_token_count de 120. Si tu agente resume o recorta el historial al acercarse a un límite, usa initial_prompt_token_count (initialPromptTokenCount en JavaScript), o el promptTokenCount del primer salto si llamas a REST. Ese campo lo calcula el SDK en el cliente: no aparece en la respuesta REST ni en model_dump(), así que guárdalo aparte si lo necesitas en los registros.
En la factura de Google pagas todos los tokens de todos los saltos, también los que solo contienen razonamiento. El almacenamiento en caché implícito descuenta un 95 % la entrada repetida de cada salto, que durante el periodo de lanzamiento cuesta 0,10 $ por millón en lugar de 2 $, pero la caché caduca tras 15 o 20 minutos sin uso, y una pausa larga entre saltos vuelve a cobrar la tarifa completa. Un salto sin streaming que falla no cuesta nada; un stream que se cae antes de los 32K tampoco, y si se cae después pagas hasta el último punto de control. Si llamas a REST a través de una pasarela, suma tú los campos de cada salto para el coste y quédate con el promptTokenCount del primero como tamaño del prompt.
Fuentes8
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 28 oct 2026.
Fuentes8
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 28 oct 2026.
- 1.registro de cambios de la API de Geminiai.google.dev/gemini-api/docs/changelog
- 2.facturación de la API de Geminiai.google.dev/gemini-api/docs/billing
- 3.guía de novedades de Gemini 4 Argonai.google.dev/gemini-api/docs/latest-model
- 4.documentación de long decodeai.google.dev/gemini-api/docs/generate-content/long-decode
- 5.página de precios de la API de Geminiai.google.dev/gemini-api/docs/pricing
- 6.referencia de generateContentai.google.dev/api/generate-content
- 7.API Interactions con long decodeai.google.dev/gemini-api/docs/long-decode
- 8.documentación del endpoint compatible con OpenAI de Googleai.google.dev/gemini-api/docs/openai