Qwen4-MaxとOpus 5.5比較:短い仕事は費用1/3.4、AAのテストでは逆転
Qwen4-Maxの単価はClaude Opus 5.5の約4分の1。同じ12問の実測では費用1/3.4・待ち時間4倍で、AAのテストでは1タスクの費用が逆転します。
目次
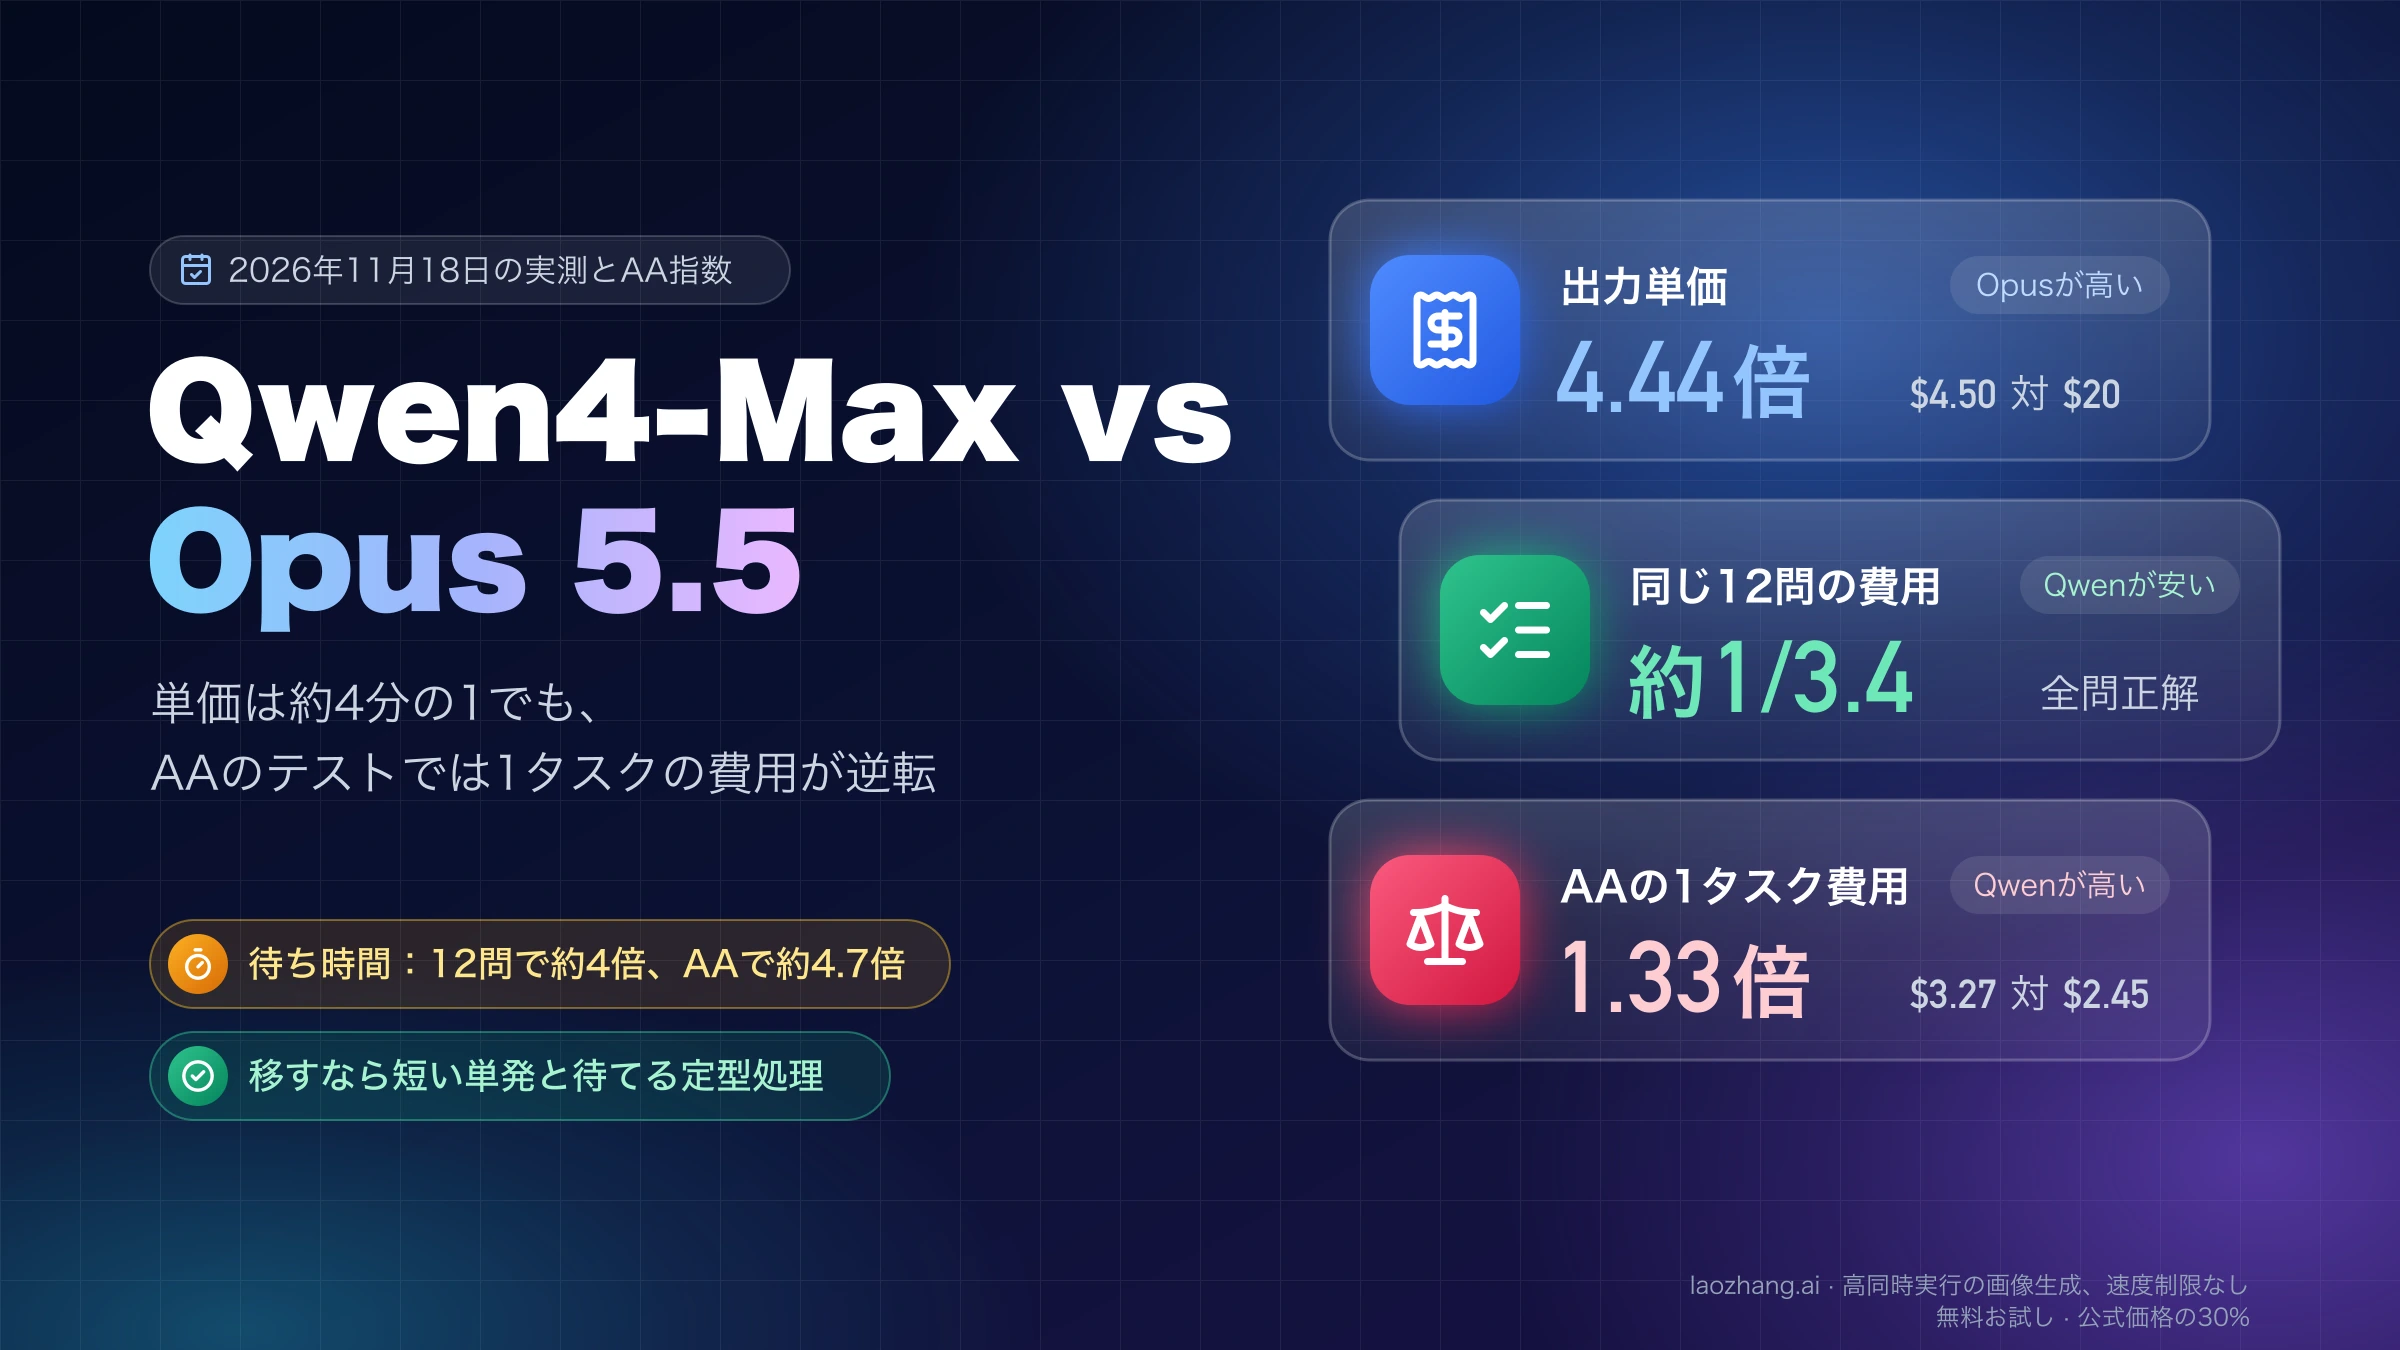
Claude Opus 5.5(claude-opus-5-5)の仕事の一部をQwen4-Max(qwen4-max、2026年11月16日正式公開)へ移すなら、対象は短い単発リクエストと、待ち時間を気にしない定型の業務処理です。2026年11月18日にLaoZhangのAPIゲートウェイ経由で同じ12問を解かせると、どちらも全問正解で、Qwen4-Max(既定の思考設定)の費用はOpus 5.5 mediumの約3.4分の1でした。その代わり、合計の待ち時間は約4倍かかっています。
長く難しい推論やコーディングエージェント、すぐに返事が欲しい対話的な用途は、Opus 5.5に残すほうが確実です。Artificial Analysis(AA)の指数v5.0.1(2026年11月18日時点)では、Qwen4-Maxは1タスクあたり$3.27・32.3分で43点、Opus 5.5 mediumは$2.45・6.9分で48点で、AAのテスト群では単価の安さが思考の量に打ち消されています。長い作業の費用はテストによって向きが変わりますが、Qwen4-Maxが数倍遅い点はどの測定でも共通です。
Qwen4-Maxは既定で思考がオンになっており、思考トークンは出力として課金されます。仕事を移すときは、リクエストにenable_thinking: falseを付けて思考を切るか、thinking_budgetで上限をかけてください。同じ日の実測では、reasoning_effortをlowにしても思考は安定して減りませんでした。
料金の差:出力単価は約4.4分の1、思考も出力として課金
Qwen4-MaxのAPI単価は、Alibaba Cloud Model StudioのInternational(シンガポール)区分で100万トークンあたり入力$1.50、出力$4.50です。Claude Opus 5.5は入力$4、出力$20なので、出力ではOpusが約4.44倍、入力では約2.67倍高くなります。「Opusの約4分の1」という比は、出力単価の比(0.225倍)に近い数字です。どちらのモデルも思考トークンは出力として課金され、Qwen4-Maxの料金表は出力単価の対象を「思考(chain-of-thought)+回答」と明記しています。
| 100万トークンあたり | Qwen4-Max(International) | Claude Opus 5.5 | Opus÷Qwen |
|---|---|---|---|
| 入力 | $1.50 | $4 | 2.67倍 |
| 出力(思考を含む) | $4.50 | $20 | 4.44倍 |
| キャッシュ読み込み | $0.075 | $0.20 | 2.67倍 |
| Batch(入力/出力) | $0.707/$2.12(中国・北京リージョンのみ) | $2/$10 | なし |
Qwen4-Maxの単価はAlibaba Cloud Model StudioのQwen4-Maxモデルページ、Opus 5.5の単価はClaude APIの料金ページに基づきます(2026年11月18日時点)。中国(北京)リージョンと、香港・フランクフルト・バージニア・東京のGlobal区分では、Qwen4-Maxは入力$1.413、出力$4.24です。Batch推論に対応しているのは北京リージョンだけで、$0.707/$2.12はそのBatch価格(Batch Chatは期間限定の50%オフ)です。シンガポールのInternational区分や東京リージョンではBatchは使えません。キャッシュは明示・暗黙ともすべてのリージョンで使え、International区分に限り、有効化またはモデル公開から90日以内に100万トークンの無料枠があります。Qwen4-Maxのキャッシュ読み込みは、AAとOpenRouterが入力単価の5%として表示している値です。Opus 5.5のキャッシュ書き込みは5分が$5、1時間が$8です。Opus側の料金体系と利用枠はClaude Opus 5.5の料金と上限リセット権:API単価、使える枠、確認手順で詳しく扱っています。
仕様では、コンテキスト長はどちらも100万トークンです。Qwen4-Maxの最大出力は131,072トークン(思考モードでは262,144トークン)で、入力はテキスト・画像・動画に対応し、Opus 5.5はテキストと画像です。Qwen4-MaxはOpenAI互換のChat Completions・Responses、Anthropic Messages形式、DashScopeで呼び出せるので、既存のクライアントからモデル名を差し替えて試せます。
同じ12問の実測:費用は約3.4分の1、待ち時間は約4倍
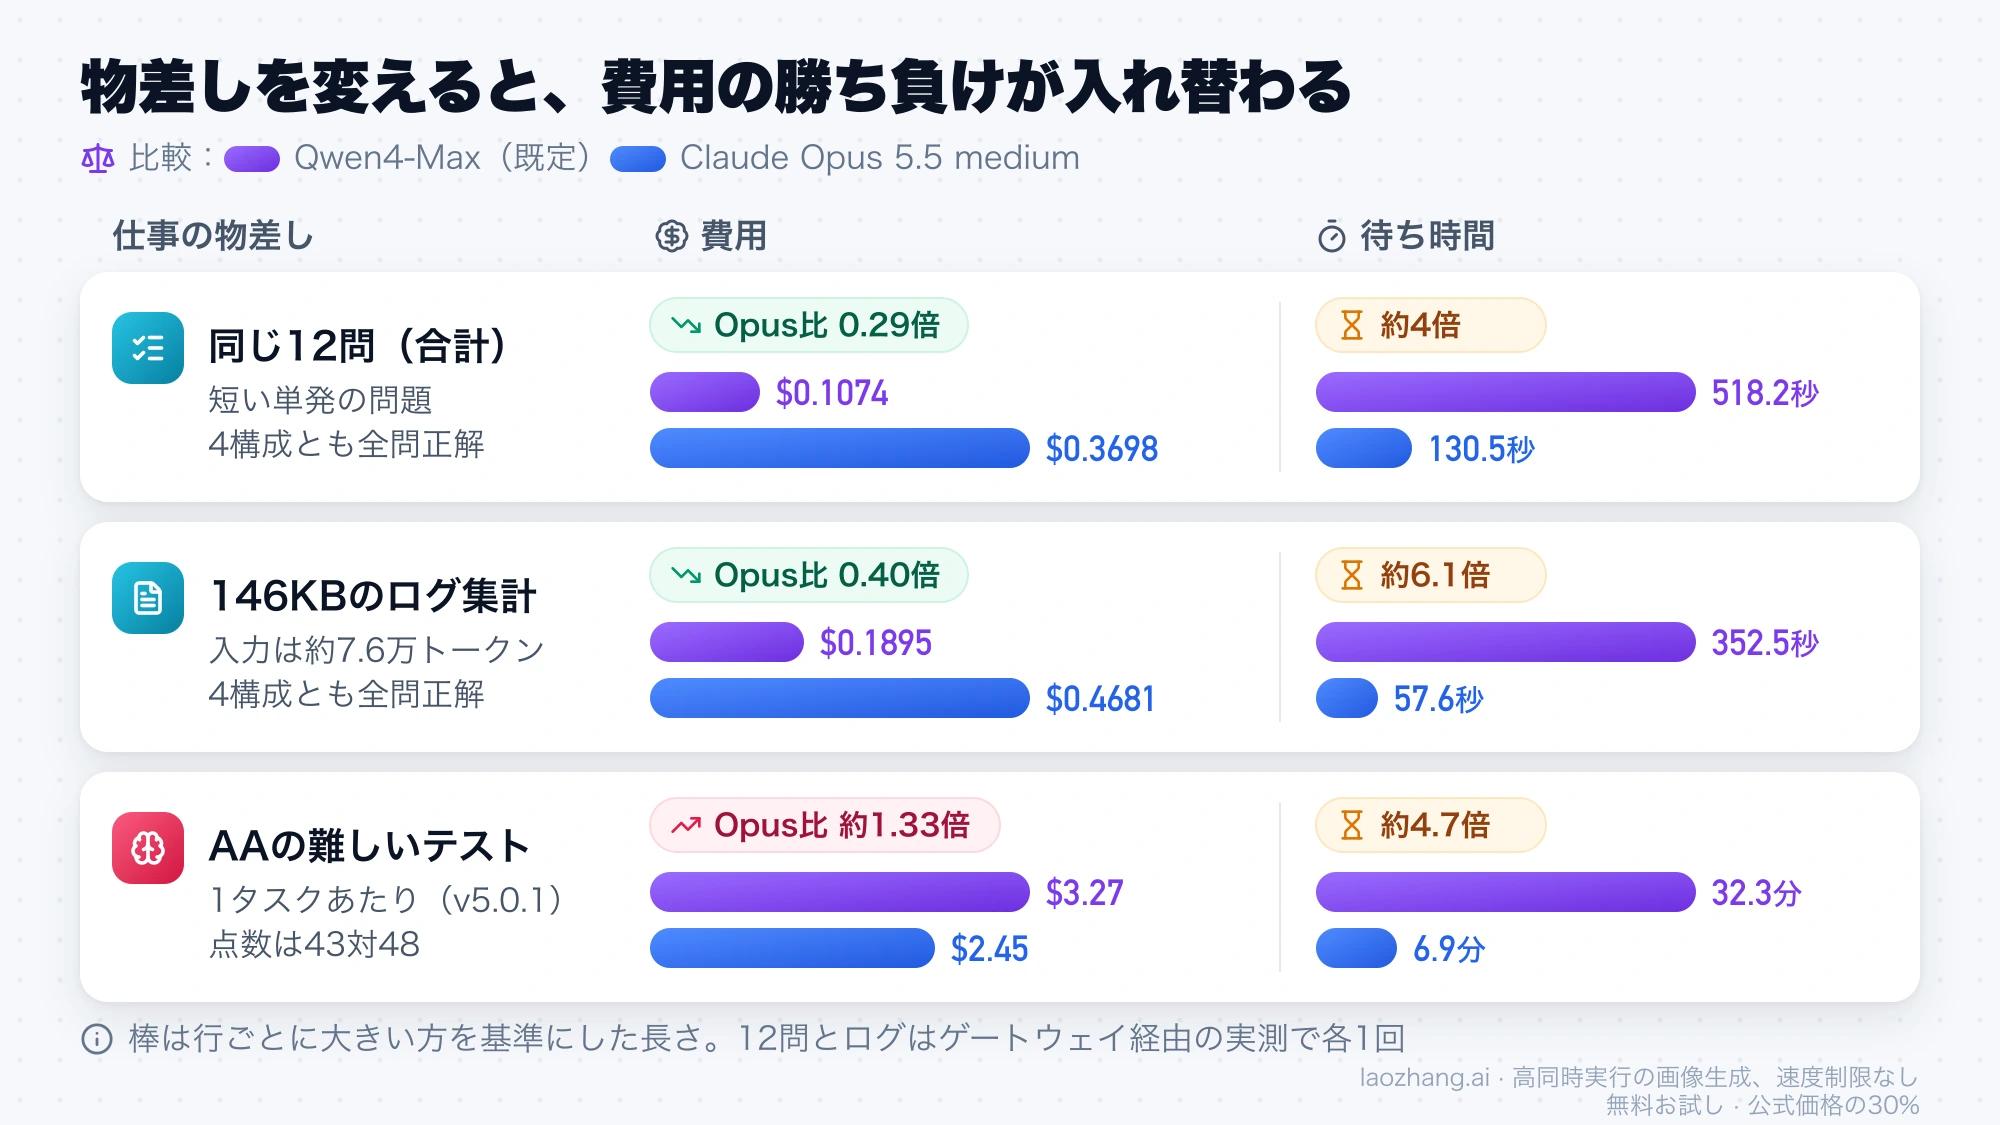
短い単発の問題なら、Qwen4-Maxは正解数を落とさずに費用をOpus 5.5 mediumの約3.4分の1に抑えました。代わりに待ち時間は約4倍です。2026年11月18日、隠しテストか正確な答えで採点する12問を、LaoZhangのAPIゲートウェイ経由でQwen4-Maxに解かせ、同じ問題・同じ採点で記録してあるOpus 5.5のmediumとhighの結果と並べています。問題は文章題、区間のマージ、時間表記の解析、頻出単語の集計、約1.1万トークンの文書の5項目要約、数式の評価器、CSV行の分割、桁和の推論、semverの比較と範囲判定、メモからの計算、標準ライブラリだけで書く課題です。
| 構成 | 正解 | 出力トークン(うち思考) | 合計時間 | 費用(定価換算) | Opus medium比の費用 |
|---|---|---|---|---|---|
| Qwen4-Maxの既定(high) | 12/12 | 15,915(10,465) | 518.2秒 | $0.1074 | 0.29倍 |
| Qwen4-Maxのlow | 12/12 | 16,924(11,237) | 567.3秒 | $0.1119 | 0.30倍 |
| Claude Opus 5.5 medium | 12/12 | 11,833(内訳なし) | 130.5秒 | $0.3698 | 1倍 |
| Claude Opus 5.5 high | 12/12 | 13,674(内訳なし) | 159.3秒 | $0.4067 | 1.10倍 |
Qwen4-Maxは出力トークンがOpus mediumの約1.34倍と多く、その約3分の2が思考でした。それでも出力単価が約4.44分の1なので、合計の費用は安くなります。待ち時間は1問あたり平均で約43秒対約11秒です。差が大きく出たのはsemverの範囲判定で、Qwen4-Maxは5,317トークン・113.9秒、Opus mediumは2,503トークン・22.6秒でした。入力の多い文書要約では、Qwen4-Maxの$0.0201に対してOpus mediumは$0.0907と約4.5倍の差です。lowは既定より費用が1.04倍、時間が1.09倍で、この問題群では節約になりませんでした。
146KBのログ集計:Qwen4-Maxは費用0.40倍、待ち時間6.1倍
長めの入力でも費用の向きは同じでした。146KB・1,500行のログから7つの数値を数える課題では、4構成とも全問正解です。費用は返ってきたトークン数に定価を掛けて計算でき、Qwen4-Max既定は76,037×$1.50+16,767×$4.50を100万で割って$0.1141+$0.0755=$0.1895、Opus 5.5 mediumは78,537×$4+7,699×$20を100万で割って$0.3141+$0.1540=$0.4681です。Qwen4-Maxの費用はOpusの0.40倍ですが、出力トークンは約2.2倍で、待ち時間は352.5秒対57.6秒と約6.1倍でした。Qwen4-Maxのlowは出力21,158トークン・364.1秒・$0.2093で、ここでも既定より多くかかっています。Opus 5.5 highは8,136トークン・59.0秒・$0.4769でした。
これらの数字は各セル1回ずつの結果です。4構成とも解ける小さな問題なので、比べているのは費用・トークン数・待ち時間で、賢さの差ではありません。時間はゲートウェイで測った応答完了までの時間で、Qwen4-Maxは中国本土の上流経由、Opus 5.5は8問とログ課題が2026年11月11日、残り4問が11月18日の記録で、一部はストリーミングなしです。待ち時間の倍率は目安として読んでください。ログ課題の入力は約7.6万トークンで、どちらの100万トークンの上限にも遠く、非常に長い入力については何も言えません。
AAの1タスク費用ではQwen4-Maxが高い理由:思考の量
AAのテスト群では、Qwen4-Maxは1タスクあたりの費用でもOpus 5.5 mediumを上回り、点数は5点低く、時間は約4.7倍かかります。単価が安くても、1件に使うトークンが多ければ費用は逆転します。AAの指数v5.0.1(2026年11月18日時点)で、Qwen4-MaxとOpus 5.5の各推論強度(effort)を並べると次のとおりです。
| モデルと設定 | AA指数 | 1タスクの費用 | 1タスクの時間 |
|---|---|---|---|
| Qwen4-Max | 43 | $3.27 | 32.3分 |
| Claude Opus 5.5 low | 35 | $0.98 | 3.0分 |
| Claude Opus 5.5 medium | 48 | $2.45 | 6.9分 |
| Claude Opus 5.5 high | 52 | $3.46 | 9.3分 |
| Claude Opus 5.5 xhigh | 57 | $6.05 | 15.8分 |
| Claude Opus 5.5 max | 59 | $10.04 | 24.6分 |
数字はAAのQwen4-MaxとClaude Opus 5.5の比較ページによります。AAのQwen4-Maxのモデルページは、Qwen4-Maxを「タスクあたりが目立って遅く、非常に冗長」と評価しています。指数の評価全体で生成したトークンは1.27億で、AAが示す中央値6,510万の約2倍です。出力速度は毎秒54トークンとOpus 5.5(毎秒105〜117トークン)の約半分で、最初の回答トークンまで148.6秒かかります。出力単価が約4.44分の1なのに1タスクの費用が約1.33倍になるということは、このテスト群ではOpus mediumよりはるかに多くのトークンを使った計算になります。
短い12問で安く済んだのは、思考の量が絶対数として小さく、単価の差がそのまま効いたためと考えられます。仕事が長く難しくなると思考トークンが積み上がり、AAのテスト群ではそれが単価の差を上回りました。ただし、長い仕事なら必ず逆転するわけではありません。atomicagent.ioのQwen4-MaxとOpus 5.5の比較記事は、隠しテスト59件の複数ステップのコーディングエージェント課題1つを、OpenRouter経由で各設定3回走らせています(Qwen4-Maxは2026年11月16日、Opus 5.5は11月9日)。全回が全テストに合格し、Qwen4-Max highは1タスク約$0.65・25分、Opus 5.5 mediumは$0.97・4.2分で、Qwen4-Maxが約3分の1安く、約6倍遅い結果でした。著者は、1回あたり約270万トークンの入力がAlibaba側の暗黙キャッシュから読まれたことを安さの一因と見ています。AAの1タスク費用は一般則ではなく、AAのテスト群での結果として読んでください。同じ費用帯で比べても、Opus 5.5 highはQwen4-Maxとほぼ同じ1タスク費用で9点高く、約3分の1の時間で終わります。Opus 5.5 lowは最も安いものの、点数はQwen4-Maxより8点低くなります。
推論強度の物差しは両モデルで違います。Qwen4-Maxはlow・high・xhighの3段階で既定はhigh、Opus 5.5はlow・medium・high・xhigh・maxの5段階です。AAはQwen4-Maxをどの設定で測ったかを示しておらず、登録は1つだけです(APIの既定はhigh)。「Qwen4-Maxの既定とOpus 5.5 mediumの比較」とは言えても、「同じ推論レベル同士の比較」とは言えません。AAの数字はQwen4-Maxの公開2日後のもので、今後再計算される可能性があります。
ベンチマークでQwen4-Maxが強い所と弱い所
AAの個別スコアでQwen4-Maxが勝っているのは、業務自動化と文書業務寄りの評価です。AutomationBench-AAでは72.6%で、Opus 5.5のmaxを含む6構成の中で最高でした。AA-BriefcaseでもOpus 5.5 mediumを上回ります。一方で、高難度の知識・科学推論、ターミナル操作、難しいコーディングでは差がはっきり開きます。
| AAの評価(2026年11月18日時点) | Qwen4-Max | Opus 5.5 medium | Opus 5.5 max |
|---|---|---|---|
| AutomationBench-AA | 72.6% | 61.2% | 69.5% |
| AA-Briefcase | 1686 | 1617 | 1800 |
| Terminal-Bench 4.0 | 48.5% | 52.5% | 59.6% |
| FrontierCode-AA 2.0 | 26.5% | 33.1% | 46.4% |
| HLE-Diamond | 44.9% | 51.4% | 67.9% |
| CritPt v2 | 43.0% | 54.0% | 68.0% |
| Terminal-Bench-Science | 23.3% | 43.3% | 59.0% |
| AA-Omniscience | 28 | 40 | 48 |
GDP.pdfは26.2%でOpus 5.5 maxと同じ、mediumの25.6%をわずかに上回りました。分野別の指数をOpus 5.5 mediumと比べると、Qwen4-MaxはFinance(54対51)とStrategy & Ops(57対56)でわずかに上、Legalは50で同点、Healthcare(48対51)、Engineering(50対54)、Economics(51対53)では下です。定型の多い業務エージェントや財務・事業企画の文書作業ならQwen4-Maxが候補になり、難しい開発や高度な推論ではOpus 5.5が有利、という方向がこの数字から読み取れます。
Alibabaの発表に由来する数字は、第三者の評価と分けて読む必要があります。「DeepSWE v1.1で75.7、Opus 5.5を含む比較モデルの中で最高」はAlibaba自身の発表による数字で、上のAAの表のような第三者の測定値ではありません。同じ発表でTerminal-Bench 4.0は48.5、Opus 5.5は59.6とされており、この59.6はAAのOpus 5.5 maxの値と一致します。AA指数でOpus 5.5の59点はmaxの値で、Qwen4-Maxとの差は16点、mediumとの差は5点です。Alibabaによると、Qwen4-Maxは総パラメータ2.4兆、1トークンあたり約710億が動くスパースMoEです。
仕事の種類別:Qwen4-Maxに移す仕事、Opus 5.5に残す仕事
移すかどうかは、1件の仕事の長さと難しさ、そして待てるかどうかの2つで決まります。短い単発の処理でバックグラウンド実行できるならQwen4-Maxで費用が下がり、長く難しい作業や人が画面の前で待つ用途ではOpus 5.5のほうが速く、AAのテストではmediumなら1タスクの費用も安くなります。
| 仕事の種類 | 向いているモデル | 判断の根拠 |
|---|---|---|
| 短い単発の定型処理(抽出、分類、要約、小さなコード) | Qwen4-Max(思考を抑える) | 同じ12問の実測で全問正解、費用は大幅に低い |
| 数万トークンのログや文書の集計 | Qwen4-Max(待てる場合) | 146KBのログ集計の実測で全問正解、待ち時間は大幅に長い |
| 定型の多い業務自動化、財務・事業企画の文書作業 | Qwen4-Maxを候補に自分の仕事で試す | AutomationBench-AA 72.6%、Finance 54対51 |
| 長く難しい推論やコーディングエージェント | Opus 5.5 medium(点数を優先するならhigh) | Opusが数倍速く、AA指数でmediumは5点上、highは9点上。1タスクの費用はAAではmediumが安く、第三者のエージェント課題1つではQwenが安い |
| チャットやIDEでの対話的な用途 | Opus 5.5 | 最初の回答トークンまで148.6秒(AA) |
| 動画を入力する処理 | Qwen4-Max | Opus 5.5は動画入力に非対応 |
併用するなら、Opus 5.5をそのまま既定に残し、結果をすぐに必要としない短い定型処理から順にQwen4-Maxへ切り出すのが無難です。切り出す前に、自分の仕事から数十件を選んで両方に流し、正解率と1件あたりの費用・時間を比べてください。上の12問は全構成が解ける問題だけなので、難しい仕事で正解率が落ちるかどうかは、自分のデータでしか確かめられません。
Opus 5.5の費用を下げる手段は、モデルの乗り換えだけではありません。同じAnthropicの半額モデルについてはSonnet 5.5とOpus 5.5の使い分け:半額が効く仕事、もう一つの中国系フラッグシップとの比較はKimi K3.1 ProとOpus 5.5比較:半額は単価だけ、effort別に計算、同じ12問でのOpenAIとの比較はGPT-6.2 Sol・6.1 Sol・Opus 5.5の違い:同じ12問の実測と使い分けにまとめています。
Qwen4-Maxの思考を抑える設定:enable_thinkingとthinking_budget
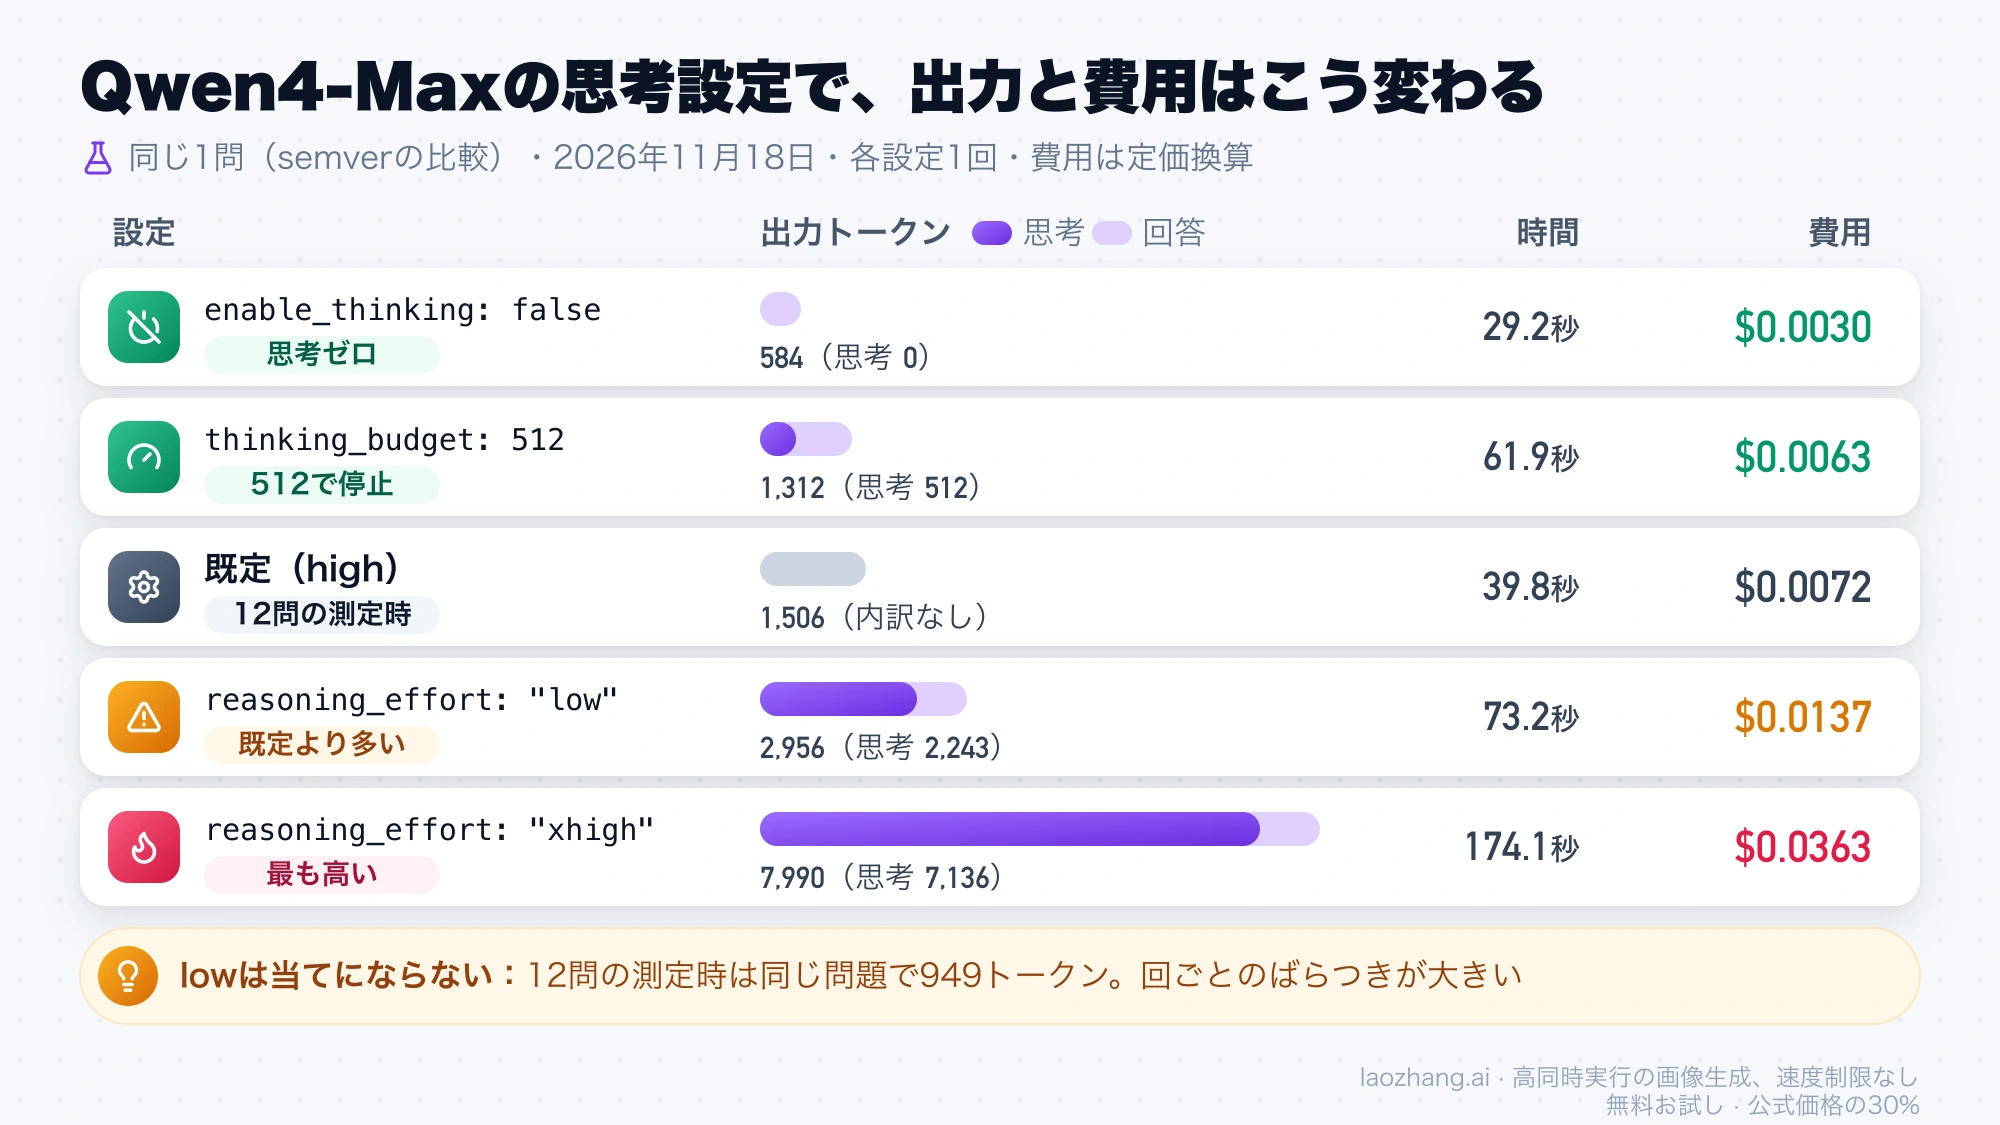
Qwen4-Maxの費用と待ち時間を下げるには、思考を切るenable_thinking: falseか、思考トークンに上限をかけるthinking_budgetを使います。何も指定しないとreasoning_effortはhigh、thinking_budgetは131,072トークンになり、思考の上限は大きく取られています。2026年11月18日に同じ1問(semverの比較)で各設定を試した結果が次の表です。
| 設定 | 出力トークン(うち思考) | 時間 | 費用(定価換算) |
|---|---|---|---|
enable_thinking: false | 584(0) | 29.2秒 | $0.0030 |
thinking_budget: 512 | 1,312(512) | 61.9秒 | $0.0063 |
| 既定(high、12問の測定時) | 1,506 | 39.8秒 | $0.0072 |
reasoning_effort: "low" | 2,956(2,243) | 73.2秒 | $0.0137 |
reasoning_effort: "xhigh" | 7,990(7,136) | 174.1秒 | $0.0363 |
thinking_budget: 512では思考がちょうど512トークンで止まり、enable_thinking: falseでは思考がゼロになりました。lowはこの回では既定より多く、12問の測定時には同じ問題で949トークンだったので、1回ごとのばらつきが大きく、費用を抑える手段としては当てになりません。各設定1回ずつの結果で、思考を切った回でも回答は返りましたが、その正誤は採点されていません。思考オフで正解率が保てるかは、自分の仕事で確認してください。
OpenAI互換のChat Completionsでは、次のようにリクエスト本文にパラメータを加えます。OpenAIの公式Python SDKから送る場合は、標準外のパラメータなのでextra_bodyに入れます。2026年11月18日にPython SDK 2.24.0からextra_bodyでenable_thinking: falseとthinking_budgetを短い計算問題で1回ずつ送ったところ、どちらもQwen4-Maxまで届き、思考オフでは思考トークンがゼロでした。LaoZhangのゲートウェイ経由でもこれらのパラメータはAlibaba側まで届き、reasoning_effortに存在しない値を送ると400のinvalid_parameter_errorが返りました。
{
  "model": "qwen4-max",
  "messages": [{ "role": "user", "content": "..." }],
  "thinking_budget": 2048
}思考を完全に切る場合は、thinking_budgetの行を"enable_thinking": falseに置き換えます。Opus 5.5用のコードをそのまま向けるときは推論強度の読み替えに注意してください。Qwen4-MaxはChat Completionsのreasoning_effort、Responsesのreasoning.effort、Anthropic Messagesのoutput_config.effortでlow・high・xhighを受け付け、mediumはhigh、maxはxhighとして扱います。Opus 5.5でmediumを指定していたコードは、Qwen4-Maxでは既定と同じhighで動きます。
Qwen4-Maxを使える場所:APIが中心、重みは非公開
Qwen4-MaxはAPIで使うモデルで、2026年11月18日時点で重みは公開されておらず、Hugging Faceからダウンロードしてローカルで動かすことはできません。Model Studio上でもファインチューニングと独自デプロイには対応していません。Alibabaは小さいQwen4モデルを後日オープンソース化するとしていますが、時期は示していません。
公式の経路は、Alibaba Cloud Model Studio(QwenCloud)のAPIと、Token Planのサブスクリプションです。報道によると、Alibaba自身のQwenWork、Qoder、Qwen Studioにも搭載されています。OpenRouterではqwen/qwen4-maxとして入力$1.425、出力$4.275で提供されています。Qwen Chat(chat.qwen.ai)は、2026年11月18日時点でログインしていない状態のモデル選択にQwen3.7-PlusとQwen3.8-Maxしか表示されませんでした。Qwen Chat側の回数制限はQwenの制限:無料の回数は非公開、上限メッセージ別の対処法を参照してください。
2つのモデルを同じコードで並べて試したいなら、LaoZhangのAPIキー1本でqwen4-maxとclaude-opus-5-5の両方を呼べます。上の実測もこの方法で行い、Qwen4-Maxのゲートウェイ料金は100万トークンあたり約$1.43/$4.29でした。Opus 5.5はClaudeの有料プラン、Claude Code、Claude API、Amazon Bedrock、Google Cloud、Microsoft Foundryで使えます。入手方法はClaude Opus 5.5の使い方:無料で使う方法と外部サービスの無料枠にまとめています。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
Qwen4-MaxとOpus 5.5のよくある質問
「Qwen4がOpus 5.5超え(49.9対47.2)」はQwen4-Maxの点数ですか?
いいえ。2026年11月6〜10日ごろに中国メディアで報じられた49.9対47.2は、公開前のQwen-4-Flash-Earlyがゲーム制作のベンチマークでOpus 5.5(XHigh)を上回ったという数字で、正式公開されたQwen4-Maxのものではありません。同じ時期の「1タスク$0.4対$2.6」もQwen4-Flashの値です。正式版Qwen4-MaxのAA指数は、2026年11月18日時点でOpus 5.5 mediumより低い値です。
「トークン50%減、1タスクの費用60%以上減」という話は本当ですか?
Alibabaが公表しているコスト削減の数字は、社内評価Work360で前世代のQwen3.8-Maxと比べて平均タスク費用が62%下がったというもので、Opus 5.5との比較ではありません。2026年11月18日時点でAAはQwen4-Maxを「非常に冗長」と評価しており、同じ日の12問の実測でも、Qwen4-Maxの出力トークンはOpus 5.5 mediumより多めでした。トークンが半分になるという主張は、少なくともOpus 5.5との比較では裏付けがありません。
「Qwen 4 Max」「Qwen4-Max」「qwen4-max」は同じモデルですか?
同じモデルです。表記の揺れで、APIのモデルIDはqwen4-maxです。ただし「Qwen4」とだけ書かれている場合は、Qwen4-Flashや27Bなど別サイズのモデルを指していることがあり、点数や料金をQwen4-Maxのものとして読むと誤ります。Qwen4-Maxはプレビュー版qwen4-max-previewが2026年11月11日、正式版qwen4-maxが11月16日に公開されています。
参考資料5
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年11月18日。
参考資料5
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年11月18日。
- 1.Alibaba Cloud Model StudioのQwen4-Maxモデルページdocs.modelstudio.console.alibabacloud.com/en/model-studio/qwen4-max
- 2.Claude APIの料金ページplatform.claude.com/docs/en/about-claude/pricing
- 3.AAのQwen4-MaxとClaude Opus 5.5の比較ページartificialanalysis.ai/models/comparisons/qwen4-max-vs-claude-opus-5-5
- 4.AAのQwen4-Maxのモデルページartificialanalysis.ai/models/qwen4-max
- 5.atomicagent.ioのQwen4-MaxとOpus 5.5の比較記事atomicagent.io/blog/qwen-4-max-vs-opus-5-5