Claude Opus 4.6とGPT-5.3-Codexを比較:API料金と開発作業での選び方
Claude Opus 4.6とGPT-5.3-CodexのAPI単価、キャッシュ料金、コンテキスト上限を比較。同じトークン数での費用計算と、既存リポジトリで実装・テスト・手直しまで比べる手順をまとめます。
目次
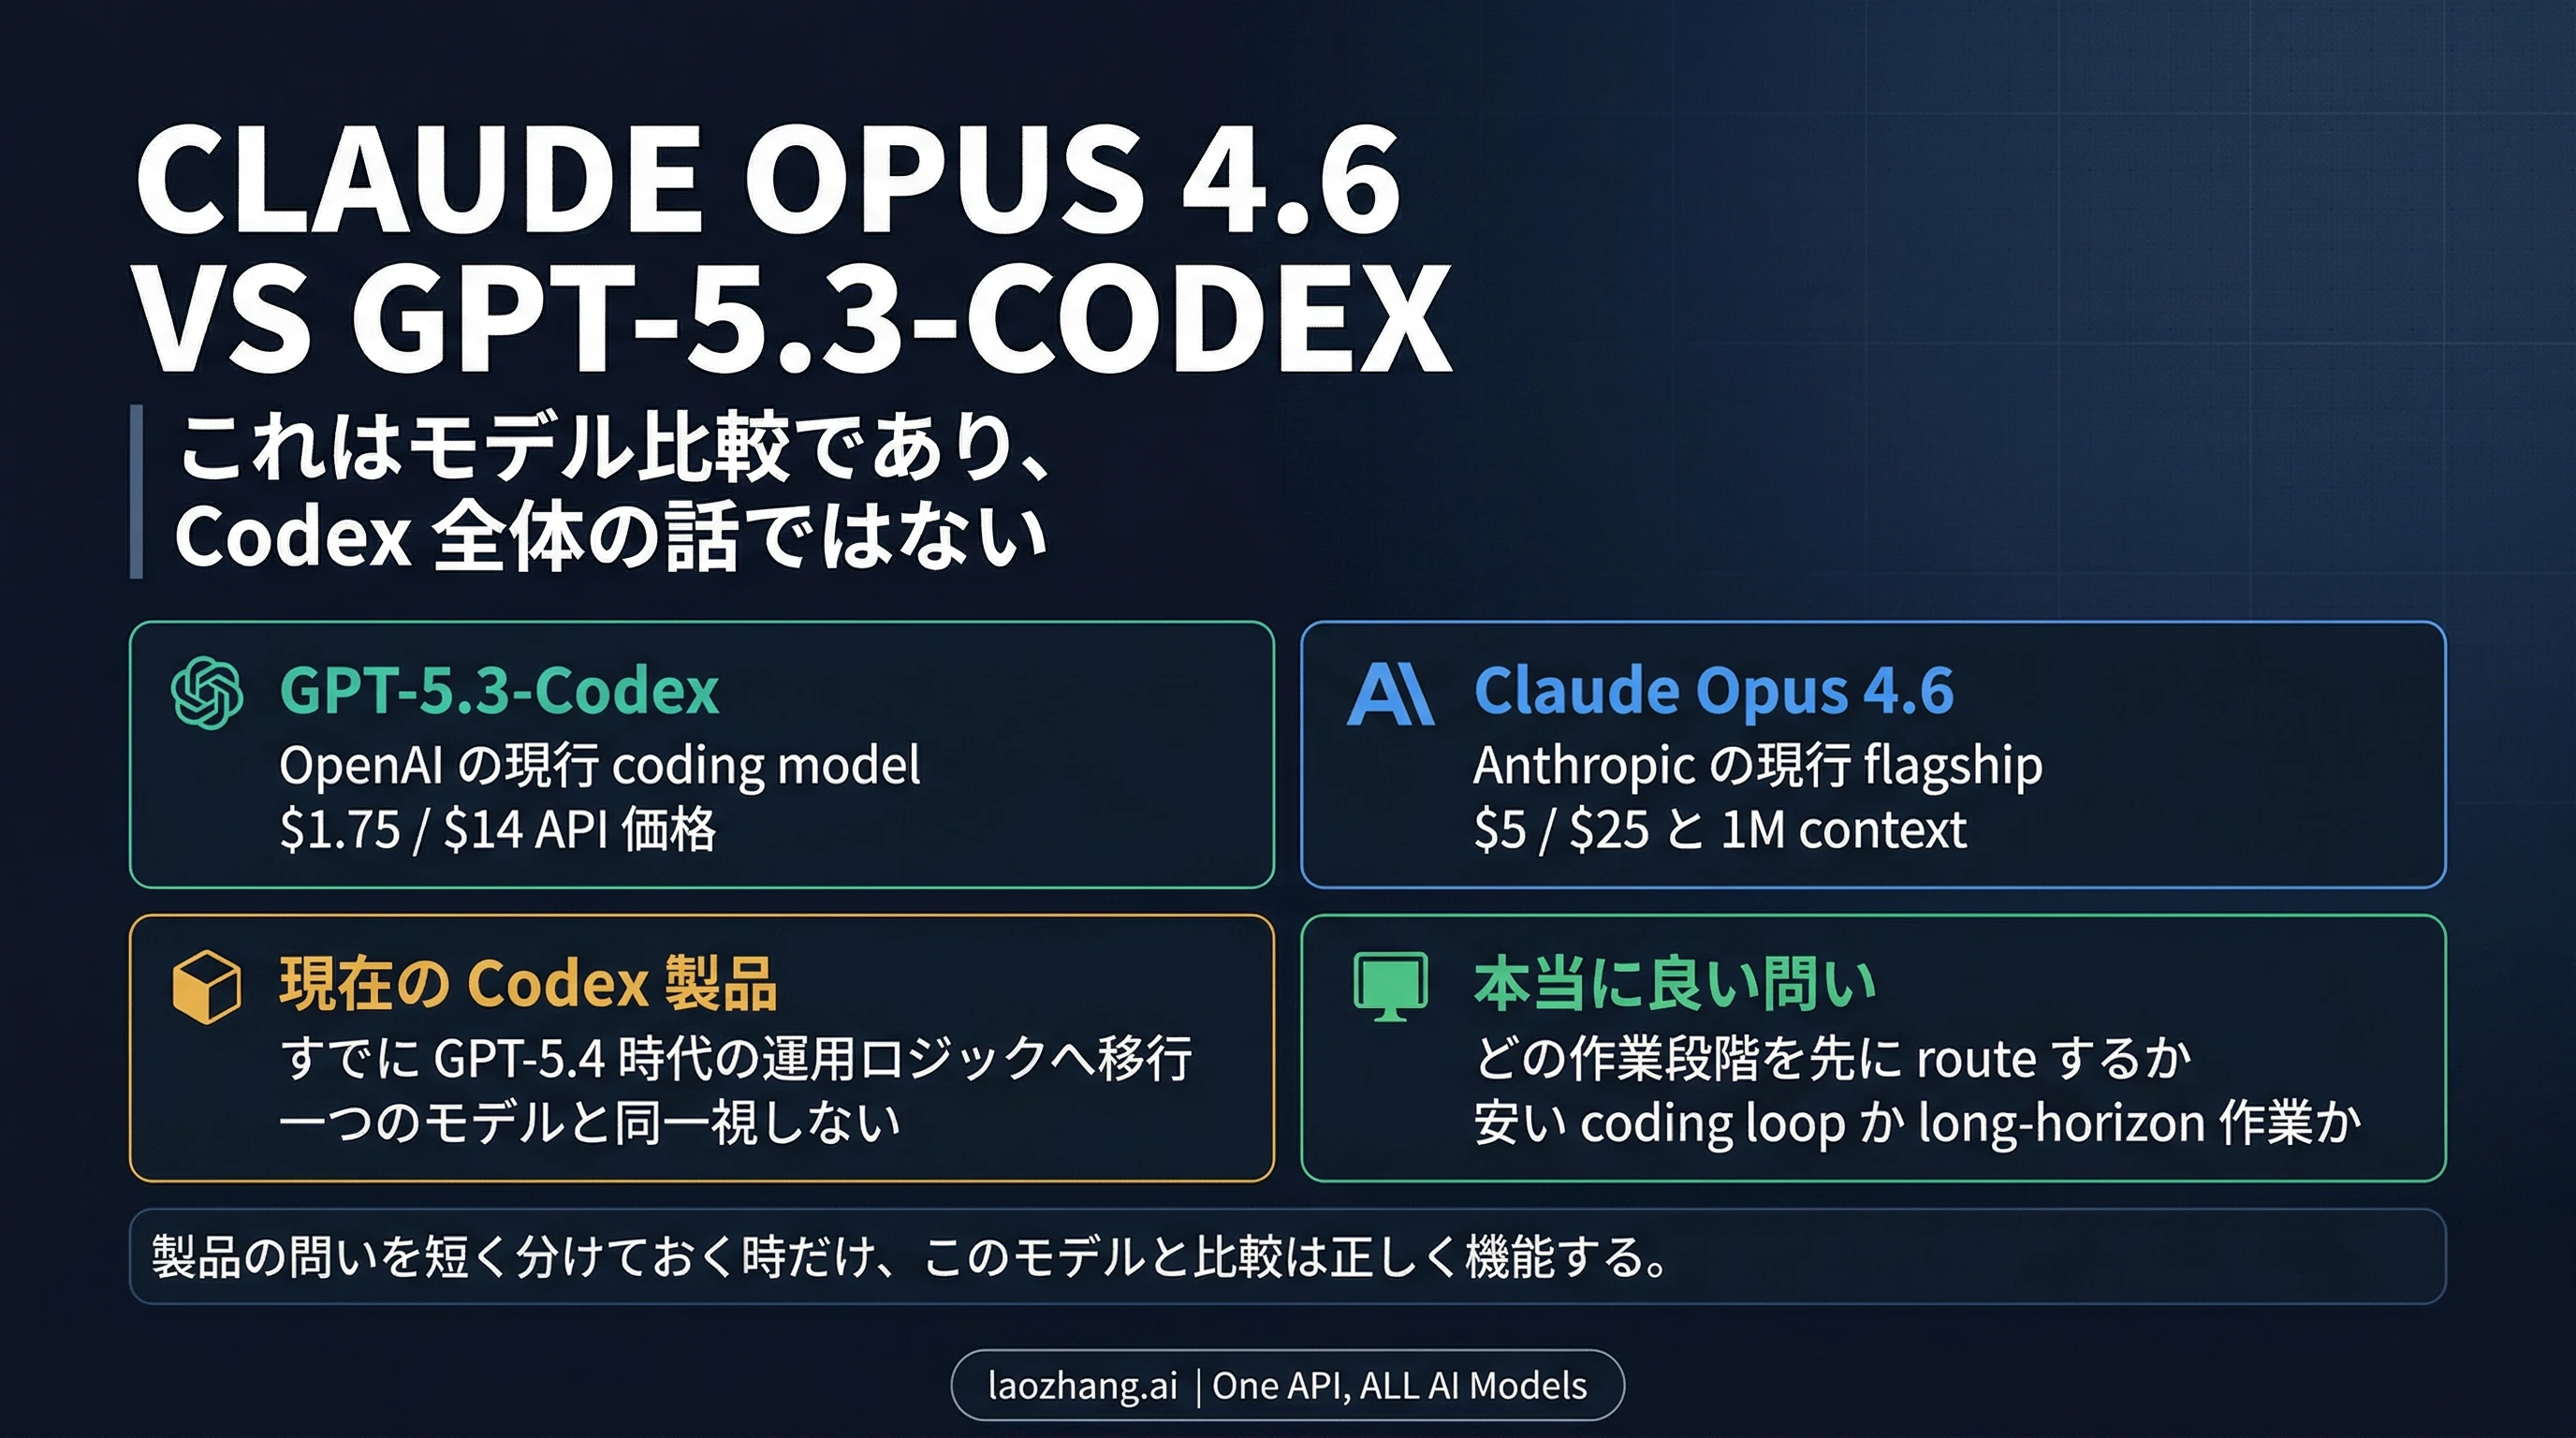
Claude Opus 4.6とGPT-5.3-Codexを既存の開発環境で選ぶなら、最初に確認したいのは必要な文脈が収まるか、採用できる修正をいくらで得られるかです。公式APIのトークン単価はGPT-5.3-Codexのほうが低く、コンテキストウィンドウはOpus 4.6のほうが大きい。ただし、この2点だけでコードの正しさや手直しの少なさまでは決まりません。
入力が両方の上限に収まり、まだ自分の作業での比較結果がないなら、GPT-5.3-Codexを費用面の基準として試せます。一方、分割しにくい大量の仕様・コードを一度に渡す必要があるなら、Opus 4.6の容量を先に検討する理由があります。いずれも、最後は同じ修正課題と合格条件で確かめるのが実用的です。
以下は2026年9月7日に確認した、この2つの指定モデルの比較です。API料金を扱い、月額サブスクリプションの利用枠とは分けています。端末操作、権限設定、IDE連携などの製品選びが目的なら、Claude CodeとCodexの比較も参照してください。
モデルの仕様と料金を同じ条件で並べる
OpenAIのGPT-5.3-Codexモデル仕様とAnthropicのOpus 4.6仕様に基づく比較です。料金は米ドル、100万トークン当たりの通常API料金で、Opusのキャッシュ費用はAnthropic料金表も参照しています。
| 項目 | GPT-5.3-Codex | Claude Opus 4.6 |
|---|---|---|
| モデルID | gpt-5.3-codex | claude-opus-4-6 |
| コンテキストウィンドウ | 400,000トークン | 1,000,000トークン |
| 通常の最大出力 | 128,000トークン | 128,000トークン |
| 通常入力 | $1.75 | $5.00 |
| キャッシュからの入力読み出し | $0.175 | $0.50 |
| キャッシュ書き込み | Opus型の保存期間別料金をこの表では適用しない | 5分:$6.25、1時間:$10.00 |
| 出力 | $14.00 | $25.00 |
| 思考量の設定 | low、medium、high、xhigh | adaptive thinkingに対応、effortの既定値はhigh |
Opus 4.6の1Mコンテキストには標準料金が適用されます。表の最大出力128Kは通常利用の値で、Batch APIのベータ機能には300K出力の例外があります。対話的なコーディングエージェントの出力上限を300Kとして計画しないでください。地域指定などの処理条件による追加費用は上の表に含めていません。
コンテキストウィンドウは、その全量をソースコードとして入力できるという意味ではありません。システム指示、会話、ツール結果、生成に必要な枠も考慮します。GPT-5.3-Codexでは最大入力272Kという制限もあるため、400Kのファイル群をそのまま投入する設計にはできません。入力上限と出力上限を別々に確認しましょう。
大きなリポジトリでも、対象モジュールと関連テストを抽出すれば小さい入力で済む場合があります。逆に、全体の仕様の整合性を調べる作業では、読むべき範囲が広がります。リポジトリの総行数よりも、その課題の解決に同時に必要な情報量を見積もるほうが、上限の差を判断しやすくなります。
1回の修正にかかるAPI費用を計算する
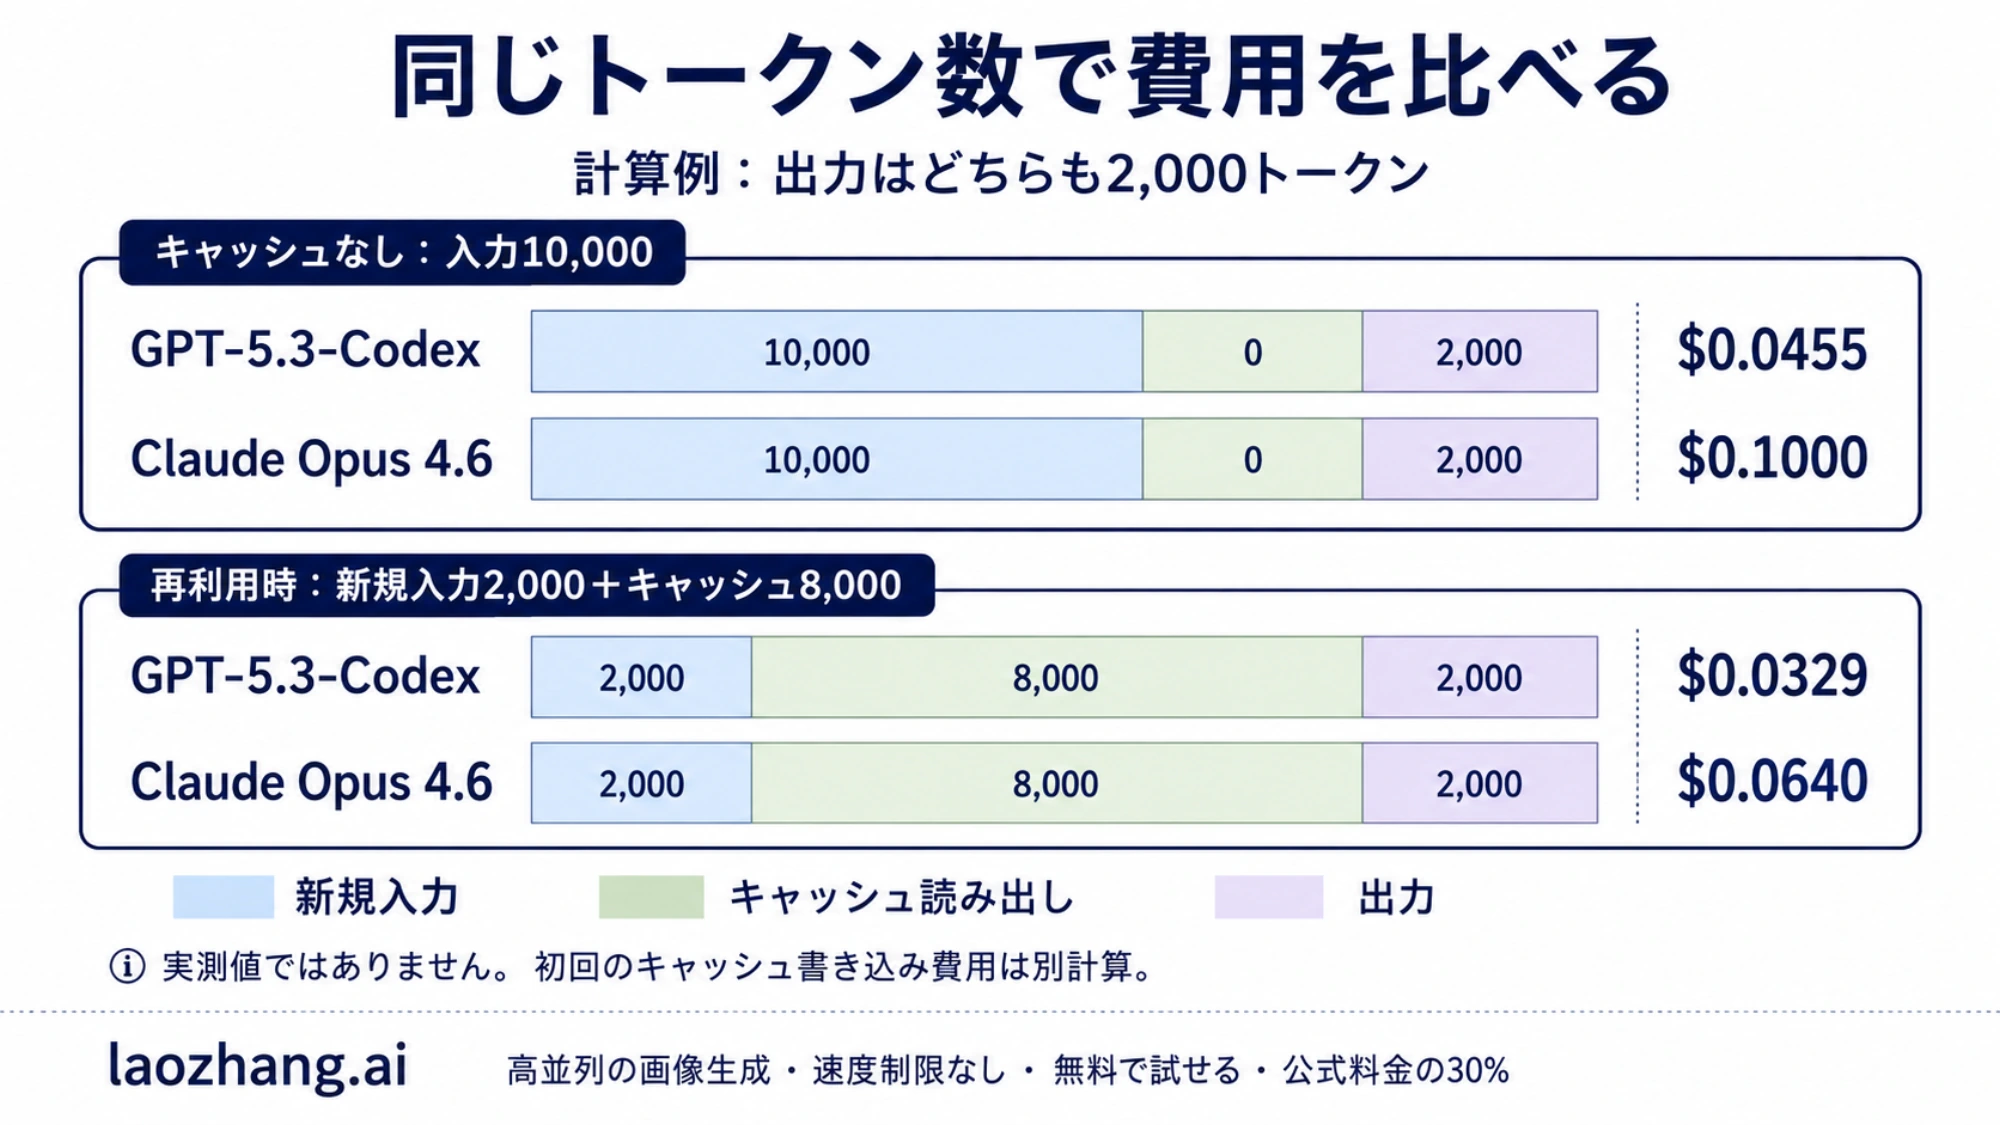
次の数値は実測ではなく、単価差を見るための計算例です。両モデルとも入力10,000トークン、出力2,000トークンと仮定します。同じ日本語やコードを渡してもモデルごとのトークン数は一致するとは限らず、実際の作業ではツール結果や再試行も追加されます。
キャッシュを使わない場合
計算式は「通常入力数×入力単価+出力数×出力単価」を100万で割ったものです。
| モデル | 計算 | 合計 |
|---|---|---|
| GPT-5.3-Codex | 10,000×$1.75÷1,000,000+2,000×$14÷1,000,000 | $0.0455 |
| Claude Opus 4.6 | 10,000×$5÷1,000,000+2,000×$25÷1,000,000 | $0.1000 |
この条件ではGPT-5.3-CodexのAPI費用が低くなります。ただし、片方が1回で修正を完了し、もう片方が何度も失敗するなら、比較すべき値は最終的な合計です。「1回の応答が安い」と「採用できる修正が安い」は別々に記録する必要があります。
共通の文脈8,000トークンを再利用する場合
入力のうち8,000トークンがキャッシュにヒットし、新規入力が2,000トークン、出力が2,000トークンなら、費用は次のようになります。保存済みの文脈を読み出す呼び出しだけを比べています。
| モデル | 新規入力 | キャッシュ読み出し | 出力 | 合計 |
|---|---|---|---|---|
| GPT-5.3-Codex | $0.0035 | $0.0014 | $0.0280 | $0.0329 |
| Claude Opus 4.6 | $0.0100 | $0.0040 | $0.0500 | $0.0640 |
Opusではキャッシュを作る呼び出しの費用も見ます。同じ8,000トークンを書き込み、新規入力2,000・出力2,000を処理すると、5分キャッシュなら$0.1100、1時間キャッシュなら$0.1400です。書き込んだ8,000トークンを通常入力としても二重に加算しないようにします。
たとえばOpusで「5分キャッシュを作る1回+その有効期間内に読み出す4回」がすべて上記の量なら、合計は$0.1100+4×$0.0640=$0.3660です。5回ともキャッシュなしなら$0.5000になります。これは5回のキャッシュ条件が成立した場合の算数であり、実行すれば必ずこの請求額になるという予測ではありません。
実際の比較では、通常入力・キャッシュ書き込み・キャッシュ読み出し・出力の使用量を保存してください。キャッシュヒットを設定したつもりでも、入力の変更や有効期間によって結果は変わります。APIの使用量と、作業全体で消費した費用を突き合わせると、単価差と使い方の差を分けて把握できます。
公開ベンチマークから分かること、分からないこと
GPT-5.3-Codexの発表記事には、Terminal-Bench 2.0などの結果と評価条件が掲載されています。Opus 4.6の発表記事でも、ターミナル作業や長い文脈を扱う能力が説明されています。どちらも候補に入れる根拠にはなりますが、公開値を並べただけで、自社の修正課題での勝敗は決まりません。
Terminal-Benchのようなターミナル課題でも、モデルに渡す指示、使用可能なツール、思考量、時間制限が結果を左右します。OpenAIの発表時評価はxhigh条件です。別の設定で動かす実装に、その結果をそのまま当てはめるのは適切ではありません。また、OSWorldはGUI操作の評価であり、点数からコードレビューでの欠陥率や保守性を直接推定することはできません。
「長い文脈が入るから手戻りが減る」という結論も、仕様表だけでは出せません。必要な仕様を保持できる利点はありますが、重要な制約を実装に反映できたかどうかは、成果物で確認します。大量のファイルを渡すより、関係する部分を適切に選んだほうがよい場合もあります。
公開の作例で美しい画面や大きな変更ができていても、単一の成功例です。自分の課題では、画面の見た目に加えて既存機能の維持、例外処理、テストの妥当性まで確かめましょう。
既存リポジトリで比べるための実施手順
ここでは、ページ番号付きAPIをカーソル方式へ変更する課題を例にします。この記事で両モデルを実行した結果ではなく、チームで再現できる比較方法の提案です。実案件に合わせて課題を置き換えてください。
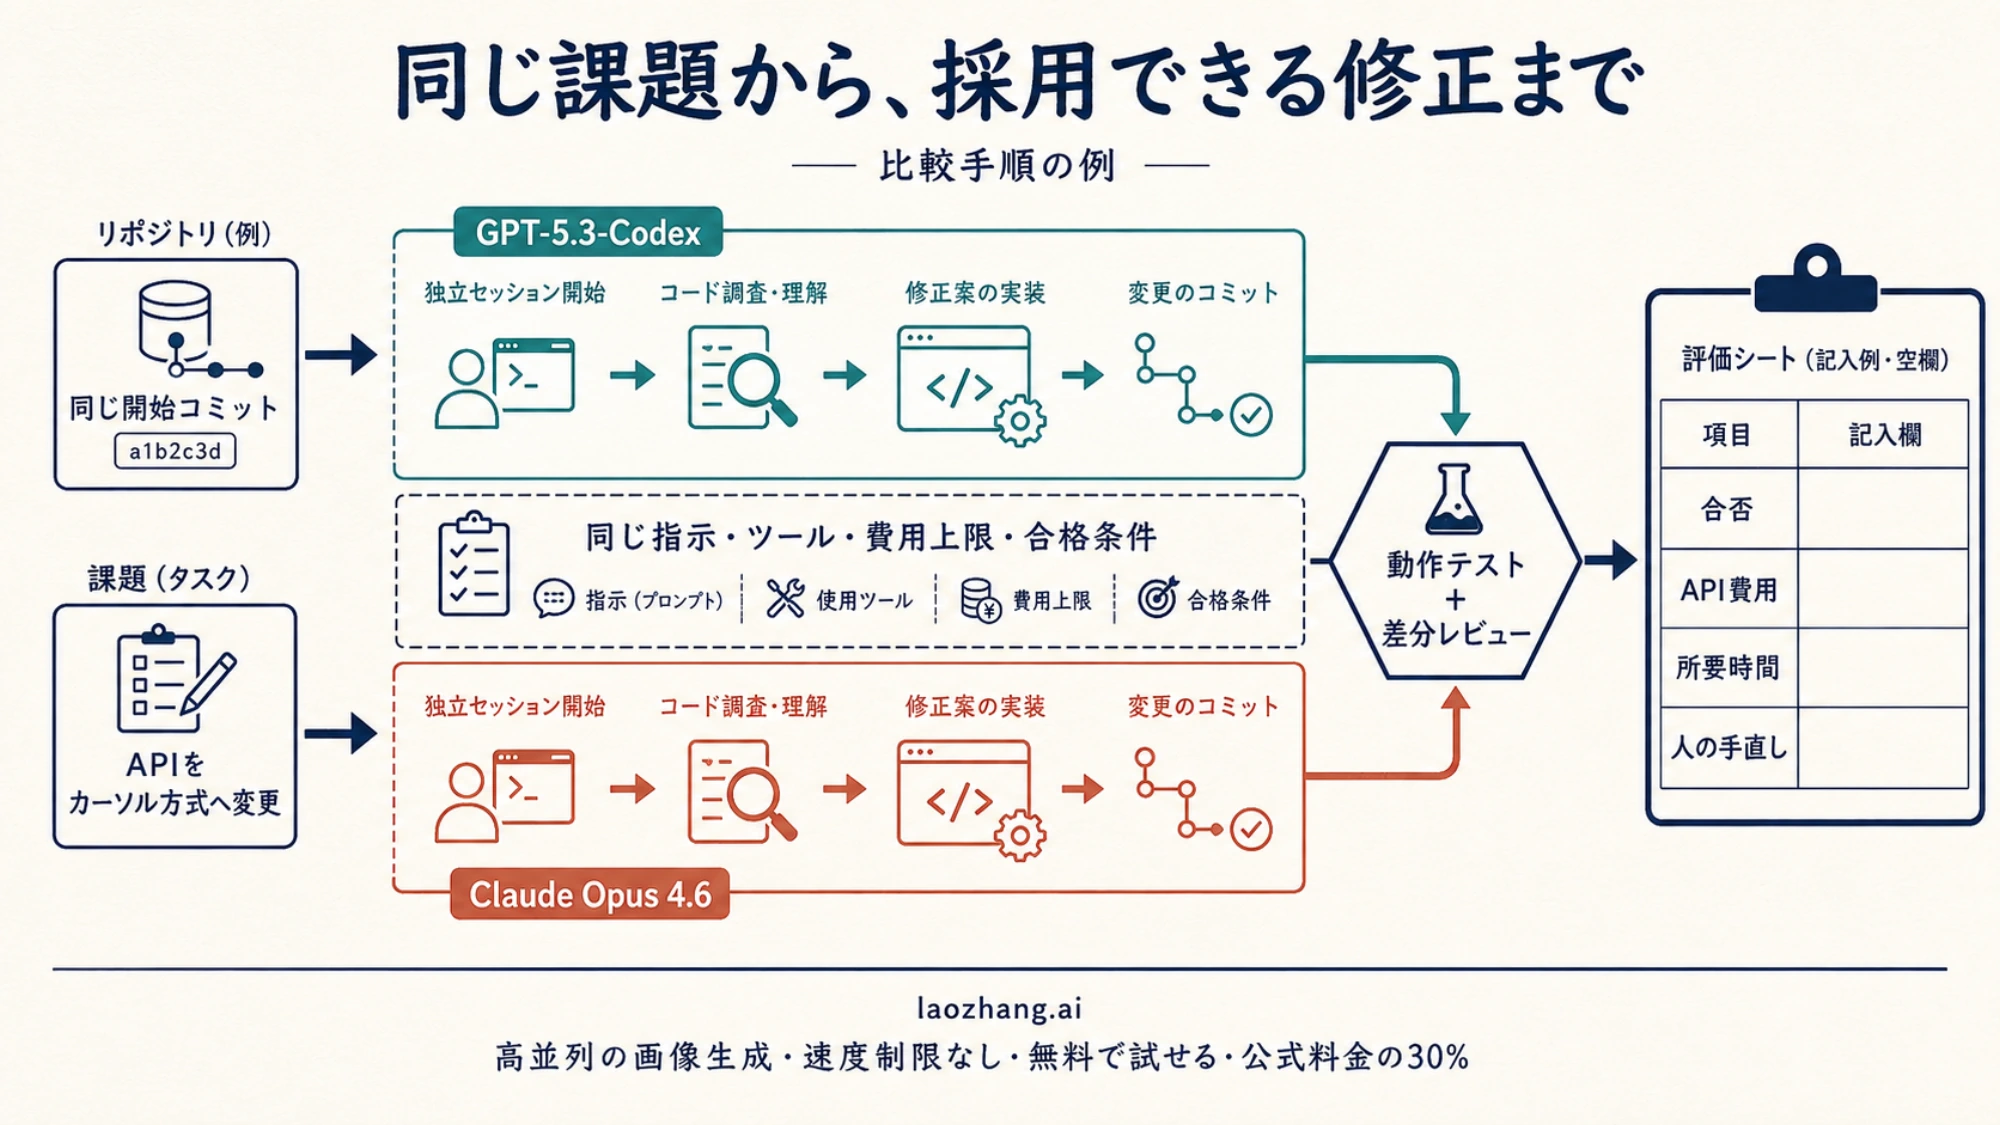
まず、開始コミットと合格条件を固定します。たとえば「重複なく次の20件を取得できる」「不正なカーソルを拒否する」「既存の絞り込み条件を維持する」「API利用側を更新する」「仕様に対応するテストを追加する」と決めます。回答の流暢さではなく、変更後の動作で採点できる条件にします。
次に、同じGitコミットから2つの独立した作業ディレクトリを用意します。同じ依存関係、環境変数、初期データを使い、新しいセッションから開始してください。片方のパッチや説明をもう片方へ渡すと、独立した比較にはなりません。
| そろえる条件 | 記録する内容 |
|---|---|
| 作業指示と渡す資料 | 同じ課題文、仕様、対象コード、禁止する変更 |
| ツールと権限 | 実行できるコマンド、ネットワーク利用、ファイル操作の範囲 |
| 実行の上限 | 最大費用、制限時間、追加指示を出す条件 |
| モデル設定 | 正確なモデルID、思考設定、最大出力、キャッシュ条件 |
| 合格判定 | 機能テスト、回帰テスト、変更差分のレビュー |
思考設定の名前が似ていても、2社で同じ計算量を意味するとは限りません。「両方highなので公平」とせず、設定と実際の費用・所要時間を一緒に残します。普段使う設定での比較と、一定の費用上限でどこまで完了できるかの比較を分けてもよいでしょう。
実行後は、まず同じ検証コマンドで成果物を判定し、次に差分を読みます。課題外のファイル変更、不十分な境界条件、テストを弱めただけの修正がないかを確認します。成功したように見える報告だけで採用を決めないことが大切です。
記録用の表は、空欄から始めます。ここに架空の結果を入れる必要はありません。
| 記録項目 | GPT-5.3-Codex | Claude Opus 4.6 |
|---|---|---|
| 全合格条件を満たしたか | 実行後に記録 | 実行後に記録 |
| API費用の合計 | 実行後に記録 | 実行後に記録 |
| 完了までの時間 | 実行後に記録 | 実行後に記録 |
| 追加指示・再試行の回数 | 実行後に記録 | 実行後に記録 |
| 人が修正した内容と時間 | 実行後に記録 | 実行後に記録 |
最初の1件で差が出ても、担当業務全体の結論にはしません。不具合修正、複数ファイルの変更、仕様を読んで行う実装など、普段の作業から少数の代表例を選びます。失敗した実行も費用に含め、「合格した修正1件当たりのAPI費用」と「人が使った修正時間」を並べると、導入後の負担を判断しやすくなります。
比較結果を採用判断につなげる
両方が同じ合格条件を満たし、人の手直しにも大差がなければ、費用と既存環境への組み込みやすさで選べます。GPT-5.3-Codexの低い単価は、その条件で実際のメリットになります。
必要な入力がGPT-5.3-Codexの上限を超えるなら、情報を抽出・分割する設計と、Opus 4.6にまとめて渡す設計を比較します。Opusの容量は後者を試せる根拠ですが、品質の保証ではありません。抽出処理の開発・保守が増えることも含め、作業全体で判断してください。
片方だけが特定の課題を完了できた場合は、その課題群で採用範囲を決めます。すべての作業を一度に切り替えたり、最初から2モデルの併用を必須にしたりする必要はありません。自分のリポジトリで合格した変更、実際の費用、人の手直しがそろって初めて、この2モデルの選び方を具体化できます。