Claude Fable 5.1とOpus 5の料金比較:実コストの判断基準
通常の入力と出力はOpus 5が半額、キャッシュ読み取りはFable 5.1が半額です。自社のトークン使用量と、要求を満たして完了したタスクの割合から総費用を比較します。
目次
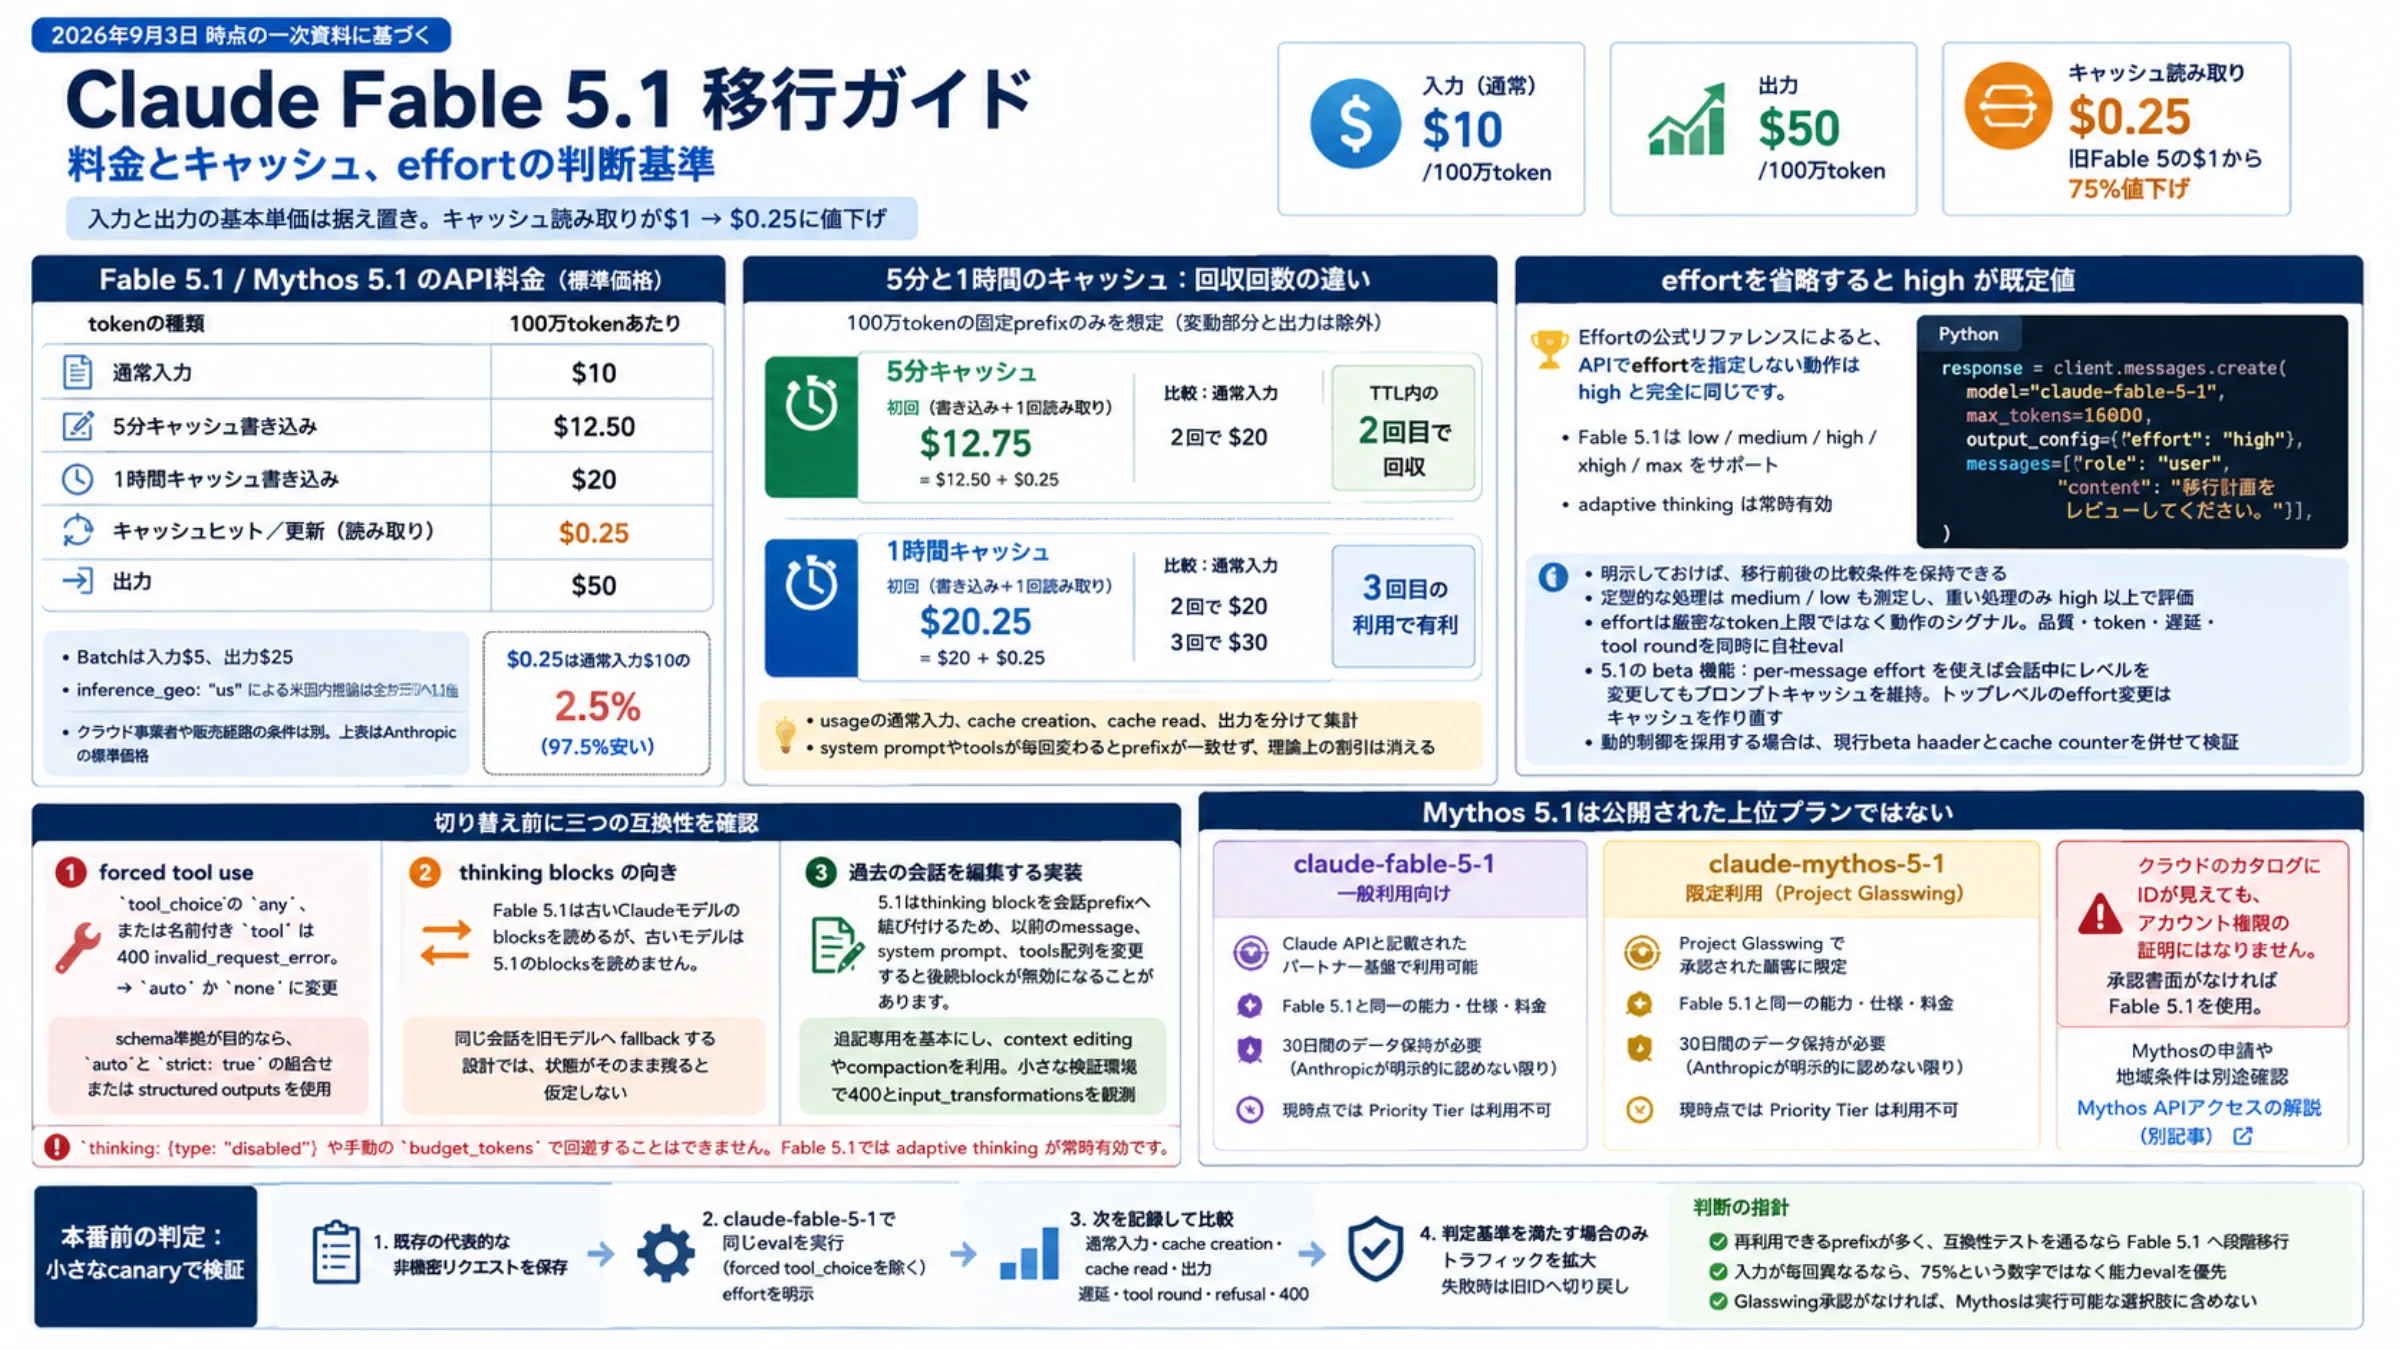
一般的なAPI処理なら、まずClaude Opus 5を試すのが合理的です。通常入力、キャッシュ書き込み、出力は、いずれもClaude Fable 5.1の半額です。ただしキャッシュ読み取りだけは逆で、Fable 5.1が100万トークン当たり$0.25、Opus 5が$0.50です。
したがって「Fableは2倍高い」と「Fableのキャッシュは安い」は同時に成り立ちます。どちらが総額で有利かは、通常入力、書き込み、読み取り、出力、推論の強度(effort)、再試行、最終的な合格率を分けて記録しないと判断できません。
以下は2026年9月3日にClaude Platformの一次資料で確認した内容です。両モデルは100万トークンのコンテキスト、128Kの最大出力、既定のhigh effortを掲載しています。クラウド事業者、個別契約、提供地域では条件が変わり得ます。
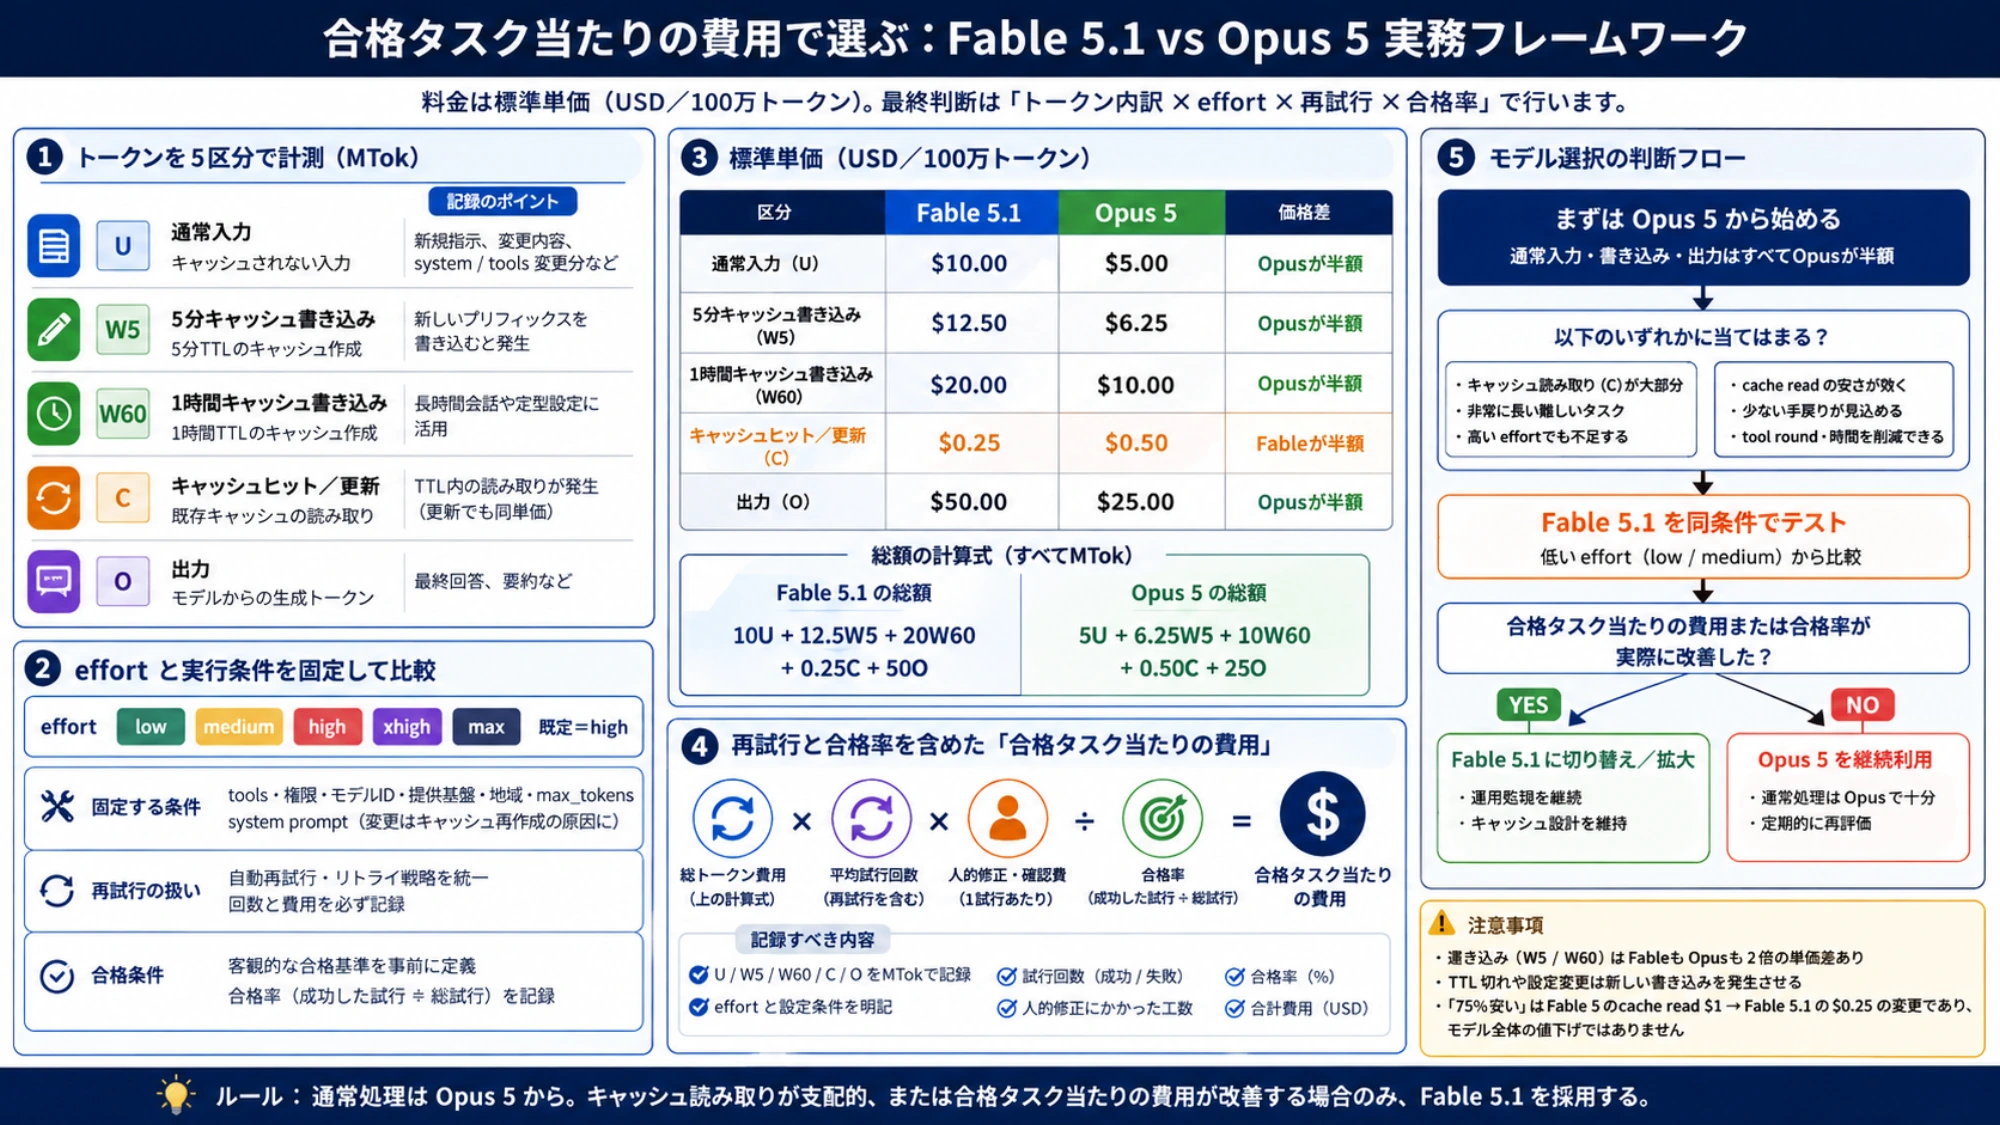
API単価は4項目でOpus、1項目でFableが安い
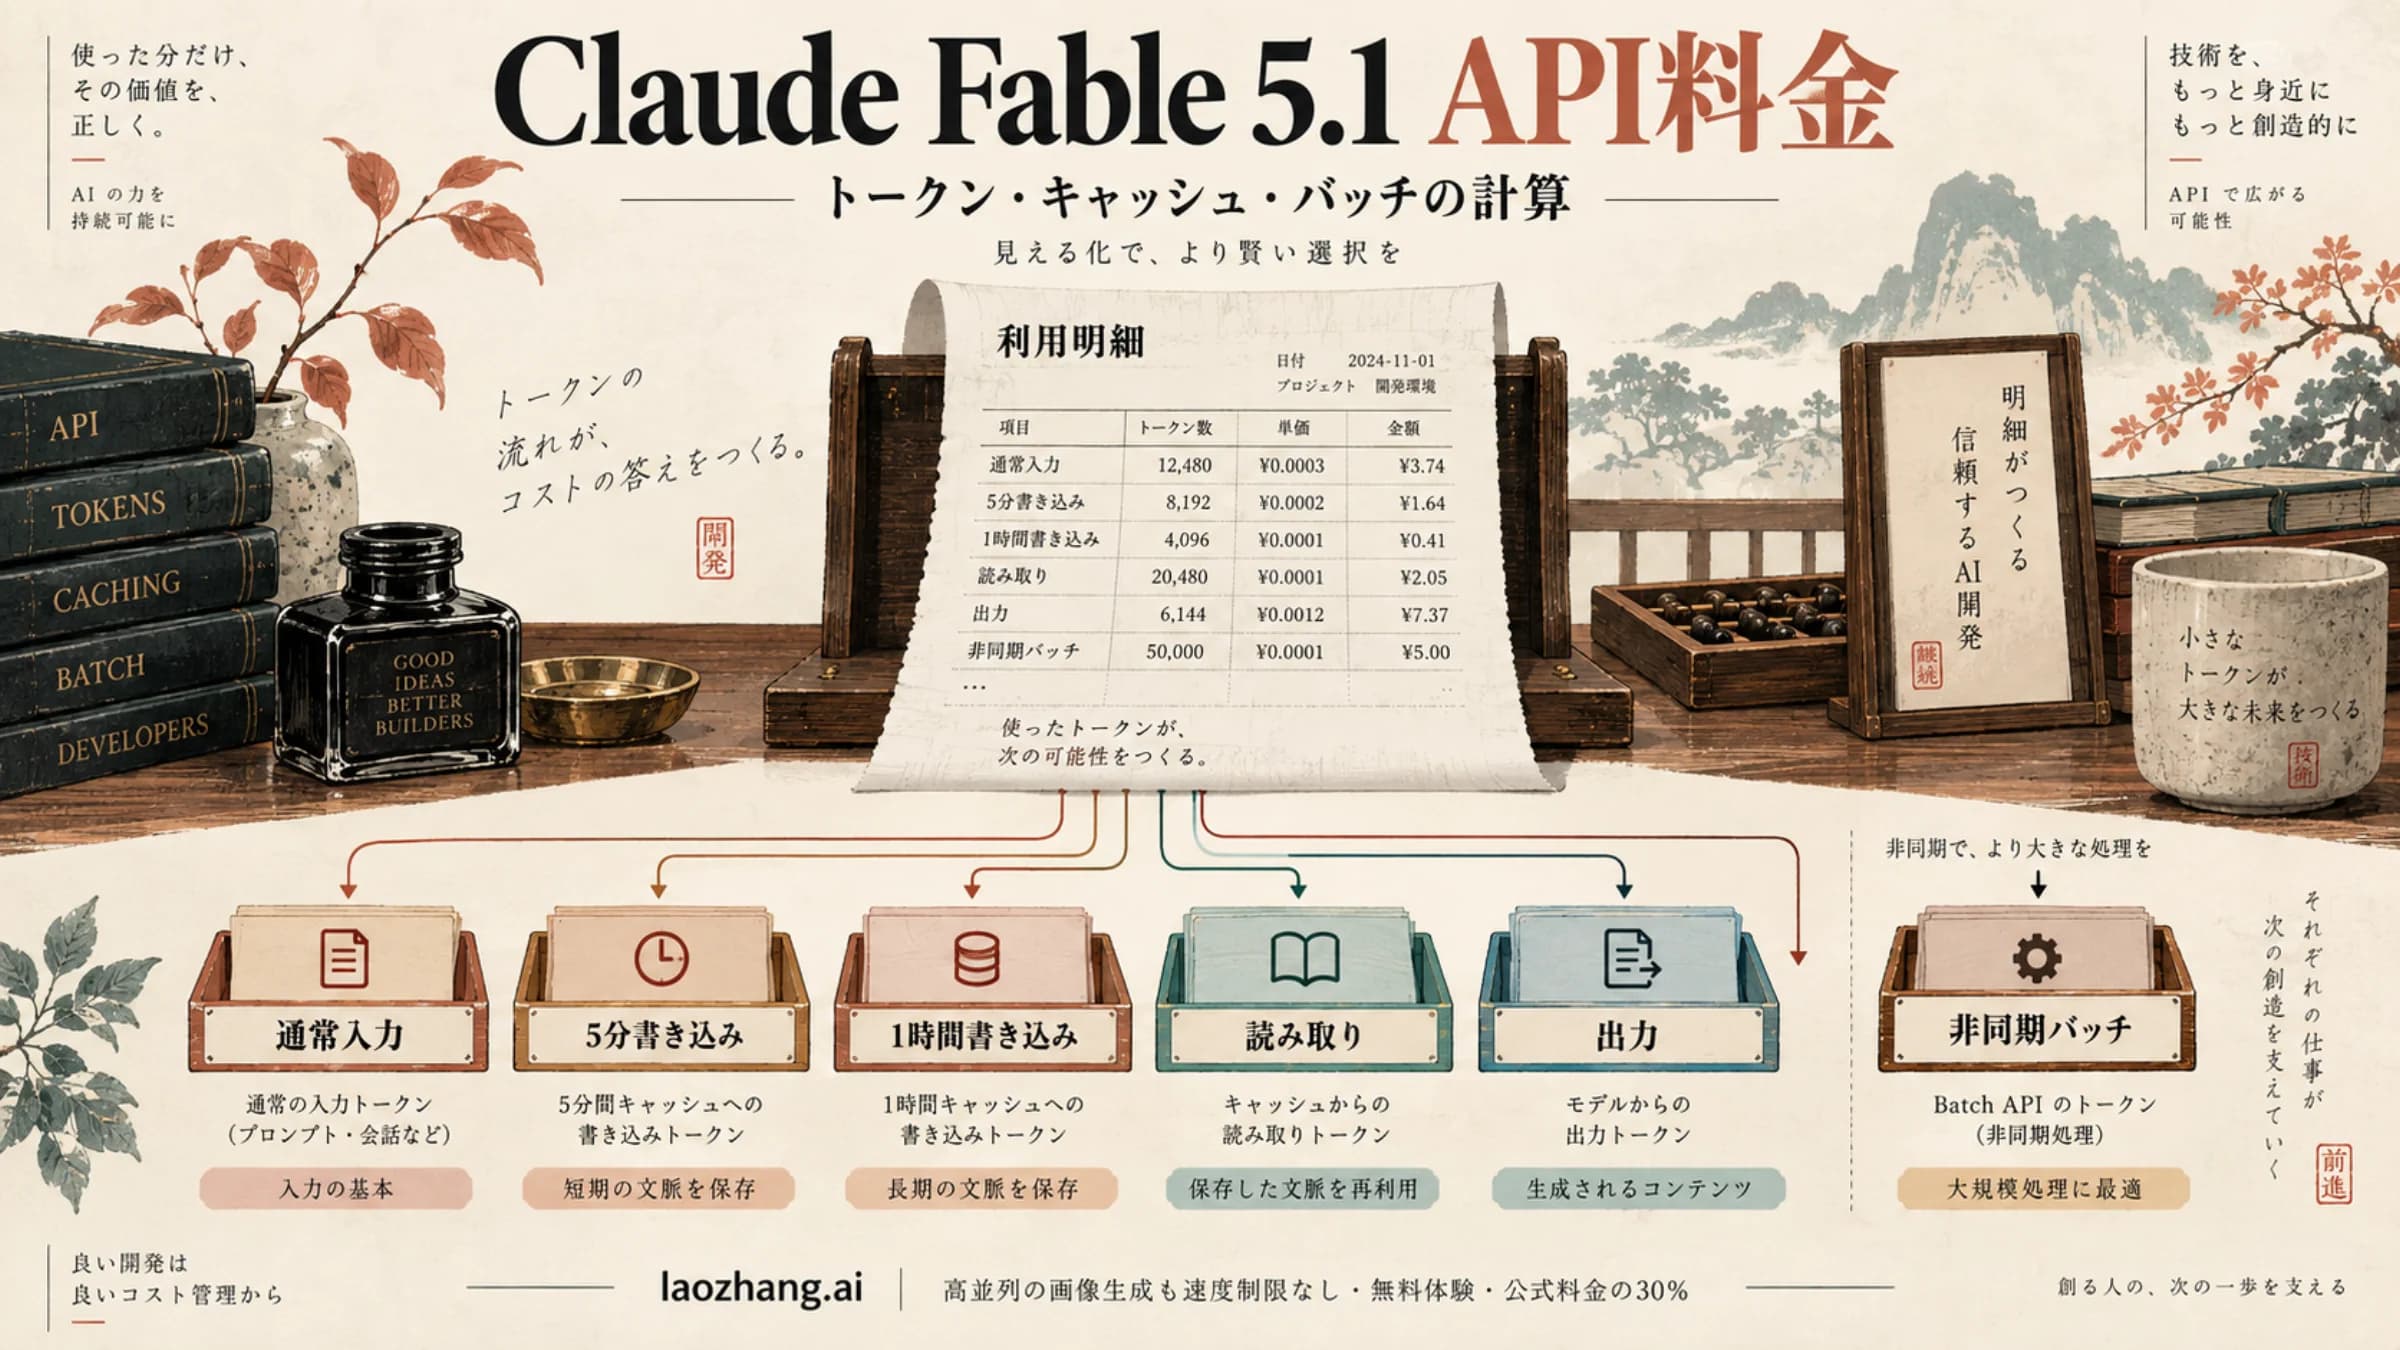
Claude APIの料金表にある標準価格を同じ単位にそろえると、差が見えます。
| 100万トークン当たり | Fable 5.1 | Opus 5 |
|---|---|---|
| 通常入力 | $10 | $5 |
| 5分キャッシュ書き込み | $12.50 | $6.25 |
| 1時間キャッシュ書き込み | $20 | $10 |
| キャッシュヒット/更新 | $0.25 | $0.50 |
| 出力 | $50 | $25 |
Batchは両モデルの通常入力と出力を半額にするため、同じトークン量なら2対1の関係は変わりません。対応するAnthropicの直接提供環境でinference_geo: "us"を指定すると1.1倍になります。Opus 5のfast modeは別単価です。
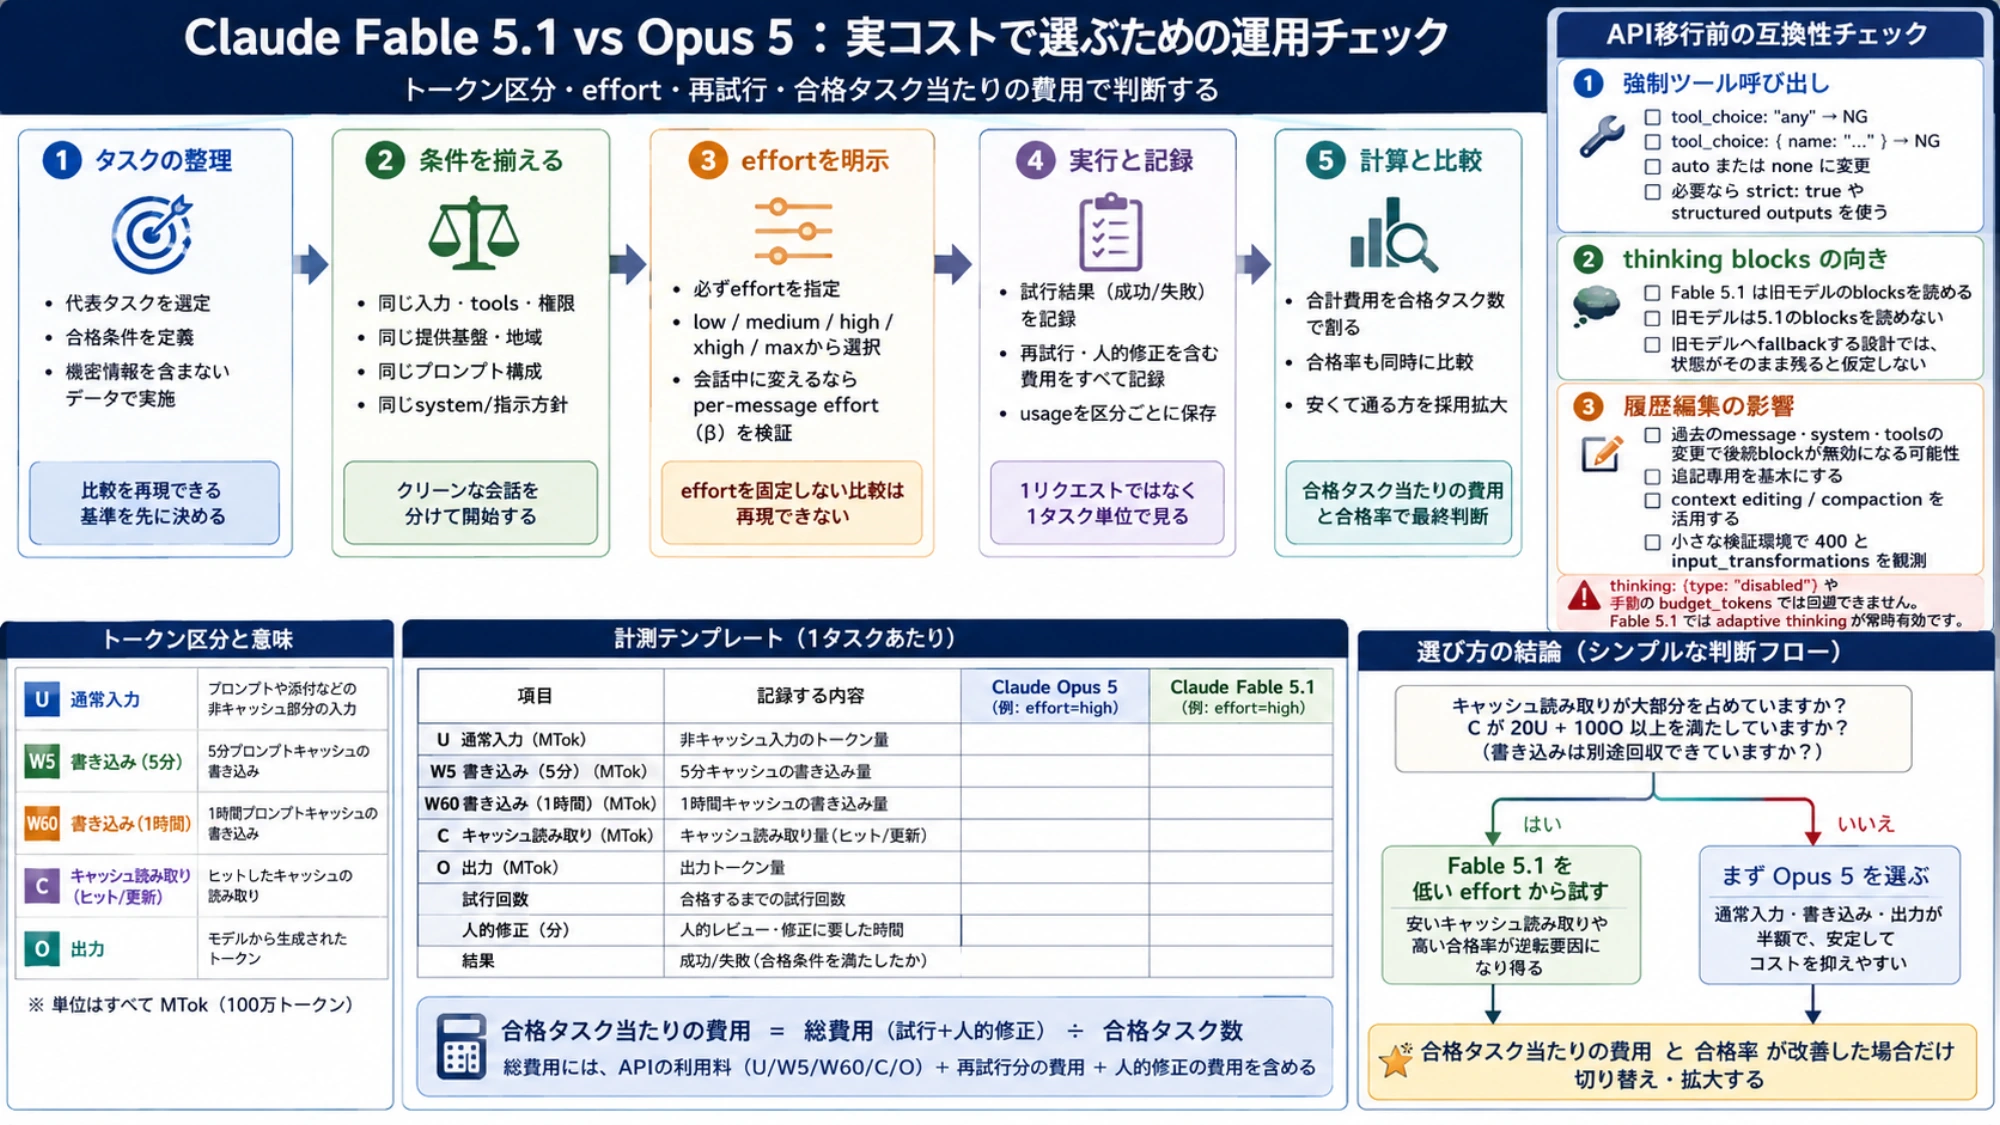
通常入力をU、5分と1時間の書き込みをW5とW60、読み取りをC、出力をOとし、すべて100万トークン単位(MTok)で表すと次の式になります。
Fable 5.1 = 10U + 12.5W5 + 20W60 + 0.25C + 50O
Opus 5 = 5U + 6.25W5 + 10W60 + 0.50C + 25Oキャッシュ読み取りで逆転する境界を計算する
書き込みと追加係数をいったん除くと、Fableの総額がOpus以下になる条件は次のように整理できます。
C >= 20U + 100Oたとえば通常入力0.01 MTok、キャッシュ読み取り2 MTok、出力0.002 MTokで、書き込み料金を別の処理で計上済みと仮定するなら、Fableは$0.70、Opusは$1.10です。通常入力0.02 MTok、読み取り0.8 MTok、出力0.01 MTokなら、Fableは$0.90、Opusは$0.75に変わります。出力の単価差が大きいためです。
実運用では書き込みを除外できません。Fableの書き込み単価もOpusの2倍です。TTL切れ、システム指示やtools配列の変更は新しい書き込みを発生させます。usageの各区分を分けて保存してください。Claude Codeで急に利用量が増えた場合は、キャッシュミスの診断記事で別の原因を確認できます。
「75%安い」はFable 5のキャッシュ読み取り単価$1からFable 5.1の$0.25への変更を指し、モデル全体の値下げではありません。
公開ベンチマークより自社の合格条件を優先する
Anthropicのコスト最適化ガイドでは、同社のSWE-bench Pro subsetで既定設定のFable 5.1が92.1%、既定設定のOpus 5が91.7%でした。差は実行ごとのばらつき内で、解決1件当たりはFable $1.19、Opus $1.01と、Opusが約15%安い結果です。
一方、同じ資料の別のAdvisor coding構成では、Fable 5.1 mediumが既定設定のOpus 5と同等の結果を、1試行$2.91対$8.50で記録しています。これはAnthropic自身の特定条件の測定であり、独立ランキングでも自社コードの予測でもありません。条件によって順位が変わること自体が重要です。
effortを固定しない比較は再現できない
Effortの公式リファレンスでは、APIでeffortを指定しない動作はhighと完全に同じです。Fable 5.1はlow、medium、high、xhigh、maxをサポートし、適応型思考は常時有効です。
response = client.messages.create(
    model="claude-fable-5-1",
    max_tokens=16000,
    output_config={"effort": "high"},
    messages=[{"role": "user", "content": "移行計画をレビューしてください。"}],
)
公式のモデル概要は、多くの処理でOpus 5から始め、長時間の難しい処理やOpusを高いeffortで実行しても不足する場合にFable 5.1を使うよう案内しています。最初から長いエージェント処理と分かっているなら、Fableのlowまたはmediumも初回比較に含められます。effortは厳密なトークン上限ではないため、品質、消費トークン数、待ち時間、ツールとの往復回数を一緒に測ります。
5.1では、ベータ版のメッセージ単位のeffort設定を使うと、会話中に推論の強度を変えてもプロンプトキャッシュを維持できます。一方、リクエストのトップレベルでeffortを変更すると、キャッシュは作り直されます。会話中に設定を変える実装では、必要なベータ版ヘッダーを確認し、キャッシュの使用量も記録してください。
切り替え前に三つの互換性を確認する
公式の移行ガイドで、最初に確認すべき点は次の三つです。
一つ目は、ツール使用を強制する設定です。tool_choiceのany、または名前付きtoolは400 invalid_request_errorになります。autoかnoneへ変更します。スキーマへの準拠が目的なら、autoとstrict: trueを組み合わせるか構造化出力を使います。
二つ目は、思考ブロックの互換性です。Fable 5.1は旧Claudeモデルの思考ブロックを読めますが、旧モデルは5.1の思考ブロックを読めません。同じ会話を旧モデルへ切り替える設計では、履歴をそのまま引き継げるとは限りません。
三つ目は過去の会話を編集する実装です。Fable 5.1は思考ブロックをそれ以前の会話内容に結び付けるため、過去のメッセージ、システム指示やtools配列を変更すると、後続の思考ブロックが無効になることがあります。自前でmessagesを構築する場合は追記を基本にし、履歴の整理にはコンテキスト編集や圧縮機能を利用します。アカウント作成時期によって適用段階が異なるため、小さな検証環境で400とinput_transformationsを観測します。
thinking: {type: "disabled"}や手動のbudget_tokensで回避することはできません。Fable 5.1では適応型思考が常時有効です。
Mythos 5.1は公開された上位プランではない
Fable 5.1の新機能ページによると、Fable 5.1とMythos 5.1は能力、仕様、料金を共有します。実務上の違いは利用資格です。
claude-fable-5-1はClaude APIと記載されたパートナー基盤で一般顧客が利用できます。claude-mythos-5-1はProject Glasswingで承認された顧客に限定されます。- どちらもAnthropicが明示的に認めない限り30日間のデータ保持が必要です。
- 現時点ではPriority Tierを利用できません。
クラウドのカタログにIDが見えても、アカウント権限の証明にはなりません。承認書面がなければFable 5.1を使い、Mythosの申請や地域条件はMythos APIアクセスの解説で別に確認します。
1リクエストではなく合格した1タスクで割る
機密情報を含まない少数の代表タスクを選び、claude-opus-5とclaude-fable-5-1へ同じ入力、ツール、権限、提供基盤、合格条件を与えます。effortは明示します。長い会話の途中でモデルを変えると、履歴の再読み込みとキャッシュ再作成が混ざるため、クリーンな会話を分けて開始します。
再試行を含む全試行のAPI費用に、手作業の修正時間を金額に換算して加え、要求を満たして完了したタスク数で割ります。API費用に含まれる再試行分は重複して加算しません。Opusが安定して通るなら、通常単価の低さからそのまま採用しやすいでしょう。Fableの利用を広げるのは、キャッシュ読み取りの安さや手戻り・ツール往復の少なさ、高い合格率による利点が、入力と出力の割増料金を上回る場合です。
判断基準は明確です。通常処理はOpus 5から始める。非常に長い難問、またはキャッシュ読み取りが大部分を占める処理では、Fable 5.1を低いeffortから同条件で試す。合格タスク当たりの費用か合格率が実際に改善した場合だけ切り替える。Glasswing承認がなければMythosは実行可能な選択肢に含めません。
参考資料5
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年9月3日。
参考資料5
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年9月3日。
- 1.Claude APIの料金表platform.claude.com/docs/en/about-claude/pricing
- 2.Anthropicのコスト最適化ガイドplatform.claude.com/docs/en/about-claude/models/optimizing-for-cost-and-intelligence
- 3.Effortの公式リファレンスplatform.claude.com/docs/en/build-with-claude/effort
- 4.公式の移行ガイドplatform.claude.com/docs/en/models/fable-5-1/migration-guide
- 5.Fable 5.1の新機能ページplatform.claude.com/docs/en/models/fable-5-1/whats-new-fable-5-1