Gemini 4 Argon vs Claude Fable 5.1 怎么选:同题实测与涨价后成本
AA 指数 v5.0.1 上两者持平;同题实测都全部通过,日常题上 Fable 5.1 花费是 Argon 默认档的 8.6 倍,Argon 12 月涨价后约 4.3 倍。
文章目录
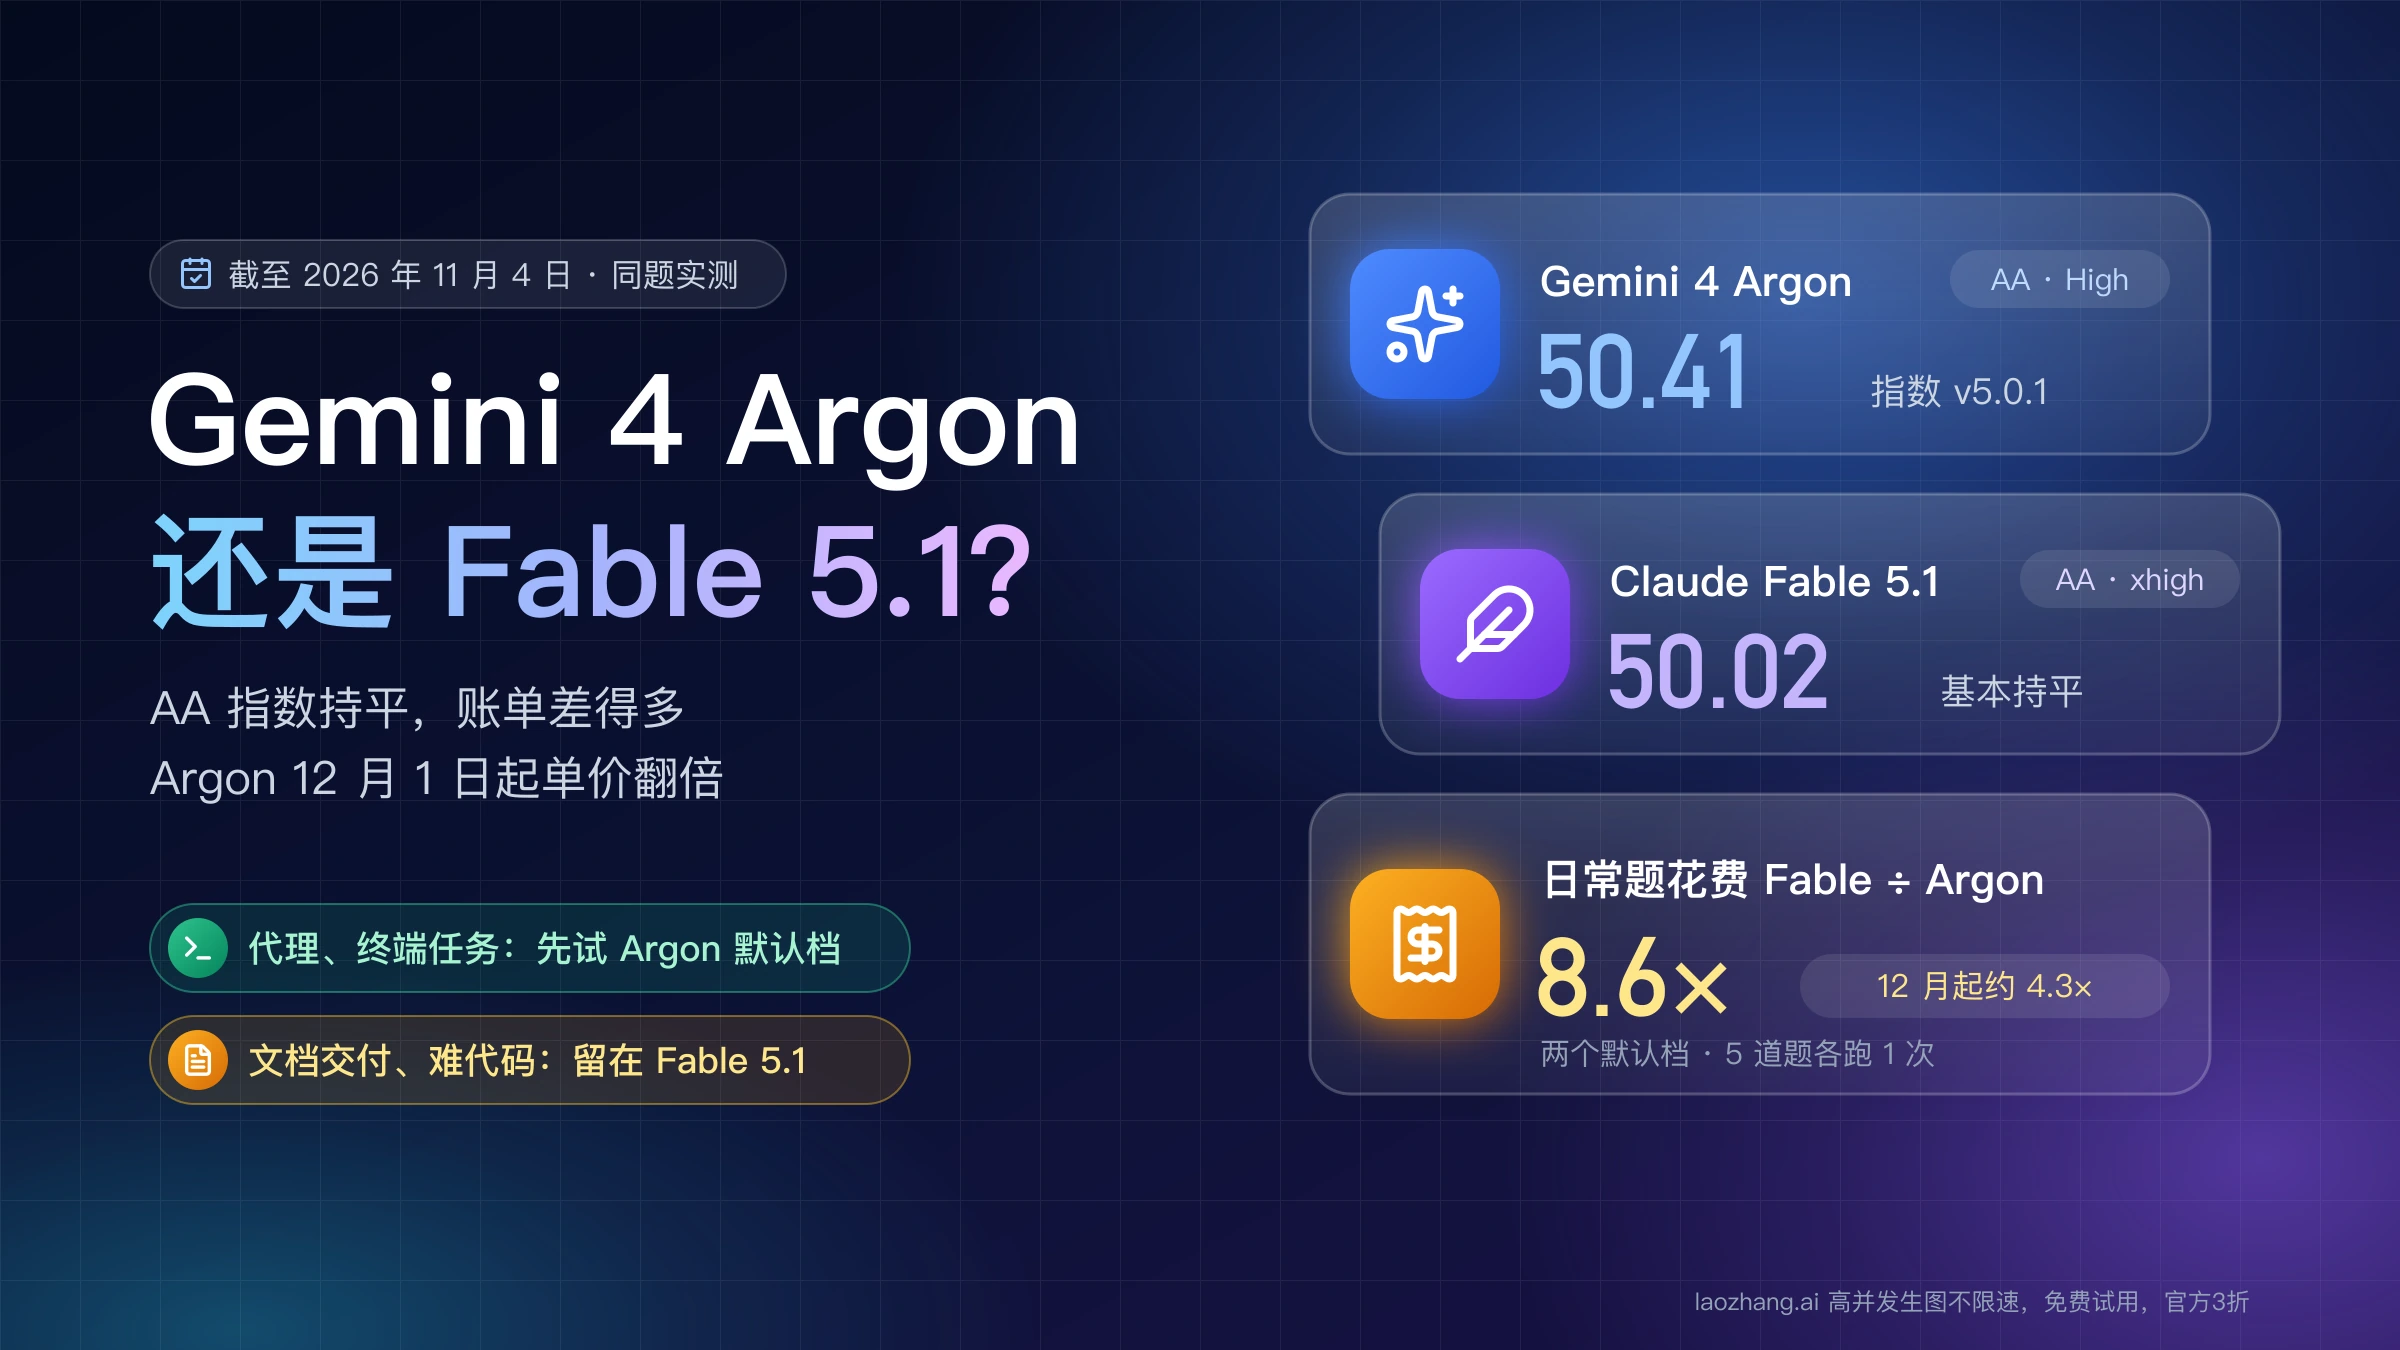
在 Gemini 4 Argon 和 Claude Fable 5.1 之间,代理、自动化和终端类工作可以先换到 Gemini 4 Argon 的默认设置去跑,办公文档、报告类交付和难度高的写代码任务先留在 Fable 5.1。Argon 的 API 模型 ID 是 gemini-4-argon。截至 2026 年 11 月 4 日,两者在 Artificial Analysis 智能指数 v5.0.1 上基本持平(Argon High 50.41,Fable 5.1 xhigh 50.02),差别在分项:Argon 领先自动化与终端评测,Fable 领先办公文档、FrontierCode 和 HLE-Diamond。
真正拉开差距的是账单。2026 年 11 月 4 日用同样 8 道带隐藏测试的题目让 Argon 跑默认档和高思考档,再和 10 月 26 日 Fable 5.1 默认档的结果对照:三种配置全部通过,日常题一轮 Fable 的花费是 Argon 默认档的 8.6 倍。Argon 从 12 月 1 日起单价翻倍,这个差距会缩到约 4.3 倍;如果输入以中文为主,同一段文字 Fable 还要多计 78% 的 token。
例外有两个。把 Argon 的思考档位(thinkingLevel)开到 high 后,它会大量思考,12 月起在较难题上反而比 Fable 默认档更贵;而如果你只是在 Claude 家族里挑,Anthropic 自己建议多数工作先用 Opus 5.5,见 Claude Fable 5.1 和 Opus 5.5 怎么选?性能、价格与切换建议。
谁更强:AA 指数 v5.0.1 上 50.41 对 50.02,算持平
截至 2026 年 11 月 4 日,Artificial Analysis(下称 AA)智能指数 v5.0.1 给 Gemini 4 Argon(High)50.41 分,给 Claude Fable 5.1 最好的一档(xhigh)50.02 分。不到 1 分的差距在这个指数的误差范围内,应当看作持平。逐档数据见 AA 的 Gemini 4 Argon 与 Claude Fable 5.1 对比页。
| 配置 | AA 指数 | AA 跑完一个指数任务的成本 | 每任务耗时 | 首 token 时间 | 每任务输出 token |
|---|---|---|---|---|---|
| Gemini 4 Argon High | 50.41 | $7.68 | 1,362.9 秒 | 41.5 秒 | 116,368 |
Fable 5.1 max | 49.16 | $12.99 | 1,066.4 秒 | 252.5 秒 | 117,941 |
Fable 5.1 xhigh | 50.02 | $10.85 | 965.7 秒 | 79.5 秒 | 97,059 |
Fable 5.1 high(API 默认) | 47.17 | $7.54 | 719.8 秒 | 18.3 秒 | 66,031 |
Fable 5.1 medium | 43.17 | $5.56 | 537.1 秒 | 14.7 秒 | 48,545 |
Fable 5.1 low | 38.68 | $4.47 | 421.3 秒 | 2.6 秒 | 37,837 |
两边的档位名不能直接对齐。Argon 用的是思考档位 thinkingLevel,只有 low、medium、high 三档,API 默认 medium,而且思考关不掉(Gemini API 思考功能文档);Fable 5.1 用的是推理强度 effort,从 low 到 max 五档,默认 high(Claude effort 文档)。AA 只测了 Argon 的 High,比 API 默认高一档,所以更合理的比法是拿它对照两档 Fable:每任务成本几乎相同的默认档 high(47.17 分,比 Argon 低 3.2 分),和分数相同的 xhigh。两种对照下各花多少钱,在下面的价格一节展开。Fable 的 max 在 v5.0.1 上反而比 xhigh 低,首 token 要等 252.5 秒,除非你自己的任务证明它有用,不必开。
其他第三方指数给出的也是"差不多"。Epoch Capabilities Index 在 2026 年 11 月 3 日的更新里给 Fable 5.1 166.36、Argon 166.07,两者的置信区间几乎完全重叠。Vals Index 已换成 v2.2(10 月 19 日发布),Argon 以 69.24% 排在 32 个模型中的第 4,当前榜单上没有 Fable 5.1,Vals 也没有说明原因。9 月到 10 月中旬流传的"差 0.79 分、价格差 5 倍""AA 给 Argon 约 53 分、与 Fable 持平",用的都是已停用的 AA v4.3.2,和 v5.0.1 的分数不能放在一起比;Vals 上 Fable 65.83% 那组是 v2.1 的旧数;"Fable 更好,因为能调用"的说法写在 Argon 10 月 13 日正式开放之前,现在两者都能通过 API 调用。
各自强在哪:Argon 赢代理和终端,Fable 赢文档和难代码
分数持平不等于每类任务一样。AA v5.0.1 的 9 项分项里,Argon 在自动化代理和两项终端评测上领先,Fable 5.1 在办公文档、FrontierCode、GDP.pdf 和 HLE-Diamond 上领先,其余两项打平。截至 2026 年 11 月 4 日的分项如下,AA 的 Argon 只有 High 一档,Fable 列出 max 和 xhigh 两档。
| AA 分项 | Argon High | Fable 5.1 max | Fable 5.1 xhigh | 领先方 |
|---|---|---|---|---|
| AutomationBench-AA | 77.5% | 59.4% | 57.8% | Argon |
| Terminal-Bench 4.0 | 57.1% | 52.0% | 55.1% | Argon |
| Terminal-Bench-Science | 52.9% | 43.3% | 40.5% | Argon |
| AA-Briefcase | 1484 | 1669 | 1649 | Fable |
| FrontierCode 2.0 | 25.7% | 31.6% | 35.7% | Fable |
| GDP.pdf | 21.8% | 26.2% | 26.2% | Fable |
| HLE-Diamond | 56.7% | 60.1% | 58.8% | Fable |
| AA-Omniscience | 46.1 | 46.3 | 44.3 | 持平 |
| CritPt v2 Hard | 52.5% | 52.5% | 60.0% | 与 max 持平 |
Google 在 2026 年 9 月 30 日的 Gemini 4 Argon 发布文章里也放了一张对照表,17 项共同评测中 Argon 领先 15 项,Fable 5.1 只在 FrontierSWE v2(56.3 对 55.0)和 Terminal-bench 4.0(57.9 对 57.4)上领先;差距最大的是 AutomationBench(51.3 对 31.4)、Harvey Legal Agent(19.6 对 6.7)、LABBench 2(88.8 对 68.6)和 Chartography(71.6 对 46.2)。这张表是 Google 自己跑的,Argon 用的是最高思考档位,没有第三方复现;同一个 Terminal-Bench 4.0,在 AA 那里是 Argon 领先,在 Google 表里是 Fable 略高,说明评测框架不同,结论会跟着变。看方向比看单个数字可靠:自动化、代理和终端偏向 Argon,文档交付和难代码偏向 Fable。安全方面,VentureBeat 报道的 Google 图表里,Gray Swan 间接提示注入攻击成功率 Argon 0.7%、Fable 5.1 1.0%,同样是厂商图表。
一个任务花多少钱:单价差 5 倍,12 月 1 日起差 2.5 倍
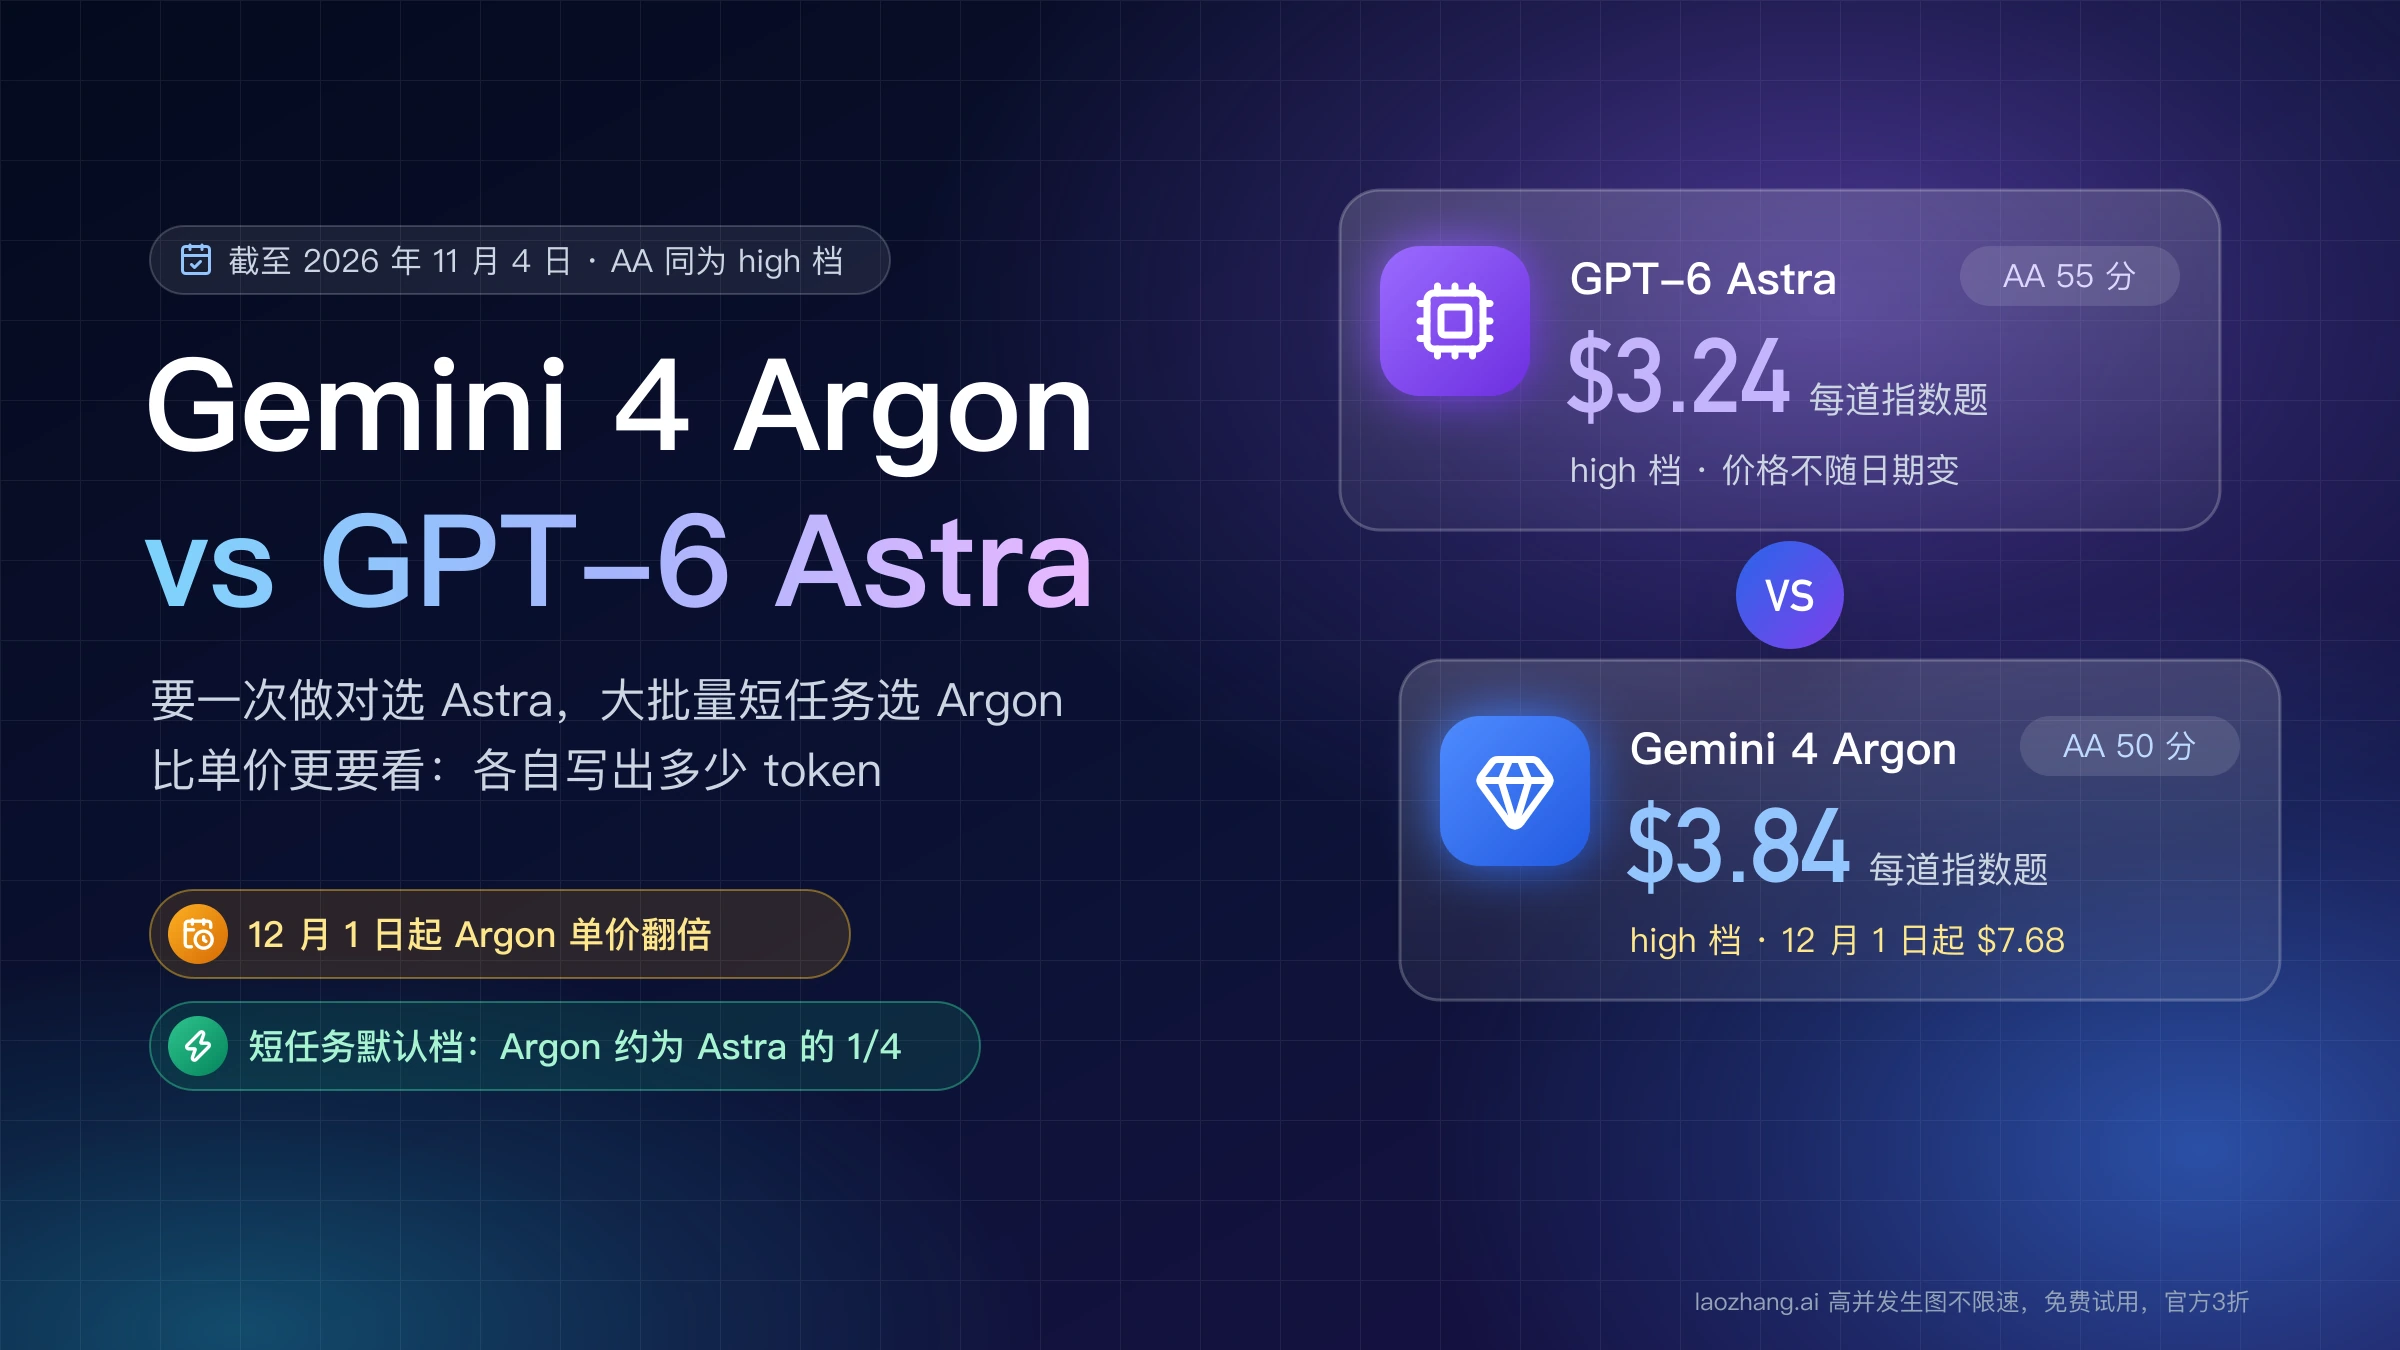
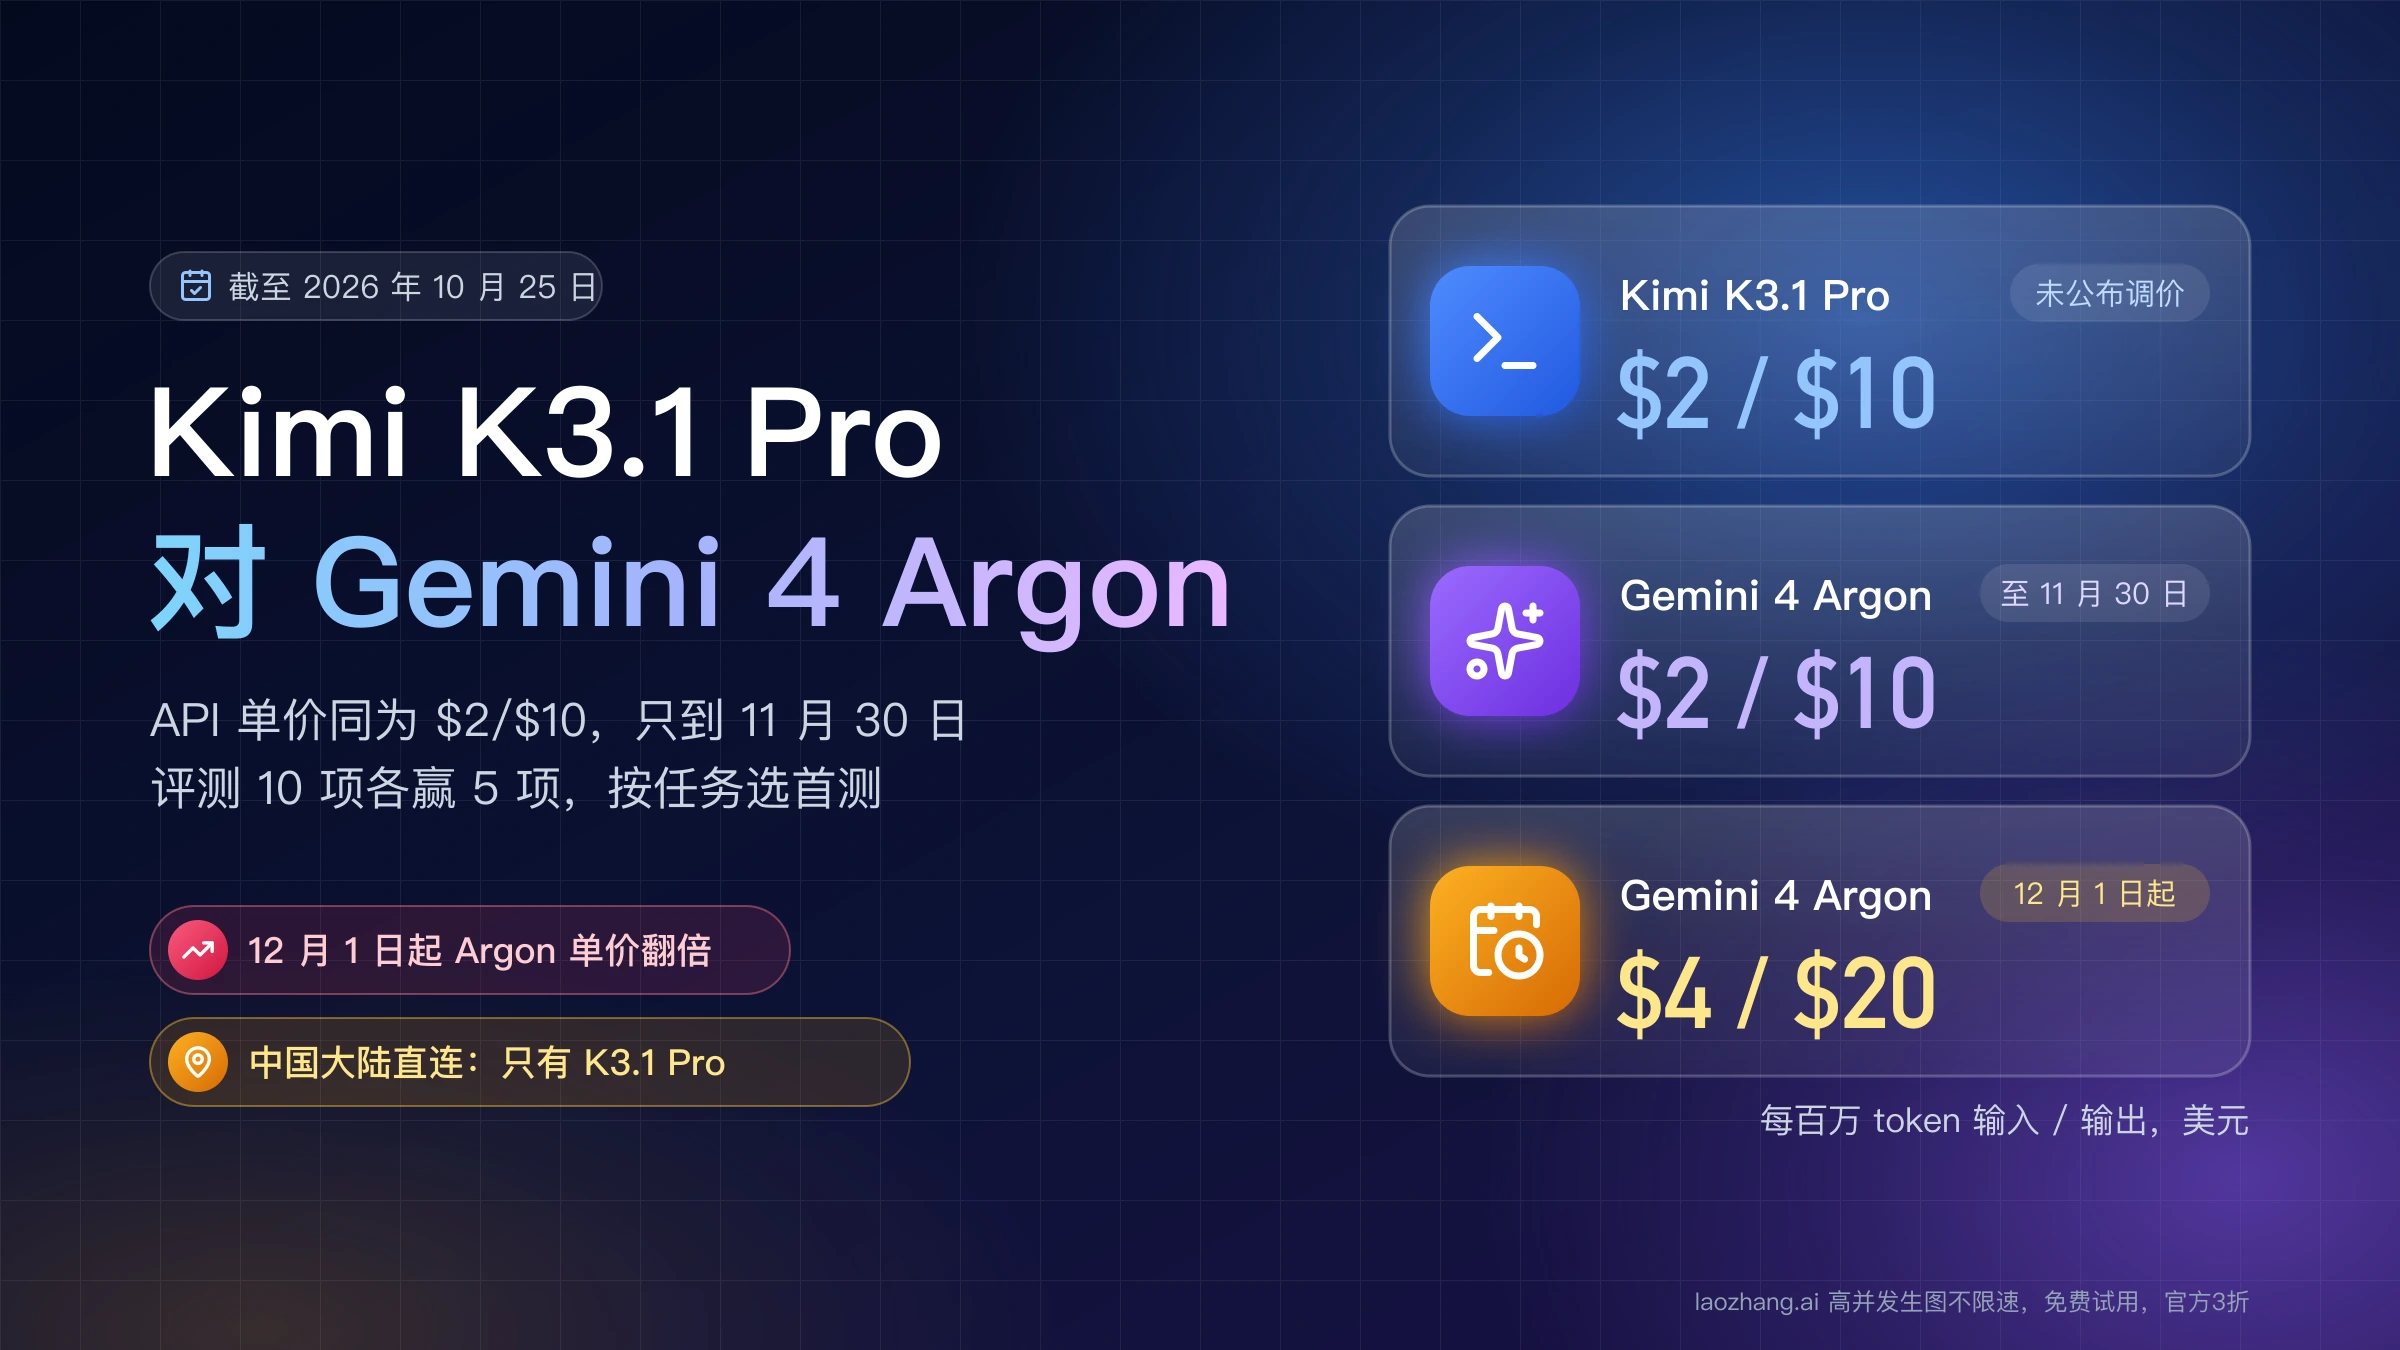
截至 2026 年 11 月 4 日,Gemini 4 Argon 的标准 API 单价是 Fable 5.1 的五分之一;2026 年 12 月 1 日起 Argon 单价翻倍,变成 Fable 的二分之一。但每个任务花多少,还取决于两边各用掉多少 token,所以单价只是起点。下表单位是美元 / 每百万 token,来自 Gemini API 价格页和 Claude API 价格页。
| 计费项 | Argon,至 11 月 30 日 | Argon,12 月 1 日起 | Claude Fable 5.1 |
|---|---|---|---|
| 输入 | $2.00 | $4.00 | $10.00 |
| 输出(含思考 token) | $10.00 | $20.00 | $50.00 |
| 缓存读取 | $0.10 | $0.20 | $0.25 |
| Batch 输入 / 输出 | $1 / $5 | $2 / $10 | $5 / $25 |
两边的计费细则也不一样。Argon 没有免费层,没有单独的 200K 以上价格档,思考 token 按输出计费,只有隐式缓存、不支持显式缓存;Google 还没有说明 11 月 30 日到期的首发价会不会延长。Fable 5.1 的 100 万 token 上下文全程按标准价计,缓存要在请求里加 cache_control 才生效,5 分钟缓存写入 $12.50、1 小时 $20,指定 inference_geo: "us" 另加 10%。两家的完整计费可以看 Claude Fable 5.1 API 价格:降了什么,省多少和 Gemini API Key 购买前先看:价格、免费额度与 2027 年 Flash 涨价。
按 AA 的每任务成本算,差距比单价小得多。AA 计算 Argon 时已经用了 12 月起的 $4/$20:Argon High $7.68,Fable high $7.54,几乎一样贵,Argon 高 3.2 分;要拿到同样的分数,Fable 得开 xhigh,$10.85,是 Argon 的约 1.4 倍。11 月 30 日前 Argon 的各项单价都是一半,按此折算每任务约 $3.84,这是减半推算的数,不是 AA 公布值;这段时间里 Fable high 约是它的 2.0 倍,xhigh 约 2.8 倍。之所以没有 5 倍那么大,是因为 Argon High 每个任务要输出 116,368 个 token,比 Fable high 的 66,031 个多出近八成。
同 8 道题实测:都全过,日常题 Fable 花费是 Argon 的 8.6 倍
8 道带隐藏测试的题目,Argon 默认档、Argon high 和 Fable 5.1 默认档全部通过(各 11/11),这组题分不出质量高低,能比较的是同样做对时的花费、token 和耗时。Argon 在 2026 年 11 月 4 日跑了两种设置:不设 thinkingConfig 的默认档,和 thinkingLevel 设为 high;Fable 5.1 用默认的 effort high,结果来自 2026 年 10 月 26 日,11 月 4 日用同一道题重新调用一次,模型 ID 和输入 token 数都没变。
题目分两轮。第一轮 5 道日常题各跑 1 次:一道应用题、合并区间、解析时长字符串、统计高频词,以及给一篇 6,723 个英文单词的长文写摘要;第二轮 3 道较难的题(表达式求值、CSV 行解析、数位和谜题)各跑 2 次。两边都经同一个 LaoZhang API 网关调用,Argon 走 Gemini 原生接口、非流式,Fable 走 Anthropic Messages 接口、流式,都不开缓存、不用工具。成本按各自返回的 token 用量乘官方标价计算,不是账单扣费。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
| 配置 | 第一轮 5 题:11 月 30 日前 / 12 月起 | 第二轮 3 题×2:11 月 30 日前 / 12 月起 | 11 次合计输出 token(其中思考) | 11 次合计耗时 |
|---|---|---|---|---|
| Argon 默认 | $0.0384 / $0.0768 | $0.0556 / $0.1112 | 6,859(1,531) | 128 秒 |
Argon high | $0.1364 / $0.2728 | $0.2565 / $0.5130 | 36,746(31,016) | 532 秒 |
Fable 5.1 默认(high) | $0.3310 / $0.3310 | $0.3073 / $0.3073 | 9,327(含思考,不单列) | 116 秒 |
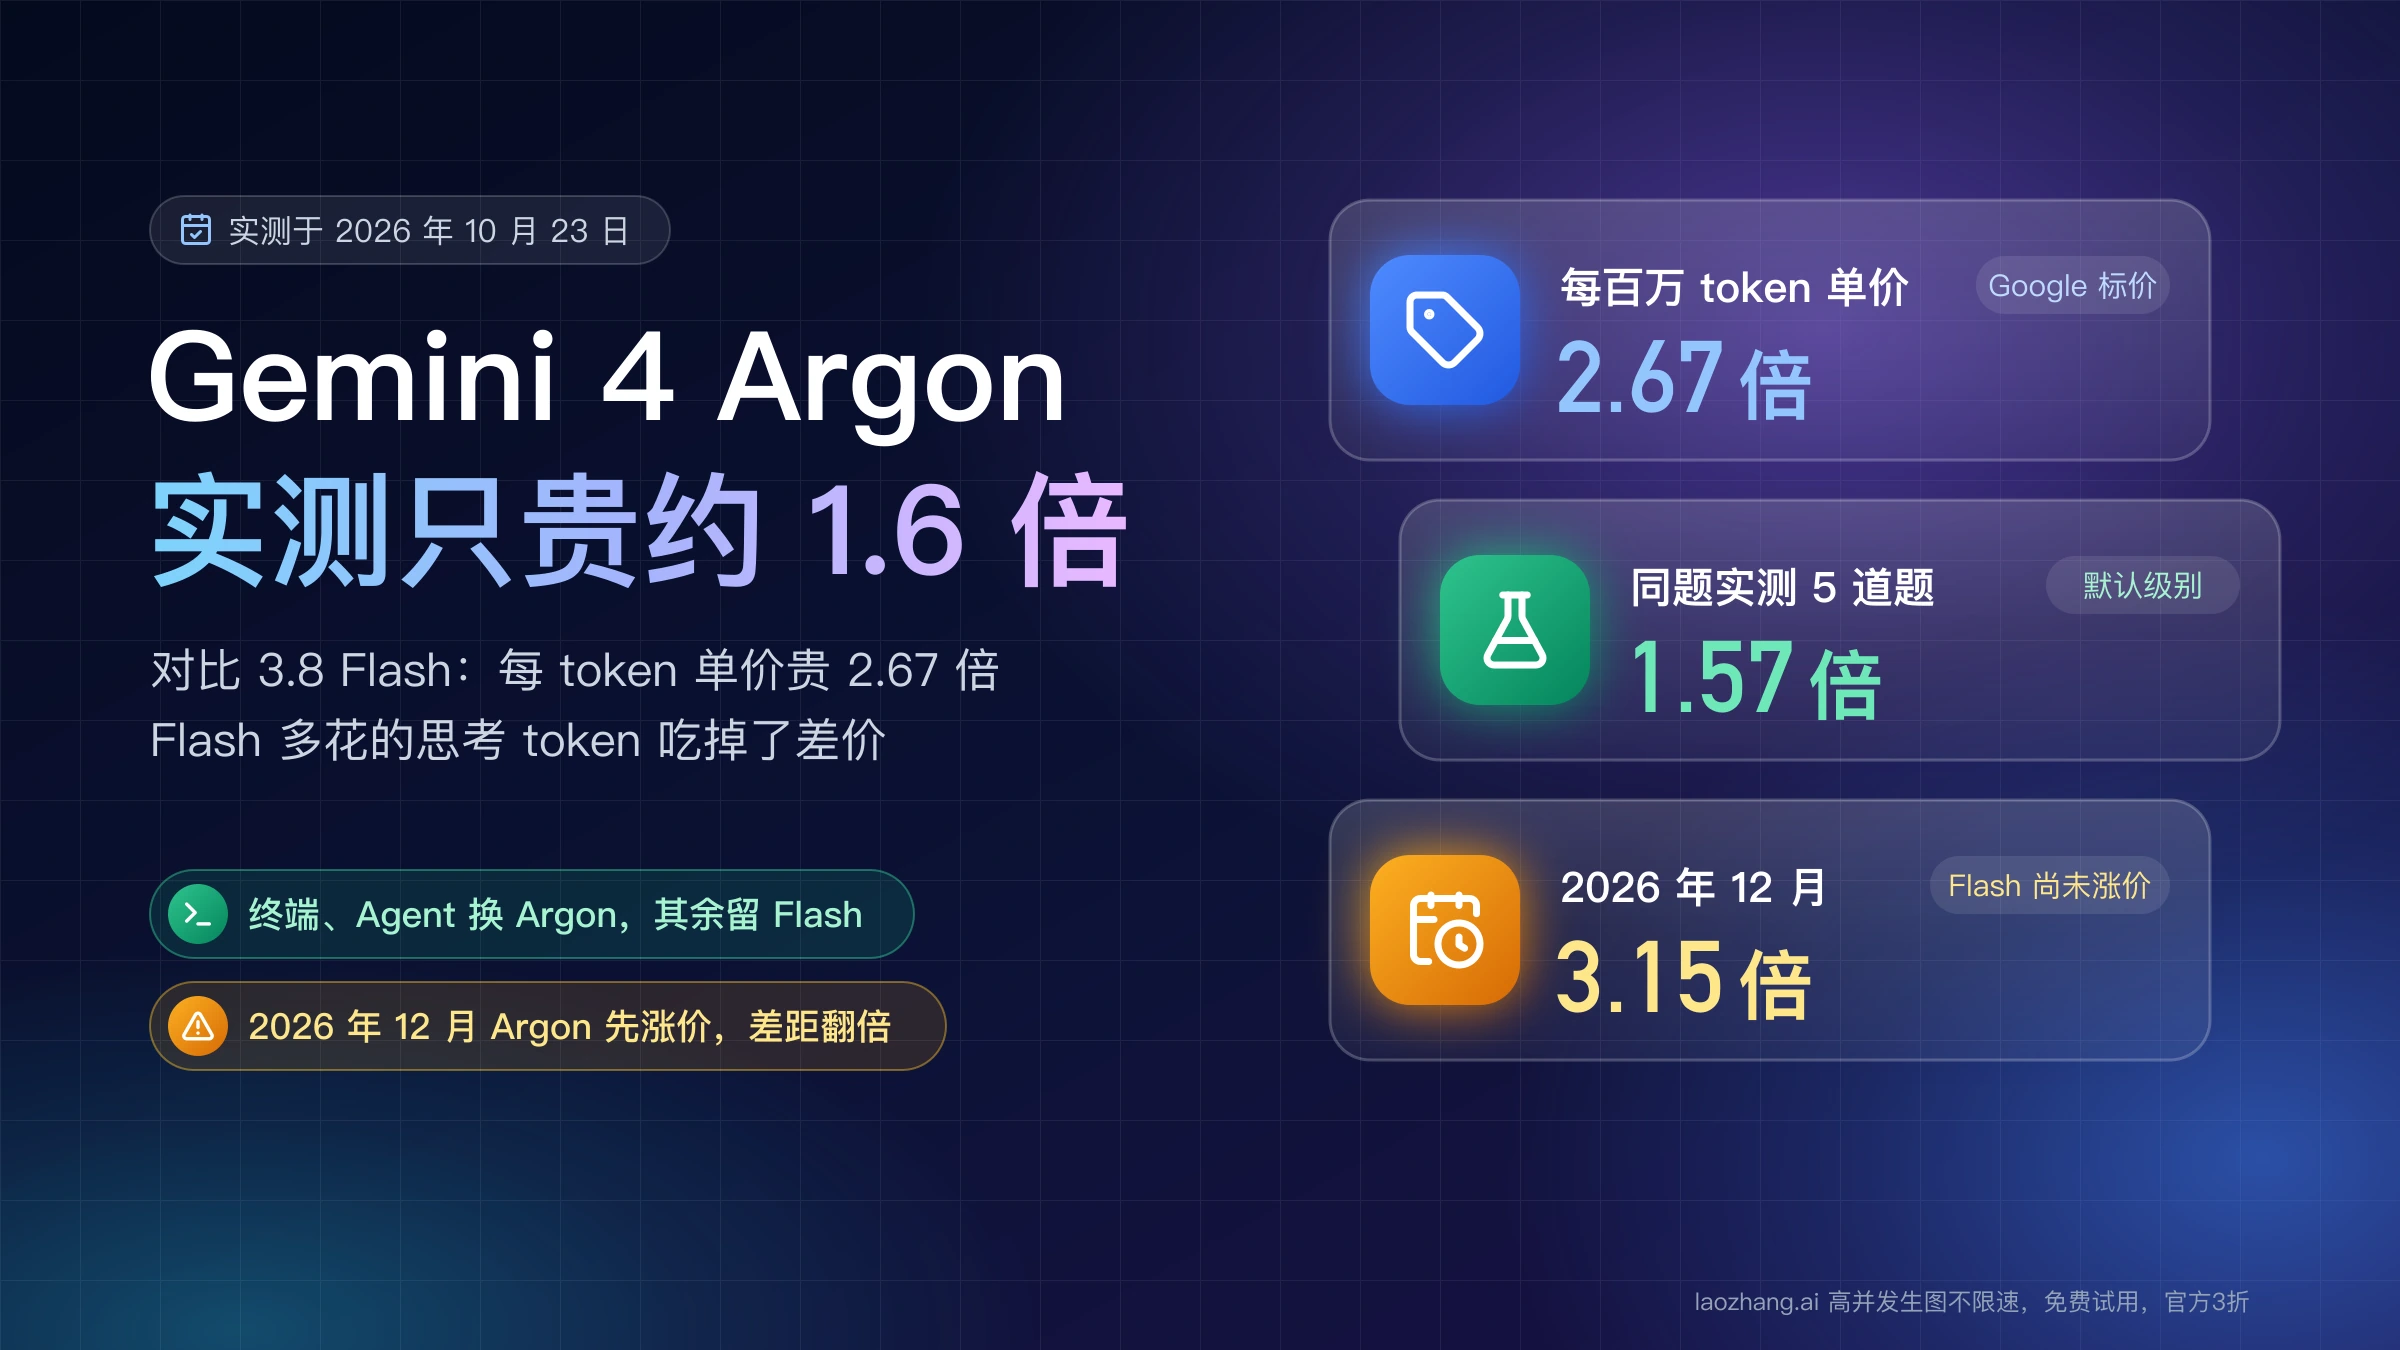
两个默认档相比,第一轮 Fable 的花费是 Argon 的 8.6 倍,12 月起约 4.3 倍;第二轮较难题是 5.5 倍,12 月起约 2.8 倍。较难题差距变小,是因为输入很短,花费主要在输出上,而 Fable 那一轮的输出量只比 Argon 多一成。Argon 默认档虽然名义上是 medium,在 11 次调用里有 9 次思考 token 为 0,只在数位和谜题上思考了 651 和 880 个 token;开到 high 后每次都思考,11 次合计 31,016 个思考 token。结果是 12 月起的较难题上,Argon high 要 $0.5130,Fable 默认档只要它的 0.60 倍。耗时方面,Argon 默认档和 Fable 接近(128 秒对 116 秒),Argon high 合计 532 秒,约是 Fable 的 4.6 倍。
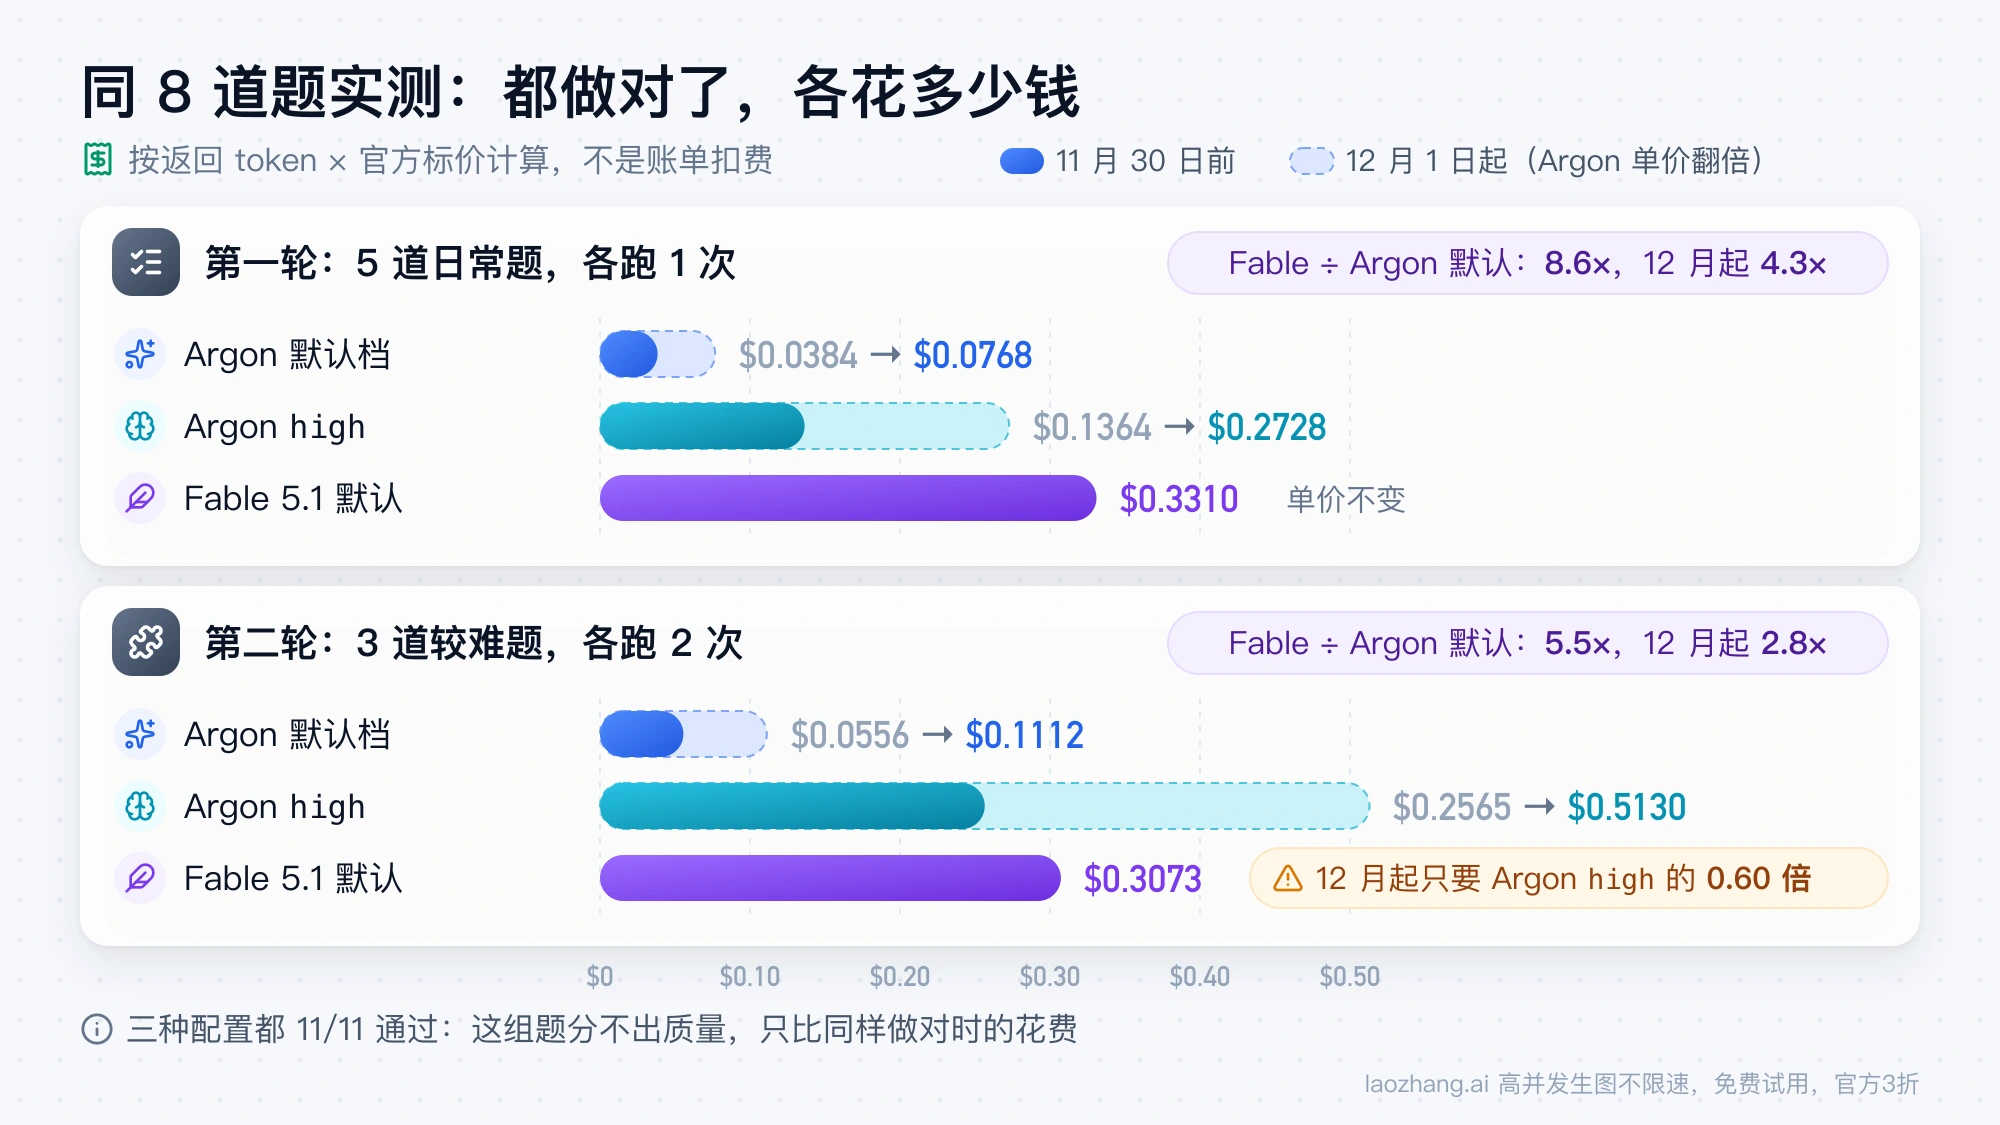
这组测试能说明的是:在题目明确、两边都能做对的情况下,Argon 默认档便宜得多,而开 high 会把这个优势吃掉。它说明不了谁的质量更好,也覆盖不到代理循环、工具调用、长输出和缓存这些真实工作里常见的情况;每道日常题只跑了 1 次,Fable 同一道题在 10 月 26 日输出 773 个 token、11 月 4 日输出 674 个,单次结果本身就有波动。质量判断仍以上面的 AA 分项为准。另外,经 OpenAI 兼容接口调 Argon 时 reasoning_effort 不起作用,要改档位得用 Gemini 原生接口的 thinkingConfig.thinkingLevel;经这个网关调 Claude 时单次输出上限是 32,768 token。
中文输入会更贵吗:同一段中文,Fable 5.1 计 1.78 倍 token
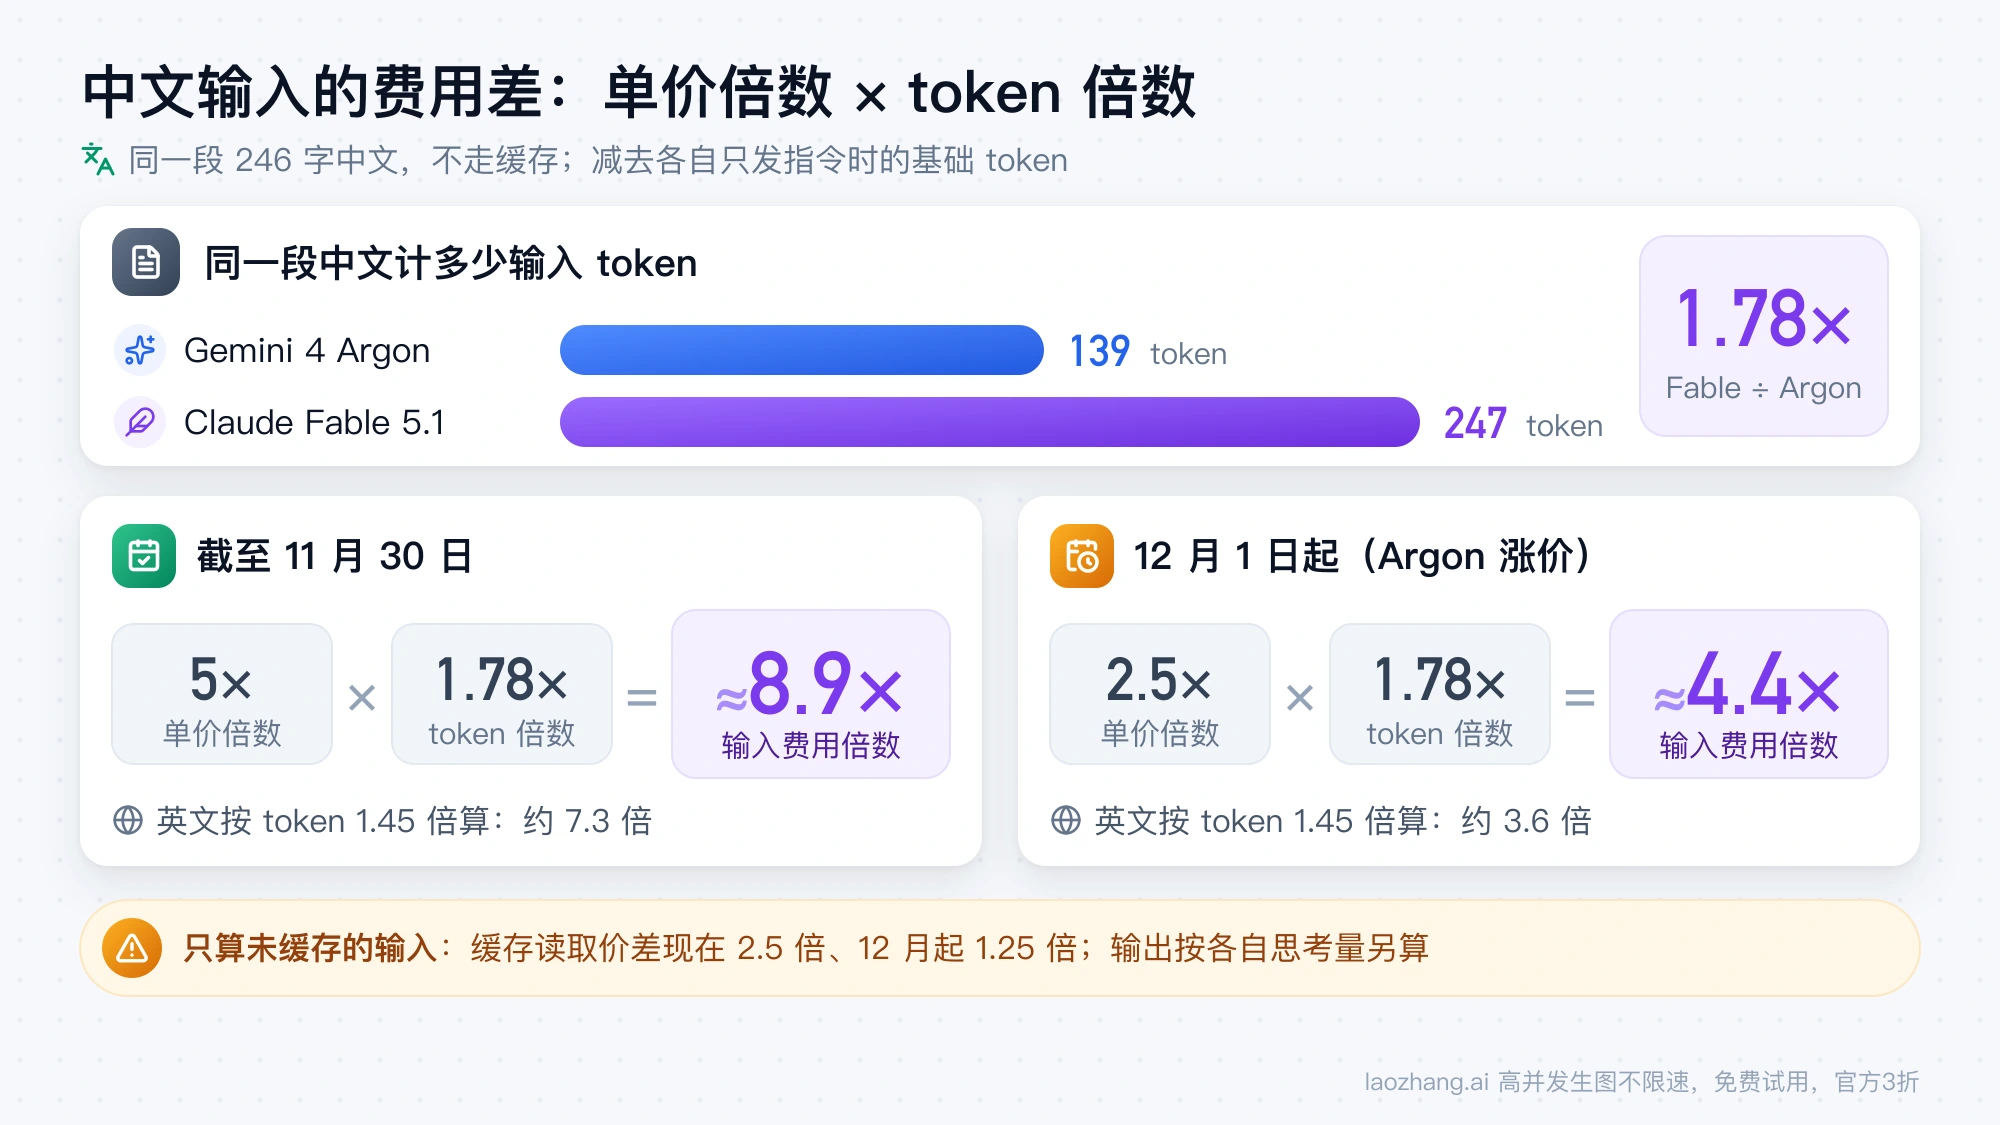
会。同一段 246 个字的中文,Gemini 4 Argon 计 139 个输入 token,Claude Fable 5.1 计 247 个,是 Argon 的 1.78 倍。这是 2026 年 11 月 4 日(Argon)和 10 月 26 日(Fable)用同一段文字测得的,计数时减去了各自只发指令时的基础 token,所以反映的是这段文字本身。同样的方法下,一段英文是 1.45 倍,那篇 6,723 词的英文长文是 1.38 倍(11,110 对 15,335),中文差得最多。Anthropic 的文档也提到,Fable 5.1 用的是从 Opus 4.7 开始的分词器,同样的文字比旧 Claude 模型多计约 30% 的 token;两家都没有公布 Claude 和 Gemini 之间的对照。
账单上的倍数等于单价倍数乘以 token 倍数。同一段中文、不走缓存时,输入这一项现在是 5 × 1.78,约 8.9 倍;12 月 1 日起是 2.5 × 1.78,约 4.4 倍。英文按 1.45 倍算,分别约 7.3 倍和 3.6 倍。输出那一侧另算,取决于各自思考多少:上面的同题测试里,Fable 的输出 token 是 Argon 默认档的 1.4 倍,却只有 Argon high 的约四分之一。
缓存会把差距拉近。如果你的请求每次都带同一段很长的系统提示或文档,命中缓存的部分按缓存读取价计:Fable $0.25,Argon 现在 $0.10、12 月起 $0.20,这一项的单价差现在是 2.5 倍,12 月起是 1.25 倍,都比普通输入小。但 Fable 只有加了 cache_control 才缓存,Argon 只有隐式缓存,提示要达到约 4,000 到 6,000 个 token 才可能命中(Google 不同页面写的是 4,096 和 6,144)。两边的命中规则和实测见 Claude Prompt Caching 提示缓存怎么用:各模型价格与命中实测和 Gemini 上下文缓存(Context Caching):隐式/显式、价格与命中实测。
按工作类型选:哪些活换 Argon,哪些留在 Fable 5.1
默认先试 Argon 的,是自动化代理、终端操作、批量处理和长中文输入这类对成本敏感、Argon 在分项上又不吃亏的工作;留在 Fable 5.1 的,是办公文档与报告、难度高的写代码,以及需要单次超长输出或更快首 token 的场景。下表的分项数字来自 AA v5.0.1,规格来自两家截至 2026 年 11 月 4 日的模型文档。
| 你的主要工作 | 先用 | 依据 | 什么时候换另一个 |
|---|---|---|---|
| 自动化代理、多步工具流程 | Argon 默认档 | AutomationBench-AA 77.5% 对 59.4% | 你的流程里 Argon 反复漏步骤,Fable 能稳定完成 |
| 终端操作、命令行科研任务 | Argon 默认档 | Terminal-Bench 4.0 57.1% 对 52.0%,Terminal-Bench-Science 52.9% 对 43.3% | 默认档失败,开 high 后成本超过 Fable |
| 大批量处理、长中文输入 | Argon 默认档 | 同一段中文的未缓存输入费用约 8.9 倍,12 月起约 4.4 倍;输出另算 | 质量验收不过,返工成本高于差价 |
| 办公文档、表格、报告交付 | Fable 5.1 默认 high | AA-Briefcase 1669 对 1484,GDP.pdf 26.2% 对 21.8% | 文档量大、预算紧,Argon 在你的验收里也能通过 |
| 难度高的写代码 | Fable 5.1 xhigh | FrontierCode 2.0 35.7% 对 25.7% | 任务能拆小、测试明确,Argon 默认档也能过 |
| 单次输出超过 65,536 token | Fable 5.1 | Fable 单次最多 128K;Argon 同步请求 65,536,非流式单跳 32,768 | 能接受续写或后台长解码时可用 Argon |
| 交互式对话,要快出首字 | Fable 5.1 high | AA 首 token 18.3 秒对 Argon High 41.5 秒 | 对延迟不敏感的批处理 |
Argon 的 high 只留给默认档做不对的任务。默认档在同题测试里已经全部通过,开 high 后输出 token 涨到 5 倍多,12 月起在较难题上比 Fable 默认档还贵,所以"一律开高档"在 Argon 上不划算。合规条件也会改变选择:Fable 5.1 要求 30 天数据保留,你的合同或政策不允许保留数据时,这一条就先排除 Fable。
如果你在用 Fable 5.1 只是因为它是 Claude 最强的型号,先比一下 Opus 5.5 更值得。Anthropic 的模型总览建议,拿不准时多数工作先从 Opus 5.5 开始,Fable 5.1 留给要求很高的推理和长时间代理任务,或者 Opus 5.5 提高推理强度后仍然达不到要求的情况,详见 Claude Fable 5.1 和 Opus 5.5 怎么选?性能、价格与切换建议;Argon 和 Opus 5.5 的直接对比在 Gemini 4 Argon、Opus 5.5、GPT-6.1 Sol 对比:已开放,12 月起涨价。还在考虑 OpenAI 旗舰的话,Fable 5.1 和 Astra 的对比见 GPT-6 Astra 与 Claude Fable 5.1 怎么选:实测 token 与 API 成本。
Gemini 应用和 Claude 订阅里能不能用:Argon 要 AI Pro 起
在网页版和编程工具里,Gemini 4 Argon 需要 Google AI Pro 或 Ultra 订阅;Claude Fable 5.1 在 Pro 方案里从第一条消息起就按用量额度付费,Max 和 Ultra 方案最多可用到每周额度的一半。订阅和 API 是两套计费,Google 的订阅不覆盖 API 调用,Claude 只有 Max 和 Ultra 每月附带一笔 API 额度。
Google 这边,按美国价格,Google AI Plus($4.99/月)只有 Flash 模型,没有 Argon;Google AI Pro($19.99/月)可以用 Gemini 4 Argon,Google AI Ultra($99.99 或 $199.99/月)额度最高,见 Google AI 订阅方案页。Argon 从 2026 年 10 月 13 日起在 Gemini 应用里向 Pro 和 Ultra 开放,AI Studio 网页版也只给 Pro 和 Ultra 配了 Argon 额度。编程工具方面,截至 10 月下旬,Antigravity 对付费的 AI Pro 和 Ultra 开放 Argon,有单独的每周额度;Gemini CLI 的说明写明 Argon 在那里没有优化,建议用 Antigravity。额度按算力计,每 5 小时刷新、另有每周上限,Google 没有公布 Argon 的具体条数。
Claude 这边,免费版不能用 Fable 5.1;Pro($20/月,按年付 $17/月)从第一条消息起扣用量额度;Max($100/月)和 Ultra($200/月)里 Fable 最多用到每周额度的一半,这一半算在同一份额度里,不是额外的,用完后改用额度付费或换模型,见 Claude 帮助中心关于 Fable 模型的说明。Max 和 Ultra 每月还附带 $100 和 $200 的 API 额度。Claude Code 要 2.1.255 或更新版本才能用 Fable 5.1。这两档在 2026 年 10 月 30 日之前叫 Max 5x 和 Max 20x。
换之前,用自己的任务复测 Argon 和 Fable 5.1
拿到你自己任务上的通过率和每个合格结果的成本之前,不要整批切换。上面的指数和同题测试只能告诉你从哪里开始试,你自己的提示词、语言和验收标准才决定最终账单,按下面五步做一轮就够判断。
- 从最近真实做过的工作里挑 10 到 20 个任务,每个写下能自动判断的验收条件,比如单元测试、必须包含的字段或结论;平时用中文提问,就用中文原文。
- 两边都先跑默认设置:Argon 不设
thinkingConfig(默认medium),Fable 5.1 不设effort(默认high),并把max_tokens留大,避免高推理强度下输出被截断。 - 每次调用记下返回的输入 token、输出 token(含思考)和耗时;Argon 的成本按 $2/$10 和 $4/$20 各算一遍,看 12 月后还划不划算。
- 只把没通过的任务升档重跑:Argon 改
thinkingLevel: "high",Fable 改effort: "xhigh",记下升档多花的钱。 - 用"总花费 ÷ 通过的任务数"比较每个合格结果的成本;如果每次请求都带很长的固定前缀,给 Fable 加上
cache_control再跑一轮,因为缓存会明显改变它的账单。
判断规则很简单:Argon 默认档的通过率和 Fable 相同或只差一两个任务时,换到 Argon,把差价留给返工;Argon 要开 high 才能追平时,按 12 月后的价格重算一次,很可能留在 Fable 更省;Fable 也做不好的任务,再去比 Opus 5.5 的高推理强度或别的模型。
Gemini 4 Argon 和 Fable 5.1 的其他问题
Claude Fable 5.5 出了吗?
截至 2026 年 11 月 4 日,Anthropic 的文档、API 更新说明和新闻页都没有 Fable 5.5,Fable 5.1 在模型列表里仍标为最新。10 月 13 日在第三方平台上出现过 claude-fable-5-5 的名字,至今没有官方确认,来龙去脉见 Fable 5.5、Gemini 4、GPT-6.1 对比:Argon 已开放,Fable 5.5 未出。
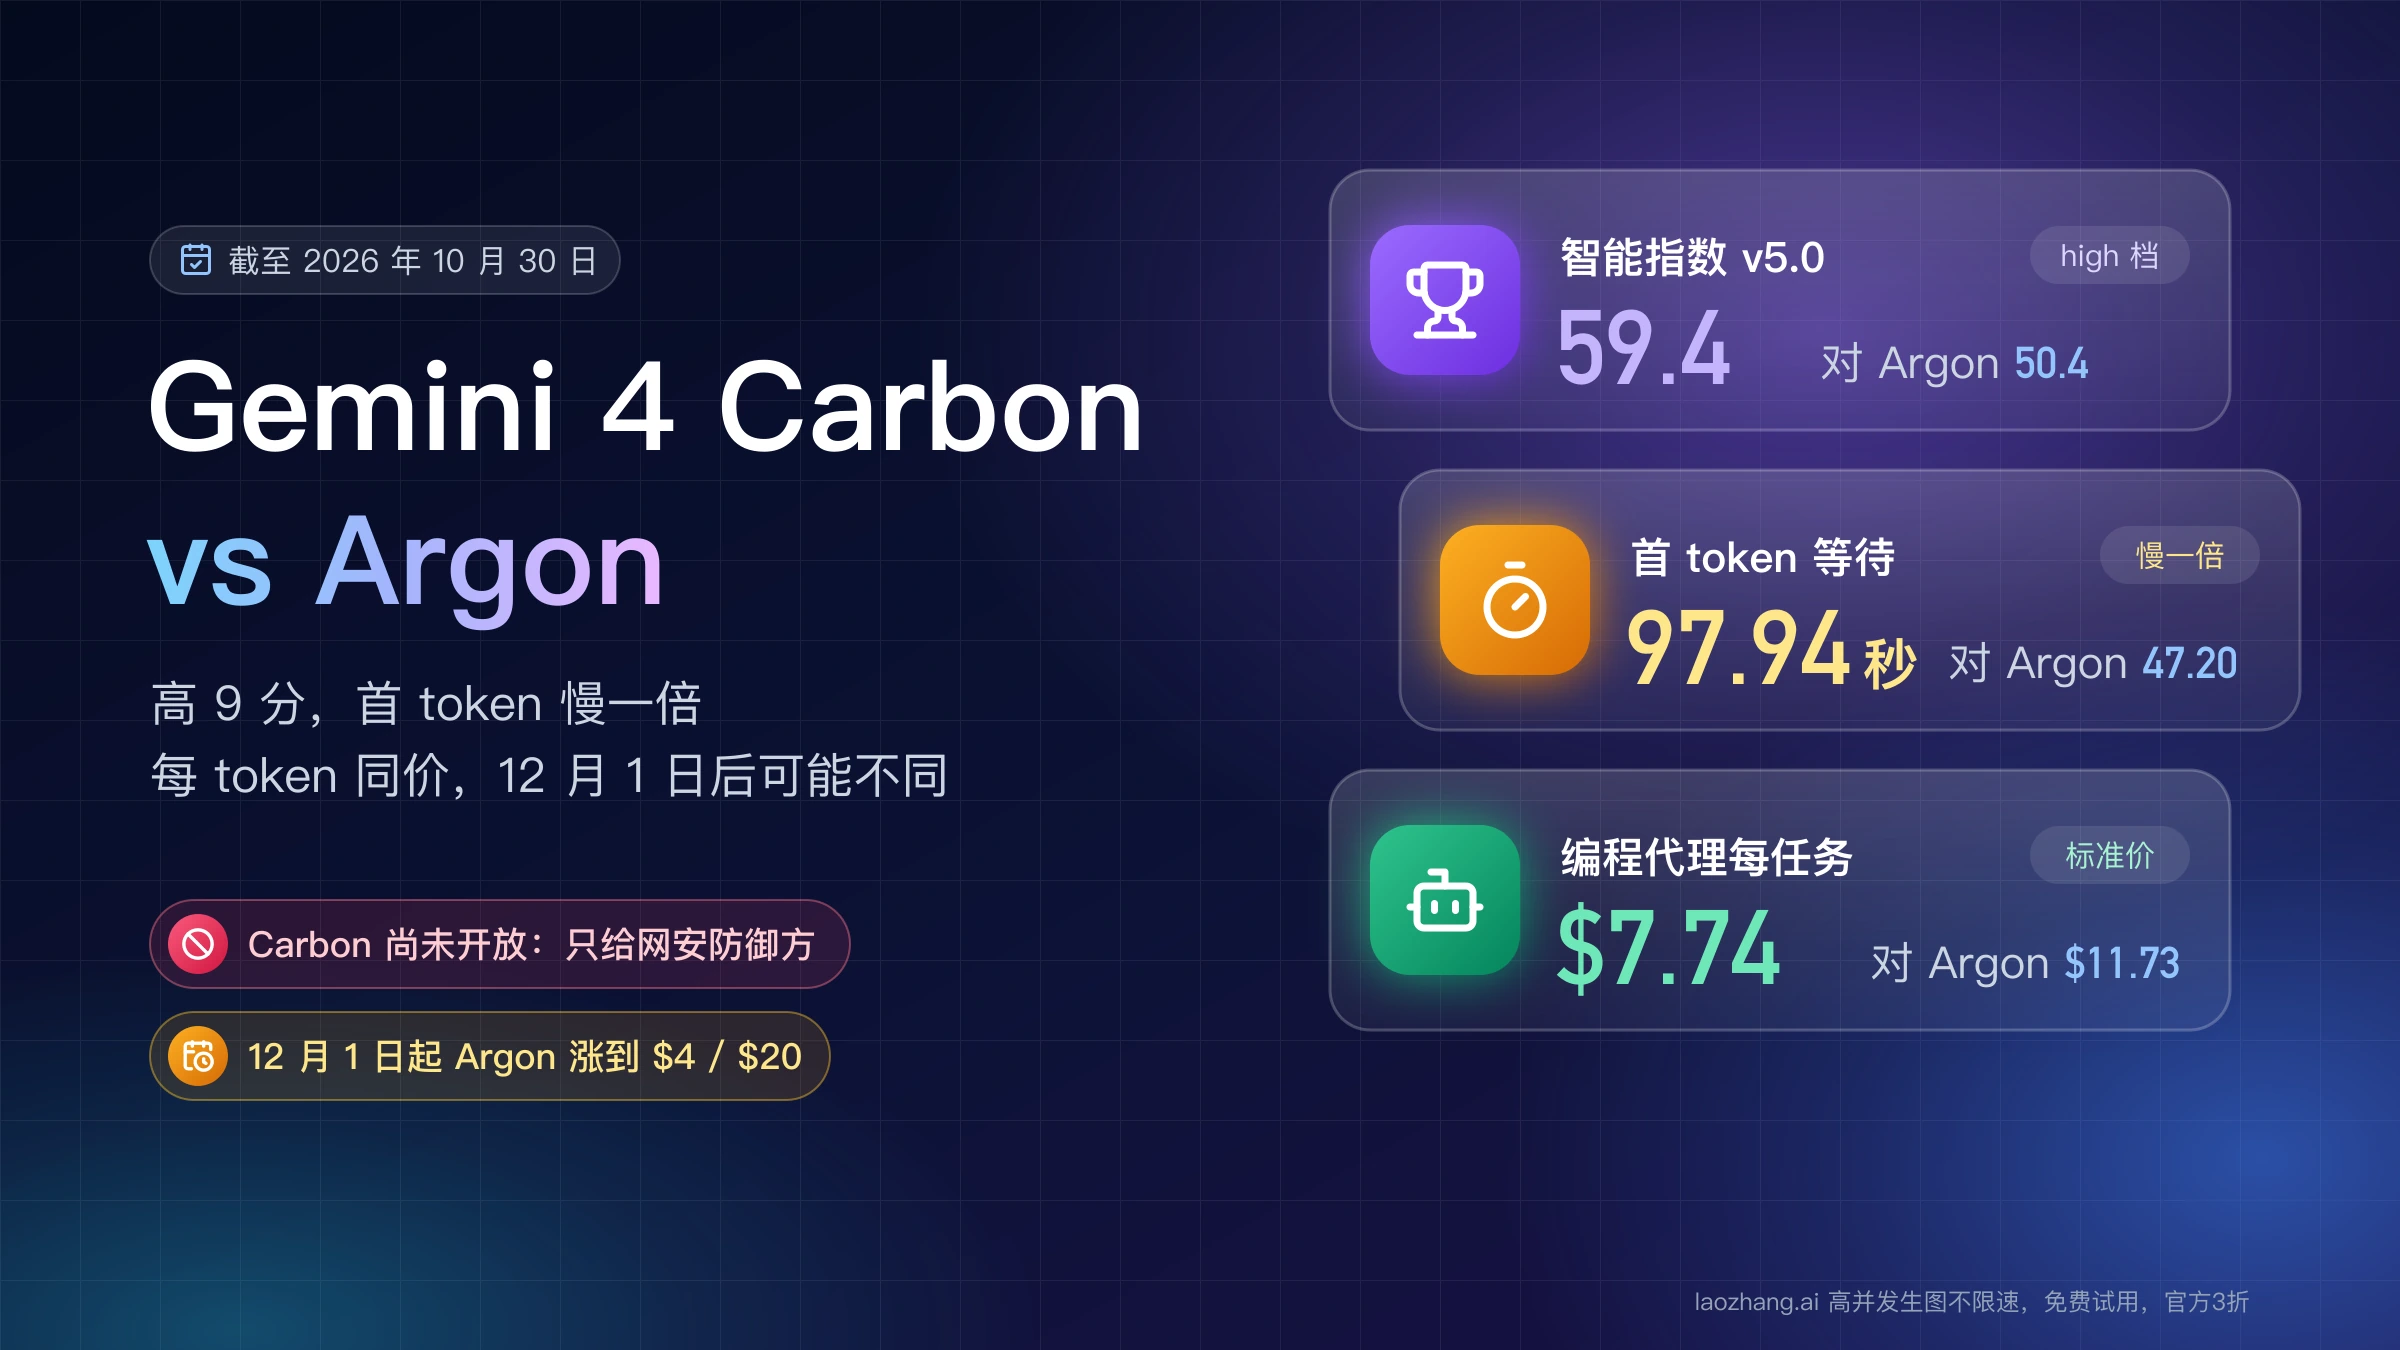
Gemini 4 Carbon 比 Argon 强,要不要等它?
不用等。Gemini 4 Carbon 在 2026 年 10 月 28 日发布,目前只给一部分网络安全防御方使用,没有公开的模型 ID、API 和开放日期,虽然 AA v5.0.1 给它(High)60.03 分;Google 也没有说 Argon 会被替换。两者的差距见 Gemini 4 Carbon vs Argon 测评与价格:高 9 分,首 token 慢一倍,什么时候能用见 Gemini 4 Carbon 什么时候可以用:已发布,但只给网安防御方。
"Gemini 4 Pro" 和 Gemini 4 Argon 是一个模型吗?
"Gemini 4 Pro"是发布前流传的猜测名,并没有这个模型。Google 在 2026 年 9 月 30 日发布、10 月 13 日正式开放的型号叫 Gemini 4 Argon,API 模型 ID 是 gemini-4-argon;单说"Gemini 4"时,也可能指只对网安防御方开放的 Gemini 4 Carbon。
Gemini 4 Argon 的长输出被截断了怎么办?
Argon 同步请求单次最多输出 65,536 个 token,非流式单次请求上限是 32,768 个,超过时需要用后台长解码(background=true)或在客户端续写,最多可到 1,048,576 个 token。怎么判断被截断、怎么续写,见 Gemini 4 Argon API finish_reason 怎么处理:长输出续写与中转实测。
参考来源10
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年11月4日。
参考来源10
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年11月4日。
- 1.AA 的 Gemini 4 Argon 与 Claude Fable 5.1 对比页artificialanalysis.ai/models/comparisons/gemini-4-argon-vs-claude-fable-5-1
- 2.Gemini API 思考功能文档aistudio.google.com/docs/thinking
- 3.Claude effort 文档platform.claude.com/docs/en/build-with-claude/effort
- 4.Epoch Capabilities Indexepoch.ai/benchmarks/eci
- 5.Vals Indexvals.ai/benchmarks/vals_index
- 6.Gemini 4 Argon 发布文章blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- 7.Gemini API 价格页aistudio.google.com/docs/pricing
- 8.Claude API 价格页platform.claude.com/docs/en/about-claude/pricing
- 9.Google AI 订阅方案页gemini.google/us/subscriptions
- 10.Claude 帮助中心关于 Fable 模型的说明support.claude.com/en/articles/15424964-claude-fable-models-on-your-plan