Gemini 4 Carbon vs Argon 测评与价格:高 9 分,首 token 慢一倍
Carbon 比 Argon 高 9 分,强在编程代理和科研推理,SaaS 自动化持平,首 token 约慢一倍。Carbon 尚未开放,先用 Argon,按 12 月涨价做预算。
文章目录
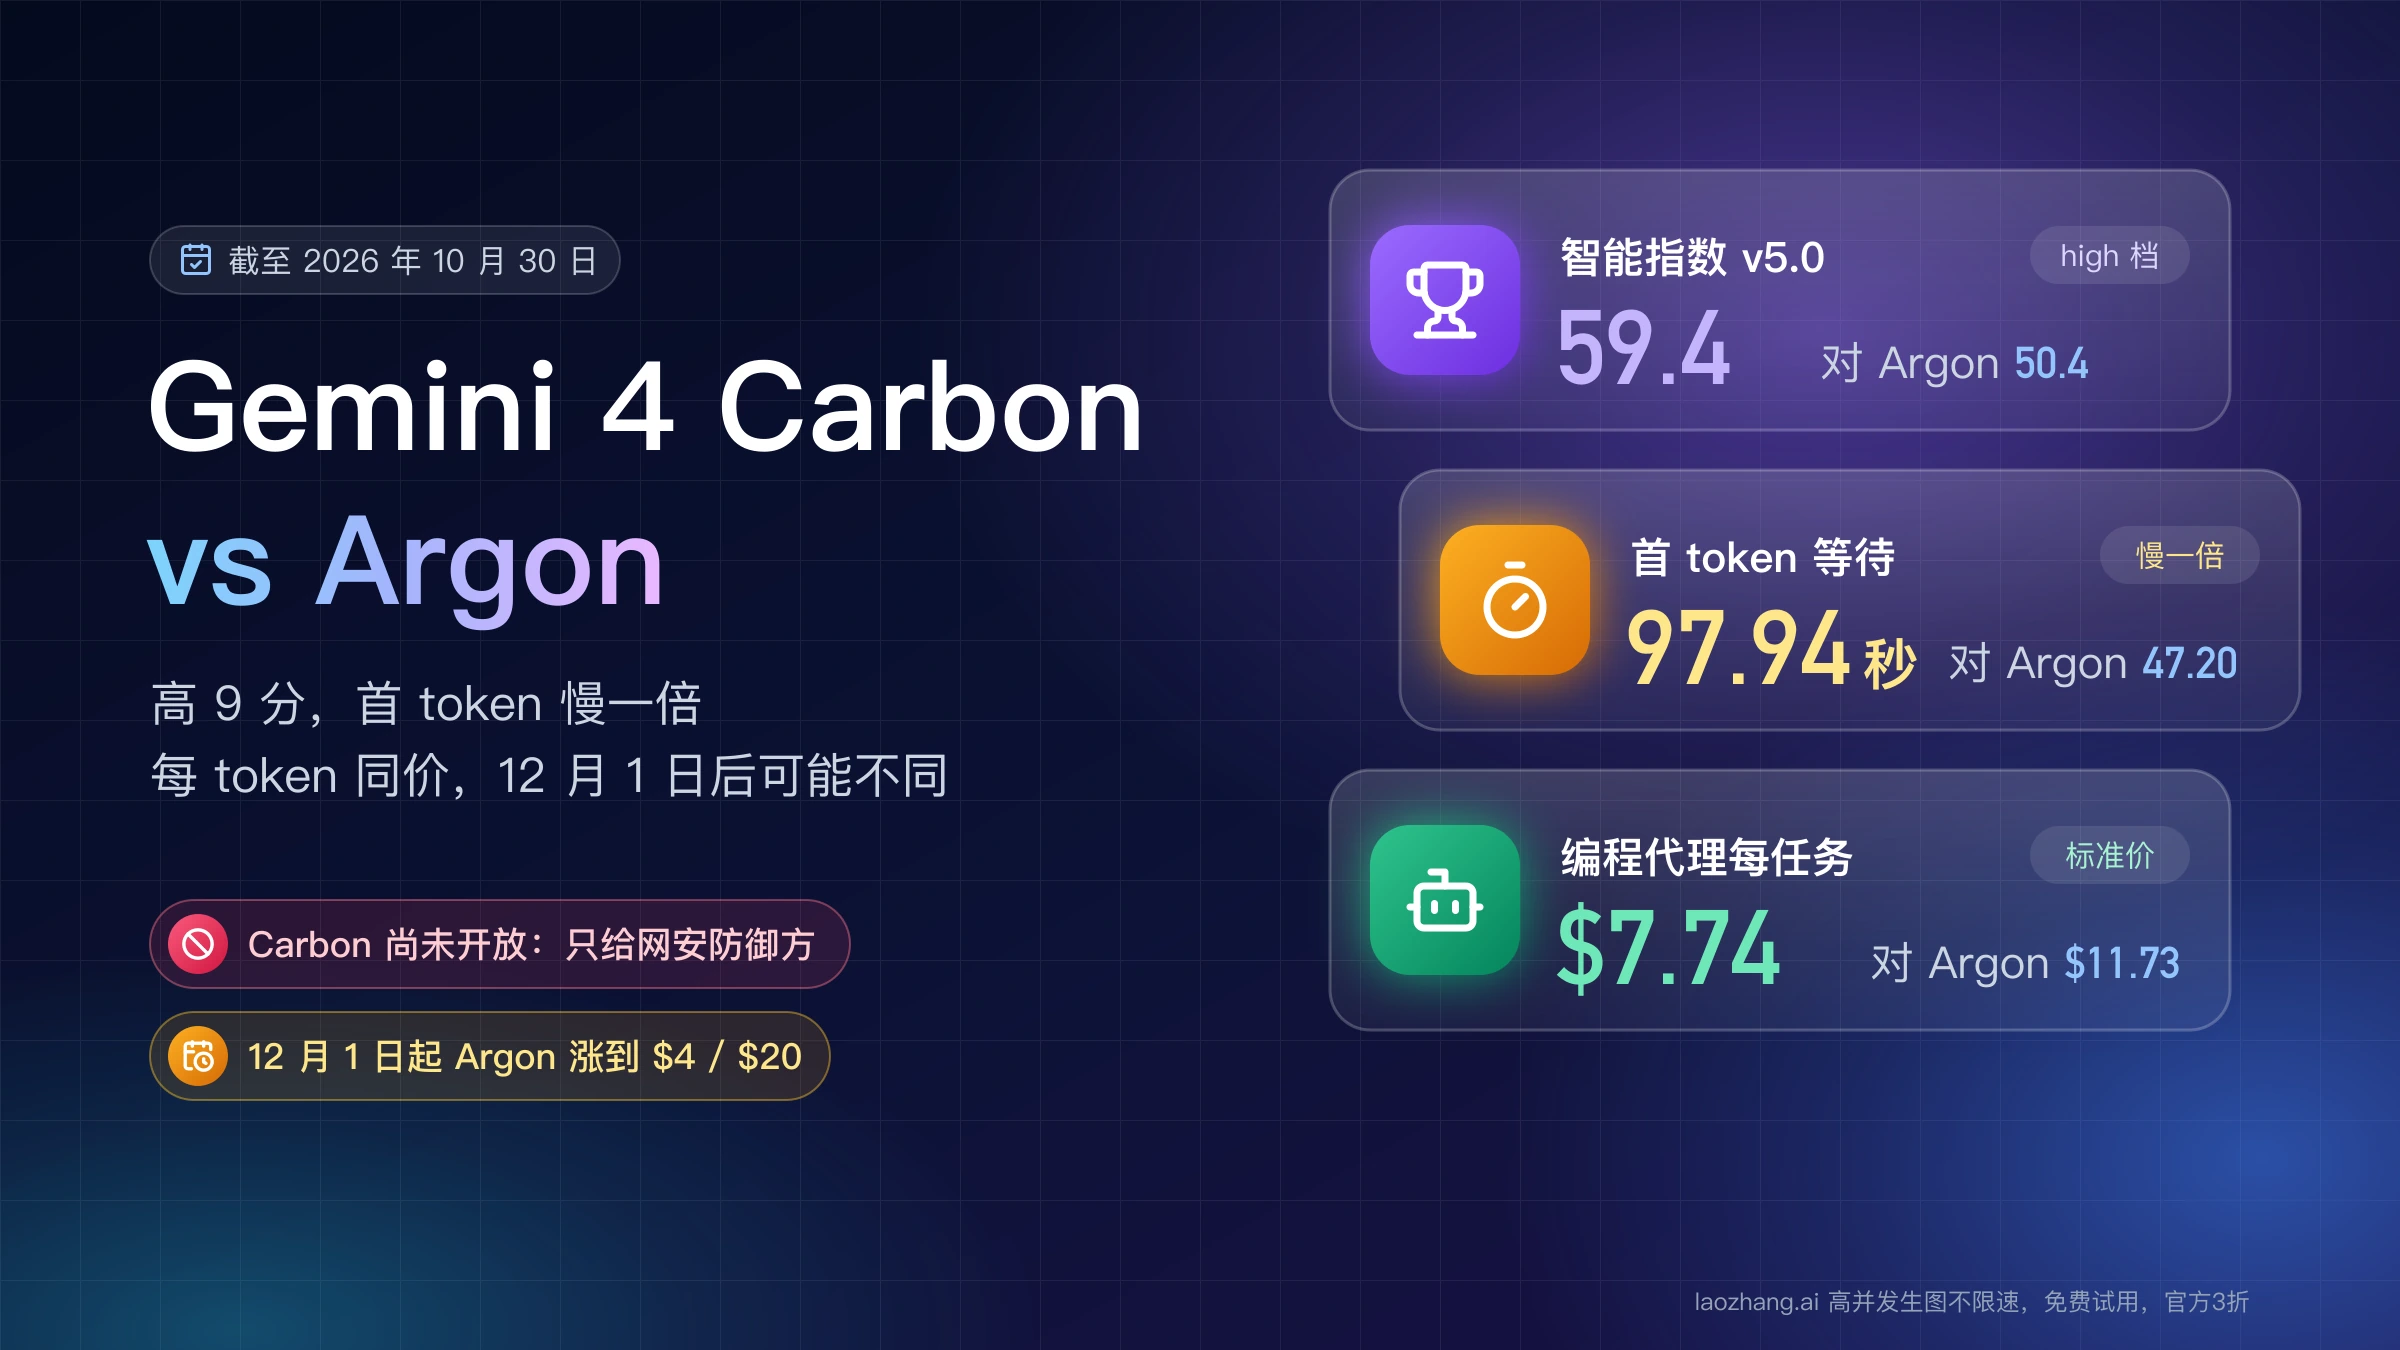
Gemini 4 Carbon 确实比 Argon 强,但提升集中在编程代理和科研推理,SaaS 自动化几乎没有差别。截至 2026 年 10 月 30 日,在 Artificial Analysis(下称 AA)智能指数 v5.0 的 high 推理档上,Carbon 得 59.4 分,Argon 得 50.4 分;在开源仓库里做软件工程的 FrontierCode 2.0 上 Carbon 高出 14.9 个百分点,在 SaaS 工作流测试 AutomationBench-AA 上只高 0.3。代价在首 token:AA 测得 Carbon 平均 97.94 秒才吐出第一个回答 token,Argon 是 47.20 秒。
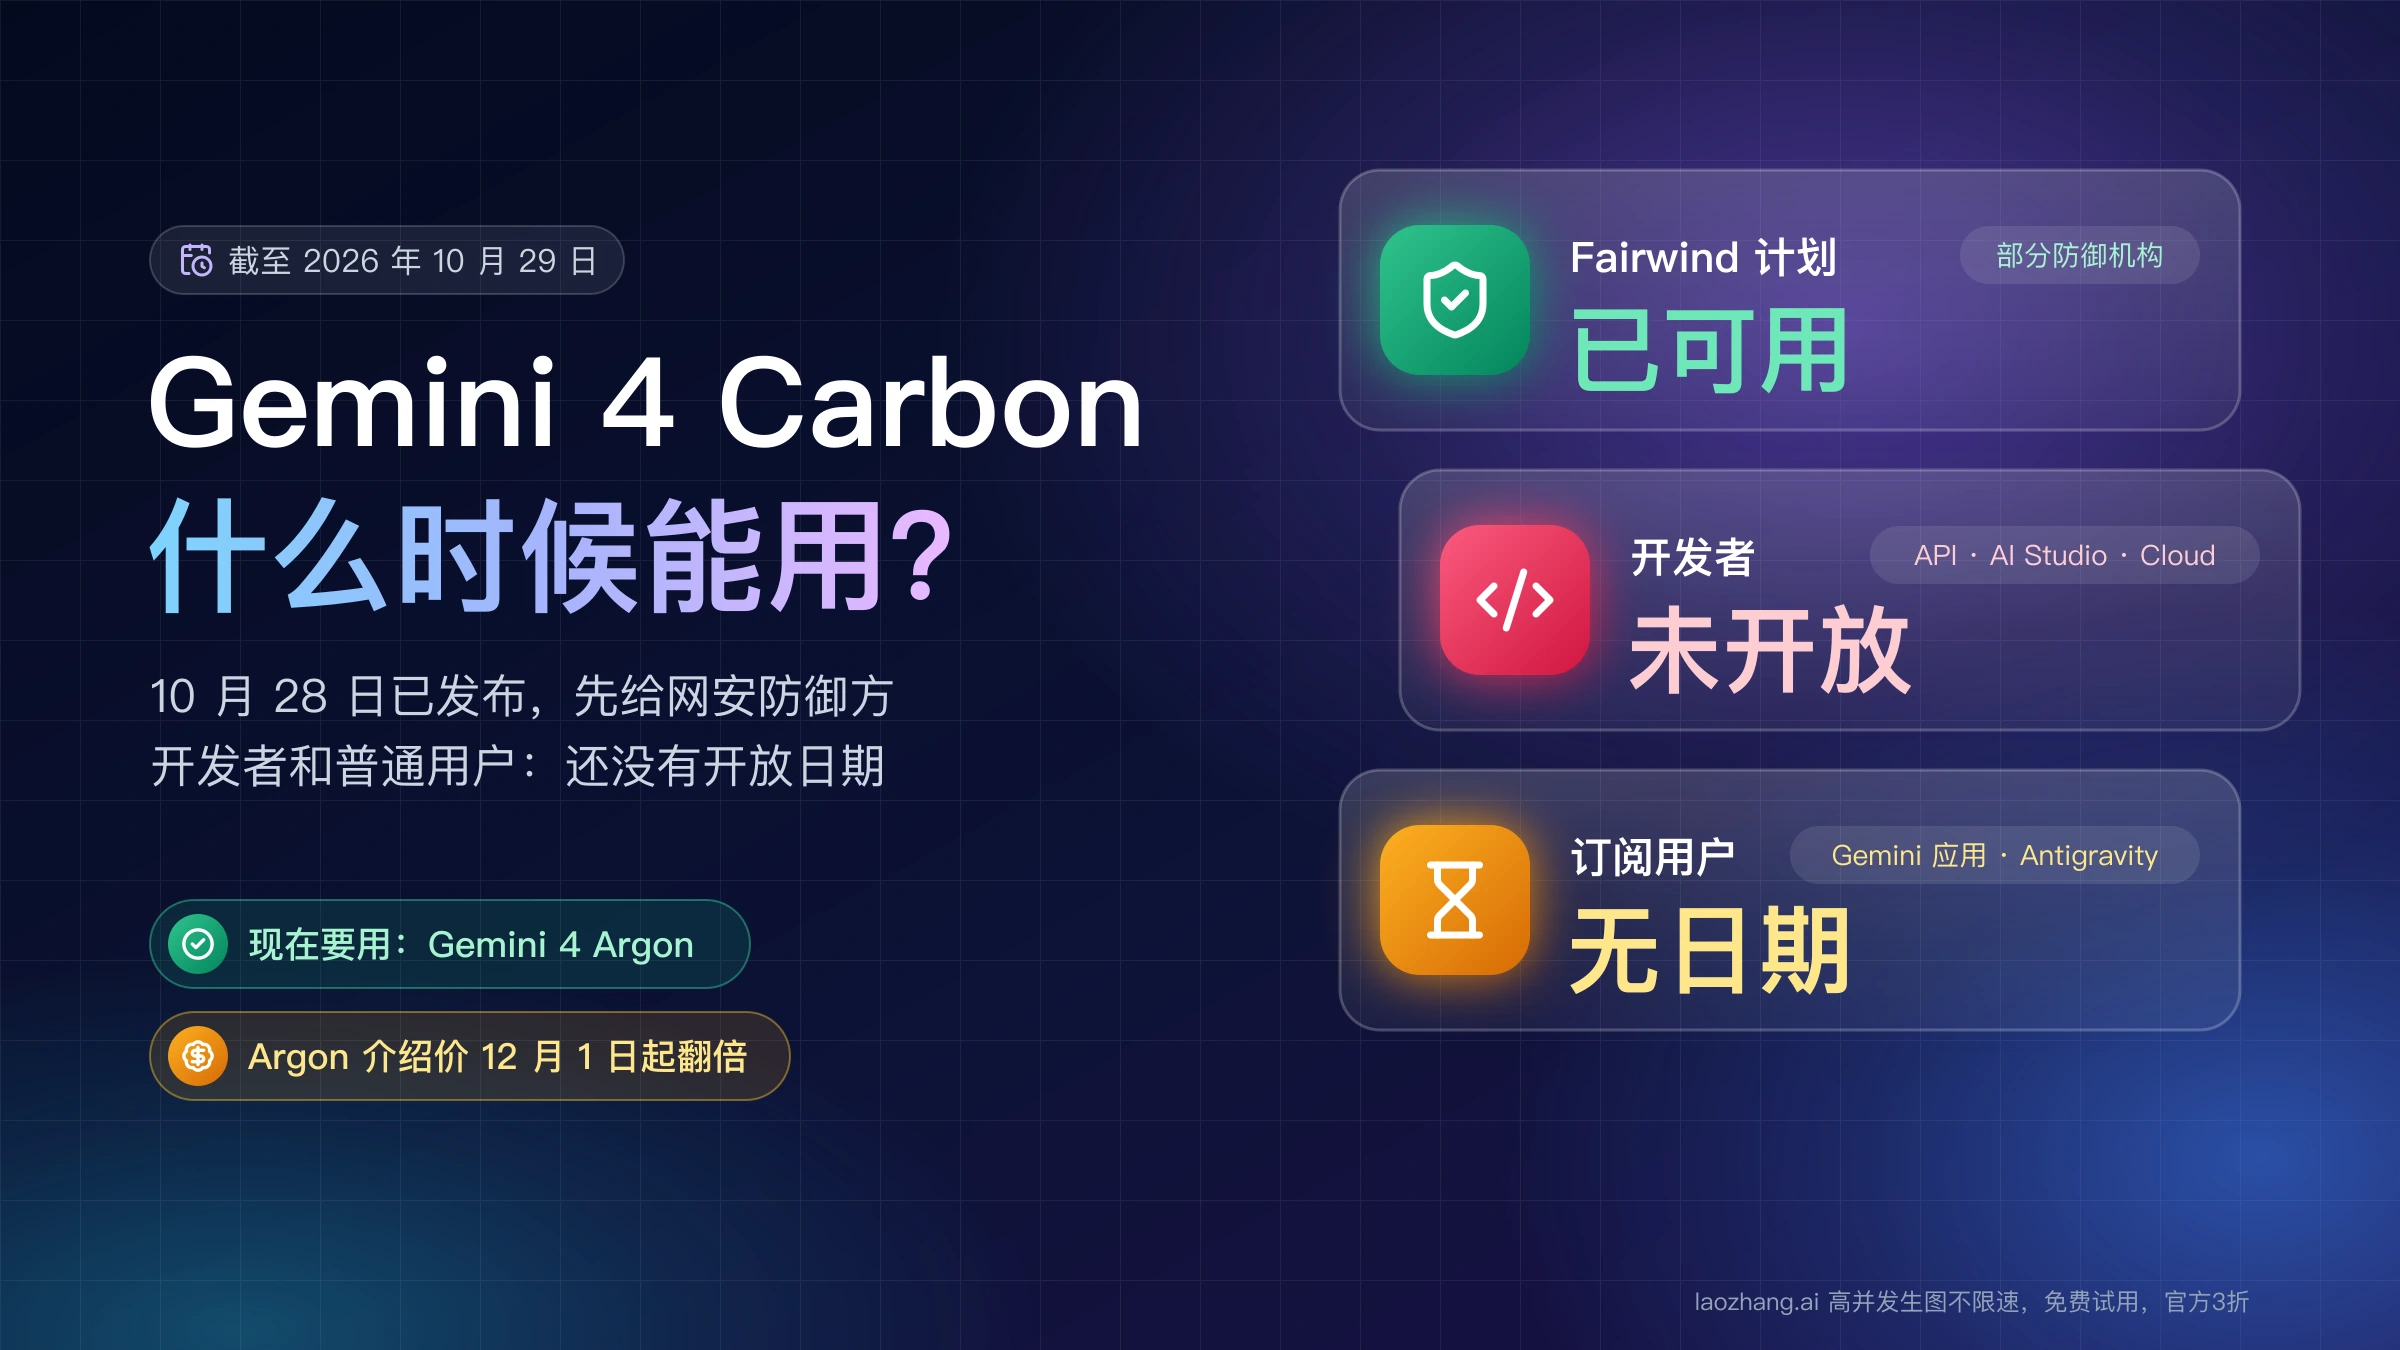
Carbon 今天还用不上。Google 在 10 月 28 日宣布 Carbon 后,只先开放给一部分网络安全防御方,没有公布面向开发者的日期和模型 ID,详情见 Gemini 4 Carbon 什么时候可以用:已发布,但只给网安防御方。所以现在的做法是继续在 gemini-4-argon 上交付,把模型名放进一个配置项,以后改一行就能切换;同时按 12 月 1 日起 Argon 每百万 token 输入 $4、输出 $20 重做预算,因为这一天 Argon 的首发价到期,同样的用量账单翻倍。
"两者同价"和"Carbon 更慢"都只说对一半。同价只在每 token、同一价格阶段成立,12 月 1 日后两者可能处在不同阶段;慢只体现在首 token,生成速度基本相同,整个编程代理任务 Carbon 反而少用约 5 分钟。要秒回的交互式功能,以及要求"不知道就说不知道"的事实问答,即使 Carbon 开放也应先留在 Argon,等自己的测试结果出来再说。
Gemini 4 Carbon 比 Argon 强在哪:九项评测按工作类型拆开
AA 智能指数 v5.0 的九项评测里,Carbon 提升最大的是编程代理和科研推理,多数项目高出 8 到 15 个百分点;文档型知识工作提升中等;SaaS 自动化两者基本打平。下表是截至 2026 年 10 月 30 日 AA 的 Gemini 4 Argon 与 Carbon 对比页上的数据,两者都只测了 high 推理档,用的是 Google 给 AA 的预发布接口,成本按标准价计算。
| 工作类型 | 评测:测什么 | Argon | Carbon | 差距 |
|---|---|---|---|---|
| 编程代理 | FrontierCode 2.0:在开源代码仓库里自主完成软件工程任务 | 25.7% | 40.6% | +14.9 |
| 编程代理 | Terminal-Bench 4.0:在命令行终端里完成工程任务 | 57.1% | 65.2% | +8.1 |
| 推理与科研 | HLE-Diamond:高难度跨学科考题 | 56.7% | 69.1% | +12.4 |
| 推理与科研 | Terminal-Bench-Science:在终端里完成科研计算任务 | 52.9% | 64.8% | +11.9 |
| 推理与科研 | CritPt v2 Hard:研究级物理问题的高难子集 | 52.5% | 63.0% | +10.5 |
| 文档型知识工作 | AA-Briefcase:代理式知识工作的交付物质量,Elo 分 | 1,483.3 | 1,609.5 | +126.2 |
| 文档型知识工作 | GDP.pdf:专业文档任务,所有检查点都通过才算完成 | 21.8% | 28.4% | +6.6 |
| 事实问答 | AA-Omniscience v1.1:知识问答,答错扣分、不答不扣分 | 46.1 | 53.5 | +7.4 |
| SaaS 自动化 | AutomationBench-AA:在 SaaS 应用里跑代理式工作流 | 77.5% | 77.8% | +0.3 |
| 综合 | 智能指数 v5.0 | 50.4 | 59.4 | +9.0 |
AA 按行业算的能力分指数也是同一个走向。工程、法律、经济、金融四类 Carbon 都高 7 分左右,比如工程从 57.3 升到 64.7、法律从 54.6 升到 62.0;战略与运营只从 57.2 升到 60.9,是提升最小的一类;医疗类 AA 还没有给出 Carbon 的分数。把它和 AutomationBench 的持平放在一起看,偏流程、偏运营的工作从 Carbon 得到的好处最少。v5.0 是 AA 在 10 月 27 日前后换上的新版指数,分数不能和之前流传的 v4.3.2 分数直接比。
Google 自己的发布文章里也有一张对比表,那是 Google 自己跑的成绩,目前没有第三方复现。按 Google 的 Gemini 4 Carbon 发布文章,网络安全类提升最明显:找漏洞的 SEC-bench Pro 从 83.4% 到 88.2%,验证可利用性的 ExploitGym 从 42.0% 到 54.8%,这两项是在最高思考档、关闭防护的条件下跑的;间接提示词注入测试 Gray Swan 的攻击成功率从 0.7% 降到 0.0%。这几行主要对安全团队有参考价值。同一张表里也有几乎没涨的项目,例如 Vals Index v2.2 只从 69.2% 到 70.4%,修补漏洞的 CWE-bench 从 68.0% 到 71.0%。
我的工作该用 Carbon 还是 Argon:六类任务的判断规则
编程代理和科研推理是最值得为 Carbon 做切换准备的两类工作;SaaS 自动化和交互式低延迟功能没有理由换;文档型知识工作和事实问答要先用自己的任务测过再定。下面按工作类型给出条件,Carbon 开放前这些都只是"准备什么"的依据,今天的生产流量仍然跑在 Argon 上。
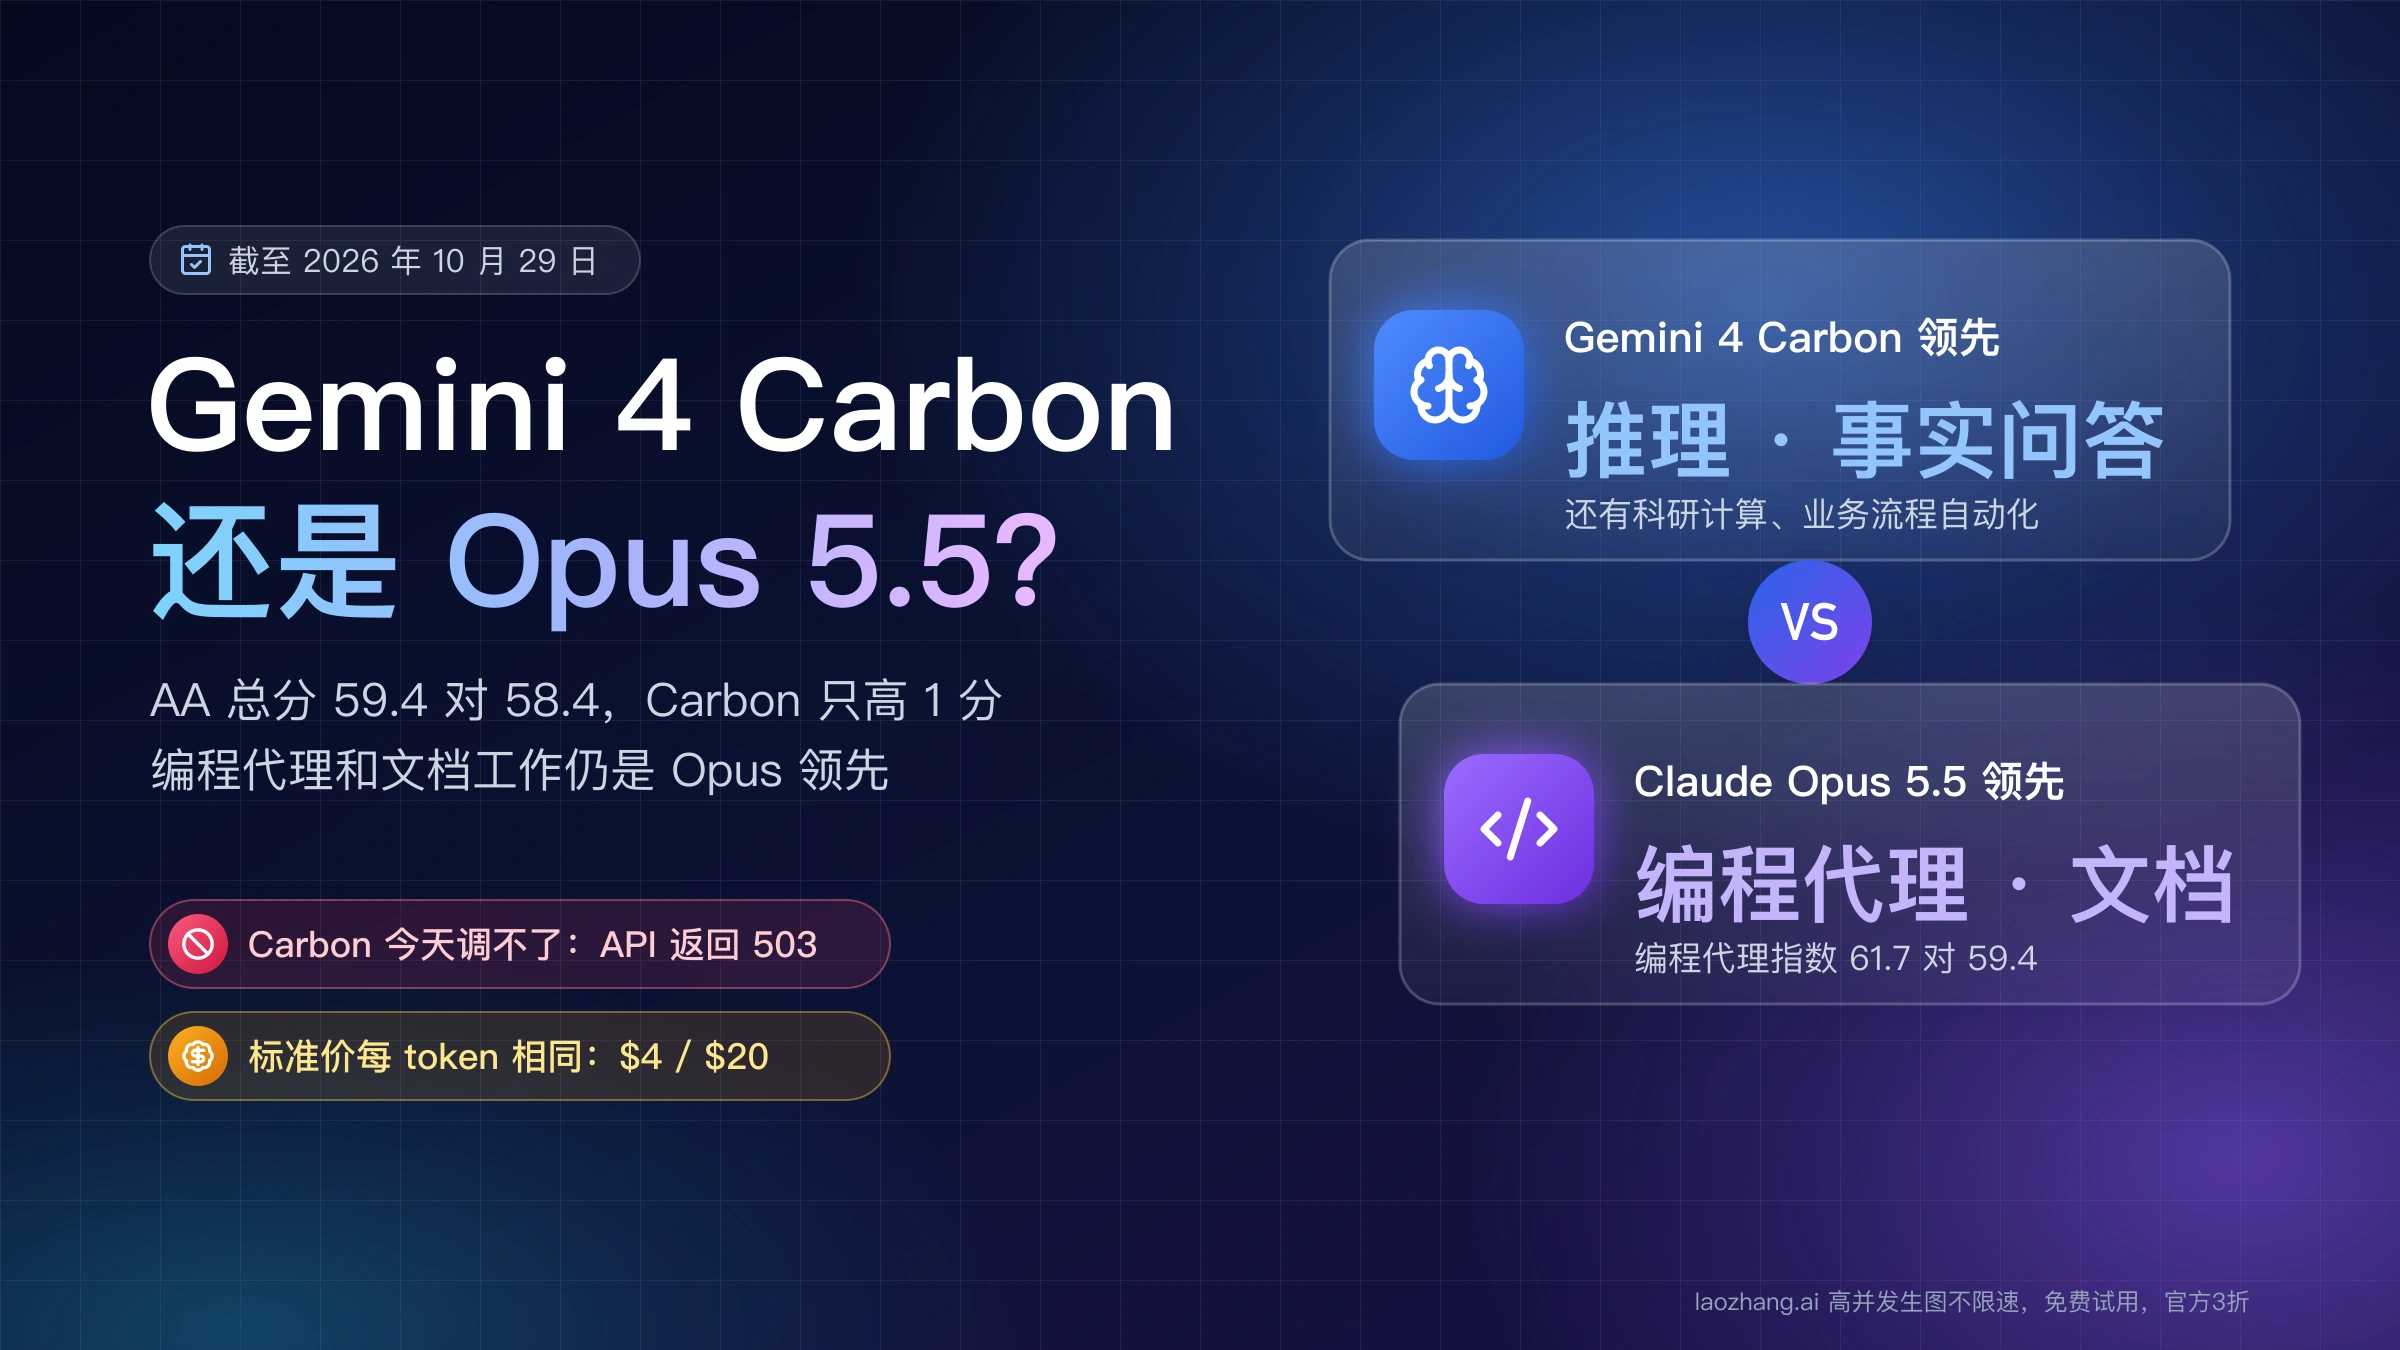
如果你主要跑长时间的编程代理,Carbon 是提升最清楚的一类。AA 编程代理指数用 Antigravity CLI 测两者的 high 档,截至 2026 年 10 月 29 日的数据是 Carbon 59.4、Argon 53.2;其中代码库问答 SWE-Atlas QnA 从 55.1 升到 63.7,同一工具下的 Terminal-Bench v4 从 56.1 升到 63.6(Google 表和 AA 单模型测试里是 65.2%,三个数字来自不同的测法)。更关键的是,Carbon 在这个测试里每个任务用时 29.8 分钟,Argon 要 34.7 分钟,同为标准价时 Carbon 每任务的成本还低约三分之一,具体金额见下面的价格表。拿 Carbon 和 Claude 比,Claude Code 搭配 Opus 5.5 max 在同一指数上是 61.7,仍然领先,细节见 Gemini 4 Carbon vs Opus 5.5 怎么选:编程代理仍是 Opus 领先。
推理和科研类工作同样值得准备。HLE-Diamond 高 12.4 个百分点、Terminal-Bench-Science 高 11.9、CritPt 物理题高 10.5,而这类任务通常是批量或后台跑的,首 token 多等 50 秒影响不大。文档型知识工作的提升要打折看:AA-Briefcase 总分高 126.2 Elo,按 AA 关于 Gemini 4 Carbon 登上智能指数第一的文章,涨得最多的是演示文稿分项(+293 Elo),但 Carbon 的 Briefcase 总分约 1,609,仍低于 Grok 4.7 xhigh 的 1,638、Muse Wonder max 的 1,659 和 Kimi K3.1 Pro 的 1,678;GDP.pdf 的完成率也只从 21.8% 到 28.4%。如果你的交付物主要是幻灯片和分析报告,值得把 Carbon 放进测试名单;写普通文档、整理资料,Argon 已经够用。
SaaS 自动化可以不考虑 Carbon。AutomationBench-AA 上 77.8% 对 77.5%,战略与运营分指数也只高 3.7,在 CRM、工单、表格之间搬数据的代理任务换模型拿不到可测的提升;这类工作更值得问的是 Argon 是不是已经超出需要,可以看 Gemini 4 Argon 和 3.8 Flash 区别:实测成本差多少,哪些任务该换。交互式低延迟功能,比如聊天界面、IDE 里的即时补全和语音助手,按 AA 的 high 档数据,Carbon 单次请求的首 token 等待是 Argon 的两倍多,留在 Argon 更合适。事实问答的情况比较特殊,答对的更多,但硬答错的也更多,下文单独说明。想横向比较今天已经能调用的几家旗舰模型,可以看 Gemini 4 Argon、Opus 5.5、GPT-6.1 Sol 对比:已开放,12 月起涨价。
Gemini 4 Carbon 价格:同价只在同一价格阶段成立
按每百万 token 算,Carbon 和 Argon 的标价完全一样,差别来自时间线和每个任务消耗的 token。截至 2026 年 10 月 30 日,Gemini API 定价页上 gemini-4-argon 的首发价是输入 $2、输出 $10、缓存输入 $0.10,有效期到 11 月 30 日,12 月 1 日起变成 $4、$20 和 $0.20,Batch 和 Flex 都是半价。Google 说 Carbon 上线时用同样的首发价,首发期结束后同样是 $4 和 $20,缓存输入按普通输入价的 5% 收费;但 Carbon 还不能调用,首发价什么时候开始算、什么时候结束都没有公布,AA 的说法是"没有确认的截止日期",Batch 和 Flex 价格也没有公布。
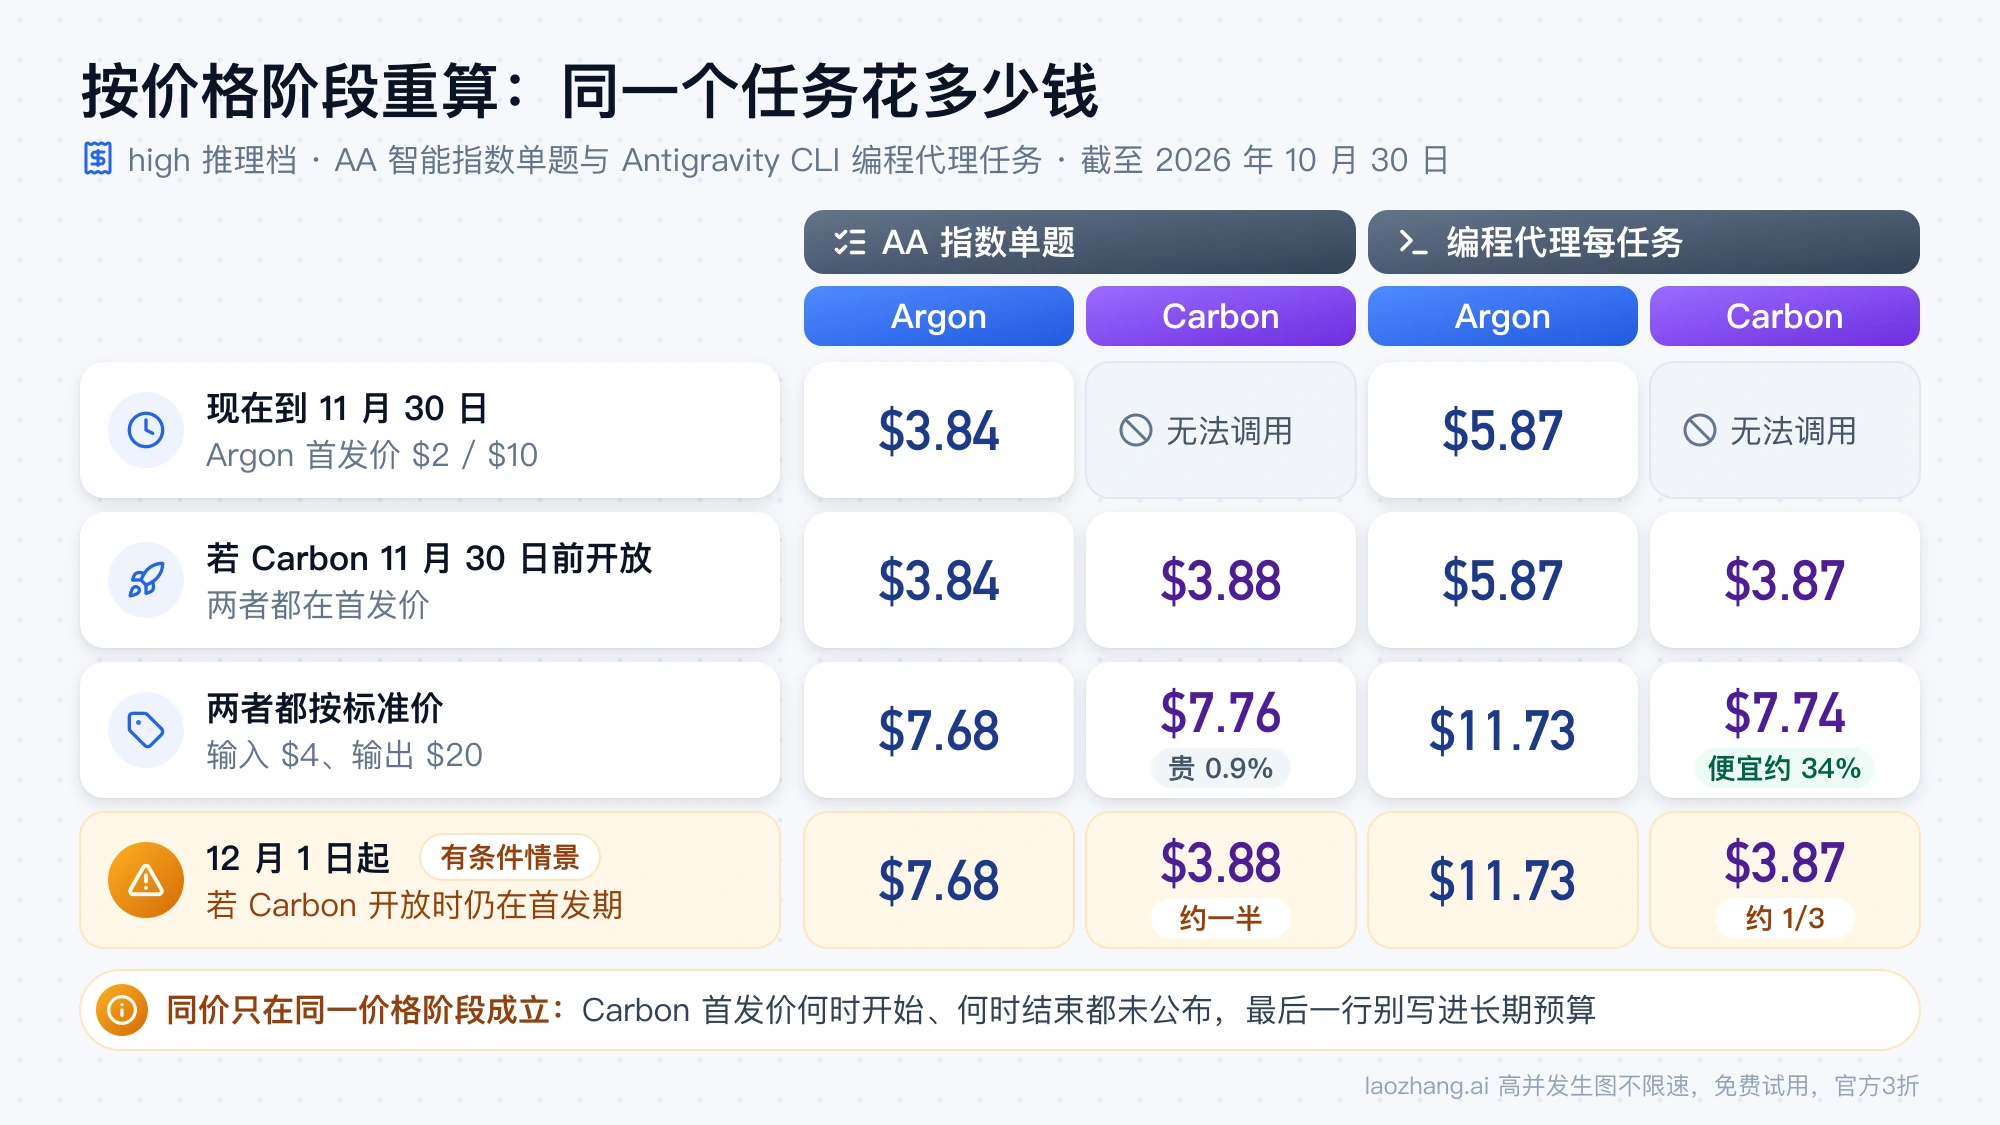
所以"同价"能不能兑现,取决于 Carbon 开放的时间。下表按价格阶段重算两种任务的单任务成本:一种是 AA 智能指数的一道题,另一种是 AA 编程代理指数里 Antigravity CLI 跑完的一个任务,都是 high 推理档。
| 价格阶段 | 指数单题 Argon | 指数单题 Carbon | 编程代理 Argon | 编程代理 Carbon |
|---|---|---|---|---|
| 现在到 11 月 30 日 | $3.84 | 无法调用 | $5.87 | 无法调用 |
| 如果 Carbon 在 11 月 30 日前开放,两者都在首发价 | $3.84 | $3.88 | $5.87 | $3.87 |
| 两者都按标准价 | $7.68 | $7.76 | $11.73 | $7.74 |
| 12 月 1 日起,如果 Carbon 开放时仍在首发期 | $7.68 | $3.88 | $11.73 | $3.87 |
指数单题的 token 用量是从 AA 公布的成本分项反推出来的:Argon 每题输出 116,368 token、读缓存 10,357,304 token,另有约 82.1 万 token 按普通输入计费(含写入缓存的部分,Google 的隐式缓存不单收写入费);Carbon 分别是 122,768、10,195,728 和约 81.5 万。按标准价代入,能复现 AA 给出的总数:
Argon 标准价:0.8210 × 4 + 10.3573 × 0.20 + 0.1164 × 20 ≈ 7.68 美元
Carbon 标准价:0.8153 × 4 + 10.1957 × 0.20 + 0.1228 × 20 ≈ 7.76 美元
(单位:百万 token × 每百万 token 美元单价;首发价每一项都是标准价的一半)
编程代理任务的 $11.73 和 $7.74 直接取自 AA 的标准价结果,因为首发价对输入、输出和缓存都正好打五折,首发价下就是这两个数的一半。从表里能读出三件事。同为标准价时,指数单题 Carbon 只贵 0.9%,原因是它多输出约 5.5% 的 token,按每得 1 分的成本算,Carbon 是 $0.131,反而低于 Argon 的 $0.152。编程代理任务上 Carbon 便宜约 34%;从 AA 公布的分项看,主要原因应该是 Carbon 的缓存命中率更高(95.2% 对 87.0%)、输入 token 更少(1,244 万对 1,376 万),不是 token 单价更低。最后一行是有条件的情景:如果 Carbon 开放时首发期还没结束,12 月 1 日后同一道指数题在 Carbon 上只要 Argon 的一半,编程代理任务约是三分之一,Google 不公布截止日期之前,不要把这一行写进长期预算。
Carbon 是不是更慢:首 token 慢一倍,代理整任务反而更短
"更慢"取决于量的是哪一段时间。截至 2026 年 10 月 30 日,AA 测得 Carbon 的首 token 时间约是 Argon 的 2.1 倍,生成速度基本相同,而在完整的编程代理任务上 Carbon 少用约 5 分钟。具体数字在 AA 对比页上:首个回答 token 出现的时间 Carbon 97.94 秒、Argon 47.20 秒;之后的生成速度 Carbon 每秒 85 个 token、Argon 83 个;输出 500 个 token(含思考)的完整响应时间 Carbon 103.82 秒、Argon 53.23 秒,也是约 2 倍。
AA 页面上还有一个"每任务时间",Carbon 1,452.93 秒、Argon 1,364.94 秒,看起来 Carbon 只慢 6%。这个数是按生成速度折算的解码时间,AA 注明不含首 token 等待和其他开销,不能当成你实际要等多久。编程代理的 29.8 分钟对 34.7 分钟是另一种量法,计的是 Antigravity CLI 从开始到完成一个任务的总时长,Carbon 走了 178 步、Argon 走了 166 步,Carbon 仍然先完成。所以单次请求的等待 Carbon 更长,长任务的总耗时 Carbon 更短,两句话要分开说。
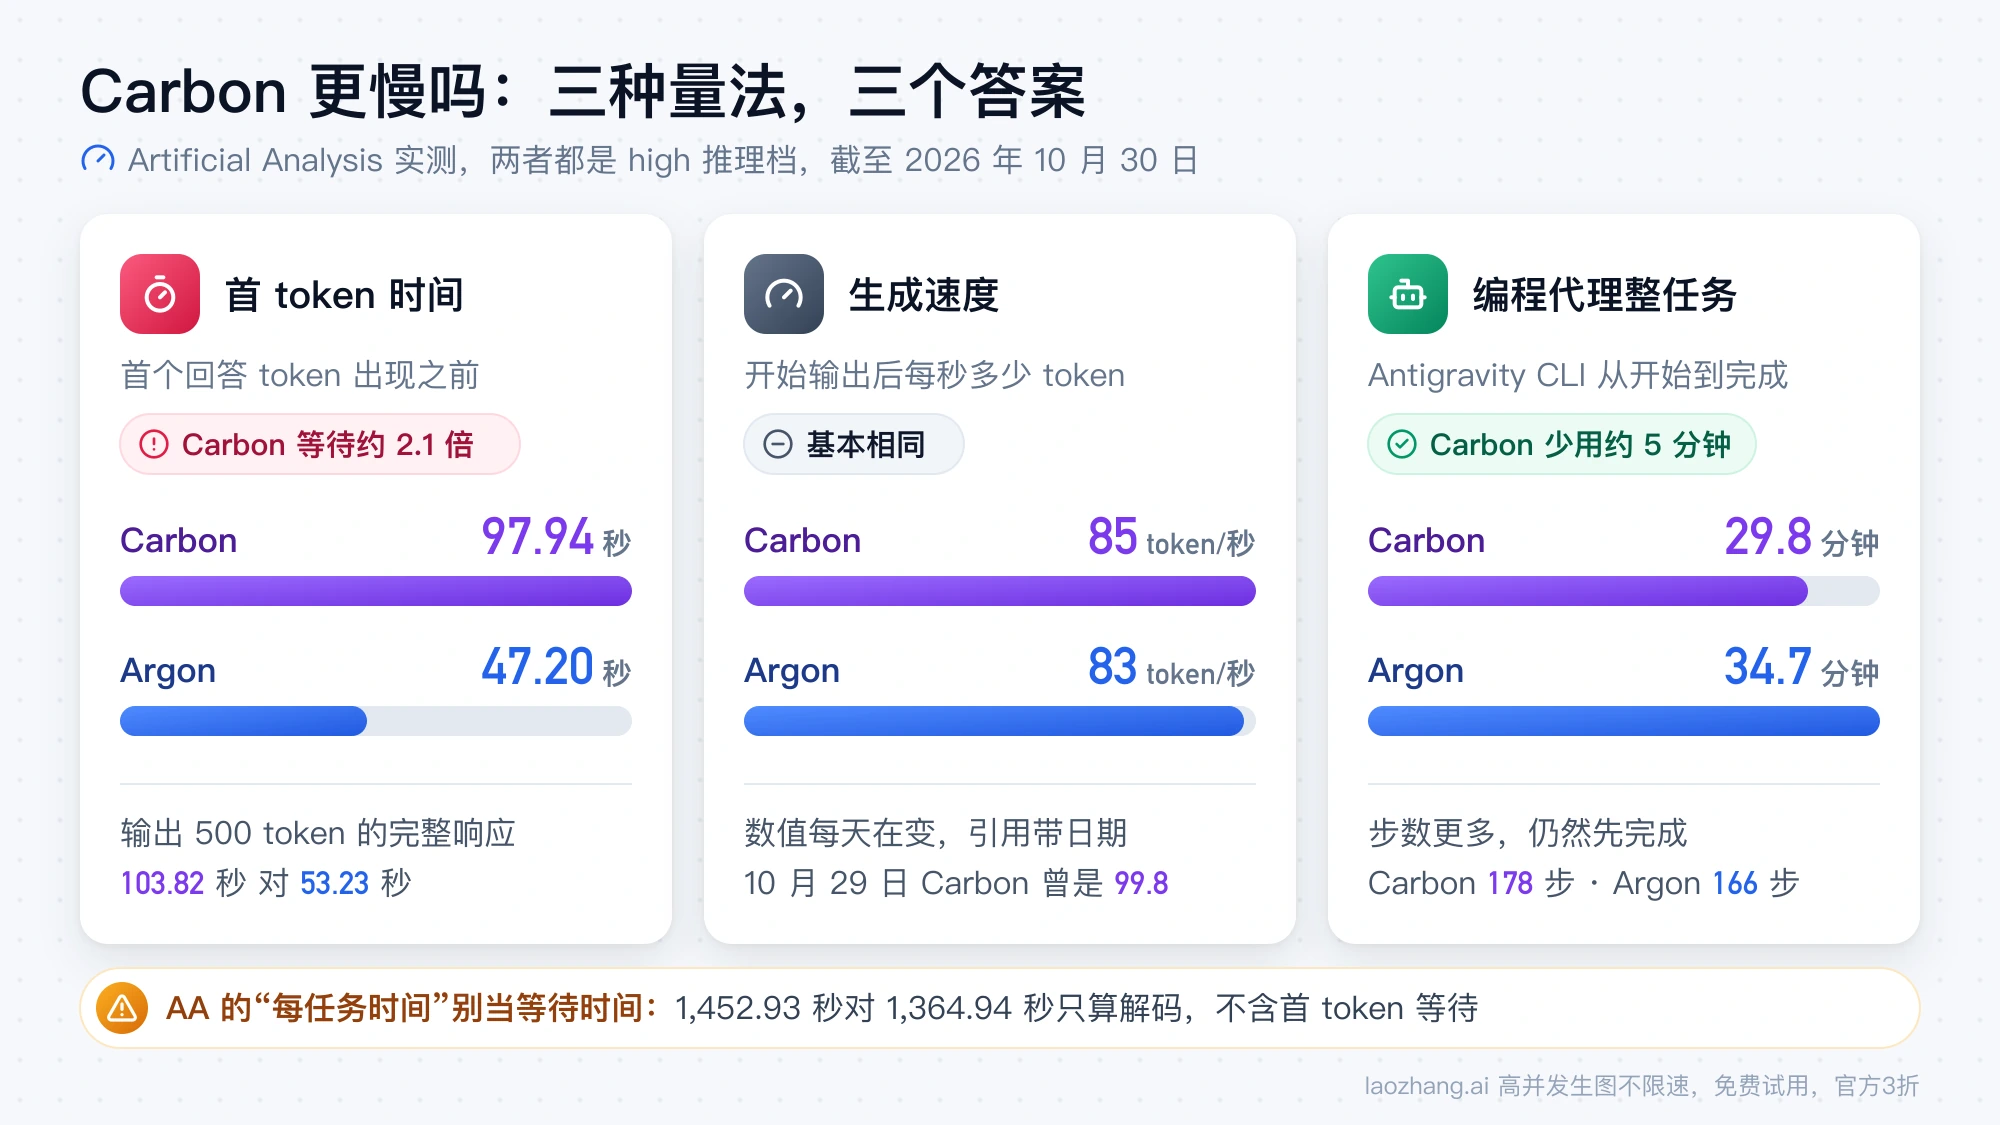
网上流传的"Carbon 慢 2 到 4 倍"出自更早的报道。letslearngenai 10 月 28 日的 Carbon 与 Argon 对比文章引用 Arena 盲测的反馈,说 Carbon 根据任务不同慢 2 到 4 倍,复杂任务接近 30 分钟,同时也写明这是早期访问和盲测的印象,不是标准化的延迟测试,测的还是发布前的版本。AA 的测量只支持"首 token 和短回答约慢 2 倍",不支持 2 到 4 倍。这些速度数值每天都在变,AA 页面在 10 月 29 日显示的 Carbon 生成速度还是每秒 99.8 个 token,公开 API 开放后可能再变,引用时带上日期。
Carbon 幻觉更多吗:AA 测到 11.4%,Google 说减半
两个说法都成立,因为它们量的不是同一件事。AA-Omniscience v1.1 测的是知识问答,答对加分、答错扣分、不答不扣分,其中的幻觉率看的是模型在不知道答案时,是承认不知道,还是给出一个错答案。截至 2026 年 10 月 30 日,Carbon 的正确率从 Argon 的 48.3% 升到 58.3%,幻觉率也从 4.3% 升到 11.4%:Carbon 更愿意作答,所以答对的和答错的都变多了。按 AA 关于 Gemini 4 Carbon 登上智能指数第一的文章,11.4% 在 AA 测过的所有模型里仍是第二低,只比 Argon 高,Opus 5.5 max 和 GPT-6 Astra max 都在 50% 左右。
Google 的说法是另一个场景。Google 称在内部测试中,Carbon 的无依据陈述比 Argon 少了约一半,会把方法上的保留意见直接写进交付物,遇到被阻止的操作会列出还缺什么,而不是编造或含糊带过。这量的是代理任务产出的报告、代码说明里有没有缺乏依据的陈述,是 Google 自测的结果,没有公布测试方法。
所以切换前要测的东西取决于你的产品。如果你做的是客服知识库、内部文档问答这类"答错比不答代价大"的功能,拿自己的问题集测一遍,其中故意放一批文档里没有答案的问题,分别记下 Argon 和 Carbon 回答"不知道"和答错的次数;Carbon 的弃答变少会直接变成错答。如果你的工作是让代理产出带引用的报告,Google 的说法更接近你的场景,但仍要抽查结论有没有对应的出处,而不是只看 Google 的倍数。
2026 年 10 月 30 日实测:gemini-4-carbon 请求返回 503
2026 年 10 月 30 日 00:12(UTC,北京时间 08:12),通过 api.laozhang.ai 用一个按量计费的 key 调用 Carbon,三种请求都在约 1.1 秒内返回 HTTP 503,没有计费。GET /v1/models 正常返回 200,列出 192 个模型,其中 Gemini 4 只有 gemini-4-argon。用 Chat Completions 接口请求 gemini-4-carbon,1.08 秒返回 503;换成 gemini-4-carbon-preview,1.11 秒返回 503;走 Gemini 原生接口 POST /v1beta/models/gemini-4-carbon:generateContent,1.07 秒返回 503。10 月 29 日 01:36 和 03:00(UTC)两次测试结果相同。返回内容如下:
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
{"error":{"message":"Current group default has no available channels for model gemini-4-carbon under billing mode [pay-as-you-go, pay-per-request]","type":"shell_api_error"}}这个结果说明,截至 10 月 30 日,这个网关上没有 Carbon 的可用渠道,无论用哪种猜测的模型名都调用不到,所以秒回 503。它不能说明 Google 官方 API 的情况,因为这次没有用 Google 自己的 key 去调;不过同一天 Gemini API 的模型页和定价页上也都没有任何 Carbon 的模型 ID,gemini-4-carbon 本身只是猜测的名字。laozhang.ai 目前列出的 Gemini 4 模型是 gemini-4-argon,Gemini 原生和 OpenAI 兼容两种调用方式都可以用。
为切换到 Carbon 做准备:今天在 Argon 上做的四件事
现在最有用的准备都在 Argon 上完成,不需要等 Carbon 开放。按下面的顺序做,Carbon 开放那天你只需要改一个配置值,再跑一遍现成的测试:
- 继续用
gemini-4-argon交付,把模型 ID 放进环境变量或配置文件,例如GEMINI_MODEL=gemini-4-argon。Carbon 的正式 ID 还没公布,不要提前在代码里写死gemini-4-carbon。 - 按 12 月 1 日起的标准价重算 Argon 预算,同样的 token 用量账单是现在的两倍;不需要实时返回的任务先挪到 Batch 或 Flex,按现在的定价是半价。
- 从自己的日志里攒一套有标准答案的回归任务,按上文的工作类型分组,记下 Argon 今天的通过率、每任务 token 和总耗时,作为以后对比的基线。
- 检查超时和流式输出。Carbon high 档的首 token 在 AA 的测试里要等近 98 秒,客户端或网关的请求超时如果短于这个时间,同步请求会先超时,要改成流式输出或调大超时。
Carbon 开放第一天,先确认 Google 公布的正式模型 ID、可选的思考档位、首发价截止日期、Batch 和 Flex 是否可用以及速率限制,再在你的回归任务上对比通过率、每任务成本和整个任务的耗时,不要只看首 token。做事实问答的,同时跑一遍上文的弃答测试。Argon 同步请求单次最多输出 65,536 token,回归任务里有长输出的,截断和续写的处理可以参考 Gemini 4 Argon API finish_reason 怎么处理:长输出续写与中转实测。
Gemini 4 Carbon 和 Argon 的其他问题
Gemini 4 Argon 会被 Carbon 取代或下线吗? 截至 2026 年 10 月 30 日,Google 没有宣布 Argon 下线,也没有说 Carbon 会取代 Argon。Google 的发布文章把 Carbon 描述为在 Argon 基础上打造的模型,Gemini API 定价页也已经列出 Argon 从 12 月 1 日起的标准价。
Carbon 的上下文窗口和输入类型跟 Argon 一样吗? Google 没有公布 Carbon 的上下文窗口、输入类型和输出上限。Argon 在 Gemini API 模型页上是 1,048,576 token 的统一上下文;AA 把两者都列为 100 万 token,但那是 AA 的条目,不是 Google 的规格,在 Google 公布前不要按 Carbon 和 Argon 规格相同或不同来做设计。
Gemini 4 Carbon 有 high 以外推理档的测评吗? 目前没有。截至 2026 年 10 月 30 日,AA 对 Carbon 和 Argon 都只测了 high 档,Google 的对比表也没有分档数据,所以上面的分数、成本和延迟都来自 high 档。Carbon 在 low 或 medium 档能把首 token 缩短多少,要等公开 API 开放后才有测量。
怎样才能提前用上 Carbon? Google 的安排是先给一部分网络安全防御方,再通过 Fairwind 计划逐步扩大到更多可信合作伙伴,之后才面向开发者、企业和普通用户。如果你的团队做网络安全防御,资格和申请准备可以参考 Gemini 3.8 Flash Cyber 怎么申请 Fairwind:资格、限制与准备清单;其他团队只能等 Google 公布开放时间。
参考来源6
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月30日。
参考来源6
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月30日。
- 1.AA 的 Gemini 4 Argon 与 Carbon 对比页artificialanalysis.ai/models/comparisons/gemini-4-argon-vs-gemini-4-carbon
- 2.Google 的 Gemini 4 Carbon 发布文章blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon
- 3.AA 编程代理指数artificialanalysis.ai/agents/coding-agents
- 4.AA 关于 Gemini 4 Carbon 登上智能指数第一的文章artificialanalysis.ai/articles/gemini-4-carbon-new-number-1
- 5.Gemini API 定价页ai.google.dev/gemini-api/docs/pricing
- 6.letslearngenai 10 月 28 日的 Carbon 与 Argon 对比文章letslearngenai.com/articles/gemini-4-carbon-vs-gemini-4-argon-a-faster-flagship-becomes-a-harder-working-one-2026-10-28