Gemini 4 Argon 和 3.8 Flash 区别:实测成本差多少,哪些任务该换
Argon 单价是 3.8 Flash 的 2.67 倍,同题实测默认级别只贵约 1.6 倍,仅 12 月差距翻倍;终端和 Agent 任务换 Argon,其余留在 Flash。
文章目录
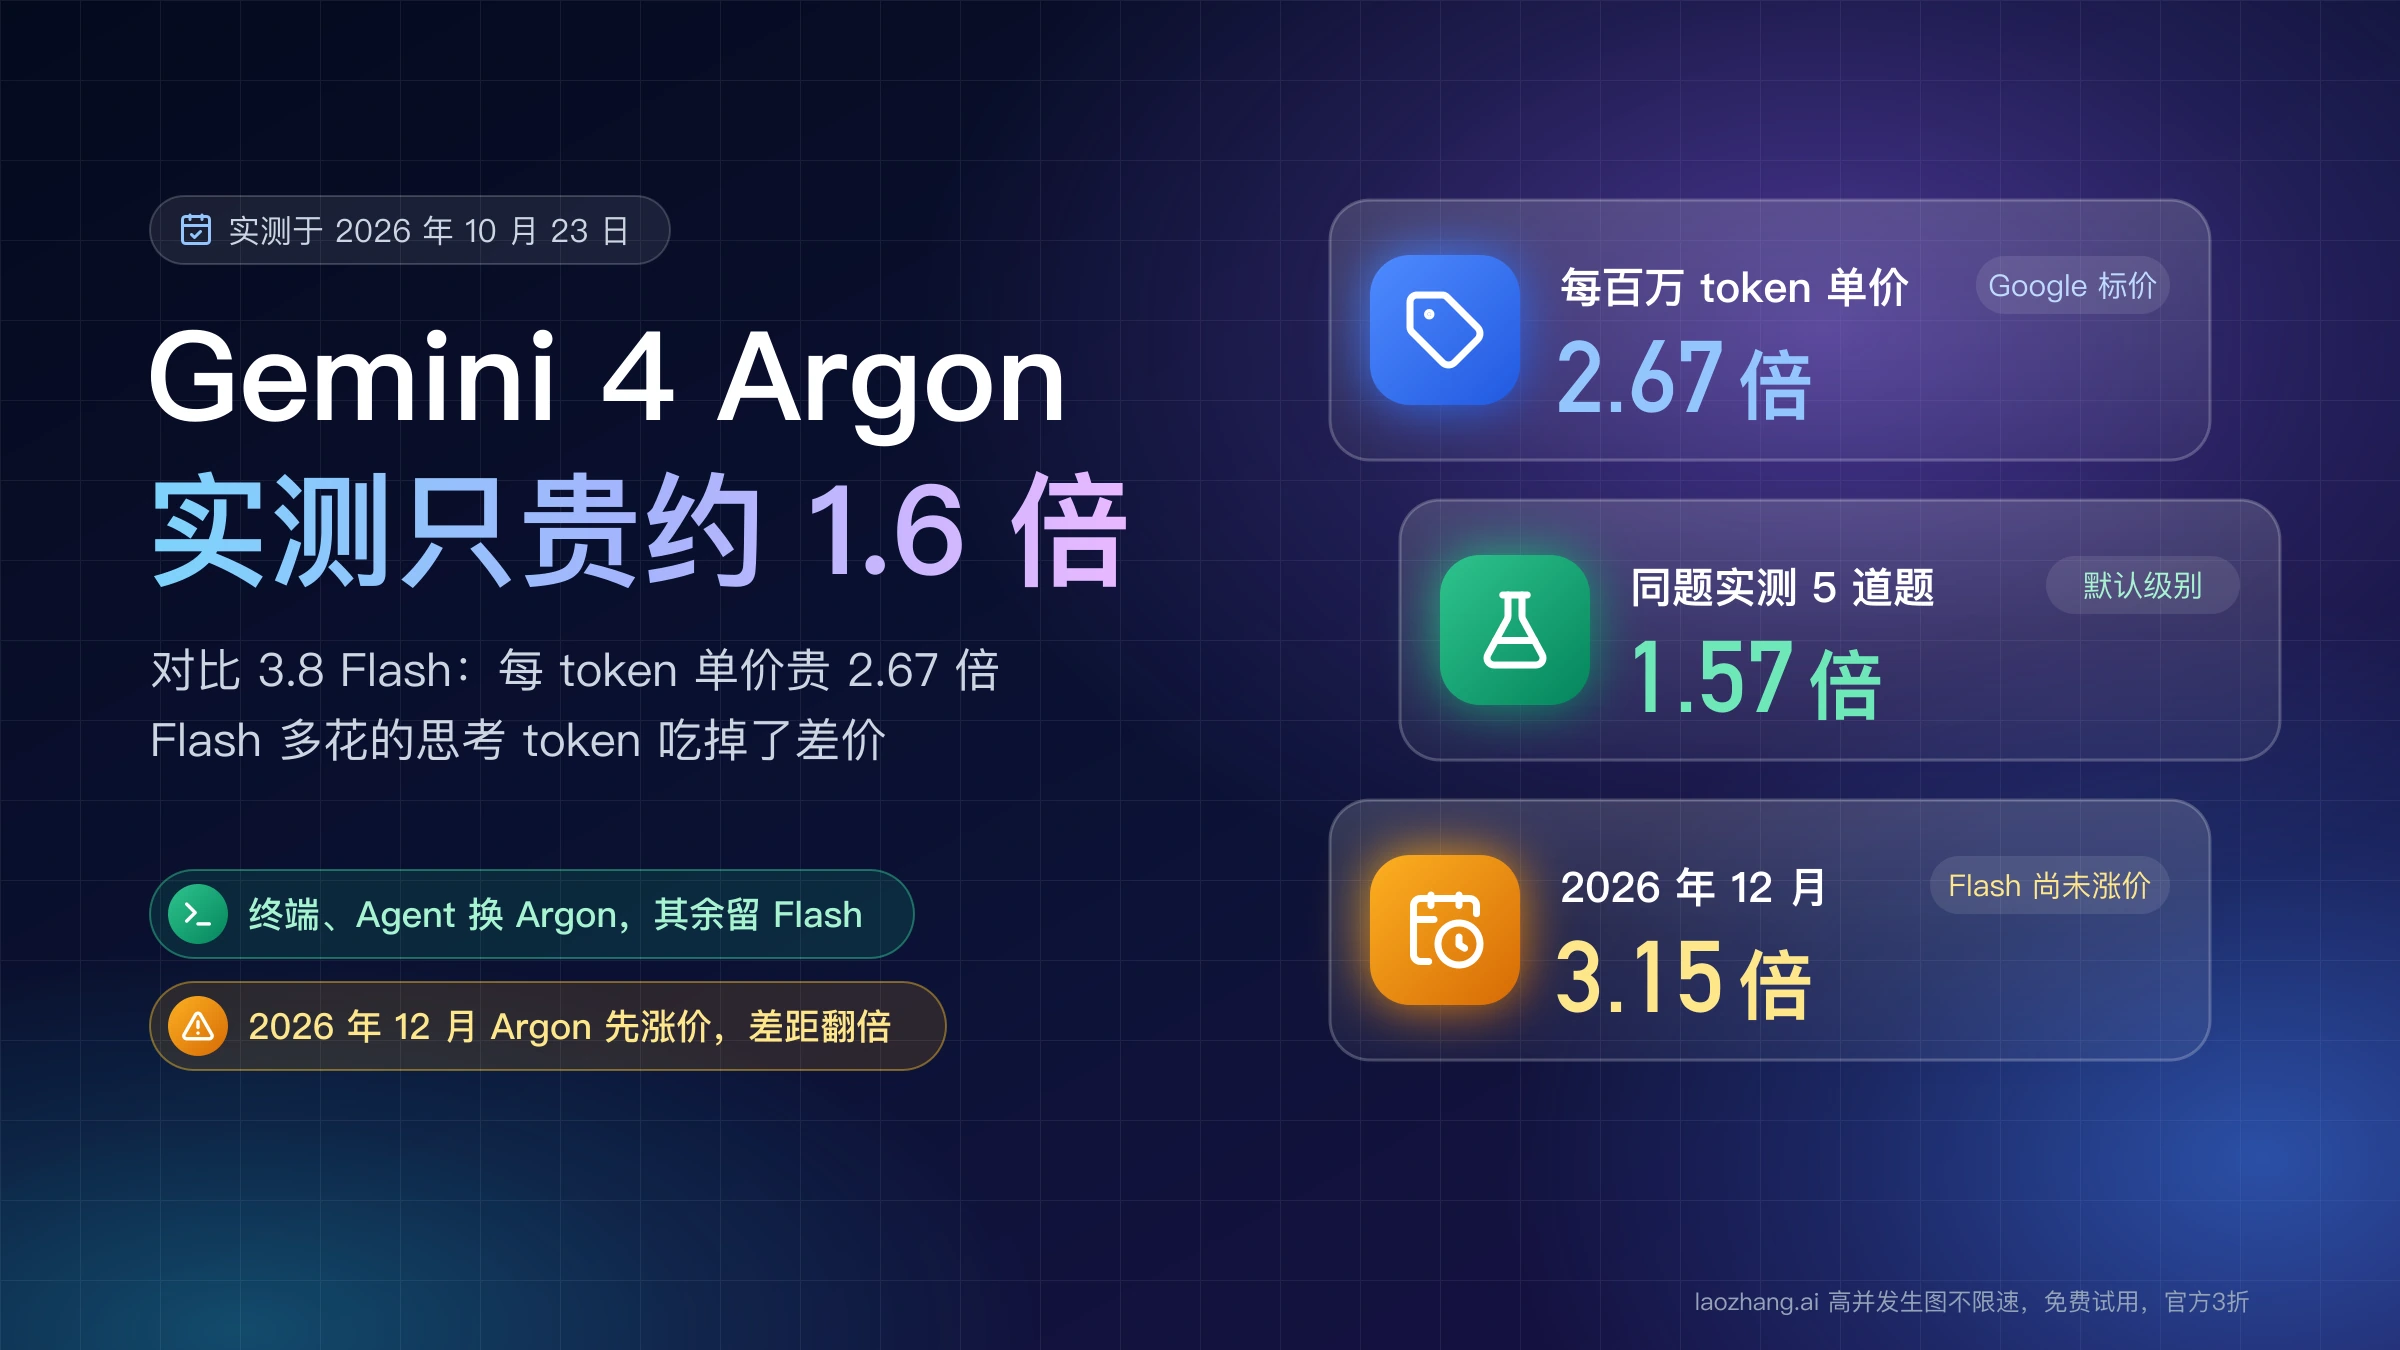
Gemini 4 Argon(gemini-4-argon)在 2026 年 10 月 13 日正式开放,Gemini API 标价是每百万 token 输入 $2、输出 $10(2026 年 11 月 30 日前),3.8 Flash(gemini-3.8-flash)是 $0.75 和 $3.75,按 token 算 Argon 贵 2.67 倍。但同一件活 Flash 往往要多花思考 token:2026 年 10 月 23 日用同一批 5 道题实测,两个模型都用默认思考级别,Argon 合计只贵 1.57 倍;Artificial Analysis 在难题上让两者都开 High,每个任务也只差约 1.6 倍。2026 年 12 月 1 日 Argon 涨价一倍,这个月差距会拉到 3 倍以上,2027 年 1 月 1 日 Flash 也涨价后又回到约 1.6 倍。
所以没有必要整体替换。终端操作、多步 Agent、难的代码和数学,把模型 ID 换成 gemini-4-argon,Argon 在这类测试上领先最多;短问答、分类、长文档总结和大批量调用留在 gemini-3.8-flash,这类任务两者质量接近,Flash 按每百万 token 的单价便宜得多,每秒输出也更快,只是很短的请求按次算两者花费差不多。拿不准的请求先交给 Flash,测试不通过或需要返工时再升级到 Argon。
有两种情况先别换:你还在用 Gemini API 免费层(Argon 不在免费层),或者代码依赖显式上下文缓存 cachedContents(Argon 不支持)。在 Gemini 应用和 Antigravity 里,Argon 只对 Google AI Pro 和 Ultra 开放,Google AI Plus 和免费账号用不了。
单价差多少:Argon 每百万 token 贵 2.67 倍,12 月贵 5.33 倍
截至 2026 年 10 月 23 日,按 Google 的 Gemini API 价格页,Standard 档的 Argon 输入、输出单价都是 3.8 Flash 的 2.67 倍,输出价包含思考 token。两个模型各有一次已公布日期的调价:Argon 从 2026 年 12 月 1 日起翻倍到 $4 / $20,Flash 从 2027 年 1 月 1 日起翻倍到 $1.50 / $7.50。中间这一个月 Argon 已涨、Flash 未涨,每 token 差距变成 5.33 倍,2027 年起回到 2.67 倍。
| 每百万 token,Standard 档 | Argon,2026 年 11 月 30 日前 | Argon,2026 年 12 月 1 日起 | 3.8 Flash,2026 年 12 月 31 日前 | 3.8 Flash,2027 年 1 月 1 日起 |
|---|---|---|---|---|
| 输入 | $2.00 | $4.00 | $0.75 | $1.50 |
| 输出(含思考 token) | $10.00 | $20.00 | $3.75 | $7.50 |
| 缓存命中的输入 | $0.10,只有隐式缓存 | $0.20 | $0.075 | $0.15 |
| 显式缓存存储,每小时 | 不支持 | 不支持 | $0.50 | $1.00 |
| Batch / Flex 输入与输出 | $1 / $5 | $2 / $10 | $0.375 / $1.875 | $0.75 / $3.75 |
两个模型的价格都不分提示词长度,没有超过 200K token 另计一档的规则。上下文也不能只比"1M":两者都标 1,048,576 token,但 Argon 的这个窗口由输入、思考和输出共用,而两者普通请求的输出上限都是 65,536 token。Batch 和 Flex 对两者都是 Standard 的一半,倍数关系不变。差别在价格表之外的两行:3.8 Flash 有免费层,免费层的数据会被用于改进 Google 的产品,付费层不会;Argon 没有免费层,用它就要付费。缓存方面,Flash 可以用显式缓存把固定的长前缀存起来按小时付存储费,Argon 只有默认开启的隐式缓存,提示词达到 4,096 token 且命中时输入按 5% 计价。Flash 的购买流程和 2027 年涨价的细节见 Gemini API Key 购买前先看:价格、免费额度与 2027 年 Flash 涨价。
单价倍数不等于每个任务的倍数,因为两个模型完成同一个任务用的 token 不一样多。Artificial Analysis 的Gemini 4 Argon 与 3.8 Flash 对比页让两者都开 High 跑完它的智能指数,平均每个任务 Argon 花 $1.99、Flash 花 $1.24(按 11 月 30 日前的价格),只差 1.6 倍;原因是 Flash 每个任务平均输出 71k token(其中思考 43k),比 Argon 的 62k(思考 36k)多约 15%,多出来的 token 吃掉了一部分单价优势。假设 token 用量不变,2026 年 12 月 Argon 每任务约 $3.98,是 Flash 的约 3.2 倍;2027 年 1 月起 Flash 约 $2.48,又回到约 1.6 倍。这几个数是用价格页和 Artificial Analysis 的 token 数算出来的,不是它的实测,涨价后它会按新价格重新公布。
同题实测 12 次调用:简单题 Argon 更便宜,长文档贵 2 倍
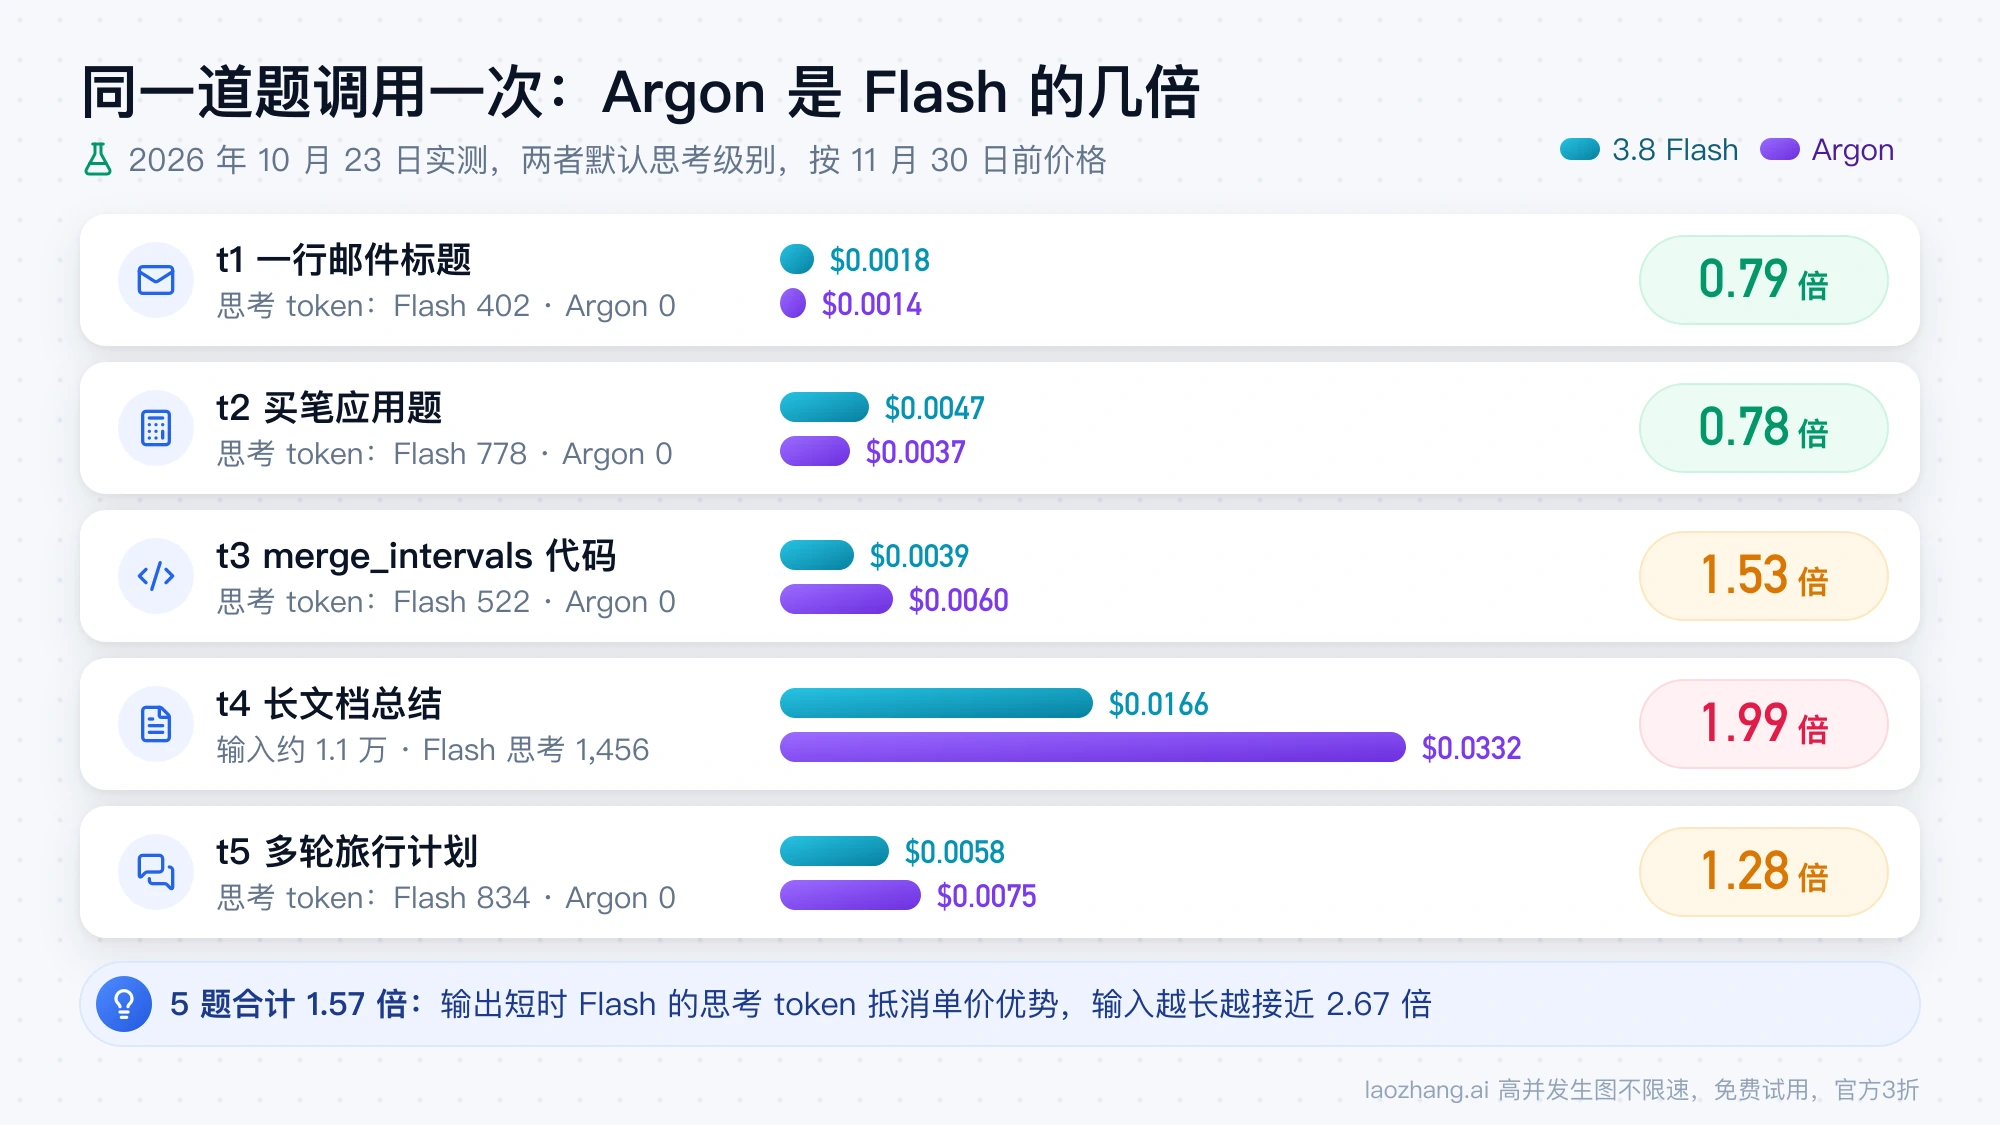
2026 年 10 月 23 日晚上,用同一批提示词给两个模型各发了 12 次请求,覆盖 5 类任务,费用按返回的 token 数和 Google 标价计算。两者都用默认思考级别时,一行邮件标题和买笔应用题 Argon 反而更便宜,代码、长文档总结和多轮对话 Argon 更贵,其中长文档总结贵 1.99 倍;能核对对错的两道题,两个模型都答对了。
5 道题分别是:写一行通知改期的邮件标题(t1);买笔的最省钱组合应用题(t2);用 Python 写 merge_intervals 并附 6 个 pytest 测试(t3);总结一篇 6,723 个英文单词的文章并列出 3 条需要核实的说法(t4,约 11,100 个输入 token);在 4 轮对话之后把旅行计划整理成带欧元预算的表格(t5)。每道题用默认级别跑一次,t3 另跑 low 和 medium,5 道题再各跑一次 high,每个组合只有一个样本,没有重跑挑结果。
调用都经过老张API(laozhang.ai),3.8 Flash 走 OpenAI 兼容端点(/v1/chat/completions,用 reasoning_effort 设级别),Argon 走 Gemini 原生端点(generateContent,用 thinkingConfig.thinkingLevel)。两边端点不同是因为当晚 3.8 Flash 的原生端点连续 4 次超时,而 Argon 在 OpenAI 兼容端点上 reasoning_effort 看不出效果,high 和默认几乎一样,也不报告思考 token。每次调用返回的模型 ID 都是 gemini-3.8-flash 或 gemini-4-argon。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
下表是两者各自默认级别的结果,Gemini API 思考功能文档写明两个模型的默认都是 medium。token 列依次是输入、思考、可见输出,成本按 2026 年 11 月 30 日前的价格计算。
| 题目 | 3.8 Flash token | Flash 成本 | Argon token | Argon 成本 | Argon 是 Flash 的 |
|---|---|---|---|---|---|
| t1 一行邮件标题 | 23 / 402 / 67 | $0.0018 | 53 / 0 / 129 | $0.0014 | 0.79 倍 |
| t2 买笔应用题 | 61 / 778 / 456 | $0.0047 | 92 / 0 / 347 | $0.0037 | 0.78 倍 |
| t3 merge_intervals 代码 | 61 / 522 / 503 | $0.0039 | 91 / 0 / 577 | $0.0060 | 1.53 倍 |
| t4 长文档总结 | 11,191 / 1,456 / 741 | $0.0166 | 11,102 / 0 / 1,097 | $0.0332 | 1.99 倍 |
| t5 多轮旅行计划 | 218 / 834 / 676 | $0.0058 | 267 / 0 / 693 | $0.0075 | 1.28 倍 |
倍数高低取决于两件事。Flash 在默认级别每次都报告了 402–1,456 个思考 token,Argon 在这些题上默认级别报告的是 0,所以输出短的 t1、t2 上 Flash 的思考 token 抵消了单价优势,Argon 更便宜。t4 有 1 万多个输入 token,输入费用占 Argon 这次成本的约三分之二,输入单价的 2.67 倍直接体现出来,Flash 多想的那点 token 抵不过,所以输入越长,倍数越接近 2.67。Argon 在默认级别是确实没有思考,还是这条线路没有报告,单凭这次测试分不出来;按 Google 的计费规则,思考 token 按输出计费,上表用的就是线路实际返回、会被计费的 token 数。
把 5 道题加总,再按三个价格时期分别计算:
| 价格时期 | 单价倍数 | Flash 5 题合计 | Argon 5 题合计 | Argon 是 Flash 的 |
|---|---|---|---|---|
| 2026 年 11 月 30 日前 | 2.67 倍 | $0.0328 | $0.0516 | 1.57 倍 |
| 2026 年 12 月 1 日至 31 日 | 5.33 倍 | $0.0328 | $0.1033 | 3.15 倍 |
| 2027 年 1 月 1 日起 | 2.67 倍 | $0.0656 | $0.1033 | 1.57 倍 |
1.57 倍和 Artificial Analysis 难题上的 1.6 倍很接近,两种完全不同的测法指向同一个方向:Flash 多用的思考 token 吃掉了一部分单价优势。不过两者的条件不同,一个是短到中等任务、各自默认级别,一个是难题、两者都开 High,不能合成一个数。
把 Argon 开到 high 后,它开始报告思考 token(t1 445 个,t4 2,439 个),5 题合计从 $0.0516 涨到 $0.1110,约为它默认级别的 2.15 倍,是 Flash 同样请求 high 时合计 $0.0322 的 3.44 倍,2026 年 12 月是 6.89 倍。这个对照偏向 Flash 更便宜,因为在 Flash 走的 OpenAI 兼容端点上,reasoning_effort 没有明显改变它的思考 token(t3 在默认、low、medium、high 下分别是 522、516、588、512),Flash 的 high 实际上和默认差不多。
质量上只核对了能判对错的两道题。t3 把 8 份代码答案(两个模型各 4 个级别)都抽出来用 pytest 9.1.1 运行,每一份都是 6 个测试全部通过;t2 的 4 份答案(两个模型的默认和 high)都算出买 10 支装 4 盒加 6 支装 3 盒,共 58 支,$41.50,答案正确。t1、t4、t5 没有评分。这些题对两个模型都不难,所以这次测试说明的是成本,不是谁更聪明。
耗时只能当作参考。Flash 默认级别 t2、t3、t5 分别用了 9.3、8.8、15.5 秒,t4 用了 124.9 秒,t1 是第 4 次尝试才成功、用了 98.6 秒;Argon 默认级别 5 道题分别是 6.8、10.8、15.5、20.1、59.7 秒。测试期间 20:17 到 20:21(北京时间)前后,Flash 先后返回 429"当前分组上游负载已饱和"和 503"This model is currently experiencing high demand",还有几次读取超时,Argon 的请求都是一次成功。这只是一条线路、一个晚上的情况,不能说明 Flash 一贯不稳定;速度要看 Artificial Analysis 的数据,下一节有。
把单次成本放大到自己的流量上,可以这样算(以下是计算,不是实测)。假设每月 10 万次和 t4 类似的长文档总结:Flash 每次是 11,191 × $0.75 加 (1,456 + 741) × $3.75,再除以 100 万,约 $0.0166,10 万次约 $1,663;Argon 每次是 11,102 × $2 加 1,097 × $10,再除以 100 万,约 $0.0332,10 万次约 $3,317。2026 年 12 月 Argon 涨价后约 $6,635 而 Flash 不变,2027 年 1 月起 Flash 涨到约 $3,326,Argon 仍约 $6,635。
这次没有测试的部分:Google 直连端点和 Vertex AI、Batch 与 Flex、长时间运行的 Agent 会话、Gemini 应用和 Antigravity,以及 t2、t3 以外的答案质量。这些内容在下文出现时,来自 Google 文档、Artificial Analysis、BenchLM 或用户报告,各自标明。
Argon 强在哪:终端和多步任务差距最大,长文档阅读打平
两者差距集中在终端操作、多步自动化和最难的数学上。Artificial Analysis 让两个模型都开 High 测试,Terminal-Bench 4.0 上 Argon 57%、Flash 20%;而长上下文推理 AA-LCR 上 Argon 80%、Flash 81%,几乎没有差别。综合的 Artificial Analysis 智能指数 v4.3.2 是 53 对 41。
| 测试 | 测的方向 | Gemini 4 Argon | Gemini 3.8 Flash | 来源 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 终端命令行任务 | 57% | 20% | Artificial Analysis,High |
| AutomationBench-AA | 多步自动化流程 | 78% | 60% | Artificial Analysis,High |
| FrontierMath v2 Tier 4 | 最难一档数学 | 78.0% | 22.0% | BenchLM |
| ARC-AGI-3 | 新题型推理 | 46.3% | 10.4% | BenchLM |
| Humanity's Last Exam | 高难度学科题 | 57% | 48% | Artificial Analysis,High |
| SciCode | 科研代码 | 62% | 57% | Artificial Analysis,High |
| DeepSWE | 软件工程任务 | 77.9% | 73.8% | BenchLM |
| AA-LCR v1.1 | 长上下文推理 | 80% | 81% | Artificial Analysis,High |
| LVBench | 长视频理解 | 91.7% | 87.1% | BenchLM |
| Gray Swan IPI | 提示词注入成功率,越低越好 | 0.7% | 5.5% | BenchLM |
BenchLM 的数字来自它的Gemini 3.8 Flash 与 Gemini 4 Argon 对比页(页面标注 2026 年 10 月 20 日更新),混合了厂商公布和第三方测得的成绩,总分在不同时间读取时有变动,大约是 Flash 69、Argon 81 到 83,分项比总分更有参考价值。从表里能看出一条清楚的分界:Terminal-Bench、FrontierMath 和 ARC-AGI-3 这类要连续操作或解决最难推理的测试,Argon 的分数是 Flash 的约 2.9 到 4.5 倍,多步自动化也领先 18 个百分点;读长文档、看长视频、常规软件工程这类测试,两者只差几个百分点,长上下文推理 Flash 还略高。Gray Swan 一行对 Agent 也重要,让模型读网页、邮件这类外部内容时,Argon 被注入指令带偏的比例低得多。
速度是 Flash 的优势。同样开 High,Artificial Analysis 测得 Flash 每秒输出 142 个 token、首个 token 平均 24.70 秒,Argon 是每秒 82 个、48.05 秒;跑完一个智能指数任务平均 Flash 489 秒、Argon 722 秒。Argon 每秒出字慢,但任务里用的 token 更少,所以总耗时的差距比速度差距小。
Agent 任务上 Argon 步骤更少的说法,目前只有用户报告,没有成体系的测量。Reddit r/singularity 有人报告,Argon 在宝可梦游戏里拿下冠军所用的 token,不到 Flash 拿到 3 枚徽章所花的一半;X 上也有开发者说 Flash 完成一件事需要大量步骤和工具调用,Argon 给它明确任务就照做,不会做一堆多余操作。这和 Artificial Analysis 里 Flash 每任务 token 更多的方向一致,但具体省多少,要在你自己的 Agent 上测。
哪些任务留在 3.8 Flash,哪些换成 Argon
按任务分流,而不是按"新模型更好"整体切换:任务要在终端里执行命令、要跨很多步调用工具、或者 Flash 反复做不对,交给 Argon;单轮、短输出、长文档读取和摘要、高并发批量处理,留在 Flash。这条规则是根据上面的测试分数和实测成本得出的,Google 自己的定位与它一致,把 3.8 Flash 称作"daily workhorse"(日常主力),把 Argon 定位为处理最难的问题。
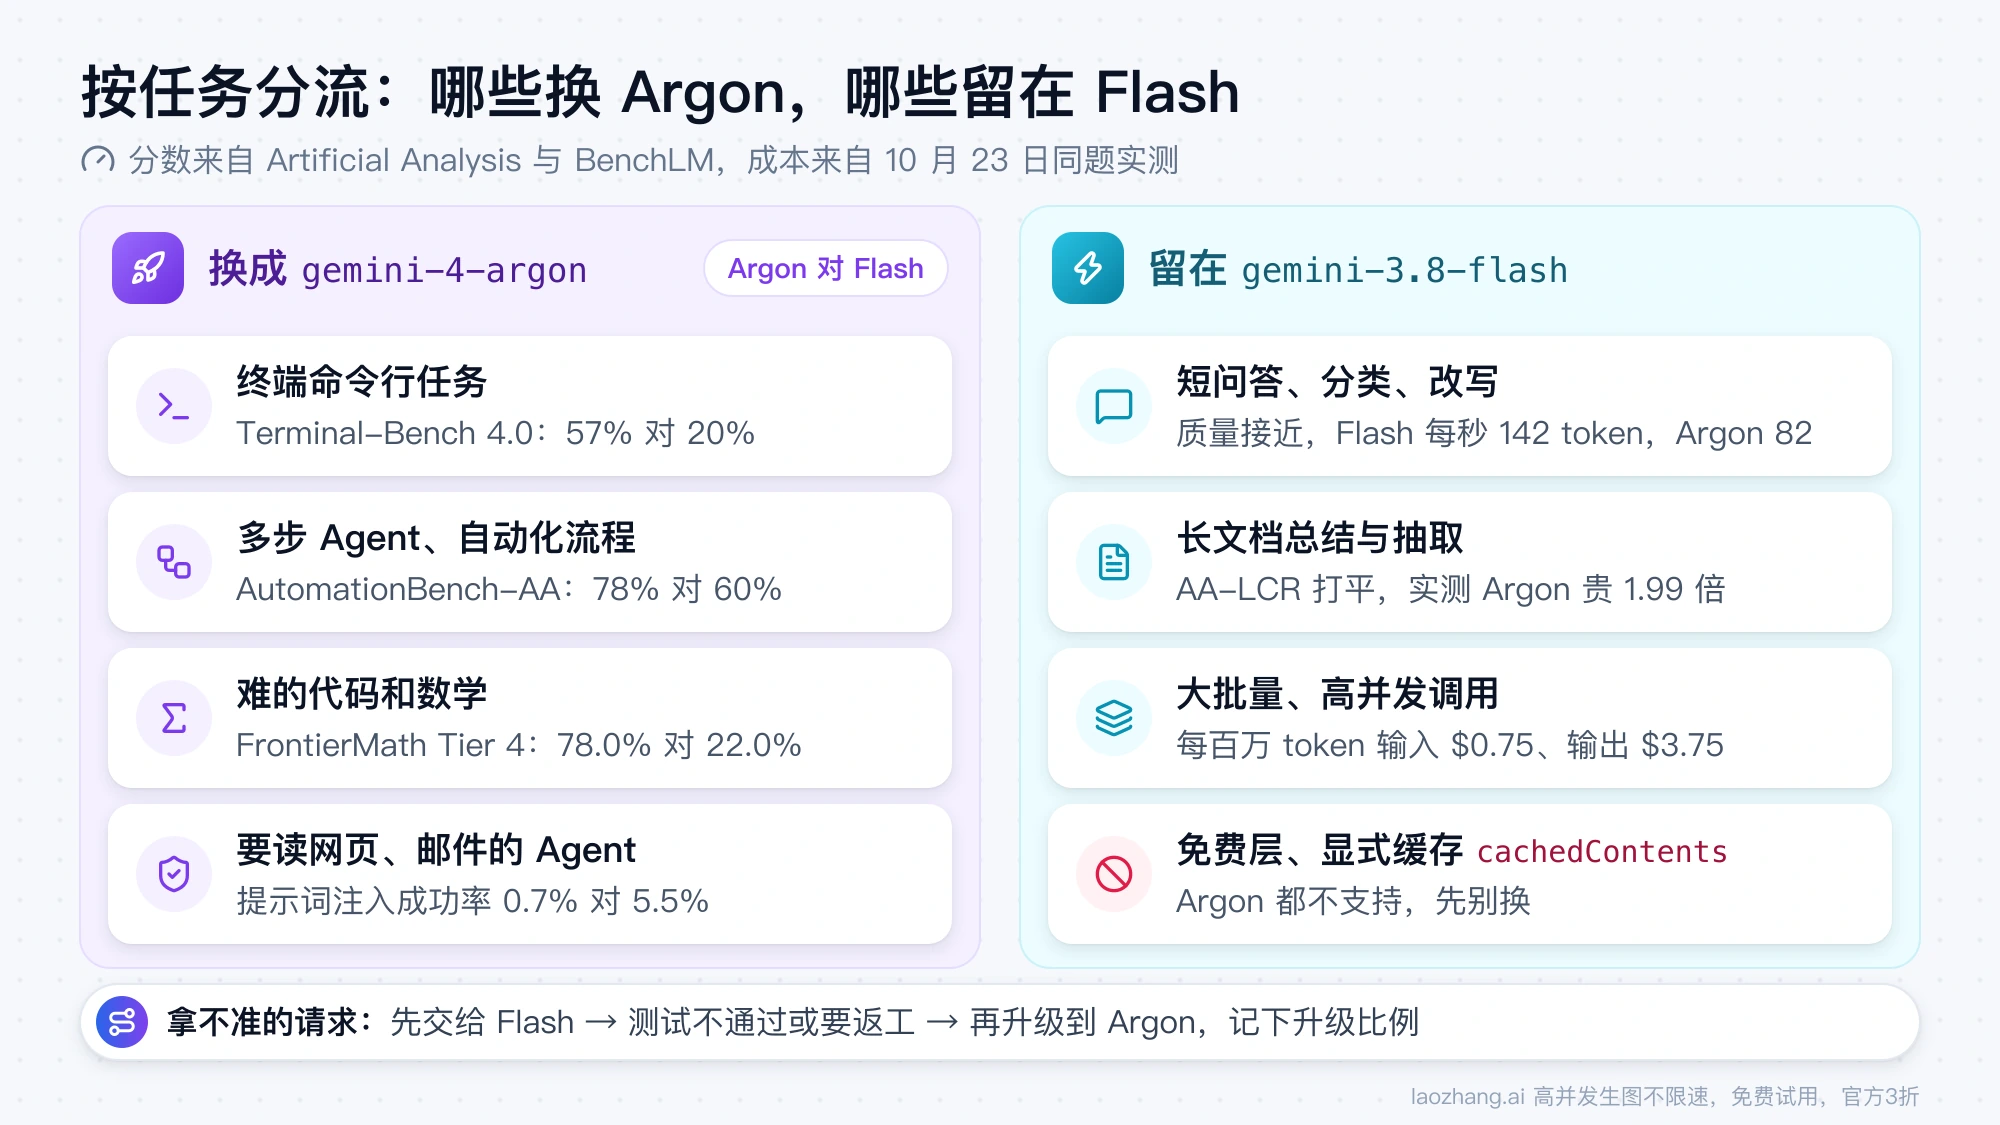
换到 Argon 最划算的是失败代价高的任务。在终端、自动化和高难度数学类测试上,Flash 的分数只有 Argon 的 28% 到 77%,而难题上按任务算的成本差距远小于单价差距;如果 Flash 做一次不成、要重试或人工返工,按"每个合格结果"算,Argon 可能并不更贵。让模型自己读网页、邮件、工单的 Agent 也偏向 Argon,因为它被提示词注入带偏的比例更低。
留在 Flash 最划算的是读得多、想得少的任务。长文档总结和抽取上两者质量接近,但输入 token 占大头,Argon 的成本更接近单价倍数,实测里长文档总结也是两者差距最大的一道题;分类、改写、短问答这类请求,按次算的花费差别不大,默认级别下 Argon 实测甚至略便宜,留在 Flash 的理由是速度:Artificial Analysis 测得 Flash 每秒输出 142 个 token,Argon 是 82 个。还在用免费层做开发测试、或者靠显式缓存反复复用同一份长前缀的,也只能留在 Flash。
两者之间的请求,可以先交给 Flash,用测试、校验规则或人工抽查判断结果,不合格再用 Argon 重做,并记下升级的比例。如果升级比例很高,说明这类任务直接用 Argon 更省事。时间上注意 2026 年 12 月:这个月 Argon 已涨价而 Flash 还没涨,按实测成本算差距翻倍,打算把大量流量迁过去的话,12 月的 Argon 预算要按两倍准备;2027 年 1 月 1 日 Flash 涨价后,差距回到 2026 年 12 月 1 日之前的水平。
把 gemini-3.8-flash 换成 gemini-4-argon 前要改的代码
只改模型 ID 不够。Google 的 Gemini 4 Argon 迁移说明列了几处 Flash 上能用、Argon 上会出问题或被忽略的设置:输出上限、显式缓存、采样参数和超时,免费层也要先确认。按下面的顺序检查:
- 确认 API key 所在的项目已经开通付费。Argon 不在免费层,免费层里能用哪些模型见 Gemini API Key 免费额度与速率限制 2026:哪些还免费、去哪看限额。
- 把
max_output_tokens调到至少 32,768。这个上限同时包含思考和输出,Argon 会把更多额度花在思考上,原来设得低的请求可能答到一半就被截断。同步请求的输出上限是 65,536 token,超过要改用后台执行(background: true)。 - 删掉所有创建或引用显式缓存的调用(
cachedContents、caches.create、cached_content)。Argon 不支持显式缓存,只能依靠默认开启的隐式缓存。 - 删掉
temperature、top_p和top_k。Argon 会忽略这三个参数,留着只会让人误以为它们生效了。 - 把 HTTP 客户端超时调到至少 15 分钟,或者改用后台执行。Google 提醒难的提示词可能要跑好几分钟。
- 在自己的任务上把
low、medium、high三个思考级别都跑一遍,默认是medium。想省 token 就降级别,不要靠调低max_output_tokens。 - 多轮对话和函数调用改用
previous_interaction_id把对话状态留在服务器上,这是 Google 对 Argon 的建议做法。
通过 OpenAI 兼容端点调用 Argon 的,先确认思考级别真的生效。2026 年 10 月 23 日的测试里,测试所用平台的 OpenAI 兼容端点上,Argon 的 reasoning_effort 设成 high 和默认几乎没有区别,改走 Gemini 原生端点的 thinkingConfig.thinkingLevel 后才生效。没有 Google 结算账号的开发者也可以通过老张API(laozhang.ai)这类聚合平台调用两个模型,截至 2026 年 10 月 23 日平台报价与 Google 当前标价相同,Argon 2026 年 12 月 1 日之后的价格平台还没有公布。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
Gemini 应用、Antigravity 和 Gemini CLI 里谁能用 Argon
截至 2026 年 10 月 23 日,Gemini 应用和 Antigravity 都只给付费的 Google AI Pro 与 Ultra 开放 Argon,Google AI Plus 和免费账号用不了;3.8 Flash 在 Antigravity 的所有方案里都能用。Gemini CLI 官方建议改用 Antigravity 来用 Argon。
在 Gemini 应用里,按 Gemini 帮助中心的"关于 Gemini 模型"页面,Google AI Pro 和 Ultra 可以在模型菜单里选 4 Argon;Google AI Plus 没有 Argon,帮助中心已说明 Plus 调整后只保留 Flash-Lite 和 Flash;没有订阅的账号能看到 4 Argon,但处于锁定状态。应用里的思考级别默认是 Low。Google 不公布任何模型的对话条数,所有模型共用一个按算力计算的额度,每 5 小时刷新一次、直到用完每周上限,帮助中心写明更高级的模型和更高的思考级别消耗更多额度。所以 Argon 额度掉得快是规则本身的结果;具体有多快只有用户报告,例如 Reddit 上有 Pro 用户说十来条消息就用完了 Argon,也有人说只发一句"test"就用掉了 5 小时额度的 9%,这些都是个人经历,不是测得的比例。
在 Antigravity 里,按 Antigravity 的模型文档,Argon 对付费的 Google AI Pro(或随符合条件的设备附赠的试用)、Ultra 和企业版开放,Free 和 Plus 不可用;它可以在 Antigravity 应用、CLI 和 IDE 扩展里用,不在 Antigravity IDE 里。3.8 Flash 在所有方案里都能用,包括 Free。Google 员工 Varun Mohan 在 X 上说 Pro 用户的 Argon 有单独的每周额度,不会占用 Flash 的额度,但文档里的用量面板仍只显示一个"Gemini Models"。Flash 在 Antigravity 里慢的问题,见 Gemini 3.8 Flash 在 Antigravity 中很慢?先分清四种卡顿再处理。
Gemini CLI 的 GitHub 仓库首页写着它没有针对 Gemini 4 Argon 做优化,要用 Argon 请改用 Antigravity,模型列表里也没有 Argon,最新的 Flash 是 gemini-3.8-flash。Threads 上有一位用户报告,在 Gemini CLI 里 Argon High 一轮消耗的额度是 Flash High 一轮的 27.8 倍,他也说明其中有工具循环把轮次拉长的因素,这只是一次个人测量。
Gemini 4 Argon 和 3.8 Flash 的其他问题
有没有 Gemini 4 Flash?Argon 会不会是 Gemini 4 Flash 的前身?
截至 2026 年 10 月 23 日,Google 的模型列表和更新日志里都没有 Gemini 4 Flash 这个模型 ID,Argon 的正式发布文章只说之后会推出 Gemini 4 家族的其他模型,没有给出时间。gemini-4-argon 在模型页上标为稳定版,Google 没有说明它和以后的 Flash 是什么关系,所以"Argon 就是 4 Flash 的前身"目前只是猜测。
Gemini 3.8 Flash 会停用吗?还在调用 3.7 Flash 怎么办?
截至 2026 年 10 月 23 日,Google 没有公布 gemini-3.8-flash 的停用日期。gemini-3.7-flash 已在 2026 年 10 月 8 日弃用,并自动转到 gemini-3.8-flash,所以还写着 3.7 Flash 的代码实际用的是 3.8 Flash,见 Gemini API 更新日志。
Gemini 4 Argon 和 Claude Opus 5.5、GPT-6.1 Sol 比怎么样?
跨厂商的成本和可用性对比,见 Gemini 4 Argon、Opus 5.5、GPT-6.1 Sol 对比:已开放,12 月起涨价。
参考来源9
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月23日。
参考来源9
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月23日。
- 1.Google 的 Gemini API 价格页ai.google.dev/gemini-api/docs/pricing
- 2.Gemini 4 Argon 与 3.8 Flash 对比页artificialanalysis.ai/models/comparisons/gemini-4-argon-vs-gemini-3-8-flash
- 3.Gemini API 思考功能文档ai.google.dev/gemini-api/docs/thinking
- 4.Gemini 3.8 Flash 与 Gemini 4 Argon 对比页benchlm.ai/compare/gemini-3-8-flash-vs-gemini-4-argon
- 5.Gemini 4 Argon 迁移说明ai.google.dev/gemini-api/docs/latest-model
- 6.Gemini 帮助中心的"关于 Gemini 模型"页面support.google.com/gemini/answer/18648722
- 7.Antigravity 的模型文档antigravity.google/docs/models
- 8.Gemini CLI 的 GitHub 仓库github.com/google-gemini/gemini-cli
- 9.Gemini API 更新日志ai.google.dev/gemini-api/docs/changelog