Claude Fable 5.1 API 价格:降了什么,省多少
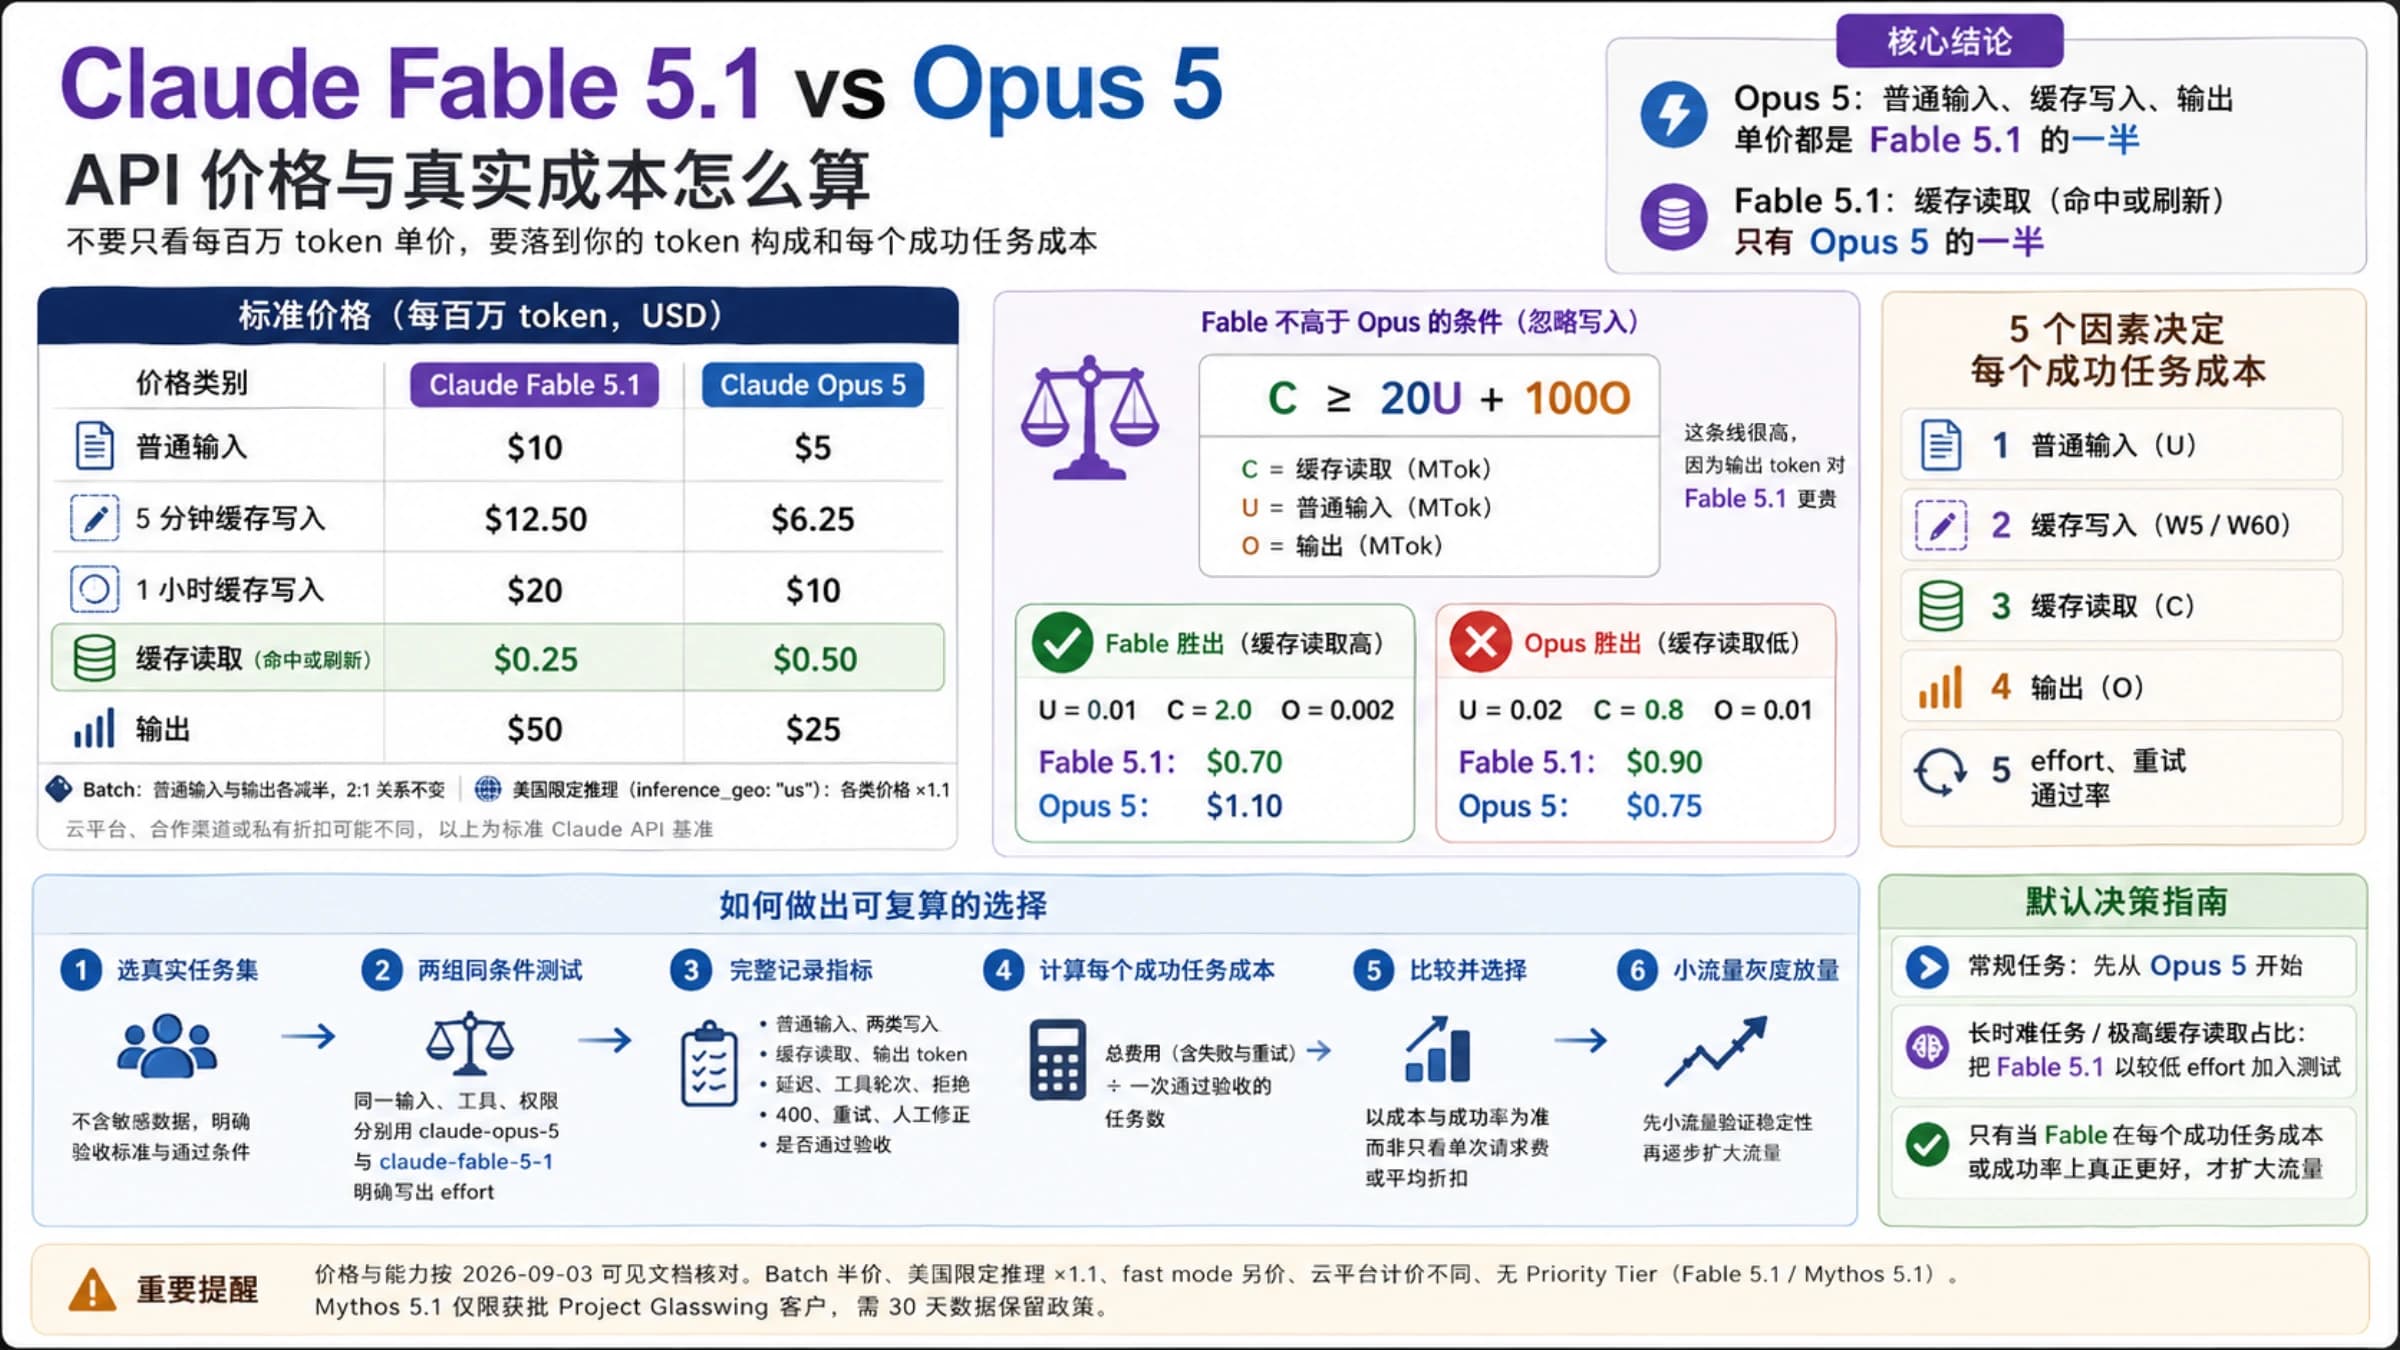
Fable 5.1 官方价仍是每百万 token 输入 $10、输出 $50,只有缓存读取从 $1 降到 $0.25。能省多少看缓存读取原本占账单几成,不用缓存则几乎不变。
文章目录
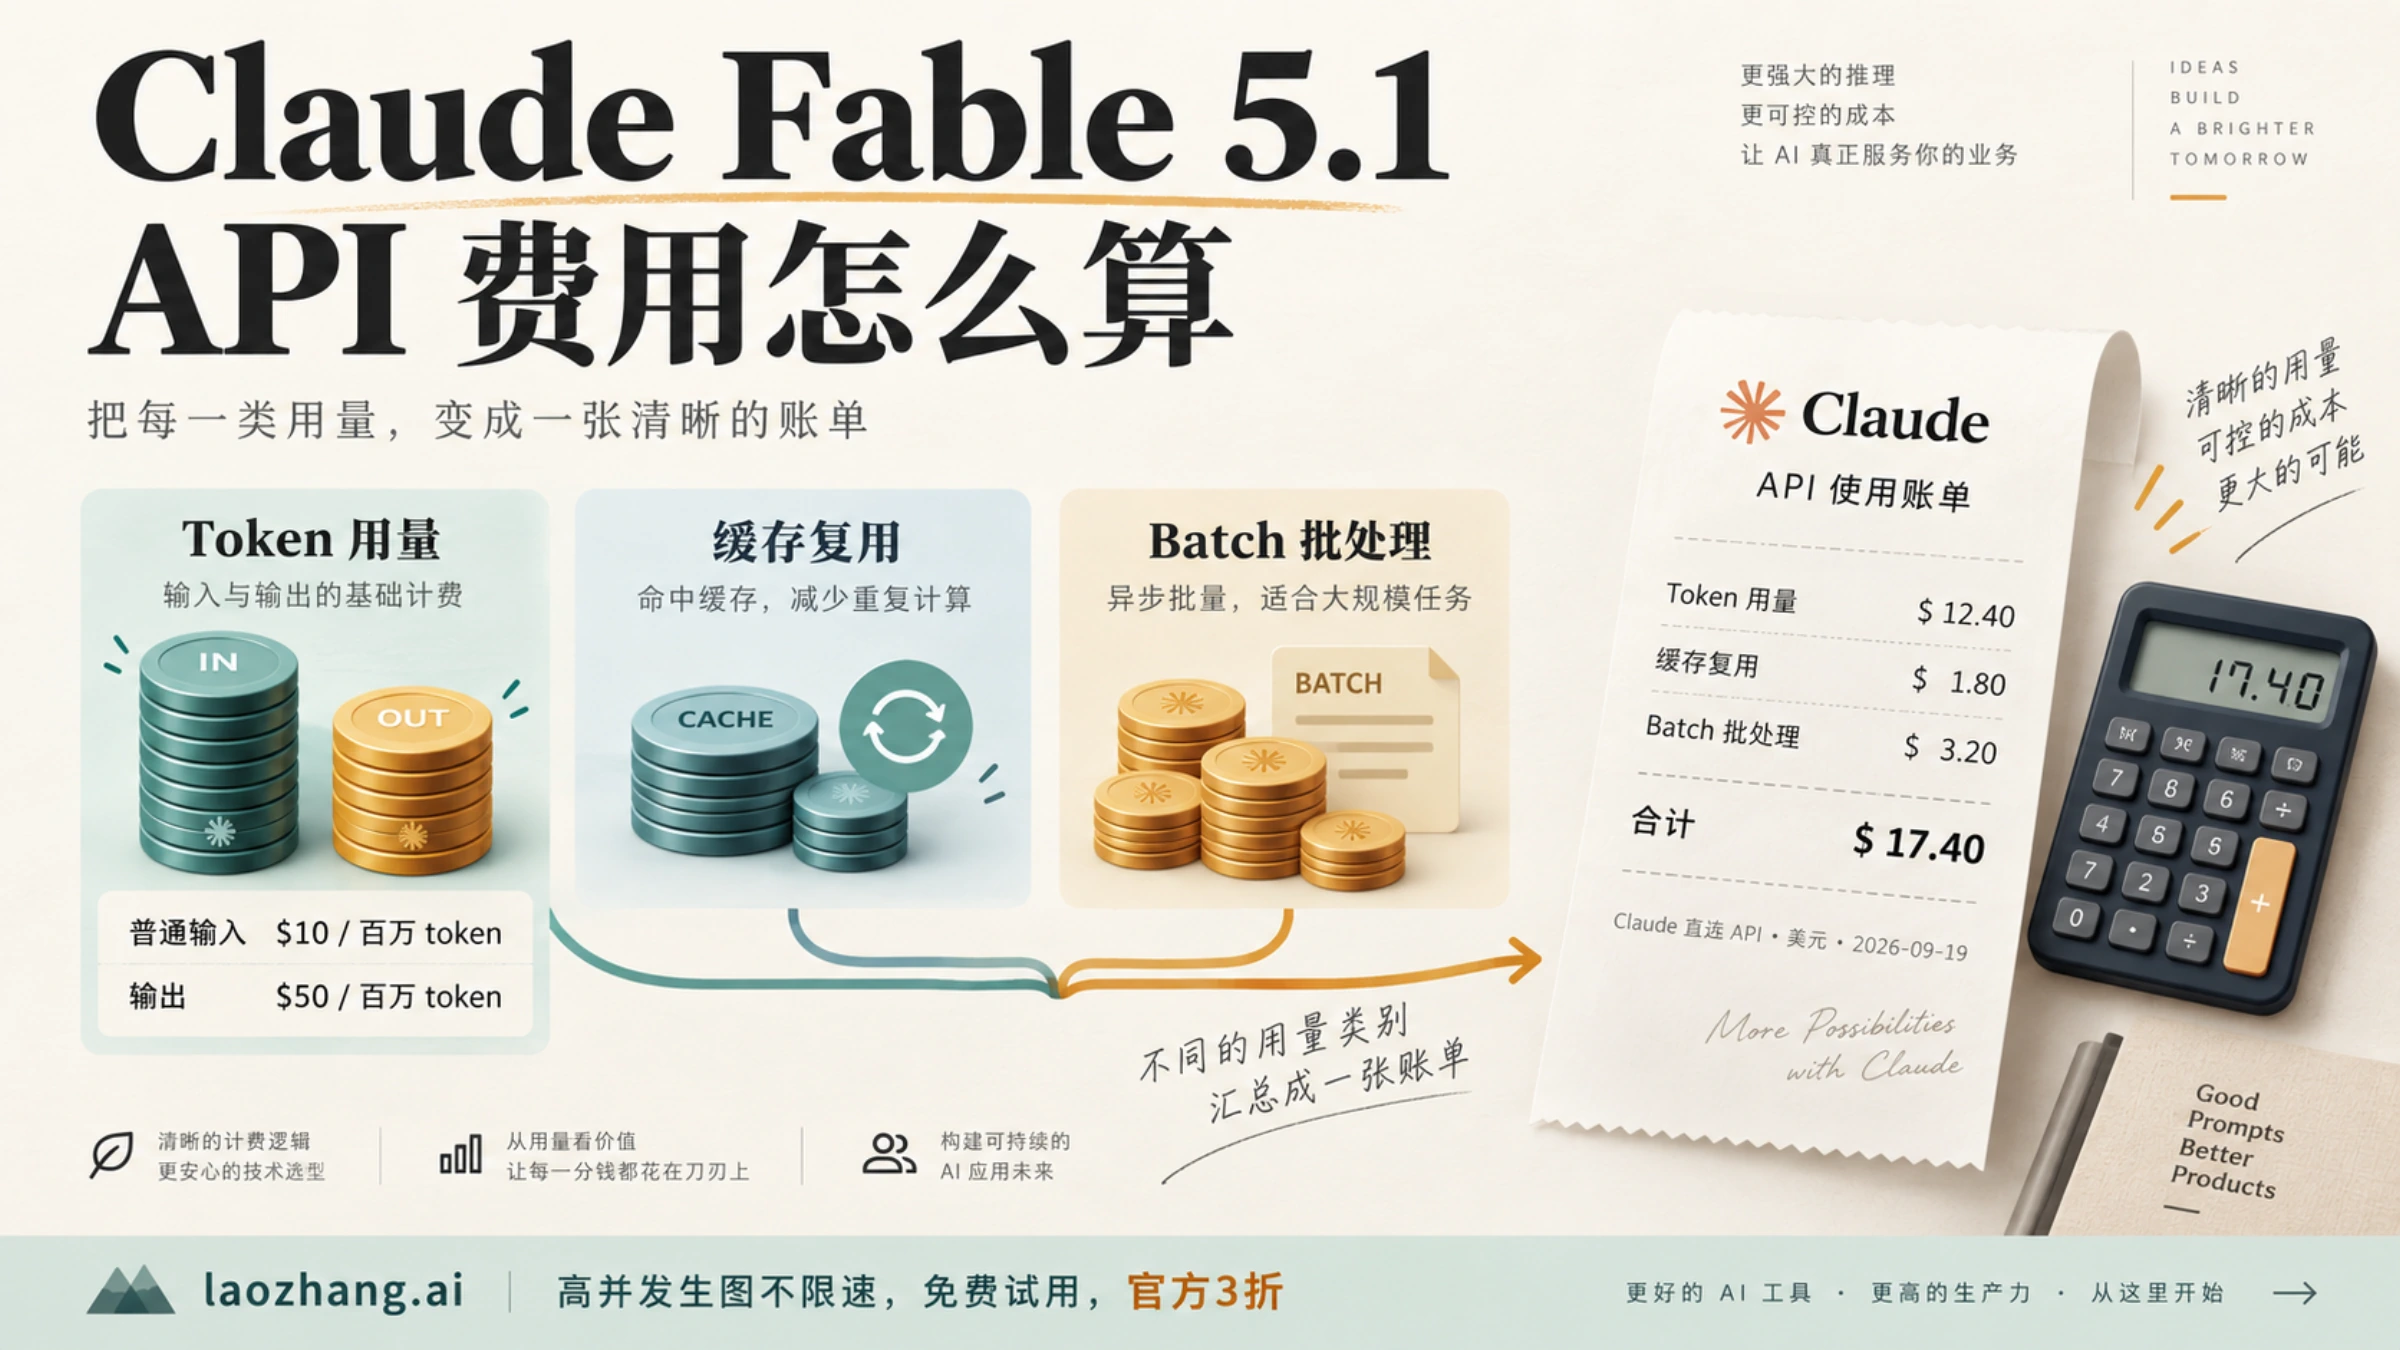
截至 2026 年 9 月 25 日,Claude Fable 5.1(模型 ID claude-fable-5-1)在 Claude API 上的官方价格是:普通输入每百万 token $10,输出每百万 token $50,缓存命中(读取)每百万 token $0.25。和上一代 Fable 5 相比,只有缓存读取这一项变了,从 $1 降到 $0.25;输入、输出、两种缓存写入和 Batch 价格都没动。
所以"降价 75%"说的是缓存读取这一个单价,不是整张账单。你的账单能降多少,取决于 Fable 5 时期缓存读取在账单里占了多少:占三分之一,大约省 25%;占六成,大约省 45%;几乎不用缓存,账单基本不变。另外,9 月 22 日发布的 Opus 5.5 单价更低,输入 $4、输出 $20,如果你只是想让 Claude 的账单变便宜,先看它。
官方单价:Fable 5.1 和 Fable 5 对照
下表是 Anthropic 官方 Pricing 文档里的标准价,单位是美元 / 百万 token,适用于 Claude API 默认的全球推理,不含税。
| 计费项 | Fable 5.1 | Fable 5 | 变化 |
|---|---|---|---|
| 普通输入 | $10 | $10 | 不变 |
| 5 分钟缓存写入 | $12.50 | $12.50 | 不变 |
| 1 小时缓存写入 | $20 | $20 | 不变 |
| 缓存命中与刷新 | $0.25 | $1 | 降 75% |
| 输出 | $50 | $50 | 不变 |
| Batch 输入 / 输出 | $5 / $25 | $5 / $25 | 不变 |
$0.25 这个数是这样来的:其他 Claude 模型的缓存命中按普通输入价的 0.1 倍计费,Fable 5.1 单独改成了 0.025 倍,也就是普通输入的 2.5%。Claude Mythos 5.1 和 Fable 5.1 价格完全一样,但只通过 Project Glasswing 邀请开放,一般开发者用不到。
几个跟价格直接相关的规格:上下文 100 万 token,同步 Messages API 单次最多输出 12.8 万 token;整个 100 万上下文都按标准单价计费,90 万 token 的请求和 9,000 token 的请求每 token 价格相同。Fable 5.1 的自适应思考始终开启,默认 effort 是 high,思考产生的 token 按输出价计费——这一点后面会反复影响账单。
75%、25%、45% 各指什么
围绕这次调价流传的三个数字,口径完全不同:
- 75%:缓存读取单价从 $1 降到 $0.25 的降幅。它只描述一个单价。
- 约 25%:Anthropic 在发布公告里给出的估算——"典型工作负载"下,Fable 5.1 的花费比 Fable 5 低约 25%。
- 最高约 45%:同一份估算里,"高度 agent 化"的工作负载(上下文很重、工具调用很多、缓存读取占大部分成本)最多能低约 45%。
后两个数字的计算方法写在公告脚注里:用 2026 年 8 月四周的真实用量,按默认 effort、按 token 计费,把同样的工作负载分别放在 Fable 5 和 Fable 5.1 上算成本指数。"典型工作负载"覆盖的是 Claude Enterprise、Claude Code 和 API 上的 Fable 用量汇总。这是厂商对自家整体用量的估算,不是对某一个项目的承诺,也不是"最高降价 45%"。
用一条规则估算自己能省多少
因为 5.1 只改了缓存读取单价,在两个版本 token 数相同的前提下,可以直接推出:
Fable 5.1 账单 = Fable 5 账单 − 0.75 × Fable 5 账单里的缓存读取费用
节省比例 ≈ 0.75 × 缓存读取在 Fable 5 账单中的占比
| 缓存读取在 Fable 5 账单中的占比 | 换到 Fable 5.1 约省 |
|---|---|
| 0(不用缓存或从不命中) | 约 0 |
| 10% | 约 7.5% |
| 约 1/3 | 约 25%(对应 Anthropic 的"典型"估算) |
| 约 60% | 约 45%(对应"高度 agent 化"估算) |
占比怎么算:把 Fable 5 时期一段时间的 cache_read_input_tokens 加总,乘以 $1 / 百万 token,再除以同期总费用。
下面两个假设请求,能看出差别有多大(单位美元,按上表单价计算):
| 假设请求 | Fable 5 | Fable 5.1 | 节省 |
|---|---|---|---|
| A:未缓存输入 2,000,缓存写入 18,000(5 分钟 8,000 + 1 小时 10,000),缓存读取 40,000,输出 3,000 | $0.510 | $0.480 | 约 5.9% |
| B:未缓存输入 500,缓存读取 120,000,输出 2,000 | $0.225 | $0.135 | 40% |
请求 A 刚写入大量缓存、读取不多,缓存读取只占 Fable 5 账单的约 7.8%,所以只省 6% 左右。请求 B 是长对话或 agent 循环中的典型一轮:上下文大部分从缓存命中,缓存读取占了 Fable 5 账单的 53% 多,省下 40%。
这条规则什么时候不成立
规则假设两个版本处理同一任务用的 token 数相同。实际上输出和思考 token 会随模型版本和 effort 变化,而输出是最贵的一项($50 / 百万 token)。第三方的例子:Finout 引用的一项 Intelligence Index 基准测试里,在 max effort 下 Fable 5.1 每个任务的成本约 $3.76,比 Fable 5 的 $3.14 高了约 20%。这只是单一基准、单一 effort 档位的结果,但它说明如果新版本在你的任务上想得更多、写得更长,缓存读取省下的钱可能被输出抵消。
所以最可靠的做法是:用同一批真实任务各跑一次,比较两边 usage 算出的金额,而不是套用 25% 或 45%。
如果你用的是 Pro、Max 等 Claude 订阅,这次调价不改变订阅月费——订阅和 API 是两套独立的账单。订阅的额度与收费见 Claude Fable 5.1 使用限制:Pro 怎么收费,Max 额度何时恢复。
用一次响应的 usage 算出费用
每次 API 响应都带 usage 对象。要把它换成钱,先弄清几个字段各算什么:
| 字段 | 含义 | 单价(美元 / 百万 token) |
|---|---|---|
input_tokens | 最后一个缓存断点之后的输入,也就是没走缓存的部分,不是全部输入 | $10 |
cache_creation.ephemeral_5m_input_tokens | 写入 5 分钟缓存的 token | $12.50 |
cache_creation.ephemeral_1h_input_tokens | 写入 1 小时缓存的 token | $20 |
cache_read_input_tokens | 从缓存读取的 token | $0.25 |
output_tokens | 输出,包含看不到的思考 token | $50 |
cache_creation_input_tokens 是两种写入的合计,等于 ephemeral_5m_input_tokens 与 ephemeral_1h_input_tokens 之和。算钱时用明细分别乘单价,合计值只拿来核对,不要再加一遍。总输入 token 数 = 读取 + 写入 + input_tokens;两个缓存字段都是 0,说明这次请求没有用上缓存。
公式(token 数为原始数量):
费用(美元)= (10 × input_tokens
            + 12.5 × ephemeral_5m_input_tokens
            + 20 × ephemeral_1h_input_tokens
            + 0.25 × cache_read_input_tokens
            + 50 × output_tokens) ÷ 1,000,000
拿上面的请求 A 来说,它的 usage 大致如下:
{
  "input_tokens": 2000,
  "cache_creation_input_tokens": 18000,
  "cache_read_input_tokens": 40000,
  "output_tokens": 3000,
  "cache_creation": {
    "ephemeral_5m_input_tokens": 8000,
    "ephemeral_1h_input_tokens": 10000
  }
}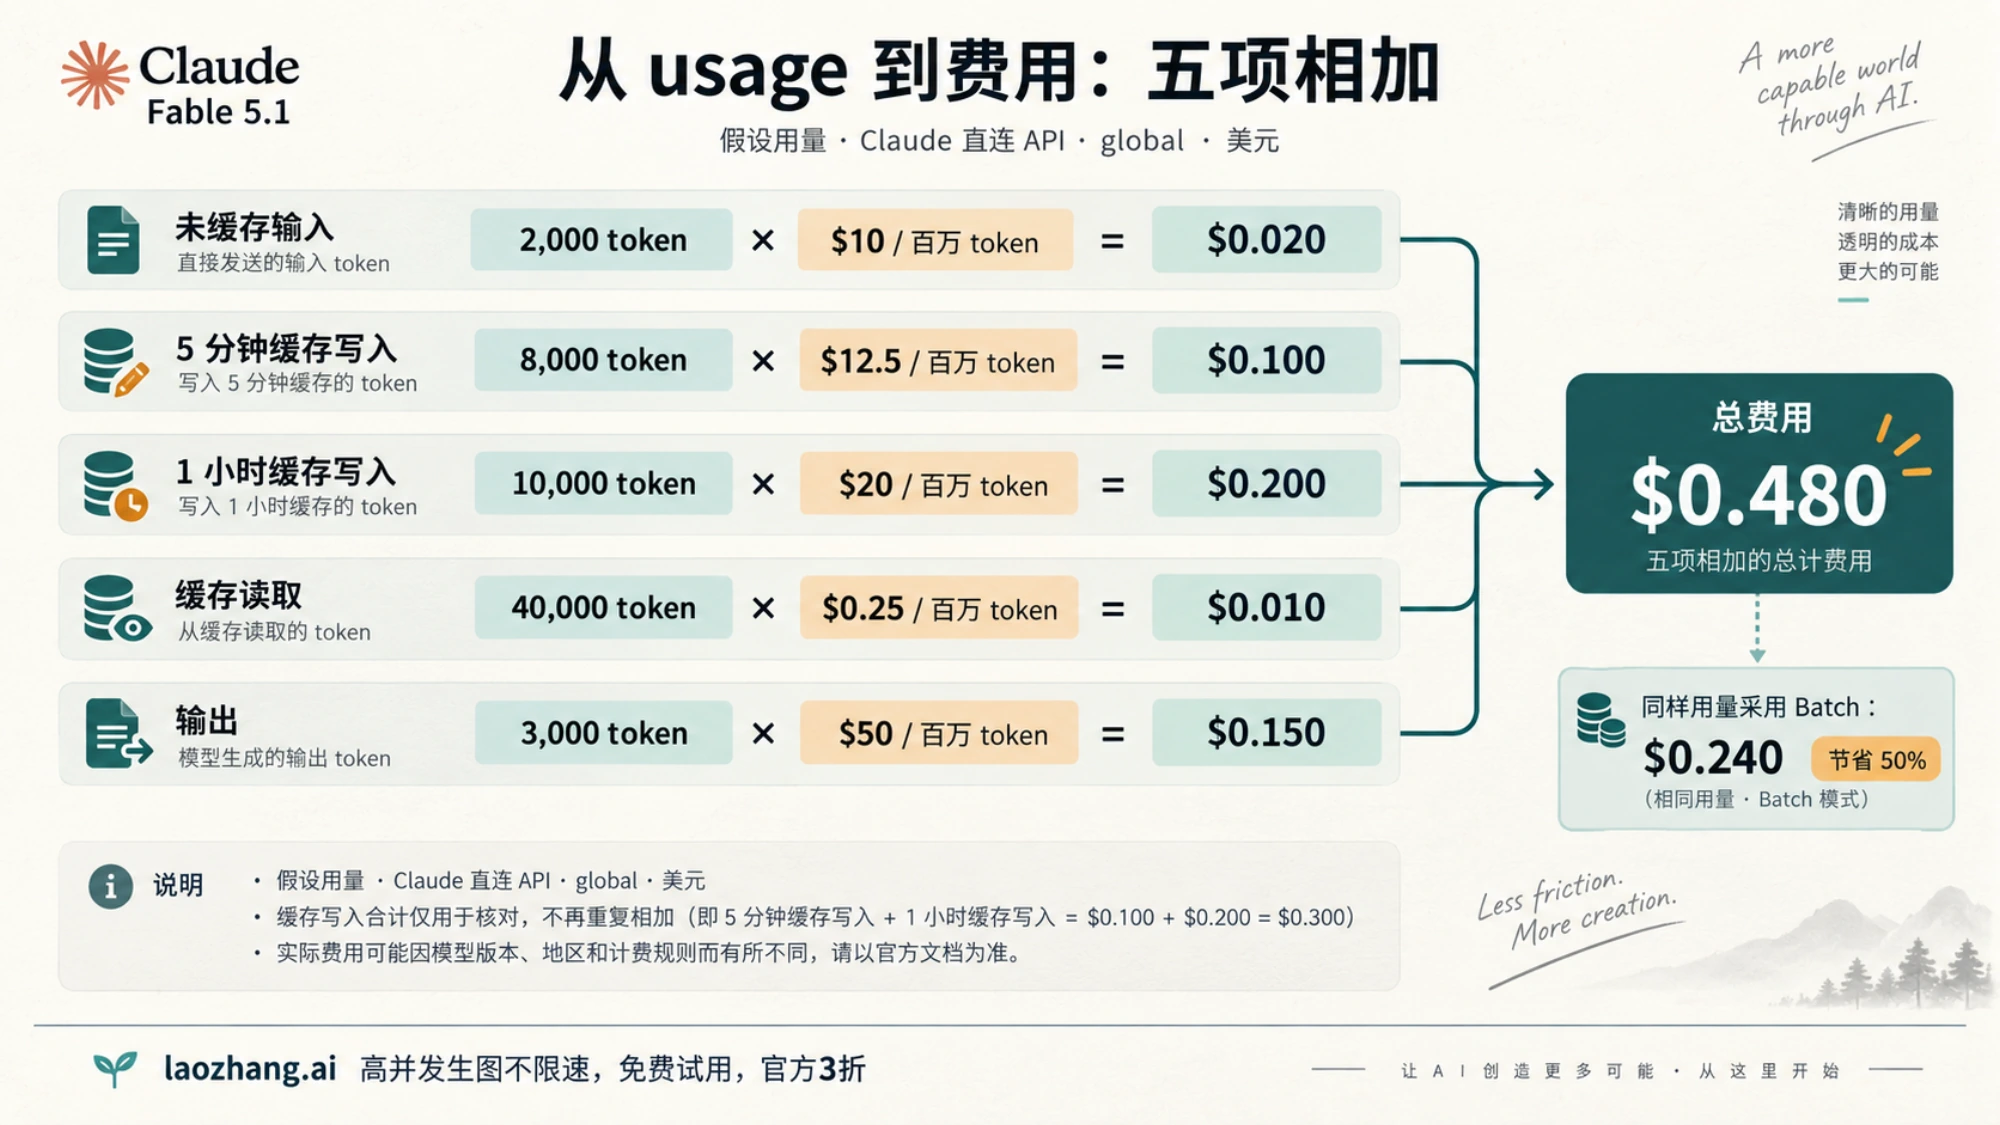
五项分别是 $0.020、$0.100、$0.200、$0.010、$0.150,合计 $0.480。18,000 个写入 token 已经按 5 分钟和 1 小时拆开算过,不能再按 cache_creation_input_tokens 补算一次。
想批量计算日志里的请求,可以用下面这个函数。它按标准全球推理计价;如果日志里没有 cache_creation 明细,就把写入全部按默认的 5 分钟缓存计。
# Claude Fable 5.1 标准价,美元 / 百万 token(截至 2026-09-25)
RATES = {"input": 10.0, "write_5m": 12.5, "write_1h": 20.0, "read": 0.25, "output": 50.0}

def fable51_cost(usage: dict, batch: bool = False, us_only: bool = False) -> float:
    detail = usage.get("cache_creation") or {}
    w5 = detail.get("ephemeral_5m_input_tokens", 0)
    w1h = detail.get("ephemeral_1h_input_tokens", 0)
    if not detail:  # 没有明细时,写入按默认 5 分钟缓存计
        w5 = usage.get("cache_creation_input_tokens", 0)
    cost = (
        usage.get("input_tokens", 0) * RATES["input"]
        + w5 * RATES["write_5m"]
        + w1h * RATES["write_1h"]
        + usage.get("cache_read_input_tokens", 0) * RATES["read"]
        + usage.get("output_tokens", 0) * RATES["output"]
    ) / 1_000_000
    if batch:    # Batch:所有 token 类别打五折
        cost *= 0.5
    if us_only:  # inference_geo="us":所有 token 类别乘 1.1
        cost *= 1.1
    return cost
对请求 A,fable51_cost(usage) 返回 0.48,batch=True 返回 0.24,us_only=True 返回 0.528。网页搜索等服务端工具的按次费用不在 token 里,需要另加。
估月费时,不要拿单次请求乘以一个拍脑袋的次数,而是把一段有代表性的时间(比如一天)的所有请求逐条算出金额再加总,然后按天数放大。原因是缓存写入和读取的比例会随请求间隔变化:同一个前缀在有效期内被连续复用,后续请求都是便宜的读取;间隔一长缓存过期,就得重新付写入费。假设你的业务每天有 200 次和请求 A 相同的调用,月费约为 200 × 30 × $0.48 = $2,880——但这个数只在每次请求的缓存情况都像 A 时才成立。
缓存用 5 分钟还是 1 小时
只看缓存前缀本身的成本(不含输出),一个 P token 的前缀先写入一次、之后命中 H 次:
- 不用缓存:P × $10 × (1 + H)
- 5 分钟缓存:P × ($12.50 + $0.25 × H)
- 1 小时缓存:P × ($20 + $0.25 × H)
(以上都要再除以 1,000,000。)
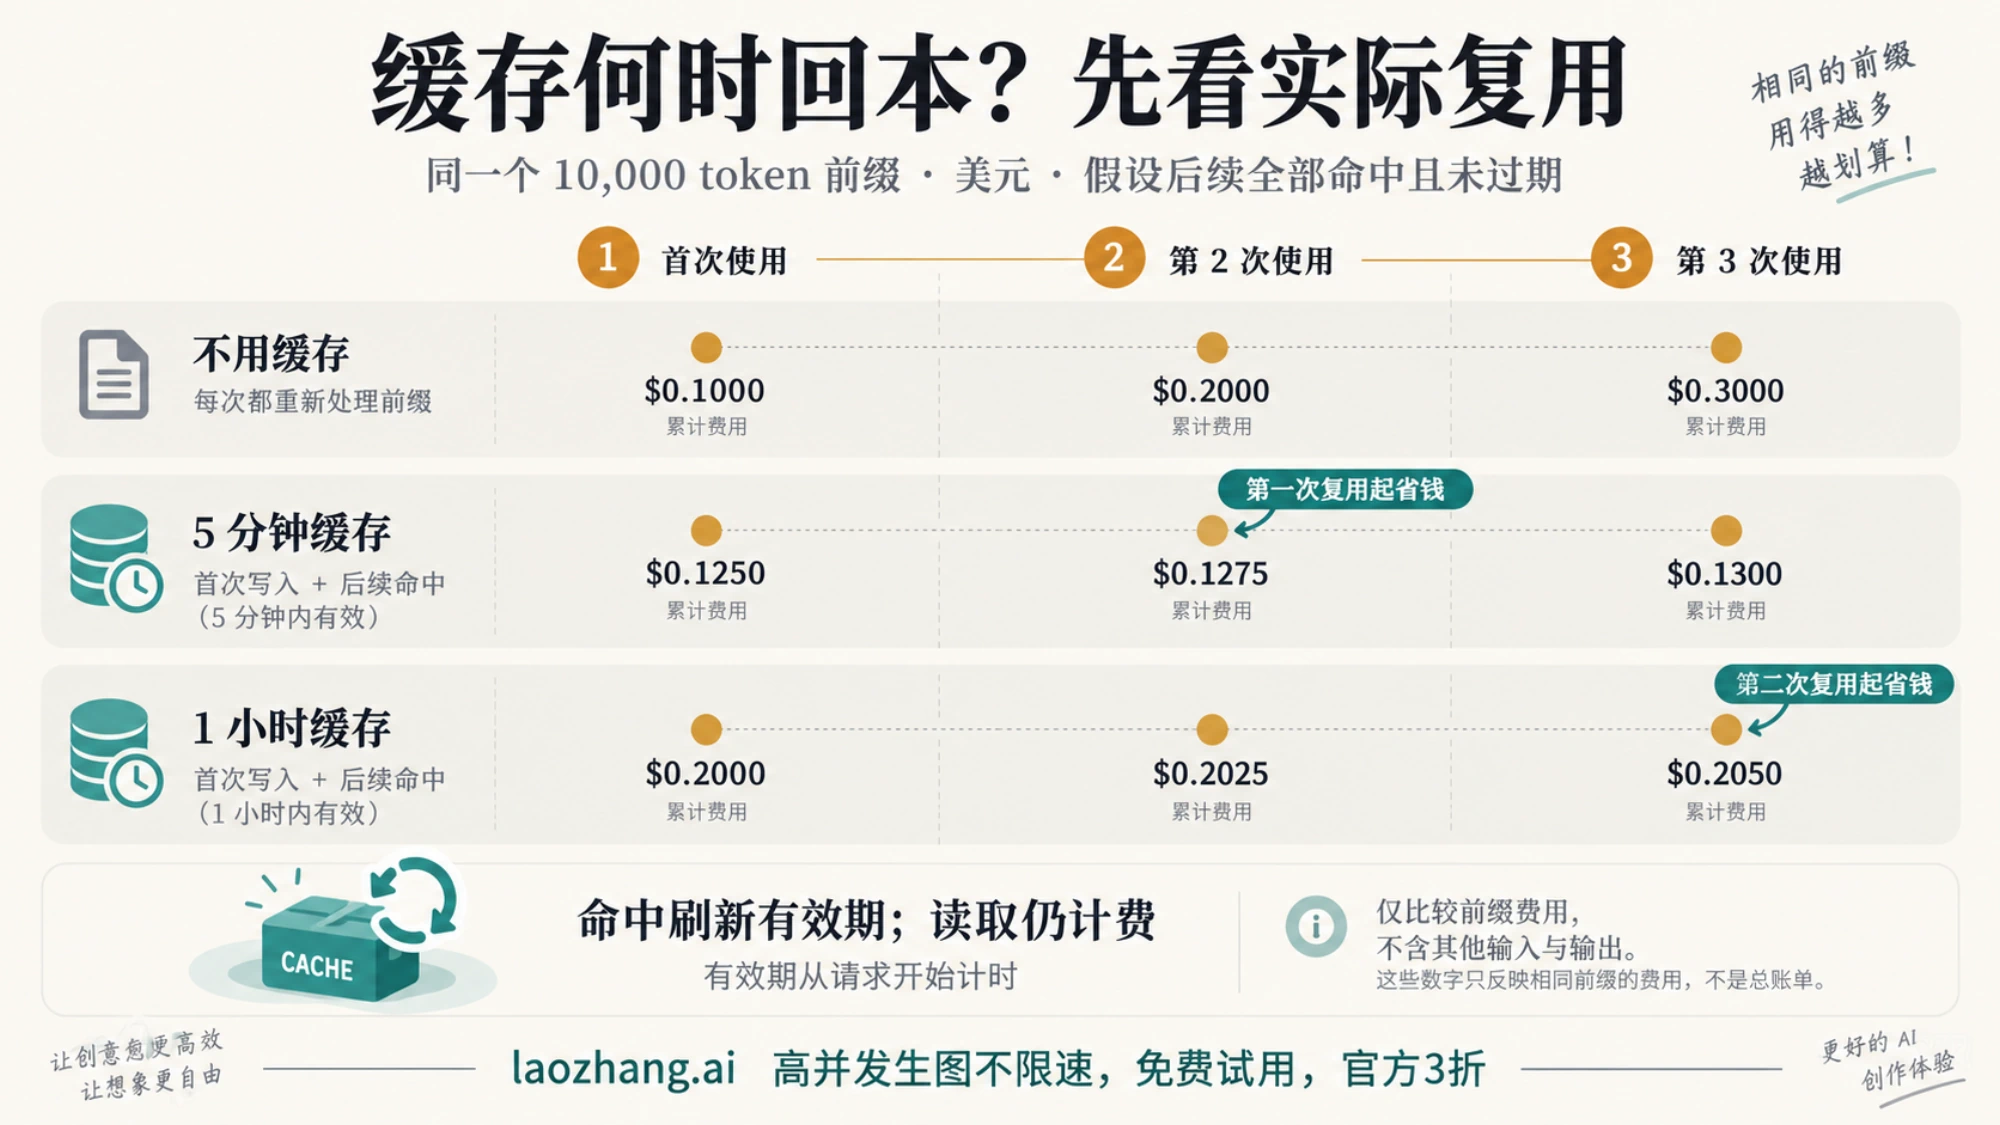
以 10,000 token 的前缀为例:用到第二次时,不用缓存累计 $0.20,5 分钟缓存 $0.1275,1 小时缓存 $0.2025;用到第三次时,三者分别是 $0.30、$0.13、$0.205。也就是说,5 分钟缓存只要命中一次就回本,1 小时缓存要命中两次,官方 Pricing 文档给出的也是这个结论。前提是命中发生在有效期内;过期后再用,就要再付一次写入。
怎么选:
- 请求间隔在 5 分钟以内(连续对话、agent 循环、同一份文档连续提问):用 5 分钟缓存。每次命中都会免费刷新有效期,只要间隔不超过 5 分钟,缓存可以一直续下去,没必要多付 1 小时的写入价。
- 间隔在 5 分钟到 1 小时之间(用户可能过几分钟才回复、子任务要跑很久、批量任务共享同一段上下文):用 1 小时缓存,在请求里写
"cache_control": {"type": "ephemeral", "ttl": "1h"}。 - 间隔超过 1 小时,或前缀只用一次:缓存只会增加写入成本,不如不缓存。
几个容易让缓存"白付钱"的细节:
- 有效期从请求开始时计算,不是从响应结束时。一个响应要生成 4 分钟,下一个复用同一前缀的请求就必须在它结束后约 1 分钟内发出,才能赶上 5 分钟缓存。
- Fable 5.1 的最小可缓存长度是 512 token。更短的内容不会报错,只是按普通输入处理。
- 改动会让缓存失效:改工具定义,全部缓存失效;开关网页搜索或引用,system 和 messages 的缓存失效;修改顶层的
output_config.effort,messages 部分的缓存失效。有两个例外:把 effort 显式设成模型默认值(Fable 5.1 为high)等同于不设,不会失效;在支持按消息设置 effort 的模型上(该功能为 beta),把 effort 变更放进messages里的role: "system"消息,缓存前缀保持不变。 - 对话中途要追加系统指令时,在 Fable 5.1 上往
messages里追加一条{"role": "system"}消息,不要去改顶层system字段,这样 system 和 messages 的缓存都能保留。 - 预热缓存:发送
max_tokens: 0的请求,只写入缓存、不生成输出,按写入计费。预热请求的 thinking 配置和 effort 要和正式请求一致,否则写进去的缓存正式请求命中不了。
如果你在 Claude Code 里发现某次对话突然变贵,多半是缓存没命中,排查思路见 Claude Code 缓存未命中 token 成本:一次对话为什么突然变贵。
Batch 适合哪些任务,能和缓存一起打折吗
Message Batches API 把输入和输出都打五折,Fable 5.1 的 Batch 价是输入 $5、输出 $25。缓存的倍率和 Batch 折扣可以叠加,所以 Batch 下的完整单价是:
| 计费项 | 标准价 | Batch |
|---|---|---|
| 普通输入 | $10 | $5 |
| 5 分钟缓存写入 | $12.50 | $6.25 |
| 1 小时缓存写入 | $20 | $10 |
| 缓存读取 | $0.25 | $0.125 |
| 输出 | $50 | $25 |
请求 A 走 Batch 就是 $0.24。注意这张表已经是折后价,不要再减半一次。
适合 Batch 的任务:结果不需要马上返回、单条请求互不依赖、量比较大,比如批量打标签、文档摘要、离线评测、数据抽取。判断时看这几条限制:
- 大部分批次在 1 小时内完成,但结果要等整批完成或满 24 小时才能取;24 小时内没处理完的请求会过期。
- 每批最多 100,000 个请求或 256 MB;不支持流式输出,也不能用
max_tokens: 0预热缓存。 - 结果保留 29 天,返回顺序不保证和提交顺序一致,要用
custom_id对应。 - 状态为
errored、canceled、expired的请求不计费;但succeeded的请求即使结果不合你的要求,也已经计费。
Batch 里的缓存命中是"尽力而为":同一批请求并发、以任意顺序处理,不保证后面的请求能读到前面写入的缓存。官方文档建议,批量任务共享同一段上下文时用 1 小时缓存,提高命中机会。估算 Batch 成本时,缓存命中率最好按偏保守的值算。
Batch 折扣只针对 token 价格。网页搜索这类按次收费的工具费用,不要假设也会减半。
还会改变账单的几项
- 只在美国推理:请求里设
inference_geo: "us",输入、输出、缓存写入、缓存读取所有类别都乘 1.1。它和 Batch、缓存倍率叠加:Batch 下的输出就变成 $25 × 1.1 = $27.50。默认的全球路由按标准价。 - Amazon Bedrock 和 Google Cloud:由云厂商按自己的价目表收费,区域端点和多区域端点比全球端点贵 10%。1.1 倍的美国推理倍率不要套到这两家的账单上,价格以各自的定价页为准。
- 工具调用:
tools里的工具名、描述和参数定义,以及tool_use、tool_result内容块,都按输入 token 计费。网页搜索每 1,000 次另收 $10,外加相应 token;网页抓取除 token 外不另收费。 - 思考 token:Fable 5.1 思考始终开启,
display默认是"omitted",你在响应里看不到思考内容,但它按输出价计费。看到的回复很短、output_tokens却很大是正常的,算钱以output_tokens为准。effort 越高,这部分通常越多。 - 新分词器:Claude 4.7 及之后的模型(包括 Fable 5.1)用的是新分词器,同样的文本比 Sonnet 4.6 及更早模型多出约 30% 的 token,具体取决于内容。拿旧模型的 token 统计来估 Fable 5.1 的成本会偏低。发请求前可以调用免费的 token 计数接口估算输入量,它返回的是估计值,也不考虑缓存。
- 币种:官方价格都是美元。换成人民币的实际支出取决于你的付款方式、汇率和手续费。
和 Opus 5.5 比,Fable 5.1 贵在哪里
| 计费项(美元 / 百万 token) | Fable 5.1 | Opus 5.5 |
|---|---|---|
| 普通输入 | $10 | $4 |
| 5 分钟 / 1 小时缓存写入 | $12.50 / $20 | $5 / $8 |
| 缓存读取 | $0.25 | $0.20 |
| 输出 | $50 | $20 |
| Batch 输入 / 输出 | $5 / $25 | $2 / $10 |
同样的 token 用量,放在 Opus 5.5 上,未缓存输入、缓存写入和输出都只要 Fable 5.1 的 40%,缓存读取是 80%。请求 A 在 Opus 5.5 上是 $0.196,约为 Fable 5.1 的 41%。两者都有 100 万上下文和 12.8 万输出上限;Opus 5.5 默认 effort 是 medium,官方标注的延迟档位也比 Fable 5.1 快一档(Moderate 对 Slower)。
不过按 token 的单价不等于按任务的成本:两款模型完成同一任务用的输出和思考 token、需要的重试次数都可能不同。Anthropic 的官方建议是,大多数工作先用 Opus 5.5;遇到高难度推理、长周期任务,或者 Opus 5.5 调高 effort 后仍然不够用时,再换 Fable 5.1。两者怎么选、何时切换,见 Claude Fable 5.1 和 Opus 5.5 怎么选?性能、价格与切换建议;Opus 5.5 自己的账单算法见 Claude Opus 5.5 价格与用量重置:API 账单怎么算,重置卡怎么用。如果你是从 Fable 5 或 Opus 5 迁移过来、想按任务成本做比较,可以参考 Claude Fable 5.1 与 Opus 5:API 价格与任务成本怎么算。
再往下,Sonnet 5 是输入 $2、输出 $10(原定 9 月 1 日涨到 $3/$15 的计划已取消),Haiku 4.5 是输入 $1、输出 $5,是当前在售 Claude 模型里最便宜的。
常见问题
订阅了 Claude Pro 或 Max,这次调价会影响我吗?
不会。订阅按月固定收费,和 API 按 token 计费是两套独立的账单,缓存读取降价只影响 API 用量。订阅的额度规则见 Claude Fable 5.1 使用限制:Pro 怎么收费,Max 额度何时恢复。
Claude API 在国内怎么开通和付款?
官方充值方式、国内可用的路线和共享密钥的风险,见 Claude API Key 怎么购买:官方充值、国内可用路线与共享密钥避坑;直连、云平台和网关几种接入方式的取舍,见 Claude 稳定接入怎么选:Anthropic 直连、云平台,还是 laozhang.ai 网关?。第三方渠道的价格与计费规则各不相同,以对方公布的价目为准,不能直接套用上面的官方单价。
100 万 token 的长上下文要加价吗?
不加。整个 100 万上下文按标准单价计费,缓存和 Batch 折扣在全部上下文范围内照常适用。但上下文越长,每轮请求的输入越多,如果这部分没有命中缓存,就会按 $10 / 百万 token 全价计费。
Fable 5.1 还会出新版本吗,价格会再变吗?
截至 2026 年 9 月 25 日,官方文档列出的最新 Fable 模型是 Fable 5.1,停用时间不早于 2027 年 9 月 1 日。关于"Fable 5.2"的说法只出现在传闻和早期报道里,没有官方价格。计费前以 Pricing 文档当天显示的价格为准。
参考来源2
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年9月25日。
参考来源2
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年9月25日。