Claude Haiku 5.5 对比 GPT-6 Luna:同价,默认档任务成本差 2.2 倍
Claude Haiku 5.5 与 GPT-6 Luna 短提示同价;AA v5.0 中默认档 Haiku 每任务约贵 2.2 倍、分更高,提示过 100K 后单价再涨 5 倍。
文章目录
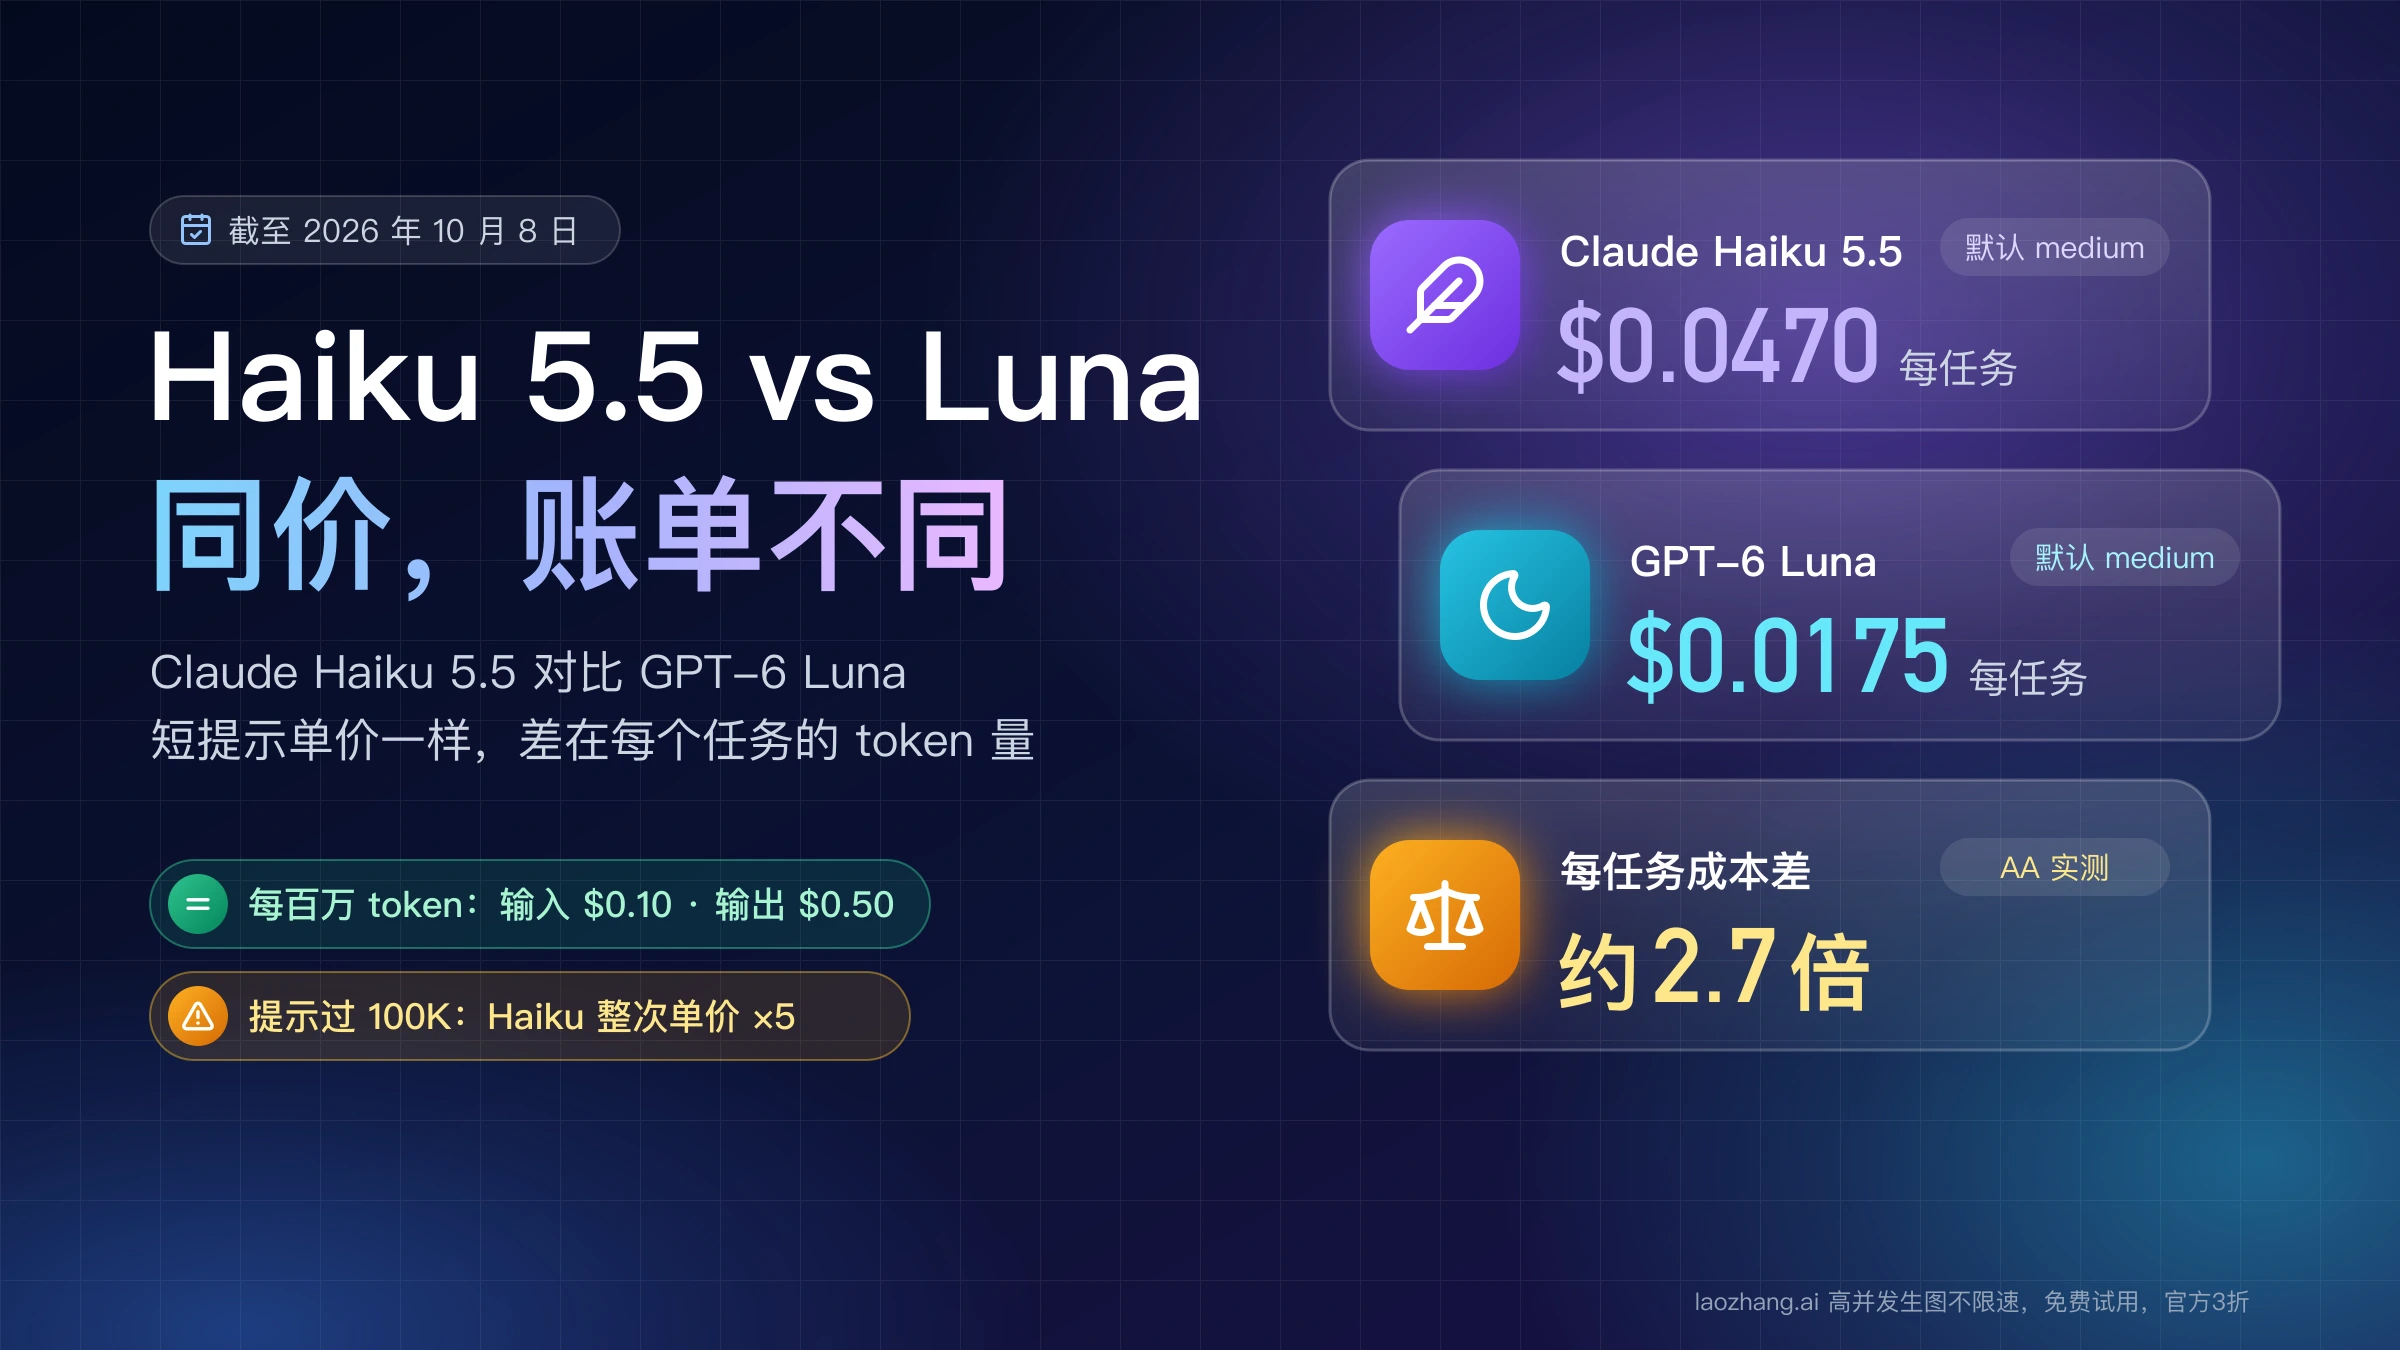
截至 2026 年 10 月 8 日,Claude Haiku 5.5 和 GPT-6 Luna 的 API 标价在短提示下完全一样:每百万 token 输入 $0.10、缓存读取 $0.01、输出 $0.50(见 Claude API 价格页与 OpenAI API 定价页)。拉开账单的是每个任务生成多少 token。Artificial Analysis(下称 AA)的智能指数在 2026 年 10 月 27~28 日换成 v5.0(9 项评测),在两边默认的 medium effort 下,Haiku 5.5 每任务 $0.0918,GPT-6 Luna 每任务 $0.0422,前者约贵 2.2 倍,分数是 25 对 18(AA 的 Haiku 5.5 与 GPT-6 Luna 对比页)。提示一旦超过 100K token,Haiku 整次请求的单价再涨 5 倍,Luna 要到 272K 才换档,而且只涨 1.5~2 倍。
所以没有自己任务的对照数据时,先拿 GPT-6 Luna 做成本基线,尤其是请求量大、提示偏长的分类、路由和信息抽取。下面几种情况再让 Haiku 5.5 跑同一批任务:
- 需要的质量接近或超过 Luna 的上限。AA v5.0 里 Luna 开到 max 档才 28 分,Haiku 从 high 档起就有 30 分,xhigh 和 max 档是 34 和 36 分;Luna 要开到 xhigh 才有的 23 分,Haiku 默认的 medium 档就有 25 分,每任务还便宜约 12%。
- 终端操作、电脑操作一类的代理任务。AA 的 Terminal-Bench 4.0 和 Anthropic 自报的 OSWorld 2.1 离线子集里,Haiku 都明显领先。
- 主代理已经是 Claude Sonnet 5.5 或 Opus 5.5,需要一个同栈的子代理,或者在 Claude Code 里用
haiku别名。
还有一个前提在单价之前:Anthropic 和 OpenAI 的支持地区列表里都没有中国大陆、香港和澳门。能不能合规直连,决定了比较是否成立,具体见后面的接入一节。
同价、贵 12 倍、便宜 75%:三种说法各在比什么
三种说法都有出处,但比较的对象不同,只有第一种直接比的是这两款模型。
| 说法 | 实际比较的是什么 | 出处 | 能否用来估你的账单 |
|---|---|---|---|
| 两者同价 | Haiku 5.5 提示不超过 100K、Luna 输入不超过 272K 时的每百万 token 单价 | 两家定价页 | 只能代入单价,总额还要乘各自的 token 数 |
| Haiku 便宜 75% | Haiku 5.5 对比上一代 Claude Haiku 4.5 的平均运行成本 | Anthropic 的 Haiku 5.5 发布公告 | 只对从 Haiku 4.5 迁移的人有意义,与 Luna 无关 |
| Haiku 贵 12 倍 | 社区帖子里的单次对比;AA 旧版数据里只有拿 Haiku max 档对 Luna medium 档才得到这个数,v5.0 下这一对约 9.7 倍 | 社区帖子;AA 数据推算 | 不能,两边的 effort 档位不一样 |
75% 是 Anthropic 的平均估算。公告脚注说明,按单价算,100K 以内的请求 Haiku 5.5 比 Haiku 4.5 低 90%,超过 100K 低 50%,而 Haiku 4.5 约 90% 的请求在 100K 以内。只按请求数加权是 0.9 × 90% + 0.1 × 50% = 86%;Anthropic 还扣掉了 Haiku 5.5 因新分词器每个任务多用的 token,结果约为 75%。
12 倍可以用 AA 10 月 8 日的旧版 v4.3.2 每任务成本复算:Haiku max 档 $0.2128 ÷ Luna medium 档 $0.01748 ≈ 12.2 倍。换成 v5.0 后同一对是 $0.4110 ÷ $0.0422 ≈ 9.7 倍;两边都取同一档位时,比值是 2.2~8.6 倍(下面有整张表);Haiku medium 对 Luna low 能凑出约 18 倍。档位不同,比出来的是"开多大思考量",不是"哪个模型贵"。
既然短提示单价相同,同一个任务的成本差就只来自三处:模型生成了多少输出和思考 token、同一段文字被各自的分词器切成多少 token,以及 Haiku 的请求有没有越过 100K。
API 单价:Haiku 过 100K、Luna 过 272K,整次请求换档
下表单位是美元/每百万 token,截至 2026 年 10 月 8 日,取自两家的官方定价页。输出单价也适用于思考或推理 token。
| 计费项 | Haiku 5.5,提示 ≤100K | Haiku 5.5,提示 >100K | GPT-6 Luna,输入 ≤272K | GPT-6 Luna,输入 >272K |
|---|---|---|---|---|
| 输入 | $0.10 | $0.50 | $0.10 | $0.20 |
| 缓存读取 | $0.01 | $0.05 | $0.01 | $0.02 |
| 缓存写入 | 5 分钟 $0.125,1 小时 $0.20 | 5 分钟 $0.625,1 小时 $1 | $0.125 | $0.25 |
| 输出 | $0.50 | $2.50 | $0.50 | $0.75 |
| 批处理输入/输出 | $0.05/$0.25 | $0.25/$1.25 | $0.05/$0.25 | $0.10/$0.375 |
两条阶梯线有三点不同:
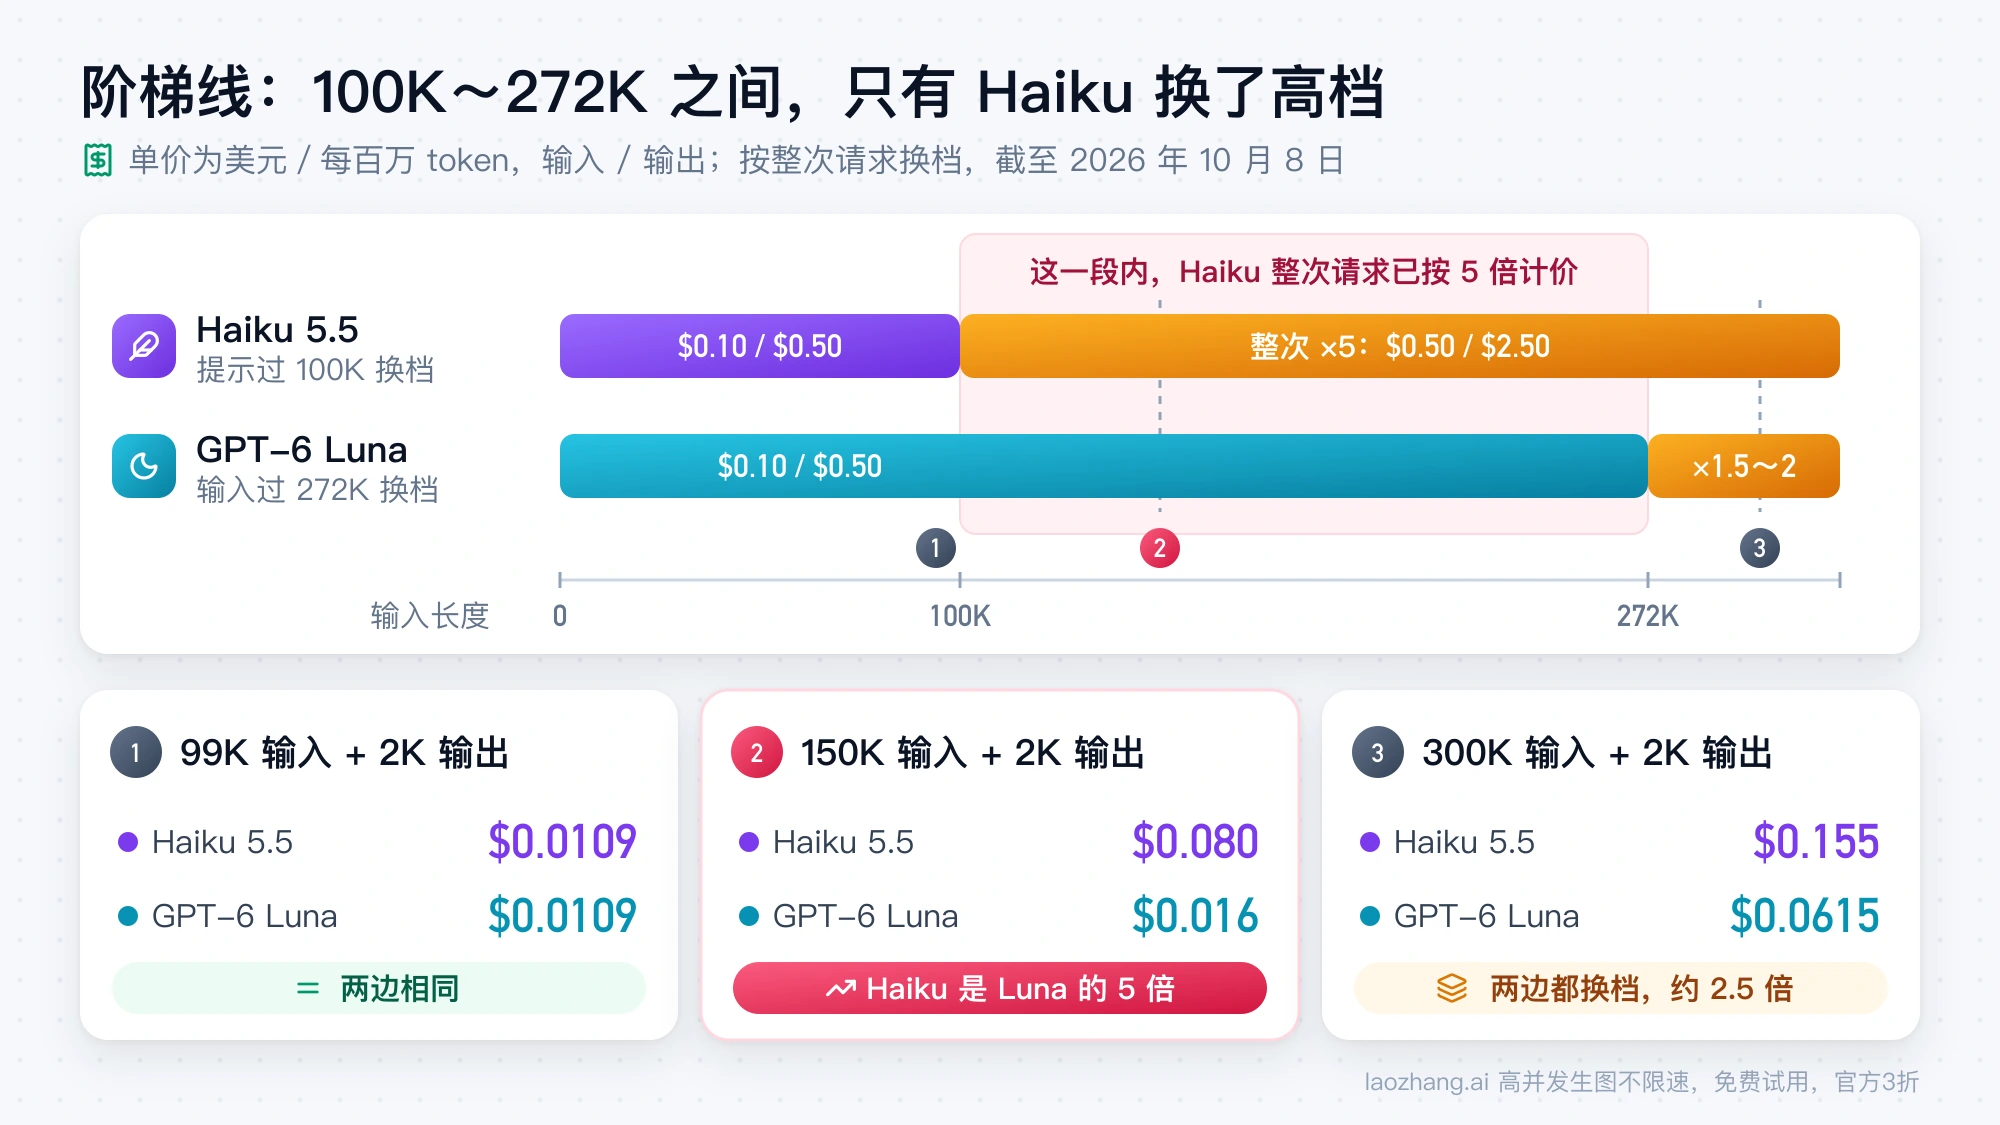
- 位置不同。Haiku 是提示超过 100,000 token,Luna 是输入超过 272K token。100K 到 272K 之间,Luna 仍是低档价,Haiku 已经是高档价。
- 涨幅不同。Haiku 换档后各项单价都是原来的 5 倍;Luna 输入和缓存是 2 倍,输出是 1.5 倍。
- 计价范围相同。GPT-6 Luna 型号页写明超过 272K 后"整次请求"按高档计价;Anthropic 价格表把输出和缓存列也放在"提示超过 100,000 token"那一行,公告脚注的说法是"超过 100,000 token 的请求",即整次请求换档,而不是只对超出部分加价。
缓存 token 也算进 Haiku 的 100K。Anthropic 价格页写明,提示长度按请求的全部输入 token 计算,缓存读取和缓存写入都包括在内;每次请求单独计价,超过 100K 的请求即使部分命中缓存也按高档收费,之前的请求仍按原来的价格。下面的缓存算例会说明这对账单的影响有多大。
加速通道上两家也不一样。OpenAI 在 2026 年 7 月 30 日把 Priority 处理改名为 Fast mode,价格是标准价的 2 倍,Batch 和 Flex 是五折;Anthropic 的服务等级文档写明 Haiku 5.5 不支持 Priority Tier,Anthropic 的 Fast mode 也只适用于 Opus 系列。需要付费买更低延迟时,两款里只有 Luna 有这条路。
上下文长度都够用:Haiku 5.5 上下文 1M token、单次输出最多 128K;GPT-6 Luna 上下文 1,050,000 token,其中输入最多 922,000,输出最多 128K。
每次请求花多少:阶梯线、缓存与批量分类算例
单次请求的成本按下面的公式算,单价取这次请求所在的档位:
成本 =(未缓存输入 × 输入单价 + 缓存读取 × 读取单价 + 缓存写入 × 写入单价 + 输出与思考 token × 输出单价)÷ 1,000,000
下面四个场景都不带缓存,输出量为假设值:
| 场景 | Haiku 5.5 | GPT-6 Luna | 差距 |
|---|---|---|---|
| 10K 输入 + 1K 输出 | $0.0015 | $0.0015 | 相同 |
| 99K 输入 + 2K 输出 | $0.0109 | $0.0109 | 相同 |
| 150K 输入 + 2K 输出 | $0.080 | $0.016 | Haiku 是 Luna 的 5 倍 |
| 300K 输入 + 2K 输出 | $0.155 | $0.0615 | Haiku 约是 Luna 的 2.5 倍 |
150K 这一行最能说明阶梯线的影响。Haiku 已经越过 100K:150,000 × $0.50 + 2,000 × $2.50,再除以一百万,等于 $0.075 + $0.005 = $0.080。Luna 还在 272K 以内:150,000 × $0.10 + 2,000 × $0.50,除以一百万,等于 $0.015 + $0.001 = $0.016。同样的请求,只是比 99K 多了 51K 输入,Haiku 的花费从 $0.0109 跳到 $0.080。到了 300K,Luna 也换档:300,000 × $0.20 + 2,000 × $0.75,除以一百万,等于 $0.0615;Haiku 是 300,000 × $0.50 + 2,000 × $2.50,除以一百万,等于 $0.155。
再看缓存。一次 150K 的请求,其中 140K 命中缓存、10K 未缓存,输出 2K:
- GPT-6 Luna:140,000 × $0.01 + 10,000 × $0.10 + 2,000 × $0.50,除以一百万,等于 $0.0034。
- Haiku 5.5:缓存 token 算进 100K,这次请求按高档计价,140,000 × $0.05 + 10,000 × $0.50 + 2,000 × $2.50,除以一百万,等于 $0.017。
同样大部分命中缓存,Haiku 这次请求是 Luna 的 5 倍。带长缓存前缀的 Haiku 请求要按 $0.017 这类高档数字做预算;想回到低档,就得把整次输入(含缓存部分)压到 100K 以内。
再看大批量分类:100 万次请求,每次 2K 输入、300 输出。每次是 2,000 × $0.10 + 300 × $0.50,除以一百万,等于 $0.00035,100 万次共 $350,两边相同;走批处理五折,各 $175。同样的工作量放在 Haiku 4.5 上,每次是 2,000 × $1 + 300 × $5,除以一百万,等于 $0.0035,共 $3,500。
这个算例里的 300 个输出 token 必须包含思考 token。两款模型默认都是 medium 档:Haiku 5.5 默认开启自适应思考,Luna 默认会推理。假设每次请求再多出 1,000 个思考 token,就是多 1,000 × $0.50 ÷ 1,000,000 = $0.0005,100 万次多 $500,总额从 $350 变成 $850。做分类、路由这种答案很短的任务时,把思考量压到最低,比在两个模型之间挑单价更省钱。
最后一个变量是分词器。Anthropic 说明,同一段文字在 Haiku 5.5 上比在 Haiku 4.5 上多出约 30% 的 token,具体视内容而定;Anthropic 与 OpenAI 两家分词器之间的换算比例没有公开数据。用自己的真实提示分别调用两边,读响应里的 usage 字段,比套任何比例都准。
每个任务花多少:AA 测得同档 effort 下 Haiku 贵 2.2~8.6 倍
AA 用同一套 9 项评测(综合指数 v5.0,取代了 10 项评测的 v4.3.2,两版分数不能逐分对比)按档位分别测了两款模型。下表是截至 2026 年 10 月 28 日 AA 对比页上的数据,每任务成本为美元,耗时是每个指数任务的平均秒数。
| effort 档位 | Haiku 5.5 指数 | Haiku 每任务 | Haiku 每任务耗时 | Luna 指数 | Luna 每任务 | Luna 每任务耗时 | Haiku/Luna 成本比 |
|---|---|---|---|---|---|---|---|
| max | 36 | $0.4110 | 593 秒 | 28 | $0.1520 | 597 秒 | 2.7 |
| xhigh | 34 | $0.2484 | 441 秒 | 23 | $0.1041 | 357 秒 | 2.4 |
| high | 30 | $0.1586 | 298 秒 | 21 | $0.0729 | 269 秒 | 2.2 |
| medium(两边默认) | 25 | $0.0918 | 193 秒 | 18 | $0.0422 | 未公布 | 2.2 |
| low | 19 | $0.0438 | 98 秒 | 10 | $0.0051 | 28 秒 | 8.6 |
| none(仅 Luna) | 无此档 | 无此档 | 无此档 | 9 | $0.07 | 86 秒 | 不适用 |
成本比按 AA 页面上的数值相除,例如 medium 档 0.0918 ÷ 0.0422 ≈ 2.2,low 档 0.0438 ÷ 0.0051 ≈ 8.6;xhigh 档 Haiku 的 $0.2484 和 high 档 Luna 的 $0.0729 是 AA 页面数据里的未取整值,它的表格上显示为 $0.25 和 $0.07。
同一档位下,Haiku 的分数高 7~11 分,从 medium 到 max 各档的输出 token 也多出约 2.7~3.1 倍。单价相同,成本比就跟着输出量走。low 档差距最大,因为 Luna 在 low 档几乎不怎么推理,每任务只花 $0.0051、约 28 秒。
AA 另一张表算了跑完整个指数的总花费:两边都开 max 档,Haiku 5.5 是 $339,GPT-6 Luna 是 $136,约 2.5 倍(AA 的 max 档对比页)。按 10 月 8 日的旧版 v4.3.2 数据,Haiku 当时的总花费里约六成花在思考 token 上。这里的倍数与每任务成本比 2.7 不同,因为两边计入的任务数不一样。
读这张表要注意一点:AA 对 Haiku 5.5 的所有档位都按 100K 以内的单价计价,页面没有提到阶梯价。如果评测里有提示超过 100K 的题,Haiku 的真实成本只会比表里高,表中的倍数是下限。
按同等分数比较:默认档 Haiku 反而更省,28 分以上只有 Haiku
只看同档位,会觉得 Haiku 贵两三倍;但 Haiku 每一档的分数都比 Luna 同档高,Luna 要追上同样的分数,得开到更高的档位,token 也跟着涨。按分数接近的组合重新配对:
| 目标分数 | Haiku 5.5 | GPT-6 Luna | Haiku/Luna 成本比 |
|---|---|---|---|
| 约 18 分 | low,19 分,$0.0438,98 秒 | medium,18 分,$0.0422,耗时未公布 | 1.04 |
| 约 23~25 分 | medium,25 分,$0.0918,193 秒 | xhigh,23 分,$0.1041,357 秒 | 0.88 |
| 约 28~30 分 | high,30 分,$0.1586,298 秒 | max,28 分,$0.1520,597 秒 | 1.04 |
| 34~36 分 | xhigh 或 max,$0.25~$0.4110 | 任何档位都达不到 | 不适用 |
结论有三层。在 Haiku 的默认档上,Haiku medium(24.6 分)在分数、每任务成本和耗时上都胜过 Luna xhigh(23.3 分):便宜约 12%,耗时少约 46%。另外两组里 Luna 便宜约 4%,但分数都略低(18.3 对 18.6、27.8 对 29.6),Luna max 的耗时还是 Haiku high 的两倍。需要高于 28 分的综合水平时,只能选 Haiku。
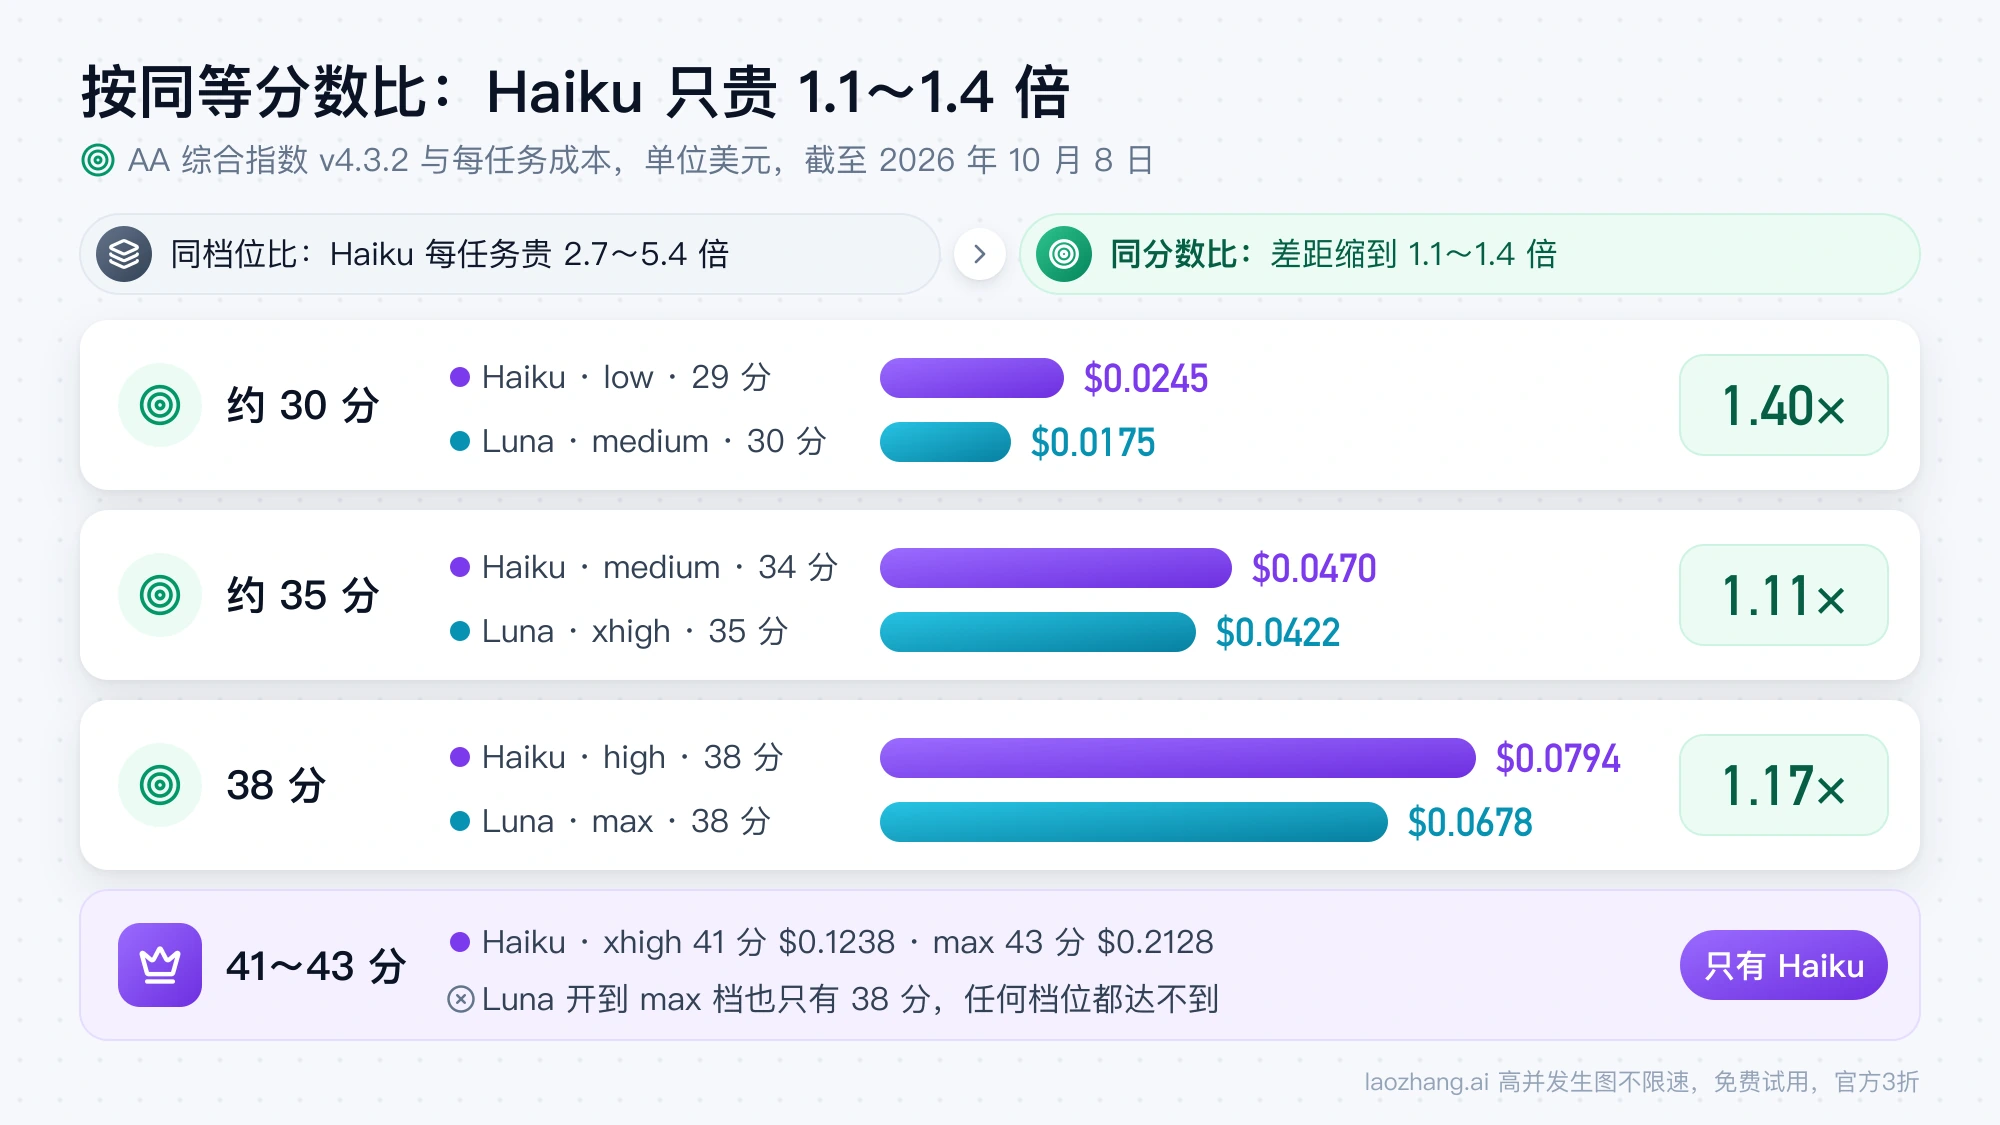
图中是 Artificial Analysis v4.3.2 的分数和成本;截至 2026 年 10 月 28 日的 v5.0 数字以上表为准,Haiku 默认的 medium 档对 Luna xhigh 反而更便宜。
综合指数是 9 项评测汇总的结果,分项结果会把结论推向两边:
- Terminal-Bench 4.0(终端里的代理式编码)每一档都是 Haiku 领先。Haiku low 档 12.6%,和 Luna max 档的 12.6% 持平;AA 只公布了全指数的平均每任务成本,按平均值粗看,Haiku low 档 $0.0438 还不到 Luna max 档 $0.1520 的三分之一。按这个粗算,在终端类任务上,更啰嗦的 Haiku 按同等分数反而更省。
- AutomationBench-AA 正好相反:Luna medium 档 40.5%,已经高于 Haiku max 档的 35.4%;两边都开 max 时是 53.2% 对 35.4%。
- 长上下文推理 AA-LCR 两边很接近,max 档是 82.7% 对 83.3%;这项属于旧版 v4.3.2,已不在 v5.0 指数里。
Anthropic 发布公告里也有一张对比表:OSWorld 2.1 离线子集 72.4% 对 48.9%,Terminal-Bench 4.0 39.2% 对 16.4%,FrontierCode 1.1 46.4% 对 42.4%。这些是 Anthropic 自己跑的,表里没有注明每格用的档位,可以作为方向参考,不宜和 AA 的数字直接混算。
落到自己的任务上,比的应该是每个合格结果的成本:
每个合格结果的成本 = 每任务成本 ÷ 通过率
Haiku 只有在"Haiku 通过率 ÷ Luna 通过率"大于"Haiku 每任务成本 ÷ Luna 每任务成本"时才更省。拿 kingy.ai 的一组小样本测试代入:它用两家订阅账号的命令行客户端跑了 40 个任务、每个两次,严格判分下 Haiku 通过 60/80(75.0%),Luna 通过 51/80(63.75%),通过率之比约 1.18(kingy.ai 的 Haiku 5.5 与 GPT-6 Luna 160 次回答测试)。如果你的任务也是这个比例,Haiku 每任务成本只要超过 Luna 的 1.18 倍,按合格结果算仍是 Luna 便宜;按 AA v5.0 的同分组合,Haiku 落在 0.88~1.04 倍,都在这条线以下,只有同档对比的 2.2~8.6 倍超过它。失败后要人工复核或整段重跑时,把这笔花费也计入每任务成本,通过率高的一方优势会更大,这时 token 单价就不再是主要因素。
按任务先试哪个:分类、抽取、子代理、电脑操作与长提示
| 任务 | 先试 | 理由 | 要设置的参数 |
|---|---|---|---|
| 大批量短请求:分类、路由、打标签 | GPT-6 Luna | 单价相同,Luna 低档输出极少;AA v5.0 中 low 档每任务 $0.0051;10 月 8 日测得首 token 3.23 秒 | Luna 用 none 或 low;Haiku 用 low,Anthropic 也推荐它处理简单的大批量请求 |
| 结构化信息抽取 | 两边都跑同一批样本 | kingy.ai 的小样本里两边 JSON 抽取都是 10/10 | Haiku 不能用预填充,改用结构化输出或带枚举字段的工具 |
| 提示 100K~272K 的长文档、长对话 | GPT-6 Luna | 这一区间 Haiku 整次请求按 5 倍单价计费,150K 的算例是 $0.080 对 $0.016 | 两边都先数清完整输入:系统提示、历史、工具定义和工具返回 |
| Claude 主代理下的子代理、Claude Code | Haiku 5.5 | Anthropic 把它定位为 Opus 5.5、Sonnet 5.5 编码工作的子代理;Claude Code 的 haiku 别名在 Anthropic API 上直接指向它 | Claude Code v2.1.293 以上 |
| 电脑操作、终端编码 | Haiku 5.5 | Terminal-Bench 4.0 在 AA 和厂商表里都领先;OSWorld 是厂商自报 | Haiku 要换成 computer_toolset_20260801 |
| 业务流程自动化 | GPT-6 Luna | AA 的 AutomationBench-AA 里 Luna medium 档已高于 Haiku max 档 | 用 Responses API 搭配推理与工具调用 |
| 首 token 延迟敏感的交互 | GPT-6 Luna | AA 10 月 8 日测得 Luna low 档首 token 3.23 秒,Haiku low 档 11.99 秒;需要时 Luna 还能买 Fast mode | 开始输出之后,Haiku 每秒输出的 token 更多(10 月 28 日 low 档 185 对 119) |
| 综合水平要求高于 Luna max | Haiku 5.5 | AA v5.0 中 Luna 最高 28 分,Haiku 的 high、xhigh、max 为 30、34、36 分 | 每任务 $0.16~$0.41,先在小样本上确认质量提升 |
只在 OpenAI 自家型号之间挑,可以看「GPT-6 Sol、Luna、Astra 与 Terra 怎么选?认清 6.1 Terra,再算成本」;要比两家的旗舰,见「Claude Opus 5.5 对比 GPT-6 Sol 与 6.1 Sol:先看任务,再算合格交付成本」。Haiku 5.5 的上一级是 Claude Sonnet 5.5,Anthropic 建议在用 Haiku xhigh 或 max 之前先和 Sonnet 5.5 比一比性能、成本与速度。
从一个换到另一个:会报 400 或改变账单的设置
两款模型的默认 effort 都是 medium,而且默认都会思考。迁移时最容易出问题的是下面这些地方,依据是 Claude Haiku 5.5 迁移指南、Claude effort 文档和 OpenAI 最新模型使用指南。
关掉或压低思考:
- GPT-6 Luna 支持
reasoning.effort: "none"(Chat Completions 里是reasoning_effort)。档位从低到高是none、low、medium、high、xhigh、max。 - Haiku 5.5 没有
none档,只有low到max五档。要关思考,可以在high及以下档位发送thinking: {"type": "disabled"};在xhigh或max档这样发会返回 400。Anthropic 提醒,关掉思考又要求 JSON 输出时,模型可能跳过本该调用的工具。 - Haiku 5.5 的思考 token 计入
max_tokens。原来给 Haiku 4.5 设的较小max_tokens可能让请求在思考块之后、正文之前就以stop_reason: "max_tokens"结束。
Haiku 5.5 会返回 400 的写法:
- 带非默认的
temperature、top_p或top_k。temperature只能是 1,top_p只能是默认的 0.99,两个同时带也会报错。 - 以 assistant 轮结尾的预填充,即使关了思考也一样。需要固定输出格式时,改用结构化输出,分类任务可以用带枚举字段的工具。
- 旧的
thinking: {"type": "enabled", "budget_tokens": N},要改成自适应思考。 - 在 Claude API 和 Google Cloud 上声明旧的
computer_20250124电脑操作工具。
GPT-6 Luna 这边:
- effort 不是
none时,要去掉temperature、top_p和top_logprobs。 - Chat Completions 里只有
reasoning_effort: "none"时才能用函数调用;需要边推理边调工具,改用 Responses API。
还有几处不报错、但会改变结果或账单:
- 换模型后重新数 token。Haiku 5.5 文档要求用
model为claude-haiku-5-5重新计数,不要沿用 Haiku 4.5 的数字;跨厂商时同理。 - 模型 ID 要写全。Haiku 5.5 是固定 ID
claude-haiku-5-5,没有日期后缀;GPT-6 Luna 是gpt-6-luna,不要和仍在列表里的上一代gpt-5.6-luna混用。 - Haiku 5.5 带有安全分类器,可能返回
stop_reason: "refusal",服务端不会自动换模型重试,代码里要处理。 - Haiku 5.5 的思考块只能在产生它的账号(或关联账号)里回放,对话要保持只追加、不改前文,否则会报 400。多租户共用一个对话存储的服务要特别留意。
在中国大陆和港澳:两家 API 都不在支持地区内
截至 2026 年 10 月 8 日,Anthropic 的支持国家和地区列表(适用于 API 和 Claude.ai)与 OpenAI API 的支持国家和地区列表里都没有中国大陆、香港和澳门。OpenAI 在列表页写明,在列表以外的地区访问或提供其服务,可能导致账号被封禁或暂停。
这对选型的影响是:两款模型在这个前提上是对等的,哪一款都不能从这些地区直接合规调用官方 API。团队在国内的,先确定能合规使用的是哪条线路,再在这条线路能调用的模型里比成本;单价再低,用不了也没有意义。
Haiku 5.5 还上架了 Amazon Bedrock、Google Cloud、Microsoft Foundry 和 Claude Platform on AWS,这些平台上的价格和可用区域由各云平台自定,不一定和 Anthropic 官方价一致。
laozhang.ai 的模型文档(数据更新于 2026 年 10 月 7 日)列出了 gpt-6-luna,走 OpenAI 兼容接口,单价与 OpenAI 官方一致:272K 以内输入 $0.10、输出 $0.50、缓存读取 $0.01,超过 272K 为 $0.20、$0.75、$0.02,整次请求按一个档位计费,调用日志里能看到实际用的档位(laozhang.ai 模型与价格文档)。同一份文档写明 Claude 模型因容量限制暂时下线,所以在这里调用不到 Haiku 5.5;要把两款放在同一批任务上对比,Haiku 需要另找可用的线路。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
Haiku 5.5 与 GPT-6 Luna 的常见问题
GPT-6 Luna 比 Claude Haiku 5.5 便宜吗?
单价不比 Haiku 便宜;同一档位按任务算更便宜,按同等分数算就不一定。提示不超过 100K 时两者单价相同;截至 2026 年 10 月 28 日,AA v5.0 的数据里同一档位 Haiku 每任务贵 2.2~8.6 倍,按分数接近的组合比差距在 ±12% 以内,Haiku 默认的 medium 档对 Luna xhigh 反而便宜约 12%。提示在 100K 到 272K 之间时,Haiku 整次请求按 5 倍单价计费,150K 输入加 2K 输出是 $0.080 对 $0.016。
Claude Haiku 5.5 和 GPT-6 Luna 哪个更强?
按 AA v5.0 综合指数,Haiku 5.5 每一档都比 Luna 同档高 7~11 分,最高 36 分对 28 分;终端编码和 Anthropic 自报的电脑操作成绩也是 Haiku 领先。但 AA 的 AutomationBench-AA 一项 Luna 明显领先,旧版指数里的长上下文推理两边接近。更强不等于更划算,要按每个合格结果的成本来比。
Claude Code 里能用 Haiku 5.5 吗?
能,需要 Claude Code v2.1.293 或更高版本,可运行 claude update 升级。haiku 别名只在 Anthropic API 上指向 Haiku 5.5;在 Amazon Bedrock、Google Cloud、Microsoft Foundry 和 Claude Platform on AWS 上,它仍指向 Haiku 4.5,要用 Haiku 5.5 就写完整模型名固定版本(见 Claude Code 模型配置文档)。在 Claude Code 里 Haiku 5.5 的默认 effort 同样是 medium。
ChatGPT 免费版现在用的是 GPT-6 Luna 吗?
是在逐步切换。OpenAI 在 2026 年 10 月 7 日的公告中说,从 10 月 8 日起,ChatGPT 的 Free 和 Go 用户在 Chat 里使用的 GPT-6 由 GPT-6 Luna 提供,Plus 及以上由 GPT-6 Sol 提供,两者都针对日常对话做了调校;Work 和 Codex 用的模型不变(OpenAI 的 GPT-6 for everyone 公告)。Claude.ai 的 Free 到 Enterprise 用户也都能选 Haiku 5.5。聊天产品里的版本与 API 的 gpt-6-luna 是否完全相同,OpenAI 没有说明,上面的 API 单价也不适用于订阅额度。
GPT-6 Luna 和 GPT-5.6 Luna 是同一个模型吗?
不是。gpt-6-luna 于 2026 年 9 月 22 日在 API 上线;上一代 gpt-5.6-luna 仍列在 OpenAI 定价页上,标准价输入 $0.20、输出 $1.20,比 GPT-6 Luna 贵。两者是不同的模型 ID,能力也不同。读第三方对比时先看清楚比的是哪一代,上面的价格和评测数据都指 gpt-6-luna。
参考来源14
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月28日。
参考来源14
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月28日。
- 1.Claude API 价格页platform.claude.com/docs/en/about-claude/pricing
- 2.OpenAI API 定价页developers.openai.com/api/docs/pricing
- 3.AA 的 Haiku 5.5 与 GPT-6 Luna 对比页artificialanalysis.ai/models/releases/comparisons/claude-haiku-5-5-vs-gpt-6-luna
- 4.Anthropic 的 Haiku 5.5 发布公告anthropic.com/claude-haiku-5-5
- 5.GPT-6 Luna 型号页developers.openai.com/api/docs/models/gpt-6-luna
- 6.AA 的 max 档对比页artificialanalysis.ai/models/comparisons/claude-haiku-5-5-vs-gpt-6-luna
- 7.kingy.ai 的 Haiku 5.5 与 GPT-6 Luna 160 次回答测试kingy.ai/blog/claude-haiku-5-5-vs-gpt-6-luna-benchmark
- 8.Claude Haiku 5.5 迁移指南platform.claude.com/docs/en/models/haiku-5-5/migration-guide
- 9.Claude effort 文档platform.claude.com/docs/en/build-with-claude/effort
- 10.OpenAI 最新模型使用指南developers.openai.com/api/docs/guides/latest-model
- 11.Anthropic 的支持国家和地区列表anthropic.com/supported-countries
- 12.OpenAI API 的支持国家和地区列表developers.openai.com/api/docs/supported-countries
- 13.Claude Code 模型配置文档code.claude.com/docs/en/model-config
- 14.OpenAI 的 GPT-6 for everyone 公告openai.com/index/gpt-6-for-everyone