Claude Prompt Caching 提示缓存怎么用:各模型价格与命中实测
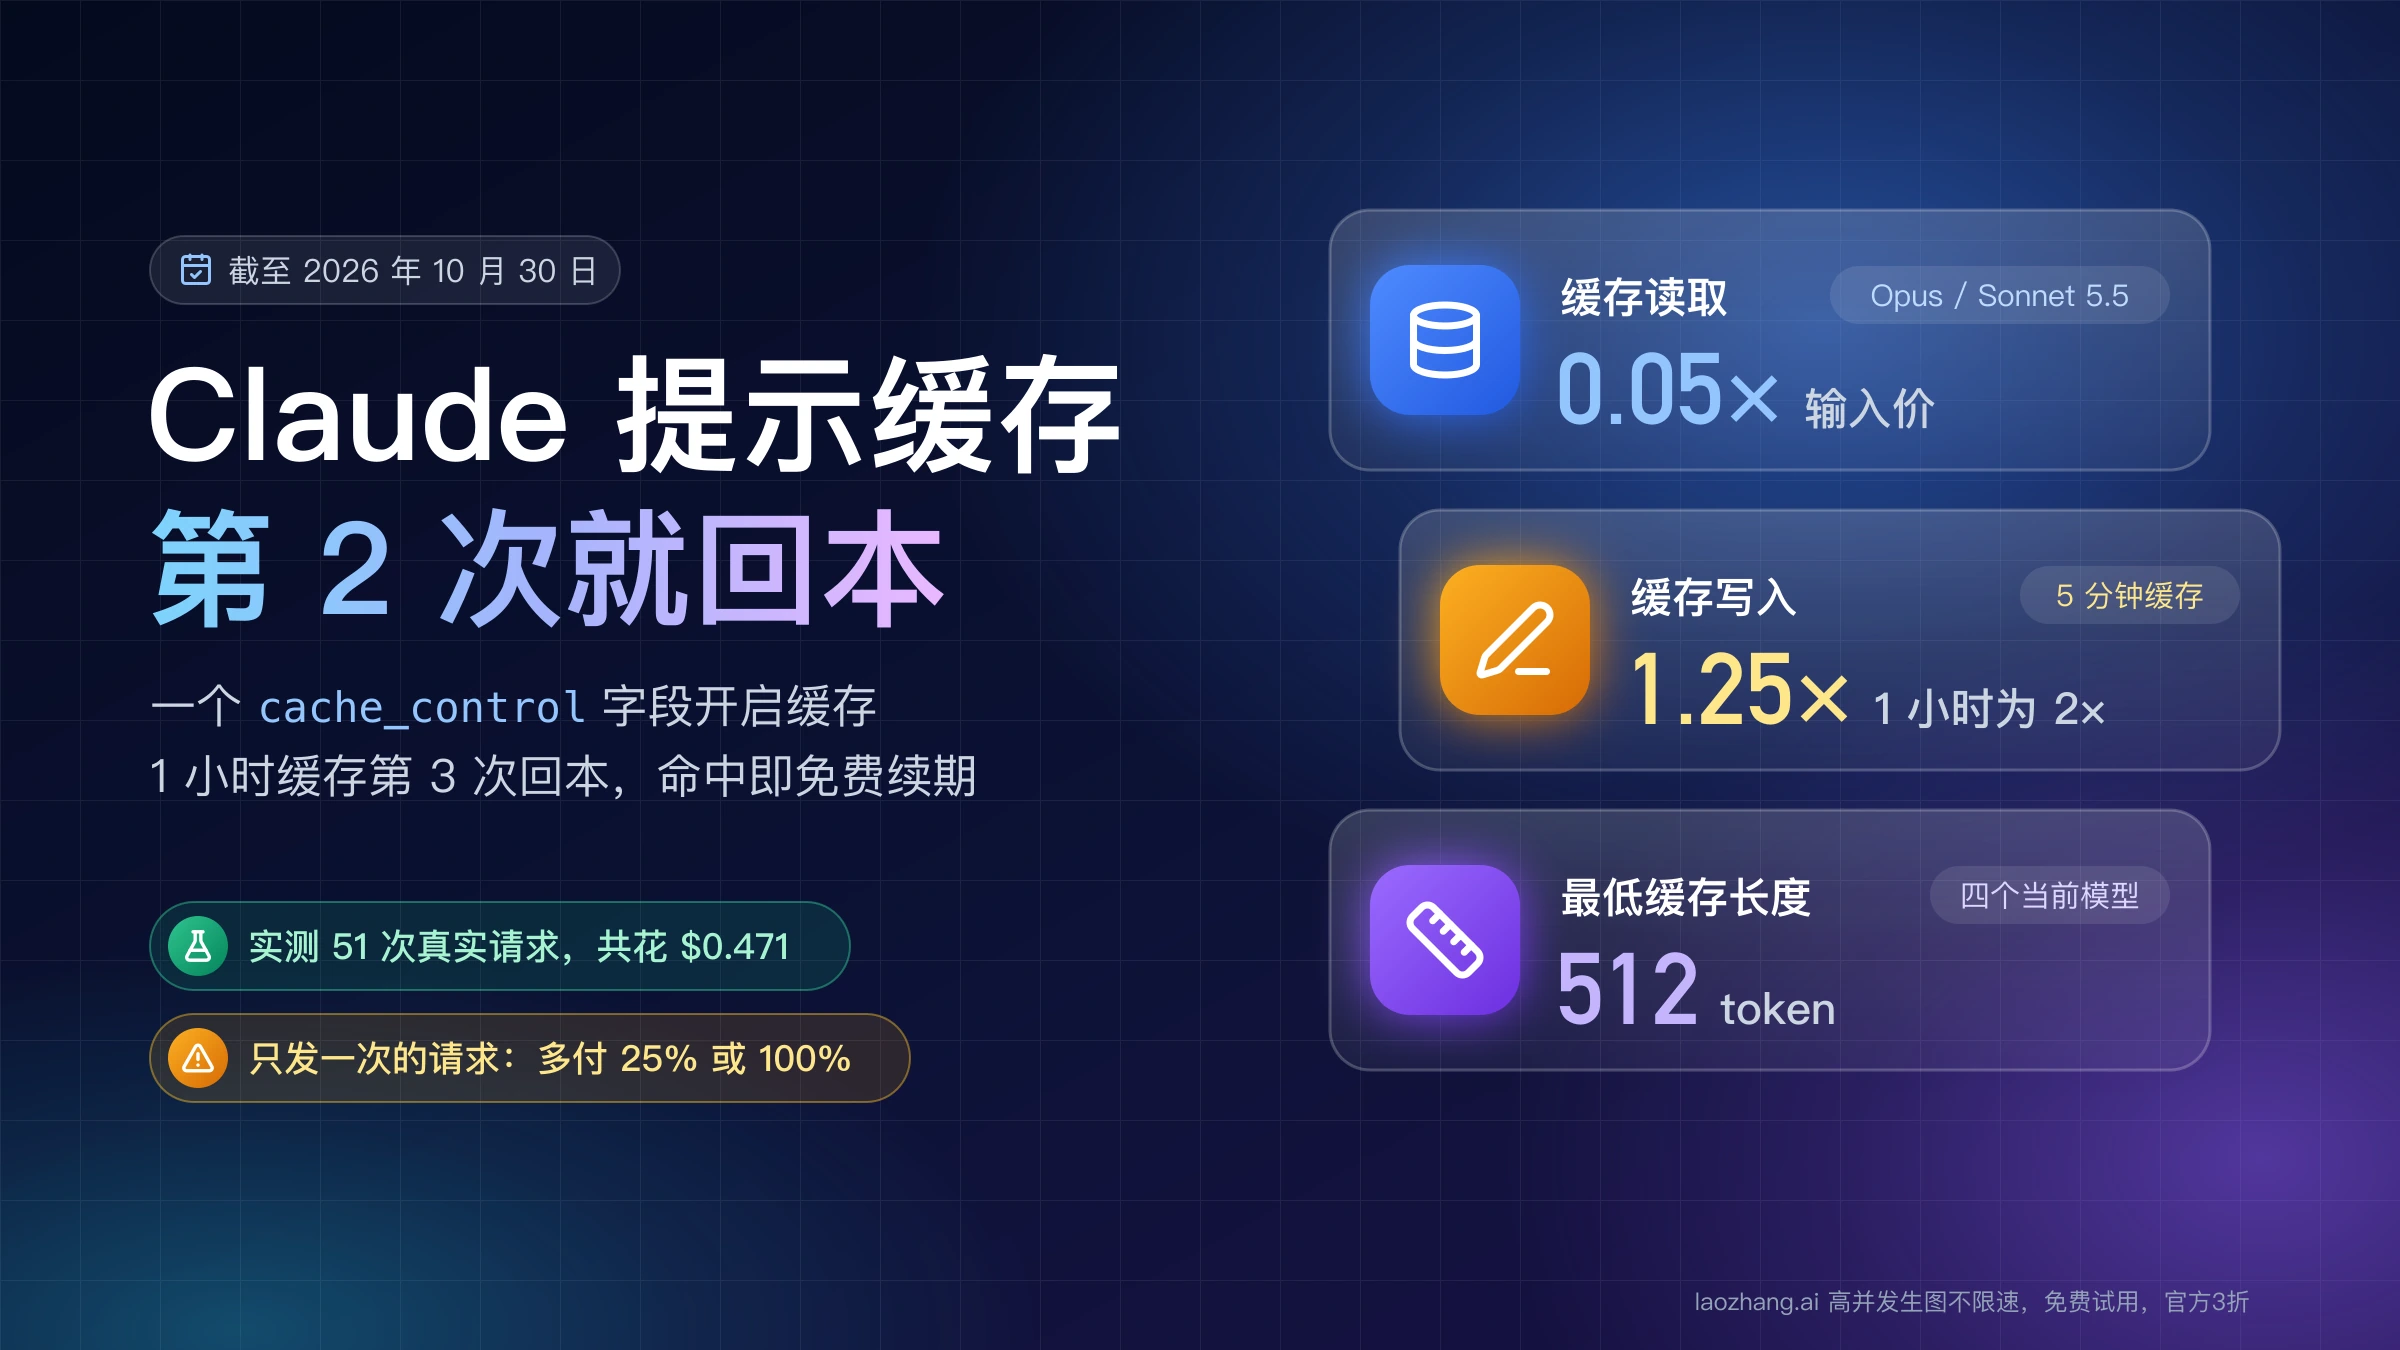
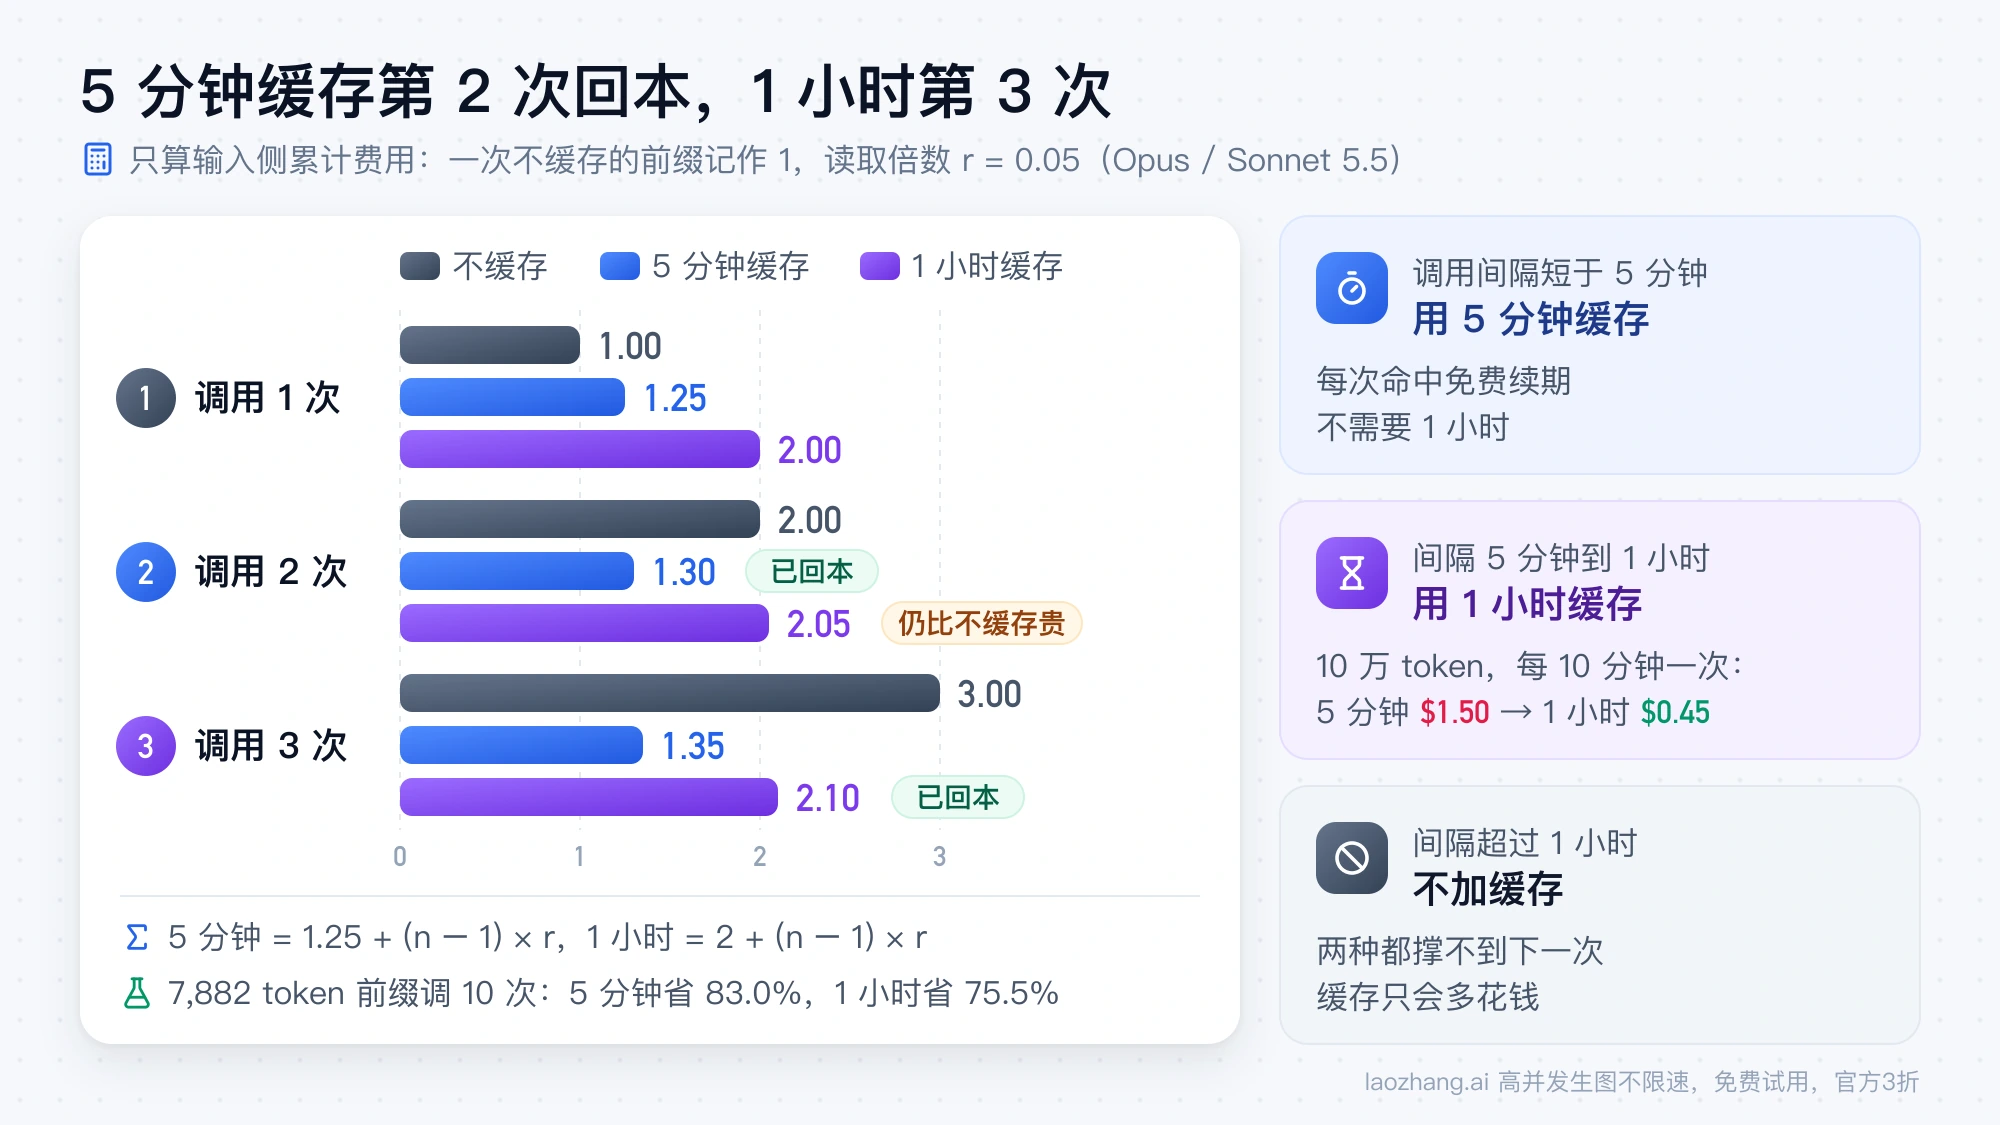
Claude 提示缓存加一个 cache_control 即可开启;Opus/Sonnet 5.5 读取只要输入价的 0.05 倍,最少 512 token,第 2 次调用就回本。
文章目录
Claude 的提示缓存(prompt caching,也有人叫提示词缓存)缓存的是请求开头的一段前缀:按 tools → system → messages 的顺序,从第一个字一直到带 cache_control 标记的那个块。开启只要一个字段:多轮对话在请求体顶层加 "cache_control": {"type": "ephemeral"},让 API 自动放断点;长文档或长 system 提示后面跟着每次都变的内容时,把同一个标记放在最后一个不变的块上。缓存默认保留 5 分钟,每次命中免费续期,也可以付更高的写入价换 1 小时。
截至 2026 年 10 月 30 日,Anthropic 价目表上的缓存写入是基础输入价的 1.25 倍(5 分钟)或 2 倍(1 小时);缓存读取在 Opus 5.5 和 Sonnet 5.5 上是 0.05 倍,Fable 5.1 是 0.025 倍,Haiku 5.5 和更早的模型仍是 0.1 倍。这四个当前模型的最低缓存长度都是 512 token。按这些倍数,同一前缀在有效期内用到第 2 次就回本,1 小时缓存要到第 3 次。发完请求看返回的 usage:cache_creation_input_tokens 大于 0 是写入,cache_read_input_tokens 大于 0 是命中,两个都是 0 说明这次根本没有缓存。
缓存也会让账单变贵:只发一次的请求,缓存部分要多付 25% 或 100%;调用间隔超过有效期,每次都在重新写入;几个相同的冷请求同时发出,每个都写一遍。下文除了 Anthropic 的文档,还有 2026 年 10 月 30 日经 LaoZhang 的 Claude 接口发出的 51 次真实请求(一个账号、一份 7,882 token 的前缀,主要用 Sonnet 5.5),总花费 $0.471;这条中转路线上有几处行为和官方文档不一样,单独放在后面一节。
Claude 提示缓存存的是什么:开头到 cache_control 的整段前缀
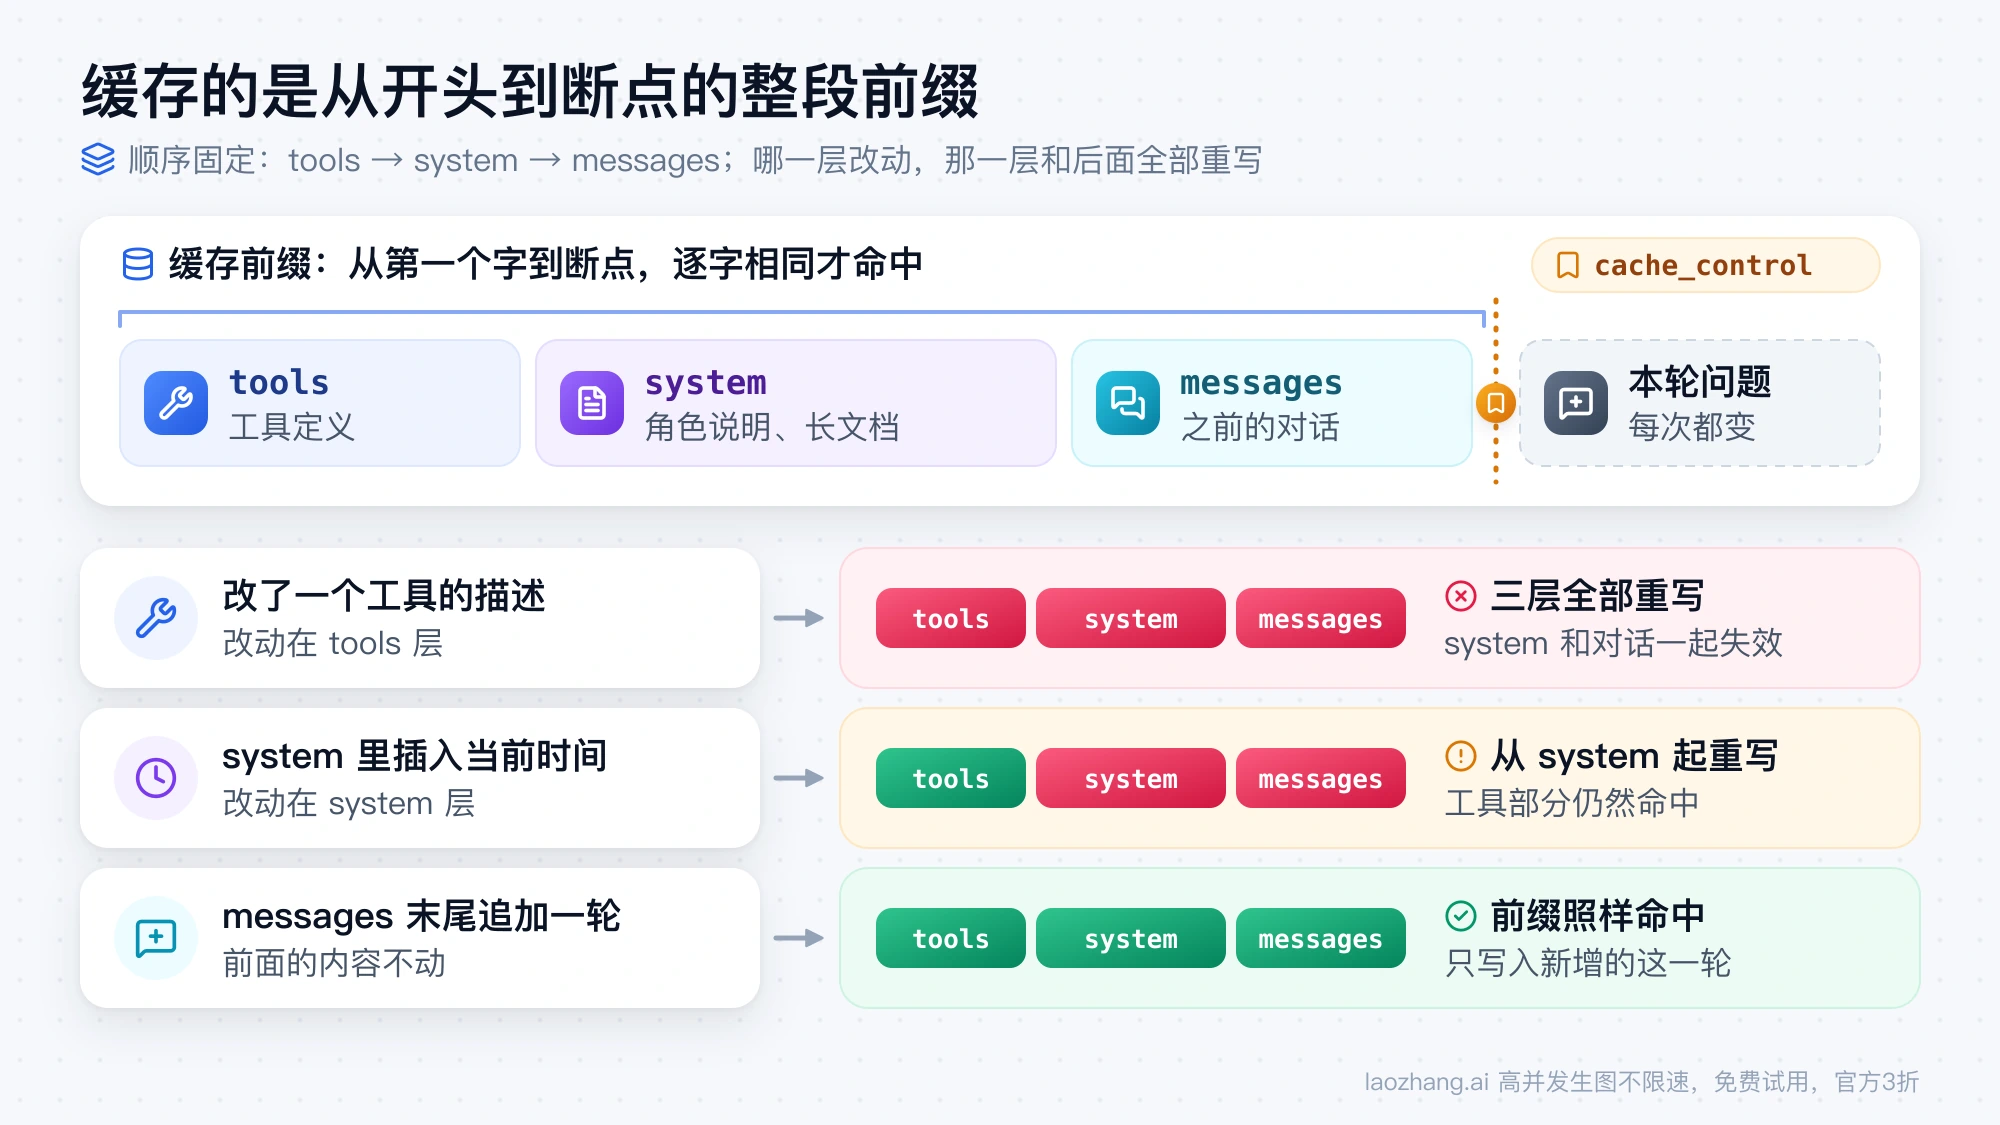
Claude 不是按"哪段文字重复了"来缓存,而是按位置:API 把从请求第一个字到断点为止的整段内容算成一个哈希,下一次请求只有这一整段逐字相同(图片也算在内),才能读到缓存。顺序固定是工具定义 tools 在最前,然后是 system,最后是 messages,这是 Anthropic 提示缓存文档里写明的层级。所以改动发生在哪一层,那一层和它后面的缓存全部作废:改了一个工具的描述,system 和对话的缓存一起失效;在 system 里插一个当前时间,后面的对话缓存跟着失效;只在 messages 末尾追加新的一轮,前面的部分照样命中。
这也决定了提示该怎么排:不变的内容放前面(工具定义、角色说明、长文档、示例),会变的内容放后面(检索结果、当前时间、用户这一轮的问题)。缓存只省输入的计算和费用,不改变模型的输出,同样的请求开不开缓存,回答的生成方式一样。
缓存的有效期从写入或读取它的那次请求开始算,不是从响应结束算。官方文档举的例子是一个流式响应持续了 4 分钟,那么 5 分钟的缓存只剩大约 1 分钟。缓存也不跨账号共享:不同组织之间永远隔离,在 Claude API 上同一组织的不同 workspace 之间也各自独立;只有 Amazon Bedrock 和 Google Cloud(Google 托管)上按组织隔离。
怎么开启缓存:多轮对话用自动缓存,固定前缀用显式断点
两种开法的价格、最低长度和前缀规则完全一样,区别只在断点由谁来放。对话一轮一轮往后追加、前面的内容从不改动,用自动缓存,Anthropic 也建议多轮对话先从它开始;前缀后面紧跟着每次都变的内容,或者想把工具定义、长文档、对话历史分层缓存,就用显式断点,一个请求最多 4 个。
自动缓存:请求体顶层加一个 cache_control
在请求体最外层加 cache_control,API 会把断点放在最后一个可缓存的块上,并随着对话变长自动往后挪:每一轮读取上一轮写下的前缀,再把新增的这一轮写进去。下面是直连 Anthropic 的写法:
curl https://api.anthropic.com/v1/messages \
  -H "content-type: application/json" \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -d '{
    "model": "claude-sonnet-5-5",
    "max_tokens": 1024,
    "cache_control": {"type": "ephemeral"},
    "system": "你是一名售后客服,依据下面的手册回答……(这里是几千 token 的固定说明)",
    "messages": [
      {"role": "user", "content": "我的订单还没发货"},
      {"role": "assistant", "content": "请提供订单号,我帮你查一下。"},
      {"role": "user", "content": "订单号是 20261030-001"}
    ]
  }'
经 LaoZhang 调用时,地址换成 https://api.laozhang.ai/v1/messages,认证头换成 -H "Authorization: Bearer $LAOZHANG_API_KEY",请求体不变。2026 年 10 月 30 日经这条路线用 Sonnet 5.5 跑了一段三轮对话:第 1 轮写入 7,906 token;第 2 轮读取 7,906、新写入 65;第 3 轮读取 7,971、新写入 74,断点确实跟着对话往后移。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
自动缓存有几种会直接报 400 的情况:最后一个块上已经有一个 TTL 不同的显式 cache_control,或者请求里已经用满 4 个显式断点(自动缓存本身也占一个名额)。旧版 Amazon Bedrock 集成(Opus 4.6 及更早)不支持顶层 cache_control,在那里只能用显式断点。
显式断点:标在最后一个不变的块上
显式断点把 cache_control 写在某个内容块上,缓存只在这个位置写入。下面用 Python SDK 把一份手册放进 system 并在它上面打断点,用户问题放在断点之后:
import os
from anthropic import Anthropic

client = Anthropic(api_key=os.environ["ANTHROPIC_API_KEY"])
# 经 LaoZhang:Anthropic(api_key=os.environ["LAOZHANG_API_KEY"], base_url="https://api.laozhang.ai")

manual = open("manual.md", encoding="utf-8").read()

resp = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=1024,
    system=[
        {"type": "text", "text": "依据下面的手册回答问题,答不上来就直说。"},
        {"type": "text", "text": manual, "cache_control": {"type": "ephemeral"}},
    ],
    messages=[{"role": "user", "content": "退货期限是几天?"}],
)
print(resp.usage)
2026 年 10 月 30 日用同样的结构(Sonnet 5.5,system 是一篇 7,882 token 的文章)连问三个不同的问题:第 1 次 cache_creation_input_tokens 是 7,882,第 2、3 次 cache_read_input_tokens 都是 7,882,写入为 0。问题本身在断点之后,换问题不影响命中。
断点要放在"最后一个每次都相同的块"上,而不是放在最末尾。API 读取时只会从断点往回找最多 20 个位置,看有没有之前请求在那里写过的条目;它不会因为断点前面有一段稳定内容,就自动把那段缓存起来。长对话里如果一轮加了 20 个以上的块,上一次写入就落到了窗口外,这时在更靠前的位置预先加第二个断点;在 Claude API 上,连续的 tool_use 块只算一个位置,连续的 tool_result 块也只算一个,所以一轮里并行调用很多工具,本身不会把上一次写入挤出窗口。断点本身不收费,费用只来自实际的写入和读取。
各模型缓存价格:写入 1.25 或 2 倍,读取 0.025 到 0.1 倍
缓存价格都是在各模型的基础输入价上乘一个固定倍数,写入倍数所有模型相同,读取倍数(命中时的续期也按读取价)因模型而异。下表是截至 2026 年 10 月 30 日 Anthropic 提示缓存文档的价格表,单位为每百万 token 的美元价,最低缓存长度取自同一文档的限制说明。
| 模型 | 基础输入 | 5 分钟写入 | 1 小时写入 | 缓存读取 | 读取倍数 | 最低缓存长度 |
|---|---|---|---|---|---|---|
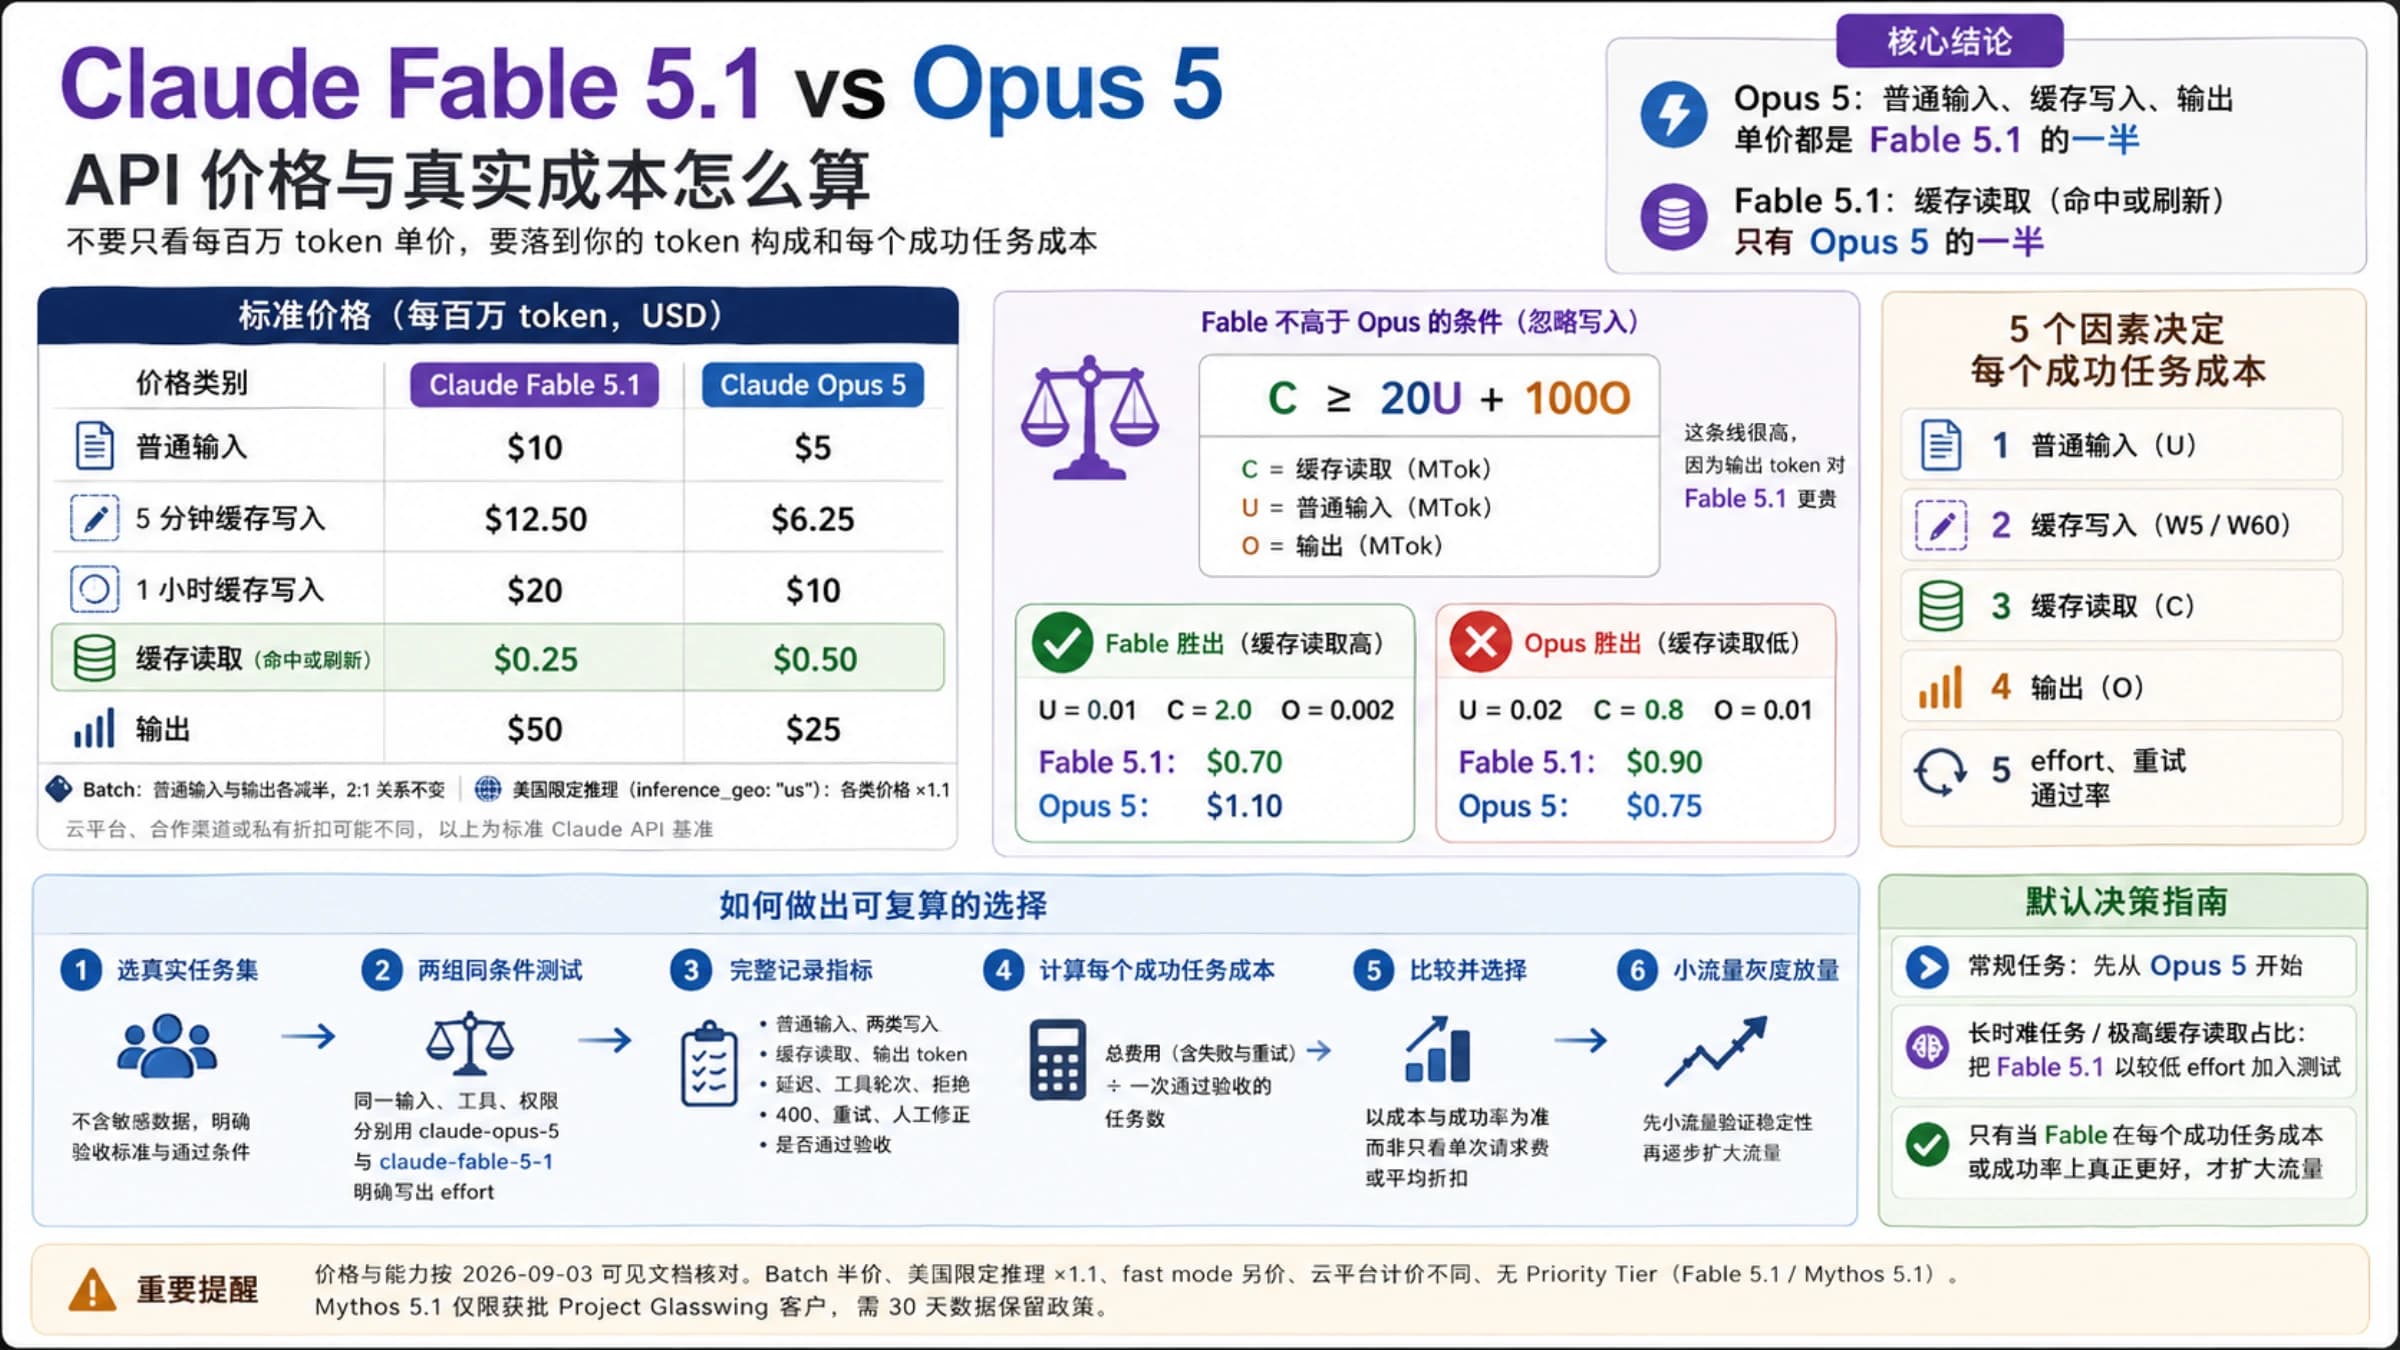
| Fable 5.1 | $10 | $12.50 | $20 | $0.25 | 0.025× | 512 |
| Opus 5.5 | $4 | $5 | $8 | $0.20 | 0.05× | 512 |
| Sonnet 5.5 | $2 | $2.50 | $4 | $0.10 | 0.05× | 512 |
| Haiku 5.5(提示 ≤10 万 token) | $0.10 | $0.125 | $0.20 | $0.01 | 0.1× | 512 |
| Haiku 5.5(提示 >10 万 token) | $0.50 | $0.625 | $1 | $0.05 | 0.1× | 512 |
| Opus 5 | $5 | $6.25 | $10 | $0.50 | 0.1× | 512 |
| Sonnet 5 | $2 | $2.50 | $4 | $0.20 | 0.1× | 1,024 |
| Sonnet 4.6 | $3 | $3.75 | $6 | $0.30 | 0.1× | 1,024 |
| Haiku 4.5 | $1 | $1.25 | $2 | $0.10 | 0.1× | 4,096 |
"缓存读取打 1 折""至少 1,024 token 才能缓存"这两个数字现在只对一部分模型成立。在 Opus 5.5 和 Sonnet 5.5 上,5 分钟写入价是读取价的 25 倍(1.25 ÷ 0.05),按 0.1 倍算出来的 12.5 倍已经不适用;Sonnet 5.5 的读取价是 10 月 7 日从 $0.20 降到 $0.10 的,一张账单因此能省多少,取决于缓存占输入的比例,见 Claude Sonnet 5.5 缓存读取价格降到 $0.10:省多少看缓存占比。
这些倍数会和批处理折扣、长上下文计价叠加。Haiku 5.5 按提示长度分档时,缓存读取和写入的 token 也算进提示长度,所以一个 9 万 token 的缓存前缀加上 1.5 万 token 的新内容,整次请求会按超过 10 万 token 的那一档计价。经 LaoZhang 调用时,它的模型价目表上四个当前模型的输入和缓存读取单价与上表相同(输出价也与官方一致),缓存写入价没有列出;10 月 30 日的计费实测里,写入按官方的 1.25 倍扣费,下文"经中转"一节有具体数字。各模型完整价目分别见 Claude Fable 5.1 API 价格:降了什么,省多少 和 Claude Opus 5.5 价格与用量重置:API 账单怎么算,重置卡怎么用。
缓存时间选 5 分钟还是 1 小时:第 2 或第 3 次调用回本
按同一前缀两次调用的间隔来选:间隔短于 5 分钟,用默认的 5 分钟缓存,每次命中都会免费续期,不需要 1 小时;间隔在 5 分钟到 1 小时之间,用 1 小时缓存,写入贵一些,但不会每次过期重写;间隔超过 1 小时,两种缓存都撑不到下一次调用,缓存只会多花钱。1 小时的写法是把标记写成 {"type": "ephemeral", "ttl": "1h"};同一个请求里两种混用时,1 小时的断点必须排在 5 分钟的前面。
盈亏点可以只看输入侧算,因为缓存不改变输出 token 的价格。把一次不缓存的前缀费用记作 1,读取倍数记作 r:调用 n 次,不缓存是 n,5 分钟缓存是 1.25 + (n − 1) × r,1 小时缓存是 2 + (n − 1) × r。Opus 5.5 和 Sonnet 5.5 的 r 是 0.05,调用 2 次时 5 分钟缓存是 1.30,已经低于 2;1 小时缓存调用 2 次是 2.05,比不缓存的 2 还贵,第 3 次是 2.10,低于 3 才回本。Haiku 5.5(r = 0.1)和 Fable 5.1(r = 0.025)的回本次数一样:5 分钟缓存第 2 次,1 小时缓存第 3 次。
套到实际数字上,用前面测过的 7,882 token 前缀在 Sonnet 5.5 上调用 10 次(都在有效期内),输入侧不缓存是 $0.1576(7,882 × 10 × $2 ÷ 100 万);5 分钟缓存是 1 次写入加 9 次读取,$0.0268,省 83.0%;1 小时缓存 $0.0386,省 75.5%。前缀越长、调用越密,省得越多:8 万 token 的前缀调用 20 次,Opus 5.5 从 $6.40 降到 $0.704(5 分钟缓存,省 89.0%)。反过来,如果是一个 10 万 token 的前缀、每 10 分钟调用一次,一小时 6 次,不缓存是 $1.20;5 分钟缓存每次都过期重写,6 次写入共 $1.50,比不缓存多 25%;改成 1 小时缓存是 1 次写入 $0.40 加 5 次读取 $0.05,共 $0.45。
有效期在 2026 年 10 月 30 日经 LaoZhang 用 Sonnet 5.5 测过两次。5 分钟缓存在 04:45:11 写入、04:45:17 命中,闲置 6 分 20 秒后再发同样的请求,又是一次 7,882 token 的写入,已经过期。1 小时缓存在 04:46:21 写入、04:46:27 命中,闲置 7 分钟后(04:53:34)仍然读取 7,882 token,没有重写;1 小时的上限没有实测。按 Anthropic 文档,两种有效期在延迟上表现相同,区别只在存多久。
缓存反而更贵的两种情况:只发一次的请求和并发冷启动
除了上一节那种调用间隔超过有效期的情况,最常见的多花钱是给只发一次的请求加缓存。写入本身就比普通输入贵:Sonnet 5.5 上一个 10 万 token 的提示不缓存是 $0.20,加 5 分钟缓存变成 $0.25,加 1 小时缓存变成 $0.40,如果之后没有第 2 次相同前缀的调用,这 25% 或 100% 就白付了。批量处理一批互不相同的文档、一次性的长文翻译,都属于这种情况;只有共享部分(比如同一段很长的指令)会被多次复用时,才在那一段上打断点。
另一种是并发冷启动。缓存条目要等第一个响应开始返回之后才可用,所以同一个前缀的几个请求如果同时发出,谁也读不到谁。2026 年 10 月 30 日在 Sonnet 5.5 上同时发了 3 个相同的冷请求,3 个的 cache_creation_input_tokens 都是 7,882,没有一个读取。按标价算,3 次写入是 $0.0591,而先发 1 个、等它开始返回再发另外 2 个,是 1 次写入加 2 次读取,$0.0213。批量任务的做法是先发一个请求(或者下文的预热请求)把缓存写好,再并发其余的。
怎么确认缓存命中:看 usage 里的三个字段
每个响应的 usage 里有三个输入字段,三者相加才是这次请求的全部输入:cache_read_input_tokens 是从缓存读取的部分,cache_creation_input_tokens 是这次新写入缓存的部分,input_tokens 只是最后一个断点之后、没有参与缓存的部分。所以开了缓存之后 input_tokens 往往只有几十,看起来像"输入变少了",其实是被拆到了另外两个字段里。流式响应里,这些字段在 message_start 事件中返回。
| 字段 | 含义 | 2026 年 10 月 30 日实测(Sonnet 5.5,7,882 token 前缀) |
|---|---|---|
cache_creation_input_tokens | 本次写入缓存的 token,按写入价计费 | 第 1 次 7,882,第 2、3 次 0 |
cache_read_input_tokens | 本次从缓存读取的 token,按读取价计费 | 第 1 次 0,第 2、3 次 7,882 |
input_tokens | 最后一个断点之后未缓存的 token,按基础输入价计费 | 28、16、17 |
cache_creation.ephemeral_5m_input_tokens / ephemeral_1h_input_tokens | 用 1 小时缓存时,写入量按有效期拆开,两者之和等于 cache_creation_input_tokens | 经 LaoZhang 的 Messages 接口,1 小时请求的响应里没有这个对象 |
prompt_tokens_details.cached_tokens | OpenAI 兼容格式里的命中量 | 第 2 次 7,882 |
prompt_tokens_details.cached_creation_tokens | OpenAI 兼容格式里的写入量 | 第 1 次 7,882 |
下面是第 2 次调用实际返回的 usage,读取了 7,882 token,没有新的写入:
"usage": {
  "cache_creation_input_tokens": 0,
  "cache_read_input_tokens": 7882,
  "input_tokens": 16,
  "output_tokens": 38,
  "service_tier": "standard"
}
要算一段时间的缓存命中率,把每次请求的 cache_read_input_tokens 加总,除以三个输入字段的总和即可。这个比例才是账单上的有效比例;只数"命中了几次请求"会高估,因为一次请求可能读到前缀、同时又写入一大段新内容。
缓存命中率低、不命中或失效:按现象逐条排查
先看两个缓存字段属于哪种情况,再对照下表。两个都是 0,说明这次根本没有缓存,多半是前缀太短或标记没送到;每次都是写入、从不读取,说明前缀每次都不一样或者已经过期;读到了一部分、又写入一大段,说明前缀中间某处变了。
| 原因 | usage 里的表现 | 怎么改 |
|---|---|---|
| 前缀短于最低缓存长度 | 两个字段都是 0,HTTP 200,不报错 | 断点前的内容凑够 512 token(Sonnet 5 与 4.6 要 1,024,Haiku 4.5 要 4,096),或者不缓存这段 |
| 断点标在每次都变的块上(时间戳、本轮用户消息) | 每次都写入,从不读取 | 把 cache_control 挪到最后一个不变的块上;自动缓存同样会落在最后一块,这种结构改用显式断点 |
| 改了工具定义 | 工具、system、对话缓存全部重写 | 工具列表和描述固定下来,顺序也不要变 |
| 开关网页搜索、引用或 fast 模式 | system 和对话缓存重写 | 同一个会话里保持同一套开关 |
改了 tool_choice、增删图片、改 thinking 或 effort 设置 | 对话部分重写,工具和 system 是否保留因模型而异 | 同一会话保持同一套参数 |
| 两次调用间隔超过有效期 | 隔一段时间后又变回写入 | 间隔在 5 分钟到 1 小时之间改用 1 小时缓存 |
| 换了模型 | 新模型上第一次是完整写入 | 每个模型各有一份缓存,切换后第一次必然重写 |
| 并发发出相同的冷请求 | 每个请求都写入 | 先发一个,等它开始返回再并发 |
| 长对话一轮新增 20 个以上的块 | 对话进行中突然整段重写 | 在靠前的位置加第二个断点 |
| 不同 workspace 或不同组织 | 同样的提示换个 key 就重写 | Claude API 上缓存按 workspace 隔离 |
中转平台没有转发 cache_control | 两个字段都是 0,或者响应里没有这两个字段 | 用同一请求连发两次核对,不行就换平台或换接口格式 |
最低长度这一条在 2026 年 10 月 30 日用 Sonnet 5.5 测过:180 和 377 token 的前缀打了标记,连发两次,两个缓存字段都是 0,请求正常返回;567 和 1,094 token 的前缀则第 1 次写入、第 2 次命中。换模型这一条也测过:同一个 7,882 token 的前缀已经在 Sonnet 5.5 上缓存,发给 Opus 5.5 时仍是完整写入,第 2 次才命中。effort 那一行在 Sonnet 5.5 上测的是 system 层:effort 从 low 改成 medium 再改回 low,三次分别是写入、读取、读取,system 的缓存没有丢,与 Claude Code 文档"5.5 系列改 effort 保留缓存"的说法一致;按 API 文档,改 effort 总会让对话部分的缓存失效,这一层没有单独测。把 effort 显式设成模型默认值,等同于不写,不会让缓存失效。Swift 和 Go 这类会打乱 JSON 键顺序的语言,序列化 tool_use 块时键序每次不同,也会让缓存永远对不上。
对话中途需要追加一条新的系统指令时,不要改顶层的 system。在 Opus 5.5、Sonnet 5.5、Haiku 5.5、Fable 5.1 等模型上,可以往 messages 里追加一条 {"role": "system"} 消息,前面缓存的前缀保持不变;Sonnet 5 不支持这种写法。
直连 Claude API 时还可以让 API 直接告诉你前缀从哪里开始不一样:第 1 轮请求加 "diagnostics": {"previous_message_id": null},之后每一轮把上一次响应的 id 填进去,响应里的 diagnostics 会指出差异出在模型、system、工具还是消息历史,返回 null 表示两次请求结构一致。按 Anthropic 缓存诊断文档,这个功能已经正式提供,不再需要 beta 请求头,但只在 Claude API 上有。
经中转或 OpenAI 兼容接口还能缓存吗:LaoZhang 上的实测差异
能不能缓存,取决于中转平台是否把 cache_control 原样转发给上游、是否把 usage 里的缓存字段原样返回。LaoZhang 的 Claude 接口文档写明支持提示缓存(5 分钟与 1 小时);2026 年 10 月 30 日经它的 /v1/messages 接口实测,自动缓存、显式断点、两种有效期、最低长度和并发冷启动的表现都和 Anthropic 文档一致。51 次请求按账户余额变化扣了 $0.471,按每次返回的 usage 和官方标价逐条复算是 $0.469,说明这段时间写入和读取都是按官方倍数计费的。
和官方文档不一样的地方有一处会影响账单:经这条路线,完全不带 cache_control 的请求也会缓存 system 提示。用同一个 7,882 token 的 system 在 Sonnet 5.5 上连发两次,第 1 次写入 7,882,第 2 次读取 7,882;按账户扣费看,第 1 次是 1.9788 美分,正好等于按 5 分钟写入价计费,而同样的请求不缓存应是 1.5846 美分,多了 25%;第 2 次只扣 0.0872 美分。断点放在带时间戳的块上时,system 部分照样能读到。这说明网关或它背后的上游线路会自行给 system 加缓存,对重复调用是好事,对只发一次的长 system 请求则意味着多付 25%;这一点没有拿 Anthropic 官方 API 直连对照过,属于根据现象的推断。
另外两处差别影响排查。经 LaoZhang 发 diagnostics 对象,请求正常返回,但响应里没有 diagnostics 字段,第 2 轮故意改了 system,只看到一次新的写入,没有任何说明;用 1 小时缓存时,响应里也没有按有效期拆分的 cache_creation 对象。所以经中转时,判断命中只能靠 cache_creation_input_tokens 和 cache_read_input_tokens 两个字段。
走 OpenAI 兼容的 /v1/chat/completions 接口调用 claude-sonnet-5-5 时,请求里没写任何缓存字段,system 照样被缓存了。第 1 次返回 prompt_tokens: 7893 和 prompt_tokens_details.cached_creation_tokens: 7882,第 2 次返回 prompt_tokens_details.cached_tokens: 7882,同时还附带了 Anthropic 格式的 cache_creation_input_tokens 和 cache_read_input_tokens。要注意这种格式里的 prompt_tokens 是含缓存部分的总输入,不能直接按基础输入价乘。
换成其他中转平台,可以用同一个超过 512 token 的请求在一分钟内连发两次来验证:第 2 次的 cache_read_input_tokens(或 cached_tokens)大于 0,说明缓存生效;两个字段都是 0 或者干脆没有,说明标记没被转发或者用量字段被改写了,这时账单上也看不到缓存的折扣。
提前预热缓存:官方用 max_tokens 0,经 LaoZhang 改用 1
在真正的流量到来之前先写好缓存,第一个用户请求就能直接命中。Anthropic 文档给的做法是发一个 max_tokens 为 0 的请求:API 只在断点处写入缓存,返回空的 content 和 stop_reason: "max_tokens",不计输出 token,只收一次写入费。
{
  "model": "claude-sonnet-5-5",
  "max_tokens": 0,
  "system": [
    {"type": "text", "text": "(几千 token 的固定说明或文档)", "cache_control": {"type": "ephemeral"}}
  ],
  "messages": [{"role": "user", "content": "warmup"}]
}
断点要放在和后续请求共用的块上(通常是 system 或工具定义),不能放在那条占位用的 warmup 消息上,所以这里要用显式断点,不能用自动缓存;thinking 和 effort 也要和后续请求一致,否则写下的条目真实流量读不到。官方的 max_tokens: 0 不能和 stream: true、thinking.type: "enabled"、结构化输出、强制 tool_choice 一起用,也不能放进批处理请求。
2026 年 10 月 30 日经 LaoZhang 发 max_tokens: 0,得到的是一个正常回复:stop_reason 为 end_turn,输出了 46 个 token,同时写入了 7,882 token 的缓存,看起来网关把 0 当成了"未设置"。改用以前常用的 max_tokens: 1 写法,只输出 1 个 token、写入 7,882,紧接着的正式请求读取 7,882,可以当预热用。
Claude 提示缓存的其他问题
Claude Code 会自动缓存吗?缓存时间多长?
会,Claude Code 自己管理缓存,不需要手动加 cache_control。按 Claude Code 的提示缓存文档(截至 2026 年 10 月 30 日),用 Claude 订阅且在套餐用量内时,主对话的缓存时间是 1 小时;用 API key、用量额度或云平台时是 5 分钟。缓存为什么会突然失效、一次对话为什么变贵,见 Claude Code 缓存未命中 token 成本:一次对话为什么突然变贵。
缓存命中会占用速率限制吗?
按 Anthropic 提示缓存文档的说法,缓存命中的 token 不计入速率限制,这也是官方列出的使用 1 小时缓存的理由之一。如果已经遇到 429,先分清是哪一项限制触发的,见 Claude API 提示速率限制已达到:先找限制归属再重试。
thinking 思考块能单独缓存吗?
不能直接在 thinking 块上打断点。按 Anthropic 文档,之前助手轮次里的 thinking 块会随其他内容一起被缓存,读取时按输入 token 计费;引用(citations)的子块也不能单独缓存,要缓存的是作为引用来源的整份文档;空的文本块同样不能缓存。
参考来源2
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月30日。
参考来源2
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月30日。