Gemini 上下文缓存(Context Caching):隐式/显式、价格与命中实测
Gemini 4 Argon 只有隐式缓存,3.8 Flash 等还能建显式缓存。2026 年 10 月 30 日实测:命中时有时无,一次只省输入费的 44%–78%。
文章目录
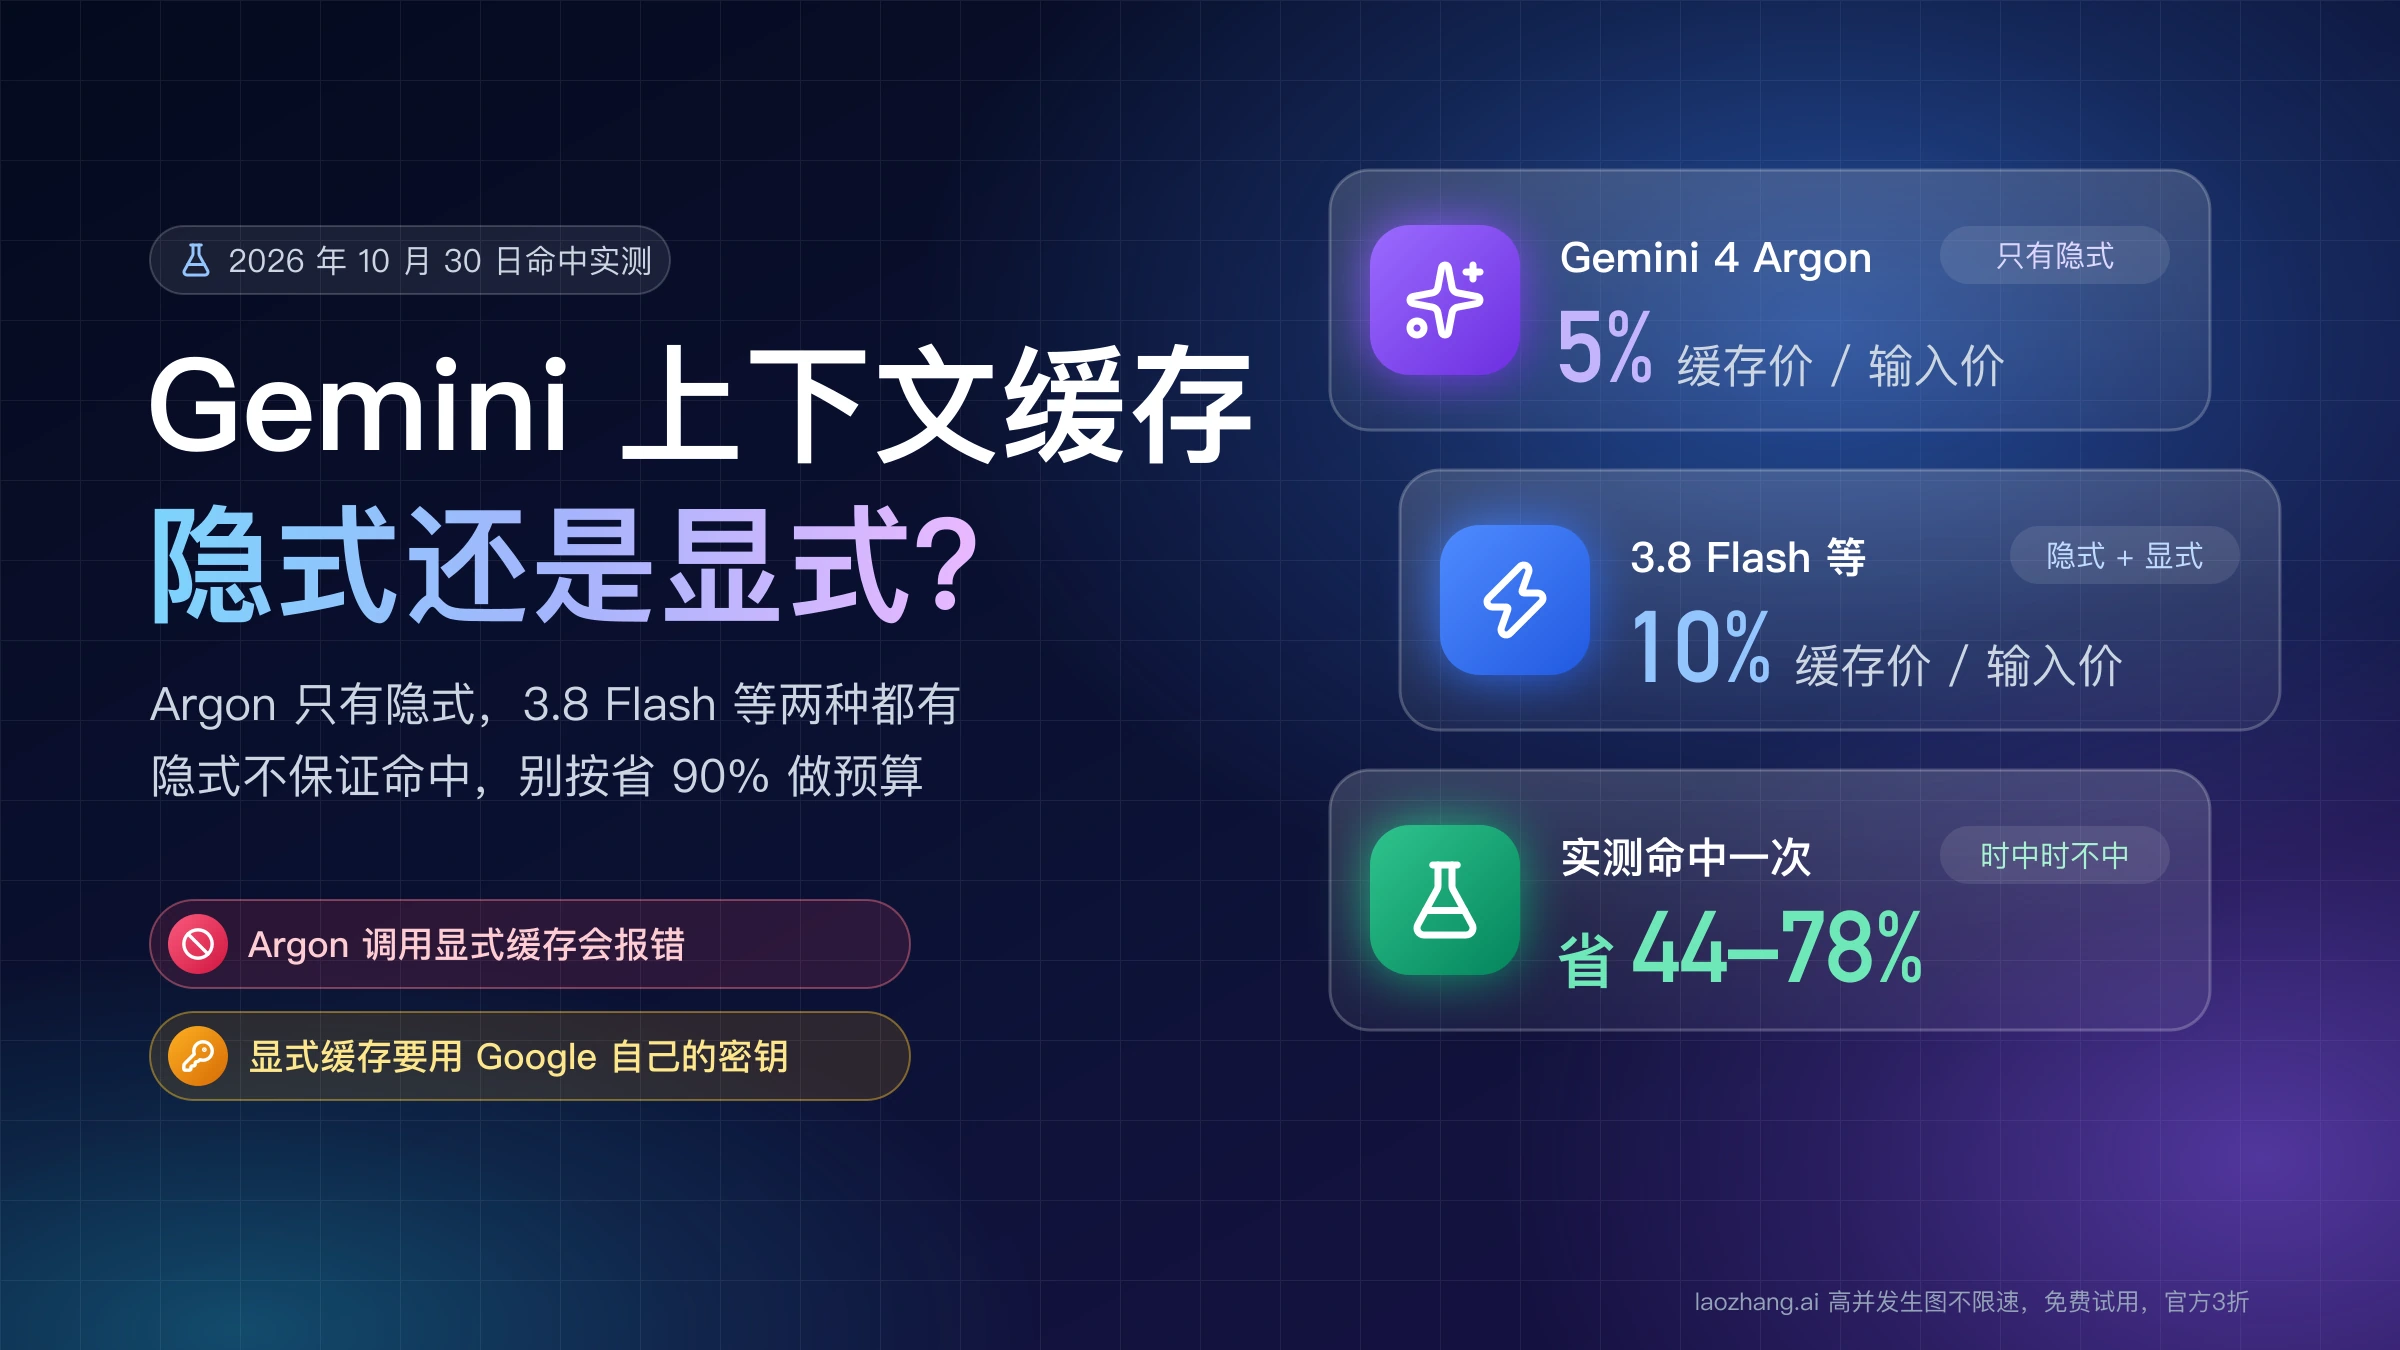
Gemini 上下文缓存(Context Caching)有两种。隐式缓存在 Gemini 2.5 及之后的模型上默认开启,不用写任何代码,不收存储费,但 Google 不保证命中;显式缓存要你先用 caches.create 把长文档或系统指令存成缓存对象,再在请求里用 cached_content 引用它,折扣有保证,代价是按小时收存储费。截至 2026 年 10 月 30 日,Gemini 4 Argon(gemini-4-argon)只有隐式缓存,调用显式缓存会报错;gemini-3.8-flash、gemini-3.6-flash、gemini-3.1-pro-preview、gemini-3.5-flash-lite 和 2.5 系列两种都能用,但显式缓存只能走 generateContent 接口,Google 推荐的 Interactions API 只支持隐式缓存。
所以先做两件事:把每次都一样的长内容(系统指令、文档、代码库)挪到提示最前面,再看返回的 usageMetadata 里有没有 cachedContentTokenCount,有就是命中了,没有这个键就是没命中。用 Argon 的,删掉代码里的 caches.create 和 cached_content;用 3.8 Flash 等模型、同一份长文档在一小时内会反复用到的,可以考虑显式缓存,但要用 Google 自己的 API Key 或 Google Cloud 项目,经 LaoZhang 网关调用时显式缓存接口返回 404。
别按"命中省 90%–95%"做预算。2026 年 10 月 30 日经 LaoZhang 实测,gemini-3.8-flash 的提示在 5,000 token 以下一次也没命中,5,605 token 以上大约每 3 次命中 1 次,命中时只有提示的 49%–70% 进了缓存,按 Google 标价折算只省下这次输入费的 44%–63%;gemini-4-argon 命中时进缓存的比例是 66%–82%,省 63%–78%。
你的模型有哪种缓存:Argon 只有隐式,3.8 Flash 等两种都有
能不能建显式缓存,先看模型,再看接口。Google 的 Gemini API 上下文缓存文档(generateContent 版)截至 2026 年 10 月 30 日写明:隐式缓存对 Gemini 2.5 及更新的模型自动开启;显式缓存可以在 Gemini 3 和 2.5 系列上手动启用,"Gemini 4 Argon 及之后的模型不支持"。显式缓存目前仍是 Beta,接口和 SDK 方法都在 v1beta 下。
| 模型 | 隐式缓存 | 显式缓存 | 免费层能否用缓存 |
|---|---|---|---|
Gemini 4 Argon(gemini-4-argon) | 有,默认开启 | 不支持,调用会报错 | Argon 没有免费层 |
Gemini 3.8 Flash(gemini-3.8-flash) | 有 | 有 | 免费 |
Gemini 3.6 Flash(gemini-3.6-flash) | 有 | 有 | 免费 |
Gemini 3.1 Pro Preview(gemini-3.1-pro-preview) | 有 | 有 | 该模型没有免费层 |
Gemini 3.5 Flash-Lite(gemini-3.5-flash-lite) | 有 | 有 | 免费层不提供缓存 |
| Gemini 2.5 Pro、2.5 Flash | 有 | 有 | 免费层不提供缓存 |
免费层一列来自 Gemini API 价格页(2026 年 10 月 28 日更新),各模型免费额度的完整情况见《Gemini API Key 免费额度与速率限制 2026:哪些还免费、去哪看限额》。
接口同样决定能不能用显式缓存。Google 现在推荐的 Interactions API 只支持隐式缓存,有状态(带 previous_interaction_id)和无状态两种对话方式都能命中,但不能创建或管理缓存对象;要在 3.8 Flash、3.1 Pro Preview 这类模型上用显式缓存,得改用 generateContent 接口(Interactions API 上下文缓存文档)。Google Cloud 那一侧的 Vertex AI 在文档里已改名为 Gemini Enterprise Agent Platform,同样有隐式和显式两种缓存,另外多一层 durable caching,后面单独说;AI Studio 密钥和 Cloud 项目该选哪个,见《Gemini API 和 Vertex AI API 怎么选:先看开发速度还是云上治理》。
Gemini 缓存价格:命中部分按输入价的 5% 或 10% 计
命中缓存的那部分 token 按"缓存价"计费:Gemini 4 Argon 是输入价的 5%,也就是这部分省 95%;3.8 Flash、3.6 Flash、3.1 Pro Preview、3.5 Flash-Lite 都是 10%,省 90%。没进缓存的 token 和输出 token 照原价算。显式缓存另收存储费,按缓存的 token 数和保存时长计;隐式缓存不收存储费。下表是 Gemini API 价格页截至 2026 年 10 月 30 日的标准档付费价格,单位是每 100 万 token 的美元价。
| 模型 | 输入 | 缓存价 | 显式缓存存储费(每小时) | 已公布的调价 |
|---|---|---|---|---|
| Gemini 4 Argon | $2.00 | $0.10 | 不支持显式缓存 | 2026 年 12 月 1 日起输入 $4.00、缓存价 $0.20 |
| Gemini 3.8 Flash、3.6 Flash | $0.75 | $0.075 | $0.50 | 2027 年 1 月 1 日起输入 $1.50、缓存价 $0.15、存储费 $1.00 |
| Gemini 3.1 Pro Preview(提示不超过 200k) | $2.00 | $0.20 | $4.50 | 无 |
| Gemini 3.5 Flash-Lite | $0.30 | $0.03 | $1.00 | 无 |
| Gemini 3.1 Flash-Lite(文本) | $0.25 | $0.025 | $1.00 | 无 |
两次调价都是所有价格一起翻倍,所以折扣比例不变,变的是每次命中省下的绝对金额:Argon 每 100 万缓存 token 现在省 $1.90,12 月 1 日起省 $3.80。显式缓存还有一笔容易漏算的钱:Google Cloud 上下文缓存概览写明,无论隐式还是显式,用来创建缓存的那批输入 token 按标准输入价计费,等于建缓存时先付一次全价。所有模型的输入输出价格、预付费和 Flash 涨价细节见《Gemini API Key 购买前先看:价格、免费额度与 2027 年 Flash 涨价》。
显式缓存什么时候划算:3.8 Flash 存 1 小时要用 2 次以上
显式缓存要付两笔钱:建缓存时那批输入按全价算一次,之后每存一小时付一份存储费;每引用一次,缓存里的每 100 万 token 省下"输入价减缓存价"。只存一小时就删的缓存,这一小时里的请求次数要达到(输入价 + 每小时存储费)÷(输入价 − 缓存价)才比不缓存便宜。以 3.8 Flash 和 3.6 Flash 为例,($0.75 + $0.50)÷($0.75 − $0.075)= 1.85,也就是这一小时里至少要用 2 次。
缓存长期保留、建缓存那一次的全价已经摊薄时,回本线只看存储费:每小时至少复用次数 = 每小时存储费 ÷(输入价 − 缓存价)。3.8 Flash 和 3.6 Flash 是 $0.50 ÷ $0.675 = 0.74 次,约每 81 分钟用一次就能抵掉存储费。2027 年 1 月 1 日三项价格一起翻倍,这两条回本线都不变。
Pro 和 Flash-Lite 的回本线高得多。按只存一小时算,3.1 Pro Preview 是($2.00 + $4.50)÷ $1.80 = 3.61,要 4 次以上;3.5 Flash-Lite 是($0.30 + $1.00)÷ $0.27 = 4.81,要 5 次以上;3.1 Flash-Lite 是($0.25 + $1.00)÷ $0.225 = 5.56,要 6 次以上。按长期保留算,三者分别是每小时 2.50、3.70、4.44 次,约每 24、16、14 分钟用一次。原因是 3.1 Pro Preview 的存储费是 Flash 的 9 倍,两个 Flash-Lite 的输入价本来就低,每次复用省下的钱少。如果你的长文档一小时只被问一两次,在这几个模型上开显式缓存大概率是亏的,留给隐式缓存更合适。
拿一份 10 万 token 的文档、3.8 Flash 2026 年的价格算一小时的输入费,差别更直观。显式缓存一列包含建缓存时的一次全价输入、每次请求按缓存价读取,以及 1 小时存储费;隐式缓存分两种情况:第一次之后每次都命中(最好情况),和每 4 次命中 1 次(比下文实测的命中率略低)。问题和回答本身的 token 不计入。
| 每小时请求次数 | 不用缓存 | 显式缓存 | 隐式缓存,第一次之后全部命中 | 隐式缓存,每 4 次命中 1 次 |
|---|---|---|---|---|
| 1 | $0.0750 | $0.1325 | $0.0750 | $0.0750 |
| 2 | $0.1500 | $0.1400 | $0.0825 | $0.1500 |
| 5 | $0.3750 | $0.1625 | $0.1050 | $0.3075 |
| 10 | $0.7500 | $0.2000 | $0.1425 | $0.6150 |
| 60 | $4.5000 | $0.5750 | $0.5175 | $3.5550 |
每小时只用 1 次时显式缓存最贵,因为存储费和建缓存的全价都白付了;2 次时已经略省;到 10 次,显式缓存把 $0.75 压到 $0.20。隐式缓存的最好情况比显式还便宜,可一旦命中率只有四分之一,60 次请求要付 $3.555,是显式缓存的 6 倍多。按实测大约每 3 次命中 1 次估算,每小时 3 次请求时隐式缓存约 $0.18,显式缓存 $0.1475,从这里开始显式缓存更便宜;命中率拿不准、复用又频繁时,显式缓存买的是确定性。Argon 没有这个选项,只能靠隐式缓存。
用 generateContent 建显式缓存:创建、引用、续期、删除
下面的 Python 示例用 google-genai SDK 走完显式缓存的四步:建缓存、在请求里引用、改 TTL、删除。写法依据 Gemini API 上下文缓存文档(generateContent 版)(2026 年 10 月 23 日更新),模型用 gemini-3.8-flash;换成 gemini-4-argon 会报错。API Key 从环境变量 GEMINI_API_KEY 读取,要用 Google 签发的密钥;经 LaoZhang 网关调用这几个接口会返回 404,原因见后文。
import os
from google import genai
from google.genai import types

client = genai.Client(api_key=os.environ["GEMINI_API_KEY"])
MODEL = "gemini-3.8-flash"  # gemini-4-argon 不支持显式缓存

with open("manual.txt", encoding="utf-8") as f:
    manual = f.read()  # 要反复引用的长文档,长度要超过模型的最低缓存长度

# 1. 建缓存:长文档和系统指令一起存进去,TTL 1 小时
cache = client.caches.create(
    model=MODEL,
    config=types.CreateCachedContentConfig(
        display_name="product-manual",
        system_instruction="你根据产品手册回答问题,手册里没有写的就直接说没有。",
        contents=[manual],
        ttl="3600s",
    ),
)
print(cache.name, cache.usage_metadata)

# 2. 引用缓存:之后每次只发新问题
resp = client.models.generate_content(
    model=MODEL,
    contents="退货期限是多少天?",
    config=types.GenerateContentConfig(cached_content=cache.name),
)
print(resp.text)
print(resp.usage_metadata.cached_content_token_count)

# 3. 续期:只能改 ttl 或 expire_time,内容不能改
client.caches.update(
    name=cache.name,
    config=types.UpdateCachedContentConfig(ttl="7200s"),
)

# 4. 用完就删,停止计存储费
client.caches.delete(name=cache.name)
有几处行为和直觉不同。缓存内容会被当作提示的前缀,所以请求里的 contents 只放新问题,模型不区分缓存 token 和普通输入 token。缓存建好后不能读回内容,caches.list() 和 caches.get() 只返回名称、模型、usage_metadata、创建时间和过期时间这些元数据。用 expire_time 指定过期时刻时,时间必须带时区,Python 里要用 datetime.now(timezone.utc),不能用不带时区的 datetime.utcnow()。用 OpenAI 官方库调用 Gemini 时,可以把 cached_content 放进 extra_body 来引用已有的显式缓存。
REST 接口对应 POST /v1beta/cachedContents 创建、PATCH 改 TTL、DELETE 删除,请求地址都在 generativelanguage.googleapis.com 下;在 generateContent 请求体里用 "cachedContent" 字段引用缓存名。
怎么确认命中:看 cachedContentTokenCount,没命中时这个键不存在
一次请求有没有命中、命中了多少,看返回里的用量字段。generateContent 的 REST 响应看 usageMetadata.cachedContentTokenCount,Python SDK 里是 usage_metadata.cached_content_token_count;Interactions API 看 usage.total_cached_tokens;经 OpenAI 兼容接口调用时看 usage.prompt_tokens_details.cached_tokens。下面是 2026 年 10 月 30 日经 LaoZhang 调用 gemini-3.8-flash 时一次命中的原始用量:
{
  "promptTokenCount": 11645,
  "cachedContentTokenCount": 8165,
  "candidatesTokenCount": 56,
  "totalTokenCount": 11701,
  "cacheTokensDetails": [{ "modality": "TEXT", "tokenCount": 8165 }]
}没命中时,usageMetadata 里根本没有 cachedContentTokenCount 这个键,不是返回 0,所以代码里要按"不存在"处理;Python SDK 读到的是 None。promptTokenCount 是整个提示的长度,已经包含命中的部分,按原价计费的 token 数要用两者相减。OpenAI 兼容接口也一样:命中时是 "prompt_tokens_details": {"cached_tokens": 8161},没命中时是空对象 {},prompt_tokens 始终是总数。
um = resp.usage_metadata
cached = um.cached_content_token_count or 0
print(f"提示 {um.prompt_token_count} token,命中 {cached},按原价 {um.prompt_token_count - cached}")
用这两个数就能算出一次命中实际省了多少。上面那次请求按 Google 标价:不命中时输入费是 11,645 × $0.75 / 100 万 = $0.008734;命中后是 3,480 个 token 按 $0.75、8,165 个按 $0.075,合计 $0.003222,省了 63%,不是 90%。省得比标称折扣少,是因为每次命中都有一段提示没进缓存;下一节实测表的最后一列,是同一天每种命中情况按这个方法算出的结果。
隐式缓存最低 4,096 还是 6,144 token:Google 文档说法不一
隐式缓存的最低长度,截至 2026 年 10 月 30 日,Google 几处文档给的数字不一样。ai.google.dev 的两版缓存文档都写 Argon、3.8 Flash、3.6 Flash、3.1 Pro Preview 是 4,096 token,2.5 Flash 和 2.5 Pro 是 2,048;Google Cloud 上下文缓存概览的限制表却写 3.1 Pro Preview、3.7 Flash、3.8 Flash 的隐式缓存是 6,144,其余 Gemini 3 和 Gemini 4 模型是 4,096。Cloud 的 Gemini 4 Argon 开发者指南三处写 Argon 的共享前缀要 6,144 token 以上,同站的 Argon 型号页又写 4,096。Google 没有说明哪个数字适用于哪种调用方式。
2026 年 10 月 30 日经 LaoZhang 的 Gemini 原生 generateContent 接口做了一组实测,可以对照这些数字。测试用两篇英文技术文章拼成的长文本作前缀,后面跟一个短问题,每隔 15–20 秒发一次,思考级别设为 low。多数批次把长文本放在 systemInstruction 里,约 11,645 token 那组另有 6 次放在第一条用户消息里;同一批里的请求逐字节相同,只有约 11,645 token 那组的前 3 次各换了一个不同的问题。所有成功返回的 modelVersion 都和请求的模型一致。
| 模型 | 提示长度(token) | 调用次数 | 命中次数 | 每次命中的缓存 token | 进缓存的比例 | 命中时输入费省下 |
|---|---|---|---|---|---|---|
| gemini-3.8-flash | 4,380 | 6 | 0 | — | — | — |
| gemini-3.8-flash | 4,971 | 8 | 0 | — | — | — |
| gemini-3.8-flash | 5,605 | 8 | 4 | 3,563 | 64% | 57% |
| gemini-3.8-flash | 6,143 | 8 | 4 | 4,070 | 66% | 60% |
| gemini-3.8-flash | 8,358 | 6 | 1 | 4,077 | 49% | 44% |
| gemini-3.8-flash | 约 11,645 | 15 | 3 | 8,165–8,168 | 70% | 63% |
| gemini-4-argon | 6,122 | 5 | 2 | 4,068 | 66% | 63% |
| gemini-4-argon | 11,576 | 5 | 1 | 9,522 | 82% | 78% |
读这张表要先知道一个条件:前缀开头的随机编号是每次运行测试脚本时生成一次,同一次运行里的几批请求共用开头文本。3.8 Flash 的约 11,645(systemInstruction)、6,143、5,605、4,971 token 这几批和 Argon 的 11,576 token 那批,都是各自那次运行的第一批,之前没有可复用的缓存;3.8 Flash 的 8,358 token 那批开头和 5,605 那批相同,Argon 的 6,122 token 那批就是 11,576 那批的前 6,122 token,这两批的命中可能来自前一批写下的缓存。
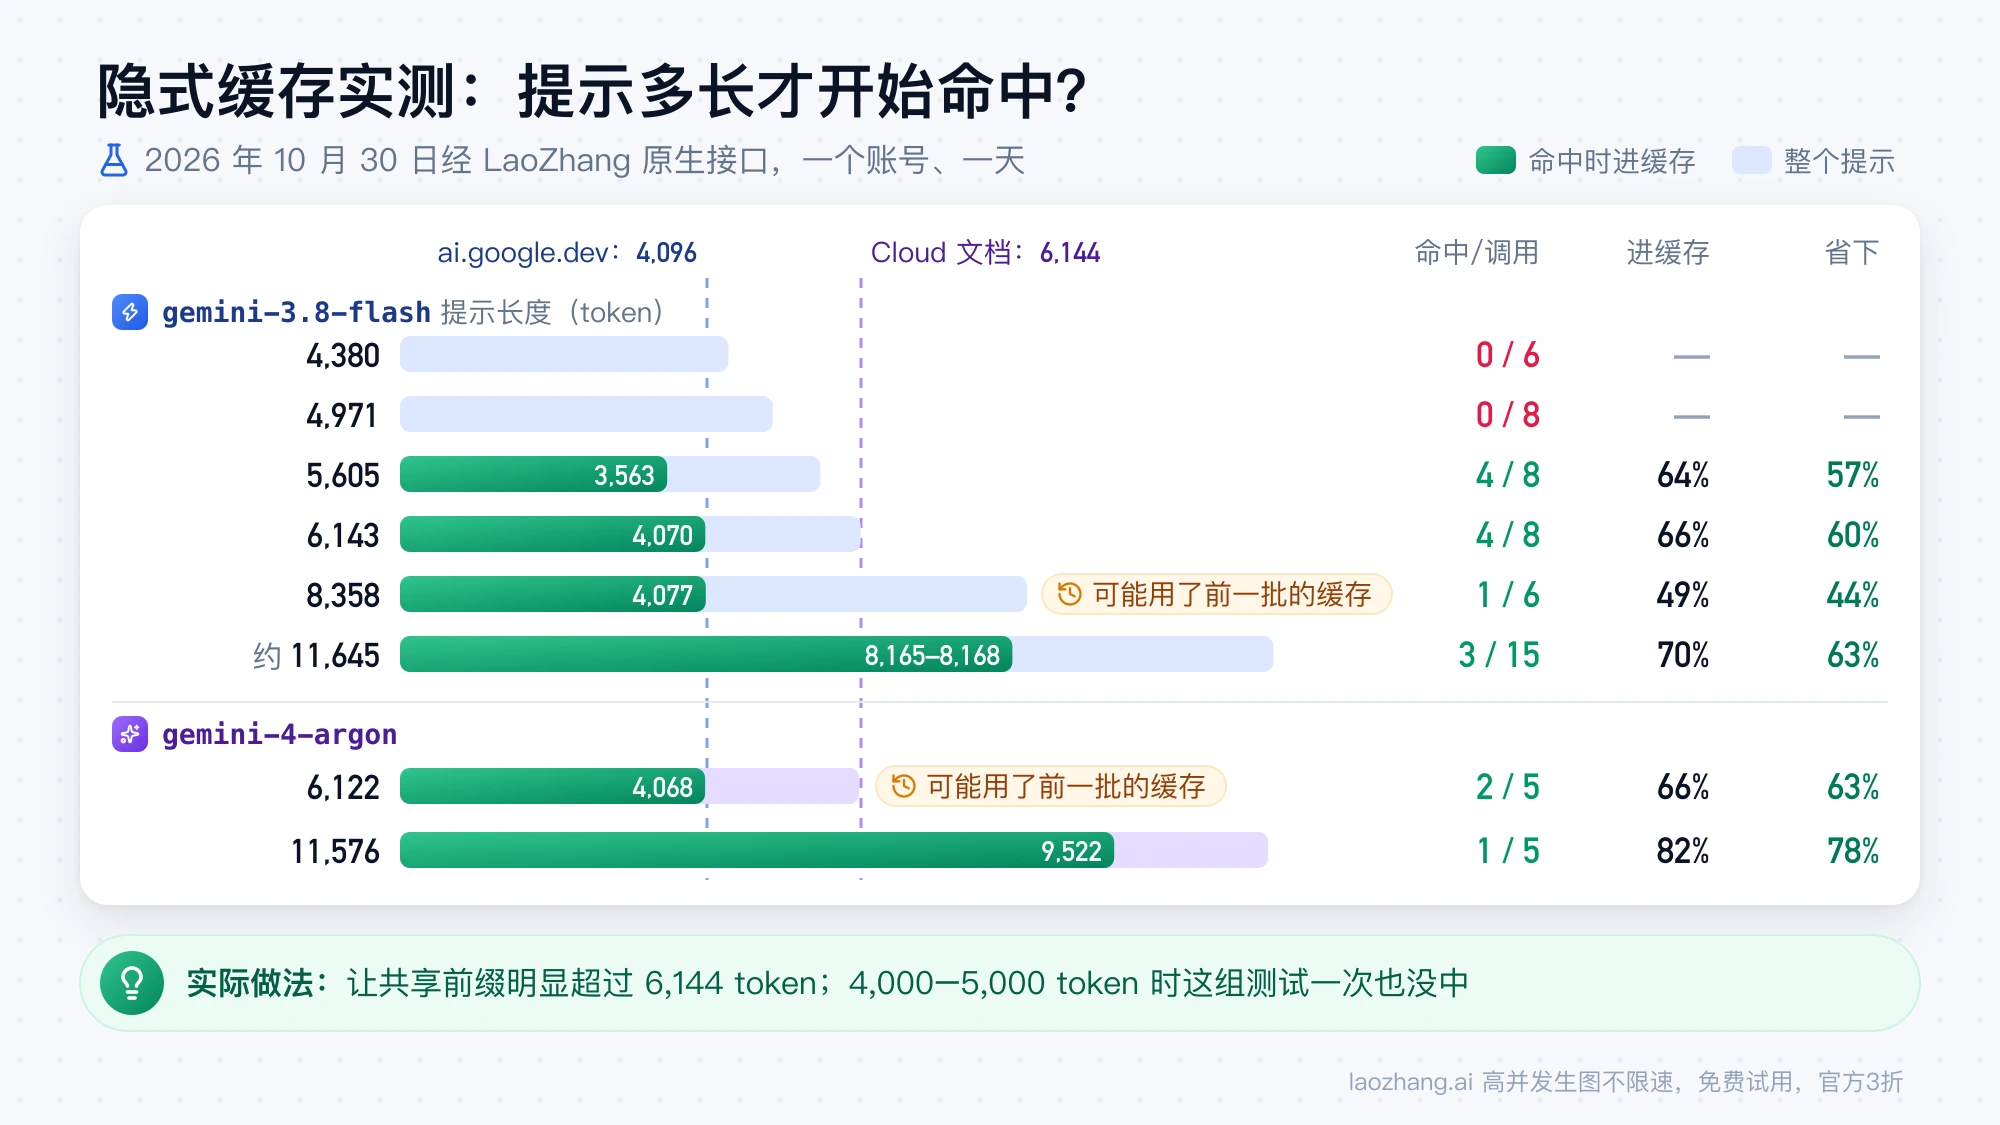
只看没有被预热的批次,3.8 Flash 在 4,380 和 4,971 token 时 14 次调用一次没中,虽然两者都超过 ai.google.dev 写的 4,096;5,605 和 6,143 token 两批都有命中,低于 Cloud 写的 6,144。Argon 6,122 token 的命中可能用的是 11,576 token 那批留下的缓存,说明不了 6,122 token 的提示自己能不能建起缓存,所以不能拿它对照 Argon 指南里的 6,144。这组数据只能说明在这个网关上、这一天,3.8 Flash 在 5,000 token 以下没有命中,不能拿来断定 Google 哪份文档是对的。实际做法是让共享前缀明显超过 6,144 token,两种说法就都满足了;前缀只有 4,000–5,000 token 时,这组测试里一次也没命中过。
这组结果的范围要说清楚:一个账号、一个中转网关、一天、一段前缀文本,全部约 60 次调用按 Google 标价折算约 $0.44。它不是直连 Google 的结果,命中率也可能受网关影响(见后文);命中和未命中的延迟差别在这组数据里看不出规律,所以不对延迟下结论。
隐式缓存不命中怎么办:按 6 个原因逐条排查
隐式缓存不命中,常见原因有六个,彼此独立,可以对照现象逐条排除。Google 给的提高命中率的建议只有两条:把大段公共内容放在提示开头,在短时间内发送前缀相同的请求(Gemini API 上下文缓存文档)。下表前三项都是这两条的具体化。
| 现象 | 可能的原因 | 怎么改 |
|---|---|---|
从来没有出现过 cachedContentTokenCount | 共享前缀不到最低长度,各处文档写 4,096 或 6,144 | 让每次都相同的部分超过 6,144 token |
| 提示很长,却一直不命中 | 开头有每次都变的内容,比如时间戳、请求 ID、用户名、随机示例顺序 | 动态内容挪到最后,前缀逐字节保持一致 |
| 隔一阵才发一次就不中 | 两次请求间隔太长,前缀已被清出缓存 | 集中发送;Cloud 的 Argon 指南把连续请求的窗口写作 15–20 分钟 |
| 同样的请求时中时不中 | 隐式缓存不保证命中 | 按"可能命中"估成本,需要确定折扣就换显式缓存 |
| 命中了,但只覆盖提示的一部分 | 每次命中都有约 2,000 token 以上留在缓存外 | 拉长共享前缀,让留在外面的这段占比变小 |
| 经中转平台调用,命中率偏低 | 缓存按 Google Cloud 项目隔离,网关可能把请求分到多个上游项目 | 需要稳定命中时改用自己的 Google 项目 |
同样的请求时中时不中,是最容易误判的一项。2026 年 10 月 30 日的测试里,6,143 token 那一批 8 个完全相同的请求,结果依次是未中、未中、中、未中、未中、中、中、中,并不是"第一次没中、之后一直命中";3.8 Flash 在 5,605 token 以上一共 40 次调用(含 OpenAI 兼容接口的 3 次,其中 34 次逐字节相同、6 次只换了最后的问题)命中 13 次,Argon 10 次命中 3 次。把长文本放在 systemInstruction 里(6 次中 2 次)还是放在第一条用户消息里(6 次中 1 次),在 11,645 token 时没有看出明显差别。
命中只覆盖一部分,决定了实际能省多少。每次命中,没进缓存的部分在 2,042 到 4,281 token 之间,而每次变化的问题本身不到 100 个 token,也就是说问题前面还有一大段公共内容同样按原价计费。Google 没有公开单次请求里缓存覆盖到哪里为止;能做的是把共享前缀拉长,Argon 在 11,576 token 时进缓存的比例就到了 82%。
在 n8n 这类工作流工具里用 Gemini 的,有用户在 Reddit 的 r/n8n 版块反映始终看不到命中,怀疑是 AI Agent 节点在提示开头插入了动态指令;这属于开头有动态内容的情况,要先看工具实际发出的请求体。
经中转平台或 OpenAI 兼容接口:隐式能命中,显式接口 404
经中转平台调用 Gemini 时,隐式缓存可以命中,显式缓存不一定能用。2026 年 10 月 30 日经 LaoZhang 测得:Gemini 原生 generateContent 接口和 OpenAI 兼容的 /v1/chat/completions 接口都出现过命中,后者的命中记在 prompt_tokens_details.cached_tokens 里(3 次调用命中 1 次,8,161 token,它的前约 6,143 token 和前一批原生接口请求相同,缓存可能是那一批写下的);但 POST /v1beta/cachedContents 创建缓存、GET /v1beta/cachedContents 列出缓存,对 3.8 Flash 和 Argon 都返回 HTTP 404 Invalid URL,错误格式是网关自己的,请求没有到达 Google。所以经这个网关只能依靠隐式缓存,要用显式缓存得换成 Google 的 API Key 或 Google Cloud 项目。
计费上也有一处要自己留意。截至 2026 年 10 月 30 日,LaoZhang 的模型价格表给 gemini-3.8-flash 列了缓存读取价 $0.075 / 100 万 token,和 Google 标价相同,gemini-4-argon 只列了输入 $2、输出 $10,没有列缓存读取价,Argon 的命中在这个平台上是否按折扣价计费,从公开文档和测试数据都判断不出来。用 Argon 且依赖缓存省钱的,可以拿账单和返回里的 cachedContentTokenCount 对一下。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
命中率可能比直连低,这一点只是推断。Google Cloud 上下文缓存概览写明,缓存数据按项目编号隔离,从不跨项目共享;中转网关如果把请求分发到多个上游项目或密钥,同一个前缀落到不同项目就不会互相命中。上面测到的"时中时不中"里,有多少来自网关、多少来自 Google 本身的"不保证命中",这组数据分不开。
缓存能存多久(TTL):显式默认 1 小时,隐式最长 24 小时
显式缓存的保存时长由你设置。不设 ttl 时默认 1 小时;ai.google.dev 的文档写 TTL"没有上下限",Google Cloud 的限制表写最短 1 分钟、没有最长限制。到期前可以随时用 caches.update 改 ttl 或 expire_time 续期,存储费按实际保存的时长计算,所以用完就删比等它过期省钱。
隐式缓存的时长你控制不了。Google Cloud 文档写,隐式缓存的前缀最晚在创建后 24 小时过期,多数会更早被清出;Cloud 的 Argon 指南把连续请求能拿到 95% 折扣的窗口写作 15–20 分钟。ai.google.dev 没有给具体时长,只说要"在短时间内"发送前缀相同的请求。实测里即使间隔只有 15–20 秒,命中也时有时无,所以不要把 24 小时当作可以依赖的保存时间。
durable caching 持久缓存:只在 Google Cloud 的隐式缓存里
durable caching(持久缓存)是 Google Cloud Gemini Enterprise Agent Platform 隐式缓存的第二层存储,截至 2026 年 10 月 30 日只出现在 Cloud 文档里,ai.google.dev 的 Gemini API 文档没有这项功能。按 Google Cloud 上下文缓存概览,隐式缓存的前缀先放在内存里,内存容量有限,被清出时会转进持久存储而不是直接丢弃,之后的请求复用这个前缀仍能命中,适合隔较长时间才复用同一段上下文的工作负载。两层都默认开启,前缀最晚 24 小时后过期,同样不收存储费。支持 durable caching 的模型是 Gemini 4 Argon、4 Argon Cyber Permissive、3.8 Flash 和 3.8 Flash Cyber。
在意数据留存的,要看 Cloud 的零数据保留说明。持久缓存保存的是派生出的缓存数据(键值表示),按项目隔离,使用 Google 默认加密,不支持 CMEK,最晚 24 小时删除,使用区域或多区域端点时留在所选区域,不用于训练。可以按项目只关掉持久缓存、保留内存缓存,也可以把隐式缓存整个关掉;开启状态下响应里会显示 "retentionType": "DURABLE",整个组织统一关闭要联系客户团队。还有一点:显式缓存会和隐式缓存相互作用,创建显式缓存时可能额外缓存指定内容以外的数据,要完全避免缓存留存,得关掉隐式缓存并且不建显式缓存。
迁到 Gemini 4 Argon:删掉显式缓存,固定内容放最前面
从 3.x 迁到 Argon,原来的显式缓存代码不能留。Google 的 Gemini 4 Argon 新特性页写明,cachedContents / caches.create 在 Argon 上不支持,"会返回错误",要删除创建缓存和传入 cached_content 的调用;Argon 的隐式缓存默认开启,命中部分打 95% 折扣,缓存价 $0.10 / 100 万 token,2026 年 12 月 1 日起是 $0.20。迁移时把原来放进显式缓存的系统指令和文档原样放到每次请求的最前面,再用前面的字段检查确认命中。
多轮对话和智能体循环在 Argon 上还有一条规则:新请求比上一次请求至少多出 2,050 token,Gemini 才会把上一次请求整个缓存下来,模型输出、思考内容和函数返回结果都算在内;增加得更少时,上一次请求的最后 2,050 token 按标准输入价重新处理。Google 说大多数智能体轮次都超过这个量。这条规则来自 Gemini API 缓存文档,上面的单轮测试没有覆盖到它。
第三方数据也显示两个模型的命中率差别很大:Artificial Analysis 在 2026 年 10 月 27–28 日发布的 Intelligence Index v5.0 测试里,Gemini 4 Argon 的 75.5 亿输入 token 有 92% 命中缓存,3.8 Flash 的 101.6 亿只有 34%,这是该测试里 Argon 单任务成本反而低于 Flash 的原因之一。这是一套基准测试的工作负载,不能当作通用命中率。两个模型该怎么选,见《Gemini 4 Argon 和 3.8 Flash 区别:实测成本差多少,哪些任务该换》;迁移时另一个常见报错见《Gemini 400 报错 Requests ending with a model turn 怎么解决》。
Gemini 上下文缓存的其他问题
Gemini 的上下文缓存和 Claude 的提示缓存有什么不同?
最大的区别在开启方式:Claude 要在请求里用 cache_control 标出缓存位置(多轮对话也可用自动缓存),写入缓存按输入价加价计费;Gemini 的隐式缓存不需要任何标记,建缓存的输入按标准价计。Claude 各模型的缓存价格和命中实测见《Claude Prompt Caching 提示缓存怎么用:各模型价格与命中实测》。
缓存 token 算不算进 Gemini API 的速率限制?
算。Gemini API 文档写明,上下文缓存没有单独的速率或用量限制,适用 generateContent 的标准限额,而且 token 限额包含缓存 token。所以缓存能省钱,但不能帮你绕开每分钟 token 数的上限。限额怎么按项目计算、429 对应哪种限额,见《Gemini API 速率限制 2026:按项目计算,429 对应哪种限额、怎么提额》。
Batch 批量请求里的缓存怎么计价?
截至 2026 年 10 月 30 日的 Gemini API 价格页,Batch 档的缓存价是标准档的一半:Gemini 4 Argon 的 Batch 缓存价 $0.05 / 100 万 token(12 月 1 日起 $0.10),仍然只有隐式缓存;3.8 Flash 的 Batch 缓存价 $0.0375,显式缓存存储费和标准档一样是每小时 $0.50 / 100 万 token。
参考来源7
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月31日。
参考来源7
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月31日。
- 1.Gemini API 上下文缓存文档(generateContent 版)ai.google.dev/gemini-api/docs/generate-content/caching
- 2.Gemini API 价格页ai.google.dev/gemini-api/docs/pricing
- 3.Interactions API 上下文缓存文档ai.google.dev/gemini-api/docs/caching
- 4.Google Cloud 上下文缓存概览docs.cloud.google.com/gemini-enterprise-agent-platform/models/context-cache/context-cache-overview
- 5.Gemini 4 Argon 开发者指南docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-argon
- 6.零数据保留说明docs.cloud.google.com/gemini-enterprise-agent-platform/resources/zero-data-retention
- 7.Gemini 4 Argon 新特性页ai.google.dev/gemini-api/docs/generate-content/latest-model