Gemini 4 Carbon vs Opus 5.5 怎么选:编程代理仍是 Opus 领先
截至 2026 年 10 月 29 日,Carbon 领先推理、科研和事实问答,Opus 5.5 仍领先编程代理和文档工作;标准价每 token 相同,Carbon 还调不了。
文章目录
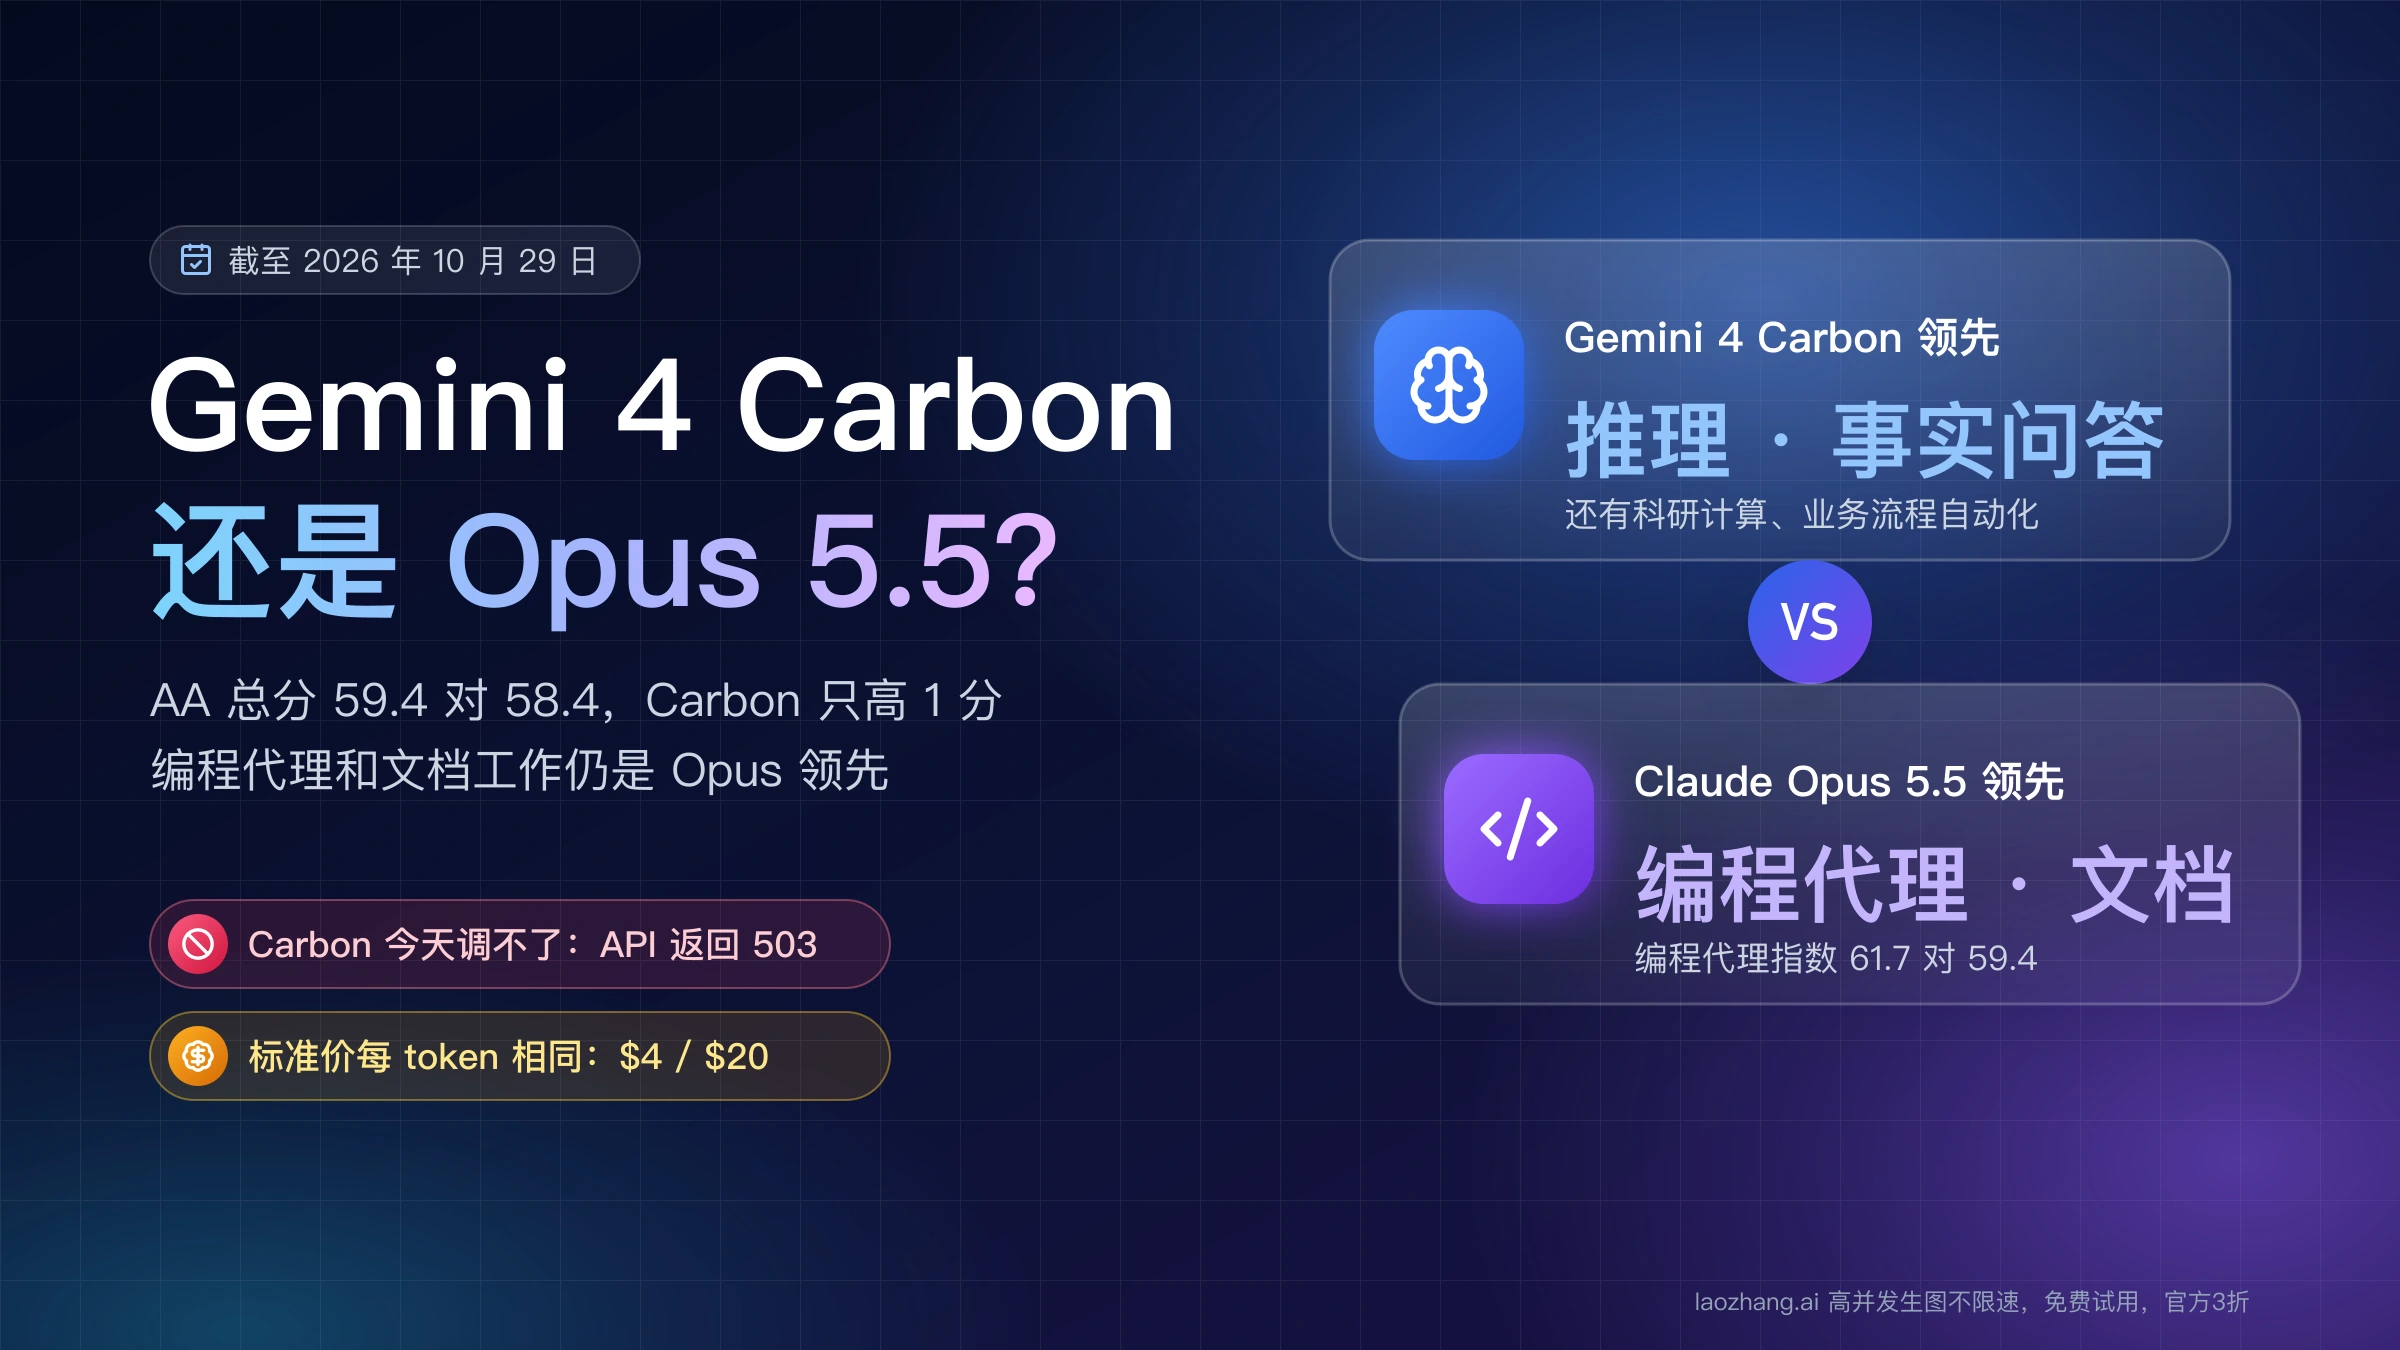
Gemini 4 Carbon 没有“全面超越” Claude Opus 5.5。截至 2026 年 10 月 29 日,在 Artificial Analysis(下称 AA)的智能指数 v5.0 里,Carbon(high)总分 59.4,比 Opus 5.5(max)的 58.4 高 1 分,领先的是高难推理、科研、事实问答和业务自动化;但 AA 编程代理指数里,Claude Code 配 Opus 5.5 是 61.7,Antigravity CLI 配 Carbon 是 59.4,文档、汇报这类知识工作的 AA-Briefcase 也是 Opus 领先,Google 自己的对比表里 Opus 还赢了电脑操作。
所以今天的做法很简单:继续用 Opus 5.5(API 模型 ID claude-opus-5-5),尤其是写代码、跑 Claude Code 和做文档类工作的人。Carbon 目前只开放给 Google Fairwind 计划里的一部分网络安全防御方,2026 年 10 月 29 日用 gemini-4-carbon 发起的 API 请求返回 HTTP 503,同一个 key 调 Opus 5.5 一切正常。你的工作主要是推理、科研或要求少出错的事实问答,就先把对照任务准备好,等 Carbon 开放第一天两边实测。
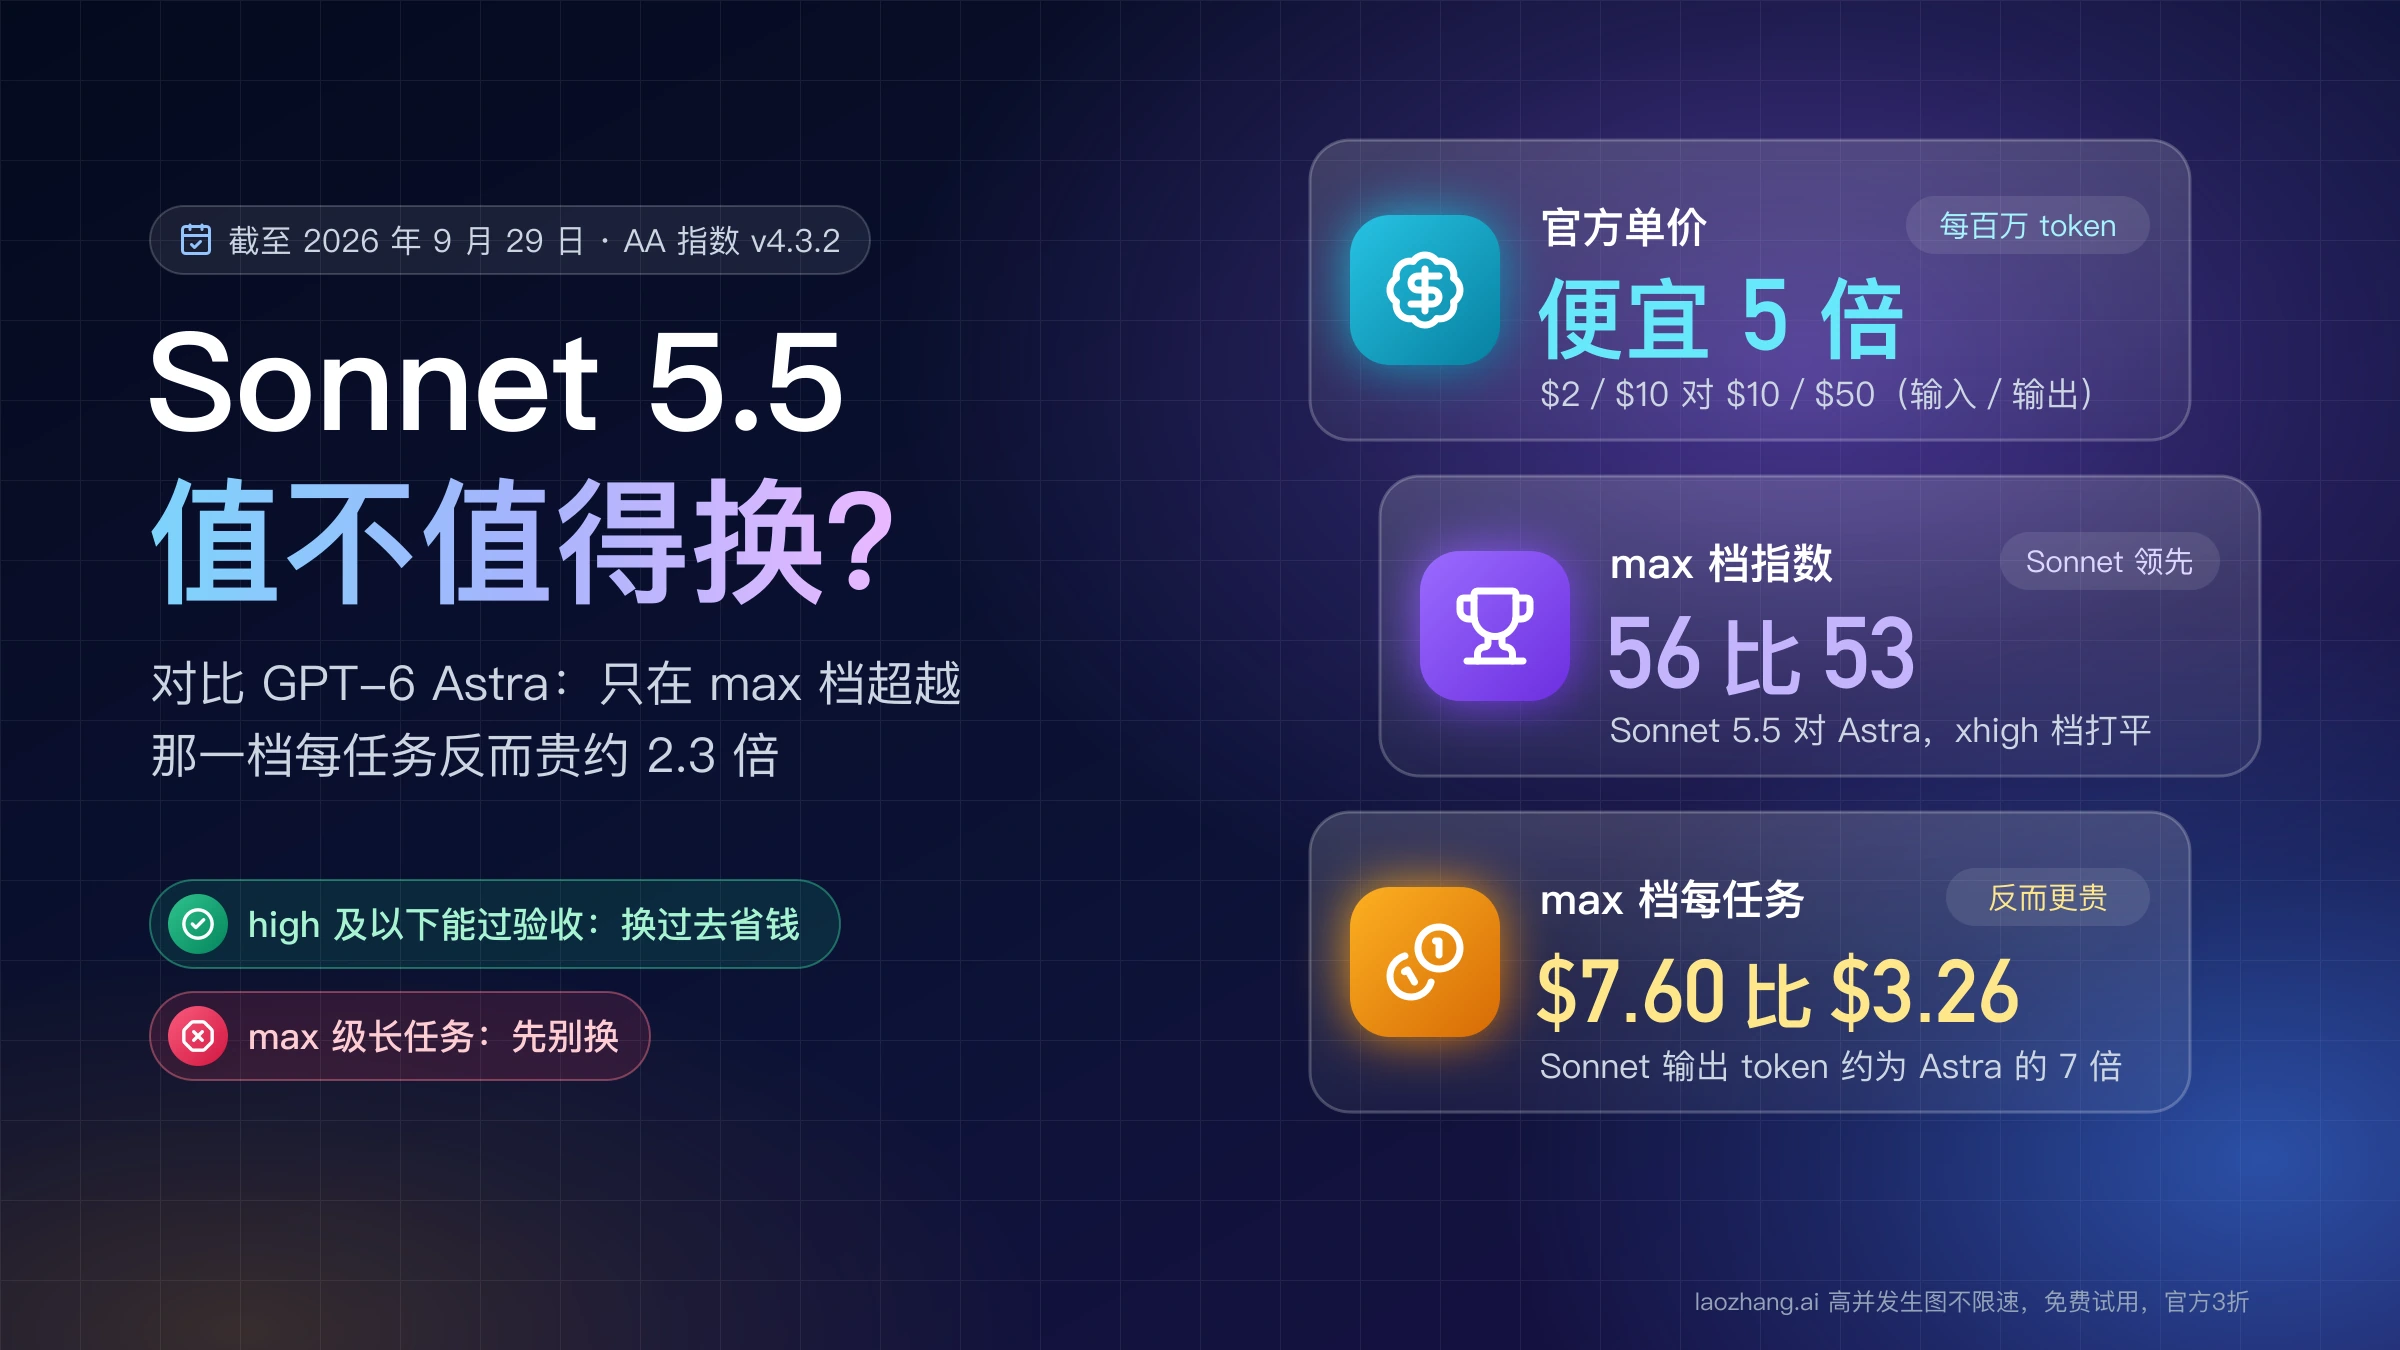
价格上,两者标准价每 token 完全相同,Carbon 只在首发期打五折,结束日期没有公布。AA 说的“每任务便宜 23%”是拿 Carbon 去比最贵的 Opus max 档;换成只低 1.4 分的 Opus xhigh,按标准价反而是 Opus 便宜。中文用户还要多算一笔:同一段中文,Opus 计出的 token 比 Gemini 多 46%。
哪类工作谁领先:Carbon 赢推理和事实问答,Opus 赢编程代理和文档
按工作类型拆开看,Carbon 领先的是高难推理、科研计算、事实问答和业务流程自动化,Opus 5.5 领先的是编程代理、代码生成、文档汇报类知识工作和电脑操作。下表除标注 Google 自测的行外,都来自截至 2026 年 10 月 29 日的 Artificial Analysis Gemini 4 Carbon 模型页与 AA 编程代理指数,Carbon 只测了 high 档,Opus 列的是 max 档,括号里是 Opus 其他推理档位的分数。
| 工作类型 | 看哪项测试 | Carbon(high) | Opus 5.5(max) | 谁领先 |
|---|---|---|---|---|
| 编程代理 | AA 编程代理指数(Antigravity CLI 对 Claude Code) | 59.4 | 61.7 | Opus |
| 写代码(模型本身) | FrontierCode 2.0 | 40.6% | 46.4%(xhigh 43.8%) | Opus |
| 终端操作任务 | Terminal-Bench 4.0(AA 模型测试) | 65.2% | 59.6% | Carbon |
| 文档、汇报类知识工作 | AA-Briefcase(Elo) | 1609 | 1800(high 1681) | Opus,high 档也领先 |
| PDF 文档任务 | GDP.pdf | 28.4% | 26.2%(high 28.8%) | 基本持平 |
| 高难推理 | HLE-Diamond | 69.1% | 67.9% | Carbon,小幅 |
| 科研计算 | Terminal-Bench-Science / CritPt v2 | 64.8% / 63% | 59.0% / 61% | Carbon |
| 事实问答 | AA-Omniscience 指数 / 幻觉率 | 53.5 / 11.4% | 48.1 / 50.3% | Carbon |
| 业务流程自动化 | AutomationBench-AA | 77.8% | 69.5% | Carbon |
| 电脑操作 | OSWorld-2.1 离线子集(Google 自测) | 81.5 | 87.2 | Opus |
| 网络安全 | SEC-bench Pro、ExploitGym、CWE-bench(Google 自测) | 88.2%、54.8%、71.0% | 无公开对照数字 | 无法直接比 |
最值得注意的是两头。事实问答上差距最大:AA-Omniscience 答对加分、答错扣分、拒答不扣分,Carbon 的幻觉率 11.4%,Opus max 是 50.3%,需要模型“不知道就别编”的场景,Carbon 优势明显。文档汇报类工作则反过来,AA-Briefcase 是 AA 自建的代理式知识工作测试,综合了评分细则通过率、分析质量和呈现效果,Opus 从 high 档到 max 档都在 Carbon 之上,AA 也写明 Carbon 在这项上还排在 Grok 4.7、Muse Wonder 和 Kimi K3.1 Pro 之后。
总分只差 1 分,单项上不少也只差 1–2 个百分点(HLE-Diamond、CritPt、GDP.pdf),这类差距不足以决定换不换。AA 的行业能力分项也一样接近:财务 62.6 对 59.4、法律 62.0 对 58.0 是 Carbon 高,工程 64.7 对 64.6 持平,战略运营 60.9 对 61.4、经济 61.0 对 62.3 是 Opus 略高。
写代码和 Claude Code 选哪个:编程代理榜 Opus 61.7,Carbon 59.4
写代码,尤其是已经在用 Claude Code 的,继续用 Opus 5.5。AA 编程代理指数把每个模型放进自家厂商的代理里测:Claude Code 配 Opus 5.5(max)比 Antigravity CLI 配 Carbon(high)高 2.3 分;AA 自己的评价是 Carbon “仅次于 Opus 5.5”,并说 Google 过去在这一块一直落后,这次进步很明显。
拆开三个分项,Opus 赢在写代码本身,终端任务两边打平。FrontierCode v1.1 是 Opus 56.0%、Carbon 50.9%;SWE-Atlas QnA 是 65.9% 对 63.7%;Terminal-Bench 4.0 在代理测试里是 Opus 63.1%、Carbon 63.6%。Carbon 的长处是快和省:每个任务平均 30 分钟、$7.74,Opus 是 61 分钟、$11.42,输出 token 分别是 10.9 万和 27.9 万(AA 按标准价计费)。
这个榜测的是“代理加模型”的组合,不是模型本身。Carbon 只在 Antigravity CLI 里测过,所以它的 59.4 不能直接换算成“在 Claude Code、Cursor 或你自己写的代理里调用 Carbon 能拿多少分”;同样,Opus 的 61.7 也带着 Claude Code 的功劳。只看模型本身的代码题,上一节表里的 FrontierCode 2.0 仍是 Opus 领先 5.8 个百分点。Google 发布文里说内部团队见过 Carbon 连续跑好几天去修大型代码库里的隐蔽 bug,这是厂商自述,没有和 Opus 的对照。
Carbon 更便宜吗:标准价和 Opus 相同,首发价才减半
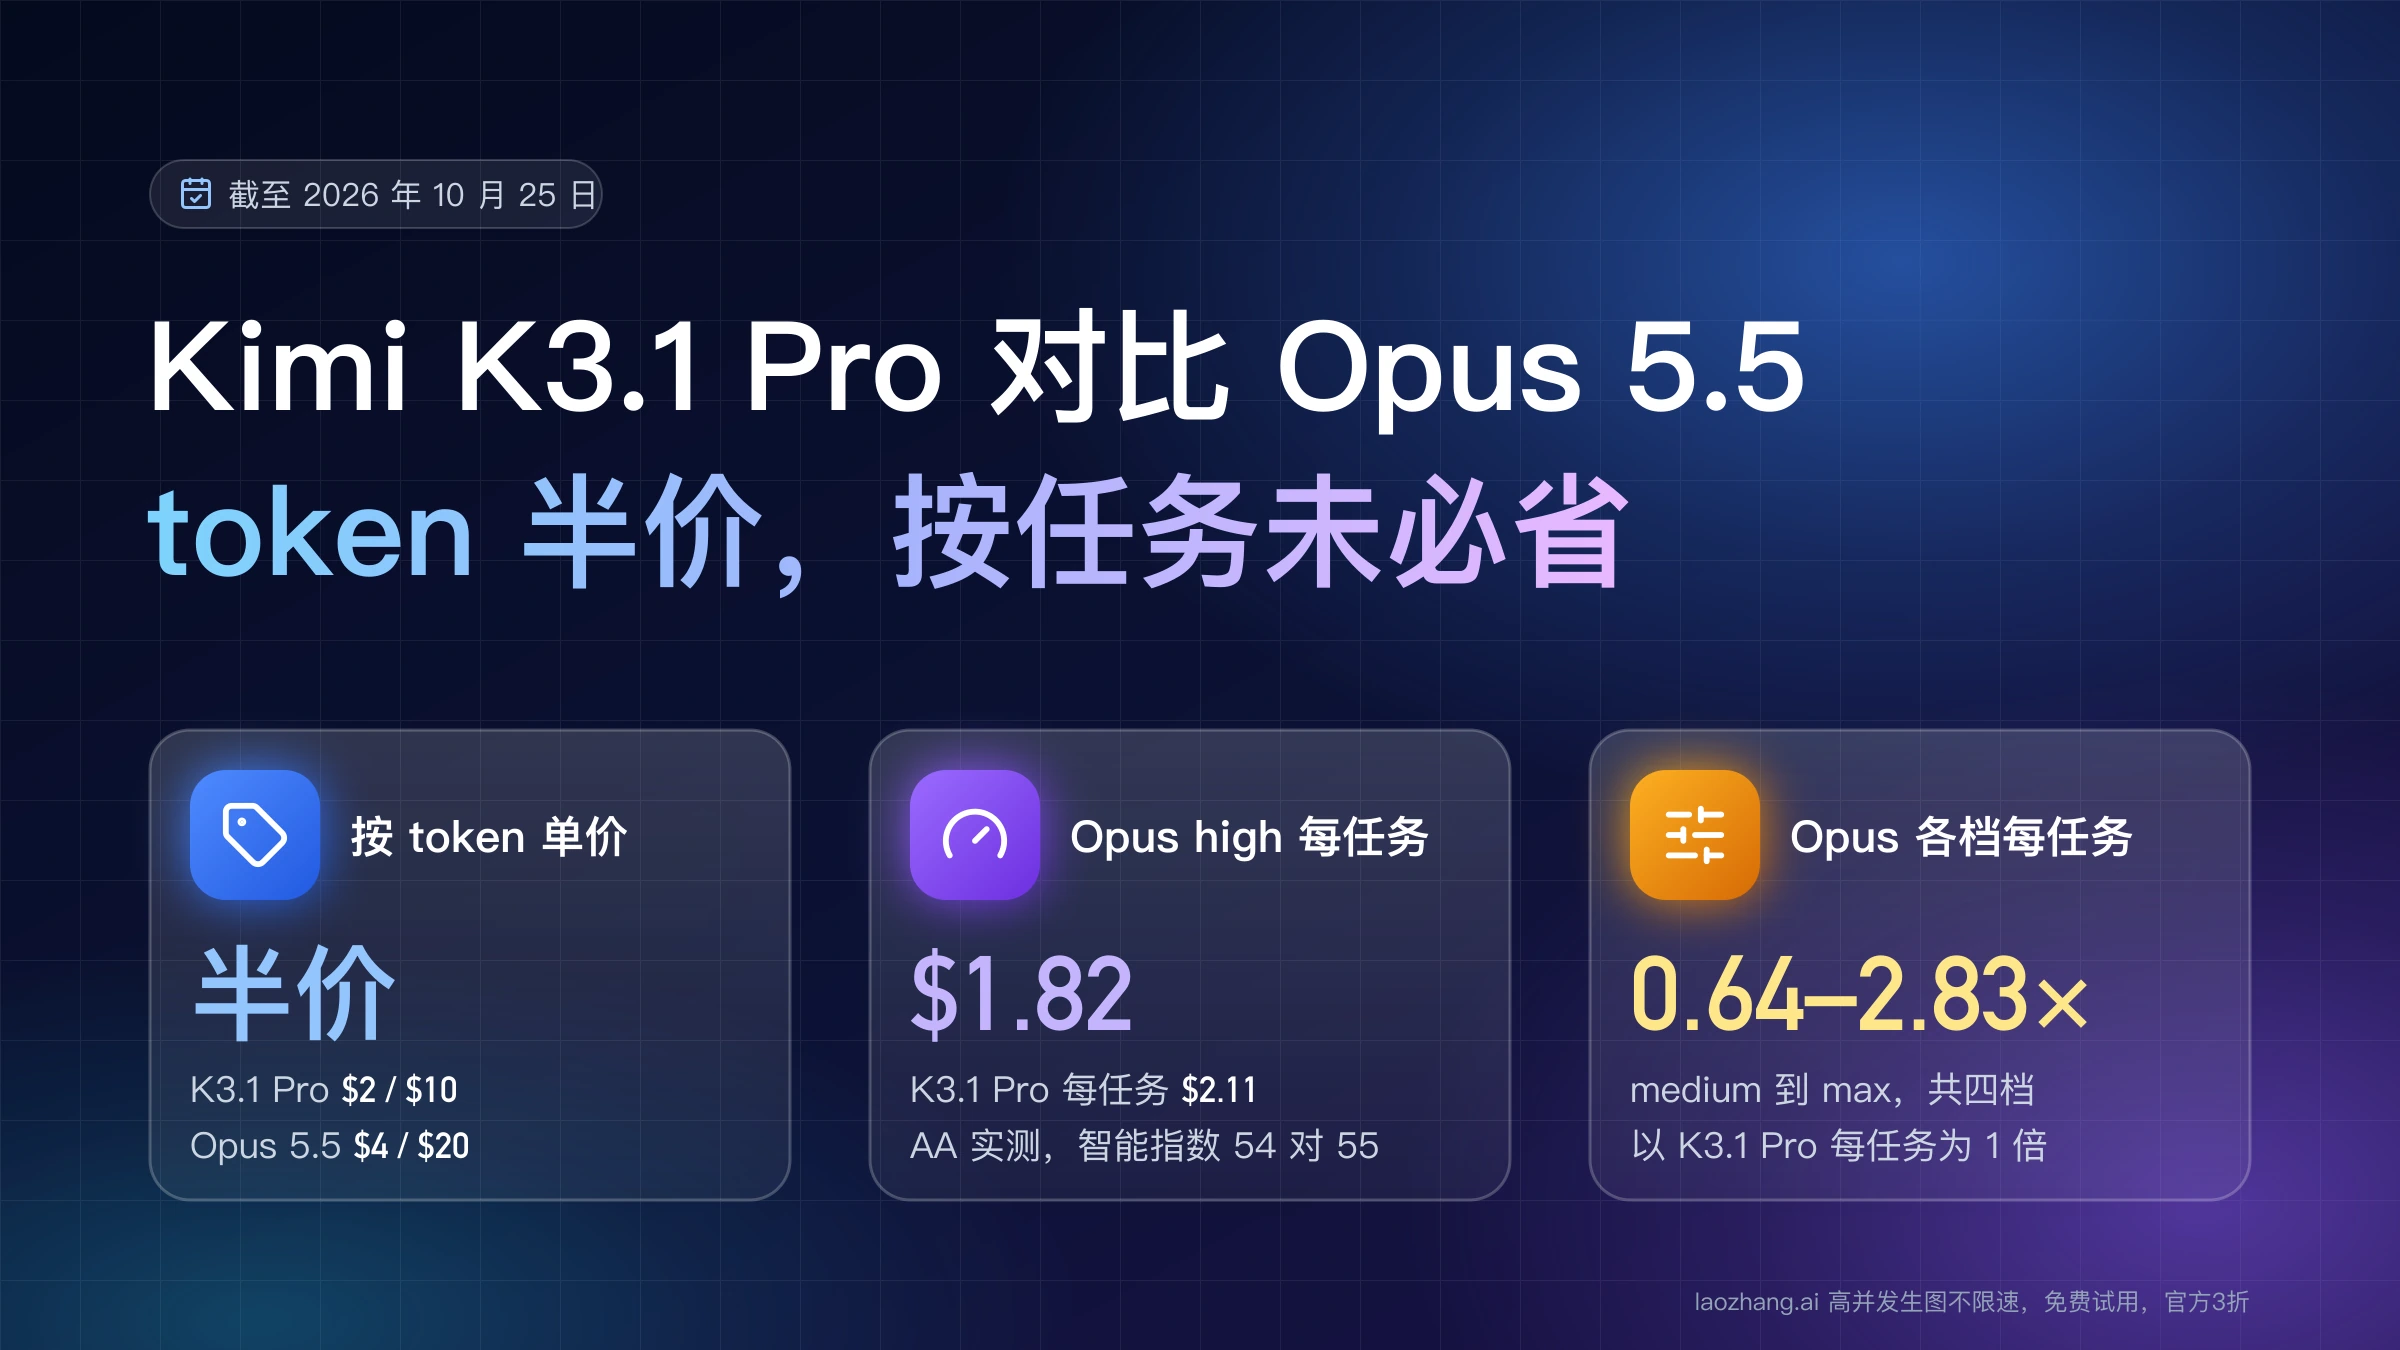
只看每 token 标价,Carbon 标准价和 Opus 5.5 一模一样,便宜只发生在首发期,而且要看你拿它和 Opus 的哪个推理档位比。Carbon 的价格来自 Google 的 Gemini 4 Carbon 发布文,Opus 的价格来自 Claude API 定价页,单位是美元 / 每 100 万 token。
| 计费项 | Carbon 首发价 | Carbon 标准价 | Opus 5.5 |
|---|---|---|---|
| 输入 | $2 | $4 | $4 |
| 输出 | $10 | $20 | $20 |
| 缓存读取 | $0.10 | $0.20 | $0.20 |
| 缓存写入 | 未公布 | 未公布 | $5(5 分钟)/ $8(1 小时) |
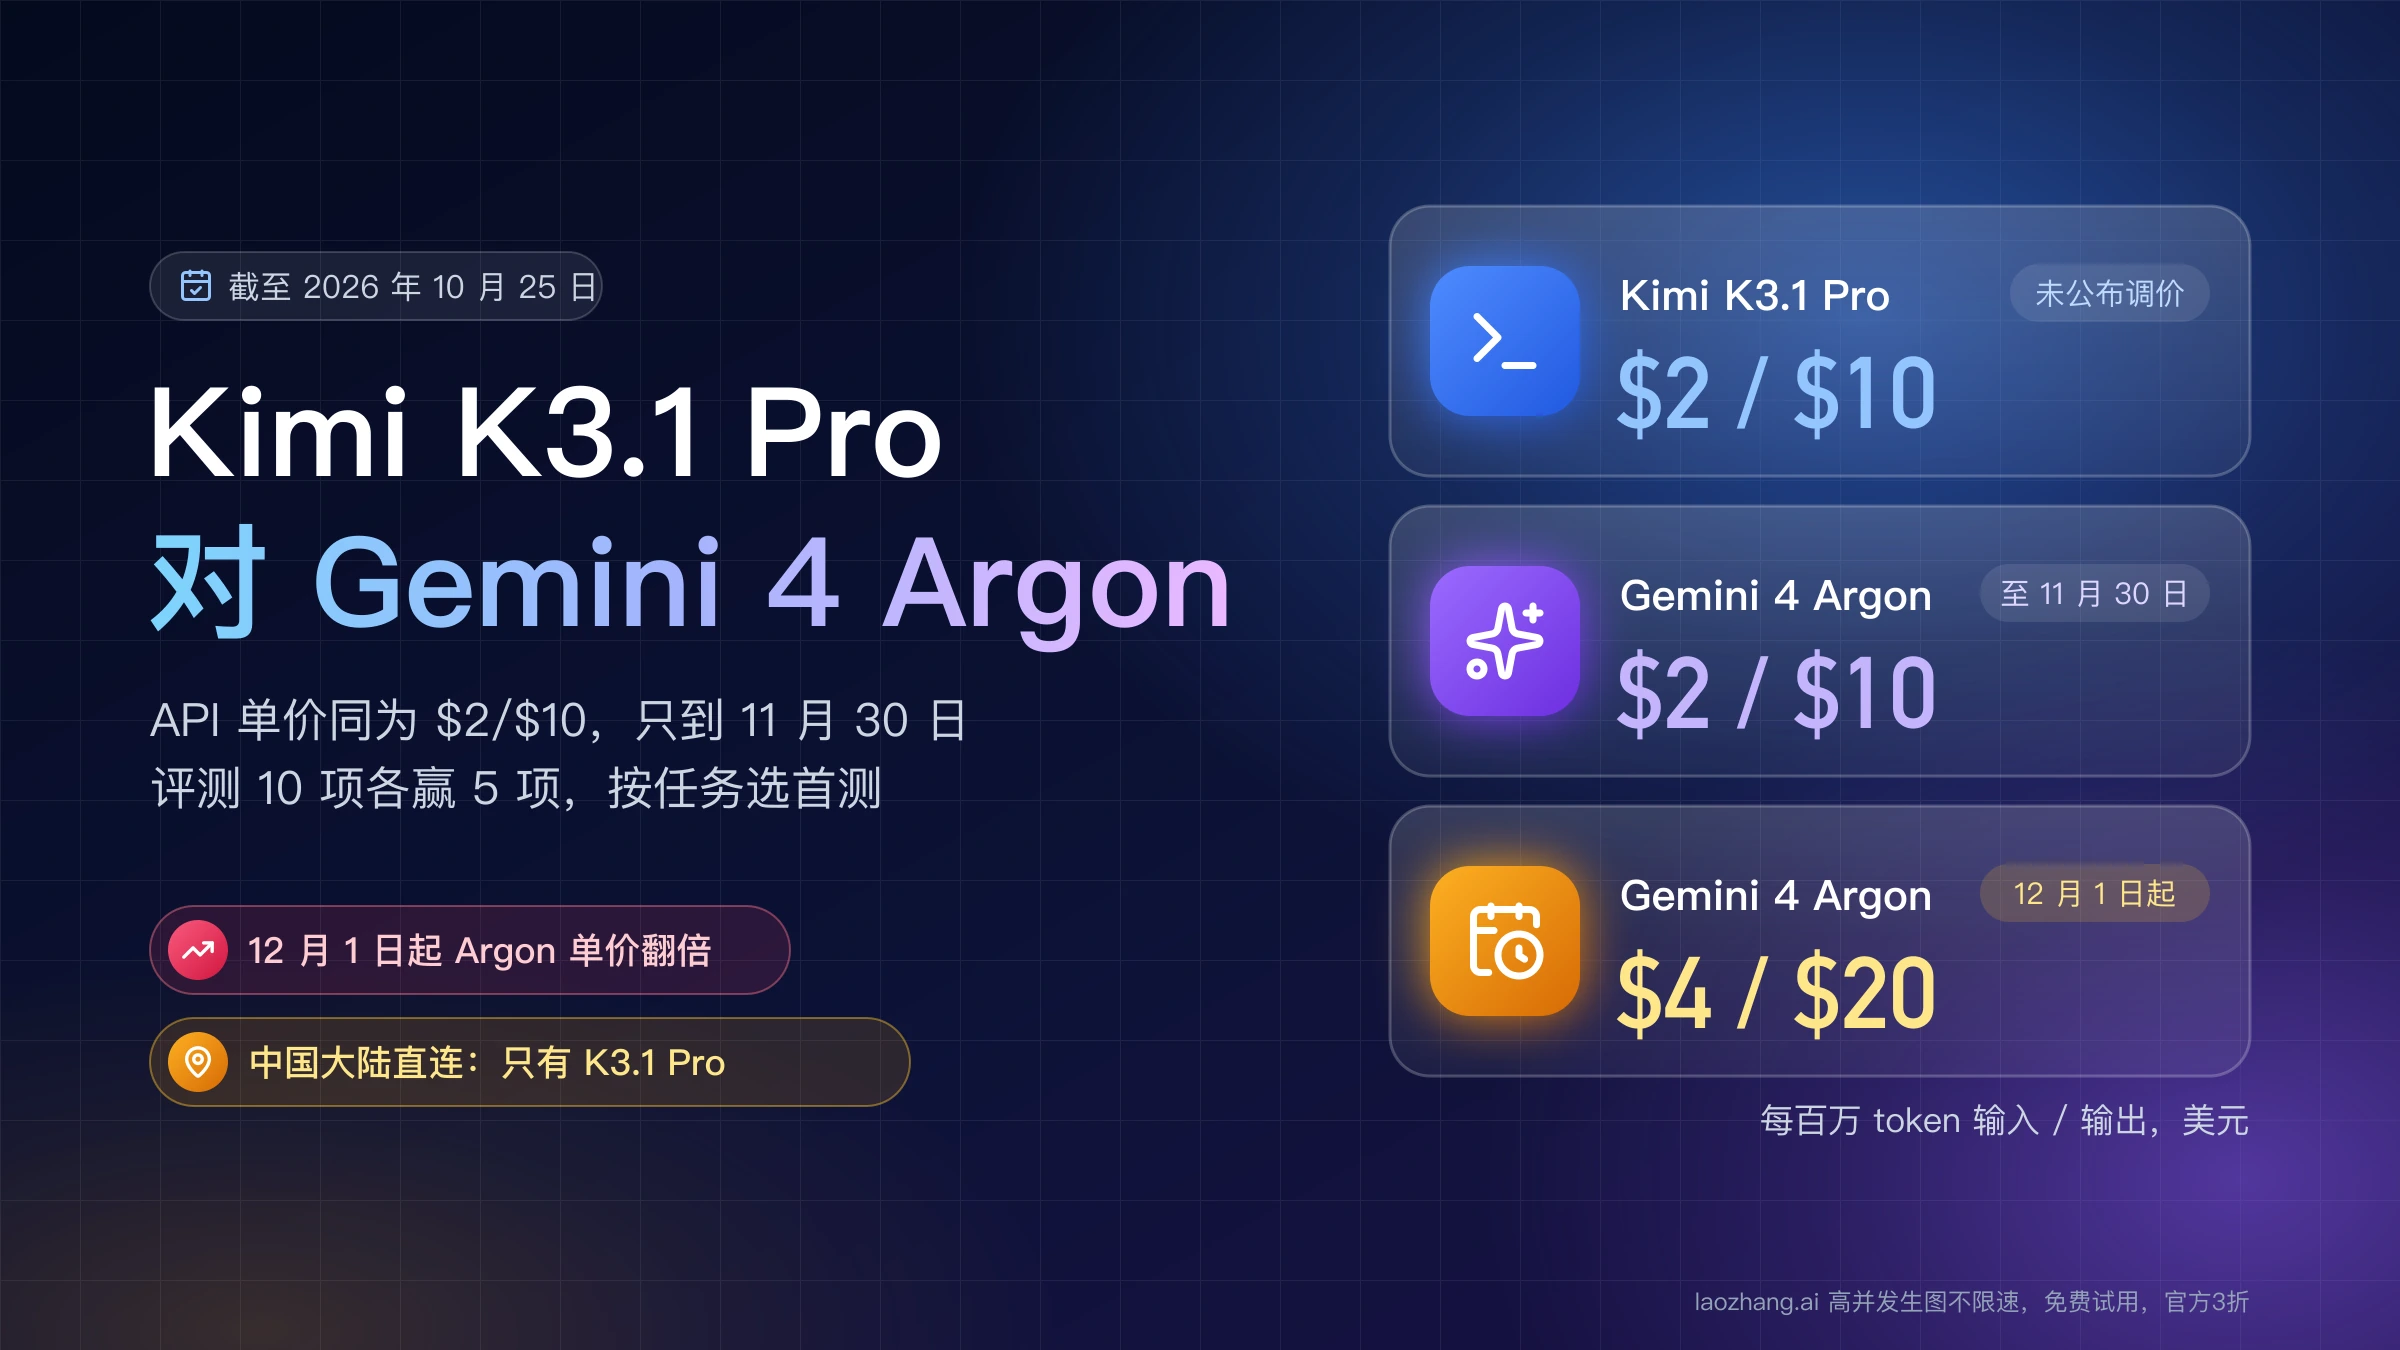
首发价哪天结束,Google 没有说,AA 也写明“没有确定的结束日期”。可以参考的是同价位的 Gemini 4 Argon:它的首发价到 2026 年 11 月 30 日结束,12 月 1 日起恢复 $4 / $20,但这是 Argon 的安排,不能套到 Carbon 身上。Carbon 的批量、长上下文加价和缓存写入费用也都还没有公布。
按每个任务算,结论随 Opus 档位翻转。AA 用标准价算出 Carbon 每个指数任务 $7.76,Opus max 是 $10.04,“便宜 23%”就是这么来的;但 Opus 降到 xhigh 只掉 1.4 分,每任务只要 $6.05。下表最后一列按 AA 的 token 用量换算:假设首发期每个计费项都减半、token 用量不变,Carbon 每任务约 $7.76 ÷ 2 ≈ $3.88。
| 配置 | AA 指数 v5.0 | 每任务成本(标准价) | 每任务用时 | Carbon 标准价是它的 | Carbon 首发价约是它的 |
|---|---|---|---|---|---|
| Carbon(high) | 59.4 | $7.76 | 20.8 分钟 | — | 0.50 倍 |
| Opus 5.5(max) | 58.4 | $10.04 | 19.1 分钟 | 0.77 倍 | 0.39 倍 |
| Opus 5.5(xhigh) | 57.0 | $6.05 | 13.0 分钟 | 1.28 倍 | 0.64 倍 |
| Opus 5.5(high) | 51.7 | $3.46 | 7.7 分钟 | 2.24 倍 | 1.12 倍 |
| Opus 5.5(medium) | 48.1 | $2.45 | 5.5 分钟 | 3.17 倍 | 1.58 倍 |
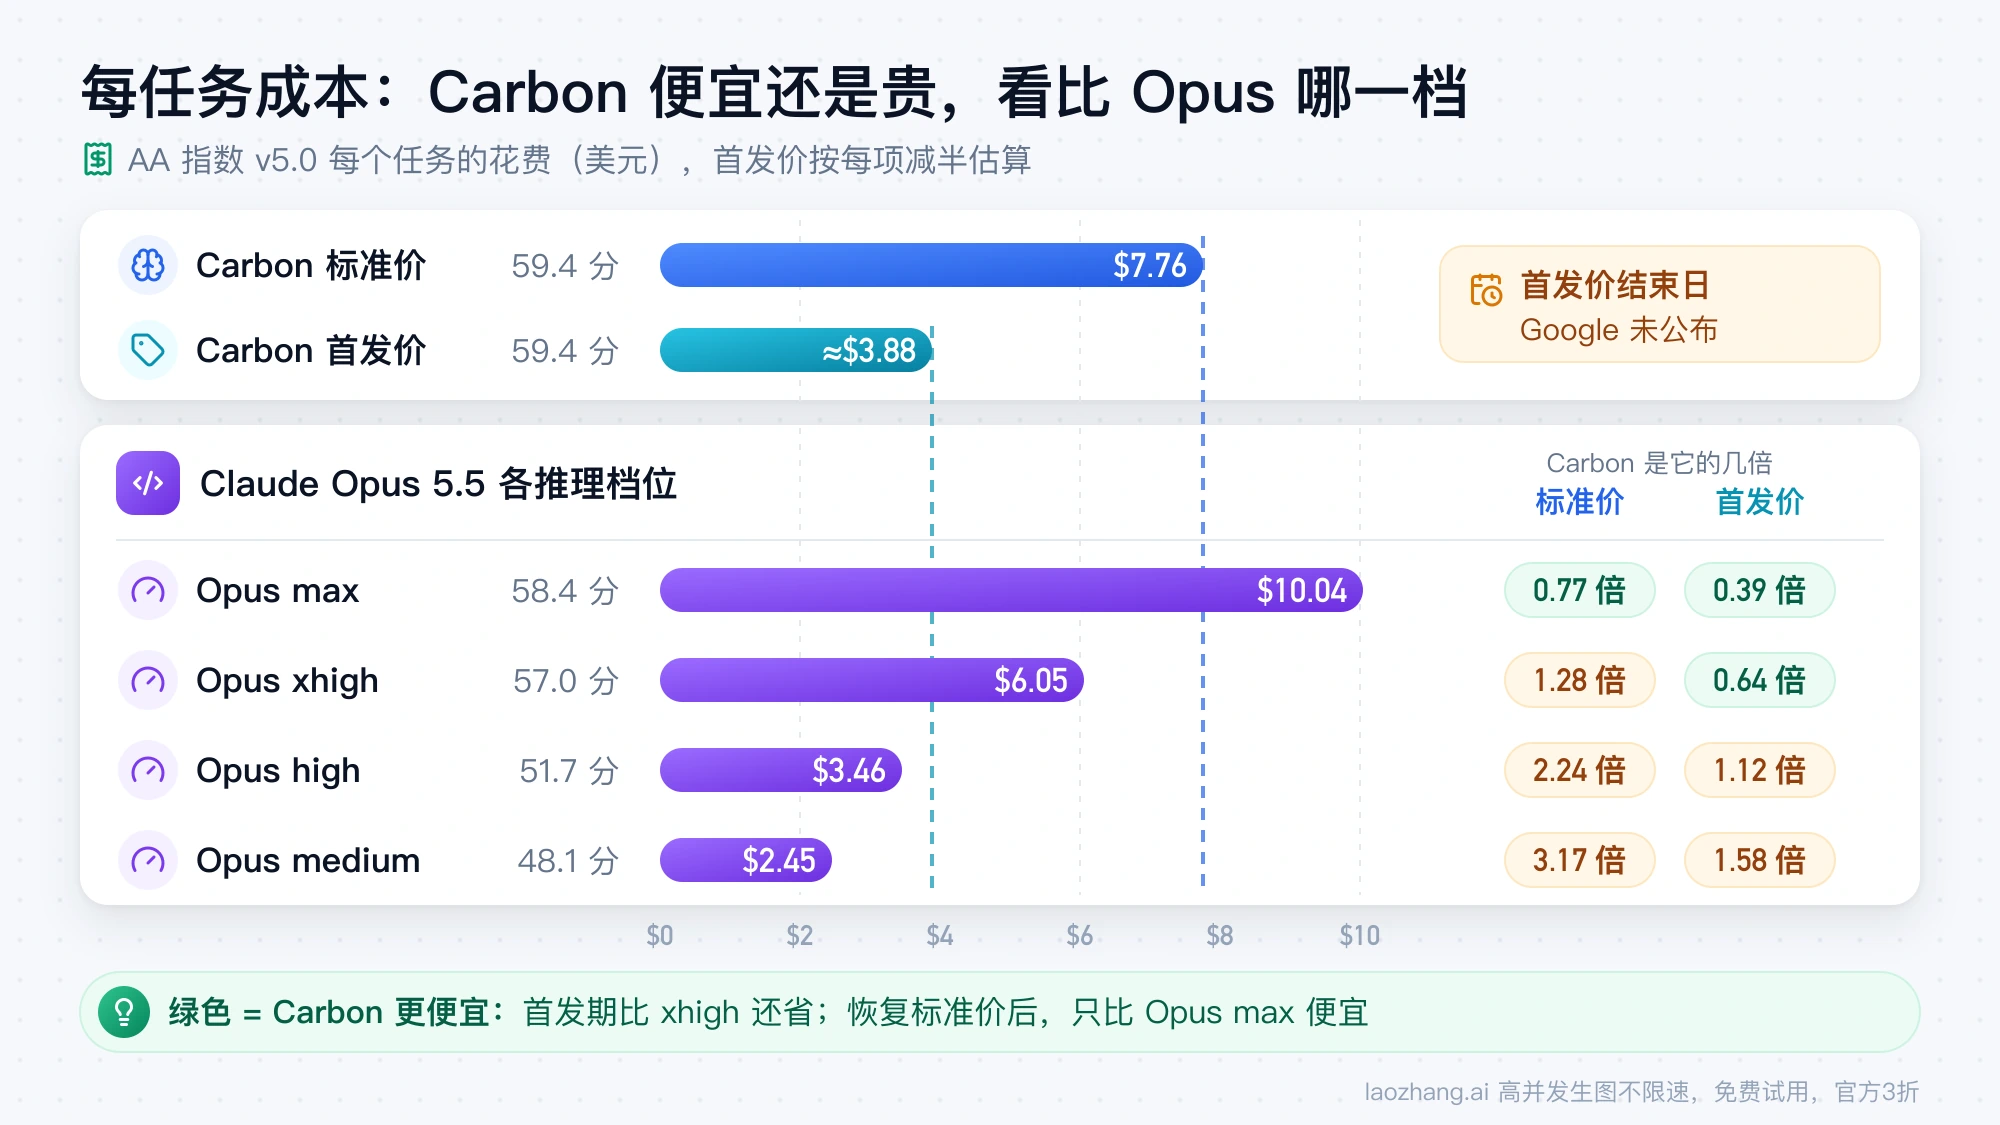
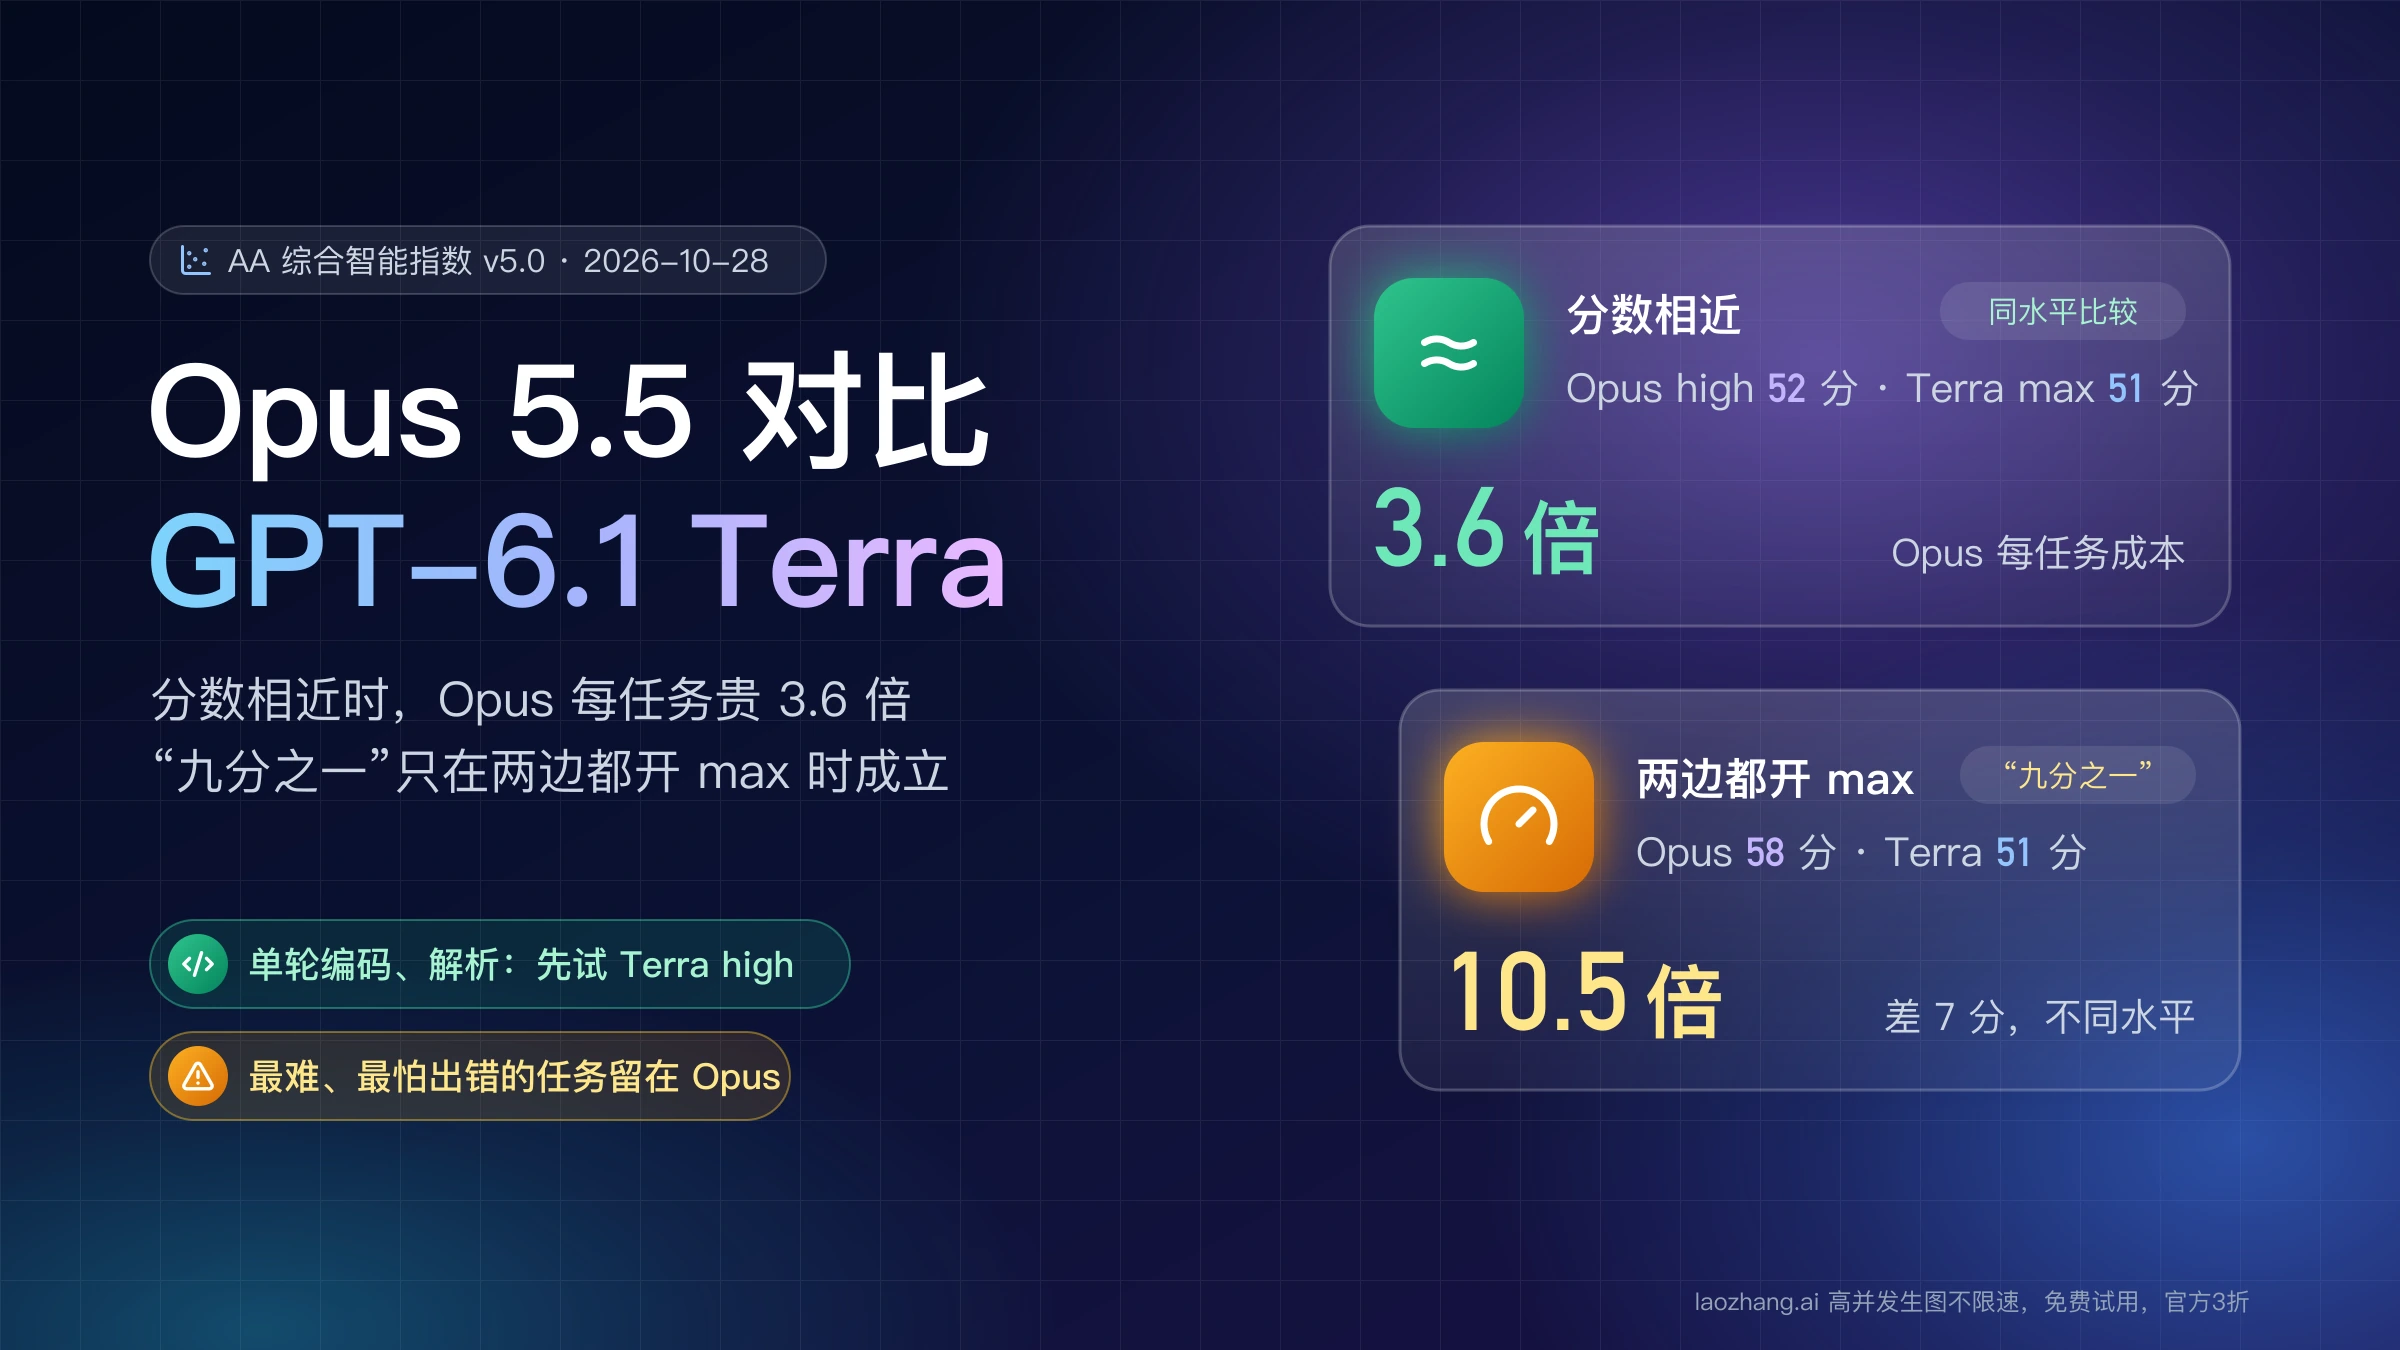
换成你的决定:首发期内,Carbon 比 Opus max 便宜约 61%,比 xhigh 便宜约 36%,分数还更高;首发期结束后,Carbon 只比 Opus max 便宜,比 xhigh 贵 28%,而 xhigh 只低 2.4 分。如果你能接受 Opus 降到 high 档(51.7 分),它在两个价格期都比 Carbon 便宜。编程代理也是同样的算法:按标准价 Antigravity CLI 配 Carbon 比 Claude Code 配 Opus 便宜 32%,首发价下约 $3.87,便宜约 66%。按推理档位比成本的同类算法,也可以看 Claude Opus 5.5 对比 GPT-6.1 Terra:同分时成本差 3.6 倍;Opus 的缓存与账单细节见 Claude Opus 5.5 价格与用量重置:API 账单怎么算,重置卡怎么用。
标价一样,中文账单为什么不一样:同一段中文 Opus 多算 46% token
每 token 同价不等于同样的话花同样的钱,因为两家的分词方式不同:2026 年 10 月 29 日,同一段 246 个字符的中文,Opus 5.5 的 API 计为 265 个输入 token,Gemini 4 Argon 计为 182 个,Opus 是 Gemini 的 1.46 倍。测试用的是 Argon 而不是 Carbon,因为 Carbon 调不了;两者同属 Gemini 4 系列,共用分词器是推断,Google 没有写明。
测试做法是:每种语言准备一段讲“给编程代理选模型”的文字,加上同一句指令,分别发给 claude-opus-5-5(Anthropic Messages 接口,max_tokens 16,effort low)和 gemini-4-argon(原生 generateContent,maxOutputTokens 16,thinkingLevel low),读取两边返回的输入 token 数,按标价共花费 $0.039。
| 文本 | Opus 5.5 输入 token | Gemini 4 Argon 输入 token | Opus ÷ Gemini |
|---|---|---|---|
| 中文(246 字符) | 265 | 182 | 1.46 |
| 英文 | 217 | 176 | 1.23 |
| 日文 | 330 | 228 | 1.45 |
| 韩文 | 414 | 213 | 1.94 |
| 英文长文档(40,625 字符) | 15,495 | 11,081 | 1.40 |
折算到钱上:同一段中文按 Gemini 计为 100 万 token 时,Carbon 输入收 $2(首发)或 $4(标准),Opus 按 1.456 倍计数、每 100 万 $4,约收 $5.82。再举一个整单的例子:1,000 次调用,每次按 Gemini 计 2 万输入 token、1,500 输出 token,合计 2,000 万输入、150 万输出,Carbon 首发价是 20 × $2 + 1.5 × $10 = $55,标准价 $110;Opus 单价和 Carbon 标准价相同,输入输出都按 1.456 倍计数,约 $110 × 1.456 ≈ $160.16。这个例子假设两边写出的回答一样长,实际不会:AA 的数据里 Carbon 每任务输出 12.3 万 token,比 Opus max 的 17.3 万少,但比 Opus high 的 6 万多。
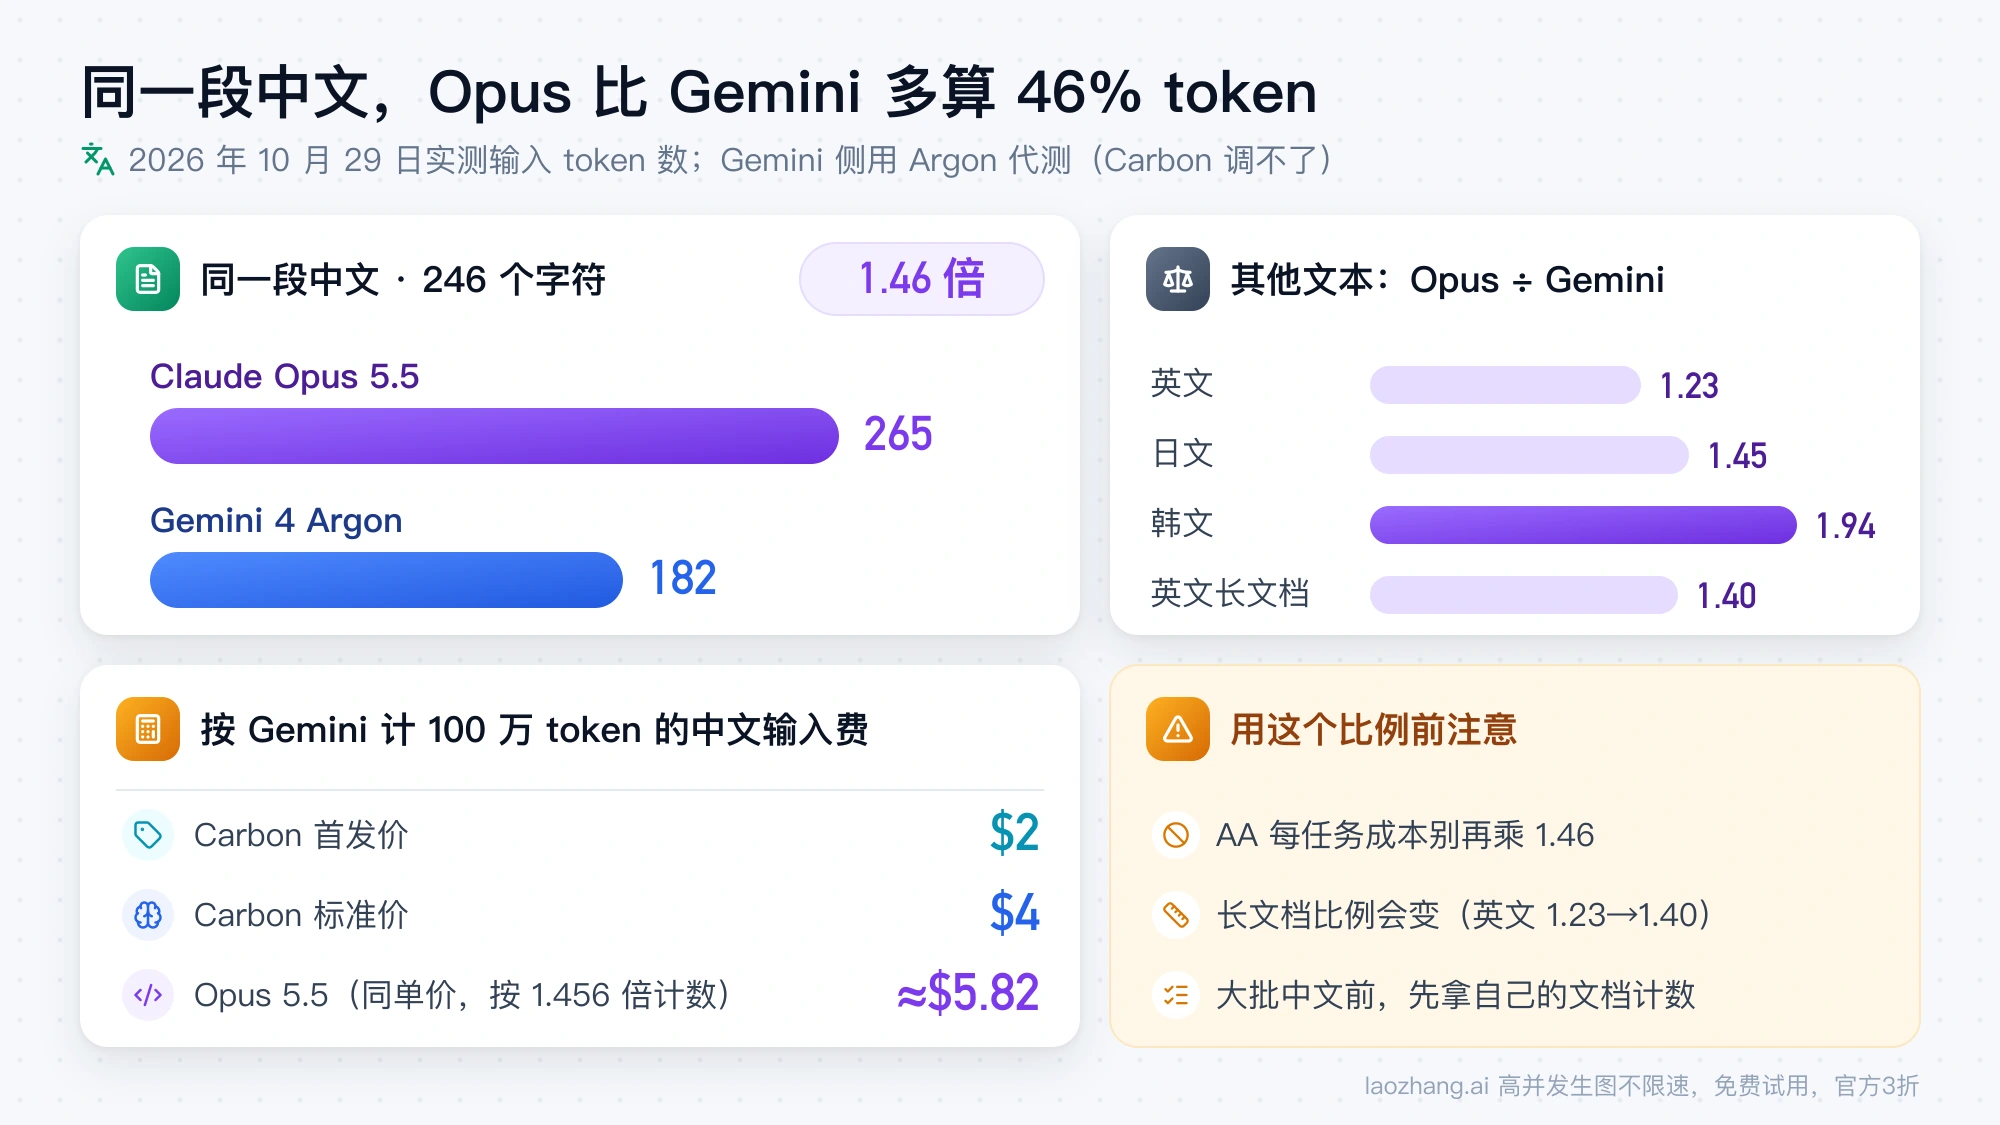
有两点限制要记住。第一,AA 的每任务成本已经按各自的 token 数算过,不能再乘一次 1.46。第二,这是一段短中文的结果;长文档只测了英文,比例从短文的 1.23 变成 1.40,所以中文长文档的比例很可能也不是 1.46,处理大批中文长文本前,最好拿自己的文档在两边各计一次数。
2026 年 10 月 29 日的调用测试:Carbon 返回 503,Opus 5.5 正常
2026 年 10 月 29 日 03:00(UTC),通过 api.laozhang.ai 用一个按用量计费的 key 请求 Carbon,OpenAI 兼容的 Chat Completions 和 Gemini 原生 generateContent 两条路径都返回 HTTP 503,同一个 key 调 claude-opus-5-5 全部正常。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
Carbon 的两次请求用的都是推测的 ID gemini-4-carbon(Google 没有公布 Carbon 的模型 ID),返回的原文是 Current group default has no available channels for model gemini-4-carbon,没有计费,当天 01:36(UTC)也是同样结果。同一个 key 下 GET /v1/models 列出 190 个模型,Gemini 4 只有 gemini-4-argon,Opus 有 claude-opus-4-6、claude-opus-4-7、claude-opus-5 和 claude-opus-5-5;Opus 5.5 回答了上一节全部计数请求。laozhang.ai 上 claude-opus-5-5 的标价是输入 $4、输出 $20、缓存读取 $0.20、缓存写入 $5,单次输出上限 32,768 token(截至 2026 年 10 月 28 日的文档)。
这个测试能说明的是:这个网关截至当天没有 Carbon 的可用通道。它不能说明 Google 自己的 Gemini API 是什么状态,因为没有用 Google 的 key 去测。Google 那边的情况看发布文本身:Carbon 先给一部分网络安全防御方,再通过 Fairwind 计划逐步扩大到受信任的合作伙伴,之后才向开发者、企业和普通用户开放,没有给日期。谁现在能用、什么时候开放、要不要先用 Argon,见 Gemini 4 Carbon 什么时候可以用:已发布,但只给网安防御方。
现在换还是等:按工作类型决定
今天没有可以换过去的 Carbon,所以问题其实是“继续用 Opus,还是等 Carbon 开放后改用”,答案取决于你的主要工作落在上面对照表的哪一边。主要是编程代理、Claude Code、文档汇报或电脑操作的,Carbon 开放也不必急着换,这几项 Opus 都还领先;主要是高难推理、科研计算、事实问答或业务流程自动化的,值得等,开放后用自己的任务实测,首发价期间尤其划算。
在 Claude Pro、Max、Team 或 Enterprise 订阅里用 Opus 的人,今天没有对应的 Gemini 入口可换,截至 2026 年 10 月 29 日 Gemini 应用、AI Studio、Gemini API、Vertex 和 Antigravity 里都没有 Carbon。按 API 付费、又想现在就压成本的,先在 Opus 内部调档位:xhigh 只比 max 低 1.4 分、每任务便宜四成,更便宜的 Claude 选项见 Sonnet 5.5 和 Opus 5.5 怎么选:半价未必更省。想现在就试 Google 这一代的,能调用的是 Gemini 4 Argon(AA 指数 50.4,比 Carbon 低 9 分),三家今天能用的旗舰对比见 Gemini 4 Argon、Opus 5.5、GPT-6.1 Sol 对比:已开放,12 月起涨价。
网络安全是 Carbon 主打的方向,Google 公布的 SEC-bench Pro、ExploitGym 和 CWE-bench 成绩都是它自己的测试,没有 Opus 在同一张表里的数字,所以这一类只能等开放后自己比。Carbon 开放当天,可以按下面的顺序测:
- 从你最近的真实工作里取 20 个任务,同一个起点、同一套验收标准,分别跑 Carbon(high)和 Opus 5.5 的 xhigh、max,比较“每个通过的任务花多少钱”,而不是每 token 单价。
- 用你自己的中文提示词和文档,读两边返回的输入 token 数(Gemini 看
usageMetadata.promptTokenCount,Anthropic 看usage.input_tokens),确认 Carbon 的计数是否和上面 Argon 的一致。 - 查清开放时的模型 ID、首发价有没有结束日期、缓存写入怎么收费、速率限制多少,再算整月账单。
- 需要准确性的,用一组你知道答案的事实问题看两边各编了几条,这是 Carbon 在 AA 测试里优势最大的一项。
跑分可信吗:Google 的表和 AA 的测试分开看
两套数字都要带着出处读:Google 发布时那张“17 项里 15 项第一”的表是厂商自测,AA 的数字是第三方测出来的,但 Carbon 在 AA 也只测了一个档位、一轮,测试时还没有公开 API。
Google 的表按 VentureBeat 2026 年 10 月 28 日的报道转述,Carbon 没拿第一的两项是 FrontierSWE 2(GPT-6 Astra 65.5,Opus 62.3,Carbon 61.2)和 OSWorld-2.1 离线子集(Opus 87.2,Carbon 81.5);差距最大的一项是 GraphWalks,Carbon 96.2 对 Opus 66.8。Google 注明表里的成绩用最高思考设置、pass@1 测得,网安几项还写明是“未加护栏”的测评,和开放后你通过 API 调到的版本未必是同一种状态。
同一项测试也可能有三个数,引用时要说清是谁测的:Terminal-Bench 4.0 上 Carbon 在 Google 的表里是 65.2,AA 单测模型是 65.2%,AA 编程代理测试里是 63.6%。Google 发布文里的其他改进,例如 Terminal-Bench 4.0 作弊成功率降到 0.0%、无依据的说法比 Argon 少约一半、间接提示注入攻击成功率 0.0%,都是 Google 自己的测试,而且只和 Argon 比,没有和 Opus 比。担心“刷榜”的话,AA 的数字和你自己的 20 个任务比 Google 的表更值得参考。
Gemini 4 Carbon 和 Opus 5.5 的其他问题
Gemini 4 Carbon 和 Gemini 4 Argon 是什么关系? Carbon 是在 Argon 基础上做的更强版本,AA 指数 59.4 对 50.4,标价相同,但截至 2026 年 10 月 29 日只有 Argon 能调用;两者的区别和要不要先用 Argon,见 Gemini 4 Carbon 什么时候可以用:已发布,但只给网安防御方。
Carbon 和 Opus 5.5 的上下文窗口一样大吗? 一样,都是 100 万 token。按 AA 的模型页,Carbon 支持文本、图片、视频和语音输入、文本输出;Opus 5.5 单次最多输出 12.8 万 token,而且整个 100 万 token 窗口内单价不变。Carbon 的单次输出上限和长上下文是否加价,Google 截至 10 月 29 日没有公布。
等 Carbon 的时候,Anthropic 会不会先出 Opus 新版? 截至 2026 年 10 月 29 日,Anthropic 的新闻页上没有任何新模型公告,最新的仍是 Opus、Sonnet 和 Haiku 5.5。网上关于 Opus 下一版的说法都是猜测,做决定时只按今天能用的 Opus 5.5 来算。
参考来源5
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月29日。
参考来源5
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月29日。
- 1.Artificial Analysis Gemini 4 Carbon 模型页artificialanalysis.ai/models/gemini-4-carbon
- 2.AA 编程代理指数artificialanalysis.ai/agents/coding
- 3.Google 的 Gemini 4 Carbon 发布文blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon
- 4.Claude API 定价页platform.claude.com/docs/en/about-claude/pricing
- 5.VentureBeat 2026 年 10 月 28 日的报道venturebeat.com/technology/google-unveils-gemini-4-carbon-retaking-the-worlds-no-1-spot-on-updated-harder-benchmarks-but-access-is-limited