Gemini 4 Argon API finish_reason 怎么处理:长输出续写与中转实测
Argon 返回 CONTINUATION 就带 token 重发原请求,MAX_TOKENS 要调高 maxOutputTokens;OpenAI 兼容接口不能续写。
文章目录
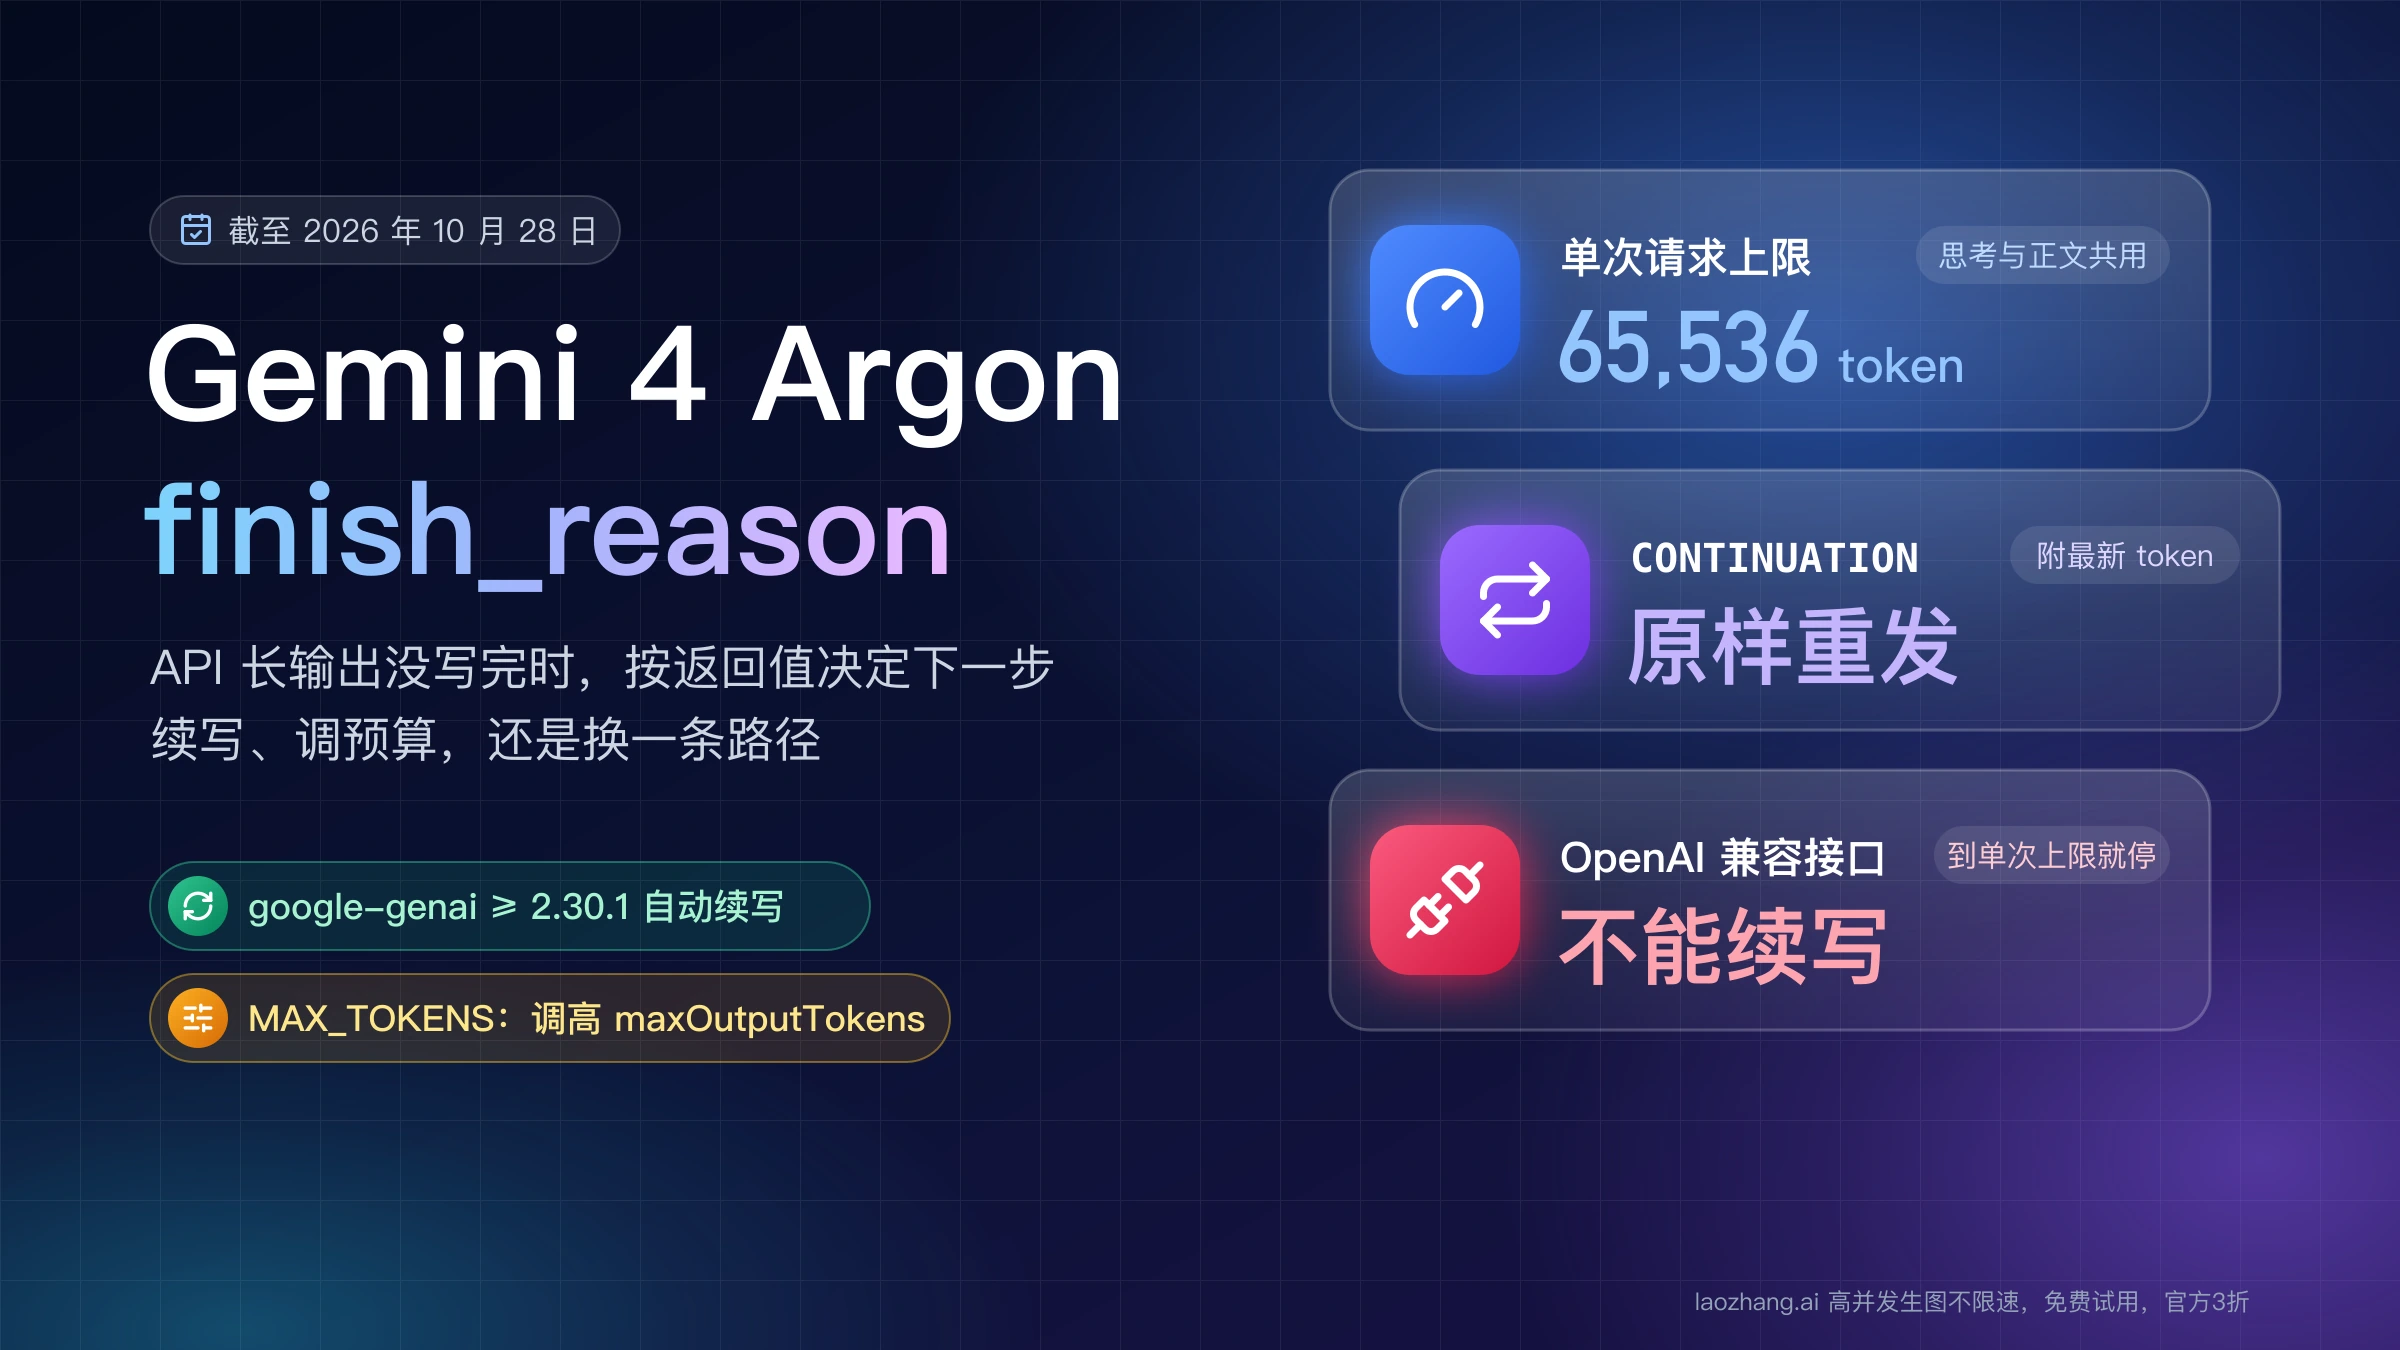
gemini-4-argon 的一次请求最多输出 65,536 个 token(直连的非流式 REST 是 32,768),思考和正文共用这份额度。回答没写完就碰到这个上限时,Gemini API 返回 finishReason: CONTINUATION 和一个 continuationToken,你要把完全相同的请求连同这个 token 再发一次,Google 把每一次这样的请求叫作一“跳”(hop),整个机制叫长解码(long decode)。如果用完的是你设定的 maxOutputTokens 总额,返回的是 MAX_TOKENS,这时要调高 maxOutputTokens,文字为空说明额度全花在了思考上。
最省事的接法是:Python 的 google-genai 升到 2.30.1 以上(JavaScript 的 @google/genai 升到 2.29.1 以上),走原生 generateContent,把 maxOutputTokens 设到 65,536 以上,SDK 会自动续写,你最后只看到一个 STOP。例外有两种:OpenAI 兼容接口不支持长解码,到单次上限就停;经过 API 中转平台时 token 可能被丢掉,2026 年 10 月 28 日实测的一条 OpenAI 兼容路径用满了 max_tokens 却返回 finish_reason: "stop",所以在这类路径上要比较 completion_tokens 和 max_tokens,不能只看 finish_reason。规则依据截至 2026 年 10 月 28 日的 Gemini API 长解码文档(GenerateContent)。
2026 年 10 月 28 日实际做了两组测试:一是通过一家 API 中转平台调用 gemini-4-argon 的 Gemini 原生接口和 OpenAI 兼容接口,共 11 次请求;二是在本机模拟服务器上测 google-genai 2.33.0 和 2.29.0 收到 CONTINUATION 时的反应。没有使用 Google 直连的 API key,真实请求里也没有出现过 CONTINUATION,所以下文关于 Google 直连行为的内容都来自官方文档,没有在一次真实的长解码上验证过。
Argon 的 finish_reason 各是什么意思,代码下一步怎么做
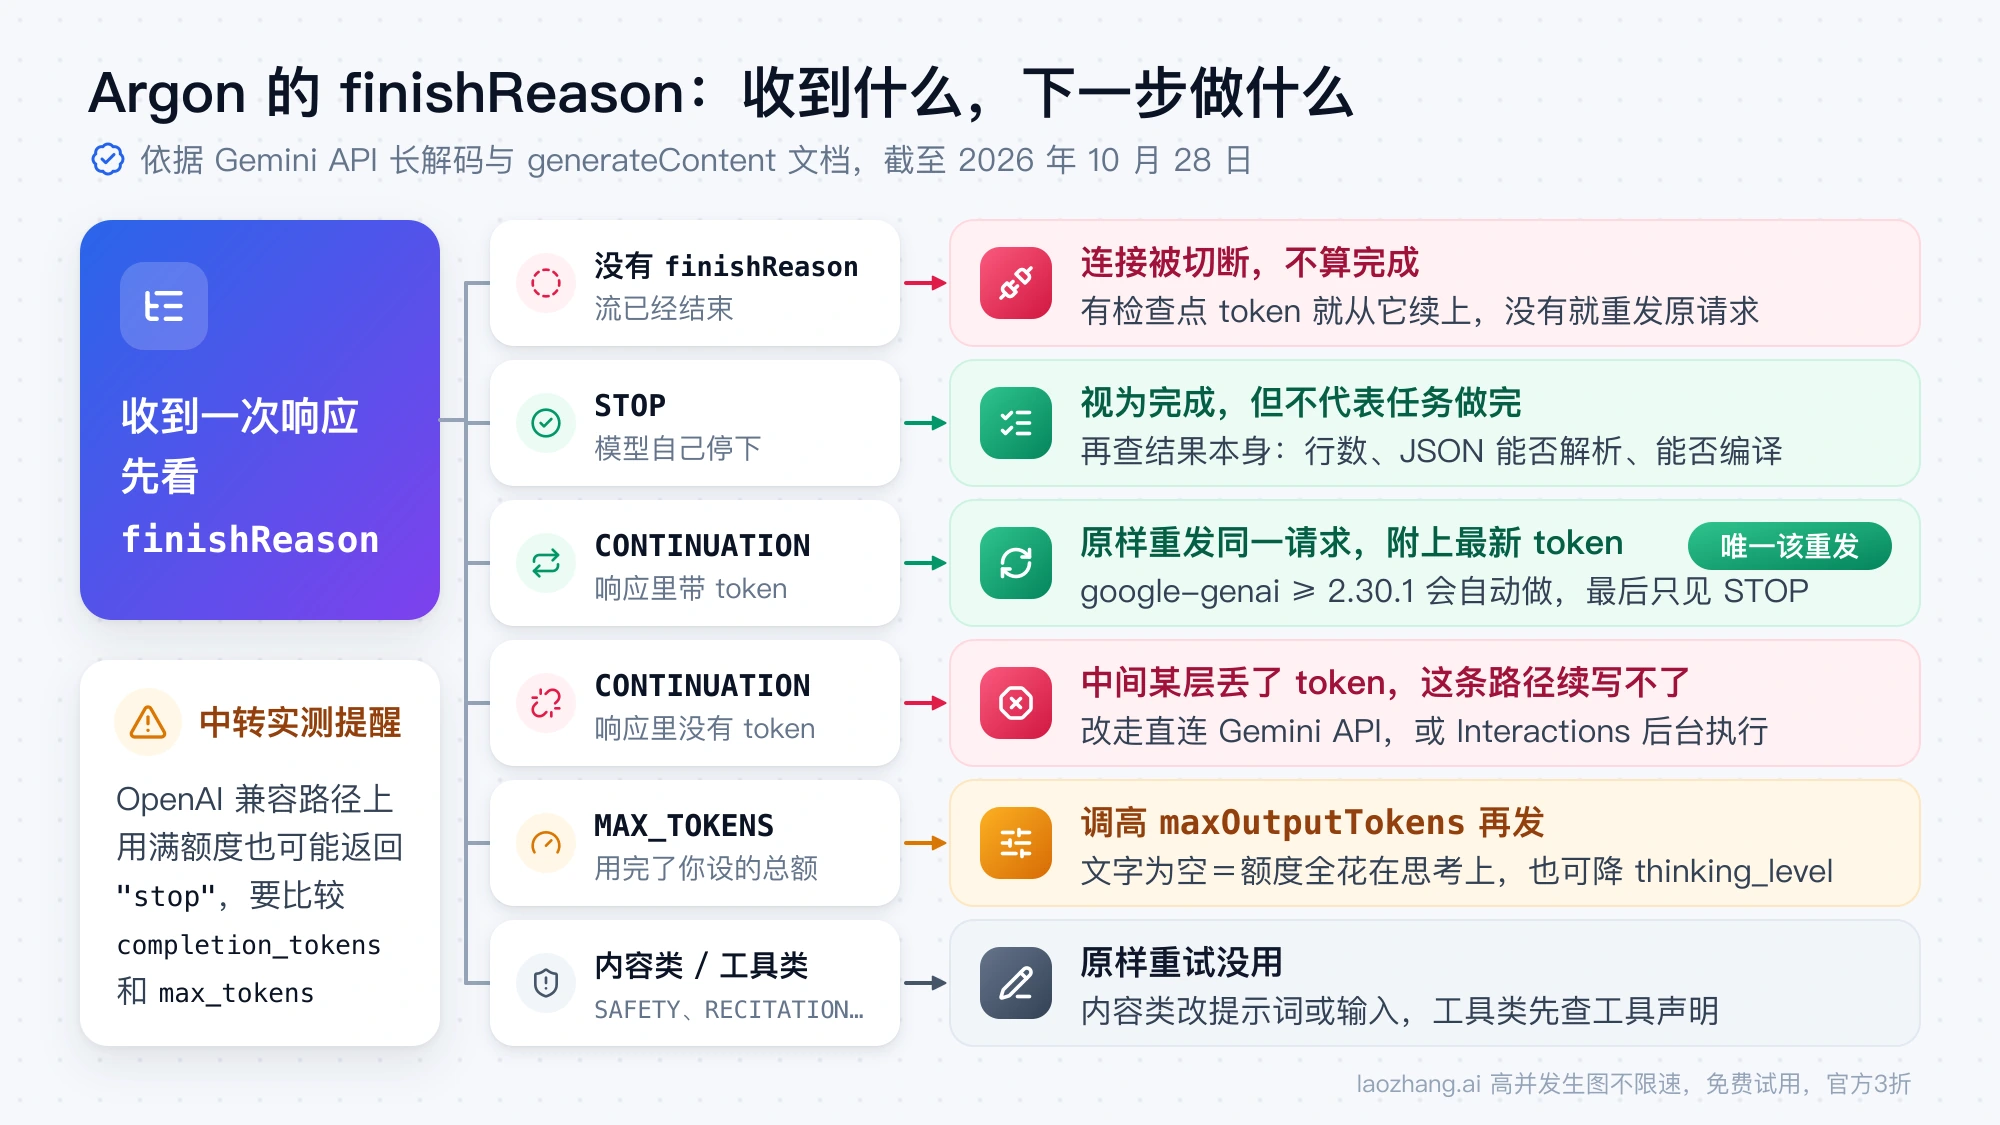
只有 CONTINUATION 应该自动重发;STOP 表示模型自己停下,MAX_TOKENS 要先改预算,内容类和工具类的停止原样重试没有用。字段名在 REST JSON 里是 finishReason,在 Python SDK 和 OpenAI 风格的响应里是 finish_reason。Argon 只输出文字,IMAGE_SAFETY、NO_IMAGE 这类图片专用的取值不会出现。下表的含义取自截至 2026 年 10 月 28 日的 Gemini API generateContent 参考文档和长解码文档。
| 返回值 | 含义 | 下一步 |
|---|---|---|
STOP | 模型自然结束,或命中了停止序列 | 视为完成,但不代表任务做完(见表后说明) |
CONTINUATION,带 continuationToken | 到了单次请求的上限,maxOutputTokens 还有余量 | 原样重发同一请求,附上最新的 token;新版 SDK 会自动做 |
CONTINUATION,没有 token | 你和 Google 之间的某一层把 token 丢了 | 这条路径续写不了,改走直连 Gemini API 或 Interactions 后台执行 |
MAX_TOKENS,有文字 | 用完了 maxOutputTokens 总额 | 调高 maxOutputTokens;带 token 就附上续写,新值必须高于已用量,否则返回 400 |
MAX_TOKENS,文字为空 | 额度全部用在了思考上 | 调高 maxOutputTokens,或把 thinking_level 降一档 |
SAFETY、PROHIBITED_CONTENT、BLOCKLIST、SPII、RECITATION、LANGUAGE | 内容被安全过滤、含禁用词或敏感个人信息、疑似复述,或用了不支持的语言 | 改提示词或输入 |
MALFORMED_FUNCTION_CALL、UNEXPECTED_TOOL_CALL、TOO_MANY_TOOL_CALLS | 函数调用格式无效、请求没开工具却产生了工具调用、连续调用工具过多 | 检查工具声明和调用流程后重试 |
MISSING_THOUGHT_SIGNATURE | 请求里至少缺了一个思考签名 | 多轮对话把上一轮返回的 thought signature 原样带回 |
ESCALATION、PUP_LIMITED_DISABLED | 被升级规则过滤;账号因违反禁止使用政策被限制或停用 | 重试无效,后者要先处理账号状态 |
MALFORMED_RESPONSE、OTHER | 响应格式异常,或原因不明 | 记录 finishMessage 和原始响应,重试一次 |
没有 candidates,只有 promptFeedback.blockReason | 提示词在生成前就被拦下 | 改写提示词,模型什么都没生成 |
| 流结束了却没有 finishReason | 连接被切断 | 不算完成,按后文“流结束了却没有 finishReason”一节处理 |
STOP 只说明模型是自己停下的。2026 年 10 月 28 日的一次测试里,把 maxOutputTokens 设为 33,000,要求逐行打印 1 到 7000,Argon 只用了 142 个 token 就以 STOP 结束:它拒绝输出完整列表,理由是会超过单次回答的长度限制,并建议改用 seq 1 7000。所以需要完整产物的任务,除了看 finishReason,还要检查结果本身,例如行数、JSON 能否解析、代码能否编译。
用 Interactions API 时看到的不是 finishReason,而是 status。截至 2026 年 10 月 28 日的 Interactions 长解码文档列出的终态有 completed(完成)、requires_action(模型要求调用工具)、incomplete(用完了 max_output_tokens,文字可能为空,相当于 MAX_TOKENS)、failed 和 cancelled;续写由服务器在后台完成,客户端没有 CONTINUATION 要处理。
开通 Gemini 4 Argon API:没有免费层,先绑结算再设预算
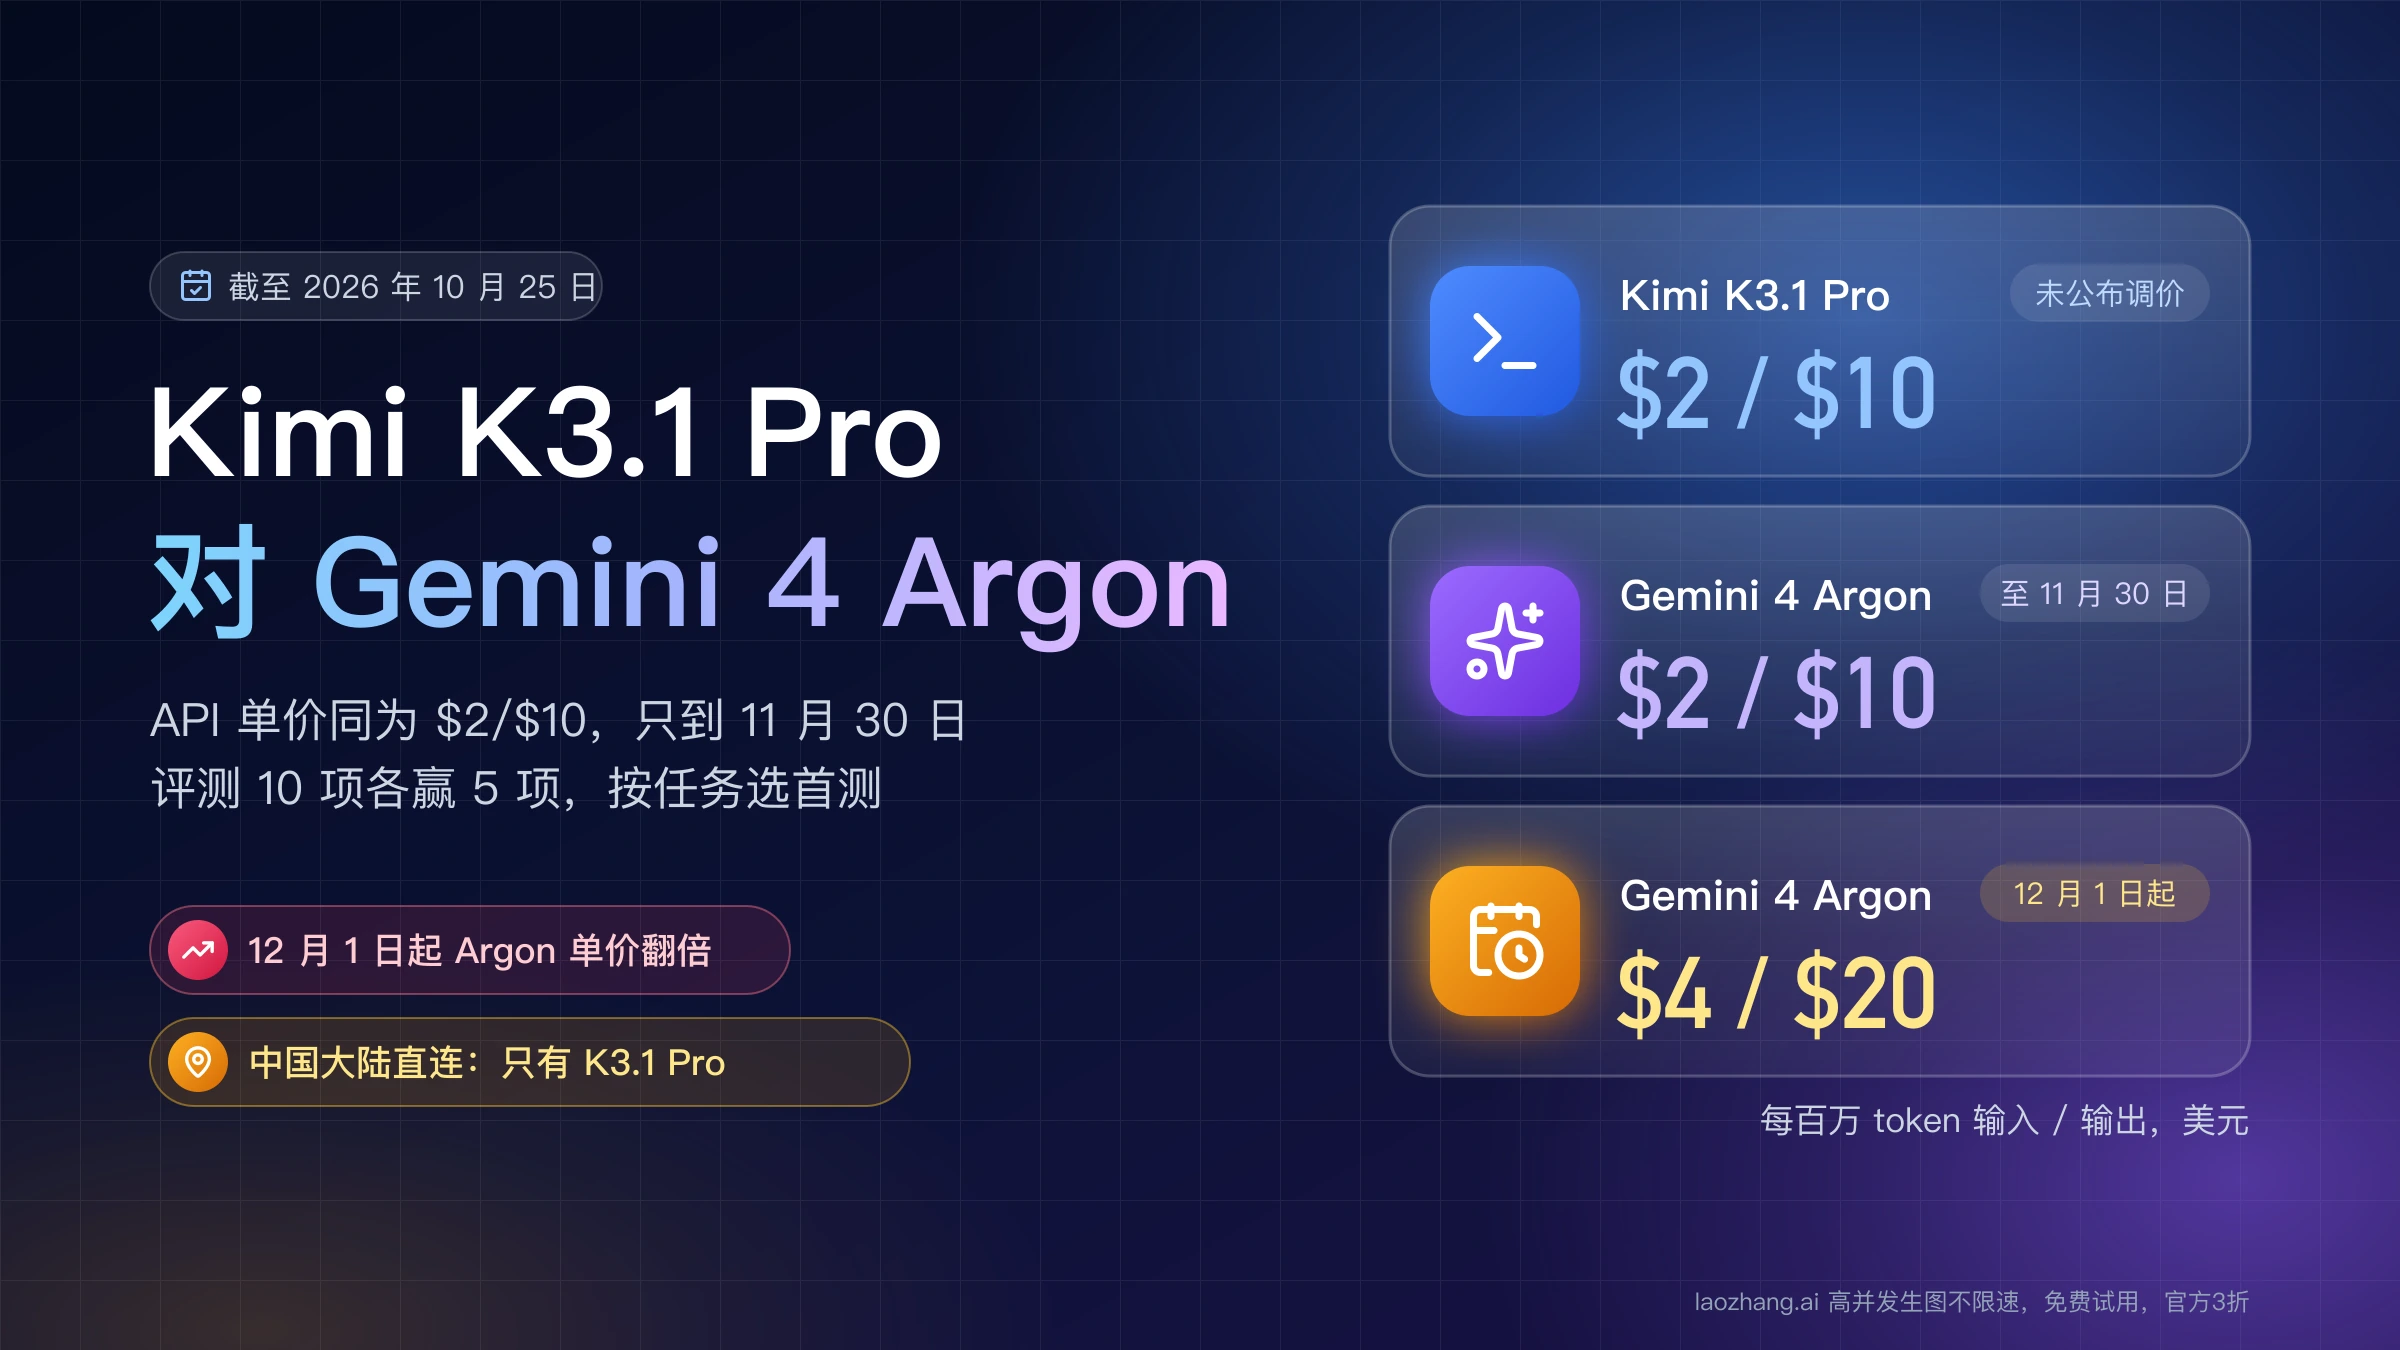
Gemini API 的免费层不能调用 gemini-4-argon,模型 2026 年 10 月 13 日正式发布(GA),每个 token 都计费,思考 token 也算在输出里。截至 2026 年 10 月 28 日的 Gemini API 价格页,每 100 万 token 输入 $2、输出 $10,2026 年 12 月 1 日起调到 $4 / $20。Gemini 应用里的 Google AI Pro、Ultra 订阅和 API 是两套体系,有订阅不等于你的项目能调 API。
- 在 Google AI Studio 的项目上关联结算账号并预付至少 $5,进入 Tier 1。预付余额降到 0 时,key 会停止工作并返回 HTTP 402。
- 请求里的模型 ID 写
gemini-4-argon。 - 升级 SDK:
pip install -U "google-genai>=2.30.1"或npm install "@google/genai@>=2.29.1";Go、Java、.NET、Kotlin 的最低版本分别是 1.74.0、1.77.0、1.26.0、1.6.0。更早的版本不会自动续写,输出停在 64K。 maxOutputTokens至少设 32,768,因为 Argon 会把更多额度花在思考上;长代码和智能体任务从 65,536 起,难的数学、证明类从 262,144 起试。同时删掉temperature、top_p、top_k,Argon 会忽略它们并给出警告。thinking_level只能用low、medium、high,默认medium;Argon 不接受minimal,也不要和thinking_budget同时设。各档区别见 Gemini 3.1 Pro 思考级别:LOW/MEDIUM/HIGH 区别与 Gemini 4 默认值。- 把客户端的读取超时设为 20 分钟。服务器对非流式请求 10 分钟后断开、流式 20 分钟后断开,3 分钟或 5 分钟的超时会提前把请求掐掉。Python 写法是
genai.Client(http_options=types.HttpOptions(timeout=1_200_000)),单位是毫秒。
截至 2026 年 10 月 22 日更新的 Gemini API 可用地区列表不包括中国大陆和香港,从这些地区调用通常要经过 API 中转平台,下文“走中转平台”一节的实测就是这种路径。请求返回 429 属于速率限制,按项目计算,处理方法见 Gemini API 速率限制 2026:按项目计算,429 对应哪种限额、怎么提额。
为什么 SDK 里看不到 CONTINUATION:2.30.1 以上会自动续写
google-genai 2.30.1 及以上默认开启 automatic_continuation,中间每一跳的 CONTINUATION 都被 SDK 自己处理掉,你拿到的是合并后的文字、最后一跳的 STOP 和各跳累加的用量。低于这个版本时 SDK 不会续写,而且不报错:它把空文字和 CONTINUATION 原样交给你,代码如果只读 response.text,看到的就是一个空字符串。
2026 年 10 月 28 日,用一个模仿 :generateContent 的本机服务器,按 Google 文档里的响应格式手写了四种情况,分别交给 google-genai 2.33.0(当天 PyPI 上的最新版)和 2.29.0,结果如下。模拟响应和真实服务器在细节上可能不同,这组测试说明的是 SDK 怎么处理这些响应。
| 模拟场景 | google-genai 2.33.0 | google-genai 2.29.0 |
|---|---|---|
第一跳 CONTINUATION + token,文字为空、思考 32,768 token;第二跳 STOP | 发了 2 次请求,第二次带 token,maxOutputTokens 仍是 262,144,contents 不变;调用方看到 STOP 和完整文字 | 只发 1 次请求;调用方拿到空文字、CONTINUATION 和 token,没有报错 |
同上,设 automatic_continuation=False | 只发 1 次请求,调用方看到 CONTINUATION 和 token | 没有这个参数 |
CONTINUATION 但响应里没有 token | 只发 1 次请求;空文字加 CONTINUATION,不抛异常 | 同左 |
MAX_TOKENS + token | 只发 1 次请求,不续写;返回已有文字和 token | 同左 |
第一种场景里,2.33.0 报告的 prompt_token_count 是 33,008,也就是第一跳的 120 加上第二跳的 32,888(原始提示加第一跳生成的全部内容),而 initial_prompt_token_count 是 120。2.33.0 的源码里,只有 finish_reason 为空或为 CONTINUATION 时才会续写;流式请求在连续 3 次重连都没拿到新的检查点 token 后放弃。由此得出一条检查规则:SDK 调用返回后,finish_reason 仍是 CONTINUATION,说明续写没有发生,要么 SDK 版本太旧,要么 token 在半路被丢了,第三种场景就是后者,它最危险的地方是静默返回空字符串。
不用 SDK 自动续写时,怎样自己写续写循环
直接调用 REST、用的语言没有新版 SDK,或者要自己控制每一跳时,就要自己写循环。按 Google 文档的规则,每一跳都发送相同的 contents、system_instruction、tools 和 generation_config,maxOutputTokens 也保持不变,因为它是所有跳合计的上限;不要把已生成的部分拼进 contents,模型的状态(包括思考)都在 token 里,所以每次只发最新的那个 token。finishReason 是 CONTINUATION 就继续,其他任何值都停,最后把各跳的 parts 合并成一条模型回复,再放进对话历史。
下面这段 Python 按上述规则写成,2026 年 10 月 28 日在 google-genai 2.33.0 和本机模拟服务器上跑过:三跳(空文字、部分文字、STOP)时它发出 3 次请求,contents 和 maxOutputTokens 每次相同,每次只带最新的 token,最后拼出完整文字;服务器返回不带 token 的 CONTINUATION 时,它抛出异常,而不是返回空字符串。走中转平台的原生接口时,在 HttpOptions 里加上平台给的 base_url 即可。
from google import genai
from google.genai import types

client = genai.Client(  # 默认读取环境变量 GEMINI_API_KEY
    http_options=types.HttpOptions(timeout=1_200_000),  # 20 分钟,单位毫秒
)

PROMPT = "给出素数定理的完整证明。"
config = dict(
    max_output_tokens=262_144,  # 所有跳合计的上限,每一跳都填同一个值
    thinking_config=types.ThinkingConfig(thinking_level="high"),
    automatic_continuation=False,  # 由下面的循环负责续写
)

parts, token = [], None
while True:
    resp = client.models.generate_content(
        model="gemini-4-argon",
        contents=PROMPT,  # 每一跳都发原始内容,不要拼上已生成的文字
        config=types.GenerateContentConfig(**config, continuation_token=token),
    )
    cand = resp.candidates[0]
    if cand.content and cand.content.parts:
        parts.extend(cand.content.parts)
    token = cand.continuation_token  # 只保留最新的 token
    if cand.finish_reason != types.FinishReason.CONTINUATION or not token:
        break

if cand.finish_reason == types.FinishReason.CONTINUATION:
    raise RuntimeError("收到 CONTINUATION 却没有 continuationToken,这条路径无法续写")
text = "".join(p.text for p in parts if p.text and not p.thought)
print(cand.finish_reason, text)
流式循环多一条规则:前 32,768 个 token 之后,流每隔 5,000 个 token 发一次检查点 token。新到的数据块先放进待定列表,收到带 token 的块时再把待定内容转为正式输出并保存这个 token;流中断就丢掉待定内容,从最后一个 token 续上;如果在第一个检查点之前就断了,只能重发原请求。遇到带 token 的 MAX_TOKENS 时有两种选择:带着 token 重发,同时把 maxOutputTokens 调到高于已用量(否则返回 400 "Continuation token has already used output tokens…");或者不带 token、调高预算从头再来,两次的费用都要付。
拿到一次响应后该做什么,可以交给一个判断函数。下面是精简版,只依赖标准库,Python 3.9 及以上可用。2026 年 10 月 28 日,用它处理当天保存的 7 个中转平台真实响应和 4 个模拟响应,11 个都归到了预期的动作;其中拒绝打印 7000 行的那次被判为“完成”,这正是 STOP 不代表任务做完的例子。
def next_action(resp: dict) -> str:
    """输入一次 REST 响应(JSON 转成的 dict),返回下一步该做什么。"""
    cands = resp.get("candidates") or []
    if not cands:
        if resp.get("promptFeedback", {}).get("blockReason"):
            return "提示词被拦截:改写提示词,模型没有生成任何内容"
        return "没有候选:记录原始响应,重试一次"
    c = cands[0]
    reason = c.get("finishReason")
    token = c.get("continuationToken")
    parts = (c.get("content") or {}).get("parts") or []
    text = "".join(p.get("text", "") for p in parts if not p.get("thought"))
    if not reason:
        return "连接被切断:有检查点 token 就从它续写,没有就重发原请求"
    if reason == "STOP":
        return "完成(模型自己停下,不代表任务做完)"
    if reason == "CONTINUATION":
        return ("续写:原样重发同一请求,附上 continuationToken" if token
                else "token 被中间层丢掉:这条路径无法续写,改走直连或 Interactions 后台执行")
    if reason == "MAX_TOKENS":
        hint = "(文字为空:预算全花在思考上)" if not text else ""
        tail = ",并附上这个 token" if token else ";没有 token,只能从头重来"
        return f"调高预算{hint}:提高 maxOutputTokens 后重发{tail}"
    if reason in ("SAFETY", "PROHIBITED_CONTENT", "BLOCKLIST", "SPII", "RECITATION", "LANGUAGE"):
        return f"内容拦截({reason}):改提示词或输入,原样重试没用"
    if reason in ("MALFORMED_FUNCTION_CALL", "UNEXPECTED_TOOL_CALL", "TOO_MANY_TOOL_CALLS",
                  "MISSING_THOUGHT_SIGNATURE", "MALFORMED_RESPONSE"):
        return f"工具或格式问题({reason}):检查工具声明、带回思考签名后重试"
    return f"其他({reason}):记录 finishMessage,重试一次"


def next_action_openai(resp: dict, max_tokens: int) -> str:
    """OpenAI 兼容接口:用满 max_tokens 就当作截断,不管 finish_reason 写的是什么。"""
    choice = (resp.get("choices") or [{}])[0]
    used = (resp.get("usage") or {}).get("completion_tokens", 0)
    if choice.get("finish_reason") == "length" or used >= max_tokens:
        return "被截断:调高 max_tokens;这个接口不能续写"
    return "完成" if choice.get("finish_reason") in ("stop", "tool_calls") else "需要人工检查"
走中转平台或 OpenAI 兼容接口:哪些情况续写不了
OpenAI 兼容接口续写不了。Google 自己的兼容端点 https://generativelanguage.googleapis.com/v1beta/openai/ 在长解码文档里写明不支持长解码,输出到单次上限就停;Interactions API 不开后台执行时,max_output_tokens 超过 65,536 会直接返回 400。中转平台能不能把 continuationToken 原样转回给你,取决于平台,公开资料里很少写明。需要超过单次上限的长回答,只有两条路:原生 generateContent 配合新版 SDK 或上一节的循环,或者 Interactions API 设 background: true、store: true、max_output_tokens 大于 65,536,由服务器在后台续写,最长运行 24 小时。
把 OpenAI SDK 指向 Google 或中转平台的地址,配置方法见 OpenAI base_url 怎么改:/v1、优先级与排错。在 Google 的兼容端点上,reasoning_effort 的 low、medium、high 对应 Argon 的同名思考级别,minimal 在 Google 的映射表里对应 low。
下表是 2026 年 10 月 28 日的实测,路径是“本机 HTTP 代理 → laozhang.ai 网关”,网关同时提供 Gemini 原生的 generateContent 和 OpenAI 兼容的 /v1/chat/completions。这只是一家平台、一个 key、一天的结果,不代表 Google 直连或其他平台。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
| 请求 | 返回 | 说明 |
|---|---|---|
原生非流式,maxOutputTokens 64,思考 low,长回答 | MAX_TOKENS,291 个字符,响应里没有 continuationToken | 无法续写,同样的请求再发一次是从头重写 |
原生非流式,maxOutputTokens 200,思考 high,数学难题 | MAX_TOKENS,文字 0 个字符(思考 197 + 输出 3 token) | 预算全被思考用掉 |
原生非流式,maxOutputTokens 40,000,只要求回复 OK | 200,STOP,“OK” | 没有出现 Google 文档所说的 400 |
原生,thinkingLevel 设为 minimal | HTTP 500,“上游服务异常,请重试,或联系网站客服”,code "402" | 网关替换了上游的报错 |
OpenAI 兼容,max_tokens 64,长回答 | completion_tokens 64,finish_reason "stop" | 明明被截断,却不是 "length" |
OpenAI 兼容,max_tokens 40,000,只要求回复 OK | "stop",5 个 token | 正常完成 |
原生非流式,maxOutputTokens 33,000,生成 2,500 行三语 CSV | 300.9 秒时连接被关闭,没有响应体 | 切断发生在代理还是网关,无法区分 |
| 原生流式 SSE,同上 | 993 个事件、74,760 个字符(写到第 1,065 行),302.5 秒时流结束 | 没有 finishReason、没有最终用量、没有检查点 token |
前两行说明,这条路径上的 MAX_TOKENS 不带 token,而 Google 文档写的是 Argon 的 MAX_TOKENS 仍会附带 token,所以在这种路径上只能调高预算从头重来。第五行说明,Chat Completions 截断时惯常返回的 "length" 在这里变成了 "stop",Google 的兼容文档也没有写明映射,可靠的判断是 completion_tokens 是否达到 max_tokens。第四行说明,网关可能把上游的真实报错换成一句笼统的提示,排查时先用一个极小的请求逐项改参数,找出是哪个字段触发的。11 次请求按 Google 标价(每 100 万 token 输入 $2、输出 $10)计算,并把两次中途断开的长请求按全额计入,最坏情况合计 $0.59。
流结束了却没有 finishReason,算成功吗
不算。每一跳正常结束时,最后一个数据块都会带 finishReason,流在没有它的情况下结束,说明连接被切断,回答不完整。接下来怎么做取决于有没有收到过检查点 token:收到过,就丢掉最后一个检查点之后的待定内容,带着那个 token 续上;没收到过(流在前 32,768 个 token 内断开),只能重发原请求。新版 SDK 的流式调用会自动从检查点恢复,连续 3 次重连没有进展才放弃。
上表最后一行就是这种情况:流里有 74,760 个字符,中间块报告的 candidatesTokenCount 是 0,结束时没有 finishReason,也没有任何检查点 token,所以没有可以续上的位置。两次长请求都在 300 秒左右被切断,远早于 Google 文档里服务器 10 分钟(非流式)和 20 分钟(流式)的断开时间,如果你也在固定时长处被切断,先查客户端、本机代理和中转平台各自的超时设置。按 Google 直连的计费规则,流在 32K token 之前断开不收费,之后按最后一个检查点收费;非流式请求失败或断开也不收费。
长解码后 prompt_token_count 为什么大好几倍
因为每一跳都会把原始提示加上之前生成的全部内容重新作为输入,SDK 再把各跳的输入加起来。Google 长解码文档的例子是:1,000 token 的提示生成 200,000 token 的思考和输出,走 SDK 需要 4 跳,各跳输入分别是 1,000、66,536、132,072、197,608,prompt_token_count 合计 397,216,total_token_count 约 597,000,而实际的上下文只有约 201,000;换成每跳 32K 的非流式 REST 循环要 7 跳,输入合计 695,128。
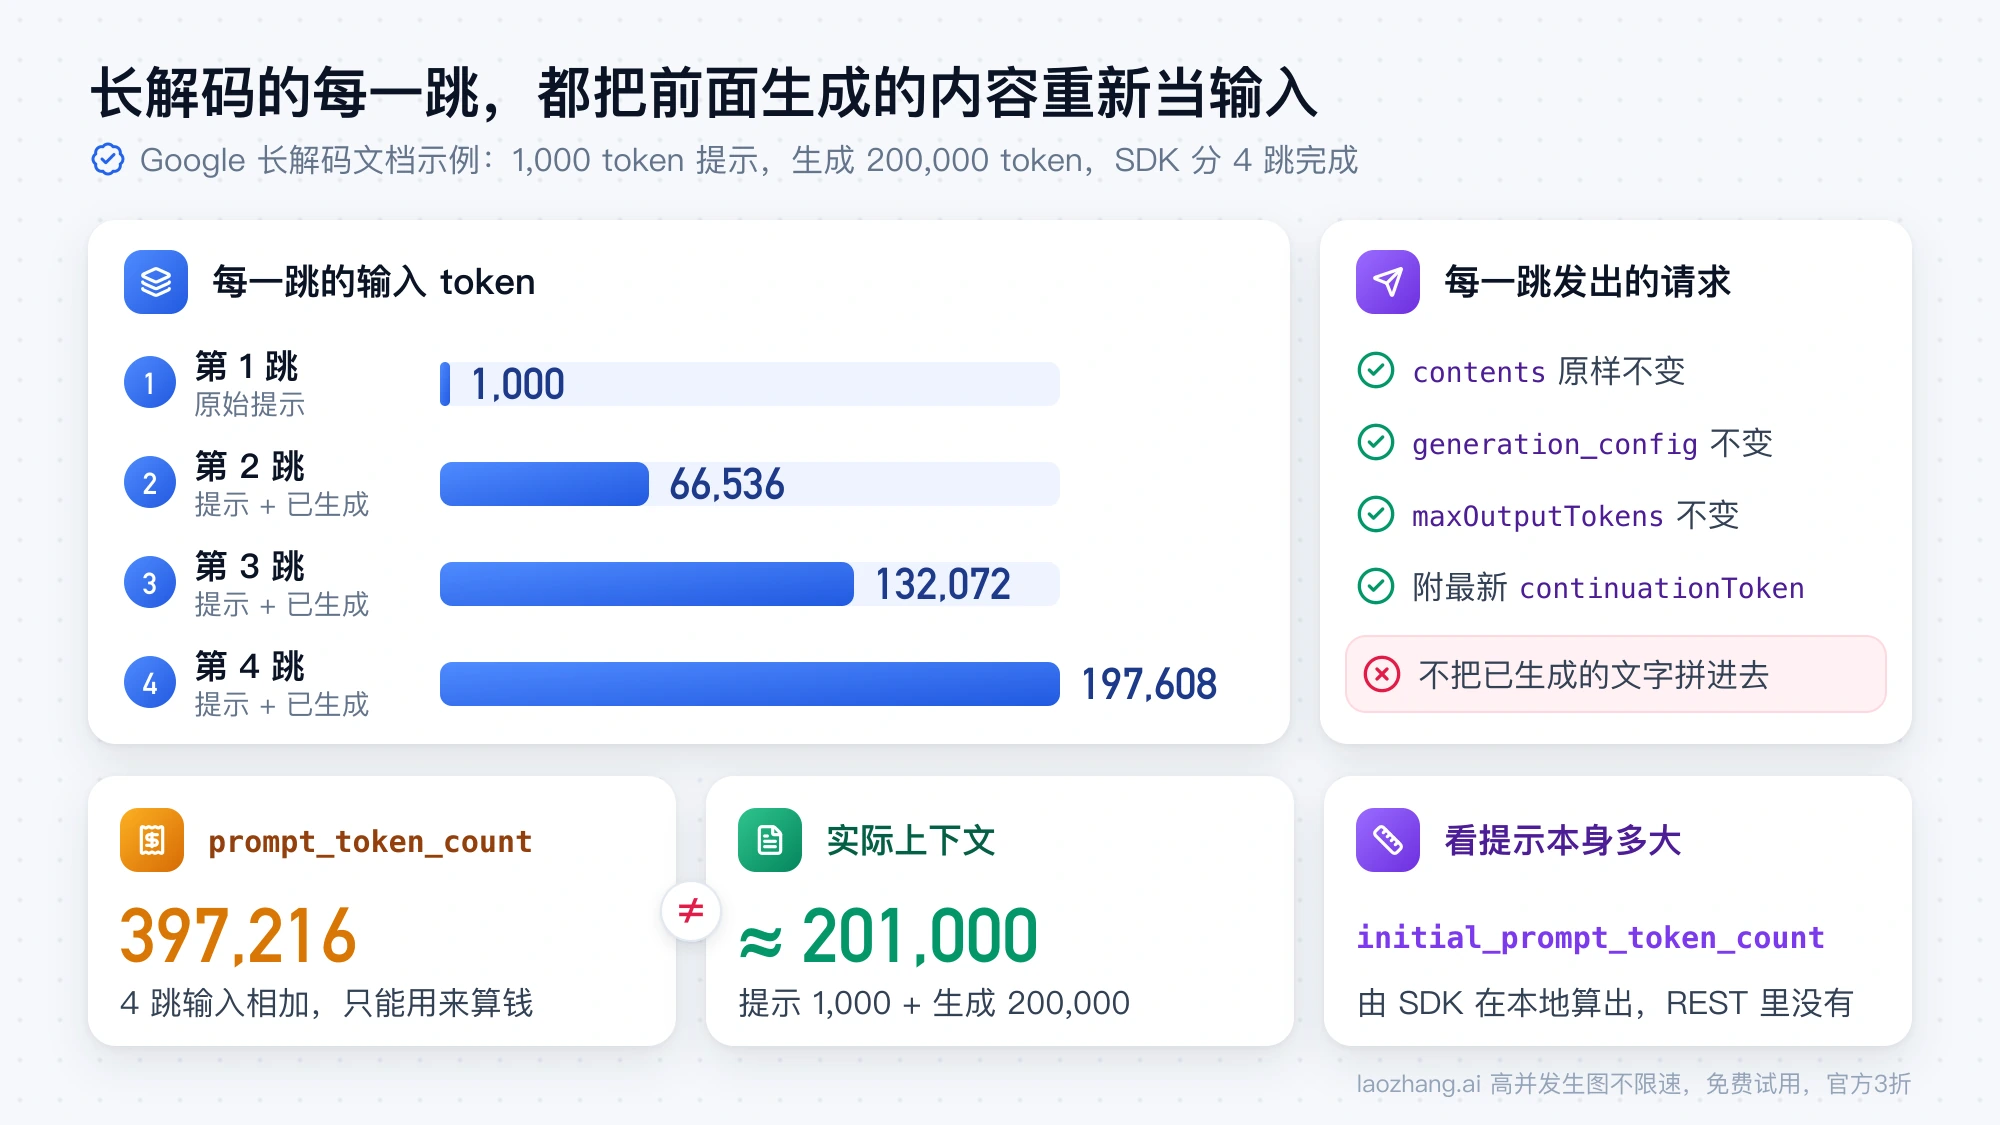
所以这两个累加值只能用来算钱,不能拿来判断上下文还剩多少,也不能用来触发对话压缩。要知道提示本身有多大,Python 读 usage_metadata.initial_prompt_token_count,JavaScript 读 usageMetadata.initialPromptTokenCount;这个字段由 SDK 在本地算出,REST 响应和 model_dump() 的输出里都没有,需要的话要单独保存。自己写循环或自己做中转时,各字段按跳相加用于计费,提示大小取第一跳的 promptTokenCount。
计费上,每一跳的每个 token 都要付费,只有思考的那一跳也一样。重复的跳间输入会命中隐式缓存,打 95% 的折扣,截至 2026 年 10 月 28 日,推广期内缓存输入是每 100 万 token $0.10,而不是 $2;缓存闲置 15 到 20 分钟就失效,跳与跳之间停顿太久,重复部分会按全价重新计费。
参考来源5
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月28日。
参考来源5
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月28日。
- 1.Gemini API 长解码文档(GenerateContent)ai.google.dev/gemini-api/docs/generate-content/long-decode
- 2.Gemini API generateContent 参考文档ai.google.dev/api/generate-content
- 3.Interactions 长解码文档ai.google.dev/gemini-api/docs/long-decode
- 4.Gemini API 价格页ai.google.dev/gemini-api/docs/pricing
- 5.Gemini API 可用地区列表ai.google.dev/gemini-api/docs/available-regions