Gemini 4 Argon、Opus 5.5、GPT-6.1 Sol 对比测评:半价不等于更省
Argon 按 token 到 11 月 30 日是 Opus 5.5 的半价,12 月 1 日起同价;开高档按任务算,同题实测和 AA 都是 Opus 更省。
文章目录
在 Gemini 4 Argon 和 Claude Opus 5.5 之间选一个做 API 开发,尤其是编程代理,截至 2026 年 11 月 11 日可以这样定:要开高档推理、或者输入很长又要求结果精确时,先用 Opus 5.5(claude-opus-5-5,effort 用 API 默认的 medium 或 high);只跑小而明确、出错可以重跑的任务时,Argon(gemini-4-argon)的默认档最便宜。同一批 8 道题经 LaoZhang 网关实测,Argon 默认档花 $0.093(12 月 1 日起 $0.187),Opus medium 花 $0.290,两边几乎全对;开到高档后,Argon high 花 $0.403(12 月起 $0.807),反而比 Opus high 的 $0.308 贵,因为它多写了 3.3 倍的输出 token。
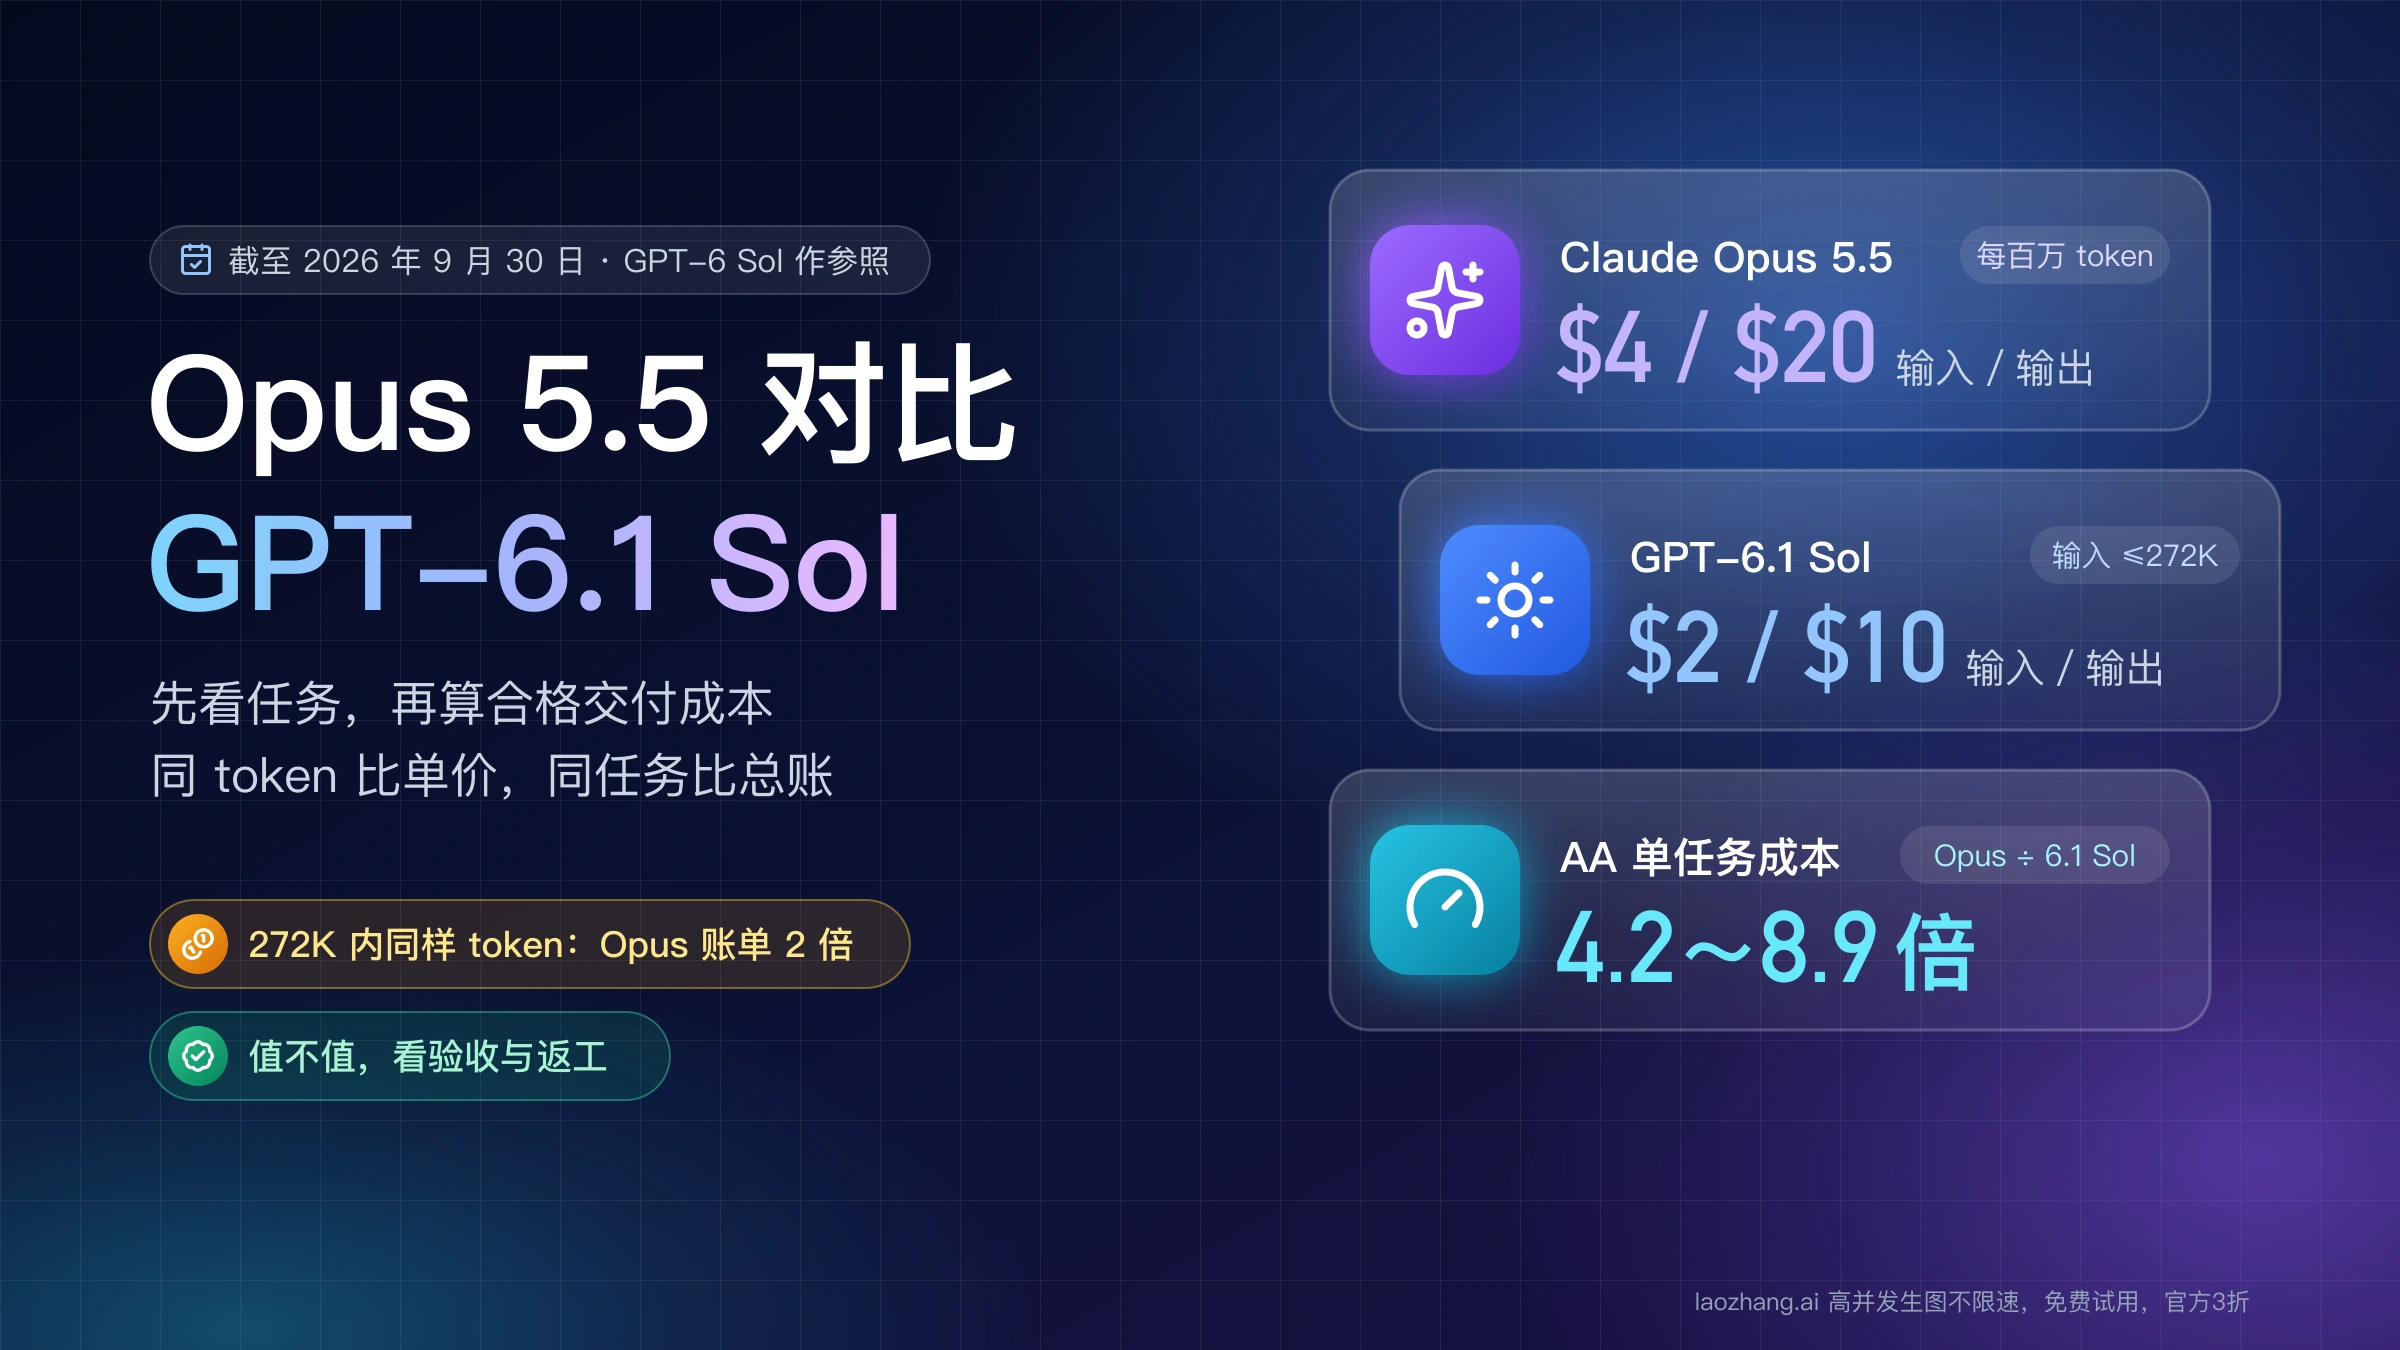
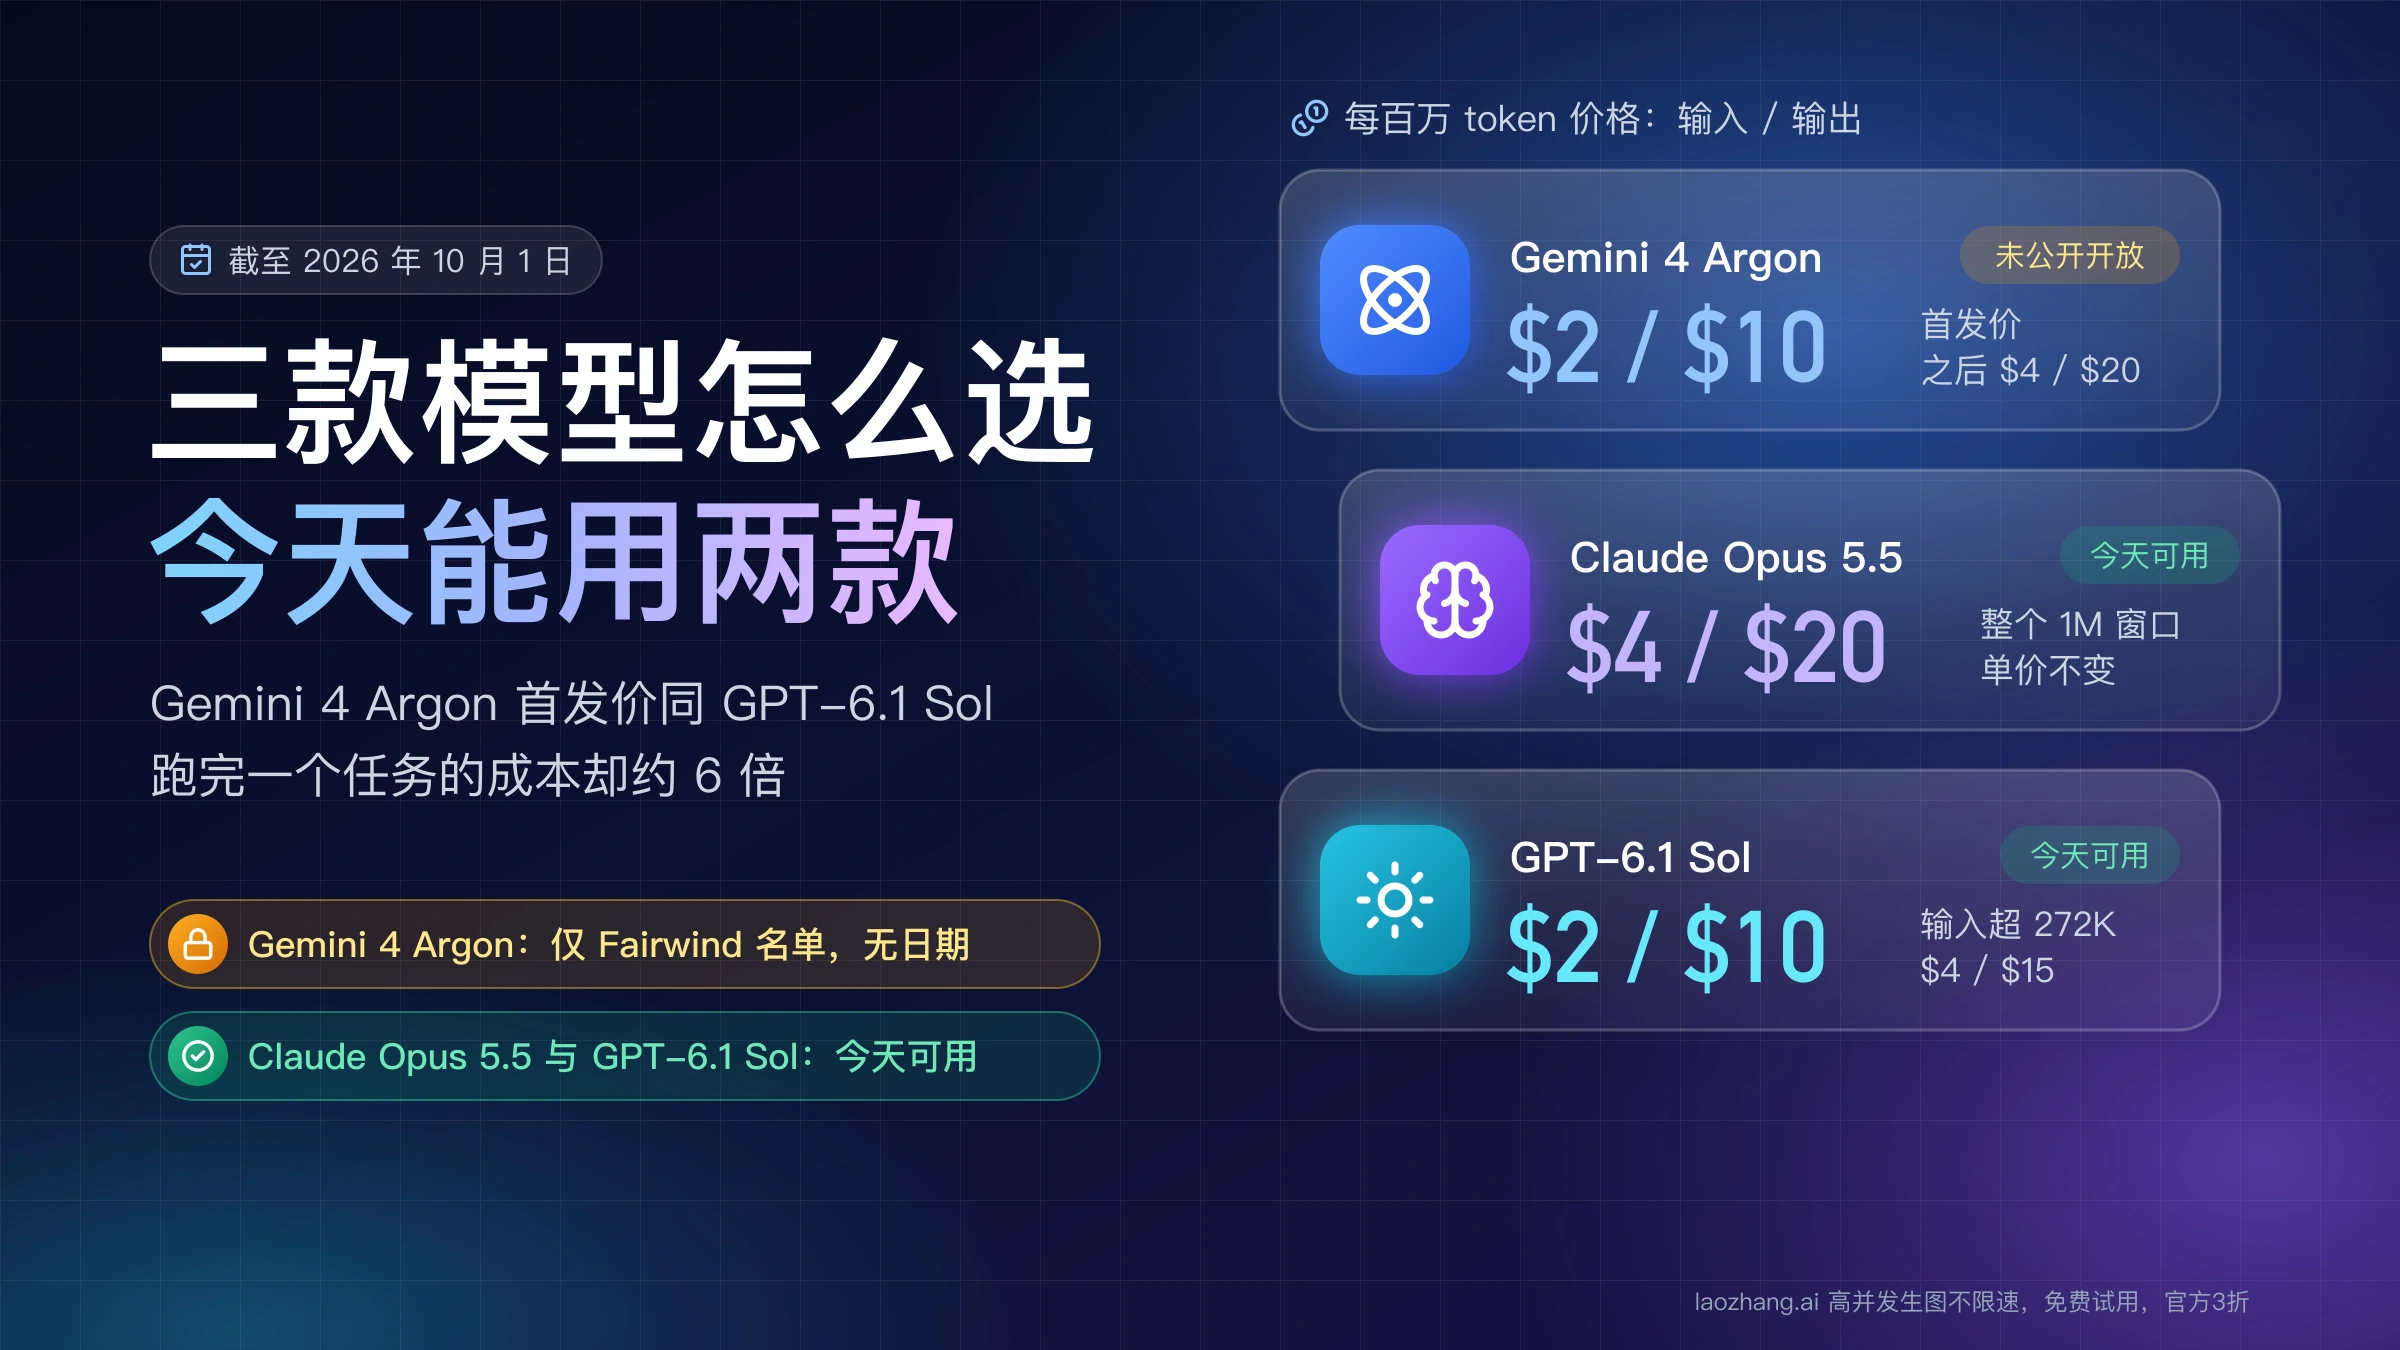
“Argon 是 Opus 的半价”只在按 token 计、并且在 11 月 30 日之前成立:Argon 的首发价是每百万输入 token $2、输出 $10,12 月 1 日起变成 $4/$20,和 Opus 5.5 完全同价。按任务算,在 Artificial Analysis(下称 AA)的 high 档上它从来不是半价,AA 截至 11 月 11 日给 Argon High 标的单任务成本是 $9.95(按 12 月价),比 11 月 4 日的 $7.68 上调了约三成,分数没变;换回首发价约 $4.98,已是 Opus High($3.46)的 1.44 倍,12 月起是 2.88 倍。GPT-6.1 Sol(常被简写成“GPT 6.1”,下文都指这一款)high 档 $0.59、同为 50 分,是三款里最便宜的参照。
所以 12 月 1 日前该做的,是拿自己的任务在两边各跑默认档和高档,记下通过率和每个合格结果的花费,再把 Argon 的费用乘以 2 比一次。中文提示词还要多算一层:同一段中文,Opus 5.5 计的输入 token 是 Argon 的 1.78 倍,12 月起单价相同后,这部分输入在 Opus 上要贵近八成。Argon 开高档时用流式调用,不开流式的长任务可能撞上 32,768 个输出 token 的上限,没有答案也照样计费。
三款今天在哪里能用:Argon 已于 10 月 13 日开放
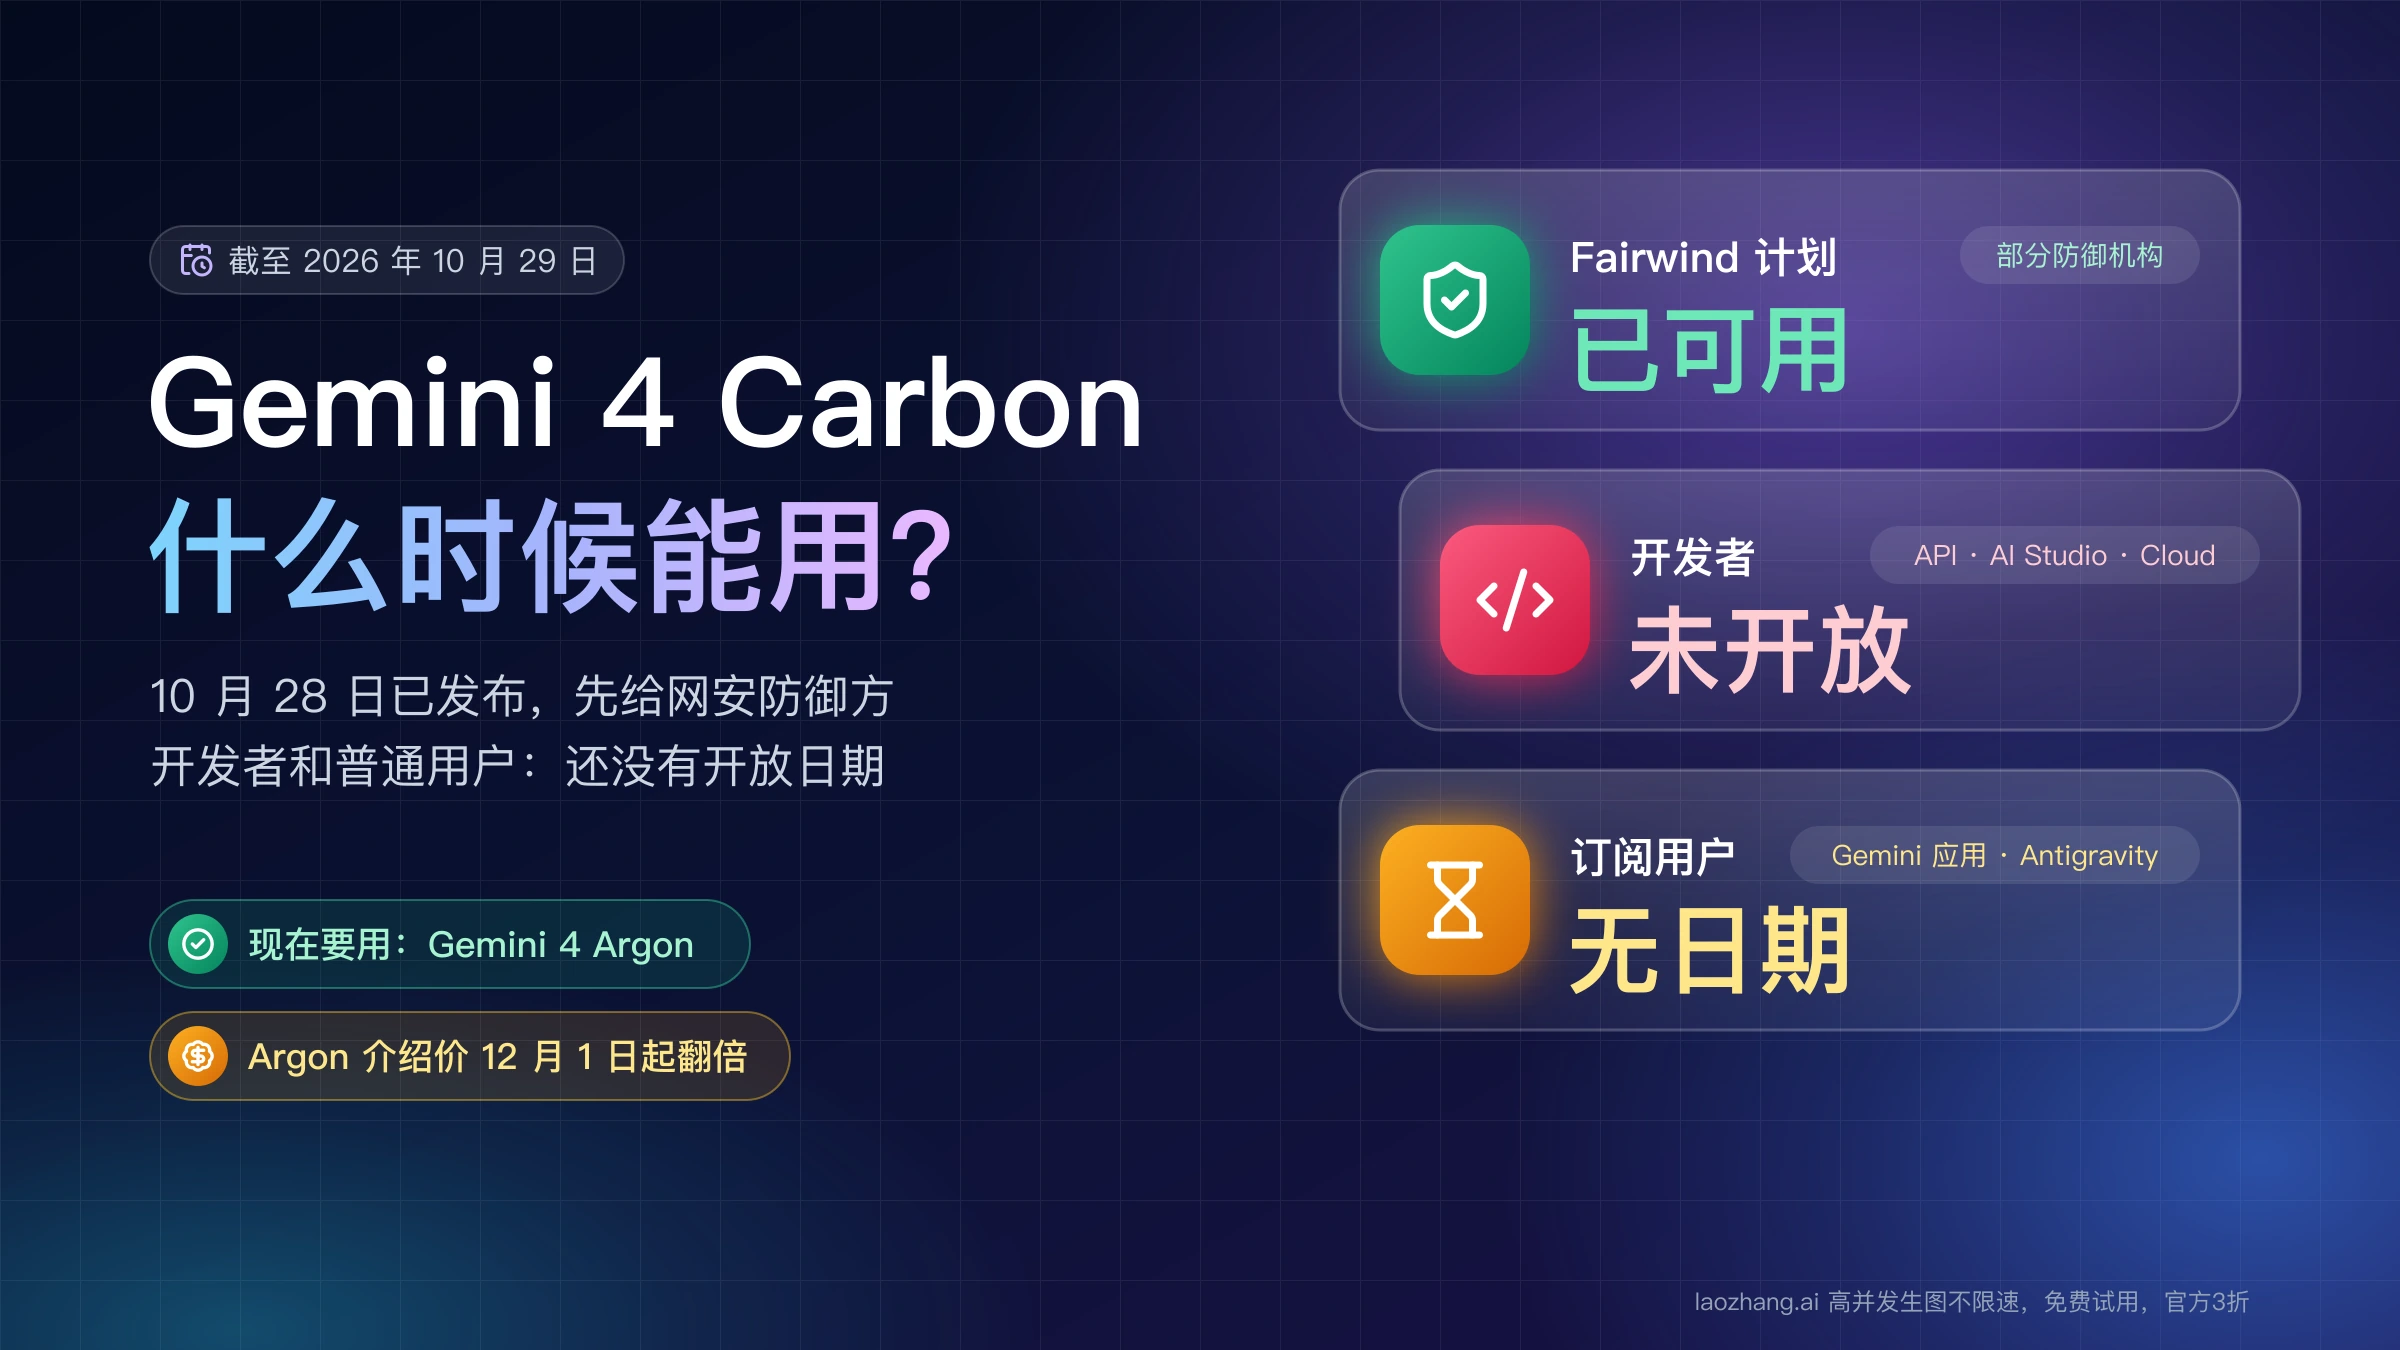
截至 2026 年 10 月 14 日,三款模型都能接进项目了。Gemini 4 Argon 在 9 月 30 日发布时只对 Fairwind 名单开放,Google 10 月 13 日的 Argon 开放公告宣布它面向开发者和企业开放:Gemini API 付费层的模型 ID 是 gemini-4-argon,AI Studio、Google Antigravity、Gemini 应用和搜索中的 AI 模式也能用,只是各有套餐门槛,API 免费层不在其中。Claude Opus 5.5 和 GPT-6.1 Sol 在那之前就已开放。
| Gemini 4 Argon | Claude Opus 5.5 | GPT-6.1 Sol | |
|---|---|---|---|
| 发布与开放 | 9 月 30 日发布,10 月 13 日开放 | 2026 年 9 月 22 日 | 2026 年 9 月 29 日 |
| API | Gemini API 付费层(AI Studio、Google Cloud 的 Gemini platform),免费层不可用 | Claude API,以及 AWS、Google Cloud、Azure | OpenAI API,工具调用需走 Responses API |
| 订阅与应用 | Gemini 应用和 AI 模式:Google AI Pro、Ultra;Google Antigravity:Ultra、付费的 Google AI Pro、随符合条件的高端设备附赠的 Pro 试用;Gemini for business | Claude 应用的 Pro、Max、Ultra、Team、Enterprise(Free 不含);Claude Code | ChatGPT Work 与 Codex(Plus、Pro、Business、Enterprise、Edu) |
| 模型 ID | gemini-4-argon | claude-opus-5-5 | gpt-6.1-sol |
| 上下文 | 1,048,576,输入和输出共用 | 1M | 1,050,000 |
| 最大输出 | 同步调用流式最多 65,536、非流式 32,768;long decode 最多 1,048,576 | 128K | 128,000 |
| 输入/输出(每百万 token) | 到 11 月 30 日 $2/$10,12 月 1 日起 $4/$20 | $4/$20 | 输入不超过 272K 时 $2/$10,超过后 $4/$15 |
| 缓存读取(每百万 token) | $0.10,12 月 1 日起 $0.20;只有隐式缓存 | $0.20 | $0.10,超过 272K 后 $0.20 |
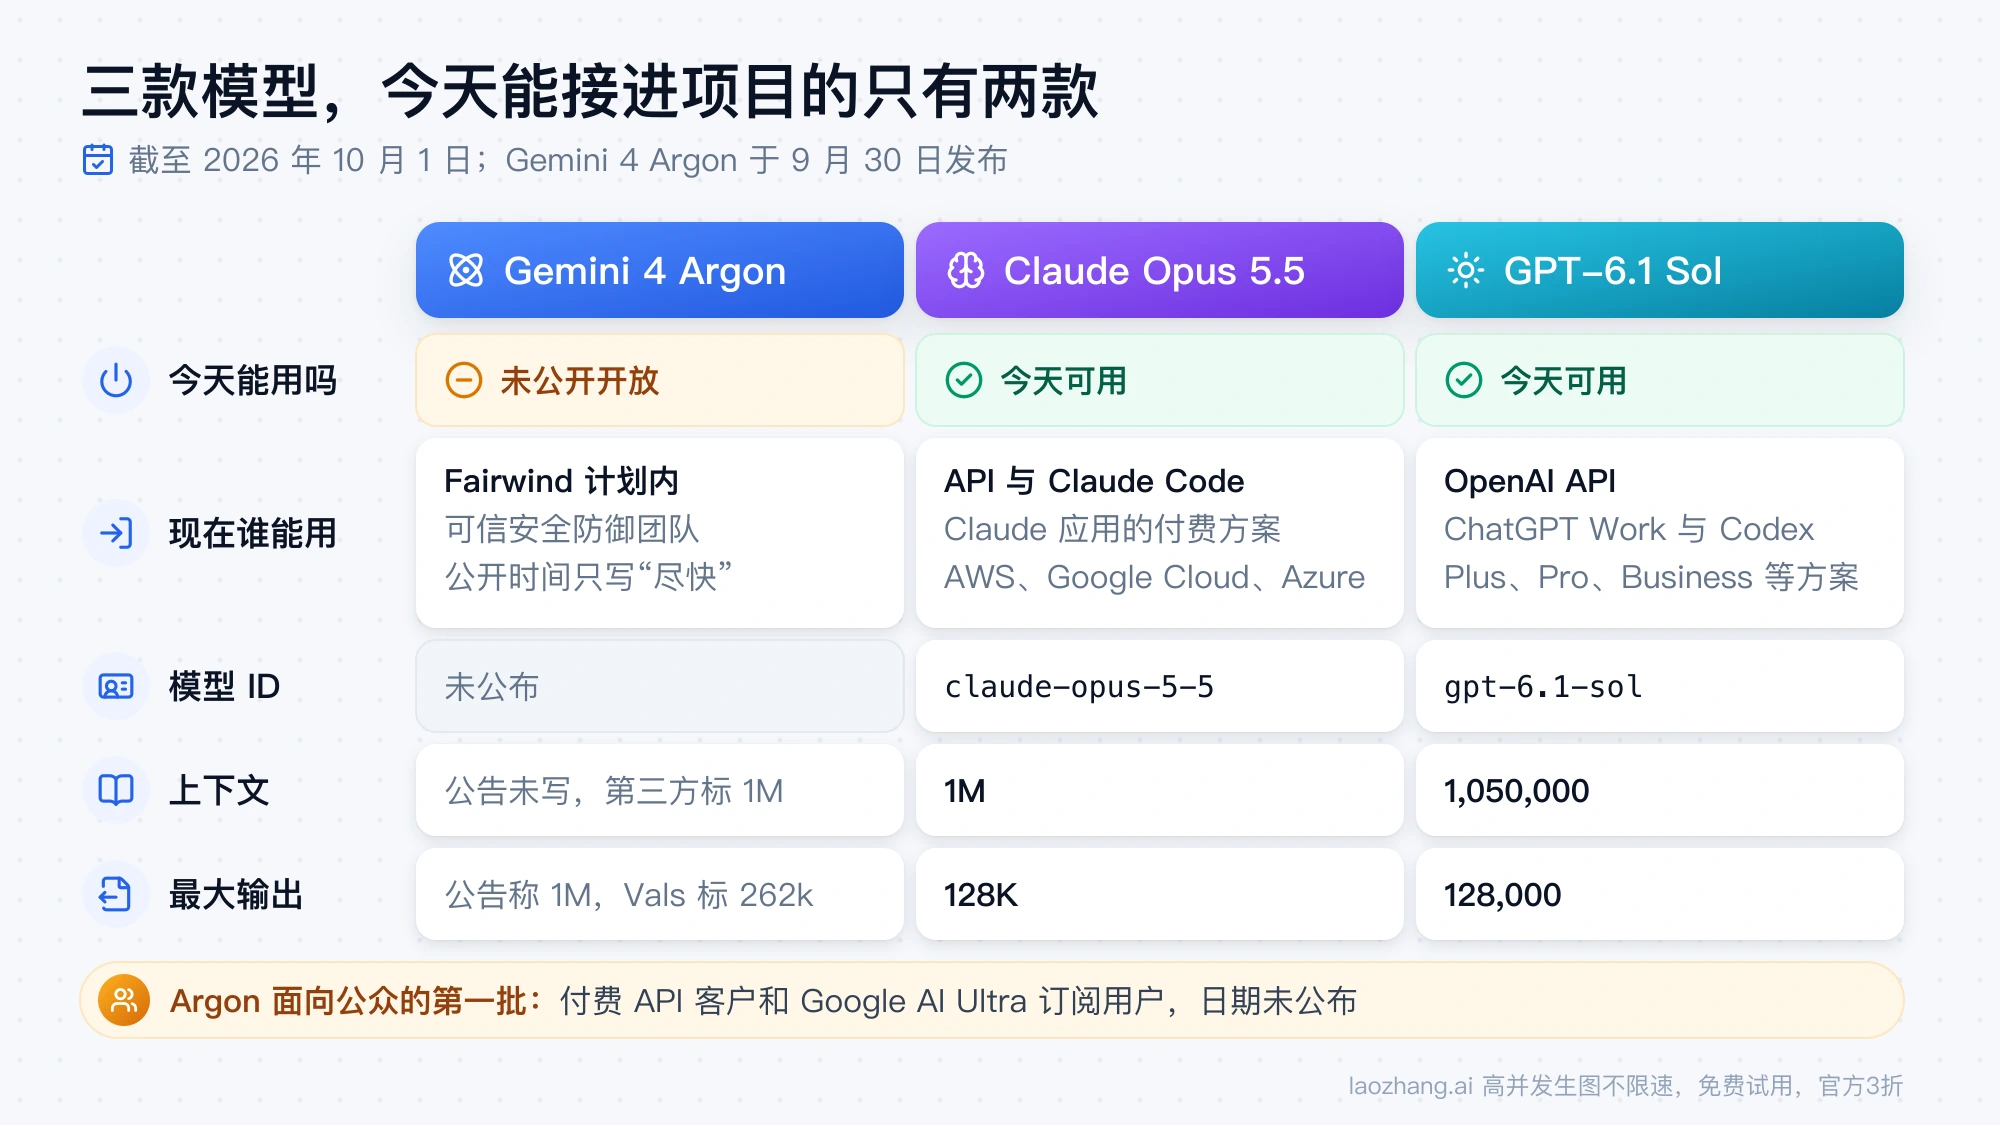
图为 2026 年 10 月 1 日的状态;Gemini 4 Argon 已于 10 月 13 日开放,以正文和上表为准。
Argon 的入口要按产品分开看。走 API 的话,Google 给的路径是 Gemini API 付费层,在 AI Studio 和 Android Studio 里都能接;Google Cloud 博客的 Argon 上线文章写的是 Gemini platform,模型 ID 同样是 gemini-4-argon。Gemini API 模型列表把它放在 Gemini 4 的稳定版(Stable)下面。用订阅的话,Gemini 应用和搜索中的 AI 模式对 Google AI Pro、Ultra 订阅者开放,企业用户在 Gemini for business 的网页、桌面和移动端里用。公告没有提到 Google AI Plus 和免费版 Gemini 应用。Google Antigravity 的开放范围后来放宽了:公告当时只写 Ultra,截至 2026 年 10 月 23 日,Antigravity 的模型页列出的是付费的 Google AI Pro,以及随符合条件的高端设备附赠的 Pro 试用(这是 Google 的原话,没有列出具体是哪些设备),普通免费试用没有被列入;10 月中旬文档改动前,有用户反馈手机套餐赠送和促销渠道的 Pro 用不了;能用的位置是 Antigravity app、CLI 和 IDE 扩展,Antigravity IDE 里没有。Pro 仍在逐步推送,有付费用户反馈暂时还看不到 Argon。
容易混的是 Google AI Pro。截至 2026 年 11 月 11 日,Gemini API 价格页对 Argon 只写了一句不在免费层(Not available on the Free tier);Google 的 AI Studio 套餐文档则写明,免费用户在 AI Studio 里用不了 Argon,Google AI Pro 有更高的额度(higher quota)可以用,Ultra 是最高额度(highest quota)。这些说的是 AI Studio 里的使用额度,API 调用本身不包含在任何订阅里:想在自己的代码里调用 Argon,仍然要单独开通付费的 Gemini API 和结算账号。同一个 Pro 订阅在 Gemini 应用和 AI 模式里也能用 Argon,付费的 Pro 和随符合条件的高端设备附赠的 Pro 试用在 Antigravity 里同样可用。
Claude 这一侧,截至 2026 年 11 月 6 日,Free 方案不含 Opus 5.5,也不含 Claude Code;Pro、Max($100)、Ultra($200)、Team 和 Enterprise 都能用,其中 Max 和 Ultra 是 10 月 30 日由 Max 5x、Max 20x 改名而来。两家的订阅都不覆盖 API 调用。另外,Anthropic 的支持国家与地区列表和 Gemini API 的可用地区列表里都没有中国大陆和香港,两款模型都不向这两地的账号正式开放;各自的入口和免费路线见「Gemini 4 Argon 怎么用?免费版不含,0 元路线与实测单次成本」和「Claude Opus 5.5 怎么用:6 个入口怎么选,免费只有限时限额试用」。
Argon 的 Gemini API 模型页列出的能力:输入支持文本、图片、视频、音频和 PDF,输出只有文本;思考等级有 low、medium、high 三档,不设置时默认 medium;支持函数调用、结构化输出、代码执行、使用 Google 搜索建立依据、URL 上下文、文件搜索和计算机使用(预览版),不支持图片生成、音频生成和 Live API。速率限制在公告、模型页和价格页上都没有写,开通后以 AI Studio 里显示的额度为准。
Fairwind 现在只和一件事有关:不带网络安全护栏的 Argon。Google 在 10 月 13 日的公告里说,这个版本会分批开给 Fairwind 计划的合作方,并开始扩展到另外数百家。资格门槛可以看「Gemini 3.8 Flash Cyber 怎么申请 Fairwind:资格、限制与准备清单」;那篇是为 3.8 Flash Cyber 写的,Argon 版本的申请步骤 Google 没有单独公布。普通的 API 和订阅用户不需要走 Fairwind。
另外两款的细节不在这里展开:Opus 5.5 的计费规则见「Claude Opus 5.5 价格与用量重置:API 账单怎么算,重置卡怎么用」,GPT-6.1 Sol 的入口和迁移改动见「GPT-6.1 Sol 怎么用:价格变化、迁移改动与可用入口」。
牌价:首发期到 11 月 30 日与 Sol 同价,之后与 Opus 同价
截至 2026 年 11 月 11 日,Gemini API 价格页仍给 Argon 列着两套价格,以 11 月 30 日为界。Google 把前一段叫作首发期(introductory period),没有说会延长;12 月 1 日起,标准、Batch、Flex、Priority 四档的输入、输出和缓存单价全部翻倍:
| Gemini 4 Argon,每百万 token | 到 2026 年 11 月 30 日 | 2026 年 12 月 1 日起 |
|---|---|---|
| 标准:输入 | $2.00 | $4.00 |
| 标准:输出(含推理 token) | $10.00 | $20.00 |
| 标准:缓存输入 | $0.10 | $0.20 |
| Batch 与 Flex:输入/输出/缓存输入 | $1.00/$5.00/$0.05 | $2.00/$10.00/$0.10 |
| Priority:输入/输出/缓存输入 | $3.60/$18.00/$0.18 | $7.20/$36.00/$0.36 |
几个容易漏的条件:Argon 只有隐式缓存,不支持显式缓存,因此没有缓存写入费和存储费;没有长输入加价档,整个窗口一个单价;没有免费层。使用 Google 搜索建立依据时,每月 5,000 次免费请求由 Gemini 3 及更新的型号共用,超出后每 1,000 次 $14。
把三家的标准档牌价写成算式,设新输入为 U、缓存读取为 R、输出(含推理 token)为 O,单位都是百万 token:
| 模型与档位 | 费用(美元) |
|---|---|
| Gemini 4 Argon,到 11 月 30 日 | 2U + 0.10R + 10O |
| Gemini 4 Argon,12 月 1 日起 | 4U + 0.20R + 20O |
| GPT-6.1 Sol,输入不超过 272K | 2U + 0.10R + 10O,缓存写入另计每百万 $2.50 |
| GPT-6.1 Sol,输入超过 272K | 4U + 0.20R + 15O,整个请求都按这一档 |
| Claude Opus 5.5 | 4U + 0.20R + 20O,5 分钟缓存写入另计每百万 $5 |
代入一个例子:一次请求用 10 万新输入、2 万输出,没有缓存。现在的 Argon 是 0.1 × 2 + 0.02 × 10 = $0.40,GPT-6.1 Sol 同样是 $0.40,Opus 5.5 是 0.1 × 4 + 0.02 × 20 = $0.80;12 月 1 日起,Argon 也是 $0.80。
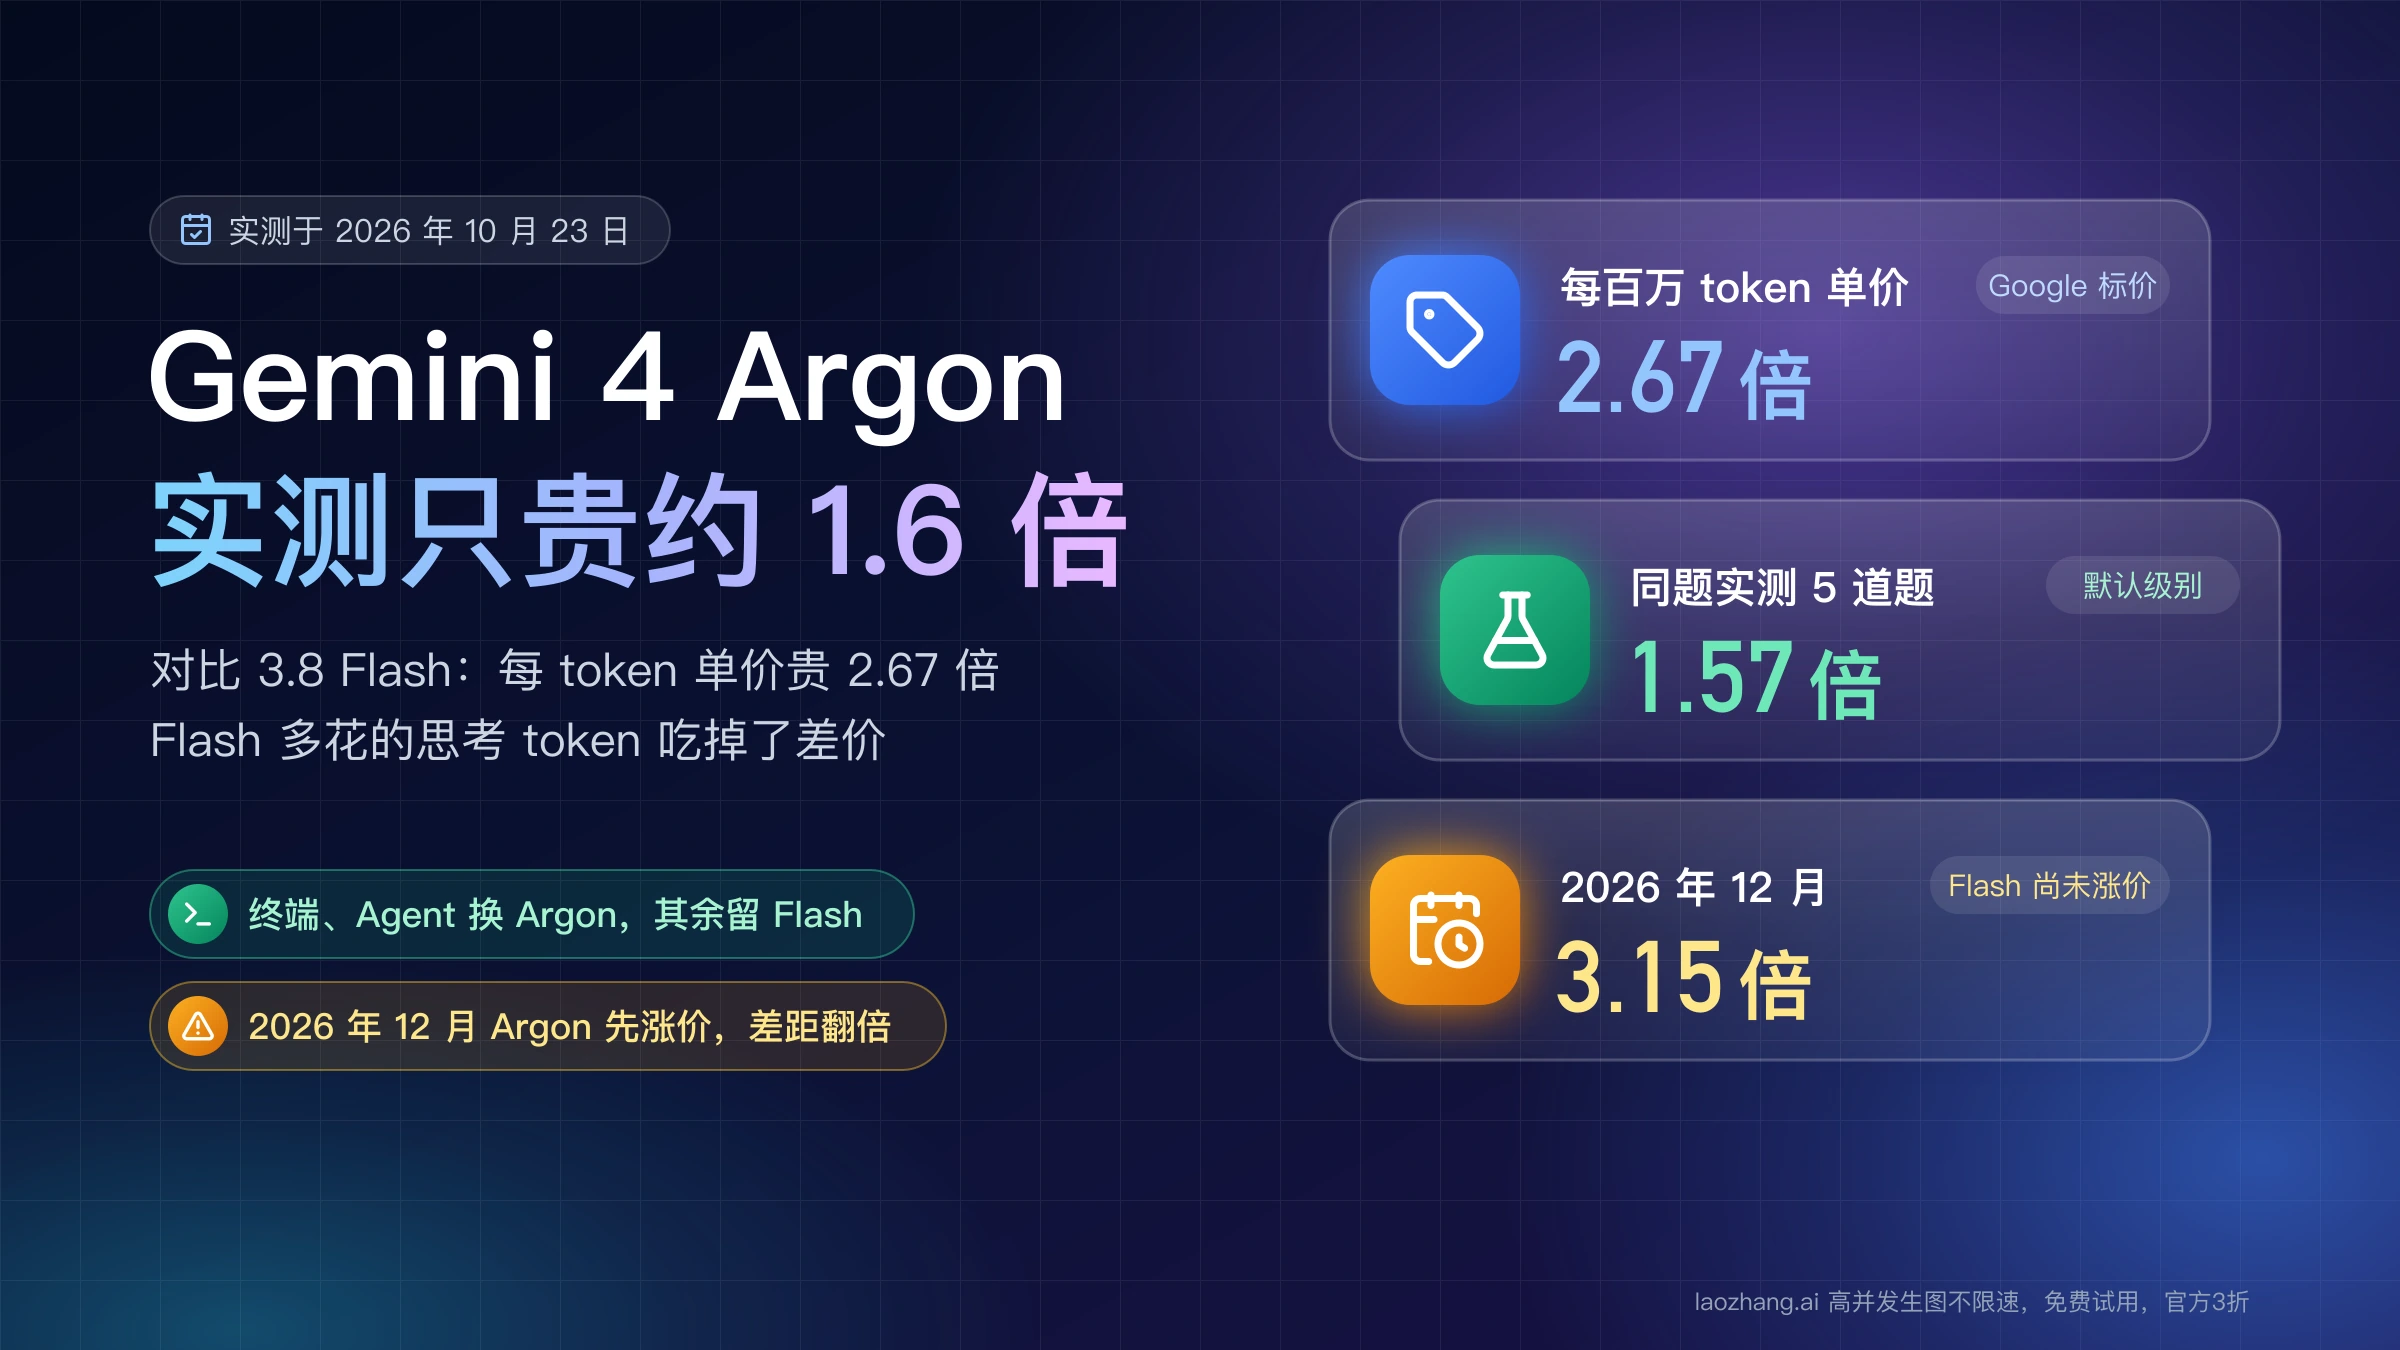
也就是说,token 数量相同时,11 月 30 日之前的 Argon 等于 GPT-6.1 Sol、等于 Opus 的一半;12 月 1 日起,它和 Opus 的输入、缓存读取、输出三项单价完全一样,区别只剩 Opus 的缓存写入要另付钱。批量任务也是同样的关系:Argon 的 Batch 价现在是 $1/$5,和 GPT-6.1 Sol 在 272K 以内的 Batch 价一样;12 月起是 $2/$10,和 Opus 5.5 的 Batch 价一样。GPT-6.1 Sol 超过 272K 输入会整单跳档,Argon 和 Opus 都没有这一档。如果你的预算要管到明年,Argon 应该按 $4/$20 来算,$2/$10 只是到 11 月 30 日为止的首发价。
“Argon 是 Opus 半价”这句话,只在这两个条件同时满足时成立:按 token 计,并且在 11 月 30 日之前。而同一段文字在两家算出的 token 数本来就不一样。2026 年 11 月 4 日和 11 日经 LaoZhang 网关把同一段文字分别发给两款模型,减去只含指令时的基数后,一段 246 个字符的中文,Opus 5.5 计 247 个输入 token,Argon 计 139 个,是 1.78 倍;6,723 个英文单词的长文是 1.38 倍;由数字和 ID 组成的 146 KB 日志几乎一样(0.99 倍)。所以 12 月起两家单价相同,同样的中文提示词在 Opus 上的输入费用仍要多出近八成;输出 token 取决于任务和推理档位,见下面两节。
OpenAI 与 Anthropic 的现行单价可在 GPT-6.1 Sol 型号页和 Claude 价格页核对;截至 10 月 14 日,两款的标准档单价与 10 月 1 日相同,Anthropic 截至 11 月 10 日也没有宣布 Opus 5.5 调价。
跑完一个任务要花多少:Argon 现价 $4.98,Opus $3.46,Sol $0.59
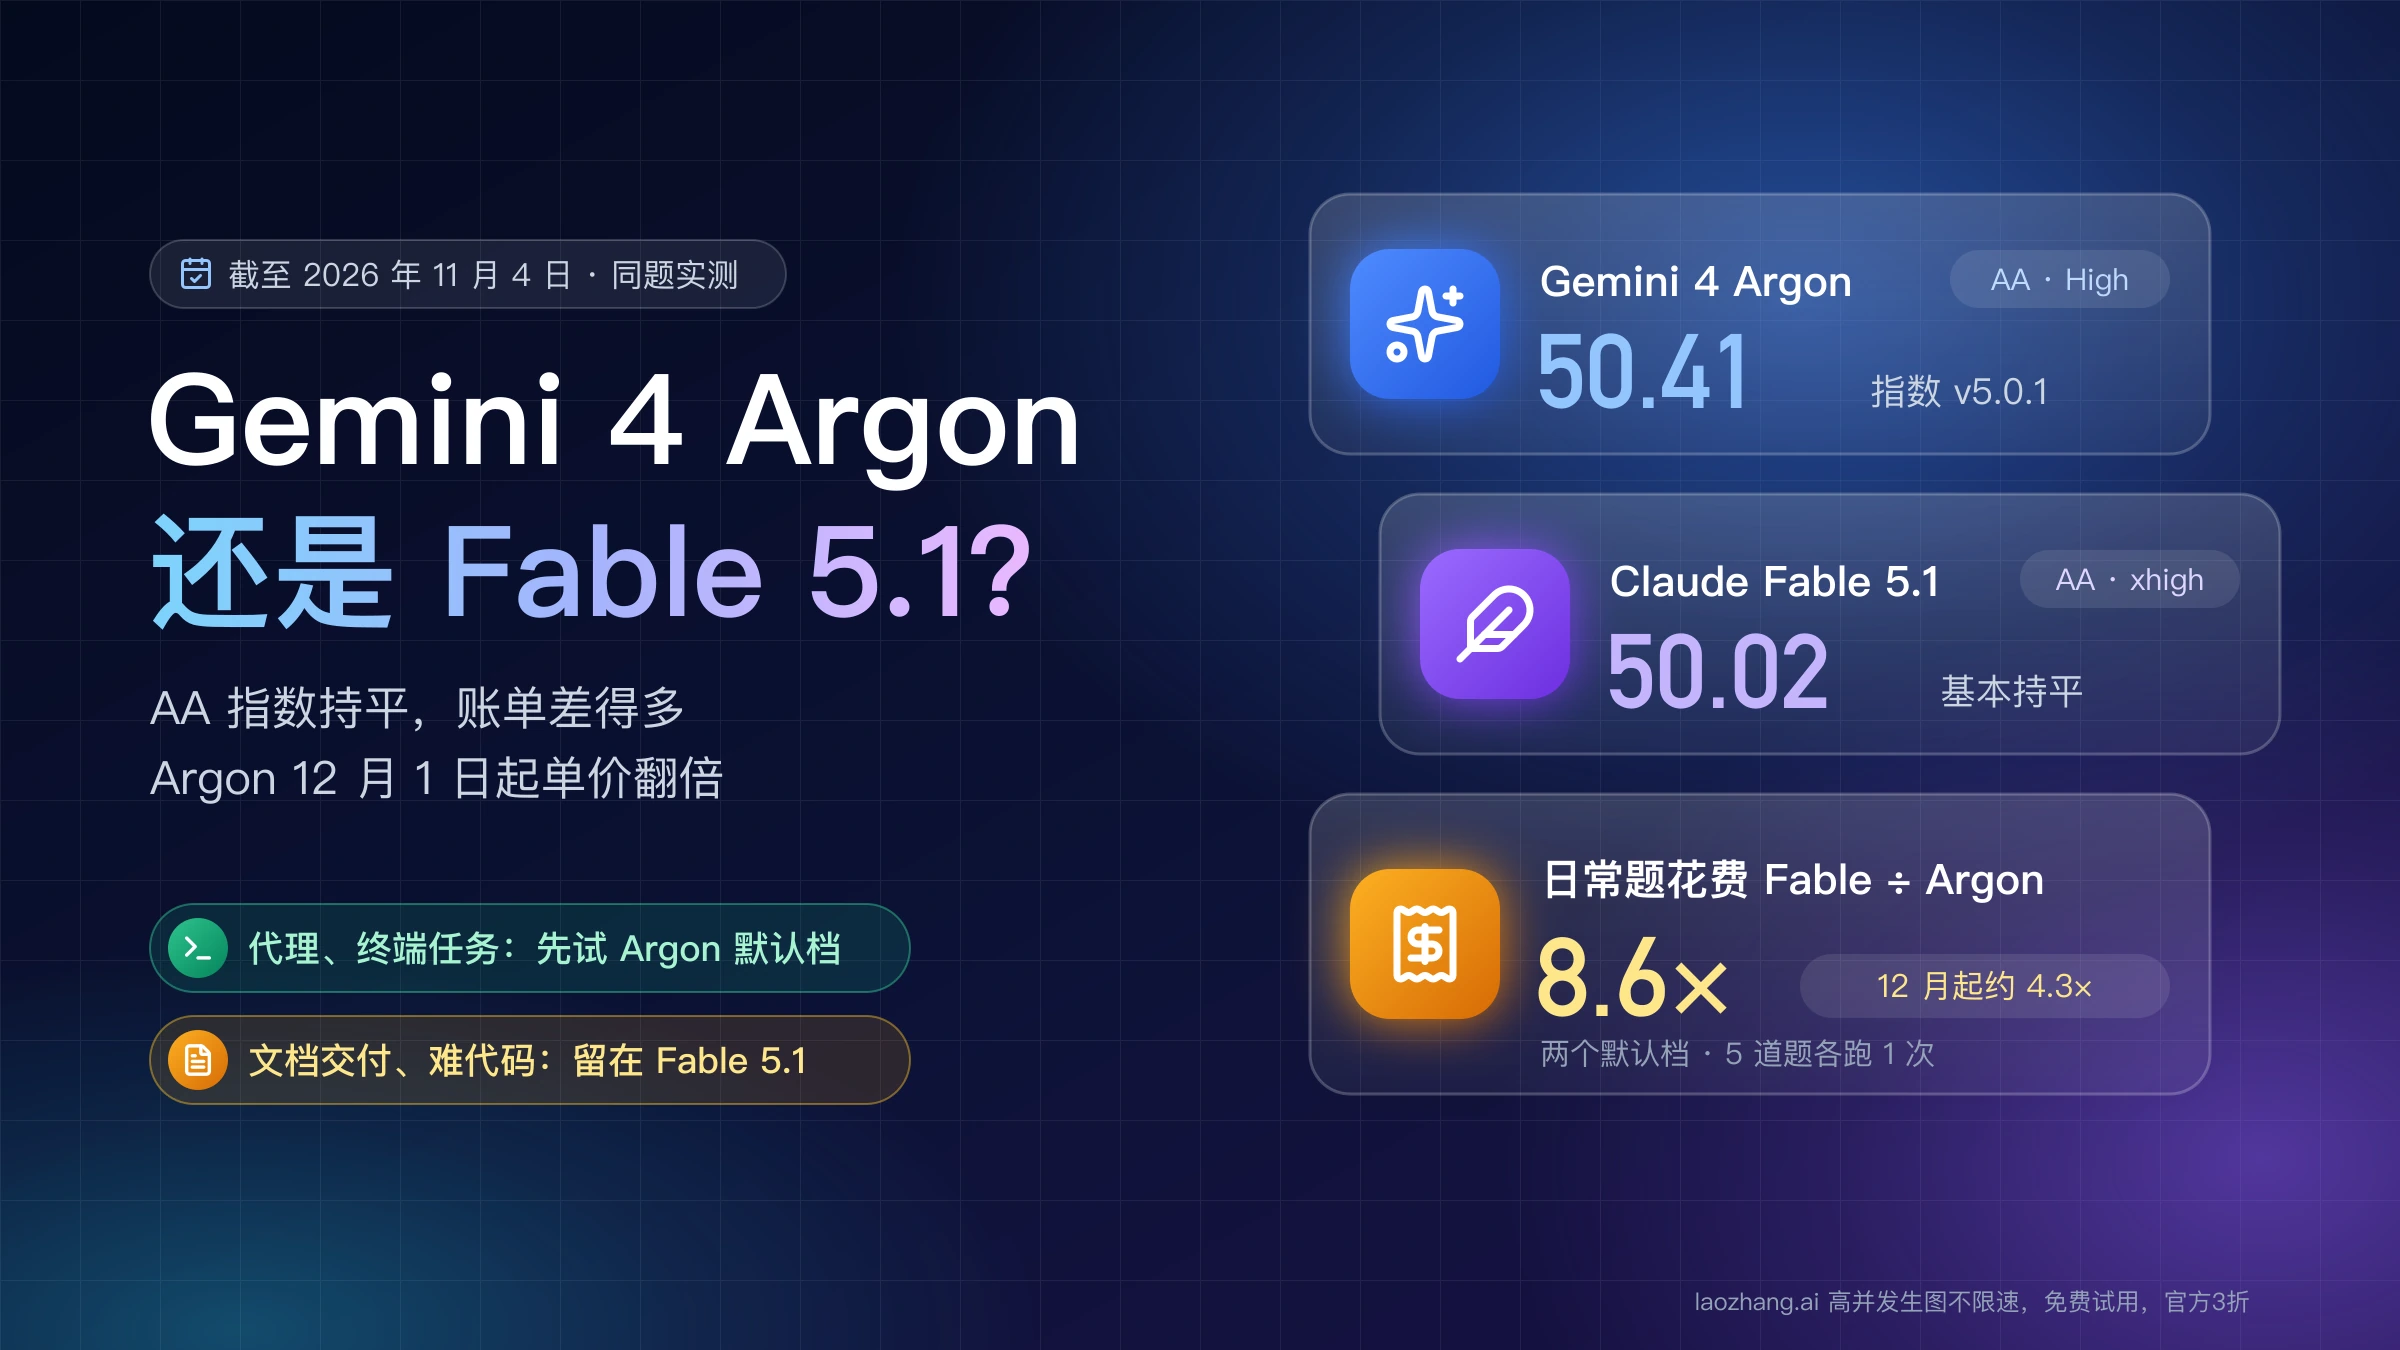
按 AA 的智能指数(Intelligence Index v5.0.1,由 9 项评测组成)同取 high 档,截至 2026 年 11 月 11 日,Argon 跑完一个任务按首发价约 $4.98、12 月 1 日起 $9.95,Opus 5.5 是 $3.46,GPT-6.1 Sol 是 $0.59。牌价算式有个前提:三款模型消耗的 token 一样多。实际上不会一样,推理 token 的多少差别尤其大,AA 同时公布综合得分和跑完指数的平均单任务成本,正好能看出这一层差别。AA 在 2026 年 10 月 27 日到 28 日之间把指数从 v4.3.2 换成了 v5.0,此前引用的分数和成本与这里不同;2026 年 11 月的 v5.0.1 只重新评分了其中的 CritPt 一项。
| 模型(high 档) | 综合得分 | 单任务成本,现在 | 单任务成本,12 月 1 日起 |
|---|---|---|---|
| Gemini 4 Argon | 50 | 约 $4.98(AA 数字减半,按 $2/$10) | $9.95(AA 页面数字,按 $4/$20) |
| Claude Opus 5.5 | 52 | $3.46 | $3.46,单价不变 |
| GPT-6.1 Sol | 50 | $0.59 | $0.59,单价不变 |
数字出自 Artificial Analysis 的 Argon 页面和 AA 的 Argon 与 Opus 5.5 对比页,截至 2026 年 11 月 11 日;Opus 与 Sol 的 high 档数字截至 11 月 4 日至 10 日。AA 给 Argon 用的是 12 月起的 $4/$20,Argon 的各项单价在 11 月 30 日前正好都是一半,所以“现在”一栏的 $4.98 是把 AA 数字减半的结果,不是 AA 公布的数。AA 自己的数字也在变:11 月 4 日它给 Argon High 标的是每任务 $7.68、22.7 分钟,跑完整个指数 $6,103;到 11 月 11 日变成 $9.95、28.6 分钟、$7,620,上调约 30%,而综合 50 分和九个分项得分一项没变,页面上没有说明原因。早先由 $7.68 折算出来的“首发价约 $3.84”以及相关倍数,都已经不适用。
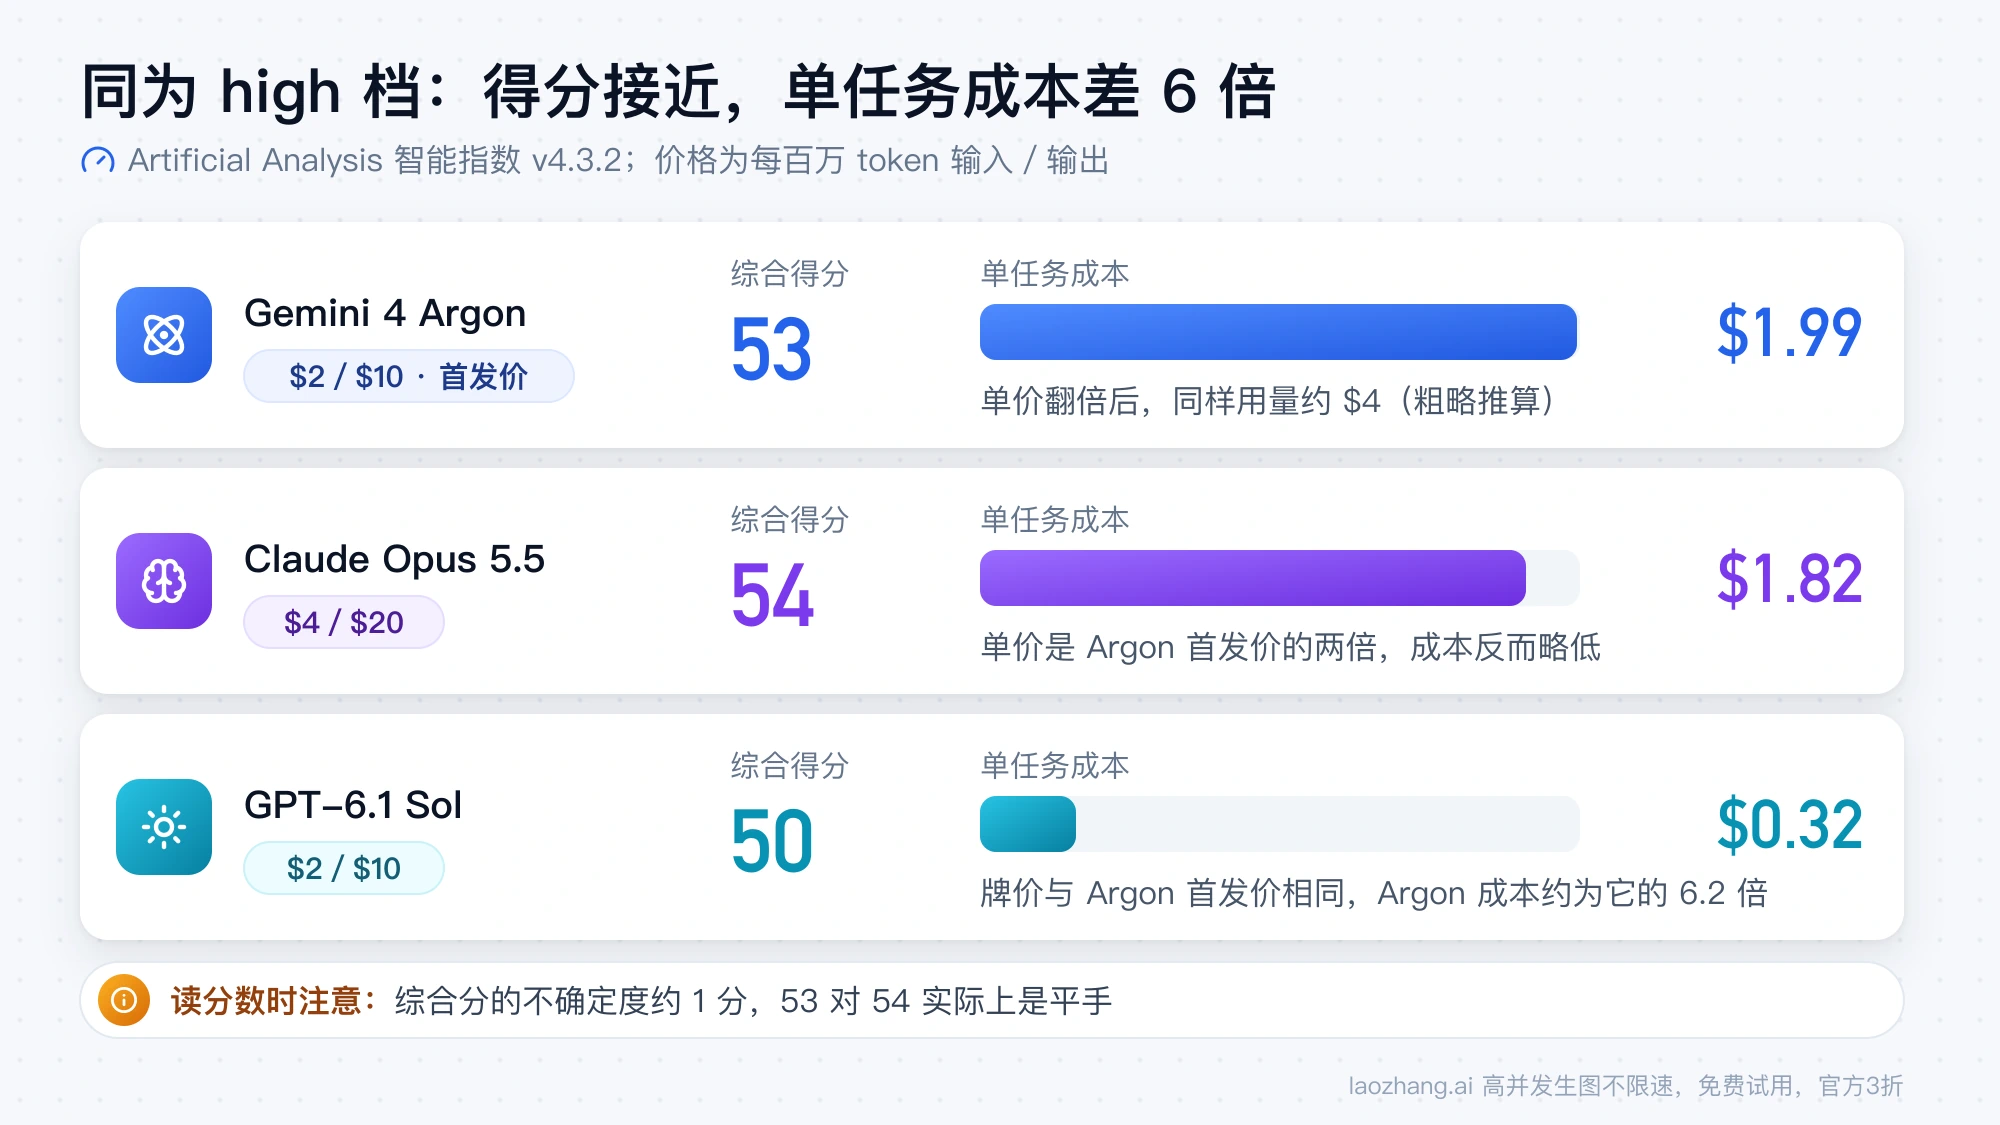
此图为 Artificial Analysis 旧版 v4.3.2 指数的数字(例如 Argon 53 分、$1.99),现行 v5.0.1 数字见上表。
从这张表能读出三件事:
- Argon 与 GPT-6.1 Sol 牌价相同、得分同为 50,单任务成本却是 4.98 ÷ 0.59 ≈ 8.4 倍,12 月起 9.95 ÷ 0.59 ≈ 16.9 倍。差出来的不是单价,是用掉的 token:AA 记录 Argon 平均每个任务输出 11.6 万 token,其中推理 6.83 万,跑完整个指数共输出 1.13 亿 token。
- Argon 的单价只有 Opus 的一半,单任务成本反而高出 44%(4.98 ÷ 3.46 ≈ 1.44),得分还低 2 分。在这套评测里,半价被更多的 token 抵消了,而且抵消得比 11 月 4 日的数字显示的更多。
- 12 月 1 日起,Argon 的单任务成本就是 AA 现在显示的 $9.95,是 Opus high 档的 2.88 倍(9.95 ÷ 3.46)。到那时,Opus 开到 xhigh(57 分、$6.05)比 Argon high 高 7 分,花费还少 39%;开到 max(59 分、$10.04)和 Argon high 花费几乎相同,分数高 9 分。AA 的 Argon 与 Opus 对比页摆的正是这一组:Argon High 50 分、$9.95、每任务 28.6 分钟,对 Opus Max 59 分、$10.04、24.7 分钟。
这些是评测里的 token 用量算出来的成本,不是你的账单。换成合格交付来算更直观,公式是每次尝试的花费 ÷ 通过率:按 AA 的 token 用量,Argon High 只有在你的任务上通过率超过 Opus High 的 1.44 倍(12 月起 2.88 倍)时才更省;反过来,GPT-6.1 Sol High 的通过率只要达到 Argon High 的 11.9%(12 月起 5.9%),就比 Argon 便宜。这里没算复核时间和重试。速度也是 Opus 占优,AA 记录 Argon High 平均每个任务 28.6 分钟,Opus High 是 9.5 分钟,约为三分之一。
推理强度换一档,位置也会变。Argon 的模型页列了 low、medium、high 三档思考等级,但 AA 目前只发布了 high 档;另外两款各有五档:
| 推理强度 | Opus 5.5 得分/成本 | GPT-6.1 Sol 得分/成本 |
|---|---|---|
| low | 35/$0.98 | 35/$0.16 |
| medium | 48/$2.45 | 46/$0.36 |
| high | 52/$3.46 | 50/$0.59 |
| xhigh | 57/$6.05 | 52/$0.76 |
| max | 59/$10.04 | 55/$1.27 |
GPT-6.1 Sol 开到 max 是 55 分、$1.27,比 Argon high 的 50 分高 5 分,成本约是它现在的四分之一(1.27 ÷ 4.98 ≈ 26%),12 月起约 13%(1.27 ÷ 9.95)。Opus 开到 max 是 59 分(v5.0 时是 58 分),比 Argon high 高 9 分,成本 $10.04,与 Argon high 12 月起的 $9.95 基本持平。“Opus 58 对 Argon 53”这组常被引用的数字出自旧版 v4.3.2,是 Opus 的 max 档对 Argon 的 high 档;换成 v5.0.1 是 59 对 50,两边同样不在同一档上,不能直接当作模型差距。
Vals 的结果从另一个方向印证了成本要看任务。截至 10 月 1 日,Vals 的 Argon 页面显示,在覆盖金融、编码、法律、税务的 Vals Index 上,Argon 以 68.90% 排在 41 个模型的第一位,每个测试 $15.68;Claude Sonnet 5.5 是 67.04%、$21.34,Opus 5.5 是 66.97%、$32.14。这是 Vals Index v2.1 的排名。Vals 在 10 月 19 日发布 v2.2(更新了 Finance Agent),截至 10 月 30 日的当前榜单上,Argon 是 32 个模型中的第 4 名,69.24%、每个测试 $13.37,排在 Claude Sonnet 5.5(70.85%)、Gemini 4 Carbon(70.45%)和 Opus 5.5(70.18%,$28.12)之后(2026 年 11 月 4 日读取)。v2.1 和 v2.2 的分数不能混在一起比。Vals 给 Argon 用的是 $4/$20,也就是 12 月 1 日起的价格,推理强度同样是 high,所以按贵的那个价算,Argon 每个测试的花费仍只有 Opus 的一半左右。据 Kingy AI 的说明,榜上 Opus 与 Sonnet 这两行跑的是 max 档,和 Argon 的 high 档并不对等。但 Vals 也写明,Argon 的成本在长流程代理任务上会明显升高:CUA-bench 每个测试 $193.78,Code Migration 每个测试 $57.82;它在 CUA-bench 上的得分只有 4.83%,8 个模型里排第 7。
GPT-6.1 Sol 在 v2.1 上的成绩是 61.15%、每个测试 $3.24,这组数字出自 Kingy AI 对 Vals 榜单的转述。按它算,Sol 比 Argon 低约 8 个百分点,成本不到后者的四分之一。在当前的 v2.2 上,Sol 是第 8 名,63.94%、每个测试 $3.61。
把两家评测合起来看:Argon 和 Opus 5.5 的综合水平相差 2 分左右,AA v5.0.1 上 Opus 高 2 分;Vals Index 在 v2.1 上是 Argon 高约 2 个百分点,换到当前的 v2.2 后变成 Opus 高约 1 个百分点。谁更省钱取决于评测内容和任务长度:AA 上 Argon high 现在就贵 44%,12 月起是 2.88 倍;Vals 上它只有 Opus 的一半左右。GPT-6.1 Sol 在 AA 上与 Argon 同分、比 Opus 低 2 分,在 Vals 上低一截,但便宜得多。这些都是评测集上的平均值,换成你自己的任务,需要看的是通过验收的那部分结果各花了多少钱。Opus 与 Sol 两款之间更细的成本账见「Claude Opus 5.5 对比 GPT-6 Sol 与 6.1 Sol:先看任务,再算合格交付成本」。
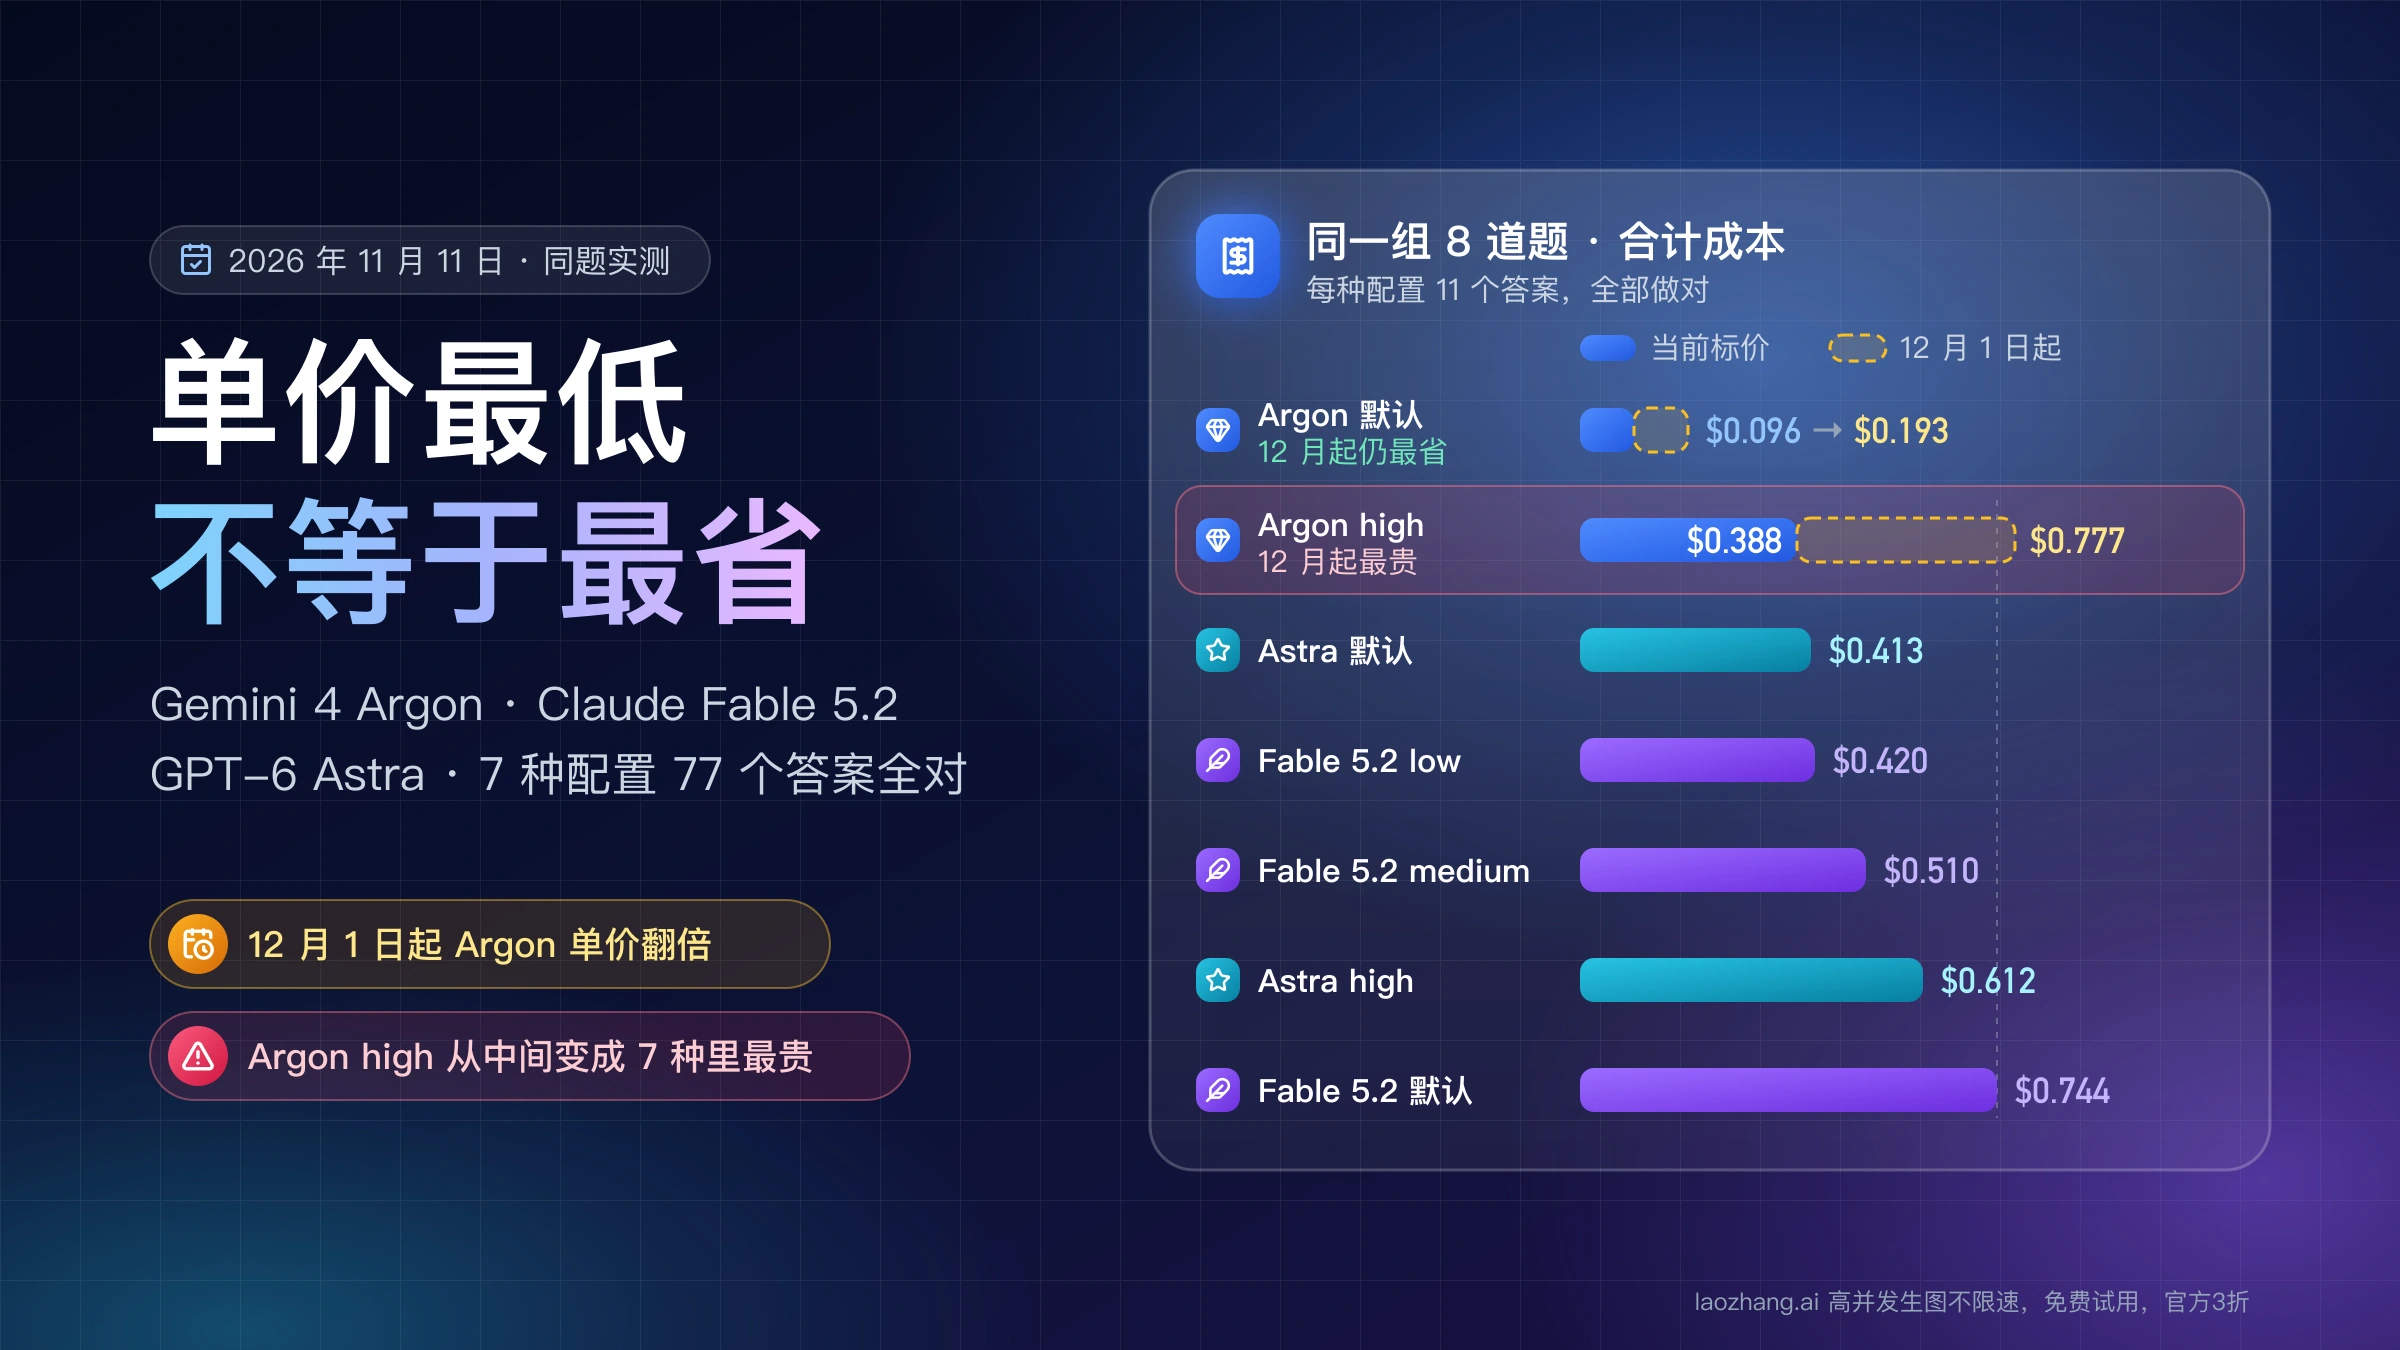
Argon 和 Opus 5.5 同题测评:默认档 Argon 省,高档 Opus 省
同一批题在两款模型上各跑默认档和高档,结果是:默认档 Argon 最省、几乎全对;开到高档后 Argon 的输出 token 涨到原来的近 6 倍,单次花费反超 Opus。测试经 LaoZhang 网关(api.laozhang.ai)用一个按用量计费的 key 完成,Argon 在 2026 年 11 月 4 日、Opus 5.5 在 11 月 11 日,花费按接口返回的用量(含 Argon 的隐式缓存命中)和各自牌价计算。Argon 走 Gemini 原生 generateContent、不开流式,默认档不设 thinkingConfig(Google 的默认是 medium),高档设 thinkingLevel 为 high;Opus 走 Anthropic Messages 接口、开流式,思考设为 adaptive,effort 分别用 medium(API 默认)和 high。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
8 道题是:一道文字应用题;三道带隐藏测试的函数题(区间合并 8 个测试、时长解析 18 个、词频统计 10 个);把一篇 6,723 词的英文文章总结成正好 5 条要点;以及三道更难的题,不用 eval 写表达式求值器(25 个隐藏测试)、不用 csv 模块写 CSV 行解析器(16 个)、数位和计数(答案 55,252)。难题各跑两次,所以每个设置有 11 个评分答案。
| 设置 | 答对 | 输入 token | 输出 token | 花费,到 11 月 30 日 | 花费,12 月 1 日起 | 总耗时 |
|---|---|---|---|---|---|---|
| Argon 默认档 | 10/11 | 12,712 | 6,782(思考 1,727) | $0.093 | $0.187 | 163 秒 |
| Argon high | 11/11 | 12,712 | 39,514(思考 33,105) | $0.403 | $0.807 | 463 秒 |
Opus 5.5 medium | 11/11 | 17,202 | 11,056(含思考) | $0.290 | $0.290 | 126 秒 |
Opus 5.5 high | 11/11 | 17,202 | 11,968(含思考) | $0.308 | $0.308 | 147 秒 |
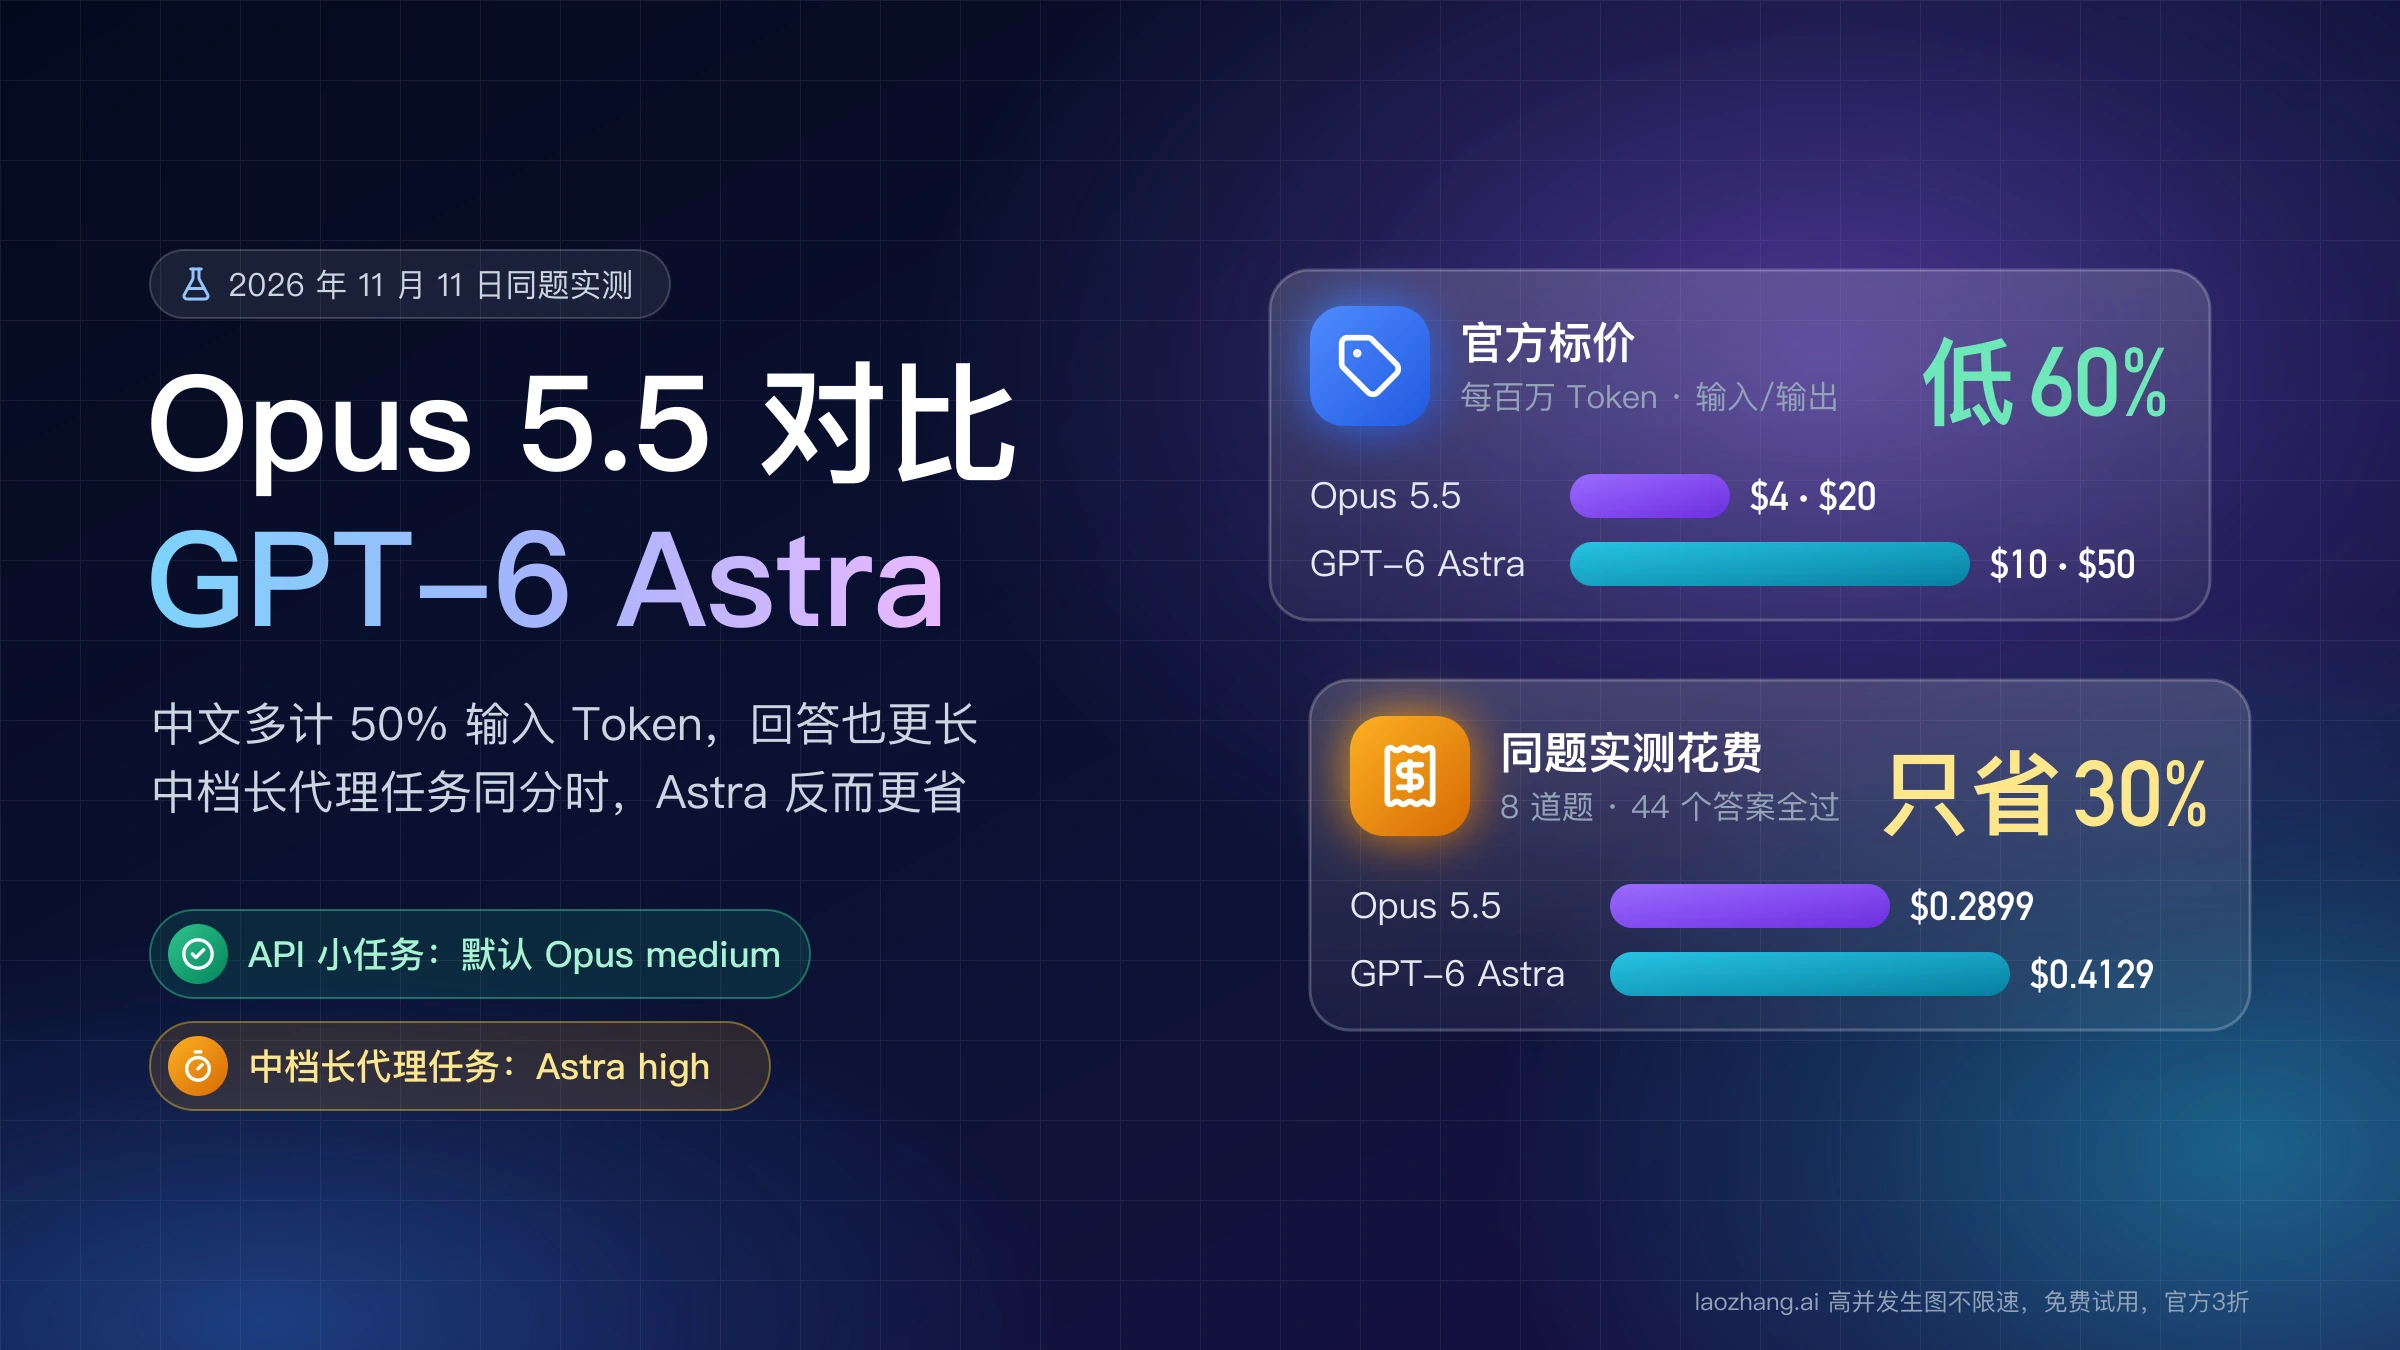
默认档之间,Opus medium 的花费是 Argon 的 3.11 倍,12 月起降到 1.55 倍,输出 token 多 63%,总耗时却短一些。高档之间方向反过来:Opus high 只花 Argon high 的 0.76 倍,12 月起是 0.38 倍,Argon high 写出的输出 token 是 Opus 的 3.3 倍,用时是 3.1 倍。两处细节会影响你怎么读“答对”这一栏。Argon 默认档唯一的失误是表达式求值器的第一次运行,遇到 " 1 + 2 " 这种多空格的输入抛出了 ValueError;同一天另一轮 Argon 默认档测试里这 11 个答案全对,合起来是 22 个答对 21 个。Opus high 的区间合并题把函数和它自己写的测试分成了两个文件交回,拆开后函数通过了全部 8 个隐藏测试和它自带的 6 个测试,表里按通过计;如果你的流水线直接执行返回的整段代码,这一题会算失败。
拉开差距的是一道长输入的精确统计题:一份 146 KB、1,500 行的合成应用日志,其中 326 行 ERROR,要求数出 5 种错误码各有多少行、有 E503 错误的不同用户数,以及重试次数最高的请求,标准答案由脚本生成并用 grep 核对过。Opus 5.5 跑了 4 次(medium、high 各两次)全部答对,每次约 57 秒、78,537 个输入 token,花费 $0.47~$0.48,12 月后不变。Argon 默认档两次都错,7 秒就交了答案,5 种错误码的行数少数了 20%~37%(E503 实际 94 行,它数成 59 行),E503 的用户数少得更多,实际 78 个,它数成 46 个,少了约 41%,每次 $0.16,12 月起 $0.32。Argon high 不开流式的那次,想到第 32,768 个输出 token 时还没写出答案,请求就结束了,仍计费 $0.49;改用流式后两次都答对,分别用了 271 秒和 402 秒,每次 $0.53~$0.55,12 月起 $1.06~$1.09。另有两次 Argon high 调用在约 300 秒时被本地代理断开,没有结果也没有计费,未计入。
这组测试的边界也要说清楚:只走了一个网关,每格只有 1~2 个样本,两边相隔一周,题目小而明确、多数拉不开差距,两家的“档位”也不是一回事(Argon 是 thinkingLevel,Opus 是 effort)。它能说明的是 token 用量、花费和耗时的方向,以及长输入精确活里 Argon 需要什么设置,不能当作质量排名,质量参照仍是上面的 AA 和下面的 Google 表。关于速度,在这几道题上 Opus 5.5 更快:高档 147 秒对 463 秒,日志题约 57 秒对 271~402 秒。
Google 的跑分表该怎么读:Argon 领先 14 项,Opus 领先 4 项
Google 9 月 30 日的 Argon 发布公告里的跑分表有四列:Gemini 4 Argon、GPT-6 Astra、Claude Fable 5.1 和 Claude Opus 5.5。表里没有 GPT-6.1 Sol,所以 Argon 与 Sol 的差距无法从这张表得出,只能看前面的第三方数据。10 月 13 日的开放公告没有新的对比表,只补了几项 Argon 自己的成绩,例如 ERQA 87%、编码评测中试图走捷径的比例 2%,以及“Vals Index 第一”。
Argon 与 Opus 5.5 都有成绩的 18 项里,Argon 领先 14 项,Opus 领先 4 项。领先的方向很有规律:
| 评测(Google 公告,%) | Argon | Opus 5.5 | 领先方 |
|---|---|---|---|
| Terminal-bench 4.0 | 57.4 | 66.4 | Opus |
| FrontierSWE v2 | 55.0 | 62.3 | Opus |
| Terminal-Bench Science 0.1 | 57.6 | 63.3 | Opus |
| PostTrainBench | 45.3 | 49.3 | Opus |
| DeepSWE v1.1 | 77.9 | 74.2 | Argon |
| Vibe Code Bench | 91.9 | 90.3 | Argon |
| AutomationBench | 51.3 | 42.5 | Argon |
| Vals Finance Agent v2 | 65.4 | 58.6 | Argon |
| Harvey Legal Agent | 19.6 | 3.8 | Argon |
| GraphWalks 256k–1M | 84.2 | 66.8 | Argon |
| LVBench | 91.7 | 83.7 | Argon |
| LABBench 2 | 88.8 | 73.1 | Argon |
| RiemannBench | 76.0 | 69.6 | Argon |
| Agent's Last Exam | 39.5 | 38.2 | Argon |
Opus 领先的四项是两个终端类评测、FrontierSWE 和归在机器学习工程下的 PostTrainBench;Argon 的优势在金融与法律类知识工作、长上下文(GraphWalks 在 256k 到 1M 区间差 17 个百分点)、LVBench 这样的多模态理解,以及科学与数学类的 LABBench 2 和 RiemannBench。编码这一类两边各有胜负:DeepSWE 和 Vibe Code Bench 是 Argon 高,Terminal-bench 和 FrontierSWE 是 Opus 高,其中 Terminal-bench 差 9 个百分点。
读这张表要记住两点。第一,它是厂商自己跑或自己汇总的成绩,没有独立复现。Kingy AI 读过 Google 的评测方法文件后指出几处设置并不对等,例如 Argon 的 Terminal-Bench Science 用了 6 倍的验证超时,LVBench 上各模型拿到的视频帧数不同;这是 Kingy 一家的解读。第二,独立机构的差距比它小得多:Vals Index 在 v2.1 上是 Argon 比 Opus 高约 2 个百分点,当前 v2.2 上是 Opus 高约 1 个百分点;AA v5.0.1 同为 high 档时 Opus 比 Argon 高 2 分。
人工盲评方面,据 Kingy AI 转述,Arena 在 9 月 30 日的文本榜上 Argon High 以 1,525 分排第一,Opus 5.5 High 为 1,504 分,GPT-6.1 Sol 不在那张表里。Arena 反映的是投票者的偏好,不是任务做对了没有。提示注入方面,Google 10 月 13 日的公告给出 Gray Swan 间接提示注入测试中 Argon 的攻击成功率为 0.7%(15 次自适应尝试);VentureBeat 对 9 月 30 日公告的报道转述的同一张图里,Opus 5.5 为 1.0%,图中没有 GPT-6.1 Sol。
写代码用 Argon 还是 Opus 5.5:编程代理先用 Opus
做编程代理,也就是终端里的多步任务和仓库级改动,截至 2026 年 11 月 11 日先用 Opus 5.5;Argon 可以留给小而明确的函数级任务,以及 Google 表上它领先的那几类代码评测所代表的场景。手上的证据有三类,方向不完全一致,要分开看。
第一类是 Google 自己的发布表。Opus 领先的四项里有三项和写代码直接相关:Terminal-bench 4.0(66.4 对 57.4)、FrontierSWE v2(62.3 对 55.0)和 Terminal-Bench Science;Argon 领先的是 DeepSWE v1.1(77.9 对 74.2)和 Vibe Code Bench(91.9 对 90.3),差距都在 4 个百分点以内。连发布方的表都显示 Opus 在终端和长流程软件工程上领先,这一点比较可信,但表本身没有独立复现。
第二类是 AA 的独立测评,结论更分化。终端类的 Terminal-Bench 4.0 上两边几乎打平:Argon High 57.1%,Opus High 56.6%,Opus 开到 max 是 59.6%,远没有 Google 表里 9 个百分点那么大。可在 AA 的代码题 FrontierCode 2.0 上差距很大:Argon High 25.7%,Opus High 35.9%,Opus max 46.4%。也就是说,独立评测里 Opus 的编码优势主要在写对代码本身,而不在终端操作。
第三类是上一节的同题实测:三道带隐藏测试的函数题和三道难题,两边在默认档和高档下都基本答对,拉不开差距;真正分开的是长输入的精确统计,Opus 默认档就能答对,Argon 要开高档加流式才行,而且慢约 5~7 倍,12 月起每次贵一倍多。
把三类放在一起,结论带着条件:编程代理、要读大量日志或代码再给出精确结果的活,Opus 5.5 更稳,effort 从 medium 起步,不够再加;单个函数、改小段代码、写一次性脚本这类明确的小任务,Argon 默认档在 11 月 30 日前花费约为 Opus 的三分之一,12 月起约为三分之二,值得在你自己的代码库上比一次。Google 另一款 Gemini 4 型号和 Opus 的编程对比见「Gemini 4 Carbon vs Opus 5.5 怎么选:编程代理仍是 Opus 领先」。
1M 输出上限是怎么回事:共用 1,048,576,默认最多输出 65,536
Argon 开放后,Google 换了说法。模型页现在写的是:上下文窗口 1,048,576 个 token,是输入和输出共用的上限;最大输出在默认的同步调用下是 65,536,开启 long decode(长解码)时最多 1,048,576。10 月 13 日的公告也改称“1M 统一输入输出 token 上限”。
9 月 30 日的公告说的是“输出上限从 64K 提高到 1M”,Vals 当时给它测的端点标的是最大输出 262k,这两个数字都是开放前的说法,现在已经不适用。按现在的口径,设计流程时要记住四点:
- 流式的同步请求,一次最多拿回 65,536 个输出 token,只有 Opus 5.5 和 GPT-6.1 Sol 的 128K 的一半左右。需要一次性生成很长内容的流程,不要默认 Argon 能比另外两款输出更多。
- 不开流式时上限更低。截至 2026 年 11 月 4 日,Gemini API 文档写明非流式的前台调用最多输出 32,768 个 token,流式才到 65,536,思考 token 也占这份额度。前面的日志题里,Argon high 不开流式的那次正是在 32,768 处停下,没有答案仍计费 $0.49,所以高档的长任务要用流式。
- 输入和输出共用 1,048,576 的额度:输入占得越多,留给输出的就越少。
- long decode 是单独的模式。怎样开启要按 Gemini API 文档里的说明来,不要套用别家模型的参数名;VentureBeat 也指出,Google 没有说清 1M 上限和单次不中断回复能有多长是什么关系。
推理 token 在三家都按输出计费,前面 Argon 单任务成本偏高正是同一件事的另一面:上限给得越宽,模型想得越久,账单也越长。
现在先用什么:首发价到期前先测 Argon 的哪些任务
Argon 已经能调用,问题从“要不要等”变成“首发价剩下的 20 天里测什么”。11 月 30 日之前测,同样的 token 只花一半的钱;12 月 1 日之后,决定要按 $4/$20 来做。可以按下面的条件分:
- 量大、单个任务出错可以重跑:继续用 GPT-6.1 Sol。high 档每任务 $0.59,分数与 Argon high 同为 50 分;开到 max 是 55 分、$1.27,成本约为 Argon high 现在的四分之一,12 月以后不到七分之一。
- 终端里的长流程编码、仓库级改动、机器学习工程任务,以及长输入上的精确统计:继续用 Opus 5.5。Google 自己的表格和 AA 的 FrontierCode 都显示 Opus 领先;同题实测里,长日志统计 Opus 默认档就答对,Argon 要开高档加流式,12 月起每次贵一倍多。
- 金融、法律文档处理,几十万 token 以上的长上下文检索,视频理解:这是 Argon 数字最好看的范围,现在就值得拿真实任务去测。
- 小而明确的函数级任务:Argon 默认档在同题实测里花费最低,值得在你的代码库上和 Opus
medium比一次,重点看偶发失误要不要人工兜底。 - 只用订阅、不走 API:Google AI Pro 或 Ultra 订阅者可以在 Gemini 应用里直接试 Argon,Antigravity 里则要 Ultra、付费的 Pro,或随符合条件的高端设备附赠的 Pro 试用;Claude 的 Pro、Max、Ultra 和 ChatGPT 的付费方案仍是另外两款的入口。订阅里的使用额度不按 token 计费,下面的成本算法只对 API 有效。
测之前先准备一组自己的任务:20 到 50 个有明确验收标准的真实案例,记录好当前模型在每个案例上的通过情况、输入输出 token 和费用。然后按这个顺序看:
- 先确认开通条件。Gemini API 要开付费层;速率限制没有公布,以 AI Studio 里的额度为准;缓存只有隐式的一种,不能手动创建缓存。
- 两边各跑默认档和高档,分别记下通过率和每个通过任务的平均费用,不要只比单次调用的价格。Argon 有 low、medium、high 三档,AA 只测过 high,低两档的效果要自己测;Opus 的 API 默认 effort 是
medium。 - 把 Argon 的费用乘以 2 再比一次。12 月 1 日起所有单价都翻倍,token 用量不变的话,费用就是现在的两倍。如果只在首发价下才划算,那么 12 月 1 日前就得再迁移一次。
- 用自己的中文提示词量一次 token。同一段中文,Opus 5.5 的输入 token 约是 Argon 的 1.78 倍;日志、代码这类以 ASCII 为主的输入差别小得多,按你的实际输入比。
- 单独看长任务。Vals 的数据提示 Argon 在长流程代理任务上成本上升很快,给单任务设一个输出 token 或费用上限再跑;Argon 开高档时用流式调用。
- 留意输出长度。同步调用流式最多 65,536 个输出 token;任务需要更长的输出,就要单独验证 long decode 能否接进你的流程。
Argon 是否值得切换,最终取决于第 2 步和第 3 步的结果:在你的任务上通过率明显更高,并且按 $4/$20 计算仍然不比现有方案贵,才有长期迁移的理由;只在首发价下划算的,可以趁 11 月 30 日前把它用在一次性的批量任务上。Anthropic 11 月 9 日发布了更贵的 Claude Fable 5.2($8/$40),但它自己的建议仍是多数工作先用 Opus 5.5,两者怎么选见「Fable 5.2 和 Opus 5.5 怎么选:哪档对哪档,同题实测贵 1.86 倍」。只在 OpenAI 自家型号之间比较的话,可以看「GPT-6.1 Sol、GPT-6 Sol、Astra 怎么选」;预算更紧、想在 Anthropic 内部降一档,见「Sonnet 5.5 和 Opus 5.5 怎么选:半价未必更省」。
Gemini 4 Argon 问答:能不能用、价格、强弱、要不要等
Gemini 4 Argon 现在能用吗?
能。Google 于 2026 年 10 月 13 日开放了 Gemini 4 Argon:开发者通过 Gemini API 付费层调用,模型 ID 是 gemini-4-argon,在 AI Studio 和 Google Cloud 的 Gemini platform 里都能用;Gemini 应用和搜索中的 AI 模式对 Google AI Pro、Ultra 订阅者开放;Google Antigravity 对 Ultra、付费的 Google AI Pro 和随符合条件的高端设备附赠的 Pro 试用开放,普通免费试用没有被列入,限 Antigravity app、CLI 和 IDE 扩展,Antigravity IDE 里没有;企业可在 Gemini for business 里用。API 免费层不能用,中国大陆和香港的账号也不在 Gemini API 的可用地区里。不带网络安全护栏的版本仍只给 Fairwind 计划的合作方。
Gemini 4 Argon 和 GPT-6.1 Sol 是一个价吗?
到 2026 年 11 月 30 日为止是一个价:两者都是每百万输入 token $2、输出 $10,缓存读取 $0.10(GPT-6.1 Sol 以输入不超过 272K 为条件)。12 月 1 日起 Argon 升到 $4/$20、缓存 $0.20,与 Claude Opus 5.5 相同,GPT-6.1 Sol 不变。牌价相同也不等于花费相同:两者在 AA v5.0.1 的 high 档同为 50 分,而 Argon 的单任务成本截至 11 月 11 日约是 Sol 的 8.4 倍,12 月起约 16.9 倍。
Gemini 4 Argon 比 Claude Opus 5.5 强吗?
综合水平接近,强弱要分任务看。Google 公告的跑分表里,两者都有成绩的 18 项中 Argon 领先 14 项,Opus 5.5 领先的 4 项是 Terminal-bench 4.0、FrontierSWE v2、Terminal-Bench Science 和 PostTrainBench;这张表是厂商自己跑或汇总的,没有独立复现。第三方的差距更小:AA v5.0.1 同为 high 档时是 Argon 50 对 Opus 52(截至 2026 年 11 月 11 日),Vals Index 当前 v2.2 上是 Opus 70.18%、Argon 69.24%,v2.1 时则是 Argon 领先,先后已经换过一次。写代码这一项,AA 的 FrontierCode 2.0 上 Opus 领先明显(high 档 35.9% 对 25.7%)。
GPT-6.1 Sol 和 Claude Opus 5.5 怎么选?
按 AA v5.0.1 指数同为 high 档的数据,GPT-6.1 Sol 是 50 分、每任务 $0.59,Claude Opus 5.5 是 52 分、$3.46。量大、出错可以重跑的任务先用 Sol;终端里的长流程编码、仓库级改动更适合 Opus 5.5。两款之间更细的成本账见「Claude Opus 5.5 对比 GPT-6 Sol 与 6.1 Sol:先看任务,再算合格交付成本」。
现在该等 Gemini 4 Argon,还是先用 Opus 5.5/GPT-6.1 Sol?
不用再等,Argon 10 月 13 日已经开放。手头在用 Opus 5.5 或 GPT-6.1 Sol 的流程不必急着换:趁 11 月 30 日首发价结束前,拿自己的任务测 Argon,重点放在金融、法律文档、长上下文检索和小而明确的代码任务上,再把费用按 12 月 1 日起的 $4/$20 算一遍。在你的任务上通过率更高、按新价格仍然不更贵,才值得长期切换。
参考来源15
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年11月11日。
参考来源15
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年11月11日。
- 1.Google 10 月 13 日的 Argon 开放公告blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-argon
- 2.Google Cloud 博客的 Argon 上线文章cloud.google.com/blog/products/ai-machine-learning/gemini-4-argon-available-on-google-cloud
- 3.Gemini API 模型列表ai.google.dev/gemini-api/docs/models
- 4.Antigravity 的模型页antigravity.google/docs/models
- 5.Gemini API 价格页aistudio.google.com/docs/pricing
- 6.Argon 的 Gemini API 模型页ai.google.dev/gemini-api/docs/models/gemini-4-argon
- 7.GPT-6.1 Sol 型号页developers.openai.com/api/docs/models/gpt-6.1-sol
- 8.Claude 价格页platform.claude.com/docs/en/about-claude/pricing
- 9.Artificial Analysis 的 Argon 页面artificialanalysis.ai/models/gemini-4-argon
- 10.AA 的 Argon 与 Opus 5.5 对比页artificialanalysis.ai/models/comparisons/gemini-4-argon-vs-claude-opus-5-5
- 11.Vals 的 Argon 页面vals.ai/models/google_gemini-4-argon
- 12.当前榜单vals.ai/benchmarks/vals_index
- 13.Kingy AI 对 Vals 榜单的转述kingy.ai/blog/frontier-ai-models-gemini-4-argon-gpt-6-astra-sol-claude
- 14.Google 9 月 30 日的 Argon 发布公告blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- 15.VentureBeat 对 9 月 30 日公告的报道venturebeat.com/technology/google-unveils-gemini-4-argon-retaking-benchmark-lead-over-openai-and-anthropic-but-in-limited-release