GPT-6.1 Terra vs Sol: в чем разница, цена задачи и тест в Codex
GPT-6.1 Terra вдвое дешевле Sol за токен и в тесте Codex 27 октября 2026 года работала вдвое быстрее, но на уровне max дешевле за задачу выходит Sol medium.
Содержание
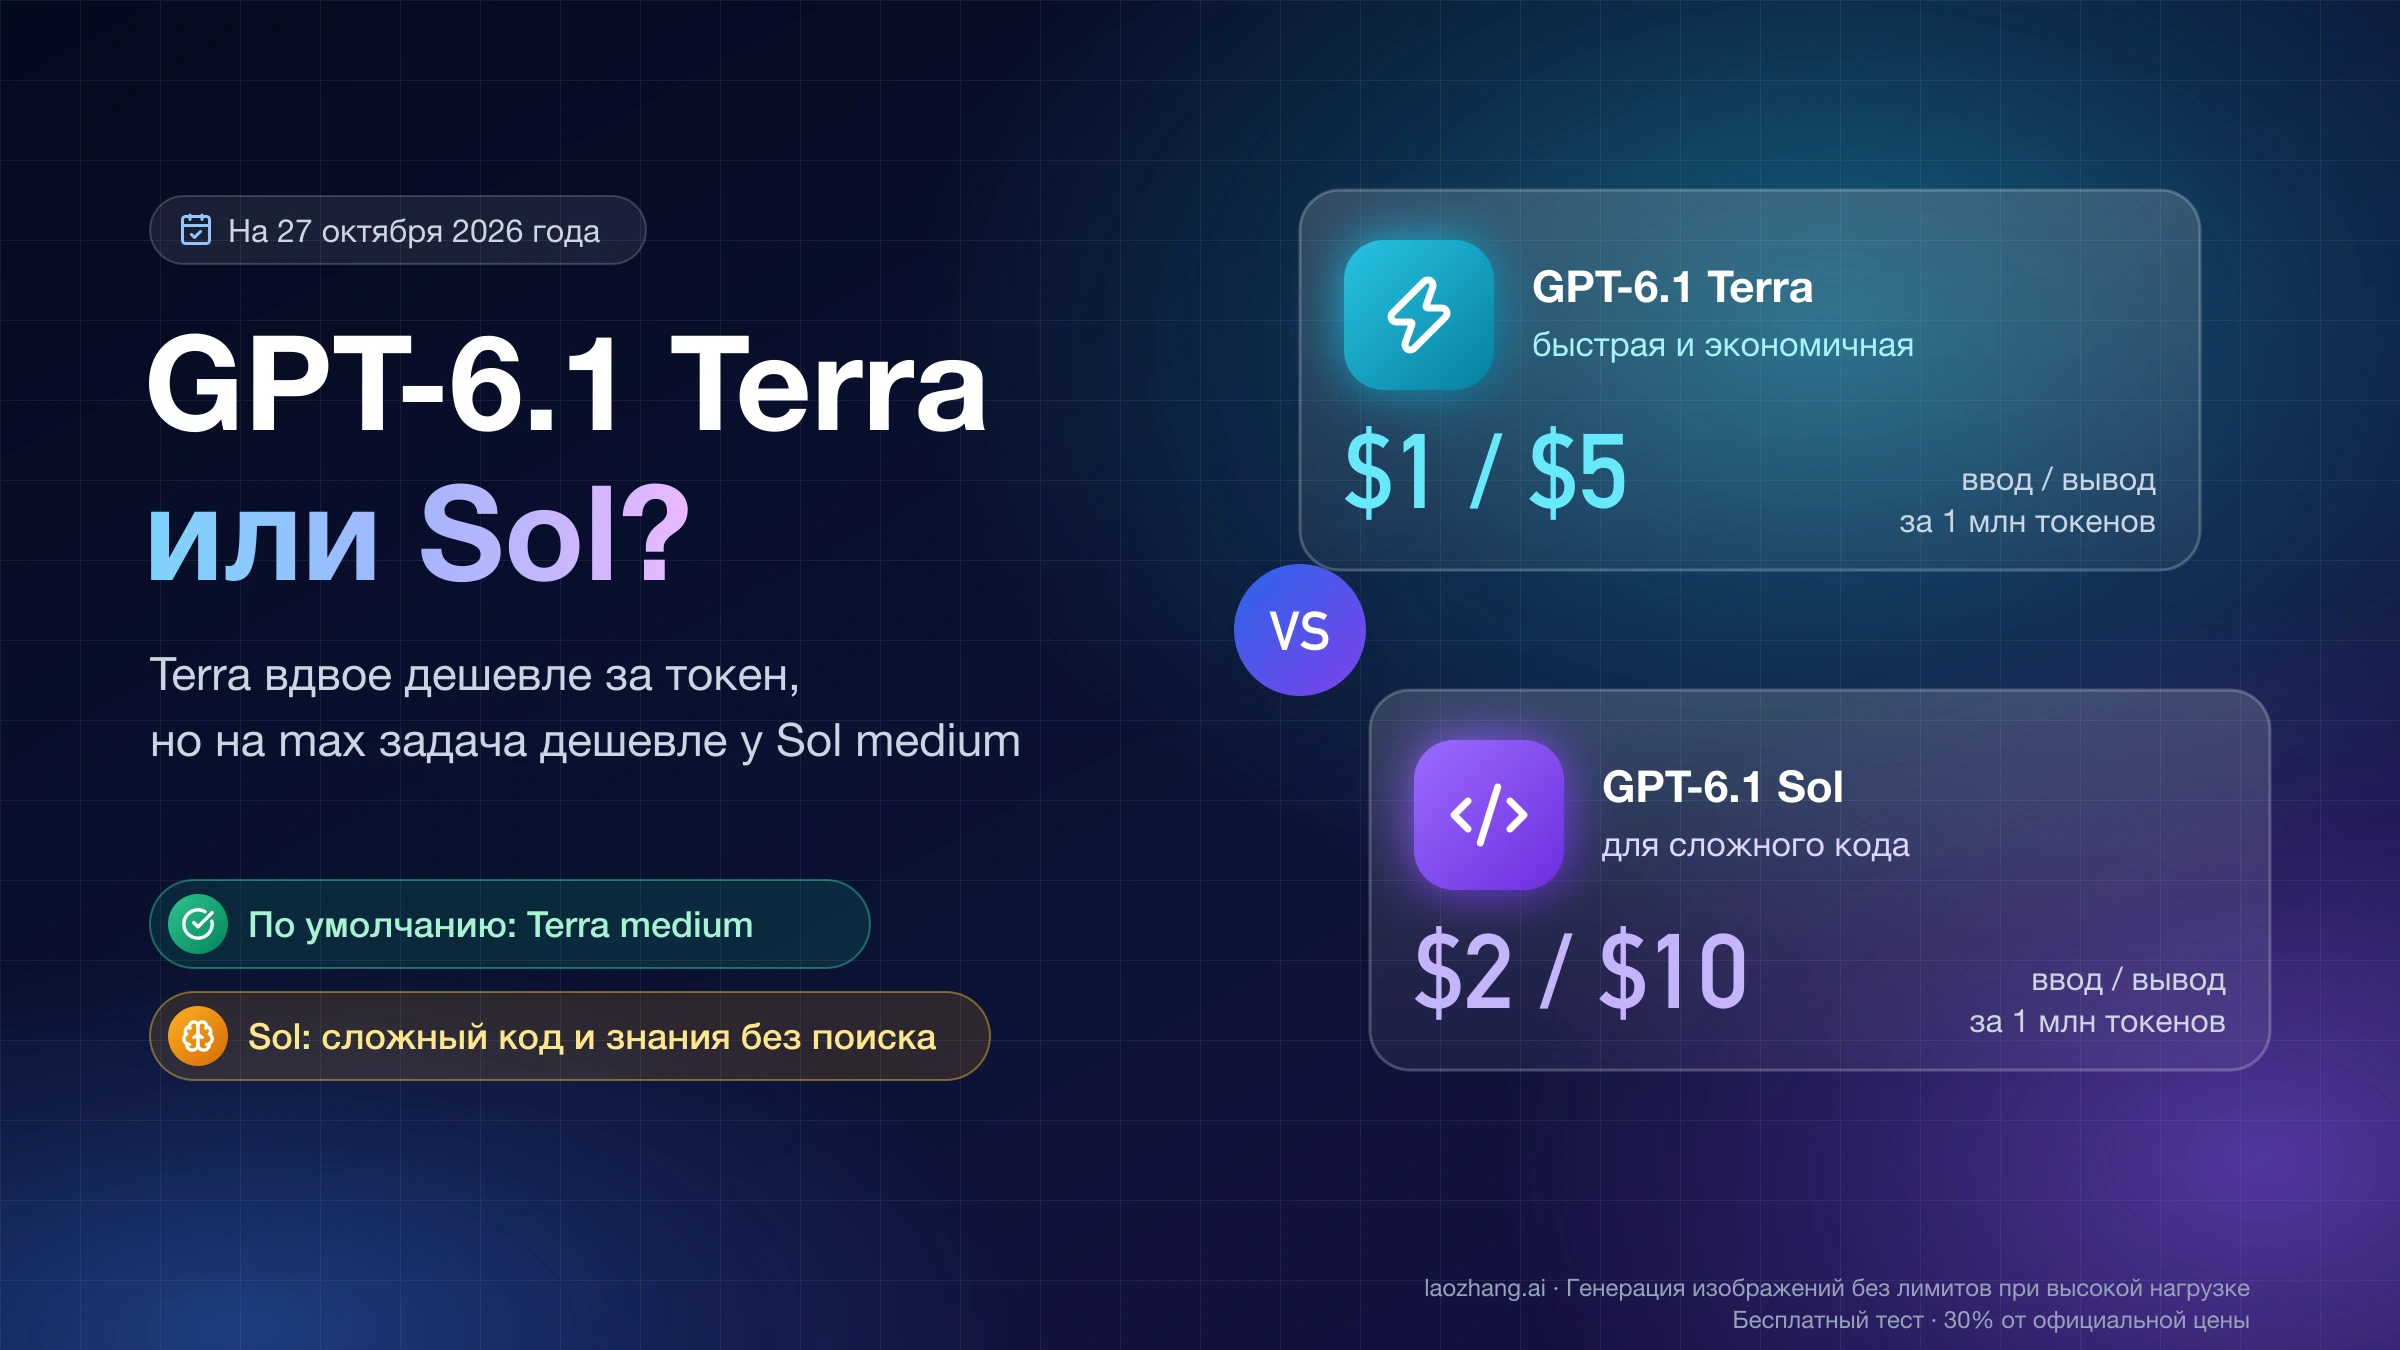
Если вы выбираете между GPT-6.1 Terra и GPT-6.1 Sol для обычной работы в Codex или через API — правки кода по спецификации, агентских задач средней длины, извлечения данных из скриншотов и документов, заполнения форм, — начните с gpt-6.1-terra на уровне рассуждений medium. Она вдвое дешевле Sol за каждый токен, а в тесте 27 октября 2026 года в Codex CLI на одинаковых задачах и одинаковом уровне справилась так же, как Sol, за половину времени и примерно за 40 % кредитов. gpt-6.1-sol оставьте для сложного многошагового кода и вопросов на знание без поиска: на medium Terra там заметно отстаёт, а чтобы догнать Sol medium в индексе Artificial Analysis, ей нужен уровень max, и тогда задача обходится дороже — $0,40 против $0,21 — и идёт в 2,6 раза дольше.
«В два раза дешевле» верно только для цены за токен. Цена выполненной задачи зависит от того, на каком уровне рассуждений (reasoning effort) сравнивать модели: на low и medium Terra дешевле и быстрее Sol при сопоставимом результате, на max это преимущество исчезает. Поэтому перед переходом прогоните обе модели на нескольких своих задачах с автоматической проверкой и сравните стоимость принятого результата, а не счёт за токены.
Несколько ограничений решают выбор сами, независимо от качества. У Terra нет режима Ultrafast ни в API, ни в Codex. Sol не принимает уровень none, поэтому сервис, работающий без рассуждений, на Sol придётся переводить минимум на low. Ни одной из двух моделей нет в обычном чате ChatGPT — только в ChatGPT Work, Codex и API. Обработку данных в ОАЭ (UAE inference residency) Terra не поддерживает. Цены и данные ниже приведены по состоянию на 27 октября 2026 года, в долларах США.
Какая модель для какой работы: Terra по умолчанию, Sol для сложного кода
Начинайте с самой дешёвой конфигурации, которая проходит вашу проверку, и повышайте уровень или переходите на Sol, только когда Terra начинает ошибаться. Таблица — стартовая точка для типичных задач на 27 октября 2026 года; основания для каждой строки разобраны в следующих разделах.
| Задача | С чего начать | Когда менять |
|---|---|---|
| Правка кода по понятной спецификации, задачи с тестами, небольшие агентские задачи | Terra medium, для простого — low | Проверки не проходят — Terra high; не помогает и это — Sol medium |
| Извлечение данных из изображений, графиков и счетов, заполнение форм, работа с интерфейсом | Terra medium | Sol — только если Terra систематически ошибается на ваших материалах |
| Сложный многошаговый код, большой незнакомый репозиторий, долгие агентские цепочки | Sol medium или high | Terra max здесь не экономит: при равном балле она дороже и медленнее Sol medium |
| Ответы на фактические вопросы без поиска и файлов, где выдуманный факт дорого стоит | Sol | В тесте на знания и выдуманные ответы Sol заметно сильнее на всех уровнях |
| Лимит Codex на Plus или Business постоянно заканчивается | Terra | По оценке OpenAI, в то же окно помещается примерно вдвое больше сообщений |
Цена GPT-6.1 Terra и Sol в API: ровно вдвое в каждой колонке
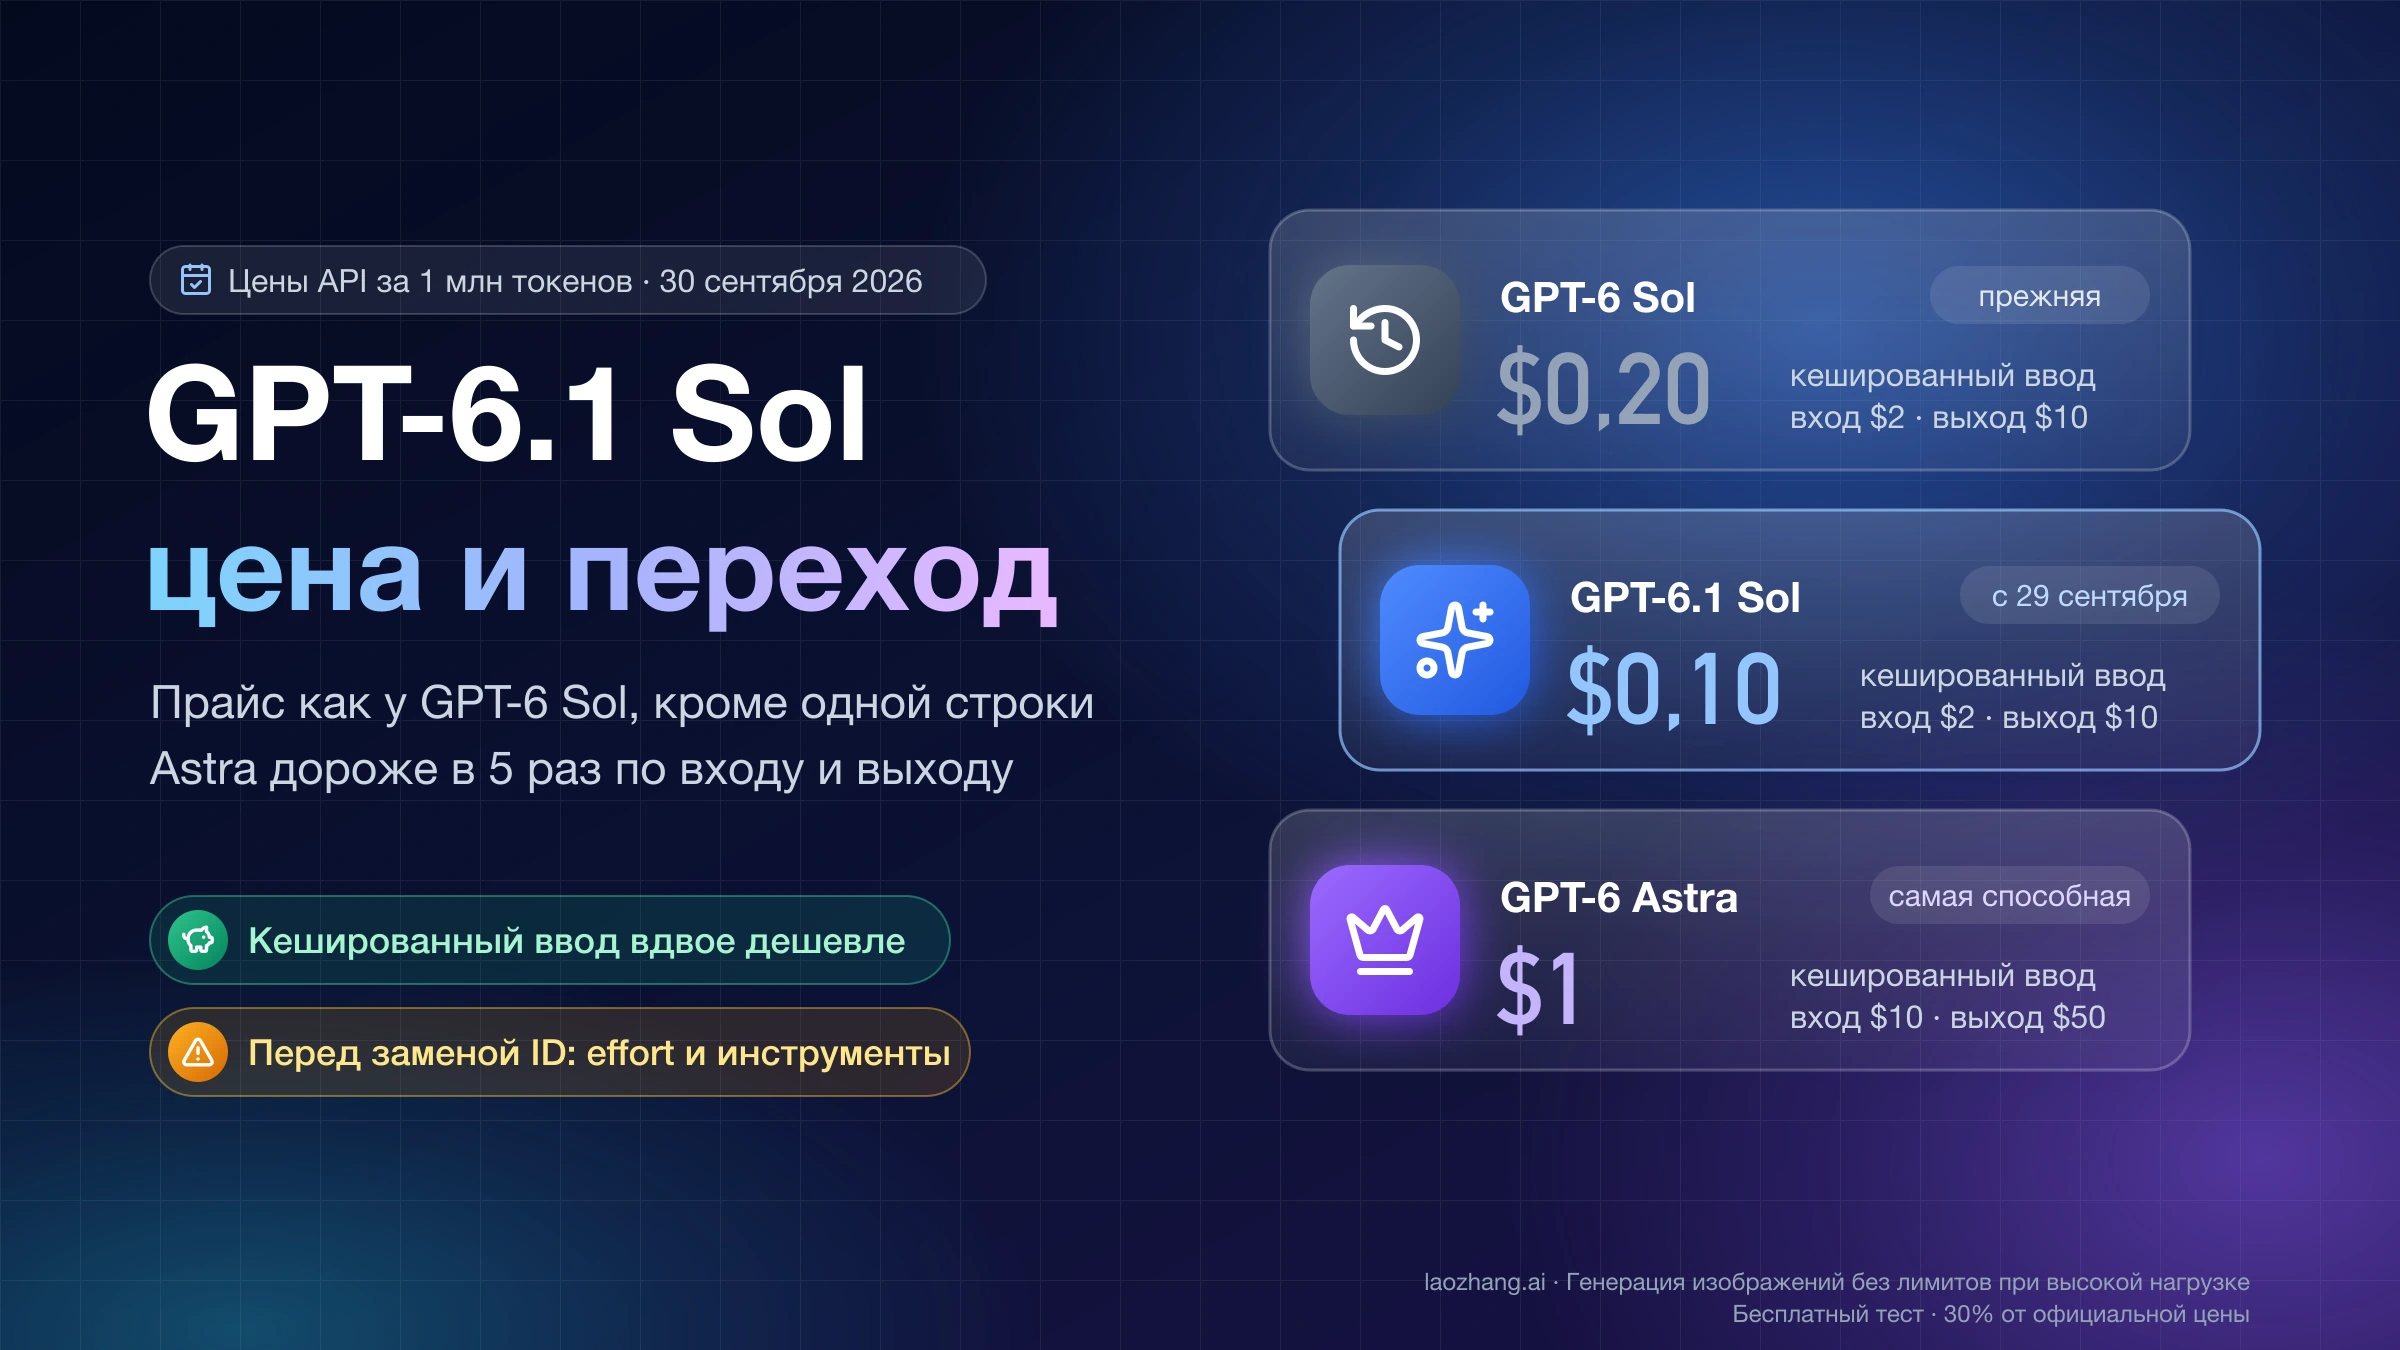
За токен GPT-6.1 Terra стоит ровно половину GPT-6.1 Sol — в каждой колонке и в каждом режиме, где есть обе модели. Так указано на странице цен OpenAI API по состоянию на 27 октября 2026 года; ставки в таблице — за 1 млн токенов, для «длинного» тарифа — при вводе больше 272 000 токенов, для остальных режимов — до этого порога.
| Режим | Terra: ввод | Terra: вывод | Sol: ввод | Sol: вывод |
|---|---|---|---|---|
| Standard, до 272 000 входных токенов | $1,00 | $5,00 | $2,00 | $10,00 |
| Standard, больше 272 000 входных токенов | $2,00 | $7,50 | $4,00 | $15,00 |
| Batch и Flex | $0,50 | $2,50 | $1,00 | $5,00 |
| Fast | $2,00 | $10,00 | $4,00 | $20,00 |
| Ultrafast | нет | нет | $12,00 | $60,00 |
Кэш тоже стоит вдвое меньше: кэшированный ввод — $0,05 у Terra и $0,10 у Sol, запись в кэш на 30 минут — $1,25 и $2,50, на 12 часов — $2,50 и $5,00 (до 272 000 токенов; на длинном тарифе всё удваивается). Когда ввод превышает 272 000 токенов, по длинному тарифу считается весь запрос, а не только излишек. Региональная обработка данных добавляет к обеим моделям 10 %. Контекстное окно у обеих — 1,05 млн токенов, максимум вывода — 128 000. Как запись в кэш и длинный контекст складываются в итоговый счёт, подробно разобрано на примере Astra в материале «GPT-6 Astra API: тарифы, кэш и стоимость длинного контекста».
Дешевле ли Terra за задачу: на low и medium да, на max нет
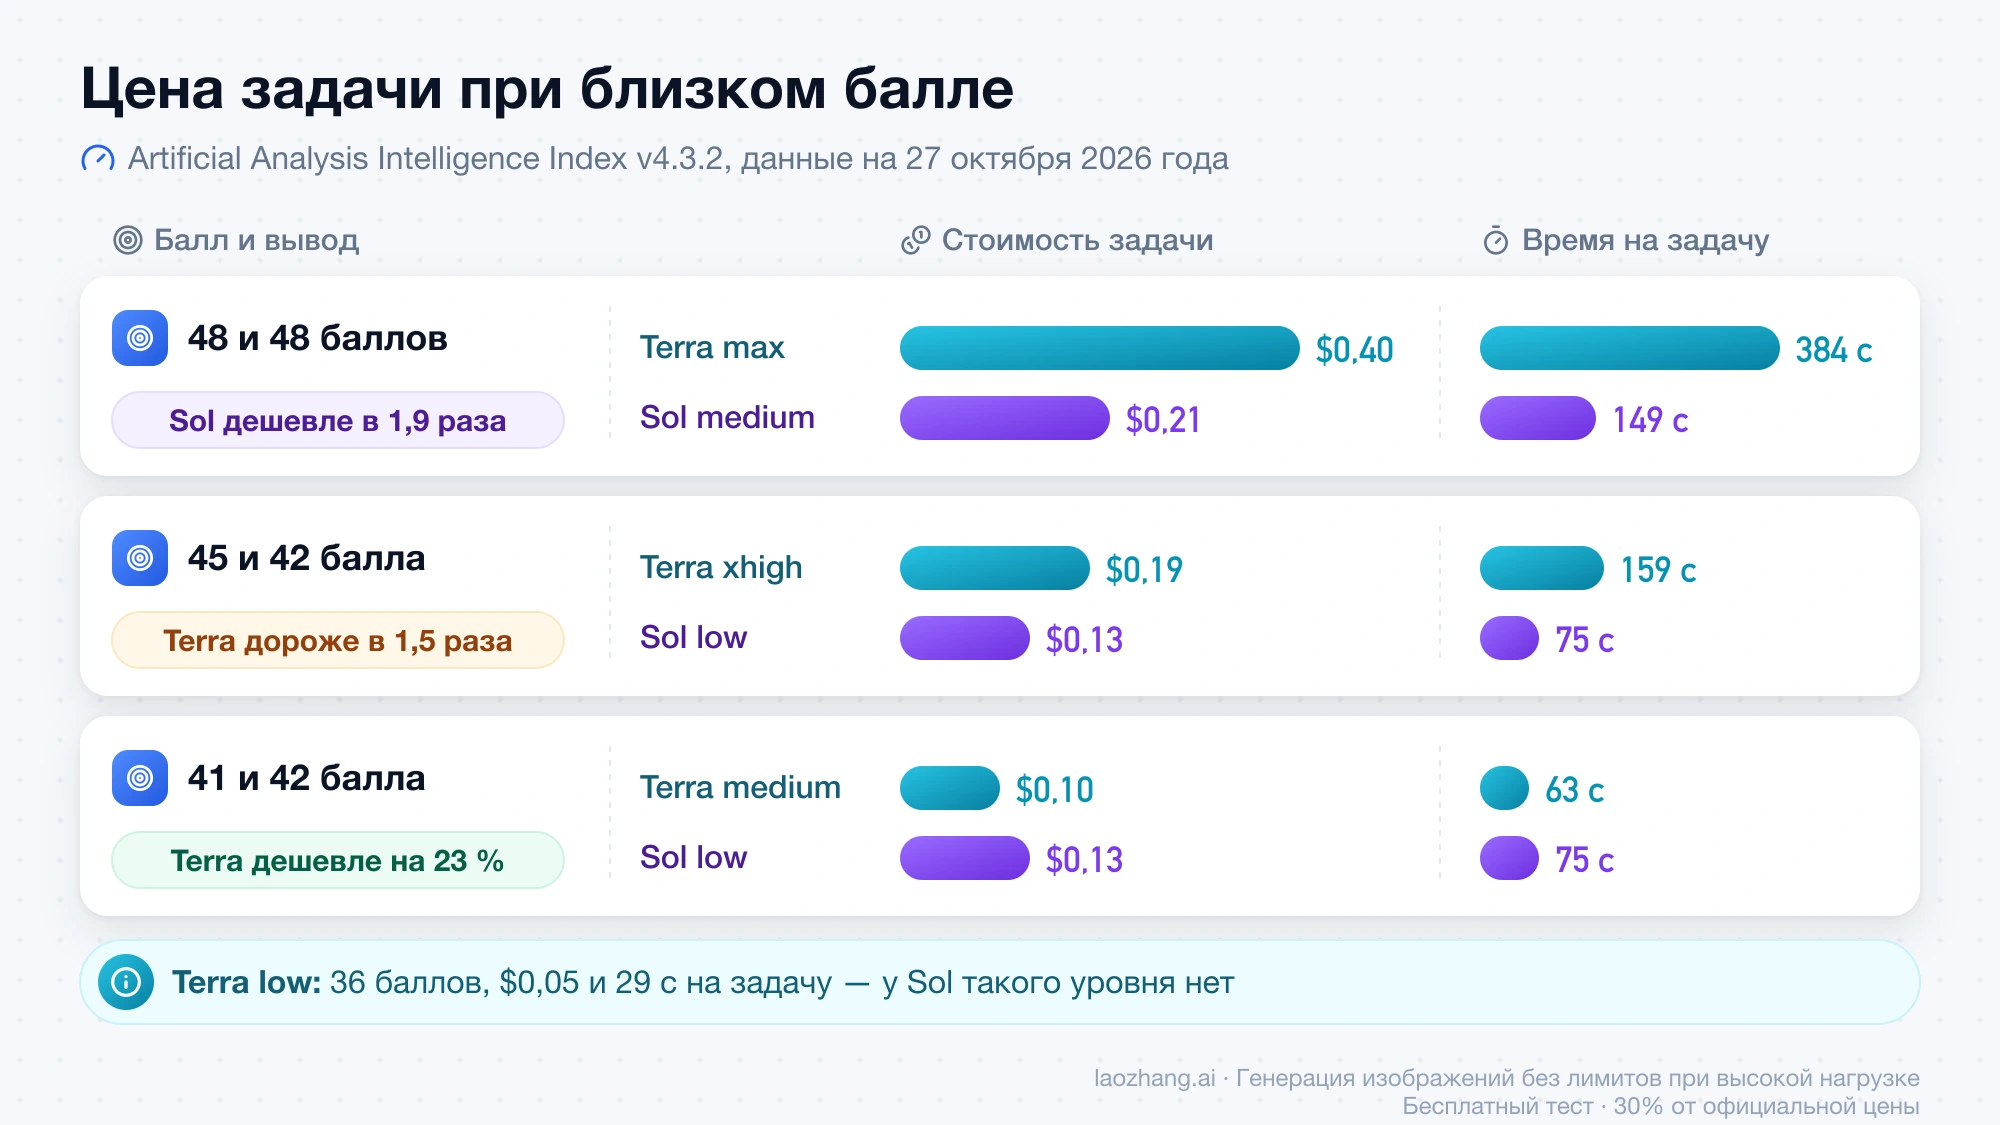
Стоимость задачи — это цена токена, умноженная на число токенов, а на высоких уровнях Terra рассуждает дольше и вдвое более низкая ставка перестаёт спасать. Artificial Analysis прогнала обе модели на всех уровнях своего индекса Intelligence Index v4.3.2 через API и опубликовала сравнение GPT-6.1 Terra и GPT-6.1 Sol по всем уровням рассуждений. Если поставить рядом конфигурации с близким баллом, получается так (данные на 27 октября 2026 года):
| Пара с близким баллом | Балл индекса | Стоимость задачи индекса | Время на задачу |
|---|---|---|---|
Terra max и Sol medium | 48 и 48 | $0,40 и $0,21 | 384 с и 149 с |
Terra xhigh и Sol low | 45 и 42 | $0,19 и $0,13 | 159 с и 75 с |
Terra medium и Sol low | 41 и 42 | $0,10 и $0,13 | 63 с и 75 с |
Terra low, у Sol пары нет | 36 | $0,05 | 29 с |
При равных 48 баллах Sol medium дешевле Terra max в 1,9 раза и быстрее в 2,6 раза. На нижних уровнях всё наоборот: Terra medium набирает почти столько же, сколько Sol low, а задача обходится на 23 % дешевле ($0,10 против $0,13) и идёт на 16 % быстрее (63 против 75 с). Terra xhigh уже на 3 балла выше Sol low, но стоит в 1,5 раза дороже. У Terra low с её 36 баллами равной пары у Sol нет вовсе: это самая дешёвая конфигурация из двух моделей, и Sol на такой уровень опуститься не может.
Уровень none у Terra не означает экономии. В том же индексе он даёт 33 балла за $0,11 и 52 с на задачу — меньше баллов, дороже и дольше, чем low. Если ваш сервис работает без рассуждений ради скорости, проверьте low на своих запросах: на задачах индекса он выигрывает по всем трём показателям.
Индекс — это средний результат по десяти тестам, от агентских задач до научного кода, поэтому на вашей нагрузке порядок может оказаться другим. Стоимость задачи индекса показывает соотношение цены и результата в одинаковых условиях, а не ваш будущий счёт; к тому же данные первых суток после выхода модели Artificial Analysis ещё может уточнить.
Тест в Codex 27 октября 2026 года: обе прошли всё, Terra вдвое быстрее
27 октября 2026 года обе модели прогнали на трёх небольших задачах в Codex CLI; все 17 запусков прошли проверку полностью, а различались модели только временем и расходом. Использовался Codex CLI 0.164.0-alpha.11.1 из состава приложения ChatGPT для macOS, вход через подписку ChatGPT, стандартная скорость (не Fast), один аккаунт и один компьютер. Каждый запуск начинался с чистой копии папки задачи командой вида codex exec -m gpt-6.1-terra -c model_reasoning_effort=medium --json с нужной моделью и уровнем, модели чередовались, время мерилось от запуска до выхода, а токены брались из события turn.completed. Кредиты и эквивалент в долларах API рассчитаны из этих токенов по ставкам Codex и прайсу API, а не считаны с панели использования.
Первая задача — исправить ошибки в модуле расчёта счетов по спецификации из семи правил; проверка — 36 скрытых тестов pytest (эталонное решение проходит 36 из 36, исходный файл — 13). Во второй модель получала две картинки: счёт на 12 строк с похожими артикулами и одной намеренно неверной суммой по строке и столбчатый график из 12 столбцов без подписей значений; нужно было извлечь все числа и найти ошибку. Третья — реализовать функцию satisfies() для диапазонов версий semver по длинной спецификации, включая правило npm для предварительных версий; проверка — тоже 36 скрытых тестов, заготовка проходит 0.
| Задача и уровень | Terra: время, кредиты | Sol: время, кредиты |
|---|---|---|
Счета, low | 29,2 с, 0,42 | — |
Счета, medium | 31,9 с, 0,44 | 51,5 с, 1,32 |
Счета, high | 34,0 с, 0,52 | 62,0 с, 1,35 |
Картинки, none | 28,8 с, 0,87 | уровня нет |
Картинки, medium | 36,4 с, 0,81 | 78,8 с, 1,69 |
Картинки, high | 38,1 с, 0,86 | 55,4 с, 1,47 |
Semver, low | 27,5 с, 0,58 | 44,2 с, 1,33 |
Semver, medium, запуск 1 | 28,1 с, 0,60 | 59,1 с, 1,47 |
Semver, medium, запуск 2 | 25,1 с, 0,45 | 57,2 с, 1,08 |
Semver, high | 36,9 с, 1,10 | — |
Если сложить четыре пары на одинаковом уровне medium, Terra потратила 121,5 с и 2,30 кредита, Sol — 246,6 с и 5,56 кредита: в 2,0 раза больше времени и в 2,4 раза больше кредитов. В долларах API это $0,0917 против $0,2222. Ставки различаются ровно вдвое, а остальное добавляет сама Sol: она пишет больше выходных токенов (в задаче со счетами на medium — 1 821 против 1 245) и иногда делает больше шагов. В задаче с картинками Sol на medium выполнила шесть команд и прочитала 196 000 входных токенов, Terra — две команды и 70 000 токенов; поэтому именно там разрыв по времени самый большой.
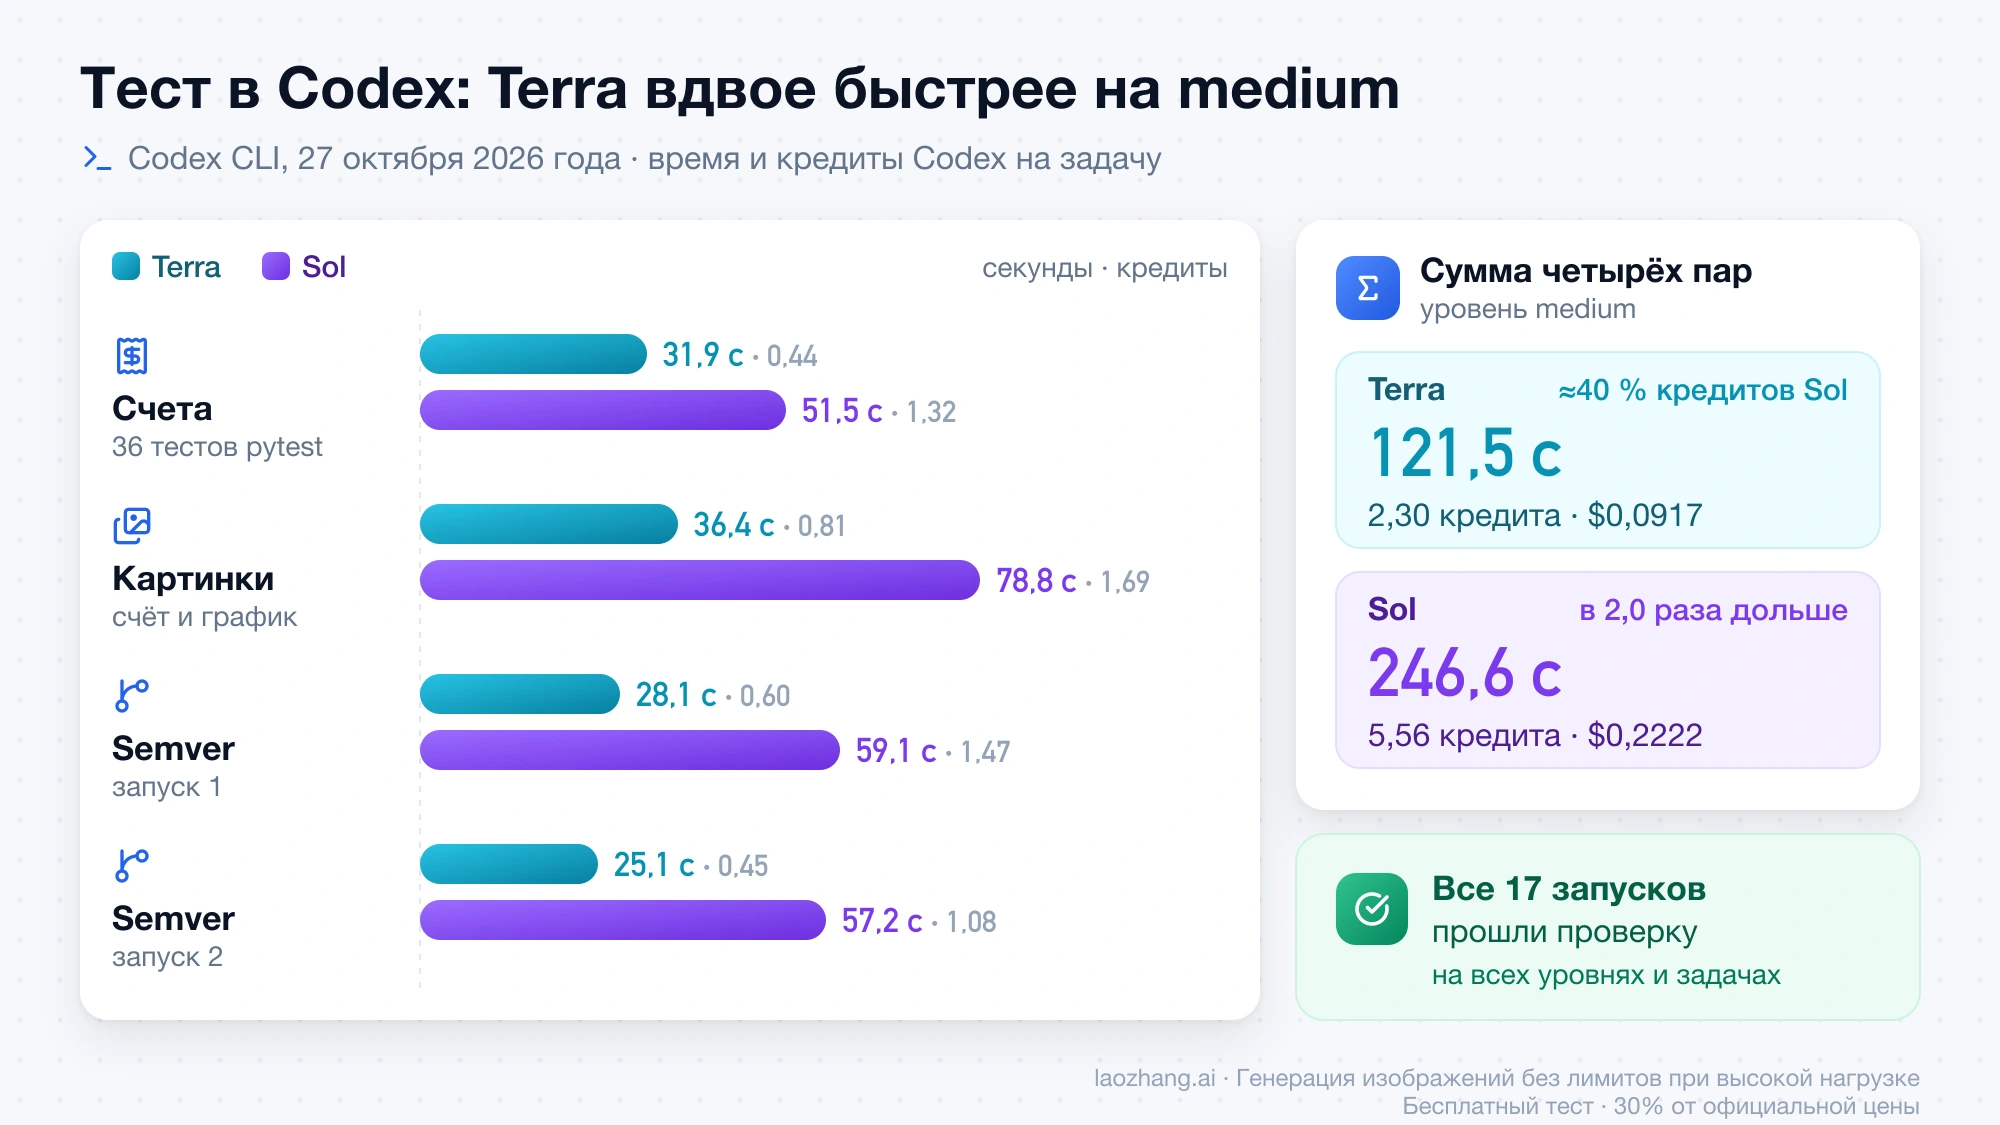
По качеству эти задачи модели не развели. В задачах с кодом обе проверяют себя тестами и правят код, пока тесты не пройдут, а в задаче с картинками обе сами обрезали и увеличивали изображения через Python PIL, извлекли все 40 чисел счёта и все 12 значений графика и нашли подложенную ошибку. Обе одинаково прочитали два артикула не так, как в оригинале (LM-1l07 как LM-1107, DW-1I1l как DW-1I11): в моноширинном шрифте l, I и 1 почти неотличимы, поэтому эти два поля в оценку не входили. Выборка маленькая: по одному запуску на конфигурацию, кроме semver на medium, без API и без режимов Fast и Ultrafast. Разница в качестве проявляется на задачах потруднее — о них раздел о коде ниже.
Правда ли Terra в три раза быстрее: время задачи, а не скорость токенов
«Более чем в три раза быстрее» — это формулировка OpenAI о времени выполнения задач в её собственном тесте, а не о скорости генерации токенов. В анонсе GPT-6.1 Terra от 26 октября 2026 года сказано, что в тесте Agents’ Last Exam Terra завершает задачи более чем втрое быстрее GPT-6 Astra и GPT-6.1 Sol. По чистой скорости вывода разница меньше: Artificial Analysis намерила у Terra 91 токен в секунду на всех уровнях, у Sol — от 54 до 73, то есть в 1,2–1,7 раза.
Главный выигрыш в том, что Terra на том же уровне тратит меньше токенов и шагов. По времени на задачу индекса Artificial Analysis Terra быстрее Sol в 2,6 раза на low (29 против 75 с), в 2,4 раза на medium (63 против 149 с) и лишь в 1,4 раза на max (384 против 527 с). Похожую картину дал и замер в Codex из раздела выше. Есть и пример с почти четырёхкратной разницей: сотрудник команды Codex в OpenAI (@victornunez в X) 26 октября 2026 года, в день выхода модели, показал один прогон заполнения формы в режиме Fast — 53,5 с у Terra против 3 мин 21,7 с у Sol. Это единичный запуск, а не замер, и выводов о том, на каких задачах разрыв больше, из него сделать нельзя.
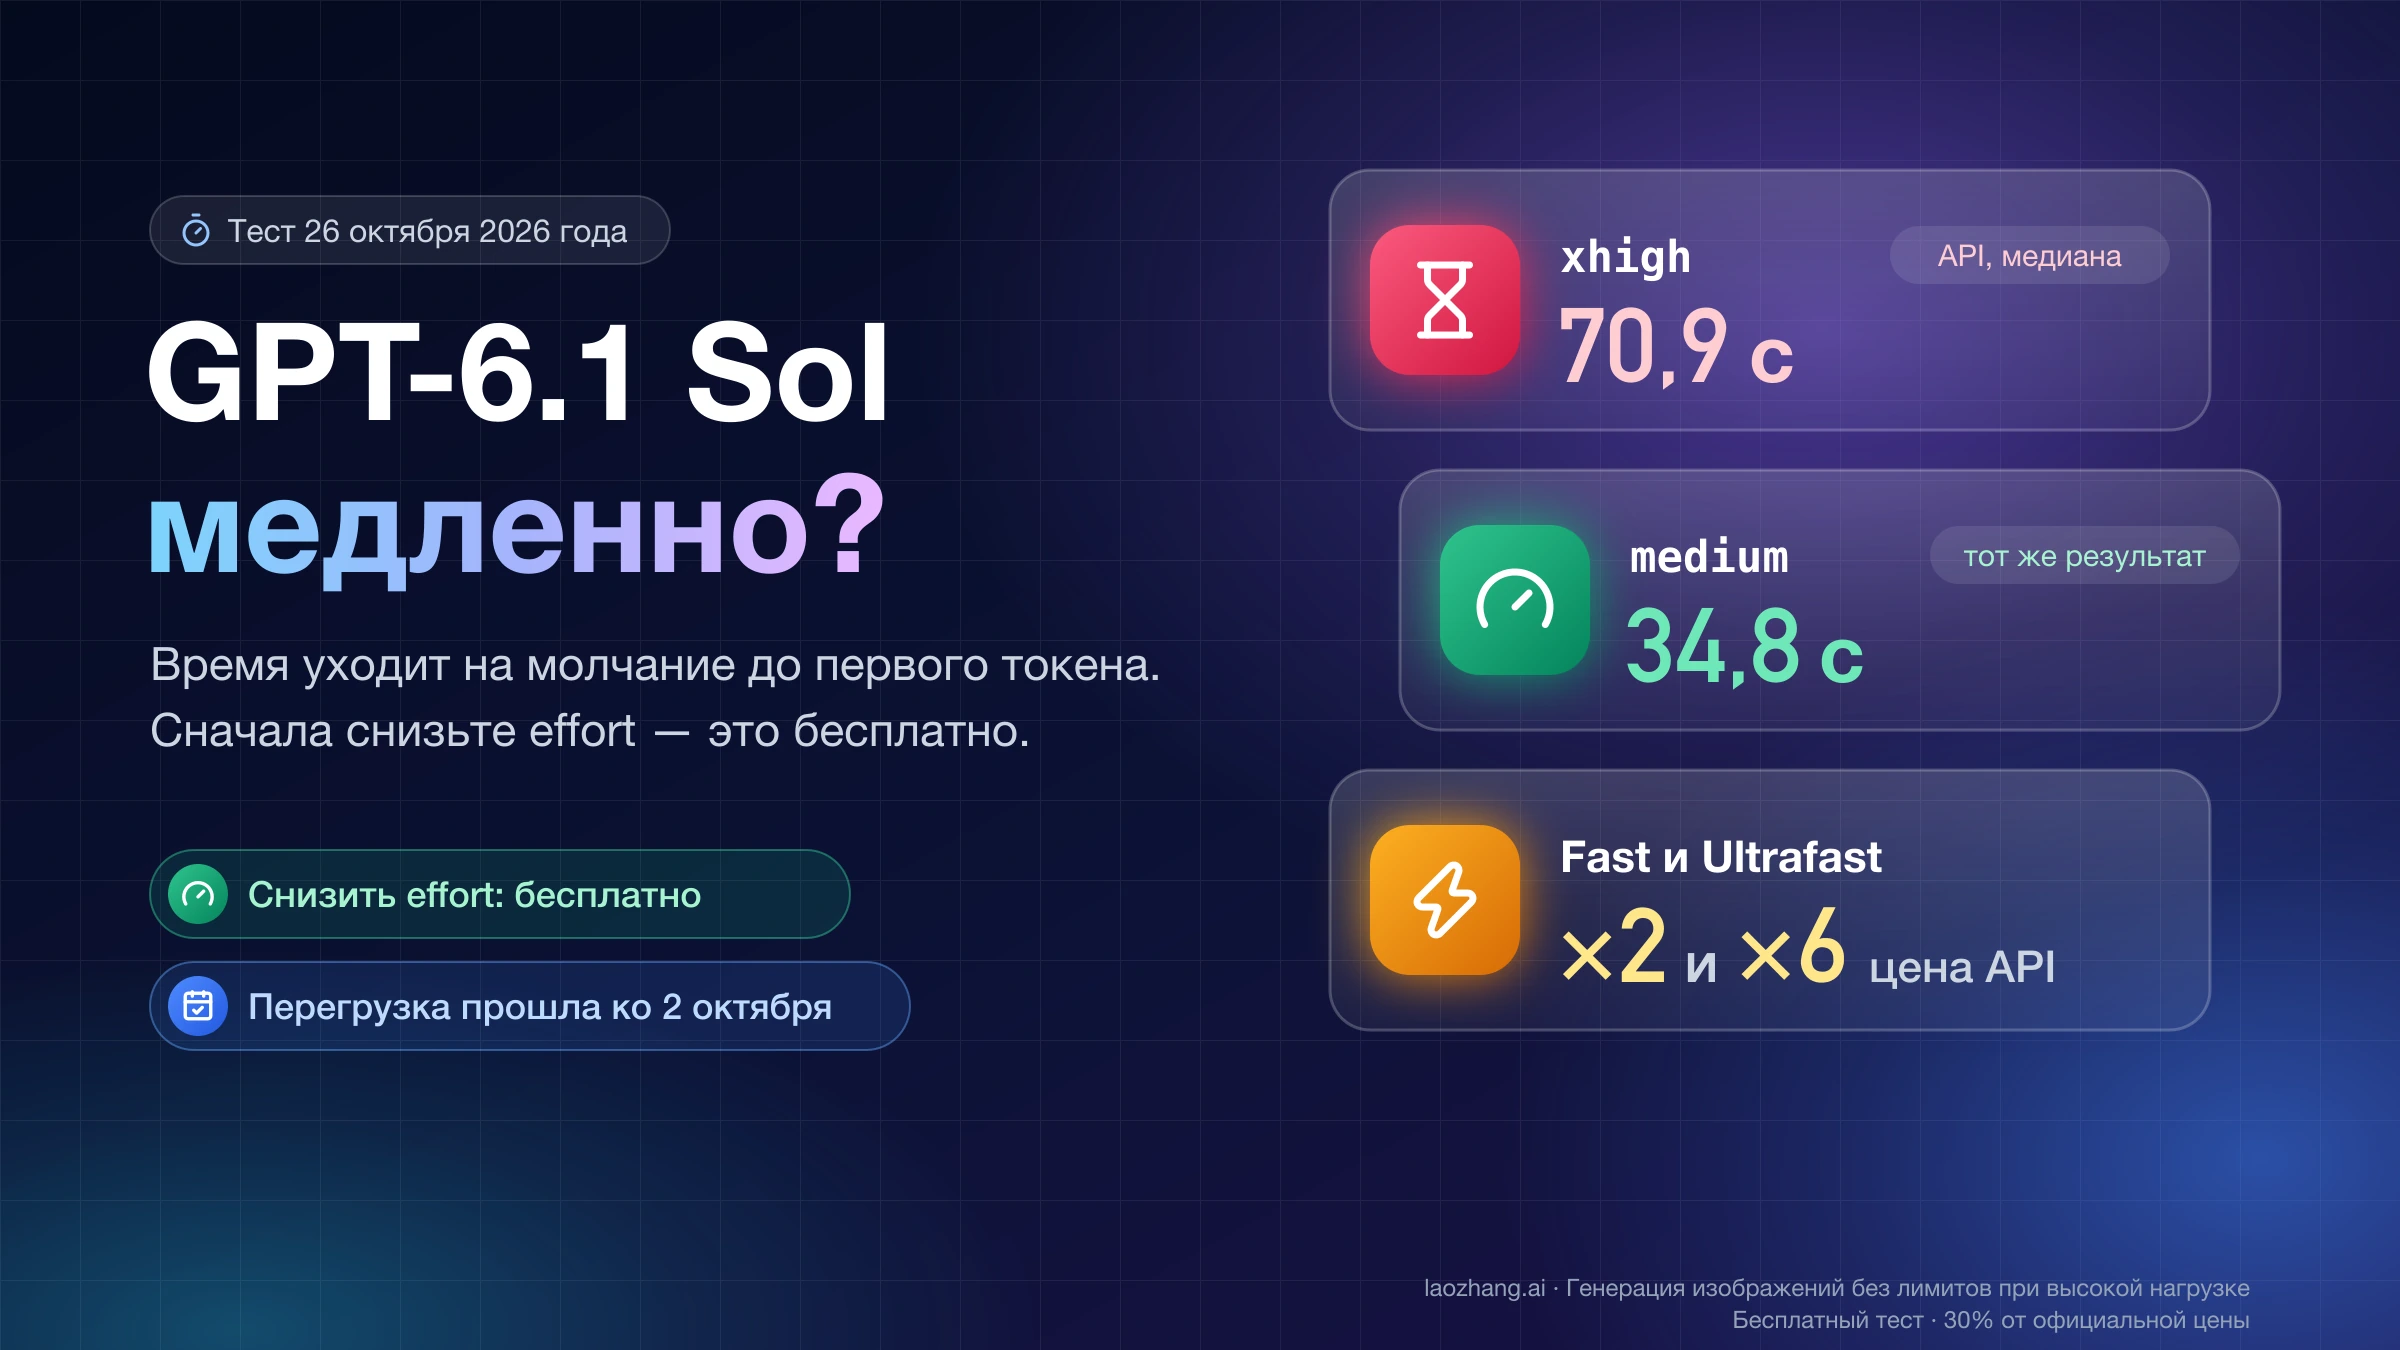
Если мешает именно медленная Sol, а менять модель не хочется, её можно ускорить настройками — замеры по уровням собраны в материале «GPT-6.1 Sol медленно работает: замеры по effort и как ускорить».
Хуже ли Terra в коде: на сложных задачах и на medium заметно
Да, если задача трудная. В Terminal-Bench 4.0 — наборе задач для агентов в командной строке, входящем в индекс Artificial Analysis, — Terra на medium решает 32,3 % против 48,0 % у Sol на том же уровне, а на low — 15,2 % против 30,8 %. Только на max результаты почти равны (55,6 % против 56,1 %), но Terra max, как видно из таблицы равных баллов, дороже и медленнее Sol medium. OpenAI в анонсе сама пишет, что для самых сложных задач программирования лучшим выбором остаются GPT-6.1 Sol и GPT-6 Astra; по её собственному замеру Terra на max решает 50,3 % Terminal-Bench 4.0.
Обратный пример тоже есть, и тоже из тестов OpenAI: в Terminal-Bench-Science 0.1, научных задачах с кодом, Terra на max обходит Sol при меньшей стоимости. В ветке о выходе модели на Reddit r/codex в первые сутки звучит похожий вывод: Terra хороша на конкретных рабочих сценариях, Sol сильнее на трудном коде. Отсюда практическое правило: если ваша задача проходит на Terra medium или high, оставайтесь на Terra; если ей нужен max, сравните с Sol medium — по данным выше Sol, скорее всего, окажется и дешевле, и быстрее.
Второе место, где Sol сильнее, — знания без поиска. В тесте AA-Omniscience, который штрафует за выдуманные ответы, Sol набирает 38–42 балла в зависимости от уровня, Terra — от 4 без рассуждений до 30 на max. OpenAI по своему внутреннему набору провокационных вопросов приводит частоту ошибок Terra 16,7 % на low и 4,3 % на max и называет последний результат близким к Sol и Astra. Если модель отвечает на фактические вопросы без доступа к поиску или файлам, держите Terra на высоком уровне или оставьте такие запросы Sol. Дата среза знаний у Terra при этом свежее: 1 июня 2026 года против 30 апреля у Sol.
Изображения, формы и интерфейсы: здесь Terra хватает
Для работы с картинками, графиками и интерфейсами Terra — основной кандидат, и так её позиционирует сама OpenAI: документация по моделям ChatGPT и Codex называет GPT-6.1 Terra быстрым и экономичным выбором для письма, понимания изображений и управления компьютером. В задаче с картинками из теста 27 октября 2026 года Terra на none, medium и high извлекла все числа и нашла подложенную ошибку так же, как Sol, но за 29–38 с против 55–79 с.
Остальные данные — от OpenAI и сторонних наблюдателей. По заявлению OpenAI, в MMMU-Pro (визуальные рассуждения) Terra близка к Astra и Sol при гораздо меньшей стоимости, а в OSWorld 2.1 (многошаговые задачи в настольных приложениях) уже на medium превосходит лучший результат GPT-5.6 Terra. Значения Sol на графиках анонса текстом не приведены; пользователь X @rezoundous 26 октября 2026 года считал их с графиков приблизительно: MMMU-Pro около 85,5 у Terra против 86,3 у Sol, OSWorld 2.1 — около 78 против 79. Если ваши материалы похожи на чистые документы и скриншоты, разница в качестве по этим данным невелика; на плохих сканах, мелком шрифте и похожих символах (как l, I и 1 в тесте выше) проверьте обе модели на своих примерах.
Где доступны GPT-6.1 Terra и Sol: Work, Codex, API и Copilot
Обе модели есть в ChatGPT Work, Codex и OpenAI API, но не в обычном чате ChatGPT. Остальные различия по документации ChatGPT о тарифах Work и Codex и документации по моделям на 27 октября 2026 года:
| Где | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|
| Обычный чат ChatGPT | Нет | Нет |
| ChatGPT Work и Codex | Plus, Pro, Business, Enterprise, Edu | Есть; в Enterprise и Edu выключена, пока её не включит администратор |
| Free и Go | В списке нет | В списке нет |
| Расширение Codex для IDE | В списке поверхностей не указано | Есть |
| Ultrafast | Нет | В API; в Codex — на Pro за $500 и подходящих Enterprise и Edu |
| Уровни рассуждений в API | none, low, medium, high, xhigh, max | low, medium, high, xhigh, max |
| Обработка данных в ОАЭ | Не поддерживается | Отдельного ограничения не указано |
В анонсе OpenAI среди тарифов для Terra не назван Business, но документация Codex его перечисляет — ориентируйтесь на документацию и на то, что видно в выборе моделей вашего рабочего пространства: состав меню зависит от тарифа, настроек и постепенного развёртывания. В API у обеих моделей одинаковый набор инструментов (функции, веб-поиск, поиск по файлам, управление компьютером), и вызов инструментов у обеих работает только через Responses API. Цена, доступ и переход на саму Sol с предыдущей версии разобраны в материале «GPT-6.1 Sol: цена, доступ и что менять при переходе с GPT-6 Sol».
Terra также появилась в GitHub Copilot для Pro, Pro+, Max, Business и Enterprise с оплатой по прайсу поставщика — так сказано в журнале изменений GitHub от 26 октября 2026 года; развёртывание постепенное, и администратор может отключить модель политикой. Если вы подключаетесь к моделям OpenAI через сторонние шлюзы, проверяйте их список моделей: например, на laozhang.ai 27 октября 2026 года запрос GET /v1/models возвращал gpt-6.1-sol, но не gpt-6.1-terra.
Примечание: laozhang.ai — наш собственный сервис; его цены — наши тарифы, а не независимое сравнение.
Насколько больше задач на Plus и Business: 35–285 против 15–160
По оценке OpenAI для Plus и Standard Business, за пятичасовое окно помещается 35–285 локальных сообщений на GPT-6.1 Terra и 15–160 на GPT-6.1 Sol, то есть в 1,8–2,3 раза больше. OpenAI оговаривает, что это не фиксированные лимиты: расход зависит от контекста, рассуждений, инструментов и кэширования, облачные задачи тратят больше локальных, а поверх пятичасового окна могут действовать недельные лимиты. На тарифах Pro пятичасового лимита сейчас нет. Цифры приведены по документации ChatGPT о тарифах на 27 октября 2026 года.
Когда включённый лимит исчерпан или рабочее пространство платит кредитами, считаются кредиты Codex: за 1 млн токенов Terra стоит 25 кредитов за ввод, 1,25 за кэшированный ввод и 125 за вывод, Sol — 50, 2,5 и 250; отдельной платы за запись в кэш в кредитах нет. Это третий счётчик, не связанный напрямую ни с лимитом подписки, ни с долларами API, и OpenAI прямо пишет, что ставки в кредитах сами по себе не определяют, сколько работы помещается в подписку. На практике разница по кредитам выходит больше двух раз, потому что Sol тратит больше токенов, — это видно в тесте выше.
Как переключить Codex на GPT-6.1 Terra
Переключение занимает минуту; важно только, чтобы Codex CLI был версии 0.159.0 или новее — так требует документация Codex по моделям.
- Проверьте версию командой
codex --versionи, если она ниже 0.159.0, обновите CLI тем же способом, каким устанавливали. - Для одного запуска укажите модель и уровень при старте:
codex -m gpt-6.1-terra -c model_reasoning_effort="medium". Для неинтерактивных запусков то же работает сcodex exec -m gpt-6.1-terra "…". - В уже открытой сессии наберите
/model, выберите GPT-6.1 Terra и уровень рассуждений. - Чтобы Terra была моделью по умолчанию, добавьте в
config.toml, общий для приложения ChatGPT, CLI и расширения для IDE, строкиmodel = "gpt-6.1-terra"иmodel_reasoning_effort = "medium". - В приложении ChatGPT и в Work в браузере выберите модель и уровень рассуждений переключателем под полем ввода.
В API достаточно поменять идентификатор модели на gpt-6.1-terra и задать reasoning.effort; если вы переходите с Sol, проверьте, что для вызова инструментов используется Responses API, а уровень рассуждений подобран заново: тот же medium у Terra слабее, чем у Sol. Если Terra не появилась в выборе моделей, причины разобраны в вопросах ниже.
Как сравнить Terra и Sol на своих задачах перед переходом
Сравнивайте стоимость принятого результата: сколько стоил весь прогон, делённое на число задач, результат которых вас устроил. Цена за токен и даже стоимость одного запроса тут мало что говорят, потому что модели тратят разное число токенов и шагов.
- Возьмите 5–10 реальных задач с автоматической проверкой: тесты, эталонный JSON, сверку с известными числами.
- Прогоните каждую на Terra и Sol на одном уровне, например
medium, а Terra — ещё и на ступень выше. Удобнее всегоcodex exec … --json: в событииturn.completedесть входные, кэшированные и выходные токены. - Посчитайте стоимость каждого запуска: (ввод − кэшированный ввод) × ставка ввода + кэшированный ввод × ставка кэша + вывод × ставка вывода, токены — в миллионах.
- Сложите стоимость по модели, разделите на число принятых результатов и отдельно запишите общее время.
Пример расчёта по задаче со счетами из теста: Terra на medium прочитала 58 622 входных токена, из них 49 792 из кэша, и написала 1 245 выходных. В кредитах Codex это 0,008830 × 25 + 0,049792 × 1,25 + 0,001245 × 125 = 0,22 + 0,06 + 0,16 = 0,44 кредита, а по прайсу API — 0,008830 × $1 + 0,049792 × $0,05 + 0,001245 × $5 ≈ $0,0175.
Из этого следует простое правило. Terra дешевле за принятый результат, пока её доля принятых решений больше, чем доля Sol, умноженная на отношение стоимостей прогона. В тесте 27 октября это отношение на парах medium было около 0,41 (2,30 / 5,56 кредита), то есть Terra оставалась бы дешевле, даже если бы принималось вдвое меньше её решений. На практике порог строже: каждая неудача стоит ещё и вашего времени на разбор и повторный запуск, поэтому, если Terra заметно чаще ошибается на ваших задачах, Sol может оказаться выгоднее при любой цене токена.
Частые вопросы о GPT-6.1 Terra и GPT-6.1 Sol
GPT-6.1 Terra — это та же модель, что GPT-5.6 Terra?
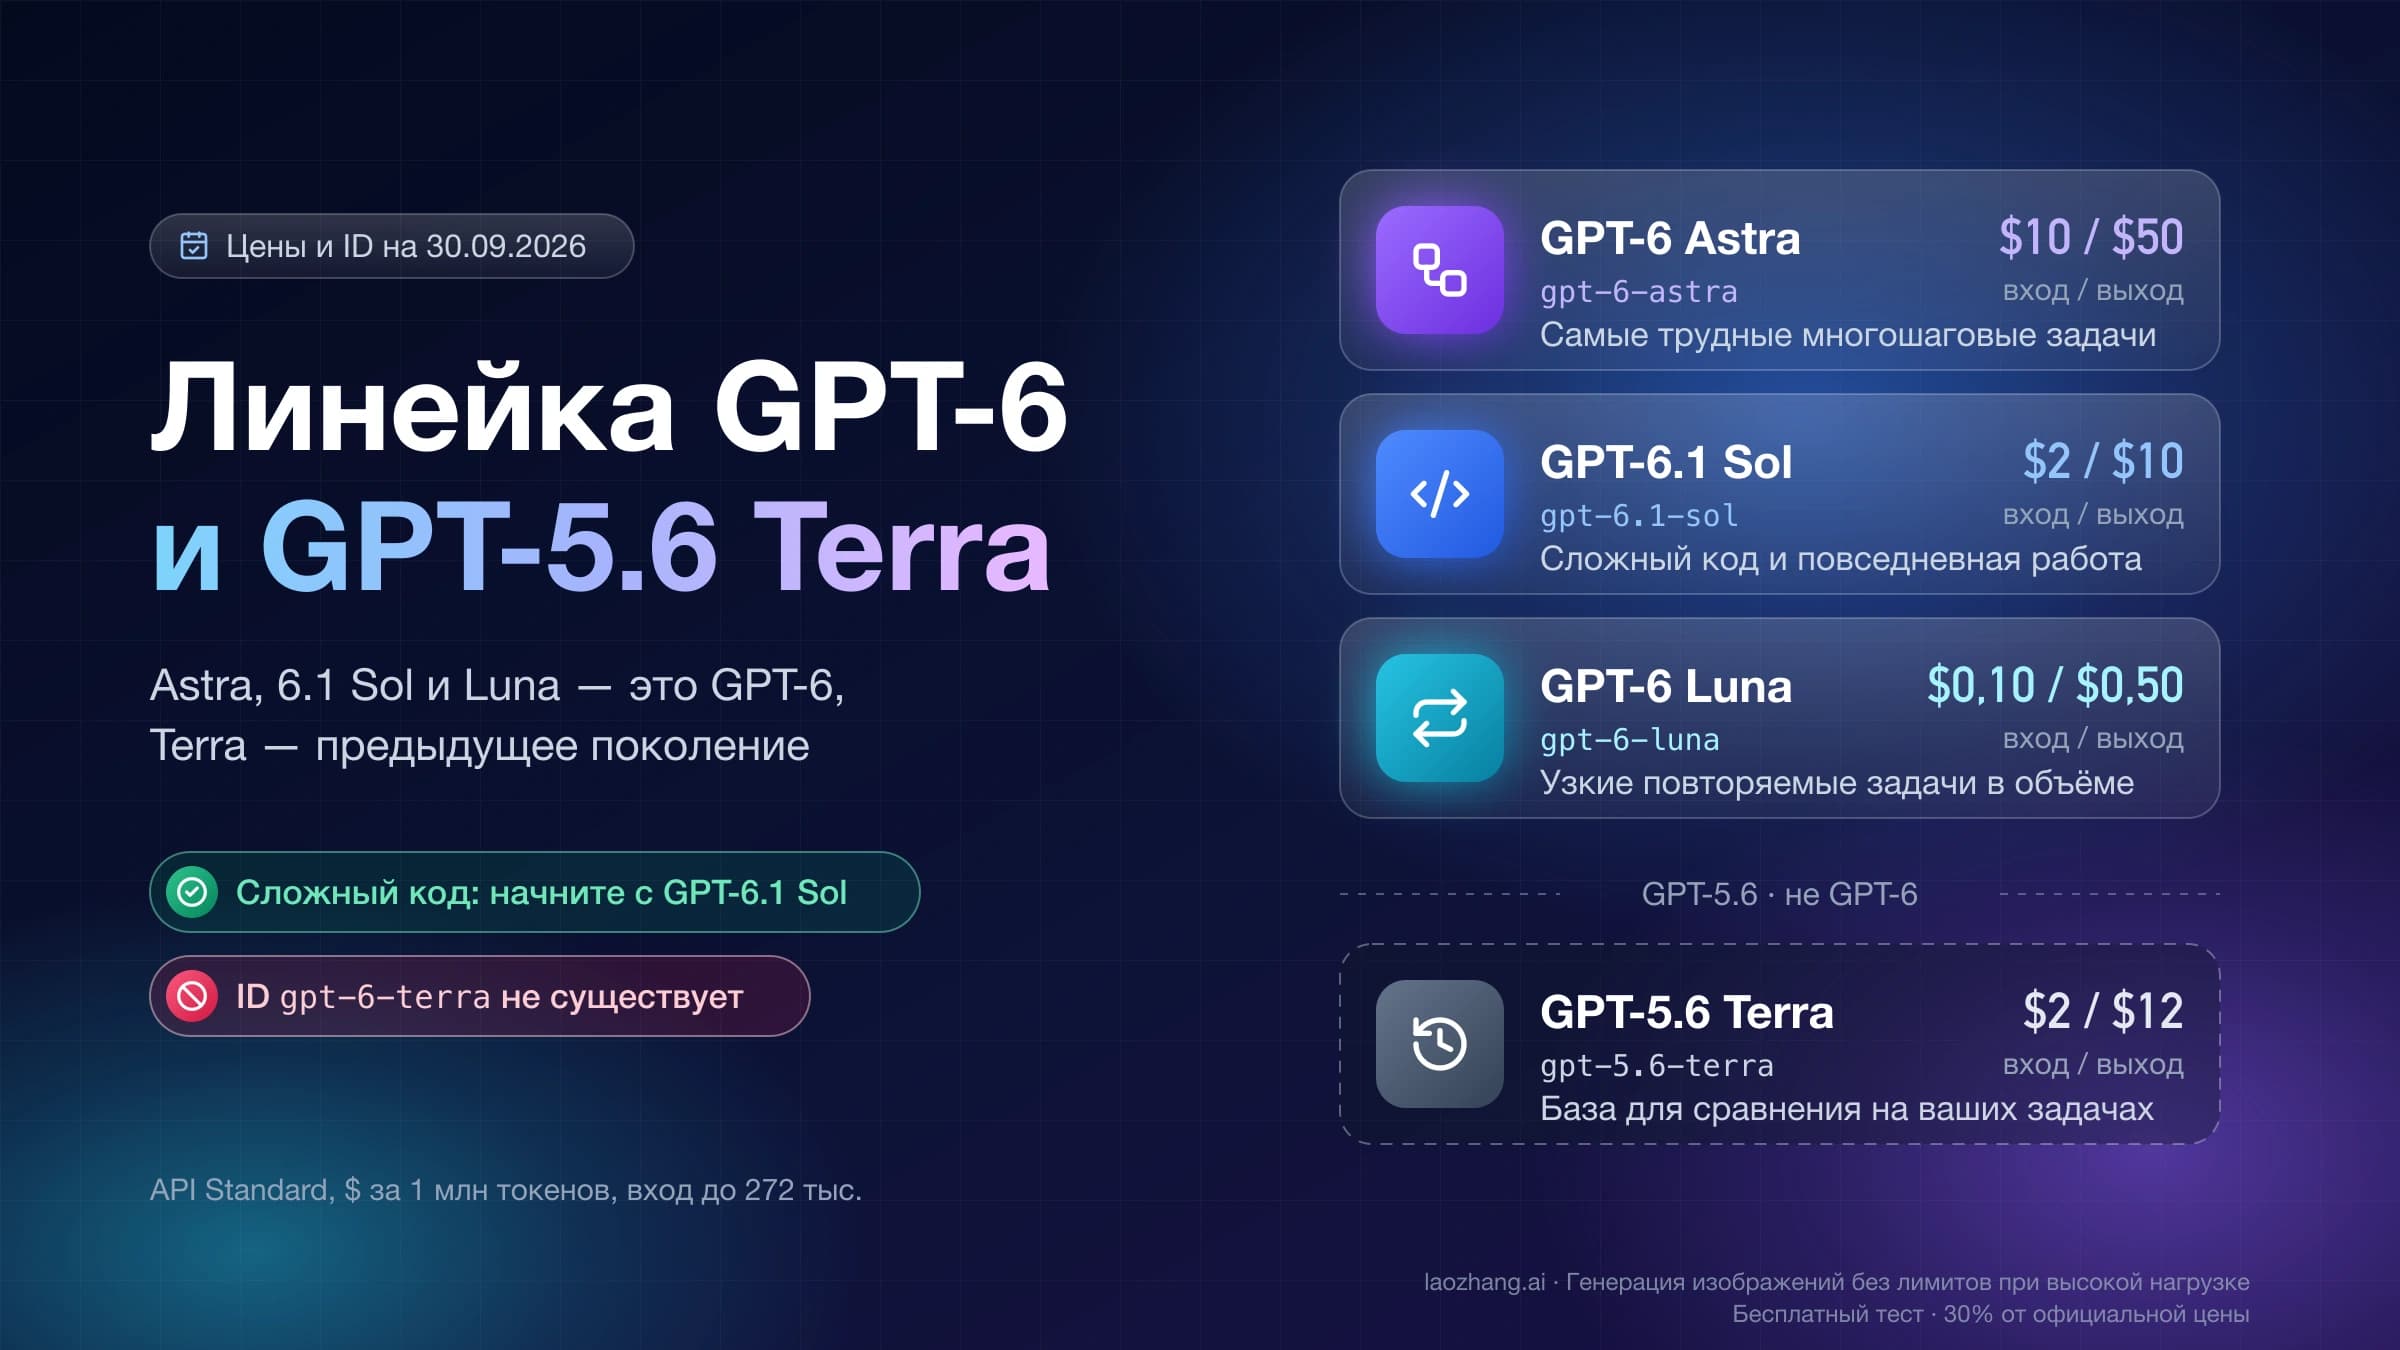
Нет. GPT-6.1 Terra вышла 26 октября 2026 года как следующее поколение Terra, которое OpenAI называет большим шагом вперёд по сравнению с GPT-5.6 Terra, но старая модель по-прежнему продаётся: на 27 октября 2026 года GPT-5.6 Terra стоит в API $2 за ввод и $12 за вывод за 1 млн токенов, а в Codex — 50, 5 и 300 кредитов. Если где-то написано просто «Terra» и цена $2 / $12, речь о предыдущей модели, которая дороже новой.
Не лучше ли сразу перейти на GPT-6 Astra?
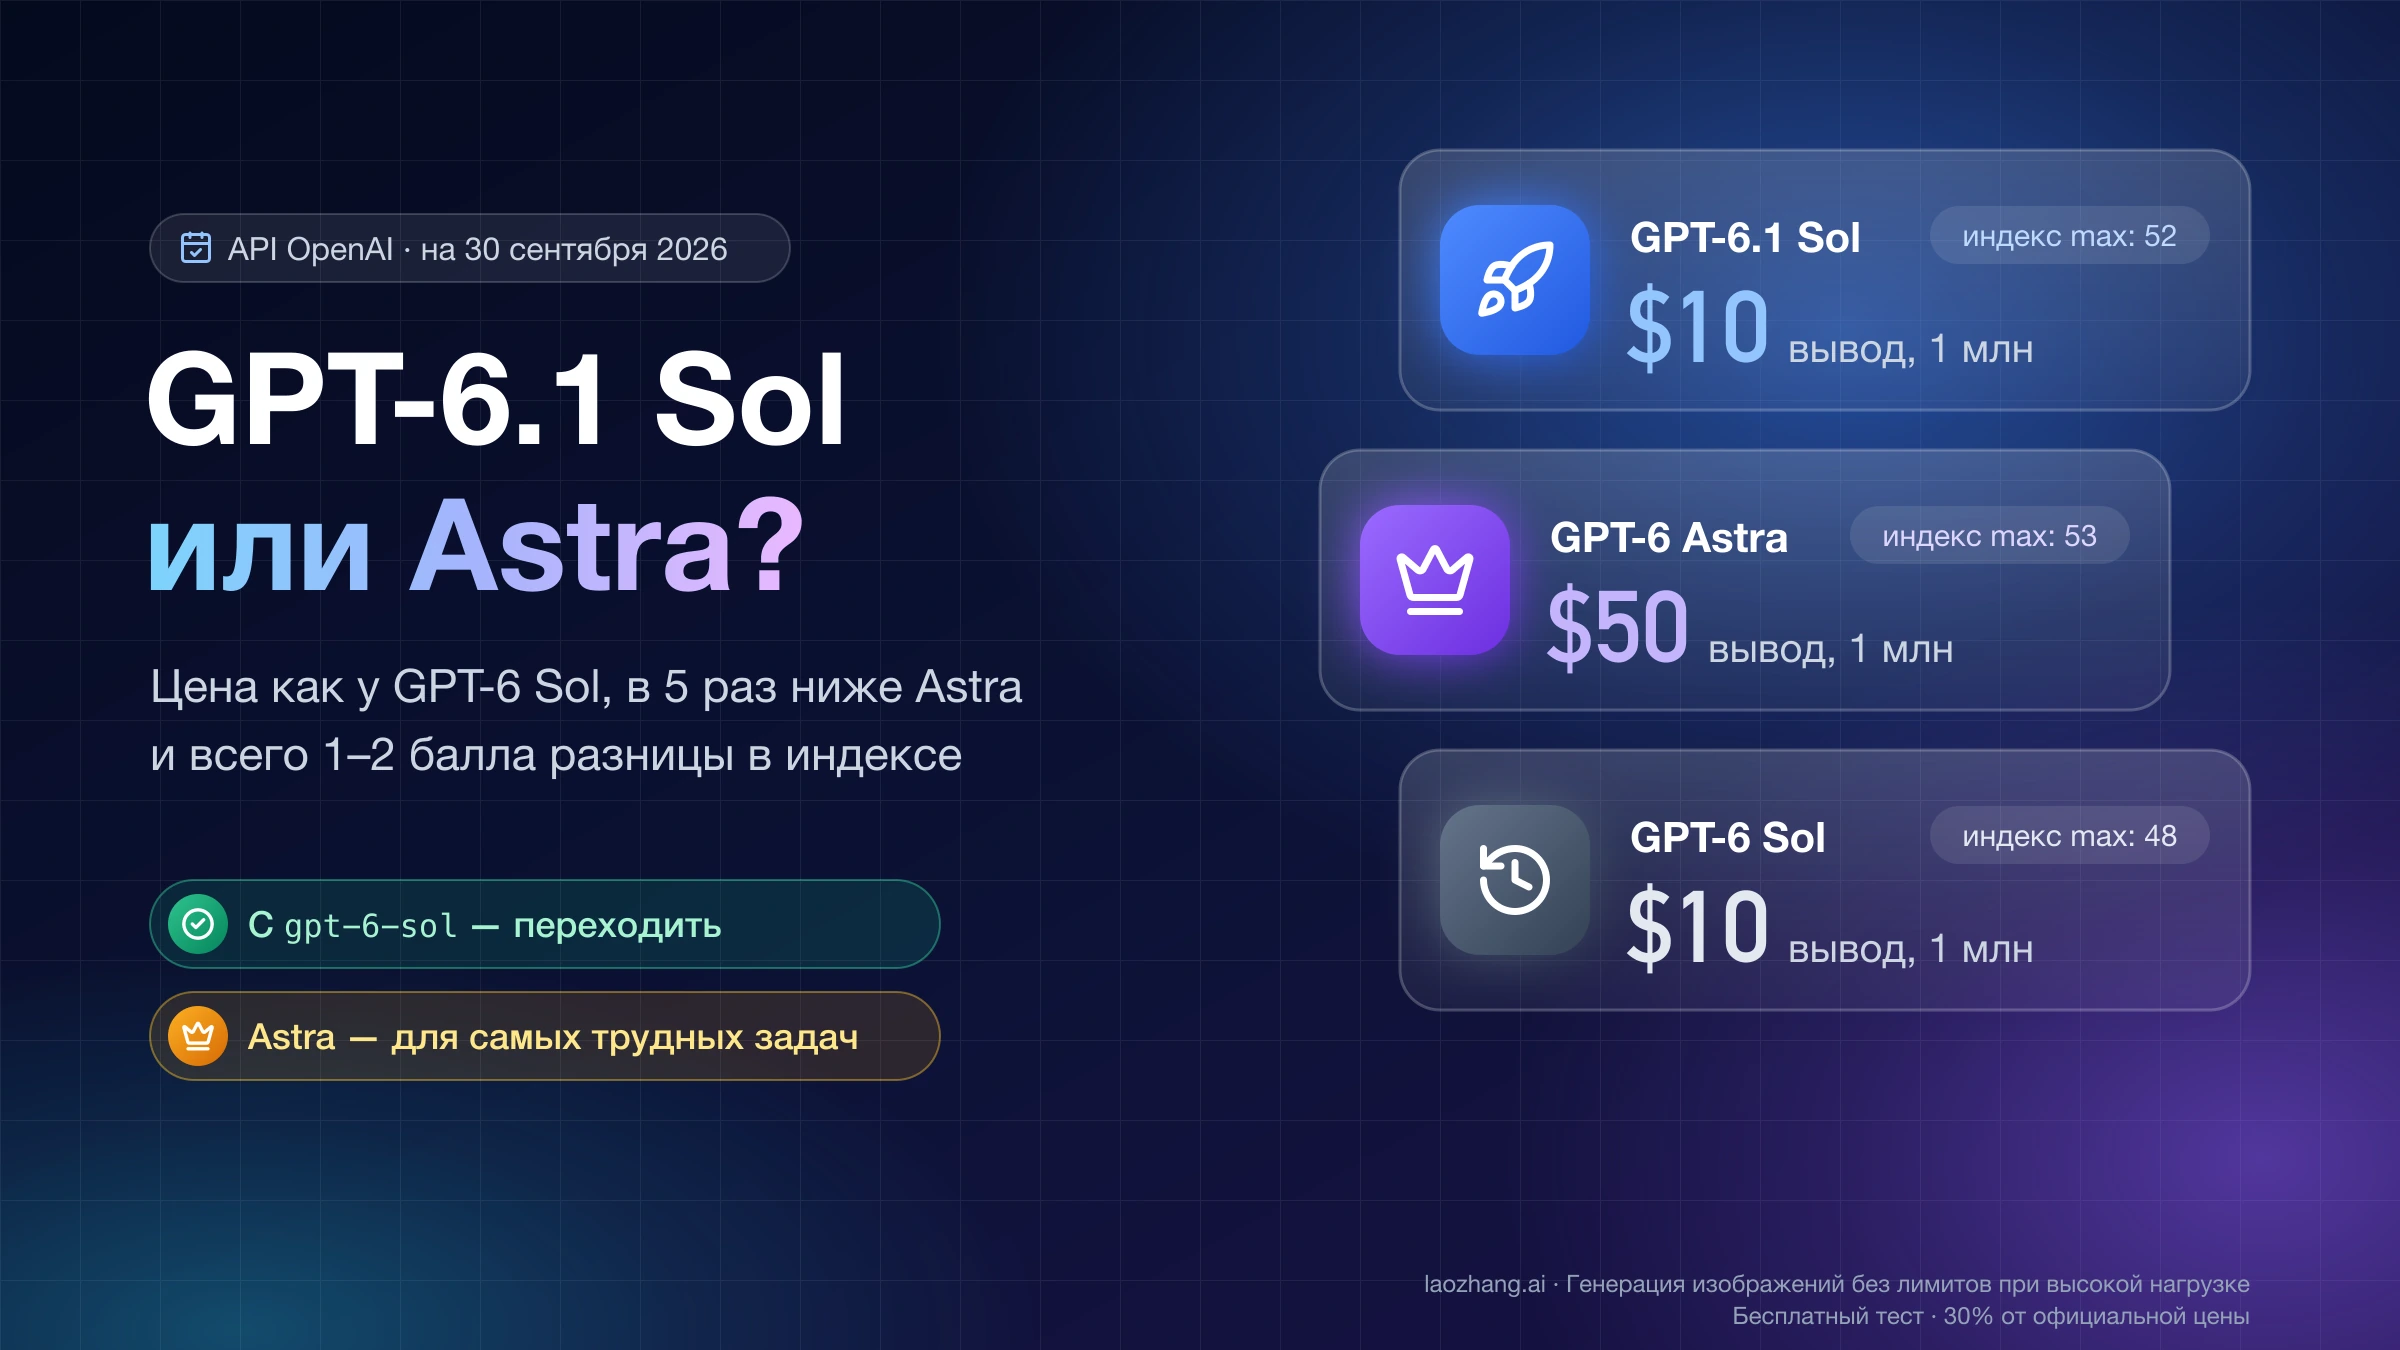
Только для самых трудных задач, где одна ошибка дороже разницы в цене. По кредитам Codex на 27 октября 2026 года Astra стоит 250 за 1 млн входных токенов против 50 у Sol и 25 у Terra, а на Plus за пять часов её хватает на 5–45 локальных сообщений. Когда Astra окупается, а когда хватает GPT-6.1 Sol, разобрано в материале «GPT-6.1 Sol, GPT-6 Astra и GPT-6 Sol: какую модель выбрать».
Почему GPT-6.1 Terra не видна в Codex?
Чаще всего из-за версии: Terra не работает в Codex CLI старше 0.159.0. Модели нет на тарифах Free и Go, в документации на 27 октября 2026 года она не указана для расширения Codex в IDE, а в Enterprise доступ зависит от настроек рабочего пространства и администратора. OpenAI выкатывает модель постепенно, поэтому в первые дни она может появиться в меню не у всех.
Источники6
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 27 окт. 2026 г..
Источники6
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 27 окт. 2026 г..
- 1.странице цен OpenAI APIdevelopers.openai.com/api/docs/pricing
- 2.сравнение GPT-6.1 Terra и GPT-6.1 Sol по всем уровням рассужденийartificialanalysis.ai/models/releases/comparisons/gpt-6-1-terra-vs-gpt-6-1-sol
- 3.анонсе GPT-6.1 Terraopenai.com/index/introducing-gpt-6-1-terra
- 4.документация по моделям ChatGPT и Codexlearn.chatgpt.com/docs/models
- 5.документации ChatGPT о тарифах Work и Codexlearn.chatgpt.com/docs/pricing
- 6.журнале изменений GitHub от 26 октября 2026 годаgithub.blog/changelog/2026-10-26-gpt-6-1-terra-in-github-copilot