Claude Sonnet 5.5: цены по уровням effort и переход с Sonnet 5
Claude Sonnet 5.5 стоит как Sonnet 5, но по данным Artificial Analysis задача на low–xhigh дешевле, а на max — на 51 % дороже. Пять изменений API ломают код.
Содержание
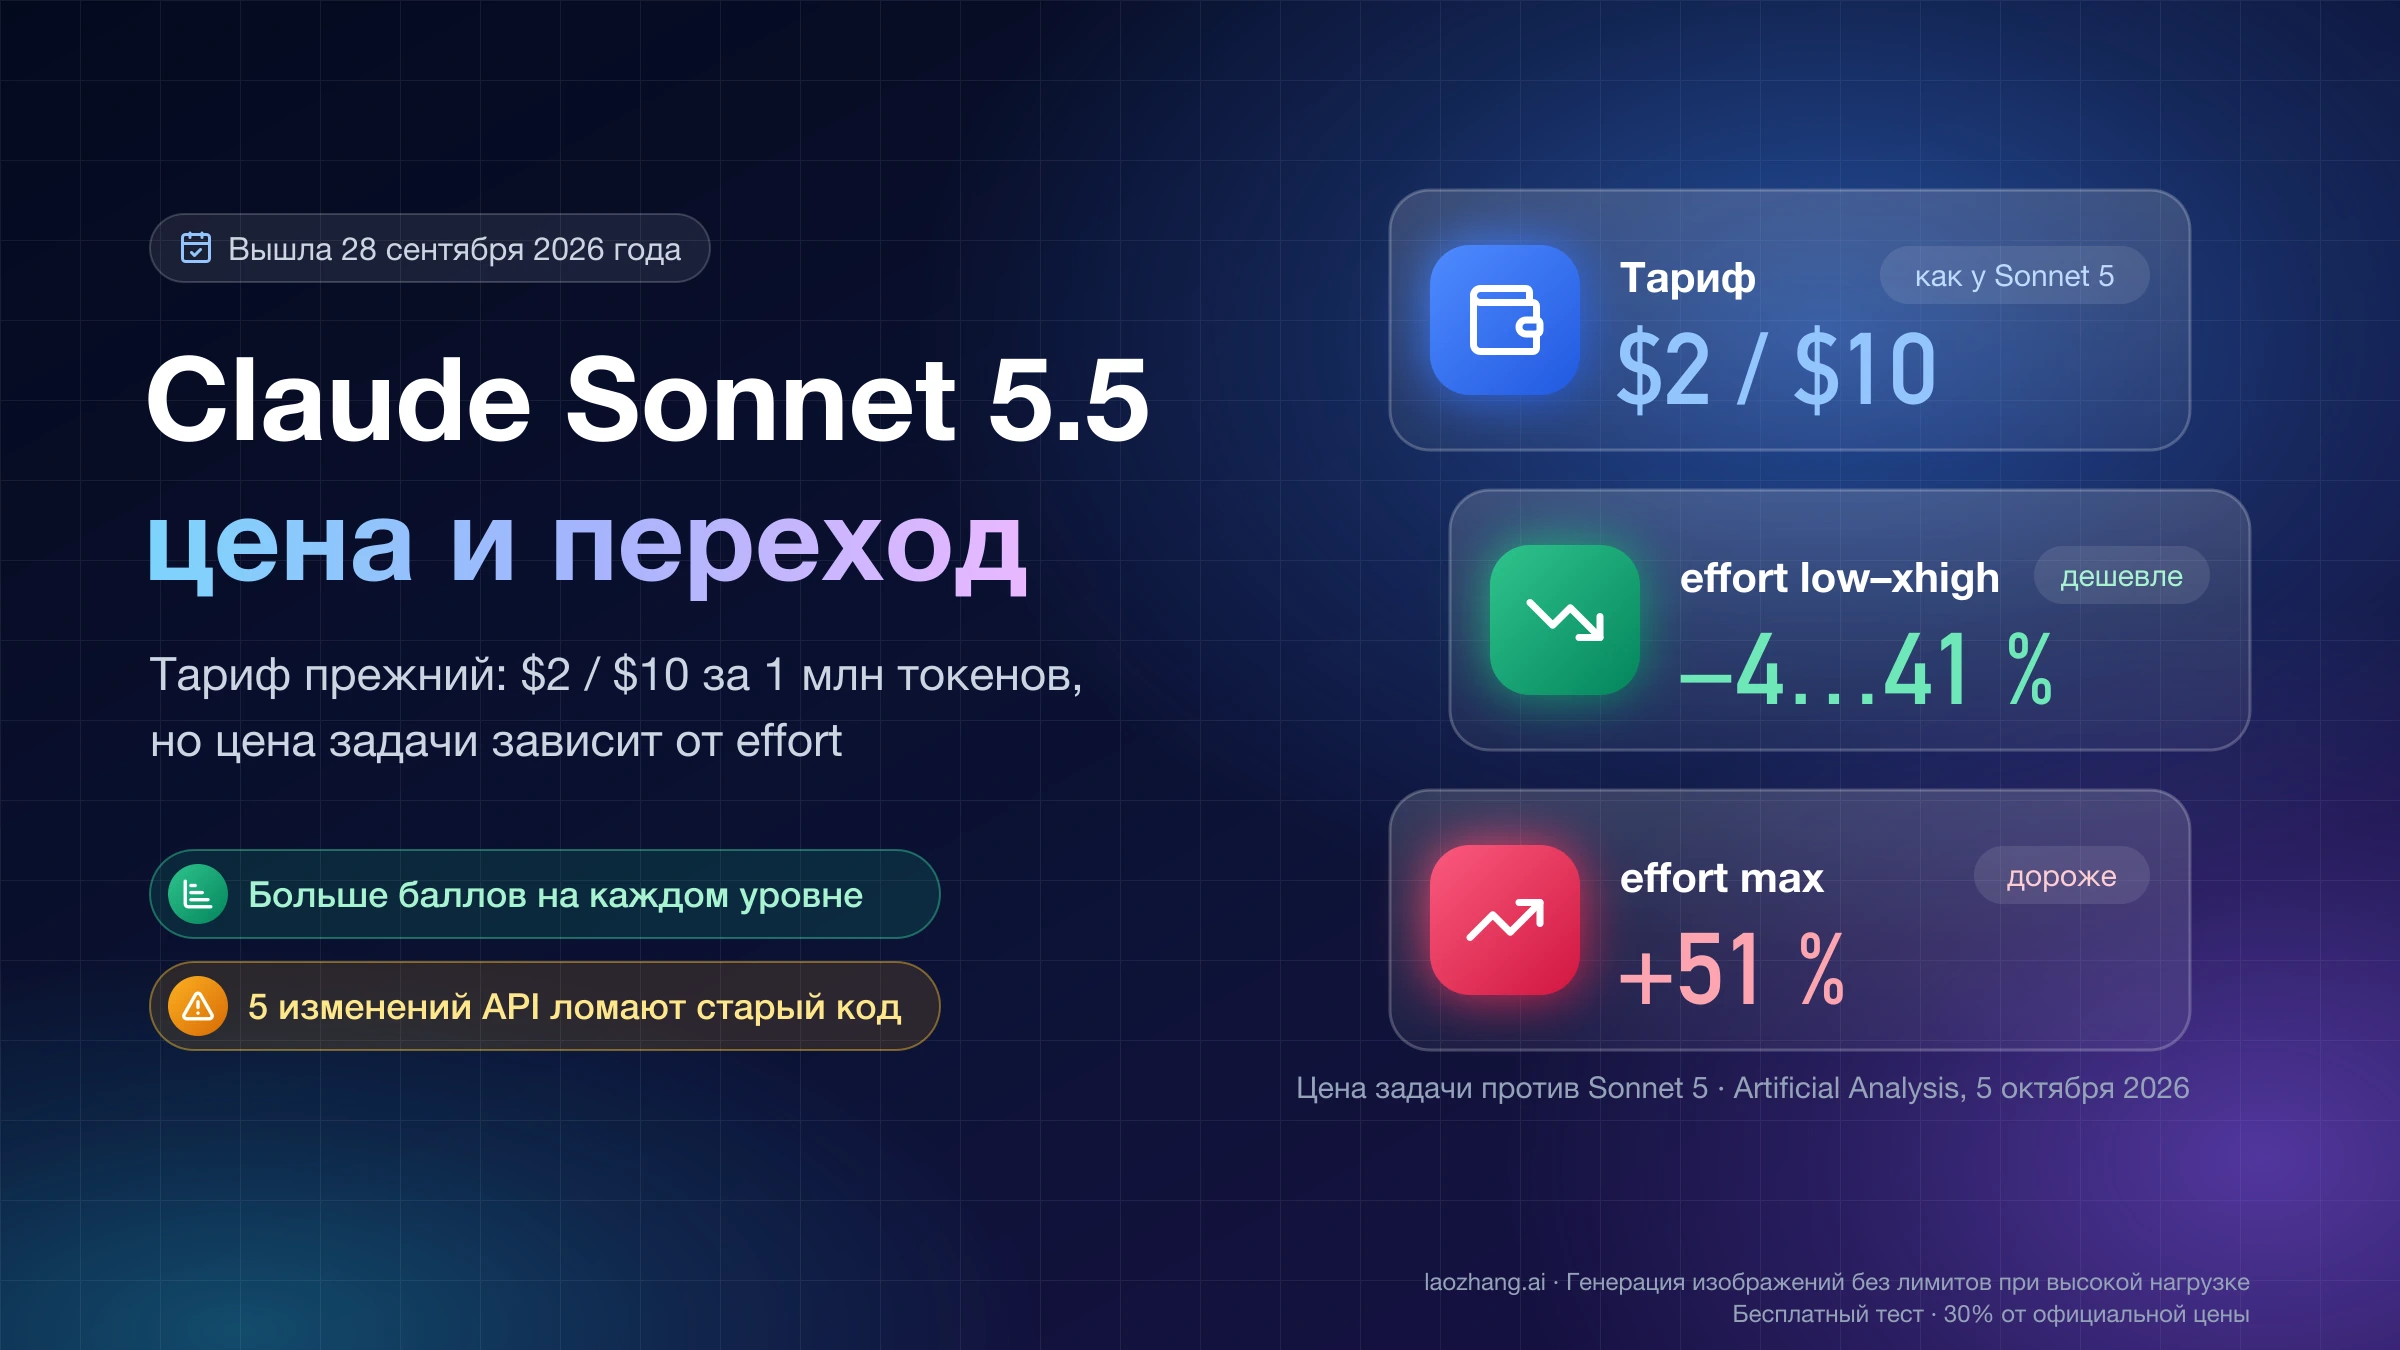
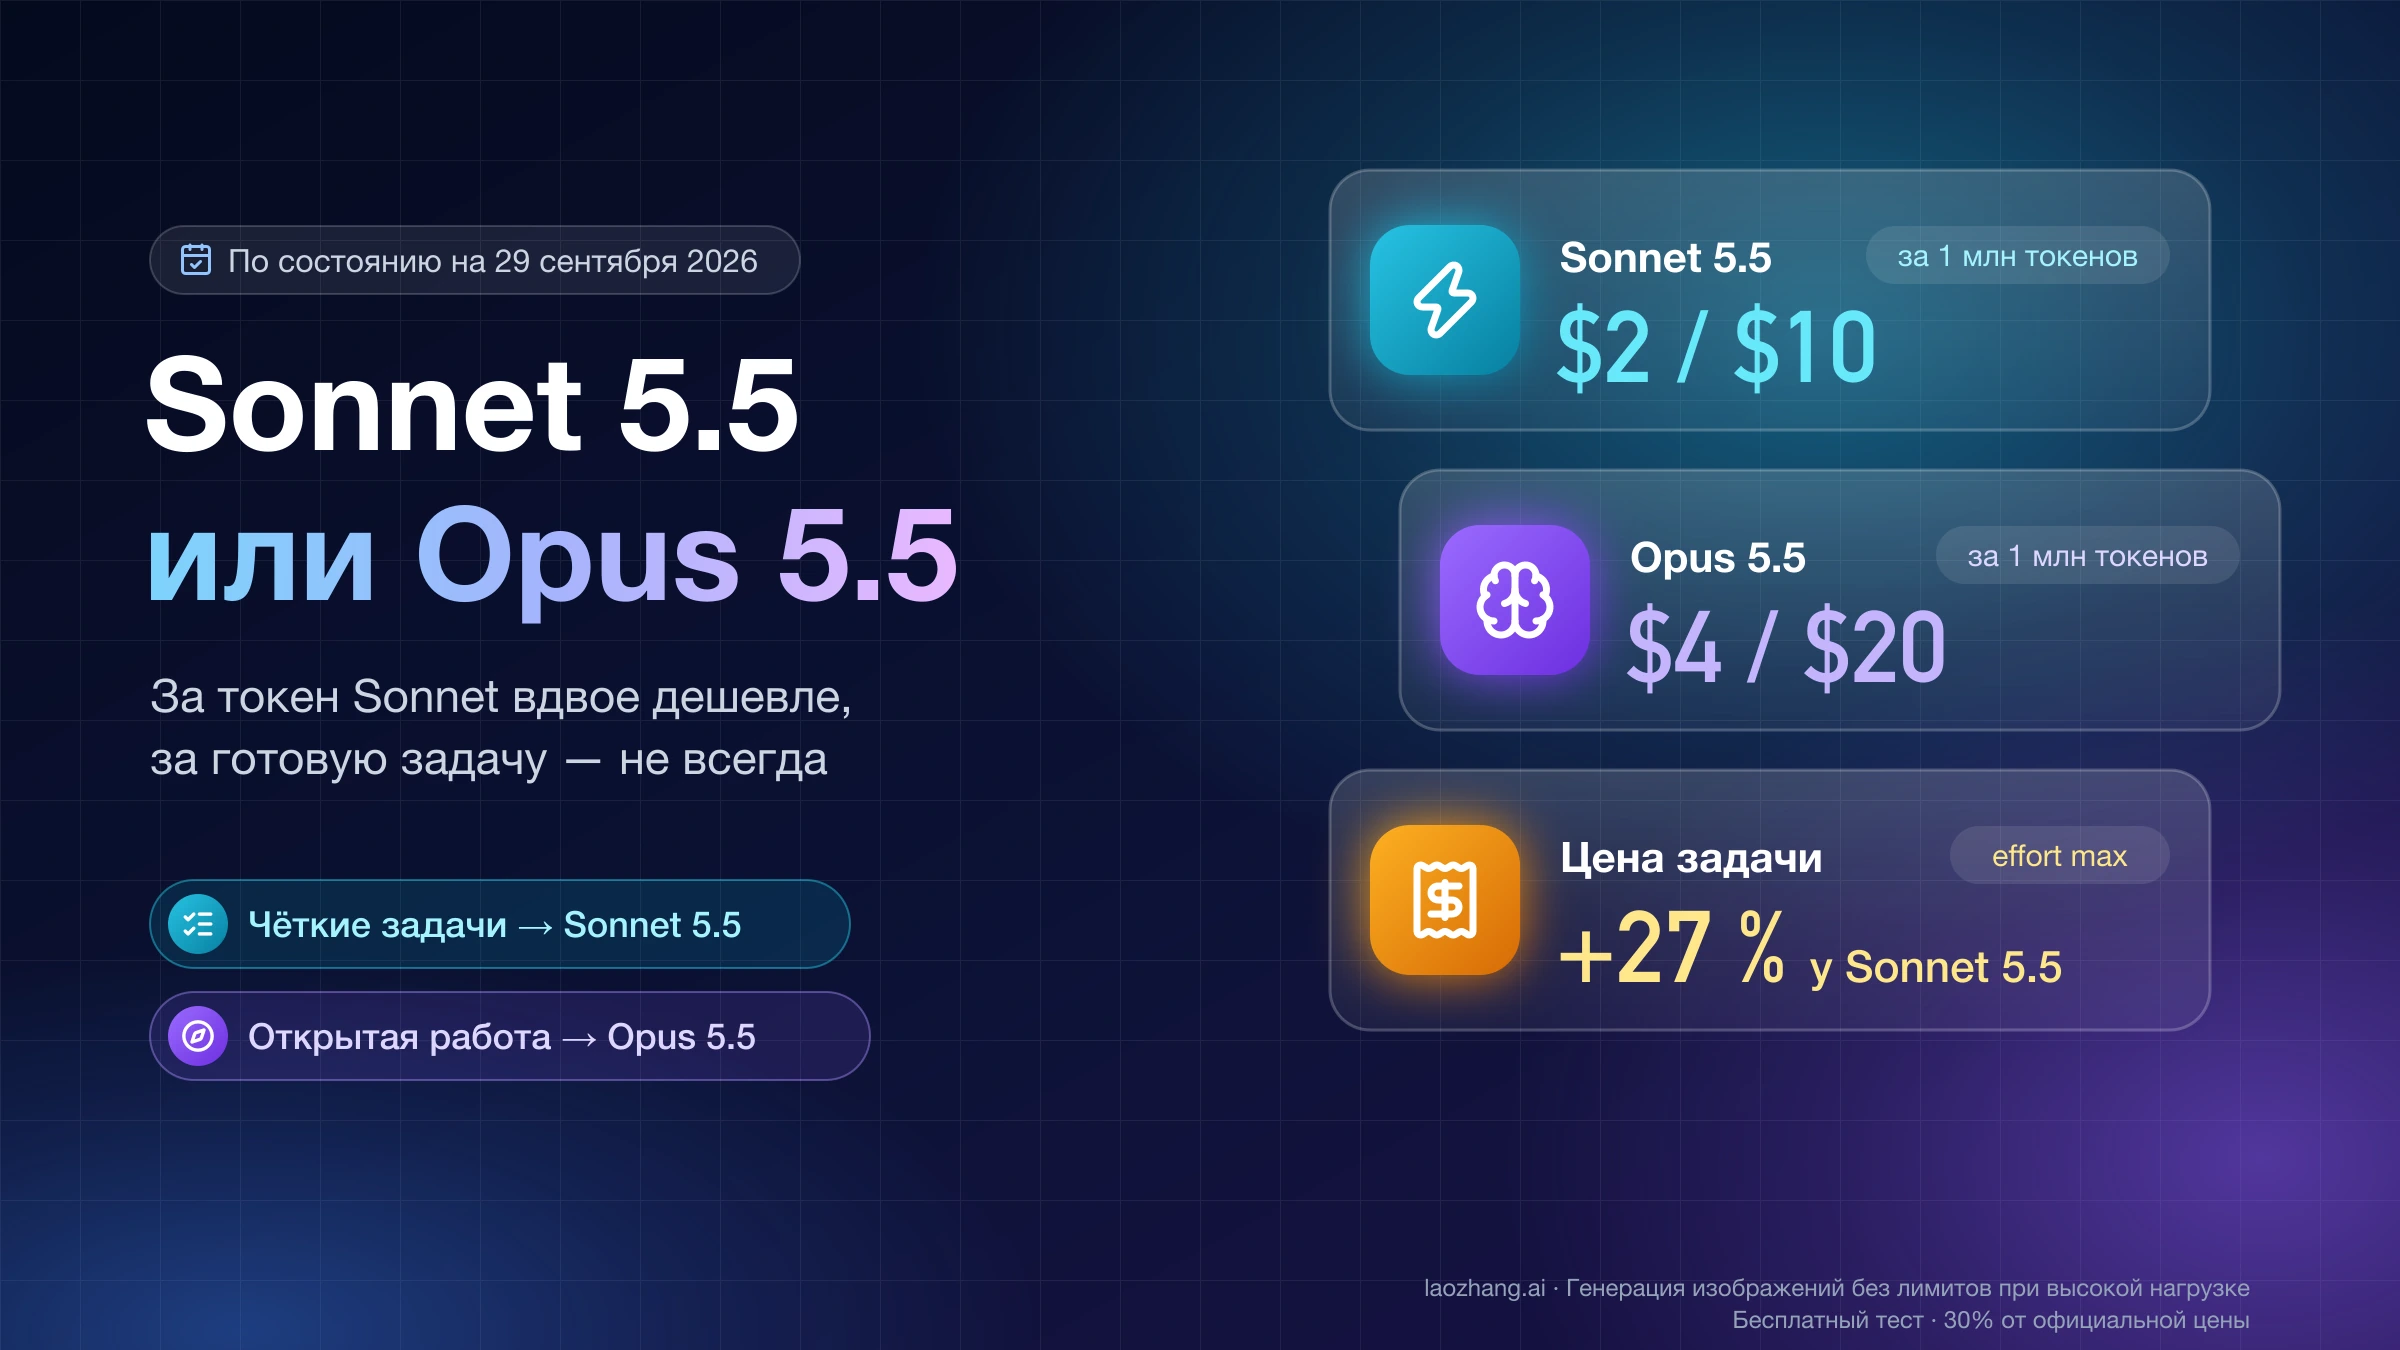
Claude Sonnet 5.5 (claude-sonnet-5-5) Anthropic выпустила 28 сентября 2026 года. Это преемник Sonnet 5 и по-прежнему модель класса Sonnet, а не Opus: тариф прежний — $2 за 1 млн входных и $10 за 1 млн выходных токенов, токенизатор тот же, контекст 1 млн токенов, а срез знаний сдвинулся с января на июнь 2026 года. Sonnet 5 при этом никуда не делся: он помечен как устаревший (legacy), но доступен, и отключат его не раньше 30 июня 2027 года.
Переходить в большинстве случаев стоит, но не простой заменой ID модели. Цена одной задачи зависит от уровня effort. По состоянию на 5 октября 2026 года в индексе Artificial Analysis Sonnet 5.5 на уровнях от low до xhigh обходится на 4–41 % дешевле Sonnet 5, на max — на 51 % дороже, и на каждом уровне набирает больше баллов. Поэтому верны оба заголовка: «до 30 % дешевле» у Anthropic и «примерно на 50 % дороже» у Artificial Analysis, просто второй сравнивает max с max.
Код, написанный под Sonnet 5, могут сломать пять несовместимых изменений: thinking: {"type": "disabled"} и принудительный tool_choice теперь возвращают ошибку 400, правка истории диалога ломает повтор thinking-блоков, а старый инструмент computer use и часть пар в advisor tool больше не принимаются. Ещё одно изменение ничего не ломает, но интерфейс, который показывал заметки модели между вызовами инструментов, замолкает. Если вы ещё на Sonnet 4.5, решение нужно принять до 30 ноября 2026 года: в этот день Anthropic отключает его в Claude API.
Чем Claude Sonnet 5.5 отличается от Sonnet 5: таблица характеристик
Почти всё, что влияет на счёт, совпадает. Различаются срез знаний, минимальный размер кэшируемого промпта и способ выключить размышления. Данные — со страницы модели Claude Sonnet 5.5, страницы Claude Sonnet 5 и прайса Claude API, по состоянию на 5 октября 2026 года.
| Claude Sonnet 5 | Claude Sonnet 5.5 | |
|---|---|---|
| ID в Claude API, Claude Platform on AWS, Google Cloud, Microsoft Foundry | claude-sonnet-5 | claude-sonnet-5-5 |
| ID в Amazon Bedrock | anthropic.claude-sonnet-5 | anthropic.claude-sonnet-5-5 |
| Дата выхода | 30 июня 2026 года | 28 сентября 2026 года |
| Статус в Claude API | устаревшая (legacy), доступна; отключение не раньше 30 июня 2027 года | активная; отключение не раньше 28 сентября 2027 года |
| Цена за 1 млн токенов | $2 вход, $10 выход | столько же |
| Кэш и пакетная обработка | запись на 5 минут $2,50, на 1 час $4, чтение $0,20; batch −50 % | столько же |
| Токенизатор | токенизатор Sonnet 5 | тот же: одинаковый текст даёт одинаковое число токенов |
| Контекст / максимум вывода | 1 млн / 128 тыс. токенов | 1 млн / 128 тыс. токенов |
| Срез знаний | январь 2026 года | июнь 2026 года |
| Минимальный кэшируемый промпт | 1 024 токена | 512 токенов |
| Как выключить размышления | thinking: {"type": "disabled"} | thinking: {"type": "between_tools"} |
| effort по умолчанию в API | high | high |
Только у Sonnet 5.5 есть effort для отдельного сообщения (бета), системные сообщения посреди диалога и смена набора инструментов посреди диалога (бета). Для длинных агентных сессий пригодятся ещё две беты: сжатие контекста по запросу (compact-2026-09-04) и описание инструментов прямо в сообщении (inline-tools-2026-09-15).
Почему Sonnet 5 вообще остался на $2 и $10 и как сверять расходы на кэш, разобрано в статье «Повышение цен Claude Sonnet 5 отменили: как пересчитать расходы на API».
Дешевле ли Sonnet 5.5, чем Sonnet 5: цена задачи на каждом уровне effort
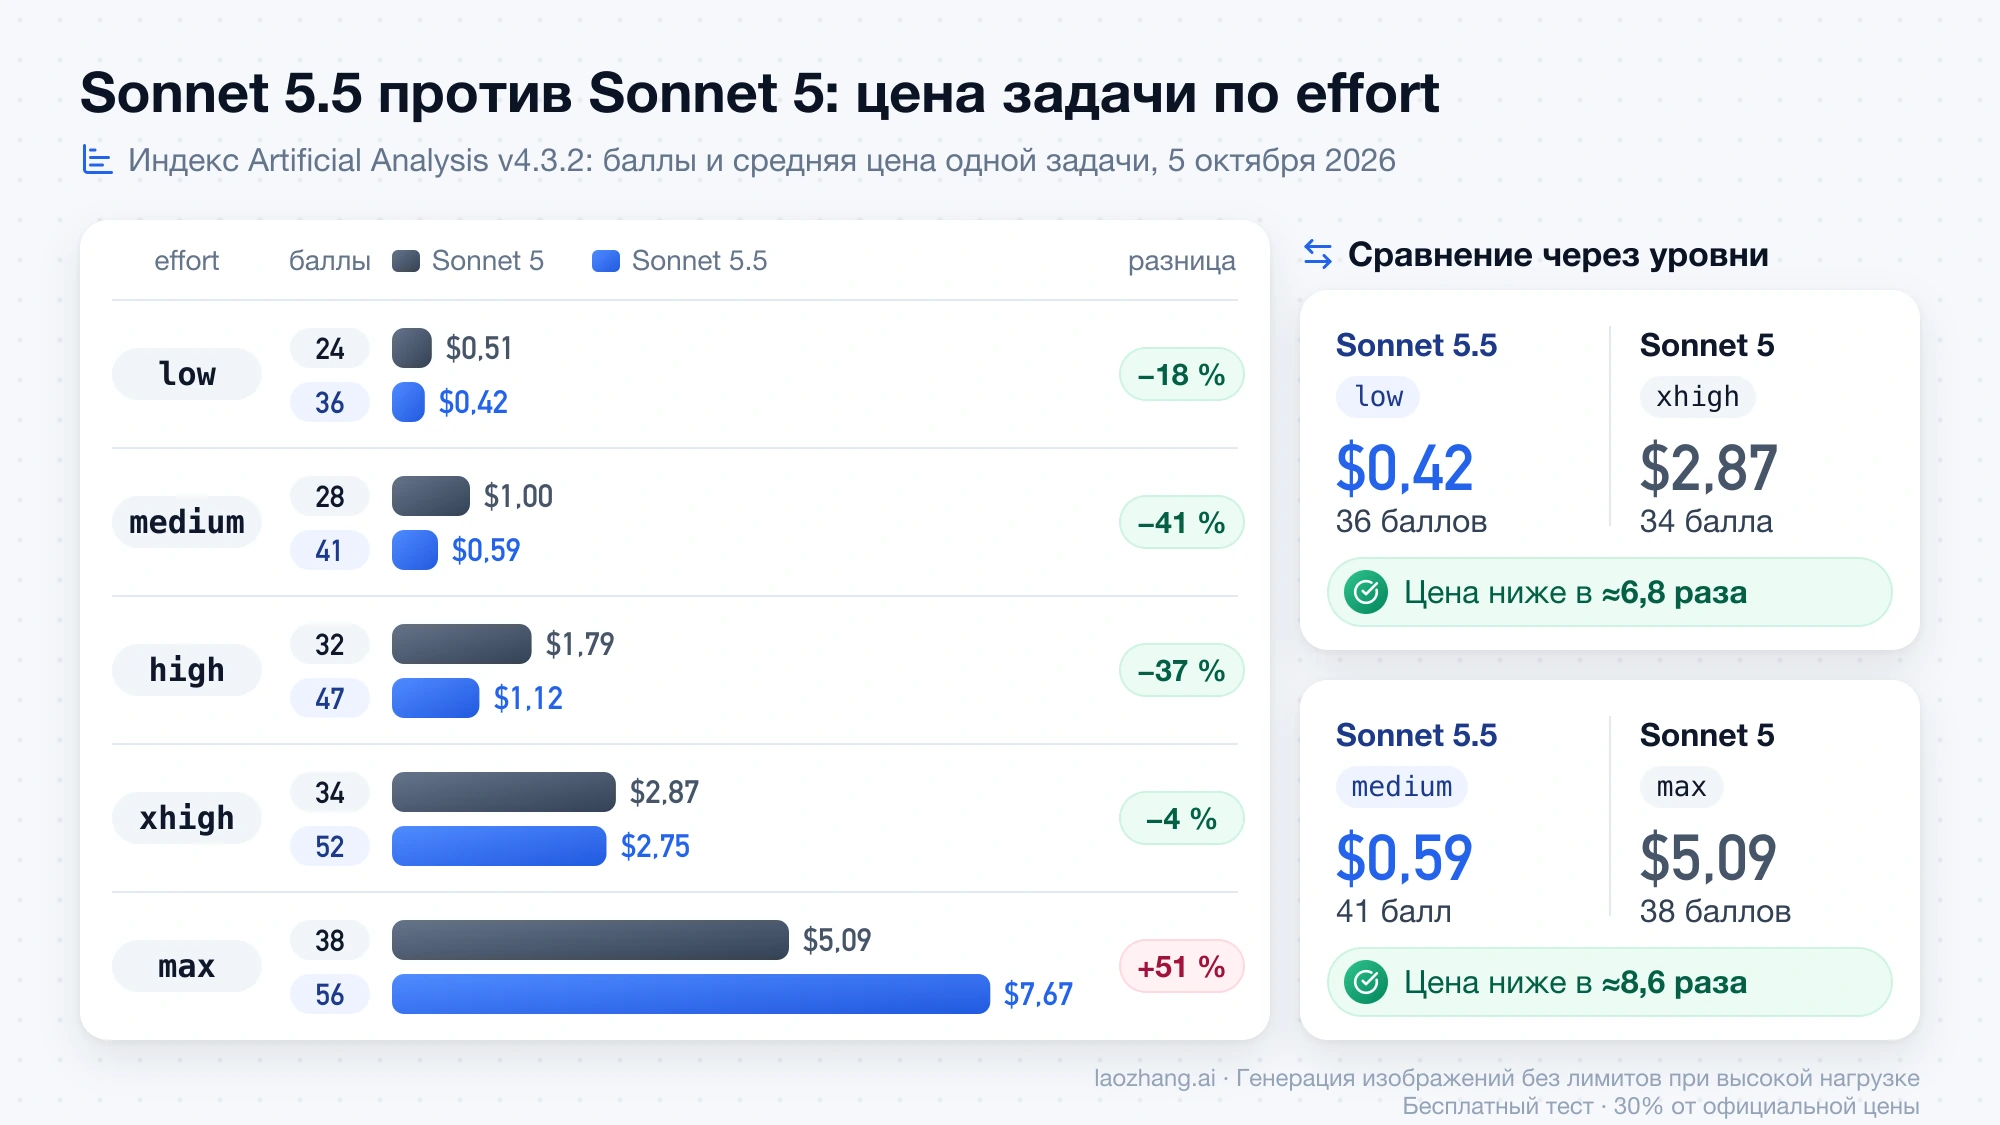
Цена за токен не изменилась, поэтому стоимость задачи определяется тем, сколько токенов модель на неё тратит. А это зависит от параметра effort (output_config.effort): он задаёт, насколько глубоко модель рассуждает, от low до max. Ниже — данные страницы Claude Sonnet 5.5 на Artificial Analysis (AA) по состоянию на 5 октября 2026 года: балл в Artificial Analysis Intelligence Index v4.3.2 (10 тестов) и средняя стоимость одной задачи индекса.
| effort | Sonnet 5: баллы / цена задачи | Sonnet 5.5: баллы / цена задачи | Разница в цене | Выходных токенов на задачу, 5 → 5.5 |
|---|---|---|---|---|
low | 24 / $0,51 | 36 / $0,42 | −18 % | 15,2 тыс. → 14,3 тыс. |
medium | 28 / $1,00 | 41 / $0,59 | −41 % | 27,3 тыс. → 20,9 тыс. |
high | 32 / $1,79 | 47 / $1,12 | −37 % | 44,3 тыс. → 37,3 тыс. |
xhigh | 34 / $2,87 | 52 / $2,75 | −4 % | 65,4 тыс. → 74,8 тыс. |
max | 38 / $5,09 | 56 / $7,67 | +51 % | 117,8 тыс. → 197,4 тыс. |
Разница в цене — расчёт по цифрам Artificial Analysis: (цена задачи Sonnet 5.5 ÷ цена задачи Sonnet 5) − 1. Для high: 1,12 ÷ 1,79 − 1 ≈ −37 %; для max: 7,67 ÷ 5,09 − 1 ≈ +51 %. Баллы округлены до целых.
Из таблицы следуют три вывода.
- На одинаковом уровне Sonnet 5.5 сильнее везде: прибавка от 12 баллов на
lowдо 18 наxhighиmax. - Дешевле он на уровнях от
lowдоxhigh. Самая большая экономия — наmediumиhigh, где модель пишет меньше выходных токенов. Наxhighтокенов уже больше, чем у Sonnet 5, и выигрыш почти исчезает. - На
maxзадача дороже на 51 %: Sonnet 5.5 выдаёт в среднем 197 тыс. выходных токенов против 118 тыс. у Sonnet 5.
Сравнение через уровни выглядит ещё нагляднее. Sonnet 5.5 на low (36 баллов, $0,42) обходит Sonnet 5 на xhigh (34 балла, $2,87) примерно при седьмой части цены: 2,87 ÷ 0,42 ≈ 6,8. Sonnet 5.5 на medium (41 балл, $0,59) обходит Sonnet 5 на max (38 баллов, $5,09) примерно за девятую часть: 5,09 ÷ 0,59 ≈ 8,6. Это совпадает с заявлением Anthropic, что на нескольких бенчмарках Sonnet 5.5 на Low или Medium превосходит лучший результат Sonnet 5 примерно за десятую часть цены задачи.
Почему одни пишут «до 30 % дешевле», а другие «на 50 % дороже»
Анонс Claude Sonnet 5.5 говорит, что модели «обычно нужно гораздо меньше токенов на ту же работу» и что в тестах Anthropic задача обходится «до 30 % дешевле». «До» здесь означает максимум, а не среднее. Разбор Artificial Analysis от 28 сентября 2026 года оценивает задачу на max примерно на 50 % дороже, чем у Sonnet 5, и называет расход токенов на этом уровне самым большим из всех измеренных моделей. Противоречия нет: Anthropic говорит о типичной работе, Artificial Analysis — о максимальном уровне.
Индекс — это фиксированный набор тестов со своим профилем диалогов и кэширования, а не прогноз вашего счёта. Sonnet 5.5 в нём запускали с серверным откатом Anthropic, и около 0,1 % задач перешли на Sonnet 5. Для своей нагрузки достаточно посчитать то же самое: суммарную стоимость прогонов, включая повторы, разделить на число результатов, прошедших вашу проверку.
Какой effort ставить на Sonnet 5.5 вместо настройки Sonnet 5
Переносить уровень со старой модели не нужно. В описании изменений Claude Sonnet 5.5 Anthropic прямо пишет, что уровни перекалиброваны: тот же effort даёт не тот объём размышлений, что на Sonnet 5, и подбор нужно провести заново. Стартовые точки от Anthropic:
- по умолчанию —
high, если нагрузка не агентная и не чувствительна к задержке; - агентное программирование и многошаговая работа с инструментами —
mediumдля чётко поставленных задач,highдля более сложных и длинных; - чат и всё, где важна задержка, —
mediumилиlow.
Если вы уже подобрали уровень для Sonnet 5, индекс Artificial Analysis подсказывает, с чего начать на новой модели. Это правило выведено из средних по индексу, поэтому соседний уровень всё равно стоит проверить на своих задачах.
| На Sonnet 5 стоял | С чего начать на Sonnet 5.5 | Что показывает индекс AA |
|---|---|---|
max | high; для чётко поставленных задач — medium | high: 47 баллов за $1,12 против 38 за $5,09 |
xhigh | medium или high | medium: 41 балл за $0,59 против 34 за $2,87 |
high | medium | 41 балл за $0,59 против 32 за $1,79 |
medium или low | low | 36 баллов за $0,42 против 28 за $1,00 и 24 за $0,51 |
размышления выключены (disabled) | between_tools на low, medium или high | поуровневых данных для этого режима в индексе нет |
max на Sonnet 5.5 имеет смысл включать, только когда задача не решается на xhigh. Это самый дорогой и самый медленный вариант: в индексе 968 секунд на задачу против 852 у Sonnet 5 на max. Больше effort не всегда значит лучше: в FrontierCode 1.1 Sonnet 5.5 на Max набрал 46,2 % против 52,1 % на Xhigh. В сноске к анонсу Anthropic объясняет это тем, что на Max модель чаще запускала навык ревью кода Claude Code, который делит работу между многими субагентами, и в разобранных случаях упиралась в таймаут или вносила правки сверх задачи. Сам Artificial Analysis по соотношению баллов и цены считает самым конкурентным уровнем high.
Насколько Sonnet 5.5 сильнее Sonnet 5: бенчмарки Anthropic и сторонние замеры
Прирост большой почти во всех тестах, но таблица Anthropic — это данные самого вендора, в основном на максимальном effort.
| Тест (данные Anthropic) | Sonnet 5 | Sonnet 5.5 | Opus 5.5 |
|---|---|---|---|
| Terminal-Bench 4.0 | 10,3 % | 70,6 % | 66,4 % (xhigh) |
| FrontierCode 1.1, основной набор | 42,4 % | 52,1 % (xhigh) | 54,4 % |
| CursorBench 4.0 | 34,1 % | 55,5 % | 57,8 % |
| GDPval-AA v2.1 | 1449 | 1844 | 1846 |
| OSWorld 2.1 (partial) | 57,0 % | 80,1 % | 81,8 % |
| Humanity's Last Exam, с инструментами | 54,9 % | 64,5 % | 67,7 % |
Здесь две оговорки. GDPval-AA и AA-Briefcase, по сноске в анонсе, запускала Artificial Analysis на предрелизной версии с ошибкой в структурированных ответах, которую потом исправили. А 10,3 % у Sonnet 5 в Terminal-Bench — необычно низкая база: в собственном прогоне Artificial Analysis Sonnet 5 на max набрал 14,1 %, Sonnet 5.5 — 63,6 %. Прирост остаётся огромным, но это примерно 4,5 раза, а не 7.
Сторонние замеры:
- Artificial Analysis: на
maxSonnet 5.5 набирает 56 баллов в индексе, на 18 больше Sonnet 5, и занимает второе место после Opus 5.5 наmax. - CodeRabbit прогнал модели через свой конвейер ревью кода (отчёт CodeRabbit о Sonnet 5.5). На 13 самых трудных случаях с заранее известными багами Sonnet 5.5 нашёл 6 против 4 у Sonnet 5 при почти той же точности полезных комментариев (41,2 % против 40,0 %), примерно вдвое быстрее и примерно на 60 % дешевле за ревью по прайсовым ценам. При этом четыре из найденных Sonnet 5.5 багов Sonnet 5 пропустил, а два бага, которые нашёл Sonnet 5, пропустил уже Sonnet 5.5. Сам CodeRabbit называет выборку маленькой: она показывает направление, а не доказывает его.
Против Opus 5.5 картина другая. Anthropic пишет, что на сложной открытой работе, где нужно долго держать собственное суждение, Opus 5.5 остаётся заметно сильнее, а в тесте фактических знаний AA-Omniscience у Sonnet 5.5 54 % точности против 66 % у Opus 5.5 (зато доля галлюцинаций ниже: 47 % против 59 %). Opus 5.5 стоит вдвое дороже — $4 и $20 за 1 млн токенов. Sonnet 5.5 рассчитан на чётко поставленные повседневные задачи, где важны скорость и цена.
Что сломается при переходе с Sonnet 5: пять несовместимых изменений API
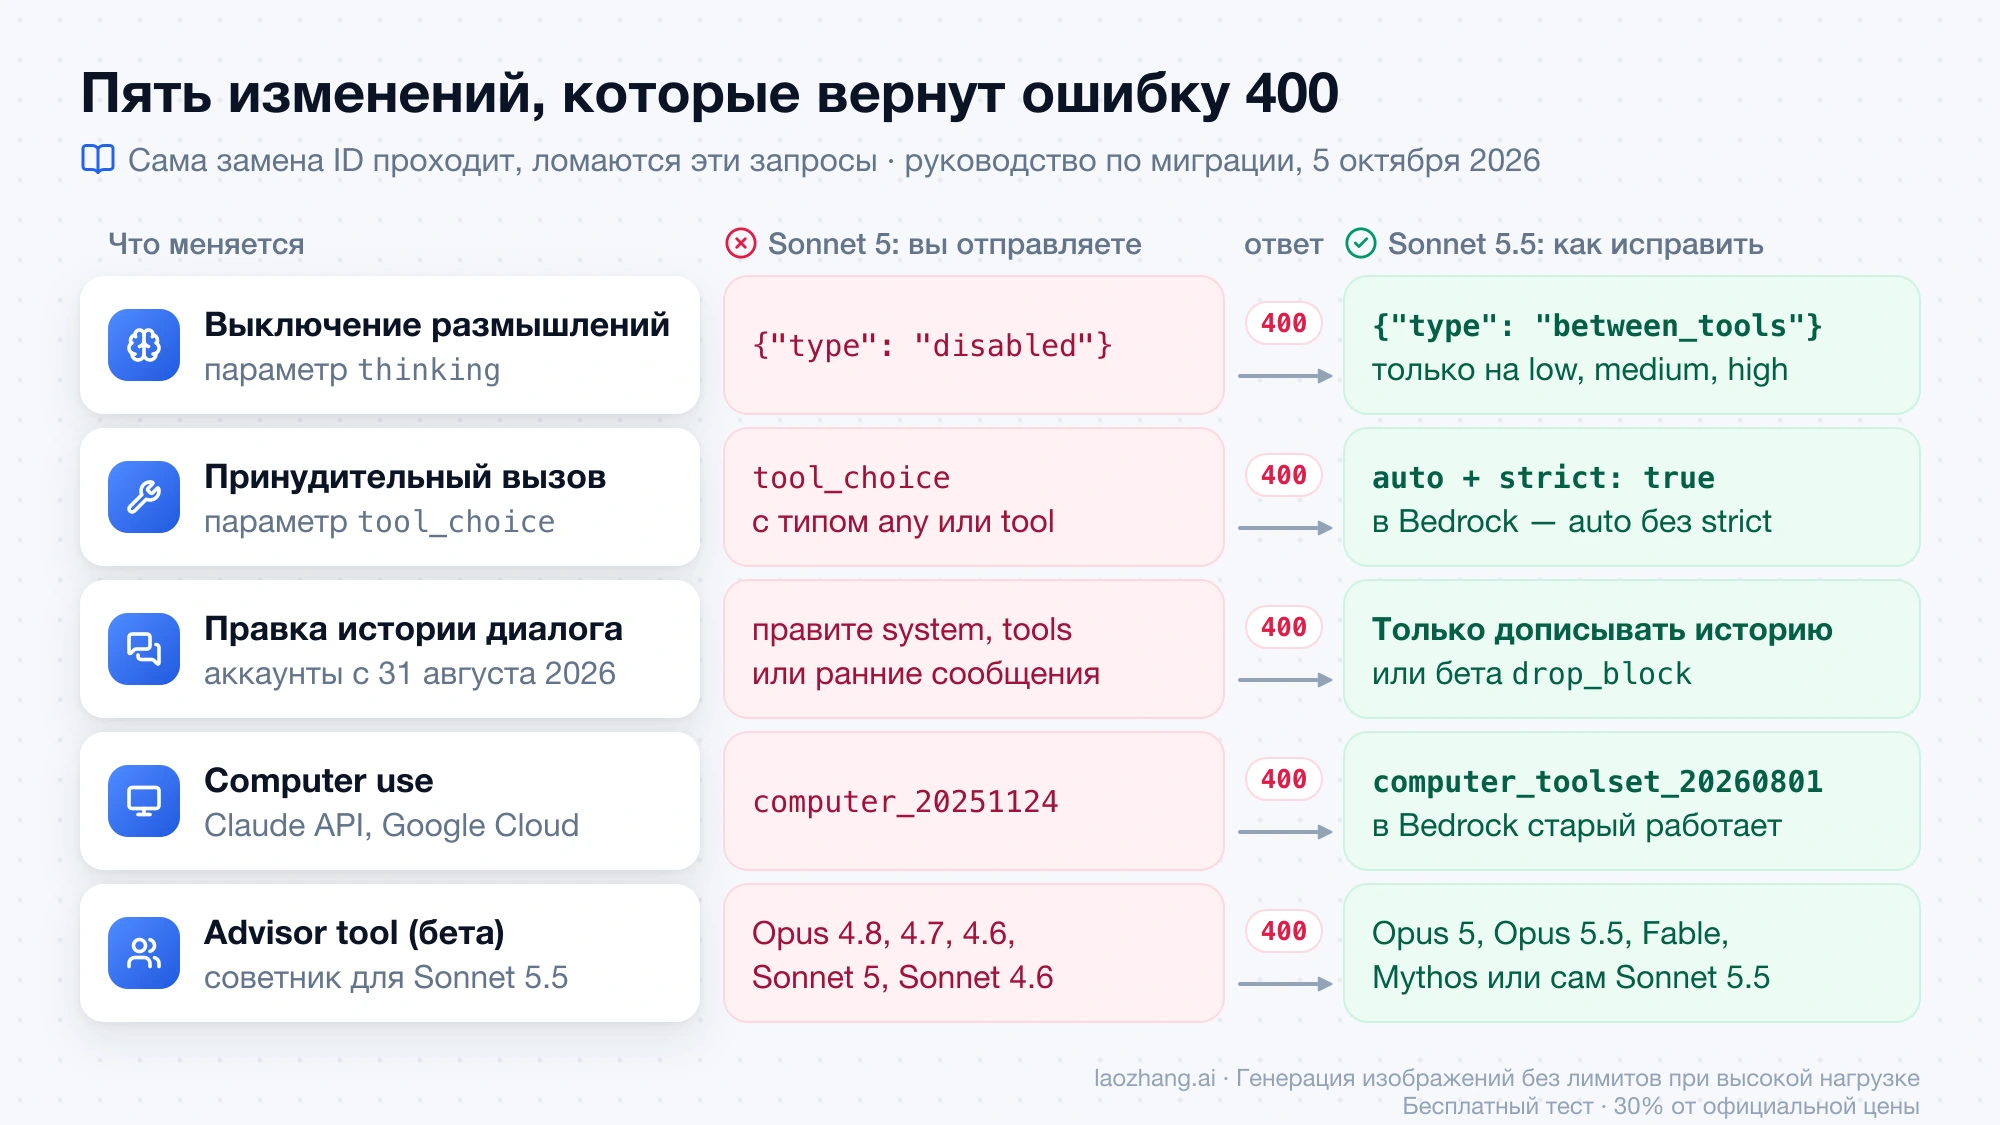
Сама замена claude-sonnet-5 на claude-sonnet-5-5 проходит без ошибок; ломаются запросы с определёнными параметрами. Ниже — всё, что на Sonnet 5.5 возвращает ошибку, по руководству по миграции на Claude Sonnet 5.5 по состоянию на 5 октября 2026 года.
| Изменение | Что вы отправляете сейчас | Что вернёт Sonnet 5.5 | Как исправить |
|---|---|---|---|
| Выключение размышлений | thinking: {"type": "disabled"} | 400 invalid_request_error | thinking: {"type": "between_tools"} на low, medium или high |
| Принудительный вызов инструмента | tool_choice с типом any или tool | 400, в том числе на эндпоинте подсчёта токенов | auto + strict: true; в Amazon Bedrock — auto без strict |
| Thinking-блоки и история | правка system, tools или ранних сообщений перед блоком Sonnet 5.5 | 400 для аккаунтов, созданных с 31 августа 2026 года | дописывать историю, а не править её |
| Computer use (Claude API, Google Cloud) | computer_20251124 | 400 | computer_toolset_20260801 |
| Advisor tool (бета) | советник Opus 4.8, Opus 4.7 или Sonnet 5 | 400 | советник Opus 5, Opus 5.5, Fable, Mythos или сам Sonnet 5.5 |
thinking: disabled заменяется на between_tools
На Sonnet 5.5 значение disabled больше не принимается. Ошибка 400 сразу подсказывает замену:
To turn thinking off on this model, send "thinking": {"type": "between_tools"} instead of {"type": "disabled"}. The model does not think before responding. The short updates it writes between tool calls come back as thinking blocks.between_tools отключает размышление перед ответом, но короткие заметки о ходе работы между вызовами инструментов по-прежнему приходят в thinking-блоках; их нужно возвращать модели без изменений вместе с остальным ответом. Без инструментов ответ состоит только из текста, как с disabled на Sonnet 5. Ограничения у режима такие:
- принимается только на
low,mediumиhigh, наxhighиmax— ошибка 400; - не принимает других полей:
display,budget_tokensилиblock_bindingрядом с ним дают 400; - effort нельзя менять посреди диалога;
- ручной бюджет
thinking: {"type": "enabled", "budget_tokens": N}тоже возвращает 400.
Если на Sonnet 5 размышления были выключены при xhigh, есть два пути: опустить effort до high и перейти на between_tools или убрать поле thinking и работать с адаптивным размышлением.
# Было: Sonnet 5
client.messages.create(
    model="claude-sonnet-5",
    max_tokens=16000,
    thinking={"type": "disabled"},
    output_config={"effort": "xhigh"},
    messages=[{"role": "user", "content": "..."}],
)

# Стало: Sonnet 5.5, effort не выше high
client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=16000,
    thinking={"type": "between_tools"},
    output_config={"effort": "high"},
    messages=[{"role": "user", "content": "..."}],
)
С серверным откатом запрос с between_tools, ушедший на Sonnet 5, выполняется там с disabled.
Принудительный tool_choice заменяется на auto и strict: true
tool_choice с типом any или tool возвращает 400 с текстом tool_choice: type "tool" and "any" are not supported for this model. Работают только auto (значение по умолчанию) и none. Чтобы аргументы вызова гарантированно соответствовали схеме, оставьте auto и пометьте инструмент strict: true (строгий режим требует additionalProperties: false у каждого объекта схемы) или перенесите схему в структурированные ответы. Модель при этом может ответить текстом и не вызвать инструмент, поэтому в промпте нужно прямо написать, когда им пользоваться.
# Было: Sonnet 5 обязан вызвать get_weather
client.messages.create(
    model="claude-sonnet-5",
    max_tokens=1024,
    tools=tools,
    tool_choice={"type": "tool", "name": "get_weather"},
    messages=[{"role": "user", "content": "Какая погода в Париже?"}],
)

# Стало: auto + strict, а условие вызова — в тексте запроса
client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=1024,
    tools=[{**tool, "strict": True} for tool in tools],
    tool_choice={"type": "auto"},
    messages=[{"role": "user", "content": "Какая погода в Париже? Используй инструмент get_weather."}],
)
В Amazon Bedrock структурированные ответы, включая строгий режим инструментов, для Sonnet 5.5 недоступны. Там отправляйте auto без strict и проверяйте аргументы вызова в своём коде.
Thinking-блоки Sonnet 5.5: историю можно только дописывать
Каждый thinking-блок помнит, какая модель его создала. Sonnet 5.5 читает блоки Sonnet 5, Opus 4.8, Haiku 4.5 и более ранних моделей, но не Opus 5, Opus 5.5, Fable и Mythos. Блоки самого Sonnet 5.5 в Claude API и Google Cloud читает Opus 5.5, и больше никто. Отсюда практическое следствие:
- переход посреди диалога с Sonnet 5 на Sonnet 5.5 сохраняет ход рассуждений;
- переход с Sonnet 5.5 на Opus 5.5 в Claude API и Google Cloud тоже его сохраняет;
- любой другой уход с Sonnet 5.5, включая возврат на Sonnet 5, продолжает диалог без прежних рассуждений.
Нечитаемые блоки API молча отбрасывает: запрос проходит, за отброшенное не списываются деньги.
Строже другое правило. API проверяет, не изменилось ли что-то перед блоком Sonnet 5.5 с момента его создания: system, tools или ранние сообщения. Для аккаунтов, созданных 31 августа 2026 года (00:00 UTC) и позже, в Claude API, Amazon Bedrock и Google Cloud повтор такого блока после правки возвращает 400. Если ваш код обрезает или переписывает историю, есть два выхода: менять инструкции и инструменты системными сообщениями посреди диалога, не трогая прошлое, или при адаптивном размышлении включить бета-заголовок thinking-binding-controls-2026-08-01 и задать thinking.block_binding.prefix_mismatch_behavior: "drop_block", чтобы такие блоки отбрасывались. Блоки Sonnet 5.5 к тому же привязаны к аккаунту: в другом, не связанном с ним аккаунте они отбрасываются.
Computer use и advisor tool
В Claude API и Google Cloud computer use на Sonnet 5.5 работает только через набор computer_toolset_20260801. Старый computer_20251124 возвращает 400 с сообщением, которое начинается так: 'claude-sonnet-5-5' does not support tool types: computer_20251124. Для перехода уберите бета-заголовок, замените запись в tools на {"type": "computer_toolset_20260801"} и научите цикл агента обрабатывать вложенные блоки tool_use, пакетные действия и toolset_name в результатах. В Amazon Bedrock computer_20251124 по-прежнему принимается. Тем, кто уже работает с набором или с инструментом browser use, ничего менять не нужно.
В advisor tool (бета) исполнителю Sonnet 5.5 нужен советник из списка: Opus 5, Opus 5.5, Fable 5, Fable 5.1, Mythos 5, Mythos 5.1 или сам Sonnet 5.5. Советники Opus 4.8, Opus 4.7, Opus 4.6, Sonnet 5 и Sonnet 4.6 дают 400. Совет любого допустимого советника приходит зашифрованным, в блоке advisor_redacted_result, и прочитать его текст клиент не может.
Интерфейс замолчал между вызовами инструментов: где теперь текст
Это изменение не вызывает ошибок, поэтому его легко пропустить. На Sonnet 5 весь текст между вызовами инструментов приходил блоками text. На Sonnet 5.5 заметки длиннее одной-двух фраз приходят как thinking-блоки с обновлениями о ходе работы, а при display: "omitted", который стоит по умолчанию, их текст пуст. Приложение, которое транслировало эти заметки пользователю, просто затихает между вызовами.
Как вернуть текст:
- при адаптивном размышлении задайте
thinking.display: "updates"(бета, заголовокthinking-display-updates-2026-08-18), чтобы получать только обновления, или"summarized", чтобы получать их вместе с кратким изложением рассуждений; - выводите каждый непустой thinking-блок перед следующим за ним блоком
tool_use; - с
between_toolsтекст возвращается и безdisplay.
Отказы с stop_reason: "refusal" и откат на Sonnet 5
Классификаторы безопасности у Sonnet 5.5 срабатывают в большем числе категорий, чем у Sonnet 5. Отказ приходит с HTTP 200, stop_reason: "refusal" и объектом stop_details, где указана категория:
cyber— запрос может помочь кибератаке;bio— запрос может помочь причинить биологический вред;frontier_llm— запрос может помочь разработке конкурирующих моделей ИИ;reasoning_extraction— запрос просит модель воспроизвести в ответе свои внутренние рассуждения;general_harms— другие области политики использования; эта категория иногда срабатывает и на безобидной работе.
Серверный откат (fallbacks: "default", бета, только Claude API) повторяет на Sonnet 5 отказы cyber и frontier_llm, но не bio, reasoning_extraction и general_harms. Для остальных случаев есть middleware в SDK или собственный повтор. Списываются ли деньги за отказ до начала вывода, зависит от категории, а в лимиты запросов такой отказ засчитывается всегда. Обычная разработка, включая поиск и исправление багов, по словам Anthropic, не затронута: на Sonnet 5 с видимым для пользователя уведомлением переходят только задачи кибербезопасности повышенного риска.
Как включить Sonnet 5.5 в Claude Code и проверить модель и effort
Sonnet 5.5 требует Claude Code версии v2.1.284 или новее. Порядок по документации Claude Code о настройке модели:
claude update                        # версия должна быть v2.1.284 или новее
claude --model claude-sonnet-5-5     # запуск сессии на Sonnet 5.5
Внутри уже открытой сессии то же делают /model sonnet или /model claude-sonnet-5-5; для всех запусков из оболочки подойдёт переменная ANTHROPIC_MODEL. После переключения выполните /status: команда показывает текущую модель и данные аккаунта. Модель видно и в строке состояния, если она настроена.
Алиас sonnet указывает на Sonnet 5.5 только при работе через Anthropic API. У других провайдеров он ведёт на более старые модели:
| Провайдер | Куда указывает sonnet |
|---|---|
| Anthropic API | Sonnet 5.5 |
| Claude Platform on AWS | Sonnet 4.6 |
| Amazon Bedrock, Agent Platform в Google Cloud | Sonnet 4.5 |
| Microsoft Foundry | Sonnet 4.5 |
Если вы работаете через Bedrock или Google Cloud и пишете /model sonnet, вы получите Sonnet 4.5 — модель, которую Anthropic уже объявила устаревшей. Выбирайте модель полным именем claude-sonnet-5-5 или задайте ANTHROPIC_DEFAULT_SONNET_MODEL.
Ещё три детали, которые меняют поведение после переключения:
- effort по умолчанию другой. В Claude Code Sonnet 5.5 и Opus 5.5 стартуют с
medium, остальные модели — сhigh. Если на Sonnet 5 вы ничего не настраивали, после перехода глубина рассуждений тихо снизится. Поменять уровень можно через/effort, флаг--effortили переменнуюCLAUDE_CODE_EFFORT_LEVEL. Claude Code хранит уровень отдельно для каждой модели, а старый общий ключeffortLevelв пользовательских настройках на модели, вышедшие начиная с Opus 5.5, не действует. - Смена модели посреди сессии сбрасывает кэш промпта. Следующий запрос заново прочитает весь контекст без скидки на кэш, поэтому переключаться удобнее в начале новой сессии.
- Запросы, помеченные как кибербезопасность, Claude Code повторяет на Sonnet 5 и показывает об этом уведомление; помеченные как биология заканчиваются отказом. В Bedrock, Google Cloud и Foundry откат работает, только если Claude Code может определить обе модели: нужна модель Opus (
ANTHROPIC_DEFAULT_OPUS_MODELили запись Opus 4.8 в списке моделей провайдера) и Sonnet 5 (черезANTHROPIC_DEFAULT_SONNET_MODELили запись Sonnet 5 в том же списке). Если закрепитьANTHROPIC_DEFAULT_SONNET_MODELна самом Sonnet 5.5, такие запросы будут заканчиваться отказом.
Значение default на тарифах Pro, Max, Team, Enterprise и в Anthropic API с версии v2.1.280 ведёт на Opus 5.5, а не на Sonnet. До этой версии на Pro и Team Standard оно давало Sonnet 5.
Sonnet 5.5 в приложениях Claude и в API: что проверить после смены модели
В приложениях Claude модель по умолчанию работает с effort Medium, на Claude Platform — с High. Это та же развилка, что и в Claude Code: в приложении модель по умолчанию рассуждает меньше и отвечает быстрее, чем при запросе к API без указания effort.
В API после замены ID стоит пройти короткий список:
- Явно задать
output_config.effort, подобранный заново, а не перенесённый с Sonnet 5. - Найти в коде
disabled,tool_choiceсanyилиtool,computer_20251124и советников advisor tool из старого списка. - Проверить, не правит ли код историю диалога перед повторной отправкой.
- Если интерфейс показывает ход работы, задать
thinking.displayили перейти наbetween_tools. - Обработать
stop_reason: "refusal"и решить, включать лиfallbacks: "default". - Пересчитать стоимость: разделить фактические расходы на число принятых результатов и сравнить с той же метрикой на Sonnet 5.
Когда остаться на Sonnet 5 и до какого срока уходить с Sonnet 4.5
Оставаться на Sonnet 5 разрешено: для него нет объявления об отключении, сама Anthropic лишь советует подумать о переходе, а отключение возможно не раньше 30 июня 2027 года. Остаться на время разумно, если:
- код держится на принудительном
tool_choiceили на советнике Sonnet 5 в advisor tool, и переписать его сейчас не получается; - основная нагрузка идёт на
max, где задача у Sonnet 5.5 дороже, а снизить уровень вы ещё не проверили; - приложение показывает пользователю заметки между вызовами инструментов, а доработать вывод thinking-блоков пока некому.
С Sonnet 4.5 вопрос решён за вас. 30 сентября 2026 года Anthropic объявила claude-sonnet-4-5-20250929 устаревшей моделью и отключает её в Claude API 30 ноября 2026 года; рекомендованная замена — claude-sonnet-5-5 (таблица устаревания моделей Anthropic). Sonnet 4.6 пока остаётся активным, отключение не раньше 17 февраля 2027 года. У Bedrock, Google Cloud и Foundry сроки свои, их нужно смотреть у провайдера.
Переход с Sonnet 4.5 объёмнее перехода с Sonnet 5: к пяти изменениям выше добавляются собственные. Самые заметные:
- размышления включены по умолчанию, поэтому блоки ответа нужно читать по
type, аmax_tokensпересмотреть; - нестандартные
temperature,top_pиtop_kнужно убрать; - тот же текст даёт примерно на 30 % больше токенов, чем у Sonnet 4.5 (токенизатор Sonnet 5);
- предзаполнение ответа ассистента возвращает 400:
This model does not support assistant message prefill. The conversation must end with a user message.; output_config.effortнужно задавать явно,output_formatперенести вoutput_config.format, а бета-заголовкиinterleaved-thinking-2025-05-14иfine-grained-tool-streaming-2025-05-14убрать (второй заменяется наeager_input_streaming).
Полный список по исходной модели есть в руководстве по миграции на Claude Sonnet 5.5, в разделе с чек-листами.
Вопросы о Claude Sonnet 5.5: бесплатный доступ, Opus 5.5, GPT-6 Astra
Доступен ли Claude Sonnet 5.5 на бесплатном плане Claude?
На странице тарифов claude.com (по состоянию на 29 сентября 2026 года) у бесплатного плана отмечен доступ к Sonnet, но версия не указана. Поскольку текущий Sonnet — 5.5, вероятнее всего, речь о нём, однако прямого подтверждения на странице нет. В API Sonnet 5.5 оплачивается по тарифу: $2 за 1 млн входных и $10 за 1 млн выходных токенов.
Что выбрать: Claude Sonnet 5.5 или Claude Opus 5.5?
Для чётко поставленных задач, где важны скорость и цена, — Sonnet 5.5: он вдвое дешевле за токен и в большинстве тестов Anthropic отстаёт от Opus 5.5 на несколько пунктов. Для сложной открытой работы, где модели нужно долго принимать решения самой, Anthropic рекомендует Opus 5.5; у него же выше точность фактических знаний.
Чем Claude Sonnet 5.5 отличается от GPT-6 Astra по цене задачи?
Токен у Sonnet 5.5 дешевле, но при близких баллах задача у Astra часто обходится дешевле. Поуровневое сравнение — в статье «Claude Sonnet 5.5 или GPT-6 Astra: стоит ли переходить».
Работает ли Claude Sonnet 5.5 в России?
Россия не входит в список стран, где Anthropic официально предоставляет свои сервисы (по состоянию на 29 сентября 2026 года). Это касается и приложений Claude, и Claude API. Официально Sonnet 5.5 распространяется через Claude API, Amazon Bedrock, Claude Platform on AWS, Google Cloud и Microsoft Foundry; посредники с оплатой в рублях в этот список не входят.
Источники11
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 6 окт. 2026 г..
Источники11
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 6 окт. 2026 г..
- 1.страницы модели Claude Sonnet 5.5platform.claude.com/docs/en/models/sonnet-5-5/overview
- 2.страницы Claude Sonnet 5platform.claude.com/docs/en/models/sonnet-5/overview
- 3.прайса Claude APIplatform.claude.com/docs/en/about-claude/pricing
- 4.страницы Claude Sonnet 5.5 на Artificial Analysis (AA)artificialanalysis.ai/models/claude-sonnet-5-5
- 5.Анонс Claude Sonnet 5.5anthropic.com/claude-sonnet-5-5
- 6.Разбор Artificial Analysis от 28 сентября 2026 годаartificialanalysis.ai/articles/claude-sonnet-5-5
- 7.описании изменений Claude Sonnet 5.5platform.claude.com/docs/en/models/sonnet-5-5/whats-new-sonnet-5-5
- 8.отчёт CodeRabbit о Sonnet 5.5coderabbit.ai/blog/sonnet-5-5-model-review
- 9.руководству по миграции на Claude Sonnet 5.5platform.claude.com/docs/en/models/sonnet-5-5/migration-guide
- 10.документации Claude Code о настройке моделиcode.claude.com/docs/en/model-config
- 11.таблица устаревания моделей Anthropicplatform.claude.com/docs/en/about-claude/model-deprecations