GPT-6.1 Sol медленно работает: замеры по effort и как ускорить
GPT-6.1 Sol теряет время в «тихом» рассуждении до первого токена. В тесте 26 октября 2026 года medium ответил вдвое быстрее xhigh; Fast удваивает цену API.
Содержание
Если GPT-6.1 Sol (gpt-6.1-sol) медленно работает у вас сейчас, в конце октября 2026 года, дело, скорее всего, уже не в перегрузке. Очередь первых дней после запуска 29 сентября, по словам руководителя Codex в OpenAI, рассосалась ко 2 октября, а 5 октября скорость по умолчанию для входа через ChatGPT подняли примерно на 50 %. То, что осталось, — свойство самой модели: перед ответом она дольше молча рассуждает, а в официальном API, по замерам Artificial Analysis, ещё и выводит текст примерно вдвое медленнее GPT-6 Sol.
Поэтому первым делом снизьте уровень рассуждений (effort): в Codex переключитесь с High, Extra High или Max на Medium или Light (в CLI он называется Low), а в API передайте reasoning_effort: "medium" в Chat Completions или reasoning.effort: "medium" в Responses API вместо xhigh и max — это бесплатно и даже уменьшает счёт. Скорость без потери глубины стоит денег: Fast в Codex расходует лимиты подписки в 2,5 раза быстрее, service_tier: "fast" в API стоит вдвое дороже, Ultrafast в Codex есть только на Pro $500 и подходящих тарифах Enterprise и Edu, а в API он в шесть раз дороже стандарта; возврат на gpt-6-sol ускоряет простые задачи, но эта модель слабее. Ошибка «Selected model is at capacity» и медленное приложение Codex в Windows при любой модели — другие случаи, они разобраны ниже.
26 октября 2026 года одну и ту же задачу прогнали двумя способами: через API, но по OpenAI-совместимому ретранслятору, а не напрямую в OpenAI, и через Codex CLI со входом через ChatGPT — на одном аккаунте, по одному запуску на каждую настройку. На этой задаче переход с xhigh на medium сократил медианное время ответа API с 70,9 до 34,8 секунды при том же результате. Fast и Ultrafast в API не проверялись, Ultrafast в Codex тоже; это одна задача за один день, а не обещание, что у вас выйдет так же.
Где GPT-6.1 Sol теряет время: тест 26 октября 2026 года
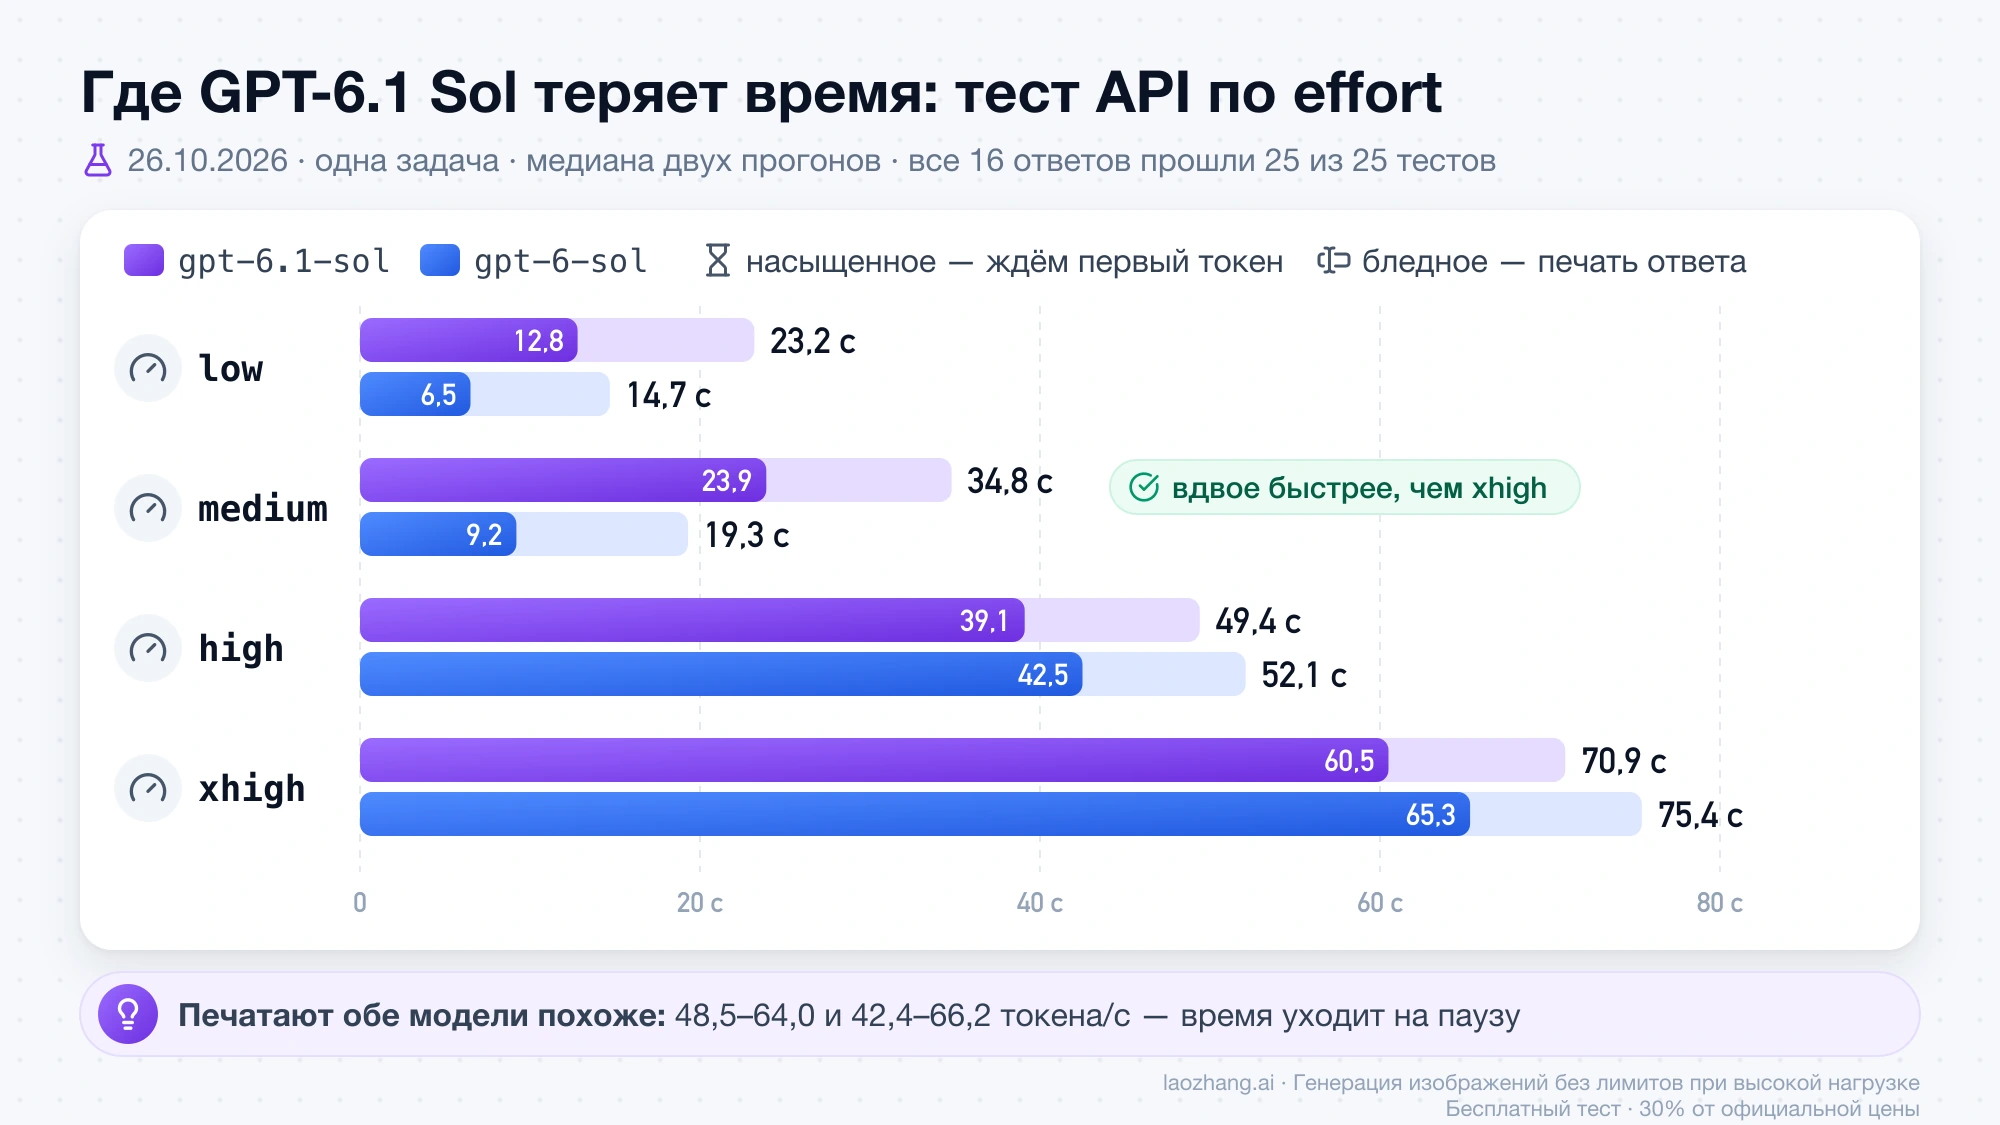
Почти всё лишнее время GPT-6.1 Sol уходит на паузу до первого токена ответа. В тесте через API, как только текст начинал идти, обе модели печатали с похожей скоростью: 48,5–64,0 токена в секунду у gpt-6.1-sol и 42,4–66,2 у gpt-6-sol. Разница была в молчании перед ним: на low и medium GPT-6.1 Sol ждала примерно вдвое дольше (12,8 против 6,5 секунды и 23,9 против 9,2) и на medium потратила почти вдвое больше токенов рассуждений.
Условия теста API: 26 октября 2026 года, 07:07–07:18 UTC, одна задача на программирование (написать функцию eval_expr, которая вычисляет выражение без eval), стриминг через OpenAI-совместимый Chat Completions от laozhang.ai, по два прогона на каждую модель и уровень. Все 16 ответов прошли 25 из 25 скрытых тестов. Через этот шлюз gpt-6.1-sol стоит по прайсу OpenAI, а попадания в кеш оплачиваются полностью; параметр service_tier он принимает, но в ответе не возвращает, поэтому сработал ли Fast, узнать нельзя, и Fast здесь не замерялся.
Примечание: laozhang.ai — наш собственный сервис; его цены — наши тарифы, а не независимое сравнение.
| Модель | effort | Всего, с (медиана) | До первого токена ответа, с | Токены рассуждений |
|---|---|---|---|---|
gpt-6.1-sol | low | 23,2 | 12,8 | 204 |
gpt-6.1-sol | medium | 34,8 | 23,9 | 590 |
gpt-6.1-sol | high | 49,4 | 39,1 | 1 289 |
gpt-6.1-sol | xhigh | 70,9 | 60,5 | 2 398 |
gpt-6-sol | low | 14,7 | 6,5 | 187 |
gpt-6-sol | medium | 19,3 | 9,2 | 317 |
gpt-6-sol | high | 52,1 | 42,5 | 1 522 |
gpt-6-sol | xhigh | 75,4 | 65,3 | 4 524 |
На high и xhigh медианы двух моделей почти совпали, но GPT-6 Sol вела себя нестабильно: на high один прогон дождался первого токена за 12,9 секунды, другой — за 72,0. Рассуждения этот шлюз не стримит, поэтому пауза до первого токена включает и очередь, и обдумывание, и разделить их нельзя. Задача была лёгкой: её решили все уровни, а ответ GPT-6.1 Sol по прайсу стоил $0,007–0,009 на low, $0,012–0,014 на medium, $0,019–0,020 на high и $0,031 на xhigh. На трудной задаче низкий effort может не справиться, и это надо проверять на своих запросах.
Второй замер — Codex CLI 0.164.0-alpha.11.1 из приложения ChatGPT для macOS, вход через ChatGPT, команда codex exec в песочнице с правом записи в рабочую папку; задача — исправить файл billing.py под спецификацию из семи правил и дописать две функции, результат проверяли 36 скрытыми тестами. Все пять завершённых запусков прошли 36 из 36.
| Модель и настройка | Время задачи, с | До первого сообщения агента, с |
|---|---|---|
gpt-6.1-sol, low | 72,6 | 11,8 |
gpt-6.1-sol, medium | 70,4 | 16,6 |
gpt-6.1-sol, high | 223,5 | 159,2 |
gpt-6.1-sol, high + Fast | 63,9 | 11,7 |
gpt-6-sol, high | 90,3 | 12,1 |
Самый долгий запуск, high в стандартном режиме, был повтором в 07:19 UTC, примерно через семь минут после ошибки нехватки мощностей; в промежутке успели пройти запуск с Fast и запуск gpt-6-sol. Он 156 секунд молчал до первого сообщения, а саму работу закончил ещё за 58 секунд; почему пауза была такой долгой, по журналу событий не видно — очередь и обдумывание в нём не разделяются. Каждая настройка запускалась один раз, поэтому из таблицы нельзя вывести, что Fast ускоряет в какое-то определённое число раз; видно лишь, что 26 октября high с Fast уложился в минуту с небольшим, как low и medium.
Насколько GPT-6.1 Sol медленнее GPT-6 Sol и GPT-5.6 Sol
По замерам Artificial Analysis в официальном API OpenAI на стандартном тарифе, по состоянию на 26 октября 2026 года GPT-6.1 Sol выдаёт 50,8–62,3 токена в секунду в зависимости от effort, а GPT-6 Sol — 112–115. На одинаковом уровне это 0,44 скорости предшественницы на Low (50,8 ÷ 114,6), 0,49 на High (54,7 ÷ 112,1) и 0,55 на Max (62,3 ÷ 112,5). Ожидание первого токена ответа на высоких уровнях у 6.1 Sol тоже дольше.
| Модель и effort | Вывод, токенов/с | До первого токена ответа, с | Intelligence Index |
|---|---|---|---|
| GPT-6.1 Sol, Low | 50,8 | 2,64 | 42 |
| GPT-6.1 Sol, Medium | 53,5 | 4,20 | 48 |
| GPT-6.1 Sol, High | 54,7 | 48,33 | 50 |
| GPT-6.1 Sol, Xhigh | 58,8 | 115,15 | 51 |
| GPT-6.1 Sol, Max | 62,3 | 246,63 | 52 |
| GPT-6 Sol, Low | 114,6 | 1,56 | 34 |
| GPT-6 Sol, High | 112,1 | 13,66 | 42 |
| GPT-6 Sol, Max | 112,5 | 108,21 | 48 |
| GPT-5.6 Sol, Max | 81,7 | 103,65 | 47 |
Скорость вывода у Artificial Analysis считается вместе с токенами рассуждений, а в тесте выше — только по видимому тексту, поэтому одно другому не противоречит: GPT-6.1 Sol может печатать ответ так же быстро, но медленнее «думать». Задачи и способ подключения у двух замеров разные, и секунды из двух таблиц напрямую сравнивать нельзя. Из таблицы следует практичный вывод: GPT-6.1 Sol на Medium набирает в индексе те же 48 баллов, что GPT-6 Sol на Max, и ждёт первого токена 4,20 секунды вместо 108,21. А переход 6.1 Sol с Max на High сокращает это ожидание с 246,63 до 48,33 секунды, на 80 %, ценой двух баллов индекса.
С GPT-5.6 Sol разница сильнее всего видна на Max: первого токена GPT-6.1 Sol ждёт примерно в 2,4 раза дольше (246,63 ÷ 103,65). В обсуждениях на Reddit ходит цифра «в 4,6 раза медленнее GPT-5.6 Sol», полученная на xhigh, но условия этого замера проверить нельзя. Задокументированный крайний случай — ветка на форуме сообщества OpenAI от 14 октября 2026 года: Responses API, Max, больше 200 тысяч входных токенов, веб-поиск и фоновый режим. GPT-5.6 Sol ответила за 373 секунды, GPT-6.1 Sol — за 1 846, и при этом выдала 62 708 выходных токенов, из них 52 552 токена рассуждений, против 31 426 и 24 186 у GPT-5.6 Sol. Вдвое больше токенов при более низкой скорости вывода — отсюда почти пятикратная разница.
Перегрузку GPT-6.1 Sol уже исправили? Даты с 29 сентября
Стартовую перегрузку исправили, и это видно по датам. Модель вышла 29 сентября 2026 года; в тот же вечер с 17:52 до 23:14 UTC на странице статуса OpenAI висел инцидент с ошибками в ChatGPT, Codex и API, а 30 сентября с 17:05 до 20:35 UTC часть запросов к API шла с повышенной задержкой. 1 октября руководитель Codex Тибо (Tibo, @thsottiaux) написал, что ChatGPT и Codex «под сильной нагрузкой» и добавляются мощности, а 2 октября — что после «массивного всплеска нагрузки в первые два дня» GPT-6.1 Sol снова работает с ожидаемой скоростью, и объявил сброс лимитов для платных аккаунтов ChatGPT.
5 октября в 17:20 UTC Тибо сообщил, что скорость по умолчанию для GPT-6 Astra и GPT-6.1 Sol по подписке выросла примерно на 50 % — с 30 до 50 токенов в секунду — во всех продуктах и у партнёров со входом через ChatGPT, включая OpenCode, Pi, Amp и Devin. Это касается только трафика со входом через ChatGPT, не запросов по ключу API, и записано только в его постах в X: ни в документации, ни в журнале изменений Codex этого изменения нет. Независимый замер на Zenn подтверждает эффект: 6 октября в Codex CLI 0.159.2 по подписке та же задача, что и 30 сентября, на High заняла 7,4 минуты вместо 19,7, на Max — 14,6 вместо 35,1 (среднее из трёх прогонов), а выходных токенов модель потратила почти столько же. Даже после этого GPT-6.1 Sol в том замере работала в 1,2–1,5 раза дольше gpt-6-sol, потому что выдавала в 1,1–1,5 раза больше токенов.
После 5 октября на странице статуса OpenAI были такие сбои, затрагивающие Codex, Work или GPT-6.1 Sol (время UTC, по Москве на три часа больше): 7 октября 17:21–18:23 — задержки ответов в Codex и Work; 13 октября 08:10–16:36 — деградация именно GPT-6.1 Sol в Codex и Work, смягчение применили в 09:30; 14 октября 07:05–09:53 — повышенная доля ошибок в Codex и ChatGPT Work; 21 октября 02:26–03:28 — проблемы в ChatGPT, Codex и API. Если ваши медленные часы не совпадают с этими окнами, причина, скорее всего, в effort и в самой модели.
GPT-6.1 Sol медленно работает: симптом, причина и что проверить
Причину проще всего найти по трём вещам: когда стало медленно, как вы подключаетесь (вход через ChatGPT в Codex и Work или ключ API) и на каком effort идёт работа. Таблица сводит типичные симптомы к вероятной причине и первой проверке.
| Что вы видите | Вероятная причина | Что проверить или сделать |
|---|---|---|
| Всё было медленно 29 сентября – 2 октября | Перегрузка после запуска | Уже прошла; замерьте задачу заново |
| Медленно в конкретные часы, ошибки, переподключения | Инцидент OpenAI | История на status.openai.com, окна 7, 13, 14 и 21 октября |
| Долгое молчание перед ответом, особенно на High, Extra High и Max | Модель долго рассуждает до первого токена | Повторите задачу на Medium и сравните время и результат |
| На Max в API запрос идёт 20–30 минут, клиент обрывает его по таймауту | Десятки тысяч токенов рассуждений плюс длинный контекст | Понизьте effort до High, поднимите таймаут клиента, заберите ответ по ID |
| «Selected model is at capacity» | В эту минуту не хватает мощностей под модель | Повтор через несколько минут или временно gpt-6-sol |
| Долгие паузы посреди длинной сессии Codex | Автоматическое сжатие контекста | Посмотрите заполненность контекста через /status |
| Codex App медленный в Windows с любой моделью | Накладные расходы самого приложения | Сравните ту же задачу в CLI |
| Через посредника Fast «не действует» | Шлюз может не передавать service_tier | Проверьте поле service_tier в ответе |
Про паузы в длинной сессии есть конкретный пример: в отчёте на GitHub от 8 октября 2026 года автоматическое сжатие контекста в десктопном Codex для Windows на xhigh заняло 178,7 секунды, а средняя скорость за сессию вместе со всеми ожиданиями вышла около 22 токенов в секунду. Как смотреть расход и заполненность контекста, разобрано в статье «Как проверить токены Codex: /status, /usage, контекст и расходы API». Если же медленно всё приложение в Windows, а не одна модель, это отдельная задача: «Codex App медленно работает в Windows: как сравнить CLI и Desktop».
Как ускорить GPT-6.1 Sol и сколько стоит каждый способ
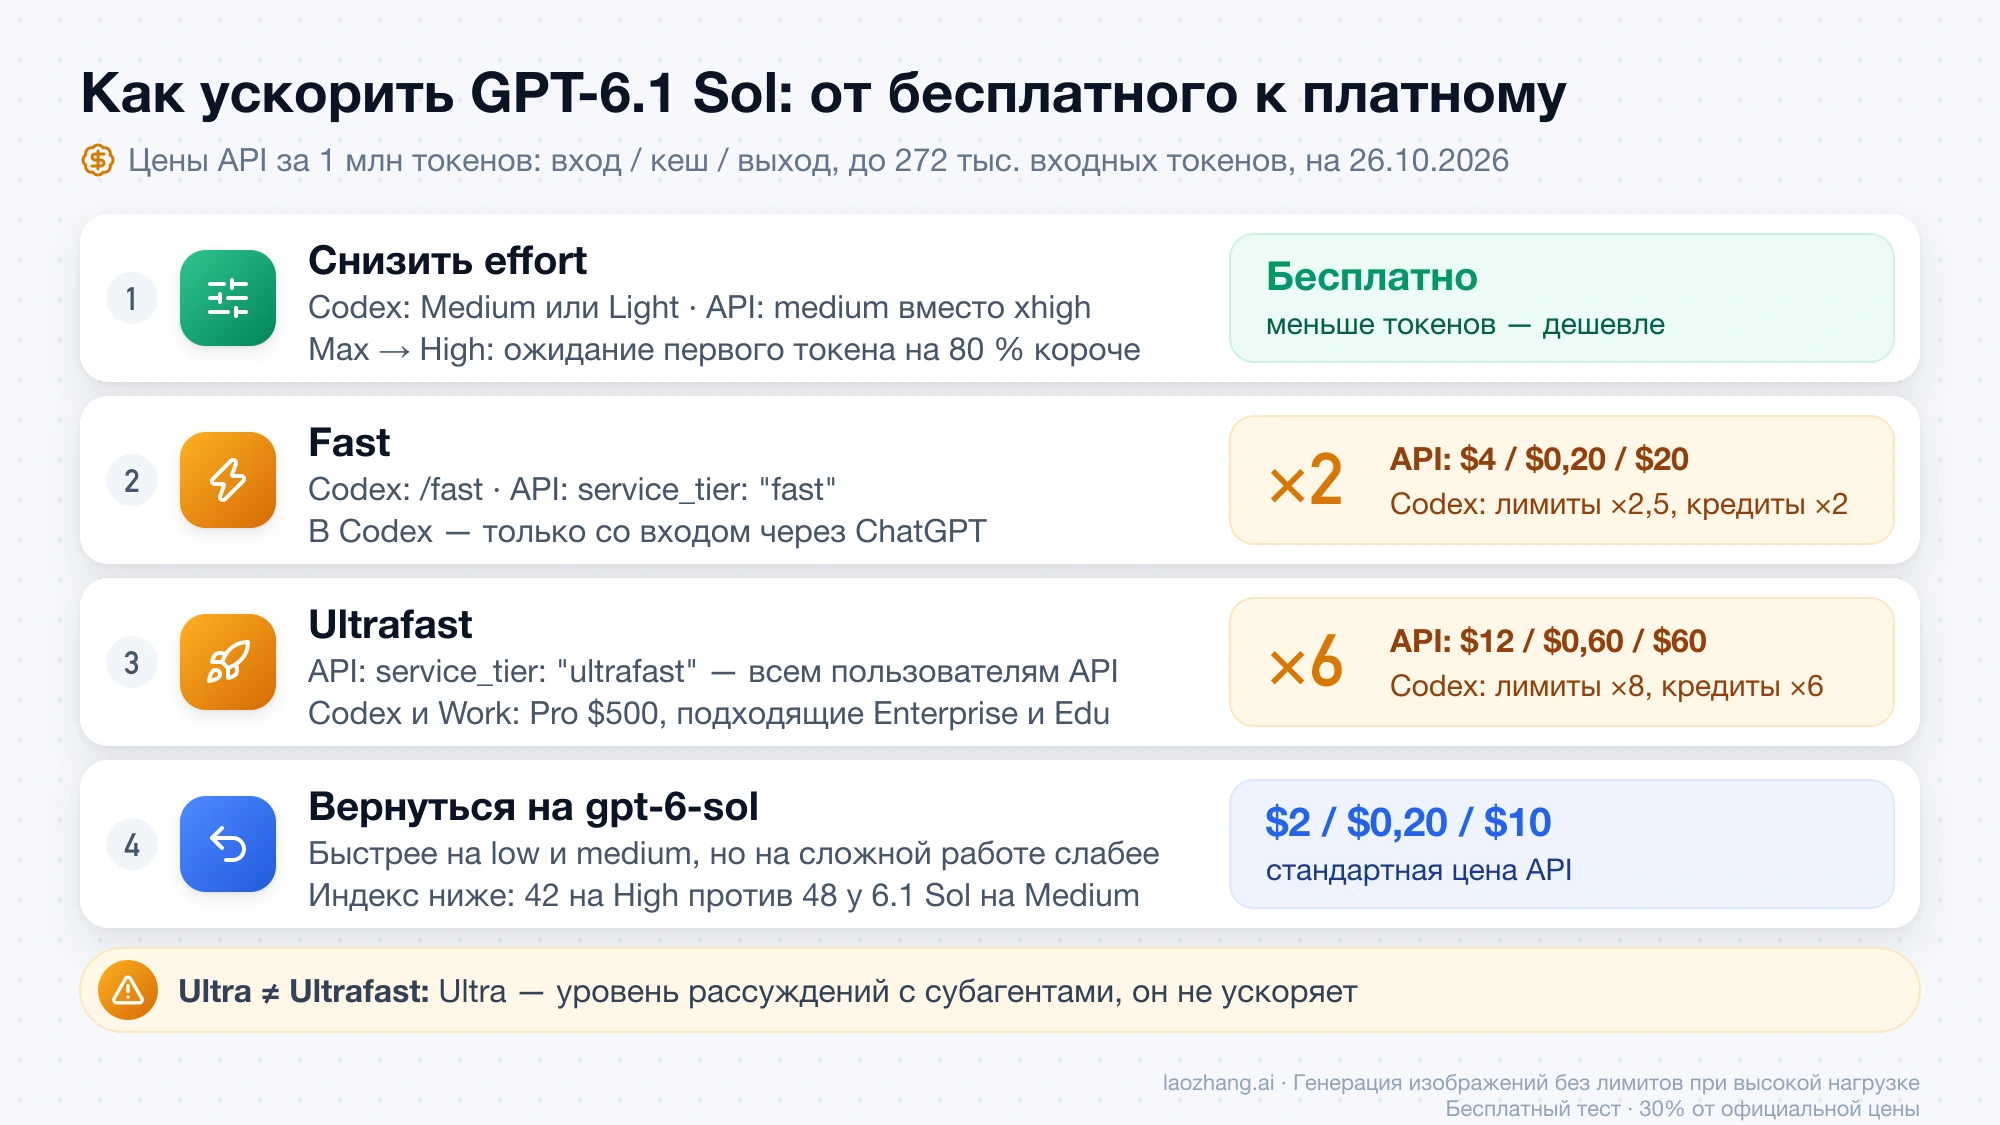
Начинайте с бесплатного: снижения effort. Платные способы — Fast, Ultrafast и возврат на другую модель — имеет смысл пробовать, только если на Medium качество вас не устраивает, а ждать High или Extra High слишком долго. Цены API ниже указаны за 1 млн токенов для запросов до 272 тысяч входных токенов, в порядке «вход / кеш / выход», по состоянию на 26 октября 2026 года.
| Способ | Что даёт | Сколько стоит | Кому доступно |
|---|---|---|---|
Снизить effort: Medium или Light в Codex, medium или low в API | В тесте API medium вдвое быстрее xhigh; по Artificial Analysis Max → High сокращает ожидание первого токена на 80 % | Ничего; меньше токенов рассуждений, поэтому дешевле | Всем; на трудных задачах сверяйте качество |
| Fast в Codex | Ускоряет поддерживаемые модели, официальной цифры для 6.1 Sol нет | Включённые лимиты подписки ×2,5; купленные кредиты и Enterprise pay-as-you-go ×2 | Вход через ChatGPT: десктопное приложение, CLI, расширение для IDE |
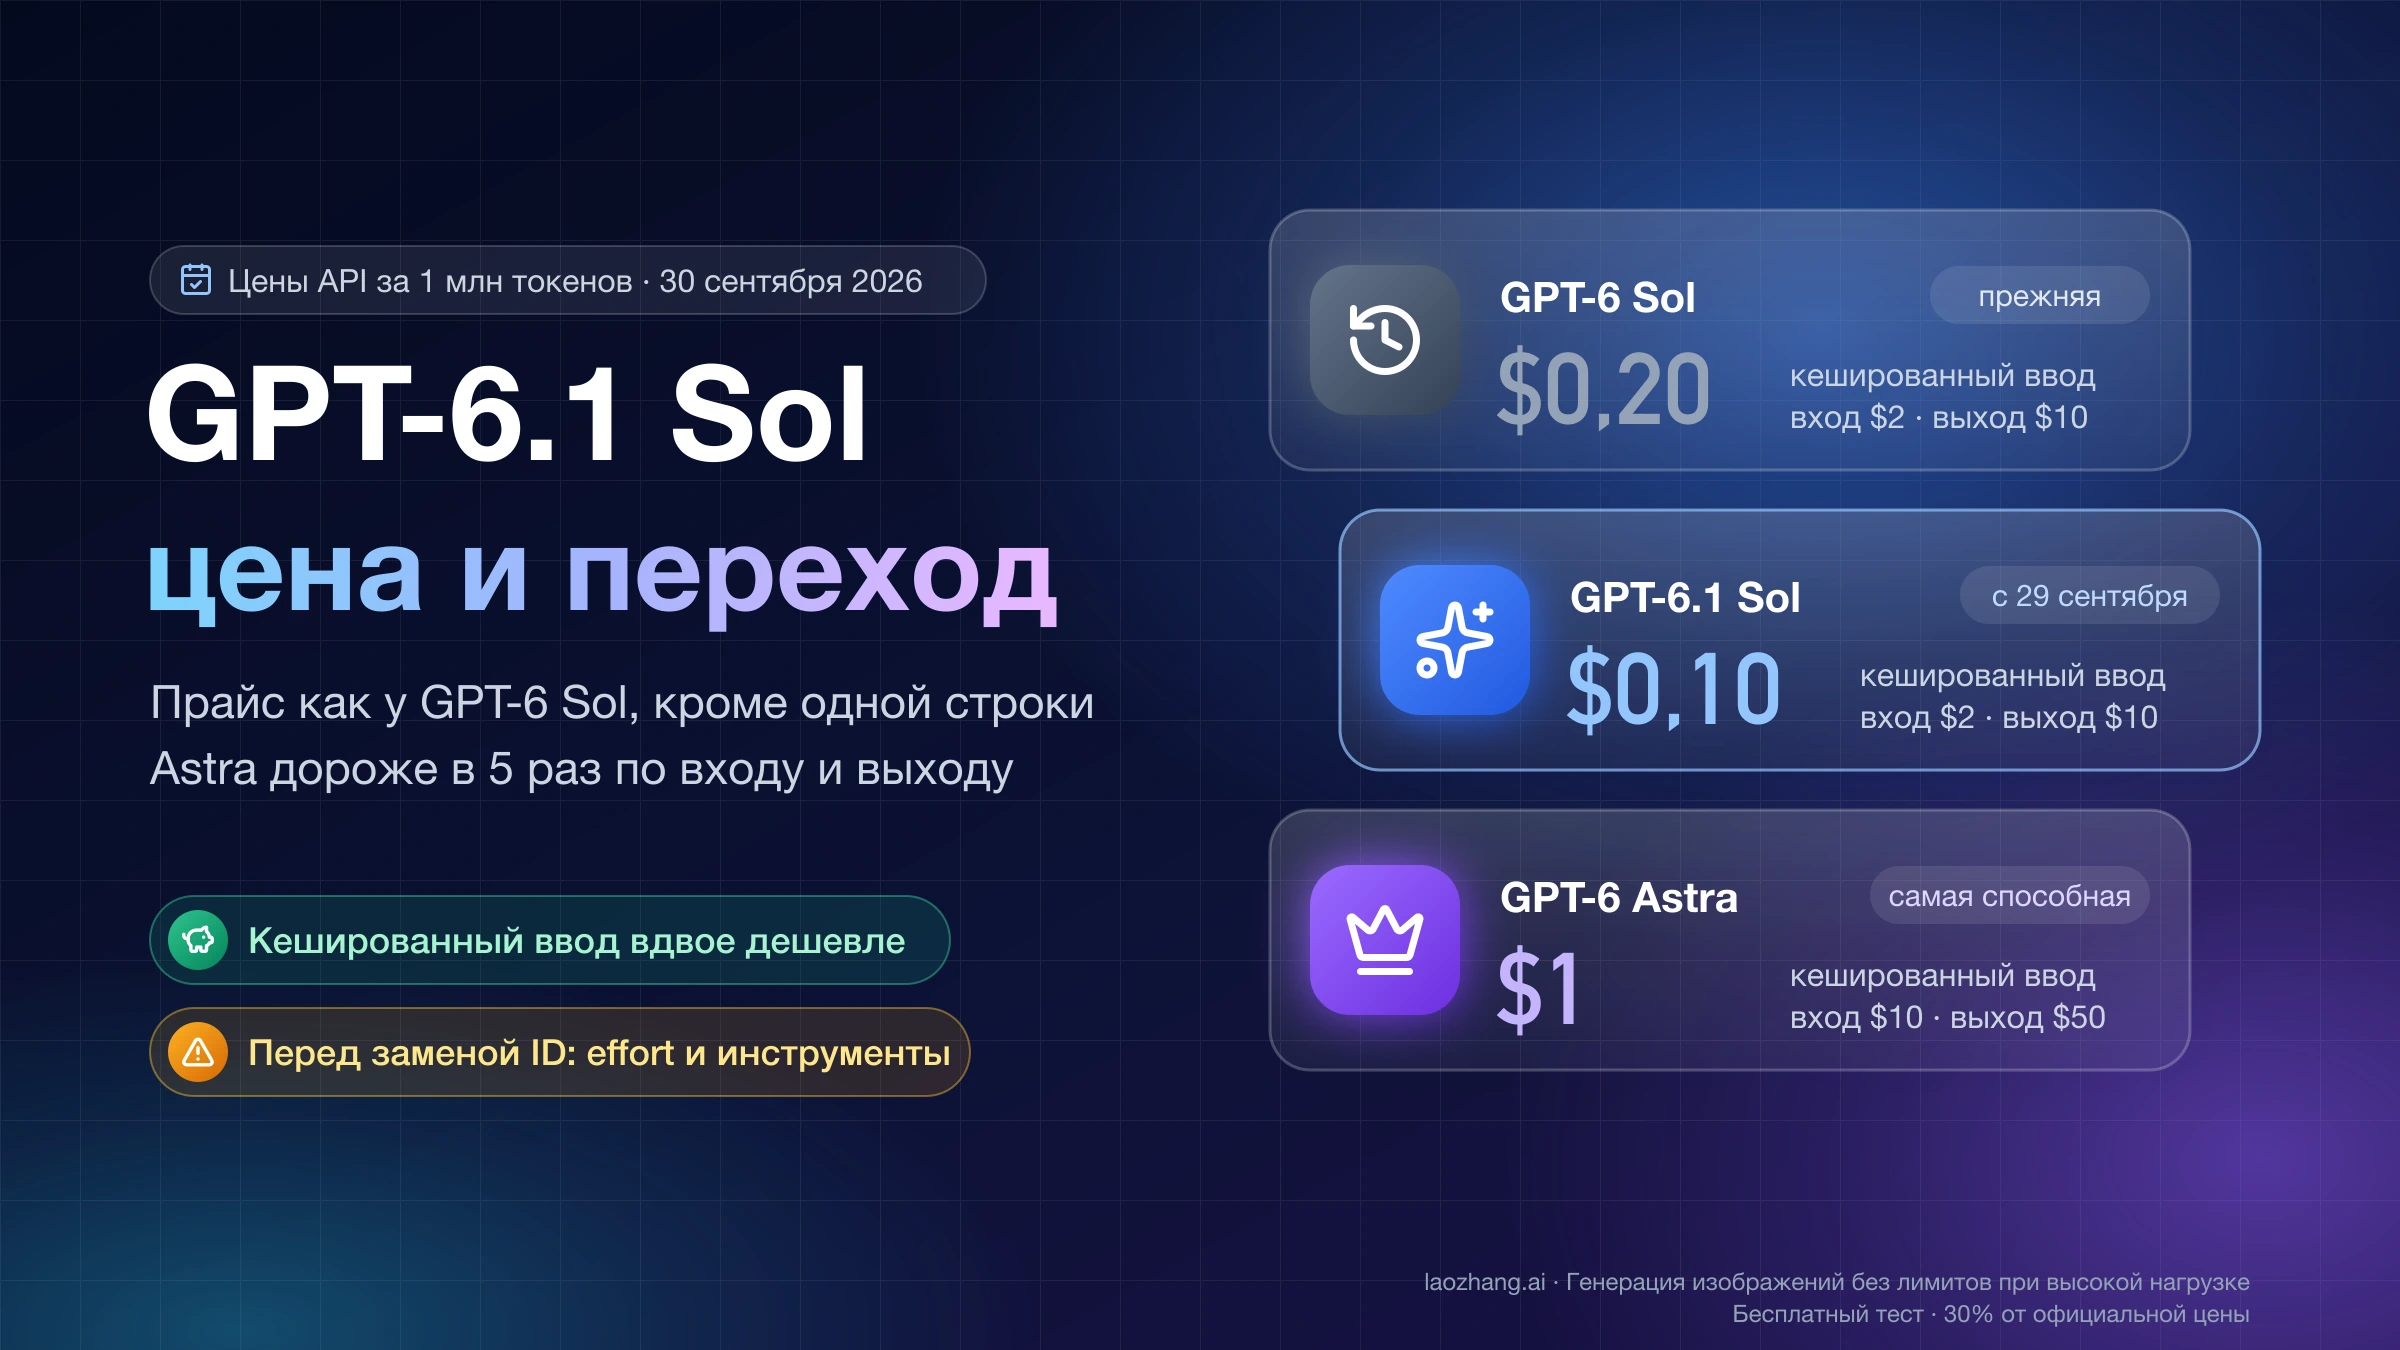
Fast в API, service_tier: "fast" | «До 2,5 раза быстрее» — общая формулировка OpenAI без цифры для 6.1 Sol | ×2: $4 / $0,20 / $20 | Ключ API; у посредника — если он передаёт параметр |
| Ultrafast в Codex и Work | Для GPT-6 Astra OpenAI пишет «до 8 раз быстрее», для 6.1 Sol цифры нет | Включённые лимиты ×8; кредиты ×6 | Pro $500, подходящие Enterprise и Edu |
Ultrafast в API, service_tier: "ultrafast" | Самый быстрый тариф API; OpenAI советует WebSocket | ×6: $12 / $0,60 / $60 | Все пользователи API; отдельные лимиты 1M / 4M / 40M токенов в минуту на уровнях Build / Launch / Grow |
Вернуться на gpt-6-sol | По Artificial Analysis вывод вдвое быстрее; в тесте на low и medium ожидание вдвое короче | $2 / $0,20 / $10 | Где модель доступна; индекс ниже: 42 на High против 48 у 6.1 Sol на Medium |
Не путайте Ultra и Ultrafast. Ultra — это уровень рассуждений в Codex, при котором модель раздаёт части задачи субагентам; он делает больше работы, а не ускоряет её. Ultrafast — платный режим скорости. Учтите и то, что лимиты Codex на GPT-6.1 Sol тают быстрее не только из-за Fast: в замере на Zenn модель выдавала в 1,1–1,5 раза больше токенов, чем GPT-6 Sol; как устроен расход и когда он сбрасывается, разобрано в статье «Недельный лимит Codex: когда он сбросится и как продолжить работу». Полная таблица цен, включая Batch, Flex и длинный контекст, — в материале «GPT-6.1 Sol: цена, доступ и что менять при переходе с GPT-6 Sol».
Как включить Fast и снизить effort в Codex
В Codex скорость меняется двумя настройками: уровнем рассуждений и режимом Fast. Fast работает только при входе через ChatGPT — в десктопном приложении ChatGPT, Codex CLI и расширении для IDE. Если Codex запущен с ключом API, он тарифицируется по ценам API, и множители подписки к нему не применяются.
- В CLI откройте
/model, выберитеgpt-6.1-solи уровень Low или Medium; Max и Ultra находятся в пункте «More reasoning…». Для разового запуска уровень задаётся флагом-c model_reasoning_effort="medium". - Если на Medium качества не хватает, верните High и включите Fast командой
/fast. Команда/statuslineвыводит текущий режим в строку состояния. - Чтобы уровень и Fast сохранялись между запусками, добавьте в
~/.codex/config.tomlнастройки из блока ниже; без Fast оставьте только первую строку. - В десктопном приложении и ChatGPT Work по умолчанию стоит пресет Power. Сдвиг ползунка к Faster даёт более быструю и дешёвую работу, к Smarter — более глубокую; в Advanced можно вручную выбрать модель, уровень рассуждений и скорость.
- Прогоните ту же задачу, что тормозила, и сравните время и расход через
/status.
model_reasoning_effort = "medium"
service_tier = "fast"

[features]
fast_mode = true
OpenAI сама советует при смене поколения моделей пробовать знакомую задачу на более низком уровне: уровни effort у разных поколений не совпадают один к одному, и привычный High у GPT-6.1 Sol может оказаться избыточным.
Как ускорить запросы к API gpt-6.1-sol и не ловить таймауты
В API главный рычаг тот же — effort. Если его не указать, gpt-6.1-sol работает на medium; уровни идут от low до max, а none, который понимала gpt-6-sol, модель не принимает. У посредников набор бывает уже: на шлюзе из теста выше max не принимался. OpenAI прямо пишет про xhigh: включать его стоит, только если ваши собственные проверки показывают выигрыш, оправдывающий лишнее время и цену. Токены рассуждений оплачиваются как выходные, поэтому снижение effort экономит и время, и деньги.
Стриминг модель не ускоряет, но показывает, куда уходит время: если первая часть ответа приходит через минуту, а потом текст идёт быстро, медленно именно рассуждение. Для интерфейсов, где важно хоть что-то показать сразу, OpenAI советует попросить модель сначала выдать короткую вводную фразу, а уже потом рассуждать глубже. Пример для Chat Completions через OpenAI SDK для Python:
from openai import OpenAI

# Для xhigh/max и длинного контекста таймаут нужен в десятки минут
client = OpenAI(timeout=1800)  # base_url укажите свой, если работаете через шлюз

stream = client.chat.completions.create(
    model="gpt-6.1-sol",
    reasoning_effort="medium",   # вместо high/xhigh; "none" модель не принимает
    # service_tier="fast",       # 2× цены; проверьте, что шлюз его передаёт
    stream=True,
    stream_options={"include_usage": True},
    messages=[{"role": "user", "content": "..."}],
)
for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end="", flush=True)
    if chunk.usage:
        print("\nreasoning tokens:", chunk.usage.completion_tokens_details.reasoning_tokens)
В Responses API то же самое задаётся как reasoning={"effort": "medium"} и service_tier="fast". Тип тарифа, по которому реально обработан запрос, OpenAI возвращает в поле service_tier ответа. Если вы резко наращиваете трафик в Fast, часть запросов может уйти в стандартный режим по стандартной цене, и тогда в этом поле будет "default": после 1 млн входных токенов в минуту OpenAI советует добавлять не больше 50 % каждые 15 минут. Если посредник это поле не возвращает, узнать, сработал ли Fast, нельзя.
Дольше всего идут запросы на Max с длинным контекстом, и с фоновым режимом это особенно заметно. В том случае с форума от 14 октября 2026 года локальный опрос по ID сдался через 1 800 секунд, а ответ завершился на 1 846-й без ошибки. Поэтому таймаут опроса ставьте с запасом, а если клиент всё же сдался, заберите готовый ответ по его ID, а не отправляйте запрос заново: повтор оплачивается ещё раз. В том же случае обе модели записали в кеш около 50 тысяч токенов и не прочитали из него ни одного, то есть кеш в тех запросах не сработал.
«Selected model is at capacity» на GPT-6.1 Sol
«Selected model is at capacity. Please try a different model.» означает, что в этот момент у OpenAI не хватает мощностей под выбранную модель; задача при этом не выполняется. 26 октября 2026 года в Codex CLI так закончились две из шести попыток на gpt-6.1-sol — в 07:08 UTC на low через 27 секунд и в 07:12 UTC на high через 36 секунд, файл остался нетронутым. Повтор на low примерно через две минуты прошёл, повтор на high — примерно через семь; единственный запуск gpt-6-sol в той же сессии ошибки не получил. 12–13 октября о том же сообщения «Model at capacity» писали на форуме OpenAI пользователи Pro, хотя у других подписчиков Plus и Enterprise проблем не было.
Если ошибка повторяется, подождите несколько минут и запустите задачу снова, а если ждать нельзя, переключитесь на gpt-6-sol до конца пиковых часов и загляните на status.openai.com.
Вернуться на GPT-6 Sol или перейти на GPT-6 Astra
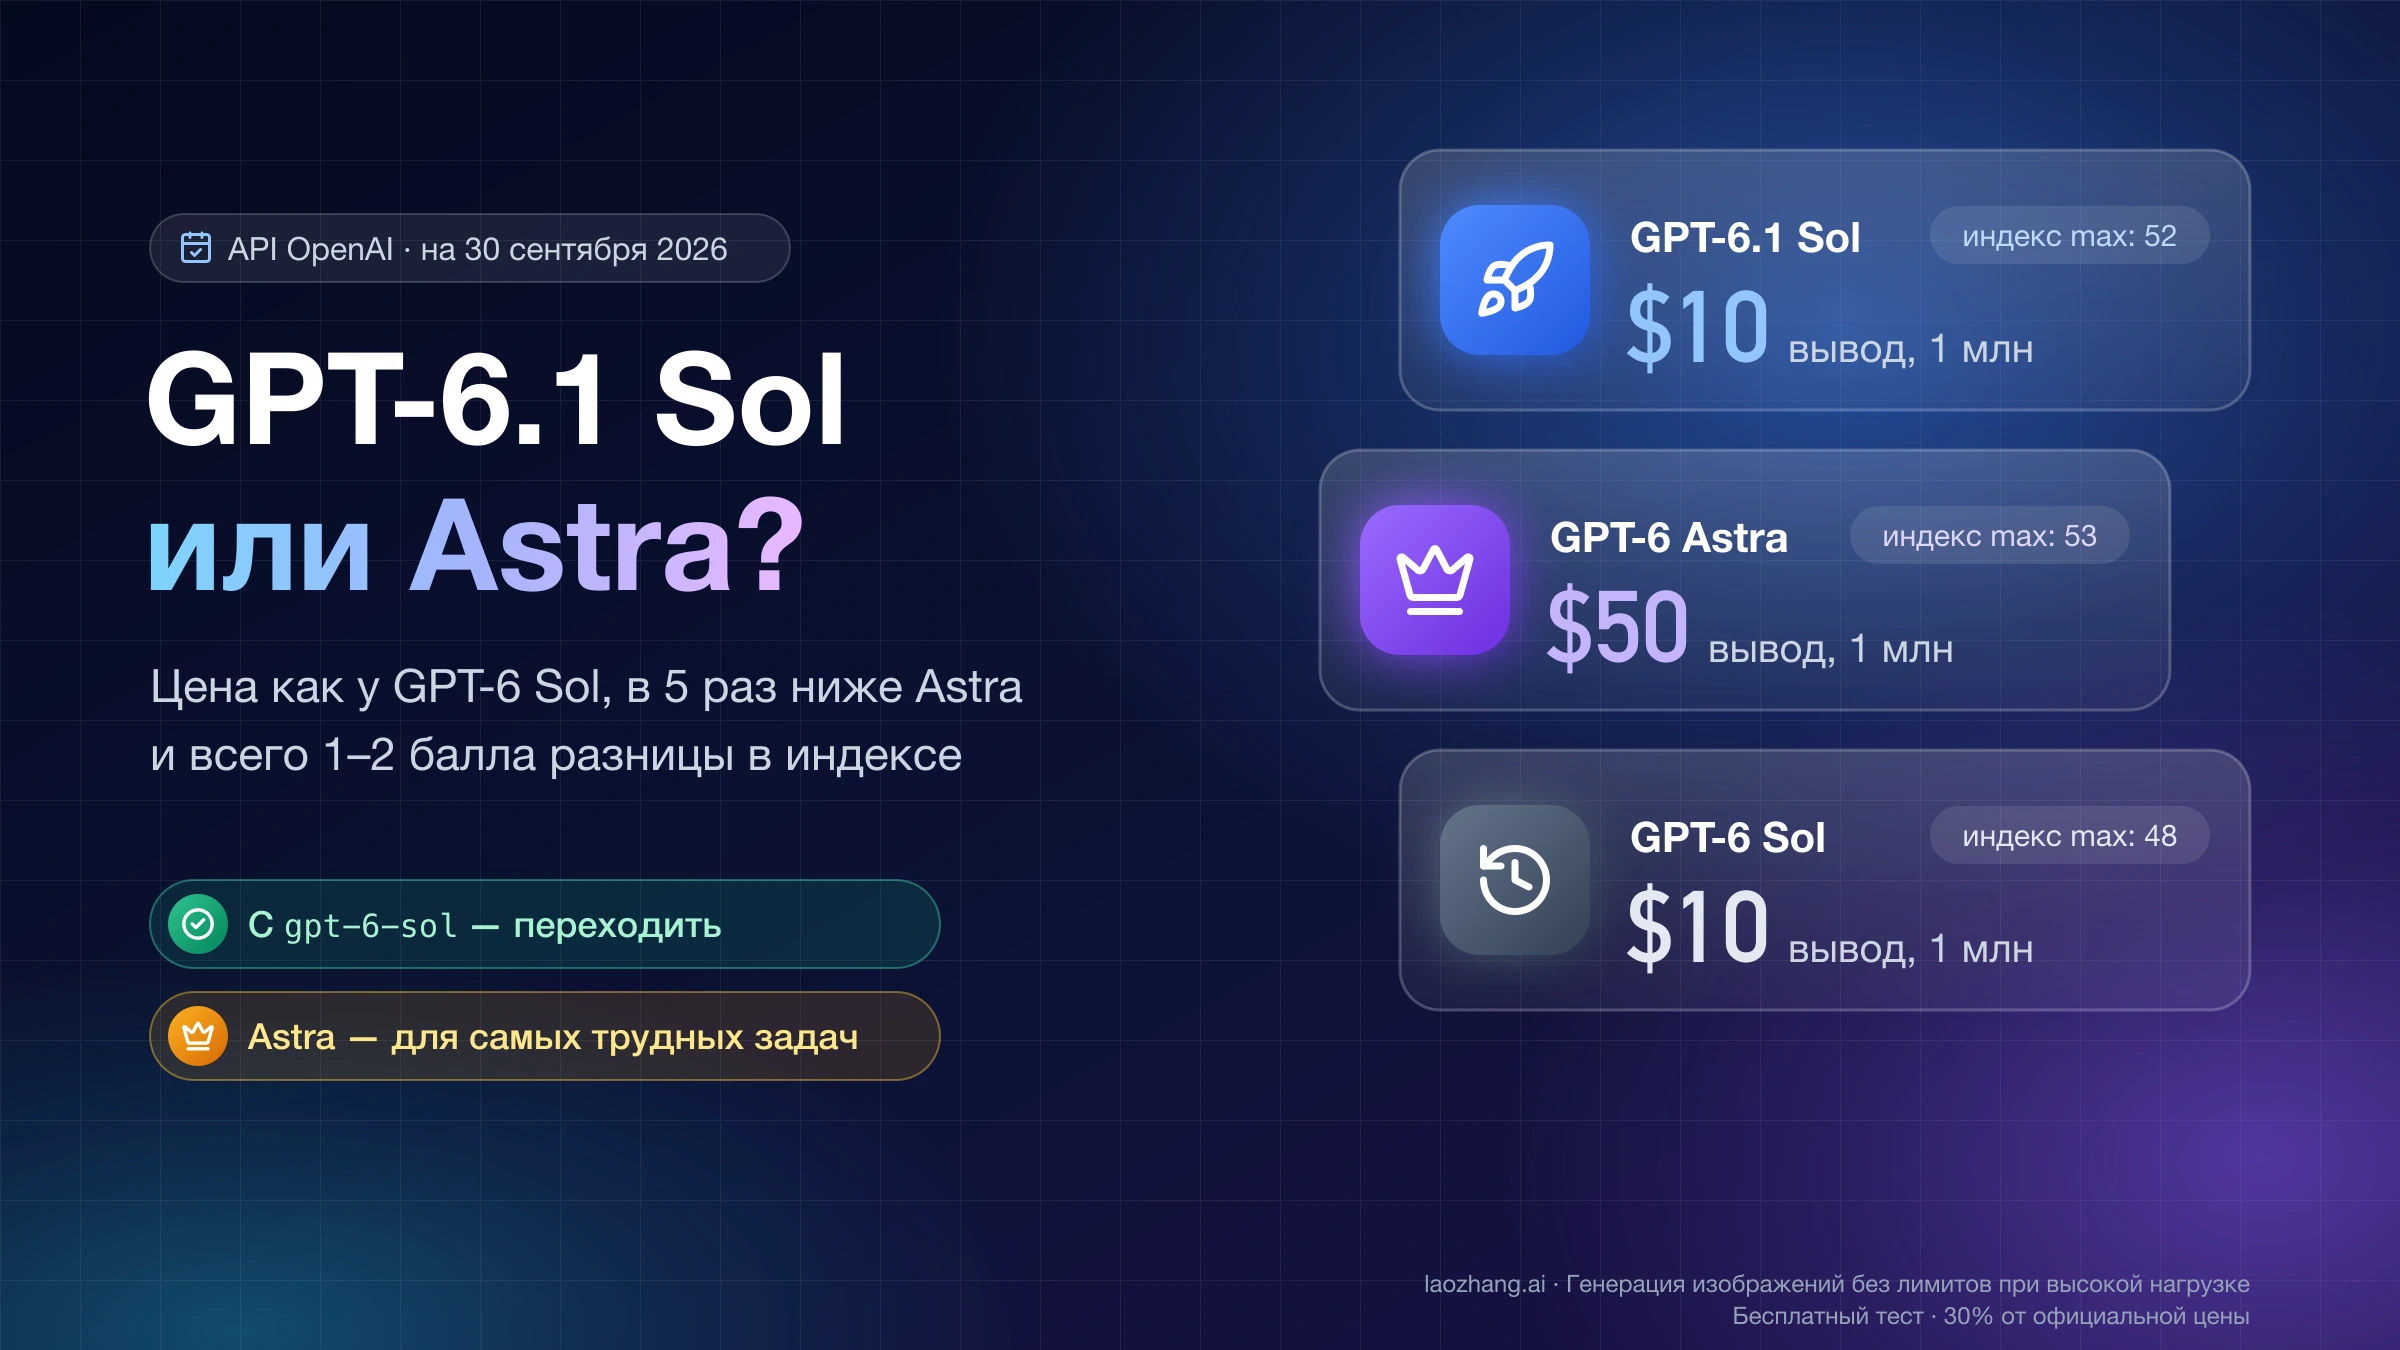
Вернуться на gpt-6-sol разумно, если ваши задачи простые, а ждать приходится на каждом шаге: на low и medium она отвечает заметно быстрее, но на сложной работе уступает GPT-6.1 Sol. По индексу Artificial Analysis GPT-6 Sol даже на Max набирает 48 баллов — столько же, сколько GPT-6.1 Sol на Medium, которая при этом ждёт первого токена гораздо меньше. Поэтому для задач средней сложности чаще выгоднее оставить 6.1 Sol и снизить effort, чем менять модель.
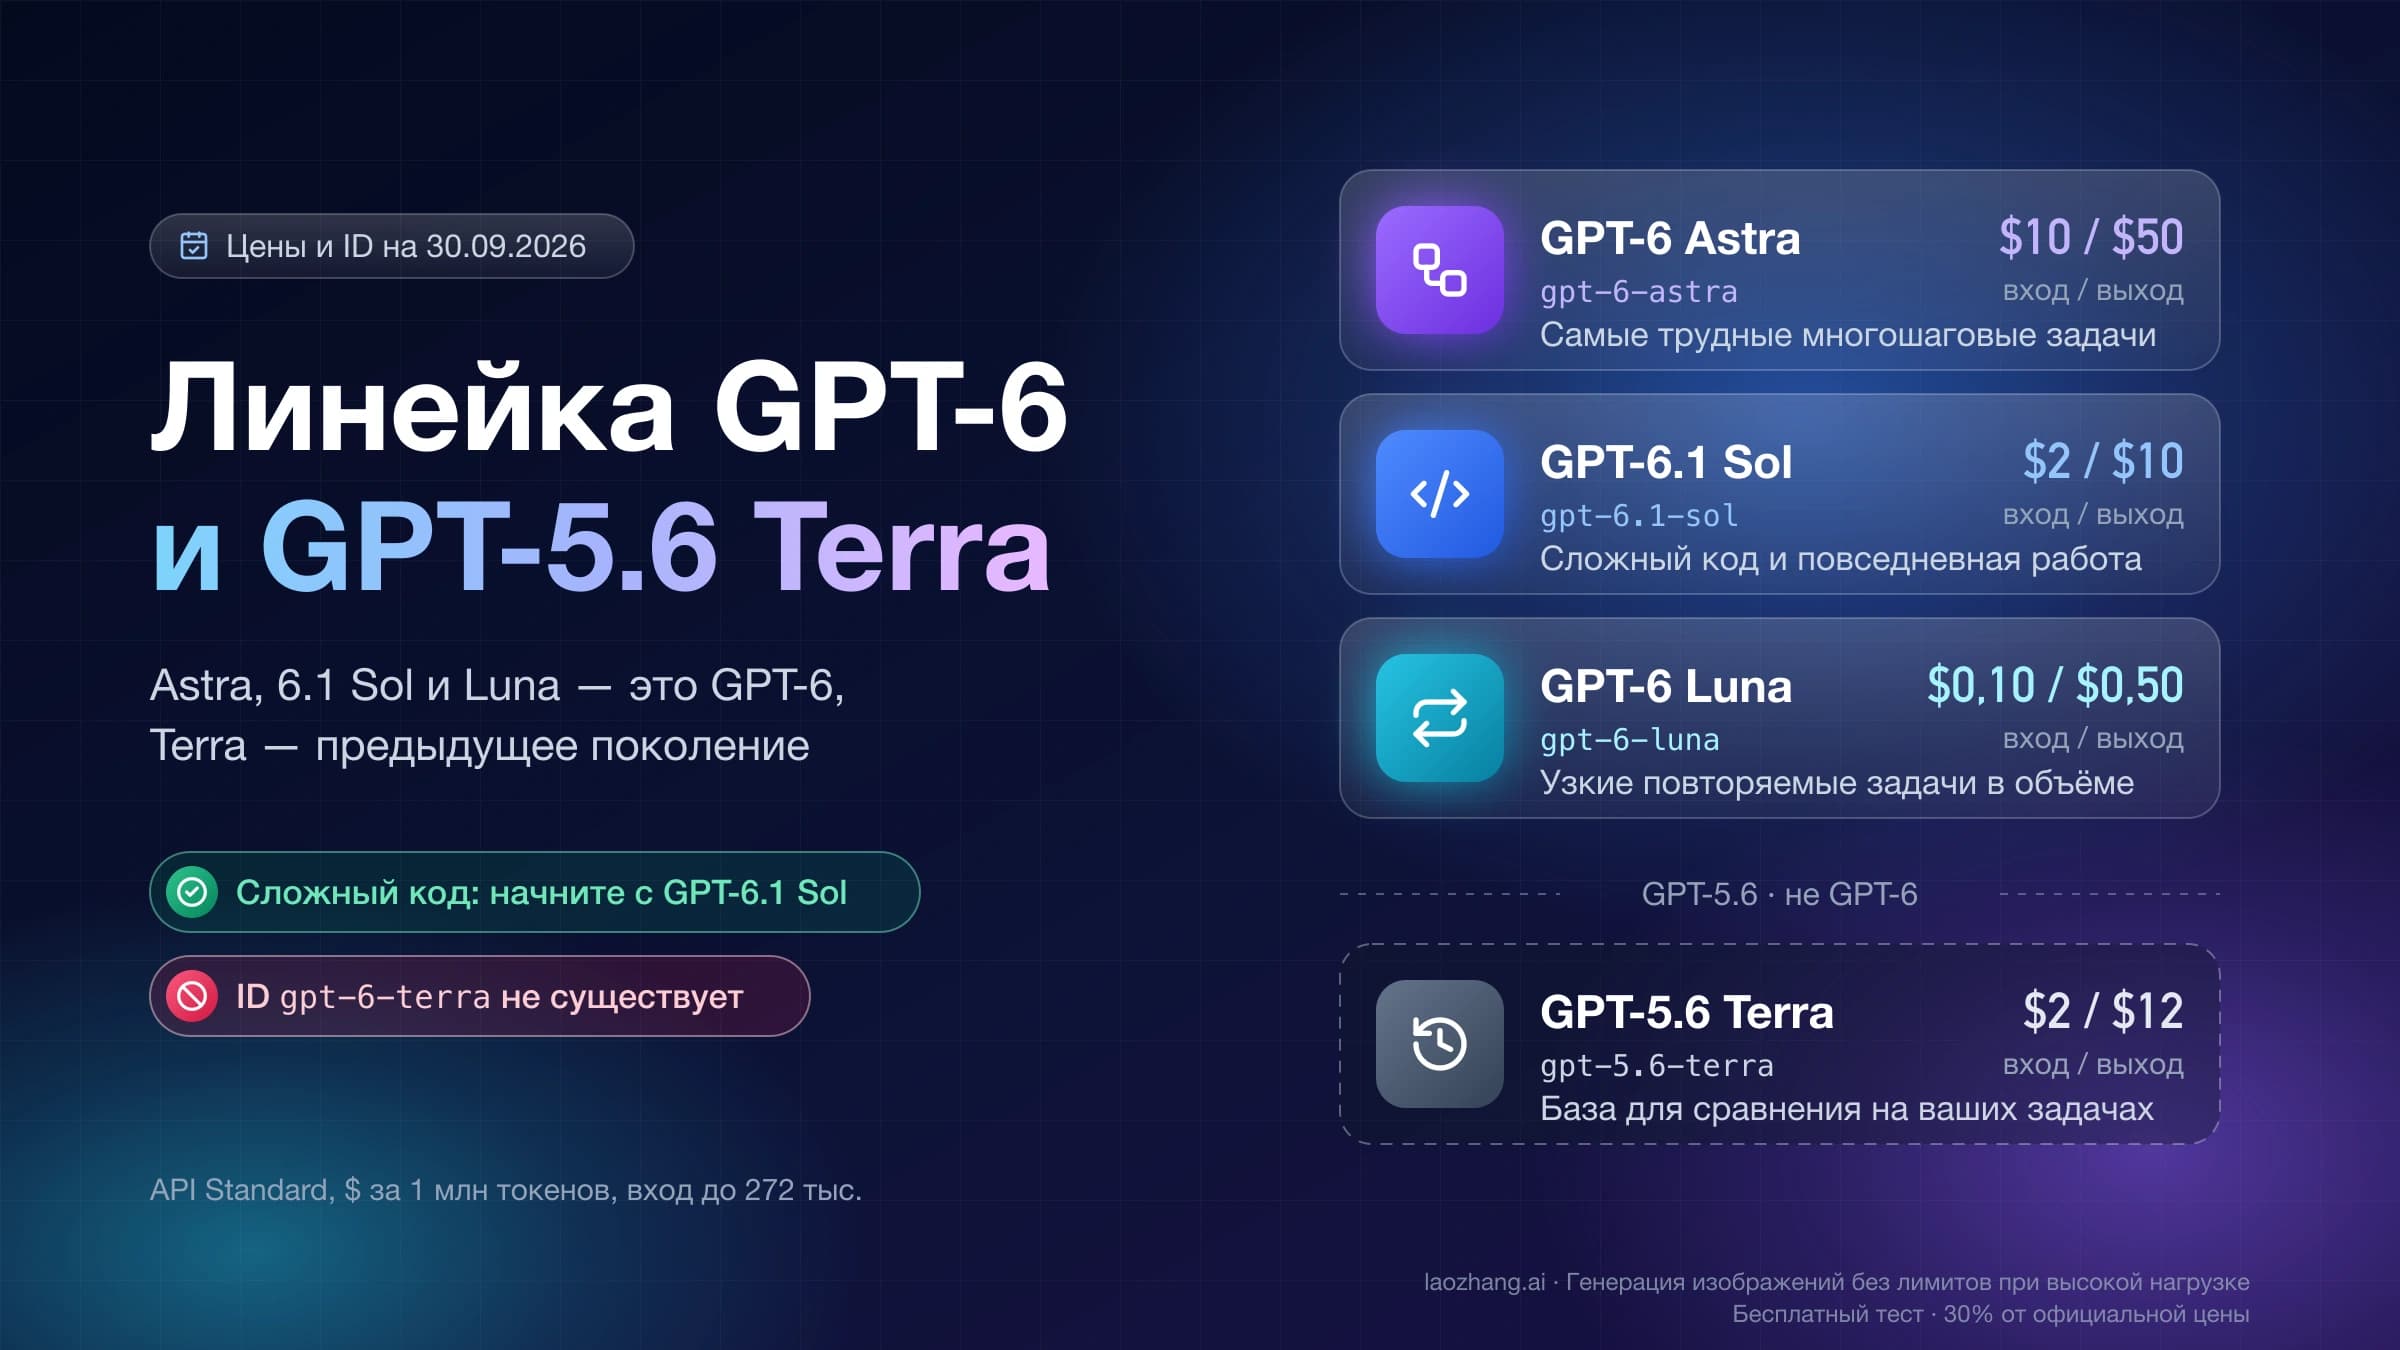
GPT-6 Astra быстрее не будет: по тем же замерам на Max она выдаёт 66,7 токена в секунду и ждёт первого токена 278,25 секунды. Для понятных повторяющихся задач — извлечения данных, классификации, преобразований — OpenAI советует GPT-6 Luna, у неё на Max 136,5 токена в секунду. Как выбрать между моделями по качеству и цене, а не только по скорости, разобрано в статье «GPT-6.1 Sol, GPT-6 Astra и GPT-6 Sol: какую модель выбрать».