Gemini 3.8 Flash TTS API:料金と移行手順
演技なら Flash、量産なら Flash-Lite。音声1分の料金は$0.0135と$0.009(2026年)、無料枠あり。3.1 preview とは書き方が5点違います。
目次
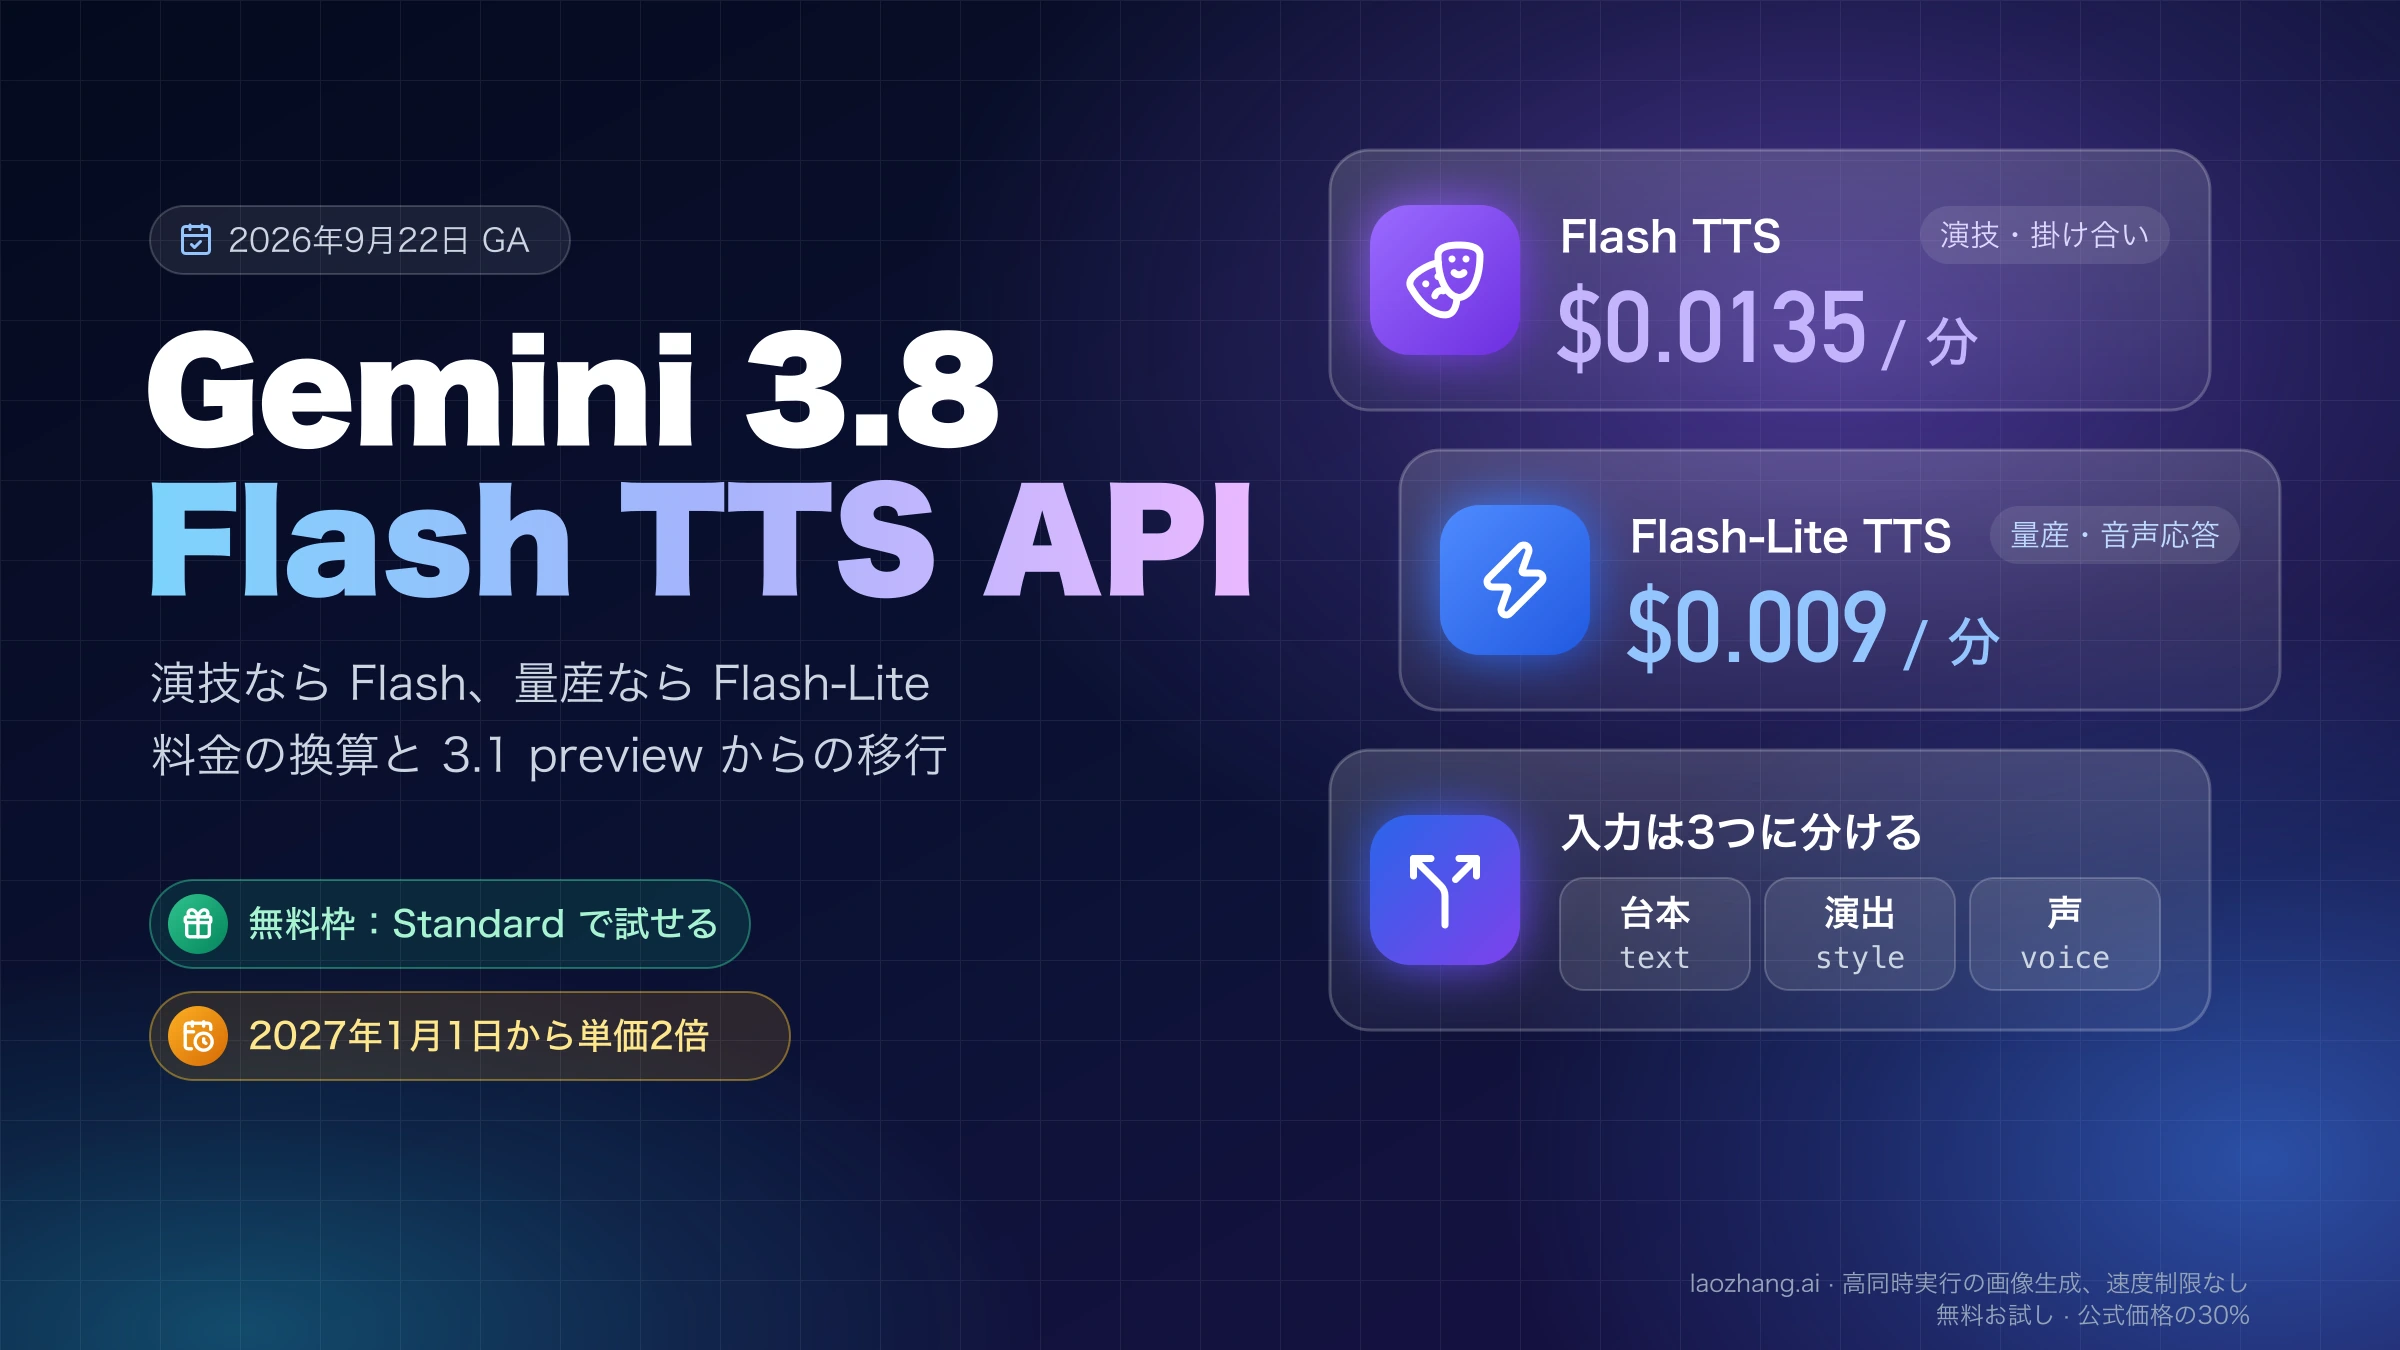
Google は2026年9月22日付の Gemini API リリースノートで、テキスト読み上げモデル gemini-3.8-flash-tts と gemini-3.8-flash-lite-tts を GA として公開しました(発表記事の日付は9月23日)。同時に音声を検索・作成する /v1beta/voices エンドポイントが追加され、音声デザイン(Voice design)と音声複製(Voice replication)が API から使えるようになっています。どちらのモデルも日本語に対応し、日本は Gemini API の提供地域に含まれます。
要点は3つです。
- 演技指示、2話者の掛け合い、長時間ナレーションの声の安定を重視するなら
gemini-3.8-flash-tts。大量生成、音声エージェントの応答、アプリの読み上げ機能ならgemini-3.8-flash-lite-tts。後者がgemini-3.1-flash-tts-previewの公式な後継です。 - 料金は出力音声が25トークン/秒で数えられ、2026年12月31日までの標準料金は Flash TTS が音声1分あたり約 $0.0135、Flash-Lite TTS が約 $0.009 です。2027年1月1日から両方とも2倍になります。無料枠でも Standard で呼べます。
- 3.1 preview や 2.5 TTS 向けのコードはそのままでは期待どおりに動きません。台本に書いた「Say cheerfully:」のような指示は読み上げられ、単発リクエストの既定出力は生 PCM から WAV に変わりました。
コードは Google の公式ドキュメントの例を日本語の台本に書き換えたもので、音質や遅延の実測値ではありません。
どちらのモデルを使うか
両モデルは API の構造とプロンプトの書き方が完全に同じで、model の文字列を変えるだけで切り替えられます。違いは音質と価格、対応言語数です。モデルページの位置づけに沿って整理すると次のようになります。
| 作りたいもの | 選ぶモデル | 理由 |
|---|---|---|
| オーディオブック、ドラマ仕立てのナレーション、ゲームのキャラクター音声 | gemini-3.8-flash-tts | 演技のニュアンス、笑いや溜め息などのタグ、長尺での声の安定が最優先 |
| ポッドキャストの2人の掛け合い、相槌や被り気味の会話 | gemini-3.8-flash-tts | パイプ記法の相槌は Flash TTS で最もよく効くと公式が明記 |
| 難読語や方言、少数言語の読み上げ | gemini-3.8-flash-tts | 対応言語は130超、地域アクセントの再現が売り |
| 音声エージェントの応答、カスタマーサポート bot | gemini-3.8-flash-lite-tts | 低遅延・高スループット向けに最適化 |
| 記事や社内文書の読み上げ、吹き替えの大量生成 | gemini-3.8-flash-lite-tts | 出力単価が Flash の3分の2 |
| 3.1 preview で動いている既存機能の置き換え | gemini-3.8-flash-lite-tts | 公式が「推奨の置き換え先」と明記 |
品質の根拠として Google が挙げているのは、Hume AI の Voice Design Benchmark で Flash TTS が総合1位(71.4)、同じく Hume AI の Overall Quality Index で Flash TTS が1位・Flash-Lite TTS が2位、そして Voice Arena のブラインド評価で日本語を含む複数言語で上位という数字です。いずれも発表記事に載った Google 側の数値で、第三者による再現結果ではありません。
TTS ではなく Live API が必要なケース
TTS モデルは「テキストを入れて音声を返す」一方向のモデルです。相手の声を聞きながら割り込みに応じるような双方向の会話には、Gemini 3.1 Flash Live API ガイド: モデル ID、料金、最短セットアップ (2026年3月)で扱っている Live API を使います。公式ドキュメントも、TTS は「ポッドキャストやオーディオブックのように、決まったテキストを細かい演出付きで正確に読み上げる」用途、Live API は「動的な会話」用途と線を引いており、3.8 TTS のモデルページでは Live API は「非対応」です。
音声エージェントで LLM の返答を読み上げるだけなら TTS で足ります。その場合は返答のチャンクが届くたびに1ターン1回の TTS 呼び出しにし、声の同一性は設定した音声に任せる、というのが公式の推奨する組み方です。録音や会話の文字起こしが必要な側は Gemini 3.5 Transcribe API 入門:録音とリアルタイム文字起こしを正しく実装するが担当します。
3.1 preview と 2.5 TTS の扱い
gemini-3.1-flash-tts-preview はモデル一覧で「レガシーの TTS プレビューモデル。3.8 Flash TTS か 3.8 Flash-Lite TTS への更新を推奨」と表示されています。廃止日は2026年9月30日時点で公開されていません。gemini-2.5-flash-preview-tts と gemini-2.5-pro-preview-tts については、2026年9月18日のリリースノートで 2.5 系モデル全体が「過去に実際に使っていたユーザーに限定」されました。新しいプロジェクトで 2.5 TTS を呼ぶと使えない、という状況はこの措置によるものです。
最初のリクエストを通す
前提は Gemini API キーと google-genai SDK です。キーの発行と保存は Google AI Studio APIキーの発行方法:安全な保存と初回接続までにまとめています。SDK は pip install -U google-genai で入れ、後述の音声ライブラリ検索まで使うなら 2.25.0 以上(JavaScript の @google/genai は 2.24.0 以上)が必要です。環境変数 GEMINI_API_KEY を設定しておけば genai.Client() が自動で読みます。
単一話者:台本と演出を分けて渡す
3.8 TTS への入力は Interactions API の形式です。text には読み上げる台本だけを書き、口調や感情などターン全体にかかる演出は speech_metadata の style に、声は generation_config.speech_config に入れます。
import base64
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-3.8-flash-lite-tts",
    input=[{
        "type": "user_input",
        "content": [{
            "type": "text",
            "text": "本日はご来場いただき、ありがとうございます。開演まで今しばらくお待ちください。",
            "annotations": [{
                "type": "speech_metadata",
                "style": "warm and calm, announcer",
            }],
        }],
    }],
    response_format={"type": "audio"},
    generation_config={
        "speech_config": [
            {"voice": "Kore"},
        ]
    },
)

with open("out.wav", "wb") as f:
    f.write(base64.b64decode(interaction.output_audio.data))
interaction.output_audio.data は Base64 文字列で、デコードした中身は RIFF ヘッダ付きの WAV(24kHz、モノラル、16bit 符号付きリトルエンディアン PCM)です。そのまま .wav として保存すれば、macOS の afplay out.wav やブラウザで再生できます。REST で叩く場合、音声は steps[].content[].data に入っています。
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-3.8-flash-lite-tts",
    "input": [{
      "type": "user_input",
      "content": [{
        "type": "text",
        "text": "本日はご来場いただき、ありがとうございます。",
        "annotations": [{ "type": "speech_metadata", "style": "warm and calm" }]
      }]
    }],
    "response_format": { "type": "audio" },
    "generation_config": { "speech_config": [ { "voice": "Kore" } ] }
  }' | jq -r '[.steps[] | select(.type=="model_output") | .content[] | select(.type=="audio")] | last | .data' | base64 --decode > out.wav
style の公式例はすべて英語で、日本語で書いた場合の挙動は公開情報に記載がありません。まず空の style で生成し、必要なターンだけ短い英語の指示を足すのが公式の推奨する順序です。空でも句読点と文脈から抑揚を付けてくれる、というのが Google の説明です。
2話者の掛け合い:conversational モード
ポッドキャスト風の対話は、speech_config を {"mode": "conversational", "speakers": [...]} の形にし、台本の各ターンに speaker を付けます。話者名は speakers の設定と台本側の speaker で一致している必要があり、公式例は英字です。
import base64
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-3.8-flash-tts",
    input=[{
        "type": "user_input",
        "content": [
            {
                "type": "text",
                "text": "今週のテーマは、Gemini の新しい読み上げモデルです。|へえ| 先週出たばかりなんですよね。",
                "annotations": [{"type": "speech_metadata", "speaker": "Yui", "style": "cheerful podcast host"}],
            },
            {
                "type": "text",
                "text": "ええ。<laugh> 正直、最初は前のモデルと何が違うのかと思っていました。",
                "annotations": [{"type": "speech_metadata", "speaker": "Ren", "style": "relaxed, slightly amused"}],
            },
        ],
    }],
    response_format={"type": "audio"},
    generation_config={
        "speech_config": {
            "mode": "conversational",
            "speakers": [
                {"speaker": "Yui", "voice": "Aoede"},
                {"speaker": "Ren", "voice": "Puck"},
            ],
        }
    },
)

with open("dialogue.wav", "wb") as f:
    f.write(base64.b64decode(interaction.output_audio.data))
この例には3.8で使える2つの記法が入っています。パイプで囲んだ |へえ| は、話している側のターンの中でもう一人が相槌を入れる指定で、ターンを細切れにせずに被り気味の反応を作れます。公式は「Flash TTS で最もよく効く」としています。山括弧の laugh のようなタグは、その位置で一度だけ起きる非言語音(笑い、溜め息、咳、短い間など)を指定します。台本が日本語でもタグは英語のままにする、というのが公式の注意書きです。パイプの中身は実際に発話される言葉で、公式が英語に限定しているのは山括弧のタグだけです。
ストリーミング:戻ってくるのは生 PCM
stream=True にすると音声チャンクが step.delta イベントで順次届きます。単発リクエストと違い、ストリーミングの既定はヘッダなしの生 PCM(audio/l16、24kHz、モノラル、16bit)です。チャンクをそのまま連結しても継ぎ目にヘッダが挟まらない設計で、再生デバイスに流すならそのまま渡し、ファイルに残すなら最後に一度だけ WAV ヘッダを付けます。次の例は公式のストリーミング例に wave モジュールでの保存を足したものです。
import base64
import wave
from google import genai

client = genai.Client()

stream = client.interactions.create(
    model="gemini-3.8-flash-lite-tts",
    input=[{
        "type": "user_input",
        "content": [{
            "type": "text",
            "text": "お問い合わせありがとうございます。ご注文番号をお知らせください。",
            "annotations": [{"type": "speech_metadata", "style": ""}],
        }],
    }],
    response_format={"type": "audio"},
    generation_config={"speech_config": [{"voice": "Kore"}]},
    stream=True,
)

with wave.open("stream.wav", "wb") as wf:
    wf.setnchannels(1)
    wf.setsampwidth(2)
    wf.setframerate(24000)
    for event in stream:
        if event.event_type == "step.delta" and event.delta.type == "audio":
            wf.writeframes(base64.b64decode(event.delta.data))
出力形式は response_format の mime_type と sample_rate で変えられます。
mime_type | 内容 | 既定になる場面 |
|---|---|---|
audio/wav | RIFF ヘッダ付き WAV、16bit PCM、モノラル、24kHz | 単発リクエスト |
audio/l16 | ヘッダなしの生 16bit PCM、モノラル、24kHz | ストリーミング |
audio/mulaw | 8bit G.711 μ-law。公式ドキュメントは「北米と日本の電話・IVR で一般的」と説明 | 指定時のみ |
audio/alaw | 8bit G.711 A-law。欧州などの電話系 | 指定時のみ |
sample_rate には 24000、16000、8000 などを指定できます。電話系の IVR に流すなら audio/mulaw と 8000 の組み合わせが素直です。
料金:25トークン/秒から1分・1時間あたりを計算する
料金ページの TTS モデルは「出力音声100万トークンあたり」で書かれていて、脚注に「音声トークンは1秒あたり25トークン」とあります。ここから分あたり・時間あたりに直せます。
1分の音声   = 60秒 × 25 = 1,500トークン
1時間の音声 = 3,600秒 × 25 = 90,000トークン
1分あたりの料金 = 出力単価($/100万トークン)× 1,500 ÷ 1,000,000
例:Flash TTS 標準 $9.00 × 1,500 ÷ 1,000,000 = $0.0135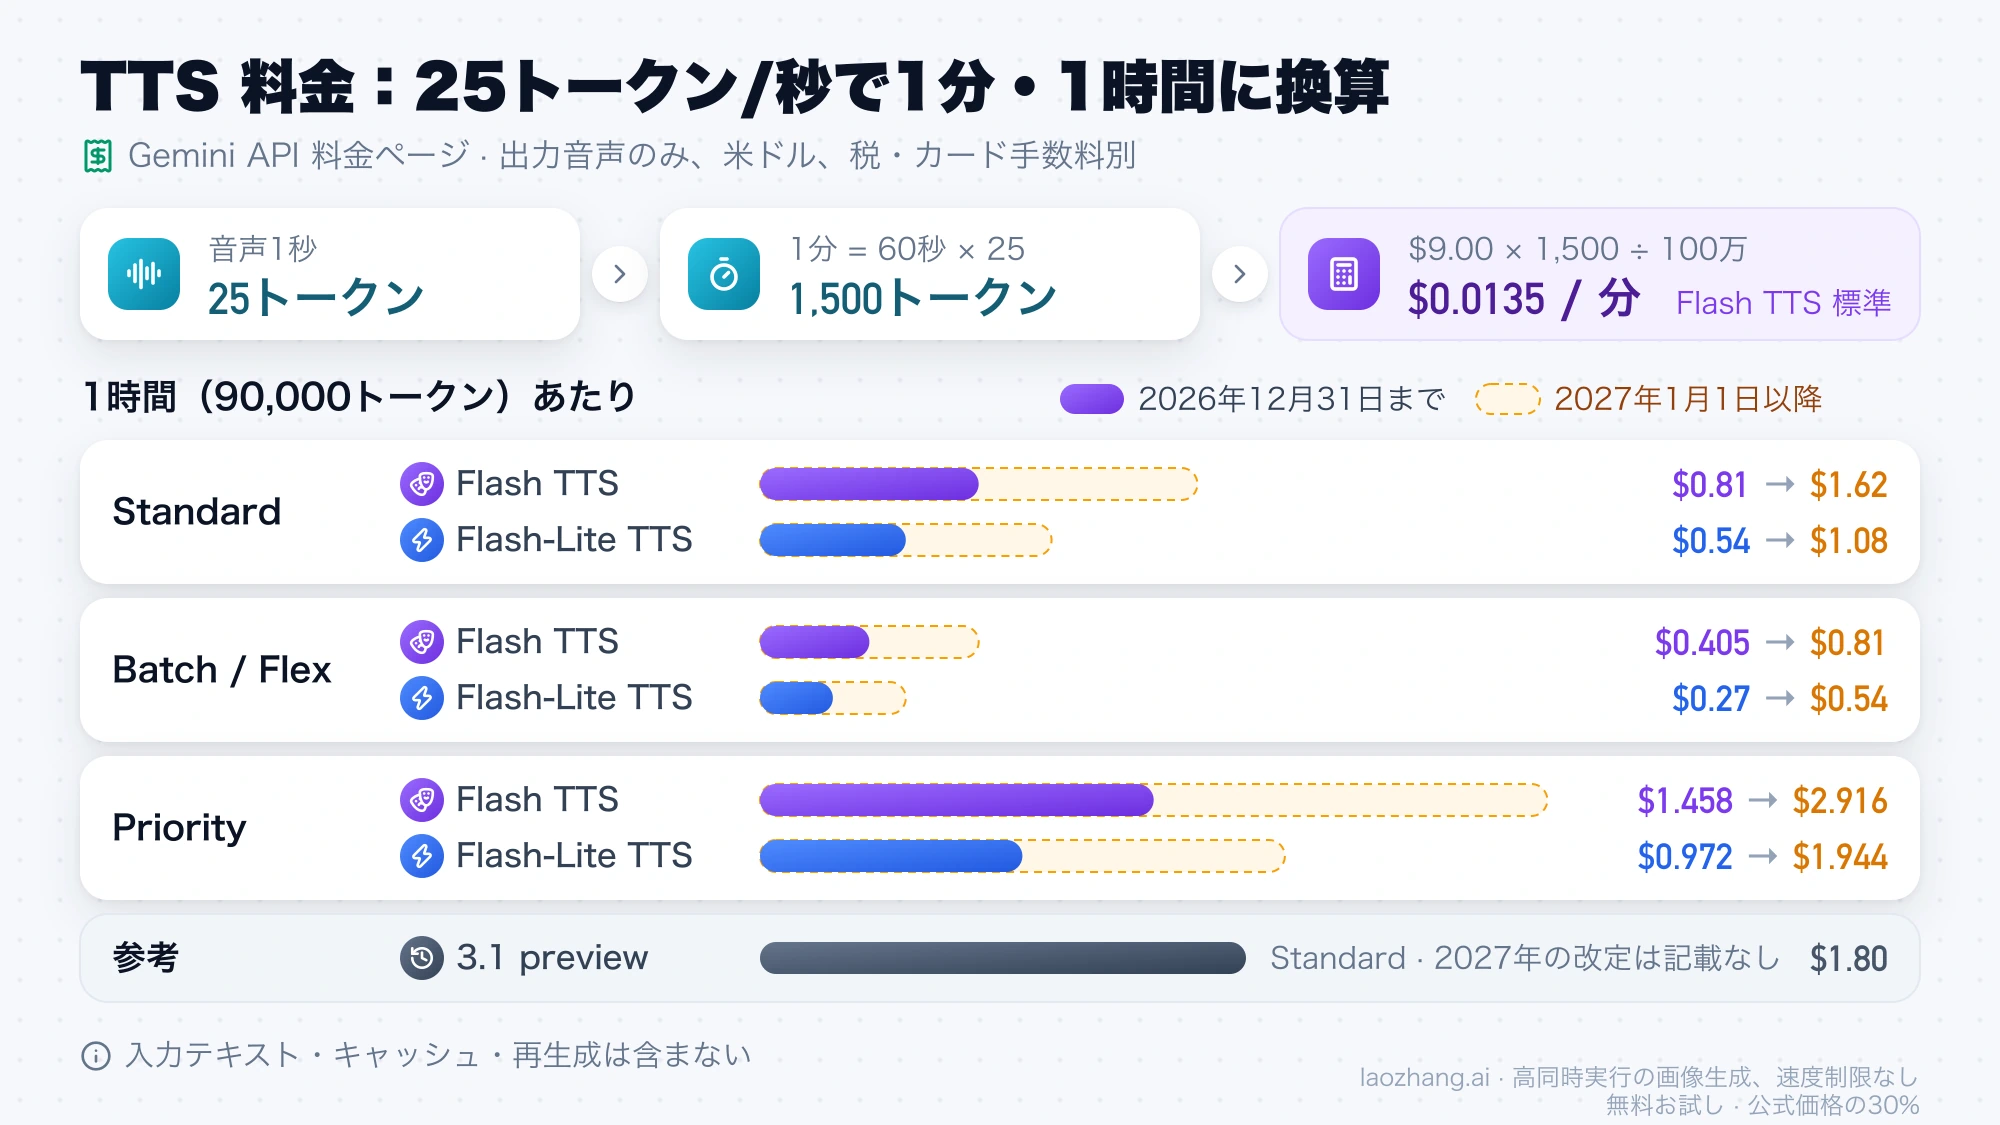
この式で各レーンを換算すると次のとおりです(出力音声のみ、米ドル、税・カード手数料別)。Batch と Flex は同じ単価です。
| レーン | モデル | 100万トークン | 1分あたり | 1時間あたり | 2027年1月1日以降の1時間 |
|---|---|---|---|---|---|
| Standard | Flash TTS | $9.00 | $0.0135 | $0.81 | $1.62 |
| Standard | Flash-Lite TTS | $6.00 | $0.009 | $0.54 | $1.08 |
| Batch / Flex | Flash TTS | $4.50 | $0.00675 | $0.405 | $0.81 |
| Batch / Flex | Flash-Lite TTS | $3.00 | $0.0045 | $0.27 | $0.54 |
| Priority | Flash TTS | $16.20 | $0.0243 | $1.458 | $2.916 |
| Priority | Flash-Lite TTS | $10.80 | $0.0162 | $0.972 | $1.944 |
| 参考:Standard | 3.1 Flash TTS preview | $20.00 | $0.03 | $1.80 | 2027年の改定の記載なし |
| 参考:Standard | 2.5 Flash preview TTS | $10.00 | $0.015 | $0.90 | 同上 |
2027年1月1日以降は、3.8 の両モデルとも入力・出力・キャッシュの単価がちょうど2倍になると料金ページに明記されています。日付が切られているので、来年度の予算は倍額で組む必要があります。それでも Flash-Lite TTS の2027年料金($12.00)は 3.1 preview の現行料金($20.00)より安く、Flash TTS の2027年料金($18.00)でも 3.1 preview を下回ります。
入力側のテキストは Standard で100万トークンあたり $0.50 なので、1分の台本が数百トークンでも $0.0001〜0.0002 程度にしかならず、見積もりでは出力音声の項がほぼすべてです。ただし請求は入力+出力なので、正確に出すときは足してください。キャッシュや保存料金、失敗したリクエストの再生成もこの表には含まれません。実際の音声の長さはモデルの話速で決まるため、台本の文字数から事前に厳密な秒数は出せません。
用途別にざっくり当てはめると、
- 10分のポッドキャスト1本:Flash TTS Standard で約 $0.135、Flash-Lite TTS なら約 $0.09
- 1時間のオーディオブック:Flash TTS Standard で約 $0.81、Batch に回せば約 $0.405
- 月100時間の読み上げ機能:Flash-Lite TTS Standard で約 $54、2027年からは約 $108
という規模感です。課金設定と支払い方法の全体像は Gemini APIキーは購入する?料金・課金・安全な選び方を参照してください。
無料枠で試せるか
料金ページの Free Tier 列では、3.8 の両モデルとも Standard と Priority が「Free of charge」、Batch と Flex は「Not available」です。無料枠で送ったデータは Google の製品改善に使われ、有料枠では使われません。開発中の動作確認や声の聞き比べは無料枠で十分できます。
ただし、無料枠でどれだけ生成できるかの数字はありません。レート制限ページに 3.8 TTS のモデル別 RPM・TPM・RPD の行はなく、「AI Studio で自分のプロジェクトの有効な制限を見る」よう案内されています。有料枠には10分間あたりの支出上限(Tier 1 で $10、Tier 2 で $50、Tier 3 で $200)もあり、超えると 429 RESOURCE_EXHAUSTED が返ります。Flash TTS Standard を1時間分まとめて流すと $0.81 なので Tier 1 でも当たりにくい額ですが、Priority で並列に投げる構成なら計算しておく価値があります。実上限の確認手順は Gemini API無料枠の利用上限 2026:何がまだ無料で、実上限はどこで確認し、キー追加で増えない理由にあります。
Vertex AI・Google Cloud で使えるか
2026年9月30日時点で、Google Cloud Text-to-Speech の Gemini-TTS ページに載っているのは gemini-3.1-flash-tts-preview と 2.5 系だけで、3.8 は掲載されていません。発表記事では企業向けに「Gemini Enterprise 経由の API で近日提供」とされています。今すぐ 3.8 を使うなら Gemini API(AI Studio のキー)経由です。
3.1 preview・2.5 TTS からの移行:壊れる5点
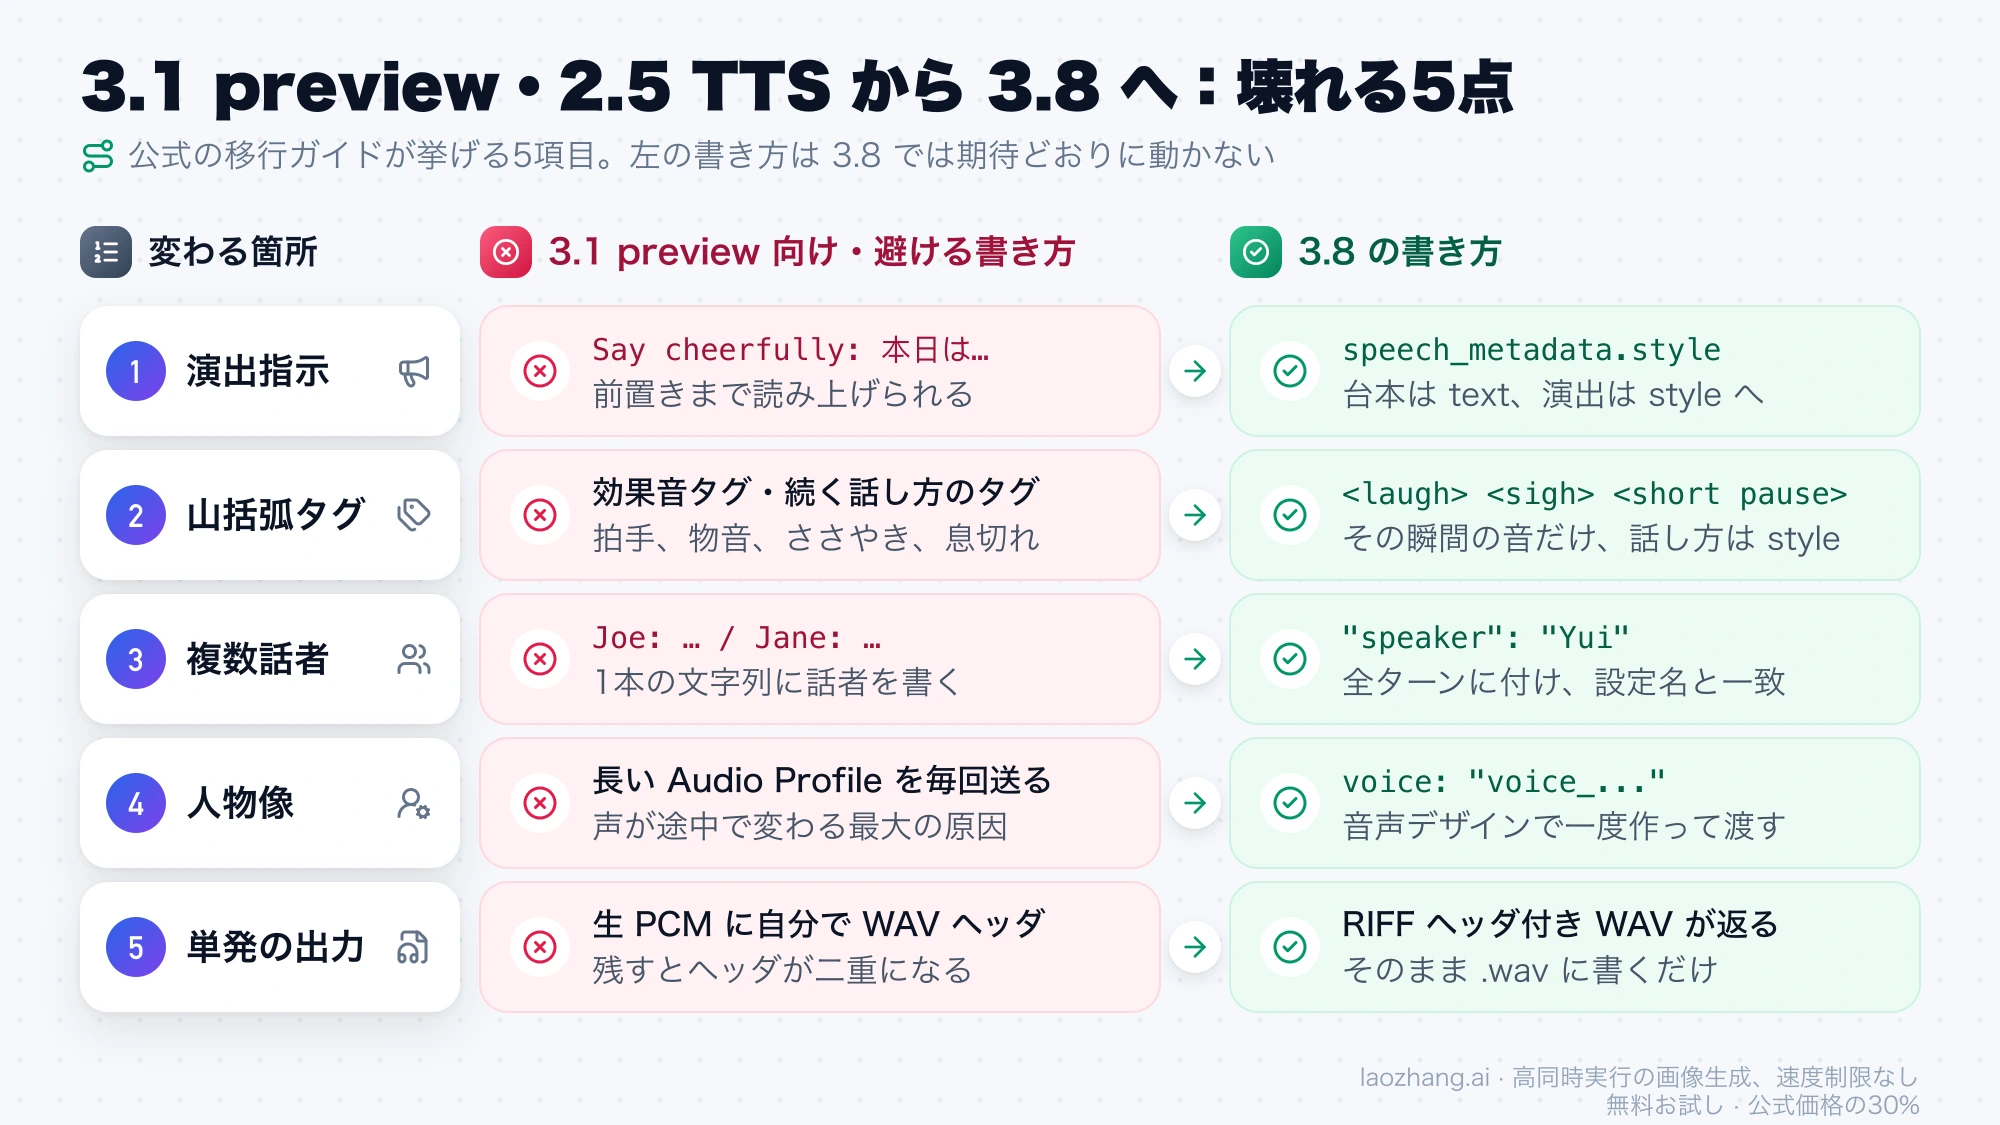
公式の移行ガイドは5項目を挙げています。旧コードで何が起きるか、書き換え後はどうなるかは次のとおりです。
1. 台本内の演出指示が読み上げられる
3.8 TTS は text を逐語の台本として扱います。3.1 preview で通用していた「Say cheerfully: 〜」や「Speaker 1: 〜」のような前置きは、そのまま声に出して読まれる可能性があります。演出は speech_metadata.style、話者名は speech_metadata.speaker に移します。
# 3.1 preview 向けの典型的な書き方(公式移行ガイドが挙げる形)
interaction = client.interactions.create(
    model="gemini-3.1-flash-tts-preview",
    input="Say cheerfully: 本日はご来場ありがとうございます。",
    response_format={"type": "audio"},
    generation_config={"speech_config": [{"voice": "Kore"}]},
)# 3.8 向け:台本と演出を分ける
interaction = client.interactions.create(
model="gemini-3.8-flash-lite-tts",
input=[{
"type": "user_input",
"content": [{
"type": "text",
"text": "本日はご来場ありがとうございます。",
"annotations": [{"type": "speech_metadata", "style": "cheerful"}],
}],
}],
response_format={"type": "audio"},
generation_config={"speech_config": [{"voice": "Kore"}]},
)GenerateContent API を使っている場合は、各 part に "speech_metadata": {"speaker": "...", "style": "..."} を付ける形になります。
2. 山括弧タグは「その瞬間の音」だけに使う
タグに使えるのは笑い、溜め息、咳、息継ぎ、短い間・長い間のような、一点で起きる人の声の出来事です。拍手や物音のような効果音タグは避け、「ささやく」「息切れ」のようにターン全体に続く話し方は style に書きます。公式が推奨するタグの一覧は次のとおりです。
<argh> <breath> <heavy breath> <exhales> <cackle> <cheer> <chuckle> <cough>
<cry> <gasp> <giggle> <groan> <growl> <grunt> <grr> <hiss> <laugh> <moan>
<pant> <pff> <phew> <scream> <shout> <shriek> <sigh> <sneeze> <snicker>
<snort> <sob> <throat-clearing> <tsk> <whimper> <whispers> <yawn>
<short pause> <long pause>
3. 複数話者では全ターンに speaker が必要
3.1 preview では「Joe: 〜 / Jane: 〜」と1つの文字列に書いた台本を渡す形でしたが、3.8 ではターンごとに text を分け、それぞれの speech_metadata に設定済みの話者名と一致する speaker を入れます。設定にない名前や speaker の抜けたターンがあると要件を満たしません。
# 3.1 preview 向け:1本の文字列に話者を書く
input="TTS the following conversation between Yui and Ren:\nYui: 今週のテーマは新しい読み上げモデルです。\nRen: 先週出たばかりですよね。"# 3.8 向け:ターンごとに speaker を付ける(speakers の設定と一致させる)
input=[{
"type": "user_input",
"content": [
{"type": "text", "text": "今週のテーマは新しい読み上げモデルです。",
"annotations": [{"type": "speech_metadata", "speaker": "Yui"}]},
{"type": "text", "text": "先週出たばかりですよね。",
"annotations": [{"type": "speech_metadata", "speaker": "Ren"}]},
],
}]4. 長い「Audio Profile」は音声デザインに置き換える
3.1 preview で人物像を数段落の「Audio Profile」や「Director's Notes」として毎回送っていたなら、それは 3.8 では声が途中で変わる最大の原因だと公式が書いています。人物像は一度だけ音声デザインで作り、返ってきた voice_... の ID を speech_config の voice に渡し、style は空か短い一言にします。
created = client.voices.create(
    store=True,
    voice={
        "model": "gemini-3.8-flash-tts",
        "type": "prompted",
        "display_name": "Calm Japanese narrator",
        "gender": "female",
        "language_code": "ja-JP",
        "prompted": {
            "input": "A calm Japanese narrator in her 40s, low-medium pitch, clear diction, unhurried audiobook cadence."
        },
    },
)
print(created.id)  # voice_... をアプリ側に保存して使い回す
音声デザインの説明文には年齢・声質・高さ・アクセント・基本の話速のような「誰が話しているか」を書き、「今このターンでどう感じているか」は書きません。公式の例文はすべて英語です。「声を変えないで」「同じ話者を維持して」といったメタ指示を足すのは逆効果で、余計な文がかえって声の揺れを増やすとされています。
5. 単発リクエストの既定出力が生 PCM から WAV に変わった
3.1 preview 以前は生 PCM が返ってきたため、wave モジュールや ffmpeg でヘッダを付けてから保存するコードが一般的でした。3.8 の単発リクエストは RIFF ヘッダ付きの WAV を返すので、そのラッパーを残すとヘッダが二重になります。書き換えは「デコードしたバイト列をそのまま .wav に書く」だけです。旧来のパイプラインが生 PCM 前提なら、response_format に "mime_type": "audio/l16" を明示すれば以前と同じ形で受け取れます。
# 3.1 preview 向け:生 PCM に自分で WAV ヘッダを付けていた
pcm = base64.b64decode(interaction.output_audio.data)
with wave.open("out.wav", "wb") as wf:
    wf.setnchannels(1)
    wf.setsampwidth(2)
    wf.setframerate(24000)
wf.writeframes(pcm)# 3.8 向け:返ってきた WAV をそのまま保存する
with open("out.wav", "wb") as f:
f.write(base64.b64decode(interaction.output_audio.data))なお公式の読み上げドキュメントでは、Python・JavaScript・REST の例が 3.8 に更新されている一方、Go の例は2026年9月30日時点でも gemini-3.1-flash-tts-preview と saveWaveFile のままです。Go で書くなら REST の JSON 形をもとに組み立て、Go の例を写さないほうが安全です。
上限と失敗の境界
先に把握しておくと手戻りが減る数字は次のとおりです。出典はモデルページと読み上げドキュメントの制限事項です。
| 項目 | 上限・挙動 | 当たったときの対処 |
|---|---|---|
| 入力トークン | 8,192 | 台本を章・段落で分割し、複数リクエストにする |
| 出力トークン | 16,384(Gemini API のサービング上限)。25トークン/秒で割ると1リクエスト約10.9分の音声(導出値) | 長尺は分割して後で結合 |
| 1リクエストの話者数 | 2人まで、しかもプリビルト音声のみ | カスタム音声や3人以上はターンごとに合成して結合 |
| 保存するカスタム音声 | store=True の voice_... はプロジェクトあたり200件、保持期間1年(デザインと複製で共有) | 不要になった音声を voices.delete() で消す |
| 保存しない複製キー | store=False の voicekey_... は7日で失効 | 期限前に作り直すか store=True にする |
| 台本内の指示文 | 逐語で読み上げられる | speech_metadata に移す |
| タグの言語 | 台本が日本語でも英語 | |
| 単発の出力 | WAV(ヘッダ付き) | 生 PCM が要るなら audio/l16 を指定 |
| ストリーミングの出力 | 生 PCM(ヘッダなし) | 保存時に一度だけヘッダを付ける |
| 非対応機能 | function calling、structured outputs、thinking、grounding、Live API、画像生成 | 台本の生成は 3.8 Flash などのテキストモデルで先に行う |
| レート上限 | 3.8 TTS の RPM・TPM・RPD の公開表なし。有料枠は10分あたりの支出上限あり | AI Studio のレート制限画面で自分の値を確認 |
| 利用地域 | 日本は提供地域に含まれる。18歳以上 |
カスタム音声どうしの対話は、話者ごとに合成した音声を連結することになります。単発リクエストの WAV には44バイトの RIFF ヘッダが付くので、そのまま連結すると2本目以降の頭にヘッダが混ざります。各ターンを audio/l16 で受け取って PCM のまま繋ぎ、最後に1回だけ WAV に包むのが公式の案内に沿ったやり方です。
import base64
import wave
from google import genai

client = genai.Client()

turns = [
    ("voice_narrator_xxx", "第一章。その朝、港は霧に包まれていました。"),
    ("voice_captain_xxx", "出航は延期だ。霧が晴れるまで待て。"),
]

with wave.open("scene.wav", "wb") as wf:
    wf.setnchannels(1)
    wf.setsampwidth(2)
    wf.setframerate(24000)
    for voice_id, line in turns:
        interaction = client.interactions.create(
            model="gemini-3.8-flash-tts",
            input=[{"type": "user_input", "content": [{
                "type": "text", "text": line,
                "annotations": [{"type": "speech_metadata", "style": ""}],
            }]}],
            response_format={"type": "audio", "mime_type": "audio/l16", "sample_rate": 24000},
            generation_config={"speech_config": [{"voice": voice_id}]},
        )
        wf.writeframes(base64.b64decode(interaction.output_audio.data))
ターン間の間合いは、無音の PCM フレームを挟むか、台本側で間のタグを使って調整します。
日本語で使うときの実務ポイント
対応言語表では Japanese が Flash TTS・Flash-Lite TTS の両方で対応です。入力言語は自動判定で、language_code のような指定は TTS リクエストにはありません。日本語の台本に英語のタグや相槌記法を混ぜても、タグは読み上げられずに音として処理されます。
読みの指定。人名や社名、専門用語の読み間違いには、公式の AI Studio 向けガイドが示す方法として、単語の直後にスラッシュで囲んだ IPA を置く書き方があります。たとえば「東海林」なら 東海林 /ɕoːdʑi/ さん のように書きます。読みが一意に決まる語であれば、台本の漢字をかなに開いてしまう方が手早い場合もあります。年齢や性別、恒久的なアクセントの変更は style に書いても効かず、Extended Voice Library から地域に合った声を選ぶか、音声デザインで作るのが公式の指示です。
日本語向けの声を探す。30種のプリビルト音声に加え、client.voices.list() で Extended Voice Library を BCP-47 の言語タグや性別、声の高さ、用途で絞り込めます。次は日本語のナレーション向けの声を探す例です。
from google import genai

client = genai.Client()
response = client.voices.list(
    language_code=["ja-JP"],
    contexts=["Audiobook"],
    persona=["Narrator"],
    type_=["prebuilt"],
    page_size=50,
)
for voice in response.voices or []:
print(voice.id, voice.display_name, voice.gender, voice.pitch, voice.description)音声複製の同意文。自分や権利を持つ話者の声を複製するには、10〜30秒の参照音声と、同じ話者が同意文を読み上げた音声の2つが必要で、両方とも同じマイク・同じ部屋で 24kHz モノラル 16bit の WAV にしておくと照合が通りやすいと案内されています。日本語(ja-JP)の同意文は次の定型で、一字一句そのまま読み上げます。
私はこの音声の所有者であり、Googleがこの音声を使用して音声合成モデルを作成することを承認します。
発表記事の脚注では、AI Studio 経由の音声複製がイリノイ州、テキサス州、EEA、英国、スイス、インドで使えないとされていますが、日本はこの一覧に含まれていません。生成されたすべての音声には SynthID の透かしが入ります。
電話・IVR。既存の PBX や IVR に流す場合は audio/mulaw と sample_rate: 8000 を指定すると、変換を挟まずに渡せる形になります。公式ドキュメント自身が μ-law を「北米と日本の電話系で一般的」と位置づけています。
台本の生成と読み上げの分担。3.8 TTS には thinking も function calling もありません。台本づくりは Gemini 3.8 Flash 導入ガイド:料金、モデル ID、3.7 からの移行で扱うテキストモデルに任せ、出来上がった台本を TTS に渡す2段構成にします。AI Studio の音声プレイグラウンドで声と台本を試してからコードに落とす流れは、Google AI Studioは無料?使える範囲と課金の境目で扱っている無料範囲で完結します。
よくある質問
無料枠で1日に何分まで生成できますか。 公開された数字はありません。料金ページには Standard と Priority が無料枠で使えることだけが書かれ、レート制限ページに 3.8 TTS の行はないため、AI Studio のレート制限画面で自分のプロジェクトの値を見るのが唯一の確認手段です。
gemini-2.5-flash-preview-tts が呼べなくなったのはなぜですか。 2026年9月18日のリリースノートで、2.5 系モデルへのアクセスが過去に実際に使っていたユーザーに限定されたためです。廃止ではありませんが、新規プロジェクトでは 3.8 Flash-Lite TTS に移るのが公式の案内です。料金も 2.5 Flash TTS の $10.00 に対して Flash-Lite TTS は $6.00(2026年)です。
3人以上の会話を1リクエストで作れますか。 作れません。1リクエストは2話者まで、かつプリビルト音声に限られます。3人目以降やカスタム音声は、上の「上限と失敗の境界」にある手順でターンごとに合成して繋ぎます。
Flash TTS と Flash-Lite TTS を途中で切り替えると台本の書き直しが要りますか。 要りません。API の構造とプロンプト形式は同一で、model の文字列を変えるだけです。まず Flash-Lite TTS で組み、演技や掛け合いの質が足りないターンだけ Flash TTS に回す構成も取れます。