Gemini 3.5 Transcribe API 入門:録音とリアルタイム文字起こしを正しく実装する
録音ファイルは gemini-3.5-transcribe、リアルタイム字幕は gemini-3.5-transcribe-live を使います。自作辞書と話者・単語時刻は録音の同じリクエストに入れられません。用途別の Python 例と、暫定字幕と確定文を分けて終了待ちに上限を設ける処理を紹介します。
目次
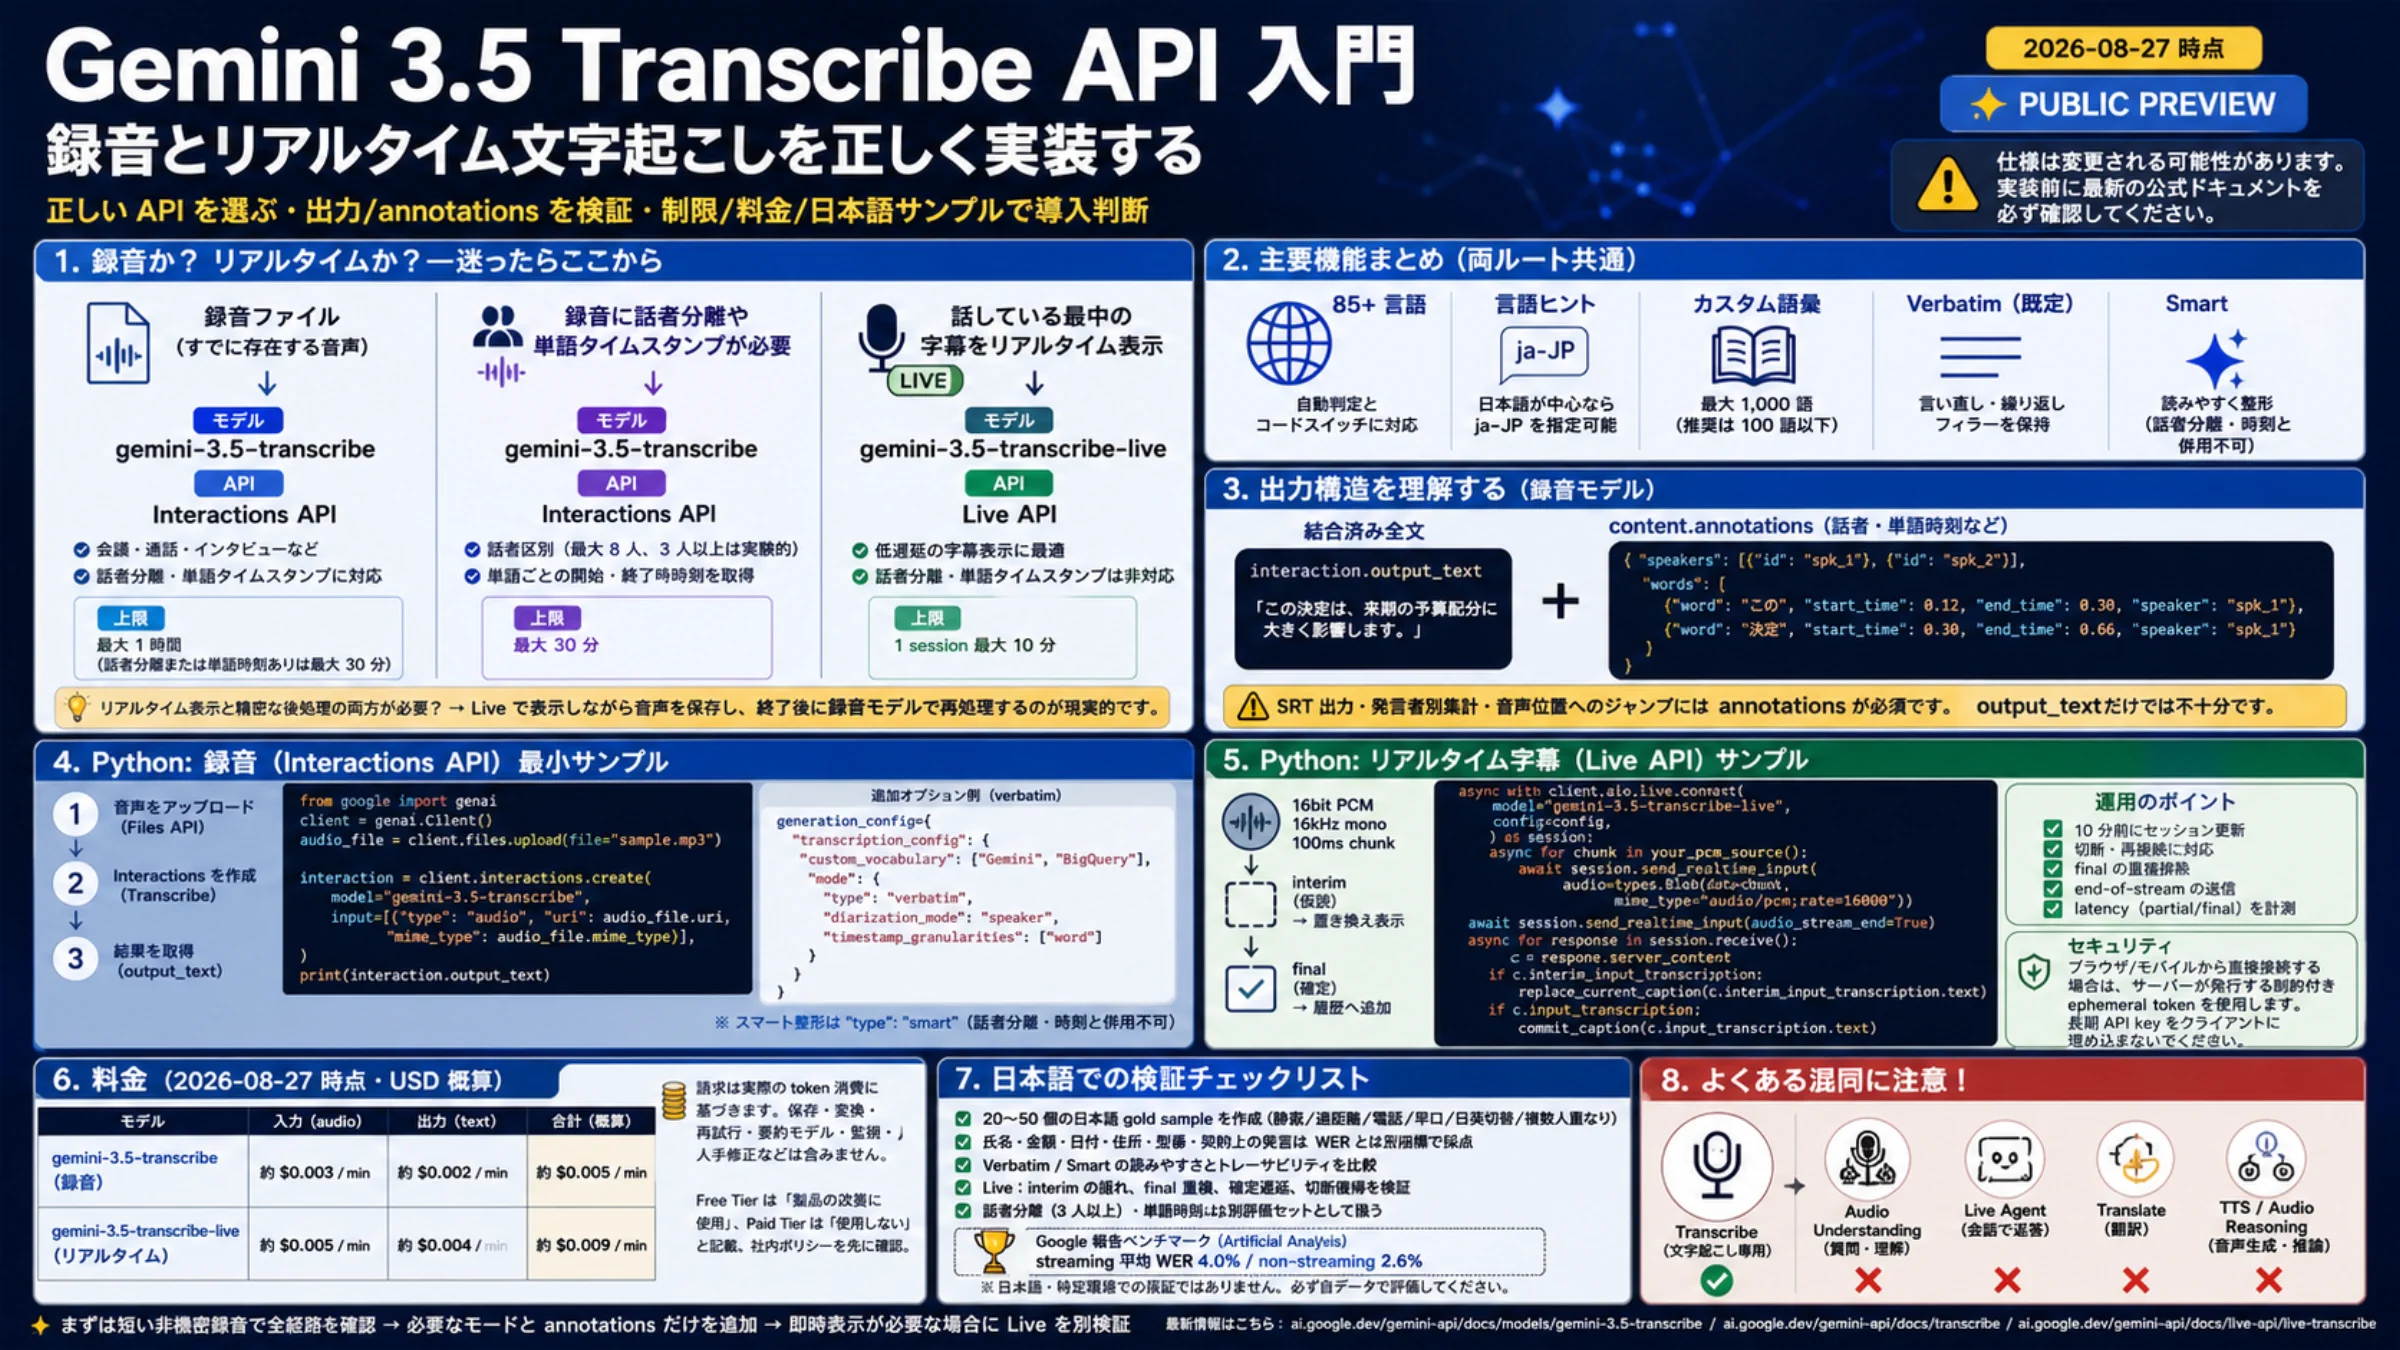
Gemini 3.5 Transcribe API では、録音ファイルに gemini-3.5-transcribe、発話中の字幕に gemini-3.5-transcribe-live を使います。録音は Files API でアップロードした音声を Interactions API に渡します。Live は専用の PCM 音声を送り、暫定テキストを更新しながら確定文を保存します。
最初に決めるのは、文字起こしから何を残したいかです。固有名詞を認識させたい録音なら自作辞書、発言者や音声位置を追いたい録音なら話者分離と単語単位タイムスタンプを選びます。自作辞書と、この二つの注釈機能を同じ録音リクエストで併用すると API に拒否されます。 この条件は現在の公式文字起こしガイドに明記されています。
以下の接続例は公式仕様に沿って作成した読者向けのコードです。本記事では Python の構文、設定の組み合わせ、合成データによる注釈処理・字幕処理・PCM 検査と料金計算をローカルで確認しました。SDK の実行、実音声の認識、アカウントでの利用可否や請求の成功は確認していません。
まず三つの要件を分ける
全文が必要なだけなら録音モデルから始めます。録音に話者や時刻が必要な場合も同じモデルですが、上限が短くなります。話している最中に表示する必要があるときに Live を選びます。
| 必要な結果 | モデルと API | 音声時間の上限・主な条件 |
|---|---|---|
| 録音の文字起こし | gemini-3.5-transcribe、Interactions API | 1リクエスト最大1時間 |
| 録音の話者分離・単語タイムスタンプ | 同上、verbatim の注釈設定 | 最大30分。自作辞書は併用不可 |
| リアルタイム字幕 | gemini-3.5-transcribe-live、Live API | 1セッション最大10分。話者分離・単語タイムスタンプは非対応 |
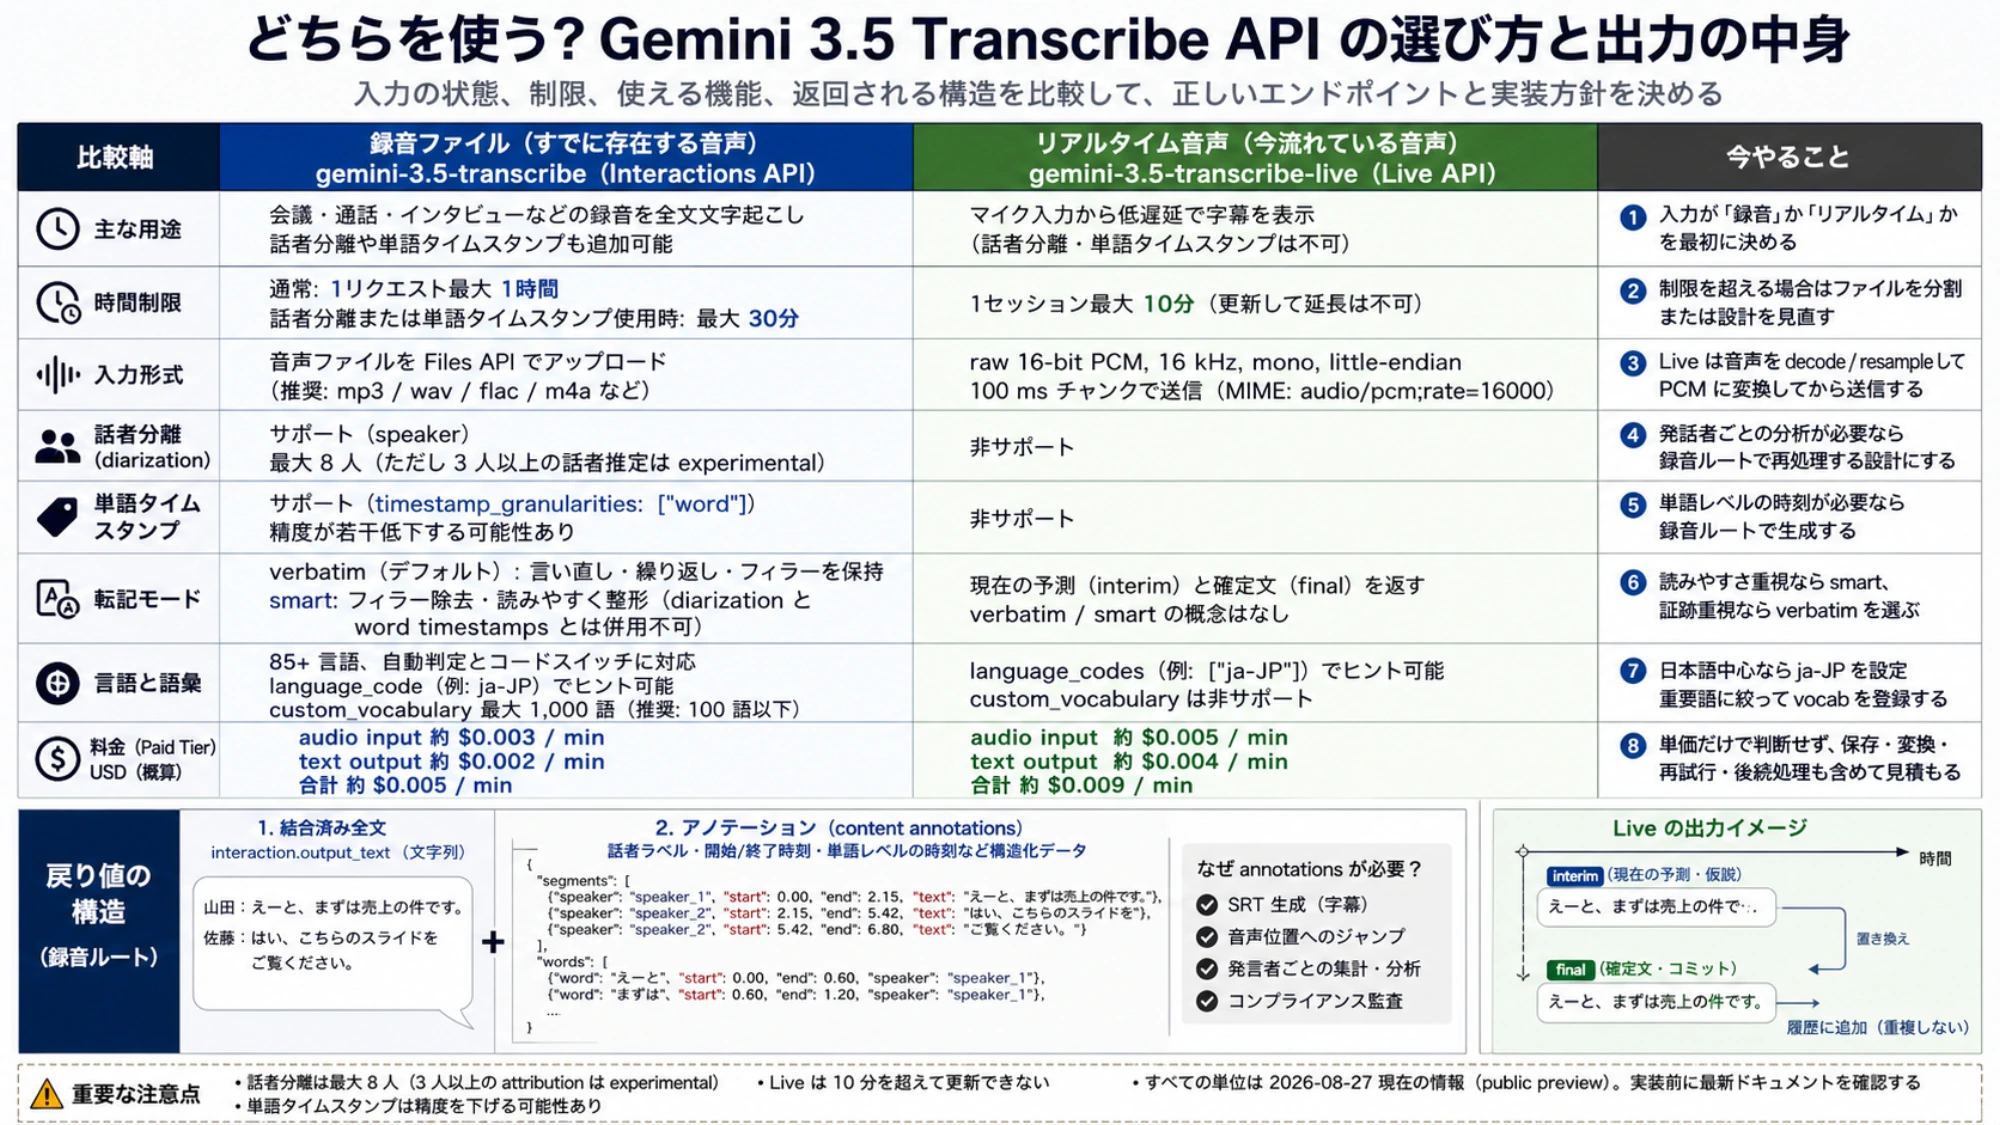
時間と機能の条件はモデル仕様、Live の入力形式と制限はLive 文字起こしガイドに基づきます。リアルタイム表示と話者付きの最終記録が両方必要なら、Live と録音後の再処理を分け、二回分の処理費用も見積もります。
これは音声からテキストを得る専用モデルです。一般の音声質問応答、音声を生成する TTS、話して返答する Live Agent、音声翻訳とは別です。要約や外部ツールの実行は文字起こし後の工程として設計してください。Transcribe 自体に関数呼び出しを任せる構成は、現在のモデル仕様に対応しません。
公開区分にも注意が必要です。2026年10月6日に確認した変更履歴は8月26日を一般提供開始と記載していますが、同日の発表記事には public preview の表記が残っています。この表記差から、特定のアカウントや地域で必ず利用できるとは判断できません。モデル ID は上表の Developer API 用の値を使い、接続先の権限と利用条件を確認します。
録音は最小 request の成功条件から確認する
録音の基本経路は「ローカル音声 → Files API の URI → Interactions API → テキストと注釈」です。通常の generateContent や、別サービスの音声エンドポイントにモデル名だけを入れ替える接続ではありません。REST の送信先は POST https://generativelanguage.googleapis.com/v1beta/interactions で、音声入力には type、uri、mime_type を指定します。公式の録音例もこの形です。
次の例を recorded.py として保存すると、用途を一つ選んで実行できます。対応する Google Gen AI SDK、サーバー側に設定済みの GEMINI_API_KEY、アップロードしてよい録音ファイルが前提です。SDK の準備用コマンドは python -m pip install -U google-genai です。本記事の検証ではこのインストールや接続を実行していません。
import json
import sys
from pathlib import Path
from google import genai


def recording_config(purpose):
    choices = {
        "plain": {"language_codes": ["ja-JP"]},
        "terms": {
            "language_codes": ["ja-JP"],
            "custom_vocabulary": ["BigQuery", "受注管理"],
        },
        "trace": {
            "language_codes": ["ja-JP"],
            "mode": {
                "type": "verbatim",
                "diarization_mode": "speaker",
                "timestamp_granularities": ["word"],
            },
        },
        "readable": {"language_codes": ["ja-JP"], "mode": "smart"},
    }
    if purpose not in choices:
        raise ValueError("plain / terms / trace / readable を指定してください")
    return {"transcription_config": choices[purpose]}


def main():
    if len(sys.argv) != 3:
        raise SystemExit("使い方: python recorded.py sample.mp3 trace")
    source = Path(sys.argv[1])
    if not source.is_file():
        raise FileNotFoundError(source)
    config = recording_config(sys.argv[2])
    client = genai.Client()
    uploaded = client.files.upload(file=str(source))
    result = client.interactions.create(
        model="gemini-3.5-transcribe",
        input=[{
            "type": "audio",
            "uri": uploaded.uri,
            "mime_type": uploaded.mime_type,
        }],
        generation_config=config,
    )
    # 注釈と状態も保持し、全文だけで成功判定しない。
    saved = result.model_dump(mode="json")
    Path("recorded-result.json").write_text(
        json.dumps(saved, ensure_ascii=False, indent=2), encoding="utf-8"
    )
    if saved.get("status") != "completed":
        raise RuntimeError(f"完了していません: {saved.get('status')}")
    text = result.output_text or ""
    Path("recorded-text.txt").write_text(text, encoding="utf-8")
    print(text if text else "完了しましたが全文は空です。元音声を確認してください。")


if __name__ == "__main__":
    main()
この例では返却された MIME type をそのまま渡します。MP3 や WAV など、録音モデルが対応する形式を使ってください。拡張子や MIME type の変更は音声の変換になりません。実行前に元音声の長さを確認し、trace は30分以内、それ以外も1時間以内に収めます。長い録音を分割する場合は、各ファイルが元音声の何秒目から始まるかも自分のシステムに保存します。
初回は短い非機密音声で plain を選び、アップロード、完了状態、空出力、内容の一致を確認します。無音なら空の文字起こしにも理由があります。一方、発話があるのに空なら、入力形式やサービスの返却内容を確認してから精度評価へ進みます。接続エラーの全文や鍵を公開ログに出さず、エラー種別、モデル、入力時間、返却状態を分けて記録すると切り分けやすくなります。
読みやすい文章と追跡可能な transcript は同じではない
録音の設定は、どの情報を優先するかで選びます。前のコードの terms と trace は、併用できない機能を分けた二つの有効な設定例です。
| 設定 | 用途 | 残す情報・注意点 |
|---|---|---|
terms | 製品名や業務用語を認識させる | custom_vocabulary を指定。話者分離・単語時刻は指定しない |
trace | 発言者と音声位置を追う | mode オブジェクトの type: "verbatim" に話者と単語時刻を指定。辞書は指定しない |
readable | 言いよどみを除いた読みやすい文章 | mode: "smart" という文字列。話者分離・単語時刻は併用不可 |
自作辞書は最大1,000語ですが、公式ガイドでは通常100語以下でよい結果を得やすいとされています。上限まで埋めるより、誤認識すると困る名称に絞るほうが評価しやすくなります。言語は省略または [] で自動判定になり、日本語中心なら対応表にある ja-JP を指定できます。辞書・言語・モードの仕様を確認してください。
verbatim は繰り返しや言い直し、言いよどみを残す逐語的な文字起こしです。smart はこれらを整理し、数字や箇条書きなどを読みやすく整えます。読みやすくなった文から、元の発言の言い直しまで復元できるとは限りません。また、逐語的な出力でも認識誤りはあり、人が確認した原記録とは区別する必要があります。
録音の mode を {"type": "smart"} に変えるのは、現在の文書の指定方法ではありません。録音の smart は小文字の文字列 "smart"、注釈付きの verbatim はオブジェクトです。Live では別の設定欄に大文字の "SMART" または "VERBATIM" を使います。
話者と単語時刻は JSON ごと保存する
output_text は結合済みの全文です。話者や単語時刻の保存先ではありません。実際の注釈は steps[].content[].annotations[] の type: "word_info" にあり、text、speaker、start_offset、end_offset を持ちます。時刻は "0.100s" のような Duration 文字列です。公式の出力構造を参照してください。
以下を word_rows.py に保存すると、前の例が保存した JSON から単語の一覧を取り出せます。欠けている話者や時刻を補わず、開始0秒も保持します。元の JSON は別途残します。
import json
import re
import sys
from decimal import Decimal
from pathlib import Path


def seconds(value):
    if value is None:
        return None
    if not isinstance(value, str) or not re.fullmatch(r"\d+(?:\.\d+)?s", value):
        raise ValueError(f"解釈できない時刻: {value!r}")
    return Decimal(value[:-1])


def word_rows(document):
    rows = []
    for step in document.get("steps") or []:
        for part in step.get("content") or []:
            for note in part.get("annotations") or []:
                if note.get("type") != "word_info":
                    continue
                start = seconds(note.get("start_offset"))
                end = seconds(note.get("end_offset"))
                if start is not None and end is not None and end < start:
                    raise ValueError("終了時刻が開始時刻より前です")
                rows.append({
                    "text": note.get("text"),
                    "speaker": note.get("speaker"),
                    "start_seconds": str(start) if start is not None else None,
                    "end_seconds": str(end) if end is not None else None,
                })
    return rows


if __name__ == "__main__":
    data = json.loads(Path(sys.argv[1]).read_text(encoding="utf-8"))
print(json.dumps(word_rows(data), ensure_ascii=False, indent=2))単語一覧が空なら「話者はいない」「精度が悪い」と即断せず、要求した設定と返却された注釈の有無を確認します。話者ラベルは人物の氏名ではありません。仕様上は最大8人に対応しますが、3人以上への話者割り当ては実験的で、単語時刻を有効にすると認識精度が下がる可能性もあります。話者分離と時刻の注意事項を踏まえ、実際の会話で確かめます。
この一覧から字幕を作る場合は、行の長さや表示時間で単語をまとめる処理が別途必要です。音声を分割したなら、注釈の相対時刻に各ファイルの開始位置を加えて元音声の時刻に戻します。重なった発話を、時刻が重複したという理由だけで削除しないでください。
Live 字幕では「現在の予測」と「確定文」を別に持つ
Live の暫定文 interim_input_transcription は現在表示中の字幕を置き換え、確定文 input_transcription は履歴へ追加します。一つの応答に両方がある場合も、どちらも処理します。server_content がない応答は字幕として扱いません。この区別はLive の暫定・確定テキストの説明に基づきます。
暫定文を届くたびに履歴へ追加すると、同じ発話の途中経過が残ります。一方、確定文を文字列だけで全体から重複排除すると、「はい」「はい」のような本当に繰り返された発言を失います。下の例では受信順の番号をアプリ側で付け、同じ文字列でも別の確定文として保存します。この番号はサーバーの発話 ID ではなく、再接続をまたいで重複がないことも保証しません。
WAV から PCM を取り出し、終了待ちに上限を設ける
Live の入力は16kHz・モノラル・符号付き16ビット・リトルエンディアンの raw PCM です。100ミリ秒なら1,600サンプル、3,200バイトになります。WAV はコンテナなので、そのファイル全体を PCM として送ってはいけません。WebM/Opus や電話音声もデコードとリサンプリングが必要です。音声送信の仕様を確認します。
次は対応形式の短い WAV を実時間のペースで送る、サーバー側の接続例です。マイクや変換処理を省略した代わりに、入力ファイルと検査を明示しています。live_wav.py として保存し、先ほどと同じ SDK・認証の前提で python live_wav.py sample-16k-mono.wav と実行します。音声はこの例では9分以内に制限します。9分は終了処理の余裕を持たせるためのアプリ側の設定で、公式の10分上限とは別です。
import asyncio
import json
import sys
import wave
from pathlib import Path
from google import genai
from google.genai import types


def read_pcm(path):
    with wave.open(str(path), "rb") as wav:
        if (wav.getnchannels(), wav.getsampwidth(), wav.getframerate(),
                wav.getcomptype()) != (1, 2, 16000, "NONE"):
            raise ValueError("16kHz / mono / 16-bit / 非圧縮 WAV が必要です")
        count = wav.getnframes()
        if not 0 < count <= 16000 * 540:
            raise ValueError("音声は0秒より長く9分以内にしてください")
        pcm = wav.readframes(count)
        if len(pcm) != count * 2:
            raise ValueError("WAV の音声データが不足しています")
        return pcm


def accept_caption(state, content):
    if content is None:
        return
    interim = getattr(content, "interim_input_transcription", None)
    final = getattr(content, "input_transcription", None)
    if interim is not None and interim.text is not None:
        state["preview"] = interim.text
    if final is not None and final.text:
        state["segments"].append({
            "local_sequence": len(state["segments"]) + 1,
            "text": final.text,
        })
        state["preview"] = ""


async def receive_captions(session, state):
    while True:
        received = False
        async for response in session.receive():
            received = True
            accept_caption(state, getattr(response, "server_content", None))
            print(json.dumps(state, ensure_ascii=False), flush=True)
        if not received:
            return "receive_ended"


async def exchange(pcm, state):
    client = genai.Client()
    config = types.LiveConnectConfig(
        response_modalities=["TEXT"],
        input_audio_transcription=types.AudioTranscriptionConfig(
            language_codes=["ja-JP"], mode="VERBATIM",
        ),
    )
    async with client.aio.live.connect(
        model="gemini-3.5-transcribe-live", config=config,
    ) as session:
        receiver = asyncio.create_task(receive_captions(session, state))
        try:
            for offset in range(0, len(pcm), 3200):
                if receiver.done():
                    receiver.result()  # 受信側の例外も呼び出し元へ渡す。
                    raise RuntimeError("送信終了前に受信が終わりました")
                chunk = pcm[offset:offset + 3200]
                await asyncio.wait_for(session.send_realtime_input(
                    audio=types.Blob(data=chunk, mime_type="audio/pcm;rate=16000")
                ), timeout=10)
                await asyncio.sleep(len(chunk) / 32000)
            await asyncio.wait_for(
                session.send_realtime_input(audio_stream_end=True), timeout=10
            )
            state["eof_sent"] = True
            try:
                state["stop_reason"] = await asyncio.wait_for(
                    asyncio.shield(receiver), timeout=8
                )
            except asyncio.TimeoutError:
                state["stop_reason"] = "drain_timeout"
        finally:
            receiver.cancel()
            await asyncio.gather(receiver, return_exceptions=True)


async def main():
    state = {"preview": "", "segments": [], "eof_sent": False,
             "stop_reason": "not_started", "all_final_received": None}
    try:
        pcm = read_pcm(Path(sys.argv[1]))
        await asyncio.wait_for(exchange(pcm, state), timeout=590)
    except Exception as exc:
        state["stop_reason"] = "error"
        state["error_type"] = type(exc).__name__
        raise
    finally:
        Path("live-result.json").write_text(
            json.dumps(state, ensure_ascii=False, indent=2), encoding="utf-8"
        )


if __name__ == "__main__":
    if len(sys.argv) != 2:
        raise SystemExit("使い方: python live_wav.py sample-16k-mono.wav")
    asyncio.run(main())
EOF では audio_stream_end=True を送り、最大8秒待って受信タスクを終了します。送信にも10秒、接続を含む処理全体にも590秒の上限を設けました。これらはアプリ側の待ち時間で、Google が8秒以内に必ず確定するという意味ではありません。drain_timeout、受信終了、例外のいずれでも、取得済みの確定文と残った暫定文を JSON に残します。待機を終えたことと、最後まで認識できたことは別です。 全確定文の到着を確認する共通の終端条件をこの例では置いていないため、all_final_received は null のままです。
この例は標準の自動 VAD を使います。Push-to-Talk にする場合は自動検出を無効にし、activity_start と activity_end で境界を制御する別の構成にします。音声を送った後に、複数の VAD 方式の信号を無計画に混ぜないでください。読みやすさを優先するときは Live 側の mode を "SMART" に変えますが、録音の小文字設定をそのまま移さないようにします。
10分を超える用途ではセッションを分け、どの音声を送信済みか、切断前にどの確定文を保存したかをアプリ側で管理します。切断時の再送は欠落を減らす一方、同じ音声を再認識すると重複し得ます。文字列の一致だけで判断する「自動復旧」や、一度だけ処理されるという保証はこの例にはありません。
ブラウザへ長期 API キーを渡さない
ブラウザやモバイルから直接 Live に接続する場合は、認証済みの利用者に対して信頼できるサーバーが制約付きの短期トークンを発行します。現在の短期トークンの公式ガイドでは Live API の v1beta のみが対象です。既定値の「1分」は新規セッションを開始する期限、「30分」は接続中の送受信の期限、uses: 1 は使用回数です。30分のトークンで Transcribe の10分上限が延びるわけではありません。
発行時には gemini-3.5-transcribe-live と TEXT など、利用させるモデルと設定を制約します。長期キーをブラウザの JavaScript や恒久的な接続 URL に埋め込まず、トークン自体も取り出せる認証情報として扱ってください。トークン発行と利用者認証は、上のサーバー側 WAV 例には含めていません。
料金表の一行だけで総コストを決めない
2026年10月6日に確認したGemini Developer API の料金表では、専用 Transcribe の有料料金は次のとおりです。録音時間そのものに固定単価を掛ける請求ではなく、音声入力・テキスト出力の実際のトークン数で計算します。
| 処理 | 音声入力100万トークン | テキスト出力100万トークン | 公式の丸めた1分概算 |
|---|---|---|---|
| 録音 | 2米ドル | 12米ドル | 入力約0.003米ドル+出力約0.002米ドル |
| Live | 3.50米ドル | 21米ドル | 入力約0.005米ドル+出力約0.004米ドル |
この料金表の概算は、入力25音声トークン/秒、出力175テキストトークン/分という仮定です。汎用音声モデルのトークン換算を、この専用モデルに流用しないでください。仮定を丸めずに計算すると次になります。
録音1分 = (25 × 60 × 2 + 175 × 12) / 1,000,000
         = 0.0051米ドル
Live 1分 = (25 × 60 × 3.50 + 175 × 21) / 1,000,000
         = 0.008925米ドル
100時間 = 6,000分 → 録音30.60米ドル / Live 53.55米ドル
公式の丸めた分単価からは約30米ドル・約54米ドルとなりますが、上記は同じ仮定を途中で丸めず計算した予算例です。実際の請求書ではありません。実使用量から確認するときは「音声入力トークン数 × 入力単価 ÷ 100万 + テキスト出力トークン数 × 出力単価 ÷ 100万」で計算します。音声の保存・変換、再送、録音後の再処理、要約、人手での修正、税や為替は別途見積もります。Transcribe のモデル仕様では Batch も非対応なので、Batch 割引を前提に予算を作らないようにします。
無料枠と音声の取り扱いを分けて確認する
料金表には無料枠の入出力が無料と表示されていますが、各アカウントの利用資格や上限、機密音声の送信可否まで保証するものではありません。利用規約では通常の無償サービスについて、入力と出力を製品改善や人による確認に利用し得ると説明し、機密・個人・センシティブな情報を送らないよう求めています。
有効な Cloud Billing に紐づく API プロジェクトなど、有償サービスに該当する場合は入力・出力を製品改善に使わない条件が適用されます。ただし、不正利用対策などの限定的なログ処理は残ります。また EEA・スイス・英国には、無償分を含め有償サービスのデータ利用条件が適用される例外や、その地域の利用者向け API クライアントに有償サービスを求める条件があります。日本語を使うことだけで地域や適用条件は決まりません。
会議や顧客通話を送る前に、参加者への説明、組織のルール、利用するプロジェクトの条件、保存先と削除方針を確認してください。医療や契約の記録に利用できるという許可を、認識精度や料金表から導くことはできません。
Files APIのファイルは最大2GB、プロジェクト全体で20GBまでで、48時間後に自動削除されます。これはアップロードした File の寿命です。文字起こし結果、Interactions の記録、提供者のログがすべて48時間で消えるという条件ではありません。アップロードしたファイルは API からダウンロードできないため、必要な原音声は自分の保存方針に従って管理します。Files API 自体の無料という説明も、文字起こし推論の無料を意味しません。
日本語の合否は日本語の失敗コストで決める
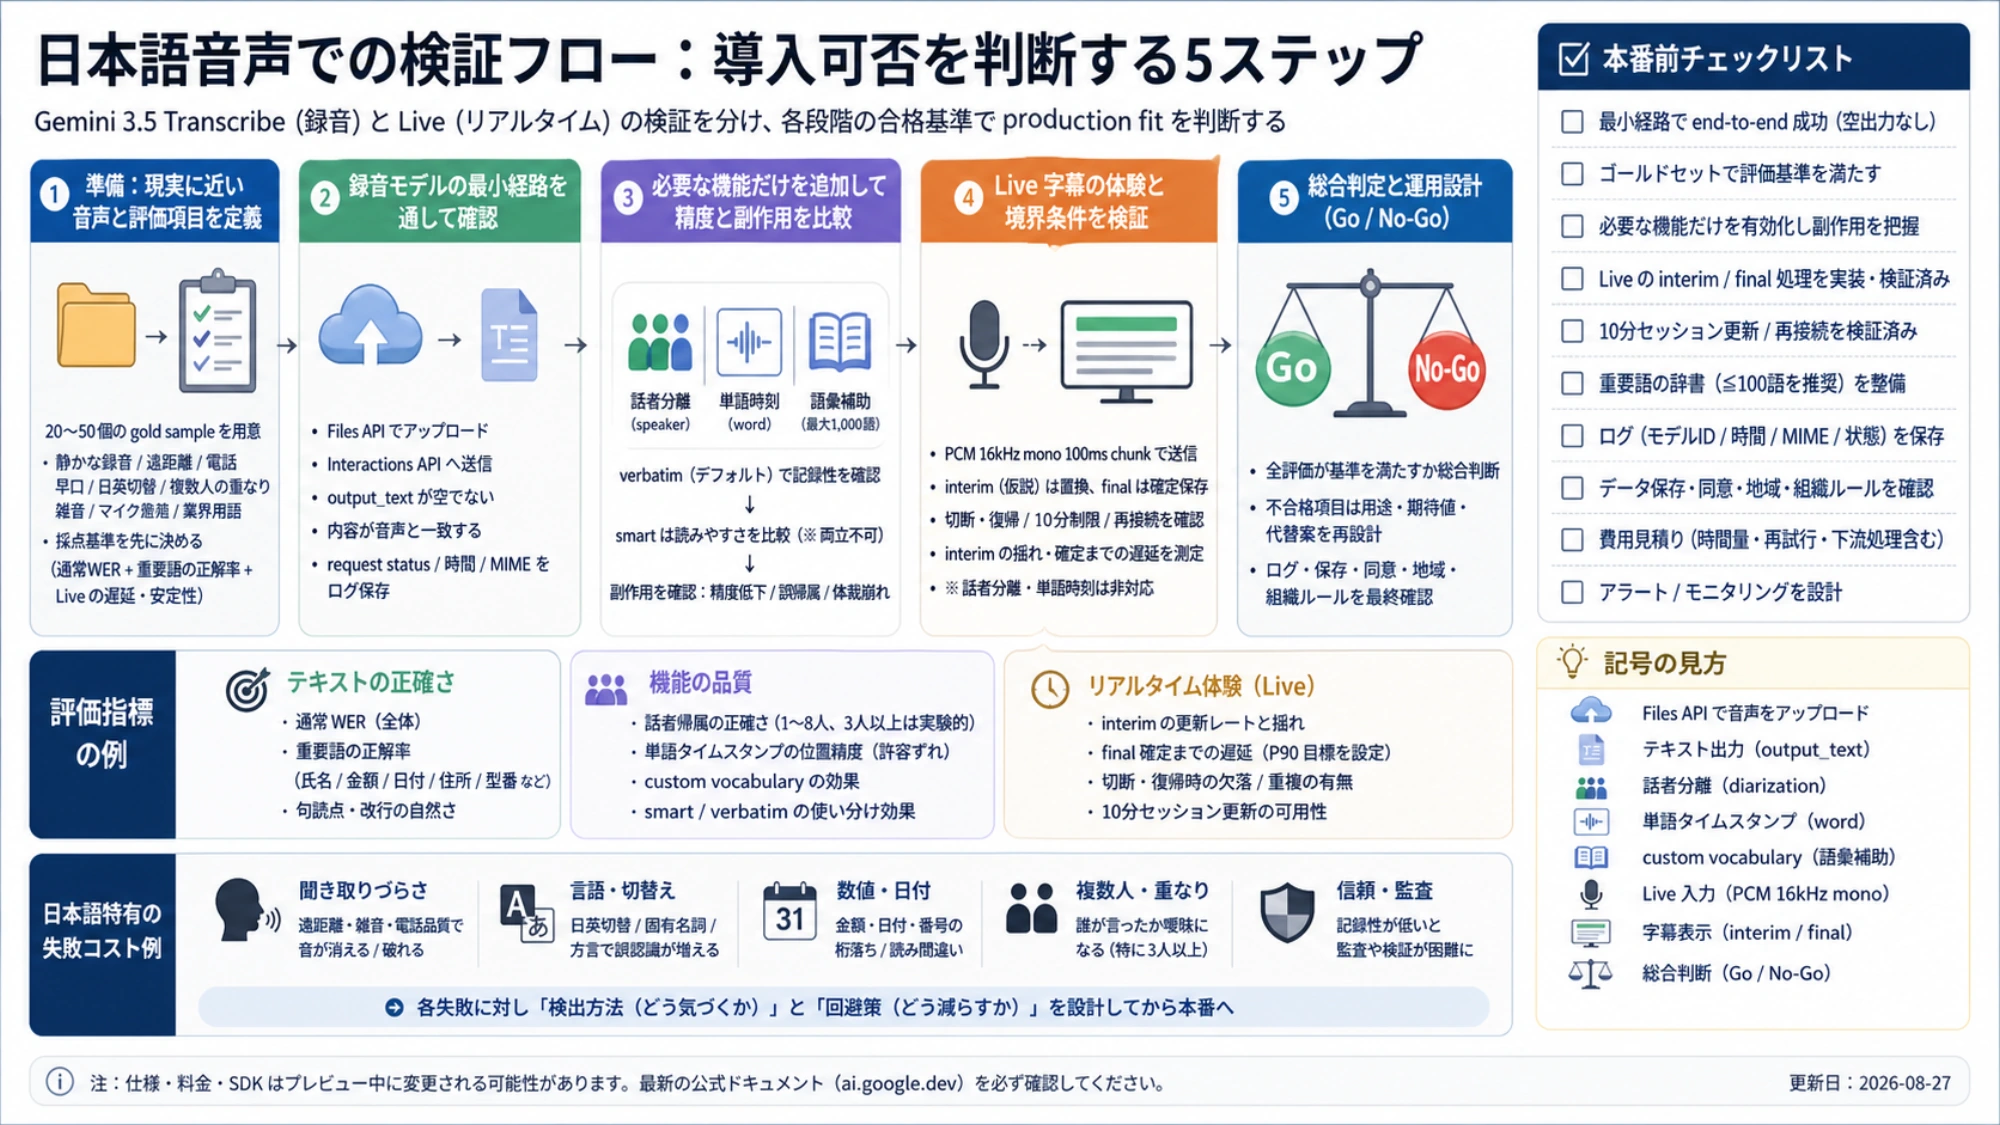
本記事のローカル確認では、録音の四つの設定、開始0秒や話者欠落を含む注釈の読み取り、暫定字幕の置換と同じ確定文の繰り返し、合成 WAV の形式・バイト数検査、料金の小数計算を扱いました。実装のこうした確認と、モデルが日本語を正しく聞き取るかという評価は分けます。
日本語の評価では、実際の用途に近い音声を、人が原音声を聞いて確認した正解文と比較します。静かな発話だけでなく、電話音声、早口、日英の切り替え、固有名詞、発話の重なりなど、損失が大きい条件を含めます。人名、金額、日付、型番は、全体の文字誤り率とは別に確認すると判断しやすくなります。注釈付き録音なら話者の取り違えと時刻、Live なら暫定文の修正、確定までの時間、切断時の欠落・重複、EOF 後の末尾を確認します。
評価条件を変えるときは、同じ音声で plain、必要な辞書、必要な注釈を比較します。自作辞書と注釈を同時に使えないので、それぞれがどの誤りを減らすかを別々に確認できます。数値が読みやすい smart 出力も、元発言から意味が変わっていないか確認してください。人による確認が必要な記録では、モデルの「確定」を確認済みの事実として扱わないことが大切です。
よくある質問
Gemini 3.5 Transcribe は日本語に対応していますか?
現在の対応言語一覧に ja-JP があり、日本語に対応しています。言語の省略または空配列で自動判定もできます。対応していることと、特定の方言・業務用語・雑音下で必要な精度を満たすことは別なので、実際に使う音声で評価します。
固有名詞を指定しながら話者分離もできますか?
現在の録音 API ではできません。custom_vocabulary と話者分離または単語時刻を同じリクエストに入れると拒否されます。公式の併用制限に沿って、辞書付きの全文か、辞書を外した注釈付き録音を選びます。二つの結果を使う場合も、単語が一対一で対応すると決めつけず、人の確認や照合処理を挟みます。
Live で話者名や単語ごとの字幕時刻も返りますか?
Live 文字起こしの制限では、話者分離と単語タイムスタンプは非対応です。必要なら音声を保存して録音モデルで後処理します。アプリが記録した受信時刻を、モデルの単語時刻として表示してはいけません。
文字起こしが途中で終わったらどうすればよいですか?
まず、音声を送り終えたか、EOF を送ったか、接続が切れたか、アプリの待機上限に達したかを分けます。取得済みの確定文と暫定文を保管し、最終部分を原音声と照合します。再送する場合は再送範囲を記録し、重複が入り得ることを明示します。10分を超える Live セッションを、短期トークンの有効期限だけで延長できるとは考えないでください。
参考資料9
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月7日。
参考資料9
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月7日。
- 1.公式文字起こしガイドai.google.dev/gemini-api/docs/transcribe
- 2.モデル仕様ai.google.dev/gemini-api/docs/models/gemini-3.5-transcribe
- 3.Live 文字起こしガイドai.google.dev/gemini-api/docs/live-api/live-transcribe
- 4.変更履歴ai.google.dev/gemini-api/docs/changelog
- 5.発表記事blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-5-transcribe
- 6.短期トークンの公式ガイドai.google.dev/gemini-api/docs/live-api/ephemeral-tokens
- 7.Gemini Developer API の料金表ai.google.dev/gemini-api/docs/pricing
- 8.利用規約ai.google.dev/gemini-api/terms
- 9.Files APIai.google.dev/gemini-api/docs/files