Precio de la API de DeepSeek en hora punta y valle desde España
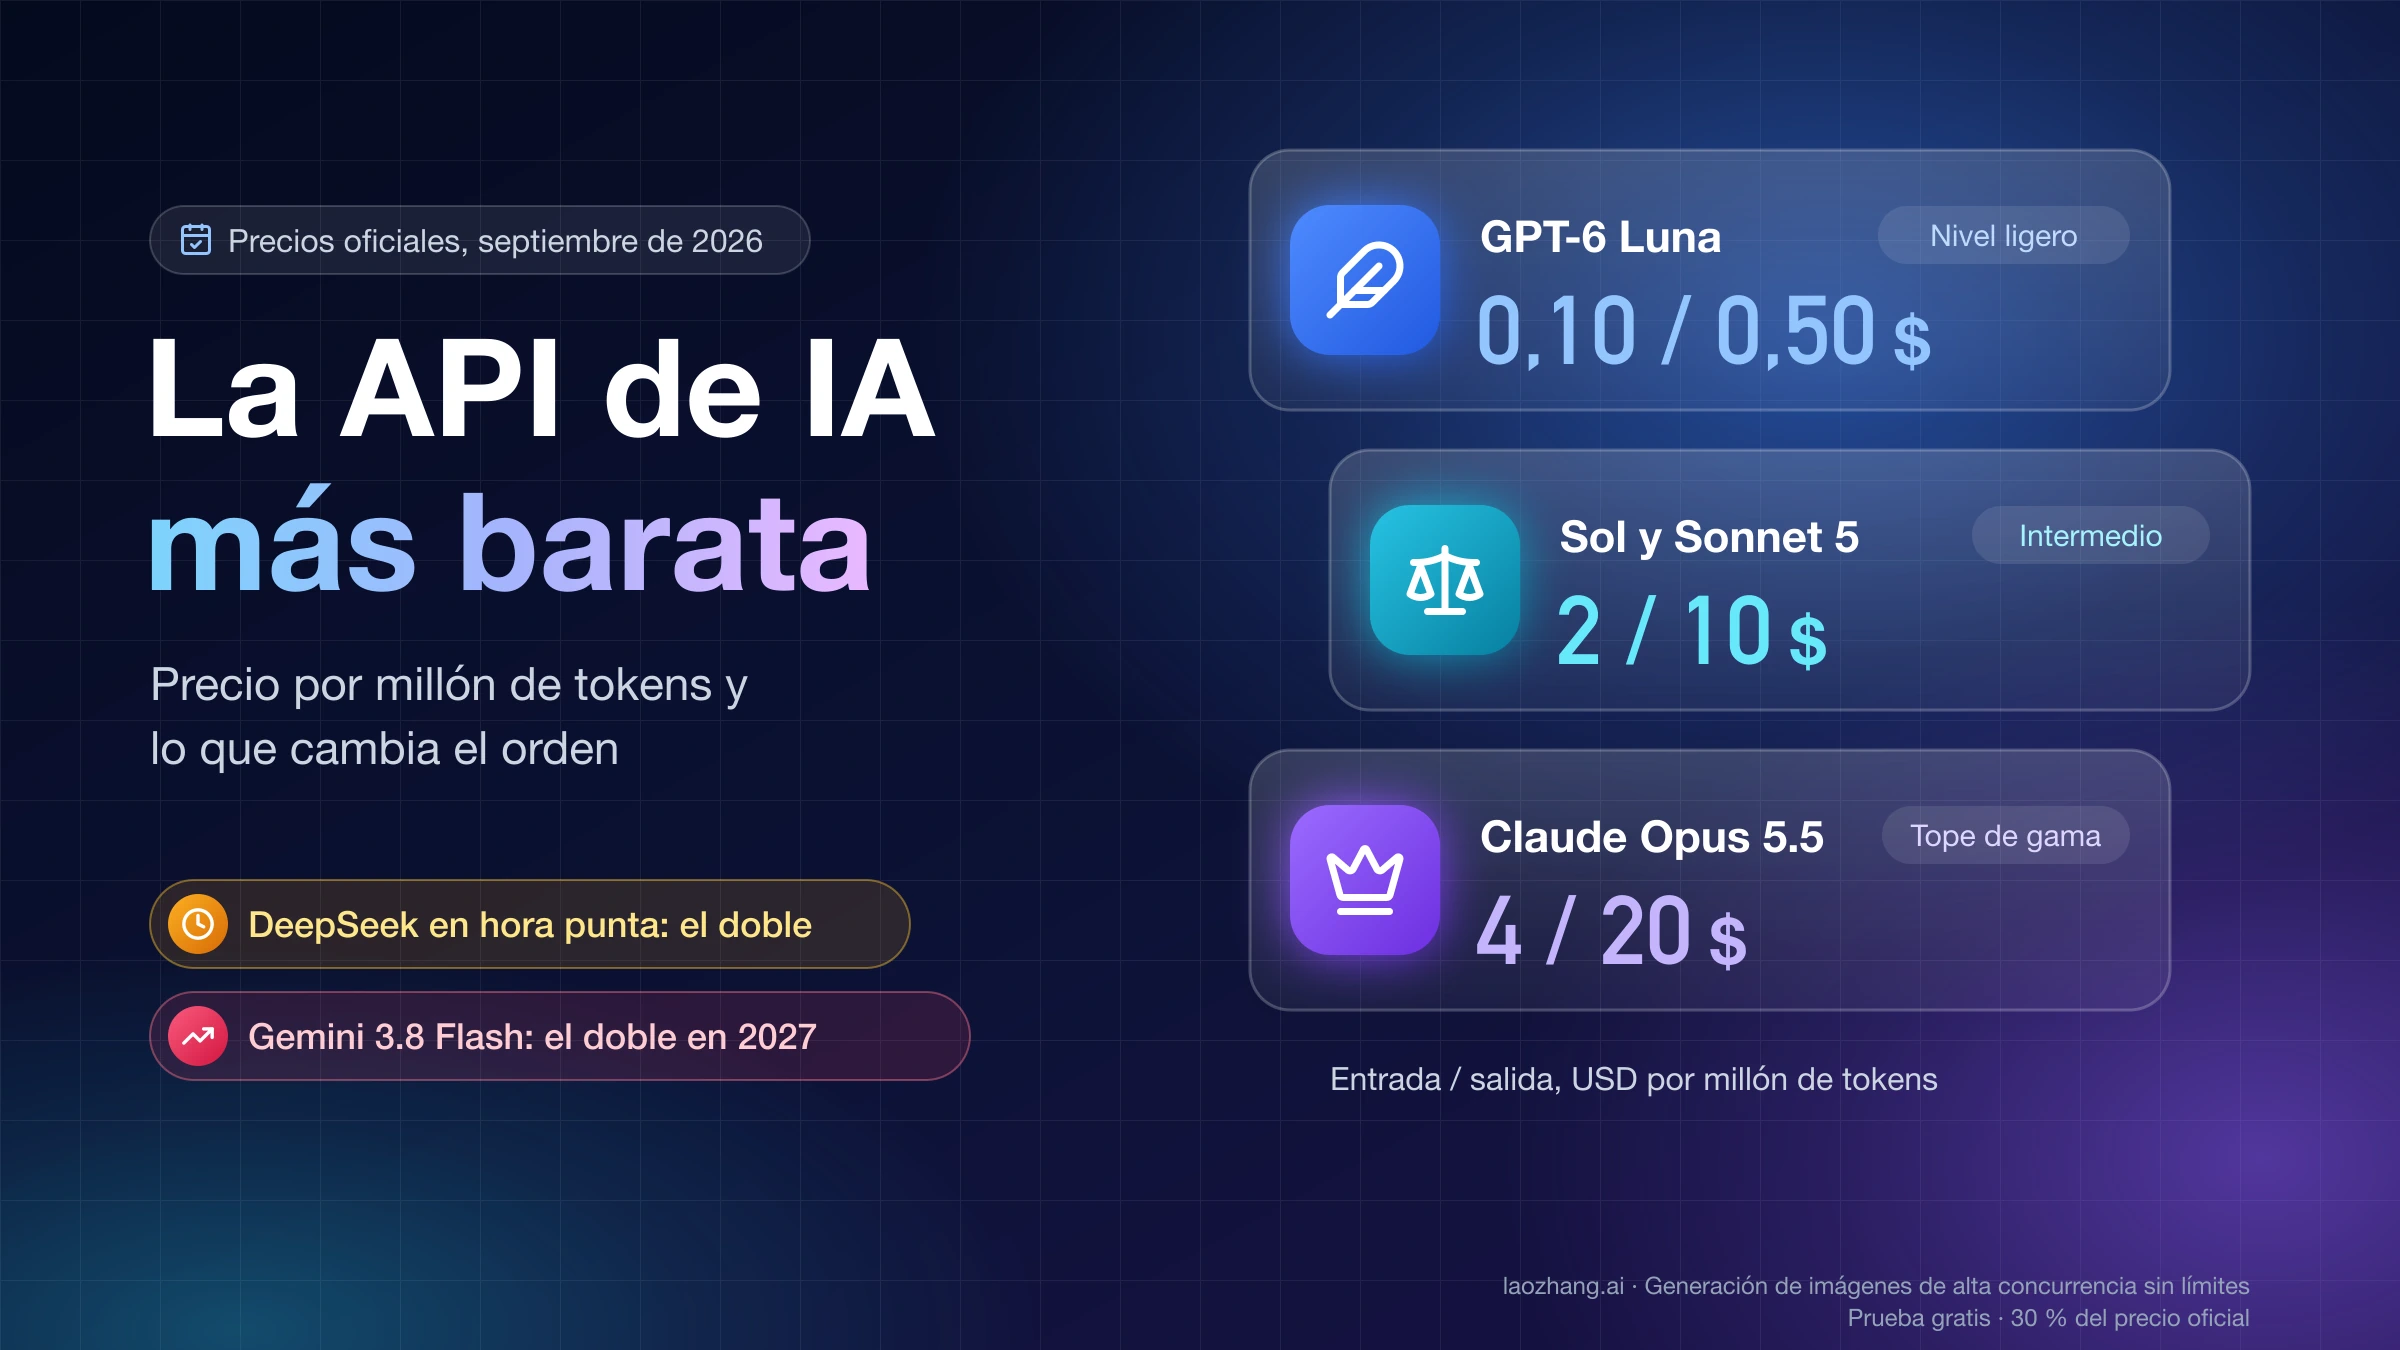
V4.1 Flash cobra 0,15 $ por millón de tokens sin caché en valle y el doble en punta: laborables de 03:00 a 06:00 y de 08:00 a 12:00 en hora de verano española.
En esta página
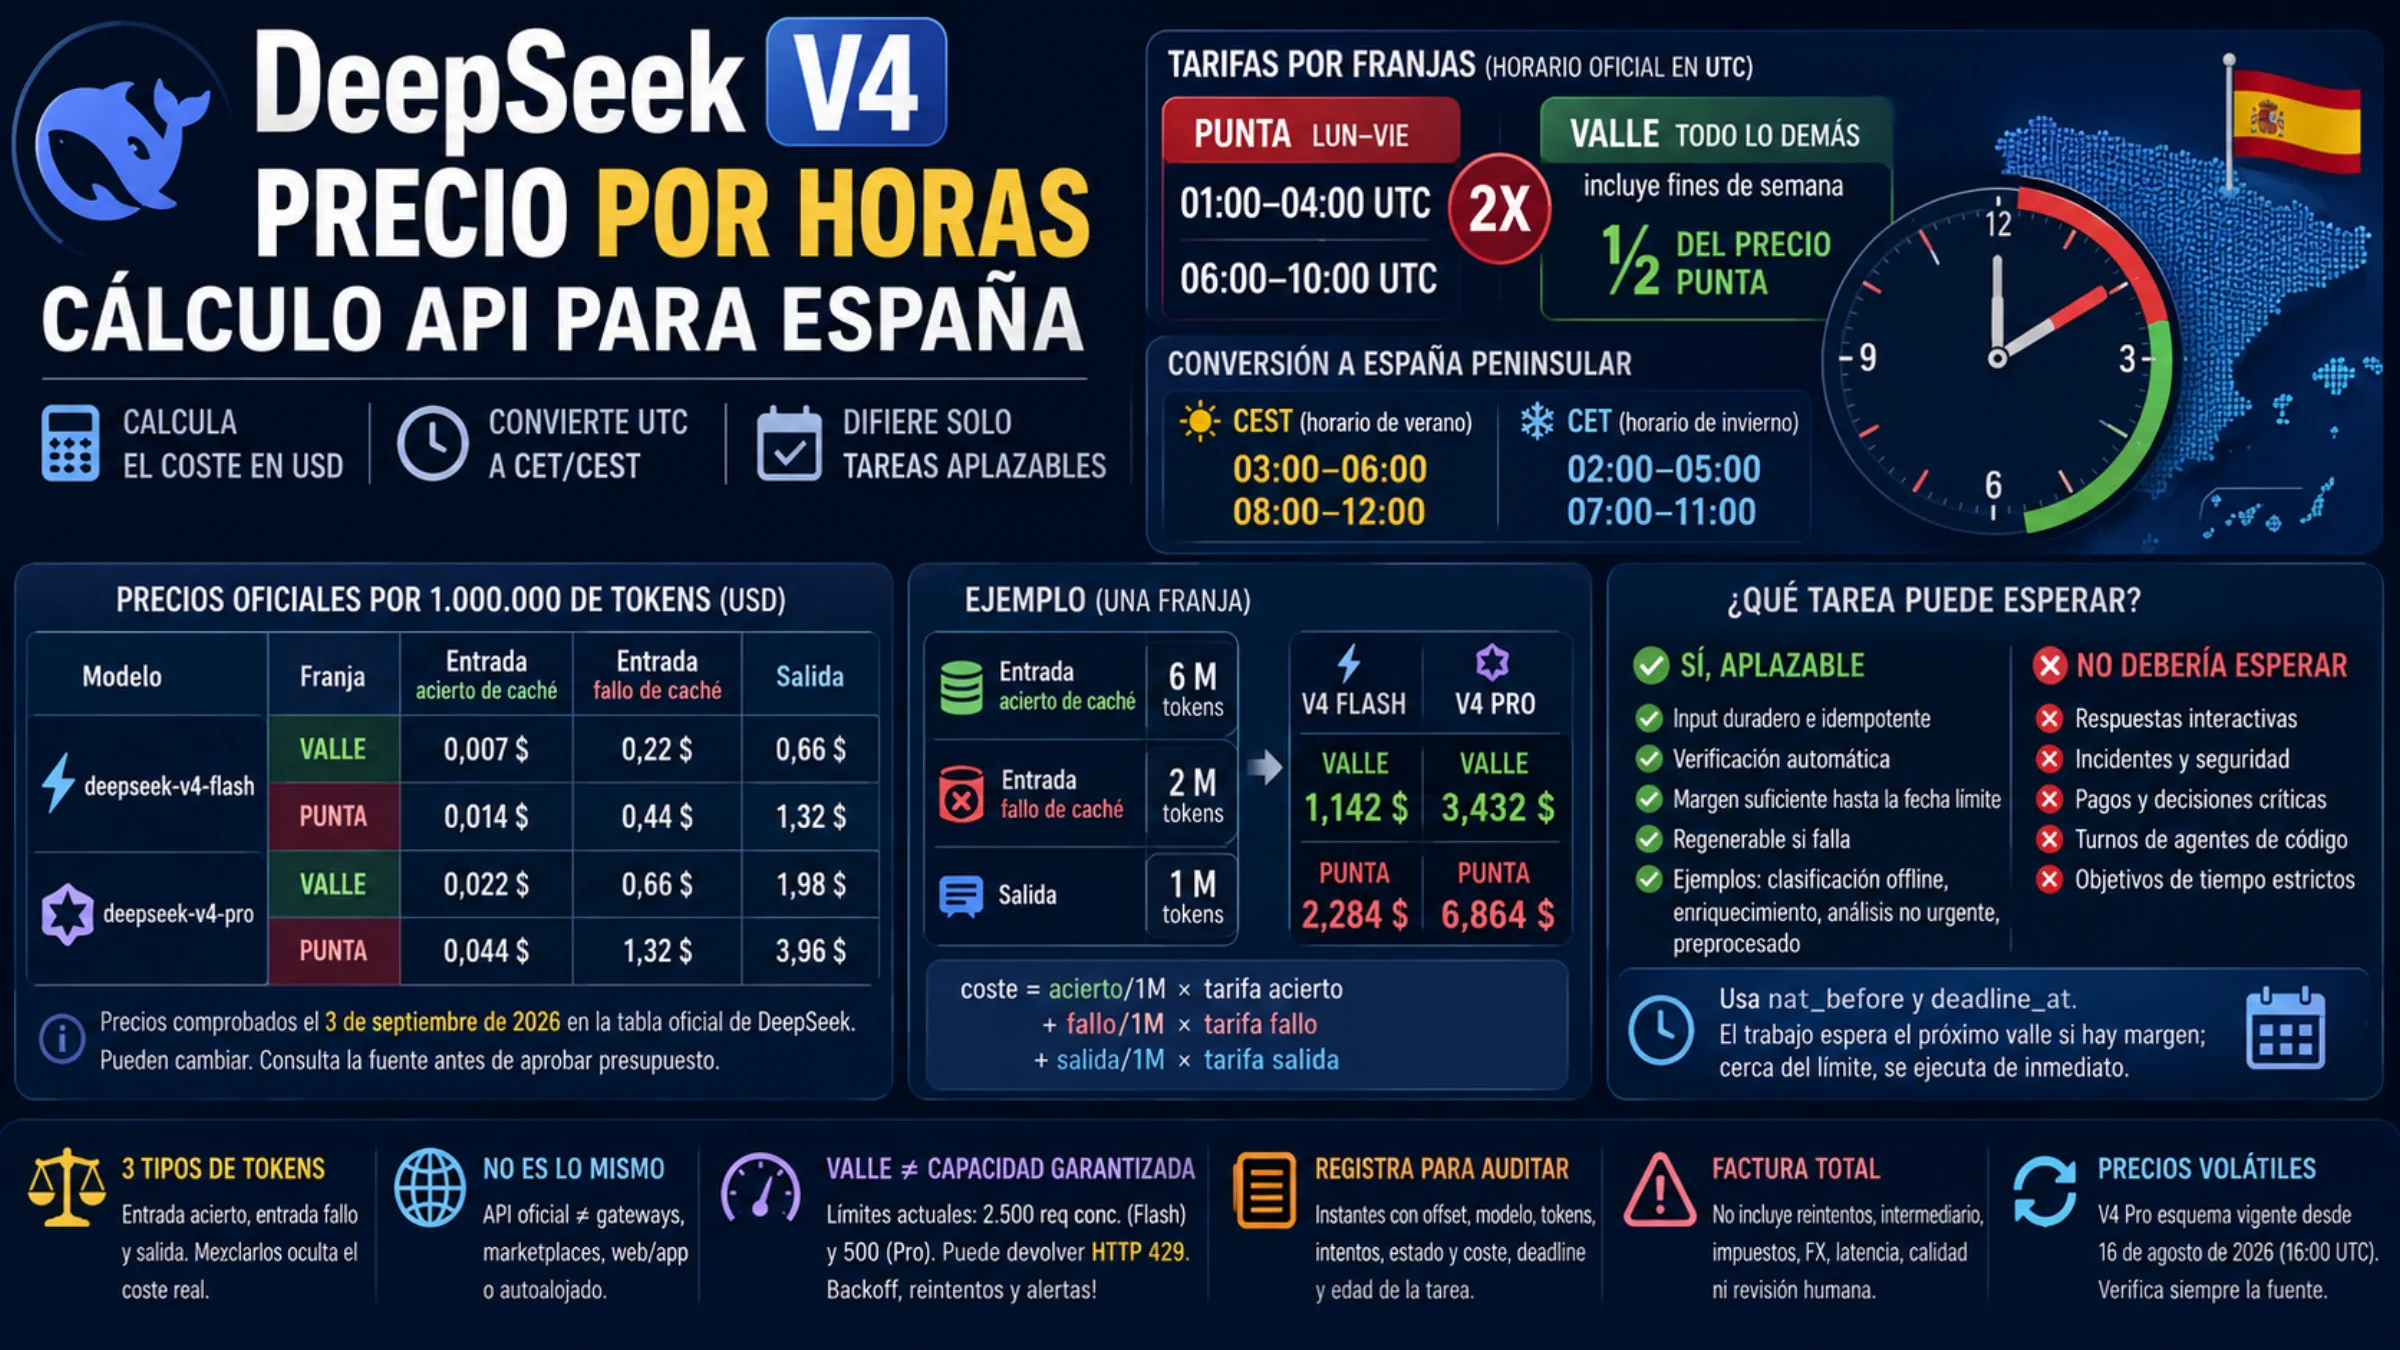
A 26 de septiembre de 2026, la API de DeepSeek cobra el doble en dos franjas de los días laborables: 01:00–04:00 y 06:00–10:00 UTC. En la España peninsular eso equivale a 03:00–06:00 y 08:00–12:00 mientras dure el horario de verano (hasta el 25 de octubre) y a 02:00–05:00 y 07:00–11:00 en horario de invierno. Los sábados, los domingos y los festivos oficiales de China son valle de principio a fin.
Las tarifas también han cambiado. El 10 de septiembre DeepSeek sustituyó V4 Flash por V4.1 Flash (deepseek-flash) y bajó su precio: la entrada sin caché pasa de 0,22 $ a 0,15 $ por millón de tokens en valle y la salida de 0,66 $ a 0,60 $. V4 Pro mantiene su tarifa. Si tu código sigue llamando a deepseek-v4-flash, ya se factura con el precio nuevo, porque ese nombre ahora apunta a V4.1 Flash.
Tarifas vigentes de deepseek-flash y deepseek-v4-pro
Precios en USD por millón de tokens de la API oficial, según la tabla de modelos y precios de DeepSeek a 26 de septiembre de 2026:
| Modelo (nombre en la API) | Franja | Entrada con acierto de caché | Entrada con fallo de caché | Salida |
|---|---|---|---|---|
V4.1 Flash (deepseek-flash) | valle | 0,003 $ | 0,15 $ | 0,60 $ |
V4.1 Flash (deepseek-flash) | punta | 0,006 $ | 0,30 $ | 1,20 $ |
V4 Pro (deepseek-v4-pro) | valle | 0,022 $ | 0,66 $ | 1,98 $ |
V4 Pro (deepseek-v4-pro) | punta | 0,044 $ | 1,32 $ | 3,96 $ |
La factura distingue tres consumos: la entrada que acierta en caché (el prefijo ya procesado en una llamada anterior), la entrada que no acierta y la salida. Con un precio medio de entrada se pierde justo la diferencia que más pesa: en Flash, un token de entrada sin caché cuesta 50 veces más que uno con acierto.
Frente a las filas de V4 Flash que regían hasta el 10 de septiembre (0,007 $, 0,22 $ y 0,66 $ en valle), el acierto de caché baja un 57 %, el fallo de caché un 32 % y la salida un 9 %. Si una tabla todavía muestra 0,22 $ / 0,44 $ para Flash, está describiendo un modelo retirado.
Los dos modelos comparten contexto de 1M de tokens, salida máxima de 384K, modos con y sin razonamiento, salida JSON, llamadas a herramientas y formatos compatibles con OpenAI (https://api.deepseek.com) y Anthropic (https://api.deepseek.com/anthropic). Hay dos diferencias que afectan a la elección: solo Flash acepta imágenes y el límite de concurrencia es de 2.500 solicitudes para Flash frente a 500 para Pro.
El cobro se descuenta del saldo recargado o del saldo concedido, y se consume primero el concedido. Estas cifras no sirven para un revendedor, un marketplace cloud o un despliegue propio de los pesos abiertos: cada uno aplica su propia tarifa, margen o unidad de cobro. Si buscas esa comparación, está en Proveedor de API LLM más barato: dónde comprar el mismo modelo.
Tres cambios en menos de un mes
Entre el 16 de agosto y el 10 de septiembre, la tarifa cambió tres veces. Una tabla de precios fechada en ese intervalo puede reflejar cualquiera de estas etapas:
| Fecha | Cambio | Fuente |
|---|---|---|
| 16 de agosto de 2026, 16:00 UTC | Entra en vigor la tarifa por franjas: valle a mitad de precio que punta | Registro de cambios del 13 de agosto |
| 23 de agosto de 2026, 00:00 hora de Pekín | Los fines de semana pasan a ser valle todo el día | Prensa (Bloomberg y El Economista); la regla figura hoy en la tabla oficial, pero el registro de cambios no recoge la fecha |
| 10 de septiembre de 2026 | Llega V4.1 Flash como deepseek-flash, se retiran V4 Flash y V4 Flash Vision Exp y baja el precio de Flash | Registro de cambios del 10 de septiembre |
En el mismo anuncio del 10 de septiembre, DeepSeek confirma que V4 Pro seguirá disponible después del 14 de septiembre «con el mismo método de facturación». Los nombres antiguos deepseek-v4-flash y deepseek-v4-flash-vision-exp siguen funcionando, pero la propia nota dice que el desvío hacia V4.1 Flash es «temporal». Conviene cambiar ya el nombre del modelo a deepseek-flash en la configuración, en lugar de esperar a que el alias deje de responder.
Horas punta en hora peninsular
DeepSeek define las franjas en UTC y excluye de la punta los fines de semana y los festivos oficiales de China. Traducido al reloj peninsular, de lunes a viernes:
| Periodo | Primera franja punta | Segunda franja punta | Valle continuo |
|---|---|---|---|
| Horario de verano (CEST, UTC+2), hasta el 25 de octubre de 2026 | 03:00–06:00 | 08:00–12:00 | 12:00 a 03:00 del día siguiente |
| Horario de invierno (CET, UTC+1), desde el 25 de octubre de 2026 | 02:00–05:00 | 07:00–11:00 | 11:00 a 02:00 del día siguiente |
En Canarias hay que restar una hora a todas las horas de la tabla. La consecuencia práctica para un equipo en España es que la mañana laboral cae casi entera en punta, mientras que la tarde, la noche y el fin de semana son valle. Desde el mediodía del viernes (hora de verano) hasta las 03:00 del lunes no hay ninguna franja cara.
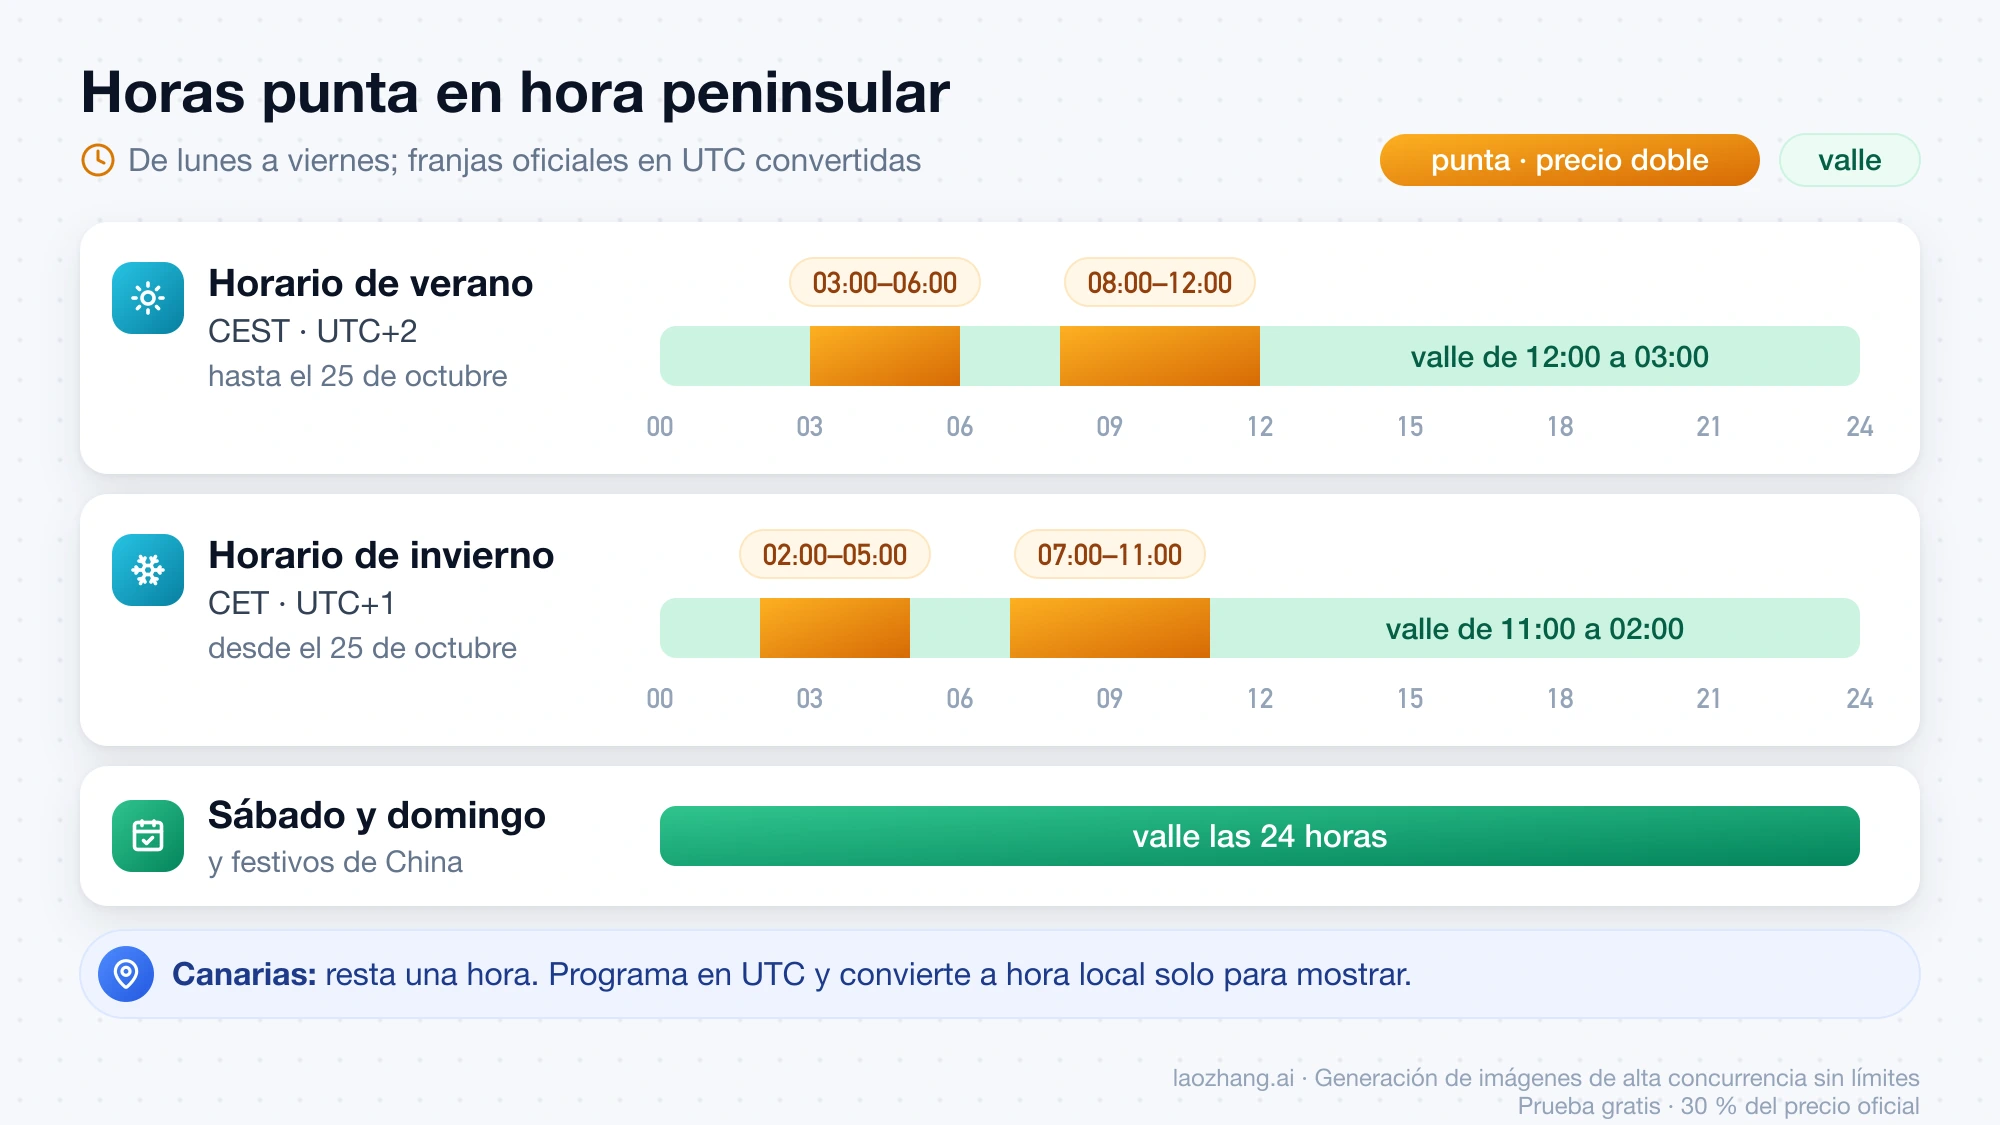
El cambio de hora del 25 de octubre cae en domingo, así que no parte ninguna franja, pero desplaza una hora todas las del lunes siguiente. Por eso el programador de tareas debe decidir con el instante en UTC y convertir a hora local solo para mostrarlo. Una prueba de calendario razonable incluye una fecha en CEST, otra en CET, el lunes posterior al cambio y el paso del viernes al sábado.
Los festivos chinos cuentan como valle el día completo. Sus fechas cambian cada año, así que tómalas del calendario oficial que publica el Gobierno chino y no de una lista fija en el código. La página de precios no aclara cómo se tratan los fines de semana que China declara laborables para compensar un puente; si tu ahorro depende de esas fechas, compara el consumo con la factura de ese día.
Cuánto cuesta un lote con caché
Para cada franja, la cuenta es:
coste = tokens con acierto de caché / 1.000.000 × tarifa de acierto
      + tokens con fallo de caché / 1.000.000 × tarifa de fallo
      + tokens de salida / 1.000.000 × tarifa de salida
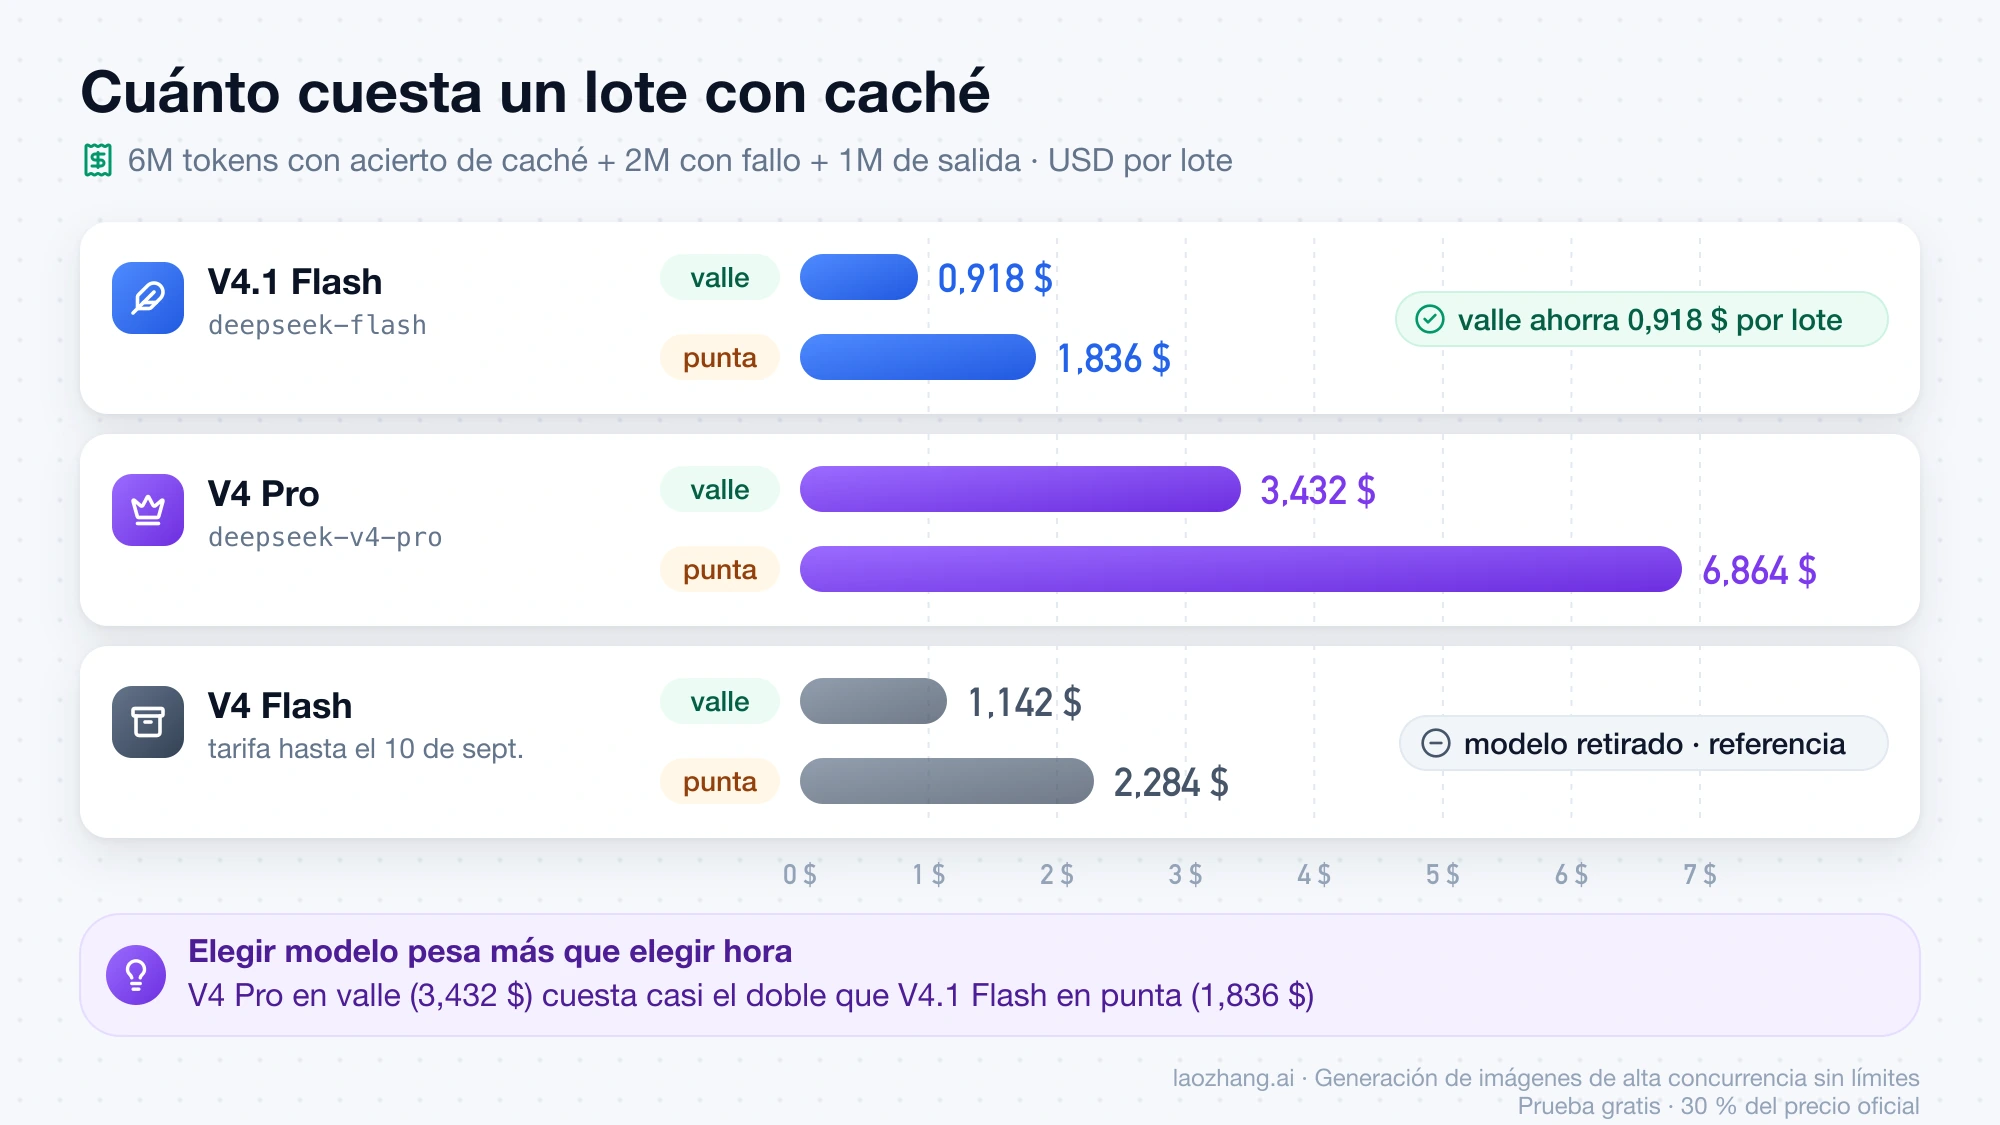
Ejemplo: un lote con 8 millones de tokens de entrada, de los que 6 millones aciertan en caché y 2 millones no, y 1 millón de tokens de salida. Son supuestos; no incluyen reintentos ni llamadas a herramientas.
| Modelo | Valle | Punta |
|---|---|---|
| V4.1 Flash | 6 × 0,003 + 2 × 0,15 + 1 × 0,60 = 0,918 $ | 1,836 $ |
| V4 Flash (tarifa anterior al 10 de septiembre) | 6 × 0,007 + 2 × 0,22 + 1 × 0,66 = 1,142 $ | 2,284 $ |
| V4 Pro | 6 × 0,022 + 2 × 0,66 + 1 × 1,98 = 3,432 $ | 6,864 $ |
Tres conclusiones salen de esa tabla:
- Mover el lote a valle ahorra la mitad del cargo por tokens. Con Flash son 0,918 $ por lote; si ejecutas cien lotes así al mes, la diferencia es de 91,80 $.
- Elegir modelo pesa más que elegir hora. V4 Pro en valle (3,432 $) sigue costando casi el doble que Flash en punta (1,836 $). Con la bajada de Flash, este lote en Pro ha pasado de costar 3,0 veces lo que cuesta en Flash a costar 3,74 veces. Pro solo compensa si en tu trabajo real reduce reintentos, revisión o tareas rechazadas en esa proporción.
- La caché es una palanca aparte. Cada millón de tokens que pasa de fallo a acierto ahorra 0,147 $ en Flash valle. Se combina con el cambio de franja, pero no es la misma mejora.
La cuenta tampoco recoge el coste de esperar. Si aplazar el lote hace que llegue tarde a una entrega y alguien tiene que repetirlo o revisarlo a mano, la factura total sube aunque la línea de la API baje. Para comparar DeepSeek con otros modelos con el mismo tipo de cálculo, consulta la comparativa de precios de API de IA: qué modelo sale más barato.
Qué trabajos pueden esperar a la franja valle
Un trabajo es buen candidato si cumple cinco condiciones: su entrada no caduca, se puede ejecutar dos veces sin efectos duplicados, el resultado se verifica de forma automática, tiene margen de sobra hasta su fecha límite y existe un plan si falla el último reintento. Clasificación offline, evaluaciones, enriquecimiento de índices, análisis de repositorios sin urgencia y preprocesado que se puede regenerar suelen cumplirlo.
No deberían esperar por precio las respuestas a un usuario, el diagnóstico de incidentes, las decisiones de pago o seguridad, los turnos de un agente de programación ni cualquier automatización con un plazo estricto.
Para los casos intermedios, asigna a cada tarea dos campos, not_before y deadline_at. La tarea espera a la siguiente franja valle mientras le quede margen y pasa a ejecución inmediata cuando se acerca el límite. Así el precio entra en la decisión sin mandar sobre la experiencia del usuario. Con la franja actual, una tarea encolada a las 08:30 de un martes de octubre en hora de verano espera como máximo hasta las 12:00.
Para poder auditar después el ahorro, registra por tarea:
- hora de entrada en cola, de envío y de finalización, con su desfase horario;
- nombre exacto del modelo enviado (
deepseek-flashodeepseek-v4-pro); - tokens con acierto, con fallo y de salida;
- número de intento, estado final y coste calculado;
- fecha límite y antigüedad de la tarea.
Con solo la bajada total del saldo no puedes separar qué parte se debe a la franja, a la caché, a una salida más larga o a una ejecución duplicada.
La franja valle no garantiza capacidad
La documentación de límites fija 2.500 solicitudes simultáneas para deepseek-flash y 500 para deepseek-v4-pro. Si las superas, la API responde con HTTP 429. Puedes pedir una ampliación sin coste adicional, pero ninguna cifra pública promete latencia ni disponibilidad en una franja concreta. Si mucha gente traslada su carga a la misma hora valle, lo notarás en la cola, no en la tarifa.
Mantén backoff exponencial, un máximo de reintentos, una alerta por antigüedad de la cola y una cola de fallos definitivos. Empieza con una muestra pequeña durante una semana completa, fines de semana incluidos, y compara tasa de aceptación, latencia p95, reintentos, longitud de la salida y minutos de revisión. Amplía solo si baja el coste por tarea aceptada, no únicamente el precio por millón de tokens.
Preguntas frecuentes
¿Es gratuita la API de DeepSeek?
No tiene un nivel gratuito publicado en la tabla de precios. Cada llamada se descuenta del saldo: primero del saldo concedido, si tienes alguno, y después del que hayas recargado. Si lo que buscas es empezar sin pagar, compara opciones en Mejores API de IA gratis: cuál elegir y cuándo empezar a pagar.
¿Sigue funcionando el modelo deepseek-v4-flash?
Sí, pero el modelo original está retirado. Las peticiones con deepseek-v4-flash las atiende V4.1 Flash y se cobran a la tarifa de deepseek-flash. DeepSeek describe ese desvío como temporal, así que cambia el nombre en tu configuración.
¿Los fines de semana hay hora punta?
No. Sábados y domingos son valle las 24 horas, igual que los festivos oficiales de China. Según la prensa, la regla del fin de semana se aplica desde el 23 de agosto de 2026; antes, las franjas punta también regían en sábado y domingo.
¿Cuánto cuesta DeepSeek frente a Claude u OpenAI?
Depende del nivel de modelo con el que lo compares, y el reparto entre entrada y salida cambia el resultado. Para los precios de esos dos proveedores, consulta Precio de la API de Claude vs OpenAI: qué nivel sale más barato y aplica la misma fórmula de esta página con tus tokens reales.
Fuentes3
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 26 sept 2026.
Fuentes3
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 26 sept 2026.