Gemini 3.8 Flash va lento en Antigravity: qué está esperando
Si Antigravity se queda en «Working…» con Gemini 3.8 Flash, mira qué muestra: razonamiento largo, reintentos por capacidad, una aprobación pendiente o un bucle.
En esta página
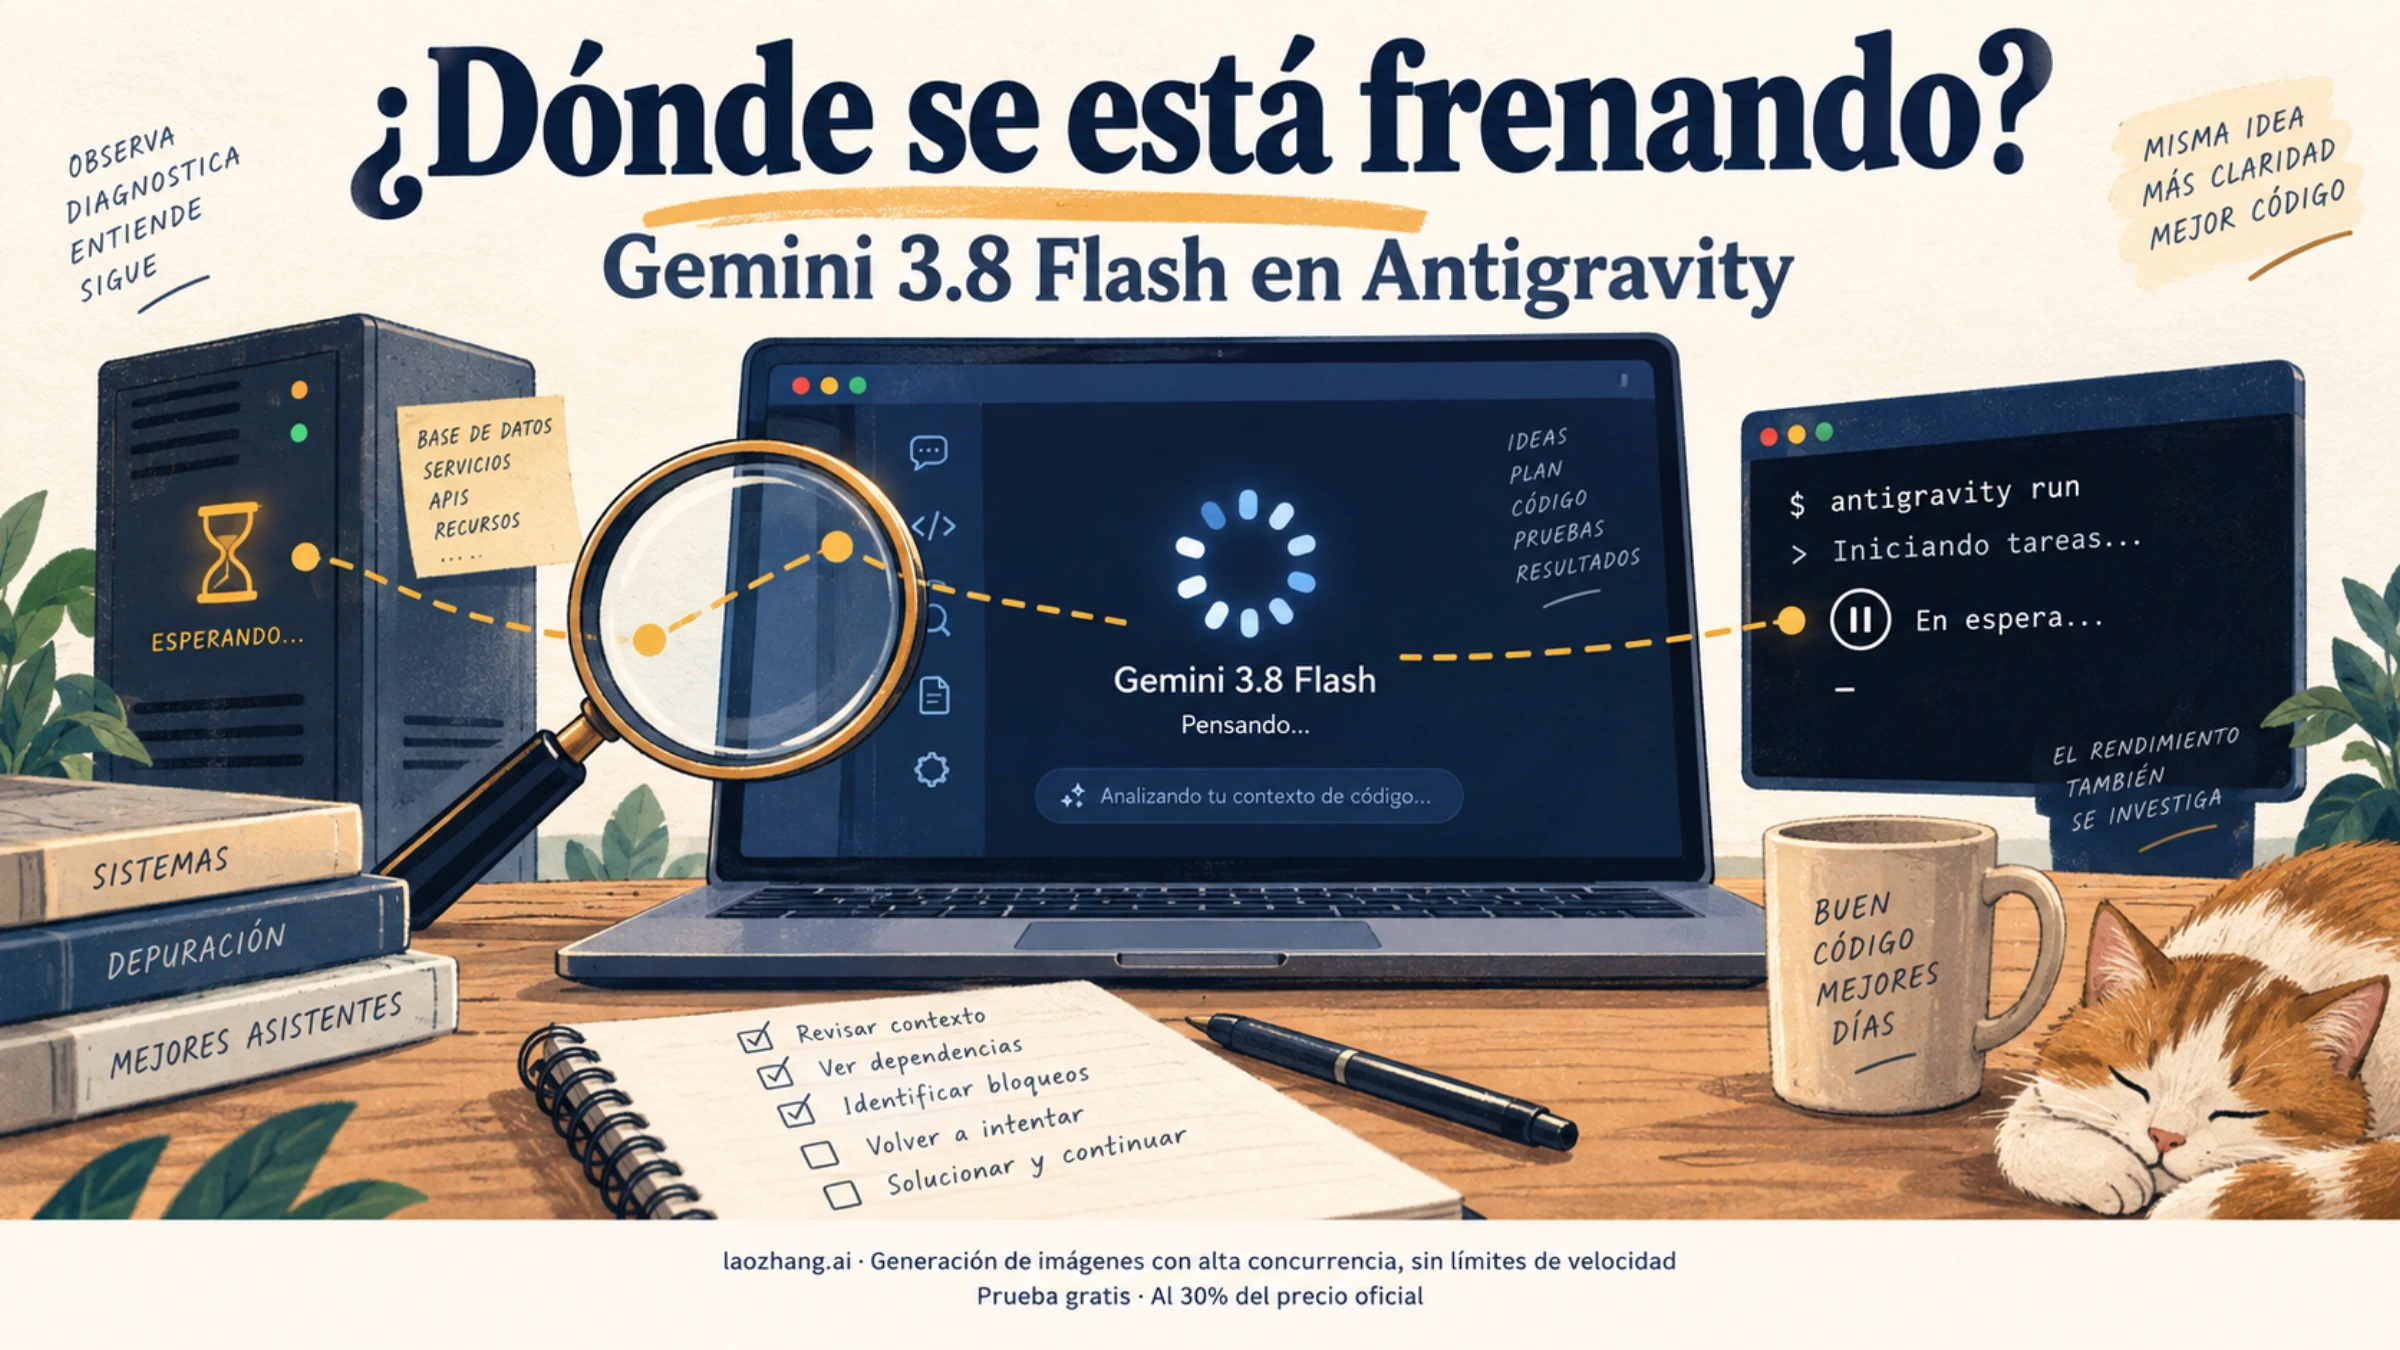
Cuando Gemini 3.8 Flash tarda en Antigravity, la espera puede tener causas muy distintas, y lo que ves en pantalla te dice cuál es: si las herramientas avanzan y aparecen resultados nuevos, el agente está trabajando y el esfuerzo alto lo hace más lento por diseño; si hay una cuenta atrás de reintento o un aviso de «high traffic», el problema es la capacidad del servidor y no tu proyecto; si el agente espera tu permiso para un comando, la pausa es tuya; y si repite el mismo comando sin avanzar, deja de esperar, detenlo y revisa los cambios. La prueba más rápida para separar tu tarea del servicio es enviar un «hola» en una conversación nueva: si eso también se cuelga, el problema no está en tu código.
Qué estás esperando: identifícalo por lo que ves
Antes de reiniciar la app o reenviar la tarea, fíjate en qué muestra el cliente mientras espera. Desde la versión 2.16.0 de la app de escritorio Antigravity 2.0 (22 de septiembre de 2026), el indicador de carga enseña qué está haciendo el agente mientras prepara la respuesta: el progreso de inicialización de las herramientas y, cuando una petición al modelo se reintenta, una cuenta atrás con el número de intento (changelog de Antigravity). Con una versión anterior verás menos pistas, pero los síntomas siguen siendo distinguibles.
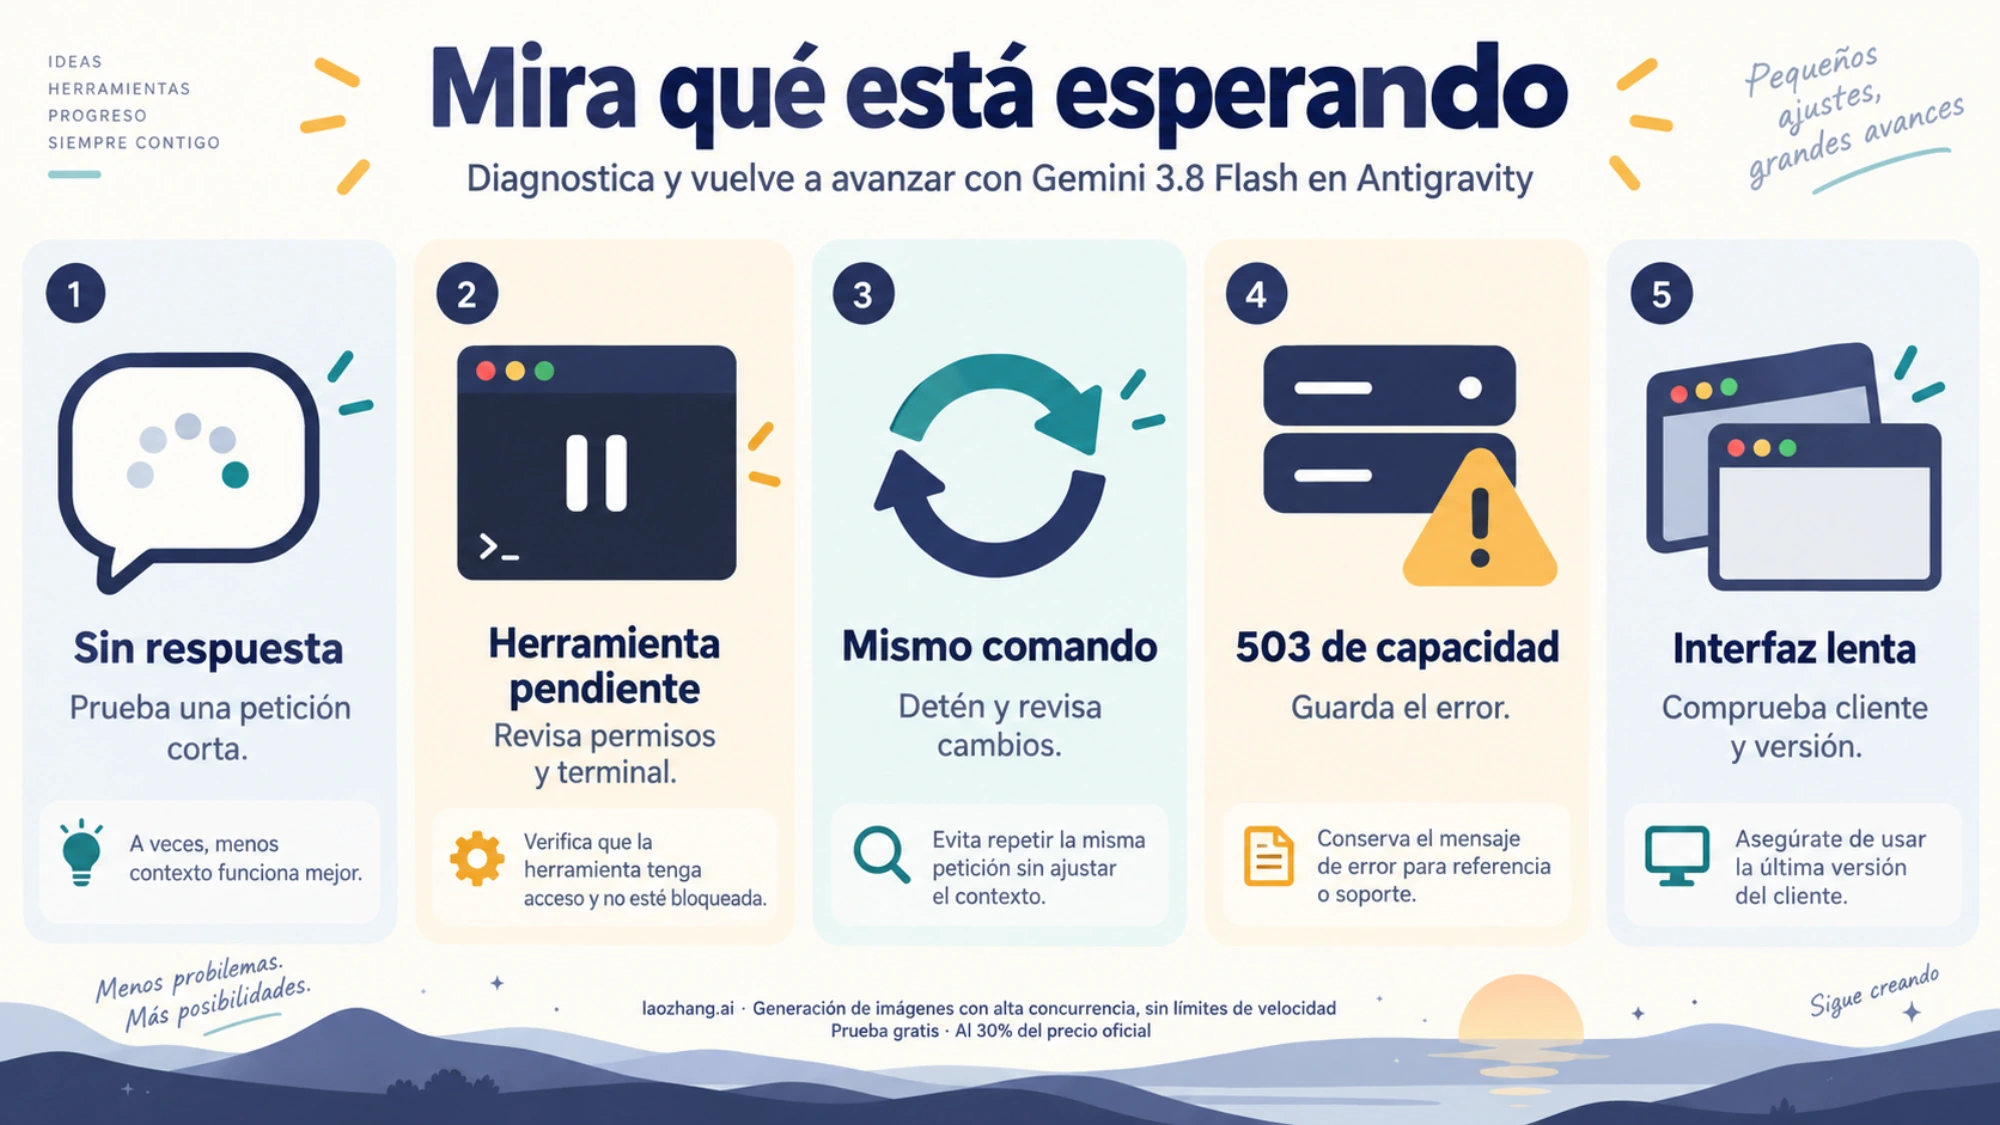
| Lo que ves | Qué suele significar | Qué hacer | Cuándo dejar de esperar |
|---|---|---|---|
| Silencio largo antes de la primera respuesta en una tarea compleja, y luego llega | Razonamiento del modelo, sobre todo en esfuerzo alto | Bajar el esfuerzo a Low o Medium si la tarea no necesita más | Cuando el mismo tipo de tarea iba claramente más rápido con el mismo esfuerzo |
| Un «hola» en una conversación nueva también se queda colgado | El servicio va lento o sin capacidad; no depende de tu proyecto | Probar lo mismo con 3.7 Flash y anotar hora y versión | Si 3.7 Flash responde, trabaja con él por ahora |
| Cuenta atrás con número de intento, «high traffic» o un 503 | Reintentos por falta de capacidad del modelo | Guardar el texto del error; decidir si esperas o cambias de modelo | El cliente reintenta durante unos doce minutos; si no puedes esperar tanto, detén el turno |
| El agente para y espera junto a un comando | Aprobación pendiente según tus permisos | Revisar el comando y aprobarlo o rechazarlo | No es lentitud: no avanza hasta que decidas |
| Las herramientas se ejecutan y salen resultados nuevos | El agente está trabajando | Dejarlo terminar | Si lleva mucho más de lo que vale la tarea, detén y acota |
| Repite el mismo comando o la misma edición sin resultados nuevos | Bucle | Detener, revisar el diff, pedir un paso concreto | En cuanto ves la segunda o tercera repetición idéntica |
| La propia interfaz va a tirones o se congela | Rendimiento del cliente | Actualizar la app | Si ya estás en la última versión, recoge datos y envía comentarios |
Ninguna de estas filas lleva un umbral oficial en segundos: Google no publica cuánto debe tardar un turno en Antigravity. El tiempo que estás dispuesto a esperar lo fijas tú según lo que vale la tarea.
Esfuerzo alto: lento por diseño, no por avería
Gemini 3.8 Flash piensa más que sus predecesores. En el anuncio del modelo, Google explica que en tareas complejas «trabaja más»: ejecuta pasos de razonamiento adicionales, llama a herramientas de forma iterativa y a veces usa más tokens, sobre todo en los niveles de esfuerzo más altos. Para cargas donde prima la eficiencia, la misma nota recomienda un esfuerzo más bajo o seguir con Gemini 3.7 Flash, que sigue plenamente soportado (blog de Google).
Eso encaja con lo que comentan en el hilo en español de r/GoogleAntigravityCLI sobre por qué 3.8 Flash en esfuerzo alto tarda más: la respuesta destacada reconoce que tarda bastante más, pero que los resultados compensan.
Para ponerle cifra al silencio inicial, Artificial Analysis mide para Gemini 3.8 Flash en esfuerzo alto, a través de la API de Google, un tiempo hasta el primer token (TTFT, time to first token) de 14,71 s, frente a una mediana de 3,78 s en modelos de razonamiento de precio parecido; una captura anterior, citada por eesel el 2 de septiembre, daba 13,30 s frente a 2,99 s (Artificial Analysis). Son mediciones de la API, no de Antigravity, y no cubren Medium ni Low. Sirven para una cosa: diez o quince segundos sin texto en un turno exigente no indican por sí solos una avería. Un «hola» que se queda colgado en un chat vacío, como describía un usuario del foro el 15 de septiembre, sí queda fuera de lo que explica el razonamiento.
Las reseñas de lanzamiento que hablan de unos 300 tokens por segundo (Artificial Analysis mide 292) no contradicen esto: esa cifra es la velocidad de salida una vez que el modelo ya ha empezado a escribir. No incluye la espera hasta el primer token, los reintentos ni los pasos de herramientas del agente.
Dónde se cambia el esfuerzo:
- App de escritorio: en el selector de modelo, bajo la caja del mensaje, cada modelo Gemini Flash ofrece niveles Low, Medium y High (la documentación también muestra una opción Fast). Bajar el nivel es cambiar de esfuerzo, no de modelo (documentación de modelos).
- CLI:
/effortmuestra o cambia el esfuerzo de razonamiento para cambiar latencia por profundidad, y--effortlo fija al arrancar.
Un detalle que evita confusiones: la elección de modelo se mantiene durante el turno en curso. Si cambias a 3.7 Flash mientras el agente trabaja, seguirá usando el modelo anterior hasta terminar sus pasos, salvo que canceles la ejecución. Para que el cambio tenga efecto ya, detén el turno y vuelve a pedirlo.
Reintentos y «high traffic»: capacidad del servidor, no tu cuota
Aquí está el motivo de muchas esperas largas sin mensaje. Desde la versión 2.14.0 de Antigravity 2.0 (15 de septiembre de 2026), un error transitorio del servicio ya no corta la sesión: la app lo reintenta con esperas crecientes durante unos doce minutos. Antes, ese mismo error terminaba la sesión. El resultado práctico es que, durante un incidente de capacidad, el cliente puede pasar muchos minutos insistiendo en silencio. Con la 2.16.0, esa espera se ve: aparece la cuenta atrás con el número de intento.
Los textos que los usuarios han copiado en el foro de desarrolladores de Google son de este tipo:
Our servers are experiencing high traffic right now
503 UNAVAILABLE
reason: MODEL_CAPACITY_EXHAUSTED
No capacity available for model gemini-3.8-flash-medium on the server
MODEL_CAPACITY_EXHAUSTED significa que el servidor no tiene capacidad para ese modelo en ese momento, no que hayas gastado tu cuota. Antigravity separa ambos casos desde su lanzamiento: el mensaje de que tú has llegado a tu límite de uso es distinto del de que todos los usuarios han chocado con el límite global de capacidad. Y gemini-3.8-flash-medium es una cadena interna del error que refleja el modelo y su nivel de esfuerzo; el identificador público en la API es gemini-3.8-flash, y no tienes que configurar nada con ese nombre.
La cuota es otra cosa y conviene tenerla clara, porque un agente atascado la consume (planes de Antigravity):
- Google AI Pro y Ultra tienen una cuota que se recupera cada cinco horas, con un límite semanal; el resto de cuentas individuales la recuperan cada semana.
- Los límites dependen del trabajo que hace el agente, que varía de un prompt a otro. Un agente que da vueltas gasta cuota aunque no produzca nada útil.
- En Pro y Ultra, la opción AI Credit Overages decide si al agotar la cuota se usan créditos de IA comprados (Always) o se espera a la recarga (Never).
- El consumo se ve en los ajustes de la app, con el límite semanal y el de cinco horas restantes; en el CLI,
/usage(o/quota) consulta la cuota al servidor y abre el panel Model Quotas.
La documentación no dice si un turno que falla por falta de capacidad descuenta cuota ni si se devuelve lo gastado durante un incidente. Una publicación de la cuenta de Antigravity en X de mediados de septiembre hablaba de alta carga y de restablecer límites, pero solo se conoce un fragmento, sin el alcance de ese restablecimiento; no cuentes con una devolución.
Si el error aparece al llamar al modelo por API, y no en Antigravity, la lectura cambia: la guía sobre el error de alta demanda en Gemini separa 503, 429 y 504 por superficie, y la de límites de la API de Gemini diagnostica el 429 por proyecto y nivel.
Una prueba corta para saber si es tu tarea o el servicio
Cuando no sabes en qué fila de la tabla estás, esta comparación resuelve la mayoría de dudas en pocos minutos y sin tocar el proyecto:
- Abre una conversación nueva y envía un mensaje corto que no necesite herramientas, con el mismo modelo y el mismo esfuerzo que en la tarea lenta.
- Si responde con normalidad, el servicio funciona: lo que tarda es tu tarea (esfuerzo, contexto largo, muchas herramientas). Baja el esfuerzo o divide el trabajo.
- Si también se cuelga o aparece la cuenta atrás de reintento, repite el mismo mensaje con Gemini 3.7 Flash y el mismo nivel.
- Si 3.7 Flash responde, trabaja con él mientras dure el problema. Es lo que el propio personal del foro señaló el 15 de septiembre como alternativa temporal. Si 3.7 también va lento, como contó otro usuario ese día, el problema es más amplio y cambiar de modelo no te ahorra la espera.
- Anota plan, modelo, nivel, versión de la app y hora en UTC de cada intento. Te sirven para comparar más tarde y para el informe de comentarios.
Esta secuencia es un criterio práctico, no una medición: dice dónde está el cuello de botella en ese momento, no que 3.7 Flash vaya a ser siempre más rápido.
Si el agente repite el mismo comando
Un agente que vuelve a lanzar el mismo comando o reescribe la misma edición sin obtener nada nuevo no va a salir solo del bucle por esperar más, y cada vuelta cuenta como trabajo del agente para la cuota. Un usuario de Ultra describía en el foro, el 18 de septiembre, bucles sobre comandos triviales en siete sesiones, sin que abrir chats nuevos le sirviera; una respuesta del 22 contaba que solo le funcionó volver a 3.7 Flash. No hay una receta que funcione siempre, pero sí un orden que no pierde trabajo:
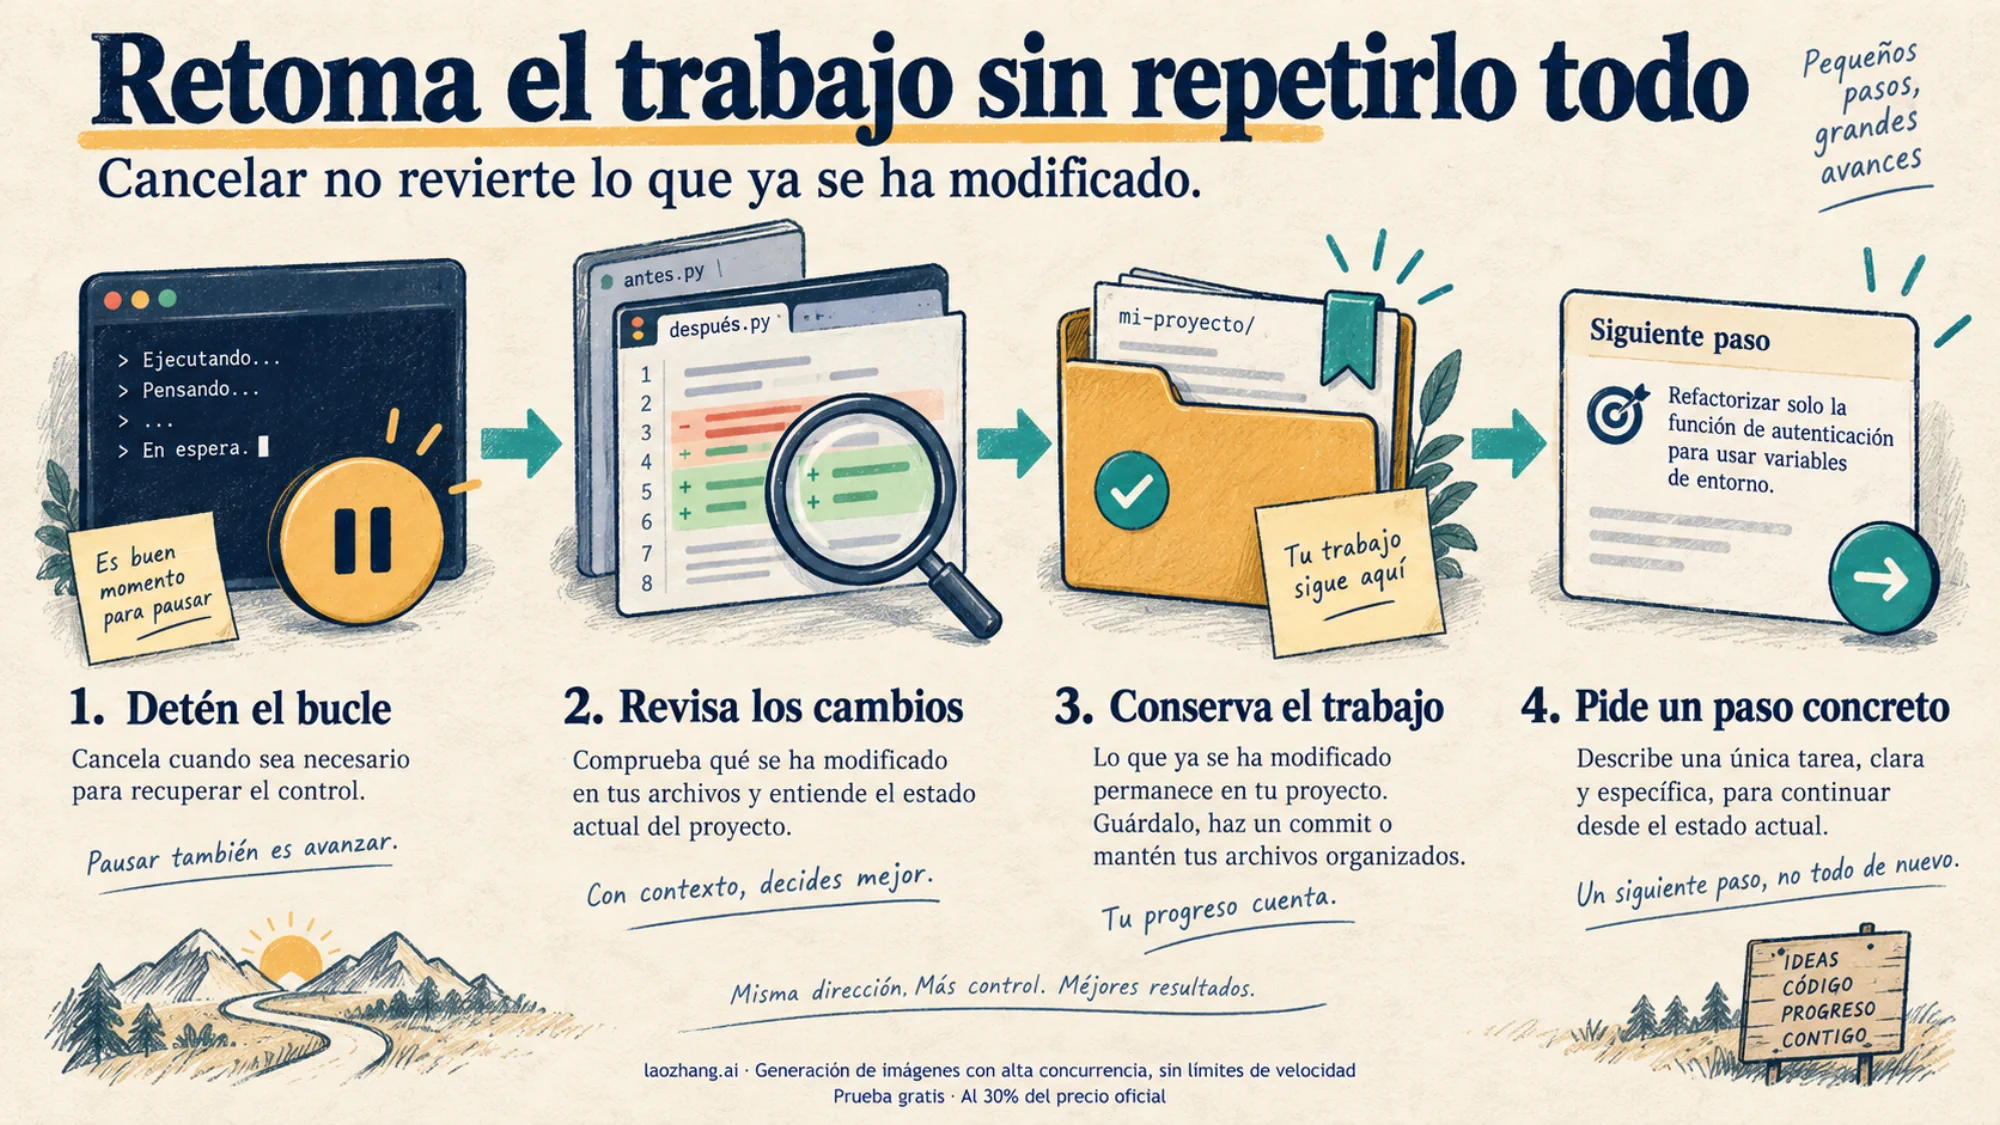
- Detén el turno. Si hay subagentes, desde la 2.16.0 aparecen como tarjetas con su estado en vivo y un control para detener el que está en marcha.
- Revisa los cambios. Detener no deshace lo que el agente ya escribió en disco; mira el diff en Review Changes antes de seguir. Si quieres volver atrás, deshazlo o rebobina la conversación de forma explícita.
- Conserva lo bueno. Haz commit de lo que sí sirve para no depender del historial de la conversación.
- Pide un solo paso concreto desde el estado actual, en lugar de repetir la tarea completa.
Dos correcciones recientes afectan a este paso: la 2.16.0 arregló un fallo por el que reabrir una conversación antigua podía volver a aplicar sus ediciones y pisar trabajo más reciente, y la 2.17.0 hizo que rebobinar una conversación ya no restaure archivos desactualizados. Si vas a reabrir o rebobinar conversaciones después de un bucle, conviene estar en una versión que incluya ambas.
La espera por aprobación se parece a un bloqueo, pero no lo es. Con el preajuste Request Review, el agente no ejecuta ningún comando de terminal sin pedirte permiso, salvo los de tu lista de permitidos; con Default, necesita tu aprobación para lo que salga del sandbox (ajustes del agente). Revisa si hay un comando esperando tu decisión antes de pensar que el modelo se ha quedado colgado.
Cuando lo lento es la propia app
Si lo que va a tirones es la interfaz (cambiar de conversación, abrir un diff, escribir en la caja del mensaje), el modelo no tiene nada que ver. Las últimas versiones de la app de escritorio corrigen varias causas conocidas:
| Versión (fecha) | Qué corrige |
|---|---|
| 2.14.0 (15 de septiembre de 2026) | Conversaciones muy largas cargan antes y usan menos memoria; se eliminó un escaneo de reglas y personalizaciones en cada mensaje; la app ya no se congela varios segundos al reconectar tras un rato inactiva |
| 2.15.0 (18 de septiembre de 2026) | Permisos duplicados que inflaban los archivos de conversación y ralentizaban la app; cambio de conversación más rápido |
| 2.16.0 (22 de septiembre de 2026) | Escaneo inicial de personalizaciones en proyectos grandes o carpetas de red: de más de un minuto a menos de un segundo |
| 2.17.0 (22 de septiembre de 2026) | Archivos y diffs grandes ya no congelan la app; los archivos de más de 100 KB se muestran como texto plano |
Estos números de versión son de la app de escritorio Antigravity 2.0. El CLI, el SDK y el IDE tienen su propia numeración en otras pestañas del changelog, así que no los apliques allí. Además, las versiones nuevas se despliegan de forma gradual y pueden tardar unos días en llegar a todos los usuarios: que la 2.17.0 exista no significa que ya la tengas.
No hace falta borrar cachés, reinstalar dependencias ni vaciar el proyecto para que un modelo en la nube responda antes; ninguna de esas acciones cambia la capacidad del servidor y algunas pueden costarte trabajo. Si trabajas con Antigravity a través de Remote Control, la guía de control remoto de Google Antigravity 2.0 cubre sus errores de conexión y daemon, que se confunden fácilmente con lentitud.
Qué pasó entre el 15 y el 24 de septiembre
La referencia pública más completa del incidente es el hilo «Gemini 3.8 in Antigravity is too slow!» del foro de desarrolladores de Google. Las horas son UTC:
- 15 de septiembre, 09:17: primer aviso. Antigravity 2.0 iba bien hasta el día anterior; ahora hasta un «hola» en un chat nuevo se cuelga, sin códigos de error. Siguen otros usuarios: unos dicen que 3.7 Flash va bien, otros que también va lento; aparecen los mensajes de «high traffic» y el 503
MODEL_CAPACITY_EXHAUSTED. - 15 de septiembre, 19:25: una cuenta con distintivo de personal y moderación del foro responde que el equipo de ingeniería investiga una degradación del rendimiento de Gemini 3.8 Flash y que cambiar a 3.7 Flash es la alternativa temporal.
- 15 de septiembre, 22:31: la misma cuenta da el problema por resuelto.
- 16 al 18 de septiembre: nuevas quejas intermitentes (lento, luego bien, luego lento); un usuario cuenta un turno colgado seis horas en el mismo punto.
- 24 de septiembre: «lento toda la semana» y «Working…» que no termina nunca, dos veces en veinte minutos, y no solo con 3.8.
La respuesta de «resuelto» del 15 de septiembre no describe el estado posterior, y las quejas del 24 tampoco prueban que el servicio siga caído para todos. Lo que pase en tu cuenta hoy lo dice mejor la prueba corta de la sección anterior que cualquier fecha del hilo.
Si lo que buscas es comparar 3.8 con 3.7 por precio o migrar una integración por API de forma reversible, eso se trata en Gemini 3.8 Flash: precio, ID y migración segura desde 3.7.
Antes de enviar comentarios, apunta esto
Cuando el problema persiste tras actualizar y probar con otro modelo, el camino razonable es enviar comentarios desde la propia app; en el foro de ayuda de Google, la respuesta destacada a un hilo sobre la latencia de 3.8 Flash del 15 de septiembre pedía precisamente eso. La 2.15.0 corrigió un fallo por el que el formulario no se enviaba con registros de diagnóstico grandes adjuntos, otra razón para actualizar antes. Un informe útil incluye:
- Versión de la app (o del CLI) y sistema operativo.
- Plan (Free, Plus, Pro, Ultra o Enterprise), modelo y nivel de esfuerzo.
- Hora en UTC del turno lento y cuánto duró.
- Texto exacto del error, si lo hubo, y si apareció la cuenta atrás con número de intento.
- Resultado de la prueba corta: si un «hola» en un chat nuevo respondía y si 3.7 Flash iba igual.
- Si el agente repetía un comando, cuál y cuántas veces.
Preguntas frecuentes
¿Abrir un chat nuevo arregla la lentitud de Gemini 3.8 Flash?
Depende de la causa. Si el problema es una conversación muy larga o un contexto cargado, empezar de cero puede acortar la espera, y la 2.14.0 ya hizo más ligeras las conversaciones largas. Si es falta de capacidad del servidor, un chat nuevo se colgará igual; precisamente por eso sirve como prueba.
¿Poner Turbo o Always Proceed hace que el agente vaya más rápido?
Solo elimina la espera de tu aprobación, no la del modelo. A cambio, el agente ejecuta comandos sin revisión y, con Turbo, con acceso completo a tu sistema de archivos. Si las aprobaciones te frenan, añade comandos concretos y seguros a la lista de permitidos en lugar de quitar la revisión entera.
¿Me devolverán la cuota que gastó el agente durante el incidente?
Las páginas de planes de Antigravity no contemplan devoluciones y tampoco aclaran si los turnos fallidos por capacidad descuentan cuota. Lo que sí puedes controlar es no dejar un bucle corriendo: detenerlo pronto es la única forma segura de no gastar de más.
Fuentes6
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 25 sept 2026.
Fuentes6
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 25 sept 2026.
- 1.changelog de Antigravityantigravity.google/changelog
- 2.blog de Googleblog.google/innovation-and-ai/models-and-research/gemini-models/3-8-flash-and-3-8-flash-cyber
- 3.Artificial Analysisartificialanalysis.ai/models/gemini-3-8-flash
- 4.documentación de modelosantigravity.google/docs/models
- 5.planes de Antigravityantigravity.google/docs/plans
- 6.ajustes del agenteantigravity.google/docs/agent-settings