GPT-6.2 Sol 和 6.1 Sol 区别:同价实测快 4 倍,Opus 5.5 还值不值
GPT-6.2 Sol 与 6.1 Sol 标准价相同,同一批 12 道题耗时约为四分之一。单次请求和日常代理换 6.2 Sol,最难的长代理编码任务 Opus 5.5 仍领先。
文章目录
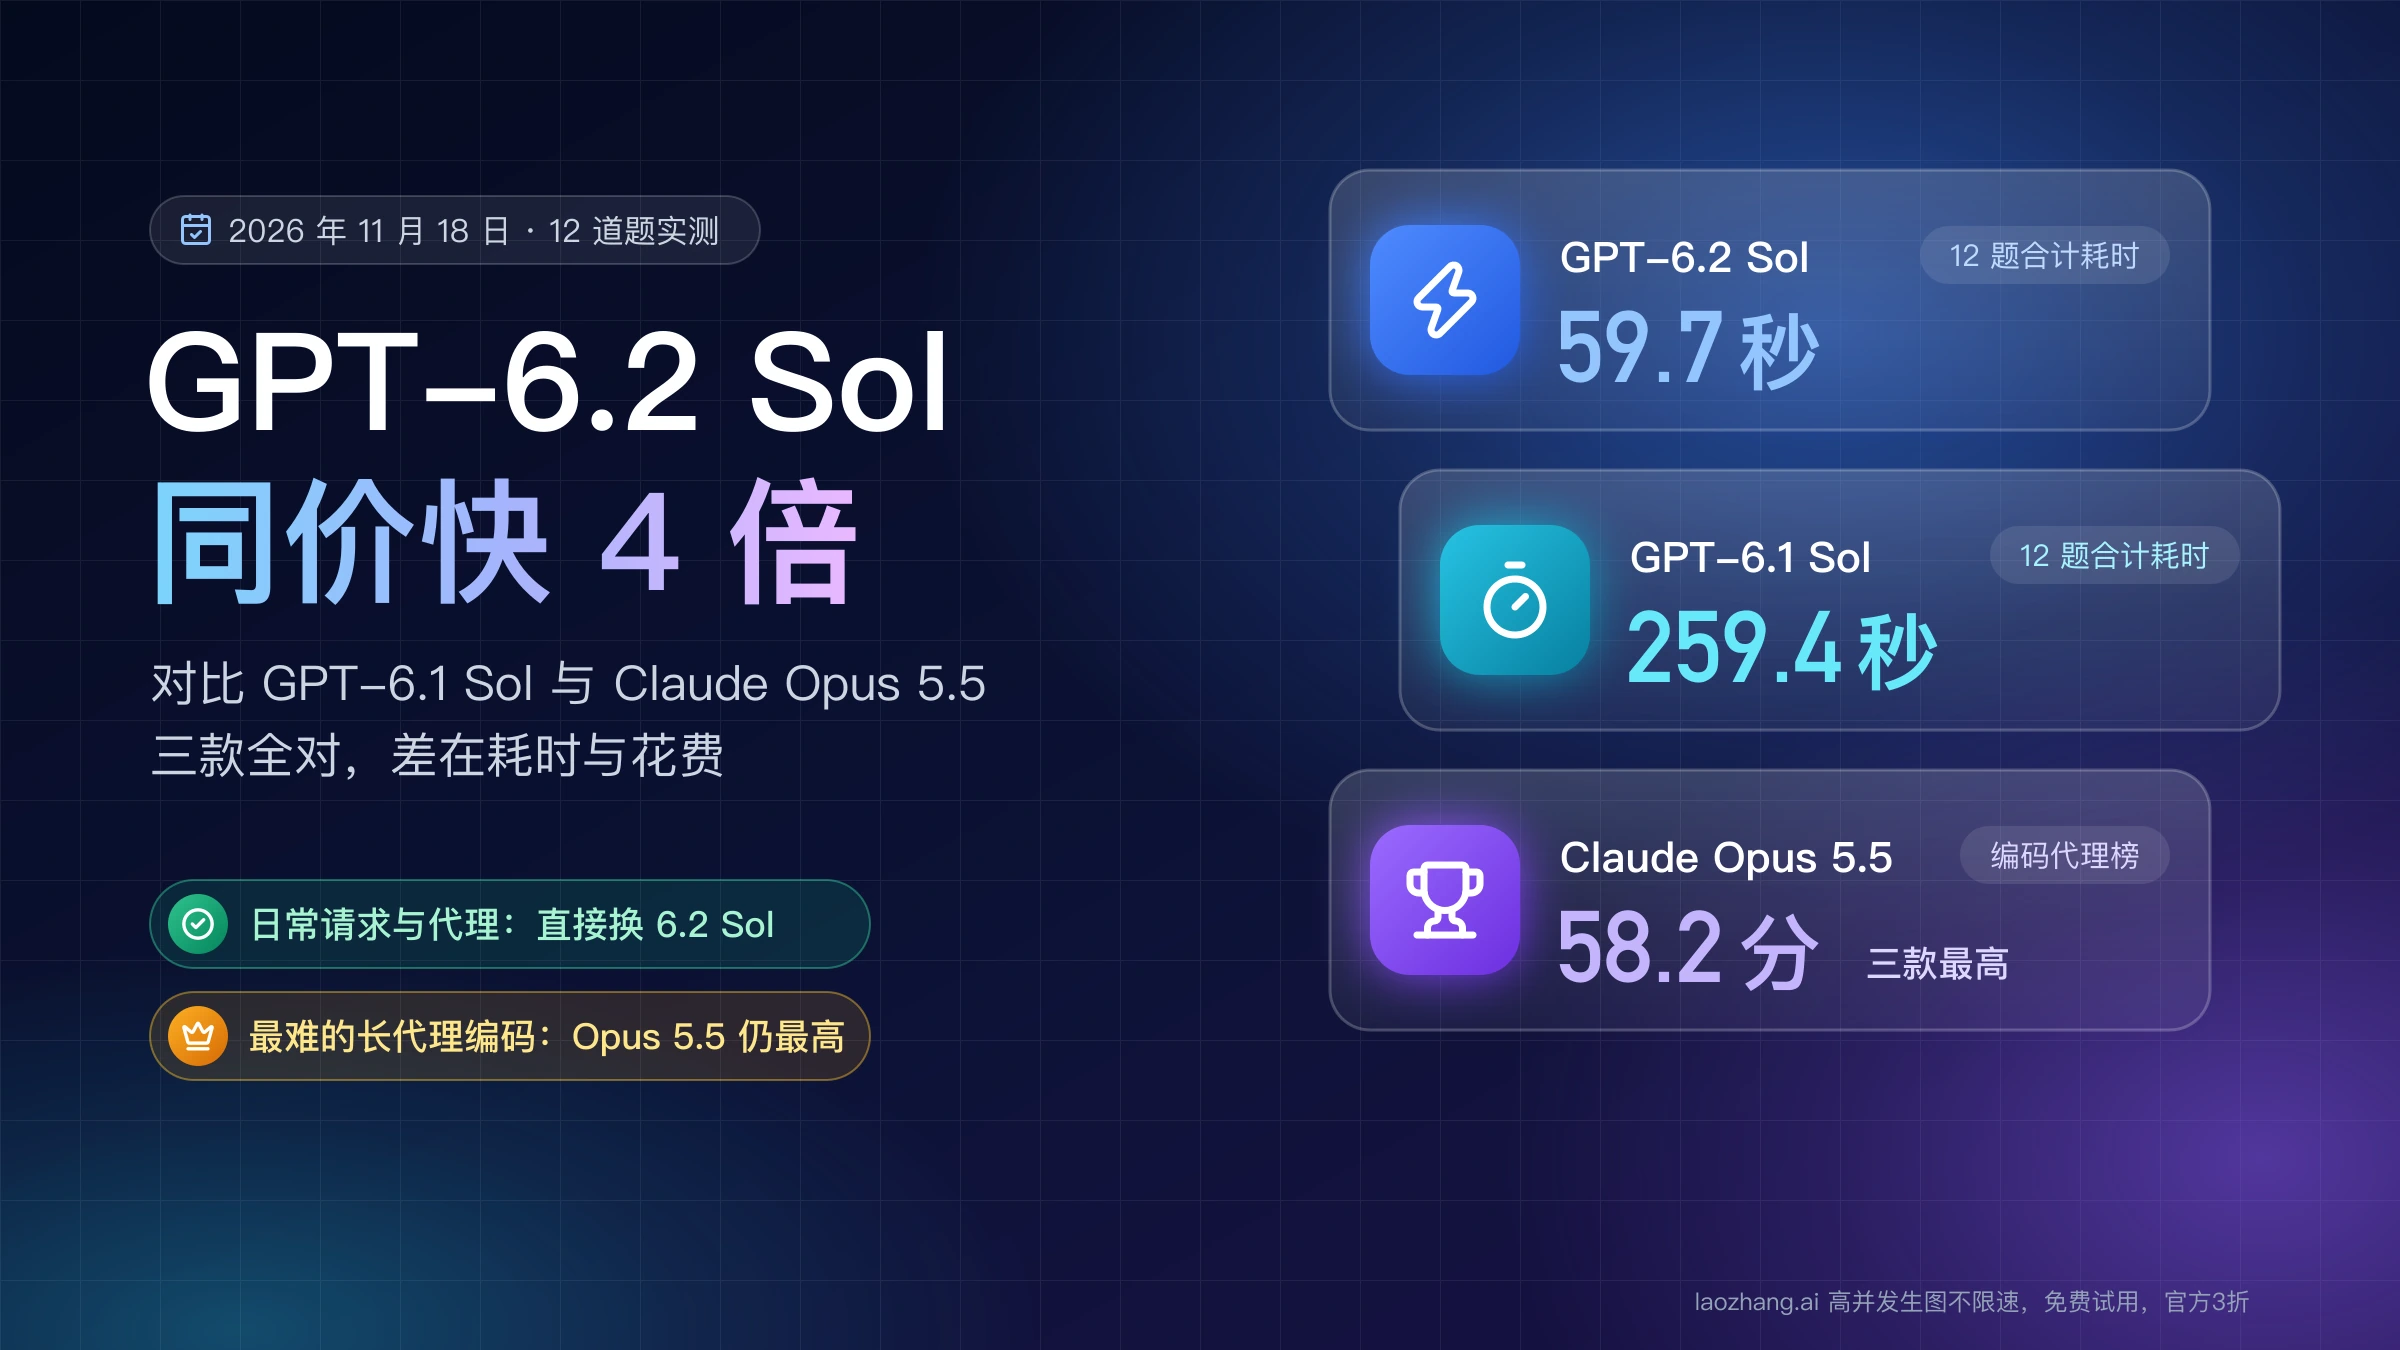
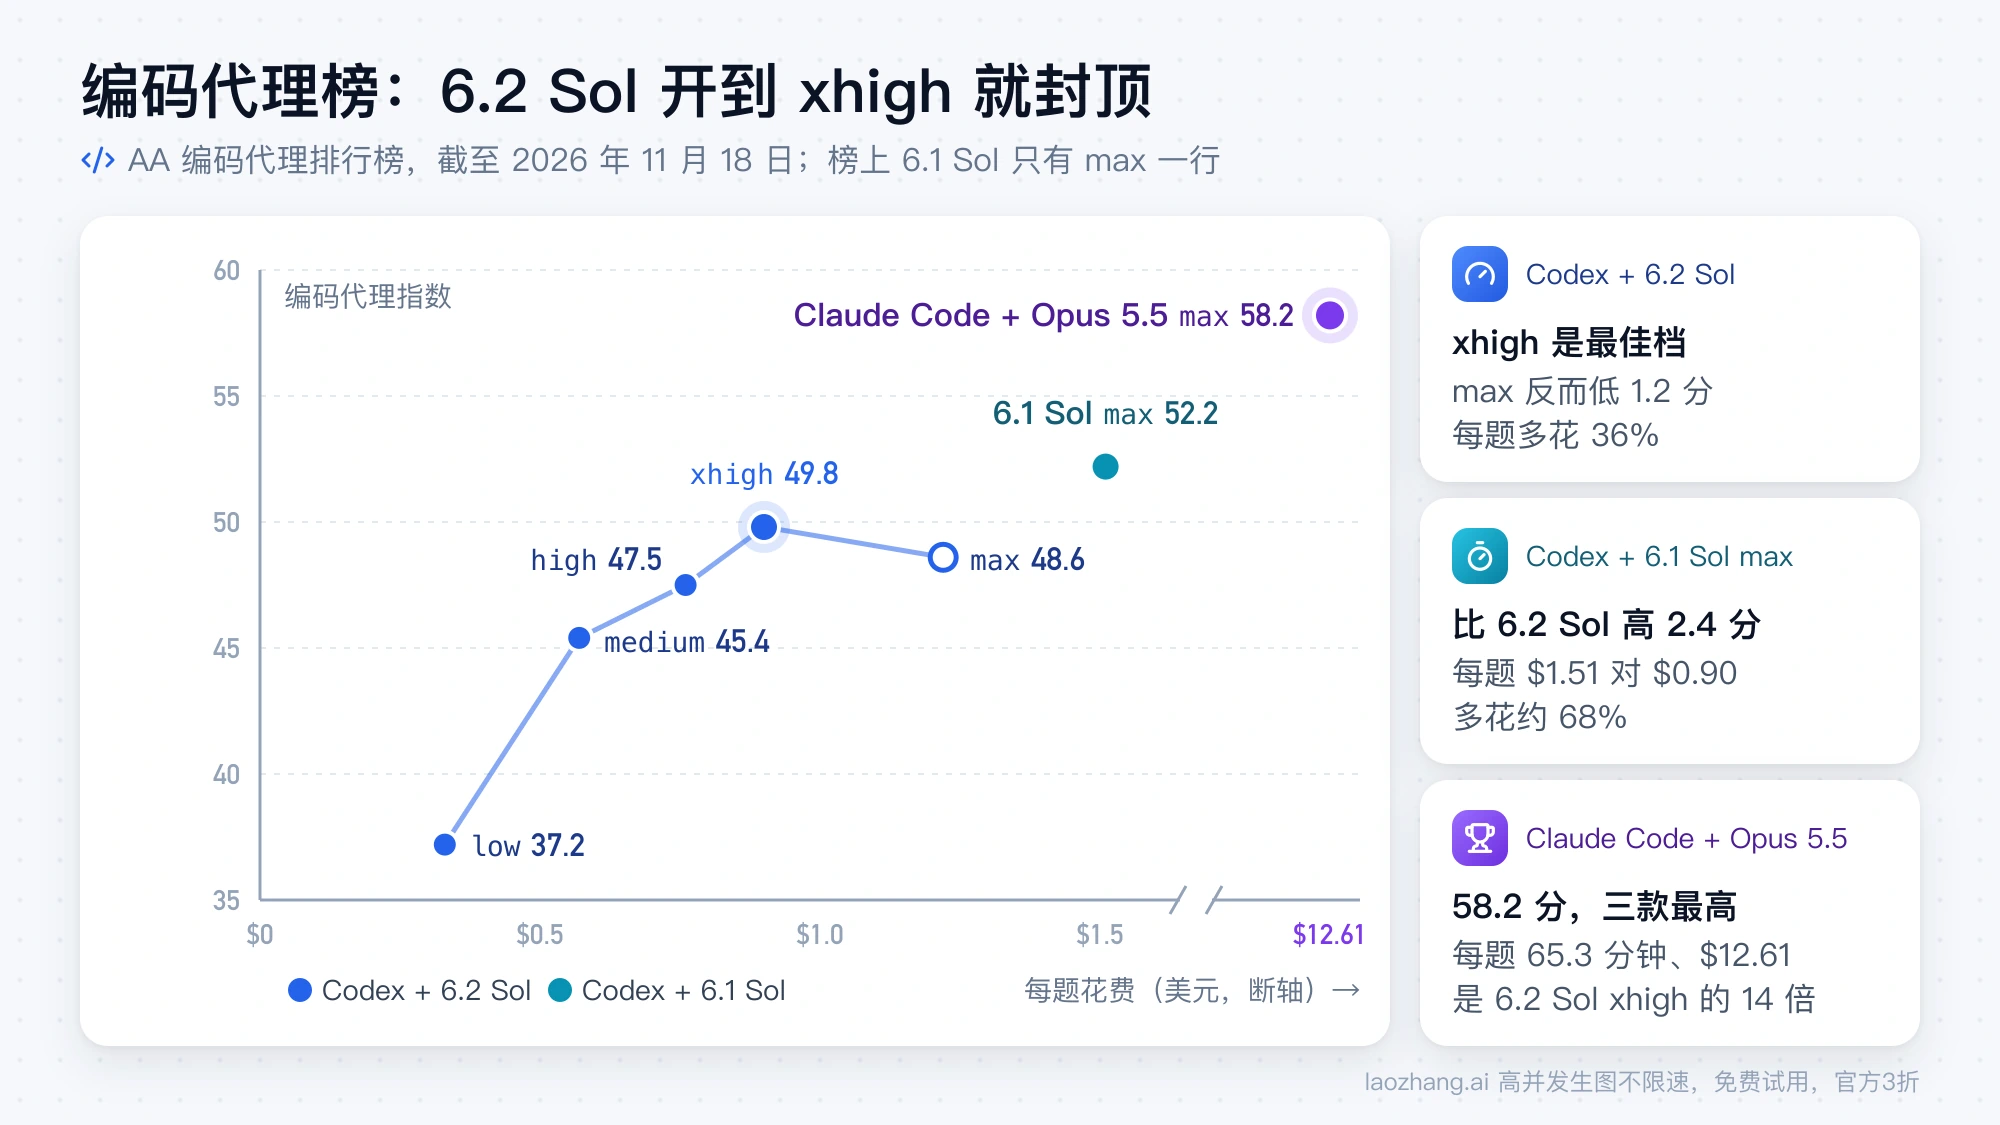
OpenAI 在 2026 年 11 月 17 日发布了 GPT-6.2 Sol(模型 ID gpt-6.2-sol)。截至 11 月 18 日,它的 API 标准价和 GPT-6.1 Sol 完全一样,每百万 token 输入 $2、输出 $10,但同样的活用的时间和 token 都更少:2026 年 11 月 18 日用同一批 12 道带隐藏测试的题实测,两款都全对,6.2 Sol 默认档合计耗时 59.7 秒,6.1 Sol 是 259.4 秒。"6.2 Sol 写代码不如 6.1"的说法也有出处:在 Artificial Analysis(下称 AA)的编码代理榜上,Codex 搭配 6.2 Sol 的最好成绩是 xhigh 档的 49.8 分,低于 6.1 Sol max 档的 52.2 分,只是每题花费少了 40%。
所以 API 里的单次请求、日常编码和代理工作流,直接把模型换成 gpt-6.2-sol,从默认的 medium 推理强度(effort)开始;原来开 6.1 Sol max 的,先试 6.2 Sol high,AA 智能指数上两者同为 55 分,6.2 Sol 每题成本只有 44%。在 Codex 里跑很长的代理编码任务时,6.2 Sol 用 xhigh 而不是 max;如果在你自己的仓库上 6.1 Sol max 明显更稳,gpt-6.1-sol 截至 11 月 18 日仍在 OpenAI 的 API 价目表上,可以继续调用。
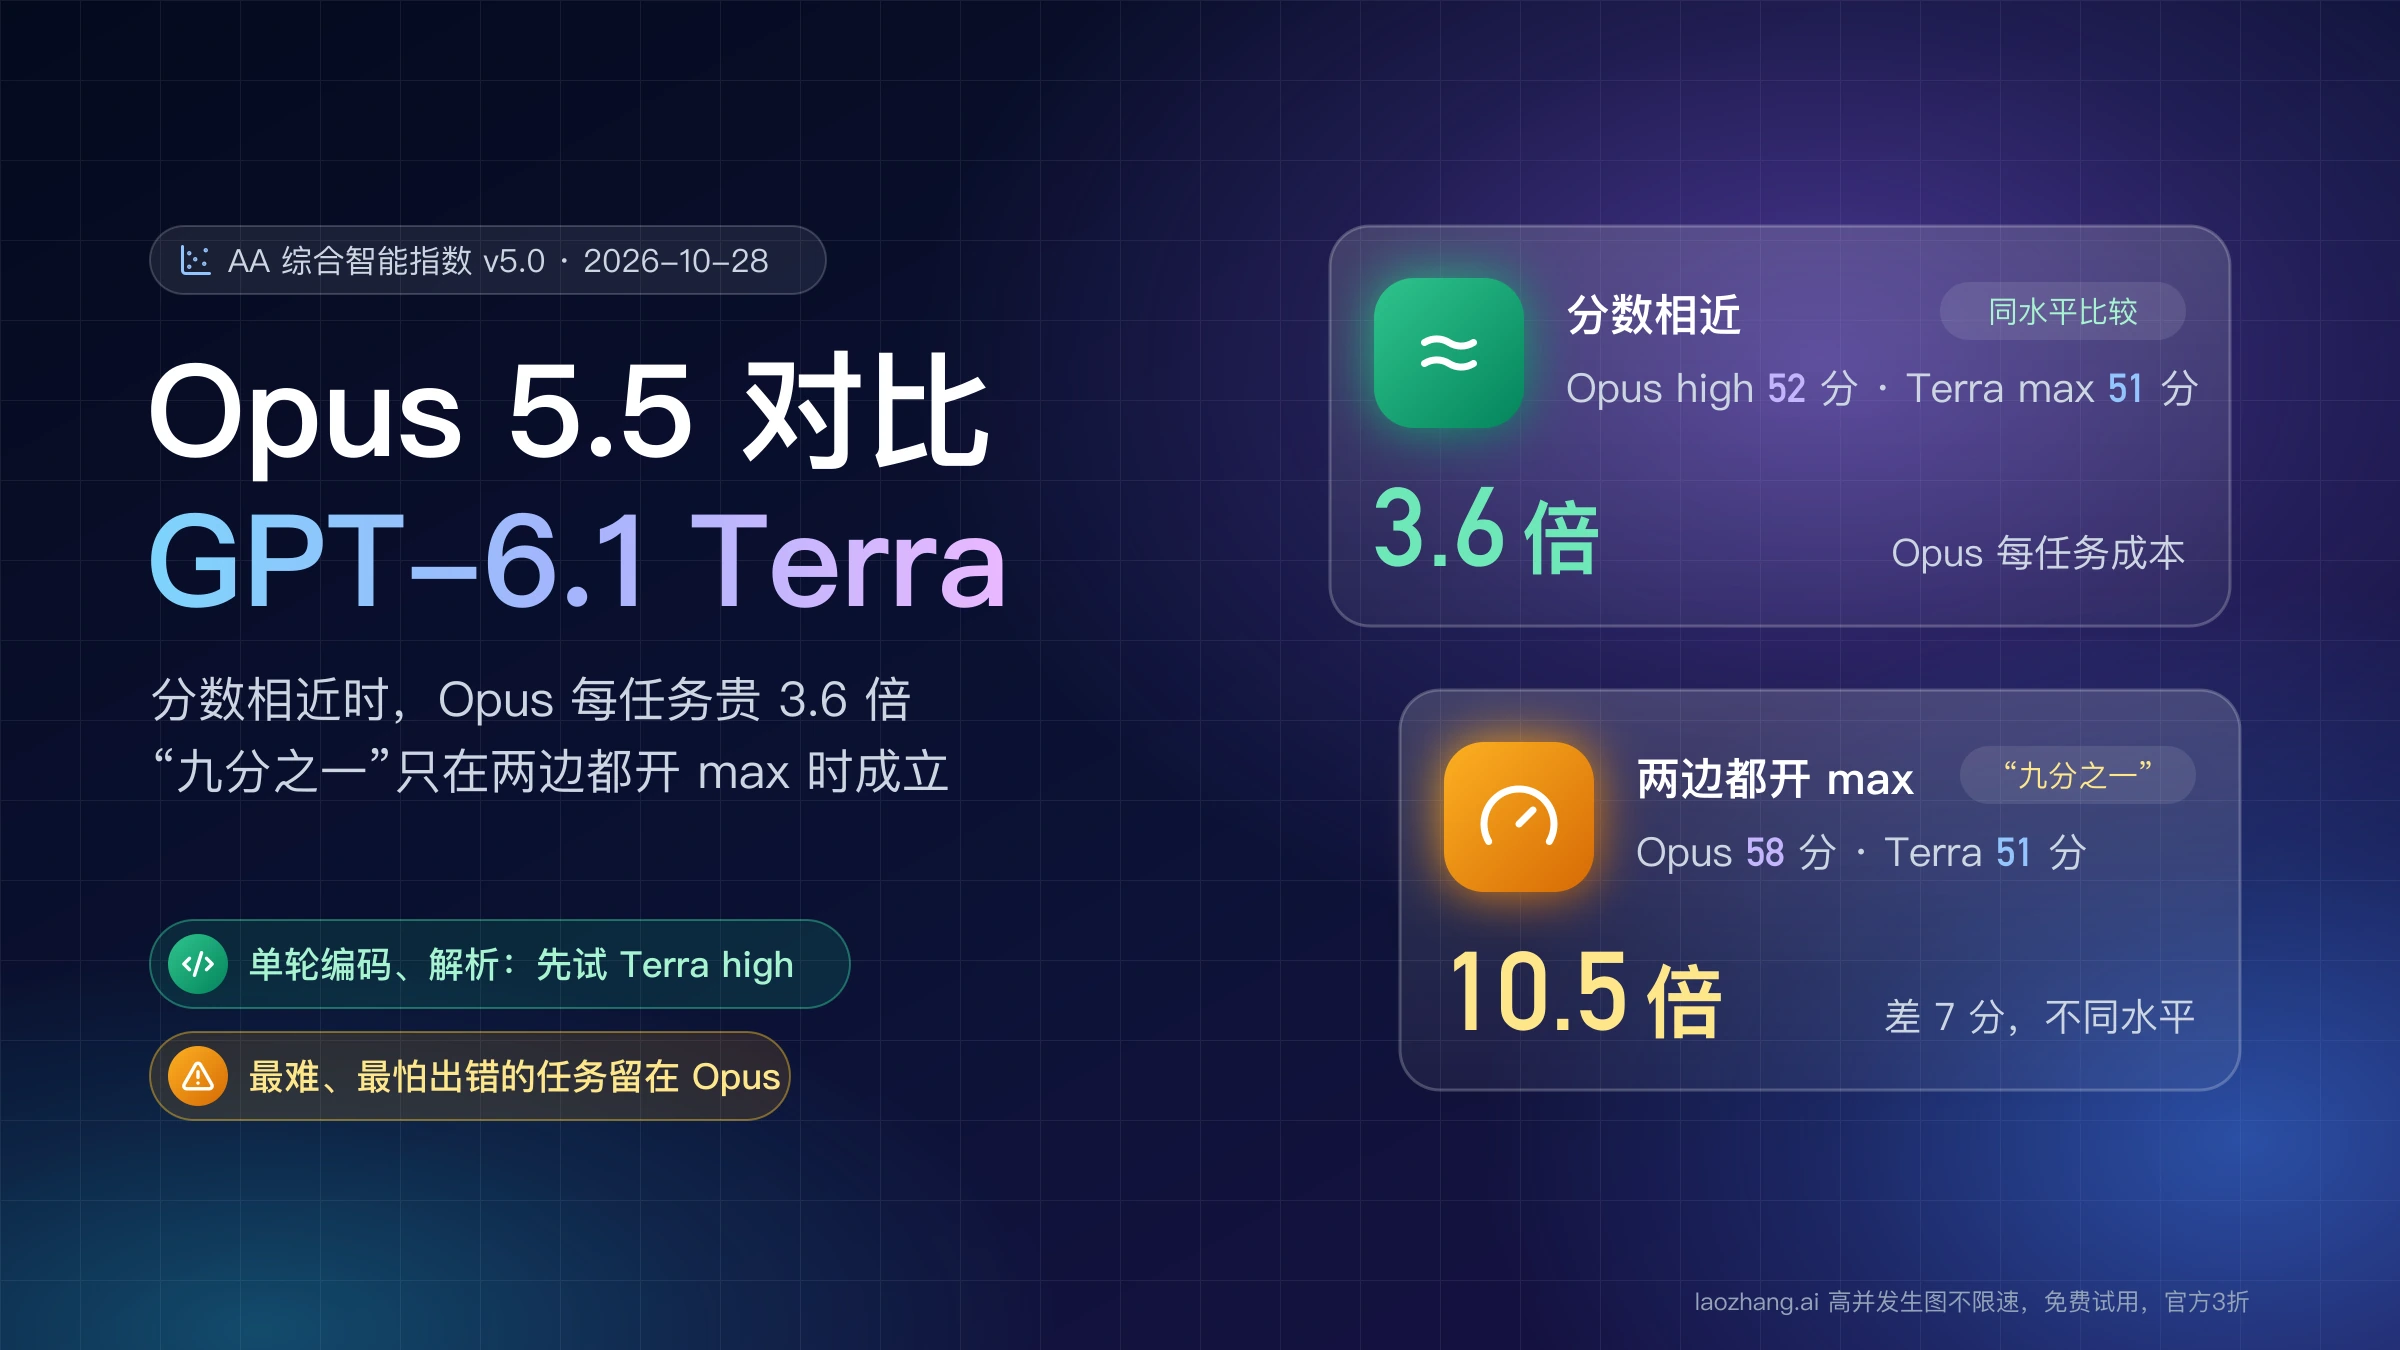
Claude Opus 5.5 按 token 计价是 Sol 的 2 倍,在 AA 编码代理榜上 Claude Code 搭配 Opus 5.5 max 拿到 58.2 分,三款里最高,但每题 $12.61、耗时 65.3 分钟。返工代价高、最难的长代理任务继续交给 Opus 5.5;单轮问答、长日志分析这类三款都能做对的活改给 6.2 Sol,同一批题上 Opus 5.5 medium 的花费是 6.2 Sol 的 5.1 倍。切换时最容易出错的是两处:可复用的指令要放进 input 里第一条 developer 消息才能被缓存,工具调用走 Responses API。推理强度 none 6.1 Sol 本来就不接受,从 6.1 Sol 直接换过来不受影响;只有共用配置、或为其他接受 none 的模型写的代码把它发给 6.2 Sol 时,才会收到 400。
该换哪个:按工作类型分配 6.2 Sol、6.1 Sol 和 Opus 5.5
决定换不换的不是模型名,而是你的活属于哪一类。单次请求和中等长度的代理任务,6.2 Sol 在同价下更快、分数更高,没有理由留在 6.1 Sol;在 Codex 里连续跑二三十分钟的代理编码,6.1 Sol max 在 AA 的榜上仍高 2.4 分,这时才值得在自己的仓库上对比一轮;Opus 5.5 只在最顶端还领先,领先的代价是花费高一个数量级。下表是起点,依据在后面各节。
| 你的活 | 先用 | 什么时候换,换了损失什么 |
|---|---|---|
| API 单轮请求:问答、改写、抽取、写函数 | 6.2 Sol 默认 medium | 很少需要换。原来用 6.1 Sol high 或 max 的,先试 6.2 Sol high |
| 长日志、长文档分析,输入不超过 272K token | 6.2 Sol medium | 146 KB 日志题三款都算对,6.2 Sol 最快;输入超过 272K 后 6.2 Sol 的输入单价翻倍,和 Opus 5.5 持平 |
| Codex 里的中长代理编码 | 6.2 Sol xhigh | 不要开 max,它比 xhigh 分数低、更贵。自己仓库上 6.1 Sol max 通过率更高时,在 API 里继续用它,每题多花约 68% |
| 最难、返工代价高的长代理任务 | Opus 5.5(Claude Code,xhigh 或 max) | 改给 6.2 Sol xhigh 能省下九成以上花费,代价是编码代理指数低 8.4 分 |
| 预算很紧的批量任务 | 6.2 Sol low,可叠加 Batch 半价 | low 在 AA 智能指数上是 41 分,比 Opus 5.5 low 高 6 分,每题成本不到它的五分之一 |
表里"每题多花约 68%"按 AA 编码代理榜算:6.1 Sol max 每题 $1.51,6.2 Sol xhigh 每题 $0.90,$1.51 ÷ $0.90 ≈ 1.68。"省下九成以上"同样来自这张榜:Opus 5.5 max 的每题花费是 6.2 Sol xhigh 的 14 倍,1 − 1/14 ≈ 93%。
同一批 12 道题实测:三款全对,6.2 Sol 耗时约为 6.1 Sol 的四分之一
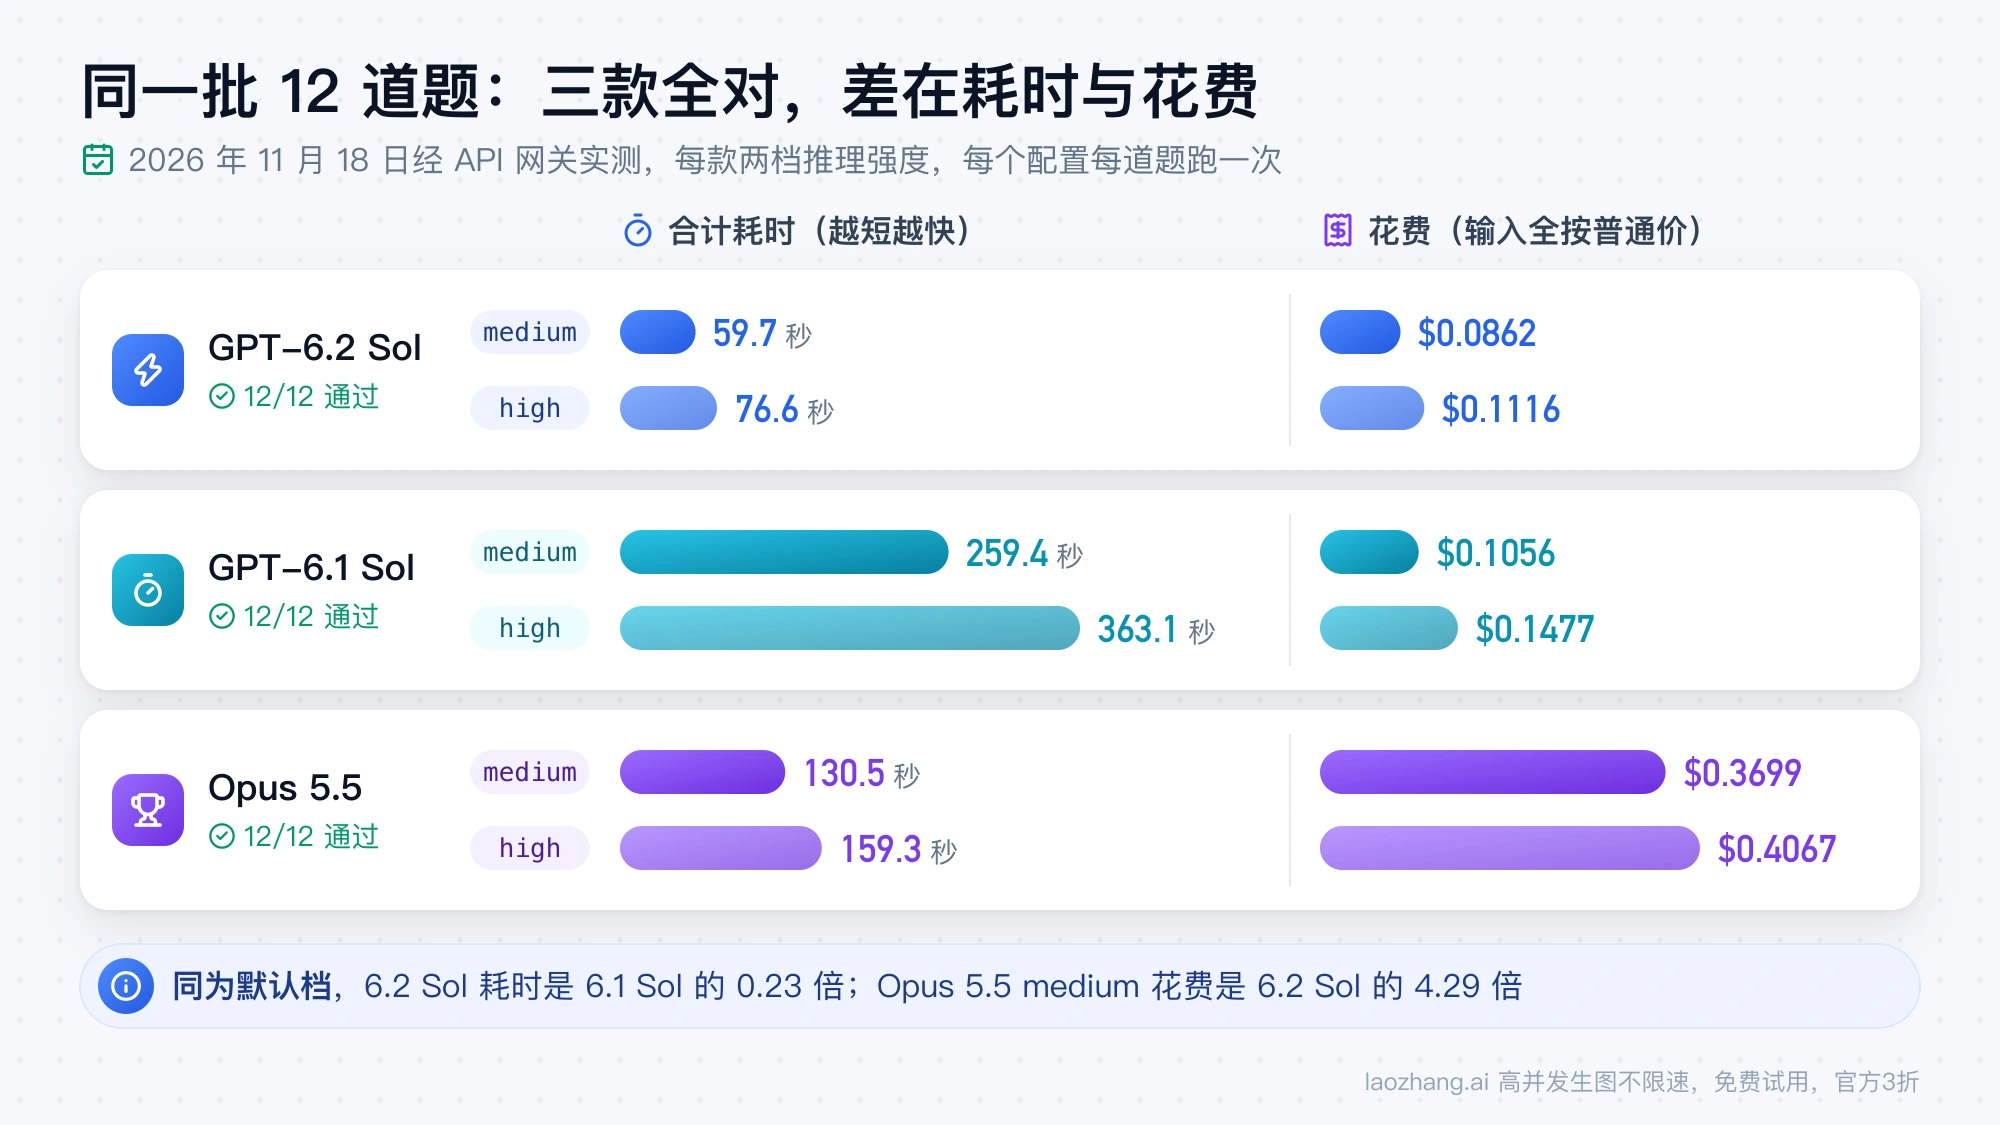
2026 年 11 月 18 日,经 laozhang.ai 的 API 网关,把同一批 12 道单轮题交给 6.2 Sol、6.1 Sol 和 Opus 5.5,每款各跑两档推理强度,6 个配置全部 12/12;差别只在时间、token 和花费上。题目包括应用题计算、区间合并、时长解析、语义版本比较、表达式求值、CSV 行解析和一份长文档问答,每道都带隐藏测试或唯一正确答案,题目和评分脚本与 10 月以来的同类测试相同。GPT 两款走 /v1/chat/completions,"默认档"是不传 reasoning_effort,也就是 medium;每个配置每道题跑一次。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
| 配置 | 通过 | 输出 token | 合计耗时 | 花费(按实际计费) | 花费(输入全按普通价) |
|---|---|---|---|---|---|
GPT-6.2 Sol 默认 medium | 12/12 | 4,220 | 59.7 秒 | $0.0721 | $0.0862 |
GPT-6.2 Sol high | 12/12 | 6,765 | 76.6 秒 | $0.1217 | $0.1116 |
GPT-6.1 Sol 默认 medium | 12/12 | 6,167 | 259.4 秒 | $0.1158 | $0.1056 |
GPT-6.1 Sol high | 12/12 | 10,380 | 363.1 秒 | $0.1579 | $0.1477 |
Claude Opus 5.5 medium | 12/12 | 11,833 | 130.5 秒 | $0.3699 | $0.3699 |
Claude Opus 5.5 high | 12/12 | 13,674 | 159.3 秒 | $0.4067 | $0.4067 |
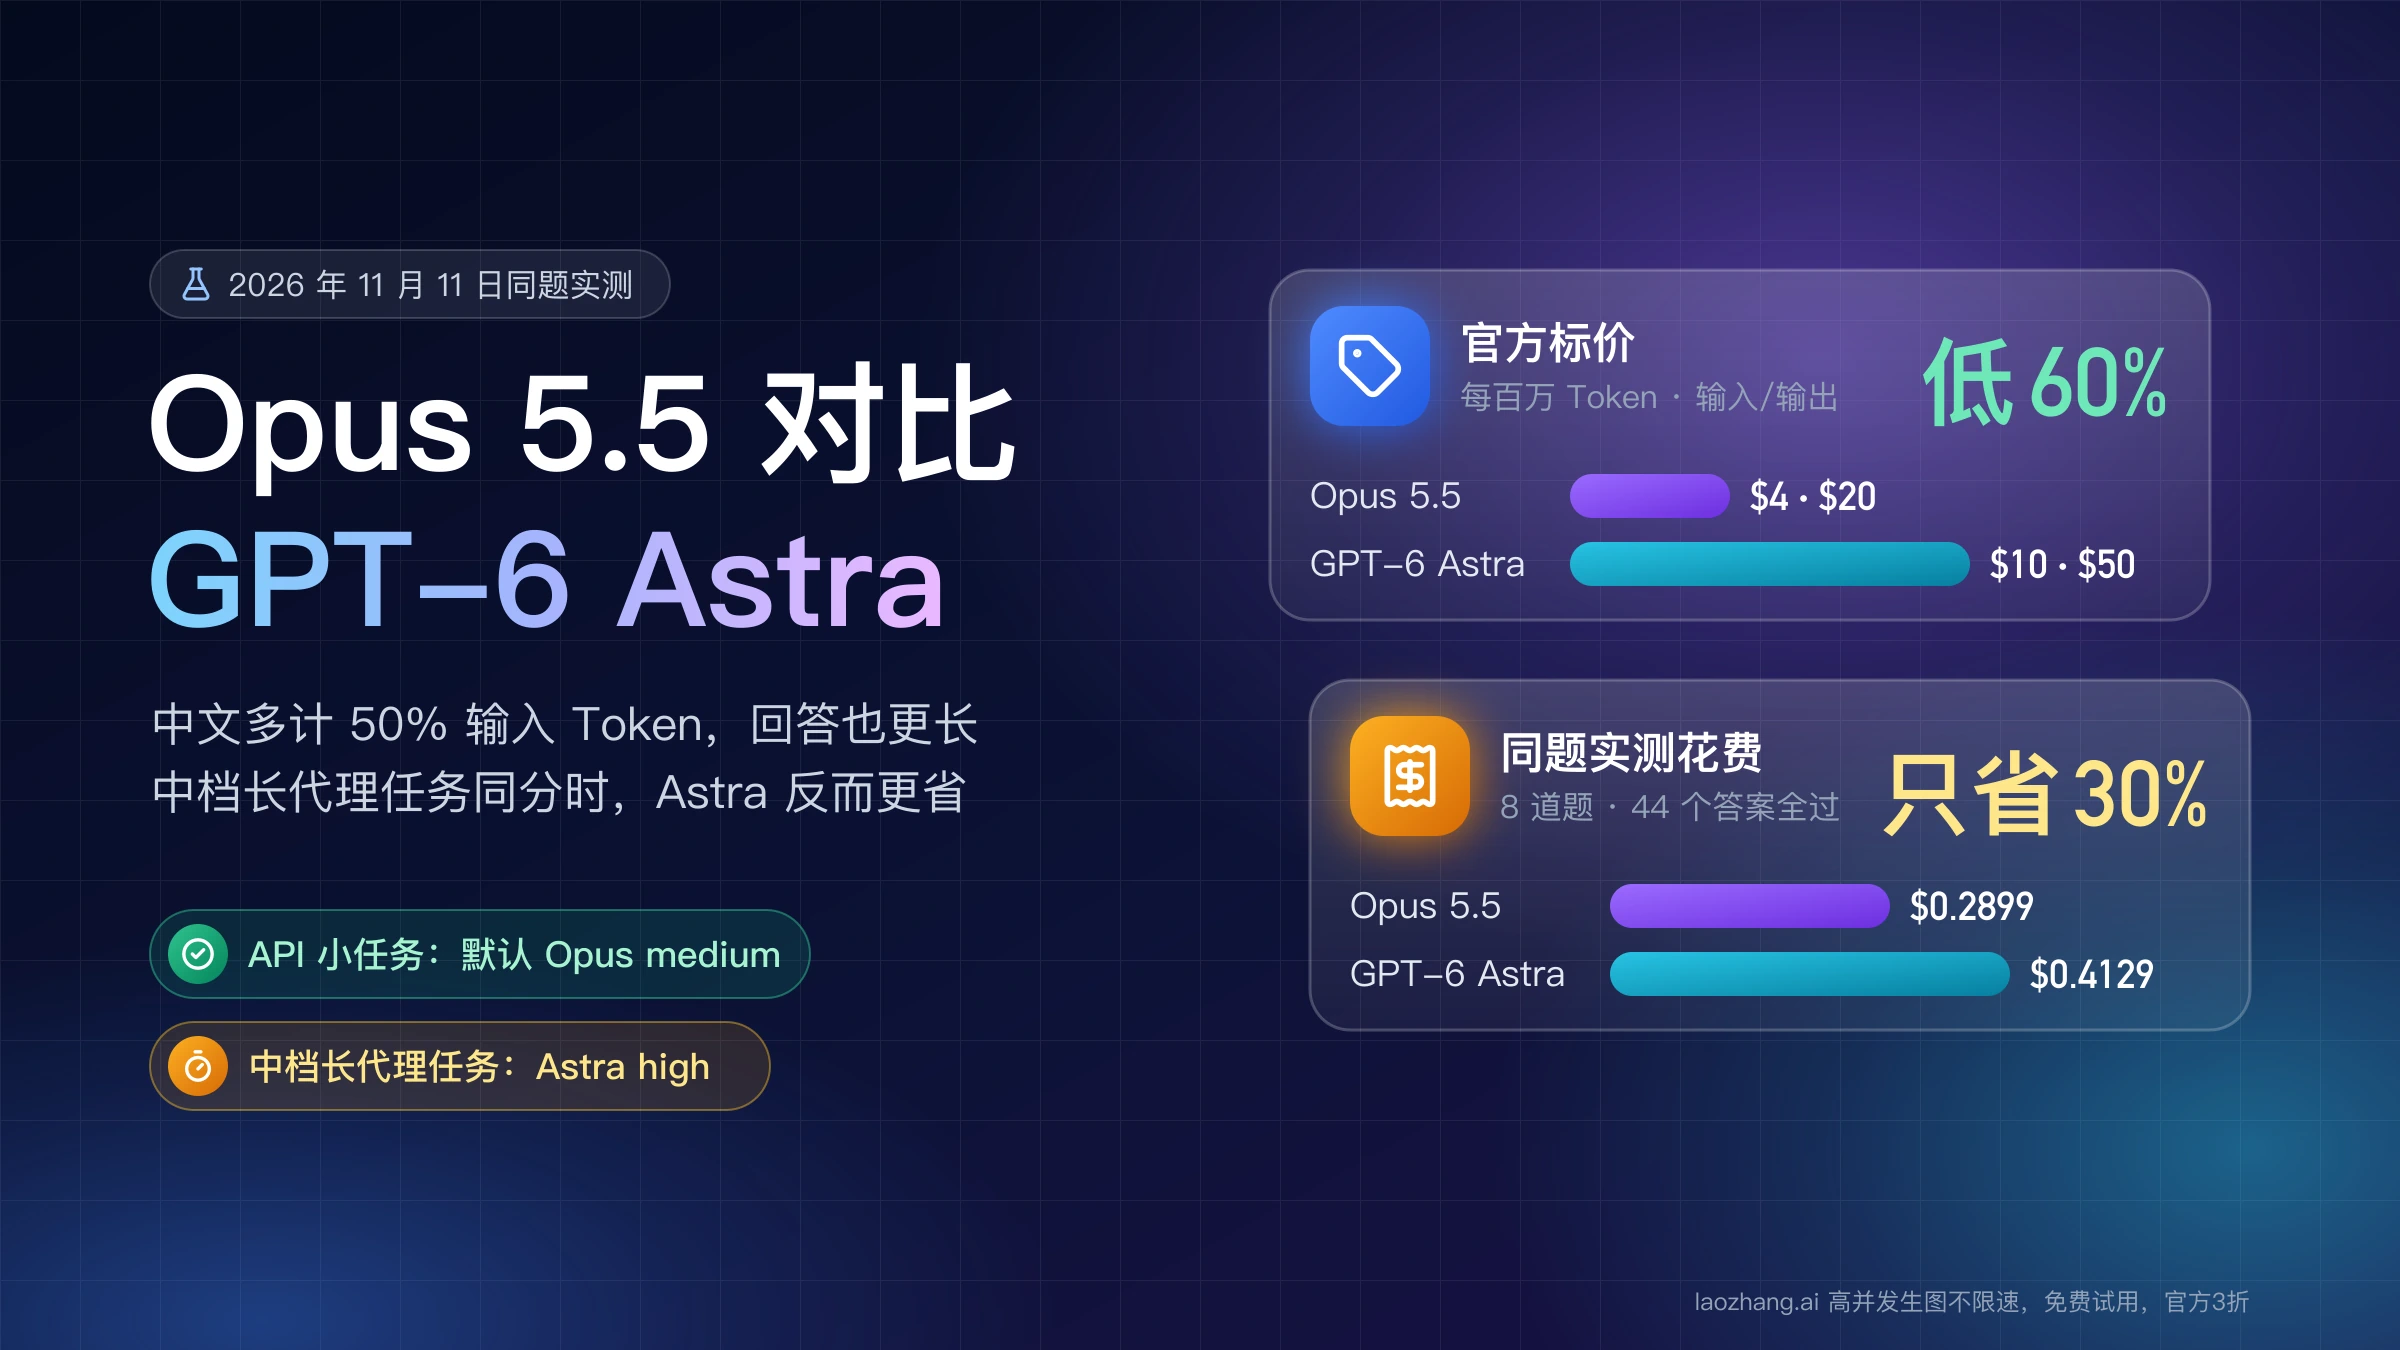
同为默认档,6.2 Sol 的输出 token 是 6.1 Sol 的 0.68 倍,耗时是 0.23 倍;同为 high,输出是 0.65 倍,耗时是 0.21 倍。花费要看最后一列:6.2 Sol 默认档在长文档那道题上读到了 10,103 个缓存 token,因为在它之前刚用 high 档发过同一个提示,所以按实际计费的 $0.0721 偏低;输入全按普通价算,6.2 Sol 默认档是 6.1 Sol 的 0.82 倍,high 是 0.76 倍,花费省两成左右,更大的差别在时间上。有的配置按实际计费反而比全按普通价贵,是因为首次写入缓存的单价 $2.50 高于普通输入的 $2.00。Opus 5.5 medium 对 6.2 Sol 默认档,输出 token 是 2.80 倍,耗时 2.19 倍,花费按实际计费是 5.13 倍,输入全按普通价是 4.29 倍。
这组数字能说明的范围有限。题目都不难,三款全过,所以它测的是速度、token 和花费,不是能力差距;每格只有一个样本;耗时是经网关的总时长,包括网络,不等于厂商自己的延迟;花费按返回的 usage 用标价算出,是估算。Opus 5.5 的 12 道题里有 8 道是 2026 年 11 月 11 日测的(流式),另外 4 道是 11 月 18 日补测(非流式);Opus 5.5 high 在区间合并题上是把函数和测试拆成两个文件后才通过的。6.1 Sol 为什么这么慢、怎么提速,见 GPT-6.1 Sol 很慢怎么办:先分清原因,降档实测耗时减半。
146 KB 日志计数:三款都对,Opus 5.5 多计 41% 的输入 token
另一道题是一份 146 KB、1,500 行的日志,要求数出 7 个精确数字。三款的默认档或 medium 都 7 个全对,结果如下。
| 配置 | 测试日期 | 输入 token | 输出 token | 耗时 | 花费 |
|---|---|---|---|---|---|
| GPT-6.2 Sol 默认 | 2026 年 11 月 18 日 | 55,843 | 1,845 | 13.6 秒 | $0.1581 |
| GPT-6.1 Sol 默认 | 2026 年 11 月 16 日 | 55,843 | 2,576 | 45.7 秒 | $0.1654 |
Claude Opus 5.5 medium | 2026 年 11 月 11 日 | 78,537 | 7,699 | 57.6 秒 | $0.4681 |
这道题里花费差得不多的两款 Sol,主要差在时间上:6.2 Sol 只用了 6.1 Sol 不到三分之一的时间。开到 high 也一样,6.2 Sol 17.3 秒、$0.1668,6.1 Sol 87.7 秒、$0.1983。更值得注意的是 Opus 5.5 那一行:同一份日志,Anthropic 计出的输入 token 是 OpenAI 的 1.41 倍(78,537 ÷ 55,843),所以 Opus 5.5 的输入单价虽然是 Sol 的 2 倍,落到这份日志上实际是 2 × 1.41 ≈ 2.8 倍。这份日志远小于 272K token,不涉及长上下文加价。
各档推理强度对照:6.2 Sol 每档都比 6.1 Sol 高 2–7 分
在 AA 智能指数 v5.0.1 上,同名推理强度下 6.2 Sol 每一档都比 6.1 Sol 分数高,低档高得多,max 只高 2 分。6.2 Sol 的数字截至 2026 年 11 月 18 日,取自 AA 的 Claude Opus 5.5 与 GPT-6.2 Sol 分档对比页;6.1 Sol 的各档是 11 月 4 日的读数(max 在 11 月 11 日复核),AA 现在已把 6.1 Sol 的对比页撤下。"每题"指跑一道指数题的平均成本,反映的是这套测试的工作量,不是你的账单。
| 推理强度 | GPT-6.1 Sol:分数 / 每题 | GPT-6.2 Sol:分数 / 每题 / 耗时 | 6.2 Sol 高出 |
|---|---|---|---|
low | 35 / $0.16 | 41 / $0.18 / 1.4 分钟 | 6 分 |
medium | 46 / $0.36 | 53 / $0.41 / 3.1 分钟 | 7 分 |
high | 50 / $0.59 | 55 / $0.56 / 4.2 分钟 | 5 分 |
xhigh | 52 / $0.76 | 56 / $0.65 / 5.1 分钟 | 4 分 |
max | 55 / $1.27 | 57 / $1.01 / 7.9 分钟 | 2 分 |
在 low 和 medium,6.2 Sol 每题反而贵 12% 到 14%,换来的是 6 到 7 分;从 high 往上,它分数更高、每题也更便宜。真正省钱的用法是降档:6.2 Sol medium 的 53 分已经高过 6.1 Sol xhigh 的 52 分,每题成本是后者的 54%;6.2 Sol high 和 6.1 Sol max 同为 55 分,每题 $0.56 对 $1.27。时间上差得更多,6.1 Sol max 每题要 20.1 分钟,6.2 Sol max 是 7.9 分钟。
11 月 9 日知乎专栏里流传的"6.2 Sol 拿到 60 分、压倒 Opus 5.5"是发布前预览期的说法;AA 在发布后公布的 6.2 Sol 最高分是 57,Opus 5.5 max 是 59。另外,AA 的模型列表里给 GPT-6.1 Sol 标了"deprecated",这是 AA 收录状态的标注,不是 OpenAI 的弃用公告。
"6.2 Sol 写代码不如 6.1"从哪来:编码代理榜 52.2 对 49.8
这个说法指的是 AA 的编码代理指数,而且只在最高档成立:Codex 搭配 6.2 Sol 的最好成绩比搭配 6.1 Sol max 低 2.4 分。这张榜和上一节的智能指数不是一回事,它把模型放进 Codex CLI(0.166.0)或 Claude Code 里跑完整的代理任务,题目来自 FrontierCode 2.0、SWE-Atlas QnA 和 Terminal-Bench v4,所以更接近"在 Codex 里连续干活"的体验。下表截至 2026 年 11 月 18 日,取自 AA 编码代理排行榜。
| 代理 + 模型 | 编码代理指数 | 每题花费 | 每题耗时 |
|---|---|---|---|
Codex + GPT-6.1 Sol max | 52.2 | $1.51 | 21.9 分钟 |
Codex + GPT-6.2 Sol low | 37.2 | $0.33 | 7.2 分钟 |
Codex + GPT-6.2 Sol medium | 45.4 | $0.57 | 8.4 分钟 |
Codex + GPT-6.2 Sol high | 47.5 | $0.76 | 10.6 分钟 |
Codex + GPT-6.2 Sol xhigh | 49.8 | $0.90 | 12.6 分钟 |
Codex + GPT-6.2 Sol max | 48.6 | $1.22 | 17.5 分钟 |
Claude Code + Claude Opus 5.5 max | 58.2 | $12.61 | 65.3 分钟 |
榜上 6.1 Sol 只有 max 一行,没法逐档比,所以能下的结论是:在长代理编码上,6.2 Sol 的上限比 6.1 Sol 低一点,但它用 xhigh 就到顶了,每题花费少 40%、耗时少 42%。6.2 Sol 的 max 反而比 xhigh 低 1.2 分、多花 36%,在 Codex 里开 max 不划算。如果你的代理任务恰好卡在那 2.4 分上,例如要连续改很多文件、跑很多轮测试才能收尾,就在自己的仓库上用 6.1 Sol max 和 6.2 Sol xhigh 各跑一批,按通过的任务数算每个合格结果的花费再决定。
社区的反应也是两边都有,以下只见到标题或摘要。Reddit r/codex 上一条标题为"Gpt 6.2 Astra is equivalent to 6 in coding, 6.2 Sol is worse than 6.1…"的帖子有 305 票;VentureBeat 的报道标题说 GPT-6.2 发布后在重度用户中口碑不佳,引用了"Essentially unusable"的说法;Hacker News 的发布讨论里有用户说,Sol 的花费从 6.1 的 $2.6 降到 6.2 的 $1.2,准确率相近,但"Opus 5.5 is just the better model"。
6.2 Sol 低档能打过 Opus 5.5 medium 吗:low 不能,medium 起反超
按 AA 智能指数 v5.0.1(截至 2026 年 11 月 18 日),6.2 Sol low 是 41 分,Opus 5.5 medium 是 48 分,低档打不过;但 6.2 Sol medium 已经是 53 分,高过 Opus 5.5 high 的 52 分,每题成本 $0.41 对 $3.46,Opus 5.5 是 8.4 倍,耗时 3.1 分钟对 9.3 分钟。AA 给 Opus 5.5 标的"Default Fallback"是它测试配置的标注,不是 Anthropic 提供的设置。
两边同为 57 分时,Opus 5.5 要开到 xhigh,每题 $6.05、15.6 分钟;6.2 Sol 要开到 max,每题 $1.01、7.9 分钟,Opus 5.5 的成本是 6.0 倍。6.2 Sol 够不着的是最顶端:Opus 5.5 max 是 59 分,两者各自开满时,Opus 5.5 在 HLE-Diamond 上 67.9% 对 64.0%,在 FrontierCode-AA 2.0 上 46.4% 对 44.4%;Terminal-Bench 4.0 上反而是 6.2 Sol 略高,60.1% 对 59.6%。
所以"比 Opus 便宜 10 倍"取决于拿哪两档比。按 token 单价只差 2 倍;同一份内容 Opus 5.5 计的 token 更多,推理时输出也更多,到每个任务上就拉开了:前面 12 道题的实测是 5.1 倍,AA 智能指数上真正同分(57 分)的一对是 6.0 倍,分数略高的 6.2 Sol medium 对 Opus 5.5 high 是 8.4 倍,编码代理榜上两边各自的最好成绩之间是 14 倍。把原来交给 Opus 5.5 的活改给 6.2 Sol,损失的是顶端那几分,在编码代理榜上是 58.2 对 49.8;三款都能做对的单轮任务、日志和文档分析,这几分换不来什么。上一代 Sol 与 Opus 5.5 怎么按合格交付算成本,见 Claude Opus 5.5 对比 GPT-6 Sol 与 6.1 Sol:先看任务,再算合格交付成本。
6.2 Sol 和 6.1 Sol 价格一样吗:标准价相同,差在 Ultrafast 和后台折扣
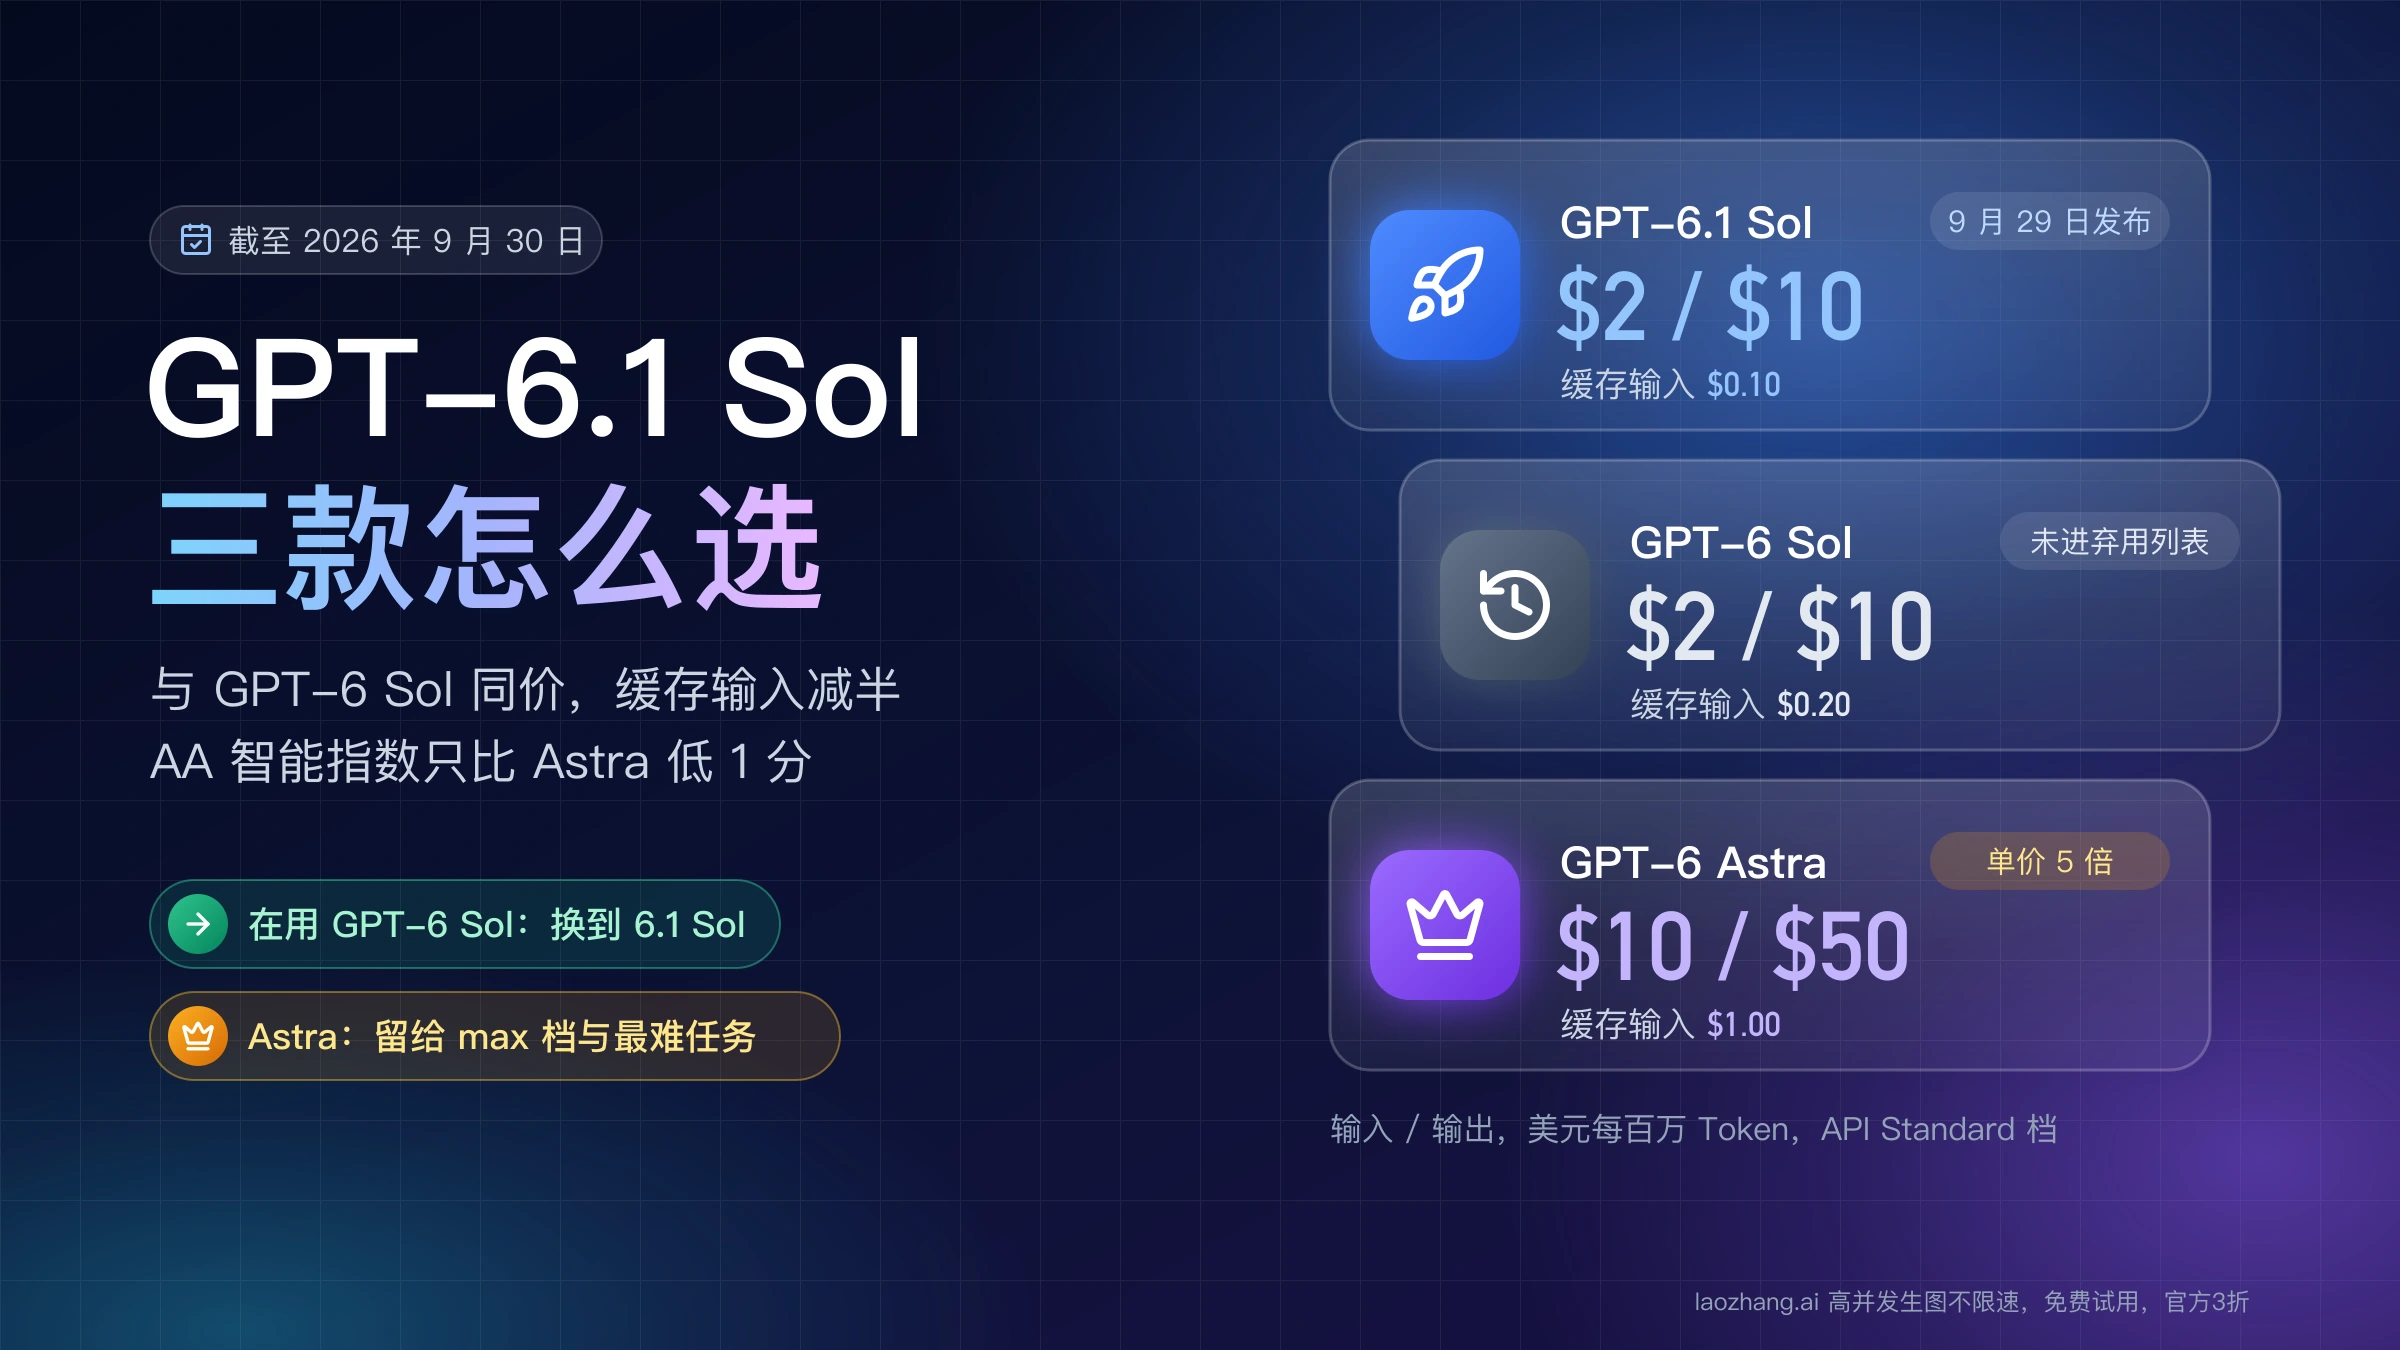
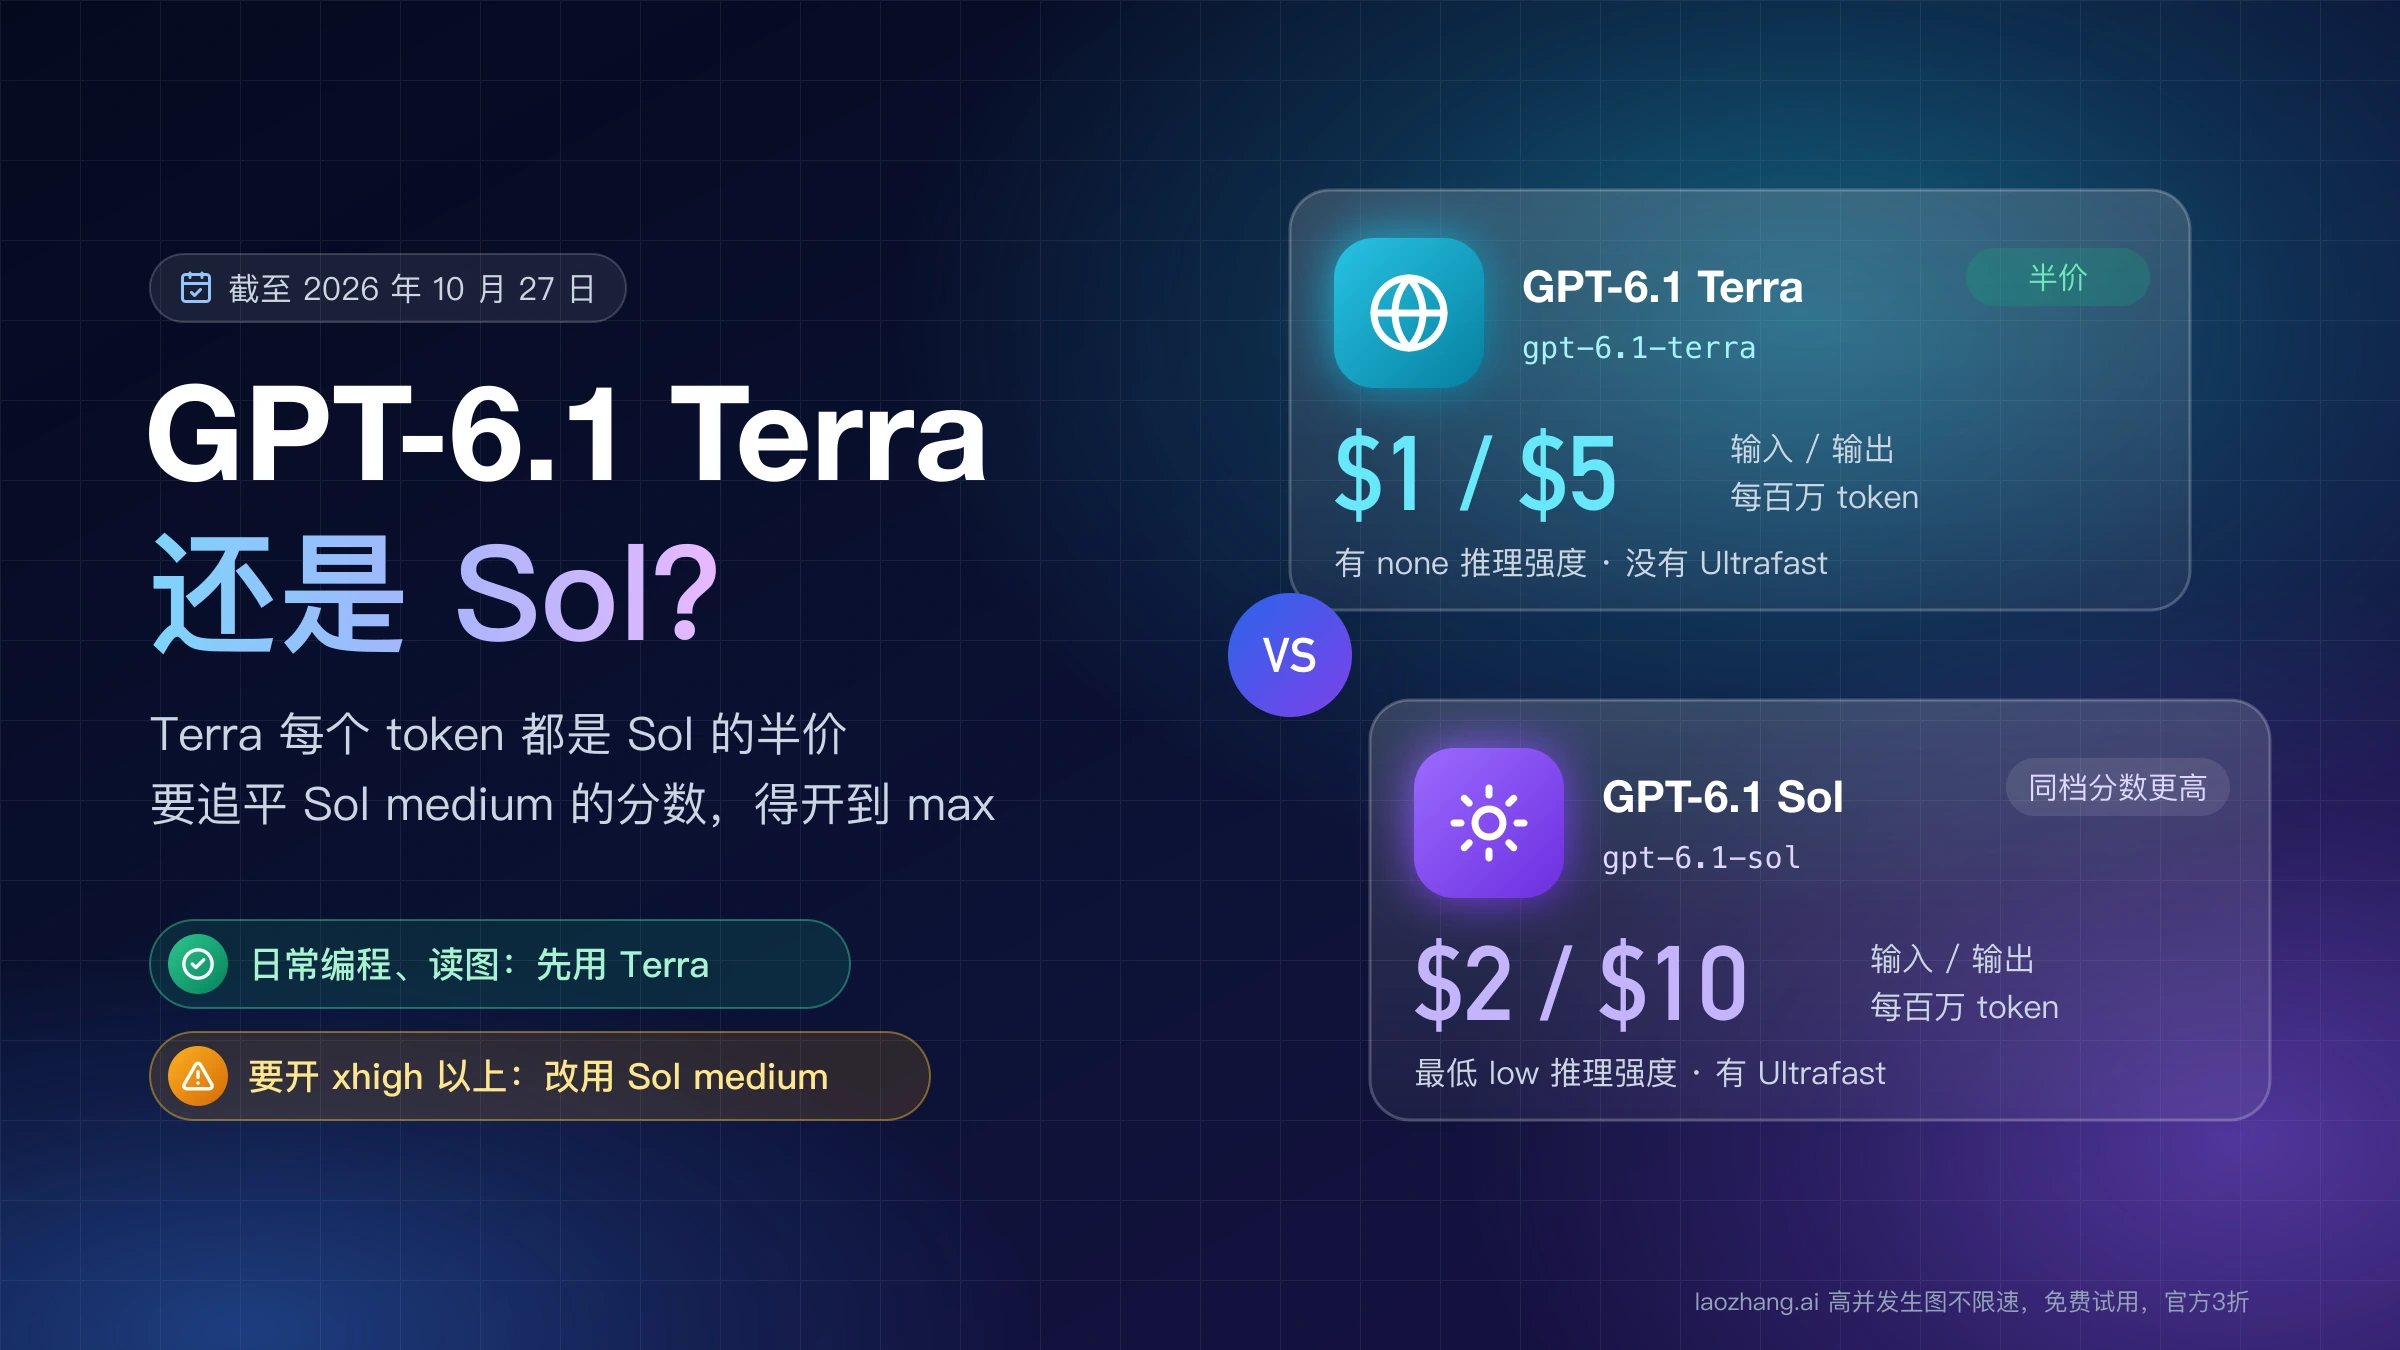
一样。截至 2026 年 11 月 18 日,OpenAI API 定价页上 gpt-6.2-sol 和 gpt-6.1-sol 的标准价完全相同:每百万 token 输入 $2.00、缓存读取 $0.10、输出 $10.00,30 分钟和 12 小时缓存写入 $2.50 和 $5.00,Batch 半价,Fast 2 倍。两处不同只影响用加速档或后台任务的人。Ultrafast 上 6.1 Sol 是标准价的 6 倍($12 / $60),6.2 Sol 到 2027 年 2 月 28 日只收 3 倍($6 / $30),3 月 1 日起同样是 6 倍;后台完成窗口折扣(2 小时窗口 7 折、8 小时窗口 6 折)列了 6.2 Sol,没有列 6.1 Sol。
按 GPT-6.2 Sol 模型页,单次输入超过 272K token 时,整次请求的输入和缓存按 2 倍、输出按 1.5 倍计费,即输入 $4、输出 $15。6.2 Sol 的上下文窗口是 1,050,000 token,单次输入最多 922,000、输出最多 128,000,知识截止 2026 年 6 月 1 日;6.1 Sol 的知识截止是 2026 年 4 月 30 日。
Claude Opus 5.5 按 Anthropic 定价页是输入 $4、输出 $20,缓存读取 $0.20,5 分钟缓存写入 $5、1 小时缓存写入 $8,Batch $2 / $10,整个 1M 上下文都按这一价,没有长上下文分段。也就是说,在 272K 以内 Opus 5.5 每个 token 都是 Sol 的 2 倍;超过 272K 后两者输入单价同为 $4,输出 $20 对 $15,Opus 5.5 仍然更贵。
从 6.1 Sol 或 Opus 5.5 切到 6.2 Sol:请求里要改的地方
只改模型名,多数请求就能跑通;下面几处不改,会直接报错、缓存失效或悄悄变差。依据是 OpenAI 的最新模型迁移指南和 2026 年 11 月 18 日经 laozhang.ai 网关的接入测试。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
- 检查有没有代码会把
none发给 6.2 Sol。6.1 Sol 本来也只接受low到max,从 6.1 Sol 直接换过来不受影响;会出问题的是多个模型共用一份配置,或为其他接受none的模型写的代码改了模型名。6.2 Sol 只接受low、medium、high、xhigh、max,传none会返回 400:Unsupported value: 'none' is not supported with the 'gpt-6.2-sol' model. Supported values are: 'low', 'medium', 'high', 'xhigh', and 'max'.原来用none或minimal的改成low;新接入从medium开始。 - 要用
max就走 Responses API。11 月 18 日经 laozhang.ai 的 Chat Completions 传reasoning_effort: max不成功,同样的设置在 Responses API 的reasoning.effort里可用。 - 把可复用的长指令挪进 input 的第一条 developer 消息。从 GPT-6.2 起,Responses API 会把顶层
instructions追加在 input 之后,放在那里的内容不再能命中提示缓存。11 月 18 日的测试里,一段约 9,000 token 的顶层instructions连发 3 次,缓存命中都是 0,直连 OpenAI 结果相同。 - 工具调用用 Responses API。OpenAI 的更新日志写明 GPT-6.2 的工具调用需要 Responses API;同一天经 laozhang.ai 的 Chat Completions 带工具的请求虽然返回了 200,按官方要求迁过去更稳妥。
- 用 Chat Completions 的,去掉
temperature、top_p、logprobs和top_logprobs。 - 不要在对话中途改历史或换模型。从 GPT-6.2 起,中途编辑对话历史、切换模型(包括降级)、更换终端用户或组织,Responses API 都会丢掉之前的推理内容,回答质量可能下降,token 也会变多。想拿 6.1 Sol 对照,就新开对话。
经 Chat Completions 调用时,6.2 Sol 返回的 model 字段是 gpt-6.2-sol-2026-11-17。OpenAI 的模型页没有列出带日期的快照 ID,所以不要把这个名字当成可以固定的版本写进配置,请求里仍写 gpt-6.2-sol。
GPT-6.2 Sol、6.1 Sol 与 Opus 5.5 的其他问题
GPT-6.1 Sol 会下线吗? 截至 2026 年 11 月 18 日,gpt-6.1-sol 仍在 OpenAI 的 API 价目表上,更新日志里也没有它的停用日期。有第三方报道称 6.2 Sol 已在 ChatGPT 工作模式和 Codex 里取代 6.1 Sol 成为默认;6.1 Sol 在这两个产品里还能不能手动选,OpenAI 的更新日志和定价页都没有写,以 Codex 和 ChatGPT 当日的模型列表为准。
GPT-6.2 Sol 和 GPT-6.2 Astra 是什么关系? 两者同日发布,OpenAI 把 Astra 定位为要求最高的推理和编码任务,把 Sol 定位为日常编码和代理工作流;Astra 每百万 token 输入 $8、输出 $40,是 Sol 的 4 倍。
还在用 GPT-6 Sol,能直接换到 6.2 Sol 吗? 可以,"请求里要改的地方"一节的改动同样适用,none 推理强度要改成 low。GPT-6 Sol 到 6.1 Sol 那一步改了哪些参数和缓存价,见 GPT-6.1 Sol 怎么用:价格变化、迁移改动与可用入口。
Claude Opus 5.5 从哪里用? 各个使用入口的门槛和免费试用条件,见 Claude Opus 5.5 怎么用:6 个入口怎么选,免费只有限时限额试用。
参考来源6
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年11月18日。
参考来源6
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年11月18日。
- 1.AA 的 Claude Opus 5.5 与 GPT-6.2 Sol 分档对比页artificialanalysis.ai/models/releases/comparisons/claude-opus-5-5-vs-gpt-6-2-sol
- 2.AA 编码代理排行榜artificialanalysis.ai/agents/coding
- 3.OpenAI API 定价页developers.openai.com/api/docs/pricing
- 4.GPT-6.2 Sol 模型页developers.openai.com/api/docs/models/gpt-6.2-sol
- 5.Anthropic 定价页platform.claude.com/docs/en/about-claude/pricing
- 6.OpenAI 的最新模型迁移指南developers.openai.com/api/docs/guides/latest-model