GPT-6.1 Terra 和 Sol 区别:Codex 实测用时减半,要高分时 Sol 更省
GPT-6.1 Terra 每个 token 都是 Sol 的半价,日常编程、读图和额度紧的 Codex 先用它;要开到 xhigh 以上的难活,Sol medium 更省更快。
文章目录
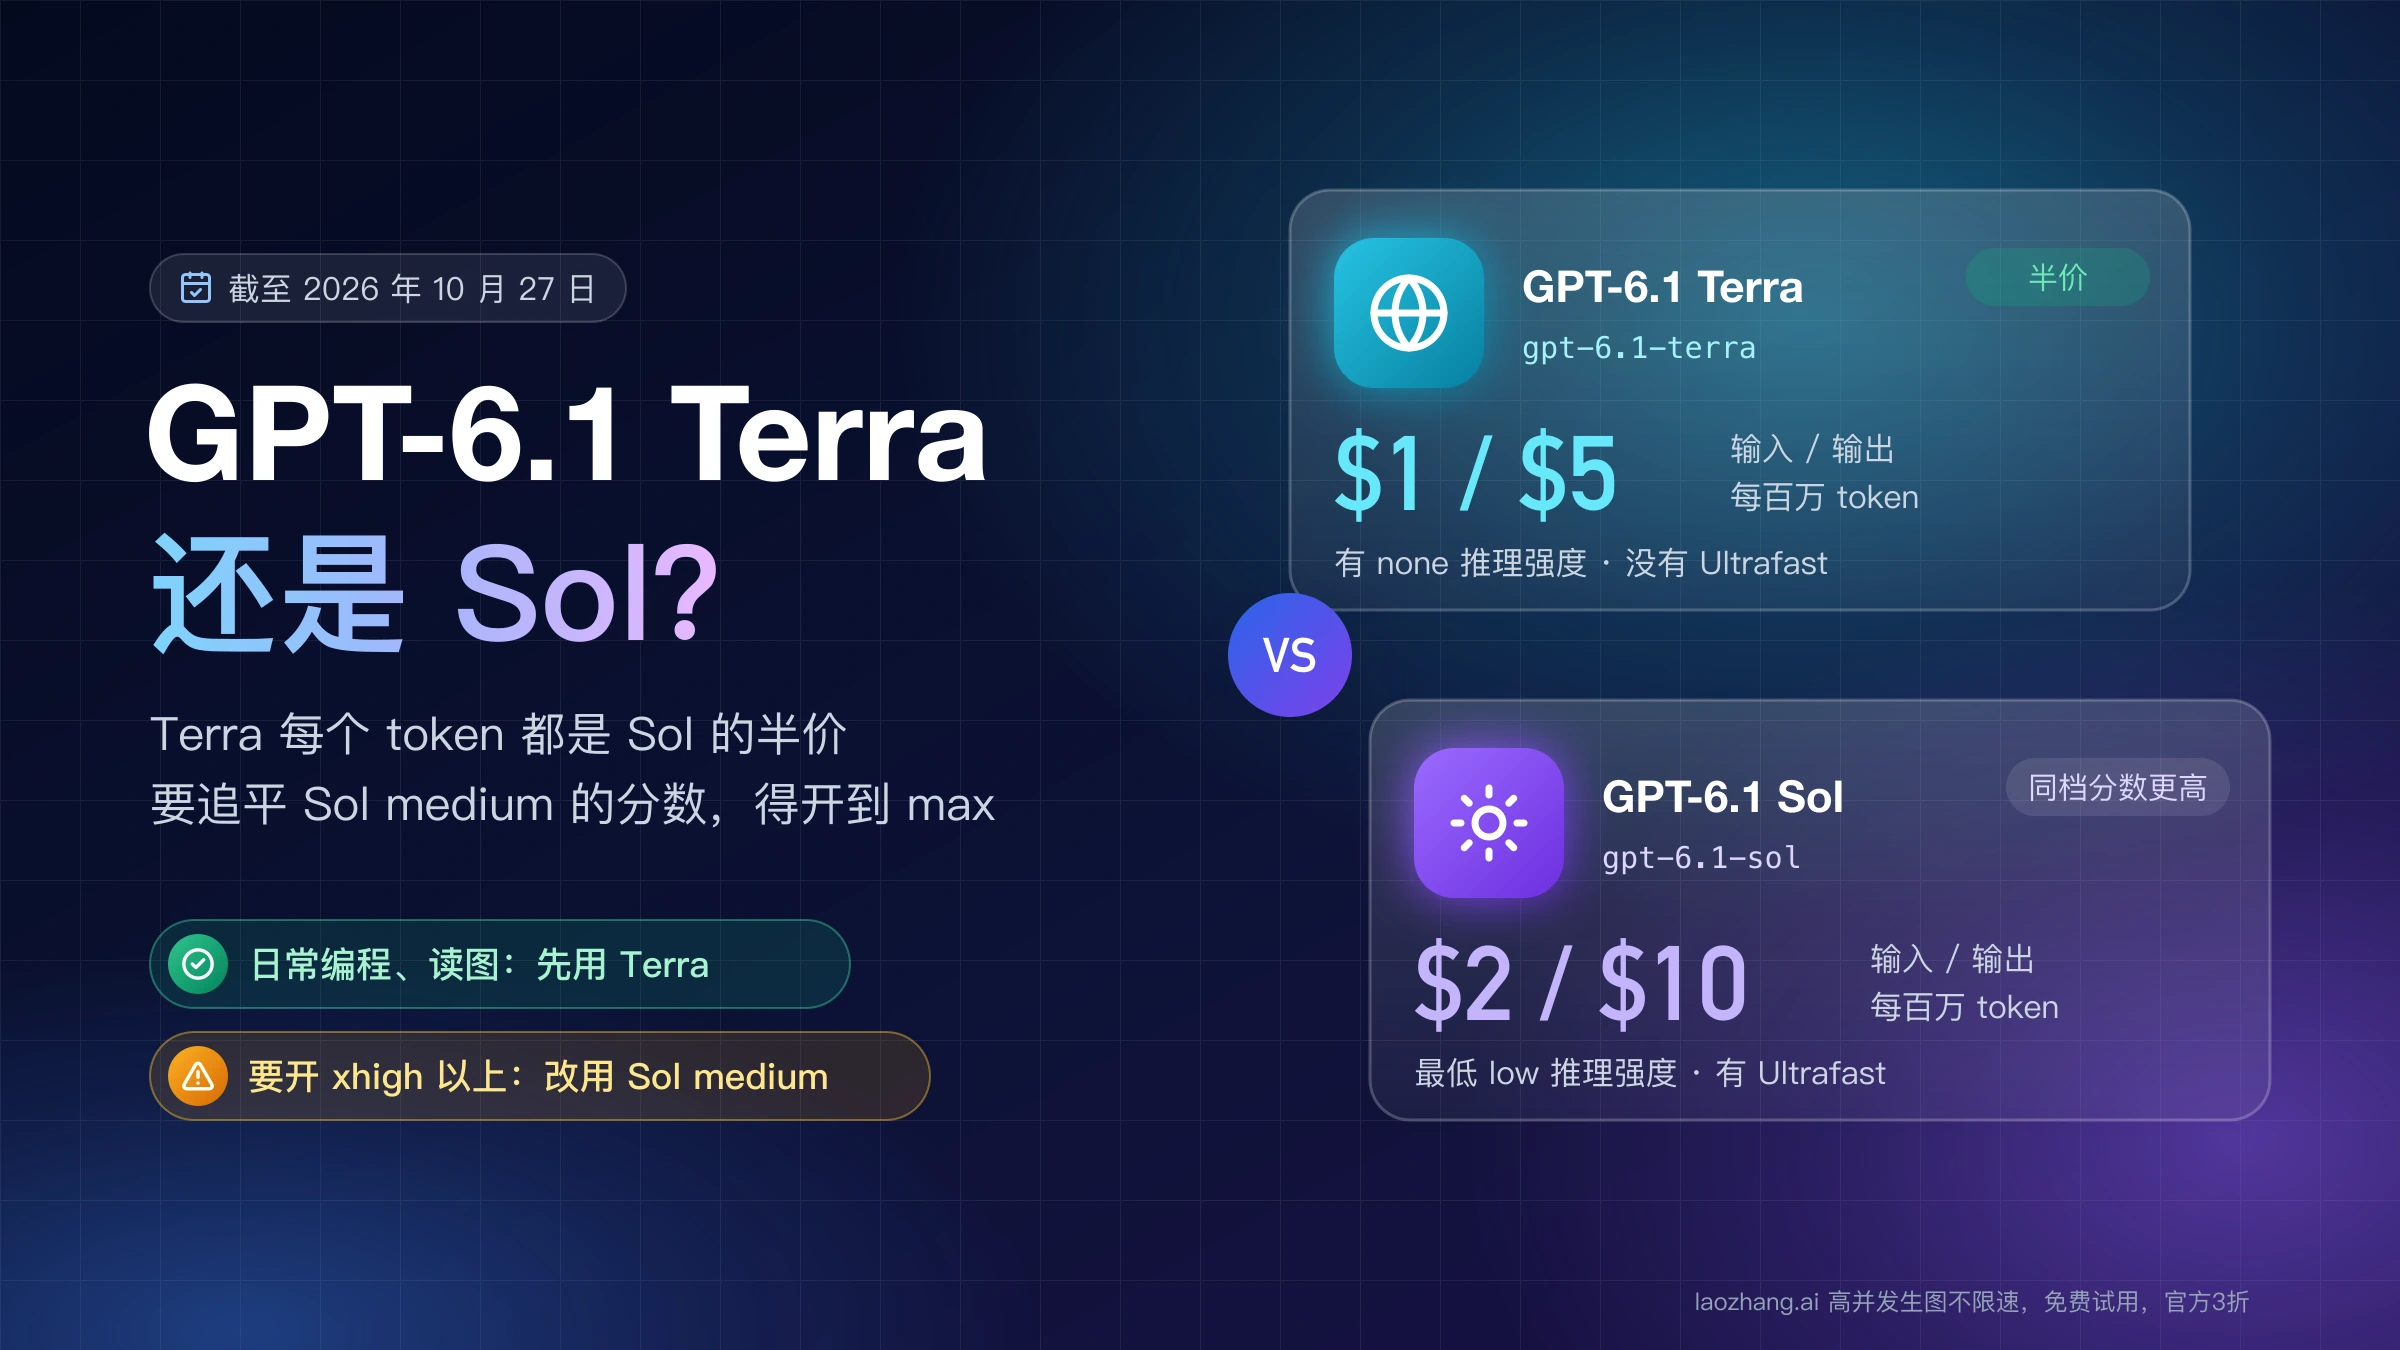
OpenAI 在 2026 年 10 月 26 日发布了 GPT-6.1 Terra(模型 ID gpt-6.1-terra)。它和 9 月 29 日发布的 GPT-6.1 Sol 规格几乎一样,上下文都是 105 万 token,区别在价钱和能力档位:截至 2026 年 10 月 27 日,Terra 的 API 单价和 Codex credits 费率每一栏都正好是 Sol 的一半,但同一推理强度下 Sol 的分数更高。所以"半价、快三倍"和"Sol 分数更高"两种说法都对,答案取决于你拿哪一档去比。
如果你的活是日常编程和 agent 任务、读发票表格或做计算机操作,或者 Codex 套餐额度总是不够用,就在 Codex 里用 codex -m gpt-6.1-terra 切过去,从 low 或 medium 推理强度开始试。2026 年 10 月 27 日用 Codex CLI 在三个小任务上跑了 17 次,两款模型全部通过;同为 medium 时,Sol 的合计用时是 Terra 的 2.0 倍,折算 credits 是 2.4 倍。难的多步编程留在 gpt-6.1-sol 的 medium:Terra 要开到 max 才追平 Sol medium 的分数,这时单任务成本反而是 Sol 的约 1.9 倍。
有几条限制会直接替你做决定。需要 Ultrafast 只能用 Sol,Terra 没有这一档;需要 none 推理强度只能用 Terra,Sol 最低是 low;两款都只在 ChatGPT 工作和 Codex 里,ChatGPT 普通聊天里都没有;Terra 还不支持阿联酋推理数据驻留,Sol 的定价文档没有写这条限制,有这项合规要求的先向 OpenAI 确认。
该先试哪个:按你的活选模型和推理强度
Terra 能覆盖的范围比"便宜的小模型"宽得多,日常编程、读图和计算机操作都可以先交给它的 low 或 medium;换回 Sol 的信号是 Terra 要开到 xhigh 以上才做得好。下表的起点来自 Artificial Analysis(以下简称 AA)的分档数据、OpenAI 的发布说明和 2026 年 10 月 27 日的 Codex 实测,依据在后面各节展开。
| 你的活 | 先试 | 什么时候换 |
|---|---|---|
| 日常编程、修 bug、按规格实现功能、常规 agent 任务 | Terra low 或 medium | 通过率掉下来,或者要开到 xhigh、max 才过,就换 Sol medium |
| 读发票、表格、图表,填表单,计算机操作 | Terra medium,大批量抽取再试 low | 结果要靠模型自己的知识判断对错时,拿 Sol 对照一轮 |
| 难的多步编程、长链路终端任务 | Sol medium,不够再 high | Terra max 在 AA 的 Terminal-Bench 4.0 上接近 Sol max,但同为 medium 时差 15.7 个百分点 |
| Codex 套餐额度紧张 | Terra | Plus 每 5 小时的本地消息估计是 35–285 条,Sol 是 15–160 条 |
| 不联网、靠模型自身知识回答事实问题 | Sol | AA-Omniscience 知识与幻觉指数里 Sol 各档 38–42,Terra 4–30 |
| 需要 API 或 Codex 的 Ultrafast | Sol | Terra 没有 Ultrafast |
现有请求写死了 none 推理强度 | Terra | Sol 最低是 low,搬过去会多出推理 token;但 none 不一定比 low 省,见下文 |
这里的"换"不必一次全量切。除了 none 和 Ultrafast,两款的 API 参数、上下文和工具都一样,可以按任务类型分流,简单活走 Terra、难活走 Sol,成本和质量各取所需。
两款的规格区别:只有 Terra 有 none,只有 Sol 有 Ultrafast
从 Sol 换到 Terra,API 请求通常只改一个模型名。按 OpenAI 的 GPT-6.1 Terra 模型页和模型总览页,两款的上下文窗口都是 1,050,000 token,单次最多输出 128,000 token,都支持文本和图片输入、文本输出,工具都包括函数调用、网页搜索、文件搜索和计算机操作,工具调用都要走 Responses API。
真正的差别有三处。第一是推理强度范围:Terra 支持 none、low、medium(默认)、high、xhigh、max,Sol 从 low 开始,没有 none,所以靠 none 压延迟的工作负载搬不到 Sol 上。第二是知识截止:Terra 是 2026 年 6 月 1 日,Sol 是 2026 年 4 月 30 日,Terra 新一个月。第三是速度档:Sol 有 Ultrafast,Terra 在 API 定价表的 Ultrafast 部分没有这一行;Sol 在 Codex 里的 Ultrafast 只对 Pro $500 和符合条件的 Enterprise、Edu 方案开放。
还有一个容易混的名字。GPT-5.6 Terra 仍在销售,单说"Terra"可能指两代模型中的任何一个,查价格、看评测、选模型时都要认准 GPT-6.1 Terra 和 gpt-6.1-terra;两代的区别见最后一节的问答。
价格差多少:每一栏都是一半,Ultrafast 只有 Sol
按 OpenAI API 定价页,截至 2026 年 10 月 27 日,GPT-6.1 Terra 在每一个计价项上都正好是 GPT-6.1 Sol 的一半,包括缓存输入和两档缓存写入。下表是美元 / 每百万 token。
| 计价项 | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|
| 输入 | $1.00 | $2.00 |
| 缓存输入 | $0.05 | $0.10 |
| 缓存写入(30 分钟) | $1.25 | $2.50 |
| 缓存写入(12 小时) | $2.50 | $5.00 |
| 输出 | $5.00 | $10.00 |
| 输入超过 272K:输入 / 缓存输入 / 输出 | $2.00 / $0.10 / $7.50 | $4.00 / $0.20 / $15.00 |
| Batch、Flex:输入 / 输出 | $0.50 / $2.50 | $1.00 / $5.00 |
| Fast:输入 / 输出 | $2.00 / $10.00 | $4.00 / $20.00 |
| Ultrafast:输入 / 输出 | 没有 | $12.00 / $60.00 |
前五行是 Standard 档、单次输入不超过 272K token 的价格。输入一旦超过 272K,整次请求都按长上下文价计费,两款的缓存写入也同步翻倍(Terra $2.50 / $5.00,Sol $5.00 / $10.00)。Batch 和 Flex 是 Standard 的一半,Fast 是 2 倍,区域处理端点两款都另加 10%。Sol 的 Ultrafast 缓存输入 $0.60、缓存写入 $15 和 $30;缓存写入和长上下文怎么叠加,算法和 GPT-6 Astra API 定价与成本计算:价格表、272K 与两档缓存写入里讲的相同。
所以按 token 算不需要任何计算:同一笔请求、同样的 token 数,Terra 的账单就是 Sol 的一半。问题在于两款完成同一个任务用的 token 数和推理强度并不一样,这是下一节要算的。
按任务算 Terra 一定更便宜吗:到 max 才比 Sol 贵
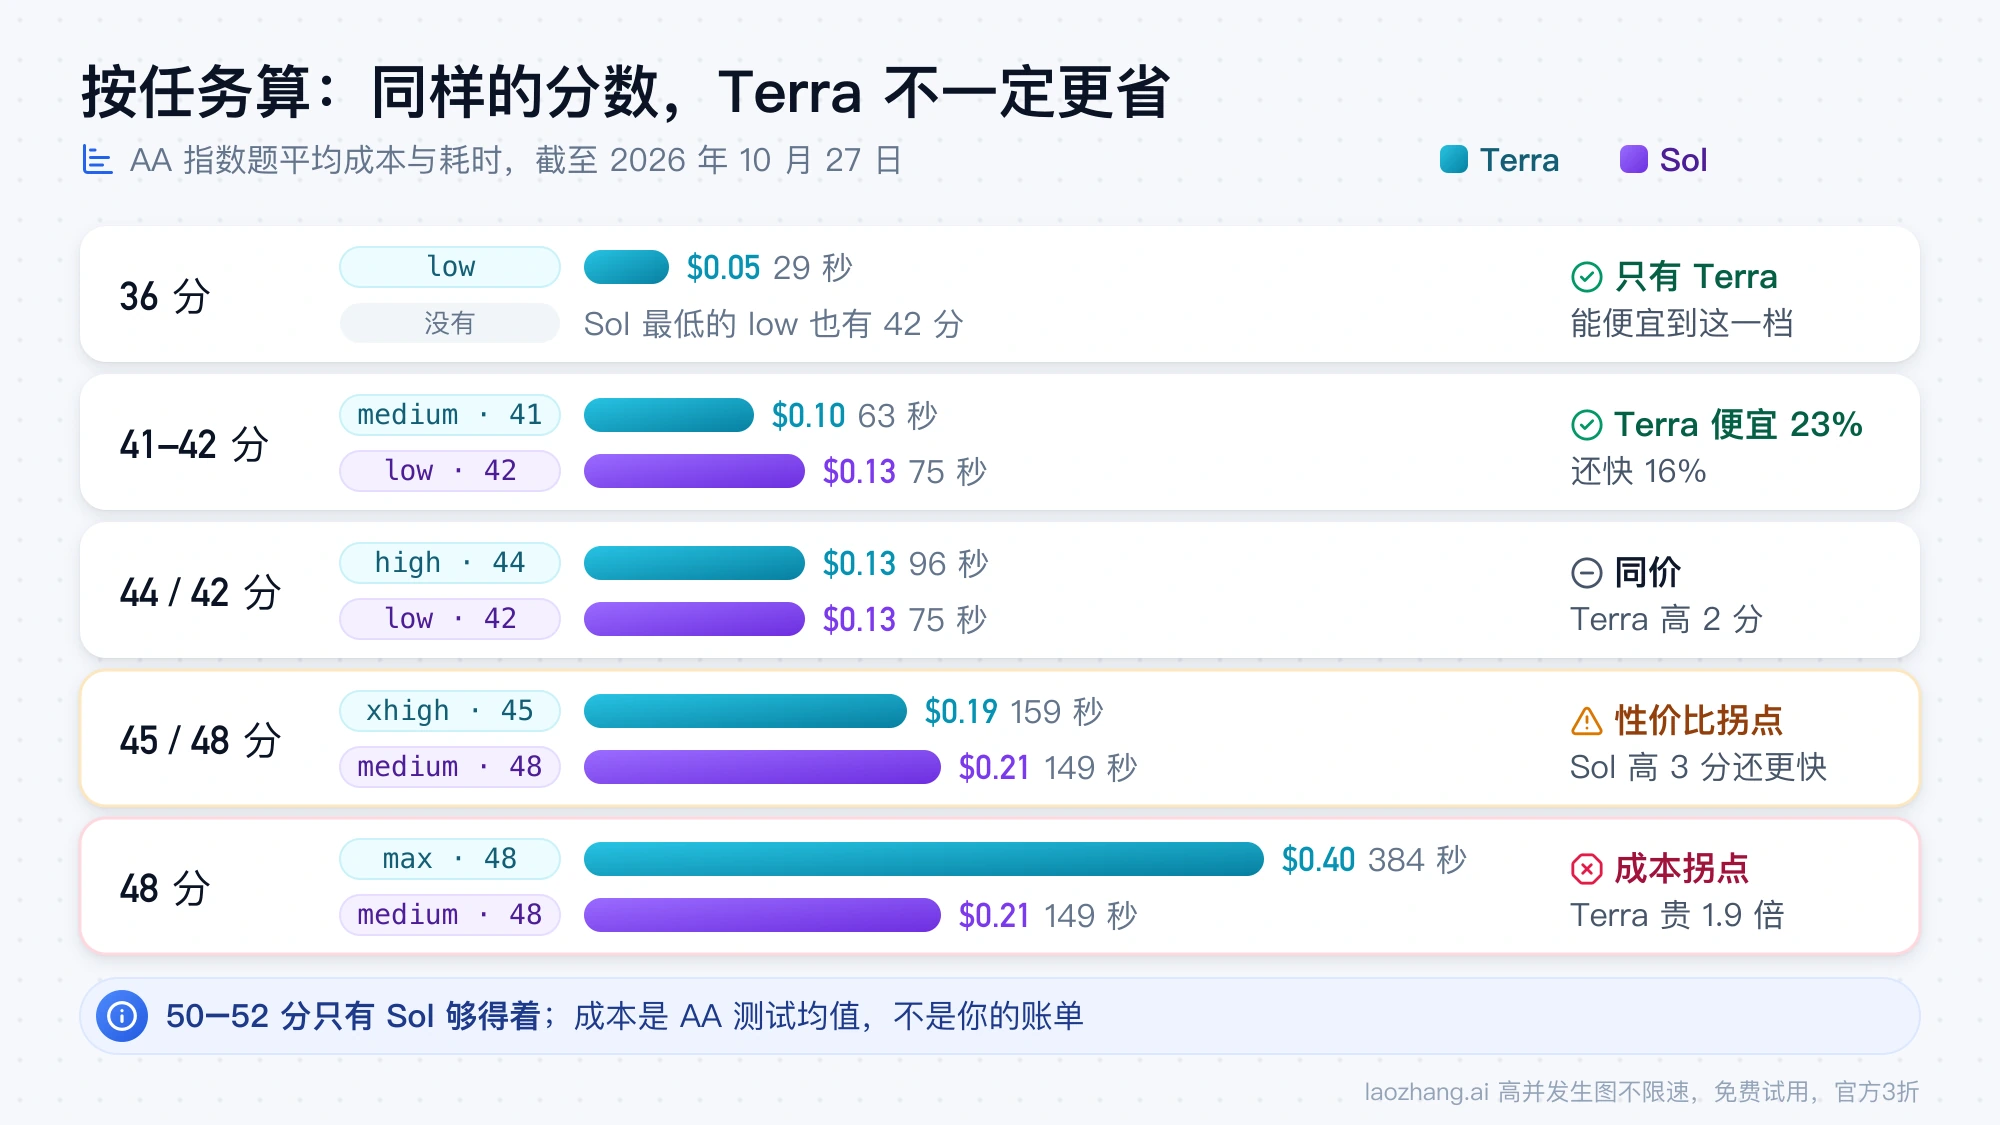
不一定。在低档和中档,Terra 达到同样分数确实更便宜也更快;到 xhigh,Terra 每道题仍比 Sol medium 便宜 $0.02,但分数低 3 分、还更慢;到 max,单任务成本才真正反转,Terra 比同分的 Sol medium 贵约 1.9 倍。依据是 AA 截至 2026 年 10 月 27 日的 GPT-6.1 Terra 与 GPT-6.1 Sol 分档对比页:每一档都有智能指数(v4.3.2,10 项评测合成)、跑一道指数题的平均成本和耗时。
下表把分数相近的档位并排。成本和耗时是 AA 指数题的平均值,反映这套测试的工作量,不是你的账单。
| 分数段 | GPT-6.1 Terra | GPT-6.1 Sol | 结论 |
|---|---|---|---|
| 36 分 | low:$0.05,29 秒 | 没有对应档,Sol 最低的 low 是 42 分 | 只有 Terra 能做到这么便宜 |
| 41–42 分 | medium 41 分:$0.10,63 秒 | low 42 分:$0.13,75 秒 | Terra 便宜 23%,快 16% |
| 44 对 42 分 | high 44 分:$0.13,96 秒 | low 42 分:$0.13,75 秒 | 同价,Terra 高 2 分,Sol 快 21 秒 |
| 45 对 48 分 | xhigh 45 分:$0.19,159 秒 | medium 48 分:$0.21,149 秒 | Sol 多花 $0.02,高 3 分还更快 |
| 48 分 | max 48 分:$0.40,384 秒 | medium 48 分:$0.21,149 秒 | Sol 成本只有 Terra 的 53%,用时是 Terra 的 39% |
| 50–52 分 | 没有 | high 50、xhigh 51、max 52 | 只有 Sol 够得着 |
xhigh 是性价比的拐点,max 是成本的拐点。Terra xhigh 的 45 分比 Sol medium 低 3 分,钱只省 $0.02、时间还慢 10 秒;到 max 两边同为 48 分,Terra 一道题 $0.40、384 秒,Sol medium 只要 $0.21、149 秒,也就是 Terra 贵 1.9 倍、慢 2.6 倍。换句话说,如果你发现 Terra 要开到 xhigh 或 max 才能把你的活做好,直接改用 Sol medium。
none 也不是自动最省。AA 测得 Terra none 是 33 分、$0.11、52 秒,比 Terra low 的 36 分、$0.05、29 秒更贵也更慢;2026 年 10 月 27 日的读图实测里,none 也比 medium 多读了近一倍的输入 token,折算 credits 反而略高。none 的用处是完全不产生推理 token,适合已经按 none 调好的现有请求;要省钱、要快,先试 low。
AA 指数是 10 项评测的合成分,具体到你的任务,排序可能不同。表里给的是该从哪一档试起,最后要用你自己的任务按"每个被接受结果的成本"确认,算法在后面一节。
"快三倍"快在哪:任务耗时、吐字速度和实测是三回事
"快三倍以上"是 OpenAI 在 GPT-6.1 Terra 发布文章里讲计算机操作基准 Agents' Last Exam 时的说法,指完成任务的速度是 GPT-6 Astra 和 GPT-6.1 Sol 的三倍以上,比的是做完一件事的时间,不是每秒吐出多少字,也不代表所有任务都快三倍。
吐字速度要看 AA。截至 2026 年 10 月 27 日,AA 测得 Terra 各档输出约每秒 91 个 token,Sol 从 low 到 max 是每秒 54–73 个,单论吐字 Terra 快 1.2–1.7 倍。完成任务的耗时差距更大,因为 Terra 同档输出的 token 更少:同一推理强度下,AA 每道指数题 Terra 比 Sol 快 1.4–2.6 倍,low 是 29 秒对 75 秒,medium 是 63 秒对 149 秒,max 是 384 秒对 527 秒。但要是让 Terra 开到 max 去追 Sol medium 的分数,它就从快变成慢,耗时是 Sol 的 2.6 倍。
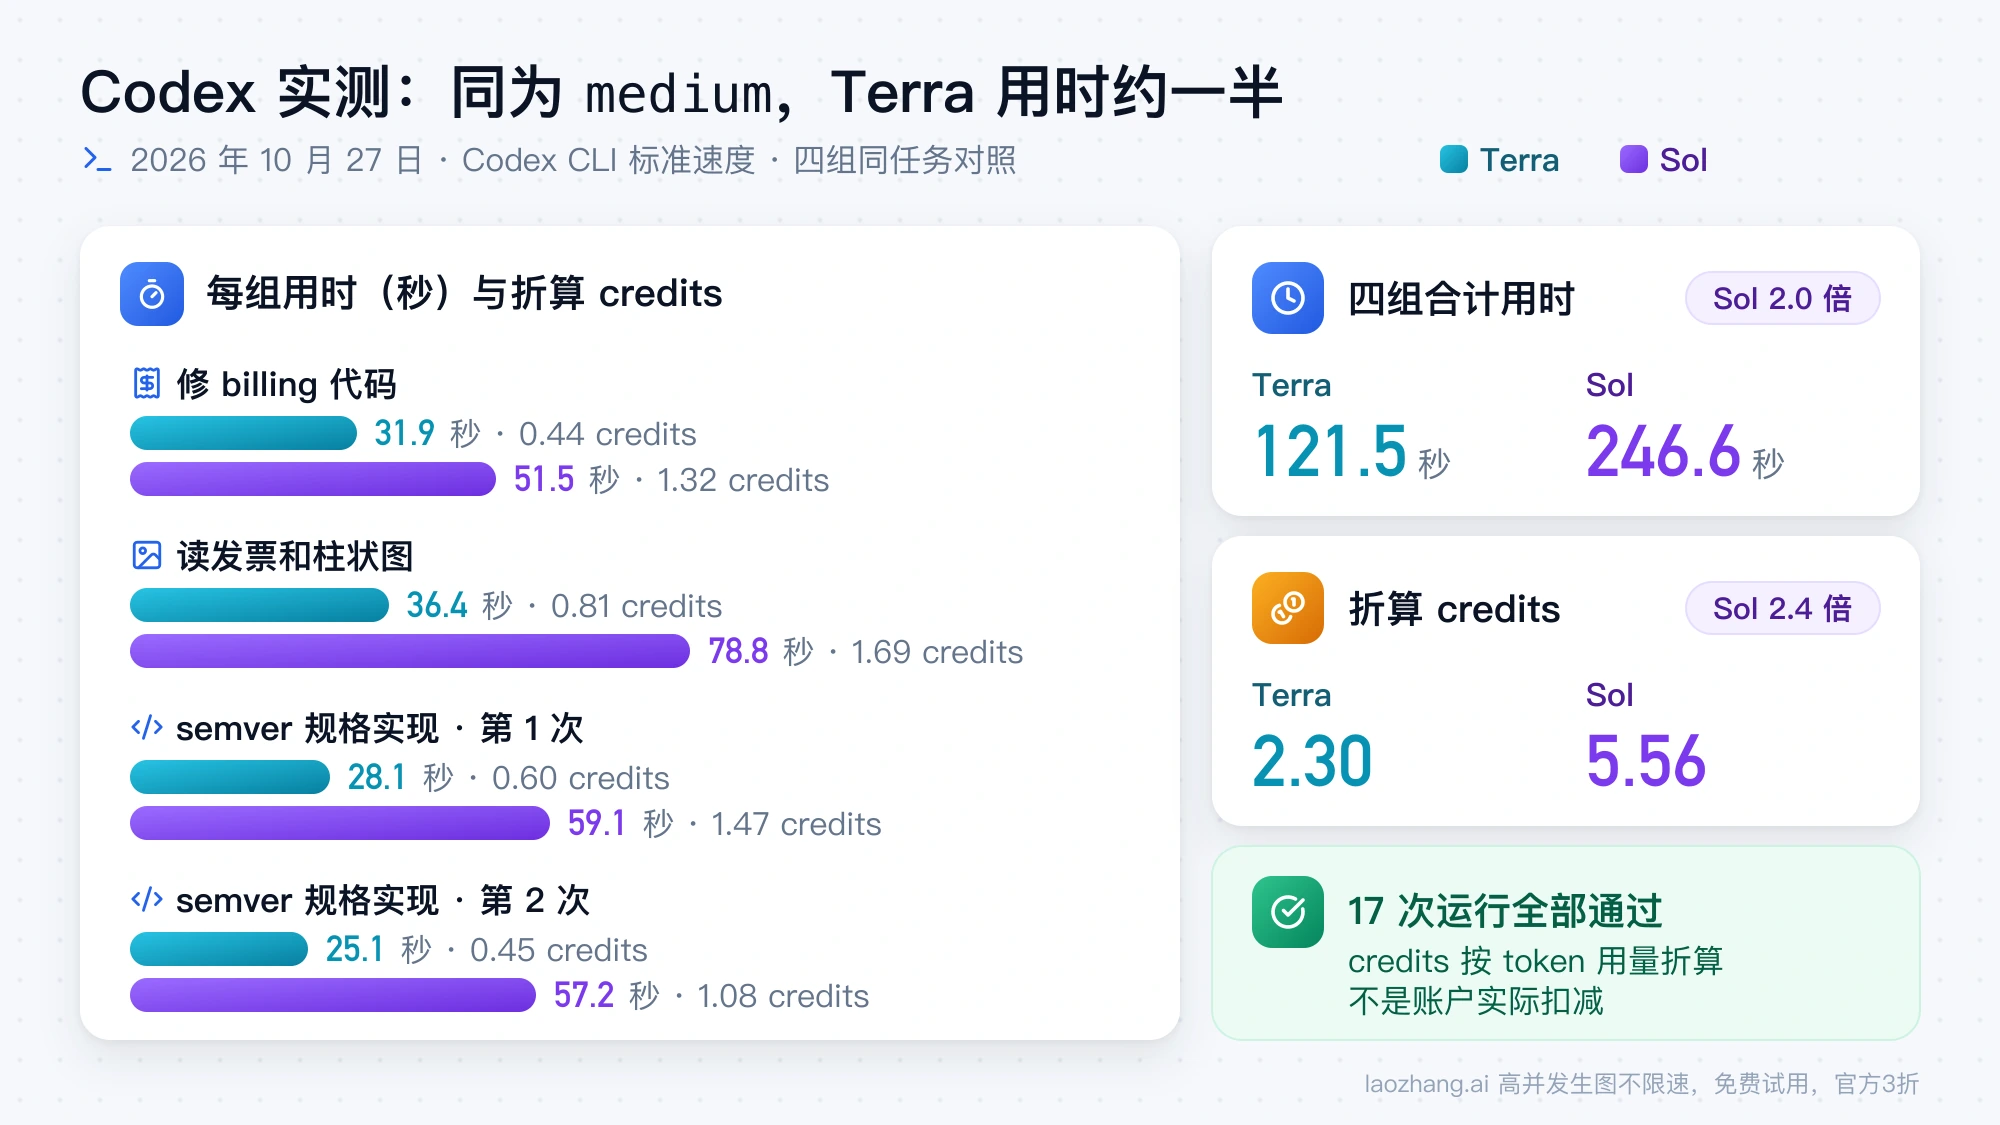
在 Codex 里实际跑同样的任务,差距落在两者之间:2026 年 10 月 27 日四组同为 medium 的对照里,Sol 的合计用时约是 Terra 的 2.0 倍,单组在 1.6–2.3 倍之间,明细在下一节。另有一个计算机操作的个例:据 OpenAI Codex 团队的 Victor Nunez 2026 年 10 月 26 日(Terra 发布当天)发在 X 上的演示,一次 Fast 模式下的填表任务 Terra 用了 53.5 秒,Sol 用了 3 分 21.7 秒,这只是单次演示。所以"快三倍"在同档的计算机操作和短任务上说得通,在需要高推理强度的难活上不成立。
Codex 实测:三个任务 17 次运行全部通过,Terra 用时约一半
2026 年 10 月 27 日,在一台 macOS 电脑上用 ChatGPT 订阅账号登录的 Codex CLI(codex-cli 0.164.0-alpha.11.1,ChatGPT 应用自带版本),以标准速度对两款模型各跑了三个任务,17 次运行全部通过。每次都从任务目录的干净副本开始,两款模型交替运行,耗时从启动到退出计,token 用量取自 Codex 输出的 turn.completed 事件。
三个任务分别是:修一份有 bug 的 billing 代码,按 7 条规则的说明改到通过 36 个隐藏测试(原文件只能过 13 个);从两张 PNG 里读出一张 12 行发票和一张 12 根柱子、没有数据标签的柱状图,发票里埋了一处算错的行合计;按一份很长的 semver 范围规格(含 npm 的预发布版本规则)实现 satisfies(),过 36 个隐藏测试。
| 任务与推理强度 | GPT-6.1 Terra:秒 / credits | GPT-6.1 Sol:秒 / credits |
|---|---|---|
修 billing 代码,low | 29.2 / 0.42 | 未跑 |
修 billing 代码,medium | 31.9 / 0.44 | 51.5 / 1.32 |
修 billing 代码,high | 34.0 / 0.52 | 62.0 / 1.35 |
读发票和柱状图,none | 28.8 / 0.87 | 没有这一档 |
读发票和柱状图,medium | 36.4 / 0.81 | 78.8 / 1.69 |
读发票和柱状图,high | 38.1 / 0.86 | 55.4 / 1.47 |
semver 规格实现,low | 27.5 / 0.58 | 44.2 / 1.33 |
semver 规格实现,medium 第 1 次 | 28.1 / 0.60 | 59.1 / 1.47 |
semver 规格实现,medium 第 2 次 | 25.1 / 0.45 | 57.2 / 1.08 |
semver 规格实现,high | 36.9 / 1.10 | 未跑 |
结果两边完全一样。billing 和 semver 每次都是 36/36;读图任务每次都读对了发票的 40 个数字和柱状图的 12 个数值,也都找出了埋下的那处错误合计。credits 是用每次运行的 token 用量乘 Codex credits 费率折算的(Terra 每百万 token 输入 25、缓存输入 1.25、输出 125,Sol 是 50、2.5、250),不是账户实际扣减;按 API Standard 单价折算,四组 medium 合计是 Terra $0.0917、Sol $0.2222。
把四组 medium 加起来:Terra 是 31.9 + 36.4 + 28.1 + 25.1 = 121.5 秒、0.44 + 0.81 + 0.60 + 0.45 = 2.30 credits,Sol 是 51.5 + 78.8 + 59.1 + 57.2 = 246.6 秒、1.32 + 1.69 + 1.47 + 1.08 = 5.56 credits,Sol 用了 2.0 倍的时间、2.4 倍的 credits。同任务同推理强度逐组比,Sol 的 credits 是 Terra 的 1.7–3.0 倍,超过单价的 2 倍,是因为 Sol 输出和推理的 token 更多,读图时还多跑了几步工具:读图 medium 那次 Sol 执行了 6 条命令、输入 196,342 token,Terra 只执行 2 条、输入 70,313 token。
这组测试的局限要说清楚。任务偏小,两款每次都通过,所以它只说明了耗时和用量,没有拉开质量差距;每个配置大多只跑了一次,只用了一个账号、一台机器,Codex 自身的工具调用开销也算在里面。API 直连、Fast 和 Ultrafast 都没有测。质量差距出现在更难的基准上,见下一节。
Terra 写代码是不是更差:简单任务看不出,难题差距明显
取决于题有多难。像上面那种有测试可循、改几十行的任务,Terra low 就能和 Sol 一样全部通过;到长链路的终端编程任务,同一推理强度下 Terra 明显落后。截至 2026 年 10 月 27 日,AA 测的 Terminal-Bench 4.0 里,medium 档 Terra 32.3%、Sol 48.0%,low 档 Terra 15.2%、Sol 30.8%,直到 max 才拉近到 Terra 55.6%、Sol 56.1%。Terra medium 和 Sol low 的成绩相当,和智能指数里的规律一致。
OpenAI 自己的说法方向相同。发布文章称 Terra 在 max 推理强度下解决了 Terminal-Bench 4.0 的 50.3%,是 GPT-5.6 Terra 21.5% 的两倍多(这是 OpenAI 自己的测试设置,和 AA 的 55.6% 不可直接比较),同时明确写着"对于最复杂的编程任务,GPT-6.1 Sol 和 GPT-6 Astra 仍然是更好的选择"。OpenAI 也报告了 Terra 占优的一项:在用代码做科研任务的 Terminal-Bench-Science 0.1 上,Terra max 以更低成本超过了 6.1 Sol。据 Reddit r/codex 的 Terra 发布帖(370 多条评论),讨论里的看法大致是 Terra 在特定工作流上表现好,更难的编程还是 Sol 强。
另一个差别在模型自带的知识。AA-Omniscience 同时考知识和是否乱答,Sol 各档在 38–42,Terra 在 4–30,max 才到 30。OpenAI 自己的幻觉测试结论更乐观:在一组容易诱发错误的提示上,Terra low 的错误率是 16.7%,max 降到 4.3%,接近 GPT-6 Astra 和 GPT-6.1 Sol。两份数据测的东西不同,实际影响是:需要模型凭记忆回答 API 细节、库版本这类事实时,给 Terra 开网页搜索或文件搜索,或者交给 Sol。
做安全研究的话还要知道,OpenAI 评估 Terra 达到了其准备框架里网络安全的"严重"风险阈值,沿用了为 GPT-6 Astra 开发的防护措施,漏洞研究一类的任务在 Terra 上可能和在 Sol、Astra 上一样被拦。
读图、表单和计算机操作:Terra 够用,易混字符两边都要校验
这类活是 Terra 的主场。OpenAI 把它定位为"快速、高效的模型,兼具细致的视觉推理、精准的计算机操作能力,以及更清晰、更自然的写作表现",举的例子就是起草提案、解读技术图纸、填写表单,以及把收到的发票录入会计软件这类大批量自动化。
2026 年 10 月 27 日的读图实测支持这个定位。Terra 从 none 到 high 都读对了 12 行发票的全部 40 个数字和柱状图的全部 12 个数值,也找出了故意算错的那一行合计,用时 29–38 秒;Sol medium 和 high 同样全对,用时 55–79 秒。两款都主动用 Python 的 PIL 把图片裁切放大后再读。有一处两边都错:等宽字体里几乎一样的 l、I、1,两款都把 LM-1l07 读成 LM-1107、把 DW-1I1l 读成 DW-1I11,所以发票编号、SKU 这类易混字符,换哪个模型都要加一道校验。
公开基准上两款也接近。OpenAI 说 Terra 在视觉推理基准 MMMU-Pro 上以低得多的成本取得接近 GPT-6 Astra 和 GPT-6.1 Sol 的分数,medium 下的 OSWorld 2.1 就超过了 GPT-5.6 Terra 的最好成绩;发布文章的图表没有给 Sol 的具体数字,X 用户 @rezoundous 在 2026 年 10 月 26 日从图表读出 MMMU-Pro 约 85.5 对 86.3、OSWorld 2.1 约 78 对 79(Terra 在前,读图估算)。前面提到的那次填表演示,Terra 也只用了 Sol 约四分之一的时间。
在哪里能用:两款都不在 ChatGPT 聊天里
两款模型的入口基本重合,都只在 ChatGPT 工作和 Codex 里,ChatGPT 普通聊天(Chat)里都没有。下表按 OpenAI 的 ChatGPT 与 Codex 定价文档和模型文档整理,截至 2026 年 10 月 27 日。
| 入口 | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|
| ChatGPT 普通聊天 | 没有 | 没有 |
| ChatGPT 工作(桌面应用、网页) | Plus、Pro、Business、Enterprise、Edu | Plus、Pro、Business、Enterprise、Edu |
| Codex(CLI、桌面应用、IDE 扩展) | 同上套餐;文档列出 CLI 和桌面应用,没有为 Terra 列出 IDE 扩展(IDE 扩展里能否使用未实测);CLI 需要 0.159.0 或更高版本 | 同上套餐;CLI、桌面应用、IDE 扩展 |
| Free、Go | 没有列出 | 没有列出 |
| Enterprise、Edu | 取决于工作区开放情况和管理员设置 | 默认关闭,管理员开启后可用 |
| OpenAI API | gpt-6.1-terra | gpt-6.1-sol |
| Ultrafast | 没有 | API;Codex 里限 Pro $500 和符合条件的 Enterprise、Edu |
| 阿联酋推理数据驻留 | 不支持 | 定价文档没有写这条限制 |
有一处官方说法不一致:Terra 发布文章列出的可用套餐是 Plus、Pro、Enterprise 和 Edu,没有 Business;Codex 定价文档写明包括 Business,而且给出了 Business 的用量区间,以文档为准。GitHub Copilot 也在 10 月 26 日上线了 GPT-6.1 Terra,面向 Copilot Pro、Pro+、Max、Business 和 Enterprise 用户逐步开放,按用量计费,见 GitHub Changelog 的 GPT-6.1 Terra 公告。
通过第三方 OpenAI 兼容网关调用的,要先确认它有没有上架 Terra。截至 2026 年 10 月 27 日,laozhang.ai 的 GET /v1/models 返回的列表里有 gpt-6.1-sol,没有 gpt-6.1-terra;它的文档给 gpt-6.1-sol 标的价格是输入 $2、输出 $10、缓存输入 $0.10(272K 以内)。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
Plus 和 Business 能多用多少:每 5 小时 35–285 条对 15–160 条
同一份套餐额度,Terra 能用的次数大约是 Sol 的两倍。OpenAI 的 Codex 定价文档给出 Plus 和标准版 Business 每 5 小时的本地消息估计:GPT-6.1 Terra 35–285 条,GPT-6.1 Sol 15–160 条(GPT-6 Astra 是 5–45 条)。区间这么宽是因为任务大小不同,文档也说明这不是固定上限,本地消息和云端任务共用额度,另外可能还有每周限额。Pro 目前没有 5 小时限额。周限额怎么重置,见 Codex 每周限额什么时候重置?恢复时间、即时重置与 28 天重置活动。
这里有三种计量,不要混成一个数。套餐里的"使用额度"按消息估算;Codex credits 在用完套餐额度后、或在按量计费的工作区里才扣,Terra 每百万 token 输入 25、缓存输入 1.25、输出 125 credits,Sol 是 50、2.5、250,也是正好一半,Codex 的 credits 不单独收缓存写入;API 则按前面价格表的美元计费。OpenAI 也提醒,credits 费率本身不决定套餐里含多少用量,所以不能拿 API 美元价去推算 Plus 能发多少条。
Codex 怎么切到 GPT-6.1 Terra
CLI 版本是第一道门槛,低于 0.159.0 的 Codex CLI 不认 gpt-6.1-terra。按 OpenAI 的 Codex 模型文档,切换步骤如下:
- 运行
codex --version确认 CLI 版本不低于 0.159.0,低了先升级。 - 启动时指定模型:
codex -m gpt-6.1-terra(--model是同一个参数)。 - 已经在会话里的,输入
/model,选 GPT-6.1 Terra,再选推理强度;要看max这类高档,选 More reasoning…。 - 非交互运行也用同一个参数,例如
codex exec -m gpt-6.1-terra -c model_reasoning_effort="low" "修复 billing.py 并跑测试"。 - ChatGPT 桌面应用和网页版 ChatGPT 工作里,打开 Power 控件的高级(Advanced),在模型列表里选 GPT-6.1 Terra,再调推理强度和速度。
模型列表里看不到 Terra,多半是套餐、工作区或灰度还没覆盖到你,Enterprise 和 Edu 还要看管理员。选上之后报模型繁忙,和额度是两回事,见 Codex Selected model is at capacity 怎么解决:不是额度用完。API 那边只需把 model 改成 gpt-6.1-terra,推理强度写在 reasoning.effort;原来用 Sol Ultrafast 的请求不能直接改,Terra 没有这一档。
换之前在自己的任务上测:算每个被接受结果的成本
半价只是每个 token 的价钱,决定换不换的是每个被接受的结果要花多少。用这个式子比较:
每个被接受结果的成本 = (每次尝试的模型费用 + 每次尝试的人工检查成本) ÷ 通过率
先只看模型费用。拿 AA 的 medium 档平均成本代入,Terra $0.10、Sol $0.21,只要 Terra 的通过率不低于 Sol 的 48%(0.10 ÷ 0.21),Terra 就更便宜,几乎总是 Terra 赢。再加上人工:假设每次尝试都要人检查一遍,折合 $2,Terra 每次共 $2.10,Sol 共 $2.21,盈亏点变成 2.10 ÷ 2.21 ≈ 95%。也就是说,Sol 能过 90% 的任务时,Terra 至少要过 85.5% 才划算。检查越贵,半价的意义越小,通过率的差距越要紧;验收能自动完成、失败重跑就行的活,Terra 的优势最大。
在 Codex 里做 A/B,可以照这个流程:
- 挑 5–10 个真实任务,包括你最难的那一类,先写好通过标准,能用测试自动判定的尽量自动判定。
- Sol 用你现在的推理强度跑一遍做基线;Terra 跑同一档和低一档,难任务再加一档。
- 每次从干净的任务副本开始,两款交替运行,避免缓存和时段影响偏向一边。
- 记录耗时、是否通过,以及
codex exec --json输出里turn.completed事件的 token 用量;用 API 的就记响应里的usage。 - 按任务类型分别代入上式:Terra 通过率守得住的类型切过去;要开到
xhigh以上才守得住的,留在 Solmedium。
2026 年 10 月 27 日那组实测用的就是这个方法,每次的命令形如下面这样,-c service_tier="default" 固定为标准速度:
codex exec --ephemeral --skip-git-repo-check -s workspace-write \
  -m gpt-6.1-terra -c model_reasoning_effort="medium" \
  -c service_tier="default" --json "按 SPEC.md 修复 billing.py"
GPT-6.1 Terra 和 Sol 的其他问题
GPT-6.1 Terra 和 GPT-5.6 Terra 是一个模型吗?
不是。GPT-6.1 Terra 是 2026 年 10 月 26 日发布的新一代,GPT-5.6 Terra 截至 10 月 27 日仍在 API 和 Codex 里销售,API 价格是输入 $2、缓存输入 $0.20、输出 $12,Codex credits 是 50 / 5 / 300。新一代输入价减半、输出从 $12 降到 $5,OpenAI 公布的编程、读图和幻觉评测都明显更好;AA 在 2026 年 10 月 26 日(发布当天)的 X 帖子里点评,Terra max 比 GPT-5.6 Terra 高 6 分,每道题成本不到三分之一($0.40 对 $1.40)。
GPT-6.1 Sol 太慢,换 Terra 是唯一办法吗? 不是,Sol 降一档推理强度也能明显提速,原因和设置见 GPT-6.1 Sol 很慢怎么办:先分清原因,降档实测耗时减半。
难活要不要直接上 GPT-6 Astra?
多数情况下先试 Sol 高一档,Astra 留给 Sol 开到 max 也做不下来、或者失败代价很高的任务,具体怎么判断见 GPT-6.1 Sol、GPT-6 Sol、Astra 怎么选。
从 GPT-6 Sol 迁到 6.1 Sol 要改什么?
主要是 none 推理强度、Chat Completions 里的工具调用和采样参数三处,逐项改法见 GPT-6.1 Sol 怎么用:价格变化、迁移改动与可用入口。
参考来源8
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月27日。
参考来源8
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月27日。
- 1.GPT-6.1 Terra 模型页developers.openai.com/api/docs/models/gpt-6.1-terra
- 2.模型总览页developers.openai.com/api/docs/models
- 3.OpenAI API 定价页developers.openai.com/api/docs/pricing
- 4.GPT-6.1 Terra 与 GPT-6.1 Sol 分档对比页artificialanalysis.ai/models/releases/comparisons/gpt-6-1-terra-vs-gpt-6-1-sol
- 5.GPT-6.1 Terra 发布文章openai.com/index/introducing-gpt-6-1-terra
- 6.ChatGPT 与 Codex 定价文档learn.chatgpt.com/docs/pricing
- 7.模型文档learn.chatgpt.com/docs/models
- 8.GitHub Changelog 的 GPT-6.1 Terra 公告github.blog/changelog/2026-10-26-gpt-6-1-terra-in-github-copilot