GPT-6.1 Sol 怎么用:价格变化、迁移改动与可用入口
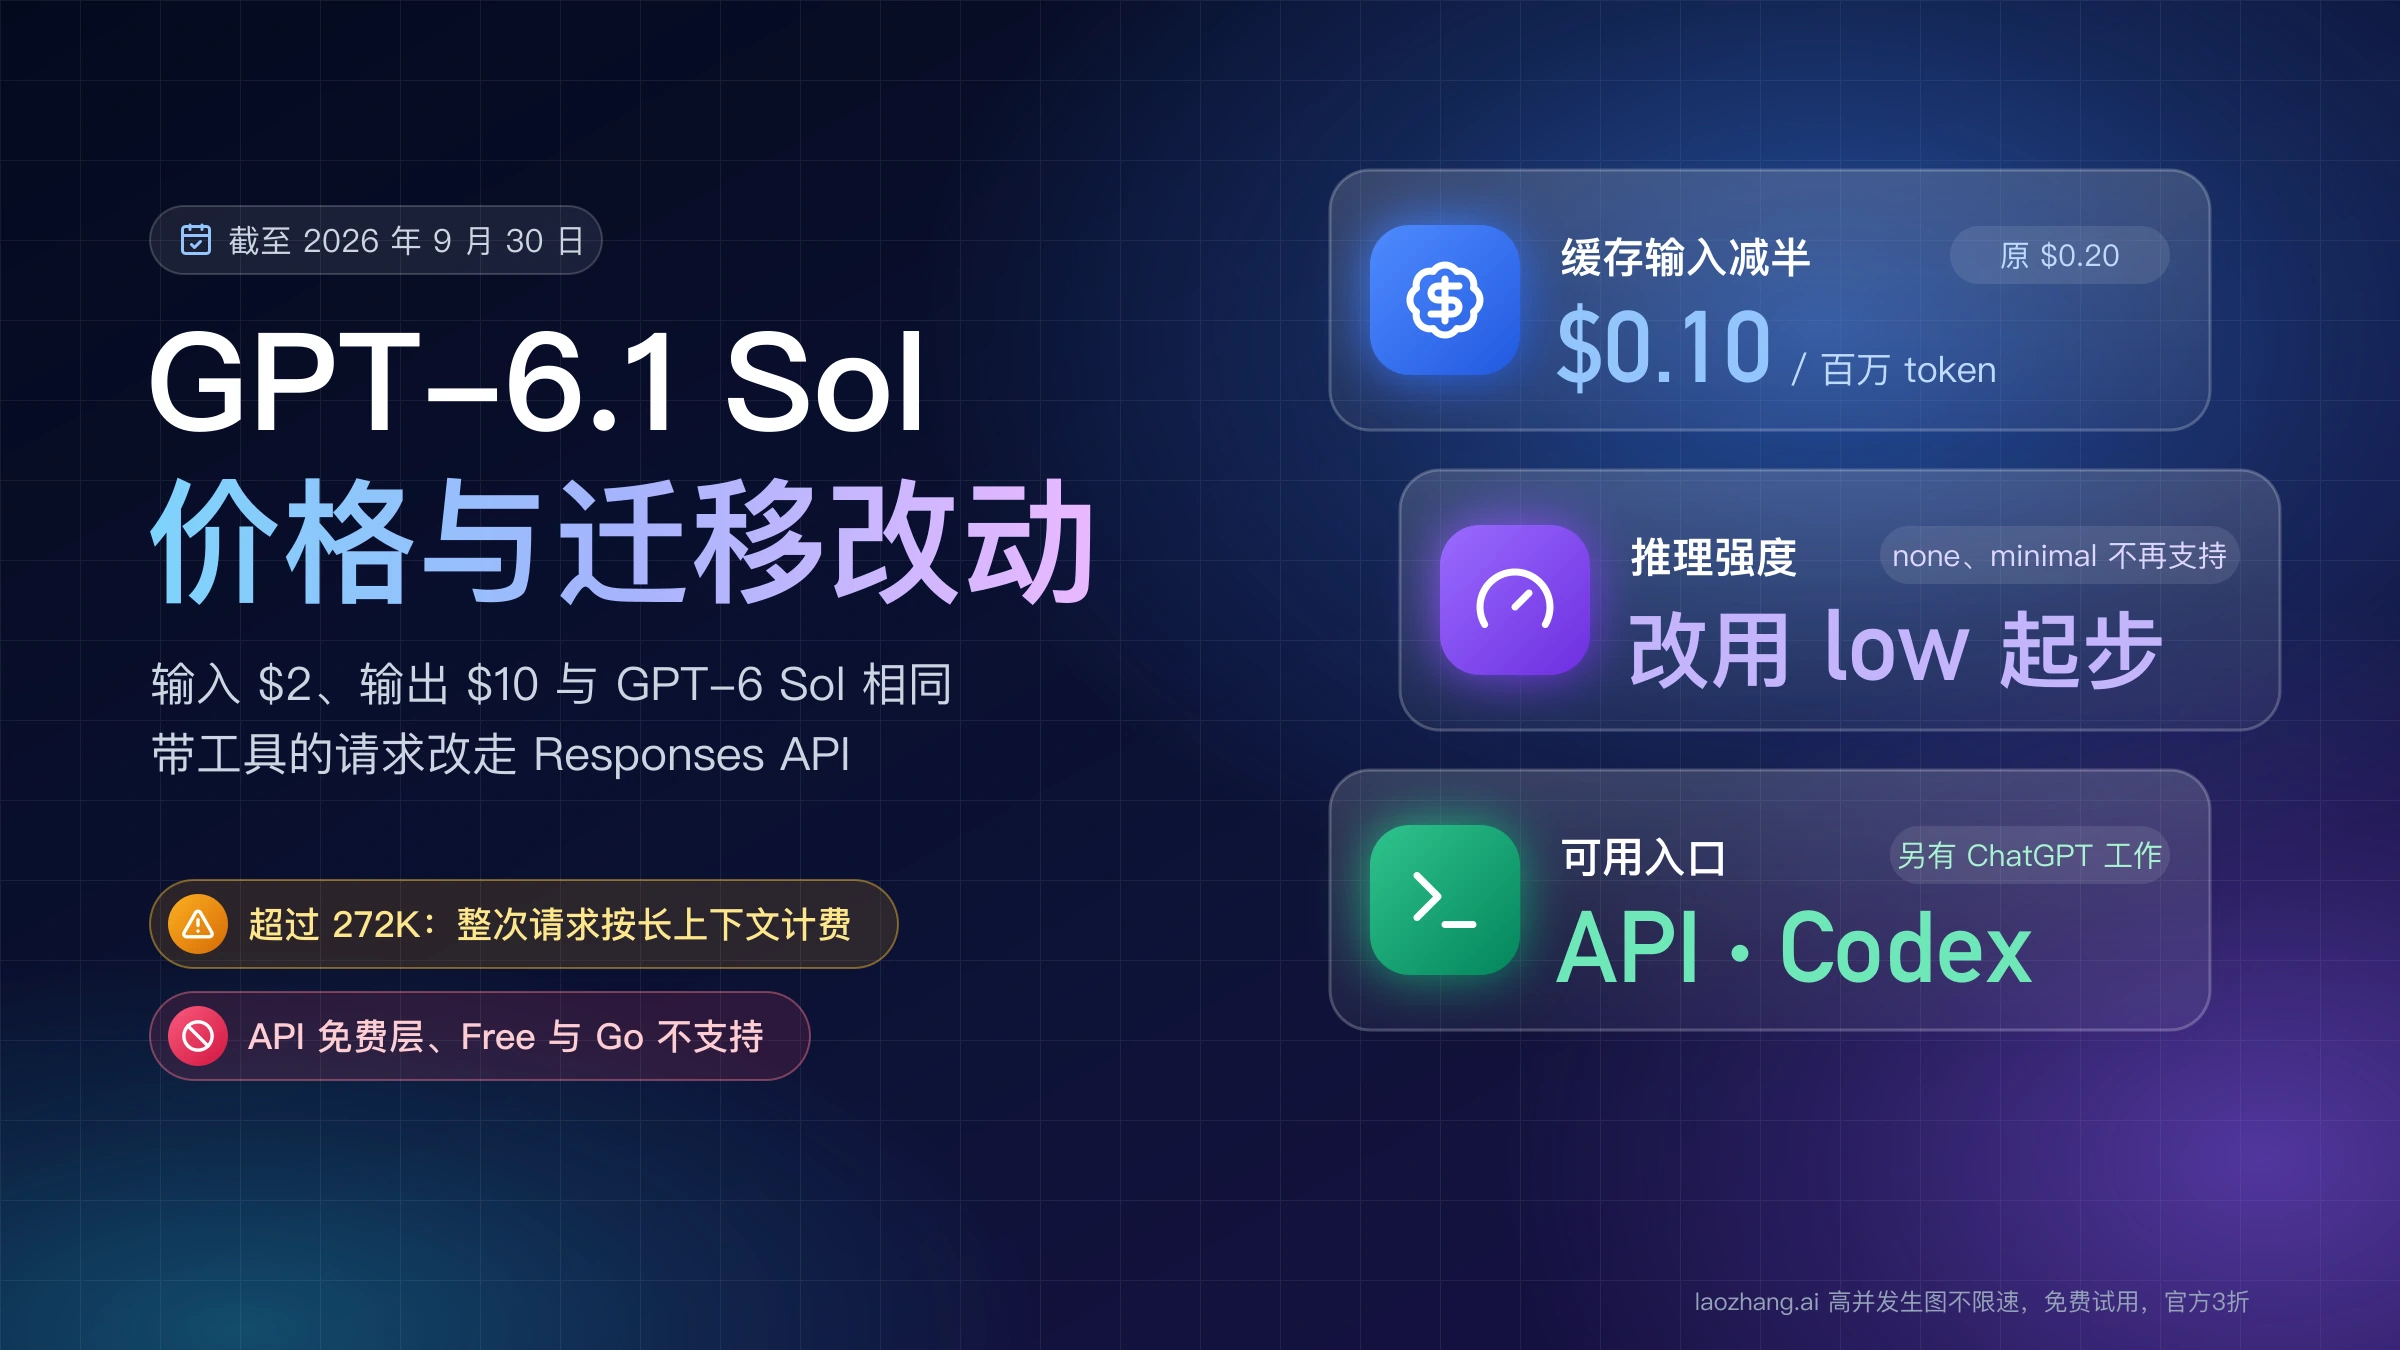
GPT-6.1 Sol 标价同 GPT-6 Sol,仅缓存输入减半至 $0.10;推理强度改 low,工具调用改走 Responses。国内可经老张API调用,缓存命中按全价计费。
文章目录
OpenAI 在 2026 年 9 月 29 日发布了 GPT-6.1 Sol,定位是一周前(9 月 22 日)发布的 GPT-6 Sol 的升级版,API 模型 ID 为 gpt-6.1-sol。截至 2026 年 10 月 5 日,对已经在用 gpt-6-sol 的开发者来说,结论可以先压成四句:
- 账单:输入 $2、输出 $10(每百万 token)与 GPT-6 Sol 相同,唯一变化是缓存输入从 $0.20 降到 $0.10。缓存命中占比越高,省得越多;完全不用缓存时,标价上没有差别。
- 请求:两类写法不能原样照搬。
none和minimal推理强度不再支持,要改成low;在 Chat Completions 里做工具调用的请求要改走 Responses API。 - 入口:API 免费层不支持;ChatGPT 里只有“ChatGPT 工作”和 Codex 能选,普通聊天里没有,Free 和 Go 套餐不含。
- 国内调用:OpenAI 的支持地区不含中国大陆。laozhang.ai(老张API)从 10 月 5 日起提供
gpt-6.1-sol,标价同为 $2 / $10,但缓存命中不打折、按普通输入价计费,工具调用只能走 Responses。不怎么命中缓存的请求两边同价;缓存占比高的智能体循环,在老张API上用gpt-6-sol更省。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
GPT-6.1 Sol 和 GPT-6 Sol、Astra 是什么关系
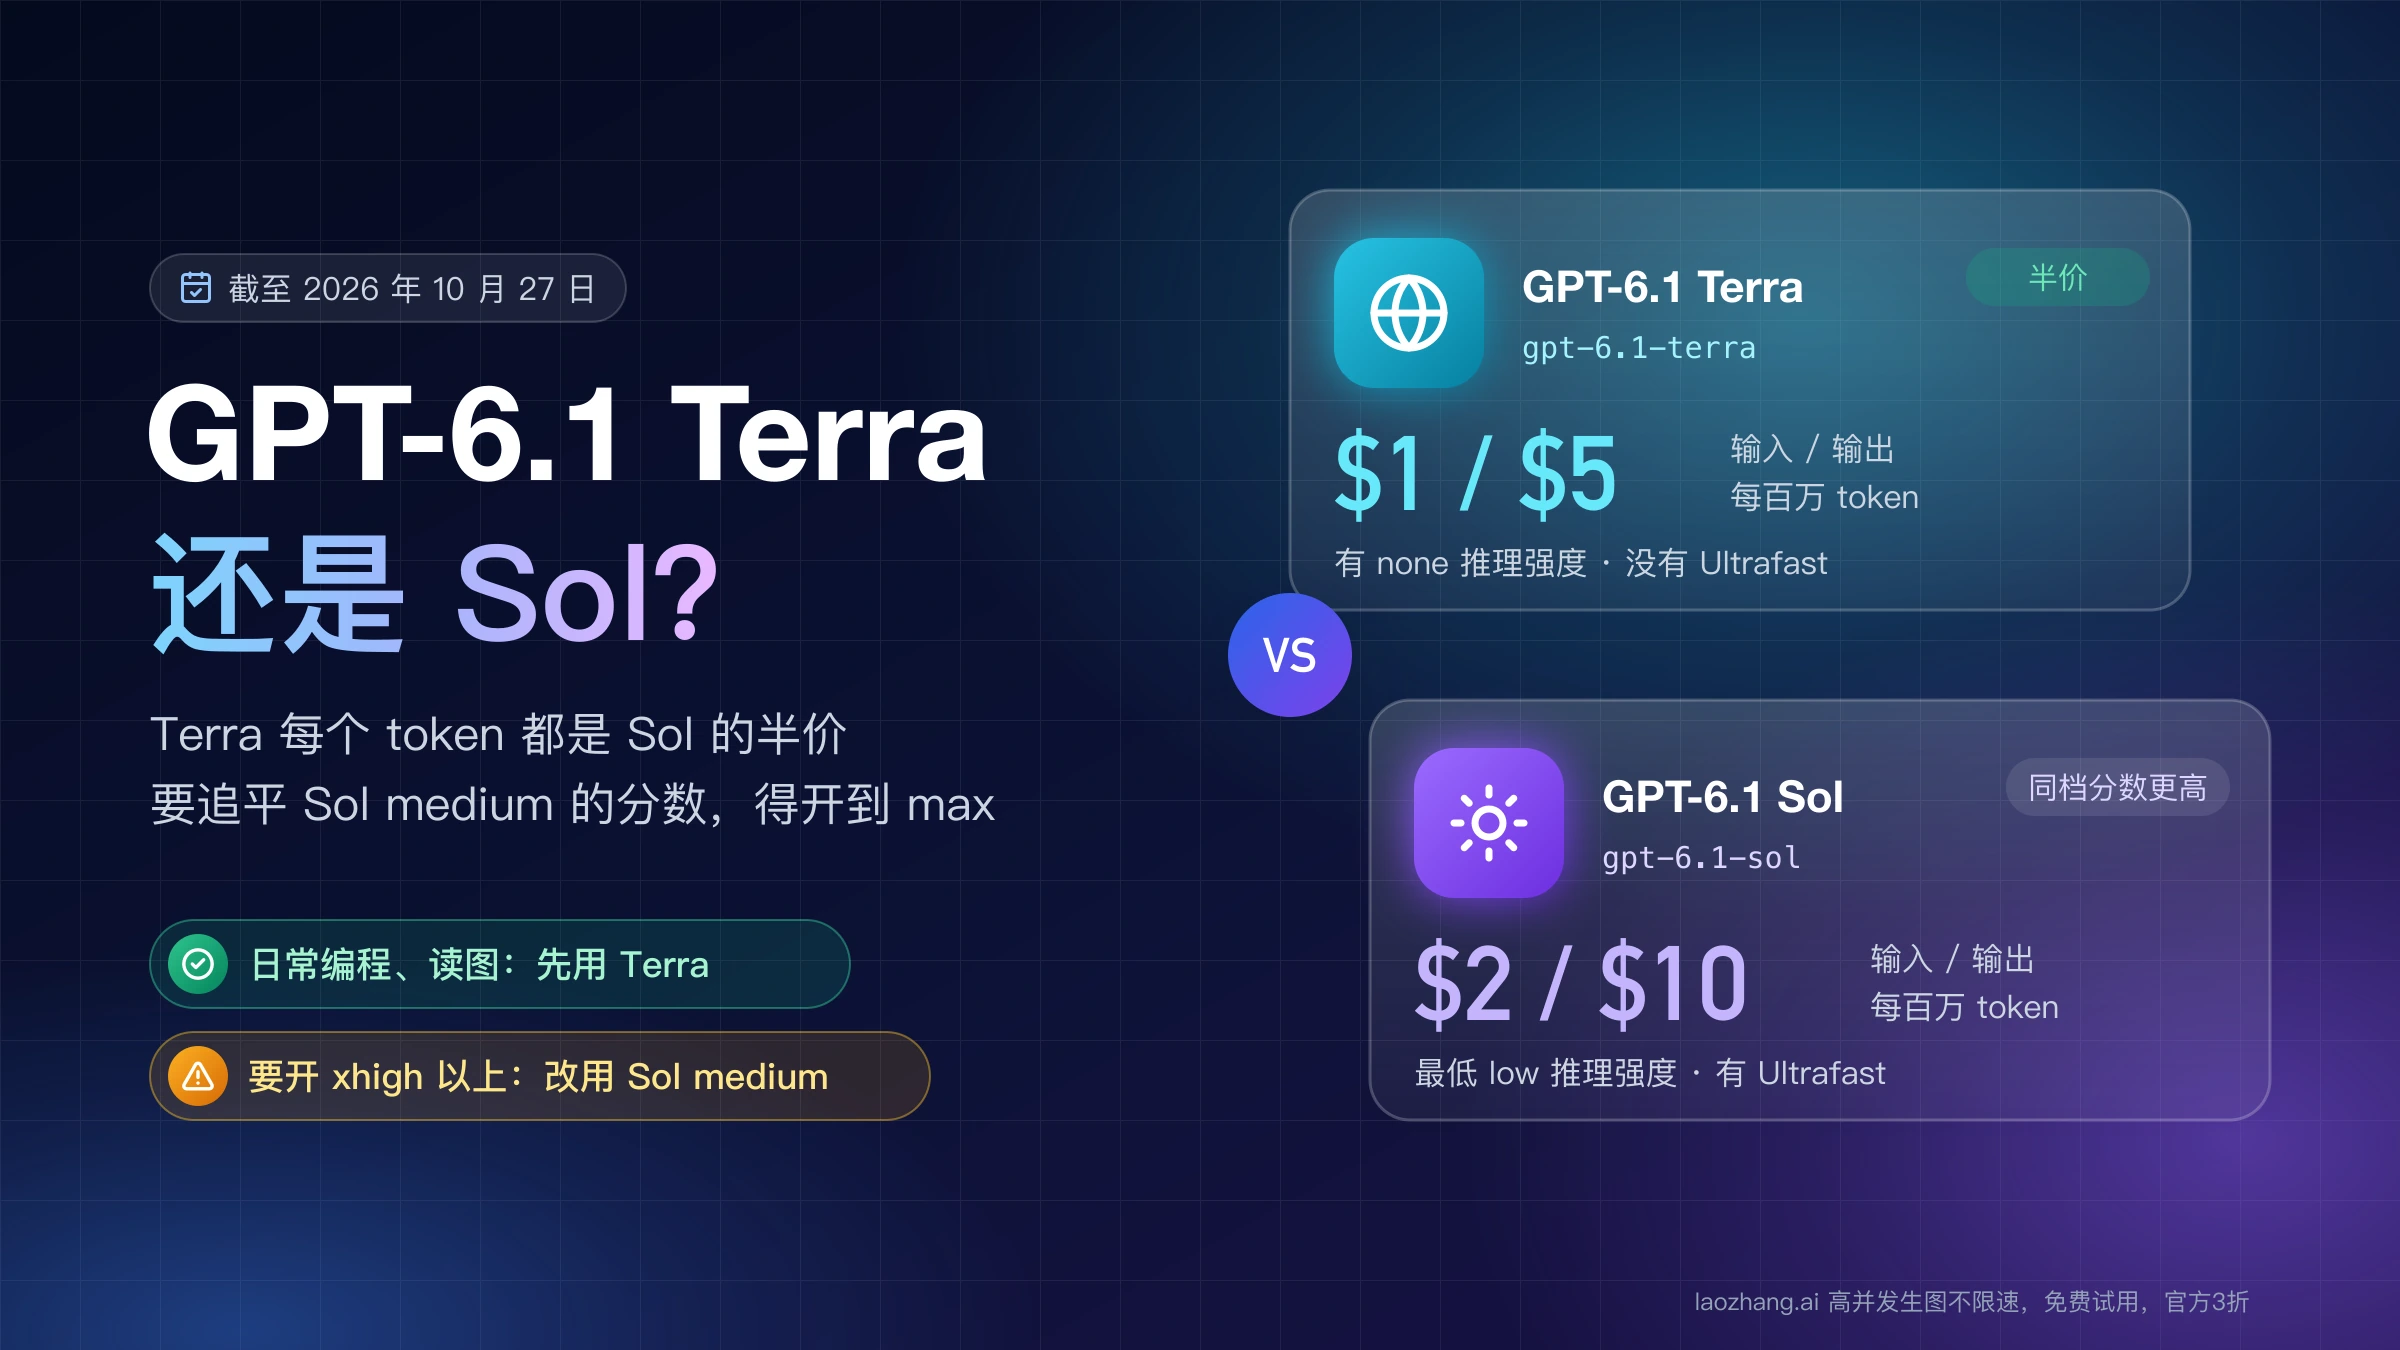
GPT-6 系列目前在 OpenAI 的模型指南里分三档:Astra 是“最高智能”,GPT-6.1 Sol 是“速度、成本与智能的平衡”,Luna 是“最快、最省钱”。GPT-6.1 Sol 取代的是 GPT-6 Sol 在这个阵容里的位置,而不是新增一档;GPT-6 Sol 的模型页现在也直接写着“较新的 Sol 模型请看 GPT-6.1 Sol”。
OpenAI 给它的定位是智能体编程、计算机使用和专业工作,发布公告的说法是“智能水平接近 Astra,价格仅为其五分之一”。这里的“五分之一”指标准输入和输出单价:Astra 是 $10 / $50,6.1 Sol 是 $2 / $10。缓存输入差得更多,Astra $1.00 对 6.1 Sol $0.10,是 10 倍。公告同时写明 GPT-6 Astra 仍是它综合能力最强的模型。
“接近 Astra”来自 OpenAI 自己的测评,公告里的几组数字可以当作参考方向:
| 测评 | OpenAI 公布的结果 |
|---|---|
| DeepSWE v1.1(编程) | 与 GPT-6 Astra 相当,成本约为其五分之一;比 GPT-6 Sol 的最高分高 6.4 个百分点 |
| OSWorld 2.0(计算机使用,最高推理强度) | 比 GPT-6 Sol 高 7 个百分点;与 Astra 相差 2.1 个百分点以内,单任务成本约为其七分之一 |
| Terminal-Bench Science 0.1(最高推理强度) | 平均单任务成本 $5.47,Opus 5.5 为 $23.21,Astra 为 $23.80;得分第一仍是 Astra(68.1%) |
| 事实错误率(超高推理强度,刻意挑选的高难度对话) | 4.1%,GPT-6 Sol 为 4.5%,Astra 为 4.0% |
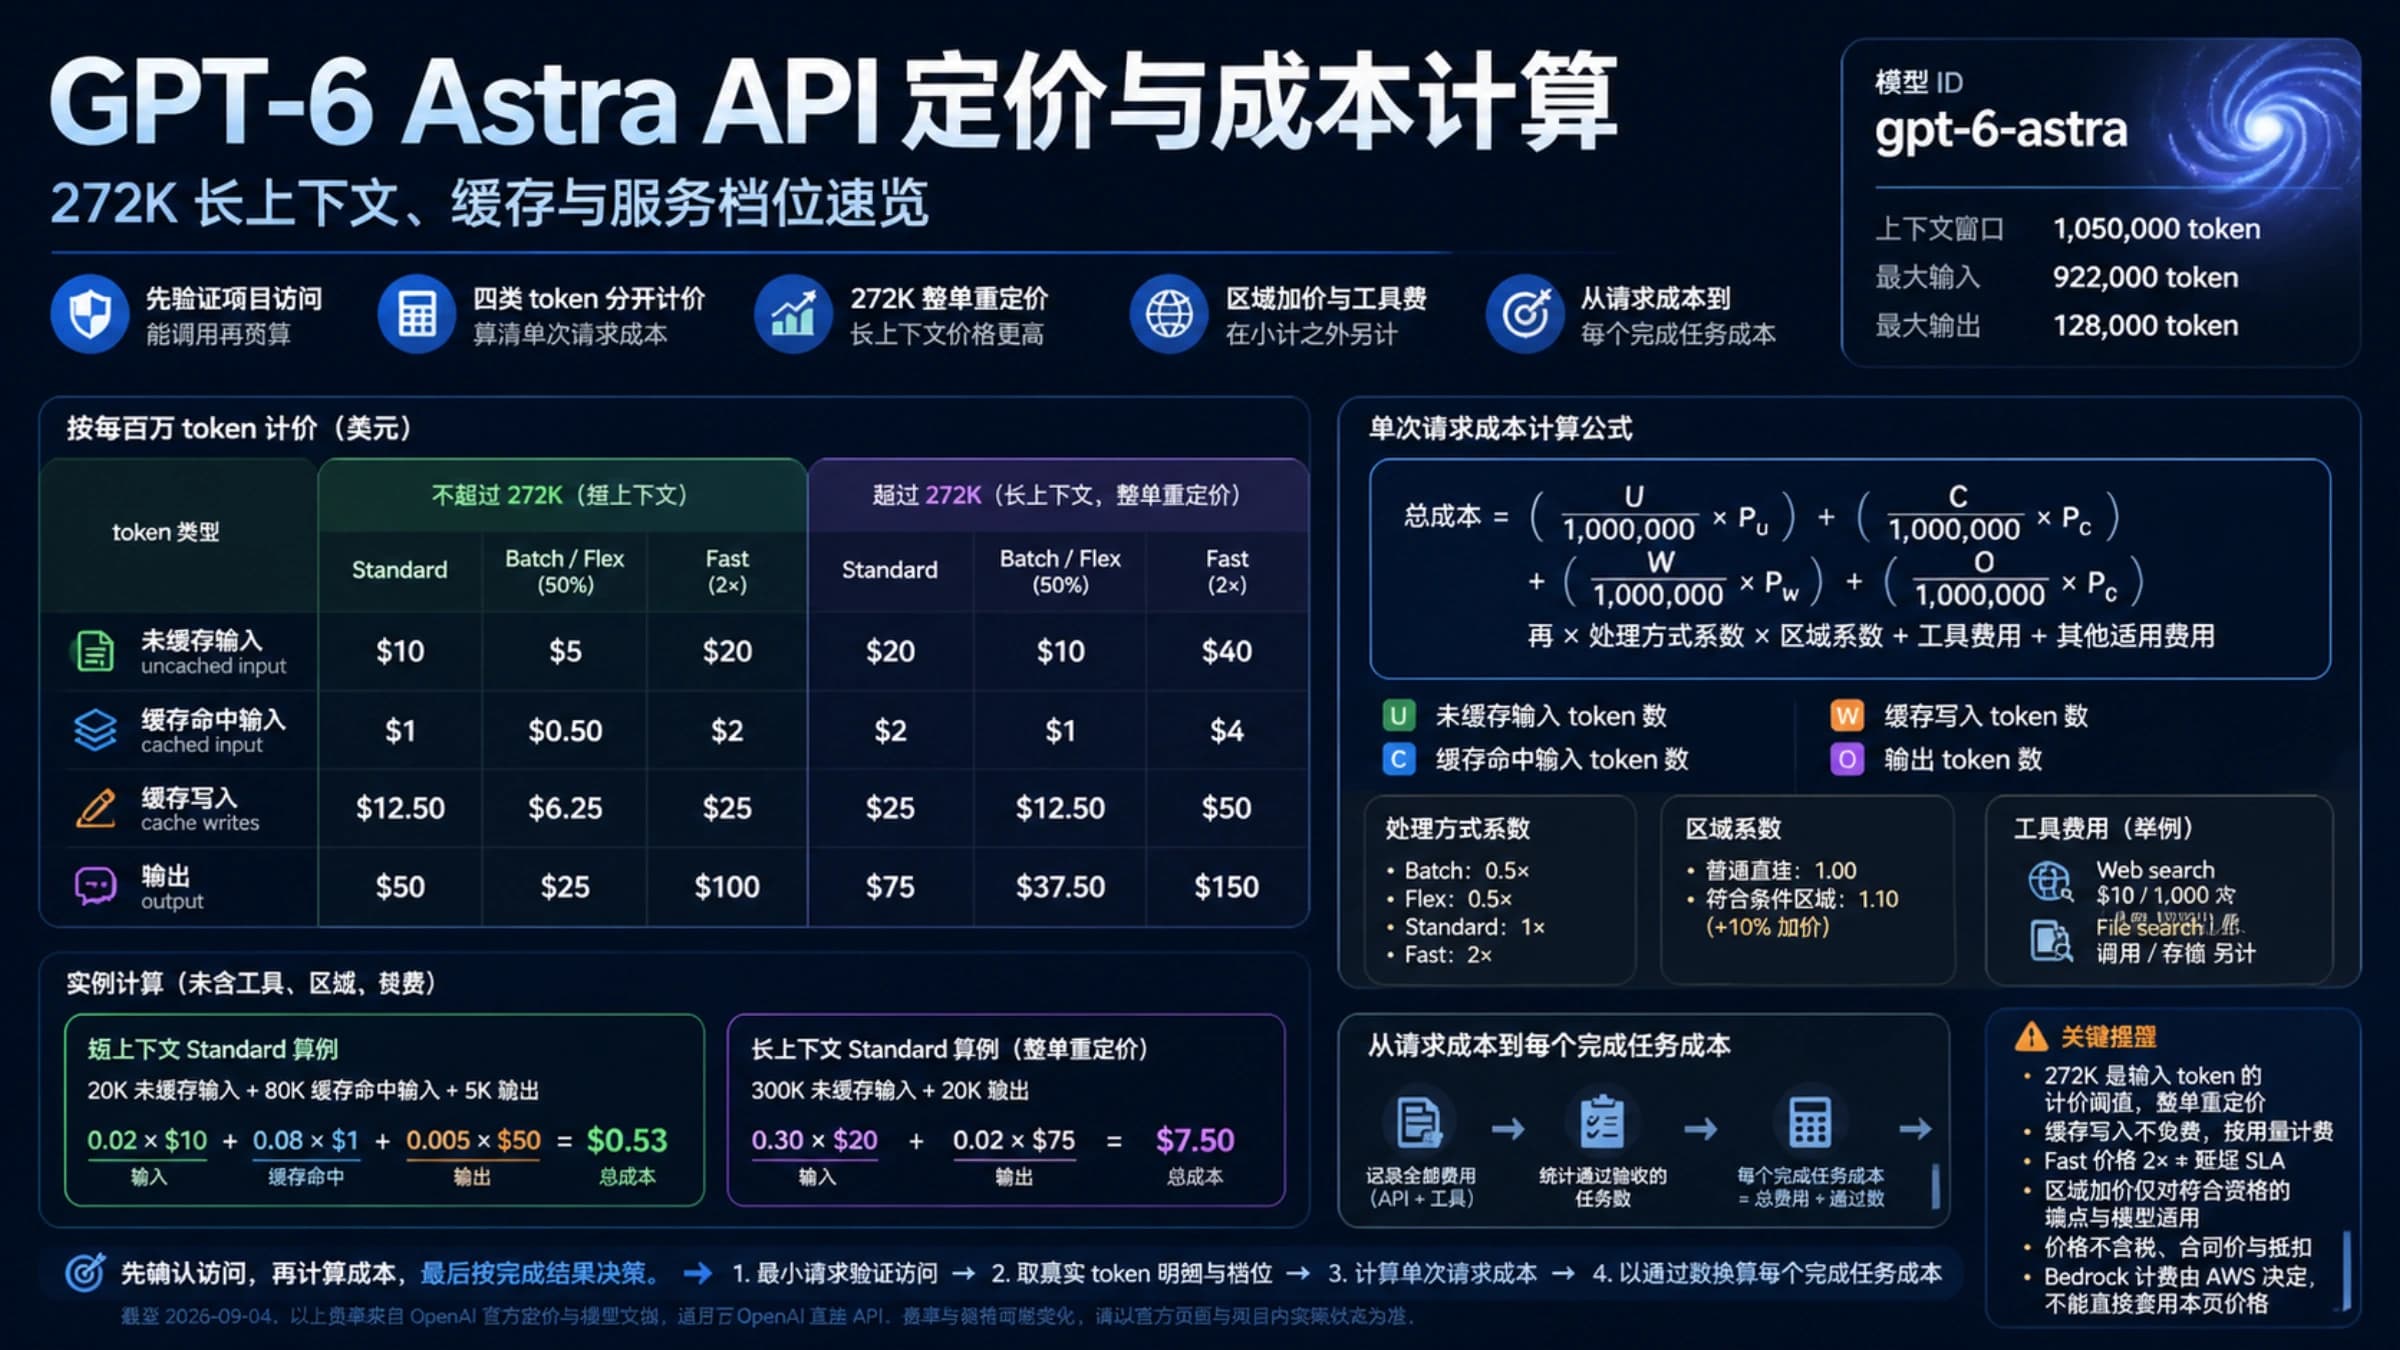
这些评估在 OpenAI 的研究环境或 API 中进行,竞品数字取自公开报告,公告也提示 ChatGPT 里的实际输出可能不同。它们能说明 6.1 Sol 相对 6 Sol 的提升方向,但换不换、要不要升到 Astra,最终要用你自己的任务来判断(做法见后文)。如果你在考虑是否值得为 Astra 多付费,GPT-6 Astra API 定价与成本计算里有 Astra 的长上下文与缓存算法。
价格:只有缓存输入降了一半
以下是 OpenAI 直连 API、Standard 档、全球处理的标价(美元/每百万 token),来自 GPT-6.1 Sol 模型页与定价页:
| 模型 | 输入长度 | 输入 | 缓存输入 | 缓存写入(30 分钟) | 缓存写入(12 小时) | 输出 |
|---|---|---|---|---|---|---|
gpt-6-sol | ≤272K | $2.00 | $0.20 | $2.50 | $5.00 | $10.00 |
gpt-6-sol | >272K | $4.00 | $0.40 | $5.00 | $10.00 | $15.00 |
gpt-6.1-sol | ≤272K | $2.00 | $0.10 | $2.50 | $5.00 | $10.00 |
gpt-6.1-sol | >272K | $4.00 | $0.20 | $5.00 | $10.00 | $15.00 |
gpt-6-astra | ≤272K | $10.00 | $1.00 | $12.50 | $25.00 | $50.00 |
缓存输入是未缓存输入单价的 5%,30 分钟缓存写入是 1.25 倍;12 小时缓存写入是 2026 年 10 月 20 日新增的档位,只能在 Responses API 里用,单价是 2.5 倍。推理 token 按输出计费,所以同一个任务推理想得越久,输出费用越高。使用网络搜索等工具时,定价页另有按次计费的工具费用,不包含在上表里。
每一笔请求都可以按同一个公式复算:
费用 = 未缓存输入 × 输入单价 / 1,000,000
     + 缓存输入 × 缓存输入单价 / 1,000,000
     + 缓存写入 × 缓存写入单价 / 1,000,000
     + 输出(含推理)× 输出单价 / 1,000,000
缓存命中多的智能体:同样用量大约便宜 18%
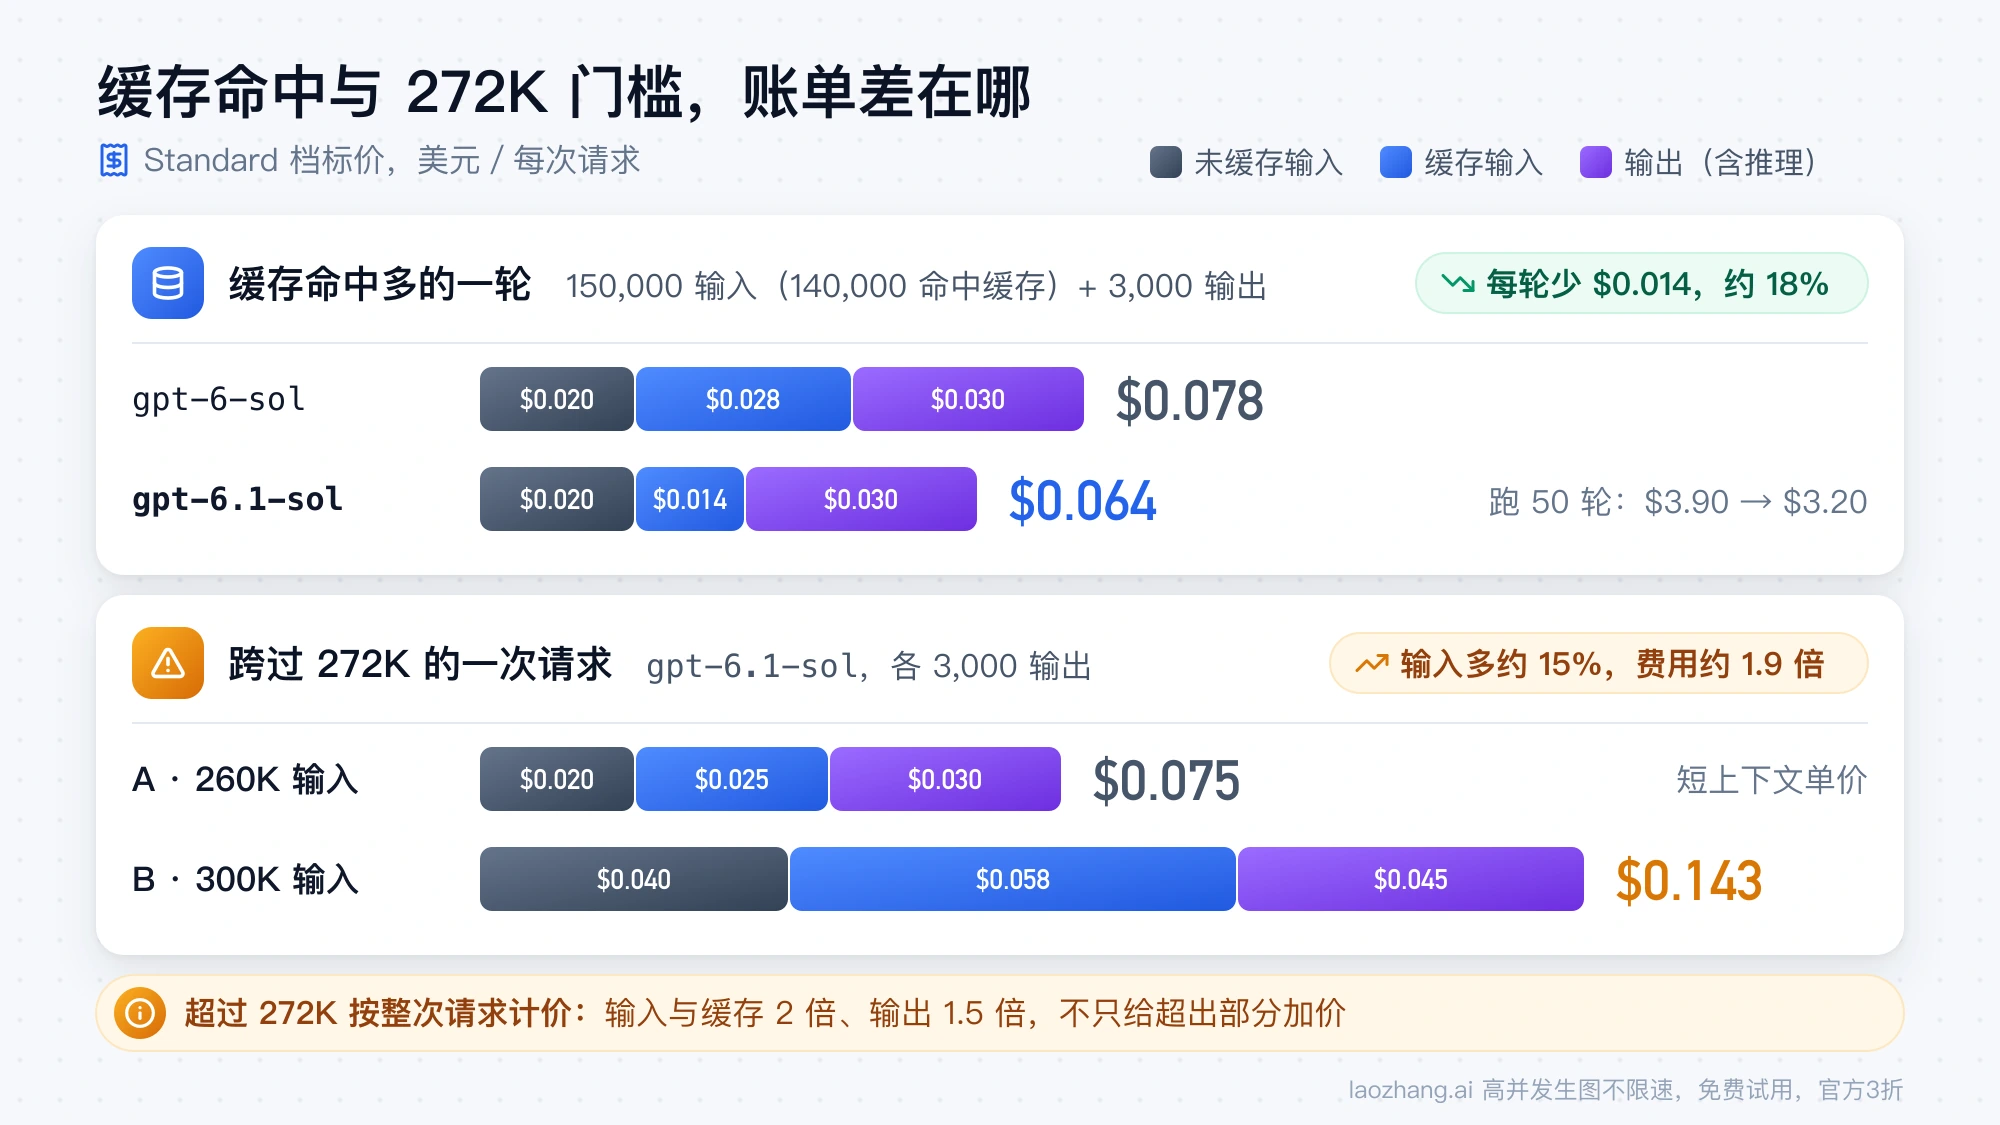
假设一个编程智能体的某一轮请求带着 150,000 输入 token,其中 140,000 命中缓存、10,000 按普通输入计费,输出(含推理)3,000 token,不计缓存写入(两个模型的缓存写入都是 $2.50,不影响差额):
| 项目 | gpt-6-sol | gpt-6.1-sol |
|---|---|---|
| 未缓存输入 10,000 × $2 / 1M | $0.020 | $0.020 |
| 缓存输入 140,000 × 缓存单价 / 1M | $0.028 | $0.014 |
| 输出 3,000 × $10 / 1M | $0.030 | $0.030 |
| 合计 | $0.078 | $0.064 |
每轮少 $0.014,约 18%;跑 50 轮是 $3.90 对 $3.20。同样的用量放到 Astra 上是 10,000 × $10 / 1M + 140,000 × $1 / 1M + 3,000 × $50 / 1M = $0.39。前提是两个模型在同一任务上用掉的 token 数相同,实际上推理长度和重试次数都会不同,所以这只是标价层面的差额。
反过来,如果你的请求几乎不命中缓存,两个模型的输入、缓存写入和输出单价完全一样,账单变化只会来自 token 用量本身。
跨过 272K:整次请求都按长上下文计价
模型页的原文是:输入超过 272K token 的请求,整次请求的输入和缓存按 2 倍、输出按 1.5 倍计费,不是只给超出的部分加价。用 gpt-6.1-sol 做两次对比:
- 请求 A:260,000 输入(250,000 缓存 + 10,000 未缓存)+ 3,000 输出,全部按短上下文单价:$0.020 + $0.025 + $0.030 = $0.075
- 请求 B:300,000 输入(290,000 缓存 + 10,000 未缓存)+ 3,000 输出,全部按长上下文单价:10,000 × $4 / 1M = $0.040,290,000 × $0.20 / 1M = $0.058,3,000 × $15 / 1M = $0.045,合计 $0.143
输入只多了约 15%,费用接近翻倍(约 1.9 倍)。同样的请求 B 放在 gpt-6-sol 上是 $0.040 + $0.116 + $0.045 = $0.201。长会话的智能体如果经常在 272K 附近徘徊,先做上下文压缩或截断,往往比换模型省得更多。
Fast、Batch/Flex 与超高速
- Fast:Standard 的 2 倍,短上下文为 $4 / $0.20 / $5 / $20。使用 EU 数据驻留时不能用 Fast。
- Batch 与 Flex:Standard 的一半,短上下文为 $1 / $0.05 / $1.25 / $5,适合不急着要结果的批量任务。
- 区域处理(数据驻留)在对应档位的价格上再加 10%。
超高速(Ultrafast)这一项,发布时 OpenAI 各处说法不一致。发布公告写的是同时推出了 GPT-6 Astra Ultrafast 和 GPT-6.1 Sol Ultrafast、可通过 API 使用;但同日的 DevDay 2026 回顾写的是“GPT-6.1 Sol 超高速即将推出”,ChatGPT Learn 的模型页写的是发布时只有 Standard 和 Fast、超高速稍后提供,9 月 29 日的 API 更新日志也只给 gpt-6-astra 加了 service_tier: "ultrafast",定价页的超高速一栏只列了 Astra。2026 年 10 月 15 日,更新日志给 gpt-6.1-sol 加上了 Responses API 的超高速,所有 API 用户都能用。价格是 Standard 的 6 倍:短上下文为 $12 / $0.60 / $15 / $60(12 小时缓存写入 $30),超过 272K 为 $24 / $1.20 / $30 / $90。它支持全球处理和美国、欧盟数据驻留(Astra 的超高速只支持全球处理和美国),有单独的速率限制,默认 Build 100 万、Launch 400 万、Grow 4,000 万 TPM。ChatGPT 和 Codex 里,Pro $500 和符合条件的 Enterprise、Edu 方案可以用 6.1 Sol 超高速。
从 gpt-6-sol 切过去,哪些写法要改
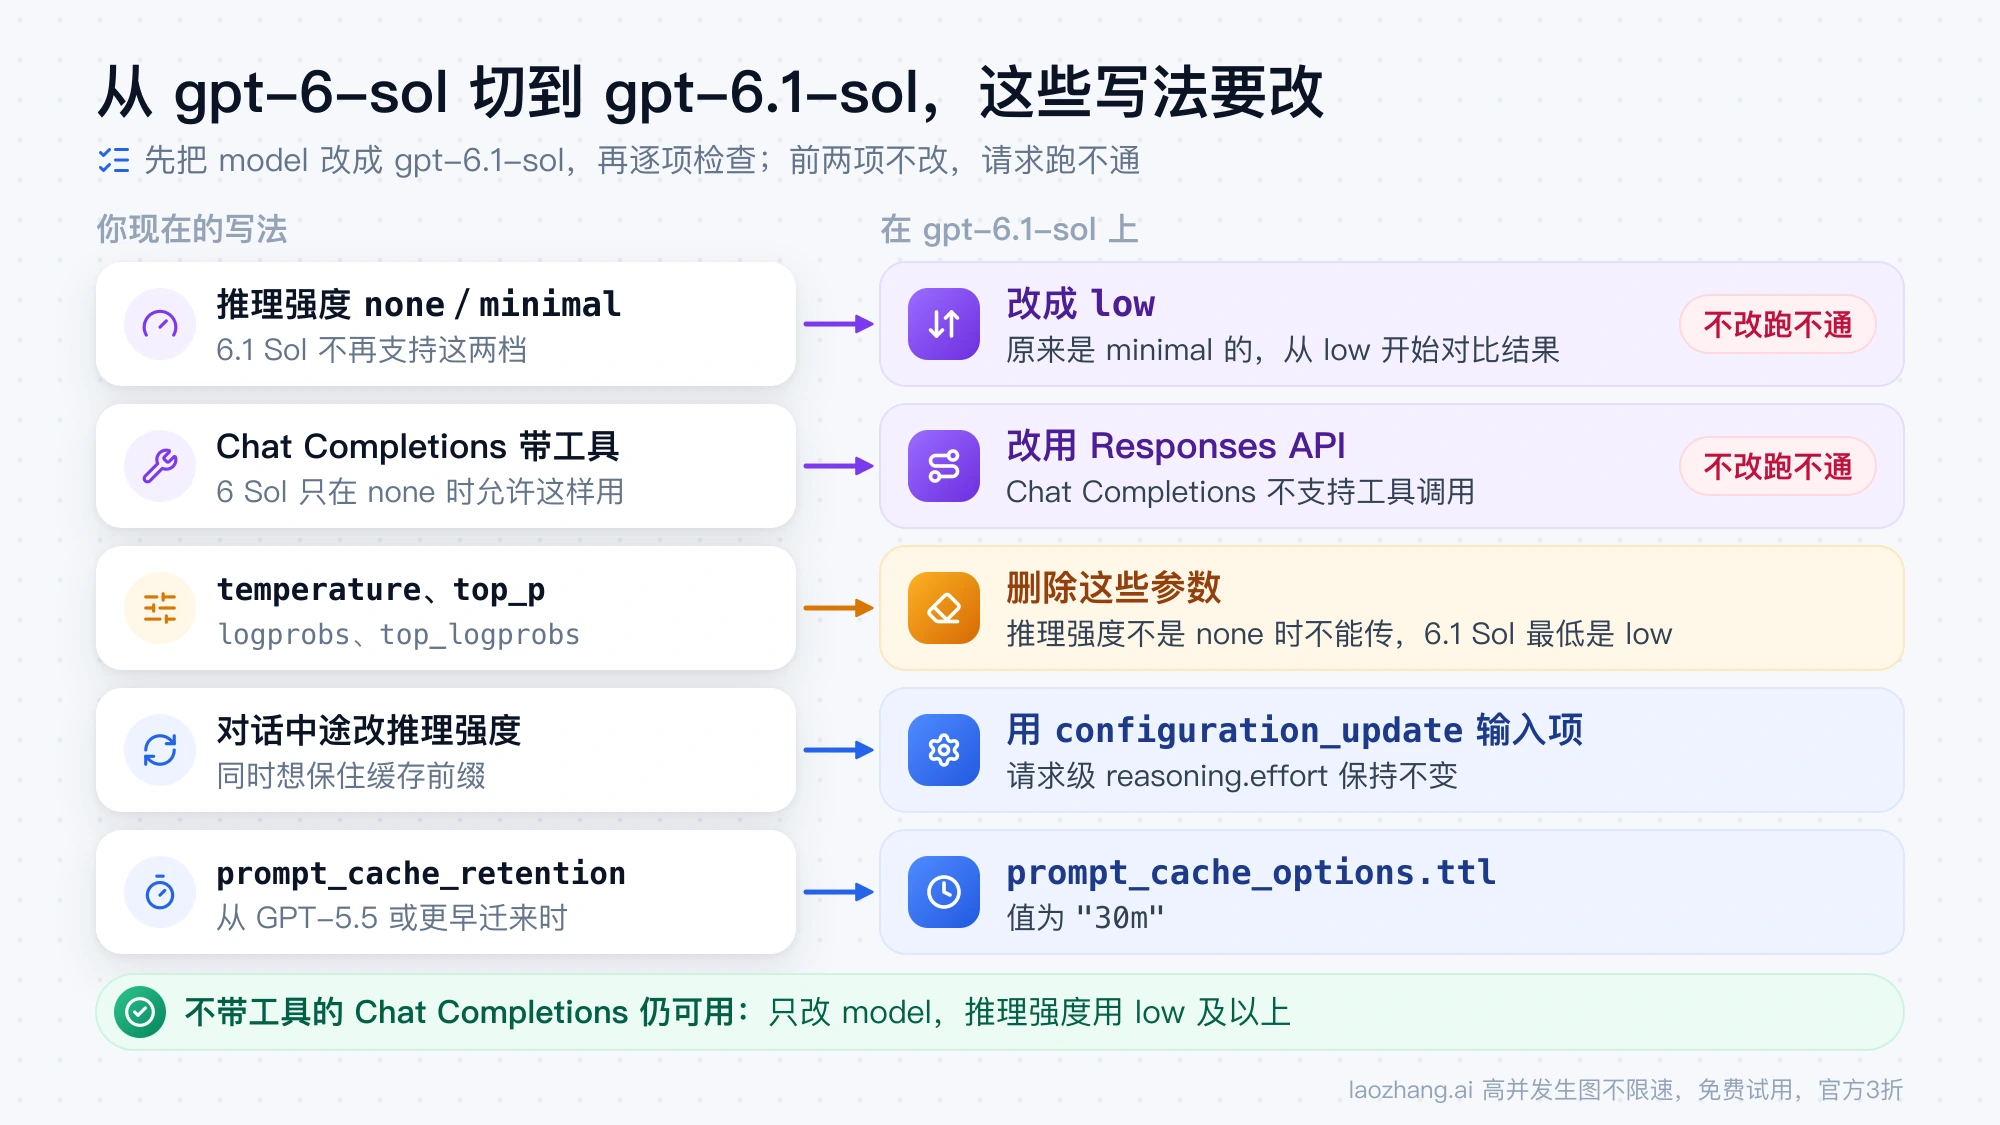
OpenAI 的迁移建议是先把 model 改成 gpt-6.1-sol,再逐项检查下面这些地方。前两行是最容易让现有请求跑不通的:
你现在的写法(gpt-6-sol) | 在 gpt-6.1-sol 上 | 怎么改 |
|---|---|---|
推理强度 none | 不支持 | 改成 low |
推理强度 minimal | 不支持 | 从 low 开始,用代表性任务对比结果 |
Chat Completions 里带工具/函数调用(6 Sol 只允许在 reasoning_effort: "none" 时这样用) | Chat Completions 不支持工具调用 | 改用 Responses API |
| Chat Completions 不带工具 | 支持 | 改 model,推理强度用 low 及以上 |
temperature、top_p、top_logprobs | 推理强度不是 none 时要去掉,而 6.1 Sol 最低就是 low | 删除 |
Chat Completions 的 logprobs | 同上 | 删除 |
Responses 里 include 的 message.output_text.logprobs | 同上 | 从 include 中移除 |
| 对话中途改推理强度 | 用 configuration_update 输入项 | 请求级 reasoning.effort 保持不变,才能保住缓存前缀 |
prompt_cache_retention(从 GPT-5.5 或更早迁来) | 已换成新参数 | 改成 prompt_cache_options.ttl,值为 "30m" |
没变的部分:上下文窗口 1,050,000 token,最大输出 128,000 token,输入支持文本和图片、输出文本,音频和视频都不支持;流式输出、函数调用和 Structured Outputs 可用,不支持微调。知识截止日期从 2026 年 4 月 20 日推到 4 月 30 日。Responses API 里可用的内置工具包括网络搜索、文件搜索、图片生成、代码解释器、托管 shell、apply patch、skills、计算机使用、MCP 和工具搜索,多智能体处于 beta。
推理强度的档位名字相同,效果却不一定一一对应。ChatGPT Learn 的原话是不同代模型之间的推理强度“不能精确对应”,建议先用熟悉的任务在较低档位试,再按结果调整。所以原来用 medium 的,不代表换过来之后 medium 就是最合适的档。
项目代码交给 Codex 迁移时,可以在 Codex 里用 OpenAI 文档技能:$openai-docs migrate this project to the GPT-6 model family。
带工具的请求:Responses API 写法
下面用 Python SDK 演示一次完整的函数调用往返。原来在 Chat Completions 里用 reasoning_effort: "none" 做函数调用的代码,换成这个结构:
from openai import OpenAI

client = OpenAI()  # 从环境变量 OPENAI_API_KEY 读取密钥

tools = [
    {
        "type": "function",
        "name": "get_order_status",
        "description": "按订单号查询订单状态",
        "parameters": {
            "type": "object",
            "properties": {
                "order_id": {"type": "string", "description": "订单号"}
            },
            "required": ["order_id"],
            "additionalProperties": False,
        },
        "strict": True,
    }
]

# 第一轮:模型决定是否调用函数
response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "low"},  # 原来是 none 或 minimal 的,从 low 开始
    tools=tools,
    input="订单 A1024 现在到哪一步了?",
)

call = next(item for item in response.output if item.type == "function_call")
print(call.name, call.arguments)

# 第二轮:把函数结果按 call_id 交回,推理强度保持不变
followup = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "low"},
    tools=tools,
    previous_response_id=response.id,
    input=[
        {
            "type": "function_call_output",
            "call_id": call.call_id,
            "output": '{"status": "已发货", "carrier": "顺丰"}',
        }
    ],
)
print(followup.output_text)
这段代码里没有 temperature 和 top_p,这是有意的:6.1 Sol 的推理强度不可能是 none,这两个参数就不能再传。
不带工具的请求:Chat Completions 仍可用
如果你的调用只是纯文本问答或结构化抽取,不涉及工具,可以继续用 Chat Completions,只改模型和推理强度:
from openai import OpenAI

client = OpenAI()

completion = client.chat.completions.create(
    model="gpt-6.1-sol",
    reasoning_effort="medium",  # 可选 low、medium、high、xhigh、max
    messages=[
        {"role": "developer", "content": "用简体中文回答,不超过三句话。"},
        {"role": "user", "content": "提示缓存命中后为什么更便宜?"},
    ],
    # 不要再传 temperature、top_p、logprobs、top_logprobs
)
print(completion.choices[0].message.content)
不过内置工具和多智能体都只在 Responses API 里提供,后面只要可能加工具,就值得趁这次一起迁过去。另外,如果你在 Codex 里配置了走 Chat Completions 的模型提供方,Codex 已经说明会在后续版本中移除对 Chat Completions API 的支持。
在哪里能选到 GPT-6.1 Sol
| 入口 | 谁能用 | 怎么选中 |
|---|---|---|
| OpenAI API | 付费使用层级 Tier 1 起,免费层不支持 | 请求里写 model: "gpt-6.1-sol" |
| Codex CLI | 用 ChatGPT 登录:Plus、Pro、Business、Enterprise、Edu;用 API 密钥:跟随 API 权限 | codex -m gpt-6.1-sol,或在会话里输入 /model |
| Codex 桌面应用、IDE 扩展 | 同上 | 模型选择器,或在 config.toml 写 model = "gpt-6.1-sol" |
| ChatGPT 工作(网页、移动端、桌面应用) | Plus、Pro、Business、Enterprise、Edu | 默认是“Power”设置,打开“Advanced”可指定模型、推理强度和速度 |
| ChatGPT 聊天 | 不可用 | — |
| Free、Go 套餐 | 发布时不含 | — |
| laozhang.ai(老张API) | 计费模式为“按量优先”的老张API令牌 | 地址 https://api.laozhang.ai/v1,model: "gpt-6.1-sol",条件见下一节 |
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
几个容易踩的条件:
- Enterprise 和 Edu 默认关闭 GPT-6.1 Sol,要由工作区管理员开启后才会出现。ChatGPT Learn 还特别说明,在客户端里选中新模型并不会改变工作区权限,也不会因此获得访问权。
- 按账户逐步开放。OpenAI 的措辞是“可用时”选择,模型能否出现取决于开放进度、登录方式和客户端版本,同一套餐的两个账户可能不同时看到。
- API 速率上限按组织的使用层级计算:Tier 1 为 500 RPM / 500,000 TPM,Tier 2 为 5,000 / 1,000,000,Tier 3 为 5,000 / 2,000,000,Tier 4 为 10,000 / 4,000,000,Tier 5 为 15,000 / 40,000,000。层级随累计消费自动提升。如果组织里压根看不到 GPT-6 系列模型,项目权限的排查步骤可以参考 GPT-6 Astra API 怎么开通。
- 地区条件。OpenAI 的支持国家和地区列表(截至 2026 年 9 月 25 日)不包括中国大陆、香港和澳门,并写明在列表以外的地区访问或提供访问可能导致账户被封禁或暂停。这一条同时适用于 API 和 ChatGPT。在中国大陆要通过 API 使用 6.1 Sol,可以走 API 网关,条件和实测结果见下一节;网关不改变 OpenAI 对你自己 OpenAI 账户的这条规则。
推理强度在桌面应用、ChatGPT 工作和 IDE 扩展里显示为 Light、Medium、High、Extra High,其中 Light 就是 CLI 里的 Low;Max 和 Ultra 要在 CLI 的 /model 里选中模型后点“More reasoning…”才能看到,是否提供取决于你的设置。ChatGPT Learn 的建议是大多数任务用不到这两档。
Microsoft Foundry、Amazon Bedrock 和 OpenRouter 的模型目录里也能看到 GPT-6.1 Sol。它们的价格、可用区域和配额由各平台自己定,不能直接套用上面的 OpenAI 标价。
国内怎么调用 GPT-6.1 Sol API:老张API的价格与限制
可以经 API 网关调用。laozhang.ai(老张API)在 2026 年 10 月 5 日把 gpt-6.1-sol 加进了老张API模型与价格总表,用老张API的令牌、把地址设为 https://api.laozhang.ai/v1 就能调,Chat Completions(/v1/chat/completions)和 Responses(/v1/responses)两个端点都可用。它是 API 网关,不提供 ChatGPT 或 Codex 订阅;总表里也只有标准价,没有 Fast、Batch、Flex 或超高速档位。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
下面的价格截至 2026 年 10 月 5 日;参数和计费行为来自同一天对 api.laozhang.ai 的一轮实际调用(default 分组、按量计费令牌,每种请求各发一次)。
老张API上的 6.1 Sol 价格:不走缓存时同价,命中缓存按全价
总表给 gpt-6.1-sol 的标价是输入 $2、输出 $10(每百万 token,单次请求输入不超过 272,000 token),超过后整次请求按 $4 / $15 计,分档方式和 OpenAI 直连一样。差别在“缓存读”一栏:gpt-6-sol 是 $0.20,gpt-6.1-sol 是“—”。老张API的提示词缓存计费说明写明,缓存读为“—”的模型没有缓存价,全部按普通输入价计费。
实际扣费和这条规则一致。同一段约 42K token 的前缀连发两次,第二次的 usage 里 cached_tokens 是 42,188,上游缓存确实命中了;可这次请求(42,191 输入、6 输出)扣了 8.4442 美分,正好等于 42,191 × $2 / 1M + 6 × $10 / 1M。同一个请求按 OpenAI 直连标价算是 3 × $2 / 1M + 42,188 × $0.10 / 1M + 6 × $10 / 1M,约 0.43 美分。所以“命中缓存”不等于“按缓存价计费”:响应里的 usage.input_tokens_details.cached_tokens(Responses)或 usage.prompt_tokens_details.cached_tokens(Chat Completions)只说明命中了,实际扣了多少要看老张API控制台的调用日志。
在老张API上,6.1 Sol 的费用这样算:
费用(输入 ≤272K)= 全部输入(含命中缓存的部分)× $2 / 1,000,000
                  + 输出(含推理)× $10 / 1,000,000
沿用前文那轮编程智能体请求(150,000 输入,其中 140,000 命中缓存;3,000 输出),四种走法的标价:
| 走法 | 未缓存输入 | 命中缓存的 140,000 | 输出 | 每轮 | 50 轮 |
|---|---|---|---|---|---|
OpenAI 直连 gpt-6.1-sol | $0.020 | $0.014 | $0.030 | $0.064 | $3.20 |
OpenAI 直连 gpt-6-sol | $0.020 | $0.028 | $0.030 | $0.078 | $3.90 |
老张API gpt-6.1-sol | $0.020 | $0.280 | $0.030 | $0.330 | $16.50 |
老张API gpt-6-sol | $0.020 | $0.028 | $0.030 | $0.078 | $3.90 |
两个模型在老张API上只差缓存这一项:每百万命中缓存的 token,gpt-6.1-sol 比 gpt-6-sol 多付 $1.80($2 − $0.20)。据此可以这样选:
- 请求之间几乎没有共享前缀,比如单次问答、每次内容都不同的抽取或翻译:两边同价。20,000 输入 + 2,000 输出,OpenAI 直连和老张API都是 $0.040 + $0.020 = $0.060。
- 长系统提示、工具定义或对话历史反复发送的智能体循环:缓存占比越高,6.1 Sol 在老张API上越贵,上面这轮约是 OpenAI 直连的 5 倍。截至 10 月 5 日,这类负载在老张API上用
gpt-6-sol,每轮费用和 OpenAI 直连的 6 Sol 相同。 - 6.1 Sol 在你的任务上明显做得更好:多付的部分值不值,按后文的对比方法,用“每个合格结果的成本”来判断。
这些是标价演算,没有计入会话第一次写入缓存的费用、重试,以及两个模型在同一任务上 token 用量的差别;gpt-6.1-sol 第一次写入缓存时怎么扣费没有单独测出,以调用日志为准。总表是标价,账户实际适用的价格看控制台;缓存价以后也可能配置上,用之前先看一眼总表里 gpt-6.1-sol 的缓存读一栏。
经老张API调用:工具调用只能走 Responses
请求(model: "gpt-6.1-sol") | 结果 |
|---|---|
Chat Completions,reasoning_effort: "low" | 成功,响应里的 model 是 gpt-6.1-sol-2026-09-29 |
Chat Completions,reasoning_effort 为 none 或 max | 400:Supported values are: 'low', 'medium', 'high', and 'xhigh'. |
Chat Completions,temperature: 0.2 | 400:Only the default (1) value is supported. |
Chat Completions 带函数工具,reasoning_effort: "low" | 400:Function tools with reasoning_effort are not supported for gpt-6.1-sol in /v1/chat/completions. |
Responses,reasoning.effort 为 low 或 max | 成功 |
Responses,reasoning.effort: "none" | 400:'none' is not supported |
| Responses 带函数工具 | 成功,返回 function_call |
Responses 带内置 web_search 工具 | 成功,返回已完成的 web_search_call |
| 两个端点各发两次相同的约 42K token 前缀 | 第二次 cached_tokens 都是 42,188 |
Chat Completions 带函数工具时,报错建议“改用 /v1/responses 或把 reasoning_effort 设为 'none'”,但 none 本身会被拒绝,所以这条路线上函数调用只能走 Responses。max 在 Chat Completions 上被拒、在 Responses 上可用,从报错看不出是 OpenAI 侧还是网关侧的限制;需要 max 就用 Responses,前文 Chat Completions 示例注释里的 max 经老张API时不要用。
下面这个请求和实测时的函数调用请求结构相同(实测用的是英文提问),返回的 output 里有一项 function_call,名称 get_weather,参数 {"city":"Paris"}:
export LAOZHANG_API_KEY="你的老张API令牌"

curl https://api.laozhang.ai/v1/responses \
  -H "Authorization: Bearer $LAOZHANG_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-sol",
    "reasoning": {"effort": "low"},
    "input": "巴黎现在天气怎么样?请调用工具查询。",
    "tools": [
      {
        "type": "function",
        "name": "get_weather",
        "description": "Get current weather for a city",
        "parameters": {
          "type": "object",
          "properties": {"city": {"type": "string"}},
          "required": ["city"]
        }
      }
    ]
  }'
用 Python SDK 时,前文的函数调用示例只需改客户端初始化,写法来自老张API文档:OpenAI(api_key=os.environ["LAOZHANG_API_KEY"], base_url="https://api.laozhang.ai/v1"),并在文件开头 import os。
报 503 no available channels:令牌计费模式选错了
完整报错:
Current group default has no available channels for model gpt-6.1-sol under billing mode [pay-per-request]原因是令牌的计费模式选了“按次计费”。这种令牌只能调用按次计费的模型(主要是图像模型),gpt-6.1-sol、gpt-6-sol、gpt-6-luna 都会返回这个 503,不扣费。到老张API控制台的令牌管理页把计费模式改成“按量优先”,或者新建一个按量优先的令牌,分组保持 default。改完用 GET https://api.laozhang.ai/v1/models 看一下列表里有没有 gpt-6.1-sol,这个列表就是当前令牌能调用的模型。几种计费模式的区别见老张API计费说明。
经老张API用 Codex 跑 6.1 Sol:有配置文档,组合没测过
老张API的 Codex CLI 接入文档用 config.toml 里的自定义 provider 接入:base_url = "https://api.laozhang.ai/v1"、wire_api = "responses",示例模型是 gpt-6-sol。把 model 换成 gpt-6.1-sol,请求走的是上面已经调通的 Responses 端点,函数调用和内置网络搜索也单独调通了,但 Codex CLI 加 gpt-6.1-sol 这个组合本身没有跑过。另外,Codex 每一步都会带上对话历史、文件内容和工具定义,正是缓存占比最高的那类负载;按上面的算例,截至 10 月 5 日在老张API上让 Codex 用 gpt-6-sol,每轮约为 6.1 Sol 的四分之一。
这条路线上同样没有测过的还有:流式输出、输入超过 272K 的请求、service_tier 各档位、内置工具的另计费用,以及 gpt-6.1-sol 的速率和并发上限。
换之前,用自己的任务做一次对比
OpenAI 的测评结论再好,也不等于在你的代码库、你的提示词上同样成立。一个成本不高的对比办法:
- 从近期真实工作里挑 5 到 10 个有代表性的任务,最好包含一两个你知道 6 Sol 做得不好的。
- 两边用同样的提示词和工具。6 Sol 原来是
none/minimal的,6.1 Sol 用low;其余档位先保持一致,再各往下试一档。 - 每次请求记录用量:Responses API 返回的
usage里有input_tokens、input_tokens_details.cached_tokens、output_tokens和output_tokens_details.reasoning_tokens。用前面的公式算出每个任务的实际花费。 - 按“一次做对”统计:通过测试或人工验收的才算完成,失败重试的费用要算进这个任务。
- 如果你的任务带图片输入,而 6 Sol 的对照结果是 9 月 25 日之前跑的,先重跑 6 Sol。OpenAI 那天修复了一个让 GPT-6 Sol 和 Luna 图片理解变差的编码问题,旧结果可能低估 6 Sol 的视觉表现。
看结果时,把“每个合格结果的成本”当主指标,而不是单价。6.1 Sol 如果用更低的推理强度就能做对,输出 token 会少,账单降得比缓存折扣更明显;反过来,如果它在你的任务上想得更久,标价相同也可能更贵。
GPT-6 Sol 还能用多久
截至 2026 年 10 月 5 日,gpt-6-sol 不在 OpenAI 的弃用页上,也就是没有公布停用日期;但它已经从定价页的主表里消失,模型页也指向 GPT-6.1 Sol。10 月 1 日弃用页新增的几条里,gpt-5.1 和 gpt-5.3-codex 的替代模型写的正是 gpt-6-sol,这两个旧模型将在 2027 年 4 月 1 日从 API 下线。现有代码暂时不必匆忙改,新项目直接用 gpt-6.1-sol 更省事;经老张API调用、缓存占比又高的负载例外,原因见上文的成本表。
ChatGPT 里,GPT-6 Sol 目前仍和 6.1 Sol、Luna 一起出现在工作和 Codex 中。另一个有明确日期的变化是:GPT-5.5 将于 2026 年 10 月 14 日从 ChatGPT、ChatGPT 工作和 Codex 的所有套餐中退役,这条不影响 API。还在 Codex 里用 GPT-5.5 的,可以趁这次一并切到 6.1 Sol。
按 GPT-6 Sol 缓存单价算出的对比,换到 6.1 Sol 时要把缓存输入改为 $0.10 重算。例如 Claude Opus 5.5 对比 GPT-6 Sol 里的成本算法仍可沿用,但缓存那一项的结论对 6.1 Sol 不再成立;GPT-6 Sol、Luna、Astra 与 Terra 怎么选可以用来了解 6.1 发布之前的型号阵容。
常见问题
GPT-6.1 Sol 比 GPT-6 Astra 强吗?
按 OpenAI 自己的测评,不比 Astra 强,而是在多项任务上接近 Astra,价格低得多:标准输入和输出是 Astra 的五分之一,缓存输入是十分之一。OpenAI 也明确说最难的任务(例如最具挑战性的科研任务)仍应使用 Astra。三者的测评与单任务成本对比,见GPT-6.1 Sol、GPT-6 Sol、Astra 怎么选。
ChatGPT 免费版或 Go 能用 GPT-6.1 Sol 吗?
发布时不能。可用的是 Plus、Pro、Business、Enterprise 和 Edu,而且只在 ChatGPT 工作和 Codex 中,普通聊天里选不到。API 的免费层同样不支持这个模型。
gpt-6.1-sol 有带日期的快照吗?
截至 2026 年 10 月 5 日,模型页的快照栏只有 gpt-6.1-sol 这一个名字,没有带日期的版本。经老张API调用时,响应里的 model 字段显示为 gpt-6.1-sol-2026-09-29,但这个名字不在模型页上,直接在请求里指定它能否调用没有测试过。需要锁定行为的生产环境,要留意后续是否出现正式快照。
在国内能用 GPT-6.1 Sol 的 API 吗?
OpenAI 直连的支持地区不含中国大陆、香港和澳门。可以经 laozhang.ai(老张API)调用 gpt-6.1-sol:截至 2026 年 10 月 5 日标价与 OpenAI 相同($2 / $10),但缓存命中按普通输入价计费,工具调用要走 Responses,令牌的计费模式要选“按量优先”或“按量计费”。缓存占比高的智能体任务,在老张API上用 gpt-6-sol 更便宜。
请求里写 reasoning_effort: "none" 会怎样?
GPT-6.1 Sol 不支持 none 和 minimal,这样的请求需要改成 low 及以上才能按预期运行。改完后记得同时去掉 temperature、top_p 等参数,它们只在推理强度为 none 时可用。
参考来源9
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月26日。
参考来源9
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月26日。
- 1.模型指南developers.openai.com/api/docs/guides/latest-model
- 2.GPT-6 Sol 的模型页developers.openai.com/api/docs/models/gpt-6-sol
- 3.发布公告openai.com/index/introducing-gpt-6-1-sol
- 4.GPT-6.1 Sol 模型页developers.openai.com/api/docs/models/gpt-6.1-sol
- 5.定价页developers.openai.com/api/docs/pricing
- 6.DevDay 2026 回顾openai.com/index/devday-2026-recap
- 7.ChatGPT Learn 的模型页learn.chatgpt.com/docs/models
- 8.API 更新日志developers.openai.com/api/docs/changelog
- 9.弃用页developers.openai.com/api/docs/deprecations