Gemini 4 Carbon 和 GPT-6.1 Sol 编程对比:同题 Carbon 更贵更慢
到 11 月 30 日两者 API 单价相同,但同样 7 道编程题都全对时,Carbon 花费约是 Sol 的 7 倍。日常写代码先用 Sol,Carbon 留给终端里的长任务。
文章目录
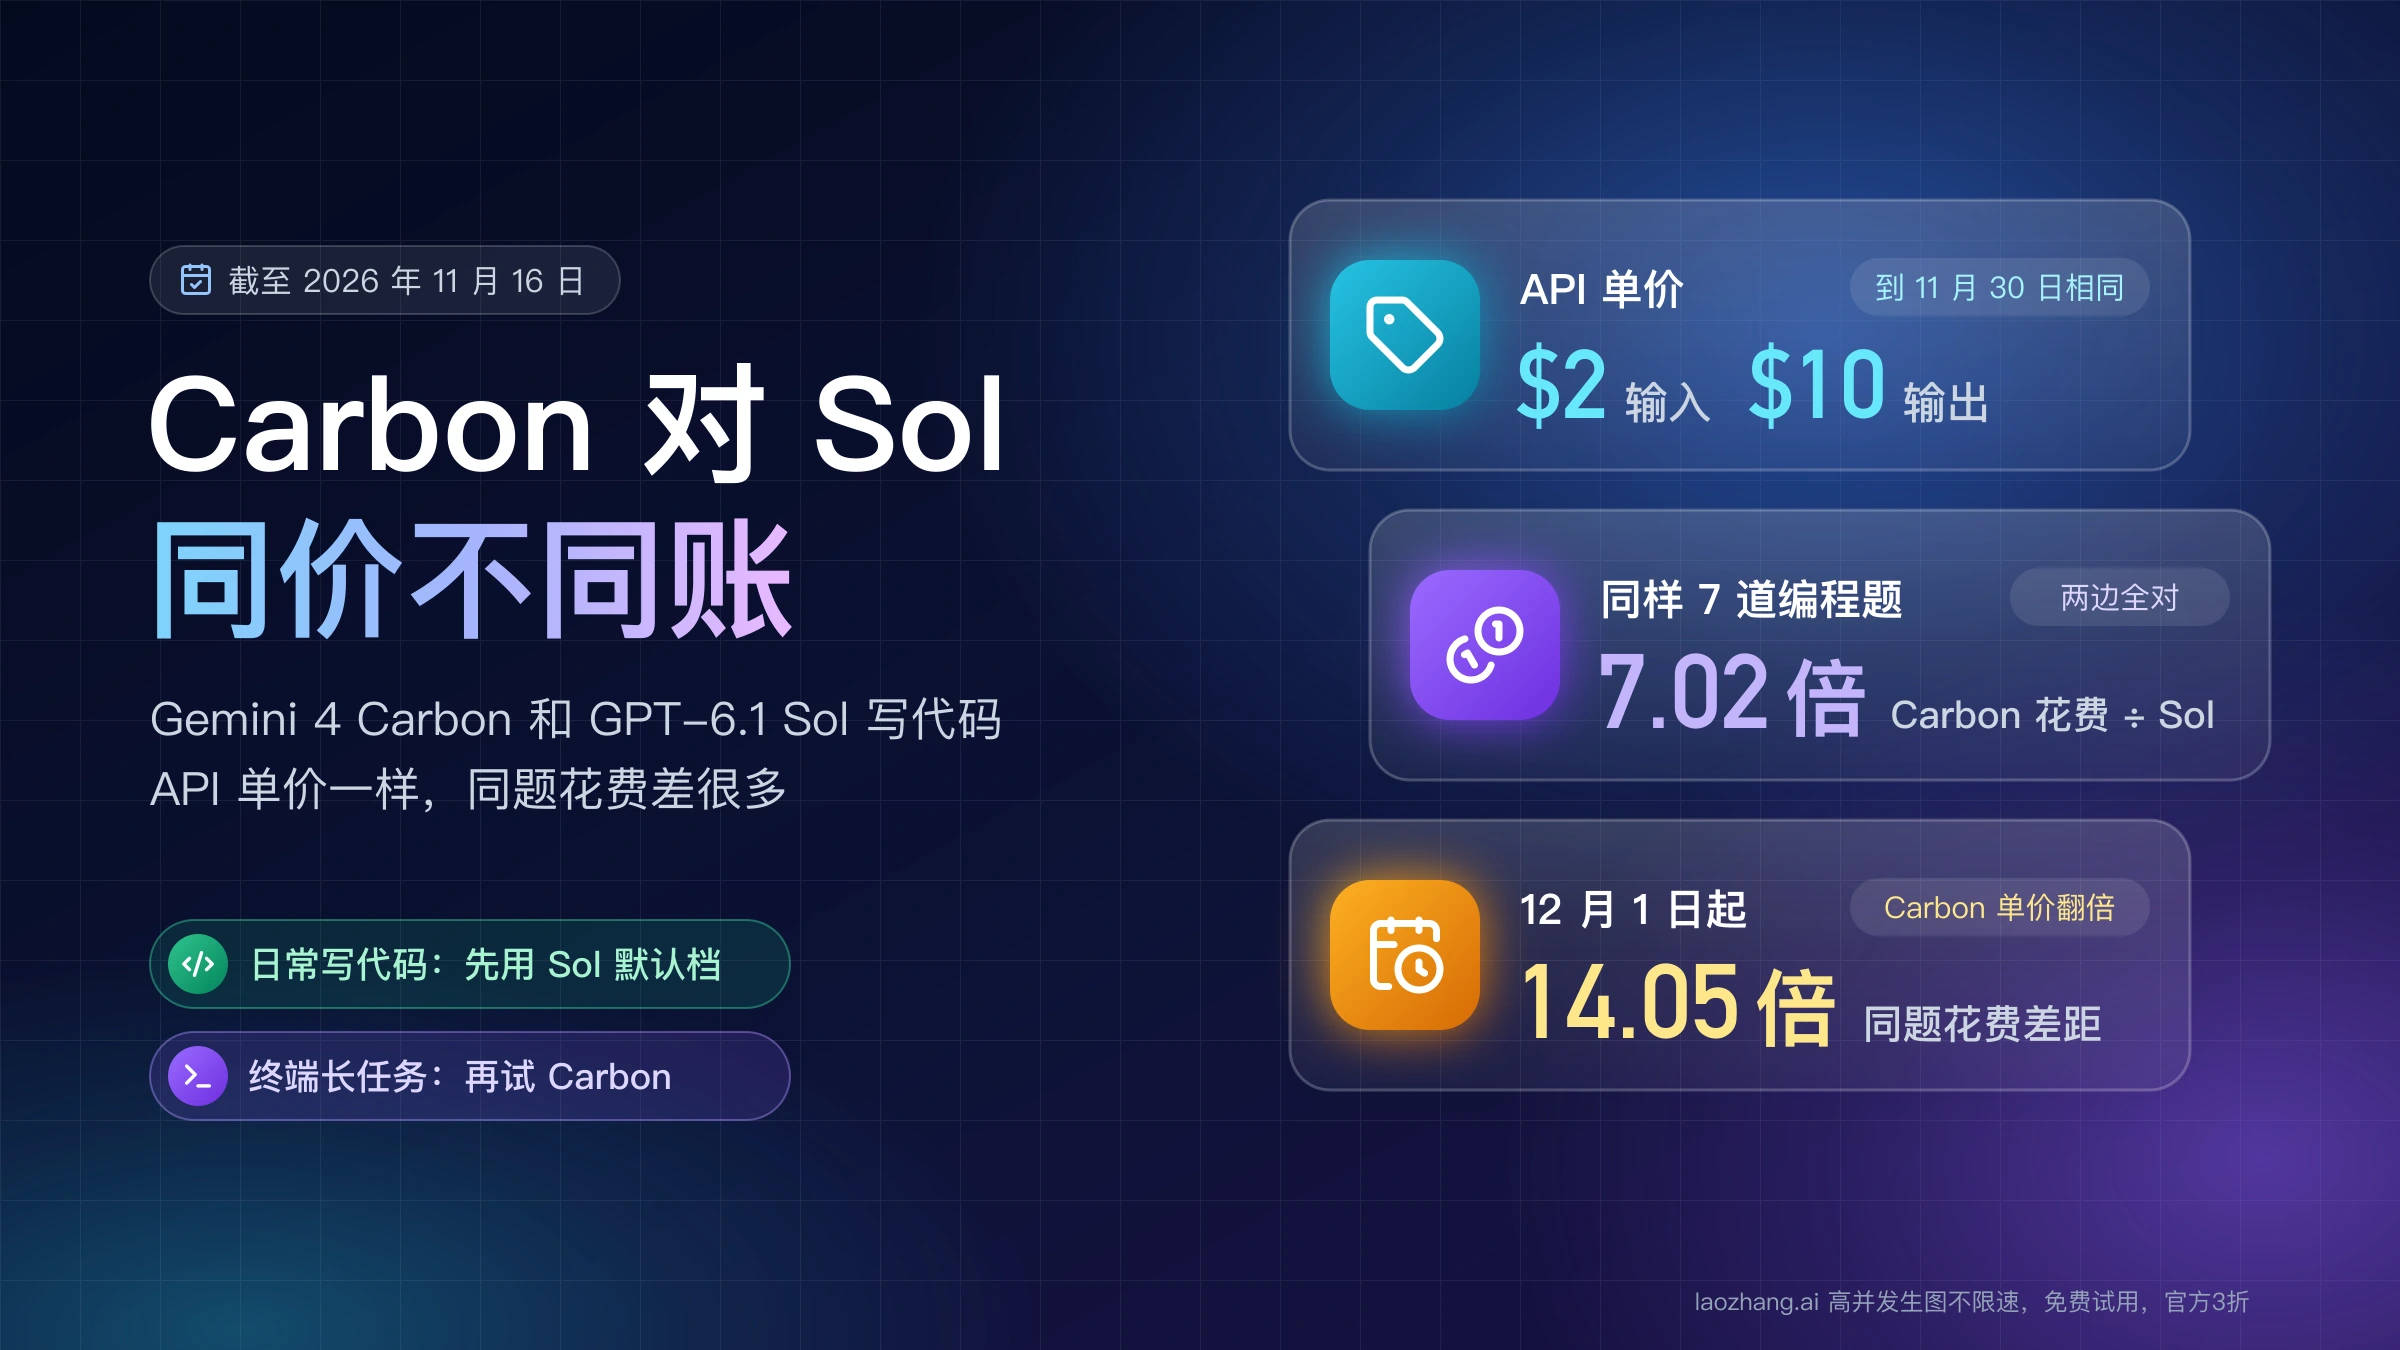
截至 2026 年 11 月 16 日,Gemini 4 Carbon(gemini-4-carbon,11 月 10 日正式开放)和 GPT-6.1 Sol(gpt-6.1-sol)的 API 单价完全一样,Artificial Analysis(下称 AA)榜单上 Carbon 的分数更高,但同一道编程题两者花的钱差得很远。用同样 7 道带隐藏测试的编程题,经 LaoZhang 网关分别在 2026 年 10 月 28 日测 Sol、11 月 11 日和 16 日测 Carbon,两边默认档全部通过,Carbon 的合计花费约是 Sol 的 7 倍、耗时约 3.4 倍,多出来的几乎都是思考 token。
所以日常写代码,也就是题目明确、能用测试验收的活,先用 gpt-6.1-sol 的默认档 medium,不够再往 high、xhigh 加。Carbon 的领先集中在终端里多步执行的长任务上:AA 的 Terminal-Bench 4.0 里 Carbon high 是 65.2%,Sol 开到 max 是 56.1%。这类任务通过率明显影响你的返工成本时,再拿 Carbon 的默认档 medium 去试;它降到 low 在 AA 上并不更省,开到 high 则在同题测试里花费是默认档的约 6 倍。
日期会改变这个账。2026 年 12 月 1 日起 Carbon 单价翻倍,同样 7 道题的花费差距会再翻一倍,到那时除非 Carbon 在你自己的任务上通过率明显更高,否则日常编程没有理由交给它。另一个例外是单次输入超过 272K token 的请求:Sol 整单加价,Carbon 不加,两者的单价差距会缩小。
同一道编程题实测:两边都全对,Carbon 花费约是 Sol 的 7 倍
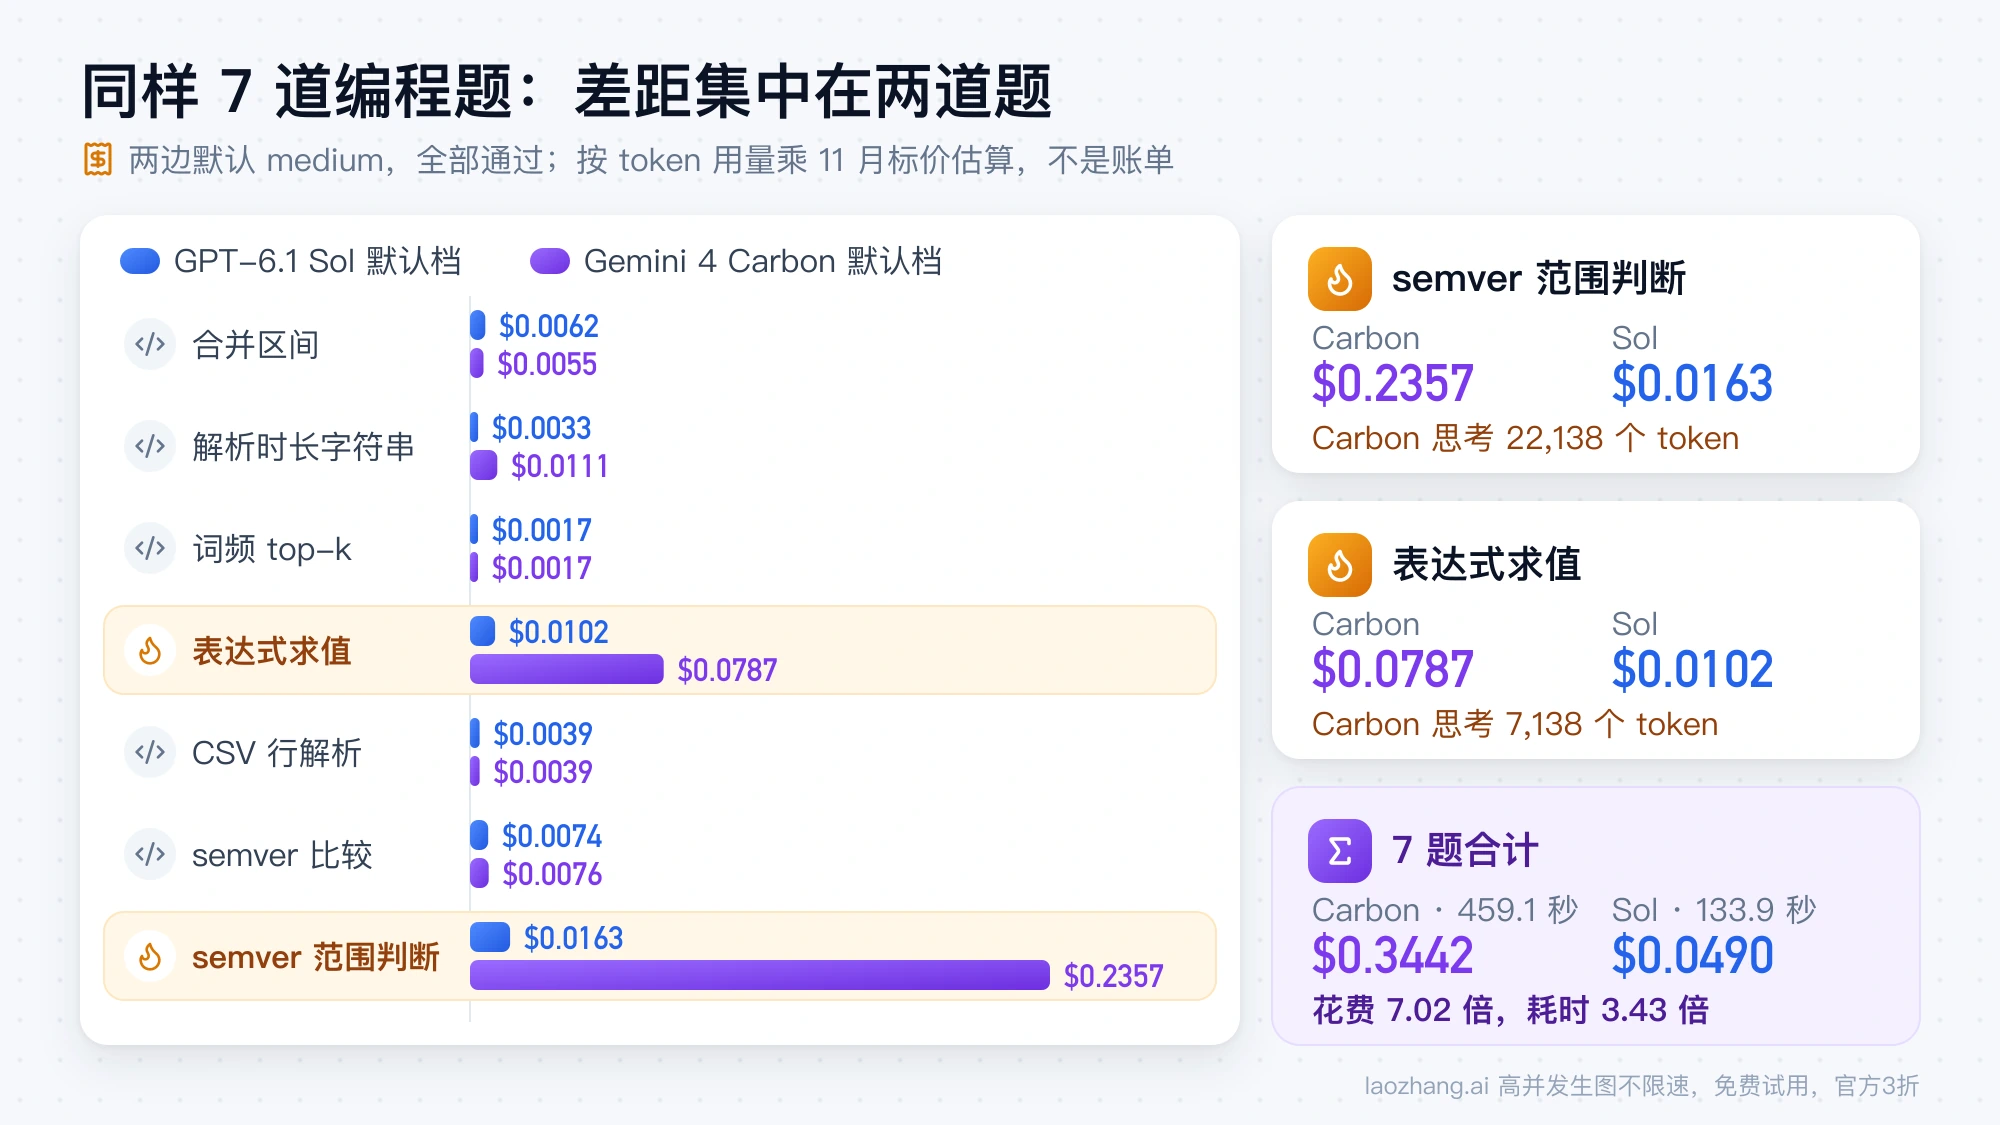
在题目小而明确、两边都能做对的编程题上,Carbon 默认档的花费和等待时间都明显多于 Sol 默认档,原因是它在部分题上写了上万个思考 token。测试经 LaoZhang 网关调用:Sol 在 2026 年 10 月 28 日走 /v1/chat/completions,Carbon 在 2026 年 11 月 11 日和 16 日走 Gemini 原生的 generateContent;两边题面逐字相同、用同一套隐藏测试判分,无系统提示、无工具、单轮,"默认"指不传推理参数(两边官方默认都是 medium)。花费按返回的 token 用量乘 11 月的标价估算,不是账单。
| 编程题 | Sol 默认 medium | Sol high | Carbon 默认 medium |
|---|---|---|---|
| 合并区间 | $0.0062 / 17.2 秒 | $0.0085 / 21.2 秒 | $0.0055 / 8.6 秒 |
| 解析时长字符串 | $0.0033 / 10.5 秒 | $0.0050 / 13.5 秒 | $0.0111 / 50.7 秒 |
| 词频 top-k | $0.0017 / 6.7 秒 | $0.0031 / 10.3 秒 | $0.0017 / 23.7 秒 |
| 表达式求值 | $0.0102 / 26.2 秒 | $0.0157 / 45.9 秒 | $0.0787 / 78.0 秒 |
| CSV 行解析 | $0.0039 / 11.5 秒 | $0.0064 / 18.6 秒 | $0.0039 / 8.7 秒 |
| semver 比较(30 个测试) | $0.0074 / 16.8 秒 | $0.0113 / 29.1 秒 | $0.0076 / 5.4 秒 |
| npm 式 semver 范围判断(36 个测试) | $0.0163 / 45.0 秒 | $0.0358 / 99.3 秒 | $0.2357 / 284.0 秒 |
| 7 题合计,全部通过 | $0.0490 / 133.9 秒 | $0.0859 / 237.9 秒 | $0.3442 / 459.1 秒 |
合计这一行的读法是:Carbon 默认档输出 34,088 个 token,其中思考 30,047 个,Sol 默认档只输出 4,613 个,所以 Carbon 的花费是 Sol 的 7.02 倍($0.3442 ÷ $0.0490)、耗时 3.43 倍;就算把 Sol 开到 high,Carbon 默认档的花费仍是它的 4.01 倍、耗时 1.93 倍。差距并不均匀,主要来自两道题:semver 范围判断上 Carbon 思考了 22,138 个 token,花费 $0.2357 对 $0.0163;表达式求值上思考 7,138 个,花费 $0.0787 对 $0.0102。合并区间、词频、CSV、semver 比较四题 Carbon 默认档的思考 token 是 0,花费和 Sol 相差不到 15%,有的还更快。也就是说,Carbon 默认档的思考量取决于它怎么判断题目难度,从 0 到 2 万多个 token 不等,合计倍数会随你的题目构成变化。
另外 4 道非编程题里,应用题、数位和计数、一篇 6,723 词长文的五点摘要,两个模型都答对了。差别出在一道 Python 3.13 标准库问答上,题里混进了两个并不存在的函数:Sol 在 10 月 28 日两档都回答这两个函数不存在;Carbon 默认档在 11 月 16 日对 functools.memoize_method 答了不存在,对 statistics.winsorized_mean 却给出了一句功能描述,那次调用的思考 token 是 0。这只是一个样本,不能据此说 Carbon 爱编造 API,AA 的事实问答分项 AA-Omniscience v1.1 里 Carbon high 是 54 分、Sol max 是 42 分,方向正好相反;但它提醒你,让 Carbon 默认档凭记忆回答库函数细节时,结果最好对照文档或跑一下。算上这道题,11 题合计 Sol 默认档 11/11、$0.0897、182.1 秒,Carbon 默认档 10/11、$0.4421、574.8 秒。
这组测试有几条边界。Sol 和 Carbon 不是同一天测的,每个格子只有 1 个样本,题目小、两边几乎全对,所以它比的是花费、输出量和等待时间,不是谁的能力上限更高;能力差距要看下一节的 AA 数据。社区里也有指向同一方向的个人单次测试:据 X 用户 EnvolDev 的一次同提示词测试,Carbon 用了 $8.83、2 小时 39 分,Sol 用了 $3.11、54 分钟,不过那是 3D 场景生成任务,不是带测试的编程题。
榜单上 Carbon 领先在哪:终端任务高 9 个百分点,FrontierCode 打平
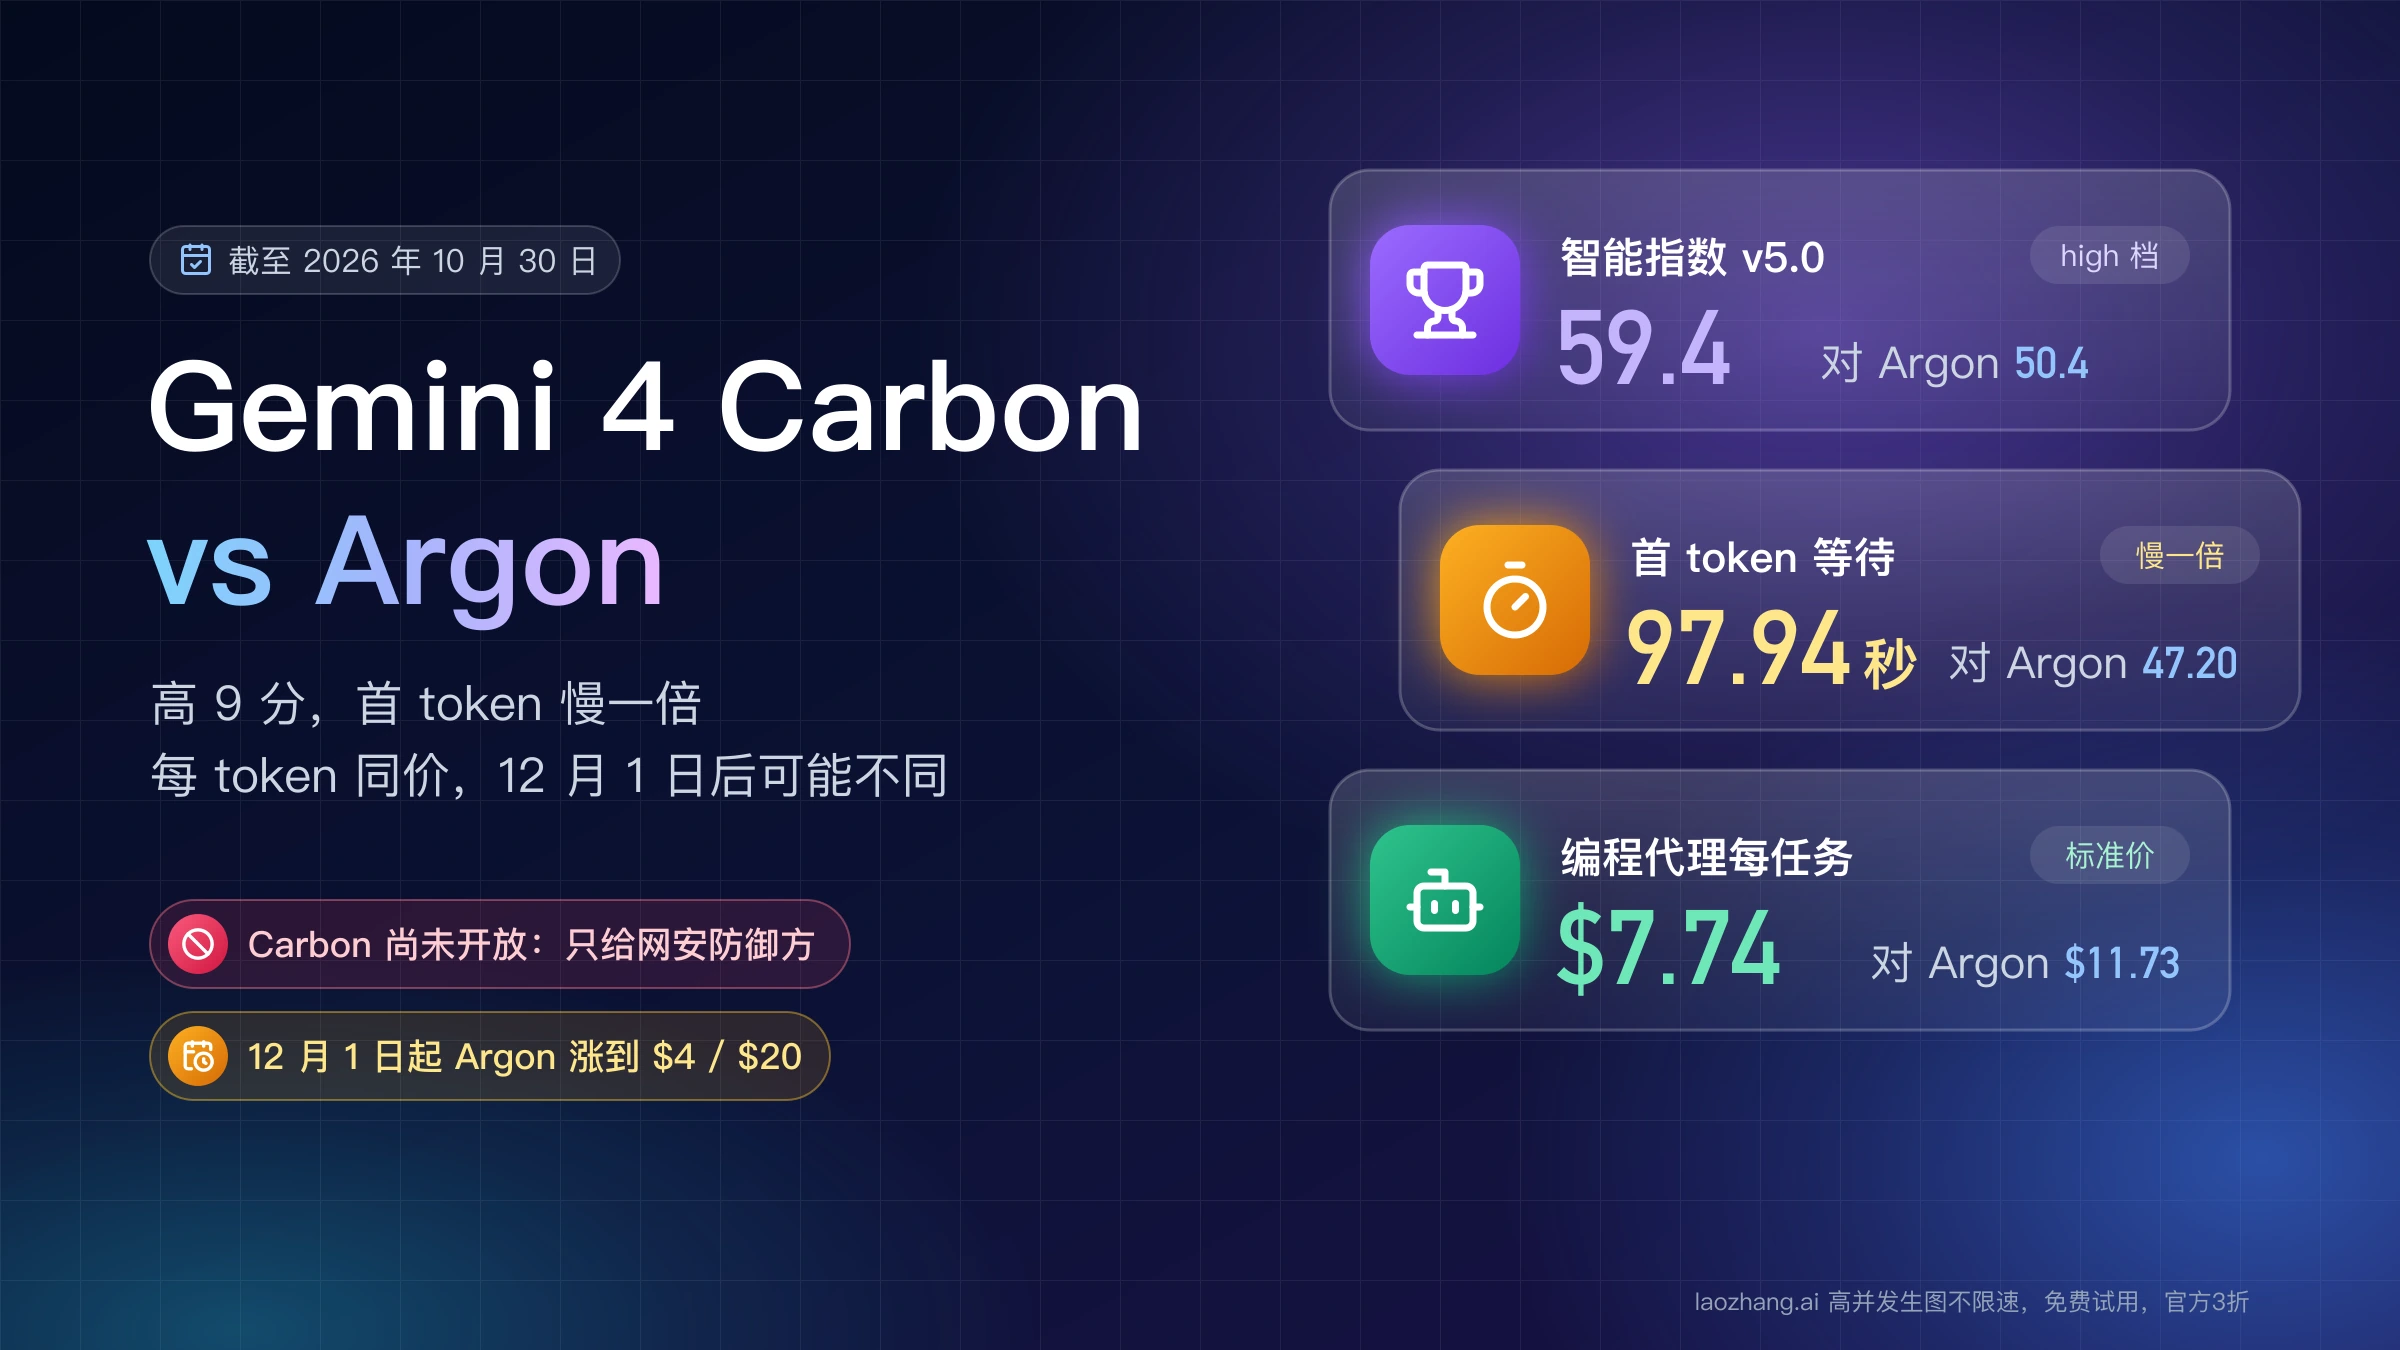
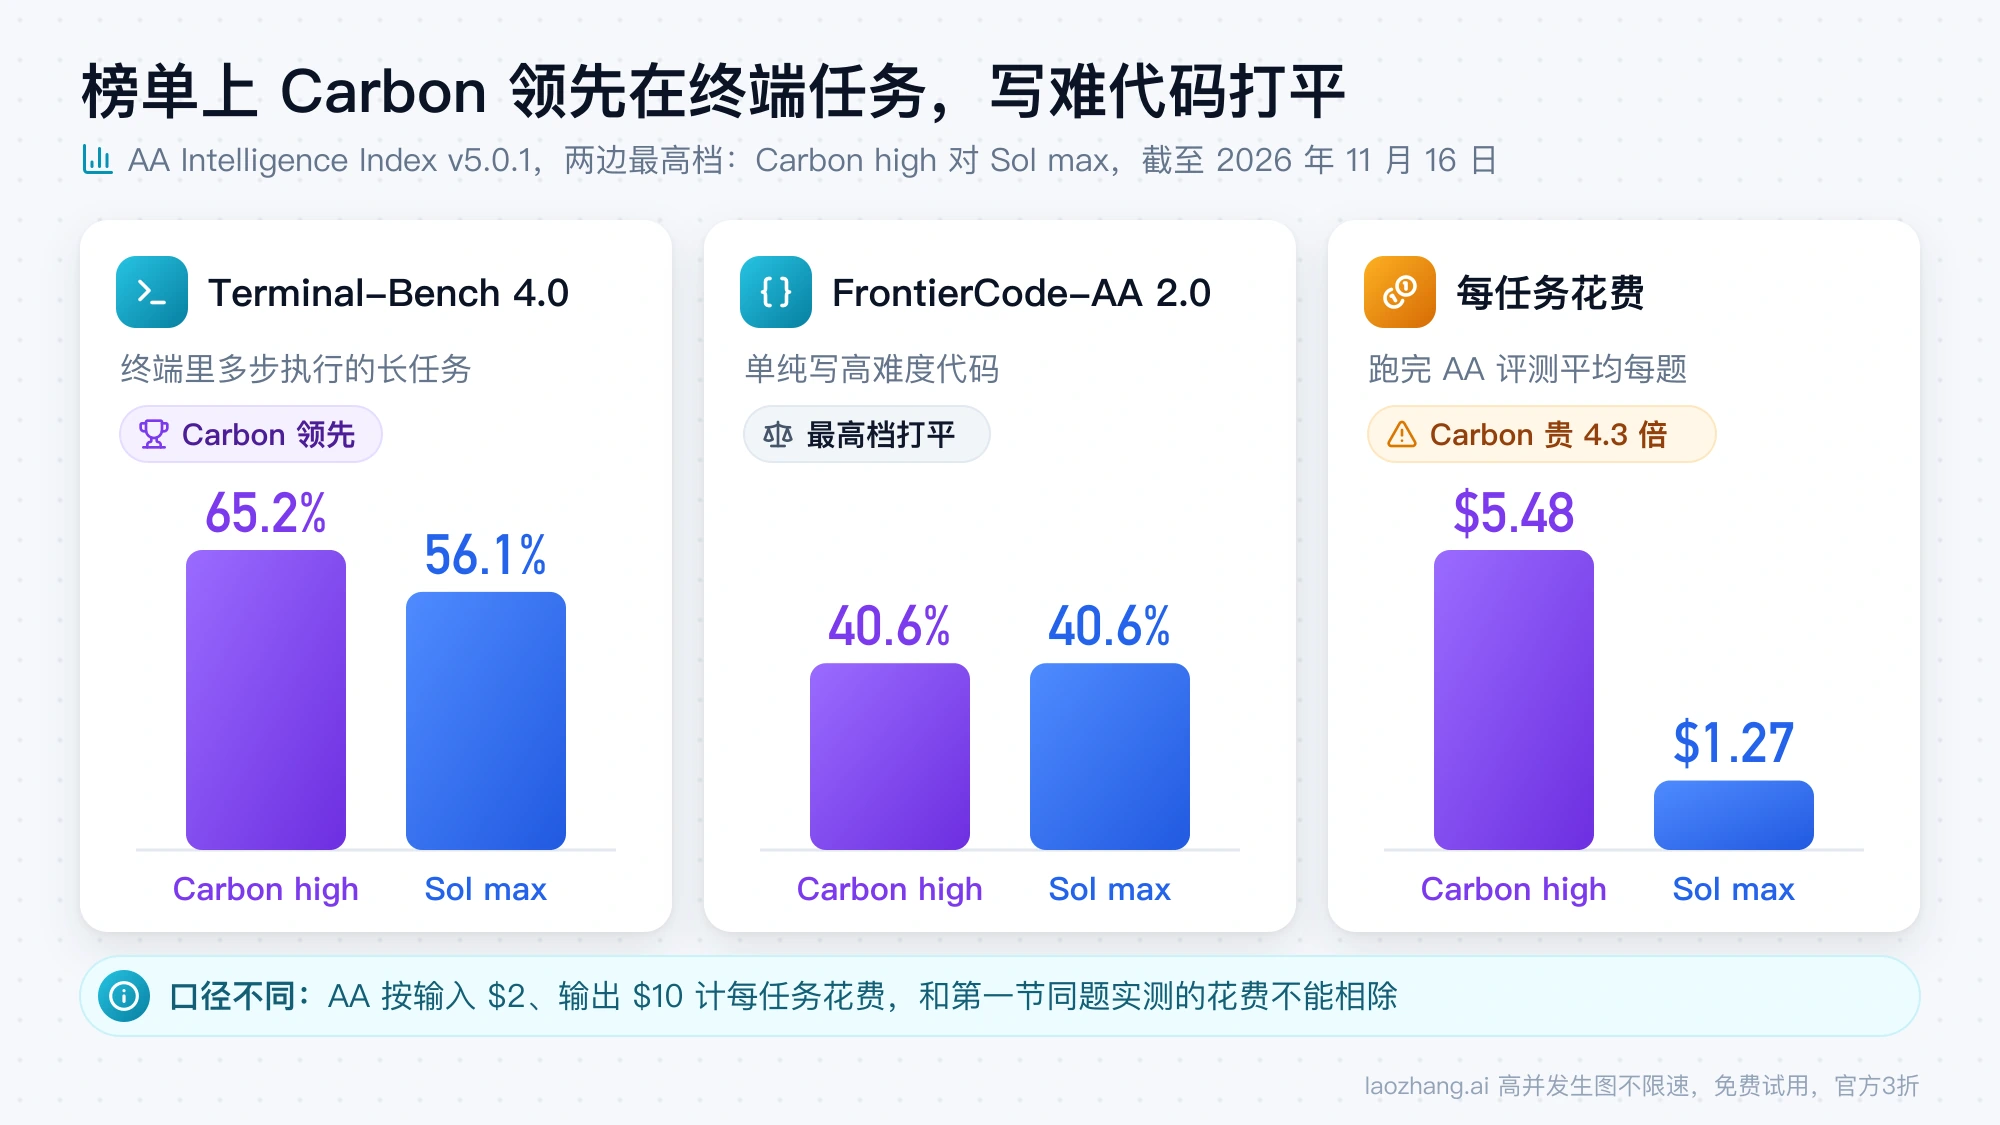
Carbon 的领先主要在终端里多步执行的任务上,写高难度代码的 FrontierCode 两边最高档打平。截至 2026 年 11 月 16 日,AA 的 Gemini 4 Carbon 与 GPT-6.1 Sol 发布对比页按 Intelligence Index v5.0.1 列出了两个模型的全部档位,下表只取和写代码有关的分项。每任务花费和耗时是跑完 AA 这套评测平均每题的数,AA 给两者都按输入 $2、输出 $10 计,和上一节的同题花费不是一个口径,不能相除。
| 模型与档位 | 智能指数 | Terminal-Bench 4.0 | FrontierCode-AA 2.0 | 每任务花费 | 每任务耗时 |
|---|---|---|---|---|---|
| Carbon high | 60 | 65.2% | 40.6% | $5.48 | 32.1 分钟 |
| Carbon medium | 58 | 60.6% | 39.5% | $4.68 | 28.0 分钟 |
| Carbon low | 54 | 62.6% | 29.6% | $5.22 | 25.9 分钟 |
| Sol max | 55 | 56.1% | 40.6% | $1.27 | 22.7 分钟 |
| Sol xhigh | 52 | 54.0% | 38.5% | $0.76 | 9.8 分钟 |
| Sol high | 50 | 51.5% | 36.7% | $0.59 | 7.6 分钟 |
| Sol medium | 46 | 48.0% | 33.4% | $0.36 | 4.4 分钟 |
| Sol low | 35 | 30.8% | 20.2% | $0.16 | 1.9 分钟 |
Terminal-Bench 4.0 上 Carbon 的三档都高过 Sol 的 max,连 Carbon low 的 62.6% 也比 Sol max 高 6.5 个百分点;用代码做科研任务的 Terminal-Bench-Science 0.1 也是这样,Carbon 三档 61.9%–64.8%,Sol max 58.1%。FrontierCode-AA 2.0 就不同了:Carbon high 和 Sol max 都是 40.6%,Carbon low 的 29.6% 还低于 Sol medium 的 33.4%。所以"Carbon 写代码更强"只在终端、多步执行这一类任务上成立,单纯写难代码,两边开到最高档是一样的。
分数之外要一起看花费。Carbon high 比 Sol max 高 5 分,每任务花费是它的 4.3 倍($5.48 ÷ $1.27);分数最接近的一对是 Carbon low 54 分对 Sol max 55 分,Carbon 花 $5.22,Sol 花 $1.27。这些花费都按 11 月的价格计,12 月 1 日之后的变化见价格一节。
放进 Antigravity 和 Codex:Carbon 高 3.3 分,每任务花费是 4.7 倍
如果你在编程代理里用,AA 的 Coding Agent Index 给出的答案和上一节方向一致:Carbon 分数略高,花费和时间都多得多。截至 2026 年 11 月 16 日,这个榜单 v2.1 里 Antigravity CLI 加 Gemini 4 Carbon(high)是 55.5 分,每任务 $7.13、33.6 分钟、平均 186 步;Codex 加 GPT-6.1 Sol(max)是 52.2 分,每任务 $1.51、21.9 分钟、平均 43 步。榜单由 FrontierCode-AA 2.0(132 题)、Terminal-Bench 4.1(66 题)和 SWE-Atlas-QnA-AA(124 题)等权组成,每题跑三次。
分项里两边各有胜负。Terminal-Bench 上 Carbon 通过了 198 次尝试中的 129 次,Sol 是 107 次;FrontierCode 上反过来,396 次尝试里 Sol 通过 183 次,Carbon 是 166 次。要注意这个榜比的是"模型加自家代理"两个产品,没有 Carbon 放进 Codex 或 Sol 放进 Antigravity 的对照,Sol 也只测了 max 一档,所以它回答的是"Antigravity CLI 和 Codex 哪个代理更合适",不是同一个代理里换模型的结果。按步数看,Carbon 在 Antigravity 里平均要走 186 步,Sol 在 Codex 里 43 步,长任务里你要盯的中间过程也会多很多。
各开哪一档:Carbon 留在默认 medium,Sol 从 medium 往上加
两边的档位刻度不同,Carbon 的 thinking level 只有 low、medium、high,Sol 的 reasoning effort 有 low、medium、high、xhigh、max,同名的 high 不是同一个强度,不能当成同档比较。各自怎么开,结论是 Carbon 基本不用调,Sol 按难度往上加。
Carbon 的三档在 AA 上每任务花费挤在一起,medium 的 $4.68 反而是三档里最便宜的,low 是 $5.22,降档省不了钱,分数却从 58 掉到 54。往上开 high 在同题测试里代价很大:两边都做过的 5 道编程题,Carbon high 全部通过,但花费 $0.6121、耗时 614.5 秒,花费是它默认档($0.1009、169.7 秒)的约 6 倍、耗时约 3.6 倍,分别是 Sol high($0.0387、109.5 秒)的 15.82 倍和 5.61 倍。Carbon high 在一道长日志题上还两次用完输出上限没给出答案,见长输入一节。所以 Carbon 留在默认的 medium,只有 medium 做不对时再试 high,并给 maxOutputTokens 留足空间。
Sol 则是档位越高越贵、分数也越高:AA 上从 low 到 max,每任务花费从 $0.16 涨到 $1.27,约 8 倍,分数从 35 到 55。日常编程从默认 medium 开始,过不了再升 high 和 xhigh,max 留给最难的任务。开到高档等待时间会明显变长,AA 测得 Sol max 的首个答案 token 要 166.70 秒,medium 只要 4.81 秒;嫌慢时怎么调,见 GPT-6.1 Sol 很慢怎么办:先分清原因,降档实测耗时减半。
API 价格和 12 月 1 日涨价:Carbon 同题花费变成 Sol 的 14 倍
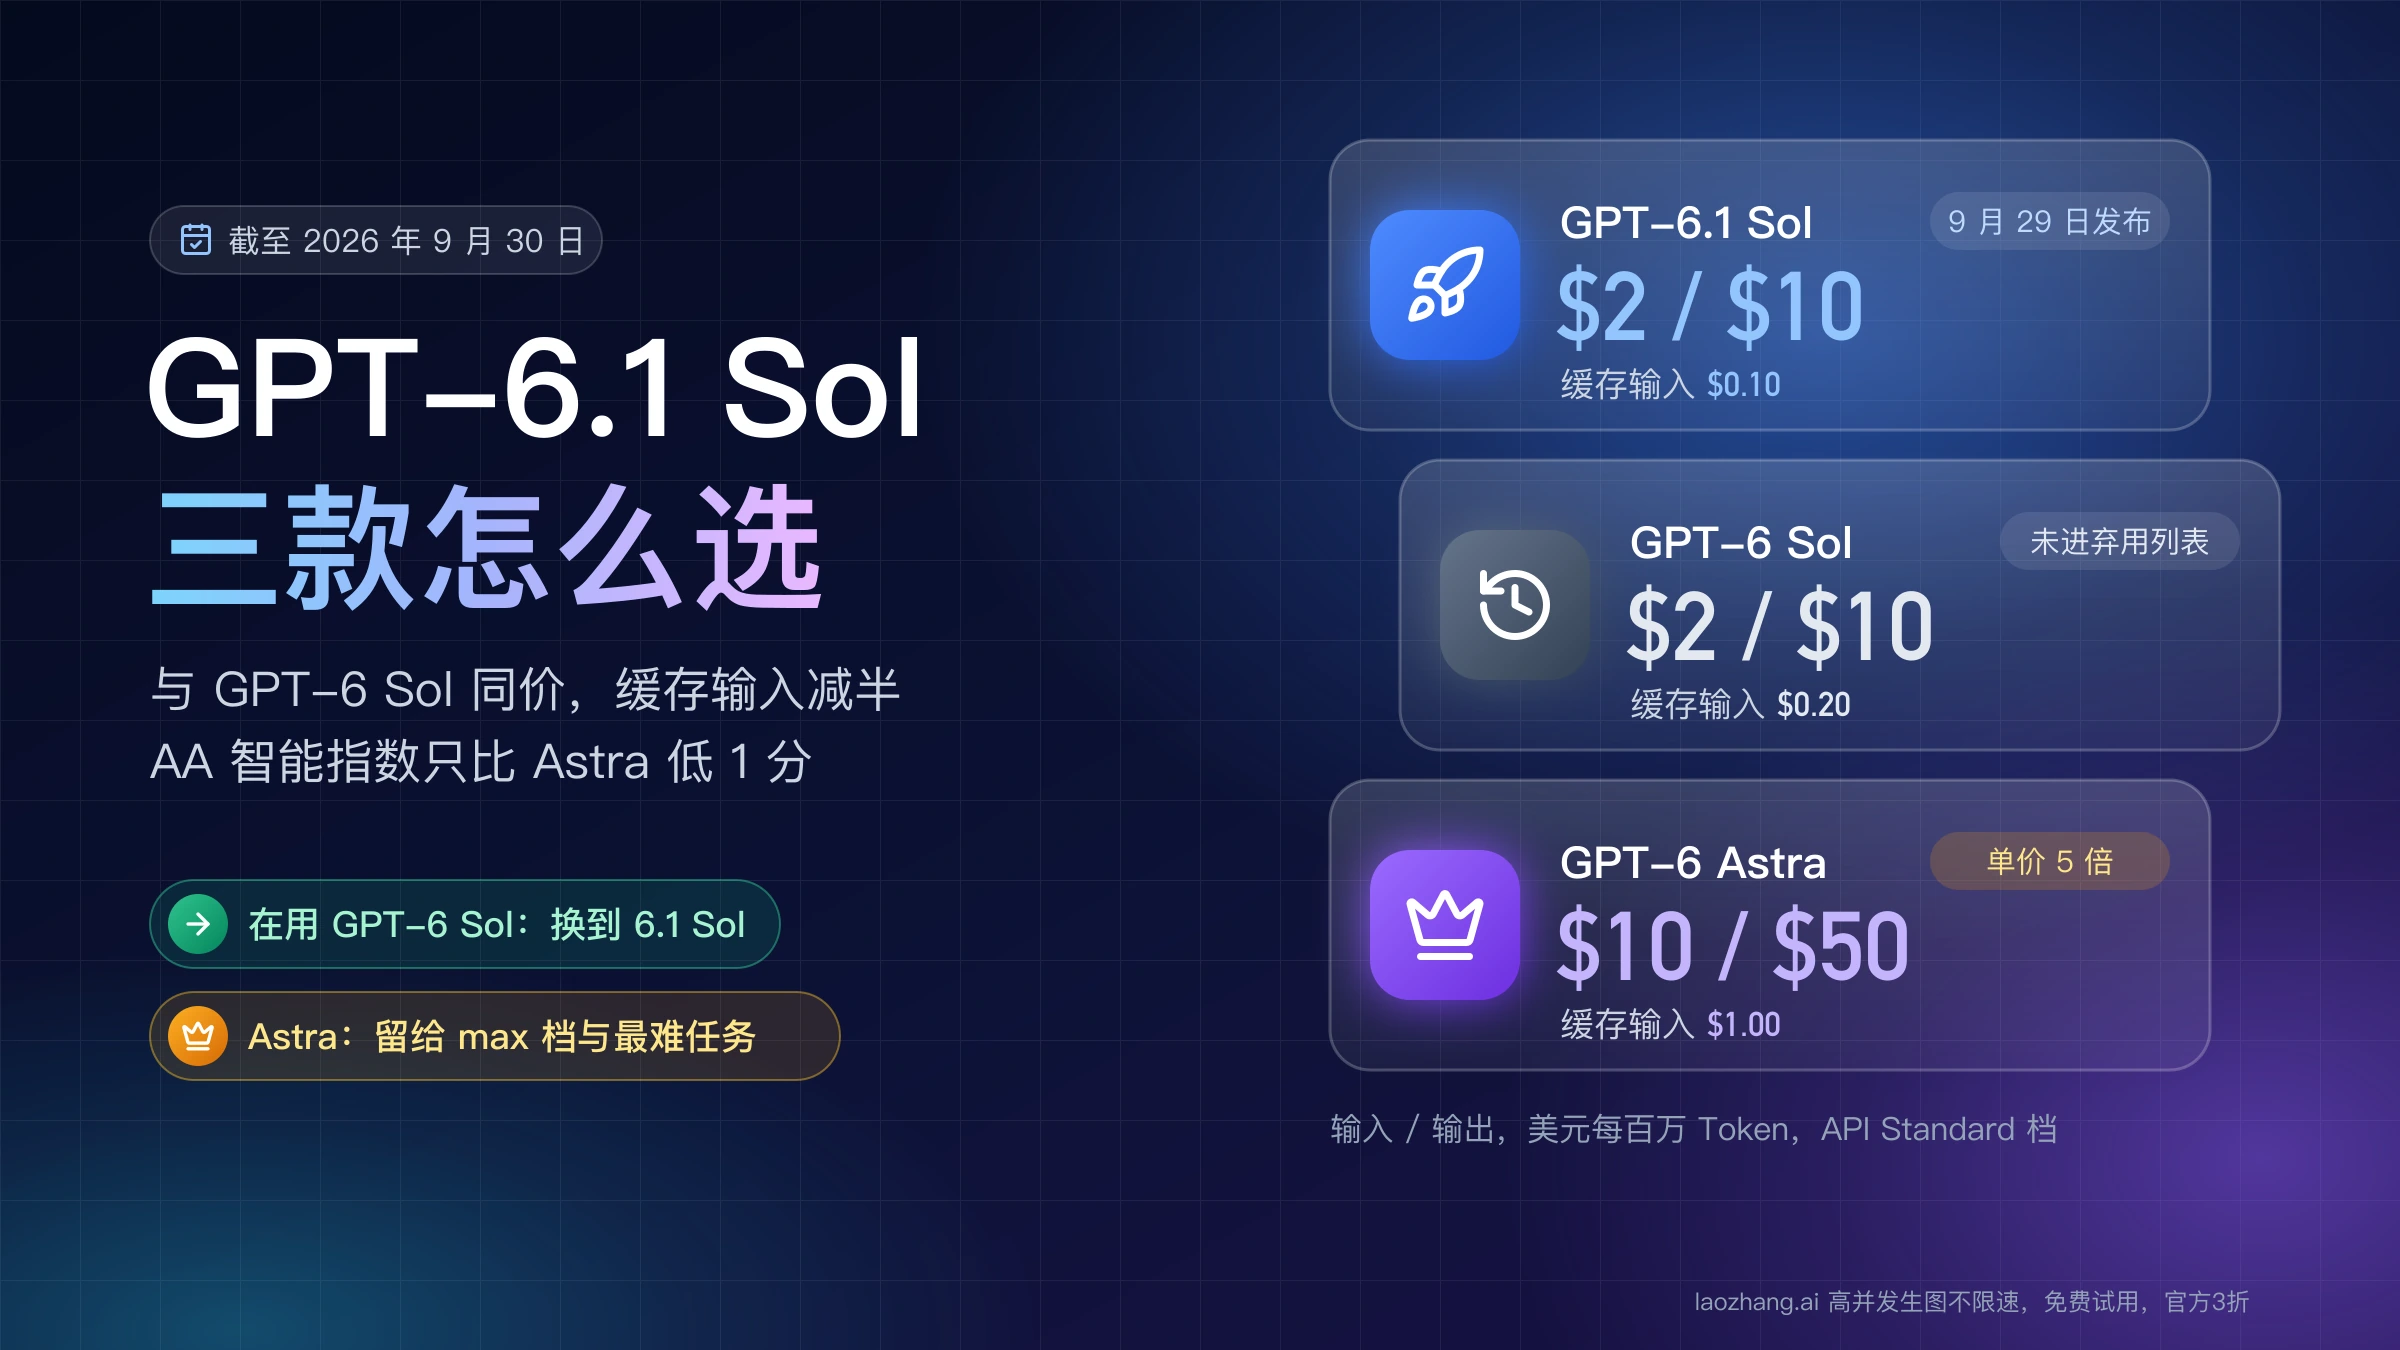
到 2026 年 11 月 30 日,单次输入不超过 272K token 时,Carbon 和 Sol 的 API 单价完全一样;12 月 1 日起 Carbon 每一项都翻倍,变成 Sol 的 2 倍。下表按 Google 的 Gemini API 价格页和 OpenAI 的 GPT-6.1 Sol 模型页整理,单位是美元 / 每百万 token,Standard 档,截至 2026 年 11 月 16 日。
| 计价项 | Gemini 4 Carbon 到 11 月 30 日 | Gemini 4 Carbon 12 月 1 日起 | GPT-6.1 Sol |
|---|---|---|---|
| 输入(272K 以内) | $2.00 | $4.00 | $2.00 |
| 输出,含思考 token | $10.00 | $20.00 | $10.00 |
| 缓存输入 | $0.10 | $0.20 | $0.10 |
| 输入超过 272K 时的输入 / 输出 | $2.00 / $10.00,不加价 | $4.00 / $20.00,不加价 | $4.00 / $15.00,整单加价 |
两边的 Batch 都是半价。Sol 另有 Flex(半价)、Fast(2 倍)和 Ultrafast(6 倍)几种服务档,缓存写入按 $2.50 计;Carbon 只有隐式缓存。
涨价对同题花费的影响可以直接复算:Carbon 的 token 用量不变,花费乘以 2,Sol 不变。下表沿用第一节的测试,Carbon 一列是 12 月 1 日起的估算。
| 比较 | GPT-6.1 Sol | Gemini 4 Carbon,12 月 1 日起 | Carbon ÷ Sol |
|---|---|---|---|
| 7 道编程题,两边默认档 | $0.0490 | $0.6884 | 14.05 倍 |
| 7 道编程题,Carbon 默认对 Sol high | $0.0859 | $0.6884 | 8.01 倍 |
| 5 道编程题,两边 high | $0.0387 | $1.2242 | 31.63 倍 |
| 全部 11 题,两边默认档 | $0.0897 | $0.8842 | 9.86 倍 |
AA 的每任务花费同样会变。按标价翻倍、缓存比例不变推算,Carbon 三档会从 $4.68–$5.48 变成约 $9.36–$10.96,编程代理榜上的 $7.13 约变成 $14.26,而 Sol max 仍是 $1.27 和 $1.51。到那时,Carbon 高出的那几分要用 7 倍以上的每任务花费去换,只有在你的终端类任务上它确实少返工、而返工本身很贵时,这笔账才算得过来。要在涨价前试 Carbon,11 月 30 日之前是成本最低的窗口。
输入很长时:Sol 超过 272K 整单加价,Carbon 没有
把整个仓库或很长的日志塞进一次请求时,先看价格规则:Sol 单次输入超过 272K token,整次请求的输入和缓存按 2 倍、输出按 1.5 倍计;Carbon 没有长上下文加价。两者的上下文都在 105 万 token 左右,Carbon 是 1,048,576(输入输出合计),Sol 是 1,050,000;同步调用时 Carbon 单次最多输出 65,536 token,Sol 是 128,000。在 Codex 和 ChatGPT Work 里用 Sol,默认上下文是 500K,订阅额度内没有长上下文加价。
用一个假设的请求算一遍:输入 400,000 token、输出 20,000 token,不计缓存。Sol 是 0.4 × $4 + 0.02 × $15 = $1.90;Carbon 到 11 月 30 日是 0.4 × $2 + 0.02 × $10 = $1.00,12 月 1 日起是 0.4 × $4 + 0.02 × $20 = $2.00。也就是说,超过 272K 之后单价上 Carbon 占便宜,涨价后两者接近;实际账单还取决于各自输出多少思考 token,而前面的同题测试里 Carbon 默认档的输出量通常更大。
长输入下谁做得更好,目前没有两边同题的数据,只有 Carbon 一侧的结果。2026 年 11 月 11 日经 LaoZhang 网关给 Carbon 一份 146 KB、1,500 行的应用日志(79,312 个输入 token),让它数出 7 个数:默认档 7 个全对,思考 26,867 个 token,耗时 213.9 秒,花费 $0.4281;high 档非流式调用在 32,765 个思考 token 处触发 MAX_TOKENS,没有答案,改成流式并把 maxOutputTokens 设到 65,536 后,思考用满 65,533 个 token、等了 507.6 秒,仍然没有答案。如果你要让 Carbon 读长日志或大段代码,默认档比 high 更可靠;Sol 在这类任务上的表现要用你自己的数据验证。
在哪里用、怎么并排试 Carbon 和 Sol
Carbon 走 Gemini API 付费层,模型 ID gemini-4-carbon;在 Gemini 应用和 Antigravity 里用它需要 Google AI Ultra 订阅,各入口的条件见 Gemini 4 Carbon 什么时候可以用:已发布,11 月 10 日起正式开放。Sol 走 OpenAI API,模型 ID gpt-6.1-sol,在 Codex 里也能选;要用工具调用必须走 Responses API,从 GPT-6 Sol 迁过来要改的地方见 GPT-6.1 Sol 怎么用:价格变化、迁移改动与可用入口。
想在自己的任务上并排比,最省事的是用同一个网关调两个模型。截至 2026 年 11 月 16 日,laozhang.ai 的模型列表里同时有 gemini-4-carbon 和 gpt-6.1-sol,前面的同题测试就是用一个 key 跑的:Sol 走 OpenAI 兼容的 /v1/chat/completions,Carbon 走 Gemini 原生的 /v1beta/models/gemini-4-carbon:generateContent。不管走哪条线路,比较时都记下每次的输出 token、思考 token 和耗时,按"每个通过测试的结果花了多少"来算,而不是只看单价。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
Gemini 4 Carbon 和 GPT-6.1 Sol 的其他问题
Gemini 4 Carbon 的 API 有免费额度吗?
没有。截至 2026 年 11 月 16 日,Google 的 Gemini API 价格页里 gemini-4-carbon 没有免费层,只能在付费层按量计费,Batch 是半价。
嫌 Sol 贵,能不能换成 GPT-6.1 Terra 或 Gemini 4 Argon? 可以试,但单价低不等于每个任务更省。Terra 和 Sol 怎么选见 GPT-6.1 Terra 和 Sol 区别:Codex 实测用时减半,要高分时 Sol 更省;把 Argon 放进来比见 Gemini 4 Argon、Opus 5.5、GPT-6.1 Sol 对比测评:半价不等于更省。
参考来源4
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年11月16日。
参考来源4
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年11月16日。