Claude Opus 5.5 对比 GPT-6.1 Terra:同分时成本差 3.6 倍
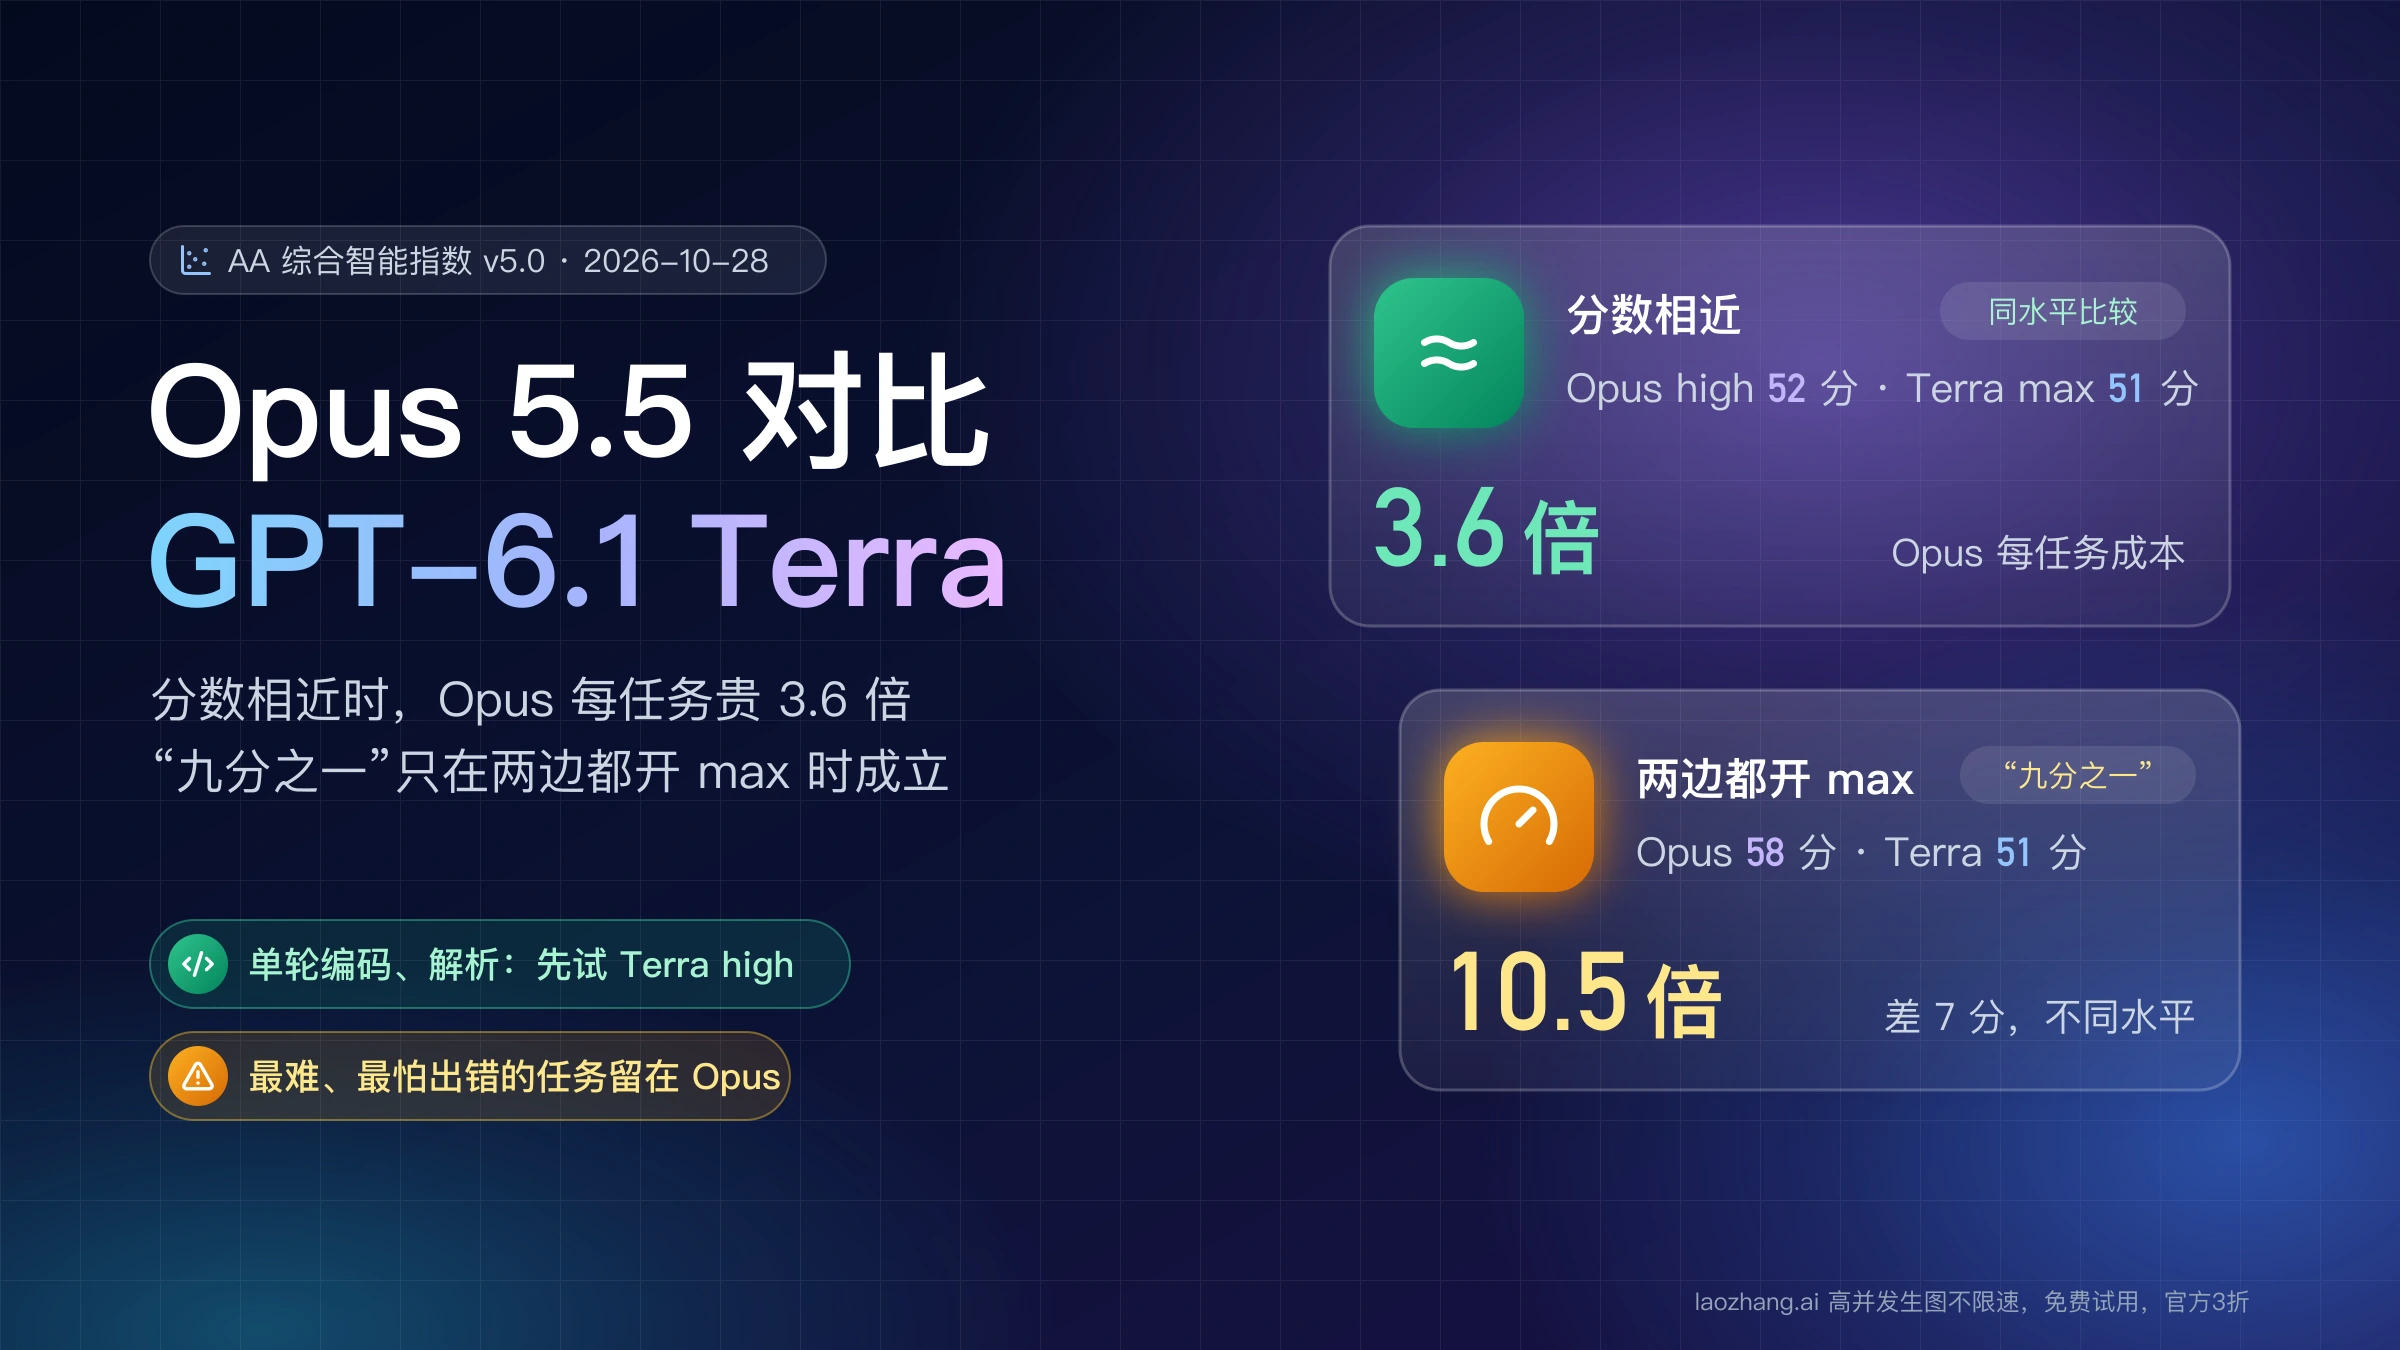
OpenAI 称 GPT-6.1 Terra 任务成本约为 Opus 5.5 的九分之一,只在两边都开 max 时成立;分数相近时差 3.6 倍,最难任务仍需 Opus。
文章目录
截至 2026 年 10 月 28 日,Claude Opus 5.5 和 GPT-6.1 Terra 可以按工作类型分开用:需求写得清楚的单轮编码、解析和批量文档任务,先换到 gpt-6.1-terra 的 high 推理强度试;要接近 Opus high 的综合水平,用 Terra 的 max 档;金融、法律、战略这类知识密集的分析,以及最难、最怕出错的任务,继续留在 claude-opus-5-5。 依据是 Artificial Analysis(AA)综合智能指数 v5.0:Terra max 51 分,Opus high 52 分,分数几乎相同,Opus 每任务成本是 Terra 的 3.6 倍,但每道题用时更短。
OpenAI 在 2026 年 10 月 26 日发布 Terra 时说它“每项任务的成本约为 Opus 5.5 的九分之一”,那是两边都开最高推理强度 max 的比较,而 AA 测得那一档 Opus 58 分、Terra 51 分,并不是同一水平的活。2026 年 10 月 28 日用同一个 API 密钥让两者在 high 档做了 7 道单轮题,全部通过,按官方标价 Opus 花费是 Terra 的 4.5 倍;同一段中文,Opus 计的输入 token 是 Terra 的 1.49 倍,乘上 4 倍单价,同样的中文输入,Opus 的输入账单约为 Terra 的 6.0 倍;算上输出,每次 2K 输入、1K 输出的中文调用,整次账单约差 4.6 倍。
所以要不要换,最终看你自己的 20 道左右真实任务在两边的通过率和“每道通过题的成本”,而不是单价。有两种情况差距会缩小或要改调用方式:单次提示词超过 272K token 时 Terra 改按长上下文价计费,差距降到 2~2.7 倍;Terra 的工具调用要走 Responses API;2026 年 10 月 28 日经 LaoZhang API 网关测试,max 档也只能经 Responses API 使用,Chat Completions 最高只到 xhigh(直连 OpenAI API 未测)。在 ChatGPT 里,Terra 只出现在工作模式和 Codex,普通对话里选不到。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
“九分之一”只在两边都开 max 时成立
OpenAI 的 GPT-6.1 Terra 发布文中文版原话是:“在最高推理强度下,Terra 的 Token 使用效率是 Claude Opus 5.5 的三倍以上,每个 Token 的价格为后者的四分之一,因此每项任务的成本约为后者的九分之一。”这句话出现在介绍计算机操作测试 Agents' Last Exam 的段落里,比的是两边都开名为 max 的推理强度档,测试由 OpenAI 自己跑。AA 的独立数据和它对得上:max 对 max,Opus 每任务 $10.04、Terra $0.96,差 10.5 倍;Opus 每任务输出约 173k token(其中推理 120k),Terra 约 60k(推理 39k),Opus 是 Terra 的约 2.9 倍。
问题在于这两档不是同一水平。AA v5.0 里 Opus max 58 分,Terra max 51 分,差 7 分,Opus 每任务用时 1,133 秒,Terra 657 秒。如果你的任务确实需要 58 分那一档,Terra 给不了;如果 51 分就够用,拿来比的就不该是 Opus max,而是分数相近、便宜得多的 Opus high。所以“九分之一”描述的是两个模型的顶档,不是你把现有工作换过去后的账单倍数。
另一个容易混的是 AA 的版本。AA 在 2026 年 10 月 27 日到 28 日之间把综合智能指数从 v4.3.2(10 项评测)换成了 v5.0(9 项评测);旧版里 Terra max 是 48 分、每任务 384 秒,新版是 51 分、657 秒。所以“Opus 54 分对 Terra 48 分”“58 对 48”这类数字出自旧版,不能和下文的数字放在一起比。下文 AA 数字均为 Intelligence Index v5.0,截至 2026 年 10 月 28 日。
按 AA 同分比较:Opus high 对 Terra max,成本差 3.6 倍
把分数相近的两档放在一起,差距是 3.6 倍而不是 10.5 倍:Opus high 52 分、Terra max 51 分,Opus 每任务成本是 Terra 的 3.6 倍,但每道题快 3 分钟多(464 秒对 657 秒)。下表是 AA 的 Claude Opus 5.5 与 GPT-6.1 Terra 逐档对比页里每一档推理强度的结果,按分数从高到低排。“每任务成本”是 AA 跑一道指数题按官方标价算出的平均花费,“每任务用时”是平均耗时,反映的是 AA 那套测试的工作量,不是你的账单。
| 模型与推理强度 | AA 综合智能指数 v5.0 | 每任务成本 | 每任务用时 |
|---|---|---|---|
Opus 5.5 max | 58 | $10.04 | 1,133 秒 |
Opus 5.5 xhigh | 57 | $6.05 | 779 秒 |
Opus 5.5 high | 52 | $3.46 | 464 秒 |
Terra max | 51 | $0.96 | 657 秒 |
Opus 5.5 medium | 48 | $2.45 | 337 秒 |
Terra xhigh | 45 | $0.40 | 287 秒 |
Terra high | 42 | $0.26 | 182 秒 |
Terra medium | 38 | $0.17 | 118 秒 |
Opus 5.5 low | 35 | $0.98 | 147 秒 |
Terra 不推理(none) | 30 | $0.23 | 104 秒 |
Terra low | 29 | $0.07 | 48 秒 |
这张表里最值得注意的是 Opus 的中低档。Opus medium 48 分,比 Terra max 低 3 分,成本却是 Terra max 的 2.6 倍;Opus low 的每任务成本和 Terra max 几乎相同,分数却低 16 分。所以如果你现在为了省钱把 Opus 开在 medium 或 low,第一个该测的替代就是 Terra max。反过来,Terra xhigh 45 分,只比 Opus medium 低 3 分,而 Opus medium 的成本是它的 6.1 倍。
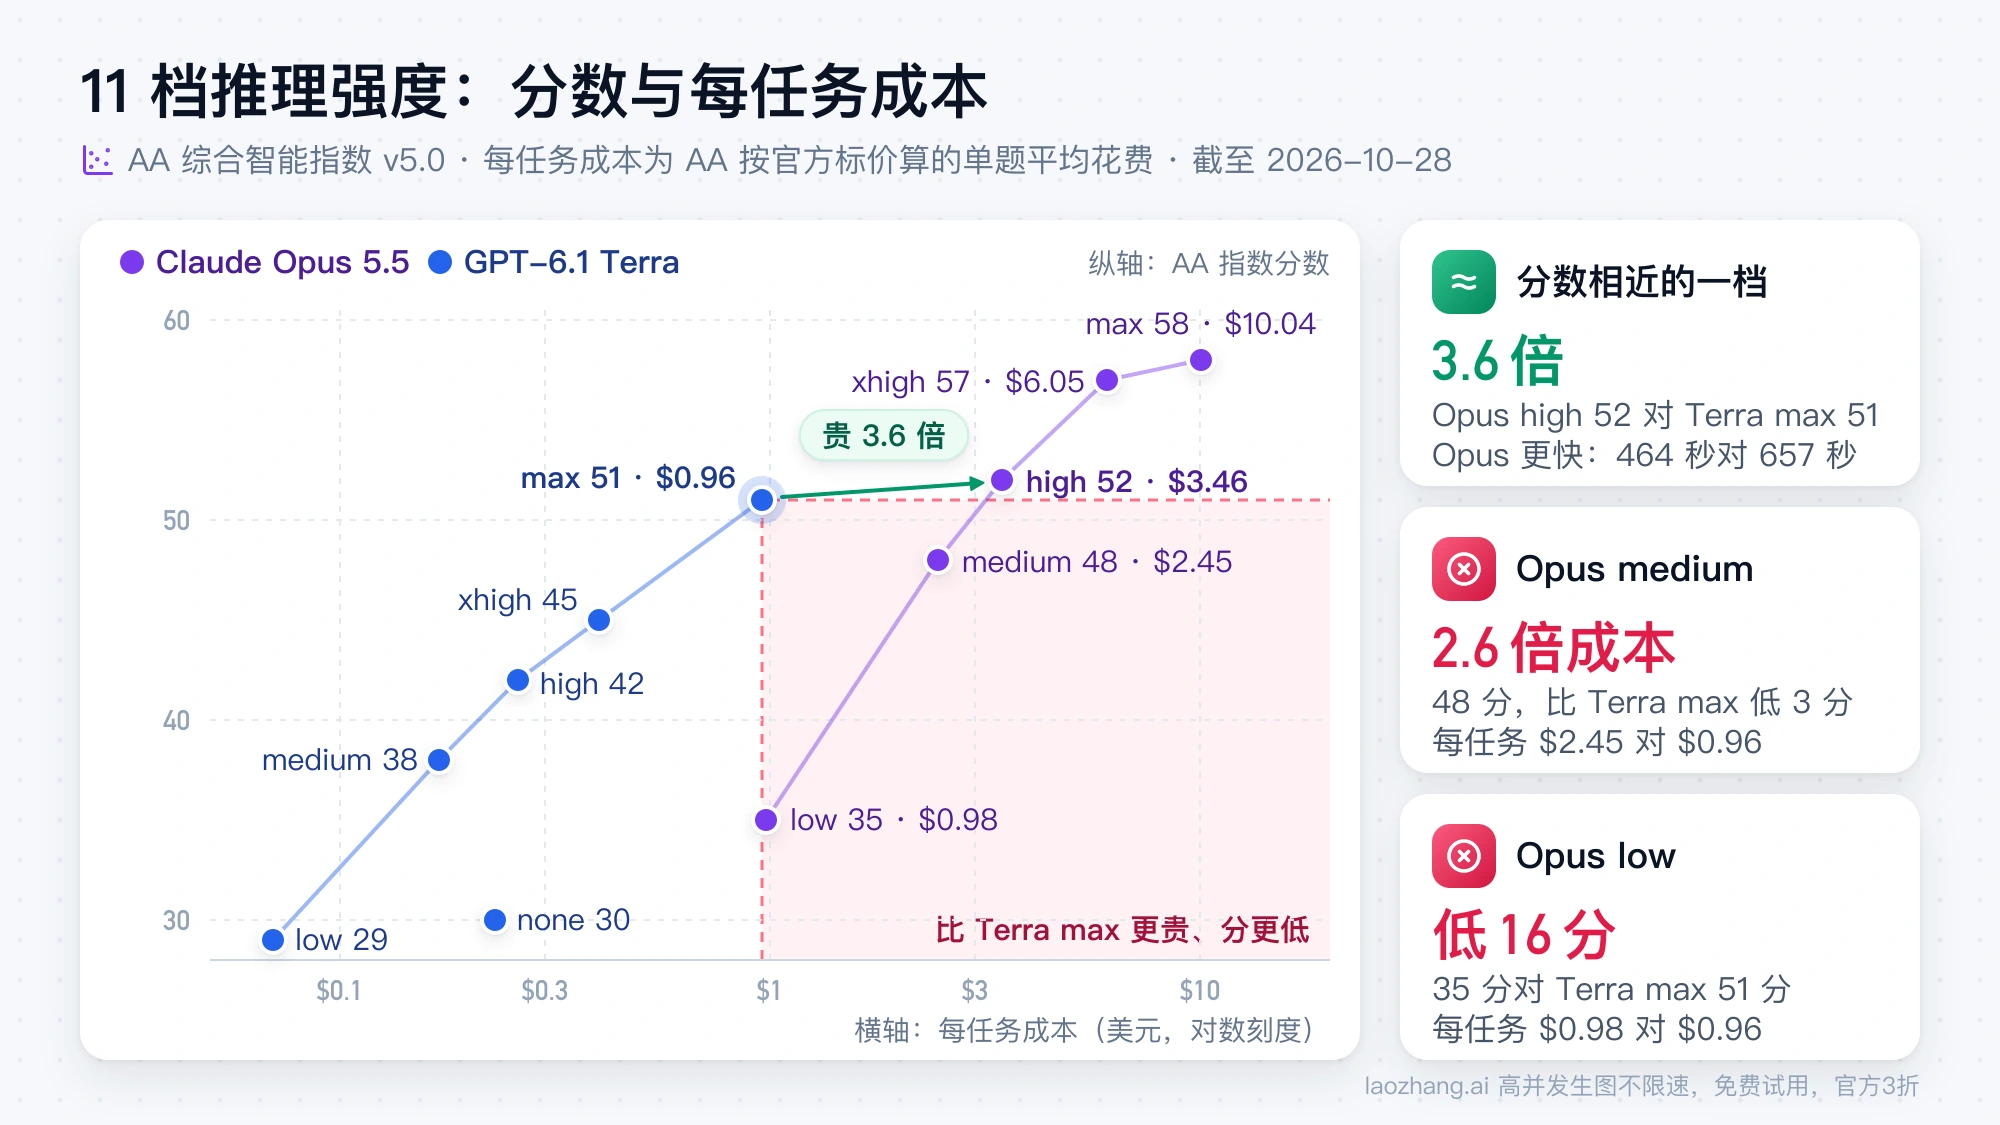
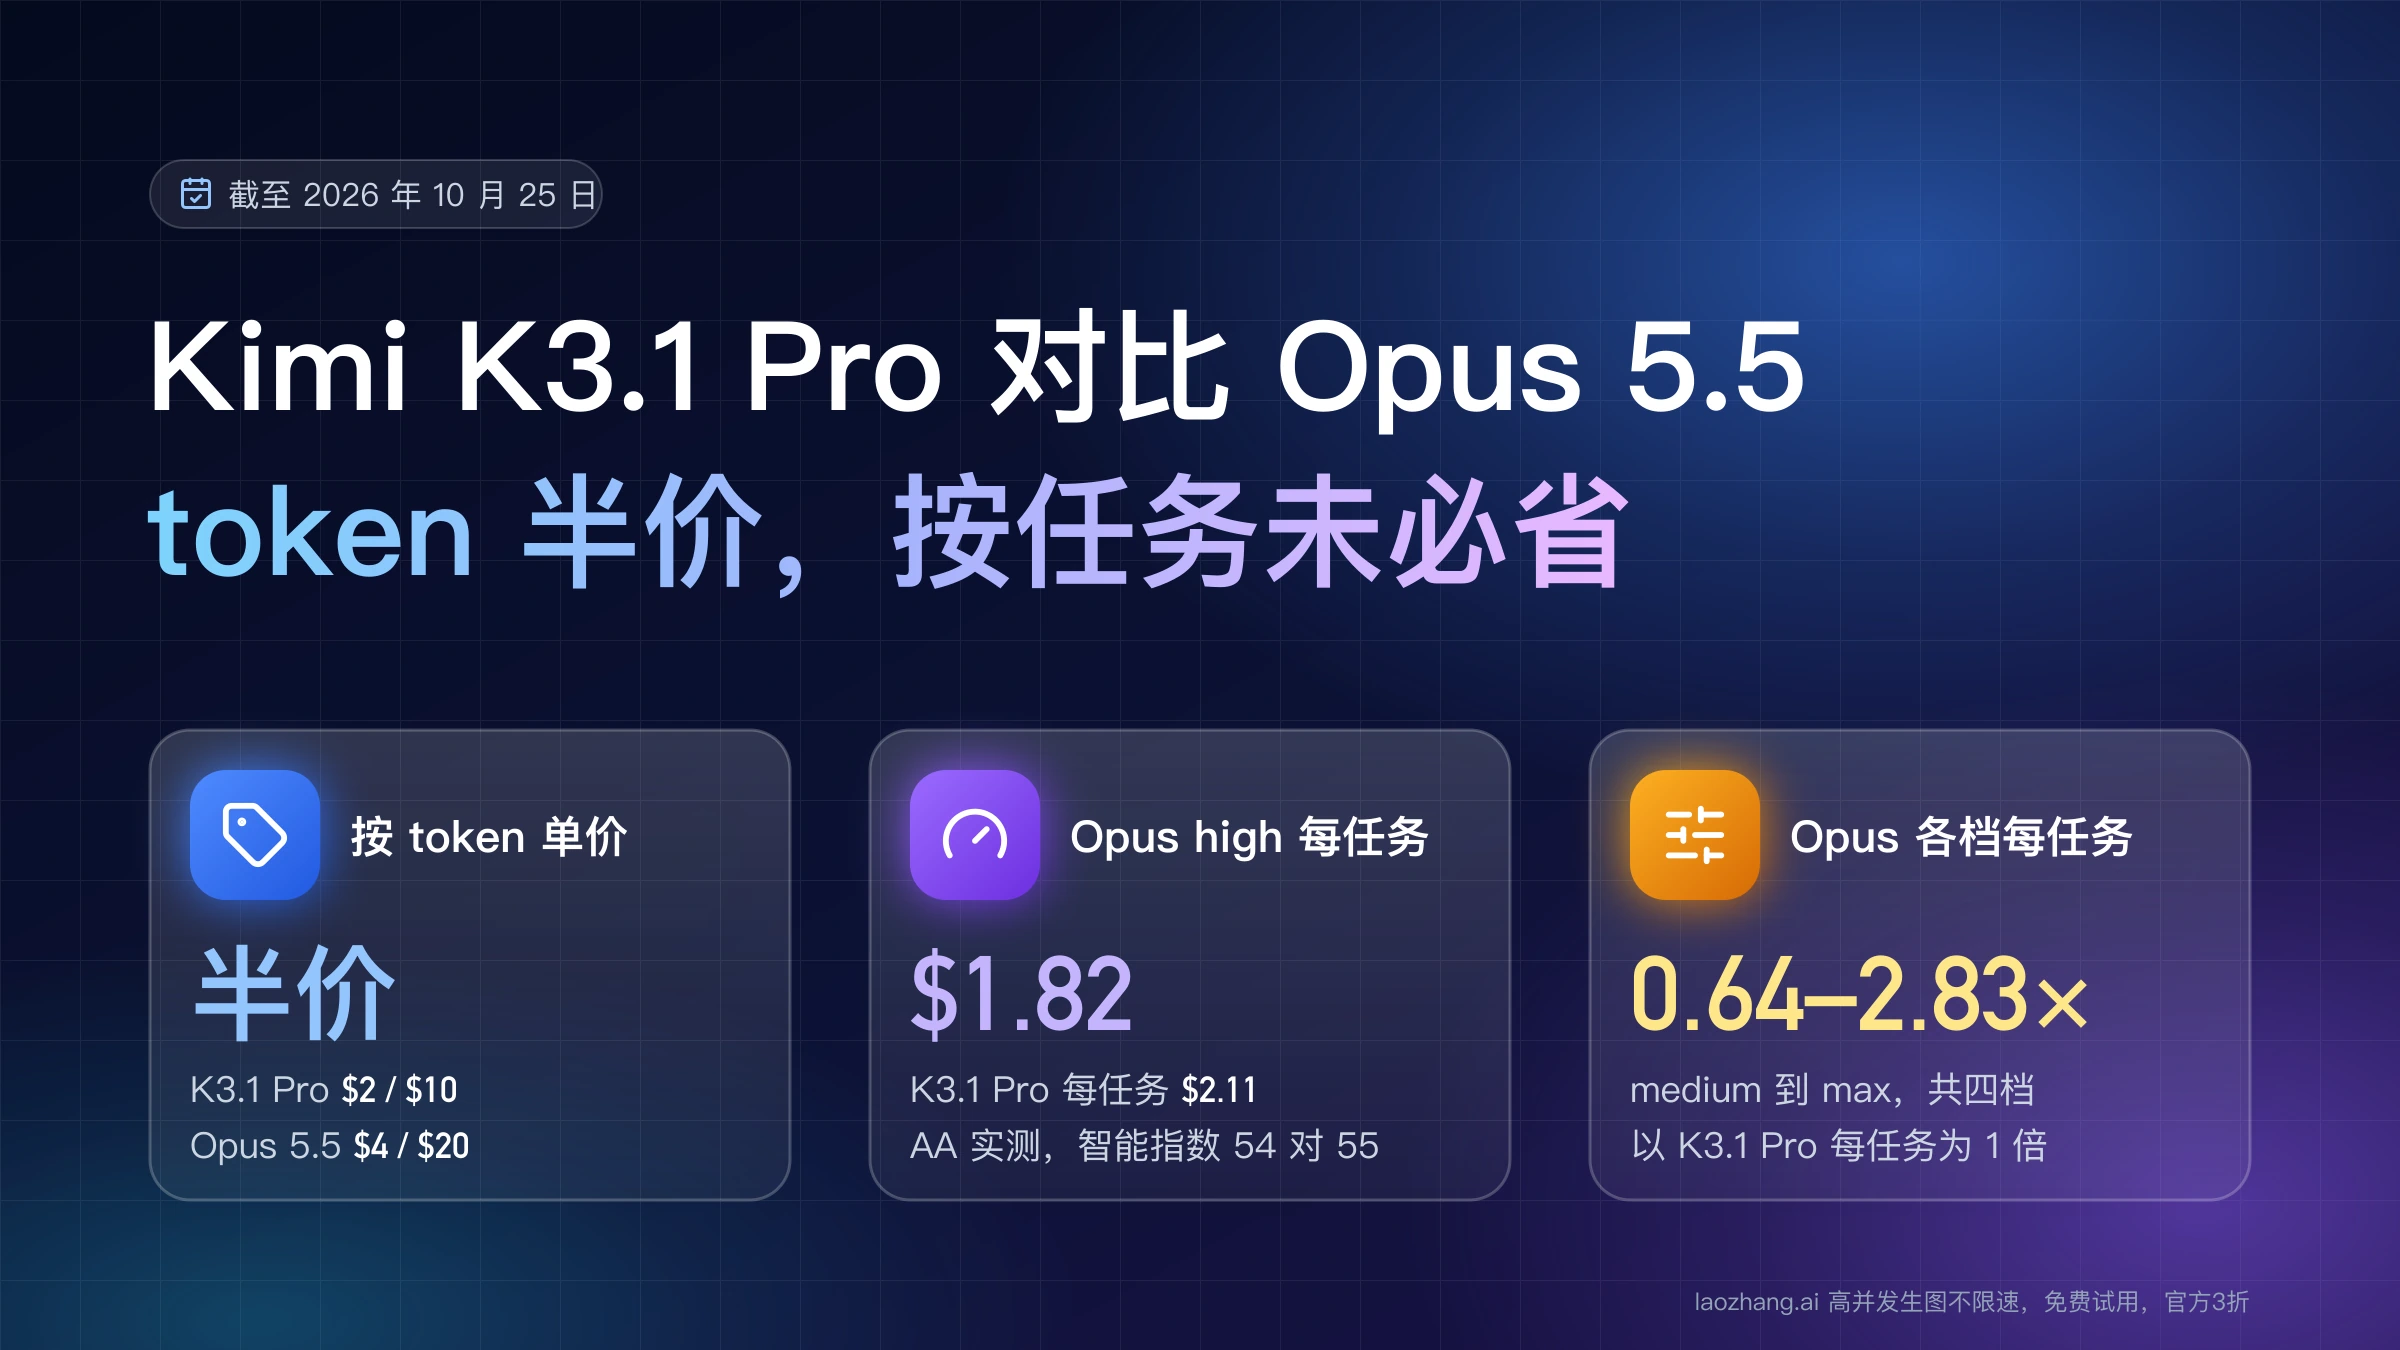
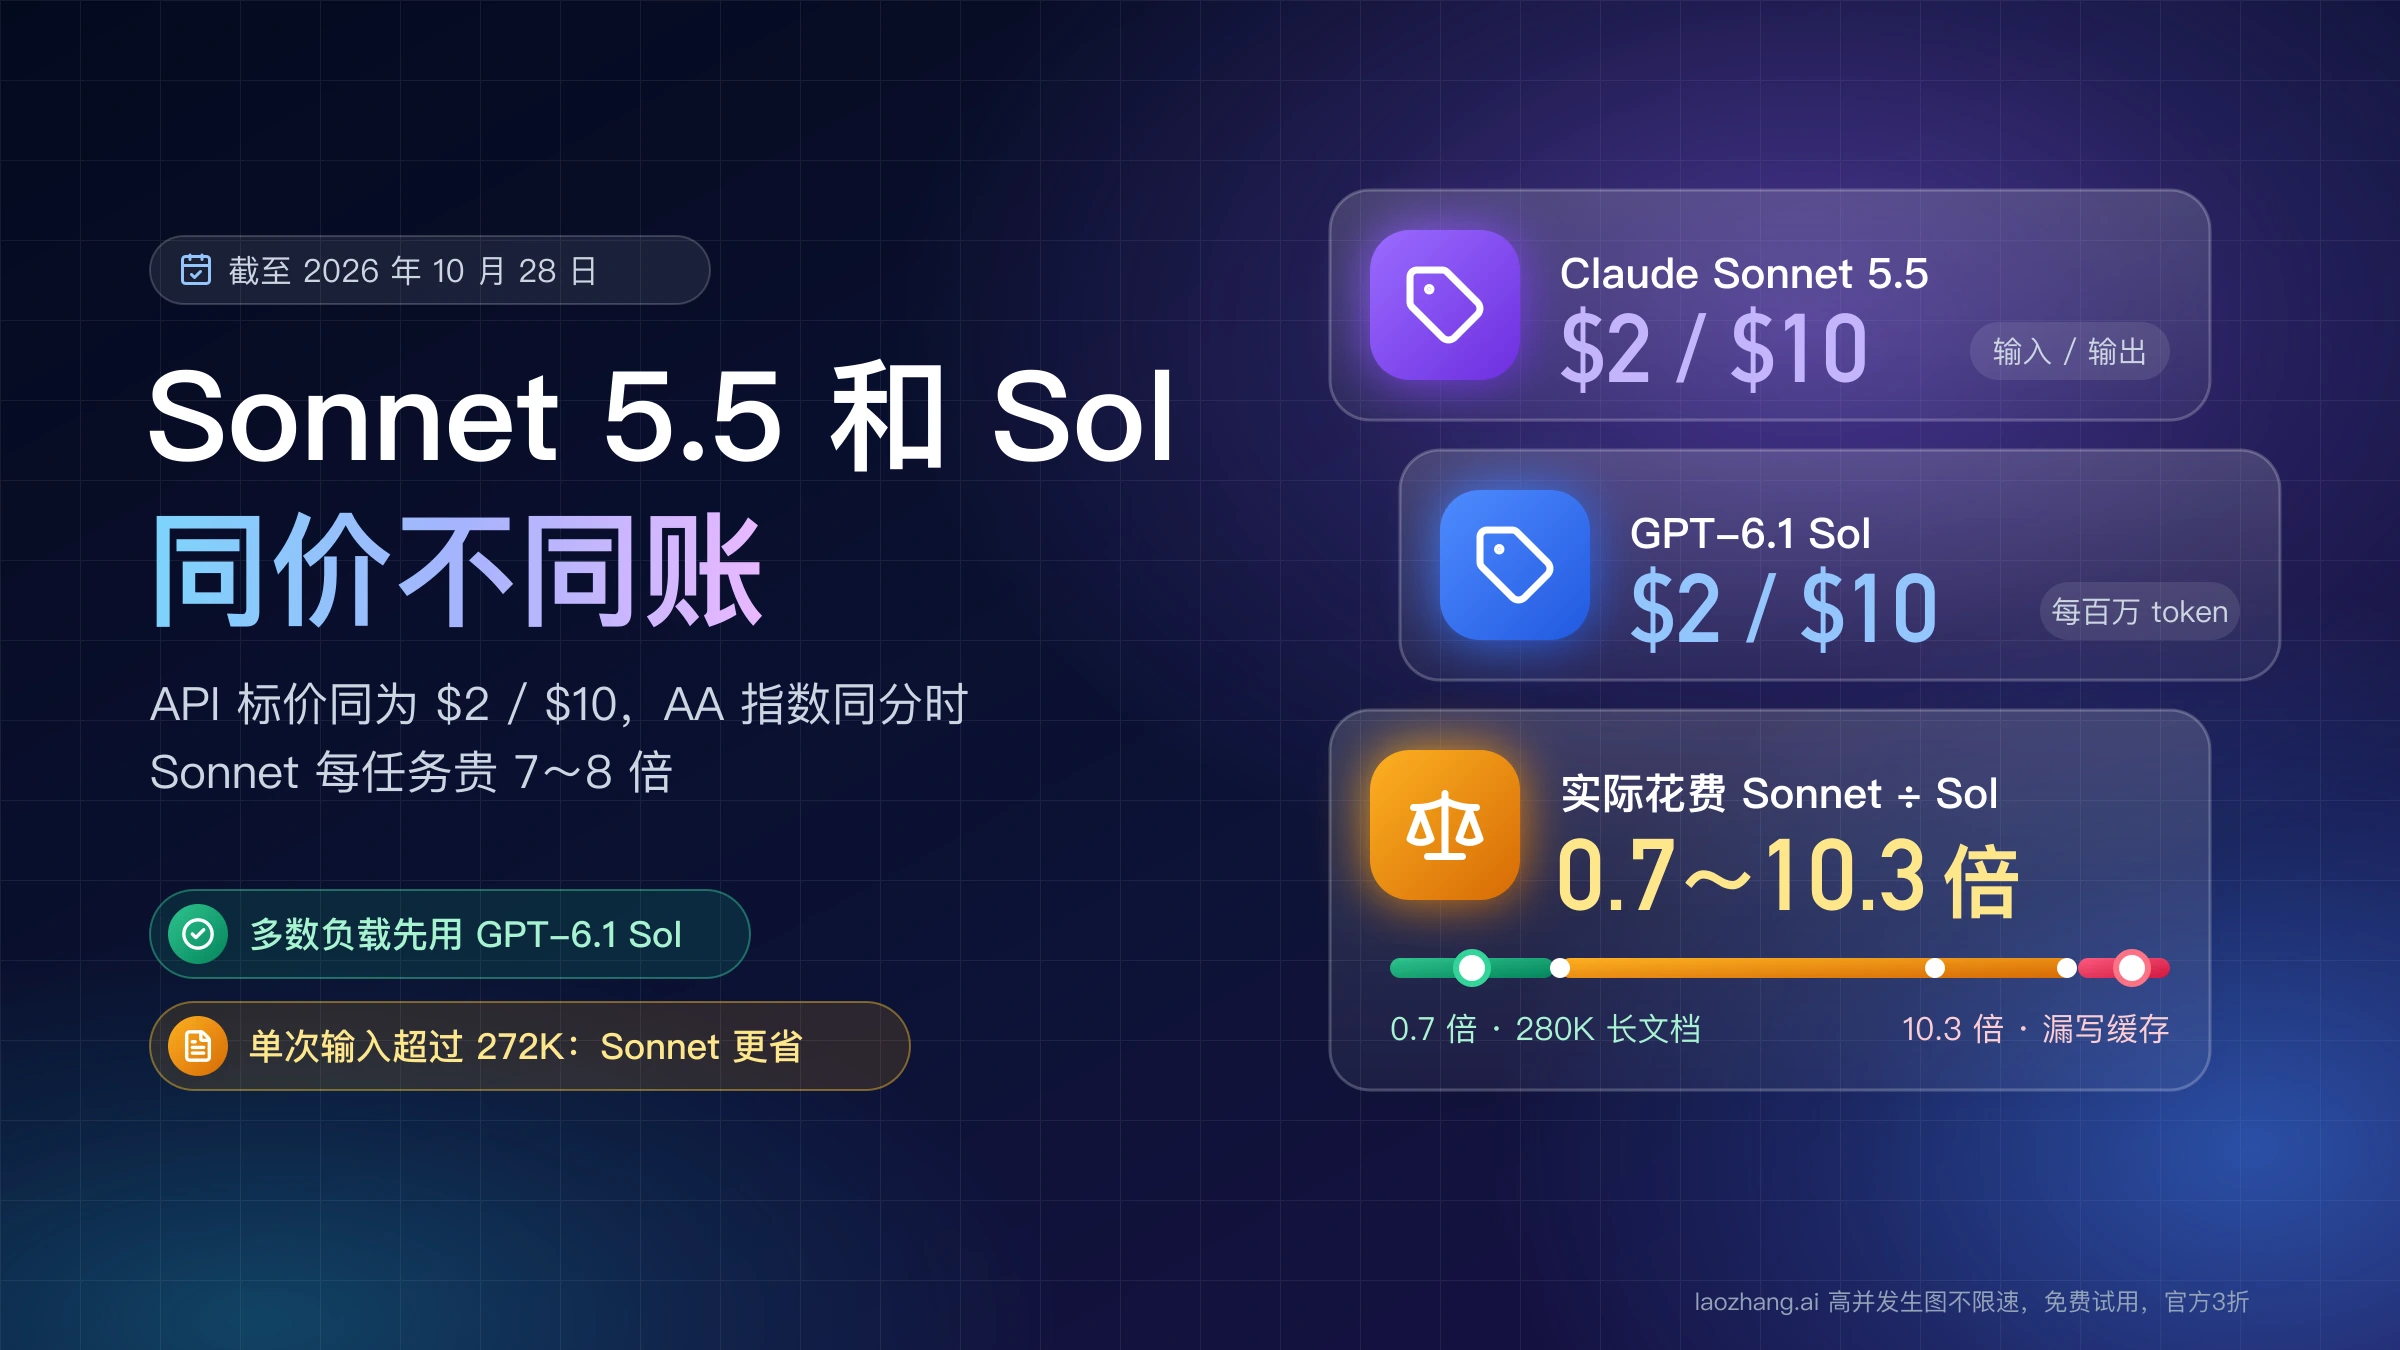
Terra 自己升档的代价也清楚:从 high 升到 max 多 9 分,每任务成本约 3.7 倍,用时从 182 秒拉长到 657 秒。52 分以上只有 Opus 的 xhigh 和 max。想要 53~55 分又不想付 Opus xhigh 的价,同一版指数里 GPT-6.1 Sol 的 max 是 55 分、每任务 $1.27,Opus 和 Sol 之间怎么取舍见《Claude Opus 5.5 对比 GPT-6 Sol 与 6.1 Sol:先看任务,再算合格交付成本》。
哪些工作交给 Terra,哪些留在 Opus 5.5
按 AA v5.0 的分项,Terra max 领先 Opus high 的是写代码和科研计算,Opus high 领先的是知识密集的专业分析和办公文件,命令行类任务两者基本持平。所以更合算的做法是按工作类型分流,而不是把所有调用一次性换掉。下表是按这些分项和 2026 年 10 月 28 日的同题测试给出的起点,每一行都应该用你自己的任务再验证一次。
| 你的工作 | 先用 | 依据 |
|---|---|---|
| 需求写得清楚的单轮编码、解析、数据提取 | Terra high,不够再升 max | 同题测试中这类题 Terra high 全部通过 |
| 写代码的智能体任务、科研计算 | Terra max,和 Opus high 对照 | AA 编程和科研分项 Terra max 领先 |
| 命令行操作类任务 | 两者都可,按成本和等待时间选 | Terminal-Bench 4.0 两者持平;按 AA 综合指数的平均口径,Terra max 每任务更便宜,Opus high 用时更短 |
| 金融、法律、战略、经济分析,办公文件 | Opus high | AA 行业指数和知识类分项 Opus high 领先 |
| 最难、出错代价最高的任务 | Opus xhigh 或 max | AA 52 分以上只有 Opus |
现在开着 Opus medium 或 low | 先测 Terra max | Opus medium 分数更低、成本更高 |
具体数字如下,均为 AA 单次运行、Opus high 对 Terra max。Terra 领先的三项是 FrontierCode 2.0(35.9% 对 42.3%)、CritPt v2 难题子集(58.0% 对 64.5%)和 Terminal-Bench-Science 0.1(49.0% 对 57.6%);Opus 领先的是 HLE-Diamond(55.6% 对 47.3%)、AA-Briefcase v1.1(1681 对 1402)和 AutomationBench-AA(63.2% 对 60.2%);Terminal-Bench 4.0(56.6% 对 55.6%)和 GDP.pdf(28.8% 对 28.6%)几乎没有差别。AA 的行业能力指数也是 Opus high 全部领先:金融会计 53 对 49,战略运营 58 对 50,法律 52 对 46,工程 58 对 54,经济学 57 对 49。
OpenAI 给 Terra 的定位是快速、高效的视觉推理、计算机操作和清晰写作,并称它在 Terminal-Bench-Science 0.1 上与 Opus 5.5 的分差不到 5 分、估算成本不到五分之一,这些是 OpenAI 自测的结果。同一篇发布文也写明,最复杂的编程任务 GPT-6.1 Sol 和 GPT-6 Astra 仍是更好的选择;Terra 和 Sol 之间怎么分工见《GPT-6.1 Terra 和 Sol 区别:Codex 实测用时减半,要高分时 Sol 更省》。如果你只想在 Claude 内部降成本,先看《Sonnet 5.5 和 Opus 5.5 怎么选:半价未必更省》。
2026 年 10 月 28 日同题实测:7 道题两边全部通过
2026 年 10 月 28 日,用 LaoZhang API(laozhang.ai)的同一个 API 密钥让两个模型做了同样的 7 道单轮题,结果 Opus 11 次调用全部通过,Terra 15 次调用全部通过,没有一道题拉开两者。claude-opus-5-5 走 Anthropic Messages 接口,设 thinking: {"type": "adaptive"} 和 output_config.effort: "high";gpt-6.1-terra 走 Chat Completions,设 reasoning_effort: "high"。每次调用都是流式、一条用户消息、不带工具,每道题的判定方法(隐藏测试或标准答案)都在看到任何回答之前写好。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
当天该网关的 /v1/models 同时列出了两个模型,gpt-6.1-terra 前一天还没有;Terra 按 OpenAI 标价计费、只提供 OpenAI 兼容接口,Opus 按每百万 token 输入 $4、输出 $20 计费,Anthropic 和 OpenAI 兼容接口都能用。经这个网关调用 Claude 有一条和 Anthropic 官方接口不同的限制:单次输出上限 32,768 token,max_tokens 设得更大时按上限处理,而官方上限是 128K,需要很长输出的任务要分段。下表的成本是“接口返回的 usage × 官方标价”,不是网关实际扣费,因为同一个密钥上还有其他调用。
| 题目(判定方式) | 输出 token(Opus / Terra) | Opus 单次花费 | Terra 单次花费 | Opus 是 Terra 的 |
|---|---|---|---|---|
| 不用 eval 写表达式求值器(25 项隐藏测试) | 1,884 / 2,081 | $0.0389 | $0.0106 | 3.7 倍 |
| 不用 csv 库解析一行 CSV(16 项) | 871 / 564 | $0.0184 | $0.0030 | 6.2 倍 |
| 统计 100 万以内数位和为 27 的数(标准答案) | 877 / 413 | $0.0178 | $0.0021 | 8.4 倍 |
| npm 风格 semver 范围判断(36 项) | 3,066 / 3,294 | $0.0640 | $0.0169 | 3.8 倍 |
| 约 6,800 词英文长文里找三条备注再计算(标准答案) | 234 / 80 | $0.0667 | $0.0106 | 6.3 倍 |
| 辨认 Python 3.13 标准库函数真假(2 真 2 编造) | 244 / 128 | $0.0056 | $0.0008 | 7.3 倍 |
| 5 字段 cron 表达式求下次运行时间(41 项) | 3,391 / 3,763 | $0.0698 | $0.0192 | 3.6 倍 |
| 7 道题各取一次平均调用合计 | — | $0.2812 | $0.0632 | 4.5 倍 |
倍数大小主要看回答长短。semver 和 cron 这类长代码题,两边输出 token 接近,差距基本就是 4 倍单价;短题上 Opus 写的 token 约为 Terra 的两倍,倍数就升到 6~8 倍。长文题的输入有约 6,800 个英文词,Opus 计 15,495 个输入 token,Terra 计 10,198 个。每次调用的耗时两边相近(cron 题 32.2 秒对 27.5 秒,长文题 5.1 秒对 4.5 秒),但这是从亚洲一台 Mac 经网关测的,只能作参考。Opus 的思考内容没有流式返回,它的 output token 已包含思考部分。
这些题不算送分题:semver 和编造函数辨认两道,MiniMax M3.1 Flash 在 2026 年 10 月 26 日的同题测试里没做对。但它们都是规格写清楚的单轮任务,没有覆盖工具调用、多步智能体、图片、超过约 15K token 的长上下文检索,也没有测 max 和 none 档,每题只跑了 1~3 次。所以这组结果能说明的是:这类任务两边都能做对,Terra 便宜很多;Opus 领先在哪里,要看上一节 AA 的分项。
实际账单差几倍:4 倍单价,再乘 token 数
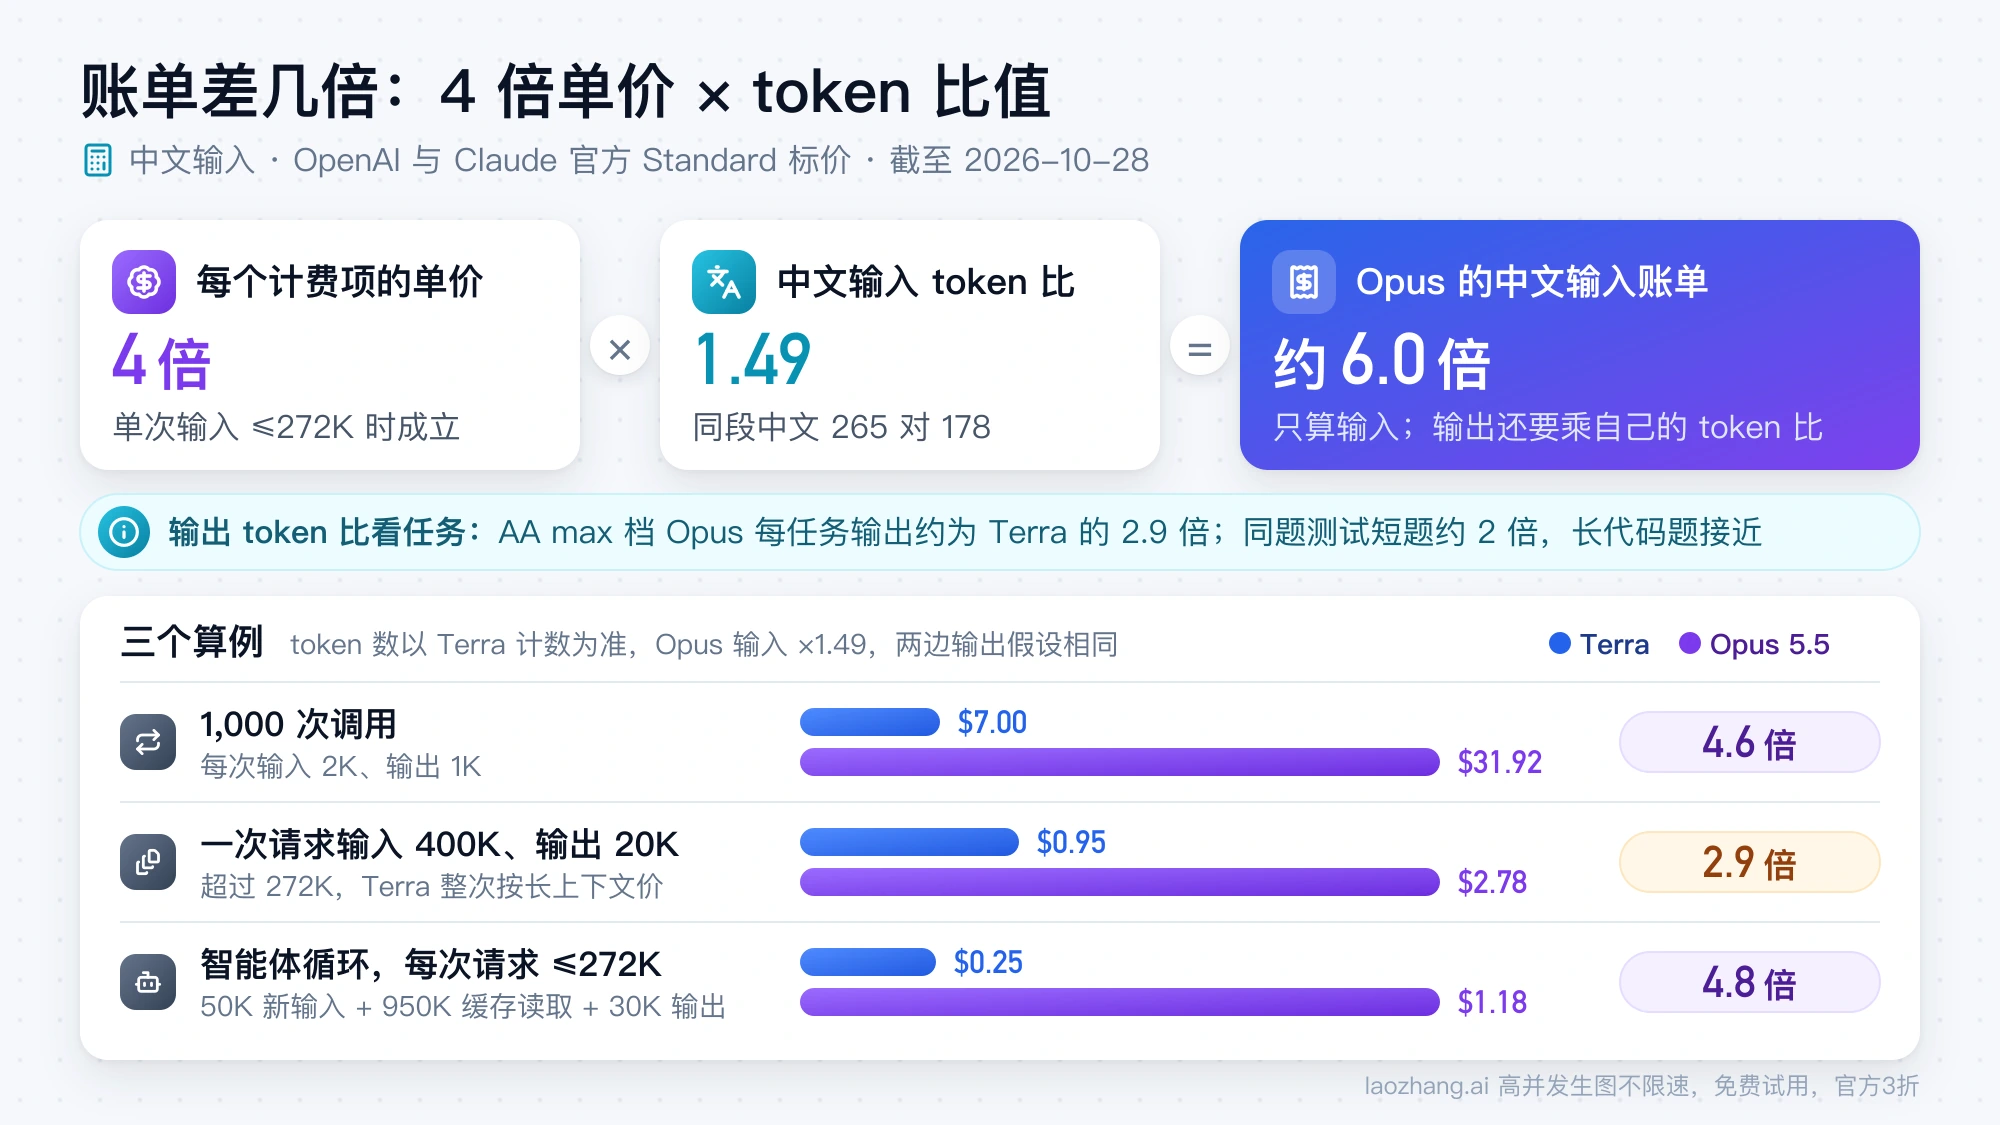
单次输入不超过 272K token 时,同样的 token 数,Opus 每一个计费项的单价都正好是 Terra 的 4 倍,所以你的账单倍数约等于 4 乘以“Opus 计的 token 数 ÷ Terra 计的 token 数”。输入侧的比值由分词方式决定,输出侧由推理强度和模型写多少决定。按 OpenAI API 定价页和 Claude API 定价页截至 2026 年 10 月 28 日的 Standard 标价,每百万 token 的计算式如下,U 是未命中缓存的输入,W 是缓存写入,R 是缓存读取,O 是输出(含推理 token):
Opus 5.5(1M 以内同价)   = 4U + 5W + 0.2R + 20O      W 为 5 分钟缓存写入
Terra(输入 ≤272K)       = 1U + 1.25W + 0.05R + 5O   W 为 30 分钟缓存写入
Terra(输入 >272K,整次) = 2U + 2.5W + 0.1R + 7.5O
推理强度主要影响 O。AA 在 max 档测得 Opus 每任务输出约为 Terra 的 2.9 倍,同题测试里短题约 2 倍、长代码题接近,所以同样的任务 Opus 的输出账单通常不止 4 倍。缓存也要留意:OpenAI 从 GPT-5.6 起默认开启提示缓存,缓存写入照常计费,除非把 prompt_cache_options.mode 设为 "explicit"。
中文输入:同一段文字,Opus 多计 49% 的 token
2026 年 10 月 28 日把同一段文字分别发给两个模型,读接口返回的输入 token 数,中文是 265 对 178,Opus 多计 49%。再乘上 4 倍单价,同样的中文输入,Opus 的输入账单约为 Terra 的 6.0 倍。
中文不是差距最大的语言。同一天用同样方法测的其他语言里,英文的 token 数之比是 1.45(输入账单约 5.8 倍),日文 1.24(5.0 倍),俄文 1.55(6.2 倍),西班牙文 1.84(7.4 倍),韩文最高,1.87(7.5 倍)。每种语言只测了一段短文本,两边都含少量消息模板 token;约 6,800 词的英文长文测得 1.52,和短文本接近。这些比值和此前在 GPT-6 Astra 与 Claude Fable 5.1 上测得的几乎一致,分词差异的详细数据见《GPT-6 Astra 与 Claude Fable 5.1 怎么选:实测 token 与 API 成本》。输出 token 的比值取决于任务本身,不能用这些数字直接推算。
三个算例:以中文输入为准
下面三笔按上面的计算式算,token 数以 Terra 的计数为准,Opus 的输入 token 乘 1.49,两边输出 token 假设相同;实际 Opus 往往输出更多,倍数还会更高。
| 场景 | Terra | Opus 5.5 | Opus 是 Terra 的 |
|---|---|---|---|
| 1,000 次调用,每次输入 2K、输出 1K | $7.00 | $31.92 | 4.6 倍 |
| 一次请求输入 400K、输出 20K | $0.95 | $2.78 | 2.9 倍 |
| 智能体循环累计 50K 新输入、950K 缓存读取、30K 输出(每次请求都在 272K 以内) | $0.25 | $1.18 | 4.8 倍 |
第一笔输出占了大头,所以倍数低于只算输入时的倍数:以百万 token 为单位,Terra 是 2 × $1 + 1 × $5,Opus 是 2 × 1.49 × $4 + 1 × $20。第三笔大部分输入是缓存读取,单价低,倍数又回到 4 倍以上。
提示词超过 272K:差距缩到 2~2.7 倍
Terra 单次输入超过 272K token 时,整次请求改按长上下文价计费,输入和缓存翻倍、输出变成每百万 $7.50;Opus 5.5 在 1M 上下文内全程同价。所以同样的 token 数,长请求里 Opus 的输入和缓存只贵 2 倍,输出贵约 2.7 倍。上表第二笔就是这种情况:Terra $0.80 输入加 $0.15 输出,Opus 中文输入 596K token 计 $2.38、输出 $0.40,合计只差 2.9 倍。经常把整本文档或整个代码仓库塞进一次请求的工作,Opus 的相对劣势最小。不过中文材料在 Opus 那边占的 token 更多,同样的原文会更早碰到 1M 上限;按 1.49 的短文本比值粗算,Terra 计约 67 万 token 的中文材料,在 Opus 那边就接近 100 万。
换到 Terra 之前,用自己的 20 道题做同题对比
7 道题两边全过,说明靠几道示例题分不出高下,要看的是你自己工作里容易出错的那类题。2026 年 10 月 28 日那组测试 26 次调用按标价合计 $0.64,可以拿来估算你这次对比的花费量级。按下面的顺序做一次:
- 从最近的真实工作里挑 20 道左右,刻意多放你担心 Terra 做不好的那类(长文档、专业分析、多步任务)。每道题先写好判定方法,比如单元测试、标准答案或核对清单,再看任何模型的回答。
- 固定配置。Opus 保持你现在用的推理强度,在 Messages 请求里写明
thinking: {"type": "adaptive"}和output_config.effort,让档位确定可查;Terra 跑high和max两档,max要用 Responses API(POST /v1/responses,reasoning: {"effort": "max"}):2026 年 10 月 28 日经同题测试所用的网关,Chat Completions 带reasoning_effort: "max"返回 HTTP 400,提示只支持none到xhigh,同样的请求改走 Responses API 则正常返回max档。同一天还发现,非流式 Chat Completions 调 Terra 时带max_tokens会返回 HTTP 400Unsupported parameter: 'max_tokens' is not supported with this model. Use 'max_completion_tokens' instead.,要改用max_completion_tokens。需要工具调用时,Terra 同样要用 Responses API。 - 每道题、每种配置至少跑 2 次,记下返回 usage 里的输入、输出、缓存读写 token 和耗时。
- 用上一节的计算式算出每种配置的总花费,除以通过的题数,得到每道通过题的成本。
- Terra 某一档的通过率不低于 Opus、每道通过题成本更低,这类工作就换过去;只在某一类题上掉分,就只把那一类留在 Opus。
在 ChatGPT、Codex 和 Claude 里用:Terra 不在普通对话中
截至 2026 年 10 月 28 日,GPT-6.1 Terra 在 ChatGPT 里只出现在工作模式和 Codex 中,普通对话里选不到;发布文写的是 Plus、Pro、Enterprise 和 Edu 用户可用,Codex 文档还列了 Business。API 里直接用 gpt-6.1-terra,Responses API 的 reasoning.effort 可选 none、low、medium(默认)、high、xhigh 和 max,见 OpenAI 的 GPT-6.1 Terra 模型页。Opus 5.5 则在 Claude 应用(Pro、Max、Team、Enterprise)、Claude Code、Claude API 以及 AWS、Google Cloud、Azure 上都能用。
订阅额度不能按 API 单价换算:Codex 价格与用量文档给 Plus 和标准 Business 每 5 小时 Terra 35~285 条本地消息,Anthropic 没有公布 Opus 5.5 在 Claude 套餐里的消息数,Opus 这一侧的 API 账单和订阅用量见《Claude Opus 5.5 价格与用量重置:API 账单怎么算,重置卡怎么用》。
GPT-6.1 Terra 与 Opus 5.5 的其他问题
GPT-6.1 Terra 和 GPT-5.6 Terra 是同一个模型吗?
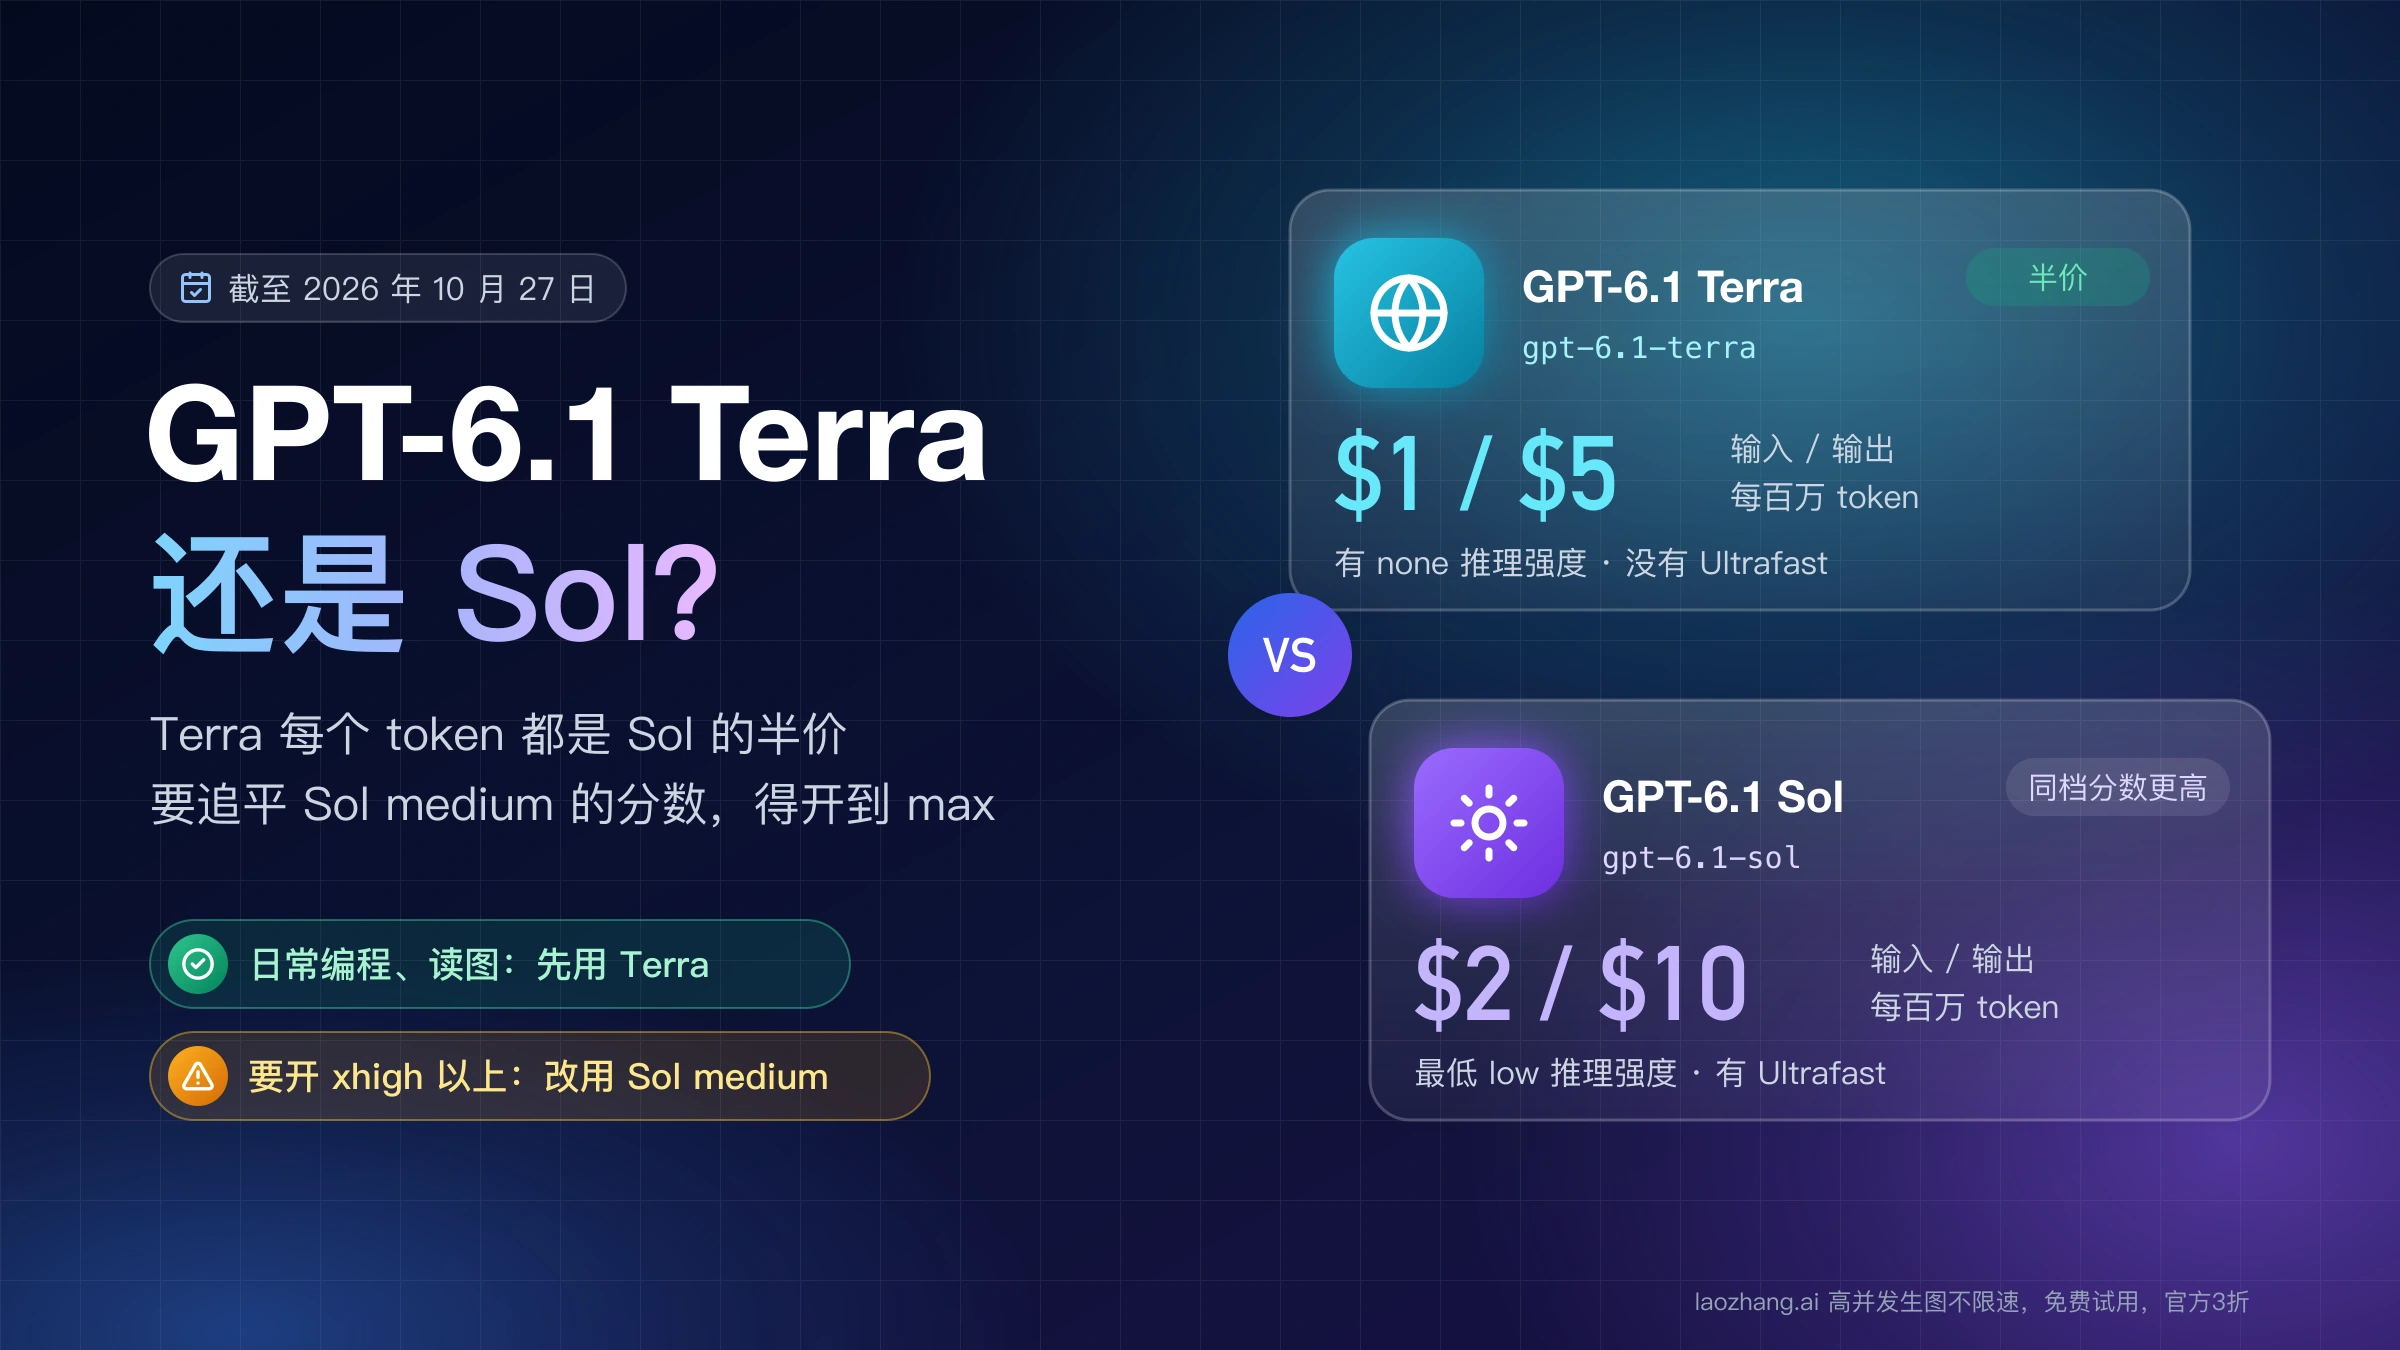
不是。GPT-6.1 Terra 于 2026 年 10 月 26 日发布,API ID 是 gpt-6.1-terra,知识截止 2026 年 6 月 1 日,上下文 1.05M token、单次最多输出 128K;价格也不同:按 OpenAI API 定价页的 Standard 标价,GPT-5.6 Terra(gpt-5.6-terra,仍在列)每百万 token 输入 $2、输出 $12,GPT-6.1 Terra 是 $1 和 $5。OpenAI 说的“低 50%”对应输入,输出其实降了 58%。看到只写“Terra”的价格或评测,先确认是哪一代。
GPT-6.1 Terra 有 Batch、Fast 这些档吗?
截至 2026 年 10 月 28 日,按 OpenAI API 定价页,Terra 的 Batch 和 Flex 是 Standard 价的一半,Fast 是 2 倍(272K 以内每百万 token 输入 $2、输出 $10),没有 Ultrafast。Claude API 定价页给 Opus 5.5 的 Fast 模式标价是每百万 token 输入 $8、输出 $40。
参考来源6
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月28日。
参考来源6
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月28日。
- 1.GPT-6.1 Terra 发布文openai.com/index/introducing-gpt-6-1-terra
- 2.AA 的 Claude Opus 5.5 与 GPT-6.1 Terra 逐档对比页artificialanalysis.ai/models/releases/comparisons/claude-opus-5-5-vs-gpt-6-1-terra
- 3.OpenAI API 定价页developers.openai.com/api/docs/pricing
- 4.Claude API 定价页platform.claude.com/docs/en/about-claude/pricing
- 5.OpenAI 的 GPT-6.1 Terra 模型页developers.openai.com/api/docs/models/gpt-6.1-terra
- 6.Codex 价格与用量文档learn.chatgpt.com/docs/pricing