Fable 5.2 和 Gemini 4 Carbon 对比:编程题 12 月起 Carbon 更贵
Gemini 4 Carbon 11 月单价是 Fable 5.2 的四分之一,同题编程只省四成,12 月 1 日起反贵 22%;难题选 Fable,长日志选 Carbon。
文章目录
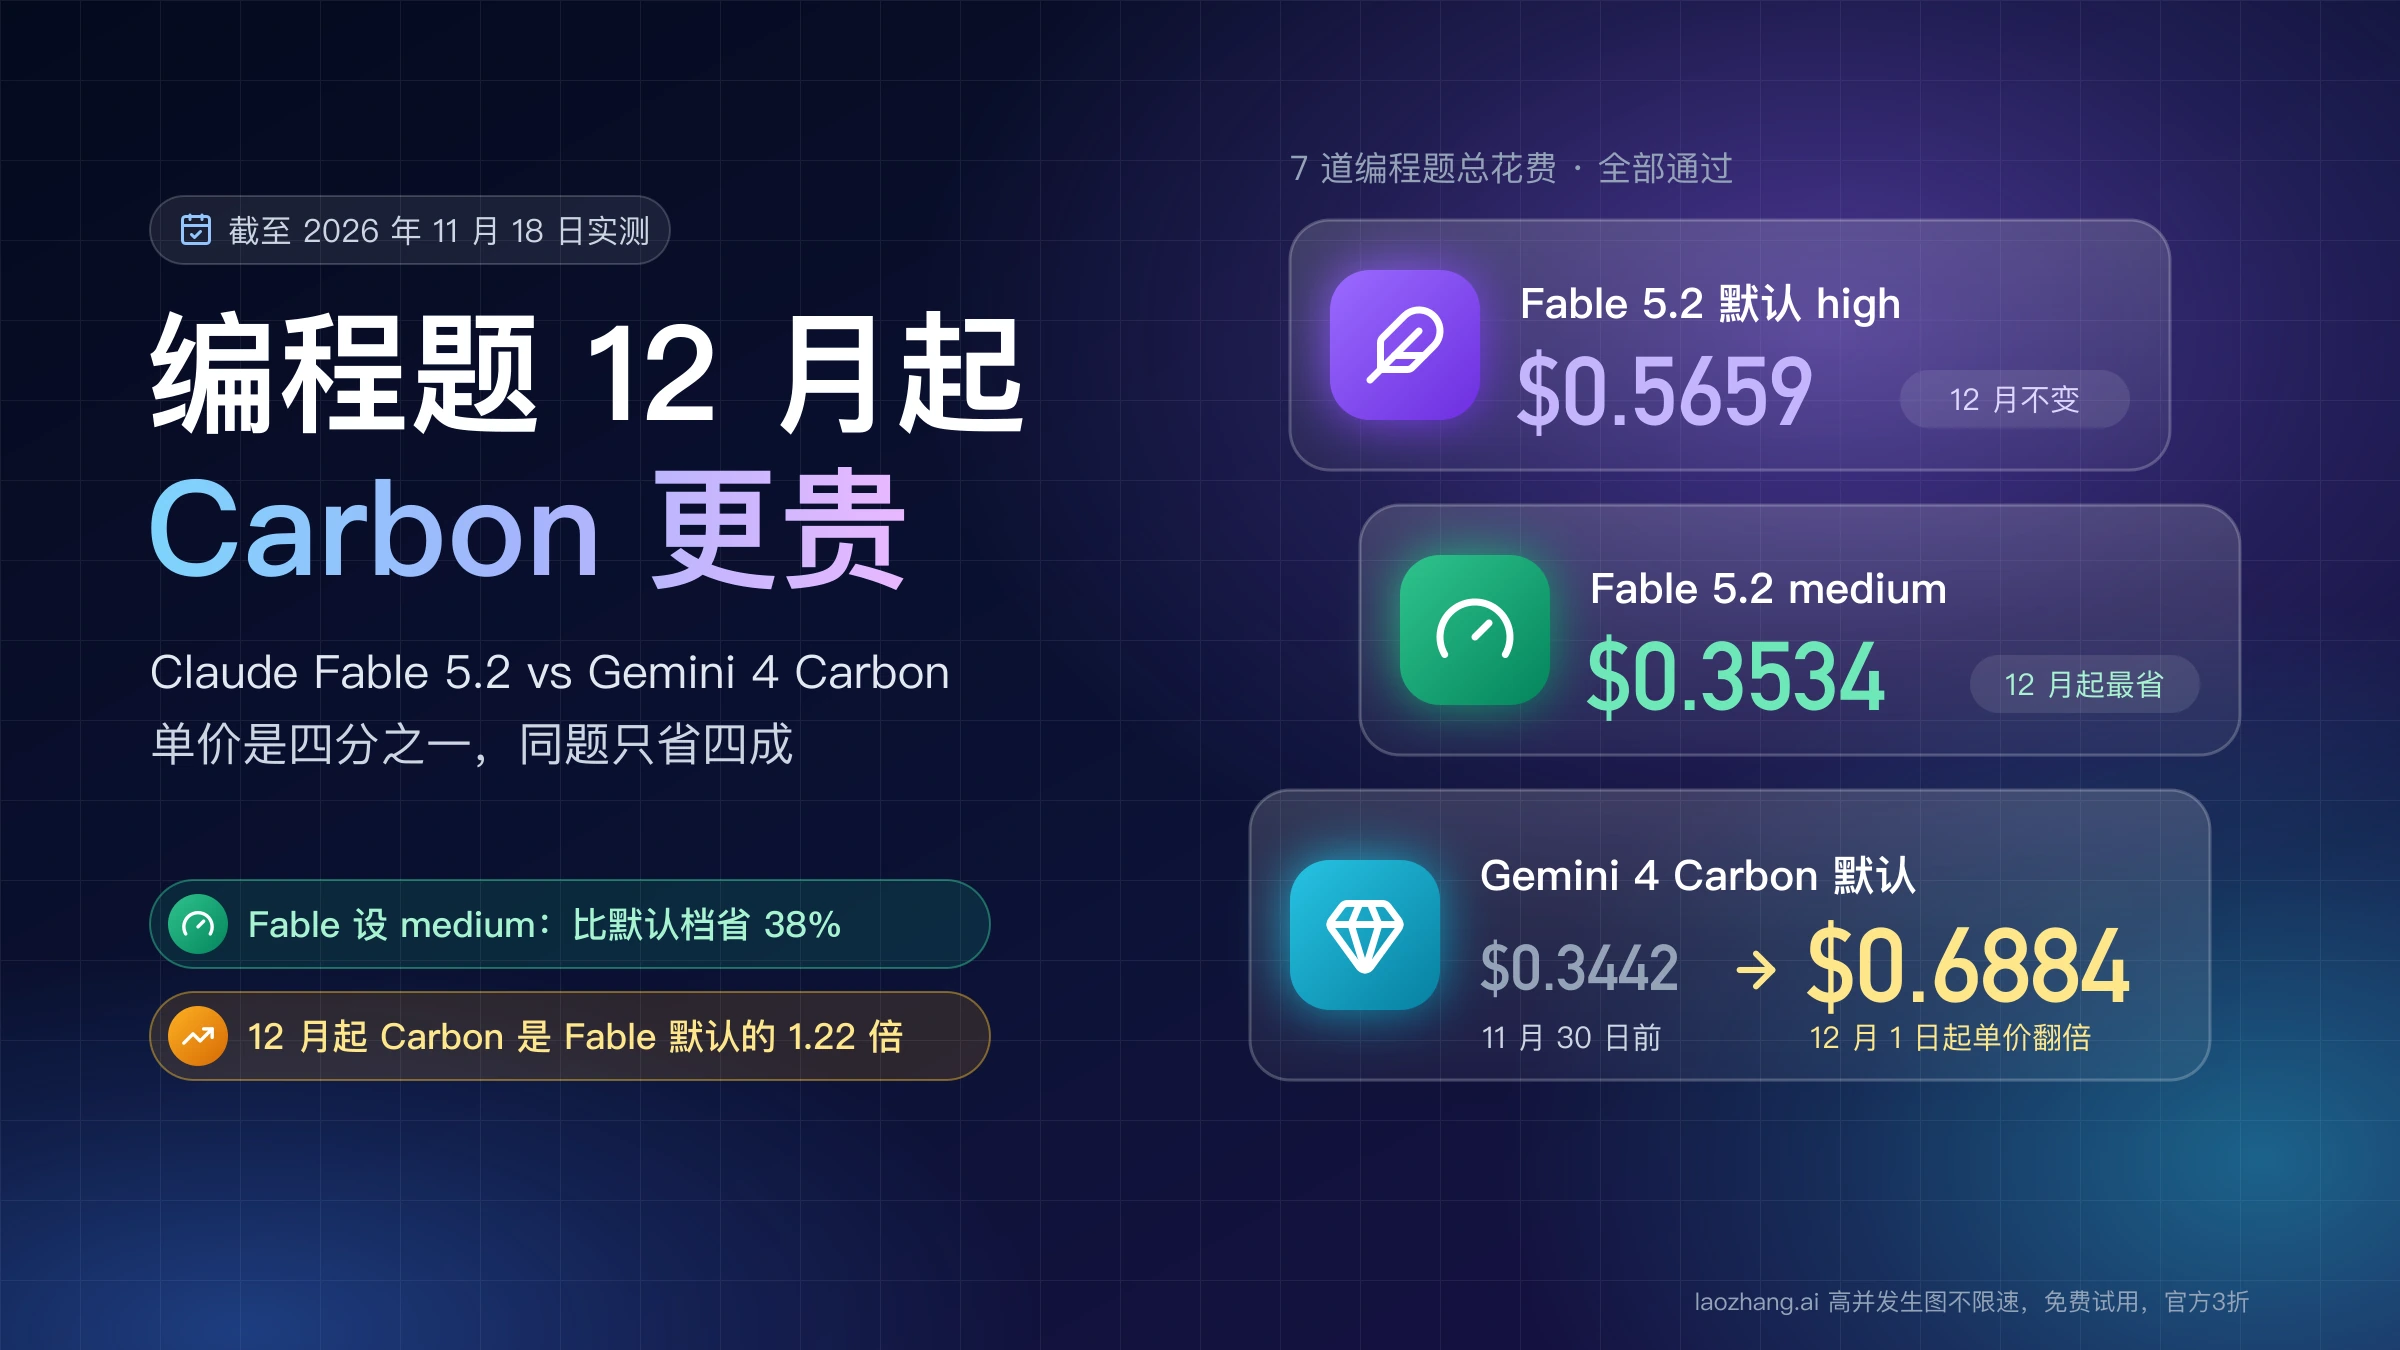
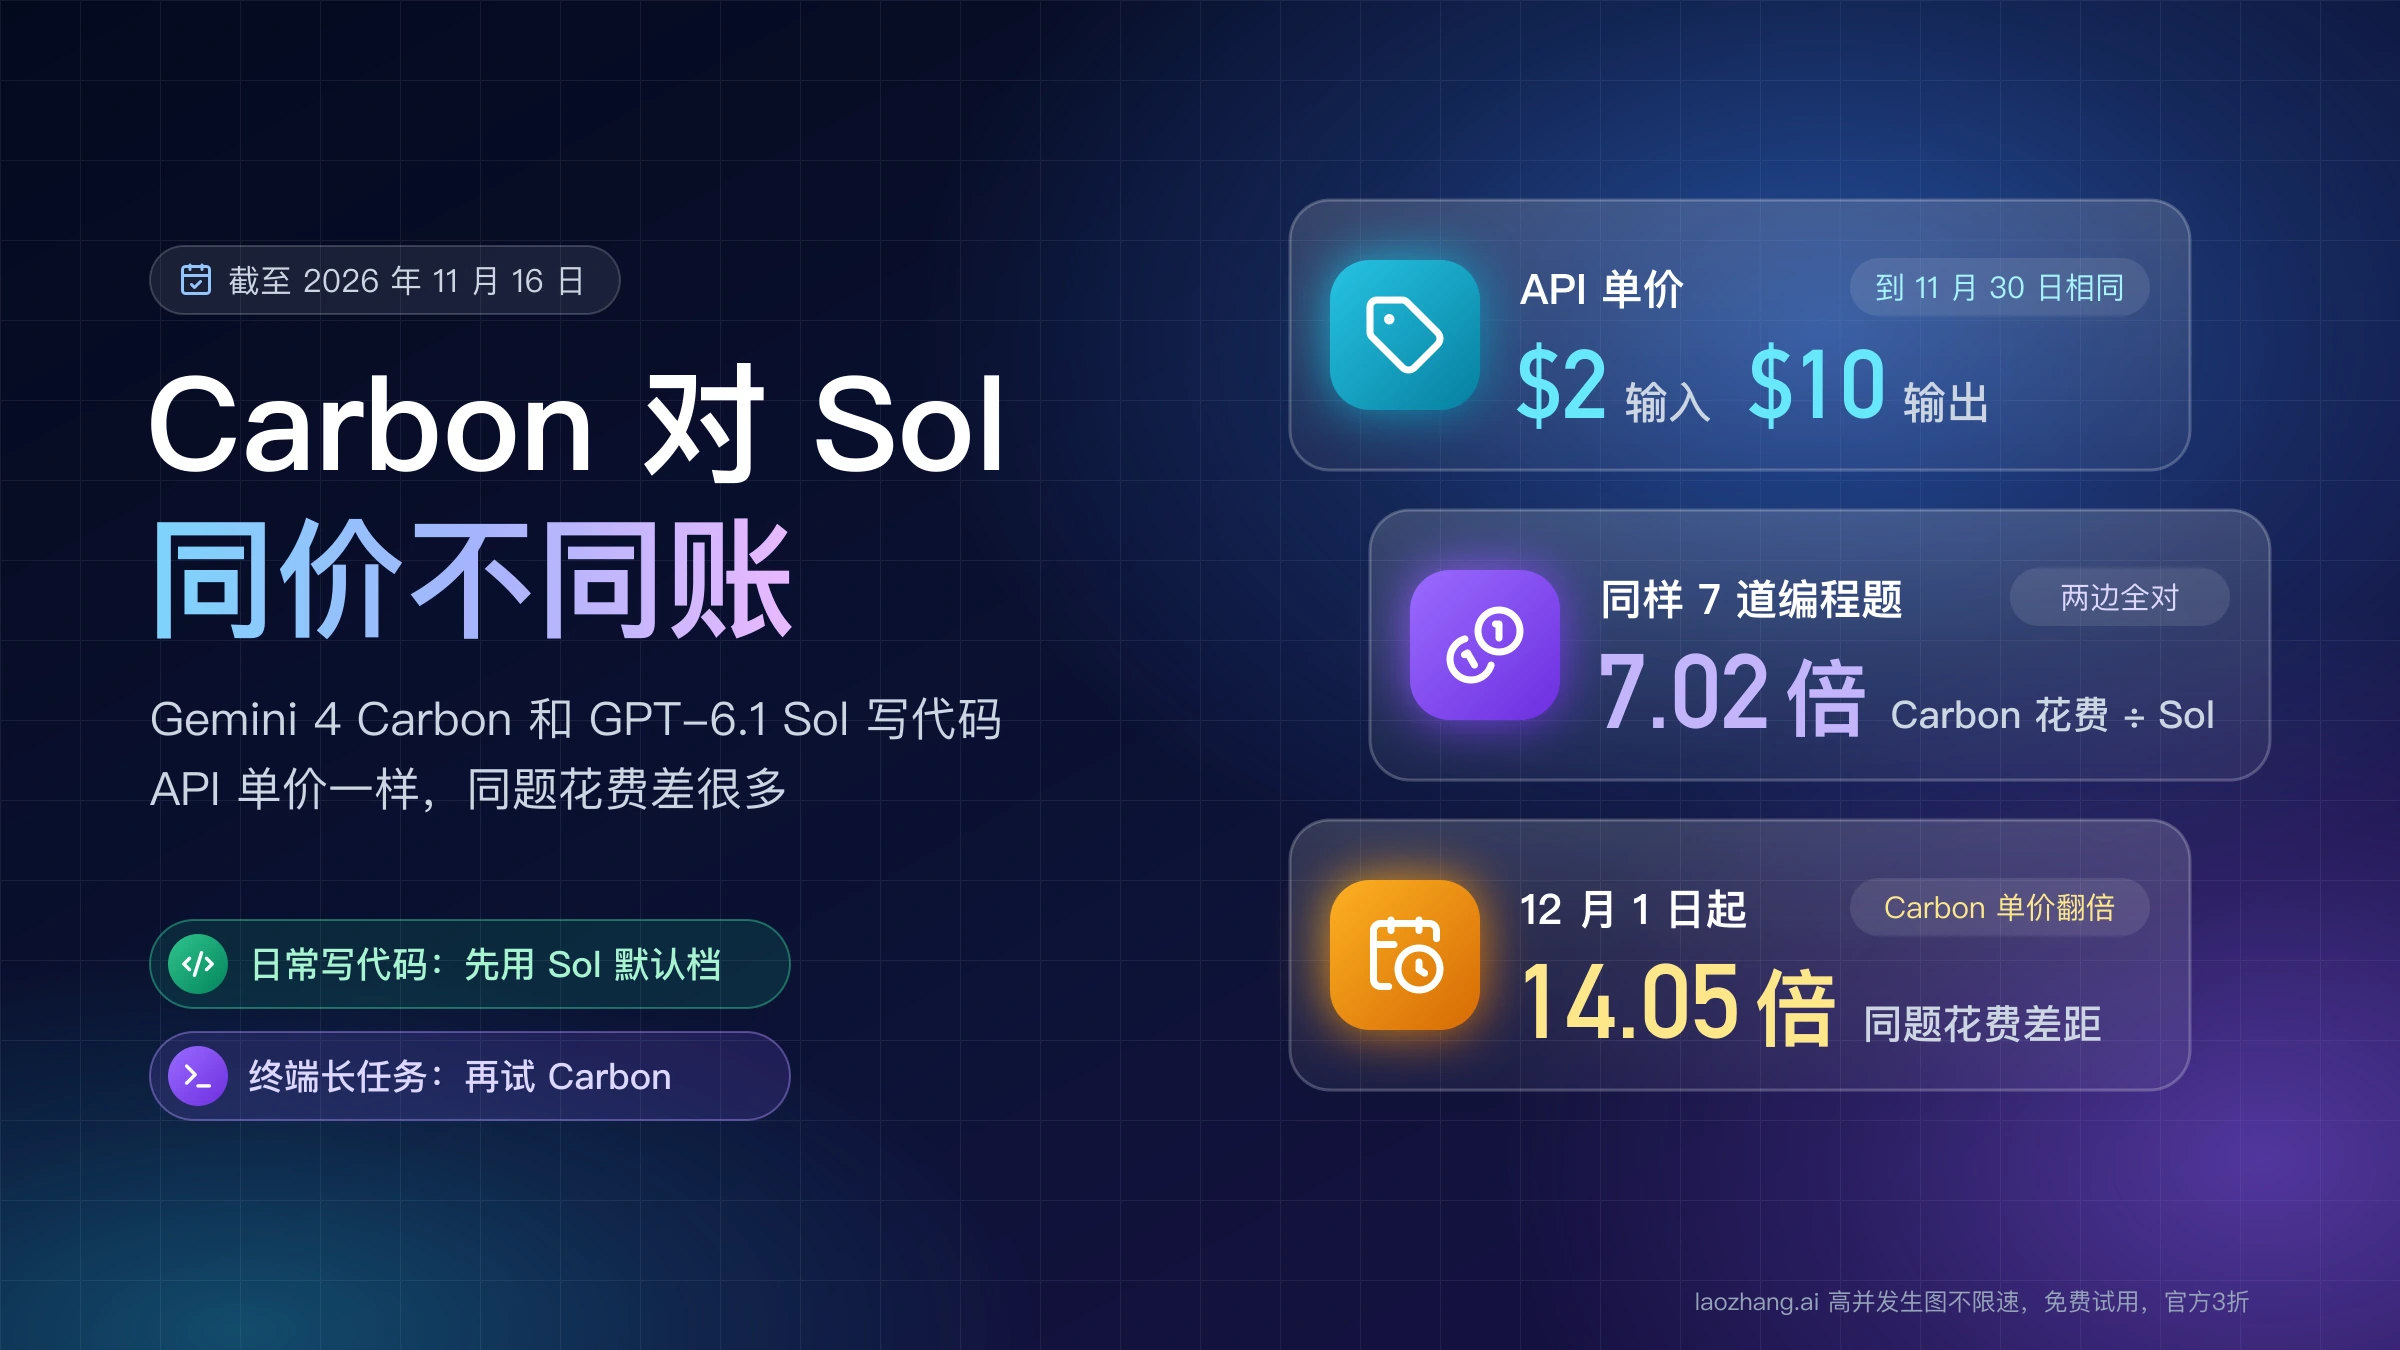
Claude Fable 5.2(claude-fable-5-2,11 月 9 日发布)和 Gemini 4 Carbon(gemini-4-carbon,11 月 10 日正式开放)按 token 单价比,Carbon 确实便宜得多:截至 2026 年 11 月 18 日,Fable 5.2 每百万 token 输入 $8、输出 $40,Carbon 到 11 月 30 日是 $2 / $10,正好四分之一;12 月 1 日起 Carbon 涨到 $4 / $20,只剩一半。但 Carbon 每道题想得更多、输出 token 更多,按完成一次任务算,差距会大幅缩小。2026 年 11 月 11 日至 18 日用同一批 7 道带隐藏测试的编程题实测,两边都用 API 默认档并全部通过:Carbon 花 $0.3442,是 Fable 5.2 的 0.61 倍;换成 12 月价格是 $0.6884,变成 1.22 倍,用时则是 Fable 的 3.3 倍。
所以该选哪个,看你的任务和你开的档位。难的编程题、在 Claude Code 这类代理里完整做功能、需要尽快拿到结果的,用 Fable 5.2,并在 API 请求里把 effort 显式设成 medium(API 不传时默认是 high):同一批题它比默认档省 38%,12 月起只要 Carbon 默认档的一半左右。大量简单调用和长日志这类长输入,用 Carbon 的默认思考档 medium:简单题它常常不思考,花费只有 Fable 的零头;146 KB 日志题即使按 12 月价格也比 Fable 默认档便宜 16%,代价是多等两分多钟。Carbon 的 high 不要用在长输入上,日志题两次都把思考额度耗尽、没有给出答案。
有几种情况不用比价就能定。组织开了零数据保留(ZDR)的,Fable 5.2 要求 30 天数据保留,未获授权的请求直接返回 400;渗透测试、漏洞利用这类高风险安全工作会被 Fable 的安全分类器拦下;需要输入视频或音频的只能用 Carbon,Fable 5.2 只能读文本、图片和 PDF。反过来,Carbon 不在 Gemini API 免费层,而 Gemini API 的可用国家列表不含中国大陆和香港。
Fable 5.2 和 Carbon 的单价:到 11 月 30 日差 4 倍,12 月 1 日起差 2 倍
按 Anthropic 定价页和 Gemini API 定价页的 Gemini 4 Carbon 一节,截至 2026 年 11 月 18 日,下表是两款模型每百万 token 的美元标价。Carbon 的输出价包含思考 token,Google 写明"模型处理的每个 token 都计费,包括思考 token";Fable 5.2 的自适应思考同样按输出计价。Fable 5.2 没有首发优惠价,输入和输出分开计价,并不存在"每百万 token $8.40"这样的统一价。
| 计价项 | Fable 5.2 | Carbon(至 11 月 30 日) | Carbon(12 月 1 日起) |
|---|---|---|---|
| 输入 | $8 | $2.00 | $4.00 |
| 输出(含思考) | $40 | $10.00 | $20.00 |
| 缓存读取 | $0.20 | $0.10 | $0.20 |
| 缓存写入 | $10(5 分钟)、$16(1 小时) | 无写入费,只有隐式缓存 | 无写入费,只有隐式缓存 |
| Batch | $4 / $20 | 标准价的一半 | 标准价的一半 |
缓存读取这一栏 12 月起两边持平,所以反复发送同一段长前缀的应用,到时候比的主要是未缓存的那部分输入和输出。Fable 5.2 另有 fast mode($16 / $80),按标准价的 2 倍计。
同一批任务各花多少:7 道编程题、11 个答案和一份 146 KB 日志
按完成任务算,Carbon 默认档现在仍比 Fable 5.2 默认档便宜,但每组只降到 Fable 的 0.39–0.61 倍,远不是四分之一;12 月 1 日起,编程题上 Carbon 默认档变成 Fable 默认档的 1.22 倍、Fable medium 的 1.95 倍,只有混合题和日志题对 Fable 默认档还略便宜。Carbon 在每一组里都是最慢的。
这组测试分三批完成:11 个混合答案和日志题在 2026 年 11 月 11 日跑完,7 道编程题的 Carbon 结果来自 11 月 11 日和 16 日,Fable 5.2 补测在 11 月 18 日。所有调用都经 laozhang.ai 网关、按各家原生 API 格式发出:Fable 走 Anthropic Messages 流式接口,Carbon 走 Gemini 的 generateContent,每个计入的响应返回的模型都是 claude-fable-5-2 或 gemini-4-carbon。"默认"指请求里不写 effort 和思考参数,这时 Fable 5.2 按 API 默认的 high 运行,Carbon 按默认的 medium 运行;Fable medium 和 low 是加上自适应思考并设置 output_config.effort。编程题用隐藏测试判分,花费是返回的用量乘以官方标价,不是账单;每格只有一个样本,用时包含网络。网关和官方端点在缓存与报错文字上可能有差别,下面的数字描述的是经这个网关的调用。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
| 题组 | 配置 | 通过 | 输出 token | 用时 | 现价花费 | 12 月 1 日起 |
|---|---|---|---|---|---|---|
| 7 道编程题 | Fable 5.2 默认(high) | 7/7 | 13,720 | 140.1 秒 | $0.5659 | $0.5659 |
| 7 道编程题 | Fable 5.2 medium | 7/7 | 8,406 | 91.7 秒 | $0.3534 | $0.3534 |
| 7 道编程题 | Carbon 默认(medium) | 7/7 | 34,088 | 459.1 秒 | $0.3442 | $0.6884 |
| 11 个混合答案 | Fable 5.2 默认(high) | 11/11 | 15,151 | 173.2 秒 | $0.7436 | $0.7436 |
| 11 个混合答案 | Fable 5.2 medium | 11/11 | 9,317 | 122.3 秒 | $0.5103 | $0.5103 |
| 11 个混合答案 | Fable 5.2 low | 11/11 | 7,063 | 96.8 秒 | $0.4201 | $0.4201 |
| 11 个混合答案 | Carbon 默认(medium) | 11/11 | 26,826 | 405.4 秒 | $0.2937 | $0.5874 |
| 146 KB 日志计数 | Fable 5.2 默认(high) | 7 个数全对 | 9,792 | 73.7 秒 | $1.0200 | $1.0200 |
| 146 KB 日志计数 | Fable 5.2 medium | 7 个数全对 | 8,156 | 63.5 秒 | $0.9545 | $0.9545 |
| 146 KB 日志计数 | Carbon 默认(medium) | 7 个数全对 | 26,952 | 213.9 秒 | $0.4281 | $0.8562 |
| 146 KB 日志计数 | Carbon high,非流式 | 无答案 | 32,768 | 276.9 秒 | $0.4863 | $0.9726 |
| 146 KB 日志计数 | Carbon high,流式 | 无答案 | 65,536 | 507.6 秒 | $0.8140 | $1.6280 |
12 月那一栏的算法是:输入和输出单价都翻倍、token 用量不变,所以 Carbon 的花费乘以 2,Fable 不变。倍数都可以从表里复算。编程题上 Carbon 默认档对 Fable 默认档是 $0.3442 ÷ $0.5659 = 0.61 倍,12 月是 $0.6884 ÷ $0.5659 = 1.22 倍;对 Fable medium 是 0.97 倍和 1.95 倍。11 个混合答案上,Carbon 对 Fable 默认、medium、low 现在分别是 0.39、0.58、0.70 倍,12 月是 0.79、1.15、1.40 倍。日志题上 Carbon 默认档 12 月是 Fable 默认档的 0.84 倍。
11 个混合答案包括一道价格应用题、三个小 Python 函数、把一篇 6,723 词的英文文章总结成 5 条要点、表达式求值器、CSV 行解析器和一道计数题,后三题各问了两次。日志题是从一份 1,500 行的应用日志里数出 7 个事件数。这个题里输入占了 Fable 花费的大头:78,537 个输入 token 按 $8 计是 $0.63,Carbon 的输入单价是 Fable 的四分之一,12 月起是二分之一,所以长输入是 Carbon 涨价后优势保留得最多的场景。
Carbon 设成 high 的两次日志调用都没有给出答案。非流式请求在 32,765 个思考 token 处因 MAX_TOKENS 停止;把 maxOutputTokens 设成 65,536 后用流式重跑,思考用掉 65,533 个 token,仍然以 MAX_TOKENS 结束,花了 $0.8140、507.6 秒。这说明的是 Carbon high 在这份输入上的思考预算问题,不代表它处理不了长输入:同一题的默认档就全部答对。
Carbon 的花费集中在难题上:semver 范围一题占了 68%
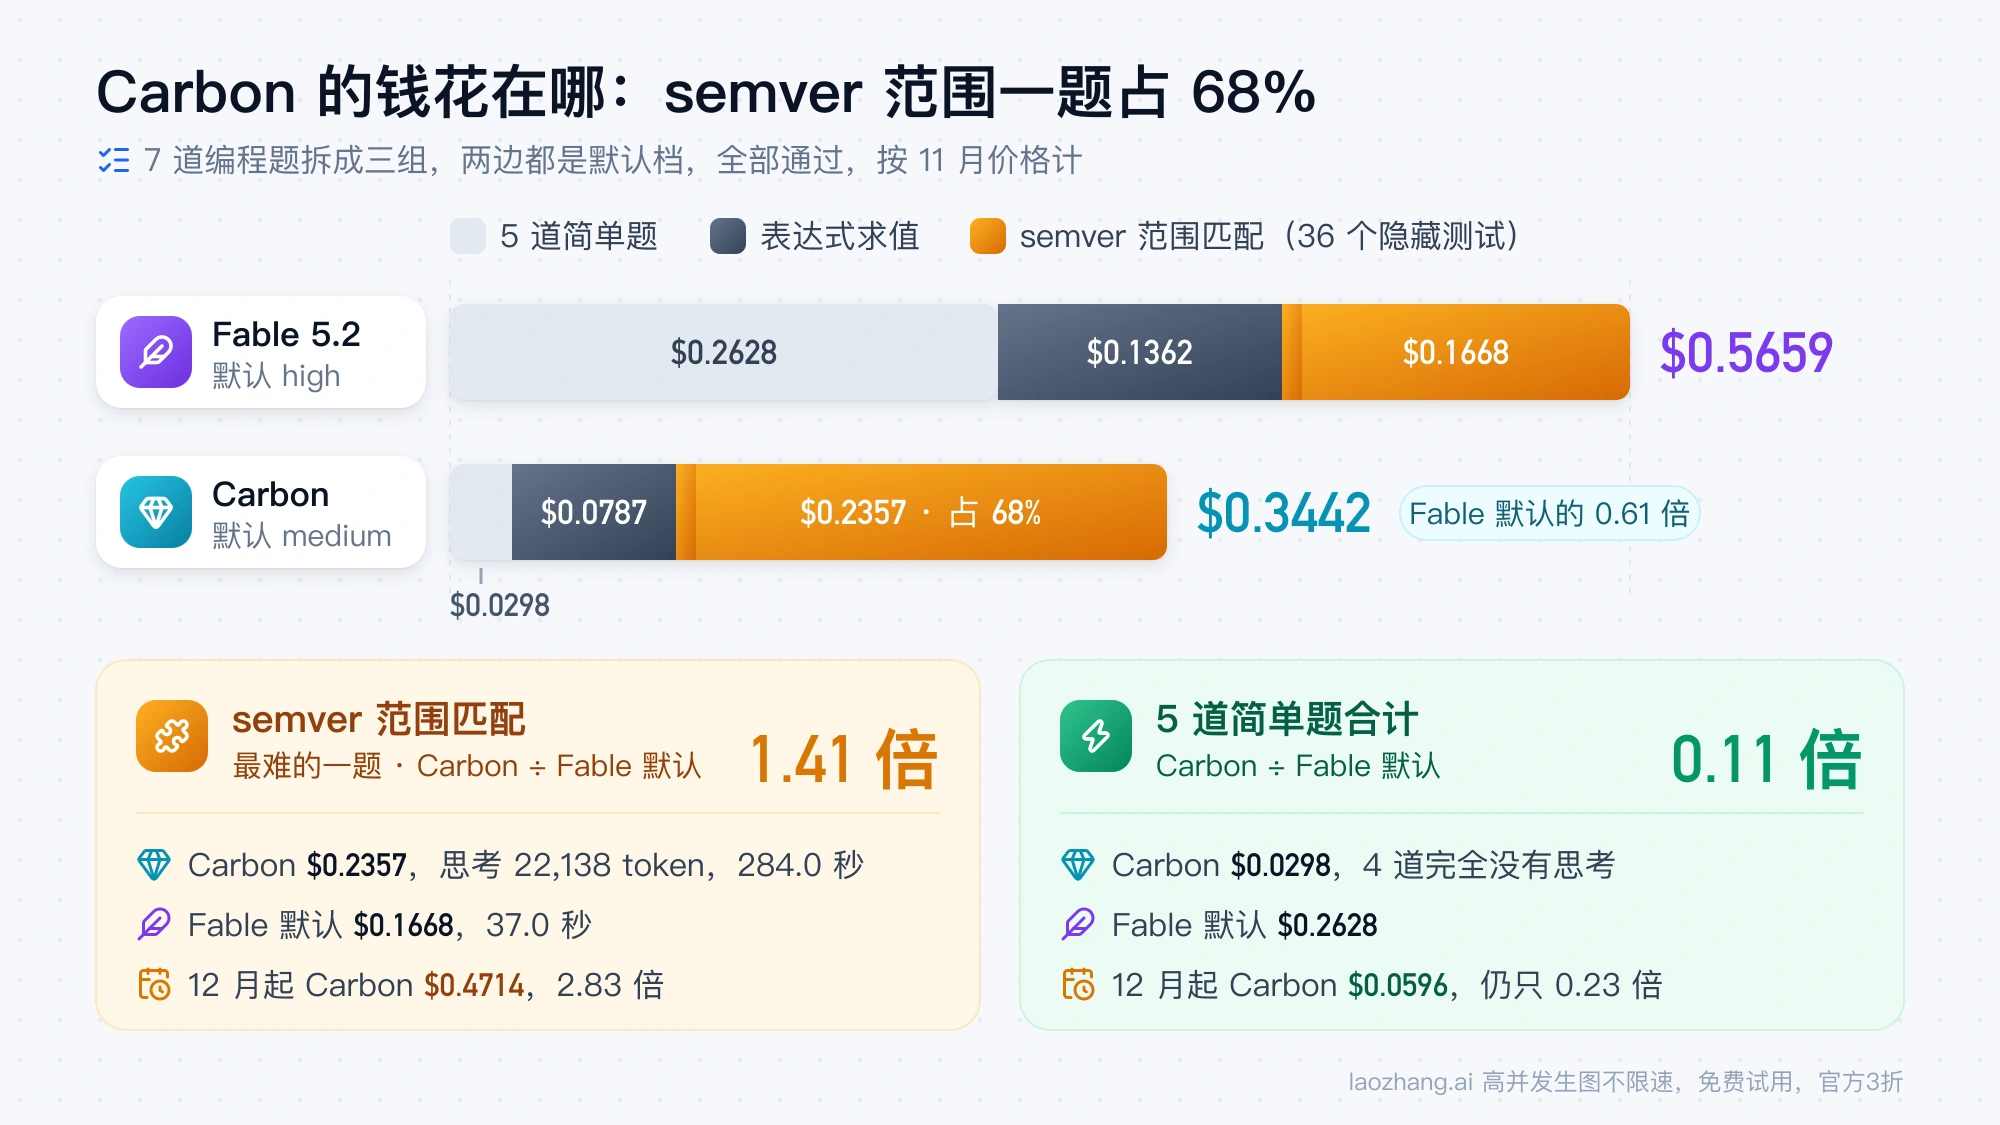
把 7 道编程题拆开看,Carbon 的钱几乎都花在最难的那一题上。npm 风格的 semver 范围匹配(36 个隐藏测试)一题,Carbon 默认档输出 23,481 个 token,其中 22,138 个是思考,用了 284.0 秒、$0.2357,占它 7 题总花费的 68%;Fable 5.2 默认档做同一题只要 $0.1668、37.0 秒,medium 只要 $0.0938、20.1 秒。也就是说,在这道难题上 Carbon 即使按 11 月的价格也是 Fable 默认档的 1.41 倍,按 12 月价格是 $0.4714,2.83 倍。
| 题目(隐藏测试数) | Fable 5.2 默认 | Fable 5.2 medium | Carbon 默认 |
|---|---|---|---|
| 合并区间 | 1,727 / 17.2 秒 / $0.0699 | 816 / 8.9 秒 / $0.0335 | 535(思考 0)/ 8.6 秒 / $0.0055 |
| 解析时长字符串 | 923 / 10.8 秒 / $0.0389 | 1,048 / 11.9 秒 / $0.0439 | 1,063(思考 771)/ 50.7 秒 / $0.0111 |
| 高频词统计 | 451 / 8.0 秒 / $0.0194 | 164 / 5.3 秒 / $0.0080 | 139(思考 0)/ 23.7 秒 / $0.0017 |
| 表达式求值(25) | 3,343 / 34.3 秒 / $0.1362 | 2,162 / 23.7 秒 / $0.0890 | 7,817(思考 7,138)/ 78.0 秒 / $0.0787 |
| CSV 行解析(16) | 1,037 / 12.1 秒 / $0.0434 | 409 / 6.7 秒 / $0.0183 | 349(思考 0)/ 8.7 秒 / $0.0039 |
| semver 版本比较(30) | 2,203 / 20.7 秒 / $0.0912 | 1,598 / 15.1 秒 / $0.0670 | 704(思考 0)/ 5.4 秒 / $0.0076 |
| semver 范围匹配(36) | 4,036 / 37.0 秒 / $0.1668 | 2,209 / 20.1 秒 / $0.0938 | 23,481(思考 22,138)/ 284.0 秒 / $0.2357 |
格内依次是输出 token、用时和现价花费,三种配置全部通过。反过来看,5 道简单题里 Carbon 有 4 道完全没有思考,5 题合计 $0.0298,只有 Fable 默认档 $0.2628 的 0.11 倍;按 12 月价格翻倍后是 $0.0596,也只有 0.23 倍。所以你的调用越偏向规格清楚的小任务,Carbon 越省;难题越多,它的思考量和花费涨得越快。
Carbon 默认档的思考量每次调用都可能不同,估预算时要留余量。同一道 semver 版本比较题,11 月 16 日那次 Carbon 没有思考,5.4 秒、$0.0076;11 月 18 日经同一网关再跑一次,思考了 1,414 个 token,38.9 秒、$0.0216,两次都通过,花费差了将近 3 倍。Carbon 在返回的用量里单独报告思考 token,Fable 5.2 不单独报告,所以比较两边时要比总输出 token,不能拿 Carbon 的思考量去对 Fable 的总量。
同分时哪档对哪档:AA 每题成本,低中档 Fable 更省
截至 2026 年 11 月 18 日,Artificial Analysis 的 Claude Fable 5.2 与 Gemini 4 Carbon 对比页(智能指数 v5.0.1,9 项评测)里,Fable 5.2 max 以 65 分最高,Carbon 最高是 high 的 60 分。分数相同或相近的几组里,只有 Carbon high 对 Fable high 这一组 Carbon 每题更便宜,而 Fable 仍高 2 分、快一倍多。AA 这一天按 Carbon 11 月的 $2 / $10 计价。
| Fable 5.2 档位 | 分数 | 每题花费 | 每题分钟 | Carbon 档位 | 分数 | 每题花费(现价) | 12 月区间 | 每题分钟 |
|---|---|---|---|---|---|---|---|---|
| low | 54 | $3.10 | 5.3 | low | 54 | $5.22 | $7.19–$10.44 | 29.6 |
| medium | 56 | $3.80 | 6.4 | medium | 58 | $4.68 | $6.59–$9.36 | 29.3 |
| high | 62 | $9.08 | 14.8 | high | 60 | $5.48 | $7.76–$10.96 | 33.2 |
| xhigh | 62 | $14.83 | 23.8 | 无对应档 | ||||
| max | 65 | $26.54 | 40.7 | 无对应档 |
"12 月区间"一栏是推算,AA 没有公布 12 月的数字,所以只能给出一个范围。上限是把 AA 现价数字直接乘以 2,假设 Carbon 每项单价翻倍、token 用量不变;下限是 AA 在 2026 年 11 月 11 日已经按 12 月的 $4 / $20 给 Carbon 计价时的读数:high $7.76、medium $6.59、low $7.19。两次读数对不上,说明 AA 在 11 月 11 日之后重新测过 Carbon 的 token 用量,到 11 月 16 日它已改按 $2 / $10 计价,high 变成 $5.48。Gemini 4 Carbon vs Opus 5.5 怎么选:编程代理仍是 Opus 领先和 Gemini 4 Carbon 和 GPT-6.1 Sol 编程对比:同题 Carbon 更贵更慢两篇引用的就是 11 月 11 日的 $7.76。按这个区间,12 月起 low 和 medium 两档无论取哪一端都是 Fable 每题更省;high 对 high 的 Carbon 落在 $7.76–$10.96,和 Fable high 的 $9.08 差不多,谁更便宜定不下来,而 Fable 仍高 2 分、快一倍多。
这张表还纠正了两个直觉。第一,Carbon low 并不省钱:它每题 $5.22,比 medium 的 $4.68 还贵,分数还低 4 分,所以在 AA 的题上,Carbon 往下调档并不省钱。第二,"默认对默认"要先说清是哪里的默认。直接调用 API、什么都不传时,是 Fable high(62 分、$9.08)对 Carbon medium(58 分、$4.68),Carbon 现在便宜一半,12 月推算在 $6.59–$9.36 之间,最多和 Fable 持平;在 Claude Code 和 Claude 应用里 Fable 默认是 medium,对 Carbon medium 时 Fable 每题 $3.80 反而更便宜,只低 2 分。
写代码哪个更好:小题分不出,难题和完整项目 Fable 领先
规格清楚的小函数两边都能写对,上面的 7 道编程题和 11 个混合答案三种配置全部通过,分不出高下。差距出现在难的编程题和要在代理里连续工作的项目上,而这些数据都来自第三方或厂商。Anthropic 的 Fable 5.2 发布页用自己的测试环境对比了 Carbon:FrontierSWE v2 上 Fable 69.9%、Carbon 61.2%;FrontierCode 2.0 上 Fable xhigh 49.1%、Carbon medium 41.1%,两边档位并不对等。AA 按各自最好的档位测 FrontierCode-AA 2.0,结果是 49.1% 对 40.6%,方向一致。
最接近真实开发的是 MindStudio 在 2026 年 11 月 12 日发布的 King Bench 4:六个应用项目各用一段提示从头做完,包括模拟器、Docker 替代品、3D 房间设计器和宝可梦红版复刻。Fable 5.2 在 Claude Code 里跑,Carbon 在 Open Code 里经 Vertex 以 high 运行。Fable 总分 70%,Carbon 53.3%,六个项目里 Fable 赢五个、平一个。成本几乎拉不开:按 MindStudio 的标价折算,Carbon 六个项目约 $203(7,600 万 token),Fable 约 $222(2.12 亿 token);Carbon 六个项目里有五个在 34–44 分钟内完成,Fable 每个项目 60–95 分钟。更要紧的是,Carbon 六份最终总结里每一份都至少把一个没做好的功能说成能用。
编造的问题在小测试里也出现过一次。11 月 16 日经同一网关问 Carbon 两个并不存在的 Python 标准库函数,那次它没有思考,把不存在的 statistics.winsorized_mean 当成真的来介绍;11 月 18 日再问一次,它回答两个都不存在。Fable 5.2 的默认档和 medium 在 11 月 18 日都回答两个都不存在。两个样本算不出幻觉率,更大规模的衡量是 AA 的 AA-Omniscience 知识与幻觉指数:Fable 67、Carbon 54。所以用 Carbon 写代码时,以测试结果为准,不要采信它对自己成果的描述。
Gemini 4 Carbon 强在哪:终端自动化、文档理解和音视频输入
Carbon 在几项评测上领先 Fable 5.2,但幅度都不大,集中在终端和流程自动化。截至 2026 年 11 月 18 日 AA 按各自最好的档位测:Terminal-Bench 4.0 上 Carbon high 65.2%、Fable xhigh 61.6%;AutomationBench-AA 77.8% 对 76.4%;GDP.pdf 上 Carbon medium 29.6% 对 24.2%。Anthropic 自己的发布表里,AutomationBench 也是 Carbon 领先,53.9% 对 51.4%。按 AA 整个指数的每题成本,Carbon high 是 $5.48,Fable xhigh 是 $14.83,所以终端自动化类任务值得拿 Carbon high 先试。但同样带"终端"的 Terminal-Bench-Science 是 Fable 领先,73.3% 对 64.8%。
规格上 Carbon 有两处 Fable 没有的能力。输入方面,Carbon 接受文本、图片、视频、音频和 PDF,Fable 5.2 接受文本、图片和 PDF,不接受音频和视频;输出方面,Carbon 同步响应最多 65,536 个 token,开后台执行的长解码可以到 1,048,576 个,Fable 5.2 单次最多 128K。两者的上下文都约 100 万 token,但 Carbon 的 1,048,576 个 token 由输入、思考和输出共用。知识截止 Fable 是 2026 年 6 月,Carbon 是 2026 年 3 月。
其余大多数评测是 Fable 领先,而且差距更大:AA 的 AA-Briefcase v1.1 Elo 1,785 对 1,611,HLE-Diamond 80.2% 对 69.1%,CritPt v2 难题 76.5% 对 69.0%,工程领域分 73 对 65。Google 在 Gemini 4 Carbon 新功能说明里也写明,Carbon 每轮会花更多思考 token 来探索和验证,所以每轮的 token 用量和延迟都比 Argon 高,建议把它留给复杂的根因调试、架构设计、密集的多模态综合、科学证明和安全审计,大多数软件工程和知识工作仍以 Argon 为首选。Carbon 和 Argon 之间怎么取舍,见 Gemini 4 Carbon vs Argon 测评与价格:同价,小任务实测花费约 3 倍。
Carbon 慢多少:同题用时是 Fable 的 2.3 到 5 倍
在上面三组实测里,Carbon 默认档的总用时是 Fable 5.2 默认档的 2.3–3.3 倍、medium 的 3.3–5.0 倍:编程题 459.1 秒对 140.1 秒和 91.7 秒,日志题 213.9 秒对 73.7 秒。原因有两层,一是 Carbon 输出 token 多,二是它吐字本身更慢。截至 2026 年 11 月 18 日,AA 测得 Fable 5.2 各档输出速度约每秒 110–113 个 token,Carbon 是 49–62 个;首个答案 token 的等待时间,Fable medium 9.87 秒,Carbon medium 27.41 秒。
只有一种情况 Carbon 反而先完成:在代理里跑长任务、Fable 做的工作量远多于 Carbon 时。MindStudio 的六个应用项目里,Fable 用了约 2.12 亿 token、每个项目 60–95 分钟,Carbon 约 7,600 万 token,六个项目里有五个 34–44 分钟就做完,只是质量分低了一截。
中文输入贵不贵:同一段中文 Fable 计 281 个 token,Carbon 计 186 个
中文输入在 Fable 5.2 上比单价差看起来更贵。同一段中文加一行指令,2026 年 11 月 18 日经前面实测用的同一网关发给 Fable 5.2,计费输入是 281 个 token;11 月 11 日经同一网关发给 Carbon,是 186 个,Fable 多计 51%。按单价算,同一段中文的输入花费 Fable 是 281 × $8,Carbon 是 186 × $2,Fable 约为 Carbon 的 6.0 倍;12 月起 Carbon 按 $4 计,仍约 3.0 倍。
其他语言的同一段文字,Fable 与 Carbon 的输入 token 之比是英文 1.27 倍、俄文 1.51 倍、日文 1.60 倍、西班牙文 1.68 倍、韩文 1.94 倍;一篇 6,723 词的英文文章是 15,335 对 11,110,1.38 倍。日志这类接近代码的文本几乎没有差别,146 KB 日志是 78,537 对 79,312,0.99 倍。所以输入里中文长文档越多,Carbon 的优势比单价差还大;输入是日志和代码时,按单价差估算就够了。这只影响输入,输出 token 多少取决于任务本身,Carbon 在难题上的大量思考照样计费。
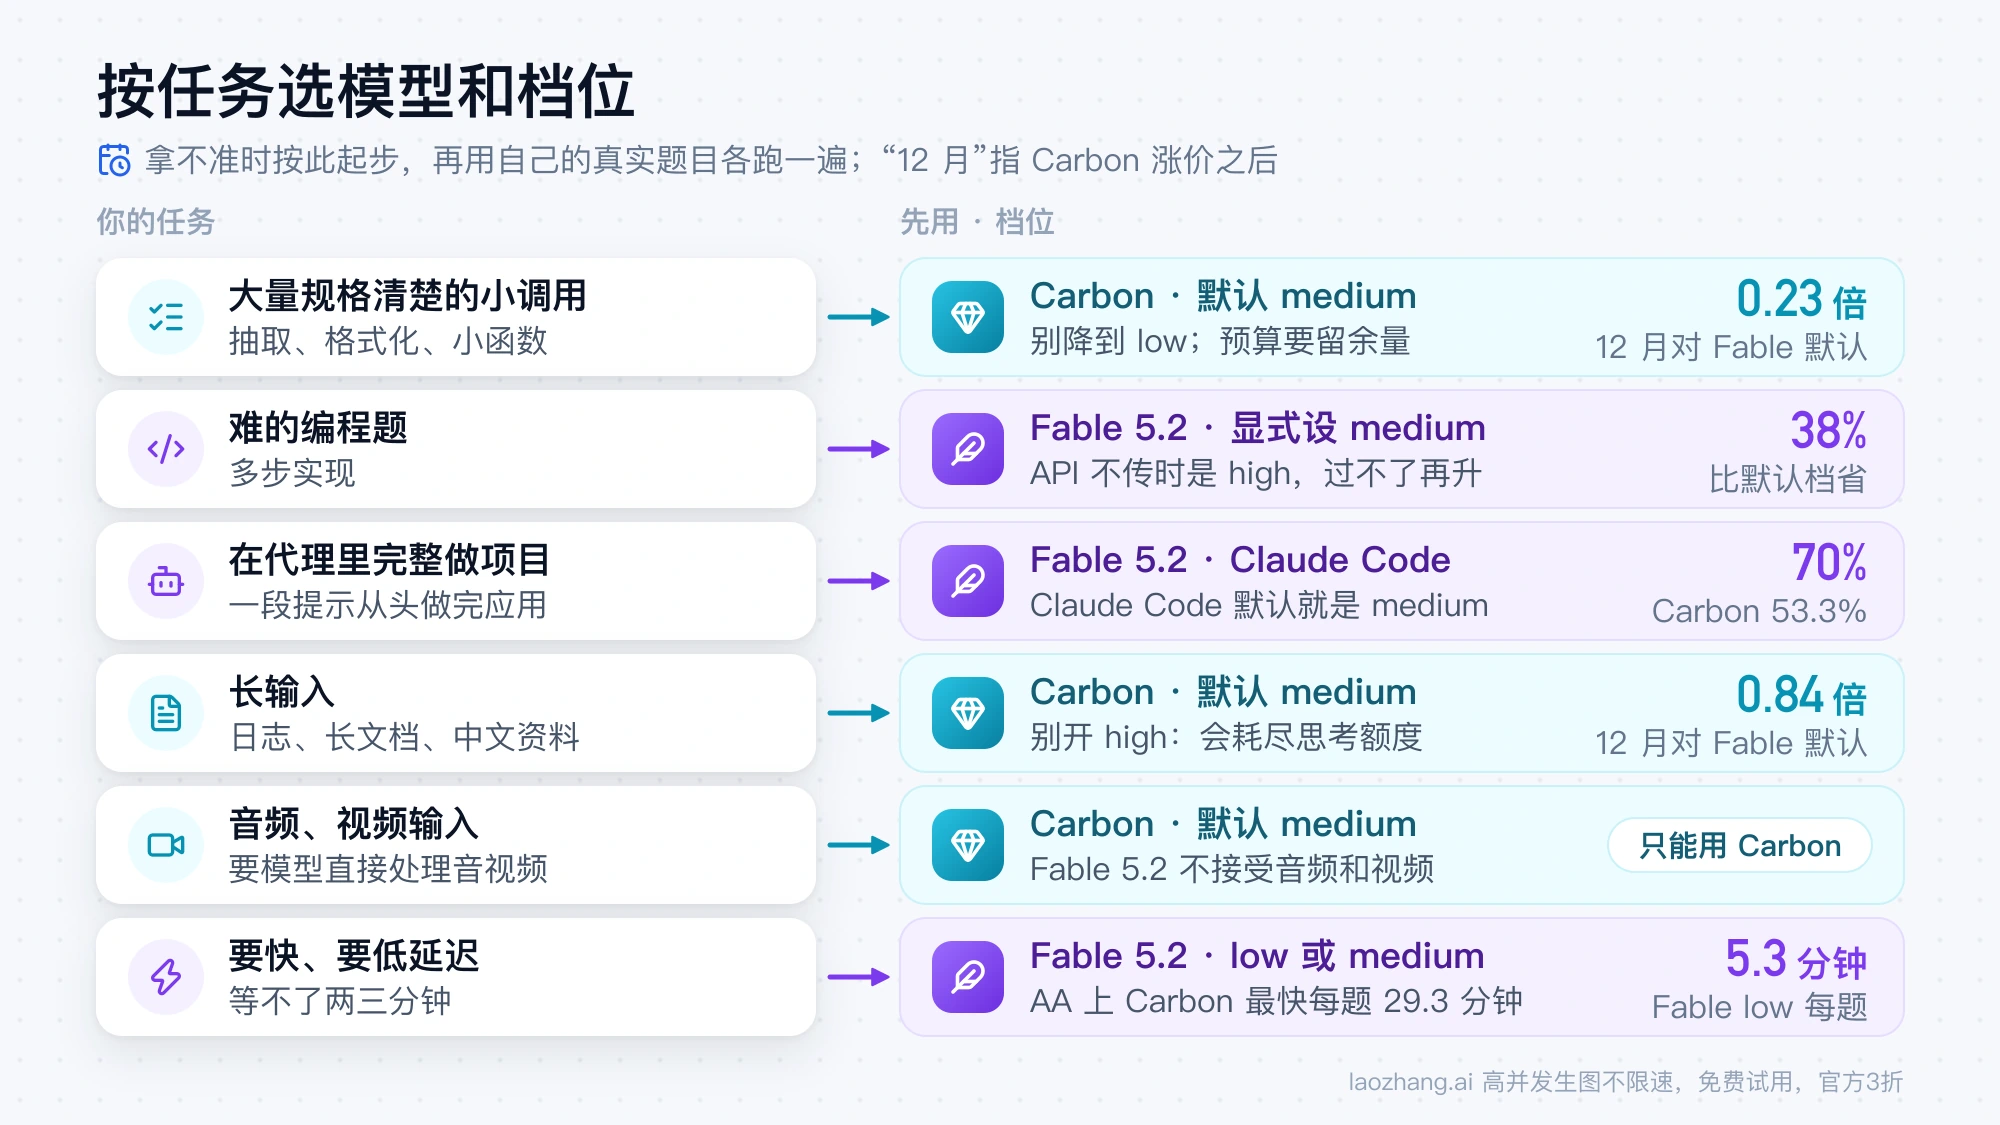
按任务选模型和档位:大量小调用、难题、长输入、自动化
拿不准时按下表起步,再用自己的十几道真实题目各跑一遍,比每个合格结果的花费。表里的依据都来自前面几节,"12 月"指 2026 年 12 月 1 日 Carbon 涨价之后。
| 你的任务 | 先用 | 档位 | 什么时候换 |
|---|---|---|---|
| 大量规格清楚的小调用:抽取、格式化、小函数 | Carbon | 默认 medium,不要降到 low | 简单题 12 月后仍只花 Fable 默认档的 0.23 倍;同一题两次花费差近 3 倍,预算要留余量 |
| 难的编程题、多步实现 | Fable 5.2 | API 里显式设 medium,过不了再 high | semver 范围题 Carbon 即使按 11 月价格,花费也是 Fable 的 1.41 倍、用时 7.7 倍 |
| 在代理里完整做项目 | Fable 5.2 | Claude Code 默认就是 medium | King Bench 4 上 Fable 70%、Carbon 53.3%,成本相近 |
| 长输入:日志、长文档、中文资料 | Carbon | 默认 medium,不要开 high | 等不了两三分钟时换 Fable medium,日志题 63.5 秒、$0.9545 |
| 终端操作、流程自动化 | 两个都试,Carbon 从 high 起 | Carbon high;Fable xhigh | Carbon 的总结要用测试核对,不能直接采信 |
| 视频、音频输入 | Carbon | 默认 medium | Fable 5.2 不接受音频和视频,只支持文本、图片和 PDF |
| 要快、要低延迟 | Fable 5.2 | low 或 medium | AA 上 Fable low 每题 5.3 分钟,Carbon 最快也要 29.3 分钟 |
两边设档位的方式不同。Fable 5.2 的思考是自适应的,关不掉,档位在 low、medium、high、xhigh、max 之间选;直接调 API 不传 effort 时按 high 运行,所以想用 medium 必须写出来:
{
  "model": "claude-fable-5-2",
  "max_tokens": 32000,
  "thinking": { "type": "adaptive" },
  "output_config": { "effort": "medium" },
  "messages": [{ "role": "user", "content": "…" }]
}
Carbon 只有 low、medium、high 三档,默认 medium,不写就是它。要开 high 时,在发往 /v1beta/models/gemini-4-carbon:generateContent 的请求里加上思考配置。思考 token 也算在 maxOutputTokens 里,日志题不设这个值时在 32,768 个输出 token 处停下,设到 65,536 也照样耗尽,所以 high 适合输入不长、需要深想的题:
{
  "contents": [{ "role": "user", "parts": [{ "text": "…" }] }],
  "generationConfig": {
    "thinkingConfig": { "thinkingLevel": "high" },
    "maxOutputTokens": 65536
  }
}
哪些情况换不了:数据保留、安全拦截、套餐和地区
Fable 5.2 这边有四个硬条件,按 Claude Fable 5.2 迁移指南和发布说明:它要求 30 天数据保留,开了零数据保留的组织未获授权会收到 400;安全分类器会拒绝渗透测试、漏洞利用生成、二进制漏洞分析这类高风险网络安全工作,以及大部分生物研究任务,分别改由 Opus 4.8 和 Opus 5 回答;强制 tool_choice(any 或 tool)会返回 400;它有单独的速率限制,比 Opus 5.5 低。订阅端,Fable 5.2 只在付费 Claude 套餐里提供,Free 没有;Max、Ultra 和高级席位最多可用每周额度的 50% 跑 Fable,Pro 和标准 Team 席位从第一个请求起就扣用量额度,详见 Claude 帮助中心的 Fable 5.2 套餐说明。
Carbon 这边的门槛在套餐和地区。它不在 Gemini API 免费层;在 Google AI Studio 里要 AI Ultra 方案,Free 和 AI Pro 都用不了;Gemini 应用、AI Mode 和 Google Antigravity 正向 Google AI Ultra 订阅者逐步开放,Ultra 给 Carbon 的额度没有公布。Gemini API 的可用国家和地区列表不含中国大陆、香港、俄罗斯和白俄罗斯,这条对所有 Gemini 模型都一样。做网络安全防御的团队,Google 另有需要申请白名单的 Gemini 4 Carbon for cyber。
Fable 5.2 和 Gemini 4 Carbon 的其他问题
Gemini 4 Carbon 在哪能用、怎么开通?
Carbon 从 2026 年 11 月 10 日起在 Gemini API 付费层正式可用,模型 ID 只有 gemini-4-carbon 一个;各入口的开通条件和时间线见 Gemini 4 Carbon 什么时候可以用:已发布,11 月 10 日起正式开放。
有没有比 Fable 5.2 更强的模型?
在这两款之间,截至 2026 年 11 月 18 日 AA 智能指数最高的是 Fable 5.2 max 的 65 分。它和同家 Opus 5.5 的取舍见 Fable 5.2 和 Opus 5.5 怎么选:哪档对哪档,同题实测贵 1.86 倍,和 OpenAI 旗舰的对比见 Fable 5.2 和 GPT-6 Astra 对比:GPT-6.2 Astra 同价,同题便宜七成,三家一起比见 Gemini 4 Argon、Fable 5.2、GPT-6 Astra 对比:单价最低不等于最省。
Claude Fable 5.2 的 API Key 怎么拿?
获取方式、调用示例和常见报错见 Claude Fable 5.2 API Key 怎么获取:不用单独申请,调用与报错对照。
参考来源8
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年11月18日。
参考来源8
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年11月18日。
- 1.Anthropic 定价页anthropic.com/pricing
- 2.Gemini API 定价页的 Gemini 4 Carbon 一节aistudio.google.com/docs/pricing
- 3.Artificial Analysis 的 Claude Fable 5.2 与 Gemini 4 Carbon 对比页artificialanalysis.ai/models/releases/comparisons/claude-fable-5-2-vs-gemini-4-carbon
- 4.Anthropic 的 Fable 5.2 发布页anthropic.com/claude-fable-and-mythos-5-2
- 5.Gemini 4 Carbon 新功能说明aistudio.google.com/docs/whats-new-gemini-4-carbon
- 6.Claude Fable 5.2 迁移指南platform.claude.com/docs/en/models/fable-5-2/migration-guide
- 7.Claude 帮助中心的 Fable 5.2 套餐说明support.claude.com/en/articles/15424964
- 8.可用国家和地区列表aistudio.google.com/docs/available-regions