GPT-6.1 Sol、GPT-6 Sol、Astra 怎么选
先用 GPT-6.1 Sol 做成本基线,Astra 留给要求更高、失败更贵的任务。GPT-6 Sol 不必因新版发布就替换;API 迁移查参数与数据驻留,Codex 另比额度。
文章目录
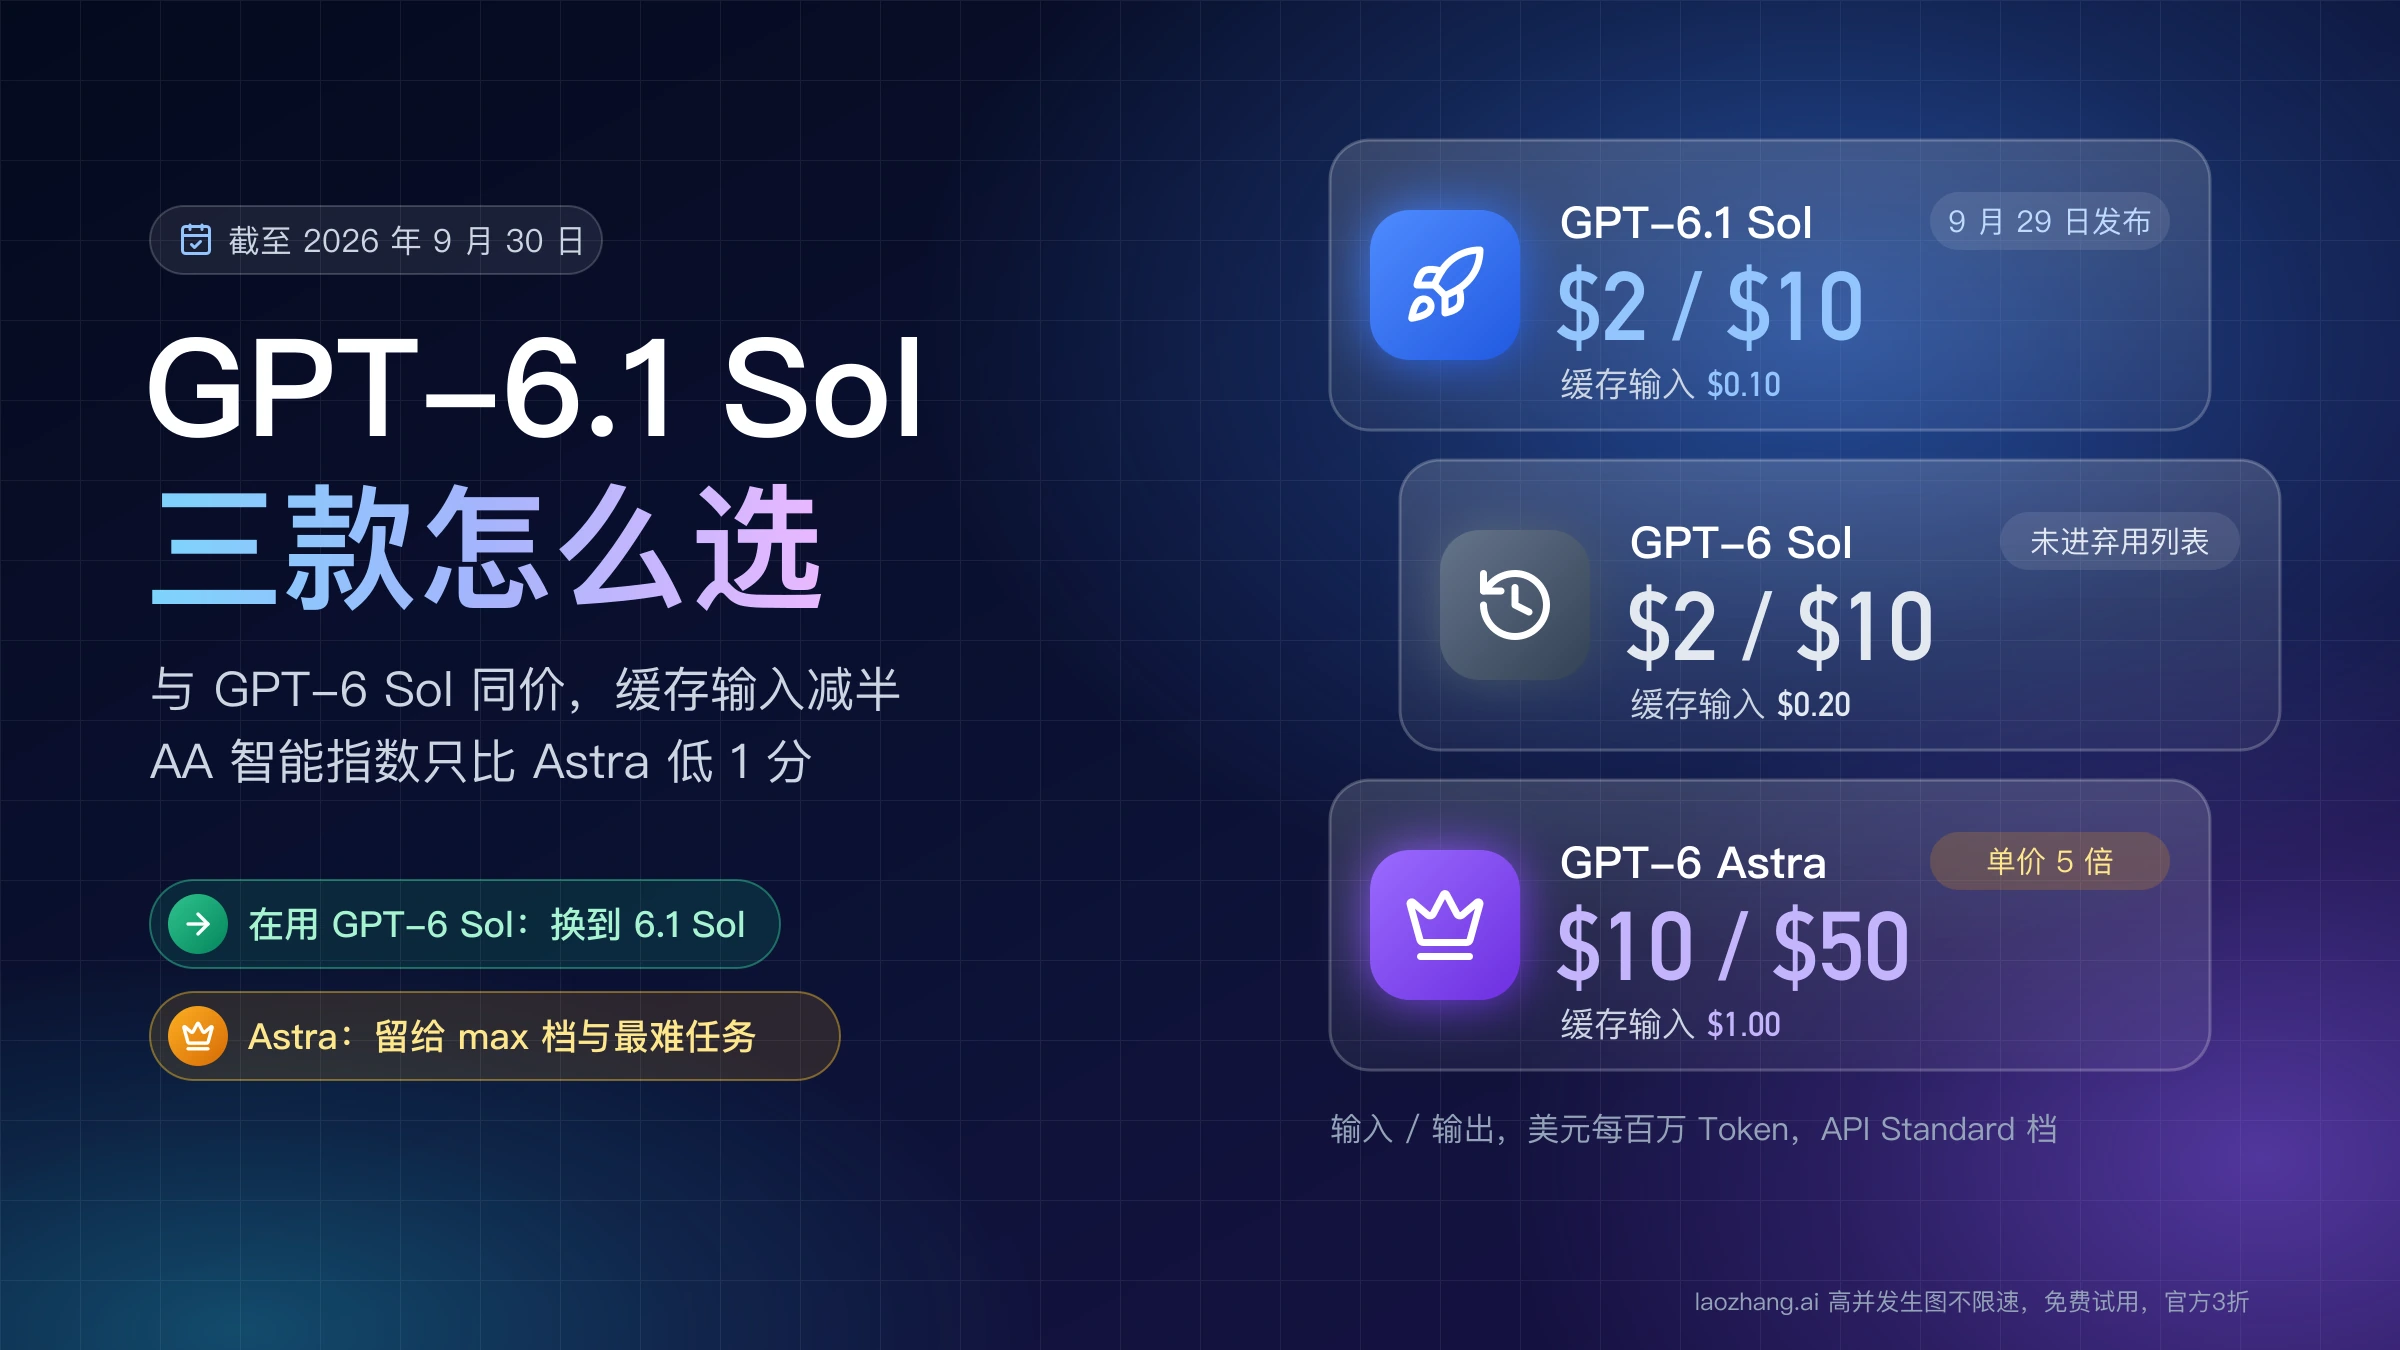
在这三款模型之间选择,可以先把 GPT-6.1 Sol 作为成本基线,再用同一批任务判断是否需要 Astra;已经稳定运行的 GPT-6 Sol 则先做兼容检查,不必立即全量替换。 OpenAI 的模型指南把 6.1 Sol 定位为成本更低、表现接近 Astra 的选项,把 Astra 留给要求最高的工作。这是选型起点,不能代替你的验收结果。
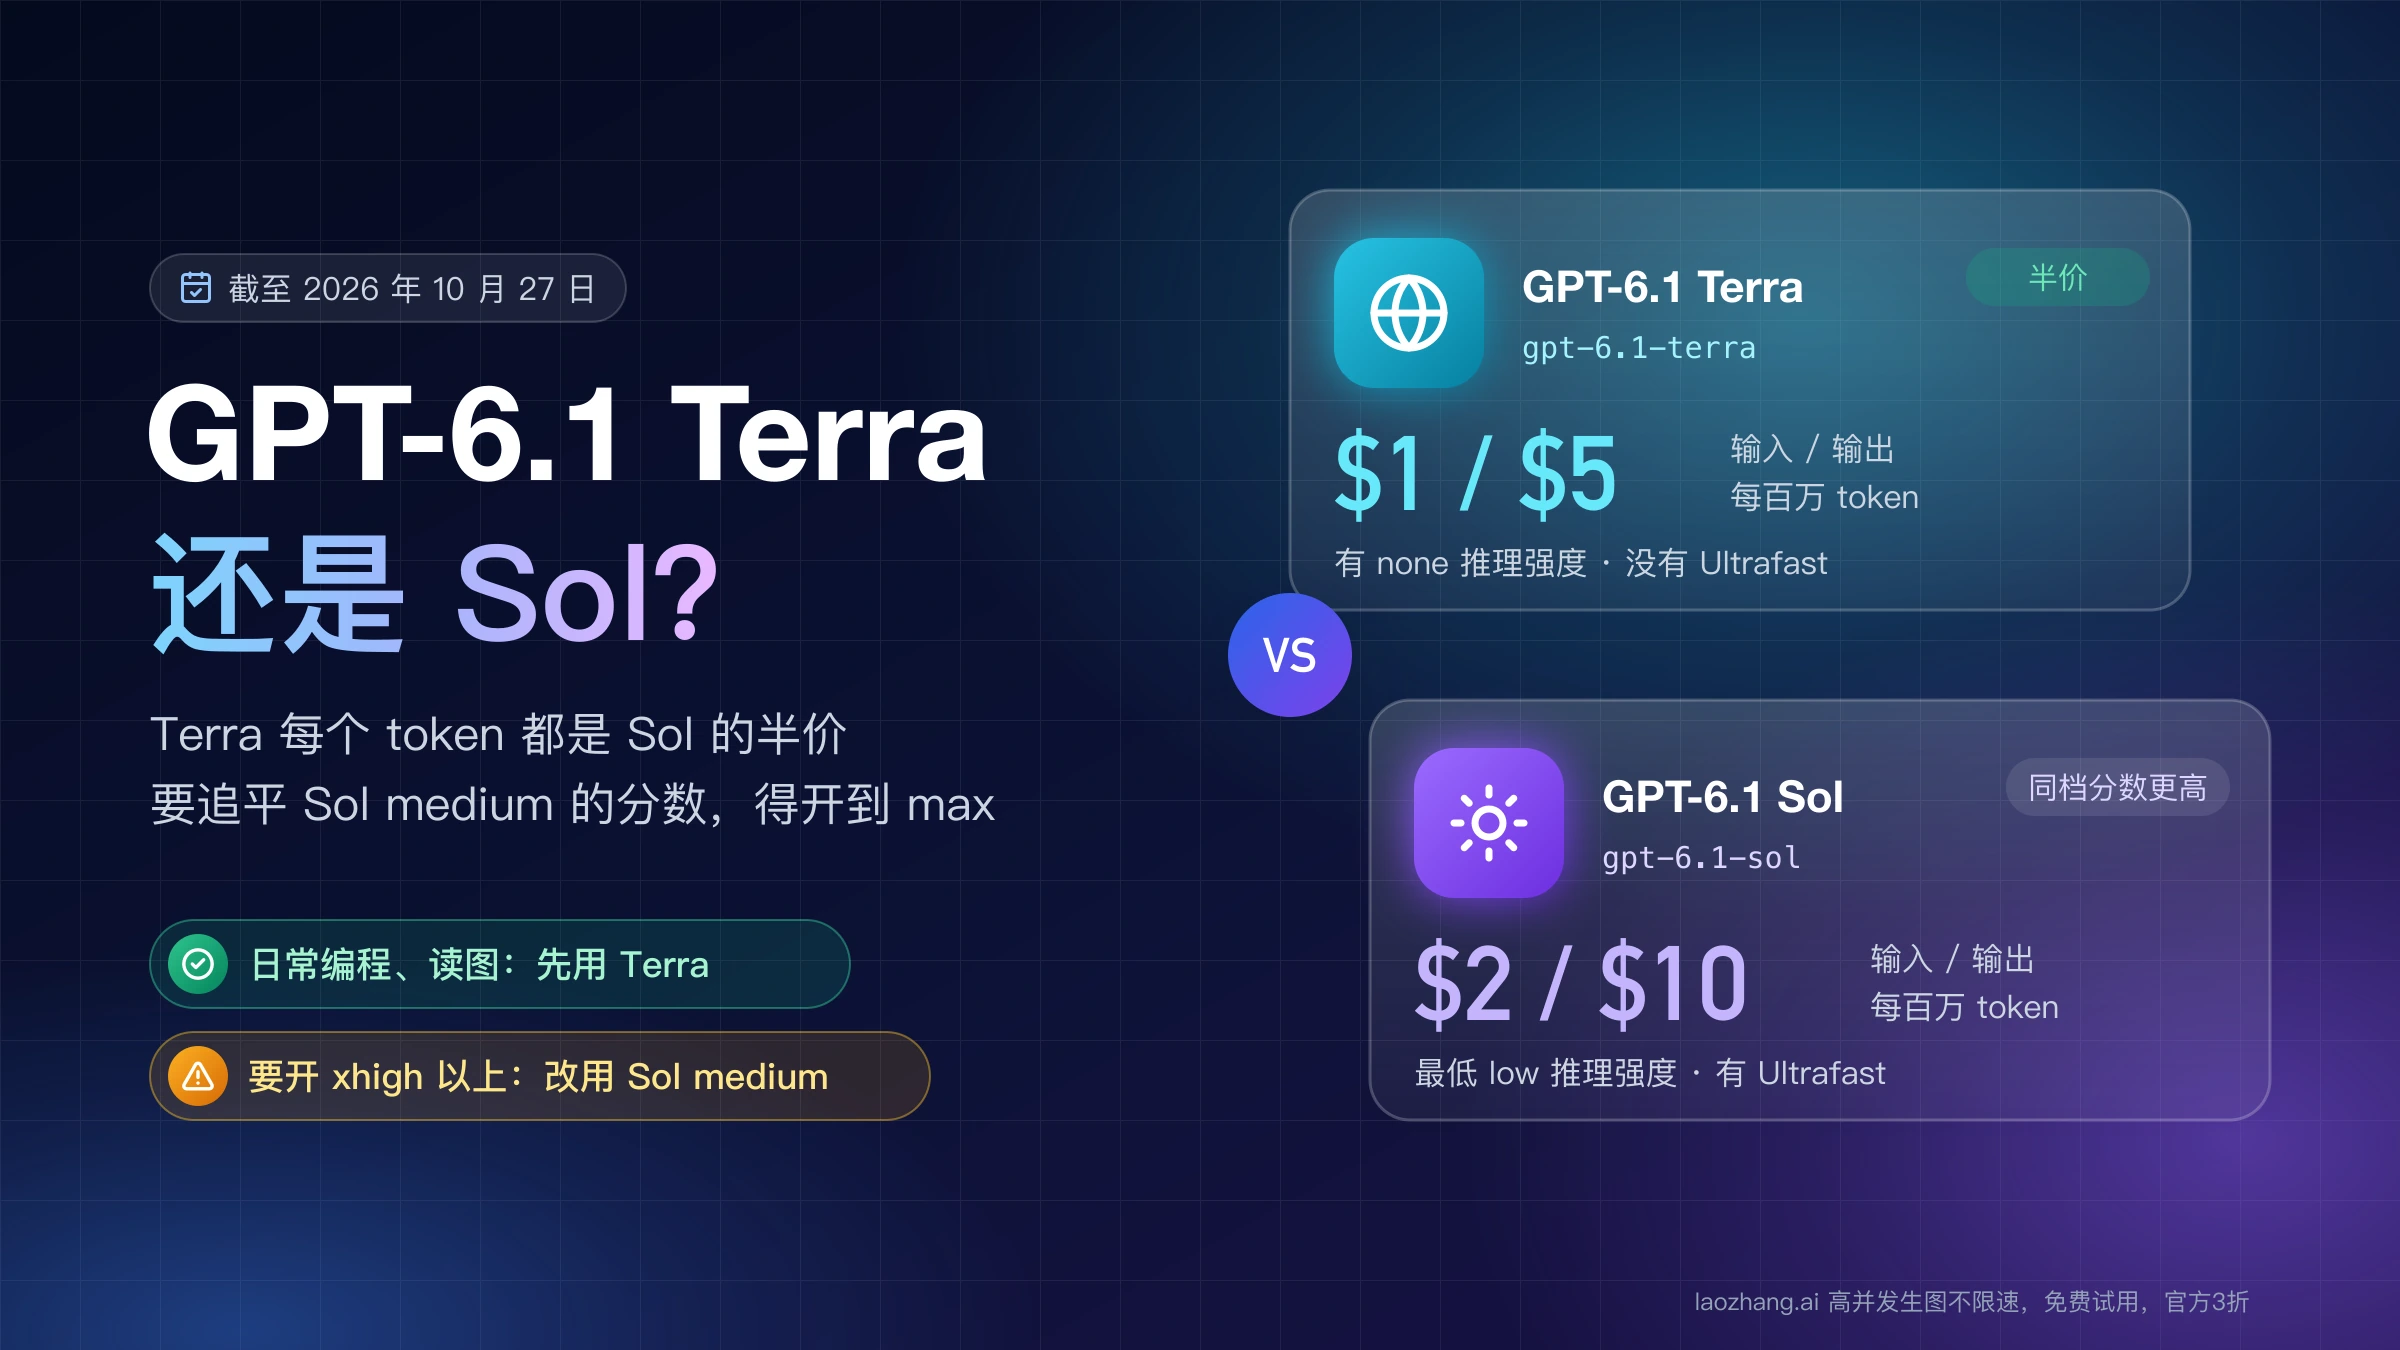
截至 2026 年 10 月 27 日,OpenAI 直连 API 的 Standard 短上下文报价中,两款 Sol 的普通输入和输出单价相同,6.1 Sol 的缓存读取从每百万 Token $0.20 降到 $0.10;Astra 的普通输入和输出单价是 6.1 Sol 的 5 倍,详见官方定价页。在 Codex 或 ChatGPT Work 中选模型,还要看套餐额度、客户端和工作区权限,不能用这组 API 美元单价代替订阅比较。
按你现在用的型号,结论分三种:
- 在用
gpt-6-sol:先做小范围迁移比较。 Artificial Analysis 智能指数(以下简称 AA)在 2026 年 10 月 27~28 日换成 v5.0(9 项评测),新版不再给 GPT-6 Sol 打分;按 9 月 30 日的旧版 v4.3.2 数据,同名推理强度下 6.1 Sol 高出 4~8 分,每道指数题成本持平或更低,OpenAI 自己的评测也指向同一方向。切换前要查none、遗留的minimal配置、Chat Completions 工具调用和采样参数;基准改善不保证原有工作流直接通过。 - 在用 Astra 的
low到xhigh:可拿同一批任务在 6.1 Sol 上高一到两档试跑。 截至 2026 年 10 月 28 日的 AA v5.0 中,同名档位 Astra 高 2~8 分;6.1 Solhigh的 50 分只比 Astramedium低 1 分,Astra 的每任务成本是它的 4.6 倍。要追平 Astrahigh和xhigh的 55 分,6.1 Sol 得开到max,Astra 的成本仍是它的 2.6~2.9 倍,但 6.1 Sol 每任务约 858 秒,Astra 只要 372~391 秒。分数接近也不代表每种任务等能力。 - 继续用 Astra: 你自己的对照任务里,它的通过率、端到端完成度或返工成本更好,或者任务属于官方建议优先使用 Astra 的高难度科研与长流程工作。
截至 2026 年 10 月 27 日,API 弃用页未列出 GPT-6 Sol 的停用公告,因此没有仅因新版发布就立即迁移的要求。这不保证未来可用性或请求永不失败;官方通知期也保留了安全与合规例外。
三个型号的关系和标价
下表价格于 2026 年 10 月 27 日核对,适用于 OpenAI 直连 API 的 Standard 档、单次输入不超过 272K Token,单位为美元 / 每百万 Token,依据官方定价页。规格依据 GPT-6.1 Sol、GPT-6 Sol 与 GPT-6 Astra 的模型页;API 推理参数不代表 Codex 界面的可选档位。
| 项目 | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra |
|---|---|---|---|
| 模型 ID | gpt-6.1-sol | gpt-6-sol | gpt-6-astra |
| 发布日期 | 2026 年 9 月 29 日 | 2026 年 9 月 22 日 | 2026 年 9 月 3 日 |
| OpenAI 的定位 | 接近 Astra 的表现,成本更低 | 模型页指向更新的 6.1 Sol | 能力最强,用于最难的推理、编码和专业工作 |
| 输入 | $2.00 | $2.00 | $10.00 |
| 缓存读取 | $0.10 | $0.20 | $1.00 |
| 缓存写入(30 分钟,默认) | $2.50 | $2.50 | $12.50 |
| 缓存写入(12 小时,仅 Responses API) | $5.00 | $5.00 | $25.00 |
| 输出 | $10.00 | $10.00 | $50.00 |
| API 推理强度 | low、medium、high、xhigh、max | none,以及左列五档 | low、medium、high、xhigh、max |
| 知识截止 | 2026 年 4 月 30 日 | 2026 年 4 月 20 日 | 2026 年 4 月 30 日 |
三款的上下文窗口都是 1,050,000 Token,单次最多输出 128,000 Token。计费规则也相同:单次输入超过 272K Token 时,整次请求的输入和缓存按 2 倍、输出按 1.5 倍计价。按“普通输入 / 缓存读取 / 30 分钟缓存写入 / 输出”的顺序,6.1 Sol 变成 $4 / $0.20 / $5 / $15,Astra 变成 $20 / $2 / $25 / $75。12 小时缓存写入是 OpenAI 在 2026 年 10 月 20 日加入的档位,单价是普通输入的 2.5 倍(30 分钟档是 1.25 倍),超过 272K 时两款 Sol 为 $10、Astra 为 $50。Batch 和 Flex 是 Standard 的一半,Fast 是 2 倍;适用的区域处理(数据驻留)另加 10%,见 OpenAI API 定价页。Astra 在长上下文、缓存写入和各服务档位下的完整算法,可以看 GPT-6 Astra API 定价与成本计算。
Ultrafast 现在两款都能用。2026 年 10 月 8 日,OpenAI API 更新日志为 gpt-6.1-sol 的 Responses API 加入了 Ultrafast。短上下文输入 / 输出单价分别为 $12 / $60;Astra 为 $60 / $300,两者都是 Standard 的 6 倍。按当前迁移指南,6.1 Sol 的 Fast 支持 EU 数据驻留,GPT-6 Sol 和 Astra 的 Fast 不支持;6.1 Sol Ultrafast 支持全球处理及 US、EU 数据驻留,Astra Ultrafast 支持全球处理及 US 数据驻留。需要 EU 与加速档同时成立时,这个差异会直接影响选择。
至于 GPT-6 Sol,当前 API 定价表仍列出它的费率,模型页也仍可查到规格,同时指向更新的 GPT-6.1 Sol。AA 发布文章标题中的“7 天就取代了 GPT-6 Sol”不能当作 API 下线公告;停用安排应以官方弃用页为准。
需要查看这三款之外的当前型号时,可从 OpenAI API 模型指南或 Codex 与 Work 模型说明继续选择。
“五分之一的价格”要放进你的请求里算
在相同服务档、上下文区间和地区条件下,6.1 Sol 的普通输入、同一时长的缓存写入和输出单价是 Astra 的五分之一,缓存读取是十分之一。只有各计费项的 Token 用量也相同,Astra 的 Token 费用才会落在 6.1 Sol 的 5 到 10 倍之间;缓存读取占比越高,越接近 10。实际任务的输出量、工具费和重试次数不同,账单就不必落在这个区间。
用一次假设的调用算一遍:输入 200,000 Token,其中 150,000 命中缓存、50,000 按普通输入计费,计费输出(含推理 Token)20,000,Standard 短上下文档。假设没有新增缓存写入,不计区域加价、工具费和重试;这不是实际账单。Token 数换算成百万为单位代入单价:
- GPT-6.1 Sol:0.05 × $2 + 0.15 × $0.10 + 0.02 × $10 = $0.100 + $0.015 + $0.200 = $0.315
- GPT-6 Sol:0.05 × $2 + 0.15 × $0.20 + 0.02 × $10 = $0.100 + $0.030 + $0.200 = $0.330
- GPT-6 Astra:0.05 × $10 + 0.15 × $1 + 0.02 × $50 = $0.50 + $0.15 + $1.00 = $1.65
这一笔 Astra 是 6.1 Sol 的约 5.2 倍。
6.1 Sol 对 GPT-6 Sol 的差距就小得多,这里只省 $0.015,全部来自缓存读取。AA 在 2026 年 9 月 29 日的报告中测到,同名推理强度下 6.1 Sol 在当时的 v4.3.2 智能指数测试中,输出 Token 比 GPT-6 Sol 多约 10%~30%。在上面这笔调用里,固定输入量不变,输出多 7.5%(1,500 Token,$0.015)就抵消了缓存节省;少于这个增幅仍更便宜,多于它则更贵。多 20% 时 6.1 Sol 要 $0.355,比 GPT-6 Sol 贵 $0.025。因此迁移的收益应看能否在相同验收标准下降低成本,可以试低一档,但不能由指数分数保证降档后质量不变。
这笔账还假设三个模型用的 Token 一样多,实际通常不一样。OpenAI 说 Astra 在多项评测里比前代模型用更少的输出 Token 拿到更好的结果,AA 则测得 6.1 Sol 比 GPT-6 Sol 输出更多。所以比较三者,最终要看完成一个任务花多少钱,而不是每个 Token 多少钱。
差距有多大:先分清是谁测的
下面的数字分三类:OpenAI 自己公布的、AA 独立测的,以及用 AA 数据算出来的对照。它们都不是在你的任务上跑出来的,条件随每组数字给出。
AA 智能指数:按推理强度逐档对照
AA 智能指数 v5.0 由 9 项评测组成,在 2026 年 10 月 27~28 日取代了 10 项评测的 v4.3.2:GDPval-AA、SciCode、Humanity's Last Exam 和长上下文 AA-LCR 被移出,FrontierCode 2.0、HLE-Diamond、CritPt v2 和 Terminal-Bench-Science 加入。所有分数和每任务成本都随之改变,两版不能逐分对比。下表每格是“指数得分 / 每任务成本 / 每任务耗时”;每任务成本是 AA 按标价跑一道指数题的平均花费,反映的是这套测试的工作量,不是你的账单。
| 推理强度 | GPT-6.1 Sol | GPT-6 Astra |
|---|---|---|
low | 35 / $0.16 / 104 秒 | 43 / $1.42 / 189 秒 |
medium | 46 / $0.36 / 231 秒 | 51 / $2.73 / 304 秒 |
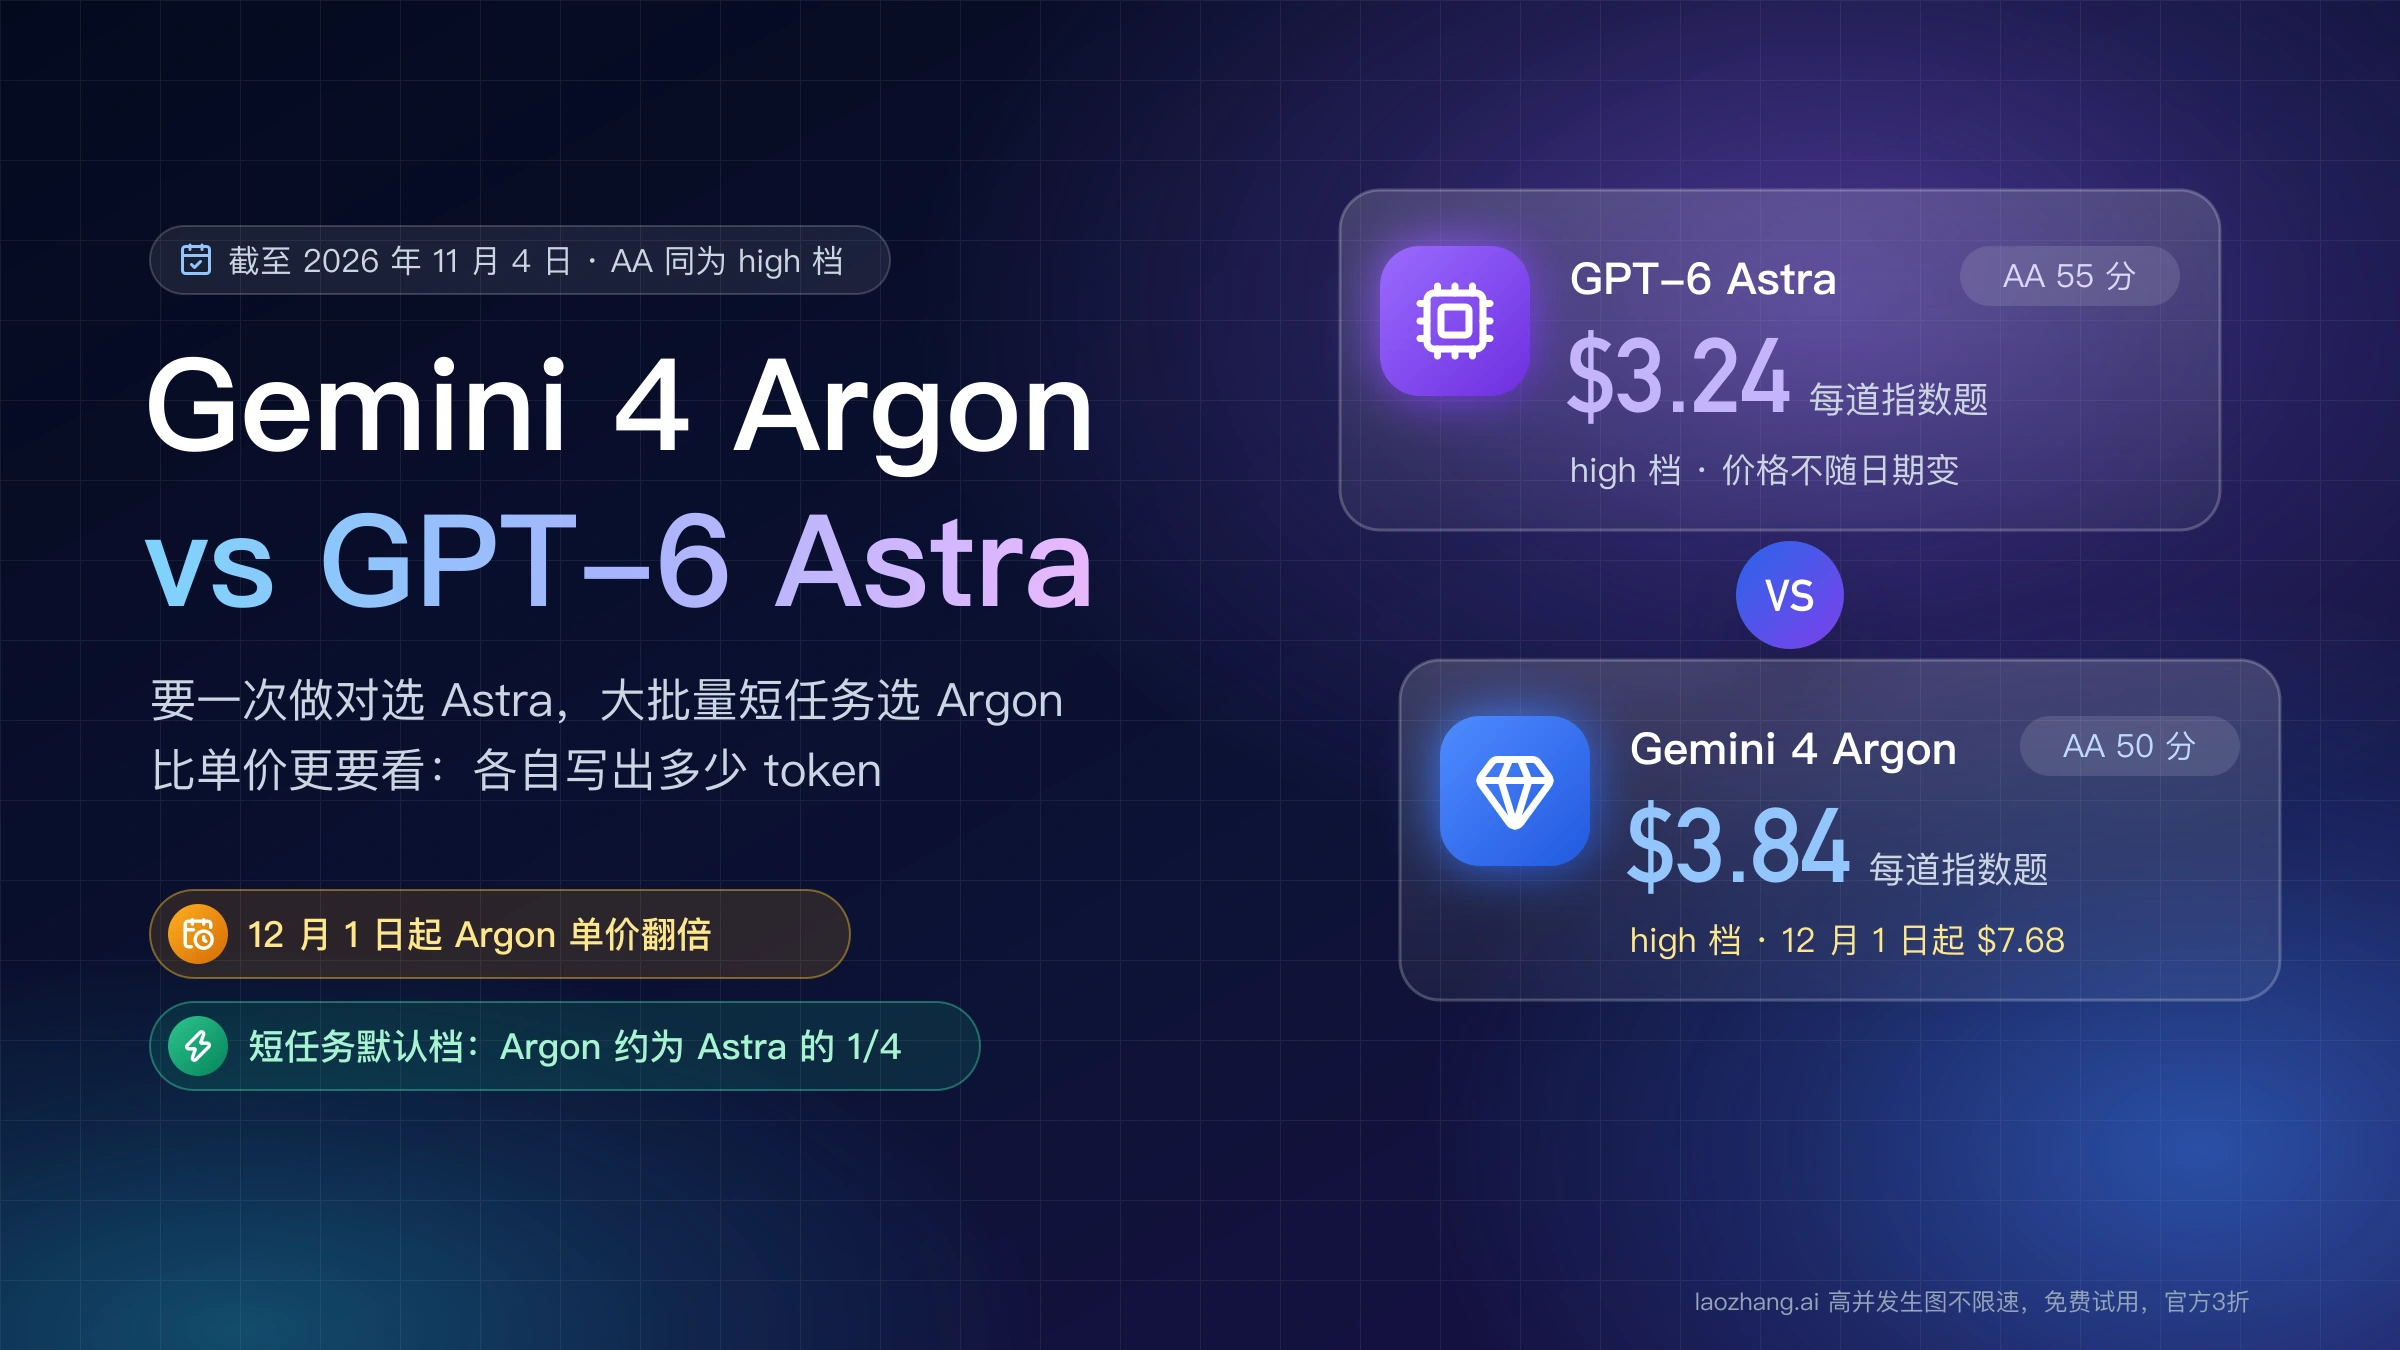
high | 50 / $0.59 / 322 秒 | 55 / $3.24 / 372 秒 |
xhigh | 52 / $0.76 / 436 秒 | 55 / $3.66 / 391 秒 |
max | 55 / $1.27 / 858 秒 | 57 / $6.24 / 711 秒 |
数据来自 AA 的 GPT-6.1 Sol 与 GPT-6 Astra 逐档比较页,截至 2026 年 10 月 28 日,之后可能更新。
v5.0 没有给 GPT-6 Sol 打分。它和 6.1 Sol 的对照只剩旧版 v4.3.2 的数字(截至 2026 年 9 月 30 日,来自 AA 的 GPT-6.1 Sol 与 GPT-6 Sol 发布页),两列同属旧版、可以互比,但不能和上表的 v5.0 分数放在一起排名:
| 推理强度(v4.3.2) | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
low | 42 / $0.13 | 34 / $0.13 |
medium | 48 / $0.21 | 40 / $0.25 |
high | 50 / $0.32 | 43 / $0.38 |
xhigh | 51 / $0.39 | 44 / $0.52 |
max | 52 / $0.72 | 48 / $1.05 |
从这两张表能读出三件事:
- 对 GPT-6 Sol,旧版指数的五档得分都更高。 在 v4.3.2 里,同一档位 6.1 Sol 分别高 8、8、7、7、4 分,每任务成本持平或更低。6.1 Sol
medium得 48 分、花 $0.21,与 GPT-6 Solmax的指数总分持平,成本是后者的 1/5。AA 不再给 GPT-6 Sol 打分,迁移的理由就落在这组旧数据和下文 OpenAI 自己的评测上。原来把 GPT-6 Sol 开到max的,可以从 6.1 Solmedium或high试起,再检查具体任务是否仍通过。 - 对 Astra,同名档位差 2~8 分。 v5.0 中 Astra 在
low领先 8 分,medium和high各领先 5 分,xhigh领先 3 分,max领先 2 分。 - 按 v5.0 总分对齐,6.1 Sol 往往要高一到两档,省下的钱也变少了。 6.1 Sol
high(50 分,$0.59)比 Astramedium(51 分,$2.73)低 1 分,Astra 的成本约是它的 4.6 倍;xhigh(52 分,$0.76)比 Astrahigh低 3 分。Astrahigh和xhigh的 55 分只有 6.1 Solmax(55 分,$1.27)追得上,Astra 的成本分别约是它的 2.6 倍和 2.9 倍,但 6.1 Solmax每任务约 858 秒,是 Astrahigh(372 秒)的 2.3 倍。Astramax的 57 分在 6.1 Sol 里没有同分档。同分或相差 1 分都不能推出任意任务的通过率。
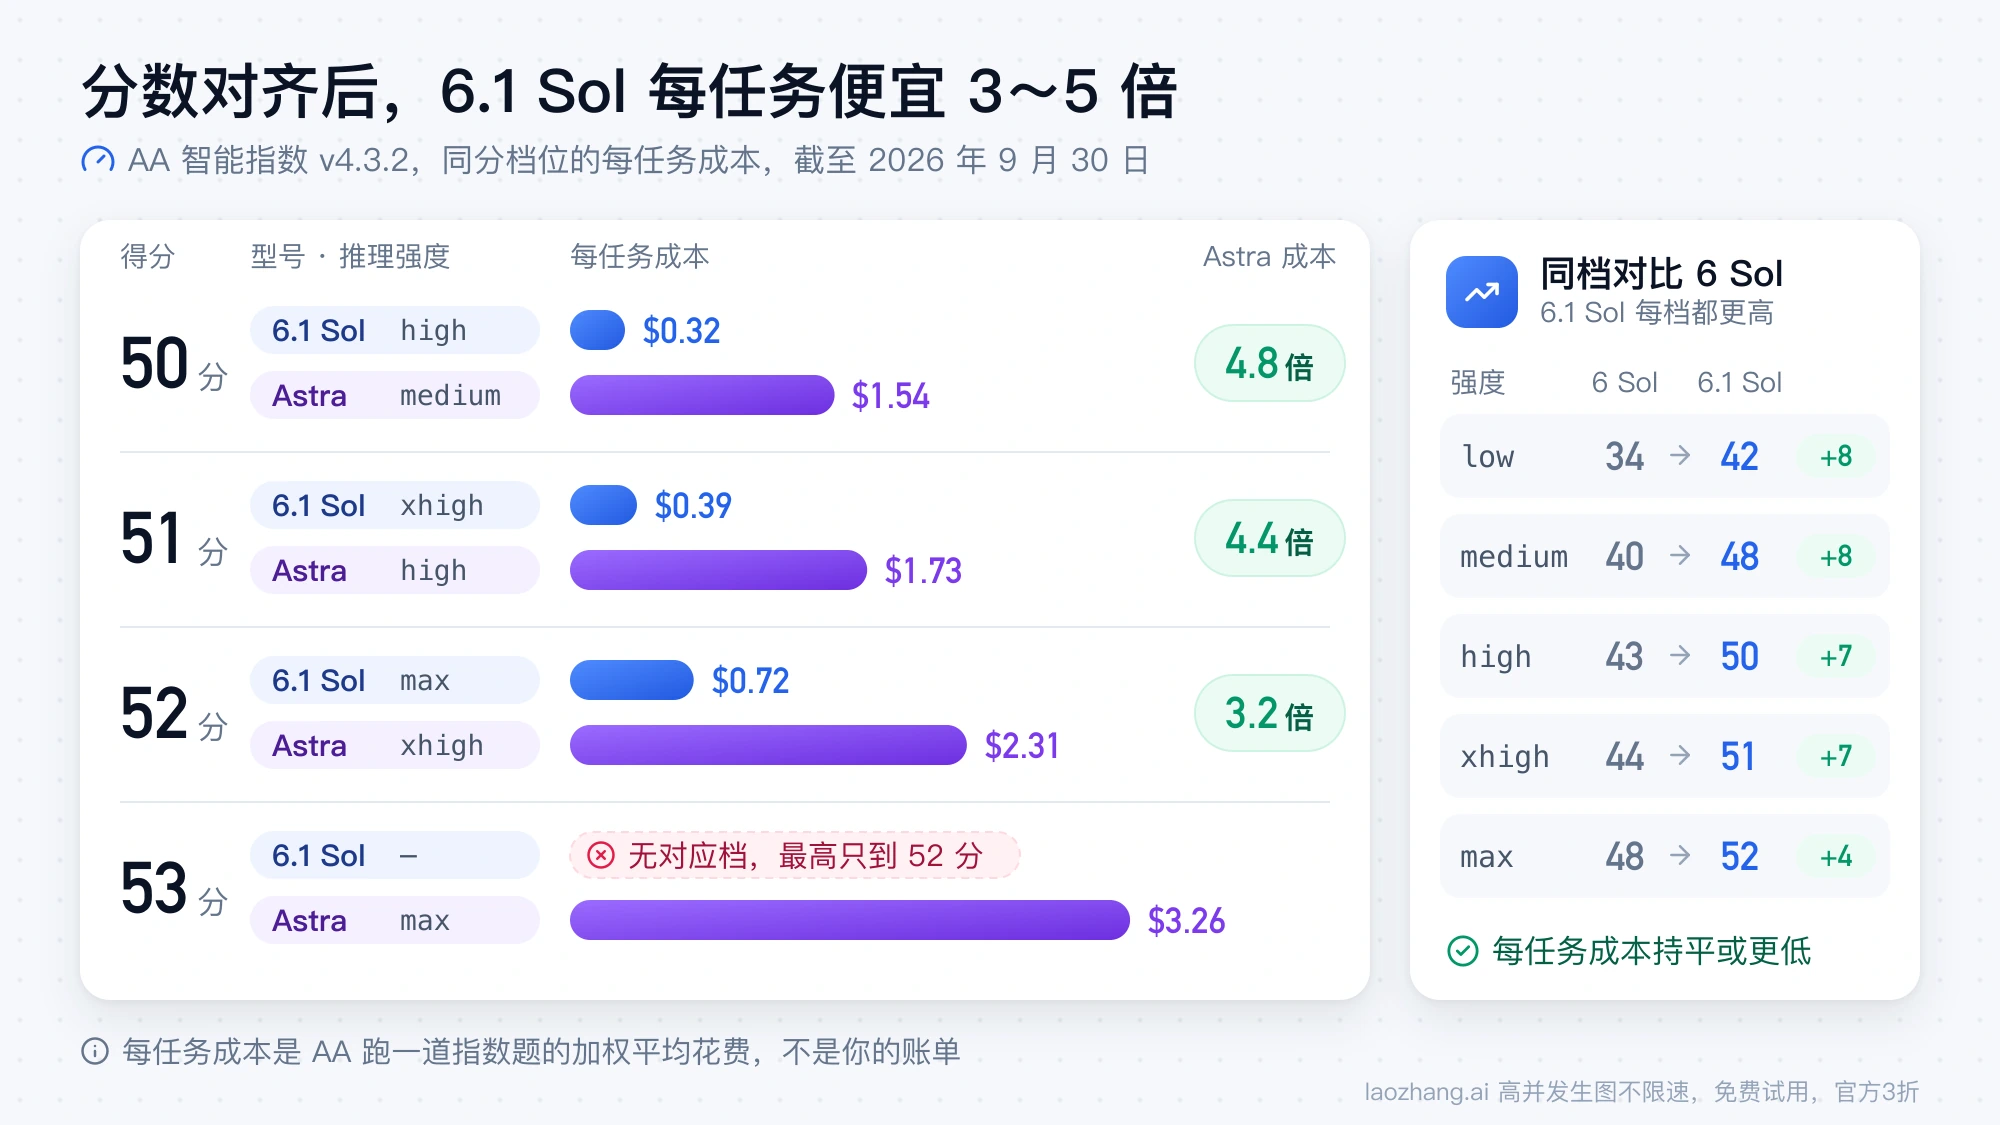
图中是 Artificial Analysis v4.3.2 的数字和同分配对;截至 2026 年 10 月 28 日的 v5.0 数字以上面的表格为准。
输出速度会随测量时间改变。AA 在上线首周测得 6.1 Sol 各档每秒约 59~66 个 Token,Astra 约 44~51 个;2026 年 10 月 26 日的历史快照里,同档 Astra 都不更慢。到 2026 年 10 月 28 日的 AA 比较页,6.1 Sol 从 low 到 max 每秒约 61、59、70、70、81 个 Token,Astra 约 48、59、63、68、71 个,每一档 6.1 Sol 都不慢于 Astra。快慢关系几天内就翻过一次,不能写成固定结论;每秒输出更快也不等于每道题更快,max 档 6.1 Sol 每任务仍比 Astra 多用约 147 秒。整项任务耗时还包括首个答案 Token 前的等待、输出总量、工具执行与重试。如何分别计时,见GPT-6.1 Sol 慢请求的原因区分与降档测试;其中测试保留原日期和调用路线,不能当作所有 Codex 任务的提速保证。
指数差几分,是 9 项评测汇总后的结果,单项差距可能大得多,下面 OpenAI 公布的 Terminal-Bench Science 就是一例。
AA 编码智能体指数:xhigh 比 max 更好
在 AA 2026 年 9 月 29 日公布的编码智能体指数(Coding Agent Index)里,6.1 Sol xhigh 比 Astra 高 1 分,每任务成本不到 Astra 的 15%;比 GPT-6 Sol max 高 6 分。6.1 Sol xhigh 还比它自己的 max 高 3 分,max 则比 Astra 低 2 分。这说明更高档不保证这项指数更高;编码任务可以试 xhigh,但仍要按自己的测试和验收决定。
同一篇 AA 文章还提到,6.1 Sol 在 Terminal-Bench 4.0 上比 GPT-6 Sol 高 12 分,AA-Omniscience 幻觉率从 60% 降到 54%。
OpenAI 公布的对比
以下保留 2026 年 9 月发布期 OpenAI 的 GPT-6.1 Sol 发布文章结果,属于厂商自报测试,在研究环境或 API 中进行,可能与正式版 ChatGPT 有差异;不是 10 月 27 日新做的独立测评:
- 编程(DeepSWE v1.1):6.1 Sol 以约五分之一的成本达到与 Astra 相当的水平;用更低的推理强度和成本,比 GPT-6 Sol 的最高分高 6.4 个百分点。
- 计算机使用(OSWorld 2.0,部分奖励得分):最高推理强度下比 GPT-6 Sol 高 7 个百分点、成本不到一半;与 Astra 相差 2.1 个百分点以内,单任务成本约为 Astra 的七分之一。
- 科学研究(Terminal-Bench Science 0.1):平均单任务成本 6.1 Sol $5.47、Astra $23.80,但 Astra 以 68.1% 排第一,OpenAI 明确说最具挑战性的科学研究任务应使用 Astra。
- 事实错误率(刻意挑选的高难度提示):发布文章报告,
low档含事实错误的回答比例从 GPT-6 Sol 的 11.4% 降至 6.1 Sol 的 7.7%。这些提示来自用户曾指出旧模型错误的对话,不代表日常使用的错误率。 - 搜索工具出错却未告知用户的比例(
max,对抗性测试):6.1 Sol 2.1%、GPT-6 Sol 4.9%、Astra 1.5%。
这些结果支持把 6.1 Sol 纳入成本与质量比较,也解释了官方为什么仍把最难科研任务推荐给 Astra;它们没有证明 Astra 对每个用户任务都更强,也没有证明 6.1 Sol 可以无条件替换 GPT-6 Sol。
推理强度怎么对档
把上面的历史基准落到具体配置上,可以从下表开始试。OpenAI 的模型说明明确说不同代模型的推理强度并不一一对应,所以这只是试跑起点,每一行都要用相同任务与验收标准确认。
| 你现在用 | 先试 GPT-6.1 Sol 的 | 依据 |
|---|---|---|
GPT-6 Sol none,或遗留配置里的 minimal | low | 6.1 Sol 不支持这两档,OpenAI 迁移指南建议从 low 开始;GPT-6 Sol 本身也未列出 minimal |
GPT-6 Sol low 到 xhigh | 同档;高于 low 时可再试低一档 | AA 旧版 v4.3.2 中同档高 7~8 分,每道指数题成本不高于 GPT-6 Sol |
GPT-6 Sol max | medium 或 high | AA 旧版 v4.3.2 中 6.1 Sol medium 与 GPT-6 Sol max 同为 48 分 |
Astra low | medium | AA v5.0 中 6.1 Sol medium 46 分、$0.36,高于 Astra low 的 43 分、$1.42,成本约为其四分之一 |
Astra medium | high | v5.0 中 50 对 51 分,低 1 分,Astra 成本约 4.6 倍 |
Astra high | xhigh,不达标再试 max | v5.0 中 xhigh 52 对 55 分,低 3 分;max 才到 55 分,成本约为 Astra 的五分之二,但每任务约 858 秒对 372 秒 |
Astra xhigh | max;编码智能体先试 xhigh | v5.0 中同为 55 分,Astra 成本约 2.9 倍,6.1 Sol 每任务多用约 467 秒;编码智能体指数(9 月 29 日)里 xhigh 高于 max |
Astra max | 保留基线,有成本压力再试 max 或 xhigh | v5.0 中 6.1 Sol 最高 55 分,没有与 Astra max 的 57 分同分的档位,能否替换仍看具体任务,不由 2 分差距决定 |
6.1 Sol 的 API 档位写在 reasoning.effort(Responses)或 reasoning_effort(Chat Completions)里,支持 low、medium、high、xhigh、max,默认 medium。Codex 和 ChatGPT Work 的 Light 在 CLI 里显示为 Low;Max 为单个任务增加推理时间,Ultra 使用子代理并行处理可拆分的任务。可选项以所用模型、客户端和工作区实际显示为准,不能因 API 没有 ultra 参数,就断言 Codex 不支持 Ultra。OpenAI 建议大多数任务不必开 Max 或 Ultra,详见模型说明。
把 gpt-6-sol 换成 gpt-6.1-sol 前要检查的地方
只用 Responses API、推理强度为 low 及以上且参数兼容的请求,可以先以改模型名为起点验证;能返回结果还不等于质量、预算和工具流程都通过。下面这些情况要单独检查,兼容规则依据 OpenAI 的 GPT-6 使用与迁移指南:
- 推理强度
none或minimal。 6.1 Sol 和 Astra 都不支持,请求会失败。改成low;如果原来用none是为了压延迟,要重新测响应时间。 - Chat Completions 里的工具调用。 GPT-6 Sol 在 Chat Completions 里只有
reasoning_effort为none时才能调函数;6.1 Sol 的 Chat Completions 完全不支持工具调用。带工具的请求要先迁到 Responses API,不带工具的 Chat Completions 请求可以照常用。 - 采样参数。 推理强度不是
none时,要删掉temperature、top_p、top_logprobs;Chat Completions 还要删logprobs,Responses 要从include里去掉message.output_text.logprobs。原来在 GPT-6 Sol 上用none配这些参数的,改成low后必须一起删。 - 输出量和预算。 AA 发布期的 v4.3.2 智能指数测试中,6.1 Sol 的输出 Token 比 GPT-6 Sol 多约 10%~30%,这不是每个请求的固定增幅。保留现有预算控制,检查是否触及输出上限、是否出现截断,以及完成任务的总费用,再决定是否提高上限。
- 图片输入的旧评测。 OpenAI 在 9 月 25 日修复了一个图像编码问题,它曾拉低 GPT-6 Sol 和 Luna 在 API 与 Codex(包括计算机使用)中的看图能力。9 月 25 日之前用 GPT-6 Sol 做的看图对比低估了它,拿来和 6.1 Sol 比之前要重跑。
- 速度档与数据驻留。 6.1 Sol 的 Fast 支持 EU 数据驻留,GPT-6 Sol 和 Astra 的 Fast 不支持。6.1 Sol Ultrafast 也支持全球处理与 US、EU 数据驻留,Astra Ultrafast 仅支持全球处理与 US 数据驻留。按迁移指南的区域说明核对具体模型与服务档,再核对项目的区域资格和设置,不能只看模型名。
- 安全研究类任务。 OpenAI 把 6.1 Sol 的网络安全能力评为 Critical、生物与化学评为 High,套用和 Astra 相同的一整套安全防护,见 GPT-6.1 Sol 系统卡补充。做漏洞研究、渗透测试一类工作,从 GPT-6 Sol 迁过来前先用真实任务跑一遍。
检查完之后,先用一小批代表任务比较通过率、输出 Token 和耗时,再决定是否切换生产流量。参数兼容的具体规则可直接对照 OpenAI 迁移清单。
什么时候仍该用 Astra
下面几种情况值得优先保留 Astra,再比较多付的费用是否换来更好的交付:
- 你的对照任务中 Astra
max才能稳定通过。 这时先保留已经验证的配置。AA v5.0 中 57 对 55 分的差距不能证明 6.1 Sol 一定失败,也不足以支持未经验证就替换现有流程。 - 最难的科学研究任务。 Terminal-Bench Science 上 Astra 排第一,OpenAI 自己也说这类任务应该用 Astra。
- 完整的端到端长流程。 OpenAI 的 Codex 文档把 Astra 推荐给需要跨代码、应用和资料持续推理与判断的完整工作流,并说它更会在关键处提问、在接受新要求的同时守住原始目标;6.1 Sol 则推荐给注重成本、重复执行的长时间任务。
- 需要 API 的 Ultrafast,而且 6.1 Sol 未达到验收标准。 两款都提供 Ultrafast,6.1 Sol 短上下文输入 / 输出为每百万 Token $12 / $60;先比较质量和完整耗时,不能由同名速度档保证同样快。费率与区域范围见上文的官方来源。
- 失败很贵。 一次失败的人工检查、返工或线上事故成本远高于 API 费用时,Astra 的通过率哪怕只高一点,也可能更划算,下一节给出算法。
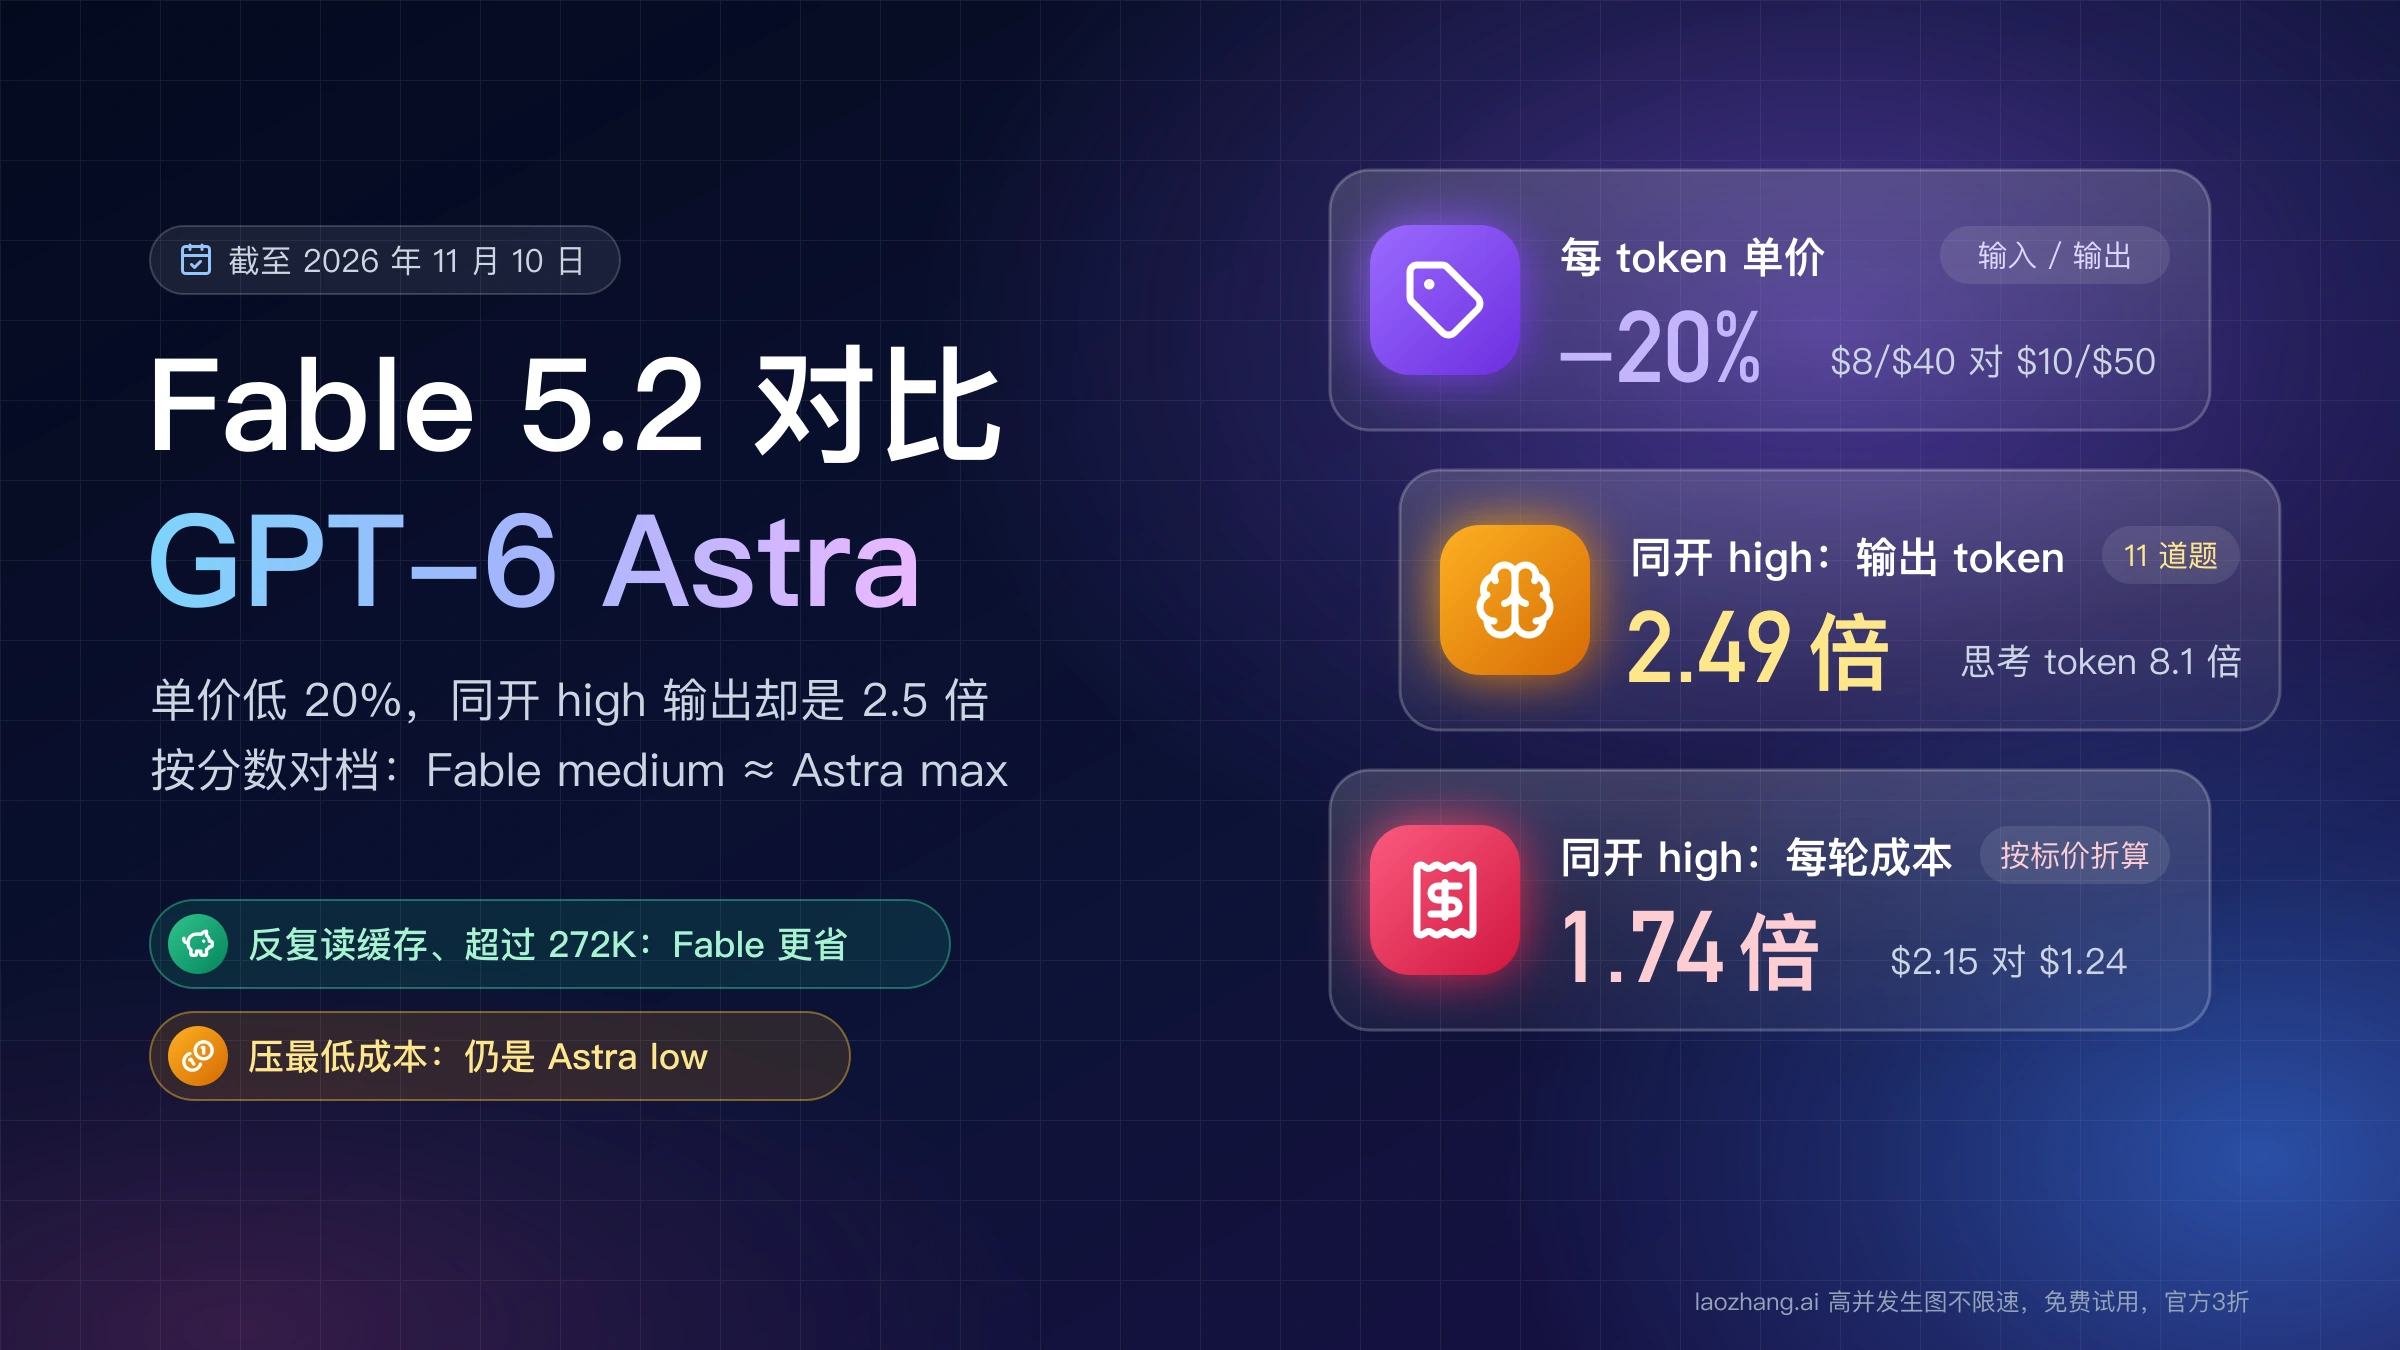
跨厂商的编码与 API 比较,可继续看 GPT-6 Astra 与 Claude Fable 5.1 怎么选:实测 token 与 API 成本。该文保留了 2026 年 10 月 26 日经 laozhang.ai 网关的测试:在所测英文短文与长文中,Fable 5.1 的输入 Token 分别约为 Astra 的 1.45、1.52 倍。这些样本说明相同标价不一定产生相同账单,不能推成所有英文请求的固定比例。2026 年 11 月 9 日起,Anthropic 的顶级模型换成了 Fable 5.2,它和 Astra 的对比见 Fable 5.2 和 GPT-6 Astra 对比:单价低 20%,同题输出却是 2.5 倍。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
在自己的任务上确认:算每个合格结果的成本
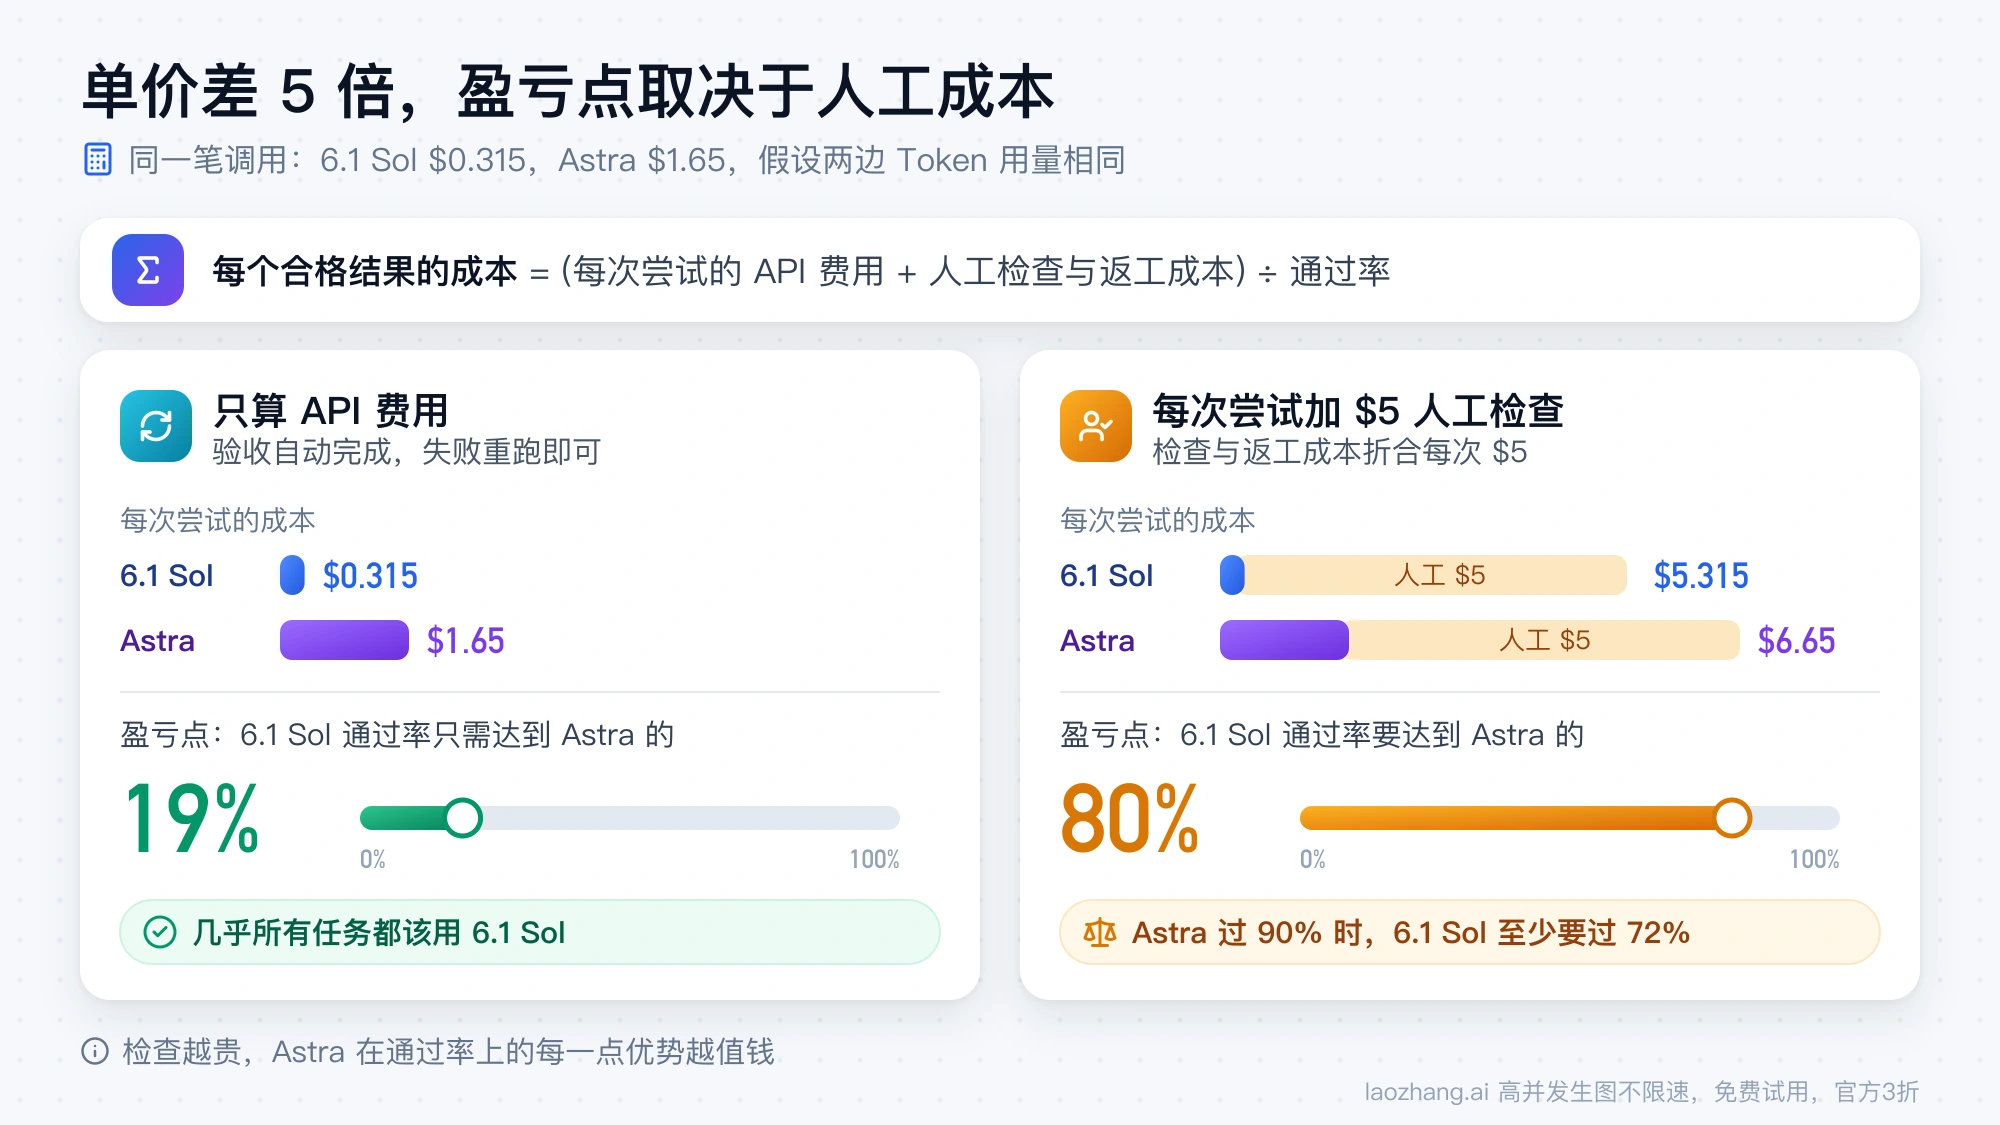
普通输入和输出单价差 5 倍,但决定选谁的往往还有失败的代价。用这个式子比较:
每个合格结果的成本 = 全部尝试的 API、人工检查与返工费用 ÷ 合格结果数
若把每次尝试的平均费用记为分子,也可写成“平均 API 与人工费用 ÷ 通过率”。失败尝试的费用要纳入;同一个任务反复重试时,最终交付只算一个合格结果。下面把每次尝试的费用与通过率视为固定估计,忽略额外重试协调和事故损失,只用于说明阈值。
继续用前面那笔调用(6.1 Sol $0.315,Astra $1.65,假设两边 Token 用量相同):
- 只看 API 费用: 两边通过率之比的盈亏点为
0.315 ÷ 1.65 ≈ 19.09%。若 Astra 通过率为 90%,6.1 Sol 高于约 17.18% 时,按这个简化公式计算的每个合格结果才更便宜。这不说明低通过率足以满足业务要求。 - 加上人工成本: 假设每次尝试都要人工检查,平均折合 $5。Astra 每次共 $6.65,6.1 Sol 共 $5.315,通过率之比的盈亏点变成
5.315 ÷ 6.65 ≈ 79.92%。Astra 通过率为 90% 时,6.1 Sol 要高于约 71.93% 才更便宜;等于阈值时两者打平。
这些假设下,人工检查越贵,通过率差距越容易抵消 API 费率优势。验收能自动完成且失败代价低时,6.1 Sol 更值得优先测试;是否迁移仍要同时满足最低通过率和时延要求,不能只追求公式里的低成本。
具体做法:
- 挑一批有代表性的真实任务,包括你最难的那类,先写好通过标准,能自动判定的尽量自动判定。
- Astra 用现在的档位跑一遍作为基线;6.1 Sol 按前面的对档表试跑,未达标且未到
max时再加高一档。 - 每次记录 API 返回的 usage(普通输入、缓存读取、缓存写入、含推理的输出 Token)、实际费用、是否通过、完整耗时与人工修正时间。
- 按任务类型分别汇总,所有尝试的费用除以最终合格结果数。达到质量与时延要求、合格交付成本更低的类型再切过去,其余保留基线,两者可以分流并用。
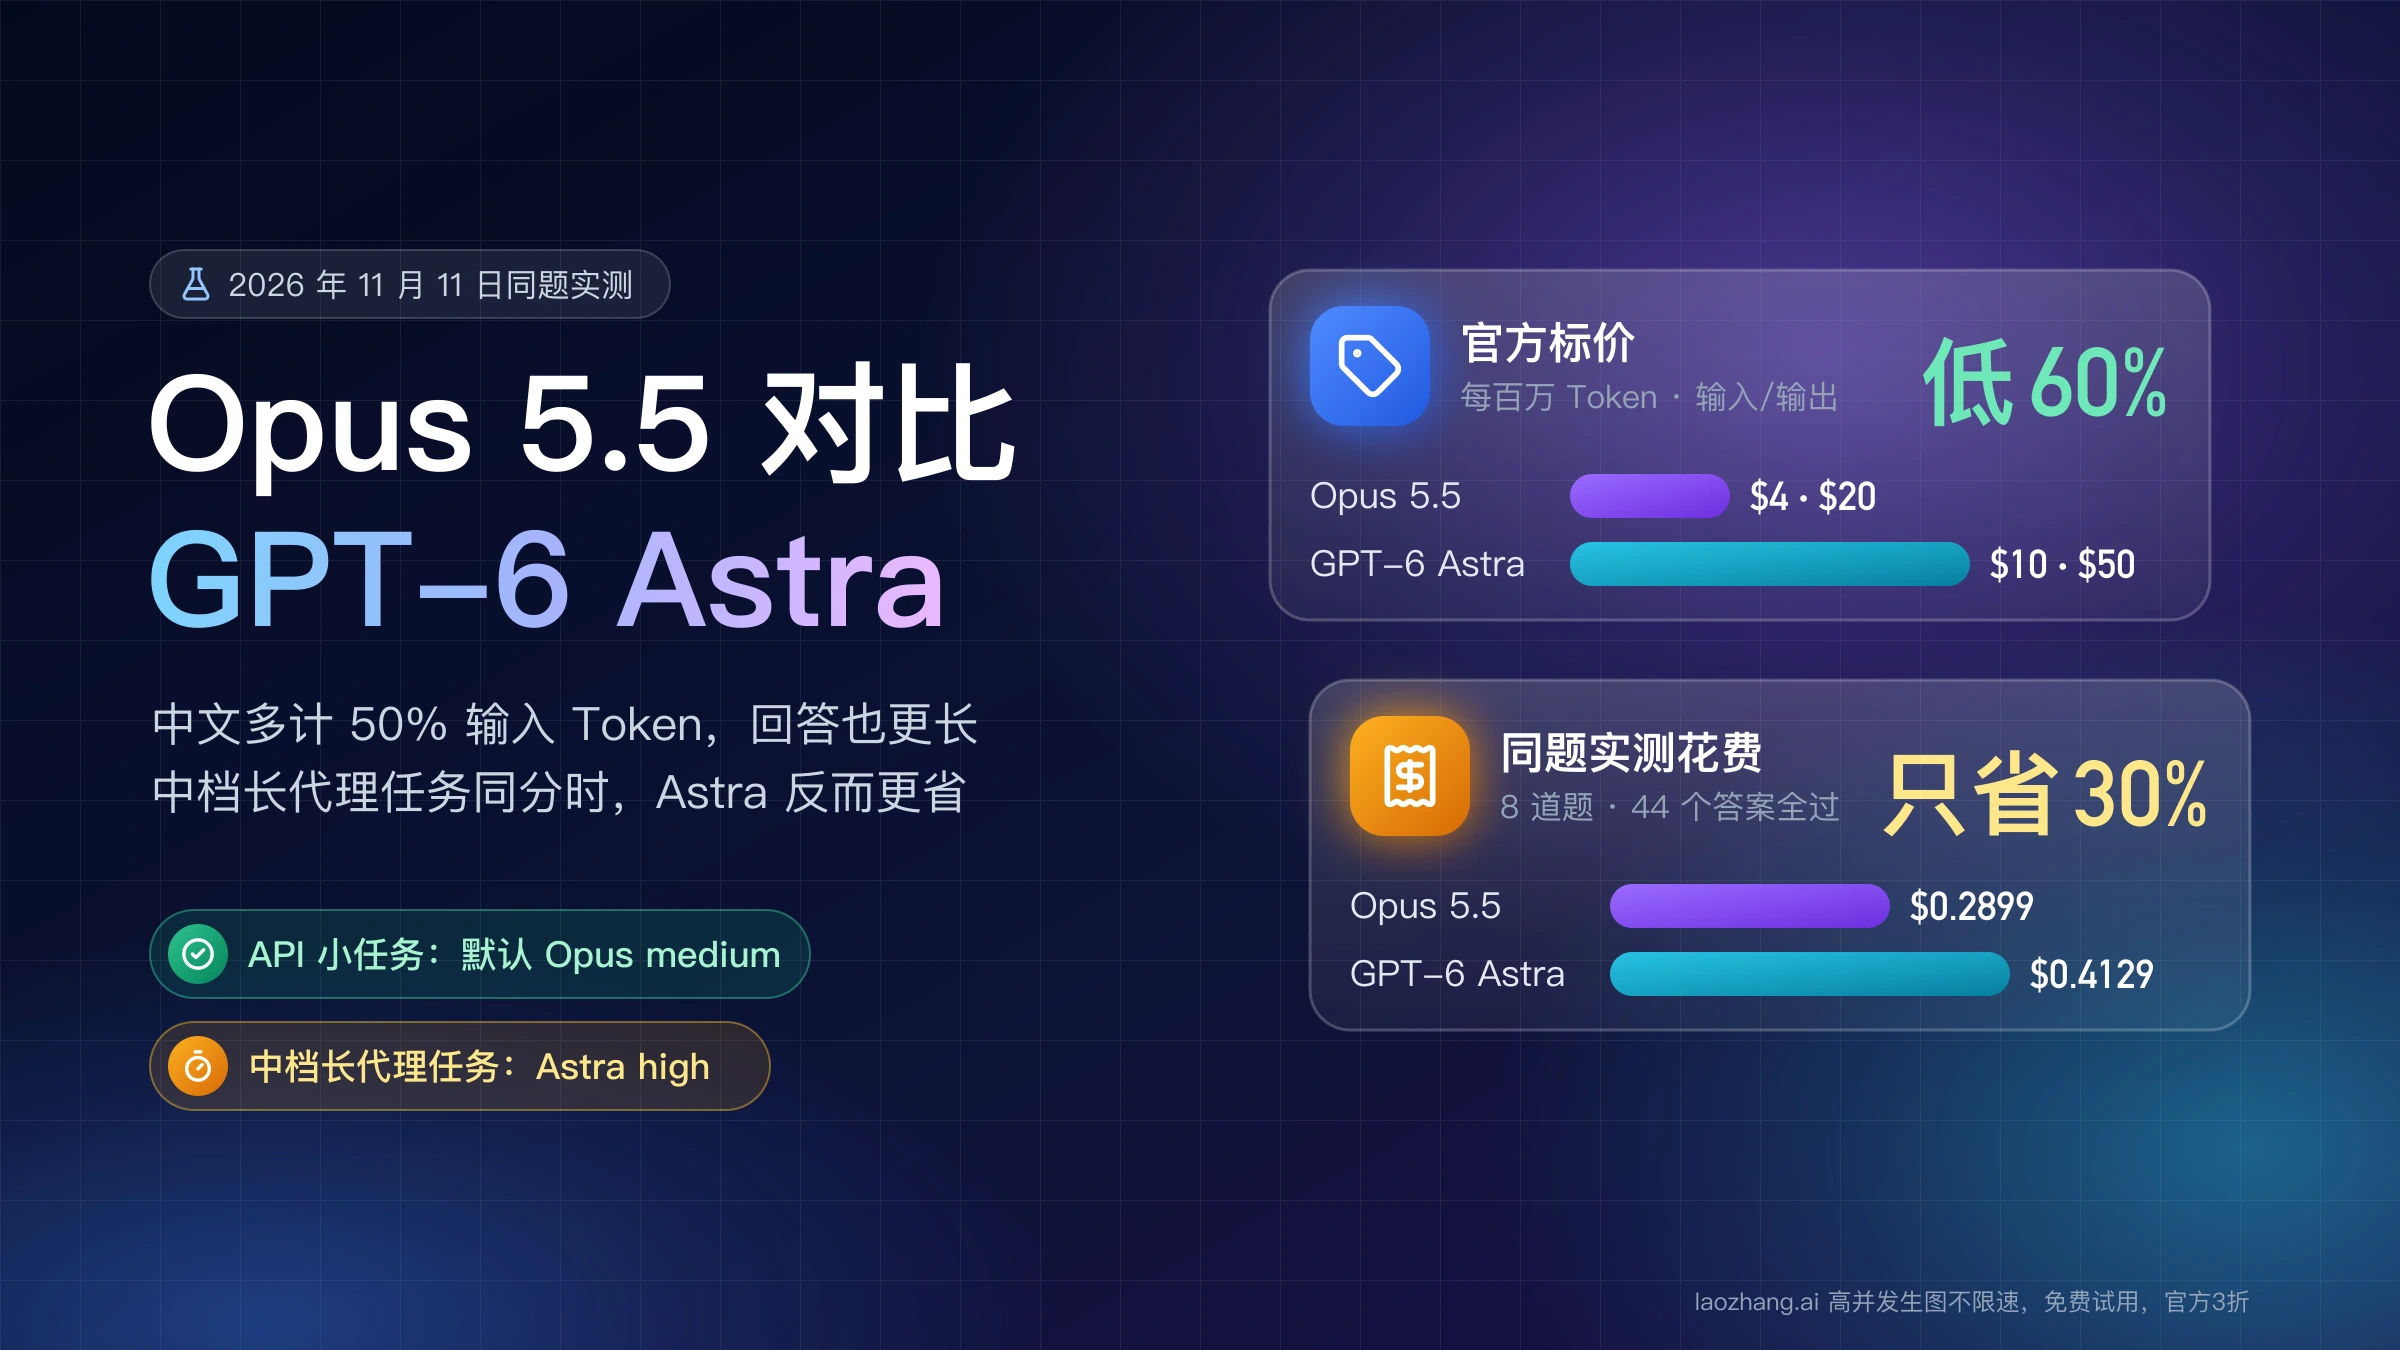
从 GPT-6 Sol 迁到 6.1 Sol 也可以用同一套流程,重点是确认请求没有报错、输出量增加后账单仍可接受,并试试低一档能不能守住原来的通过率。同一思路在跨厂商比较中的用法,见 Claude Opus 5.5 对比 GPT-6 Sol:先看任务,再算每次合格交付的成本。
Codex 和 ChatGPT 工作模式里怎么选
在 Codex 和 ChatGPT Work 中,反复执行且对成本敏感的长任务可以先试 6.1 Sol,需要持续判断的困难端到端工作优先保留 Astra;这是 OpenAI 的官方选择建议,仍应以同一任务的完成质量和用量验证。已有 GPT-6 Sol 工作流则保留作对照,不能把 API 参数兼容等同于桌面任务行为一致。
上面的 API 单价不能换算成套餐额度。以 ChatGPT 登录时,要分清套餐内额度和额外积分;用 API Key 的 Codex 会话则按 API 价格计费。按 2026 年 10 月 27 日的官方积分费率,Standard 每百万普通输入 / 缓存读取 / 输出 Token,6.1 Sol 为 50 / 2.5 / 250 credits,GPT-6 Sol 为 50 / 5 / 250,Astra 为 250 / 25 / 1,250。积分计费没有单列缓存写入费;部分 Enterprise 合同仍采用其他费率,需按自己的合同核对。
因此,同样的计费 Token 用量下,6.1 Sol 的积分成本低于 Astra,两款 Sol 的差异主要在缓存读取。但这些积分单价本身不能决定套餐内能发多少条消息。官方给 Plus 与 Standard Business 的估计是每 5 小时本地消息:6.1 Sol 15~160 条、GPT-6 Sol 15~150 条、Astra 5~45 条;它们是受任务复杂度、上下文和工具使用影响的估计,不是固定条数,也不能用上限相除得出实际倍数。当前限制与重置时间看账户用量页。同一价格页还区分了速度档:Fast 消耗套餐内额度约为 Standard 的 2.5 倍、购买积分为 2 倍;Ultrafast 分别为 8 倍和 6 倍。
可用范围按官方可用性说明核对:
- GPT-6.1 Sol: Plus、Pro、Business、Enterprise 和 Edu 可在获准的 Work 或 Codex 入口使用;Enterprise 和 Edu 默认关闭,需管理员启用。它不在普通 Chat 中提供。
- Astra 与速度档: 当前套餐页为 Plus 与 Standard Business 列有 Astra 用量估计;实际可选模型仍以套餐、客户端和工作区设置为准。两款模型的 Ultrafast 面向 Pro $500 和符合条件的 Enterprise、Edu 方案,选到模型本身不代表自动获得 Ultrafast 权限。
在 CLI 里指定模型:
codex -m gpt-6.1-sol
codex -m gpt-6-astra
桌面应用和 Work 的模型控件中,可在高级(Advanced)里选择模型、推理强度与速度;文档中的 Power 预设只是示意,选项会随套餐、客户端、工作区设置和推出进度变化。在 CLI 中用 /model 选择模型后,进入 More reasoning… 查看该模型支持的 Max 或 Ultra。桌面中模型已支持 Ultra 而滑块未显示时,可检查 Settings → Configuration → Ultra in model picker slider。这些是 OpenAI 记录的入口,选择命令和开关都不会绕过账号权限。
如果经其他云平台或 API 网关调用,需按所用提供方的模型、缓存规则和报价重新计算,不能直接套用上面的 OpenAI 直连单价。直连 OpenAI 时,Astra 的访问条件与首次调用排查见 GPT-6 Astra API 怎么开通。
参考来源16
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年11月10日。
参考来源16
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年11月10日。
- 1.OpenAI 的模型指南developers.openai.com/api/docs/guides/latest-model
- 2.官方定价页developers.openai.com/api/docs/pricing
- 3.API 弃用页developers.openai.com/api/docs/deprecations
- 4.GPT-6.1 Soldevelopers.openai.com/api/docs/models/gpt-6.1-sol
- 5.GPT-6 Soldevelopers.openai.com/api/docs/models/gpt-6-sol
- 6.GPT-6 Astradevelopers.openai.com/api/docs/models/gpt-6-astra
- 7.OpenAI API 更新日志developers.openai.com/api/docs/changelog
- 8.Codex 与 Work 模型说明learn.chatgpt.com/docs/models
- 9.同名推理强度下 6.1 Sol 在当时的 v4.3.2 智能指数测试中,输出 Token 比 GPT-6 Sol 多约 10%~30%artificialanalysis.ai/articles/gpt-6-1-sol-replaces-gpt-6-sol-after-just-7-days-with-near-astra-intelligence
- 10.GPT-6.1 Sol 与 GPT-6 Astra 逐档比较页artificialanalysis.ai/models/releases/comparisons/gpt-6-1-sol-vs-gpt-6-astra
- 11.GPT-6.1 Solartificialanalysis.ai/models/releases/gpt-6-1-sol
- 12.GPT-6 Solartificialanalysis.ai/models/releases/gpt-6-sol
- 13.AA 比较页artificialanalysis.ai/zh/models/releases/comparisons/gpt-6-1-sol-vs-gpt-6-astra
- 14.GPT-6.1 Sol 发布文章openai.com/index/introducing-gpt-6-1-sol
- 15.GPT-6.1 Sol 系统卡补充deploymentsafety.openai.com/gpt-6-1-sol
- 16.官方积分费率learn.chatgpt.com/docs/pricing