Claude Opus 5.5 对比 GPT-6 Sol 与 6.1 Sol:先看任务,再算合格交付成本
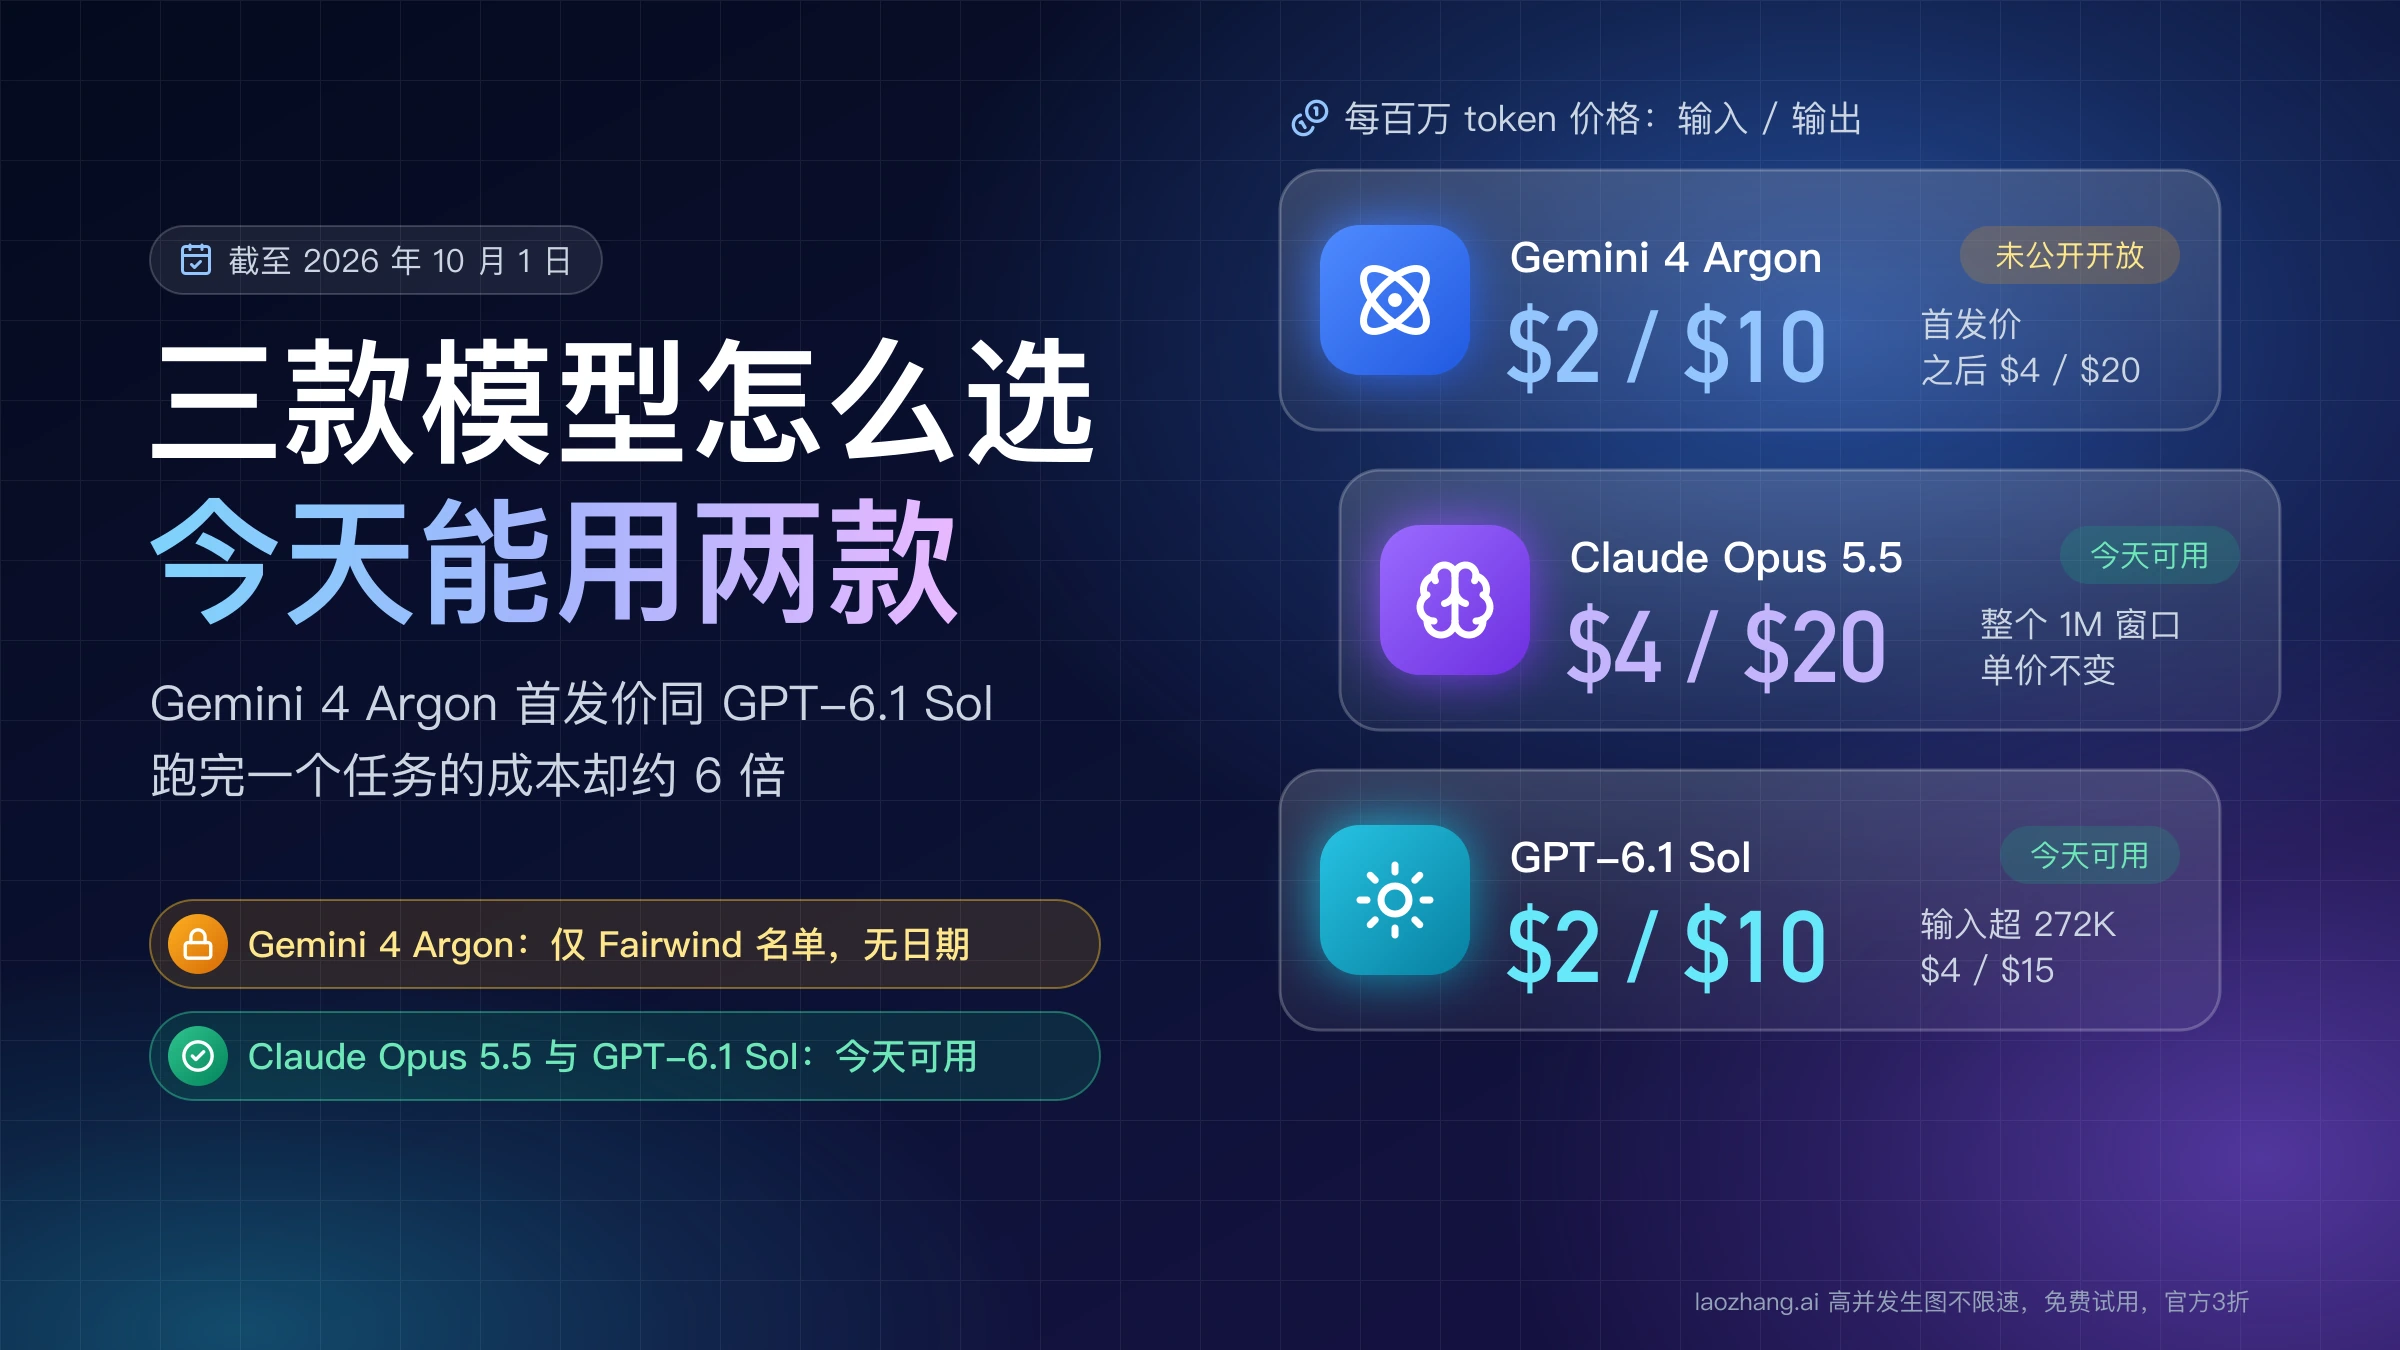
按 2026 年 9 月 30 日标价,272K 内同样的 token,Opus 5.5 花费是 GPT-6.1 Sol 的 2 倍,更长的请求也不更便宜;值不值看验收与返工。
文章目录
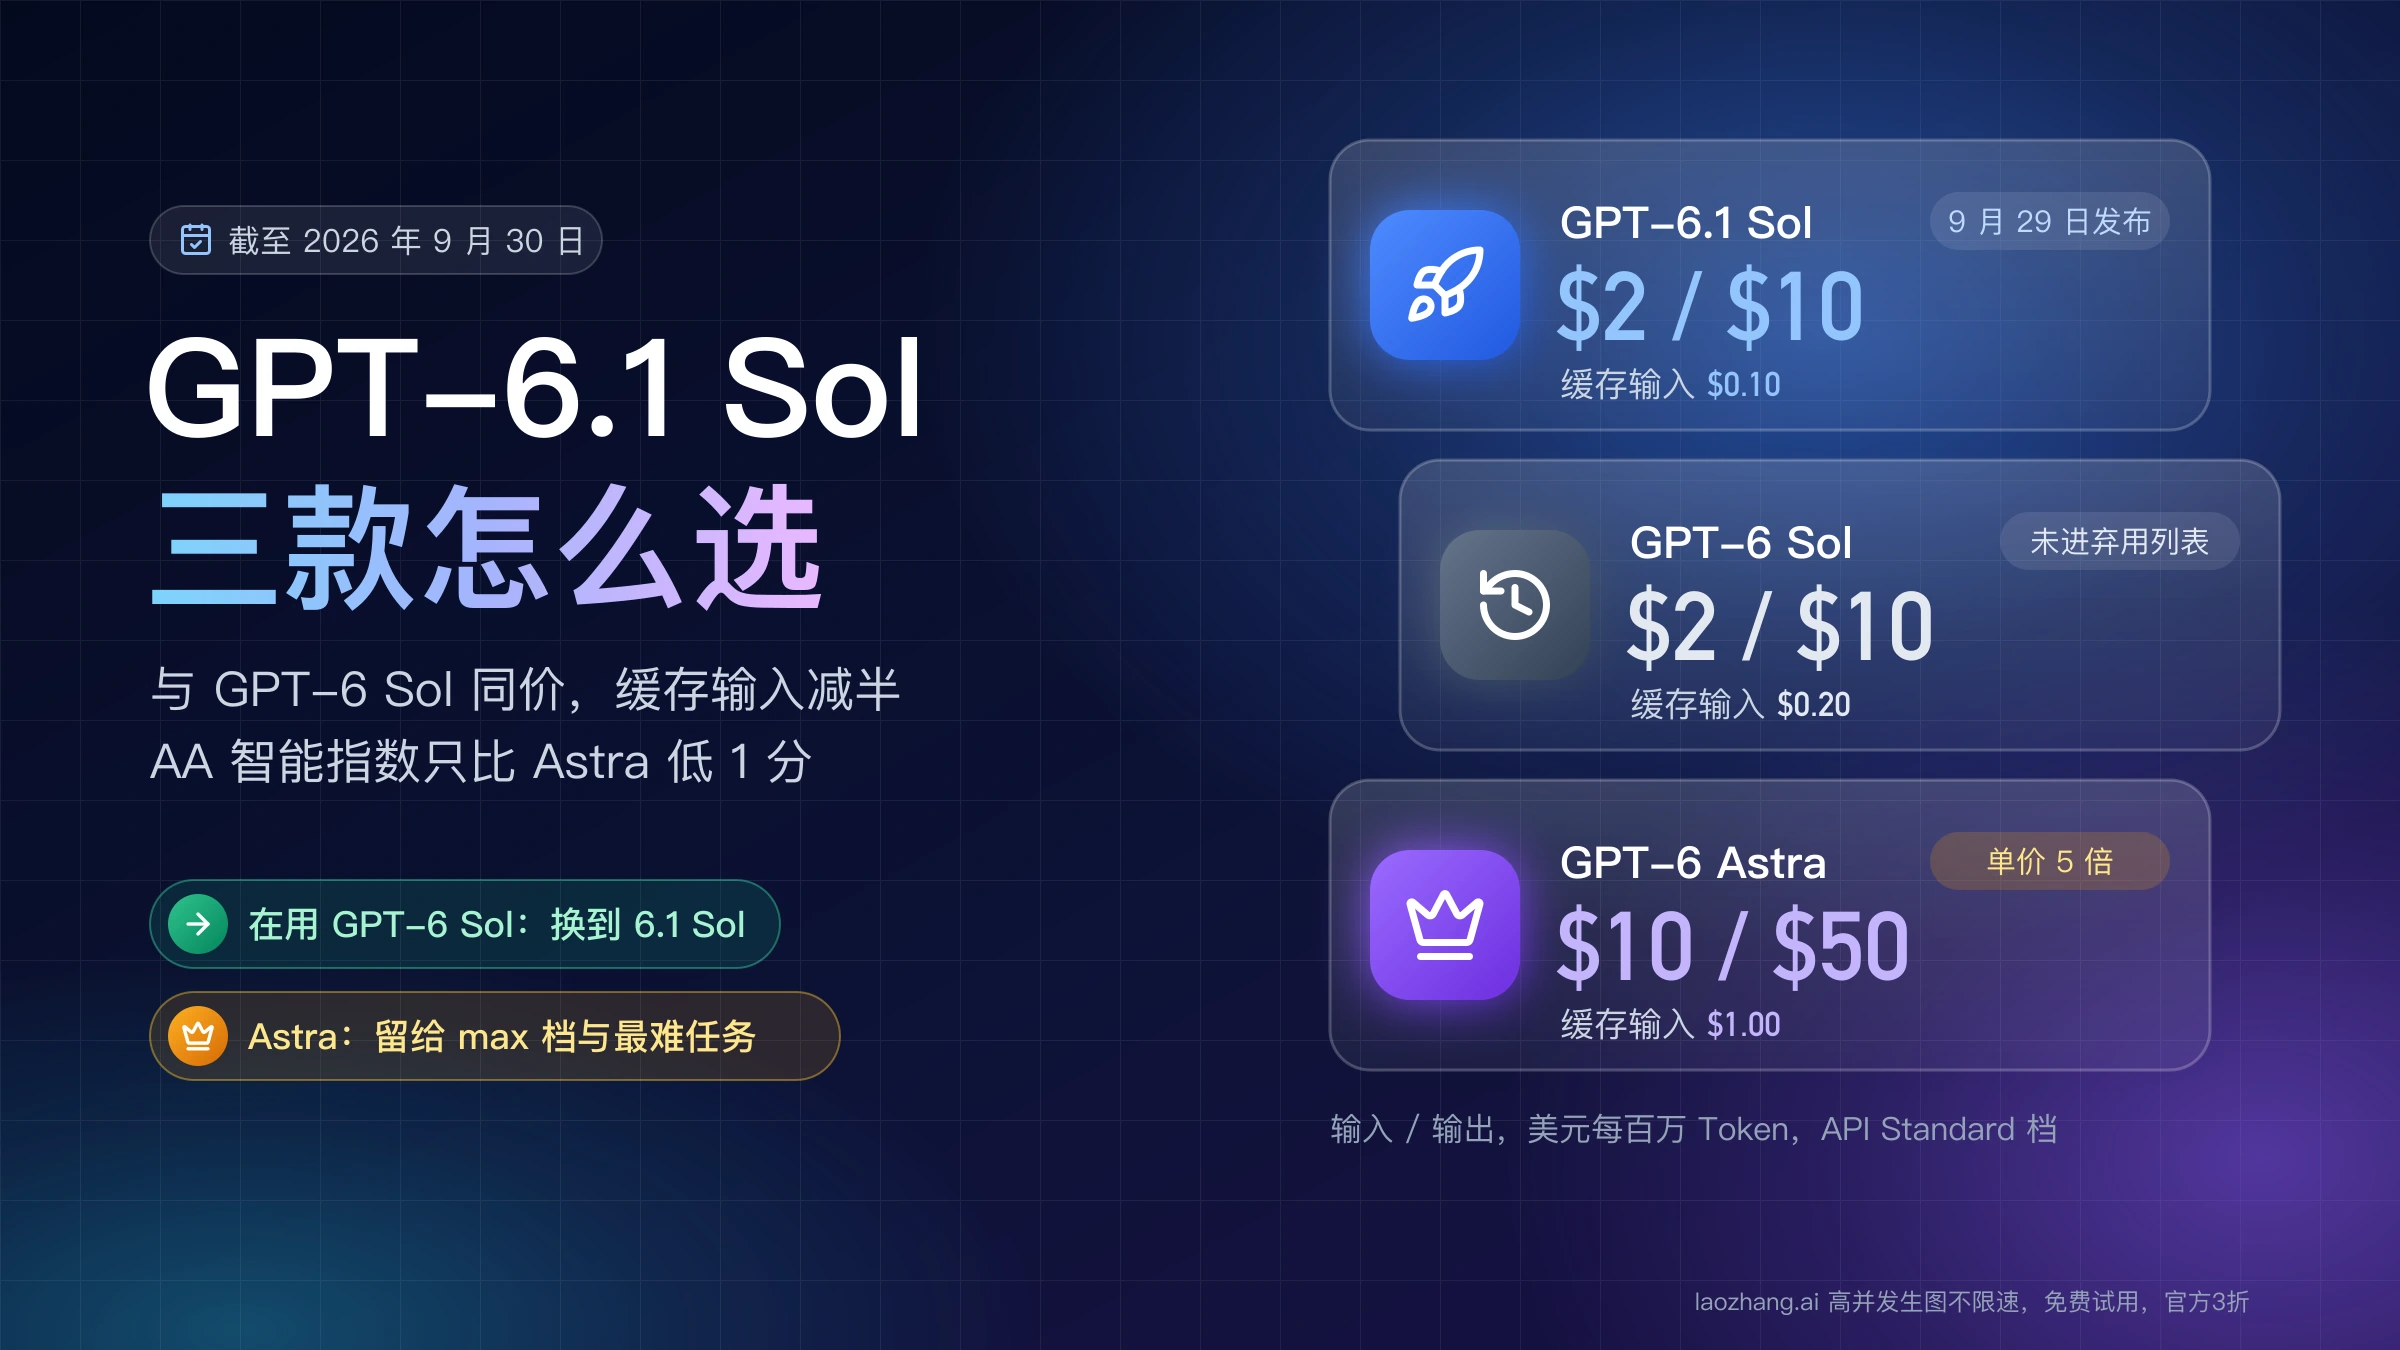
如果还没有自己任务的对照数据,先用 gpt-6.1-sol 做成本基线;若长流程编码或知识工作反复卡在质量验收,再让 claude-opus-5-5 跑同一批任务。GPT-6.1 Sol 于 2026 年 9 月 29 日发布,是 GPT-6 Sol 的升级版:输入不超过 272K token 时,输入/输出仍是每百万 token $2/$10,缓存输入从 $0.20 降到 $0.10。Opus 5.5 是 $4/$20,缓存读取 $0.20。结果是同样的 token 用量下,Opus 的直连 API 账单正好是 6.1 Sol 的 2 倍。这是计费单价的关系,不代表完成同一件工作的花费也是 2 倍,因为两款模型生成的 token 数本来就不同。单价可在 GPT-6.1 Sol 型号页、OpenAI 定价页和 Claude 价格页核对。
gpt-6-sol 仍可调用,OpenAI 没有公布停用日期,但它的型号页已指向 6.1 Sol,定价页主表也只列新型号。下文保留 GPT-6 Sol 的数字作参照,方便对照 9 月下旬的旧测评。从 GPT-6 Sol 换过去要改什么(例如 6.1 Sol 不再接受 none 推理强度),见「GPT-6.1 Sol 怎么用:价格变化、迁移改动与可用入口」;只在 OpenAI 自家型号之间挑,见「GPT-6.1 Sol、GPT-6 Sol、Astra 怎么选」。
这个初选适合按量调用模型、能保存任务与账单的开发者。只在 ChatGPT Work、Codex、Claude 或 Claude Code 的订阅里用模型,比的是额度,不是 API 单价,做法见后面的订阅一节。
先选哪个:看失败后要付出什么
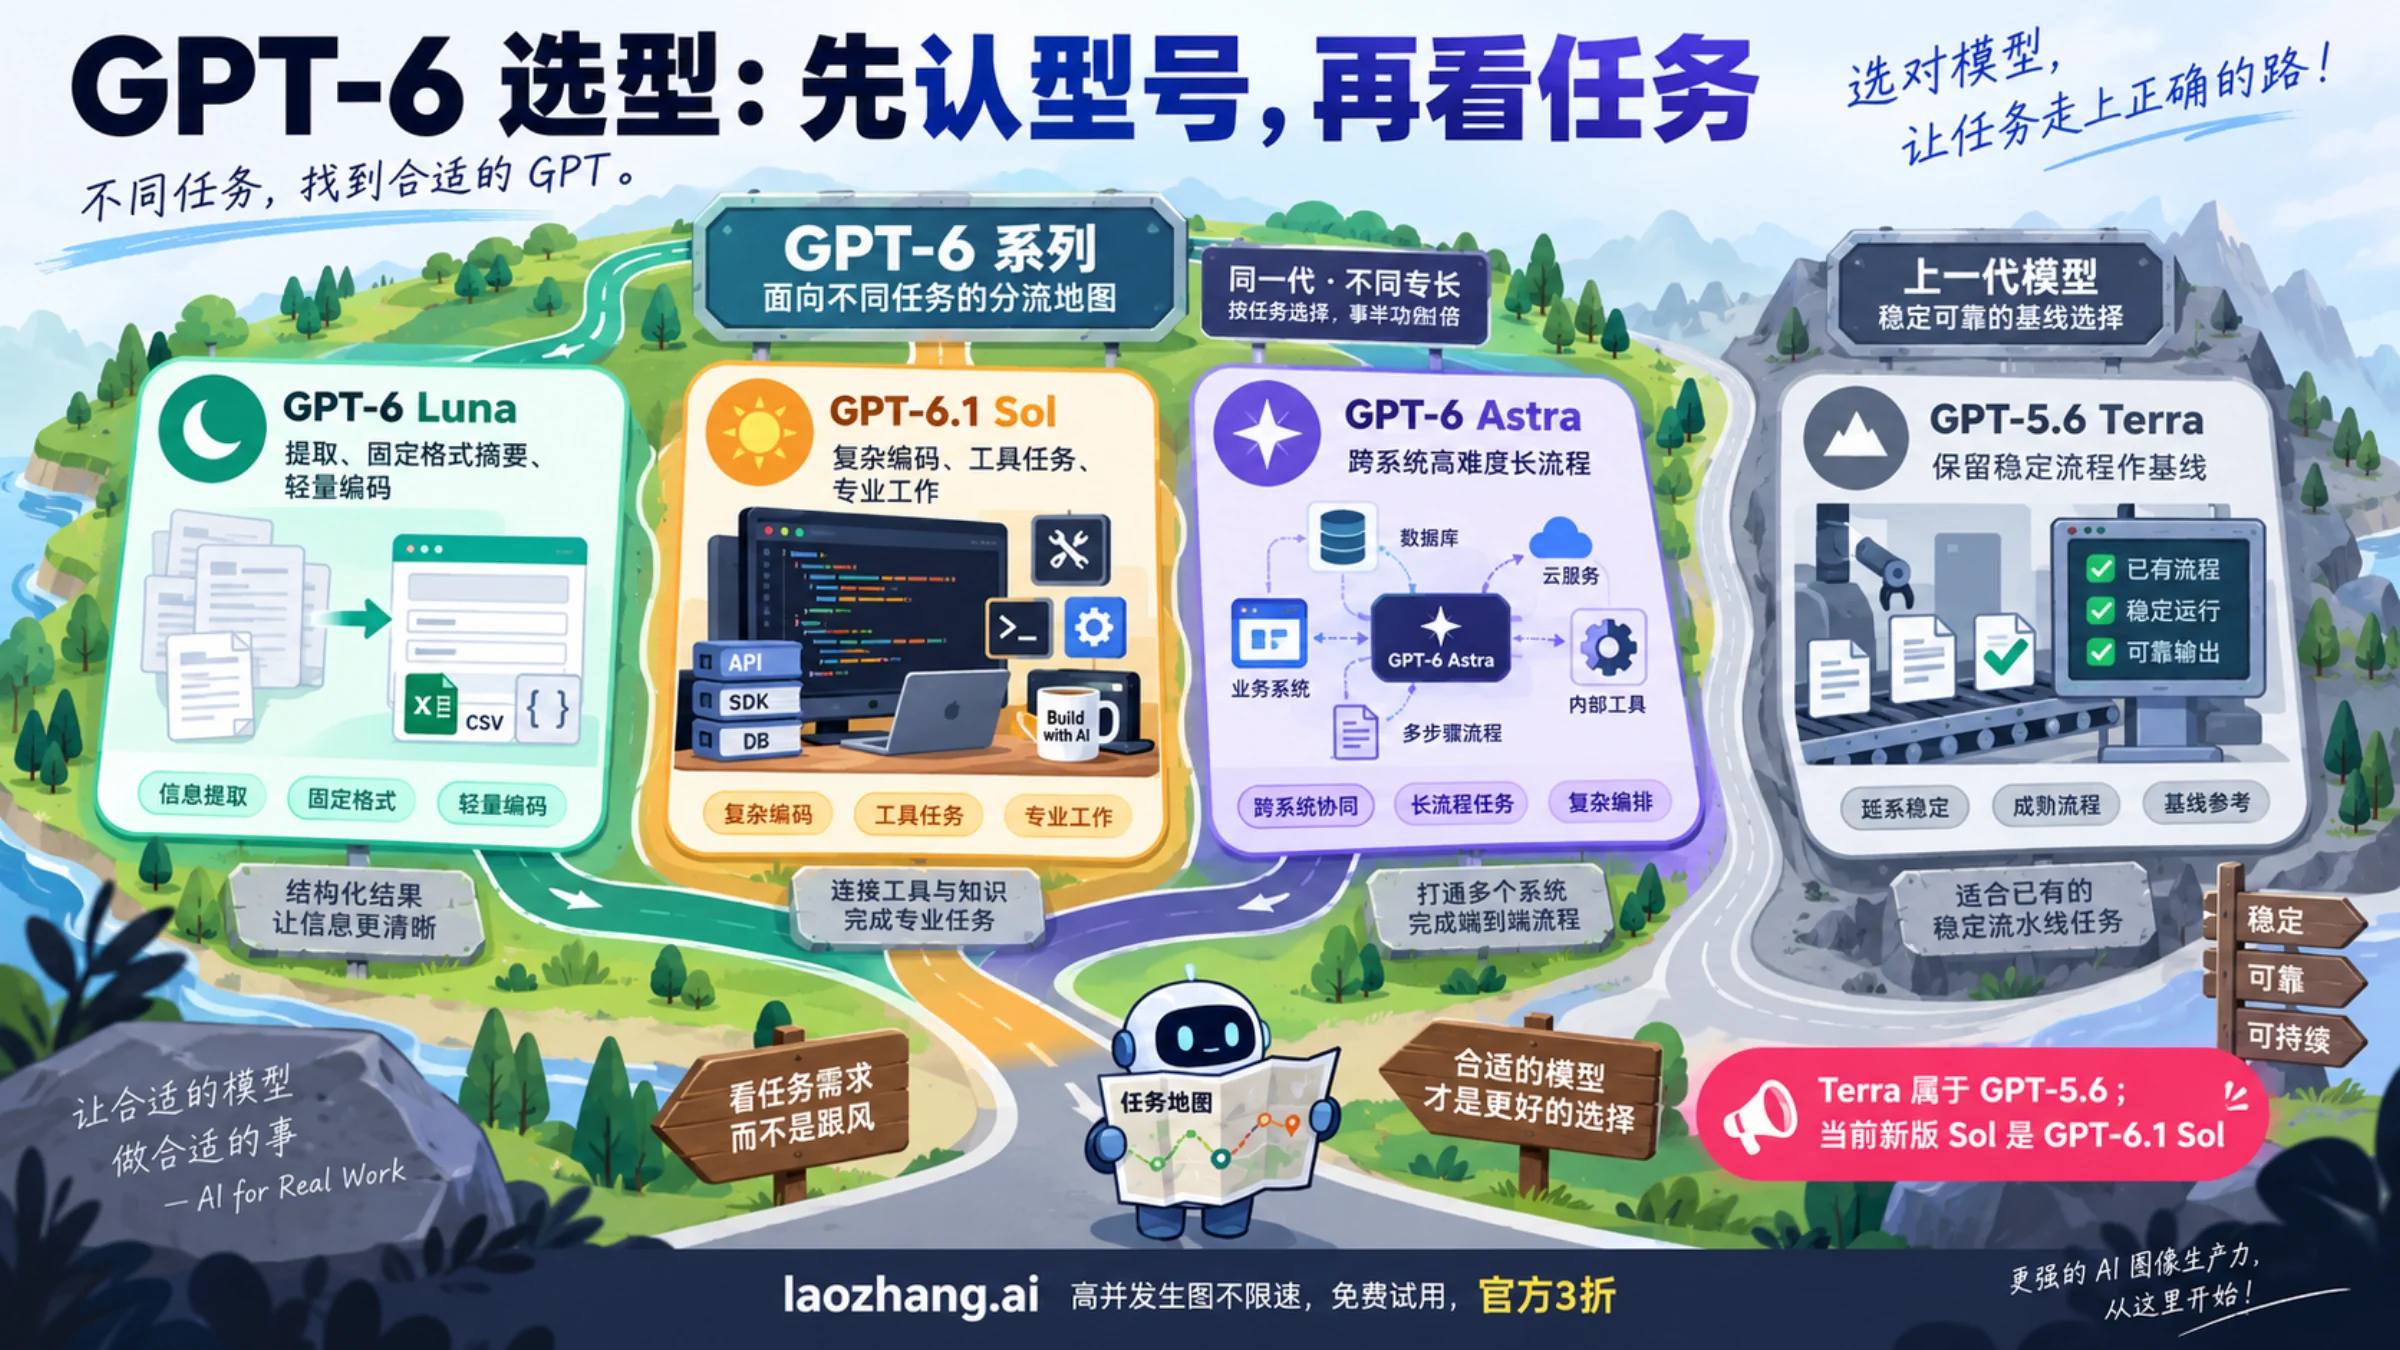
两家公司都把新型号用于复杂编码与代理式工作,但这是 GPT-6.1 Sol 的官方定位与 Opus 5.5 的官方定位,不是对你仓库的同条件实测。选择可以从任务分开:
| 你的工作 | 先试哪款 | 何时改试另一款 |
|---|---|---|
| 多文件改动、工具调用或资料处理,已有明确测试与人工验收 | GPT-6.1 Sol,先建立合格率和总成本基线 | 同类任务常需反复补约束、修错或人工接管时,加入 Opus 5.5 对照 |
| 长时间运行的编码代理、复杂资料整合,单次失败会引起较高返工 | 两款用同一批任务并排试;已有成熟 Claude 工具链可先保持 Opus 基线 | 若 6.1 Sol 在验收与返工上接近 Opus,就比较实际账单和迁移成本 |
已经在用 gpt-6-sol 做基线 | 同一批任务换成 gpt-6.1-sol 重跑一遍 | 新基线的验收结果出来后,再决定 Opus 对照是否还需要 |
这里的“先试”是降低试错成本的安排,不是速度、代码质量或可靠性排名。为 Opus 多付的费用是否值得,取决于它能否减少不合格交付、重试和人工修补。例如一次任务按下文同 token 示例多花 $0.40;只有节省的后续成本或额外通过的价值超过这笔差额,溢价才有经济理由。
直连 API 怎么算:同 token 比单价,同任务比总账
下表是美元/百万 token 的标准价,只比较两家官方直连 API 的文本计费;OpenAI 价格截至 2026 年 9 月 30 日,Anthropic 价格截至 2026 年 9 月 25 日。不含税、工具调用、地区附加费、订阅和转售渠道。Opus 行按 Claude API 的普通模式,fast mode 另有价格;Sol 行按 Standard 档,Batch/Flex 减半、Fast 翻倍。
| 模型与计费区间 | 普通输入 | 缓存读取 | 缓存写入 | 输出 |
|---|---|---|---|---|
Claude Opus 5.5 claude-opus-5-5,1M 窗口内同价 | $4 | $0.20 | $5(五分钟缓存) | $20 |
GPT-6.1 Sol gpt-6.1-sol,输入 ≤272K | $2 | $0.10 | $2.50 | $10 |
| GPT-6.1 Sol,输入 >272K,整次请求 | $4 | $0.20 | $5 | $15 |
参照:GPT-6 Sol gpt-6-sol,输入 ≤272K | $2 | $0.20 | $2.50 | $10 |
| 参照:GPT-6 Sol,输入 >272K,整次请求 | $4 | $0.40 | $5 | $15 |
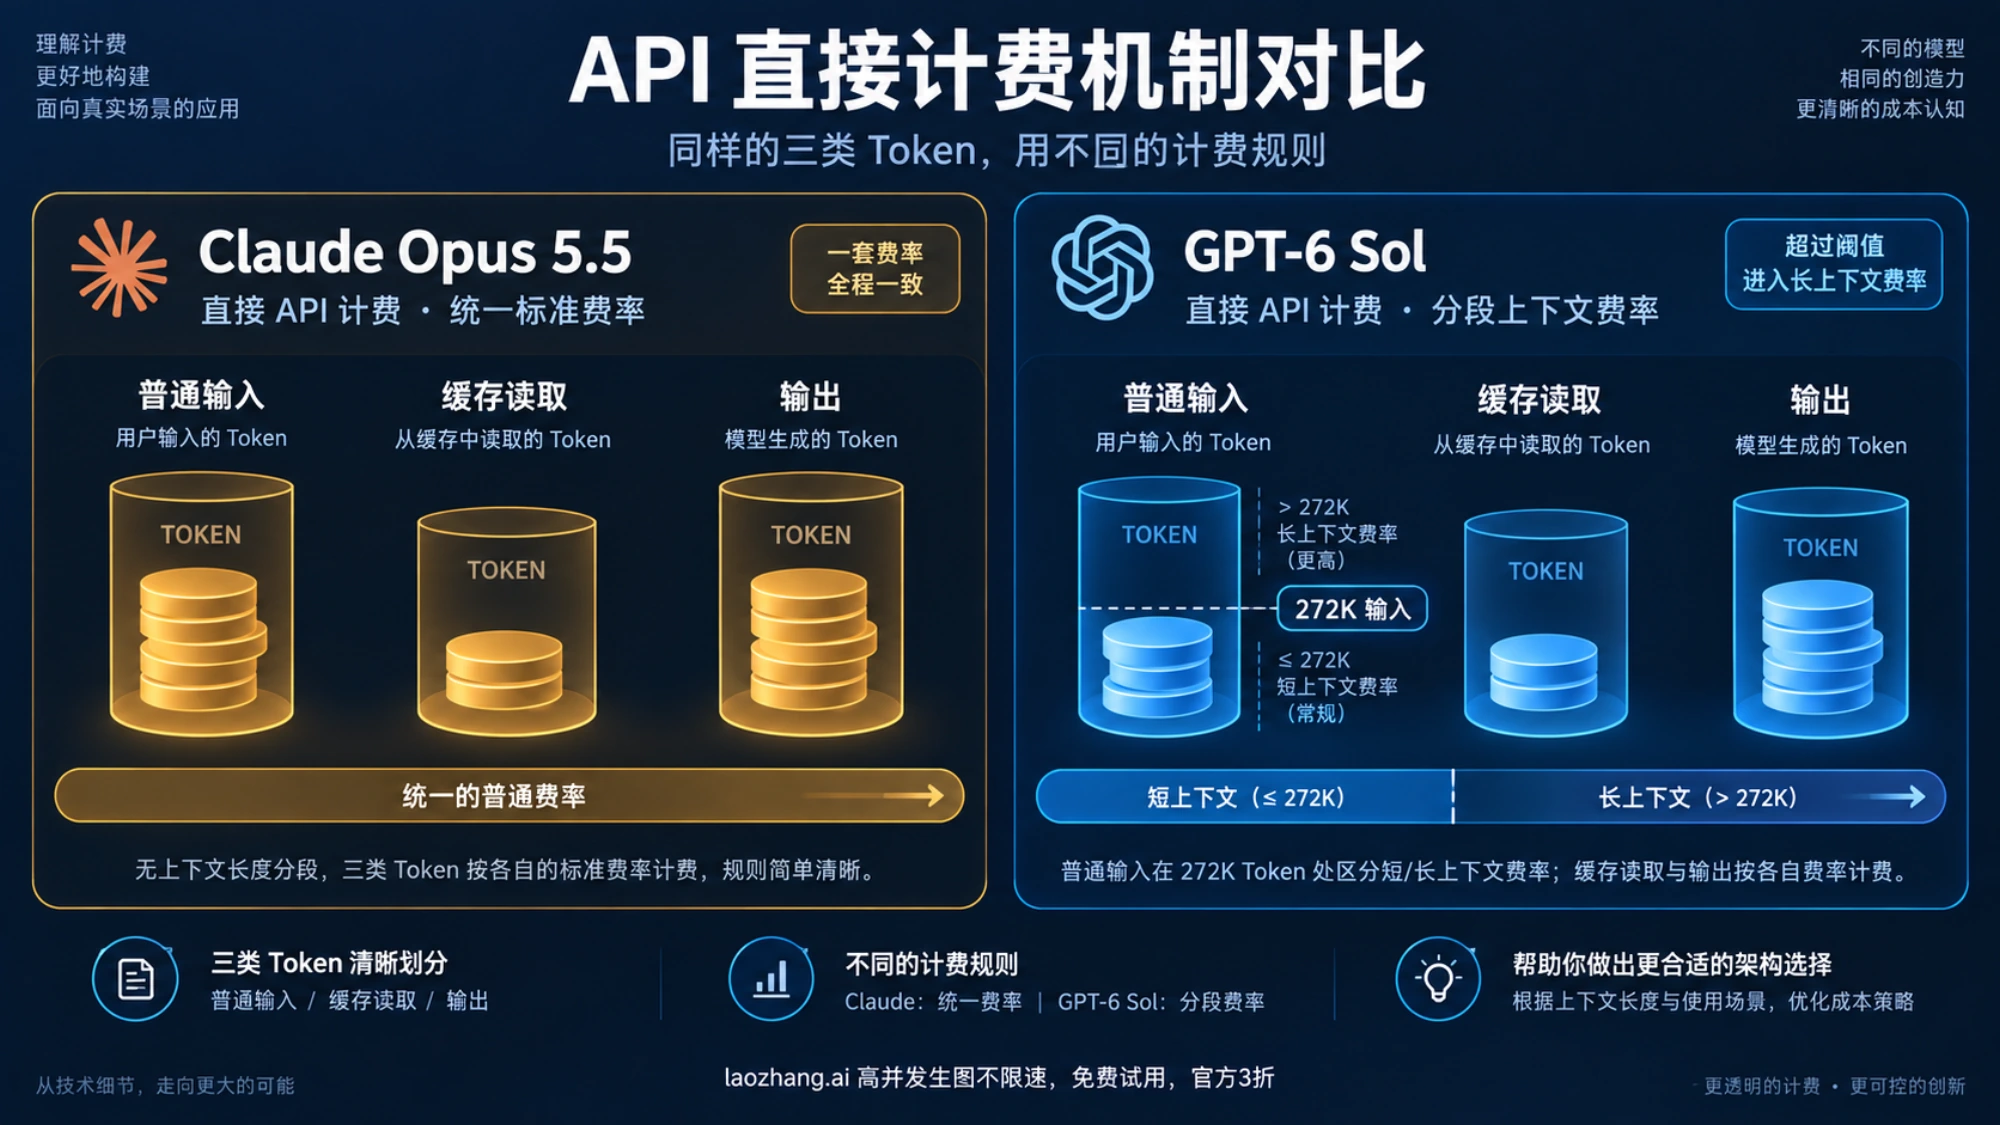
把一次请求的用量拆成四类,单位是百万 token:U 为普通输入,W 为缓存写入,R 为缓存读取,O 为输出(含推理 token)。按上表单价:
Opus 5.5              = 4U + 5W + 0.2R + 20O
GPT-6.1 Sol(≤272K)  = 2U + 2.5W + 0.1R + 10O
GPT-6.1 Sol(>272K)  = 4U + 5W + 0.2R + 15O
272K 以内,Opus 的每一项都正好是 6.1 Sol 的 2 倍,缓存用得再多,同样 token 下的比值也是 2 倍;Opus 若用一小时缓存写入($8),差距还会略大。超过 272K 时,两式只差输出一项:Opus − 6.1 Sol = 5O,不会小于零,所以同样 token 下 Opus 在长请求里也不会比 6.1 Sol 便宜。对 GPT-6 Sol 结论不同:它的短上下文缓存读取也是 $0.20,同样 token 下 Opus 等于 2 倍 GPT-6 Sol 再减去一份缓存读取费用;长上下文缓存读取 $0.40 比 Opus 还高,缓存读取超过输出 25 倍时 Opus 反而更便宜。换成 6.1 Sol 后,这两种说法都不再成立。
下面四个例子都假设两款计入完全相同的 token,没有工具、重试和此前的缓存写入;实际运行时两款生成的 token 数不会相同。
| 例子与用量 | Opus 5.5 | GPT-6.1 Sol | 参照:GPT-6 Sol | Opus ÷ 6.1 Sol |
|---|---|---|---|---|
| 短请求:100,000 普通输入 + 20,000 输出 | $0.80 | $0.40 | $0.40 | 2.00 倍 |
| 短请求:20,000 普通输入 + 80,000 缓存读取 + 20,000 输出 | $0.496 | $0.248 | $0.256 | 2.00 倍 |
| 长请求:300,000 普通输入 + 20,000 输出 | $1.60 | $1.50 | $1.50 | 1.07 倍 |
| 长请求:50,000 普通输入 + 750,000 缓存读取 + 20,000 输出 | $0.75 | $0.65 | $0.80 | 1.15 倍 |
第一行的算法是 6.1 Sol 0.1 × $2 + 0.02 × $10 = $0.40,Opus 0.1 × $4 + 0.02 × $20 = $0.80;0.1、0.02 是换成百万 token 后的数量。最后一行是 800K 的缓存型长请求:对 GPT-6 Sol,Opus 便宜一点(约 0.94 倍);对 6.1 Sol,Opus 贵 $0.10,正好是 5 × 0.02。缓存是否命中、写入按哪个时长计费,要从请求的用量记录核对,不能按假设填。
同一段文字在两家计出的 token 数也不一样:分词器不同,Anthropic 说明 4.7 以后的分词器比它上一代多出约 30% 的 token,两家之间则没有公开换算比例。所以“同 token”只用来看单价关系,真实账单要读各自 API 返回的用量字段。窗口方面,Opus 列出 1M 上下文,6.1 Sol 列出 1,050,000 上下文、最多 128,000 输出;这是可输入上限,不是建议把全部材料一次塞进去。
公开分数能说明什么,不能说明什么
先看清图里是哪个 Sol。Anthropic 的 Opus 5.5 发布表里的 Sol 列是 GPT-5.6 Sol;9 月 29 日以前的对比图和测评视频里,Sol 最多是 GPT-6 Sol。把这些分数直接当成 6.1 Sol 对 Opus 5.5,会把代际差异抹掉。
Artificial Analysis 的 GPT-6.1 Sol 与 Opus 5.5 对比页按同名推理强度并排列出 Intelligence Index 4.3.2 的结果(截至 2026 年 9 月 30 日;Opus 各档均为自适应推理、含默认 fallback):
| 推理强度 | Opus 5.5 指数/每项任务成本 | GPT-6.1 Sol 指数/每项任务成本 | Opus 成本是 6.1 Sol 的 |
|---|---|---|---|
| low | 42/$0.55 | 42/$0.13 | 4.2 倍 |
| medium | 51/$1.34 | 48/$0.21 | 6.4 倍 |
| high | 54/$1.82 | 50/$0.32 | 5.7 倍 |
| xhigh | 56/$3.46 | 51/$0.39 | 8.9 倍 |
| max | 58/$5.98 | 52/$0.72 | 8.3 倍 |
综合分最高的仍是 Opus 5.5 max 的 58,6.1 Sol 最高 52。成本差距之所以远大于单价的 2 倍,是因为 Opus 每项任务生成的 token 多得多:medium 约 26k 对 8k,max 约 119k 对 38k。两组比较值得记住:low 档两者同为 42 分,Opus 花 4.2 倍;6.1 Sol max 以 52 分略高于 Opus medium 的 51 分,成本约为后者的 54%。同名推理强度在两家并不等价,比较时看分数与成本的组合,不要只对齐档位名。作为参照,同一指数里 GPT-6 Sol max 为 48 分、$1.05,medium 为 40 分、$0.25(AA 的 GPT-6 Sol 测评)。58、52 是综合指数,不是任务通过率;每项任务成本也不是你公司的生产账单。
速度上,同一页面显示 Opus 输出更快,约 72~92 token/秒,6.1 Sol 约 59~66 token/秒;但 6.1 Sol 出第一个答案 token 早得多:low 档 2.12 秒对 12.72 秒,medium 档 5.72 秒对 22.95 秒。AA 会重新测量,这些数值随时间变化,引用时要带日期。
OpenAI 的 GPT-6.1 Sol 发布说明给了另一组厂商自选的对比:GDP.pdf 在各档推理设置下 6.1 Sol 得分都高于带回退的 Opus 5.5,单任务成本不到一半;AutomationBench 1.0.6 中等推理强度下高 2.2 个百分点、成本约三分之一;Terminal-Bench Science 0.1 最高推理强度下平均单任务成本 $5.47 对 $23.21。OpenAI 注明对手成绩取自公开报告。这与 AA 综合指数里 Opus 领先并不矛盾,两边选的测试不同,都只能说明各自那套任务。
因此,公开测评适合决定“要不要把 Opus 纳入试跑”,不适合直接宣布“某款写代码必胜”或“某款性价比必胜”。上面的分数、成本和延迟都来自厂商或 Artificial Analysis 的测试环境,你项目里的结果要靠下面的试跑得出。
只在订阅里用:看额度,不看 API 单价
OpenAI 明确说 API token 价格与订阅用量分开,不要用 API 价格估算套餐能完成多少任务(ChatGPT 定价说明)。截至 2026 年 9 月 30 日,GPT-6.1 Sol 在 Plus、Pro、Business、Enterprise、Edu 的 ChatGPT Work 与 Codex 中推出,Enterprise/Edu 需要管理员开启;普通聊天里没有,Free 和 Go 不在首批范围(ChatGPT 型号说明)。命令行可用 codex --model gpt-6.1-sol 指定。
额度方面,OpenAI 给 Plus 与 Standard Business 的估算是每五小时 15~160 条本地消息(GPT-6 Sol 为 15~150),并说明这不是固定上限,每周限额也可能生效。Pro 现在分 $100、$200、$500 三档,官方写的是“目前没有五小时限制”;早先按 Pro 5x、20x 给出的消息估算已不再公布。Opus 5.5 在 Claude 的 Pro、Max、Team、Enterprise 与 Claude Code 2.1.280 及以上可用,Anthropic 没有公布各套餐能发多少条 Opus 5.5 消息。所以入门付费档哪边更耐用,只能用同样的任务在自己账户的用量面板上看消耗,不能拿每百万 token 价格推算。
用一轮小试跑决定是否切换
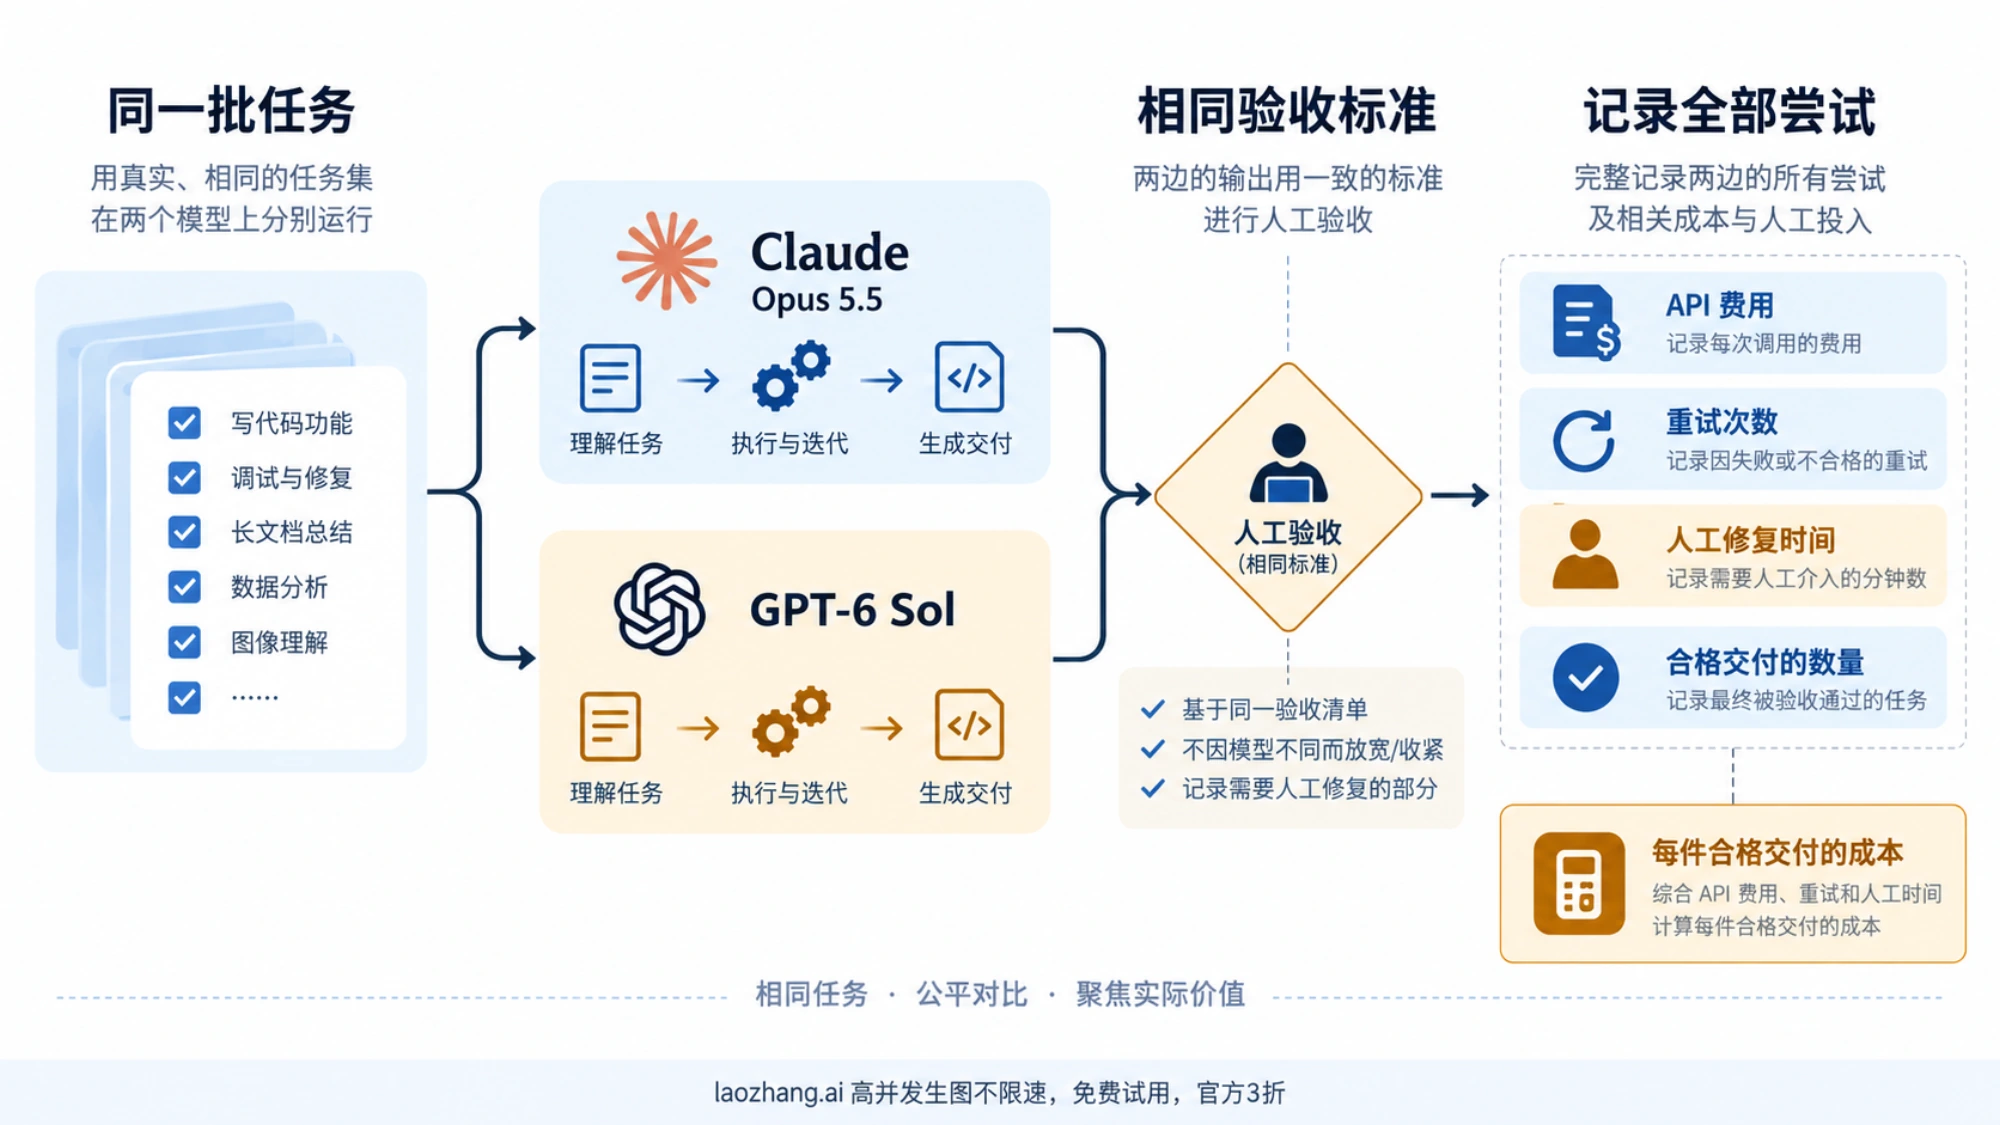
- 固定任务和验收。从最近的真实工作抽取若干有代表性的任务,混入容易完成、常失败、长上下文三类;为每件写下可执行测试、需要人工判断的点,以及失败后允许修补的次数。编码任务保留同一仓库快照与测试环境,资料任务保留同一输入和来源。
- 对齐可控条件。记下准确模型 ID、API 入口、推理强度、工具权限、提示输入、服务档位和终止条件。6.1 Sol 的
reasoning.effort可选 low 到 max,默认 medium,不支持none和minimal,工具调用要走 Responses API;Opus 5.5 默认 medium。不同提供商的同名档位不能当作完全相同,把设置写清楚,才能解释结果。 - 记录所有尝试。每次保存输入/输出 token、缓存写入与读取、工具费、重试次数、运行时间、人工检查或修补时间,以及最终是否通过预先定好的验收。token 直接读响应里的用量字段:OpenAI Responses 是
input_tokens、input_tokens_details.cached_tokens、input_tokens_details.cache_write_tokens、output_tokens;Claude 是input_tokens、cache_creation_input_tokens、cache_read_input_tokens、output_tokens。输入超过 272K 的 Sol 请求单独按长上下文费率计算。 - 按合格交付比较。先算
所有尝试的 API 费用 ÷ 最终验收通过的任务数,再并列看通过率、人工修补分钟数和完成时间;若人工时间可可靠折价,再计入总成本。分母为零就记录“未产生合格交付”,不要填一个看似精确的单件价格。
如果 6.1 Sol 的通过率与人工返工接近 Opus,就保留它作默认,同 token 下它在短请求和长请求里都更便宜;若 Opus 在高失败代价任务上稳定减少返工,可以只把那类任务交给 Opus,而不是把所有请求一起迁移。长上下文、缓存为主的工作负载不再是改用 Opus 的价格理由,要换就只因为验收结果更好。样本太少或任务差异太大时,先扩大同类任务记录,再改默认模型。这比只看发布图或每百万 token 价格,更接近你要支付的真实代价。
参考来源9
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月1日。
参考来源9
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月1日。
- 1.GPT-6.1 Sol 型号页developers.openai.com/api/docs/models/gpt-6.1-sol
- 2.OpenAI 定价页developers.openai.com/api/docs/pricing
- 3.Claude 价格页platform.claude.com/docs/en/about-claude/pricing
- 4.Opus 5.5 的官方定位anthropic.com/claude-opus-5-5
- 5.Artificial Analysis 的 GPT-6.1 Sol 与 Opus 5.5 对比页artificialanalysis.ai/models/releases/comparisons/gpt-6-1-sol-vs-claude-opus-5-5
- 6.AA 的 GPT-6 Sol 测评artificialanalysis.ai/models/releases/gpt-6-sol
- 7.OpenAI 的 GPT-6.1 Sol 发布说明openai.com/index/introducing-gpt-6-1-sol
- 8.ChatGPT 定价说明learn.chatgpt.com/docs/pricing
- 9.ChatGPT 型号说明learn.chatgpt.com/docs/models