Claude Opus 5.5 对比 GPT-6 Astra:单价低 60%,同题实测只省 30%
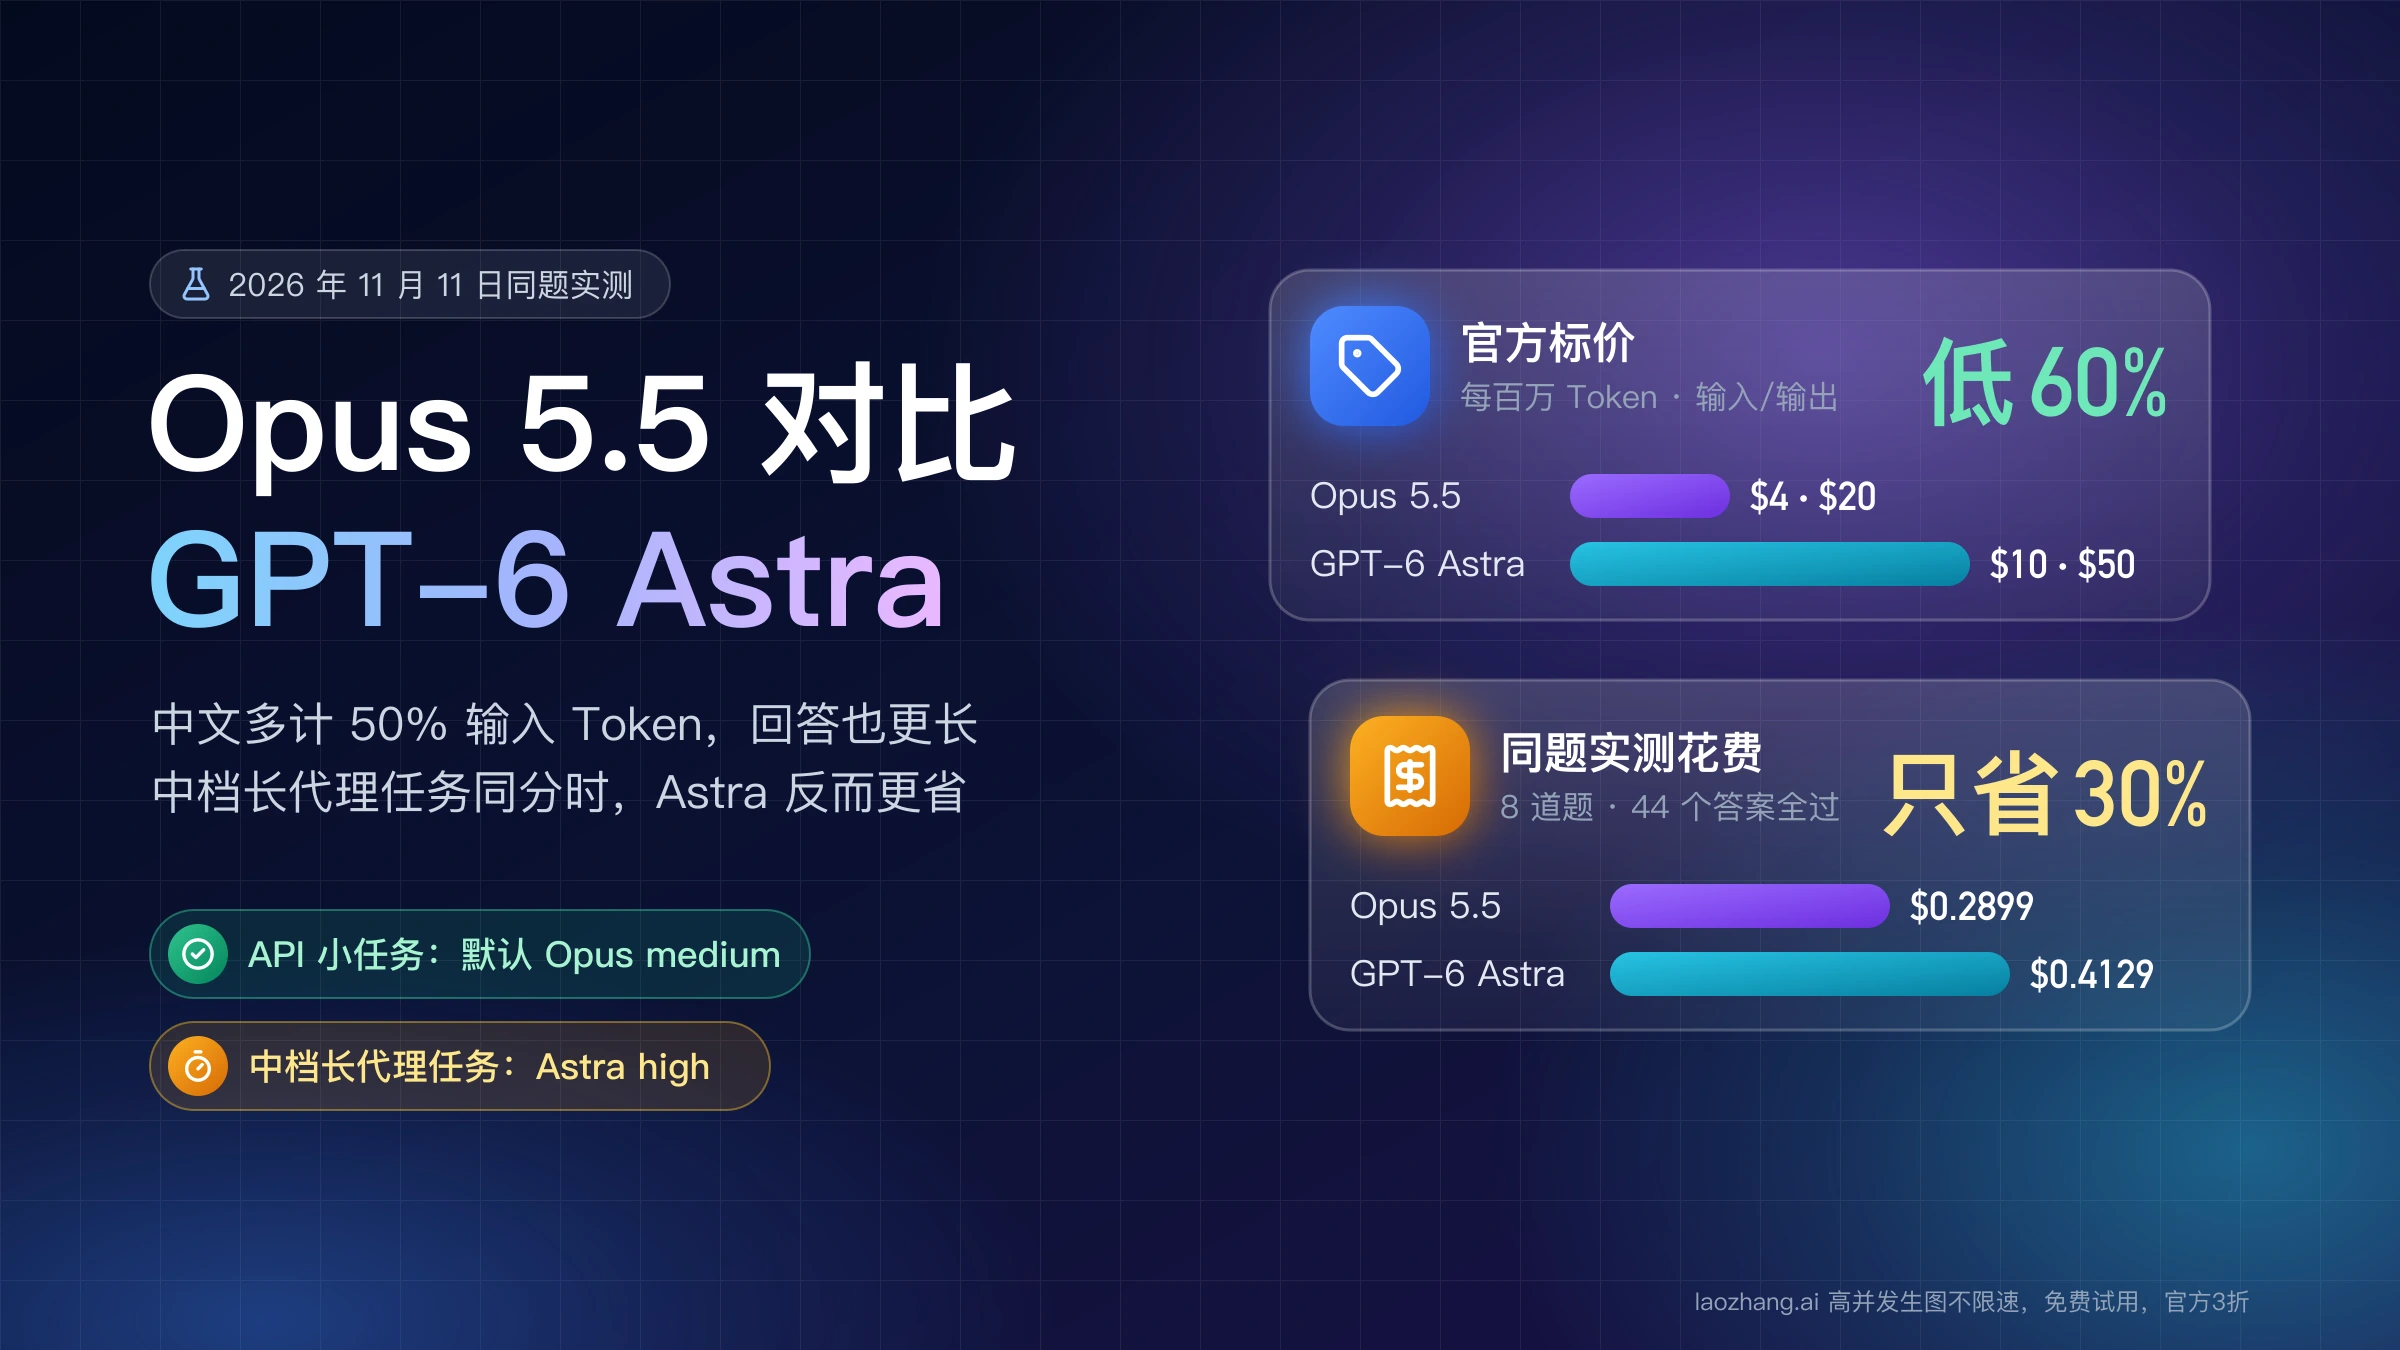
Opus 5.5 单价比 GPT-6 Astra 低 60%,同题实测只省 30%;明确的 API 小任务默认用 Opus medium,中档长代理任务用 Astra high。
文章目录
在 Claude Opus 5.5 和 GPT-6 Astra 之间选默认,先看你的任务有多长、多开放。通过 API 做边界清楚的活,比如写一个函数、从一份长日志里数出准确的值、把一篇长文压成固定格式,就把 Opus 5.5 设成默认,推理强度(effort)用它的 API 默认值 medium。2026 年 11 月 11 日用同样 8 道编程与推理小题实测,两边 44 个答案全部通过,Opus medium 的花费是 Astra 不传 effort 时的 0.70 倍,也就是便宜 30%;146 KB 日志的首次调用只要 Astra 的 57%–64%。代价是 Opus 多写约一倍的输出 Token,整组题多用 37% 的时间。
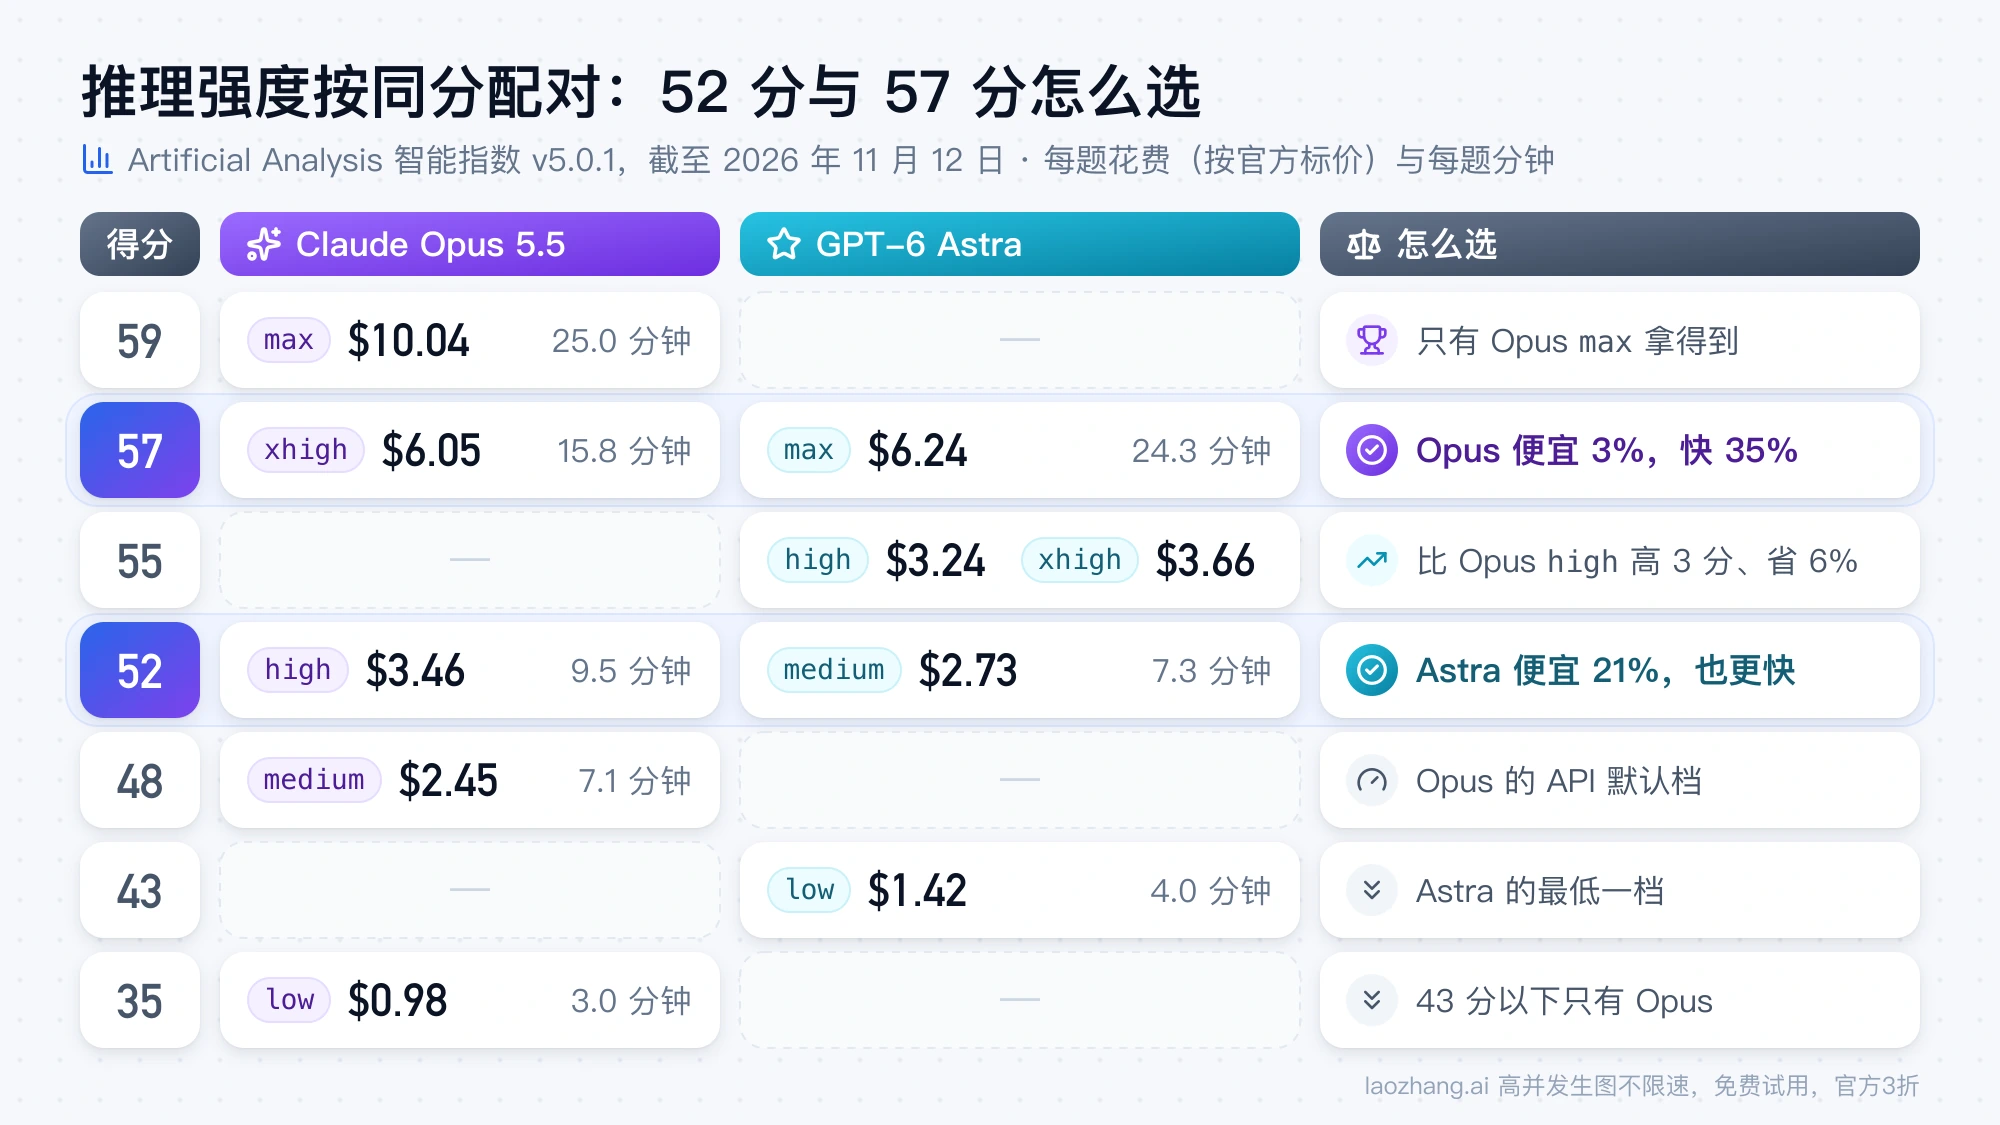
在 Claude Code、Codex 这类工具里跑几十分钟的代理式任务,这个结论不能照搬。Artificial Analysis 智能指数 v5.0.1(截至 2026 年 11 月 12 日)里,low 到 high 同名档位都是 Astra 得分更高;同样拿到 52 分,Astra medium 每题 $2.73,比 Opus high 的 $3.46 便宜 21%。所以中档长任务默认用 Astra high(55 分、每题 $3.24),要冲最高分时再换 Opus:57 分时 Opus xhigh 比 Astra max 便宜 3%、快 35%,59 分只有 Opus max 拿得到。
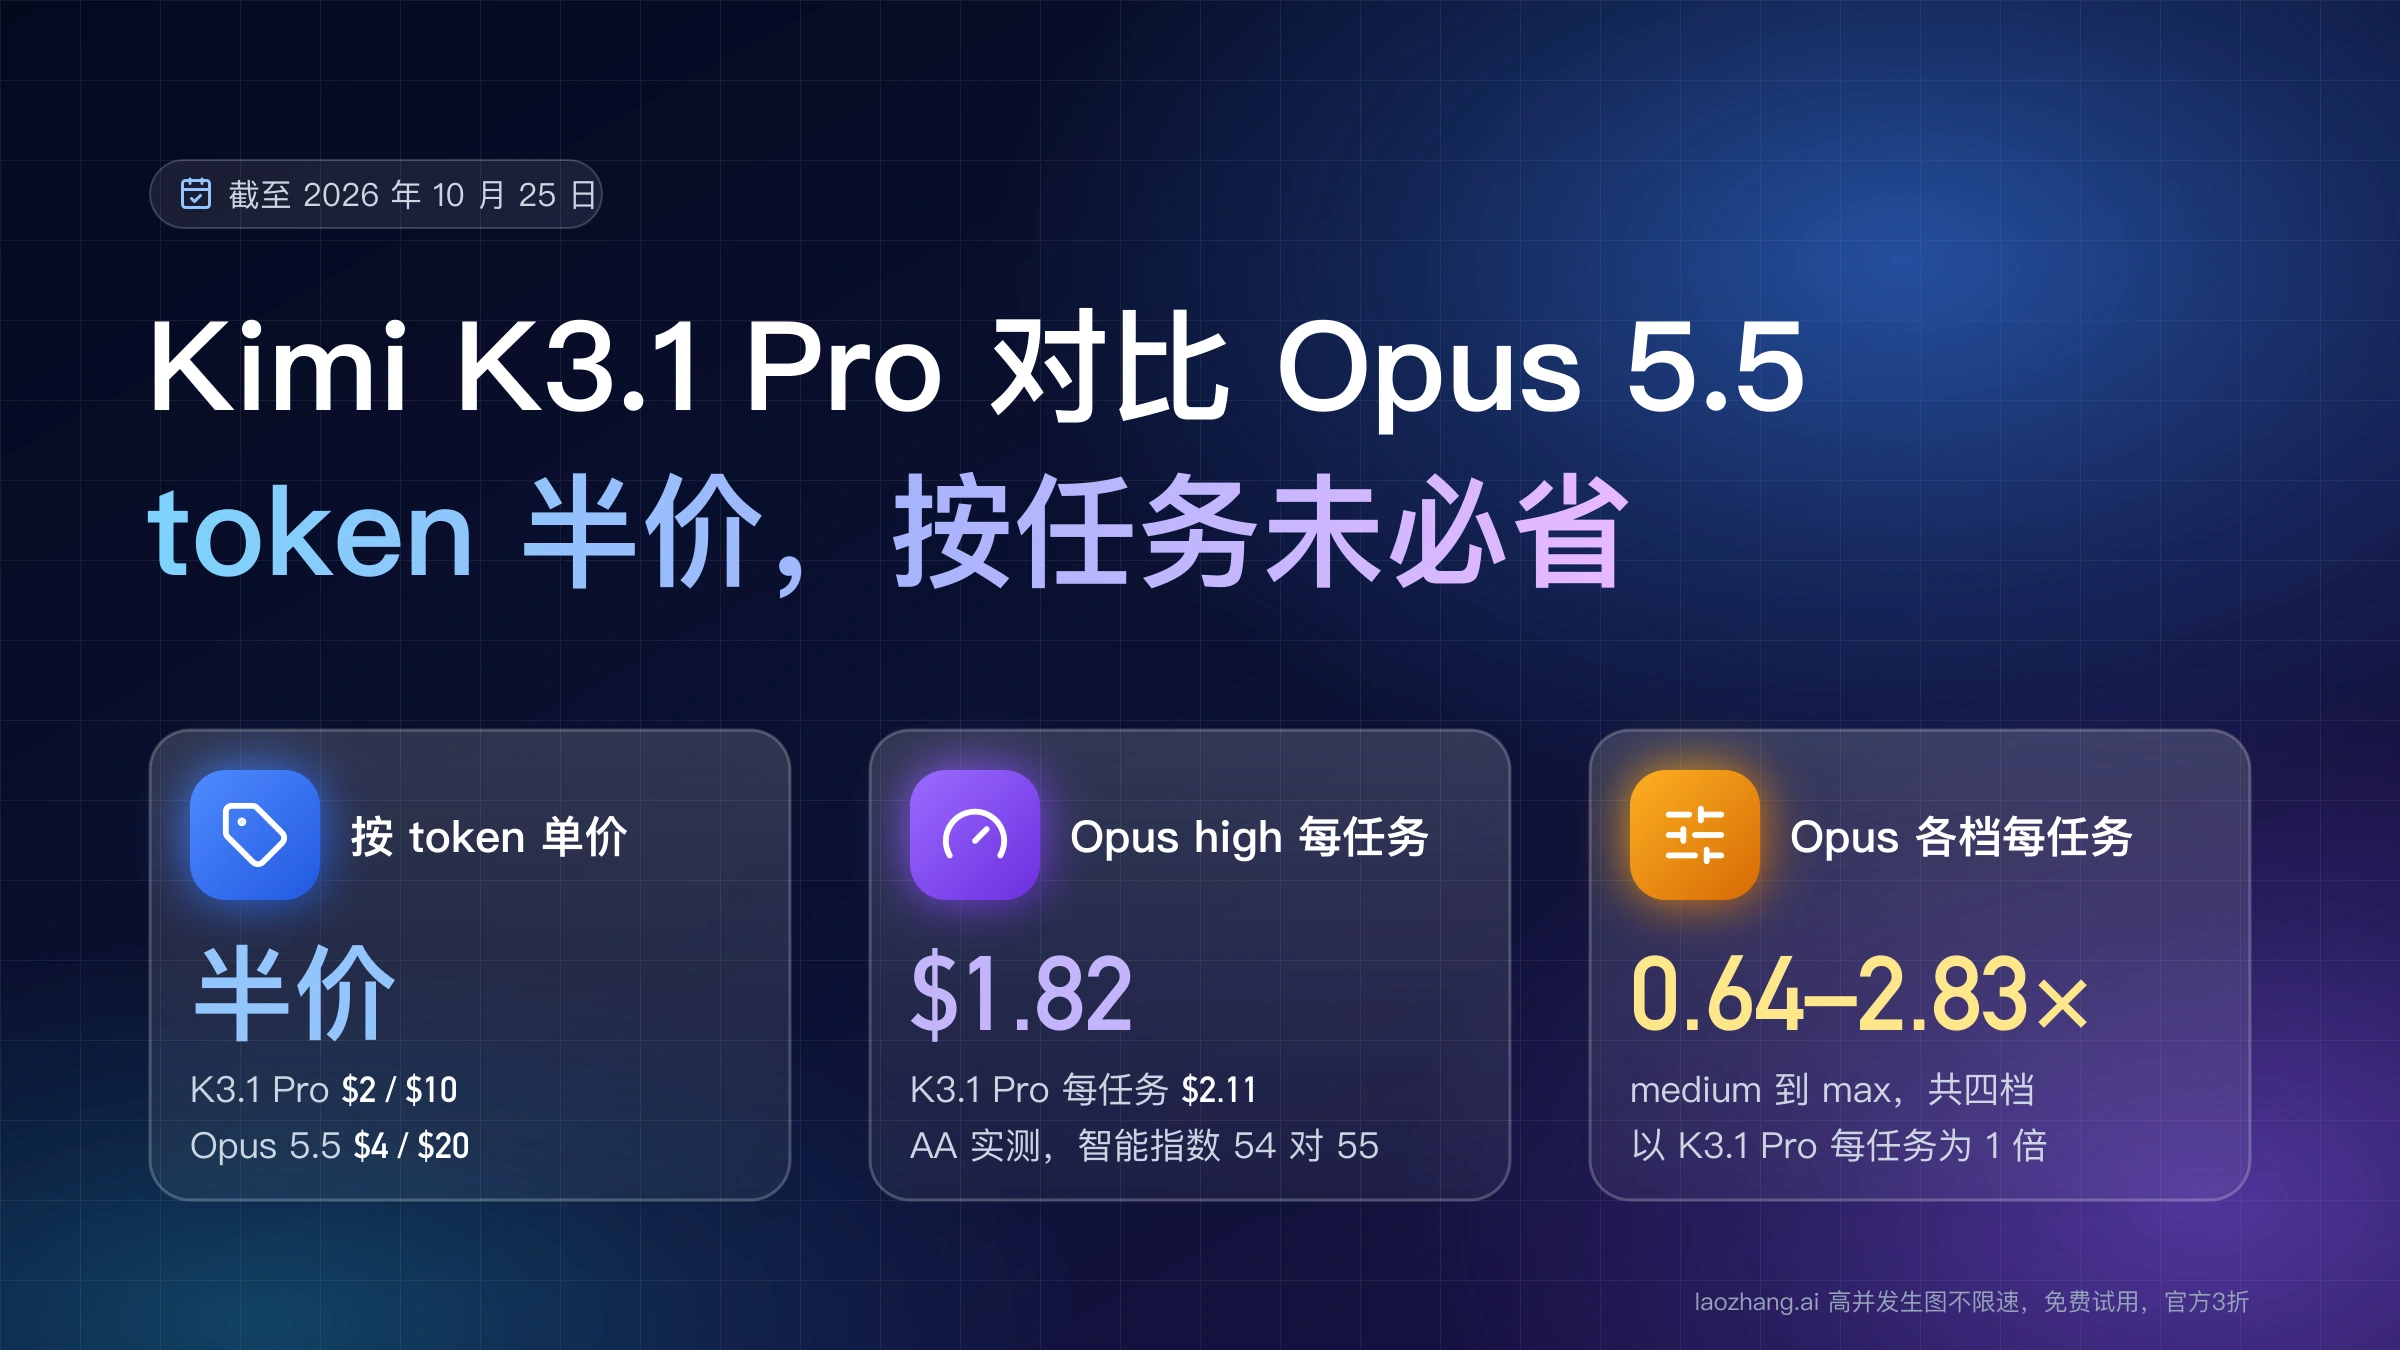
"便宜 60%"说的只是每百万 Token 的标价:Opus 输入 $4、输出 $20,Astra 输入 $10、输出 $50。同一段中文 Opus 要多计 50% 的输入 Token,回答又写得更长,所以按任务算的差距落在五到七折之间,长任务上还可能反过来。另有几种情况会在比较质量之前就替你选好:单次输入超过 272K Token、要在 Chat Completions 上用函数调用、以科研推导为主的任务,见下文的排除清单。
单价低 60%,每个任务省多少:同题实测 0.50–0.70 倍
在两边都答对的小任务上,Opus 5.5 的花费是 GPT-6 Astra 的五到七成,而不是标价暗示的四成。2026 年 11 月 11 日,同样 8 道题、每个配置 11 个评分答案,Opus medium 花 $0.2899,Astra 不传 effort 花 $0.4129;两边都开 high 时是 $0.3082 对 $0.6121。差距被吃掉的原因是 Token 数:同样的提示词 Opus 计 1.51 倍的输入 Token,默认档位下又写出 2.02 倍的输出。
测试经 laozhang.ai 网关用同一个 key 发出,两边各用自家的原生请求格式:Opus 走 Anthropic Messages,开自适应思考并显式传 medium(API 默认值)或 high;Astra 走 Chat Completions,一组不传 reasoning_effort,一组传 high。没有系统提示词,不带工具,流式返回。8 道题是一道应用题、三道带隐藏测试的函数题(merge_intervals、parse_duration、top_words)、把一篇 6,723 词的英文文章压成正好 5 条要点、不用 eval 的表达式求值器(25 个隐藏测试)、不用 csv 模块的 CSV 行解析器(16 个隐藏测试)和一道数位和计数题,后三道各问两次。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
| 配置 | 通过 | 输入 Token | 输出 Token | 按标价的花费 | 总耗时 |
|---|---|---|---|---|---|
Opus 5.5 medium(API 默认) | 11/11 | 17,202 | 11,056 | $0.2899 | 126.1 秒 |
Opus 5.5 high | 11/11 | 17,202 | 11,968 | $0.3082 | 147.2 秒 |
| GPT-6 Astra 不传 effort | 11/11 | 11,407 | 5,471(其中推理 1,964) | $0.4129 | 91.8 秒 |
GPT-6 Astra high | 11/11 | 11,407 | 9,455(其中推理 6,042) | $0.6121 | 141.7 秒 |
44 个答案全部通过,所以这组数字比的是 Token、花费和时间,不能拿来排谁更聪明。Opus 的输出 Token 含思考部分,但接口不单独报出。Astra 两组的花费都包含长文章那道题上被计费的一次缓存写入,比按普通输入价多出 $0.0253;去掉这笔,Opus 仍然更便宜(0.75 倍和 0.53 倍)。11 个单元里只有第一次 CSV 解析器那道,Astra 不传 effort 比 Opus medium 便宜($0.0173 对 $0.0227)。这组测试只覆盖一个网关、一天、每格 1–2 个样本,耗时包含网关;任务短而明确,没有工具调用和多轮代理循环,长时间的代理任务要看下文 Artificial Analysis 的数据。
同一段中文,Opus 要多计 50% 的输入 Token
同样的中文文字,Opus 5.5 计出的输入 Token 是 GPT-6 Astra 的 1.50 倍,所以按标价算,中文输入实际只便宜 40%,不是 60%。下表是同一段文字配同一句指令、减去只发指令时的基数后的计数,Opus 在 2026 年 11 月 11 日测,Astra 在 11 月 4 日测,短段落约 250–800 个字符:
| 文本 | Opus 5.5 | GPT-6 Astra | Token 比 | 输入花费比(Opus ÷ Astra) |
|---|---|---|---|---|
| 中文段落 | 247 | 165 | 1.50 倍 | 0.60 倍 |
| 英文段落 | 199 | 137 | 1.45 倍 | 0.58 倍 |
| 日文段落 | 312 | 254 | 1.23 倍 | 0.49 倍 |
| 韩文段落 | 396 | 208 | 1.90 倍 | 0.76 倍 |
| 俄文段落 | 302 | 193 | 1.56 倍 | 0.63 倍 |
| 西班牙文段落 | 304 | 162 | 1.88 倍 | 0.75 倍 |
| 6,723 词英文文章 | 15,335 | 10,106 | 1.52 倍 | 0.61 倍 |
| 146 KB 应用日志 | 78,537 | 55,843 | 1.41 倍 | 0.56 倍 |
输入花费比 = Token 比 × 0.4($4 ÷ $10)。所以同样的输入,Opus 只便宜 24%–51%,韩文和西班牙文最少,日文最多。这张表只管输入;输出写多少由任务决定,上一节的小题里 Opus 的输出是 Astra 的 1.27–2.02 倍。缓存读取的差距更大:Opus 每百万 Token $0.20,Astra $1.00,乘上 1.50 倍的中文 Token 比,从缓存重读同一段中文时 Opus 只要 Astra 的 0.30 倍。
长日志、长文档:首次调用 Opus 便宜,重复调用看缓存
一次性丢进一份长日志或长文档,Opus 5.5 的首次调用比 GPT-6 Astra 便宜三到四成;但同一段长提示词在 Astra 的缓存时效内再调一次,Astra 反而更便宜,除非你给 Opus 也开了缓存。测试用的是一份 146 KB、1,500 行的合成应用日志,其中 326 行 ERROR,要求给出 7 个准确值:5 个错误码各自的次数、遇到 E503 的不同用户数、重试次数最高的那个请求,答案在调用前由脚本算好。
Opus 在 2026 年 11 月 11 日跑了 4 次(medium、high 各两次),4 次全对,每次 55.7–59.0 秒,78,537 个输入 Token 加 7,699–8,255 个输出 Token,每次 $0.47–0.48。Astra 不传 effort 跑了 3 次(11 月 4 日两次、11 月 11 日一次),全对,26.3–46.4 秒,55,843 个输入 Token 加 2,423–3,793 个输出 Token;不走缓存时 $0.75,被计一次缓存写入时 $0.82,从缓存读取时 $0.21。Astra high 在 11 月 4 日跑了两次,全对,71.7–77.5 秒,不走缓存 $0.90,走缓存 $0.34。首次调用 Opus 是 Astra 默认的 57%–64%;但 Astra 在缓存内重复一次只要 $0.21,低于 Opus 不开缓存的 $0.47。
两家缓存的默认行为不同,这决定了重复调用谁便宜。OpenAI 默认缓存 Astra 1,024 Token 以上的提示词,默认 30 分钟档的写入按输入价 1.25 倍计费,读取按 0.1 倍;不想要可以设 prompt_cache_options.mode: "explicit"。11 月 4 日的两次没有被计写入费,11 月 11 日那次被计了,是网关还是 OpenAI 一侧的差别无法判断。Claude API 只有请求里带 cache_control 才缓存,写入按输入价 1.25 倍(5 分钟)或 2 倍(1 小时),读取按 0.05 倍。这次没给 Opus 开缓存,所以 Opus 的缓存重复调用没有实测;按标价算,78,537 个 Token 从缓存读取约 $0.016,加上这次 7,699–8,255 个输出 Token 的 $0.154–0.165,约 $0.17–0.18,而带 5 分钟缓存写入的首次调用输入费从 $0.31 涨到 $0.39,整次约 $0.55–0.56。
更长的输入还有一道 Astra 独有的门槛:单次请求输入超过 272K Token,整次请求按输入 $20、输出 $75 计价,Opus 在 1M 上下文内始终是同一个价。举个算例,一份 Astra 计为 300K Token 的中文材料,Astra 的输入费是 $6.00;Opus 按 1.50 倍计约 450K Token,输入费 $1.80。Astra 的 272K 分界、两档缓存写入和 Batch、Fast 等档位,在《GPT-6 Astra API 定价与成本计算:价格表、272K 与两档缓存写入》里有完整算法。
推理强度怎么对应:按同分配对,不按同名档位
两家的推理强度都叫 low、medium、high、xhigh、max,但同名档位不是同样的工作量。按 Artificial Analysis 智能指数 v5.0.1(截至 2026 年 11 月 12 日)的数据配对,Opus high 只对得上 Astra medium,Opus xhigh 对得上 Astra max。默认值也不对称:Opus 的 Claude API 和 Claude Code 默认都是 medium;OpenAI 文档没有写 Astra 的默认档位,Astra 也不支持 none 和 minimal,所以上面实测里 Astra 的"默认"指不传 effort。
AA 的指数题是多领域的长任务,下表里每题平均要跑 3 到 25 分钟,两边都按官方标价计费。数据来自 Artificial Analysis 的 Claude Opus 5.5 与 GPT-6 Astra 版本对比页:
| 档位 | Opus 5.5 得分 | Opus 每题花费 | Opus 每题分钟 | Astra 得分 | Astra 每题花费 | Astra 每题分钟 | 花费比 Opus ÷ Astra |
|---|---|---|---|---|---|---|---|
low | 35 | $0.98 | 3.0 | 43 | $1.42 | 4.0 | 0.69 |
medium | 48 | $2.45 | 7.1 | 52 | $2.73 | 7.3 | 0.90 |
high | 52 | $3.46 | 9.5 | 55 | $3.24 | 9.5 | 1.07 |
xhigh | 57 | $6.05 | 15.8 | 55 | $3.66 | 11.1 | 1.65 |
max | 59 | $10.04 | 25.0 | 57 | $6.24 | 24.3 | 1.61 |
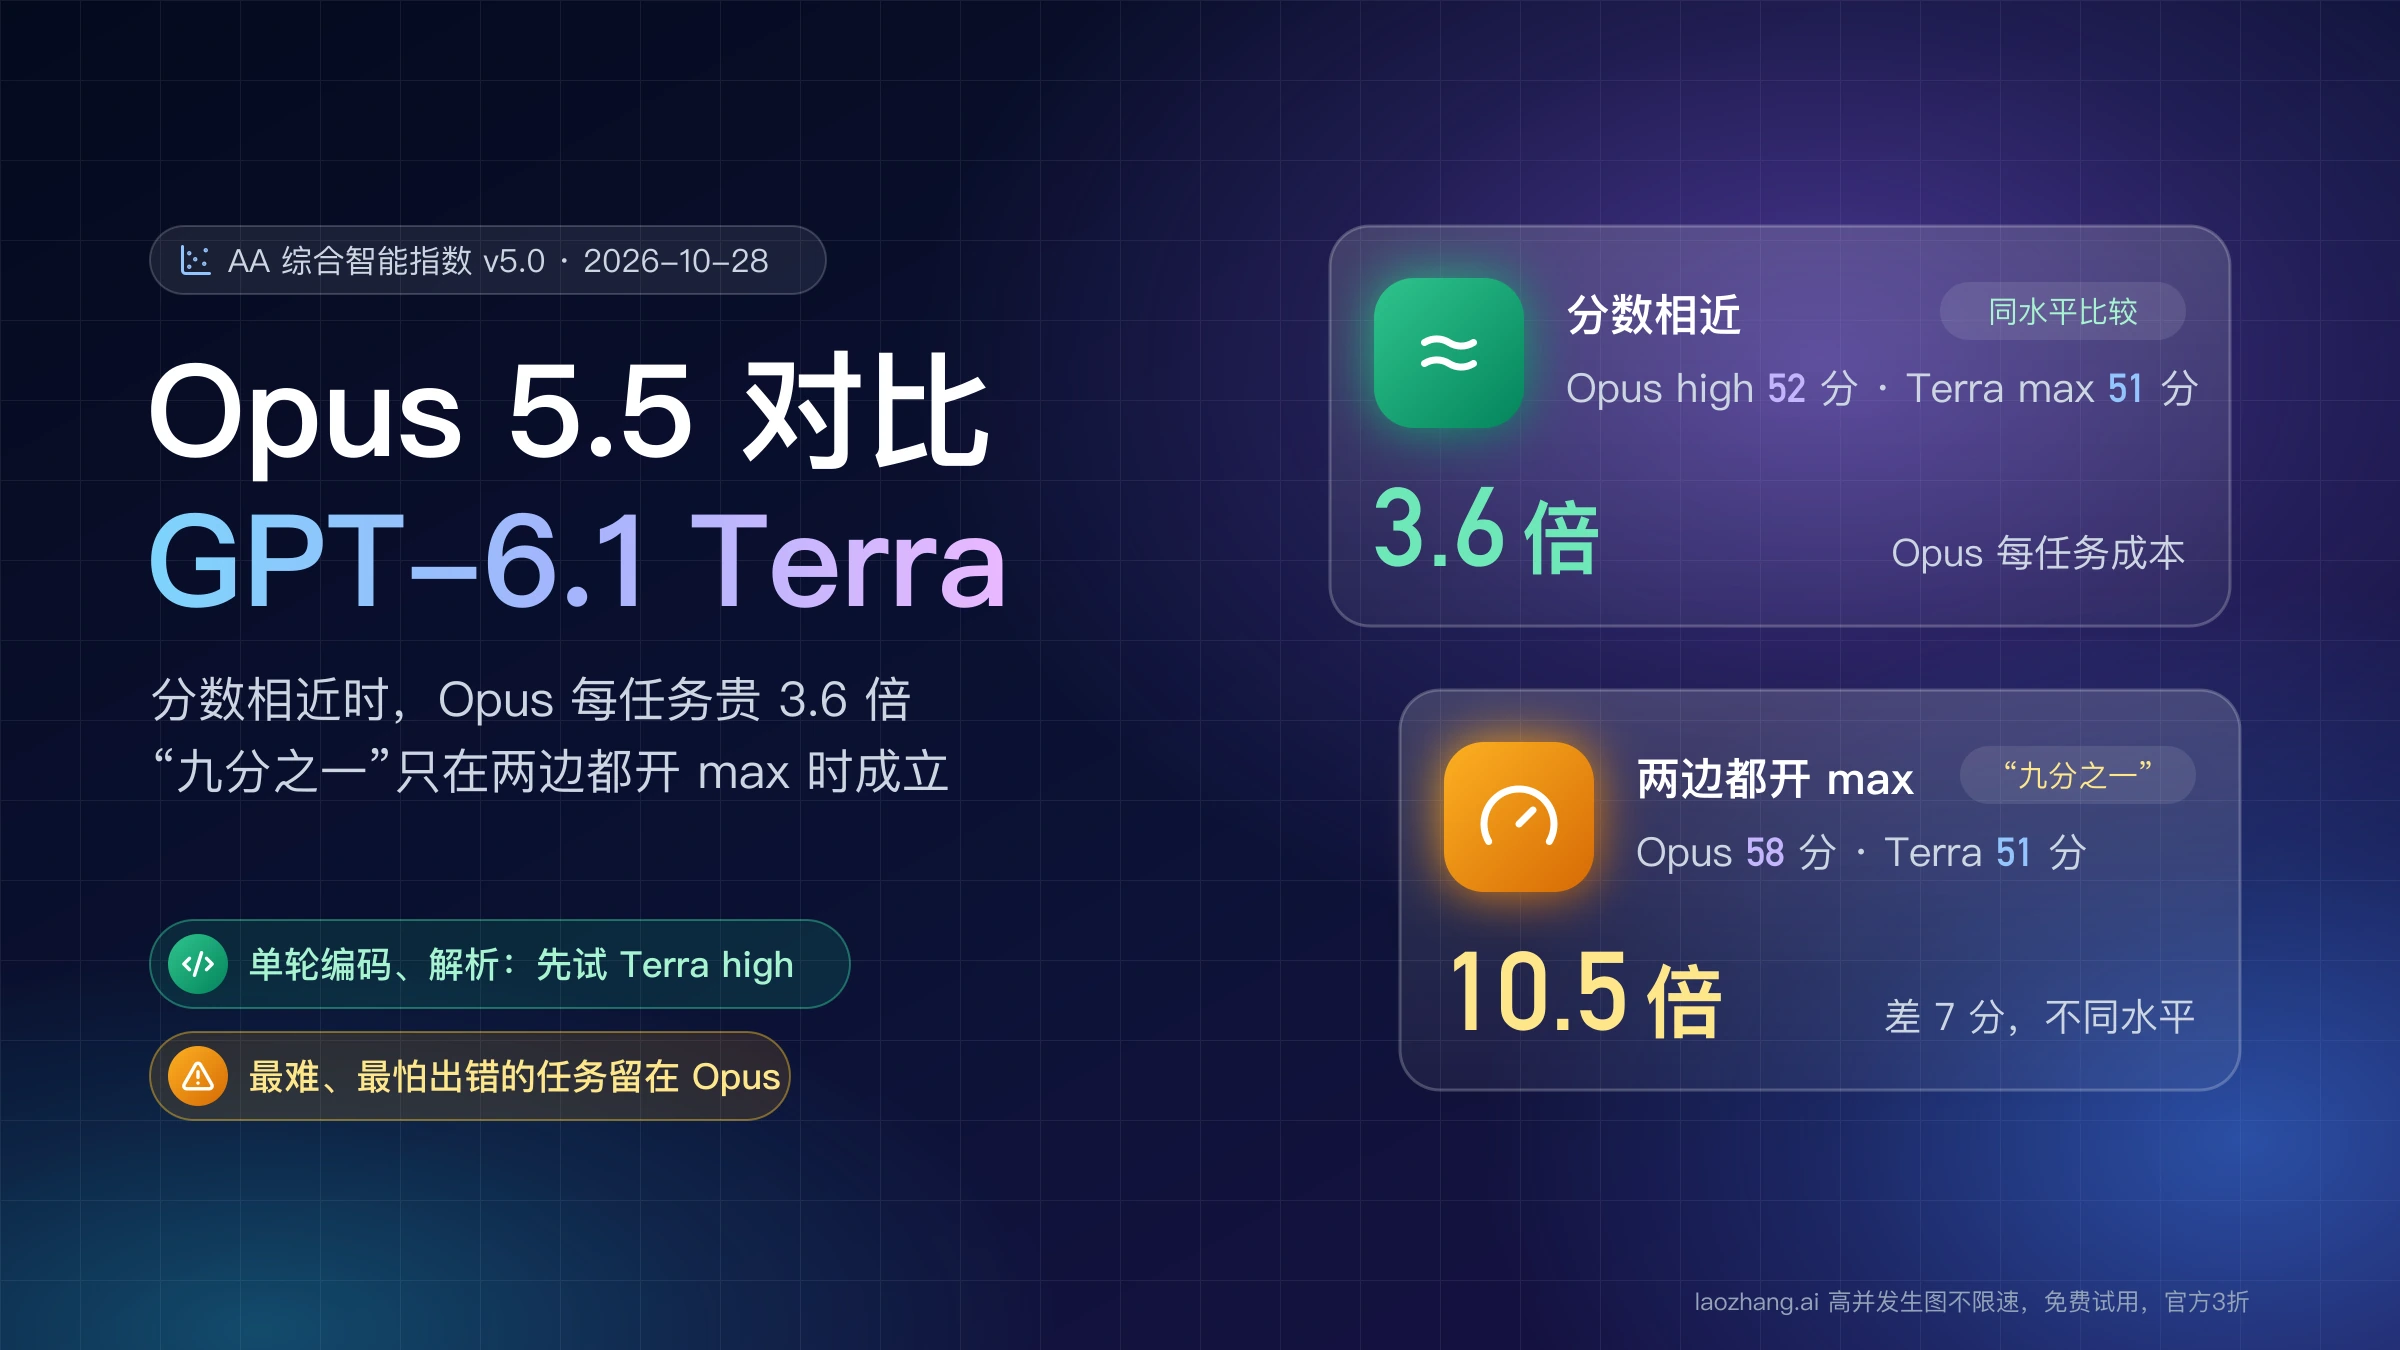
同名档位比,low、medium、high 是 Astra 高 8、4、3 分,xhigh 和 max 是 Opus 高 2 分;花费比在 0.69 到 1.65 倍之间,没有一档接近标价的 0.40 倍。按同分配对更说明问题:52 分是 Opus high($3.46、9.5 分钟)对 Astra medium($2.73、7.3 分钟),Astra 便宜 21% 也更快;Astra high 拿 55 分只要 $3.24,比 Opus high 高 3 分还便宜 6%;57 分是 Opus xhigh($6.05、15.8 分钟)对 Astra max($6.24、24.3 分钟),Opus 便宜 3%、快 35%。两头只有一边:59 分只有 Opus max($10.04),43 分以下只有 Opus low(35 分、$0.98)。
由此还能反推 Token 用量。如果两边用的 Token 一样多,Opus 的花费应是 Astra 的 0.40 倍;实际是 0.69 到 1.65 倍,说明在 AA 的任务上,Opus 按价格加权的 Token 用量约是 Astra 的 1.7 倍(low)到 4.1 倍(xhigh)。这是用花费比除以 0.40 得出的估算,前提是两边输入、输出、缓存的比例相近,不是实测。
Reddit 和 X 上的同题对比:开放式构建多是 Opus 那次更贵
网上晒出的同题对比,多数是让两个模型从零做一个游戏、网站或原型,这类开放式构建里 Opus 5.5 常被评为做得更好,同时跑得更久、花得更多。MindStudio 在 9 月 24 日的对比里写道,纯看产出质量 Opus 赢,但 Astra 更快也更便宜,32 分钟、$11.33 完成;Moe Lueker 在 9 月 25 日用同一提示词做了两次游戏,Opus 两次都做得最好,但花费是 $15.25 对 Astra 的 $7.09。X 用户 EnvolDev 约在 11 月 9 日贴出 Opus $60.89、2 小时 19 分 35 秒,Astra $16.89、34 分 06 秒,并说 Astra 远不如 Opus;Nate Herk 在 LinkedIn 上总结 12 个使用场景,Astra 少用 45% 的时间,按估算的 API 费用便宜约 38%。
反方向的说法也有。r/ClaudeCode 一个问"如果 Token 不限量,你选 Opus 5.5 还是 GPT-6 Astra"的讨论帖里,高赞评论说在一个 Astra 反复打转的问题上烧了约 $5,000,换 Opus 不到 $100 就解决了。r/claudeskills 也有人专门问做游戏开发该选哪个。这些金额出自各自作者的那几句话,档位、提示词和运行工具都不相同,只能说明"有人这样跑出过这样的账单",不是模型本身的固定差价。
把它们和前面的实测放在一起,两种说法就对得上了。Opus 的单价是 Astra 的 0.4 倍,只要它按价格加权的 Token 用量不到 Astra 的 2.5 倍,就是 Opus 便宜。边界清楚的小任务和长日志上这个倍数是 1.3–1.8,所以 Opus 省钱;开放式构建没有终点,Opus 倾向于继续打磨、跑得更久,倍数越过 2.5,那一次就是 Opus 更贵。反过来,如果一个模型卡住反复重试,失败本身的花费会压过单价,r/ClaudeCode 那条评论说的就是这种情况。
写代码选哪个:中档 Astra 领先 FrontierCode,Opus 领先 Terminal-Bench
只看编程类评测,两者各领一项,而且领先方随推理强度变。按 Artificial Analysis v5.0.1(截至 2026 年 11 月 12 日),Terminal-Bench 4.0 上 Opus 在 medium(52.5% 对 49.5%)和 high(56.6% 对 54.0%)领先,xhigh 两边都是 59.6%;FrontierCode-AA 2.0 上反过来,medium 和 high 是 Astra 领先(36.6% 对 33.1%、40.1% 对 35.9%),到 xhigh 才换成 Opus 领先(43.8% 对 41.4%)。AA 的 Engineering 分项也是这个形状:low、medium、high 三档 Astra 是 50、57、60,Opus 是 43、54、58;xhigh 和 max 换成 Opus 63、65 对 Astra 60、62。
放到工具里看:Claude Code 默认就是 Opus medium,这一档 Opus 的 Engineering 分项比 Astra 同档低 3 分。如果你的编程工作是长时间的代理式改代码,又只打算开到中档,Astra high 是更稳的起点;预算允许把 Opus 开到 xhigh,它在这两项编程评测上就不输 Astra 的任何一档。写一个明确的函数这种小活分不出高下:前面实测里的 5 道编程题共 77 个隐藏测试,两个模型在所有配置下都全部通过,这时按花费选 Opus medium 就够了。
跑分怎么看:Anthropic 发布表和 Artificial Analysis 对不上
Opus 5.5 的跑分有两份来源,结论不完全一致。一份是 Anthropic 在 2026 年 9 月 22 日发布 Opus 5.5 时自己公布的对比表,另一份是 Artificial Analysis 用同一套流程独立测的两边各档成绩;OpenAI 没有发布过对 Opus 5.5 的对比表。下表每格是 Opus 5.5 / GPT-6 Astra,Anthropic 一栏除注明外 Opus 用 max,来源是 Anthropic 的 Claude Opus 5.5 发布页和上文的 AA 对比页:
| 评测 | Anthropic 发布表(2026 年 9 月 22 日) | AA v5.0.1 max(截至 11 月 12 日) |
|---|---|---|
| Terminal-Bench 4.0 | 66.4% / 57.9%(Opus xhigh、Astra high,各取最高分) | 59.6% / 59.1% |
| FrontierCode | v1.1:54.4% / 53.3% | AA 2.0:46.4% / 42.4% |
| AutomationBench | 40.0% / 41.4%(由 Zapier 运行) | AutomationBench-AA:69.5% / 68.5% |
| Humanity's Last Exam | 带工具:67.7% / 57.2% | HLE-Diamond:67.9% / 63.8% |
| Terminal-Bench-Science 0.1 | 58.7% / 64.6% | 59.0% / 63.3% |
| GDPval-AA v2.1 | 1846 / 1542 | — |
| AA-Briefcase v1.1 | — | 1801 / 1569 |
| CritPt v2(Hard) | — | 68.0% / 70.5% |
| GDP.pdf | — | 26.2% / 31.0% |
Anthropic 表里 Astra 的 Terminal-Bench 成绩取自 OpenAI 公布的数字,Opus 一项的标准误是 ±2.6 个百分点;Terminal-Bench-Science 的标准误是 ±3.5–5 个百分点,和两边 5.9 个百分点的差距相近。往下看各档,AA 里有两类稳定的领先。CritPt 这类科研推导题和 GDP.pdf,Astra 每一档都领先,high 档 CritPt 是 59.5% 对 71.5%;Terminal-Bench-Science 除 xhigh(Opus 61.9% 对 54.8%)外也是 Astra 领先。AA-Briefcase 这项知识工作交付评测(Elo 式分数,不是百分比)则是 Opus 每一档都领先,high 档是 1682 对 1505。
两份数据最大的分歧在成本上。Anthropic 在发布页写,Opus 在默认推理强度下做 FrontierCode 能以大约 20% 的单任务成本胜过 Astra,在 Terminal-Bench 4.0 上以约 40% 的成本追平,medium 档的 FrontierCode v1.1 得分 54.6%,高于 Astra 最好的 53.3%。AA 的数字则是 Opus medium 花 Astra medium 九成的钱、低 4 分,FrontierCode-AA 2.0 上 Opus medium 只有 33.1%,Astra max 是 42.4%。评测版本、运行框架和安全机制不同能解释一部分,但两边都没有说明差距从哪来,也不能说哪个数字错了。Anthropic 自己在同一篇文章里也写到,跑分差距越来越不能代表实际使用中的差别。如果你的工作是长时间、多步骤的代理任务,AA 统一流程下的结果更接近你会遇到的情况;Anthropic 的表反映的是 Opus 在厂商选定设置下的上限。
还有一个影响跑分和实际使用的细节:Opus 5.5 的安全机制会把网络安全类任务交给 Opus 4.8、把部分生物和前沿大模型相关任务交给 Opus 5 处理,这是 Anthropic 发布说明里写明的;AA 给 Opus max 这一行标注了"Max, Default Fallback",对应的就是这套默认转交。
哪个更快:Opus 出字快 2.5 倍以上,做完不一定更快
按出字速度算,Opus 5.5 明显更快;按做完一件事的时间算,要看它写了多少。AA v5.0.1 测的流式输出速度,Opus 每秒 103–116 个 Token,Astra 36–41 个,同档相比 Opus 是 Astra 的 2.5–3.2 倍;OpenRouter 对比页约 11 月 4 日的数据是每秒 69.0 对 33.0 个 Token。但 AA 同名档位下每题耗时几乎一样(medium 7.1 对 7.3 分钟,high 都是 9.5 分钟),因为 Opus 写得更多。
前面的小题实测里,整组题反而是 Astra 不传 effort 先做完(91.8 秒对 Opus medium 的 126.1 秒),两边开 high 时接近(141.7 对 147.2 秒);长日志题 Astra 默认 26–46 秒,Opus 56–59 秒,Astra high 72–78 秒。首个可见文字的中位时间,Opus 是 6.0–6.5 秒,Astra 不传 effort 5.0 秒、high 7.4 秒。AA 测的首个回答 Token 时间在 high 档差得更多:Opus 21.92 秒,Astra 57.78 秒。所以交互式问答、需要尽快看到回答时,Opus high 比 Astra high 更跟手;批量跑短任务、看总完成时间时,Astra 不传 effort 更快。
先排除再比较:会直接决定选哪个的 7 个条件
下面这几种情况一旦成立,就不用先比质量,答案已经偏向其中一个。逐条对照自己的工作:
- 单次请求的输入经常超过 272K Token,就倾向 Opus,因为 Astra 整次请求会按输入 $20、输出 $75 计价,Opus 在 1M 上下文内不涨价。
- 现有代码走 Chat Completions 又要用函数调用,Astra 就得先迁移到 Responses API,因为它的函数调用只在 Responses API 上可用;不想迁移就用 Opus。
- 需要数据驻留时,把 Astra 区域处理端点加价 10% 算进它的成本,再和 Opus 比。
- 任务涉及网络安全时先试 Astra,因为 Opus 5.5 会把这类请求交给 Opus 4.8 处理(部分生物和前沿大模型相关任务交给 Opus 5),你实际拿到的不是 Opus 5.5。
- 输入以韩文或西班牙文为主时,Opus 要多计 88%–90% 的输入 Token,输入只便宜约 25%,单价优势大半被吃掉;中文是多计 50%。
- 同一段长提示词要反复调用、又不打算改代码加
cache_control时,Astra 默认就缓存,重复调用更便宜;愿意给 Opus 加缓存,它的缓存读取单价只有 Astra 的五分之一。 - 主要工作是科研计算和精确推导时倾向 Astra,它在 AA 的 CritPt 和 Terminal-Bench-Science 上几乎每档领先;以报告、文档这类知识工作交付为主则倾向 Opus,它在 AA-Briefcase 上每档领先。
用自己的任务重算:Opus 的 Token 量低于 Astra 2.5 倍就更便宜
自己重算只需要一条规则:Opus 5.5 的输入和输出单价都是 GPT-6 Astra 的 0.4 倍,所以只要 Opus 在你的任务上按价格加权的 Token 用量不到 Astra 的 2.5 倍,Opus 就更便宜。前面的数字都可以套进这条规则:小题实测里这个倍数约 1.76(0.70 ÷ 0.40),两边开 high 时约 1.26,长日志题约 1.4–1.6;AA 长任务上推算出的 1.7–4.1 倍横跨了 2.5,所以那里两边互有胜负。缓存会改变这个分界,因为 Opus 的缓存读取单价是 Astra 的 0.2 倍而不是 0.4 倍,缓存读得越多,Opus 能多用的 Token 就越多。
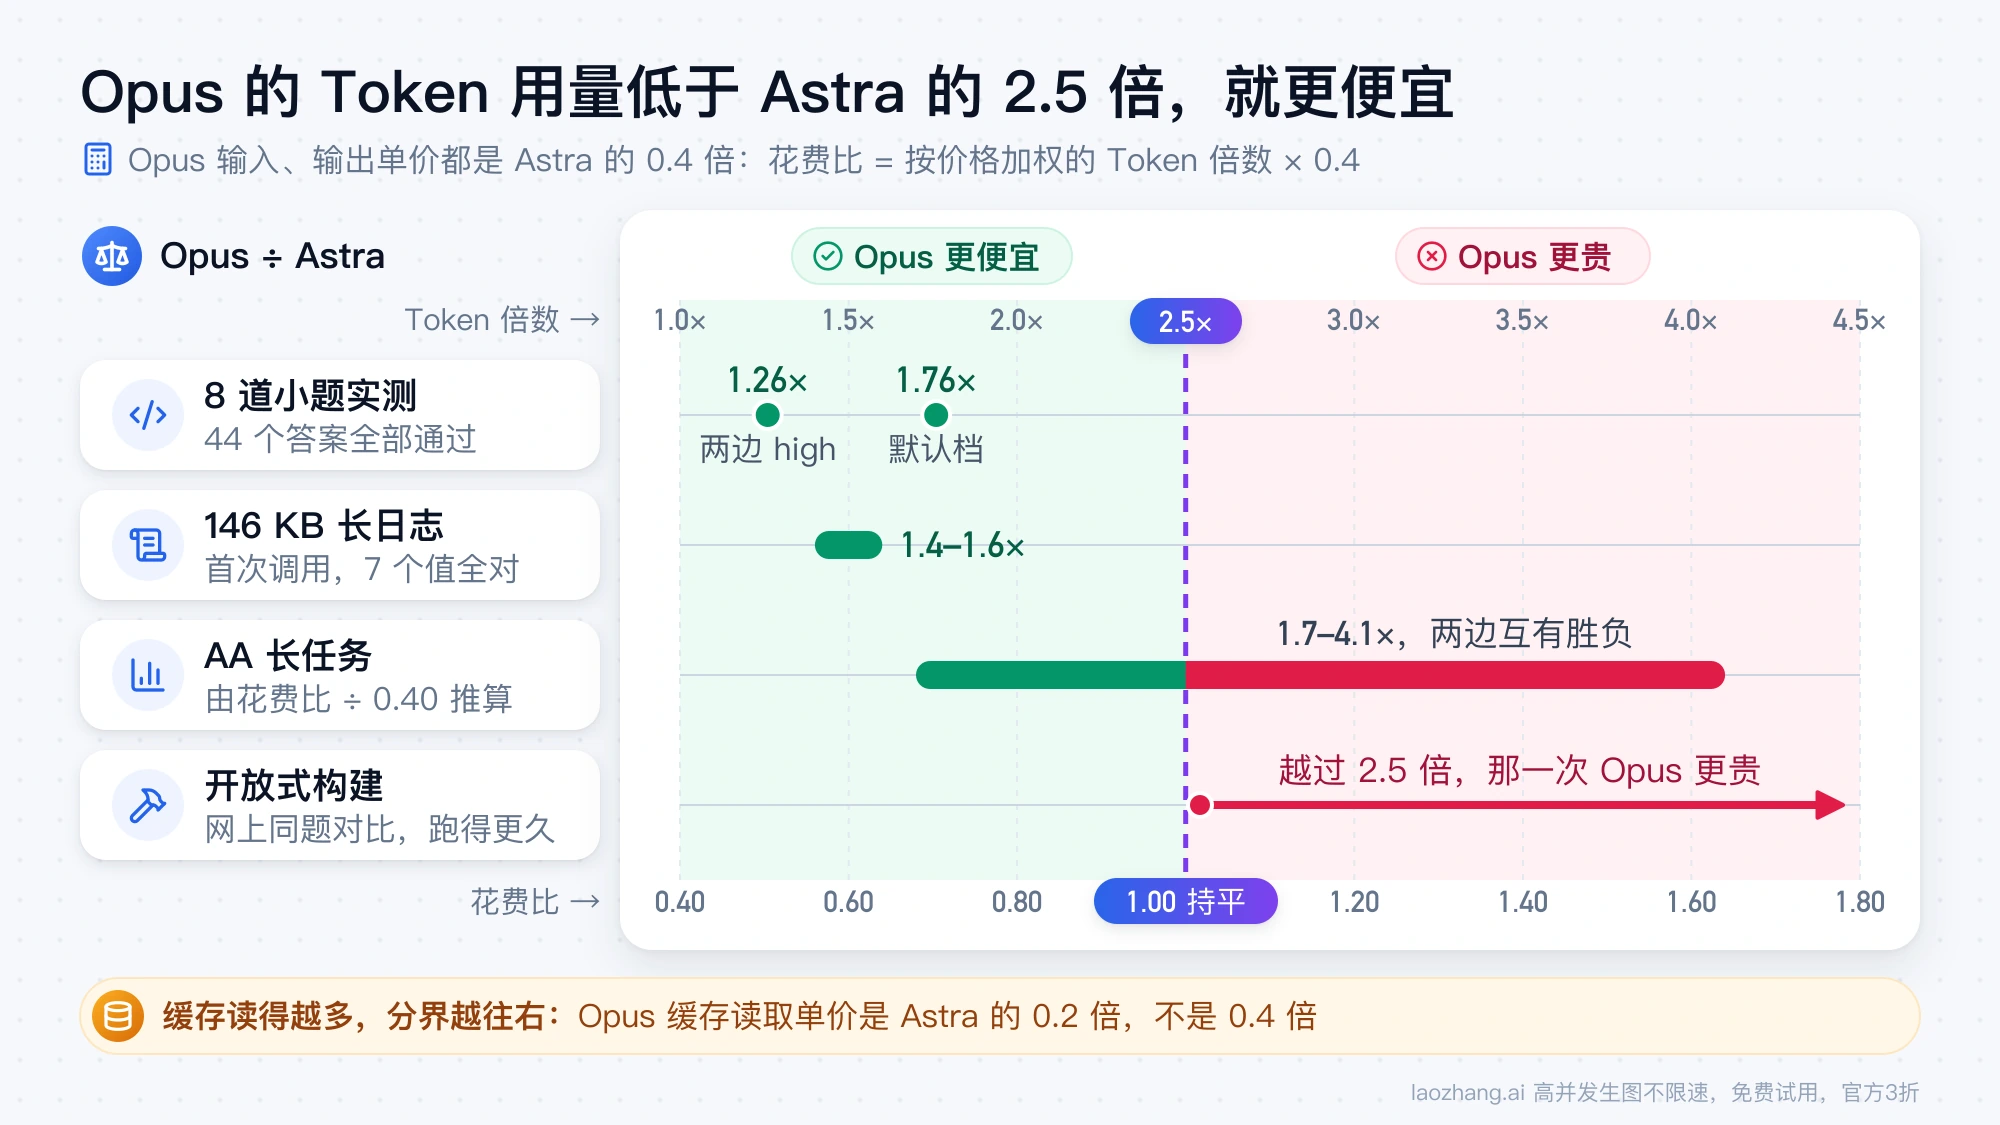
用自己的任务复核,按这个顺序做:
- 从你的实际工作里挑 10–20 个能自动判对错的任务,比如有测试的函数、有标准答案的抽取或计数,中文任务和英文任务分开放。
- 两边各跑一遍:Opus
medium和 Astra 不传 effort;打算用更高档时,再加 Opusxhigh和 Astrahigh。每次记下响应里返回的输入、输出、缓存读取和缓存写入 Token 数。 - 只统计通过的答案,按当日标价算出每个通过任务的花费。截至 2026 年 11 月 12 日,Opus 输入 $4、输出 $20、缓存读取 $0.20、5 分钟缓存写入 $5;Astra 输入 $10、输出 $50、缓存读取 $1.00、30 分钟缓存写入 $12.50,价格以 Claude API 定价文档和 OpenAI API 定价页当日显示为准。
- 用 Opus 的总花费除以 Astra 的总花费,低于 1 且耗时能接受就把 Opus 设成默认;高于 1,或者 Opus 没过而 Astra 过了的任务集中在某一类,就把那一类交给 Astra。
拿一个假设的中文任务演示:Astra 计 20,000 个输入 Token、写 3,000 个输出 Token,花费是 0.02 × $10 + 0.003 × $50 = $0.35。Opus 按中文 1.50 倍计 30,000 个输入 Token,输出按小题实测的 2.02 倍写 6,060 个,花费是 0.03 × $4 + 0.00606 × $20 ≈ $0.24,是 Astra 的 0.69 倍。如果这是开放式任务、Opus 写了 5 倍的输出(15,000 个),花费变成 0.12 + 0.30 = $0.42,反过来是 Astra 的 1.2 倍。
订阅里能不能用 Opus 5.5 和 Astra
订阅和 API 是两套账,两家的订阅都不包含 API 用量。截至 2026 年 11 月 6 日,Claude 免费版用不了 Opus 和 Claude Code,Pro($20/月,按年付 $17/月)、Max($100)、Ultra($200)、Team 和 Enterprise 都包含 Opus 5.5,各套餐的入口和额度见《Claude Opus 5.5 怎么用:6 个入口怎么选,免费版用不了》和《Claude Opus 5.5 价格与用量重置:API 账单怎么算,重置卡怎么用》。截至 2026 年 10 月 26 日,ChatGPT 免费版和 Go 用的是 GPT-6 Luna,不是 Astra;Plus 和标准 Business 在 Work 与 Codex 里每 5 小时约有 5–45 条 Astra 本地消息,Pro 没有 5 小时限制,Enterprise 和 Edu 要由管理员开启;哪些套餐能在普通聊天里选 Astra,OpenAI 没有公开说明。另外,截至 2026 年 11 月上旬,Anthropic 和 OpenAI 的官方支持国家和地区列表都不包括中国大陆和香港。
要不要再看 Fable 5.2 或更便宜的型号
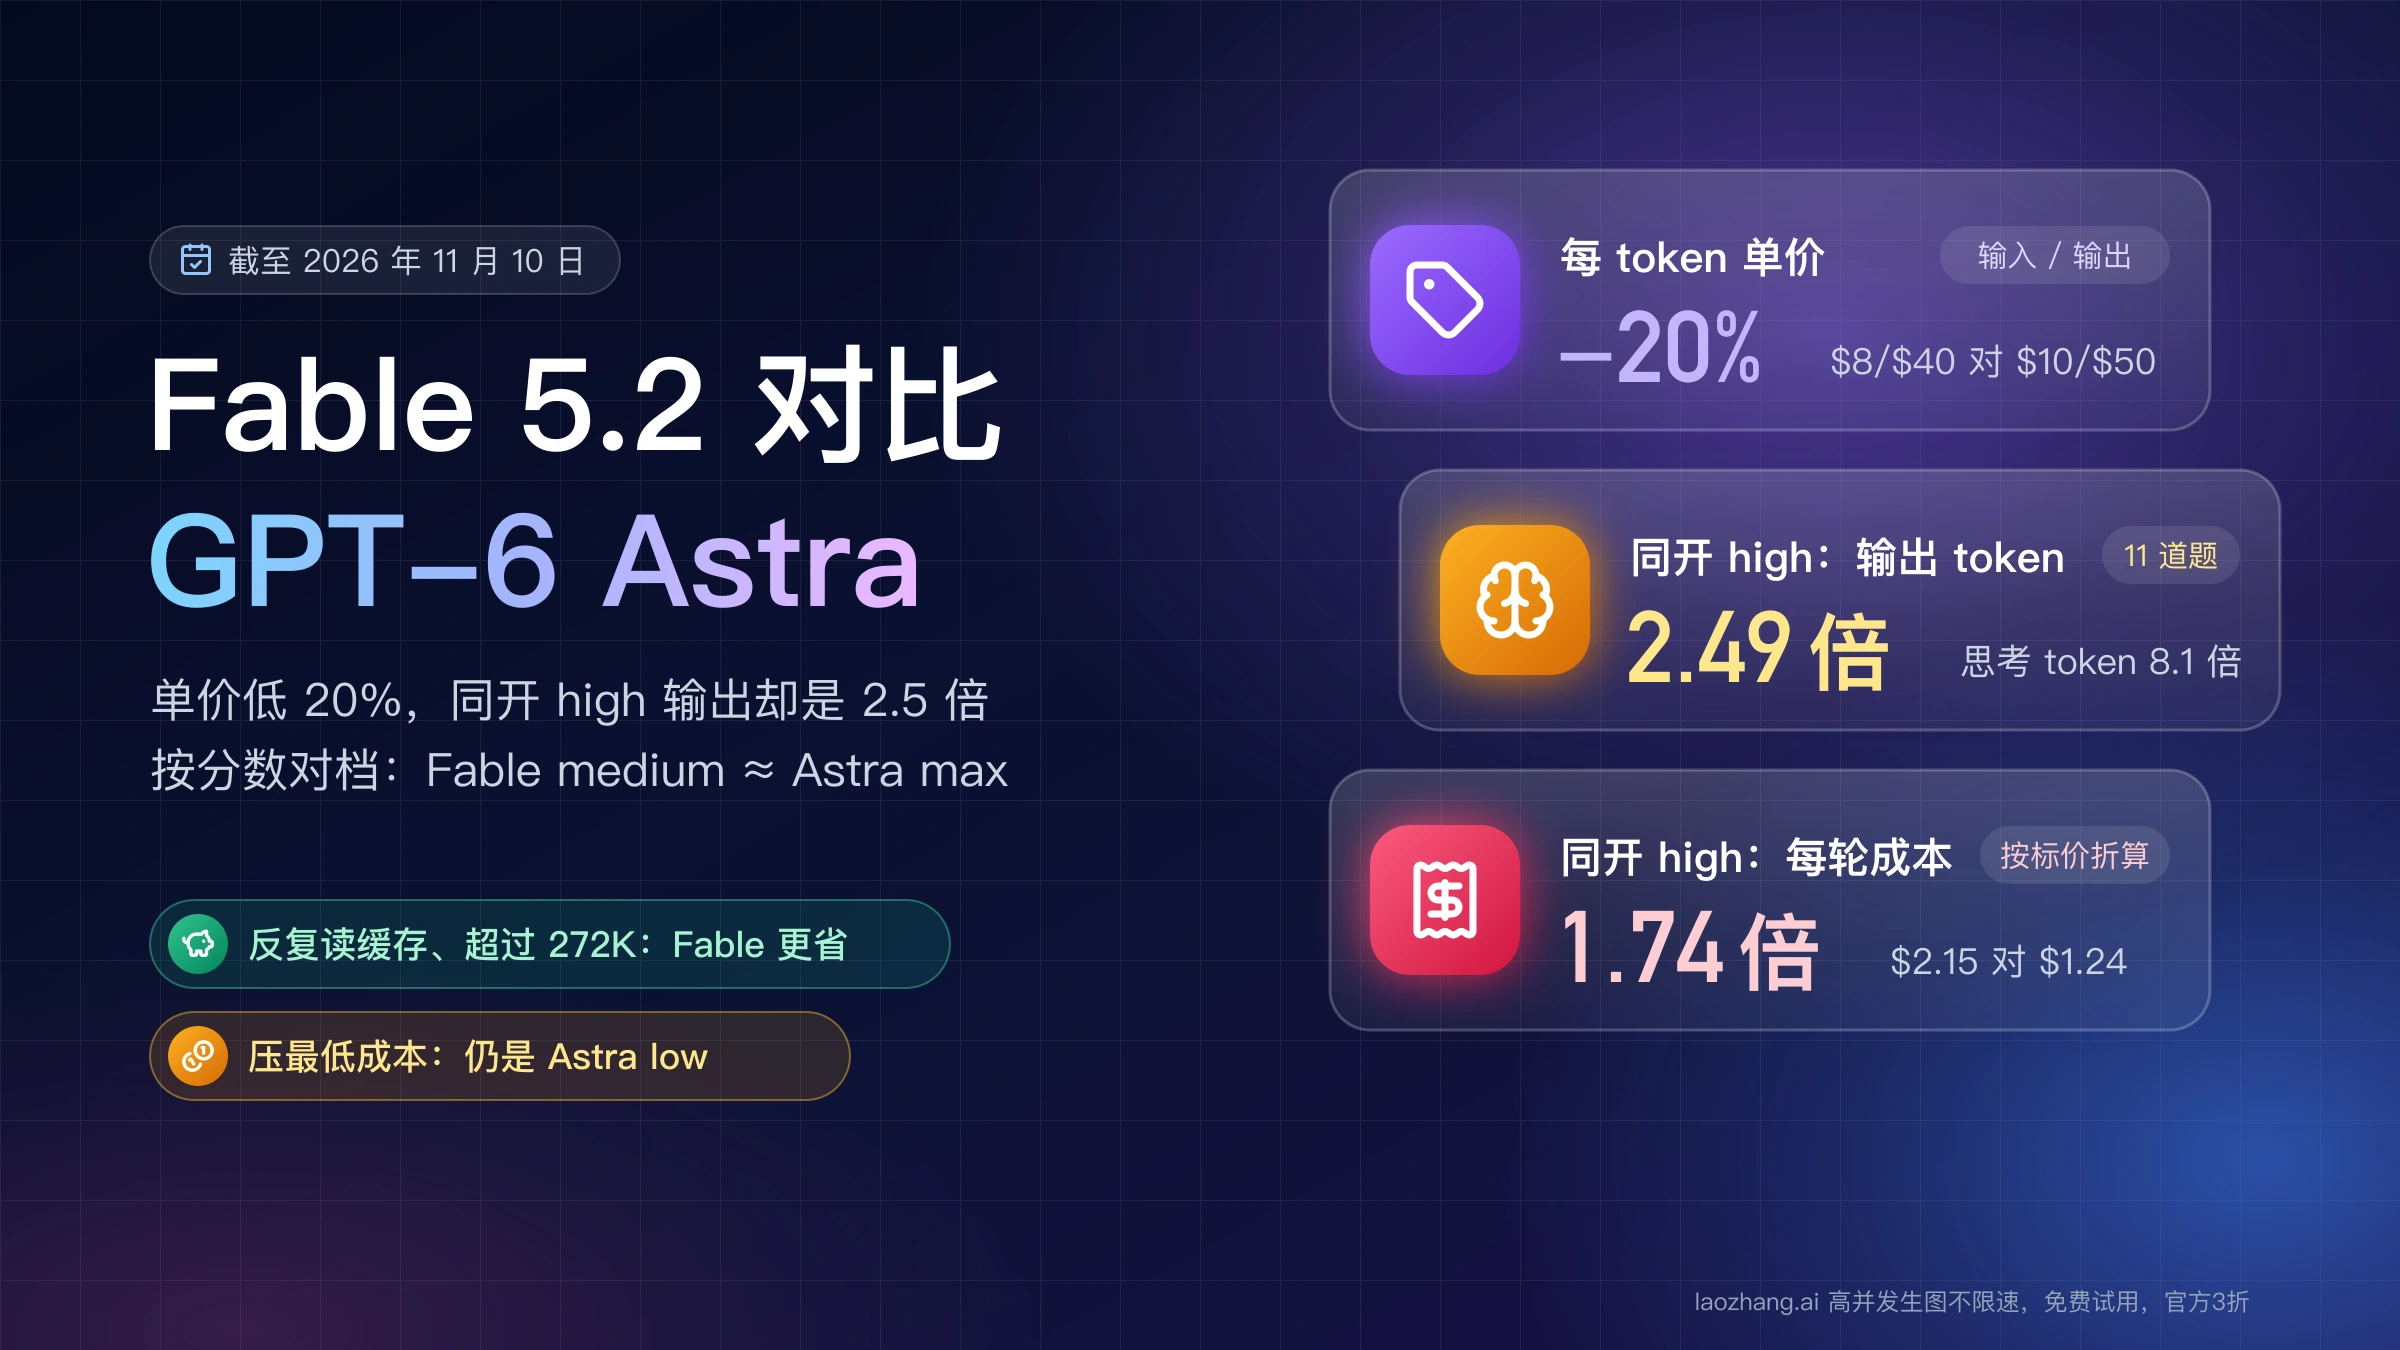
Opus 5.5 于 2026 年 9 月 22 日发布,GPT-6 Astra 于 9 月 3 日发布;搜索里的"Astra 6""GPT Astra"指的都是 GPT-6 Astra,截至 11 月 12 日 OpenAI 价格页上没有 GPT-6.2,Astra 仍是它最强的通用模型。Anthropic 那边,11 月 9 日发布的 Claude Fable 5.2($8 / $40)已经排在 Opus 5.5 之上,但 Anthropic 仍建议多数编程和知识工作从 Opus 5.5 开始,需要时再升到 Fable;两者怎么选见《Fable 5.2 和 Opus 5.5 怎么选:哪档对哪档,同题实测贵 1.86 倍》,Fable 对 Astra 见《Fable 5.2 和 GPT-6 Astra 对比:单价低 20%,同题输出却是 2.5 倍》。
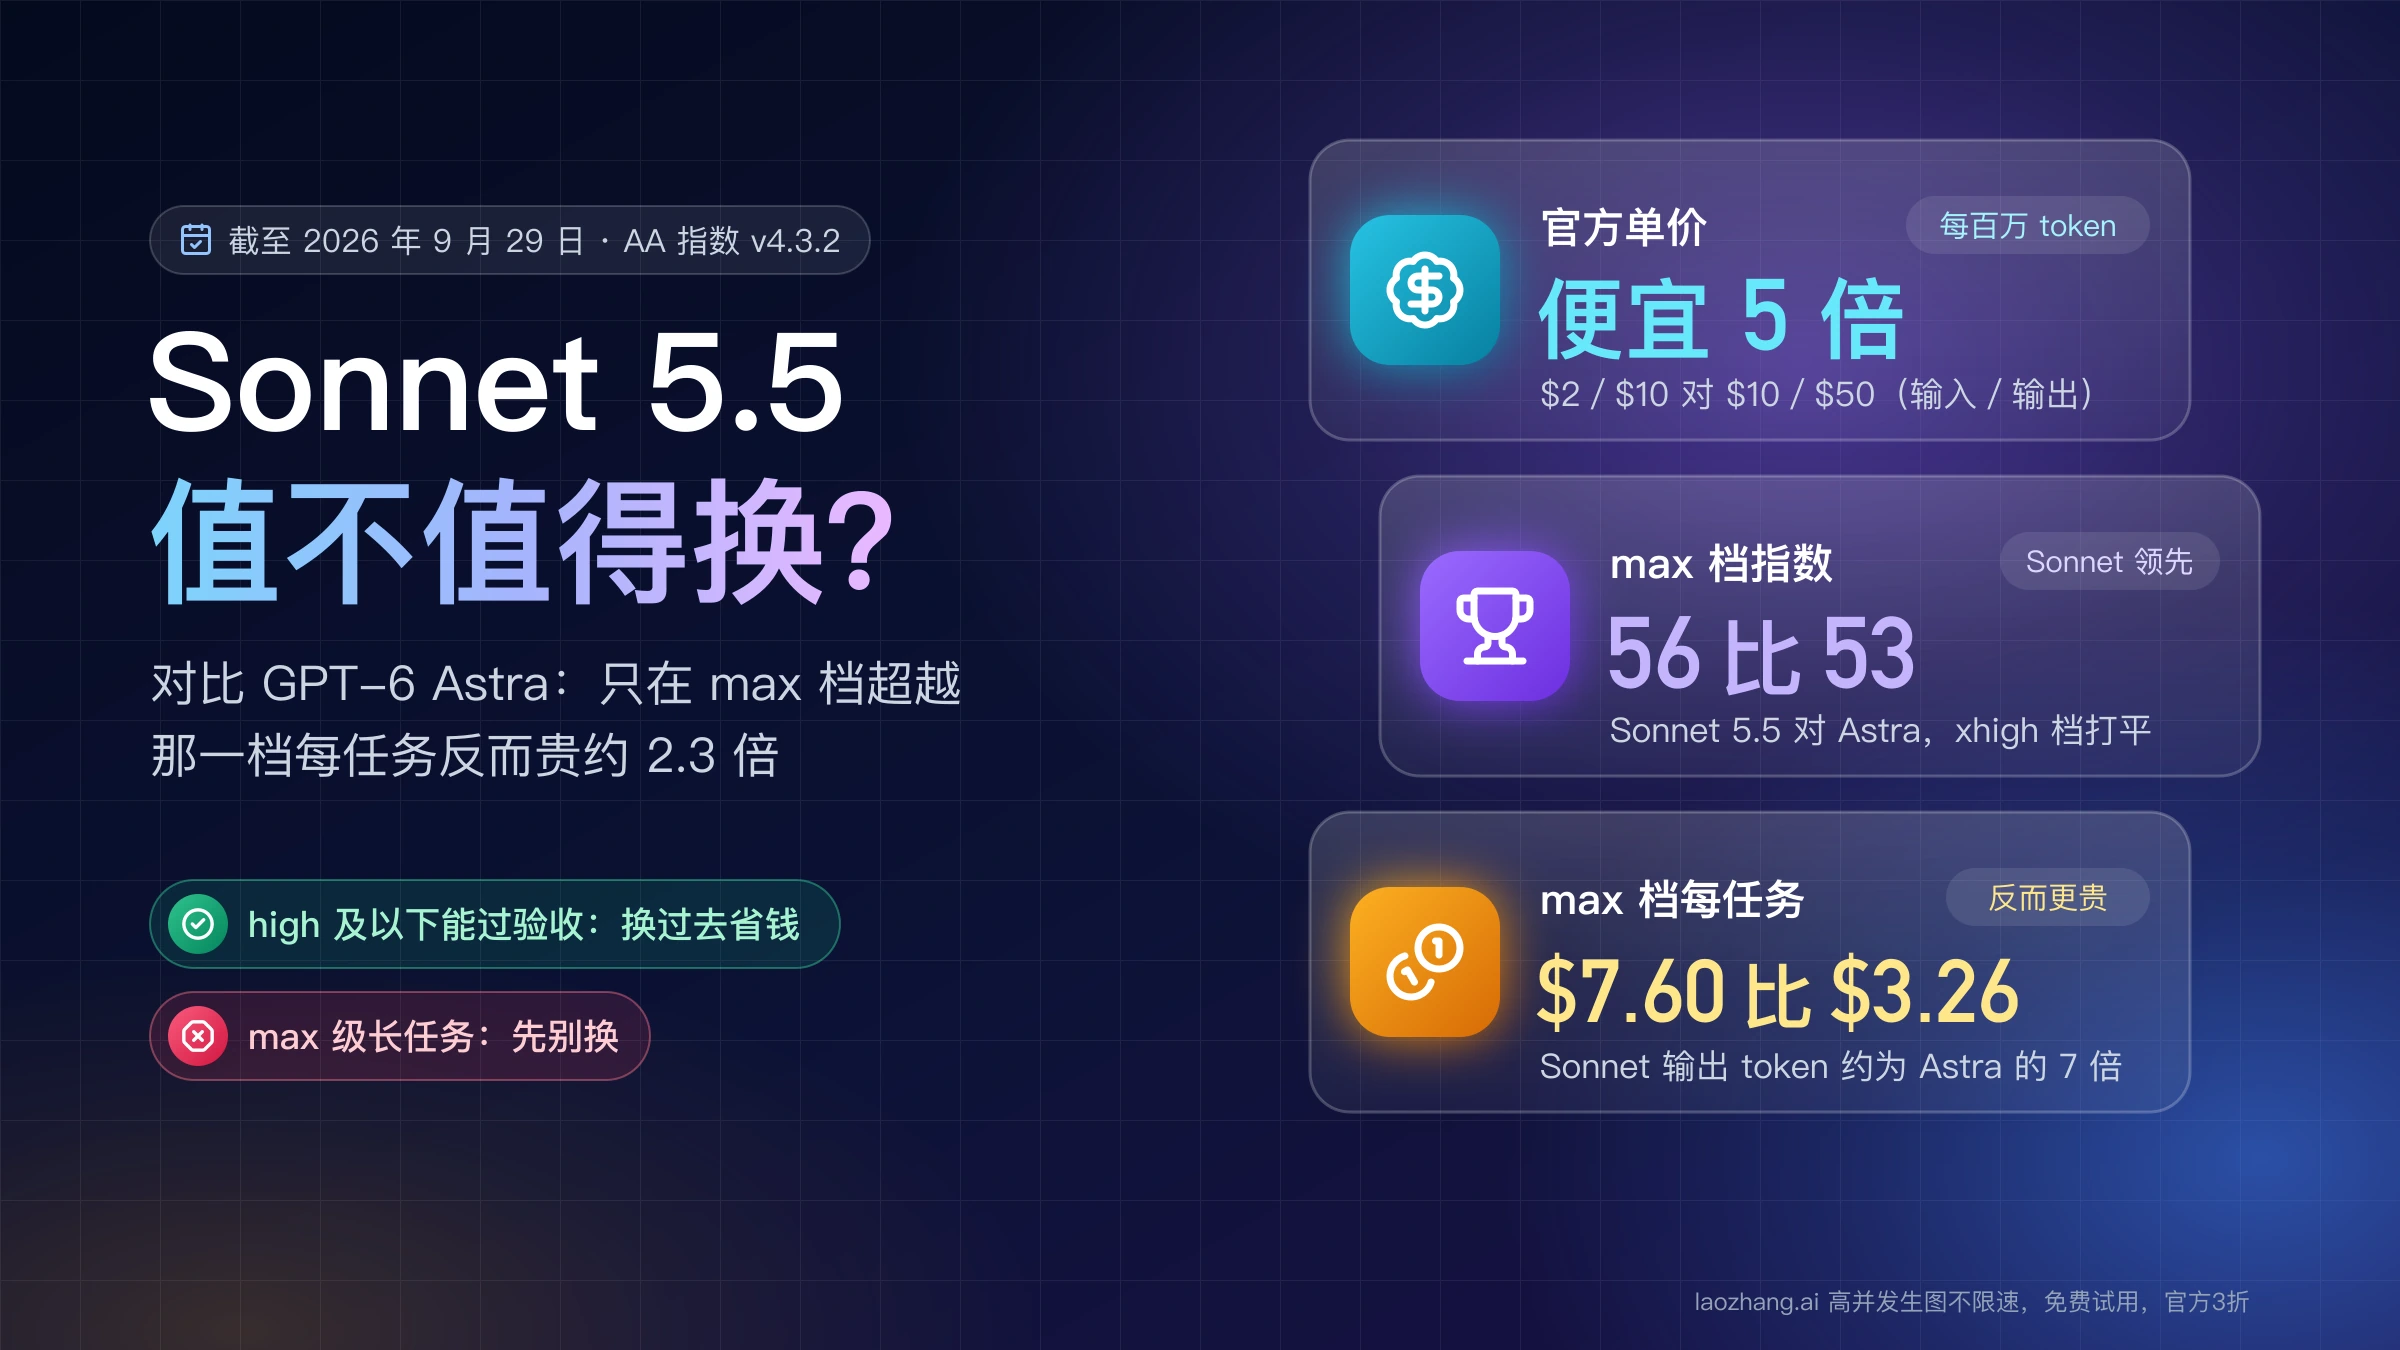
想把成本再压低,可以往下看一档:Claude 这边是《Sonnet 5.5 对比 GPT-6 Astra:值不值得换》,OpenAI 这边是《GPT-6.1 Sol、GPT-6 Sol、Astra 怎么选》,Opus 对 OpenAI 中价位模型见《Claude Opus 5.5 对比 GPT-6 Sol 与 6.1 Sol:先看任务,再算合格交付成本》。
参考来源4
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年11月12日。
参考来源4
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年11月12日。
- 1.Artificial Analysis 的 Claude Opus 5.5 与 GPT-6 Astra 版本对比页artificialanalysis.ai/models/releases/comparisons/claude-opus-5-5-vs-gpt-6-astra
- 2.Anthropic 的 Claude Opus 5.5 发布页anthropic.com/claude-opus-5-5
- 3.Claude API 定价文档platform.claude.com/docs/en/about-claude/pricing
- 4.OpenAI API 定价页developers.openai.com/api/docs/pricing